


DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现
长上下文推理的账本只有两项支出:计算量和显存带宽。标准的注意力机制在两项上都按序列长度的平方增长——每生成一个 token,都要把此前所有 token 的 Key 和 Value 读一遍并逐个做点积。当上下文从 8K 涨到 128K,这笔支出涨 256 倍,而模型实际需要的”有用信息”并没有同步涨 256 倍。DeepSeek-V3.2 的核心架构改动正是冲着这个错配去的:它把注意力从”每个 query 看所有历史 token”改成”每个 query 只看被挑选出来的 k 个历史 token”,把核心注意力的复杂度从 压到 。
这套机制叫 DeepSeek Sparse Attention(DSA),由 DeepSeek 团队在 2025 年 12 月随 DeepSeek-V3.2 的论文与开源权重一起发布(arXiv:2512.02556,v1 版本为 2025-12-02)。它不是一次重新预训练,而是在 DeepSeek-V3.1-Terminus 的基座 checkpoint 上通过”继续预训练”注入的一个新注意力通路:主干权重、MLA 的压缩结构、MoE 的专家划分全部保留,只额外插入一个轻量的闪电索引器(lightning indexer)和一个细粒度 token 选择机制。
这篇文章要回答三类问题。第一类是机制层面:索引器凭什么能用极小的代价近似出”哪些历史 token 重要”,它的分数函数为什么长成 这个形状,ReLU 和那组权重各自承担什么职责,为什么它必须跑在 FP8 上。第二类是工程层面:这套机制在真实推理框架里是怎么落地的——vLLM 用了一个什么样的 Triton 内核把 query 的 RoPE 与 FP8 量化融成一步、用什么内核产出逐行 logits、又把这些 logits 怎么变成 Top-K 的物理槽位;索引器自己的 KV 缓存为什么能和注意力的 KV 缓存分开管理。第三类是取舍层面:稀疏到底省掉了什么、没省掉什么, 的那部分留在哪里,以及为什么这套设计必须和 MLA 的 MQA 模式绑定在一起。
本文的叙述主线是”机制 → 内核 → 框架实现”,站内已有若干篇与本文直接相关的前置文章,读到对应位置会顺手给出链接。
问题的实质:注意力贵在哪里,稀疏能省掉哪一项
要判断稀疏注意力这套思路值不值,先把注意力在推理时的开销拆开。
在自回归生成中,每一步的注意力可以写成这样的形式:给定当前 token(或当前一批 token)的 query ,以及历史所有位置的 key 和 value (),输出是
这个式子有两个层次的开销。第一个层次是算分: 对每个历史位置 都要算一次,一共 次点积,每次点积涉及 维乘加。第二个层次是取值:softmax 之后要对 个 value 向量做加权求和。
在 prefill 阶段,一次要处理 个 query,所以算分这一步的总计算量是 ,也就是那个老生常谈的 。在 decode 阶段,每次只有一个新 query,看起来算分只要 ,但真正的瓶颈换成了读数据:为了算出这 个分数,必须把 个 key 从显存里读进来;为了做加权求和,又必须把 个 value 读进来。在 batch size 不大、算术强度很低的解码场景里,显存带宽是决定性因素,而 KV 缓存的大小和读写量都随 线性增长——序列越长,每一步解码需要搬运的数据越多,吞吐越低。
所以注意力有两条独立的成本曲线:一条是 prefill 的 计算,一条是 decode 的 字节搬运(乘以层数、头数、精度字节数)。任何”长上下文加速”的方案都必须说清楚它打算砍哪一条。
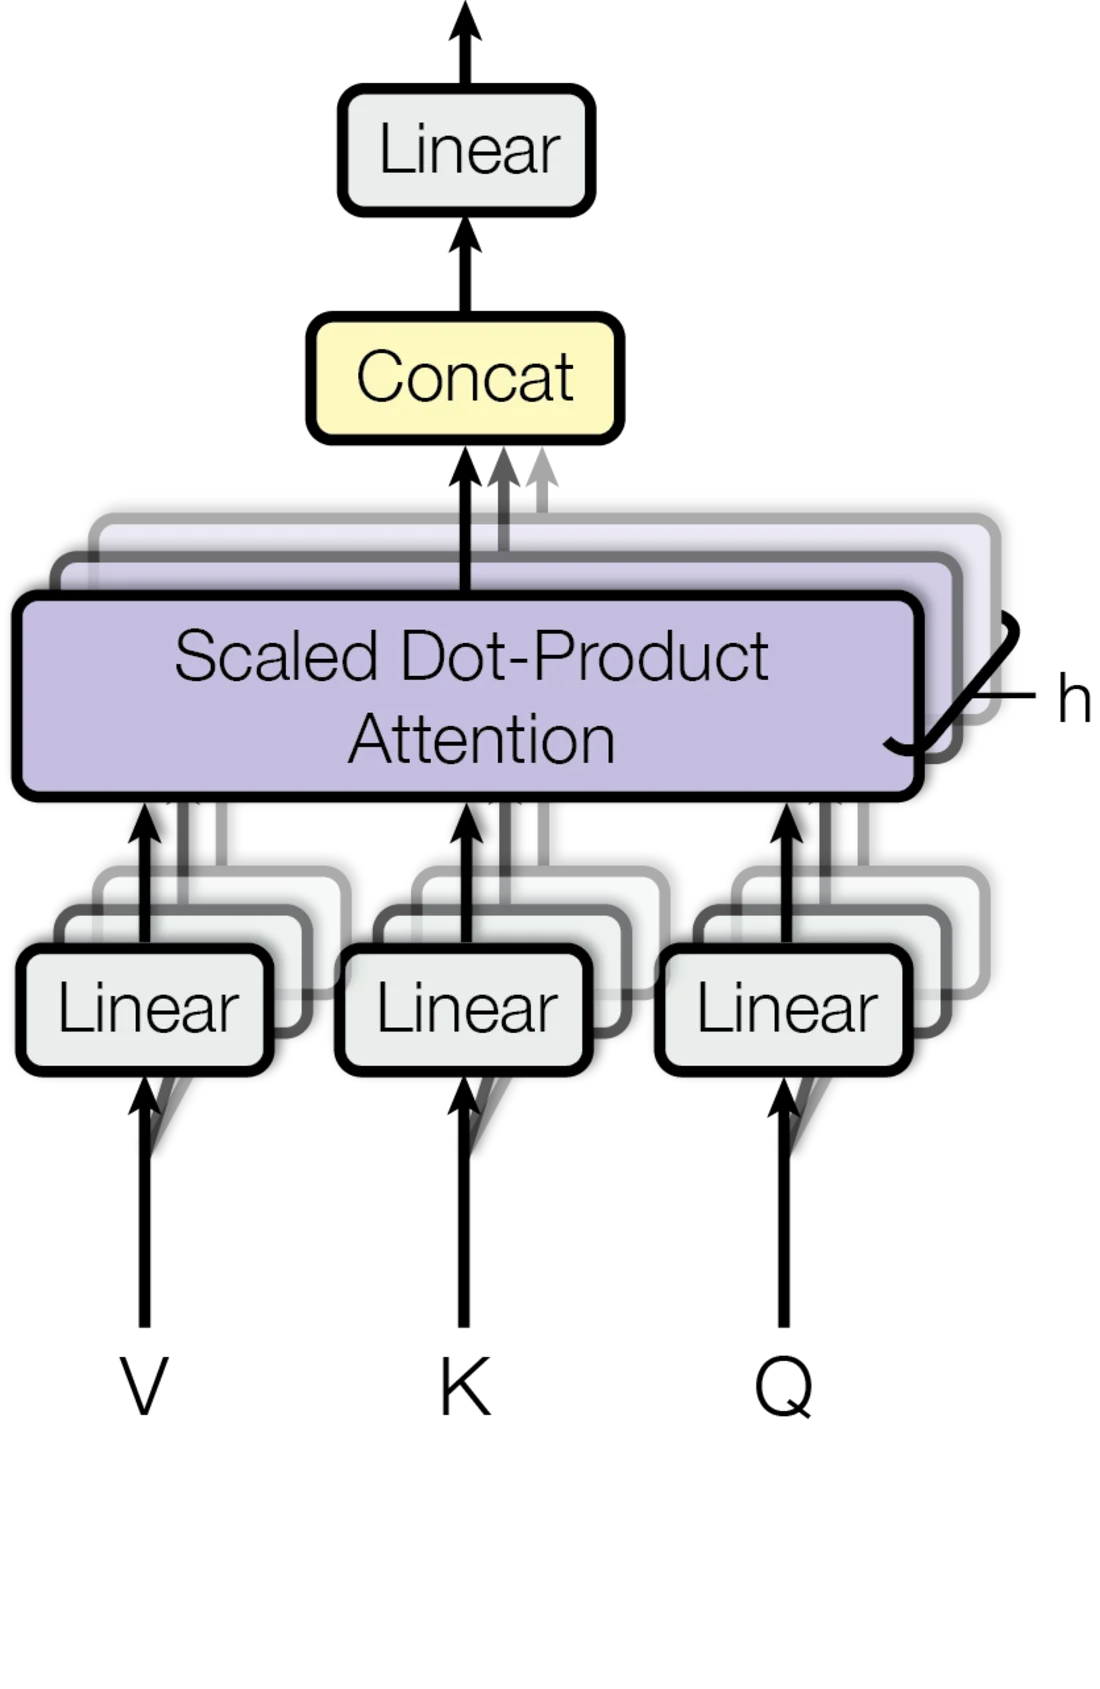
上面这张图来自 Attention Is All You Need(Vaswani 等人,arXiv:1706.03762)中的多头注意力结构图,它标出了后面所有讨论的坐标系:左边是一组线性投影把输入拆成 Q、K、V 三条通路,中间是缩放点积注意力在多个头上并行发生,右边把各头的输出拼接再投影一次。本文后面反复出现的”主注意力的头数 “指的就是中间那一叠并行通路;而 DSA 的做法,是在这套结构之外再长出一条小一号的注意力通路专门用来打分。
DSA 砍的是这样一个关键事实:对某个 query 而言,绝大多数历史位置对最终的输出几乎没有贡献。 注意力分数经过 softmax 之后高度集中在少数几个位置上,其余位置分到的权重接近零;把它们读进来、算出来、再乘上去,只是在浪费算力和带宽。如果把每个 query 真正需要的历史位置数固定为 (),那么 prefill 的算分从 降到 ,decode 的读取从 个 key/value 降到 个。这就是 的来历。
代价也很清楚:你必须先知道”哪 个位置重要”。这个”先知道”本身需要一次全序列的打分——如果不做任何优化,它就退化成一个完整的 。DSA 的闪电索引器就是这次打分本身,它的全部设计目标可以概括为一句话:用足够便宜的代价算出足够准的近似分数,让”找 Top-K”这一步的总成本远小于它省下来的一次完整注意力。
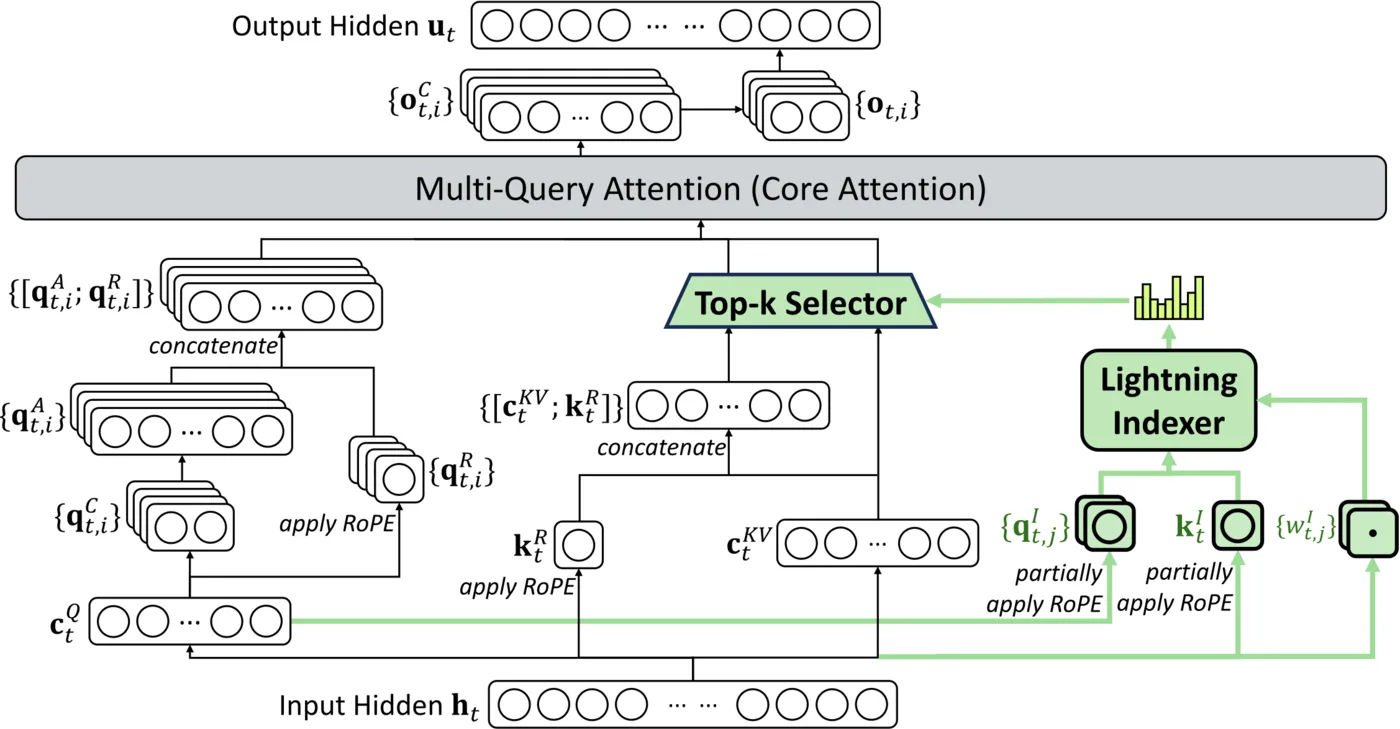
上图是 DeepSeek-V3.2 论文中的 Figure 2,也是理解整篇文章的总图。图中左侧是标准的 MLA 通路:query token 的隐状态 经过下投影得到压缩的 query 表示 (在 MLA 中 query 本身也可能被低秩压缩,见下文),历史 token 的隐状态经过 KV 联合投影得到压缩的 KV 条目 。图中绿色的那一路则是 DSA 新增的旁路:索引器读取 和历史 KV,算出一组索引分数 ,据此挑出贡献最大的若干条目。真正被送进注意力的是被挑选的那部分 ,而不是全部。
一个容易忽略的细节是:图中被挑选的 是被多个 query 头共享的。这与 MLA 的 MQA 模式直接相关,下文会专门讲。
索引器:为什么是这个分数函数
DSA 论文把索引分数定义成(式 (1)):
逐个符号拆开看:
- 是索引器的头数。注意它和主注意力的头数 是两个独立的配置量,而且索引器头数远小于主注意力。每个索引器头有自己的 query 向量 和 key 向量 ,维度是 ,同样远小于主注意力的 head dim。
- 、 都由当前 query token 的隐状态 通过线性投影得到。也就是说,每个索引器头既产出一个 query 向量,又产出一个标量权重。
- 由历史 token 的隐状态 投影得到,每个历史 token 只有一份索引器 key,被所有索引器头共享(注意下标里没有 )。
这个函数形状的每一处都是被”便宜”这两个字逼出来的。
为什么用点积而不是完整的注意力。 主注意力要用 之后接 softmax。索引器去掉了 softmax,也去掉了除以 的缩放。softmax 是一个跨所有位置的归一化操作,意味着算分必须看到完整的行才能出结果——这在分块和流式处理时非常别扭。去掉 softmax 之后,索引分数变成一个逐位置独立的标量: 只依赖 和 ,可以任意分块计算、任意并行,不需要归约。这对一个要在 GPU 上以极小代价跑完全序列的打分器来说是最重要的性质。
为什么用 ReLU 而不是 Softmax 或 GeLU。 论文给出了直截了当的理由:吞吐考虑。ReLU 是逐元素的最大值与零比较,没有除法、没有指数、没有跨元素依赖,在 GPU 上是纯粹的 ALU 操作,可以和乘加指令流水线挤在一起;而 exp 属于 SFU(特殊功能单元)指令,吞吐远低于 FMA。对索引器这种每 token 要跑 次的算子,把激活函数从 exp 换成 ReLU 带来的吞吐差异是实打实的。
另一个隐含好处是 ReLU 的稀疏性:负数被直接截断为零,意味着”这个(头, 位置)组合贡献为零”。虽然实现上不一定利用这种稀疏,但至少它保证单项贡献不会出现负值相互抵消的怪异情况,让这个”加权求和”更接近一个”投票”语义。
为什么需要那组权重 。 如果没有 ,式 (1) 就退化成 ,即所有索引器头等权求和。加上这组由 query 动态生成的权重,索引器就获得了逐头加权的能力:某个头如果在当前上下文里更”敏锐”,它的投票权重就可以被抬高。这是一个典型的轻量级门控设计——门控信号本身来自 query 隐状态,代价只是一个 的投影矩阵。
为什么”每个历史 token 只有一份索引器 key”。 因为索引器的 key 侧如果也按头存多份,那么它在 KV 缓存里占的空间就要乘以 ,而索引器缓存本来就必须对全部历史位置保持可见(它的打分范围是全序列,不能像滑窗那样只保留最近一段)。把 key 侧做成单头,是让索引器缓存尽量小的关键决策。
把这个函数和标准注意力放在一起对比,可以看出索引器是一个被刻意”降级”的注意力:去掉了归一化、去掉了缩放、换掉了激活函数、缩小了头数和维度、并且把 key 压成单头。它放弃了绝大部分表达能力,换来的是可以在极低成本下跑完整序列。
三个必须搞清楚的数字:、 与
看 DSA 的实现之前,有三个配置量必须先弄明白各自控制什么,因为后面所有内核代码都是围着它们转的。
:索引器的 head dim
的维度。它决定了索引器 KV 缓存的每 token 字节数,是一个非常敏感的量。
在 vLLM 的实现里,这个量对应配置项 index_head_dim。DeepSeek-V3.2 官方配置给出的值是 128。它直接决定索引器 key 缓存的形状:每个历史 token 存一份 维的 key。如果按 FP8 存(一个字节一个元素),那么每 token 的索引器 key 缓存就是 128 字节;再加一个 FP8 的 per-token scale(vLLM 的注释里写的是 4 字节),一共 132 字节。
这个 132 字节在 vLLM 的代码里留下了一个很有意思的脚印。看这段计算预填充工作区大小的函数(vllm/v1/attention/backends/mla/indexer.py):
def get_max_prefill_buffer_size(vllm_config: VllmConfig): max_model_len = vllm_config.model_config.max_model_len factor = vllm_config.attention_config.sparse_mla_prefill_workspace_factor # Each entry is 128 fp8 bytes and 4 scale bytes for a total of 132 bytes. # The flashmla_sparse backend uses a workspace size of factor * max_model_len. # The memory usage of the workspace there is 576 * 2 bytes; so we size this as # (576 * 2 // 132) * factor (40 at factor 5) to maximize this workspace # size while still fitting within the flashmla_sparse workspace. # For DeepSeek-V3.2, the max_model_len is 163840. # 40 * 163840 * 132 = 865075200 bytes = 825 MB return max_model_len * (576 * 2 // 132) * factor注释里的 128 与 4 就是上面说的 个 FP8 字节加一个 FP8 scale。 则是 flashmla_sparse 后端自身的工作区口径。这段代码在做的事情是:让索引器的预填充工作区大小正好塞进同一个 GPU 显存预算里,而且刻意贴着上限算,好把工作区开得尽可能大。这是一个显存预算被两个子系统共享时的典型工程手法——不是各要各的,而是先把一个后端的预算口径当成硬约束,再反推另一个子系统能开多大。
对于 DeepSeek-V3.2,max_model_len 是 163840(即 128K 训练长度加上一点余量),系数取 40,最终工作区约 825 MB。这个数字说明了索引器落地时的代价量级:不是几 MB 的零头,而是接近 1 GB 的专用工作区。
:索引器头数
和 的 取到多少个。它决定了打分时的计算量:每对 (query, 历史位置) 要算 次 维点积。
DeepSeek-V3.2 官方配置给出的值是 64。这个数字在 vLLM 的建模代码里能直接读到:
self.topk_tokens = config.index_topk self.n_head = config.index_n_heads # 64 self.head_dim = config.index_head_dim # 128(来自 vllm/model_executor/models/deepseek_v2.py 中 Indexer 类的初始化。)注释里把三个关键配置的取值都标了出来:、、 由 index_topk 给出。把它和主注意力的规模放一起对比才有感觉:DeepSeek-V3.2 主注意力的头数是 128、head dim 是 128(MLA 的 )。也就是说,索引器的”打分通路”在头数上是主注意力的一半,在 head dim 上相同,但每个历史 token 只存一份 key(而不是 128 份),并且跑在 FP8 上。
关键点是: 参与的是”算分”复杂度,而算分复杂度是 。这意味着索引器自身的复杂度仍然是 ——它只是把常数系数压得很小。论文在”推理成本”一节里把这一点写得很明确:DSA 把主模型的核心注意力从 降到 ,但闪电索引器本身仍有 的复杂度,只是相比 DeepSeek-V3.1-Terminus 里的 MLA 需要的计算量小得多。
这句限定非常重要,它划定了 DSA 的边界:DSA 不是把长上下文的平方项彻底消灭了,而是把它从”昂贵的完整注意力”换成了”廉价的索引器打分”。工程上真正能不能拿到收益,取决于索引器那条 的常数系数到底能压多低——这就解释了为什么后面的内核实现要把 RoPE、量化、点积全部融合、为什么一定要用 FP8。
:每个 query 选多少个历史 token
论文给出的值是 2048。这是”细粒度 token 选择”机制里的 top-k,也是 DSA 唯一直接控制”注意力看多少历史”的参数。
的取值需要在两个方向之间权衡: 太小,被选中的集合覆盖不到真正重要的位置,模型质量下降; 太大, 里的 上去了,省下来的计算又还回去了。2048 这个量级说明 DeepSeek 的判断是:一个 query 在 128K 上下文里真正需要回看的 token 数在两三千这个量级,而不是几万。
的另一个重要影响是下游内核的规格。因为选出来的 2048 个位置要用一个索引数组表示,而索引数组的元素数直接决定了稀疏注意力内核的 tile 尺寸和 gather 次数。这解释了为什么 vLLM 里会出现”索引数组宽度被硬编码为 512/1024/2048”这样的约束——后面会看到具体的代码。
的取值还有一个经验上的直观检验方法:把 从 2048 一路往下调,观察模型在长上下文任务上的表现何时开始明显退化。这个”质量悬崖”的位置就是该架构真正需要的历史 token 数。论文没有给出这样的扫描曲线,但从 128K 上下文只选 2048 个位置这个比例(约 1.6%)可以推断,作者认为注意力的有效信息密度非常集中——这个判断与前文提到的”指数器分数分布高度集中”是同一件事的两个侧面。
把这几个数字放在一起,就能看出这套设计的整体平衡:索引器用 个很小的头(,且 key 侧单头)跑一遍全序列的廉价打分,然后用它选出 个位置,交给完整精度、完整头数的主注意力去做真正精细的计算。贵的部分做得少(只做 2048 个位置),便宜的部分做得多(做全序列)。
实例化:DSA 为什么必须挂在 MLA 的 MQA 模式上
论文在 “Instantiate DSA Under MLA” 一节里给出了一个乍看之下很技术化、但背后是硬件约束的决定:DSA 基于 MLA(Multi-head Latent Attention)实例化,并且选用 MLA 的 MQA 模式。
先看这个选择的动机。论文的措辞是:在 kernel 层面,每个 key-value 条目必须被多个 query 共享,才能获得计算效率。 这句话点出了稀疏注意力在 GPU 上的核心矛盾。
设想如果 DSA 挂在标准 MHA 上:每个 query 头都有自己的一套 key/value。那么”选出 Top-K 位置”这个动作选出的是位置,但每个位置在每个头下都有不同的 key/value 数据。于是稀疏注意力内核在读数据时,需要按照”位置 × 头”的笛卡尔积去 gather——这会让索引数组从”位置列表”变成”位置与头的乘积”,gather 的粒度和地址计算都变得极其零碎,访存几乎无法做宽向量化,稀疏带来的带宽收益被 gather 开销吃光。
MLA 的 MQA 模式恰好解决了这个问题。MLA 的根本设计是把 KV 压到一个低维的潜向量(latent vector) 上:历史 token 的隐状态经过一个下投影得到一个维度远小于 的压缩表示,所有头部共享这同一个潜向量。这个潜向量就是论文里说的”MLA 的 key-value 条目”。在 MQA 模式下,一个潜向量 被该 token 的所有 query 头共享。
于是”选 Top-K 位置”就等价于”选 Top-K 潜向量”。索引数组描述的是”要读哪些潜向量”,而这些潜向量对所有头都是同一份数据。内核对一个被选中的位置只需要做一次 gather,读进来的 维潜向量可以同时在所有头上复用。稀疏性落到了”数据搬运”这个维度上,才是真正有价值的稀疏性。
站内的 MLA 完全拆解:DeepSeek 低秩 KV 压缩注意力的原理与全部实现细节 把 MLA 的低秩压缩、RoPE 解耦与矩阵吸收讲得很透,GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量 则解释了 GQA/MQA 这类”共享 KV 头”的设计为什么能同时省缓存和带宽。本文不再重复这两条线,只强调它们在这里的作用:MQA 不是为了让 DSA 省缓存才选的,而是为了让稀疏索引落到一个粒度足够粗、能被所有头共享的寻址单位上。
顺带一个推论:这个选择也解释了为什么 DSA 和 MLA 是一体的,而很难单独迁移到别的注意力结构上。稀疏注意力需要一个”多个消费者共享一份数据”的最小寻址单元,MLA 的潜向量天然提供了这个单元。
实测口径:每 token 成本随序列位置怎么变
机制讲完,接下来需要一个校准数量的锚点:这套设计在真实硬件上到底把成本改成了什么形状。
论文的 Figure 3 给出的是一组”每 token 成本随序列中位置变化”的曲线,对比对象是 DeepSeek-V3.1-Terminus(纯 MLA 稠密注意力)和 DeepSeek-V3.2(DSA)。数据的口径论文写得很清楚:在 H800 上对实际部署的服务做基准测试,算力单价按 2 美元每 GPU 小时折算,因此纵轴是货币化的成本,横轴是 token 在序列中的位置。
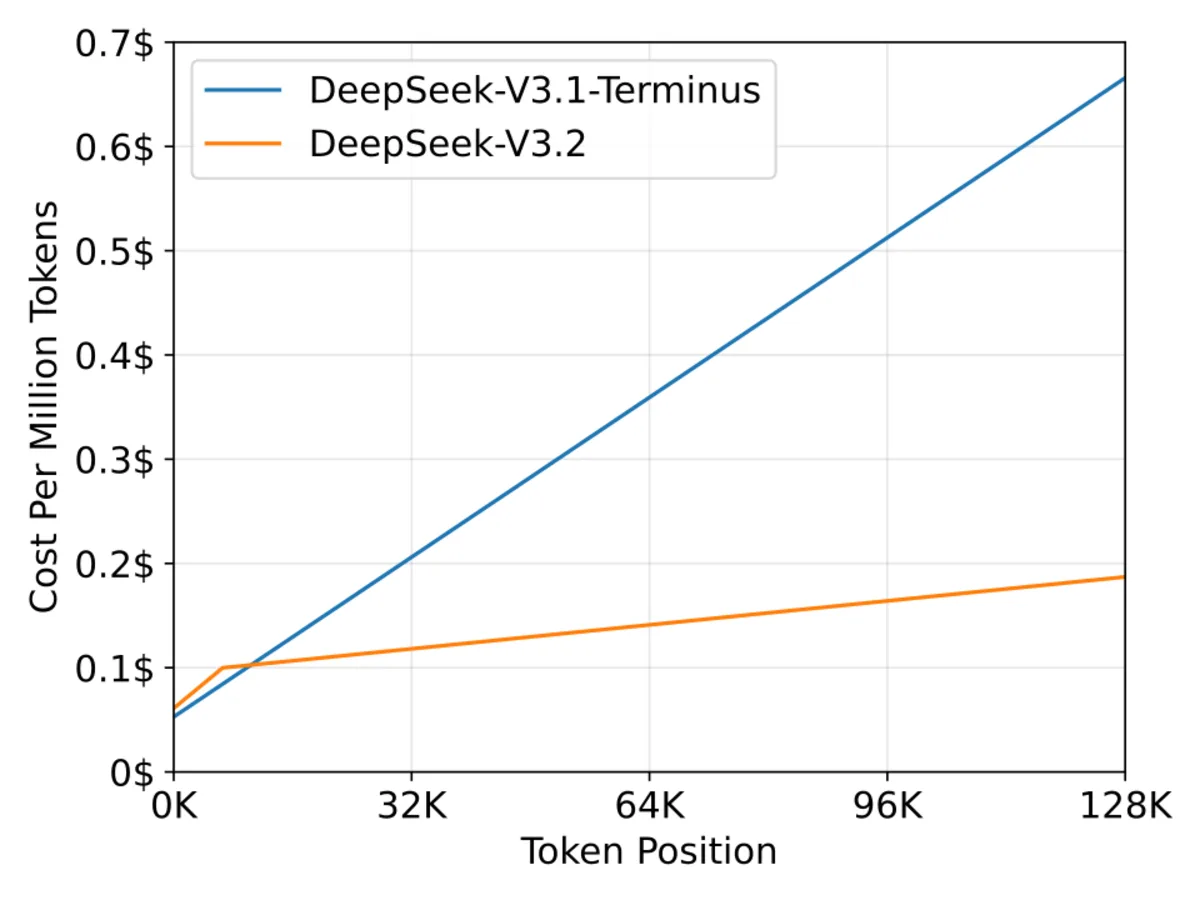
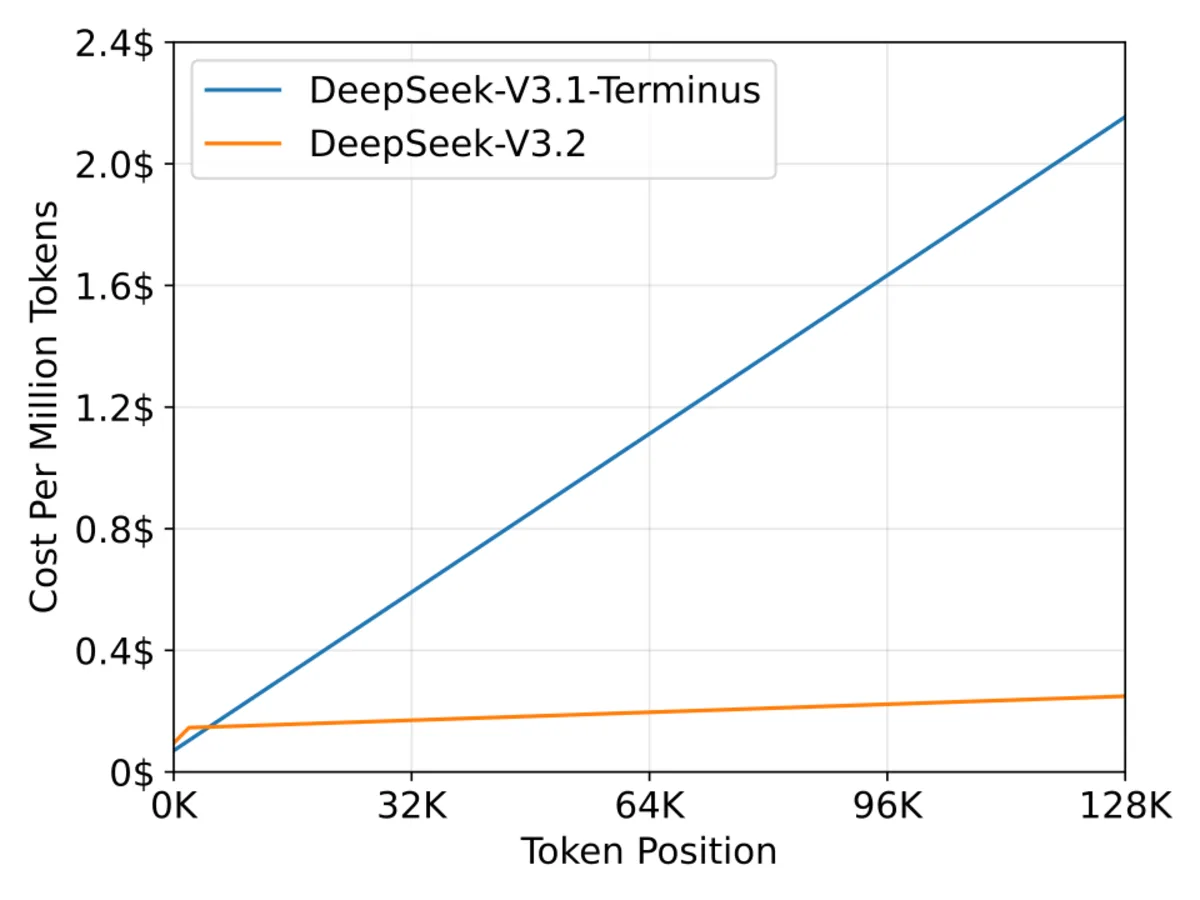
两张图对照着看,可以读出三件事。
第一,稠密注意力的成本随位置增长,稀疏的成本近似平坦。 这是 与 在成本曲线上最直接的区别:在稠密路径上,越靠后的 token 要看的上下文越长,单位成本越高;在稀疏路径上,无论 token 排在第几千位还是第几十万位,它要读的 KV 条目数都是 ——不变。曲线的形状本身就验证了复杂度量级的改变。
第二,索引器的开销体现在”平坦但非零”上。 稀疏路径的曲线不是零,它是一条有高度的近似水平线。这条线的高度就是索引器打分、Top-K 选择、地址翻译加上 个条目注意力这一整套的成本之和。“平坦”意味着它不随上下文增长,“有高度”意味着它在短上下文下可能反而是负收益——这正是下文要讨论的上下文长度门槛的来源。
第三,论文专门提到短序列预填充的处理方式。 论文里的一句话值得单独拎出来:对短序列的预填充,我们专门实现了一个 masked MHA 模式来模拟 DSA,这样在短上下文条件下能获得更高的效率。 这句话说明了 DSA 的实现者在工程上做了一件很务实的事:为短上下文单独准备一条稠密路径。 当上下文很短时,索引器那一整套开销(打分、Top-K、翻译)相对收益显得太重,不如直接用 masked MHA 把注意力算完——反正短上下文下稠密注意力的成本已经不大了。这与前文提到的 K->ne[1] >= max(4096, 2*n_gather) 判据是同一件事的两个层次:论文在模型侧准备了稠密回退,框架在 kernel 侧准备了稀疏门槛。
有了这三条校准,后面讨论所有”稀疏的代价”才有量纲:不是”稀疏有什么理论缺陷”,而是”这条平坦的线要高到什么程度,才会在某个上下文长度上超过稠密路径”。
训练侧:为什么它只需要继续预训练
虽然本文的主体是推理侧,但”索引器是怎么被训练出来的”这个问题必须简短交代,因为它决定了索引器在推理时能做多少事。
论文把 DSA 的引入分成两个阶段,都建立在 DeepSeek-V3.1-Terminus 的基座 checkpoint(上下文已扩展到 128K)之上,训练数据分布与 128K 长上下文扩展阶段完全对齐。
第一阶段是 dense warm-up。 在这个阶段索引器已经参与,但注意力的行为与稠密注意力一致——每个 query 仍然看完整的上下文。这一步的目的是让新初始化的索引器参数先”热身”,在主模型行为尽量不受扰动的前提下,把索引器的分数分布先训到一个合理的范围。
第二阶段是 sparse training。 从这个阶段开始,索引器真正控制注意力看到哪些位置(每 query 选 2048 个 KV),并且索引器的优化目标与主模型分离:索引器只由索引器自己的损失 驱动,主模型只由语言建模损失驱动。论文给出的这一阶段学习率是 ,训练 15000 步,每步 480 条 128K 长度的序列,总计 943.7B token。
这里最值得停下来想的一点是索引器有自己的损失。这不是一个”用主模型的梯度顺便带出来”的附属模块,而是一个有独立监督信号的模块。它的监督信号从哪来?直观上可以理解成:既然最终注意力只在稀疏选出的集合上计算,那么”如果让 query 看完整上下文,注意力权重会集中在哪些位置”就是索引器应该学会预测的答案。索引器的损失就是在逼近这个回答。这种”用稠密注意力当老师、用稀疏索引器当学生”的做法,是稀疏注意力能被接进已有模型而不掉点的关键。
论文对这一阶段的表述很克制,没有展开损失的具体形式,只说明了它与主模型损失分离。对于本文的读者,需要记住的结论只有两条:索引器是一个被专门训练过的模块,不是随手设计的启发式打分器;它的训练目标与主模型解耦,因此可以在不扰动主干的情况下被替换或继续优化。
落地形态之一:vLLM 里的索引器算子
接下来进入本文的重点:这套机制在真实推理框架里长什么样。以 vLLM 的实现为主线,因为它把索引器拆成了若干个可以分别理解的内核,层次最清楚。
索引器在 vLLM 里的位置是 vllm/model_executor/layers/sparse_attn_indexer.py(算子层)与 vllm/v1/attention/backends/mla/indexer.py(后端与元数据层)。前者是 SparseAttnIndexer 这个 CustomOp 的实现,后者负责为它准备元数据、管理索引器自己的 KV 缓存。
先看整体数据流。一次索引器的调用需要吃进来这样几样东西:
- 当前这批 token 的
hidden_states(用来算索引器的 query 和权重); q_quant(已经量化成 FP8 的索引器 query);k(当前批次新产生的索引器 key,需要写进索引器缓存);weights(每个 query 在每个索引器头上的标量权重);- 以及最关键的一份外部状态:索引器自己的 KV 缓存
kv_cache。
输出则是一个 topk_indices_buffer:每行对应一个 query token,行内是长度为 的整数数组,元素是该 query 选中的历史位置编号。
把这条链路拆成”打分 → 选 Top-K → 翻译成物理地址”三步,正好对应三个不同的内核。
第一步:把 query 的 RoPE 与 FP8 量化融合进一个内核
索引器的 query 需要在参与打分之前做完两件事:施加 RoPE(旋转位置编码),以及量化成 FP8(因为打分内核按 FP8 输入设计)。
如果分两步做,就要把 大小的 query 张量在显存里写一遍再读一遍。对一个每 token 都要跑的算子,这笔往返不值得。vLLM 的做法是写一个融合内核,一次读入 bf16 的 query、算出旋转后的结果、求出量化 scale、写回 FP8 结果和调整后的权重。
内核主体(_fused_indexer_q_rope_quant_kernel,Triton)的核心逻辑是这样的:
pos = tl.load(positions + token) cos = tl.load(cos_sin_cache + pos * cos_sin_s0 + offs32).to(tl.float32) sin = tl.load(cos_sin_cache + pos * cos_sin_s0 + 32 + offs32).to(tl.float32) q_base = q + token * q_s0 + head * q_s1 out_base = q_fp8 + token * q_fp8_s0 + head * q_fp8_s1
if is_neox: # NeoX layout, x0 = q[0:32], x1 = q[32:64] x0 = tl.load(q_base + offs32).to(tl.float32) x1 = tl.load(q_base + 32 + offs32).to(tl.float32) else: # interleaved layout # x0 = q[0, 2, 4, ...], x1 = q[1, 3, 5, ...] x0 = tl.load(q_base + offs32 * 2).to(tl.float32) x1 = tl.load(q_base + offs32 * 2 + 1).to(tl.float32) r0 = (x0 * cos - x1 * sin).to(tl.bfloat16).to(tl.float32) r1 = (x1 * cos + x0 * sin).to(tl.bfloat16).to(tl.float32) amax = tl.maximum(tl.max(tl.abs(r0)), tl.max(tl.abs(r1)))
q_nope = tl.load(q_base + 64 + offs64).to(tl.float32) amax = tl.maximum(amax, tl.max(tl.abs(q_nope))) scale_raw = tl.maximum(amax, 1e-10) * (1.0 / fp8_max) # e8m0 format q_scale = tl.math.exp2(tl.ceil(tl.log2(scale_raw)))这一段里有几个值得展开的细节。
grid 的组织方式。 内核用 tl.program_id(0) 当 token 编号、tl.program_id(1) 当索引器头编号。也就是说,一个 program(一个 Triton 线程块)负责”一个 token 的一个头”的 query 处理。这个粒度选择反映了一个事实:索引器头的 query 向量虽然短( 级别),但 token 数和头数的乘积非常大,按 (token, head) 二维展开可以让大量 program 并行铺满 SM。
RoPE 的两种排布。 代码里用 is_neox 开关区分两种旋转布局。NeoX 布局下,向量被切成前后两半,前一半是 、后一半是 ,旋转是 这两半之间的配对;交错布局下,取的是偶数下标和奇数下标。这两种布局在站内 RoPE 完全拆解:旋转位置编码的原理、实现与长度外推 里讲过,实现层的差别只在于元素如何配对,数学上都是”两两一组做二维旋转”。 和 从 cos_sin_cache 里按位置取出,一次读 32 个分量(offs32)——这暗示索引器 head dim 的一半是 32,也就是说每对旋转分量覆盖 64 维。
为什么旋转结果要绕一圈 bf16。 注意这两行:
r0 = (x0 * cos - x1 * sin).to(tl.bfloat16).to(tl.float32) r1 = (x1 * cos + x0 * sin).to(tl.bfloat16).to(tl.float32)乘加的结果先降成 bf16 再升回 fp32,而不是直接在 fp32 里往下算。这不是笔误,而是一种刻意的精度锚定:让旋转后的数值精度与主注意力通路里 query 的实际精度保持一致,避免索引器算出一组”比主注意力更精细”的分数而引入不匹配。这类”对齐精度口径”的处理在推理内核里很常见,站内 浮点数与数值稳定性:从 IEEE 754 到 FP8 的 LLM 精度世界 里讨论过为什么混合精度实现中刻意降精度有时反而更正确。
量化的尺度选择与 e8m0。 旋转后的两段(nope 部分与 rope 部分,代码里分别对应 q_base + 64 + offs64 那段和前半段)合起来求一个全局最大绝对值 amax,然后
scale_raw = tl.maximum(amax, 1e-10) * (1.0 / fp8_max) q_scale = tl.math.exp2(tl.ceil(tl.log2(scale_raw)))1.0 / fp8_max 把最大绝对值映射到 FP8 能表示的上界,再向上取到 2 的整数次幂——这就是 e8m0 格式的 scale:只保留指数、丢弃尾数,scale 本身就是一个纯幂次。用 exp2/ceil/log2 三步实现”向上取整到 2 的幂”,是这类块量化里非常标准的技巧,好处是 scale 的表示极省(8 bit 只存指数),且乘除 scale 在硬件上可以退化成指数加减。
权重里为什么要乘上 q_scale。 内核最后一行是这句话的答案:
weight = tl.load(weights + token * weights_s0 + head * weights_s1).to(tl.float32) tl.store( weights_out + token * weights_out_s0 + head * weights_out_s1, weight * q_scale * softmax_scale * head_scale, )query 被量化成 FP8 时除掉了 q_scale,那么后续用 FP8 query 算出来的点积就比真实值小了 q_scale 倍。与其在打分内核里给整个 logits 张量乘一个 scale(logits 是 量级的巨大张量,乘一遍的代价可观),不如把这个因子提前折进那个一维的权重里。索引器的权重张量只有 token × head 大小,改它的代价可以忽略。这是一个”把小张量的修饰搬运到大张量的修饰上”的经典优化,注释里也直说了:FP8 路径把 Q scale 折进 weights,就在 fused_indexer_q_rope_quant 里完成。
第二步:产出逐行 logits
量化好的 FP8 query 和索引器缓存里的 FP8 key 随后被送进打分内核。vLLM 在这一步调用的是 DeepGEMM 提供的 fp8_fp4_mqa_logits(以及 CPU/XPU 等平台的对应实现),得到一个逐行的 logits 张量。这个函数的命名已经把它的语义写清楚了:它以 MQA 的方式计算 logits——即 key 侧只有一份数据,被所有 query 头共享。
调用点大致长这样(去掉分支后的主干):
row_ends = cu_seqlen_ke - cu_seqlen_ks logits = as_fp32_logits( fp8_fp4_mqa_logits( (q_slice_cast, q_scale_slice), (k_quant_cast, k_scale_cast), chunk_weights, cu_seqlen_ks, cu_seqlen_ke, chunk.max_seqlen_k, ), row_ends, )这段代码里有三个设计点。
压缩 logits 与 row_starts。 注意 cu_seqlen_ks 和 cu_seqlen_ke 是成对传入的。代码的注释解释了这一点:
# DeepGEMM returns compressed logits: row i starts at K position # cu_seqlen_ks[i]. None means every row starts at column zero.也就是说,打分内核只返回每一行真正需要的那一段,而不是返回一个宽度等于完整上下文长度的张量。对因果注意力来说,位置 的 query 只需要看 ,返回整个宽度纯属浪费。返回压缩片段之后,Top-K 内核必须知道”这一行返回的片段对应的是原序列里的哪一段”,所以要把 row_starts 也传下去。这个设计把 logits 张量的显存占用从”平方级”降到”实际需要的量级”,是长上下文下能跑得动的关键。
空行与提前返回。 代码里有一段针对 local_total_seq_lens == 0 或 q_slice.shape[0] == 0 的处理,直接把 topk_indices 填成 -1。这个分支看起来很琐碎,但 -1 这个约定会一路贯穿到后面的地址翻译:-1 表示”这个槽位是空的”,不需要读任何 KV。后面讲稀疏注意力内核时会看到它是怎么被利用的。
logits 的类型与后续转换。 as_fp32_logits 这个包装函数把内核产出的结果整理成 fp32 的逐行 logits。为什么需要它?因为底层内核可能以 FP8 或低精度形式返回结果以省显存,而 Top-K 比较需要在 fp32 上做才稳定。这里有一个对应的 Triton 内核 _upcast_logits_kernel 专门负责升精度。
第三步:把 logits 变成 Top-K 索引
拿到逐行 logits 之后,需要一个”每行取最大的 个下标”的操作。vLLM 把它写成了一次算子调用:
ops.top_k_per_row_prefill( logits, torch.zeros_like(row_ends) if row_starts is None else row_starts, row_ends, topk_indices, num_rows, logits.stride(0), logits.stride(1), topk_tokens, )传入的参数里,logits 是压缩后的行张量,row_starts 是每行在原序列里的起点,row_ends 是每行的有效长度,topk_indices 是输出缓冲区,topk_tokens 就是 。函数名里的 prefill 说明这是预填充路径专用的实现——因为预填充阶段的行长参差不齐(每行的有效历史长度不同),这个内核必须处理变长行。而 decode 阶段每行长度一致,走的是另一条更简单的路径。
一个值得注意的实现取向是:vLLM 没有自己写这个 Top-K 内核,而是通过 ops 调用平台提供的算子。这既是因为 Top-K 是一个通用性很强的算子,也是因为在不同硬件平台上它可能有各自的最优实现(后文会看到 Blackwell 上走的是另一条 CuteDSL 路径)。
到这里,“打分 → 选 Top-K”这两步就完成了,topk_indices_buffer 里装的是每行 个逻辑位置编号。但这份数据还不能直接喂给注意力内核。
从逻辑位置到物理槽位
这是整个链路里最容易被忽略、但工程上必不可少的一步。
topk_indices 里存的是”该 query 在它自己的序列里要看的第几个 token”。注意力内核真正需要的是”这个 token 的 KV 数据在物理缓存里的槽位号”。这两者之间隔着会话(request)、块表(block table)、块大小(block size)等多层映射。
把逻辑位置翻译成物理地址的工作由 triton_convert_req_index_to_global_index 完成。它的调用形式是这样的(来自 flashmla_sparse 后端):
topk_indices, topk_length = triton_convert_req_index_to_global_index( req_id_per_token, block_table, topk_indices, BLOCK_SIZE=attn_metadata.block_size, BLOCK_STRIDE_ROWS=block_stride_rows, NUM_TOPK_TOKENS=topk_indices.shape[1], return_valid_counts=True, )逐个参数看:
req_id_per_token:每个 token 属于哪个请求。这是翻译的起点——不同请求的同一个逻辑位置在物理上是完全不同的地址。block_table:请求到物理块的映射表。分页 KV 缓存的核心数据结构。站内 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block 与 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率 详细讲过这套机制。BLOCK_SIZE:一个物理块装多少个 token,用于把逻辑位置拆成”块内偏移 + 块号”。BLOCK_STRIDE_ROWS:物理块在缓存张量里的行跨度。当缓存被组织成二维行视图时,块号要乘以行跨度才能得到真正的行地址。NUM_TOPK_TOKENS:索引数组的宽度,即 。return_valid_counts=True:除了物理索引,还返回每行真正有效的索引个数。
最后那个返回值 topk_length 是需要单独说的是。为什么需要它?因为在”取 Top-K”和”翻译成物理地址”之间,行的有效长度可能小于 ——一个刚生成到第 100 个 token 的请求,它根本没有 2048 个历史位置可选。这种情况下索引数组里会有一批无效槽位(前面看到的 -1),必须有一个显式的计数告诉内核”这行只有前 topk_length 个索引是真的”。内核据此跳过其余槽位,而不是去读垃圾地址。
理解了这一步,就理解了稀疏注意力在框架里落地时的真实复杂度:稀疏只是算法层面的一个想法,要在生产框架里跑起来,它必须被翻译成一套完整的分页地址运算。 这套运算本身的实现质量(能否与打分融合、能否避免额外的显存往返)直接决定了稀疏能不能转化成端到端的收益。
稀疏注意力内核:索引数组怎么被消费
翻译出物理索引之后,真正的稀疏注意力计算才发生。这里以 flashmla_sparse 后端的路径为例,把”索引数组如何被内核消费”讲清楚。
整体的调用形态是这样的(省略了预填充与解码分流的细节):
attn_out, lse = self._bf16_flash_mla_kernel( q, kv_rows, topk_indices, topk_length, actual_num_heads, )传进去的 kv_rows 是一个二维行视图——把分页的 KV 缓存摊平成”每行一个潜向量”的排布,这样物理索引就可以直接当作行号使用。转换这一步由 flat_kv_row_view 完成。这个视图化是 GPU 上处理分页缓存的标准手法:把间接寻址问题转化成”在一个规则二维张量上做行 gather”,从而避免在 kernel 里做多级指针追踪。站内 FlashInfer 完全拆解:把分页 KV、动态批处理与定制注意力编译成服务级 Kernel 里也用了同样的思路处理稀疏 KV 表示,两篇可以对照着看。
gather 式读取:稀疏在 kernel 里的样子
索引数组进入内核之后,最本质的变化发生在读取 KV tile 的那一步。
在稠密 FlashAttention 里,读取 KV 的方式是”按 tile 顺序扫过”:第 次循环读位置 的那一段,地址是连续的、可预测的、可以打满宽向量化的。读取代码通常形如 KV + (k_VKQ_0 + i) * stride_KV。
在稀疏版本里,同样的读取变成了:
int64_t i_KV; if constexpr (use_sparse) { // padded slots gather row 0, the -inf mask removes their contribution const int32_t index = i < i_sup ? indices[k_VKQ_0 + i] : 0; i_KV = index >= 0 ? index : 0; } else { i_KV = k_VKQ_0 + i; }(这段代码来自 llama.cpp 的 CUDA 稀疏注意力实现。它把”顺序读”换成”查表读”的手法和 vLLM 侧的 flashmla_sparse 是同一个意思,只是 llama.cpp 这份代码把注释写得更直白,所以借它来说明机制。llama.cpp 侧如何组织分页 KV 与掩码,站内 llama.cpp 源码完全拆解(四):llama_context 与记忆系统——KV Cache、slot 与批处理如何组织一次解码 有完整交代。)
这段代码里有三个关键点,每一句注释都在讲一个工程事实。
第一,i < i_sup ? indices[...] : 0——为什么要有 i_sup 这个上界。 稀疏 tile 每次要读的 KV 条数是固定的(比如 nbatch_fa 条),但实际有效索引数可能是 topk_length 这样的小值,也可能是被 padding 补齐的中间值。i_sup 就是”本 tile 里真正有效”的上界,超过它的一律当作无效。分块处理时,一个 tile 里可能只有一部分槽位是真的,其余是填充。
第二,index >= 0 ? index : 0——负索引统一落到行 0。 索引数组里的 -1 表示”这个槽位没有有效 KV”。直接从 -1 算地址会得到越界地址,轻则读错数据,重则触发非法访问。这里的处理是把所有负索引都改成 0,读一个肯定是合法的行,然后靠掩码把它的贡献抹掉。注释说得很清楚:填充的槽位 gather 第 0 行,由 -inf 掩码去掉它的贡献。
这是稀疏内核里一个非常典型的模式:用”读一个合法但无意义的数据”换掉”分支判断”。在 GPU 上,让所有线程走同一条无分支路径、多做一点无用的读取,通常比让一部分线程走特殊分支要快得多,因为分支发散的成本在 SIMT 机器上很高。
第三,掩码必须逐元素 gather。 这一点在同一个文件里被显式写出来:
// the sparse mask values are gathered per element, always load them synchronously constexpr bool use_cp_async = nstages == 1 && !use_sparse;在稠密版本里,掩码是从一个规则的二维张量里按 tile 读的,可以走 cp.async 异步拷贝,与计算重叠。在稀疏版本里,掩码的地址也要靠索引数组查出来,每个元素的地址都不同,没法用要求 16 字节对齐、地址规则连续的异步拷贝指令。于是稀疏路径只好退回到同步加载。
这个细节的价值在于它说明了一件事:稀疏不是免费的,它把”顺序访存”降级成”gather 访存”,代价是失去异步拷贝和部分向量化。 这就是为什么稀疏注意力的收益从来不是”理论上省了多少 FLOPs”能直接换算出来的——gather 的开销会吃掉相当一部分收益,只有当选出的 远小于 、且内核对 gather 的组织足够高效时,净收益才是正的。
顺带一提,同一份代码里还写着稀疏路径不支持多级流水:
// sparse gather is not implemented for multi-stage loading return use_sparse && nstages_target > 1 ? 1 : nstages_target;多级流水(nstages > 1)的前提是”下一批要读的数据地址可以提前算出来并预取”。稀疏路径里,下一批地址同样依赖索引数组,预取的收益被地址计算的不确定性抵消,所以实现上直接把流水级数压到 1。这又是稀疏对流水线优化的一次侵蚀,和上面丢掉 cp.async 是同一类代价。
索引数组的构造:从掩码到稀疏槽位
既然内核消费的是索引数组,那索引数组是怎么被生产出来的?llama.cpp 提供了一个很干净的逆过程实现:从稠密的掩码张量反推出稀疏索引。
前面在介绍 DSA 时说过,vLLM 把”Top-K 选择”的结果做成掩码的修改——把选中位置的掩码值从 改成 0(即解除屏蔽)。llama.cpp 走的是反方向:它从一个已经成型的掩码出发,把这个掩码压缩成索引数组,让后面的稀疏内核直接吃索引。
压缩逻辑的核心是这样一个内核:
template <int ncols1, bool oob>__launch_bounds__(256, 1)static __global__ void flash_attn_mask_to_sparse_indices( const half * mask_ptr, int32_t * indices_ptr, int32_t * counts_ptr, const int ne30, const int n_queries, const int n_kv_max, const int64_t s31, const int64_t s33) { ... const half * mask = mask_ptr + sequence*s33 + q0*s31; int32_t * indices = indices_ptr + (int64_t(sequence)*gridDim.x + group)*n_kv_max;
__shared__ int warp_offsets[256/WARP_SIZE]; __shared__ int row_count; __shared__ int chunk_count;它做的事情可以概括为四步:
-
判断每个位置是否有贡献。 核心判断是一句
isfinite(__half2float(mask[q*s31 + i]))——掩码有限(不是 )就说明这个位置未被屏蔽,应当被保留。用isfinite而不是”与某个阈值比较”,是因为掩码里未屏蔽位置的值是 0、屏蔽位置是 ,二者在浮点上有明确的可判定差异,用一个isfinite就能区分,代价极低。 -
用 ballot + popcount 压缩。 每个 lane 判断 8 个位置(
values_per_lane = 8),把判断结果用__ballot_sync收集成一个 32 位的掩码,再用__popc数出其中有多少个被选中。这是 GPU 上做”压缩/流压缩”的标准手法:把逐元素判断转成位运算,再用 popcount 算出前缀和。 -
在块内做前缀和重排。 用
warp_offsets数组在共享内存里做块内偏移前缀和,算出每个元素应该写到索引数组的哪个位置,然后indices[dst] = i完成写入。注意dst < n_kv_max这个判断——索引数组的宽度是有限的(就是 的上限),超出部分直接丢弃。 -
尾部填充 -1 并记录计数。 最后:
const int count = min(row_count, n_kv_max); for (int i = count + tid; i < n_kv_max; i += blockDim.x) { indices[i] = -1; } if (tid == 0) { counts_ptr[int64_t(sequence)*gridDim.x + group] = count; }没被填满的槽位全部写 -1,同时把真实数量写进 counts_ptr。这正是前面看到的 topk_length 的来源,也是 -1 约定的另一半——生产端负责填 -1 并报数,消费端负责把 -1 折叠成行 0 并用掩码抹掉。
把生产端和消费端放在一起看,稀疏注意力在 GPU 上的完整数据流是清楚的:稠密掩码(或 Top-K 结果)→ 压缩成索引数组 + 计数 → 索引数组驱动 gather 式 KV 读取 → 掩码抹掉无效槽位的贡献。这条链路上的每一步都有实现代价,而架构设计的价值就在于让这些代价尽量小。
掩码重写:vLLM 选择的那条路
与 llama.cpp 的”掩码压缩成索引”相反,vLLM 在 DSA 路径上走的是另一条路:用 Top-K 索引去重写掩码,然后仍然调用标准的 FlashAttention 类内核,只不过这个内核知道”只需要遍历前 个槽位”。
在 DSA 的 build_attn 里,这个过程写得非常明确:
const auto & kq_mask = inp->get_kq_mask_mla();
// prepare new kq mask - starts filled with -INFINITY ggml_tensor * kq_mask_all = ggml_fill(ctx0, kq_mask, -INFINITY);
// reshape KQ mask into tensor with rows of size 1: // [n_kv, n_batch, 1, n_stream] -> [1, n_kv, n_batch, n_stream] kq_mask_all = ggml_view_4d(ctx0, kq_mask_all, 1, kq_mask_all->ne[0], kq_mask_all->ne[1], kq_mask_all->ne[3], ...);
// reshape top_k indices: [n_top_k, n_batch, 1, n_stream] -> [n_top_k, n_batch, n_stream, 1] ggml_tensor * top_k_3d = ggml_view_4d(ctx0, top_k, top_k->ne[0], top_k->ne[1], top_k->ne[3], 1, ...);
// prepare zero-filled tensor with rows of size 1: [1, n_top_k, n_batch, n_stream] ggml_tensor * zeros = ggml_new_tensor_4d(ctx0, GGML_TYPE_F32, 1, top_k_3d->ne[0], top_k_3d->ne[1], top_k_3d->ne[2]); zeros = ggml_fill(ctx0, zeros, 0.0f);
// modify KQ mask by unmasking elements that are in top_k indices ggml_tensor * kq_mask_top_k = ggml_set_rows(ctx0, kq_mask_all, zeros, top_k_3d);
// reshape to restore the original shape of KQ mask kq_mask_top_k = ggml_view_4d(ctx0, kq_mask_top_k, ...);
// combine with the original kq mask kq_mask_top_k = ggml_add(ctx0, kq_mask_top_k, kq_mask);
ggml_tensor * cur = build_attn_mha(q, k, v, kq_b, kq_mask_top_k, sinks, v_mla, top_k->ne[0], kq_scale, il);(这段代码来自 llama.cpp 的 llama-graph.cpp,它在 DSA 路径上采用了与 vLLM 相同的”掩码重写”思路,同样因为注释写得清楚而适合用来讲解。llama.cpp 侧的计算图与注意力算子的组织方式,站内 llama.cpp 源码完全拆解(二):ggml 计算图与内存分配器——惰性张量、生命周期复用与跨后端切图 有完整讲解。)
这套操作的语义可以这样读:
- 先造一个全 的掩码
kq_mask_all——把它理解成”所有位置都被屏蔽”的初始状态。 - 造一个全 0 的
zeros张量,形状是[1, n_top_k, n_batch, n_stream]——每个被选中的槽位对应一个 0。 - 用
ggml_set_rows把zeros的值按 Top-K 索引散射写回到kq_mask_all里。写进去之后,被 Top-K 选中的位置掩码值从 变成了 0,也就是”解除屏蔽”。 - 再把原始的
kq_mask加上去——原始掩码里本身就带因果性和序列边界的约束,两者相加之后,一个位置要真正被看到,必须既被 Top-K 选中,又满足原始的因果/边界条件。
相加这一步是不能省的。Top-K 选出的 2048 个位置是”分数上贡献最大的”,但索引器打分的范围是全序列,它可能选出一些本来就不该被看到的槽位(例如其他序列的槽位、或未来位置)。原始的 kq_mask 承载了这些约束,必须叠加回去。
为什么 vLLM 选这条”重写掩码”的路而不是”压缩成索引数组”的路? 因为稀疏注意力内核通常已经具备”按照掩码跳过整块”的能力(站内 BLASST:一个标量阈值实现的动态块稀疏注意力(MLSys 2026) 与 vLLM 源码完全拆解(七):PagedAttention Kernel 如何遍历分页 KV 并完成稳定 Softmax 都讲过块级跳过)。如果内核本身就能根据掩码跳过贡献为零的块,那么把索引写成掩码的形式,不需要为稀疏单独写一个内核,复用现有的 FlashAttention 实现即可。
代价是掩码张量本身仍然是 大小——也就是平方级。所以”掩码重写”这条路并没有把显存占用降到稀疏的级别,它省掉的是计算和KV 读取,省不掉掩码本身。而 llama.cpp 那条”索引数组”的路,索引数组是 ,连掩码的平方级占用也一并省掉了。
这解释了 n_kv_max 这个参数的存在。在 llama.cpp 的稀疏路径里,它把 top_k->ne[0](即 )传给注意力算子:
ggml_tensor * cur = build_attn_mha(q, k, v, kq_b, kq_mask_top_k, sinks, v_mla, top_k->ne[0], kq_scale, il);算子拿到这个数之后就知道”最多只有前 个槽位需要真正读取”,于是内核的 gather 循环只需要跑 次而不是 次。而 CUDA 侧的稀疏分流逻辑正是拿它当判据:
const int32_t n_kv_max = ggml_get_op_params_i32(dst, 4);
// the dense kernel handles up to 64/ncols2 queries per K/V pass, the single-query gather has to beat that const int64_t n_gather = (ncols1 == 1 ? std::min<int64_t>(Q->ne[1], 64/ncols2) : ncols1) * (int64_t) n_kv_max;
return GGML_CUDA_CC_IS_NVIDIA(cc) && turing_mma_available(cc) && mask != nullptr && n_kv_max > 0 && max_bias == 0.0f && logit_softcap == 0.0f && mask->ne[0] == K->ne[1] && mask->ne[1] >= Q->ne[1] && mask->ne[2] == 1 && K->ne[1] >= std::max<int64_t>(4096, 2*n_gather);这段判据很值得读第二遍。它说的是:只有当 KV 总长度至少是”需要 gather 的元素数”的两倍(并且不低于 4096)时,才值得切换到稀疏路径。
这是一个非常务实的工程判据。它承认了 sparse 路径有固定的额外开销(查表、失去异步拷贝、失去多级流水),因此只有在”扫过整个 KV 的成本”显著大于”gather 一小部分”的成本时,切换才划算。2*n_gather 这个两倍的系数就是这条经验分界线——稀疏不是无条件的优化,它对上下文长度有门槛。
索引器缓存:为什么不能和注意力共用一块 KV
前面提到索引器有自己独立的 KV 缓存。这个”独立”是必须的,原因有三层。
第一层:存的东西不一样。 索引器缓存存的是 ——由 经索引器 key 投影得到的 维向量,单头。注意力缓存存的是 MLA 的潜向量 加上解耦的 RoPE 分量 。两者的维度、投影矩阵、甚至精度都不一样(索引器走 FP8,主注意力走 bf16 或 FP8 的另一套 scale 口径)。合在一起没有意义。
第二层:生命周期不一样。 索引器缓存必须覆盖全部历史位置,因为索引器的打分范围是全序列——这是它的职责所在。而注意力侧的 KV 缓存可能带滑窗优化、可能被压缩、可能有不同的分块策略。在 vLLM 的实现里,索引器后端甚至有自己的 get_supported_kernel_block_sizes,与主注意力后端分开配置。如果强行合并,任何一方的存储策略变化都会牵动另一方。
第三层:读写时机不一样。 索引器 key 需要在打分之前就位,注意力的 KV 需要在打分之后按选出的位置被读取。两者在一次前向里的时序位置不同,混在一个池子里会让分配与回收的记账变得复杂。
vLLM 用了一套专门的代码路径来管理这件事。索引器后端 DeepseekV32IndexerBackend 是一个独立的 AttentionBackend,注册在注意力后端的体系里,有自己的一套元数据构造器 DeepseekV32IndexerMetadataBuilder。它甚至有自己的 CUDA Graph 支持策略判断:
class DeepseekV32IndexerMetadataBuilder(AttentionMetadataBuilder): # The indexer opts out of the shared reorder-threshold vote (see __init__), # so this is None; its own split uses self.decode_threshold. reorder_batch_threshold: int | None = None requires_block_table_width = True
@classmethod def get_cudagraph_support( cls, vllm_config: VllmConfig, kv_cache_spec: KVCacheSpec, ) -> AttentionCGSupport: if _supports_varlen_paged_mqa_logits() or _use_flattening(vllm_config): return AttentionCGSupport.ALWAYS(这段代码在 vLLM 的 indexer.py 里。vLLM 的 CUDA Graph 机制本身,站内 vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph——消灭 kernel 调度开销的两层机制 有系统讲解。)
这里有两处细节值得注意。一是”选择退出共享的 reorder-threshold 投票”——reorder_batch_threshold 被显式设为 None,注释说明索引器自己用 decode_threshold 来做预填充与解码的切分。为什么?因为索引器后端对”一行多长才算解码”的判断口径和主注意力不同:索引器的打分粒度、它对变长行的处理方式都不一样,强行共用同一个阈值会导致切分不合理。二是 CUDA Graph 支持策略是条件性的——只有当平台支持变长分页 MQA logits、或者启用了 flattening 时才返回 ALWAYS。这反映了一个现实:索引器内核的形状对 CUDA Graph 的静态形状要求比较敏感,能不能整图捕获取决于底层算子是否支持变长输入。
在 Blackwell 平台上,vLLM 还走了一条额外的路径。当满足条件时,它会用 CuteDSL 实现的 pack 内核与稳定 Top-K 选择器:
def _assert_cutedsl_dcp_merge_supported(logits, topk_indices, topk_tokens): # The DCP merge only supports the CuteDSL path (Triton pack kernel + CuteDSL # stable-topk selector); there is no PyTorch fallback. The first cut targets # Blackwell/Hopper with index_topk in (512, 1024, 2048) (the selector's radix # sizing); the Triton pack itself has no shape/topk constraints. ... if topk_tokens not in (512, 1024, 2048): raise ...(这段来自 sparse_attn_indexer.py。)注释把约束讲得很清楚:CuteDSL 的 Top-K 选择器用基数排序(radix)实现,它的排序桶划分是按 的大小预先定死的,所以只支持 512 / 1024 / 2048 三档 ;而 Triton 那个 pack 内核本身没有形状约束。这是一个很典型的”为了性能而收窄可配置空间”的工程取舍——用限制 的取值,换取一个更快的 Top-K 实现。DeepSeek-V3.2 用的正是 2048,恰好落在支持档位里。
这段代码里还有一个概念值得单独点一下:DCP。注释提到”这个合并只在 CuteDSL 路径下支持,没有 PyTorch 回退”,说明索引器在解码上下文并行(Decode Context Parallelism)场景下,每个 rank 只持有 1/N 的 KV 缓存,因此每个 rank 算出的 Top-K 是”我自己这 1/N KV 里的 Top-K”。要得到全局正确的 Top-K,必须把各 rank 的候选合并起来——合并的方式是每个 rank 打包自己的 候选,all-gather 之后再做一次全局稳定 Top-K。_merge_dcp_topk_global 做的就是这件事。
这暴露了一个容易被忽略的事实:稀疏注意力在分布式部署下需要额外的通信。稠密注意力下,每个 rank 各自算自己的那一份注意力分数,不存在”必须先知道全局哪几个位置最重要”这个跨 rank 的依赖。而稀疏注意力必须先做一次全局 Top-K,这就引入了 all-gather。长上下文场景下,稀疏本身省下的通信/带宽和这次额外通信要放在一起算总账。
稀疏到底省掉了什么
到这里,可以回过头把”省了什么、没省什么”列清楚了。
省掉的:
- 主注意力的算分计算量。 从 降到 。在 、 远大于 时,这是数量级的差异。
- 主注意力的 KV 读取量。 每次 decode 不再需要把全部历史 key/value 从显存读进来,只需要读 个潜向量。
- 主注意力的 value 加权求和量。 同理,从 个降到 个。
没省掉的(或者说省得有限的):
- 索引器自身的 打分。 论文明确承认这一点。索引器仍然是每对 (query, 位置) 都要算 次 维点积。它省的是常数系数——通过缩小 和 、去掉 softmax、把激活换成 ReLU、跑在 FP8 上——但复杂度阶数没有变。
- 索引器 key 缓存的显存。 它必须对全部历史位置可见, 字节(加 scale)每 token。128K 上下文下这是几百 MB 量级的固定开销。
- “逻辑位置 → 物理槽位”的翻译开销。 这是一次随 规模增长的索引运算,虽然比读 KV 便宜,但不是零。
- 掩码的开销(如果走掩码重写这条路)。 掩码张量本身仍是平方级大小。
- gather 访存带来的效率损失。 失去异步拷贝、失去多级流水、失去部分向量化。
- 分布式下的全局 Top-K 通信。
第 1 条和第 2 条是理解 DSA 收益边界的关键。DSA 并没有消灭长上下文的平方项,它把平方项从”昂贵的完整注意力”转移到了”廉价的索引器”。 所以 DSA 的收益能不能兑现,本质上取决于索引器的常数系数相对于主注意力的常数系数小多少倍。论文给出的数字是索引器”只需要远少于 MLA 的计算量”,而 vLLM 的实现里能看到这个”少”是怎么被做出来的:更小的头数、更小的 head dim、FP8 量化、以及一个把 RoPE 和量化融成一步的专用内核。
代价的工程账本
把上面这些代价按工程维度重新组织一遍,就得到一份”DSA 落地时你需要关心的清单”。
工作区显存。 索引器的预填充需要一个大小正比于 max_model_len 的工作区。前面那段 get_max_prefill_buffer_size 的代码给出的量级是:128K 上下文下约 825 MB。这个数字不是凭空来的,而是为了让索引器工作区恰好塞进 flashmla_sparse 自身工作区( 字节每 token)的预算里。部署时要预留的第一笔预算就是它。
索引器缓存的容量。 每 token 132 字节( 的 FP8 数据加 4 字节 scale),且必须覆盖全序列。这是第二笔预算,且它不可被滑窗或驱逐策略缩减——减了会直接破坏索引器的正确性。
的可选范围。 在 Blackwell 上走 CuteDSL 路径时, 被限制在 512/1024/2048。想用别的 就只能走 Triton 路径。DeepSeek-V3.2 选了 2048,正好在支持范围内,这个巧合背后显然是协同设计的结果。
上下文长度门槛。 稀疏路径的判据是 K->ne[1] >= max(4096, 2*n_gather)。短上下文下切换到稀疏路径是负优化,所以实现里必须有稠密路径兜底(论文也提到,短序列预填充时他们”专门实现了一个 masked MHA 模式来模拟 DSA”,以获得更高的短上下文效率)。
平台差异。 变长分页 MQA logits 需要 SM100 级别的能力;flattening 路径需要 SM90;ROCm 上只对特定架构开放。同一个索引器,在不同平台上的可用路径和 CUDA Graph 支持等级都不同。
分布式下的 Top-K 合并。 用 DCP 时,每个 rank 的局部 Top-K 必须 all-gather 后做全局稳定 Top-K,且只支持 CuteDSL 路径(无回退)。
精度口径的对齐。 索引器的 query 在旋转后刻意降到 bf16 再升回 fp32,是为了让索引器的数值精度与主通路的精度口径一致。改动这个精度锚点会改变索引器分数分布,进而可能改变 Top-K 的选择结果。
从 DSA 到 vLLM:一次完整的调用链
把前面的所有片段串起来,DSA 在 vLLM 里一次调用的完整链路是这样的:
准备阶段。 元数据构造器 DeepseekV32IndexerMetadataBuilder 为本批次算好索引器需要的元数据:分块计划(预填充阶段会把长序列切成若干 chunk)、每行的起止位置(cu_seqlen_ks/cu_seqlen_ke)、每行的局部序列长度等。索引器自己的 KV 缓存的块表与槽位映射在这一步准备好。
打分准备。 fused_indexer_q_rope_quant 用 _fused_indexer_q_rope_quant_kernel 把 bf16 的索引器 query 一次性完成旋转、量化、scale 提取,并把 q_scale 折进索引器权重,产出 FP8 的 query 与调整后的权重。
写入索引器缓存。 当前批次新产生的 按槽位写进索引器自己的 KV 缓存。
打分。 逐 chunk 调用 DeepGEMM 的 fp8_fp4_mqa_logits,得到压缩形式的逐行 logits(每行从 cu_seqlen_ks[i] 开始)。
Top-K。 top_k_per_row_prefill 把每行的 logits 转成 个下标,写进 topk_indices_buffer。这一步可能带两级的候选块筛选(在某些架构上)。
(分布式时)跨 rank 合并。 _merge_dcp_topk_global 做候选打包 + all-gather + 全局稳定 Top-K。
地址翻译。 triton_convert_req_index_to_global_index 把逻辑位置翻译成物理槽位,同时产出每行的有效计数 topk_length。
稀疏注意力。 _bf16_flash_mla_kernel 拿着物理索引和有效计数,在摊平成行视图的 KV 缓存上做 gather 式读取与注意力计算。
这条链路上有六个以上的内核,涉及三个阶段(打分、索引、注意力),横跨三个内存结构(索引器缓存、注意力缓存、索引缓冲区)。DSA 在论文里是三个公式,在框架里是一条完整的数据管线。
顺带说一句,站内已经有一篇 NSA 原生稀疏注意力(二):Triton Kernel 设计与 27B 模型实验 讨论过稀疏注意力的 Triton 内核设计。NSA 和 DSA 的稀疏内核共享大量工程手法(分块、掩码、跳跃),但两者的稀疏来源不同:NSA 的稀疏来自训练时就固定的三分支结构,DSA 的稀疏来自推理前动态算出的索引。前者是”结构决定的稀疏”,后者是”数据决定的稀疏”,这导致 DSA 多出了整整一条”索引器 + 地址翻译”的管线,而 NSA 不需要。这个差异是理解两篇文档时最值得抓住的一点。
小结
把这篇的要点重新串一遍。
- 问题的形状。 注意力有两条独立的成本曲线:prefill 的 算分,和 decode 的 字节搬运。DSA 砍的是”绝大多数历史位置贡献接近于零”这个事实带来的浪费,把主注意力的复杂度从 降到 ,。
- 索引器的分数函数 的每一处设计都是为”便宜”服务的:去掉 softmax 让它逐位置独立、可任意分块;ReLU 换掉 exp 换吞吐; 提供逐头加权;key 侧单头让缓存最小。
- 三个关键数字: 决定索引器缓存每 token 的字节数(加 scale 共 132 B); 决定打分的计算常数,也是索引器 的来源; 决定主注意力看多少历史。
- DSA 必须挂在 MLA 的 MQA 模式上,因为稀疏需要一个”多个 query 头共享同一份数据”的寻址单元,MLA 的潜向量正是这个单元。稀疏只有落在数据搬运的粒度上才有价值。
- 索引器是被单独训练的模块,有自己的损失 ,与主模型损失分离;引入方式是在 DeepSeek-V3.1-Terminus 上做两阶段继续预训练(dense warm-up + sparse training),不重新预训练主干。
- vLLM 的实现链路:融合内核(RoPE + FP8 量化 + scale 折叠)→ DeepGEMM 压缩 logits 打分 → 逐行 Top-K → 逻辑位置到物理槽位的翻译(含有效计数)→ 稀疏注意力内核的 gather 式读取。
- 稀疏在 kernel 里的样子:把”顺序读 tile”换成”查表读”,代价是失去
cp.async、失去多级流水、掩码只能同步加载;负索引统一落到行 0、靠掩码抹掉贡献,以避免分支发散。 - 两条实现路线:llama.cpp 用”掩码压缩成索引数组”,索引数组是 ;vLLM 用”Top-K 重写掩码”,复用现有 FlashAttention 内核,省掉计算与 KV 读取但不省掩码本身的平方级占用。
- 收益的边界:DSA 没有消灭平方项,只是把它从贵的注意力转移到了便宜的索引器;它省不掉索引器缓存、地址翻译、gather 的效率损失、以及分布式下的全局 Top-K 通信;稀疏路径有上下文长度门槛(
K->ne[1] >= max(4096, 2*n_gather))。 - 部署清单:约 825 MB 的索引器预填充工作区、132 B/token 的索引器缓存、 在 CuteDSL 路径上只能取 512/1024/2048、平台能力决定哪些路径可用。
参考资料
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- DeepSeek-V3.2 论文 HTML 版(含 DSA 架构图与推理成本图)
- DeepSeek-V3.2-Exp 官方推理参考实现
- vLLM
vllm/v1/attention/backends/mla/indexer.py:索引器后端与元数据构造 - vLLM
vllm/model_executor/layers/sparse_attn_indexer.py:索引器算子与融合量化内核 - vLLM
vllm/v1/attention/backends/mla/sparse_utils.py:逻辑索引到物理槽位的转换 - vLLM
vllm/v1/attention/backends/mla/flashmla_sparse.py:FlashMLA 稀疏后端 - vLLM
vllm/model_executor/models/deepseek_v2.py:DeepSeek 模型的索引器接入 - llama.cpp
src/llama-graph.cpp:DSA 路径的掩码重写与稀疏注意力构建 - llama.cpp
ggml/src/ggml-cuda/fattn.cu:稀疏索引压缩与稀疏路径判据 - llama.cpp
ggml/src/ggml-cuda/fattn-mma-f16.cuh:稀疏路径的 KV tile gather - FlashMLA:MLA 解码的高效 kernel 实现
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 原始论文)
- Fast Transformer Decoding: One Write-Head is All You Need(MQA 原始论文)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



