


vAttention 完全拆解:用 CUDA 虚拟内存保住连续 KV Cache
为什么 KV Cache 的地址布局会决定推理系统的形态
vAttention 由 Microsoft Research India、印度科学理工学院等机构的研究者于 2024 年 5 月首次发布。它追问的不是“如何再写一个更快的分页注意力 Kernel”,而是一个更靠近操作系统的问题:既然 GPU 已经有页表和虚拟内存,推理框架为什么还要自己维护一套块表,再要求注意力 Kernel 理解这套块表?
自回归推理包含 Prefill 和 Decode 两个阶段。Prefill 并行处理输入 token,Decode 每轮只为每个请求生成一个新 token。第 个 token 的 Key、Value 会被后续所有 token 重用,因此每层都要维护随上下文增长的 KV Cache。若一个工作进程负责 层,每层有 个本地 KV 头,头维度为 ,每个元素占 字节,请求当前长度为 ,其 KV Cache 大小近似为:
系数 2 对应 K 与 V。对于固定模型,、、、 都不变,因此显存需求与 线性增长。困难在于系统接收请求时通常不知道最终的 :它可能很快遇到结束 token,也可能一直生成到上下文上限。
最直接的做法是按最大长度为每个请求预留连续显存。这样普通张量 Kernel 可以通过“基地址 + 线性偏移”访问 KV,却会产生严重的内部碎片。假设上限是 128K,而请求只走到 4K,那么绝大部分已经承诺的物理显存从未写入;更隐蔽的浪费发生在请求生命周期内,即便最终长度可以预知,增长过程中的尾部空间仍长期闲置。显存容纳的并发请求变少,连续批处理也就失去扩大 batch 的空间。
PagedAttention 的解决办法是把每个请求的 KV 拆成固定 token 数的小块,只在需要时分配物理块。它成功解决了容量浪费,却同时改变了 Kernel 看到的布局:一个请求的逻辑序列被散落在多个不连续的虚拟地址中。推理框架要维护“逻辑块号到物理块号”的 Block Table,Kernel 先查 Block Table,再由 GPU 页表把查到的虚拟地址翻译成物理地址。
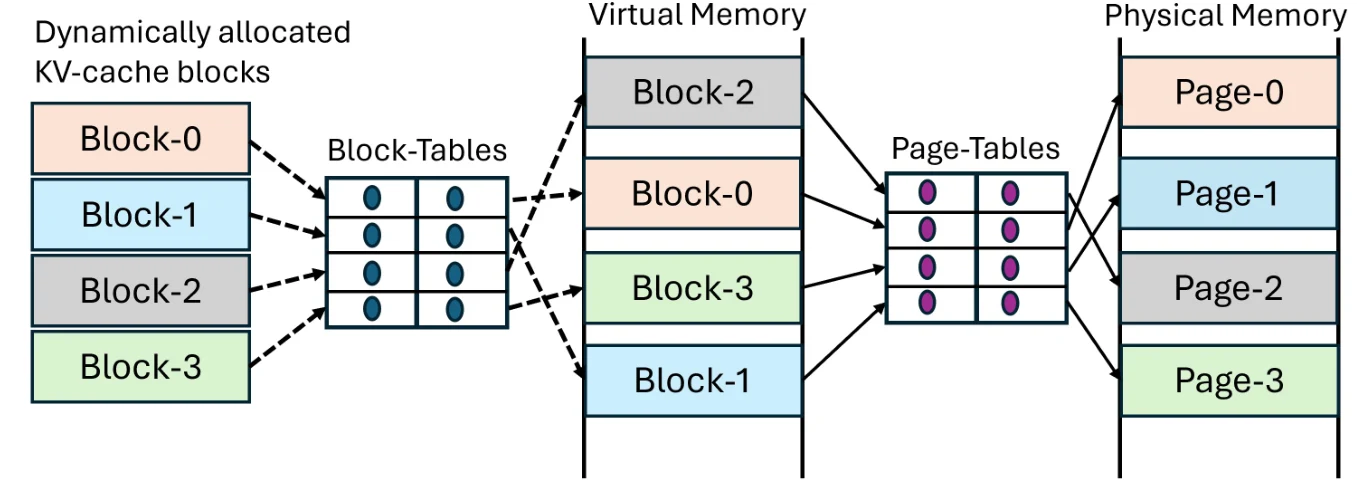
图 1 来自 vAttention 论文。左侧是框架和分页 Kernel 显式完成的第一次寻址:根据 token 所在逻辑块查 Block Table。右侧是硬件本来就要完成的第二次寻址:GPU MMU 查询页表。图中真正值得关注的不是“多查了一张表”这么简单,而是它把分页语义扩散到了整个软件栈:
- 调度器必须分配、引用、复制和回收 KV 块;
- CPU 每轮要为动态 batch 整理 Block Table 元数据;
- 注意力 Kernel 必须接受块表、块大小等额外参数,并处理跨块边界;
- 新 Kernel 即使已支持连续 KV,也不能直接获得动态内存管理能力。
这不意味着 PagedAttention 的设计错误。它以用户态软件可控的方式解决了当时最紧迫的显存碎片问题,还自然支持前缀块共享、写时复制等能力。vAttention 的贡献是指出另一种分层边界:让框架只描述“每个请求现在需要多长的连续张量”,把虚拟地址到物理页的映射交还给系统层。
vAttention 的核心抽象:虚拟连续,物理按需
vAttention 的一句话定义是:先为所有可能的 KV Cache 保留足够大的连续虚拟地址区间,但不立即为整个区间承诺物理显存;请求增长时,才把空闲物理页映射到即将访问的那一段虚拟地址。
这里必须区分三个常被混用的动作:
- 保留虚拟地址只是在进程地址空间中圈出一段号码范围,不等于消耗同等大小的 HBM。
- 创建物理内存句柄才真正从 GPU 取得物理存储,但句柄尚未必能被 Kernel 访问。
- 映射把物理内存挂到保留的虚拟地址上,并设置访问权限;此后普通 CUDA Kernel 才能用指针读写。
因此,“虚拟张量有 12 TB”与“GPU 装有 12 TB 显存”并不矛盾。论文以 Yi-34B、FP16、TP=2 为例:每个工作进程有 60 层、4 个本地 KV 头、头维 128、最大长度 200K。单层单个 K 或 V 的请求槽位上限为:
若最大 batch 为 ,一个层级 K 张量的虚拟区间为 GB。K、V 各一份且共有 60 层,总虚拟地址预留约 12 TB,但任一时刻映射的物理显存只覆盖活跃请求实际走到的页。64 位进程通常有远大于 HBM 容量的用户虚拟地址空间,这正是方案能够成立的容量差。
对普通注意力 Kernel 而言,这仍然是形如 的连续张量。请求槽位 reqId 的起始偏移可写成:
请求内部第 个 token 的 K 地址继续是固定步长的线性索引。Kernel 不知道底层哪些页何时被映射,也不需要 Block Table。只要系统保证 Kernel 启动前,其将访问的地址范围已有物理页支撑,连续张量 Kernel 就能原样运行。
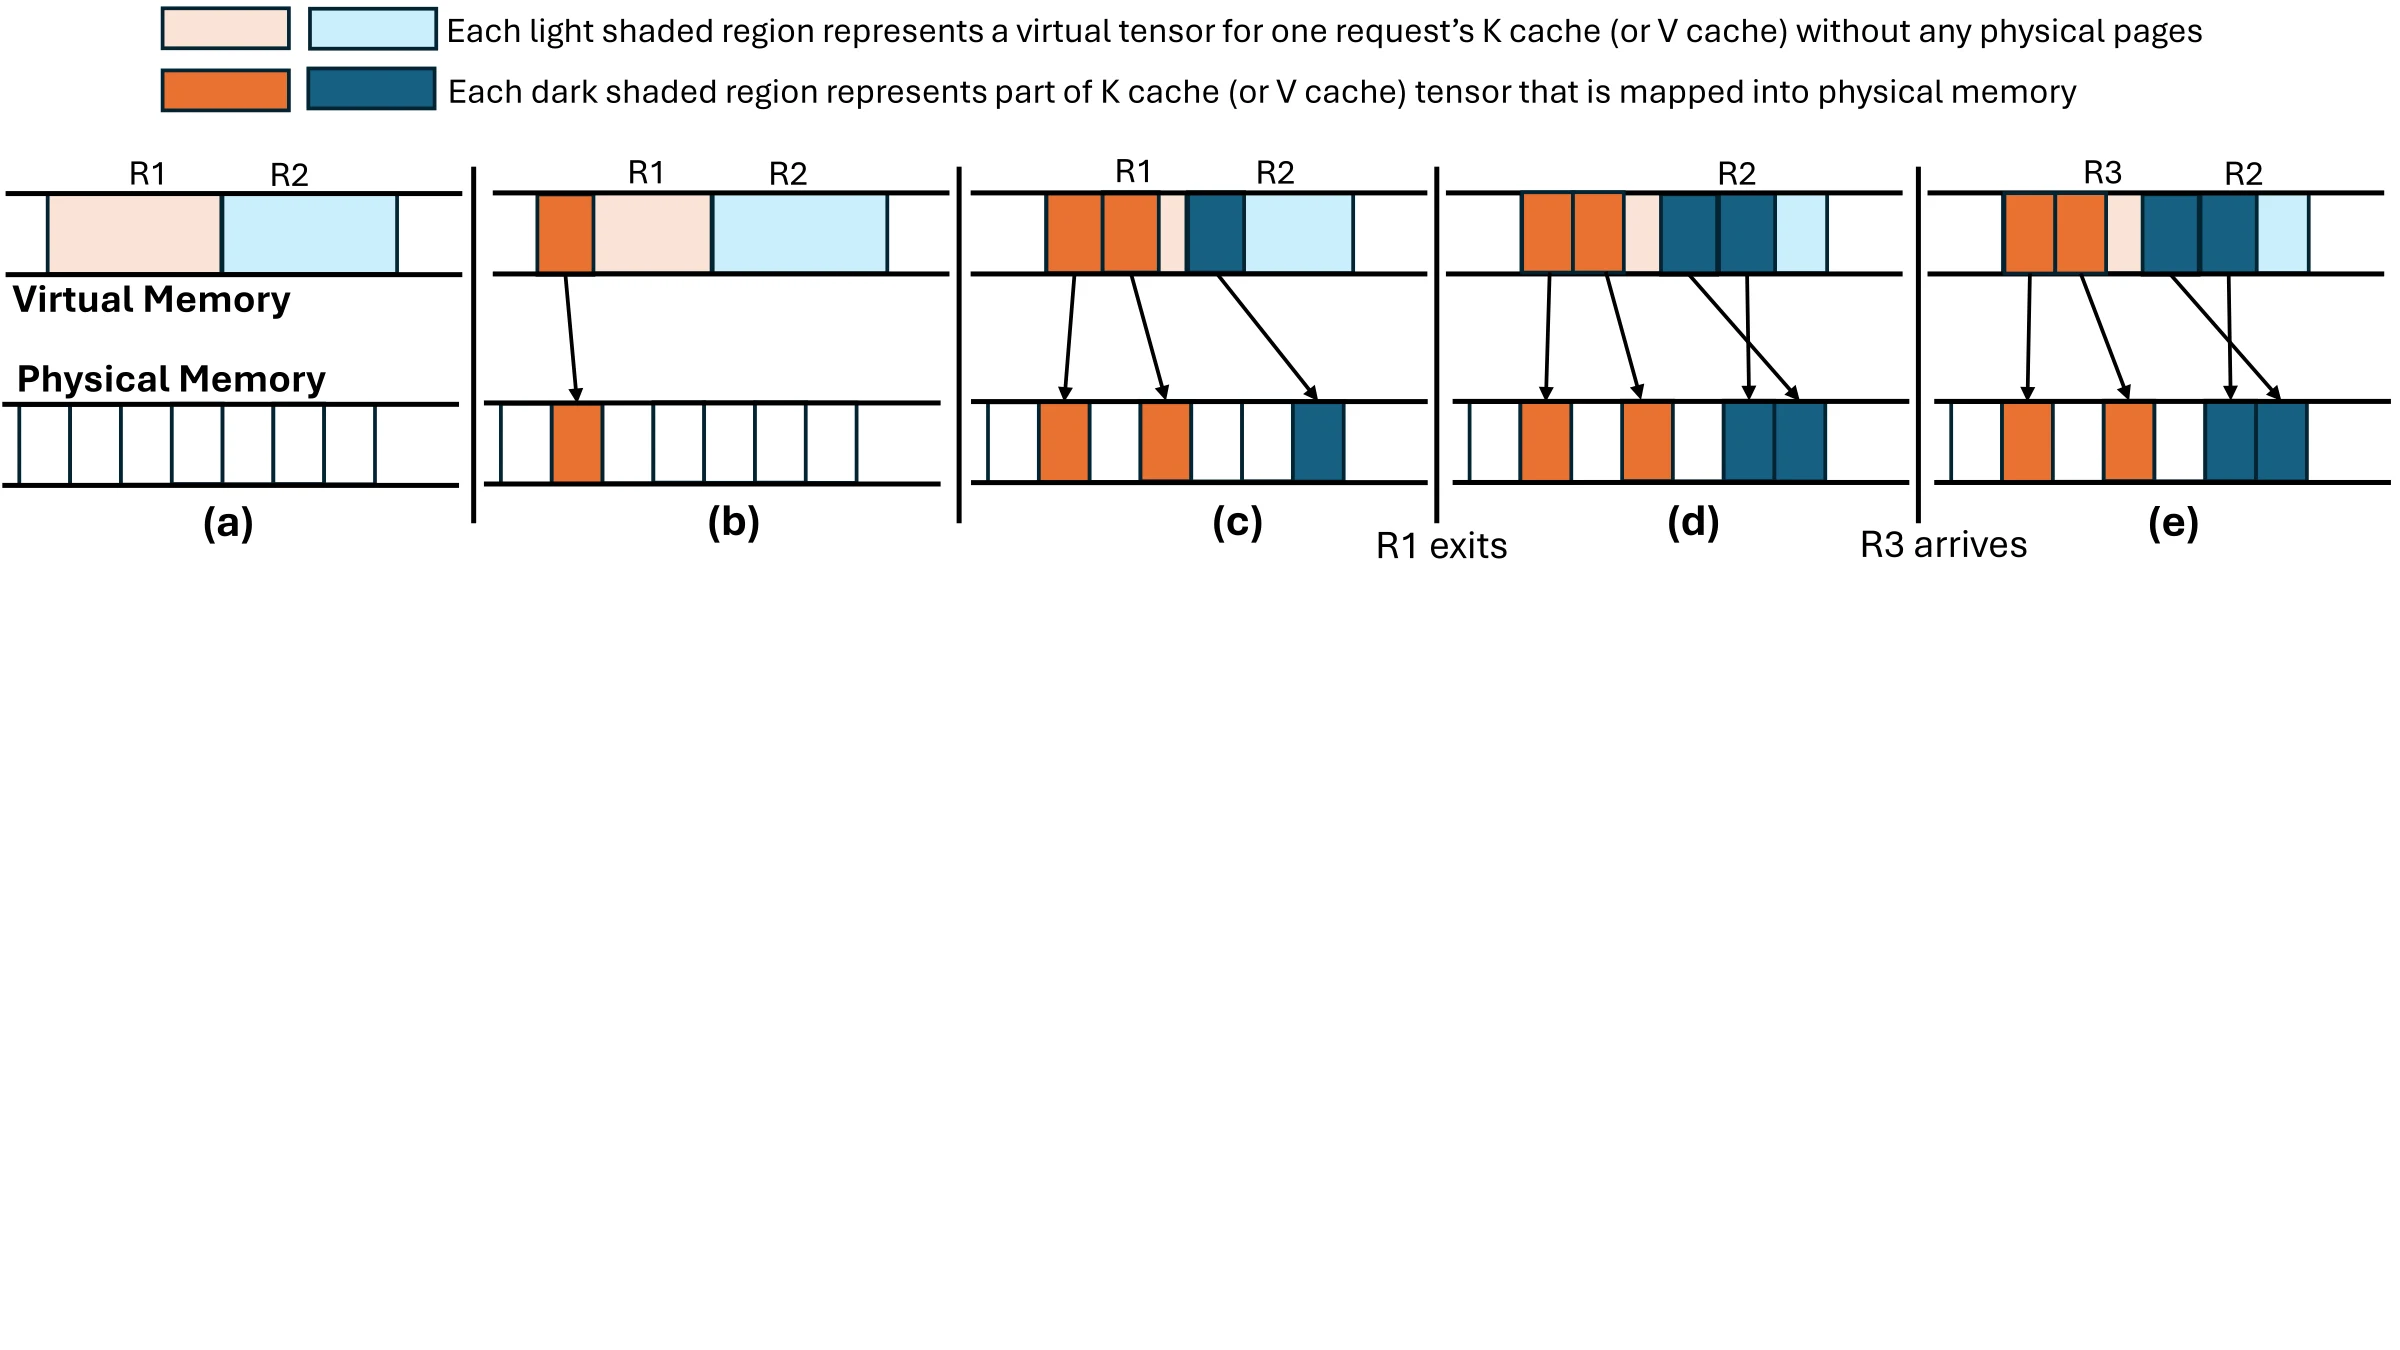
图 2 展示一个 K 张量中的两个请求槽位。阶段 (a) 只有虚拟地址,没有物理页;(b) 为 R1 映射第一页;(c) R1 扩到两页,R2 获得一页;(d) R1 结束后,页面暂不回收;(e) R3 复用 R1 的 reqId 和已经映射的页。连续性发生在虚拟地址层,按需性发生在物理地址层,两者不再互相排斥。
这也解释了 vAttention 与 Unified Memory 缺页迁移的差别。vAttention 不等待 Kernel 访问未映射地址后触发 fault,而是在已知下一轮上下文长度时主动完成映射。推理循环本来就知道本轮会写入多少 token,因此没有必要把正确性押在运行中的缺页异常和迁移策略上。
CUDA 虚拟内存如何支撑动态 KV Cache
CUDA 从 10.2 起提供底层虚拟内存管理接口。vAttention 使用的核心能力可以按以下顺序理解:
// 1. 查询物理分配的最小/推荐粒度cuMemGetAllocationGranularity(&granularity, &prop, flags);
// 2. 仅保留连续虚拟地址,不分配同等大小物理显存cuMemAddressReserve(&base, virtual_size, alignment, 0, 0);
// 3. 创建一段物理显存,得到与地址无关的 handlecuMemCreate(&handle, page_size, &prop, 0);
// 4. 把 handle 映射到 base + offsetcuMemMap(base + offset, page_size, 0, handle, 0);
// 5. 为目标 GPU 设置读写权限cuMemSetAccess(base + offset, page_size, &access, 1);cuMemAddressReserve 类似操作系统中的地址空间保留;cuMemCreate 创建物理分配句柄;cuMemMap 建立映射;cuMemSetAccess 决定哪些设备可以访问。释放时则反向执行 cuMemUnmap、cuMemRelease 和 cuMemAddressFree。NVIDIA 的 CUDA Driver API 文档 特别指出,cuMemMap 本身不会自动让地址可访问,仍需正确设置访问权限。
为什么不能直接使用 cudaMalloc
cudaMalloc 把虚拟地址分配和物理显存承诺绑在一起。应用拿到一个指针时,对应容量已经被物理内存支撑;若要增长,只能另分配更大的对象并复制,或者一开始过量分配。PyTorch 的传统 caching allocator 虽能缓存已经分配的块,减少频繁调用 cudaMalloc 的开销,但它仍把“张量容量”和“已承诺物理显存”绑定在一起。
vAttention 扩展 PyTorch allocator,使 torch.Tensor 可以先拥有形状、步长和连续虚拟地址,却只为已使用部分建立物理映射。上层算子仍接收普通 Tensor,底层 allocator 额外维护页句柄和映射状态。这种接口选择很关键:若暴露一种全新的分页张量类型,Kernel 和框架仍要适配新抽象,方案的可移植性收益就会被削弱。
2 MB 粒度为什么太粗
论文实验所用 CUDA VMM 公共接口的最小物理分配粒度为 2 MB。单看 2 MB 不大,但每次增长要在每层的 K、V 张量上分别映射。若工作进程负责 层,一次页边界增长在最坏情况下承诺的物理容量为:
是每个 K 或 V 子张量的页大小。对 60 层模型, MB 时,一个刚跨过边界、页面几乎尚未使用的请求最多带来 MB 尾部浪费;张量并行还可能让每张卡的单 token KV 变小,使一个物理页容纳更多 token,尾部浪费进一步放大。
为此,论文原型修改 NVIDIA 开源 UVM 驱动,提供 vMemCreate、vMemMap 等接口,支持 64 KB、128 KB 和 256 KB 分配,并默认推荐 256 KB。GPU 硬件页可以更小,但公共驱动接口、页表开销、映射调用次数和 TLB 行为共同决定了实际粒度,不能简单理解为“页越小越好”。
设每个工作进程中,单层单个 K 或 V 的每 token 字节数为 ,一个物理页覆盖的 token 数近似为:
减小 会减少最后一页的内部碎片,却增加映射数量。论文在 A100 上测得,细粒度接口的单次映射约为数微秒量级;当层数多、同时跨页的请求多时,累计延迟不能放在迭代关键路径上。这引出了 vAttention 最重要的系统优化:不是消灭映射成本,而是预测它并把它藏到 GPU 计算背后。
从请求到页映射:完整运行流程
vAttention 向服务框架暴露的接口很少:初始化 KV 张量、分配请求槽位、释放槽位,以及根据当前序列长度推进映射。把一次请求按时间展开,可以看到内存层与调度层的边界。
1. 引擎初始化
模型工作进程把本地层数 、最大 batch 、最大上下文 、本地 KV 头数 、头维 、元素字节数 和页大小交给 init。内存管理器为每层分别创建 K、V 虚拟张量,共 个,并建立物理页池。页池里的页已经从 GPU 取得,但尚未挂到任何请求的 KV 地址上。
把“创建物理页”和“映射物理页”拆开有两个作用:启动阶段可以批量准备容量,运行时只需从空闲池取 handle;页可以在请求槽位之间重新映射或保留复用,不必每次都走完整的分配释放路径。
2. 新请求入场
调度器第一次接纳请求时调用 alloc_reqid,取得 中的空闲整数。这个整数不是用户请求 ID,而是 KV 大张量中的槽位编号。相同 reqId 在所有层 K、V 张量中选择相同 batch 维切片,因此调度器只需保存一次映射关系。
如果 Prefill 有 个 token,内存管理器在第一轮前计算每个子张量需要覆盖的字节范围。对页大小 ,每层每个 K 或 V 子张量至少需要:
随后同样的页数需求会应用到当前工作进程负责的所有层。注意,这里的页是 CUDA 物理页,不是 PagedAttention 的 token block;注意力 Kernel 不会接触这些页号。
3. 每轮执行前调用 step
框架在发射本轮第一个模型 Kernel 前,把长度为 的序列长度数组传给 step,非活跃槽位置零。内存管理器比较“所需页数”和“已映射页数”,只补齐差值。Decode 每轮每个请求只增长一个 token,因此跨页时至多新增一组页;不跨页时不做映射。
若页池不能满足需求,step 返回失败。框架必须抢占或移出部分请求后重试,不能让 Kernel 访问未映射地址。vAttention 论文原型没有实现把 KV 换出到 CPU 的完整策略,这说明它是内存分配机制,不是完整的准入、抢占和交换调度器。
4. 请求完成与槽位复用
请求生成 EOS 或达到长度上限后,框架调用 free_reqid。直觉上可以立刻逐层解除映射并回收物理页,但这会制造密集驱动调用,也会让下一个请求从零开始映射。vAttention 默认允许槽位携带已映射页进入空闲状态;新请求接管该槽位时,可直接覆盖旧 KV 数据。只有新请求增长超过现有覆盖范围时才补页。
旧数据不会造成语义污染,因为注意力 Kernel 的有效序列长度限制了可见范围,新请求会在自己的有效位置写入 K、V。真正需要保证的是:槽位重新分配前没有在途 Kernel 仍在访问它。这要求请求完成事件、CUDA stream 顺序和 CPU 槽位状态形成正确的 happens-before 关系。
为什么异步分配不会卡住 GPU
动态映射最危险的地方是尾延迟。论文给出的一个量级例子是:Yi-34B 有 60 层,扩展一个请求需要为 K、V 各层完成 120 次映射;若每次约 9 微秒,总计接近 1 毫秒。对追求稳定 TPOT 的在线服务,周期性出现 1 毫秒以上尖峰并不能忽略。
vAttention 利用了 Decode 的确定性:第 轮开始前,系统已经知道第 轮每个存活请求最多再写一个 token。于是 step_async 可以在后台线程为下一轮准备映射,同时 GPU 执行当前轮。其时间关系是:
CPU 主线程: 检查第 i-1 轮映射 ───── 发射第 i-1 轮 Kernel ───── 检查第 i 轮后台线程: └── 为第 i 轮映射所需物理页 ──┘GPU: 执行第 i-1 轮计算前台检查仍然不能省略。如果后台线程因调度抖动、驱动拥塞或突发 Prefill 没有按时完成,主线程必须同步补齐或拒绝本轮执行。异步路径优化常态延迟,同步检查守住内存安全。
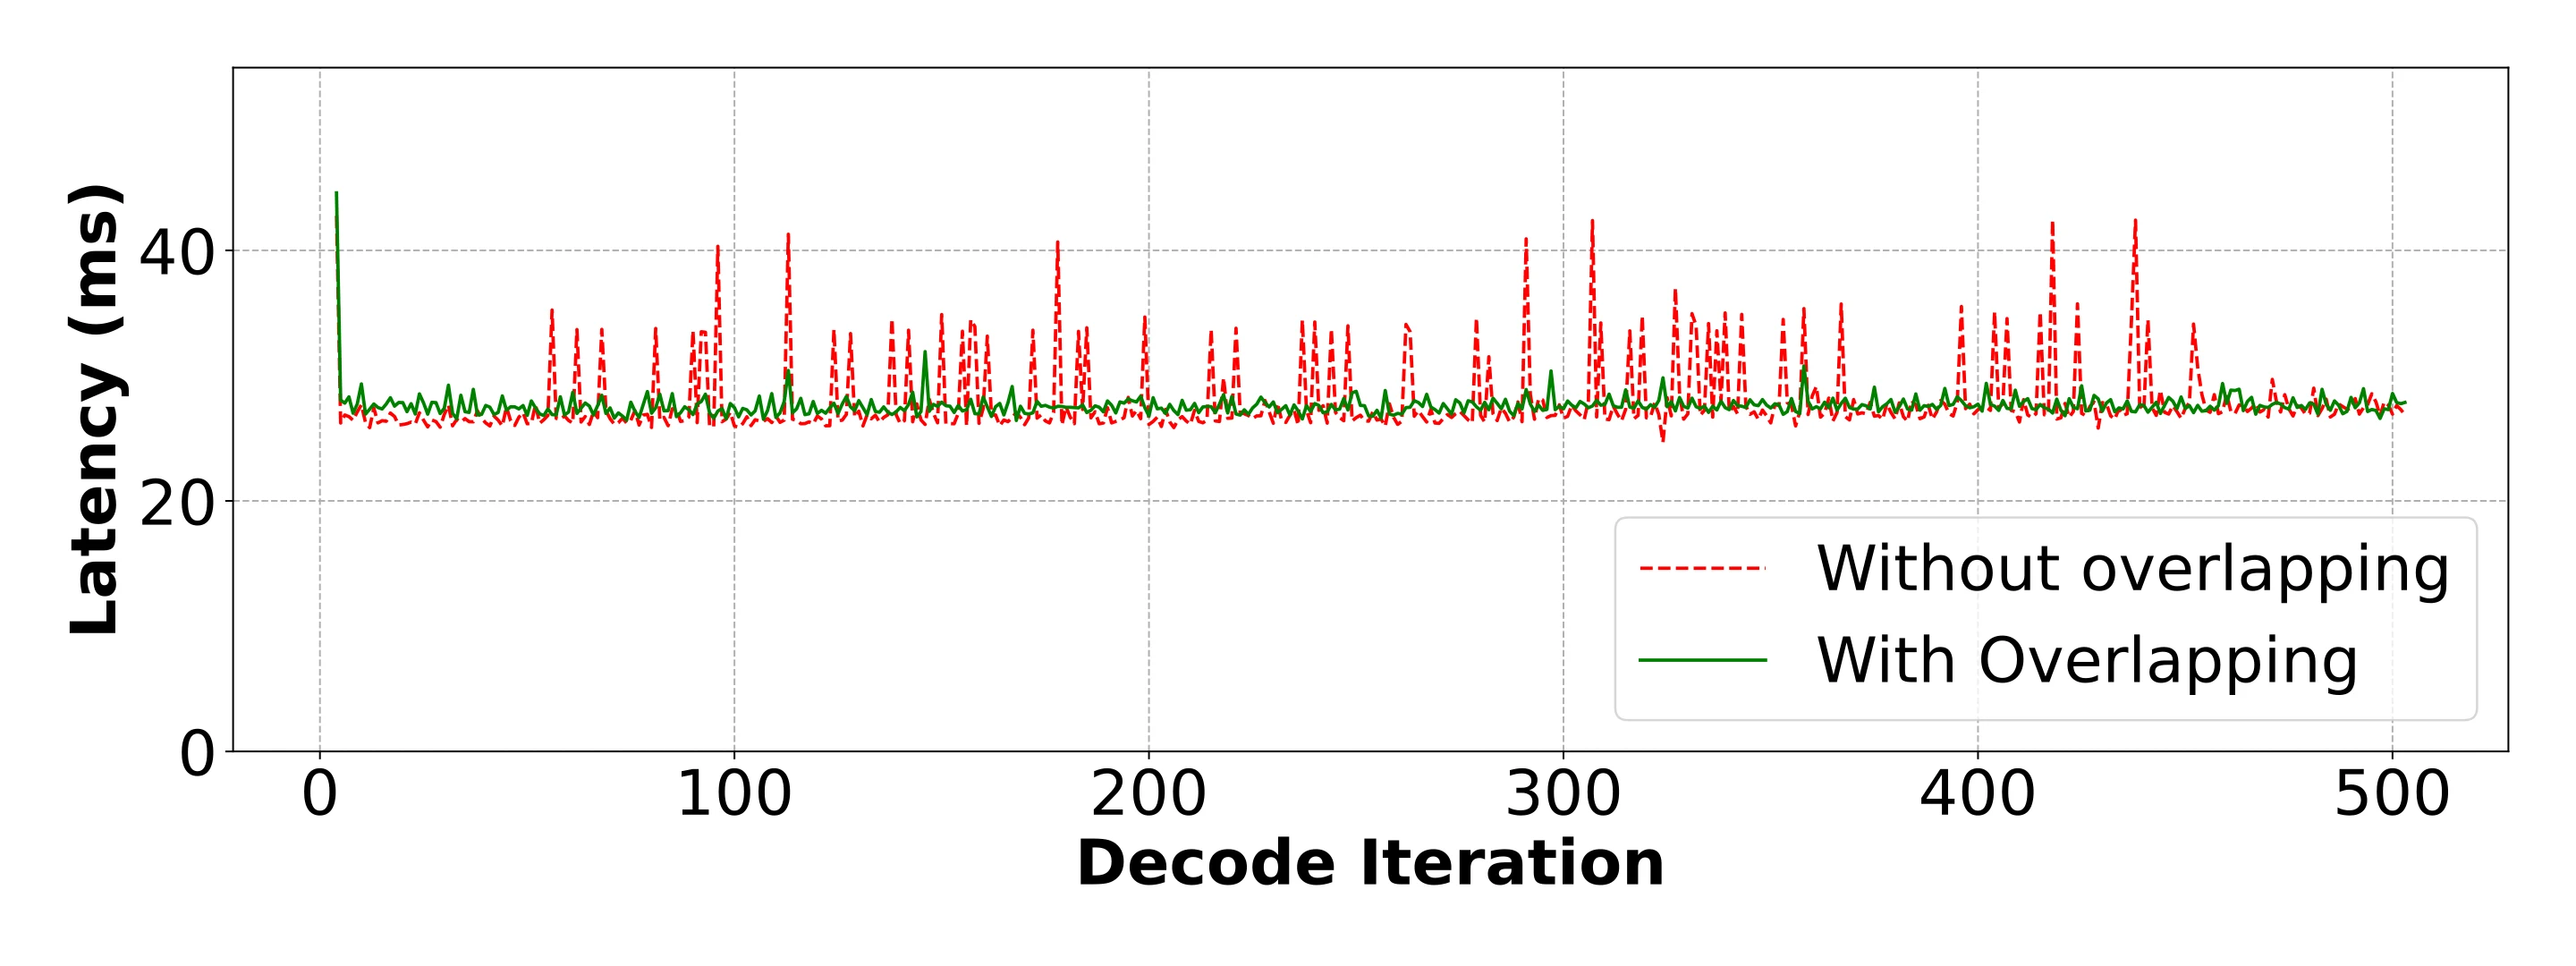
图 3 来自论文消融实验,比较同步映射和与计算重叠两种执行方式。同步方案在跨页迭代出现明显尖峰;重叠后尖峰基本被当前轮 GPU 计算覆盖。图的意义并不是映射“免费”,而是每轮模型执行通常持续数到数十毫秒,而 KV 物理分配带宽需求相对低,后台线程有足够的隐藏窗口。
除了重叠,vAttention 还使用两种互补策略:
- 延迟回收:完成请求的页暂时留在槽位上,让后继请求直接复用,减少 unmap/map 往返。
- 提前分配:为空闲槽位预先映射一部分页,使突发新请求的 Prefill 不必在关键路径上从零准备。
两者本质上都是缓存。延迟回收提高命中率,但会暂时占用本可给其他槽位的物理页;提前分配降低入场延迟,但预测错误会形成闲置容量。因此系统设定低水位阈值:当空闲物理页不足,例如下降到 GPU 容量的一定比例时,后台线程才真正回收缓存页。这个策略把频繁的精确释放改成带迟滞的批量资源管理,类似 allocator 的缓存层。
连续 Kernel、分页 Kernel 与系统代价
把两种方案放在同一张表里,差异不在“是否分页”,而在分页机制由谁看见。
| 维度 | PagedAttention | vAttention |
|---|---|---|
| Kernel 看到的 KV | 多个不连续 token block | 一个连续虚拟张量切片 |
| 物理内存增长 | 框架分配 KV block | 系统层把物理页映射到保留地址 |
| 地址元数据 | 框架 Block Table + GPU 页表 | GPU 页表 |
| Kernel 要求 | 显式解析块表、处理块边界 | 可复用连续 KV Kernel |
| CPU 工作 | 分配块、准备块表、回收引用 | 预测页需求、映射与回收页 |
| 粒度约束 | 由 token block 大小决定 | 由 VMM 物理页和 page-group 决定 |
| 前缀共享 | 块引用与写时复制较自然 | 需要额外设计共享映射和写时复制 |
| 驱动依赖 | 使用常规 CUDA 分配即可 | 细粒度方案依赖 VMM/修改驱动 |
PagedAttention 常被描述为“像操作系统一样分页”,但从地址路径看,它更像在 CUDA 用户态实现一层面向 token block 的分段映射。这个抽象能表达前缀共享、非连续扩展和独立回收;代价是计算 Kernel 必须参与解释。
vAttention 则让 GPU MMU 处理最终的页翻译。Kernel 对 的线性索引不变,硬件页表把该虚拟地址导向任意物理页。这样可以直接使用 FlashAttention 或其他只接受连续 KV 的实现,新 Kernel 的 IO 分块、warp 调度和流水线优化不必再复制一份分页版本。
连续虚拟地址不等于连续物理地址
一个常见误解是“连续 Kernel 一定要求连续物理显存”。CUDA Kernel 使用的是虚拟地址;只要虚拟页相邻,它看到的指针区间就是连续的,物理页帧可以散落。页表正是用来隐藏这种不连续性。vAttention 所谓的 contiguous 指虚拟地址连续,而不是要求 HBM 上的物理页相邻。
少一次软件寻址为何可能更快
分页 Kernel 对每个 tile 或 token block 需要计算块号、读取块表、求块内偏移,再发起 KV 访问。优化良好的实现会缓存页索引、压缩元数据并合并加载,但这些工作仍会增加指令、寄存器占用和分支。论文报告的微基准显示,分页版本可能执行更多指令,并因缓存页索引提高寄存器压力;具体差距强烈依赖 Kernel 版本、块大小、上下文长度和 GPU 架构,不能把某个百分比当成固定税率。
CPU 侧也有类似权衡。Block Table 通常按 batch 组装为二维张量,不同长度请求会带来填充与拷贝;细块减小内部碎片,却扩大表和管理次数。vAttention 没有 Block Table,但必须调用驱动映射页。前者的开销随 block 数和 batch 形态增长,后者的开销随跨页事件、层数和页大小增长。两种成本模型不同,因此不存在脱离工作负载的绝对赢家。
vAttention 并没有消灭页表
图 1 中第二级 GPU 页表仍然存在,TLB miss 也仍可能发生。vAttention 消除的是 Kernel 可见的用户态块表,不是硬件地址翻译本身。使用更小物理页会扩大页表工作集、增加 TLB 压力;使用更大页会加重最后一页浪费。论文在所测注意力 Kernel 上发现 64 KB 与 2 MB 页的运行时间接近,作者将其归因于注意力访问模式规则且 Kernel 已针对连续访问优化。这是实验结论,不应外推为“小页永远没有 TLB 代价”。
性能边界、适用条件与工程陷阱
论文在 Yi-6B、Llama-3-8B、Yi-34B 与 A100/H100 环境中分别测量 Prefill、Decode、在线和离线服务。理解结果时要先分清三种收益来源:
- 内存容量收益:按需承诺物理页,避免按最大长度预留。
- Kernel 收益:连续 KV 可以直接使用较快的非分页 Kernel。
- CPU 收益:不再逐轮构造和搬运 Block Table。
第一项是 vAttention 与 PagedAttention 都追求的;后两项才是二者的主要差异。论文早期版本在长上下文微基准中报告,相比当时 vLLM 的 Decode Kernel,vAttention 最高达到 1.97 倍吞吐;但它与优化后的 FlashAttention 分页实现大致相当。这个对照说明:最高数字主要揭示特定基线 Kernel 的差距,不能归结为虚拟内存映射本身让算术更快。
在 Prefill 中,长上下文注意力的计算占比很高,连续版 FlashAttention/FlashInfer 避免分页路径,收益更明显。论文所测版本中,连续 FlashAttention 的 vAttention 配置相对分页版本在部分长上下文场景有显著优势;FlashInfer 的专用分页 Prefill 已经更强,差距较小。Prefill 结果也受 chunk 大小、GQA 头数和具体库版本影响。
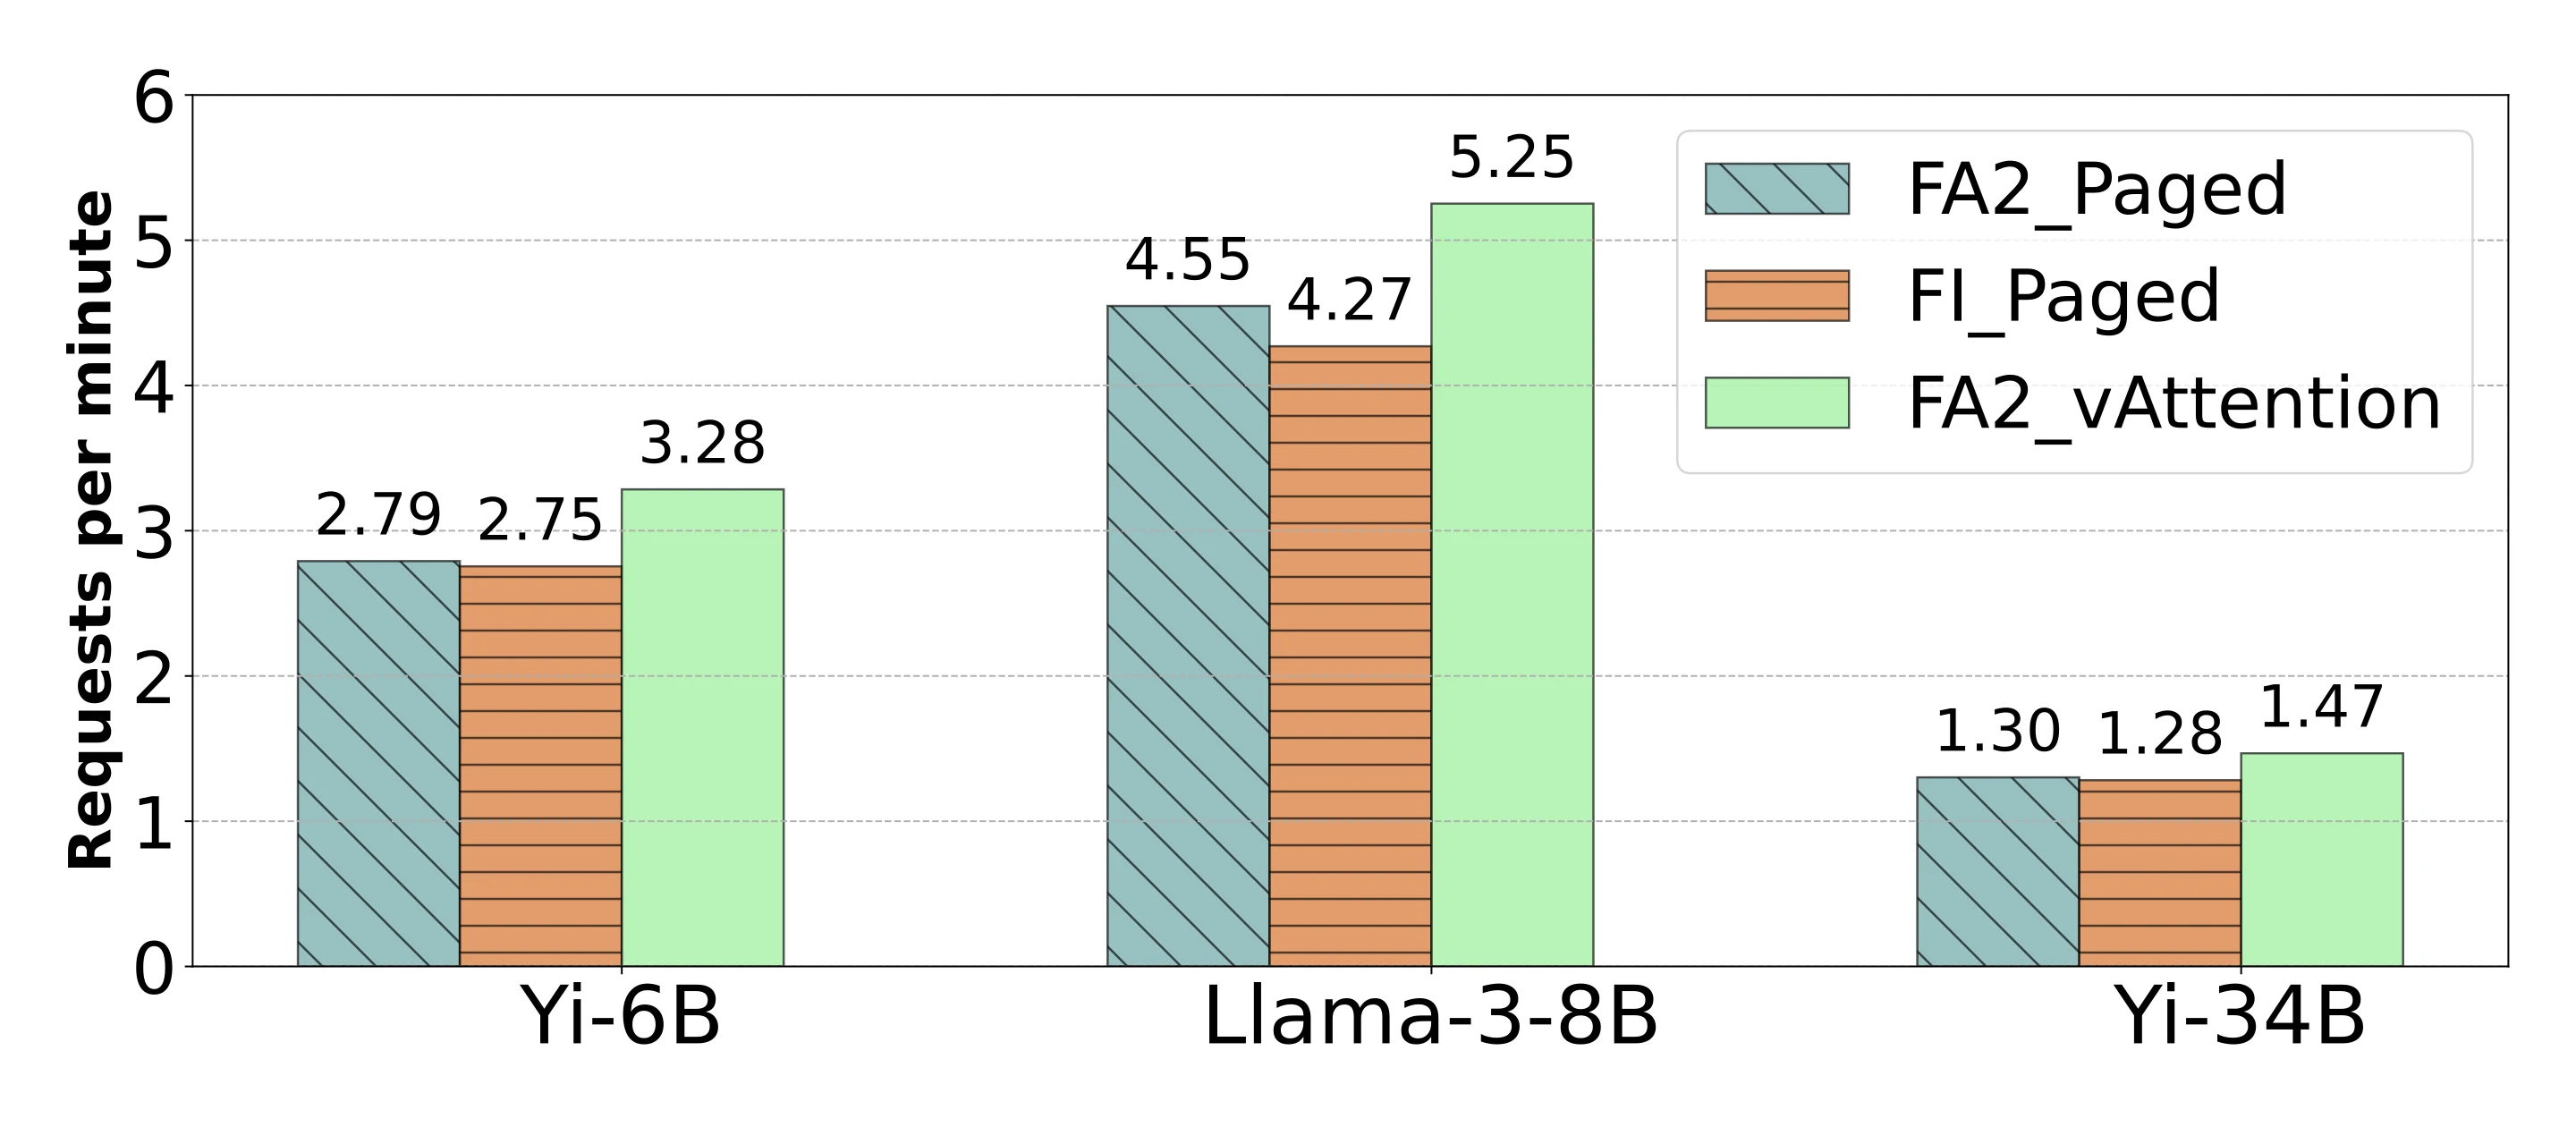
图 4 来自论文较新修订版的离线 arXiv Summarization 轨迹实验。该轨迹的输入上下文很长,Prefill/Decode token 比较高,因而连续 Prefill Kernel 的优势会被放大。论文在三种模型上报告,FA2_vAttention 相对 FA2_Paged 的端到端吞吐提升约 1.13 至 1.18 倍,相对当时 FI_Paged 配置约 1.14 至 1.23 倍。图表用于说明趋势,部署决策仍需用当前框架、当前 Kernel 与真实流量重新测量。
页大小是容量与控制面的共同参数
页大小 同时控制四件事:
- 最后一页最多浪费多少物理显存;
- 一个请求多久跨一次页边界;
- 每秒要执行多少映射操作;
- 页表和 TLB 的工作集大小。
小页适合吞吐优先、batch 很大、请求长度离散度高的场景;大页减少映射次数,适合并发受延迟约束、容量并未压满的场景。论文较新修订版显示,在一组 OpenChat 动态轨迹上,64 KB 页相对 2 MB 页可容纳更高峰值 batch;代价是更依赖细粒度驱动扩展和后台映射能力。
修改 UVM 驱动是最现实的门槛
官方仓库包含修改后的 NVIDIA UVM 驱动,并注明其复现实验环境使用 Linux、A100、PyTorch 2.3.0 与 CUDA 12.1。使用公共 CUDA VMM 接口可以保留核心思想,但按论文环境只能使用较粗的 2 MB 分配粒度;要获得 64 至 256 KB 页,需要安装定制内核驱动。生产环境通常对驱动版本、签名、容器隔离、节点升级和故障支持有严格要求,这会显著提高运维成本。
因此,“Kernel 零改动”不等于“系统零改动”。vAttention 把复杂度从注意力 Kernel 和 Block Table 管理移动到了 allocator、驱动与后台线程。这个移动是否划算,取决于组织更愿意维护哪一层。
地址空间与固定槽位也有边界
vAttention 按 为每层预留虚拟区间。虚拟地址便宜却不是无限,超大最大 batch、百万上下文、多模型共进程和大量流水线 stage 会放大保留规模。工程上需要检查 GPU 与进程实际可用 VA 位宽,而不能只根据主机是 64 位就假设所有配置都成立。
固定 reqId 槽位简化了线性寻址,也让单请求的最大长度边界在初始化时确定。若服务要动态改变最大上下文、跨实例迁移请求或把一个序列的 KV 拼接到另一个地址布局,连续槽位会比块链更难组合。
前缀缓存不是自动获得的能力
PagedAttention 的物理块可被多个请求的逻辑块表引用,天然适合共享只读前缀。vAttention 理论上也能把同一物理页映射到多个虚拟地址,但要处理页对齐、引用计数、部分页、写时复制、权限和回收顺序。论文的核心原型聚焦动态容量管理,没有证明一套与成熟前缀缓存等价的共享机制。
若业务大量依赖 RadixAttention 式跨请求前缀复用,评估不能只比较单请求连续 Kernel 的速度,还要把共享率、复制量和缓存淘汰纳入容量账本。
抢占、换出与故障恢复仍属于服务框架
当 step 无法取得物理页,vAttention 只报告失败;选择抢占谁、是否把 KV 换到 CPU、如何恢复请求,仍由上层决定。延迟回收也必须有可靠的低水位和反压机制,否则缓存页会与活跃请求争夺容量。多 GPU 下,各 worker 还要对同一批请求保持槽位和长度一致,任一 worker 映射失败都应阻止整轮执行。
安全上,复用槽位可以不立刻清零旧 KV,因为新请求只能读取有效长度且相应位置会被覆盖。但只要 Kernel 存在长度越界、元数据竞争或错误的 speculative path,旧数据就可能被访问。多租户部署应把零化策略、地址权限和边界检查当成隔离问题,而不是仅凭算法语义省略。
如何把 vAttention 接入推理引擎
官方实现选择 Sarathi-Serve 作为宿主,但接入逻辑可以抽象为四个边界。已有文章 Sarathi-Serve 完全拆解 解释了分块 Prefill 与无停顿批处理;vAttention 在这里扮演的是 KV 内存后端,不改变调度器的 token 预算目标。
边界一:模型加载后创建稳定 Tensor
内存后端根据模型并行配置计算本地 KV 形状。张量指针在服务生命周期内保持稳定,这一点对 CUDA Graph 和已编译 Kernel 很友好:动态变化的是页表映射,不是 Tensor 基地址。不过捕获和重放期间能否安全并发修改相关映射,需要按 CUDA 版本和执行同步语义验证,不能默认所有 VMM 操作都与图执行自由并发。
kv_tensors = vattention.init_kvcache( num_layers=local_num_layers, num_heads=local_num_kv_heads, head_size=head_dim, max_batch_size=max_running_requests, max_model_seq_len=max_context_len, dtype=dtype, page_size=page_size,)vattention.reserve_physical_pages(kv_budget_bytes)边界二:调度器维护 request 到 reqId 的映射
请求进入 running 集合时取得槽位,退出后释放。调度器不能在旧批次仍有在途 Kernel 时立即复用槽位。若使用 overlap scheduler,还要区分“CPU 已认为完成”和“GPU 已消费完最后一轮”两个时刻。
req_id = vattention.alloc_new_batch_idx()request_to_slot[request.id] = req_id
# 完成事件确认后vattention.free_batch_idx(req_id)del request_to_slot[request.id]边界三:每次前向前声明将访问的长度
长度数组必须表达本轮 Kernel 的真实写入上界,而不只是上轮已经完成的长度。Prefill 分块、投机解码多 token 验证、多模态 placeholder 展开都会让“本轮新增一个 token”的假设失效。正确做法是由调度结果计算目标长度,再让内存层保证覆盖。
target_lengths = [0] * max_running_requestsfor req in scheduled_requests: slot = request_to_slot[req.id] target_lengths[slot] = req.num_computed_tokens + req.num_scheduled_tokens
ok = vattention.step_async(target_lengths)if not ok: preempt_and_retry()run_model(kv_tensors, target_lengths)这里的顺序是正确性的核心:先确定调度预算,再保证物理映射,最后发射模型。不能让 GPU 先跑、CPU 再猜它是否会跨页。
边界四:监控必须覆盖内存控制面
仅记录 free_memory 不足以定位问题,至少还应暴露:
- 已创建、空闲、已映射和延迟回收的页数;
- 同步映射次数、异步命中率与后台线程排队时间;
- 每轮
step耗时及 P50/P99; - 因映射失败触发的抢占次数;
- 每个槽位的有效长度、映射覆盖长度和尾页浪费;
- 不同页大小下的 TLB、Kernel 延迟和最大可运行 batch。
验证时应构造跨页边界测试:多个请求在同一轮同时跨页、Prefill 突发占满页池、请求刚结束即复用槽位、后台线程故意延迟、TP worker 单侧分配失败。只有这些路径通过,平均吞吐数字才具有意义。
小结
vAttention 的核心不是一种新的注意力公式,而是重新划分 KV Cache 内存管理的职责:框架预留稳定的连续虚拟张量,系统层按请求增长映射物理页,普通注意力 Kernel 继续使用线性指针。它用 GPU 已有的页表替代 Kernel 可见的 Block Table,从而降低新 Kernel 获得动态 KV 能力的适配成本。
这个设计能成立,依赖三个推理负载特征:Decode 的下一轮内存需求可预测;KV 的物理分配带宽远低于 HBM 计算数据流;一次迭代足够长,可以隐藏数微秒级映射调用。细粒度页控制容量浪费,后台映射隐藏延迟,延迟回收与提前分配提高页复用率,这四部分缺一不可。
它也不是 PagedAttention 的无条件替代。定制驱动、固定虚拟槽位、前缀共享、抢占换出和多租户隔离都会把复杂度带回系统工程。更准确的判断标准是:若部署最看重连续 Kernel 的快速接入和长 Prefill 性能,且能够控制驱动栈,vAttention 很有吸引力;若系统高度依赖成熟的块级共享、交换和跨请求组合,PagedAttention 仍拥有更完整的软件生态。
参考资料
- vAttention: Dynamic Memory Management for Serving LLMs without PagedAttention
- Microsoft vAttention 官方实现
- CUDA Driver API:Virtual Memory Management
- NVIDIA Technical Blog:Introducing Low-Level GPU Virtual Memory Management
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



