


TensorRT-LLM 源码完全拆解(二十六):模型注册表与注意力后端——一张 HF 配置怎么变成一组内核
背景:配置到内核之间隔着三层东西
在 TensorRT-LLM 的旧世代里,一个模型能不能跑、跑在哪个 kernel 上,很大程度上由「构建期」决定:用户拿 trtllm-build 把 HuggingFace 权重和一份 Engine 配置编译成一个 TensorRT engine 文件,engine 里已经固化了序列长度上限、batch 上限、KV cache 的 dtype,以及 attention、GEMM、MoE 各自用了哪个插件。推理时加载 engine,执行器只负责往已经编译好的算子里塞数据。
PyTorch 后端(tensorrt_llm/_torch/)把这条路径拆开了:不再有构建期,模型结构由一段普通的 nn.Module 代码在加载时搭出来,每一个注意力层在构造时自己去问「我该用哪个 attention 实现」。「配置到内核」这件事从一次离线编译,变成了加载期的一系列运行时分派。这个过程里至少有三层要经过:
- 模型分派:
config.json里的architectures[0](例如"DeepseekV4ForCausalLM")如何映射到tensorrt_llm._torch.models下某一个modeling_*.py里的 Python 类。 - 模块构造:那个类比 HF 原版多长出多少东西——张量并行映射、量化配置、PP 切层、别名链(把上一层的 RMSNorm 和下一层连起来做融合)都必须在构造时决定。
- 后端选择:注意力层构造出来之后,用
TrtllmAttention还是FlashInferAttention,用不用稀疏后端,RoPE 是否合并进 attention 算子,分块注意力是否生效。
前三篇分别拆过整体架构、PyExecutor 装配线与调度器、KVCacheManager,注意力部分也拆过 prepare() 里的块表构造(TensorRT-LLM 源码完全拆解(六):Attention Backend 的 prepare() 内部)和 KV 内存布局(TensorRT-LLM 源码完全拆解(七):KV Cache 的内存布局与量化存储)。本篇补上最上游的那一段:在调度器之前、在 KV 管理器之前,配置是怎么被翻译成模块、模块又是怎么被翻译成内核的。这一段代码集中在两个位置:
tensorrt_llm/_torch/models/:模型动物园与注册表(_arch_index.py、modeling_utils.py、modeling_auto.py);tensorrt_llm/_torch/attention/backends/:注意力后端的接口、三个实现(TRTLLM、VANILLA、FLASHINFER)以及分派函数get_attention_backend。
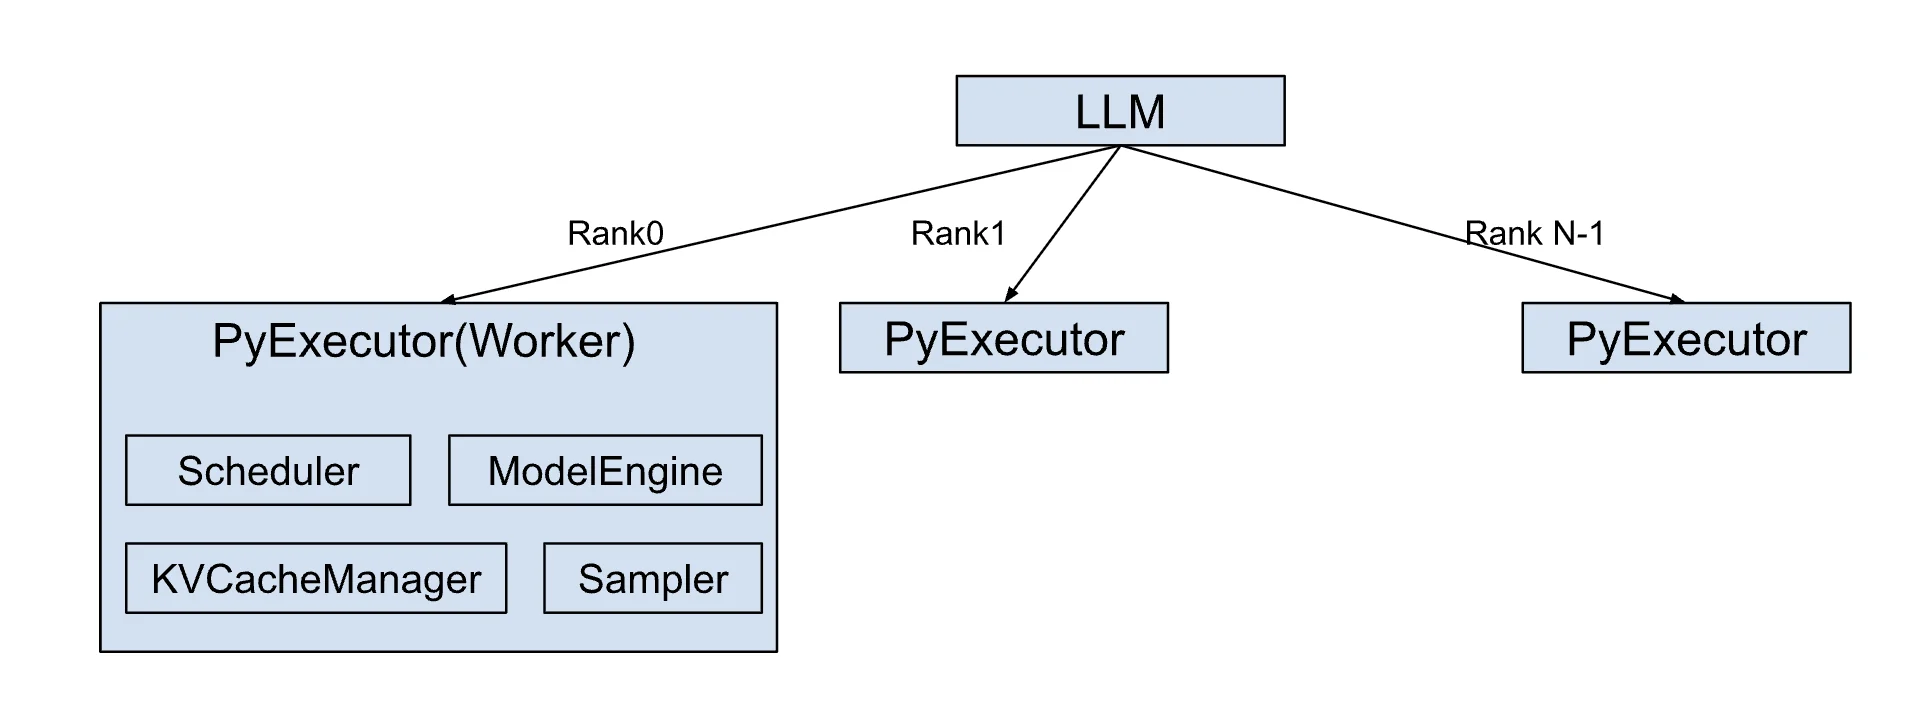
图:TensorRT-LLM 官方文档给出的整体架构。本文拆解的 models/ 与 attention/backends/ 位于图中 Model Engine 这一层的内部:前者决定「搭出哪个模型」,后者决定「注意力用哪个 kernel」。(来源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/)
第一层:注册表与懒加载
最朴素的做法,以及它的问题
模型动物园最自然的写法,是在包级 __init__.py 里把所有模型模块都导入一遍:
from .modeling_llama import LlamaForCausalLMfrom .modeling_qwen2 import Qwen2ForCausalLMfrom .modeling_deepseek_v3 import DeepseekV3ForCausalLM...配合每个模块内部的装饰器:
@register_auto_model("LlamaForCausalLM")class LlamaForCausalLM(SpecDecOneEngineForCausalLM[LlamaModel, LlamaConfig]): ...装饰器在类定义体执行完之后立刻把类塞进 MODEL_CLASS_MAPPING["LlamaForCausalLM"]。这样「一行装饰器即完成注册」,心智负担极低。
问题不在正确性,在成本。一个模型动物园里,modeling_* 模块有几十上百个,每个模块的导入都会:
- 执行模块顶层的所有
import,把 transformers、flashinfer、cutlass 相关依赖全部拉进来; - 执行模块顶层的全部语句——配置类、枚举、常量表、dataclass 声明都在这一步完成;
- 在执行装饰器时往注册表里写条目。
只有「被用到的那一个」模块是必要的,其余全是白付的启动开销。而服务的启动时间恰好是用户最敏感的一段:NVIDIA 官方文档里专门提到冷启动的预热问题,模型加载、显存 profile、CUDA Graph 捕获每一步都在争抢启动时间——前一篇拆过的 GLM-5.3 全链路系列里,「部署之后的第一条请求」一篇也详细算过这条冷启动路径。动物园导入开销叠在这条路径的最前面,是纯浪费。
PEP 562 与静态索引
TensorRT-LLM 的解法是把「注册」和「导入」拆开成两张表:
- 静态索引:
_arch_index.py里手写维护、但不导入任何模块的表,把架构名直接映射到「文件名」:
MODEL_ARCH_TO_MODULE = { "AfmoeForCausalLM": "modeling_afmoe", "BartForConditionalGeneration": "modeling_bart", # ... 每个 @register_auto_model("<arch>") 对应一行}- 运行期注册表:
MODEL_CLASS_MAPPING(架构名 → 类),只在实际导入某个modeling_*模块后,由装饰器写入。
包入口 models/__init__.py 的 docstring 把这个设计讲得很直白:
Importing this package no longer imports every
modeling_*module (which executes all model class bodies and their@register_auto_modeldecorators at interpreter startup). Instead: attribute access imports just the providing module, via PEP 562__getattr__andMODEL_CLASS_TO_MODULE; architecture-based resolution imports on demand viamodeling_utils.get_registered_model_classandMODEL_ARCH_TO_MODULE.
PEP 562 是 Python 3.7 引入的模块级 __getattr__ 协议:当模块属性找不到时,解释器会调用模块里定义的 __getattr__。TensorRT-LLM 用它实现按需导入:
def __getattr__(name: str): module_name = MODEL_CLASS_TO_MODULE.get(name) if module_name is not None: try: module = importlib.import_module(f".{module_name}", __name__) except AttributeError as e: raise ImportError( f"cannot import {name!r} from {__name__!r}: importing " f"{__name__}.{module_name} raised {e!r}", name=__name__) from e attr = getattr(module, name) globals()[name] = attr # cache: subsequent access skips __getattr__ return attr ...这里有两个值得注意的细节。
第一,导入后把属性写回 globals()。这样第二次访问同名属性不再触发 __getattr__,相当于一次惰性缓存,开销只付一次。
第二,异常类型被刻意区分。AttributeError 从被导入的模块里冒出来,说明是那个模块内部的 bug(比如某个依赖缺失导致的属性错误),必须原样包装成 ImportError 抛出去;如果直接让 AttributeError 冒出来,hasattr() 探测和带默认值的 getattr() 会把它吞掉,问题会被隐藏到很后面才暴露。反过来,只有「这个子模块根本不存在」这种 ModuleNotFoundError 才翻译成「没有这个属性」,因为子模块缺失在语义上确实等价于属性缺失。这种区分在 Python 的惰性导入实现里是很容易写错的点:except ModuleNotFoundError 不能无条件吞掉,必须检查 e.name 是否恰好是 f"{__name__}.{name}",否则模块内部的下游依赖缺失会被误报成「模型类不存在」,排查时会被误导到完全错误的路径。
__getattr__ 里还处理了「裸子模块访问」:models.modeling_llama 这种写法在原来的 eager 导入时代可以成立,改成懒加载后必须额外 importlib.import_module(f".{name}", __name__) 才能兼容。
按架构解析:get_registered_model_class
AutoModelForCausalLM._resolve_class 拿到 pretrained_config.architectures[0] 之后,并不直接查 MODEL_CLASS_MAPPING——因为那个字典此时可能还是空的。它调用的是 get_registered_model_class(model_arch):
def get_registered_model_class(model_arch: str) -> Optional[Type[nn.Module]]: ... _ensure_model_registered(model_arch) return MODEL_CLASS_MAPPING.get(model_arch)_ensure_model_registered 的注释说明了它为什么不直接查表:
Model implementations register themselves in
MODEL_CLASS_MAPPING…, and imports are the only thing that triggers registration._ensure_model_registeredreadsMODEL_ARCH_TO_MODULEto import the providing module…
也就是说,字典查找之前必须先「确保提供者已导入」。这个顺序是懒加载注册表的核心纪律,_arch_index.py 的末尾专门为投机解码的 SPEC_MODE_TO_MODULE 总结了三条硬规则:
- 只通过
get_registered_draft_model_builder查表:它会先按需导入提供者模块,裸dict.get()会静默漏掉每个尚未导入的提供者。 - 内置实现只填空槽、不覆盖:懒加载下内置模块的装饰器可能晚于外部注册执行(外部注册来自
--custom_module_dirs),如果沿用「后写覆盖」,内置实现就会把用户提供的草稿模型顶掉。 - 用类自身的
_registered_spec_modes属性反查模式,而不是扫描映射表:一个内置实现即使丢了槽位(被外部注册顶替),属性仍然在,扫描映射表会把它错判成未注册。
这三条规则同样适用于 register_auto_model,modeling_utils.py 里的实现完全对应:
def _apply_arch_registration(registry_name: str, arch: str, value: Any, module_name: str) -> None: registry = _ARCH_REGISTRIES[registry_name] existing = registry.get(arch) if (existing is not None and existing != value and is_builtin_zoo_module(module_name)): logger.info( f"Keeping {registry_name} registration {_describe_provider(existing)} " f"for architecture {arch}; built-in " f"{_describe_provider(value)} not registered.") return registry[arch] = valueis_builtin_zoo_module 判断的依据是包边界:模块名等于 tensorrt_llm._torch.models 或以 tensorrt_llm._torch.models. 开头才算「内置」。注意注释里特意提了一句:兄弟包 tensorrt_llm._torch.models_custom 不算内置——前缀检查必须带分隔符,否则 models_custom 会被误判。
注册的可回放性
还有一个不那么显眼但很关键的机制:_MODULE_REGISTRATIONS。
# Every architecture registration a module's decorators made, in the order they# ran. A module's decorators run once per process, so this is the only way to# put a provider back after its slots were released: importing it again is a# no-op against ``sys.modules``._MODULE_REGISTRATIONS: Dict[str, List[Tuple[str, str, Any]]] = {}为什么需要「把提供者放回去」?因为注册表在某些场景下会被重建——例如外部模型模块导出并重新注册(export_external_model_modules / register_external_model_modules)。重建之后,已经导入过的内置模块不会重新执行装饰器(sys.modules 里已有,第二次 import 是空操作),它的注册就永久丢了。所以装饰器每次执行时,除了写注册表,还要把「哪个模块注册了哪个架构、注册了什么」记进 _MODULE_REGISTRATIONS;重建注册表时按顺序回放这张日志即可(_replay_provider → _rebuild_arch_registries)。
这体现了懒加载注册表的一个本质困难:装饰器是「只执行一次」的副作用,而注册表却是可以被重建的普通数据结构。两者生命周期不一致时,就必须为副作用留一份可回放的日志。这个模式不是 TensorRT-LLM 独创——PyTorch 的 torch.library、vLLM 的模型注册(vllm/model_executor/models/registry.py)也都采用「静态映射表 + 按需导入」的结构,vLLM 甚至把这张映射表做成一份由脚本自动生成、带单元测试校验的清单;本文末尾的横向对比会展开。
一个容易被忽略的兼容层:_torch.configs
models/__init__.py 第一行不是导入注册相关的东西,而是一句:
# Importing _torch.configs triggers AutoConfig registration for TRT-LLM-only# model_types (deepseek_v32, kimi_k2, gemma4_unified) so AutoConfig /# AutoTokenizer.from_pretrained work under transformers >= 5.5; this must stay# eagerimport tensorrt_llm._torch.configs # noqa: F401这一句是为「模型之外的配置层」服务的。HuggingFace 的 AutoConfig.from_pretrained 按 config.json 里的 model_type 分派到某个 XxxConfig 类;如果某个模型类型只有 TensorRT-LLM 认识(比如上面提到的几个),就必须在 AutoConfig 的注册表里先登记一个同名配置类,否则 from_pretrained 在拿到权重之前就失败了。这正是「模型注册」之外的另一条注册链路——模型类型(model_type)注册在 transformers 里,架构名(architectures[0])注册在 TensorRT-LLM 自己这里,两者分属不同系统,却要在加载流程里对齐。
第二层:AutoModelForCausalLM 的解析流水
AutoModelForCausalLM._resolve_class 把上面的表串成一条解析流水,顺序上有好几个特例分支。逐段看:
pretrained_config = config.pretrained_configif not pretrained_config.architectures: return Nonemodel_arch = pretrained_config.architectures[0]第一步只认 architectures[0]。HF 的 config.json 里 architectures 是列表,但绝大多数模型只有一个,多值的情况(T5ForConditionalGeneration 这类)由别的入口处理。
分支一:编码器专用。
if config.mm_encoder_only: vision_encoder_info = get_registered_vision_encoder(model_arch) if vision_encoder_info is None: return None vision_encoder_cls, _ = vision_encoder_info return vision_encoder_cls同一个架构名可以有两份注册:一份在 MODEL_CLASS_MAPPING(因果 LM),一份在 MODEL_CLASS_VISION_ENCODER_MAPPING(视觉编码器)。mm_encoder_only=True 时,模型以「只跑多模态编码器」的方式部署——例如把 Qwen2.5-VL 的 ViT 单独拉出来做图片 embedding 服务。这对应 DecoderModelForCausalLM.get_model_defaults 里鼓励子类覆盖的「模型特有默认值」机制:模型作者可以用它告诉引擎「这个模型不支持 KV cache 块复用」「MoE 后端应该按硬件自适应选择」之类的信息。
分支二:EAGLE-3 草稿检查点。
if hasattr(pretrained_config, "draft_vocab_size"): model_arch = model_arch.replace("Eagle3", "") model_arch = "EAGLE3" + model_archEAGLE-3 草稿检查点的 architectures 通常写成 "Eagle3LlamaForCausalLM" 之类带前缀的形式,而注册表里用的是统一前缀 EAGLE3 加目标模型架构名。这里用「先删后加」的方式重写架构名。注释也自嘲了一句:
Hack to detect eagle3 checkpoints. TODO: should we provide our own checkpoints with the correct arch?
也就是说,只要配置里出现 draft_vocab_size 字段就假定它是 EAGLE-3 草稿。这是典型的「在无法修改上游格式的情况下,用字段嗅探做类型判断」。前一篇拆 EAGLE-3 一体式草稿时讲到草稿模型和验证模型共用 worker,草稿检查点能在主模型旁边被识别出来,靠的就是这一段。
分支三:modeling_v2 目标。
if config.modeling_v2_target is not None: return config.modeling_v2_target这里是 TensorRT-LLM 正在推进的「modeling_v2」实验路径:某些配置由独立的 target 模块接管实现。注释里特别写明了优先级次序——因为这段代码在 EAGLE-3 重写之后才执行,一旦生效就会覆盖前面重写的结果,所以文档化的契约是「modeling_v2 优先」;而目标判定用的是重写前的 architectures[0],因为它判定的是「这个检查点属于哪一类」,而不是「重写后它看起来像什么」。注释还补了一句:目前不可达(EAGLE-3 需要 draft_vocab_size,没有草稿检查点能匹配 target 的形状指纹),所以那是契约而非观察到的行为。
这段注释本身就是一个好的工程习惯样本——在不可达分支上写清楚「为什么不可达」,避免未来有人看到这个分支做出错误推断。
最后一句:
return get_registered_model_class(model_arch)真正的注册表查询。
from_config:构造前后的两个开关
解析出类之后,from_config 并不是直接 cls(config):
cls = AutoModelForCausalLM._resolve_class(config)if cls is None: raise ValueError( f"Unknown architecture for AutoModelForCausalLM: {config.pretrained_config.architectures[0]}" )if issubclass(cls, DecoderModelForCausalLM): config._frozen = False config.skip_create_weights_in_init = True config._frozen = True这里把 skip_create_weights_in_init 临时打开。原因是混合量化:不同线性层要用不同的量化方案,而量化方案决定了权重的存储格式与形状。如果构造每个 Linear 时就立刻分配权重,那就必须先知道每一层的量化方案;但每一层的量化方案要在整个模块树搭完之后,由 apply_layerwise_quant_config 遍历命名模块才能定下来。所以顺序被反过来了:先搭出空壳,再统一套量化配置,最后统一 create_weights:
def __post_init__(self): self.apply_layerwise_quant_config() self.apply_quant_config_exclude_modules() for _, module in self.named_modules(): if callable(getattr(module, "create_weights", None)): module.create_weights()config 上面有 _frozen 保护(防止构造期间被修改),临时解开、改值、再关上,是一个最小侵入的做法。注意 replace(config, ...) 用于 modeling_v2 目标拒绝时的回退构造时会「重新初始化 init=False 字段」,所以代码特意把 loader 写进 extra_attrs 的键(GEMM 后端、allreduce 尺寸)保存一份并回填,避免回退后丢失。
NoTarget:一种比异常更细的失败语义
with model_extra_attrs(extra_attrs): try: model = cls(config) except NoTarget as why: if cls is not target or resolved_mode(target) is ModelingV2Mode.REQUIRE: raise logger.info( f"modeling_v2: {target.__name__} refused this runtime ({why}); " "using the built-in implementation") fallback = replace(config, modeling_v2_target=None) fallback.extra_attrs.update(loader_attrs) return AutoModelForCausalLM.from_config(fallback)NoTarget 不是「代码路径不对」的异常,而是「这个 target 明确表示自己处理不了当前运行时」的声明。区分 AUTO 与 REQUIRE 两种模式:AUTO 下拒绝就静默回退到内置实现,REQUIRE 下拒绝就是错误。这一层语义和注意力后端那边的行为一致(后面会讲),说明在 TensorRT-LLM 的代码里,「有能力但判断当前配置不合适时如何优雅降级」是被系统化建模的,不是靠一串 try/except。
MetaInitMode:让构造也变成一笔显存账
模块构造除了上面的逻辑问题,还有显存问题。一个 BF16 的 70B 模型,权重就是 ~140GB;如果在构造时先在 CPU 上用随机初始化填满这 140GB,再拷到 GPU,启动阶段的峰值内存高得出奇,还可能 OOM。
MetaInitMode 是一个 TorchDispatchMode 上下文:
class MetaInitMode(TorchDispatchMode): """Context for skip random parameter initialization NN modules initialized under this context will place empty initialized parameters on `meta` device to avoid cpu computation. ... """ init_ops = {aten.empty.memory_format, aten.empty_like.default} random_init_ops = { aten.normal_.default, aten.uniform_.default, aten.log.default, ... }
def __torch_dispatch__(self, func, types, args=(), kwargs=None): if func in self.init_ops: kwargs['device'] = torch.device('meta') return func(*args, **kwargs) elif func not in self.random_init_ops and self._has_meta_tensor(args, kwargs): raise MetaInitException( f"Meta tensor used in unsupported function: {func}") return func(*args, **kwargs)要点有三:
torch.empty/torch.empty_like被改成在meta设备上分配——meta设备只记录形状与 dtype,不实际占用内存。- 随机初始化算子(
normal_、uniform_、log)允许在 meta 张量上执行——反正结果随后会被权重覆盖,不做也无所谓。 - 任何其他算子一旦吞到 meta 张量就抛
MetaInitException。这条守卫是整段代码的价值所在:如果不加,「在 meta 上构造一个模型」会得到一堆形状正确、内容垃圾的张量,错误被推迟到加载权重的某一步,报错信息与根因完全对不上。
MetaInitException 的设计也考虑了下游:抛出异常后,调用方(DecoderModelForCausalLM 的构造路径)可以捕获它,然后退回到正常初始化重来一次。也就是说,meta 初始化不是必须成功的路径,而是一个能成功就走捷径的优化。
把这一段和第一篇拆过的「整体架构」里的模型加载、以及第二十篇的「启动时显存 profiling」连起来看,TensorRT-LLM 的启动阶段其实有三笔独立的显存账:
- 权重账:加载多少字节,量化后多少字节;
- KV 池账:
free_gpu_memory_fraction占了多少; - 构造账(临时):模块构造期间的 CPU 峰值,
MetaInitMode就是在削这一笔。
前两笔账在第一篇和第二十篇里都拆过,第三笔常常被忽视,但在大模型上它可能比 KV 池的零头都大。
第三层:一个 decoder layer 的构造过程中藏着哪些后端决策
LlamaModel.__init__ 把所有层的构造写成一句列表推导:
self.layers = nn.ModuleList([ LlamaDecoderLayer(model_config, layer_idx, self.use_custom_cublas_mm) for layer_idx in range(config.num_hidden_layers)])LlamaDecoderLayer.__init__ 里接着构造 LlamaAttention 与 GatedMLP,LlamaAttention 再调用 Attention 基类的 __init__(tensorrt_llm/_torch/attention/attention.py)。Attention 的构造是这个链条里最重的一环,它同时做了四件事:
- 自我登记:把自身以弱引用形式记进
config.extra_attrs["attn_layers"],键是layer_idx字符串,重复时加_0、_1后缀。
self.register_to_config = Falseif config is not None: if "attn_layers" not in config.extra_attrs: config.extra_attrs["attn_layers"] = {} suffix = 0 while self.layer_idx_str in config.extra_attrs["attn_layers"]: self.layer_idx_str = str(layer_idx) + f"_{suffix}" suffix += 1 config.extra_attrs["attn_layers"][self.layer_idx_str] = weakref.ref(self) self.register_to_config = True为什么需要这么一张表?因为注意力层在模型之外也需要被「按层索引」访问——prepare() 阶段里,调度器和 KV 管理器是按层组织的,而模型的注意力层本身又被模型内部引用。弱引用保证这张表不会把模型层延长生命周期;后缀去重保证多模态模型里多个编码器各有自己的 layer 0 时不会互相覆盖。这和第 6 篇「Attention Backend 的 prepare()」里提到的「块句柄如何变成块表」是上下游关系:prepare() 消费的正是这张 attn_layers 表里的对象。
-
张量并行映射的拆分:
o_proj用TensorParallelMode.ROW,hidden_size这一维作为输入、按 TP 切分后做行并行 AllReduce。这部分在第 23 篇「Linear 与层内张量并行」一文里详细拆过。 -
读后端配置:
self.quant_config = config.get_quant_config()self.attn_backend = config.attn_backend
sparse_attn_cfg = config.sparse_attention_configsparse_params = (sparse_attn_cfg.to_sparse_params( pretrained_config=config.pretrained_config, layer_idx=self.layer_idx) if sparse_attn_cfg is not None else None)self.sparse_params = sparse_paramsself.sparse_attn_hooks = get_sparse_attention_hooks(self)
attn_cls = get_attention_backend(self.attn_backend, sparse_params=sparse_params)注意 attn_cls 只是类,真正的实例在 forward 路径里才通过 create_attention 构造(传入了 MLA 参数、RoPE 参数等只有在更完整上下文里才能确定的东西)。这个「先定类、再定实例」的顺序使得稀疏后端在构造 Attention 阶段就能把自己的 hook 挂上去。
- RoPE 融合开关:
self.rope_fusion = rope_fusionif (config.kv_cache_compression_config is not None and config.kv_cache_compression_config.changes_physical_kv_length): logger.warning_once( "KV-cache eviction changes the physical cache length; " "setting rope_fusion=False.", key="disable_rope_fusion_for_kv_cache_compression") self.rope_fusion = Falseif self.rope_fusion and not attn_cls.support_fused_rope(): logger.warning_once( "rope_fusion is true but the attention backend does not support it. Will disable rope_fusion.", key="disable_rope_fusion_for_non_supported_backend") self.rope_fusion = FalseRoPE 融合是指把位置编码的旋转操作合并进 attention 算子内部执行,省掉一次独立的 apply_rope kernel 与一段读写。但融合有一个前提:attention 算子要能在正确的绝对位置上看到 K——如果 KV 压缩通过驱逐改变了物理长度,逻辑位置与物理下标不再一致,融合就失效。这正是第 9 篇「KV Cache 压缩框架」里冷页 NVFP4 编码与 TriAttention 驱逐所影响的维度。所以这里用两道闸门兜住:压缩配置在「逻辑位置≠物理位置」时强制关闭融合,后端能力不足时再关一次。
而 Llama4Attention 里的处理更激进:
if model_config.attn_backend != "TRTLLM": # TODO: support chunked attention for other backends. # This is safe to do because we limit seqlen to 8k for non TRTLLM backends. attention_chunk_size = Noneelif get_sm_version() <= 90 and model_config.spec_config is not None: # pre-Blackwell spec-dec kernel does not support chunked attention attention_chunk_size = None这里出现了三种「层内决策」:后端种类、GPU 代际、是否启用投机解码。任意一个不满足,分块注意力就退化成全注意力。注释里那句「非 TRTLLM 后端把序列长度限制在 8k 所以安全」是一个约定式假设——它不在代码里强制检查,而是由部署规范保证。这种写法在性能敏感的代码里很常见,代价是:一旦有人把 8k 以上的序列喂给非 TRTLLM 后端,会得到错误的注意力结果而不是报错。读这段代码时要意识到这类隐含假设。
LlamaForCausalLM.__init__ 之后还会执行 setup_aliases(),把每一层的 next_layer_layernorm 指向下一层的 input_layernorm,并设置 skip_input_layernorm;最后一层则指向 self.model.norm 并设置 skip_norm。这套别名链的作用是让 RMSNorm 的残差相加、量化与后续层的输入融合起来执行——DeepInfer 系列第十五篇「Linear、RMSNorm 与 RoPE」拆过类似的融合形态。这里它是在模型构造期就搭好的,而不是在 forward 里临时找。
第四层:注意力后端的接口与三套实现
AttentionBackend 基类的契约
后端基类在 attention/backends/interface.py:
class AttentionBackend(Generic[TMetadata]): Metadata: Type[TMetadata] = AttentionMetadata
def __init__(self, layer_idx, num_heads, head_dim, num_kv_heads=None, quant_config=None, **kwargs): self.layer_idx = layer_idx self.num_heads = num_heads self.head_dim = head_dim self.num_kv_heads = num_kv_heads or self.num_heads self.quant_config = quant_config构造参数只有四个「几何量」加一个量化配置。这个设计的含义是:后端是「per-head 的算子」,与层的身份无关。所有与具体模型结构相关的信息(MLA、RoPE 位置、cross-attention、稀疏几何)都通过 forward_args 在每次前向时传入,而不在构造时固化。
forward 的签名:
def forward(self, q, k, v, metadata, forward_args=None, **kwargs) -> torch.Tensor: """ Update KV Cache and perform the attention operation. q: (num_q_tokens, num_heads * head_dim), or QKV tensor k: (num_new_kv_tokens, num_kv_heads * head_dim), or KV tensor, or None ... """关键在于 **kwargs——旧版本里各种可选参数(mask、cache indirection、位置偏移)走的是显式 keyword 参数;现在这些被收拢进 forward_args(一个 AttentionForwardArgs dataclass),同时保留 merge_attention_forward_args 兼容旧调用:
if forward_args is not None: if kwargs: raise ValueError( "Pass attention forward options either through forward_args " f"or as legacy kwargs, not both: {sorted(kwargs)}") return forward_argsreturn AttentionForwardArgs(**kwargs)这里做了两件事:一是把「两套写法同时用」当成错误直接拒绝,而不是合并——因为两个来源都给出了同名参数时,谁覆盖谁是没有合理默认的;二是新写法只有一条路径,避免像某些框架那样新旧两套签名长期并行维护。
能力声明:support_* 系列
基类上有四个能力开关:
@classmethoddef support_fused_rope(cls) -> bool: ...@classmethoddef support_fused_qkv(cls) -> bool: ...@classmethoddef support_mla(cls) -> bool: ...@classmethoddef support_fp4_kv_cache(cls) -> bool: ...TrtllmAttention 与 FlashInferAttention 各写各的。create_attention 在使用 MLA 之前会 assert attn_cls.support_mla();Attention.__init__ 在用 RoPE 融合之前会查 support_fused_rope()。
这种「用类方法声明而不是实例属性或配置项」的做法有一个好处:能力在导入期就是可知的,不依赖实例构造。用户可以在部署前用 TrtllmAttention.support_fp4_kv_cache() 探测当前版本+当前后端能否跑 FP4 KV cache,做部署可行性检查,而不必真的把引擎拉起来跑一遍。
能力声明配合配置校验,在 llm_args.py 里形成第二道闸门:
@model_validator(mode="after")def validate_mixed_precision_kv(self) -> 'TorchLlmArgs': if self.kv_cache_config.mixed_precision_kv is None: return self ... if self.attn_backend.upper() not in ("TRTLLM", "FLASHINFER"): raise ValueError( "Mixed-precision KV supports the TRTLLM and FLASHINFER attention " f"backends; got attn_backend={self.attn_backend!r}.") if self.sparse_attention_config is not None: raise ValueError( "Mixed-precision KV is not supported together with sparse attention." ) if self.kv_connector_config is not None: raise ValueError( "Mixed-precision KV is not supported together with a KV connector." ) if (self.speculative_config is not None or self.kv_cache_compression_config is not None or self.max_beam_width != 1): raise ValueError( "Mixed-precision KV currently requires single-beam execution " "without speculative decoding or cold-page compression.") return self这一段几乎就是一张「功能兼容矩阵」的代码化:混合精度 KV cache 只能搭配 TRTLLM/FLASHINFER 后端、不能配稀疏注意力、不能配 KV connector、必须单 beam 且不启用投机解码和冷页压缩。每一项限制背后都有一个结构性原因(块表映射、缓存形态、回滚逻辑),但它们没有写在推理内核里,而是集中前置成配置校验。
这也是 PyTorch 后端的整体架构思路:能力组合的兼容性在配置阶段一次性判定,而不是在运行期用一堆 if 兜。这样用户拿到的报错是「你的配置组合不被支持」而不是「跑到第 37 层时 assert 失败」。
同样地,enable_mla_skip_correction(启用阈值式的 MLA 跳过修正)只在 SM100/SM103 上有效,并且强制要求 attn_backend='TRTLLM':
@model_validator(mode="after")def validate_mla_skip_correction_config(self) -> 'TorchLlmArgs': if self.enable_mla_skip_correction and self.attn_backend.upper() != "TRTLLM": raise ValueError( "enable_mla_skip_correction requires attn_backend='TRTLLM'.") return selfget_attention_backend:一个四分支的分派函数
def get_attention_backend(backend_name: str, sparse_params: Optional[SparseParams] = None ) -> Type[AttentionBackend]: from .trtllm import TrtllmAttention backend_name = backend_name.upper() if backend_name == "VANILLA": if sparse_params is not None: return get_vanilla_sparse_attn_attention_backend(sparse_params) return VanillaAttention elif backend_name == "TRTLLM": if sparse_params is not None: return get_trtllm_sparse_attn_attention_backend(sparse_params) return TrtllmAttention elif backend_name == "FLASHINFER" and IS_FLASHINFER_AVAILABLE: from .flashinfer import FlashInferAttention if sparse_params is not None: return get_flashinfer_sparse_attn_attention_backend(sparse_params) return FlashInferAttention
logger.warning("Falling back to TRTLLM attention backend") return TrtllmAttention几个细节:
TrtllmAttention的延迟导入:注释写明「utils.py模块级导入.trtllm会造成循环导入」,因为.trtllm反过来要用utils.py里的check_page_table、log_attention_failure_context。这是 Python 包内循环依赖的经典处理方式——让依赖方向从「重的一侧」指向「轻的一侧」,重的一侧延迟导入。- 大小写不敏感:
backend_name.upper()。所以配置里写trtllm/TRTLLM/Trtllm都行。这个宽容在人类手写 yaml 时很有用,但也意味着配置校验那边(上面validate_mixed_precision_kv里的.upper())必须保持一致,否则会出现「校验通过但分派失败」的裂缝。读代码时把两处的.upper()都留意一下。 FLASHINFER的前置条件:IS_FLASHINFER_AVAILABLE由flashinfer_utils判断,并且attention/backends/__init__.py的__all__也是条件化追加的——FlashInferAttention只在 flashinfer 可用时才导出。这意味着如果用户配置了 FLASHINFER 但当前环境没装 flashinfer,会静默落入最后一行「回退到 TRTLLM」。这个行为是设计好的,但读的时候要清楚:这里的回退是静默的,只有一条 warning 日志。如果用户依赖的是 flashinfer 特有的某个 kernel 行为,这种回退可能不是他想要的。配置文件校验里并没有把「装了 flashinfer 才允许写 FLASHINFER」作为前置条件——这是 TensorRT-LLM 配置层的一个已知薄弱点,实践中往往依赖部署脚本先做可用性探测。- 稀疏后端的注入点:三个稀疏 getter 在
sparse子包里,说明稀疏注意力不是「另一种后端」,而是三种后端 × 稀疏模式的一个二维组合。DeepSeek 系列模型(DeepInfer 系列第三十四篇「候选块 topk 管线」所拆的 indexer)走的就是TRTLLM后端 + 稀疏 hook 的组合:注意力内核不变,只是块的选择由一个 hook 决定。这种设计把「选哪些块」和「怎么算这些块」解耦,复用度很高。
create_attention:几何量、MLA 与约束在一次调用里钉死
get_attention_backend 只决定「用哪个类」。真正构造实例的是 create_attention,它同时承担了参数装配与兼容性断言两件事:
def create_attention( backend_name: str, layer_idx: int, num_heads: int, head_dim: int, num_kv_heads: Optional[int] = None, pos_embd_params: Optional[PositionalEmbeddingParams] = None, quant_config: Optional[QuantConfig] = None, q_scaling: Optional[float] = None, is_mla_enable: bool = False, q_lora_rank: Optional[int] = None, kv_lora_rank: Optional[int] = None, qk_rope_head_dim: Optional[int] = None, qk_nope_head_dim: Optional[int] = None, v_head_dim: Optional[int] = None, rope_append: Optional[bool] = None, ... sparse_params: Optional[SparseParams] = None, dtype: Optional[torch.dtype] = None, kv_cache_dtype: str = "auto", skip_correction_threshold: float = 0.0,) -> AttentionBackend:参数列表本身就是一张「注意力几何清单」。可以按职责分成五组:
- 头几何:
num_heads、head_dim、num_kv_heads。它们决定 Q/K/V 的切分方式,也决定内核每个 CTA 要处理多少行。 - 位置编码:
pos_embd_params(RoPE 的 base、缩放策略、是否 interleave)与rope_append。它们决定位置信息是独立算子算,还是塞进注意力内核。 - 量化:
quant_config与kv_cache_dtype。前者管 QKV 投影的权重格式,后者管 KV 缓存按 FP8/FP4 存储时的读取路径。两者必须一起看——权重量化与 KV 量化是两套不同的 scale 体系。 - MLA 几何:
q_lora_rank、kv_lora_rank、qk_rope_head_dim、qk_nope_head_dim、v_head_dim。这五个数缺一不可,因为 MLA 把「每个 head 独立存 K/V」改成了「所有 head 共享一段 latent + 一段 RoPE 分量」,内核必须知道两段各多长。 - 运行时特性:
sparse_params、skip_correction_threshold、attention_chunk_size。它们决定是否走稀疏块选择、是否启用 MLA 的跳过修正、是否分块。
函数开头先做两道硬约束:
if attention_chunk_size is not None and backend_name.upper() != "TRTLLM": raise ValueError( f"Backend {backend_name} does not support chunked attention.")attn_cls = get_attention_backend(backend_name, sparse_params=sparse_params)
if is_mla_enable: assert attn_cls.support_mla( ), f"MLA is not supported for {backend_name} backend" assert (q_lora_rank > 0 and kv_lora_rank > 0 and qk_rope_head_dim >= 0 and qk_nope_head_dim > 0 and v_head_dim > 0)第一道是能力检查:分块注意力只有 TRTLLM 后端实现,其他后端直接拒绝,而不是悄悄退化成全注意力。第二道是几何完整性检查:MLA 打开时,五个几何量必须全部给出且满足取值范围。注意 qk_rope_head_dim >= 0 而不是 > 0——某些 MLA 变体可以没有 RoPE 分量,但 qk_nope_head_dim 与 v_head_dim 必须为正。
这两道检查的位置很关键:它们在构造期,而不是前向期。也就是说,配置错误会在模型加载阶段直接炸掉,而不是等到第一个 batch 跑到第 30 层才出现 shape mismatch。对部署来说,这是一个很划算的取舍——加载阶段失败可以立刻回滚,运行期失败可能已经接了一半流量。
之后的构造过程会按后端类型分叉:TRTLLM 后端把 MLA 参数打包成 MLAParams,FlashInfer 后端把同样的参数翻译成 FlashInfer 的 plan 参数,Vanilla 后端则直接用 PyTorch 的 scaled_dot_product_attention 作为参考实现。三者的构造签名相同,但内部对几何量的解释不同——这也是为什么 create_attention 必须把「模型侧几何」与「后端侧几何」的翻译集中在一处,而不是让每个 modeling 文件自己拼参数。
一个容易忽略的细节是 head_dim 的来源。对普通 MHA/GQA,head_dim = hidden_size // num_heads。但对 MLA,config.head_dim 通常不等于任何单一投影的维度;ModelConfig 里有一个专门的分支:
if self.attn_backend == 'TRTLLM': if getattr(self.pretrained_config, "kv_lora_rank", None) and getattr( self.pretrained_config, "qk_rope_head_dim", None): head_dim = self.pretrained_config.kv_lora_rank + self.pretrained_config.qk_rope_head_dim也就是说,当后端是 TRTLLM 且配置里有 MLA 的两个关键字段时,head_dim 被重定义为 kv_lora_rank + qk_rope_head_dim——这是 latent 的宽度,而不是某个注意力头的宽度。这个重定义直接影响 KV 缓存的每 token 字节数计算:MLA 的缓存不是 2 × num_kv_heads × head_dim,而是 kv_lora_rank + qk_rope_head_dim 这一段 latent(外加可选的 scale)。如果这里用错,KV 显存估算会差出一个数量级。
排查一次后端选择问题,应该按什么顺序看
实际部署中,「为什么我的模型跑的不是我指定的后端」这类问题很常见。按下面的顺序排查,通常能在几分钟内定位:
- 看
ModelConfig.attn_backend的最终值,而不是只看启动参数。llm_args.attn_backend会先经过 Pydantic 校验,再由TorchLlmArgs转成ModelConfig;如果中间有get_model_defaults的深度合并,最终值可能被模型类覆盖。 - 确认
get_attention_backend是否发生了静默回退。搜日志里的Falling back to TRTLLM attention backend。如果出现这条日志,说明配置里的名字不在VANILLA/TRTLLM/FLASHINFER三个分支里,或者FLASHINFER不可用。 - 确认
FlashInferAttention是否真的被导入。IS_FLASHINFER_AVAILABLE为假时,attention/backends/__init__.py不会导出这个类。可以运行时打印tensorrt_llm._torch.attention.backends.__all__验证。 - 确认
create_attention的断言有没有被触发。MLA、分块注意力、RoPE 融合都有各自的assert或ValueError;如果是AssertionError,看堆栈里是不是create_attention这一帧。 - 确认层内特判是否改写了配置。例如
Llama4Attention在非 TRTLLM 后端下会把attention_chunk_size置空;DeepSeek 系列在model_arch匹配时会自动补CSA2SparseAttentionConfig。这些改写发生在ModelConfig.__post_init__或模型构造函数里,光看启动参数看不出来。
这个顺序的原则是「从配置到日志,从日志到导入,从导入到断言,最后到模型特判」——每一步排除一类原因,而不是一上来就读内核代码。
第五层:config.json 字段是怎样决定后端的
到目前为止,后端的源头只有 ModelConfig.attn_backend 这一个字段。这个字段从哪来?在 model_config.py 里:
attn_backend: str = 'TRTLLM'默认值就是 TRTLLM,也就是说只要用户不显式指定,就走 NVIDIA 自研的 trtllm-gen 注意力内核。在 llm_args.py 里,对外暴露的参数是:
attn_backend: str = Field( default='TRTLLM', description="Attention backend to use.", status="beta", # Recognized values mirror get_attention_backend dispatch in # tensorrt_llm/_torch/attention/backends/utils.py. telemetry=TelemetryField.categorical("VANILLA", "TRTLLM", "FLASHINFER"))注释里「Recognized values mirror dispatch」这一句是维护时的关键约定——枚举值写死在两处(这里的 telemetry 分类、分派函数里的分支),改一处必须改另一处。
ModelConfig.__post_init__:配置里藏着的模型特判
除了 attn_backend 这个用户参数,ModelConfig.__post_init__ 里还有几条按模型类型自动补默认值的逻辑:
if (self.sparse_attention_config is None and getattr(self.pretrained_config, "model_type", None) in ("deepseek_v41", "deepseek_v41_text")): self.sparse_attention_config = CSA2SparseAttentionConfig()if self.pretrained_config and self.sparse_attention_config: # Sparse geometry can come from the checkpoint. Resolve it once so # cache allocation, CUDA-graph routing, and model layers all read # the same concrete values. self.sparse_attention_config = ( self.sparse_attention_config._resolve_checkpoint_defaults( self.pretrained_config))这里可以看到模型特判在 ModelConfig 里是怎么落地的:
- 按
model_type补默认:deepseek_v41/deepseek_v41_text这两个模型类型,如果不显式给稀疏配置,就默认启用csa2稀疏注意力。CSA2SparseAttentionConfig在llm_args.py里的 docstring 提到use_fp8_staging:在 SM100 系列上,如果attn_backend=TRTLLM、KV cache 是 FP8、且没有 packed 稀疏注意力,默认用 E4M3 来暂存 CSA2 的 KV,因为「每个 forward 用 persistent 池自身的组 scale 推导出的按张量 staging scale 是 2 的幂,所以 staging 的行保持它们解码出的 E4M3 范围」——这段描述背后是 FP8 的动态范围对齐问题,属于精度和性能之间的一个细微折中。 - 一次解析、多处一致:注释说稀疏几何可能来自 checkpoint(比如
index_n_heads、index_head_dim、index_topk这些在config.json里的字段),所以在这里_resolve_checkpoint_defaults一次性解析成具体值,缓存分配、CUDA Graph 路由、模型层三处都读同一份。这个设计避免了「三个模块各自去 config 里查一次、因为回退逻辑不同而拿到不同值」的一类隐蔽 bug——这类 bug 在注意力系统里尤其致命,因为几何量(比如 top-k 大小)一旦前后不一致,KV 读写会越界。 is_generation/is_encoder_decoder推导:由architectures自动判定,不用用户填。
AttentionMetadata 里还有一组字段值得注意,它们决定了注意力的访存形态:
kv_layout: Literal["NHD", "HND"] = "HND":KV 块中[page, 2, page_size, num_kv_heads, head_dim](NHD)与[page, 2, num_kv_heads, page_size, head_dim](HND)的差别。HND 把 token 维放在最内层之外,有利于 decode 时一个 head 连续读所有 token;NHD 对 prefill 时按 token 分块更友好。第 7 篇「KV Cache 的内存布局与量化存储」专门算过这笔账。enable_flash_mla、enable_context_mla_with_cached_kv:这两个是 MLA 场景的开关,前者决定 MLA 是否走 FlashMLA 风格的算子(每卡的 KV 读取量从 head 数 × head_dim 变成单一 latent),后者决定「已有 KV 的上下文 + MLA」是否走融合路径。chunked_prefill.chunk_size与chunked_prefill_buffer_batch_size:这两个在AttentionRuntimeFeatures里,用于 MLA 的分块预填——注意它不是分块预填本身的 chunk 大小,而是「MLA 的 KV cache 要分成几个 chunk」。
也就是说,config.json 里的模型结构信息(index_topk、kv_lora_rank、qk_rope_head_dim)通过 ModelConfig 转换成 AttentionMetadata 里的字段,再被后端在 prepare() 和内核里消费。这条链路上每一站都可能出现「此处默认值不一致」的问题,所以 TensorRT-LLM 尽量把默认值的解析集中到 ModelConfig 和 AttentionMetadata 的 __post_init__ 处,而不是让每个模块自己兜。
一层的几何量是如何到达后端的
把前面几层串起来,一次 forward 里,后端拿到的东西大致是:
| 来源 | 内容 | 抵达点 |
|---|---|---|
config.json 的 architectures[0] | 模型类名 | AutoModelForCausalLM._resolve_class |
config.json 的 model_type | 模型系列(如 llama、deepseek_v41) | ModelConfig.__post_init__ 的默认值补全 |
config.json 的 hidden_size / num_attention_heads | 头数、head_dim | Attention.__init__ → AttentionBackend.__init__ |
config.json 的 kv_lora_rank / qk_rope_head_dim | MLA 几何 | create_attention 的 MLAParams |
用户 llm_args.attn_backend | 后端种类 | get_attention_backend 分派 |
用户 llm_args.sparse_attention_config | 稀疏模式 | sparse_params → 稀疏 getter |
用户 kv_cache_config.dtype、max_seq_len | KV dtype、序列长度 | AttentionMetadata 与后端 prepare() |
| 调度器每一 step 的批组成 | seq_lens、块表、dtype | AttentionMetadata 实例 |
| 模型层自身 | layer_idx、MLA flag、RoPE 是否融合 | forward_args |
这张表说明了 PyTorch 后端「配置 → 内核」的一个特点:最上层是静态配置(HF config.json + 用户参数),越往下越动态(每个 step 的批、每个 token 的位置)。后端构造函数只吃静态几何量,动态量全部走 metadata 与 forward_args——这个分层是后端之间可以互换的技术前提。
三个后端各自的定位
图:FlashInfer 的分页 KV 数据布局。FlashInferAttention 后端直接复用 FlashInfer 的分页缓存形态,因此 prepare() 必须把 TensorRT-LLM 自己的块表翻译成 FlashInfer 的页表。(来源:FlashInfer 官方文档)
TrtllmAttention:主线后端,默认。它对接 NVIDIA 自研的 trtllm-gen 系列 FMHA 内核,在接口层声明了 FP4 KV cache、MLA 等能力,并且是唯一实现分块注意力的后端。llm_args.py里enable_mla_skip_correction只在 SM100/SM103 上有效,mla_skip_correction_threshold的取值范围(E4M3 下 ≤8、FP16 ≤15、BF16 ≤32)也间接说明了这些新内核按 BMM2 的累加 dtype 划分出的实现层次。FlashInferAttention:接入 FlashInfer(flashinfer-ai/flashinfer)的注意力后端。它的构造带一个flashinfer_backend参数(默认fa2),可在fa2、fa3、cudnn、trtllm-gen之间选具体内核。这意味着 FlashInfer 后端本身又是一层分派——所以「后端」这个词在 TensorRT-LLM 里是外层抽象名,内层再分具体内核。这条路径的优势是 FlashInfer 的 JIT 编译生态与较广的架构覆盖,check_cuda_arch()在导入时就会检查当前架构是否受支持,不支持时用TORCH_CUDA_ARCH_LIST覆盖成实际 capability 再重新编译。FlashInfer 论文对这套「可组合模板」的设计与调度器、稀疏、负载均衡 JIT 内核都有覆盖,可以对照来看。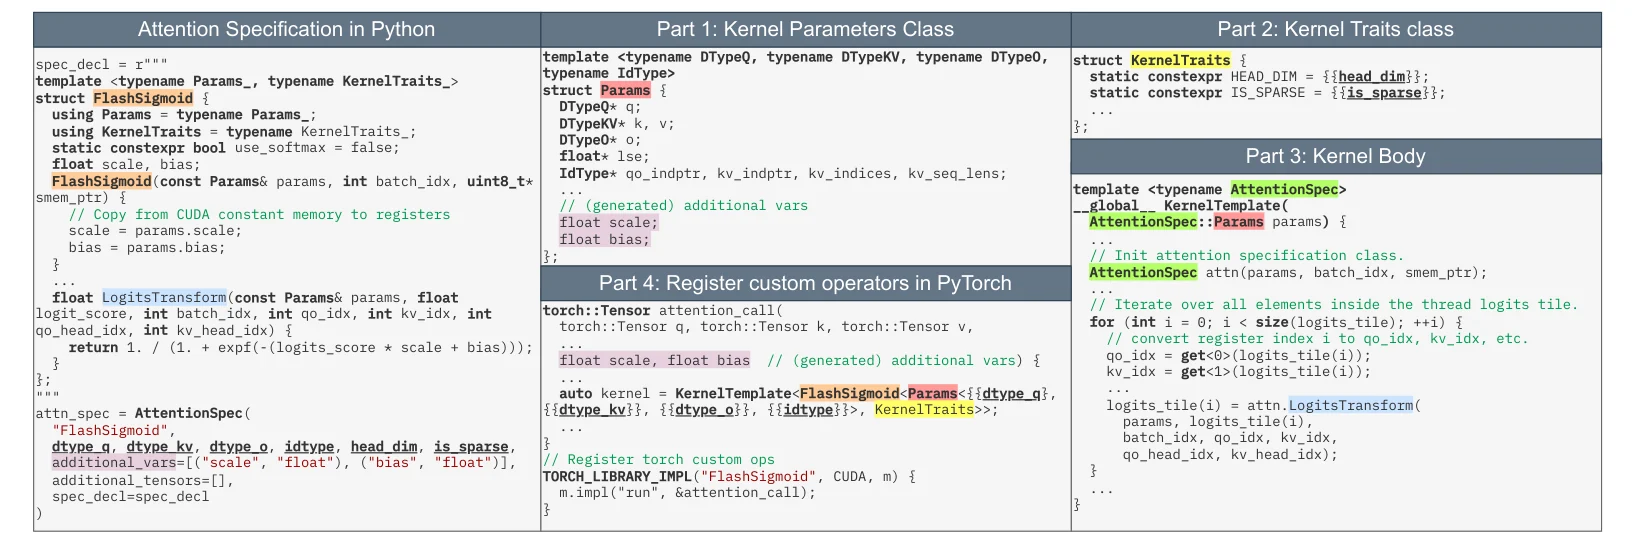
FlashInfer 的 JIT 内核生成流程:模板在运行时按调度策略编译出专用内核,这是 FLASHINFER 后端区别于预编译内核的工程形态
图:FlashInfer 论文中的 JIT 流程图。同一套可组合模板在运行时会按解码、预填充、稀疏、负载均衡等场景编译出不同的专用内核,因此 TensorRT-LLM 接入 FlashInfer 时,后端初始化阶段还要处理 TORCH_CUDA_ARCH_LIST 与架构检查。(来源:FlashInfer 论文 arXiv 2501.01005)
VanillaAttention:最朴素的实现。从llm_args.py的_kv_cache_estimation_runs可以看出它的定位:VANILLA目标后端会跳过 KV cache 显存估算。原因是 Vanilla 后端不用 TensorRT-LLM 的分页分配器做显存 profile(估算是通过一次真实前向来测),所以当用户跑 Vanilla 时引擎不给 KV 池做 profile。Vanilla 的真实价值可能是调试与基线对比——当新模型在新硬件上跑不通、或者想确认某个性能差异是不是自定义内核引起的,切换到 Vanilla 就能隔离内核层。
三个后端的元数据类也各不一样:TrtllmAttentionMetadata、FlashInferAttentionMetadata、VanillaAttentionMetadata 都继承 AttentionMetadata,各自在 prepare() 里做不同的事——Trtllm 侧准备块句柄与 MLAGroupedKVCache 视图,FlashInfer 侧准备 ragged plan,Vanilla 侧几乎什么都不做。这正是第 6 篇「prepare() 内部」和第 5 篇「输入组装」可以复用这里的分层来理解。
横向对比:五个推理框架的注册与后端选择
把注册表与后端选择放到另外四个框架里看,会发现同一个问题有几种典型思路。
| 维度 | vLLM | SGLang | llama.cpp | TensorRT-LLM(PyTorch 后端) | DeepInfer |
|---|---|---|---|---|---|
| 模型分派依据 | HF architectures[0] | HF architectures[0](含部分改写) | GGUF 里的 general.architecture | HF architectures[0](EAGLE-3 改写、modeling_v2 覆盖) | 自有的模型配置与装配路径 |
| 注册表形态 | 静态 _MODELS 映射表 + 测试校验 | ModelRegistry 与 @register_model 装饰器 | llm_arch 枚举 + 每架构专属的加载函数 | 静态 MODEL_ARCH_TO_MODULE + 装饰器 @register_auto_model | 模型层显式装配,不依赖装饰器 |
| 惰性导入 | 有,_LazyRegisteredModel 按需导入模块 | 有,按需导入模型模块 | 编译期链接,无导入问题 | PEP 562 __getattr__ + _ensure_model_registered | Python 直接导入 |
| 外部模型扩展 | 支持 out-of-tree 注册 | 支持外部模型路径 | 不支持外部模型代码,靠 GGUF 与算子 | --custom_module_dirs + 外部注册优先 | 按项目需要扩展 |
| 注意力后端 | AttentionBackend 枚举 + get_attn_backend 按平台/模型选 | 多种 attention 后端按配置与硬件选择 | ggml 统一算子 + 按架构选 flash-attn 变体 | VANILLA / TRTLLM / FLASHINFER 字符串分派 + 能力开关 | Platform 抽象区分 CUDA/Ascend |
| 兼容性校验 | 在 VllmConfig 与后端 validate_configuration 集中判定 | 在服务器参数与模型加载处校验 | 在 llama_model_load 处做架构/设备检查 | llm_args 的 model_validator 集中判定 | 在 Platform 与启动路径中校验 |
从这张表能看出两条主要分化线。
分化线一:静态映射表 vs 运行期装饰器
vLLM 和 TensorRT-LLM 都选择了「静态映射表」,但动机不同。vLLM 的动机主要是可测试性:脚本自动生成、单元测试校验「每个类是否都被注册」「每个注册类是否有对应实现文件」。TensorRT-LLM 的动机是启动开销——动物园太大,导入每个模块都要执行几十个类定义体。SGLang 的 ModelRegistry 加上装饰器,在运行期完成注册,做法更接近 PyTorch 原生习惯,代价是模块数膨胀后的导入开销。llama.cpp 是 C++ 实现,编译期就把架构分支链固定下来,没有运行期注册成本,但代价是增加架构必须重新编译。
从工程后果看:
- 静态表会与装饰器漂移:TensorRT-LLM 用
test_lazy_model_zoo.py校验两者一致,vLLM 也用测试保证生成表不过期。这是静态表方案的必备配套,否则修改装饰器却不改表会导致「这个模型明明实现了,但AutoModel说找不到」。 - 装饰器方案在多入口下容易重复注册:特别是当模型类既提供
ForCausalLM又提供视觉编码器时,需要额外的装饰器(TensorRT-LLM 的register_vision_encoder)与「按类记录已注册架构」的机制(_registered_architectures属性)来区分。
分化线二:后端抽象的对象是什么
vLLM 的 AttentionBackend 枚举背后,有一层按 (模型、硬件、配置) 选择实现类的分派;SGLang 在部分注意力后端上与 vLLM 复用内核,形态相近;llama.cpp 的注意力几乎只有一个统一实现(flash-attn 的几种变体由运行参数选择,而不是另一套后端)。
TensorRT-LLM 的独特之处在于它把「后端」分成了两层:
- 外层后端:VANILLA / TRTLLM / FLASHINFER(字符串,用户可配);
- 内层内核:TRTLLM 后端对应 trtllm-gen 的各个版本 FMHA;FLASHINFER 后端再在 fa2 / fa3 / cudnn / trtllm-gen 之间选。
这样做的好处是:用户只需要记住「用原厂的还是用 FlashInfer 的」,具体内核的调优(比如 FP4 KV cache 支持哪一代 SM)由内层自己决定。代价是内层选择对用户不透明——用户可能配置了 attn_backend=FLASHINFER,以为用的就是 FlashInfer 原生内核,实际内层可能走的是 trtllm-gen(flashinfer_backend 默认虽为 fa2,但源码对 CUDA Graph 下 head_dim > 128 的分支做了单独的 trtllm-gen 处理)。
DeepInfer 作为对照,在「后端」维度的划分方式是 Platform 抽象(CUDA / Ascend),注意力的实现随模型族走,不做多后端分派。原因在于它的目标是特定硬件族上的一体化优化,而不是做一个通用后端注册体系。DeepInfer 系列第三十三篇「Platform 抽象与 CUDA/Ascend 双后端」拆过它的做法——与 TensorRT-LLM 的注意力后端在职责上是对偶的,一个是「算子层多实现」,一个是「平台层多实现」。
一个具体的部署场景:从 HF 配置到一次 decode
把上面的内容揉成一个具体场景:部署一个 DeepSeek 风格的 MLA + 稀疏注意力模型,希望用 FP8 KV cache 和 EAGLE 风格投机解码。
第一阶段:配置解析
AutoConfig.from_pretrained读config.json,architectures[0](比如"DeepseekV3ForCausalLM")被记到pretrained_config.architectures。TorchLlmArgs校验:kv_cache_config.dtype="fp8"、attn_backend缺省为TRTLLM、speculative_config启用。ModelConfig.__post_init__:若model_type属于自动稀疏类型,则补CSA2SparseAttentionConfig,并按 checkpoint 里的index_topk/index_n_heads解析几何。AutoModelForCausalLM.from_config→_resolve_class→ 若配置里有draft_vocab_size,先走 EAGLE 重写 →get_registered_model_class→_ensure_model_registered按需导入modeling_deepseek_v3→ 返回类。MetaInitMode下构造模型树;skip_create_weights_in_init=True,所有Linear先建空壳。__post_init__:逐层套量化配置、逐层create_weights,然后把权重一次性装上(真正加载发生在权重装载阶段,本文只关心构造期留下的空壳结构)。
第二阶段:注意力层构造
- 每层
Attention.__init__把自身弱引用写进config.extra_attrs["attn_layers"]。 sparse_attention_config.to_sparse_params(...)得到CSA2Params,get_sparse_attention_hooks挂上稀疏 hook。get_attention_backend("TRTLLM", sparse_params=...)→get_trtllm_sparse_attn_attention_backend(sparse_params),返回稀疏版 TrtllmAttention 类。support_fused_rope()为真则保留 RoPE 融合;kv_cache_compression_config.changes_physical_kv_length为真则强制关闭。Llama/Deepseek的 layer 里attention_chunk_size依据attn_backend、SM 版本、spec_config决定是否生效(非 TRTLLM 后端直接关掉)。
第三阶段:首次前向与后续 decode
create_attention用 MLA 参数构造TrtllmAttention实例;support_mla()的断言保证后端有能力。AttentionMetadata.prepare()从attn_layers表里按层号找对象、把块句柄转成块表/页表。- 稀疏 hook 提供 top-k 块选择,注意力内核只在那批块上计算。
- 每步 decode 只把新的 K/V 写进分页缓存,读回的是已经选好块的稀疏 KV。
在这个场景里,配置层的每一项限制都是一个显式报错或一次显式降级——例如 FP8 KV + 稀疏 + 投机,混在一起时只要有任何一项后端不支持,validate_* 就会在 LLM(...) 构造时报错;而不是跑到第 3 个 decode step 才出现 assert 失败。
设计上值得注意的几个取舍
取舍一:懒加载注册表的复杂度成本
PEP 562 + 静态表 + 注册日志回放,这套机制比简单的 eager 导入复杂得多。它的复杂度集中在三个地方:异常翻译、内置/外部优先级、注册回放。这三处都属于「一旦写错,症状极难排查」:
- 异常翻译写错 →
hasattr吞掉真实错误; - 优先级写反 → 内置实现覆盖用户自定义;
- 注册回放缺失 → 外部模型加载后内置模型「消失」。
所以 TensorRT-LLM 在每个关键位置都写了注释解释「为什么」,并且在 _arch_index.py 末尾把三条纪律写成文字而不是让读者从代码里猜。对一个注册系统来说,文档和注释比代码更重要,因为「什么时候会被调用」很难从函数名看出来。
取舍二:能力开关用类方法
support_* 用 @classmethod 而不是实例方法,好处是可以脱离实例探测;坏处是能力声明与真实能力之间可能出现漂移——如果某个后端的内核实现在一次版本升级里新增了 FP4 KV cache 支持,而 support_fp4_kv_cache() 没有同步改,上层会误判。
一种改进是用同样的方式:像 _arch_index.py 那样用一张静态的能力表,配一个覆盖测试校验每个后端的 support_* 与测试用例一致。TensorRT-LLM 目前的做法是依赖 create_attention 里的 assert 兜底——能力声明为真但实际不支持时,assert 会失败,而不是静默出错。这是一种「宁可启动失败也不要错误输出」的选择。
取舍三:模型特判散落在配置层
ModelConfig.__post_init__ 里对 deepseek_v41 的默认稀疏配置、对 is_encoder_decoder 的自动判定、以及在 modeling_* 里对 attn_backend != "TRTLLM" 的专门处理(Llama4Attention 里的分块注意力关闭),都属于「模型特判」。这类代码分散在多个文件里,阅读时很难一次性看全。
相比之下,DecoderModelForCausalLM.get_model_defaults 提供了另一种可能性:让每个模型类集中声明自己的默认值,比如「我不支持 KV cache 块复用」「MoE 后端应该自适应」。但这套机制目前只覆盖部分场景(例如 DeepSeek 的稀疏默认值仍写在 ModelConfig 里而不是 get_model_defaults 里)。从工程角度看,把所有模型特有默认值收敛到模型类里是更好的方向,因为「一个模型的特殊之处」放在实现它的文件里,维护时不需要全局搜索。
取舍四:静默回退的范围
get_attention_backend 在遇到未知名字时回退到 TRTLLM 并只打一条 warning。这是一个典型的「向后兼容优先」选择——用户从旧版本升级,旧的配置值可能已经不在列表里,静默回退保证服务能起来。但代价是问题被掩盖。
实际上,在 llm_args 层面对 attn_backend 做了更严格的检查(例如 validate_mixed_precision_kv 里明确要求 TRTLLM/FLASHINFER)。如果用户配置了 attn_backend="foo" 而没有启用混合精度 KV,那么 validate_* 不会拦;到了 get_attention_backend 才回退。这种情况下服务能起来但用的不是用户想要的后端——一个不易察觉的配置漂移。
更稳妥的做法是在配置校验里加一条「attn_backend 必须在已知集合里」的显式检查,让回退只保留在「旧版本遗留值」这一明确场景下。
与其他篇目的衔接
本篇拆的注册与后端选择,是后续所有涉及注意力后端代码的前置知识。如果读第 6 篇(prepare() 内部)时不清楚「谁把 attn_layers 表建起来的」,本篇第 3 节回答了;如果读第 7 篇(KV 内存布局)时不清楚 kv_layout 从哪里来,本篇第 5 节回答了;如果读 TensorRT-LLM 源码完全拆解(二十二):EAGLE-3 一体式草稿 时不清楚 EAGLE3 前缀是哪里加上去的,本篇第 2 节回答了;如果读第 9 篇(KV 压缩)时不清楚 RoPE 融合为何会在压缩开启时被关掉,本篇第 3 节回答了。
反过来,读完整篇如果还想继续深入,下一篇将讨论PyTorchModelEngine 与模型模块树的关系:模型模块树是怎么被封装进 model engine 的、model engine 在每一步如何把调度器的输出翻译成模型树的一次前向、以及模型树里的 prologue / epilogue 是怎么被接上的。这一篇已经在第 5 篇(输入组装)里打了基础,但侧重于模型的装配骨架,与本篇关注「单个模块的构造与选择」不同。
小结
- TensorRT-LLM 的 PyTorch 后端把「配置 → 内核」从一次离线编译变成了加载期的一系列运行时分派,涉及三层:模型分派、模块构造、后端选择。
- 模型注册使用「静态索引
MODEL_ARCH_TO_MODULE+ 运行期装饰器注册MODEL_CLASS_MAPPING」的双层结构,PEP 562 的__getattr__实现属性级惰性导入,get_registered_model_class在查询前先确保提供者已导入。 - 内置实现只填空槽,外部注册(
--custom_module_dirs)优先;每次注册被记录进_MODULE_REGISTRATIONS以便重建时回放——这是「装饰器副作用」与「可重建数据结构」生命周期不一致时的标准解法。 AutoModelForCausalLM._resolve_class有三条特例分支:mm_encoder_only(视觉编码器)、EAGLE-3 草稿前缀重写、modeling_v2 目标覆盖。每条特例都有相应的优先级注释。from_config打开skip_create_weights_in_init以支持混合量化:先搭空壳、再套量化配置、最后统一建权重;MetaInitMode用TorchDispatchMode把构造期的张量放到meta设备,削减启动期 CPU 峰值显存。- 每个 decoder layer 的
Attention.__init__会做四件事:登记attn_layers弱引用表、拆分输出投影的 TP 映射、读后端配置并挂稀疏 hook、决定 RoPE 融合与分块注意力。 - 注意力后端基类只吃几何量(
num_heads、head_dim、num_kv_heads、quant_config),动态信息全部走metadata与forward_args。能力用support_*类方法声明,配置层用llm_args的model_validator做兼容矩阵前置校验。 get_attention_backend是四分支分派:VANILLA / TRTLLM / FLASHINFER(不可用时静默回退 TRTLLM),稀疏模式通过sparse_params叠加成二维组合。- 横向对比看,五个框架在注册表形态(静态表 vs 运行期装饰器)、惰性导入方式、后端抽象层次上各有取舍;TensorRT-LLM 的「外层后端 + 内层内核」双层结构是它相对独特的地方。
参考资料
- TensorRT-LLM GitHub 仓库(PyTorch 后端源码,
tensorrt_llm/_torch/models/与tensorrt_llm/_torch/attention/backends/) - TensorRT-LLM 官方文档
- TensorRT-LLM 官方 Overview 文档(架构与 PyTorch 原生设计说明)
- PEP 562:Module
__getattr__and__dir__ - PyTorch 源码
torch/utils/_python_dispatch.py(TorchDispatchMode实现) - FlashInfer 论文(arXiv 2501.01005)
- FlashInfer GitHub 仓库
- FlashAttention 论文(arXiv 2205.14135)
- vLLM GitHub 仓库(模型注册表
vllm/model_executor/models/registry.py对照参考)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



