


一条被中断的请求:vLLM 前端、EngineCore、调度器与五个推理框架的取消链路
一条请求已经进入推理引擎,用户关掉了网页,或者业务侧的 agent 超时,主动调用 /abort 接口。这条请求还会不会继续吃 GPU?它已经占用的 KV 块什么时候回到空闲队列?它正在跑的那一步前向会不会被中途打断?被取消的请求在输出侧还能看到什么?
这些问题看似琐碎,却直接决定了推理服务的”取消税”:如果一次断开不能迅速止住,长排队队列里会积累大量没人要的请求;如果 KV 回收有泄漏,几轮会话之后显存就会被”幽灵请求”吃掉;如果取消时机选得不对,正在执行的那一批会被打断、被迫重算。
五个主流推理框架都有取消能力,但实现路径差异很大:有的靠 Python 的协程取消,有的靠 HTTP 客户端探测,有的靠显式 abort 消息穿过进程边界,有的靠引擎主循环里的一个”取消队列”。本篇沿着 vLLM V1 的源码把完整链路拆开,再把 SGLang、TensorRT-LLM、llama.cpp 和 DeepInfer 的对应设计放在一起对照。
术语与前置
把这篇用到的几个概念先固定下来,后面不再重复。
请求 ID 与子请求。 推理框架里一条 HTTP 请求往往不是一条引擎请求。n 采样(n>1)、束搜索、投机解码草稿都可能让一次调用在引擎里产生多条”子请求”。vLLM 用两层 ID 区分:外部请求 ID(客户端用来轮询的那一个)和内部请求 ID(EngineCoreRequest.request_id)。取消时拿到外部 ID,要展开成它名下所有内部 ID。
KV 块的引用。 自 PagedAttention 提出以来,KV Cache 被切成分页块,请求持有块号列表,块由块管理器做引用计数。请求结束不等于块立刻可复用:P/D 分离场景下,KV 可能正在被远端读取,或者本地正准备写出去。请求释放和块释放之间存在一个可选的延迟窗口,这是本篇后半部分的重点。
取消和出错是两件事。 取消是调用方主动放弃,结果是 FinishReason.ABORT;出错是引擎侧异常或请求校验失败,结果是错误响应。两者在回收路径上最终汇合,但在调度器的状态机里有不同的来源。分开看,才能理解为什么有些框架会在输出处理器里”再补一刀”。
为什么不能直接杀线程。 GPU 侧一次前向是由多卡、多个进程、几十层算子组成的,无法像操作系统的线程那样从一个点强制终止。框架能够做的,是在”步”的边界上停止调度这条请求、让它不再进入下一批,并妥善处理已经写在显存里的 KV。这也是所有框架取消都表现为”下一次调度时消失”而不是”立刻消失”的根本原因。
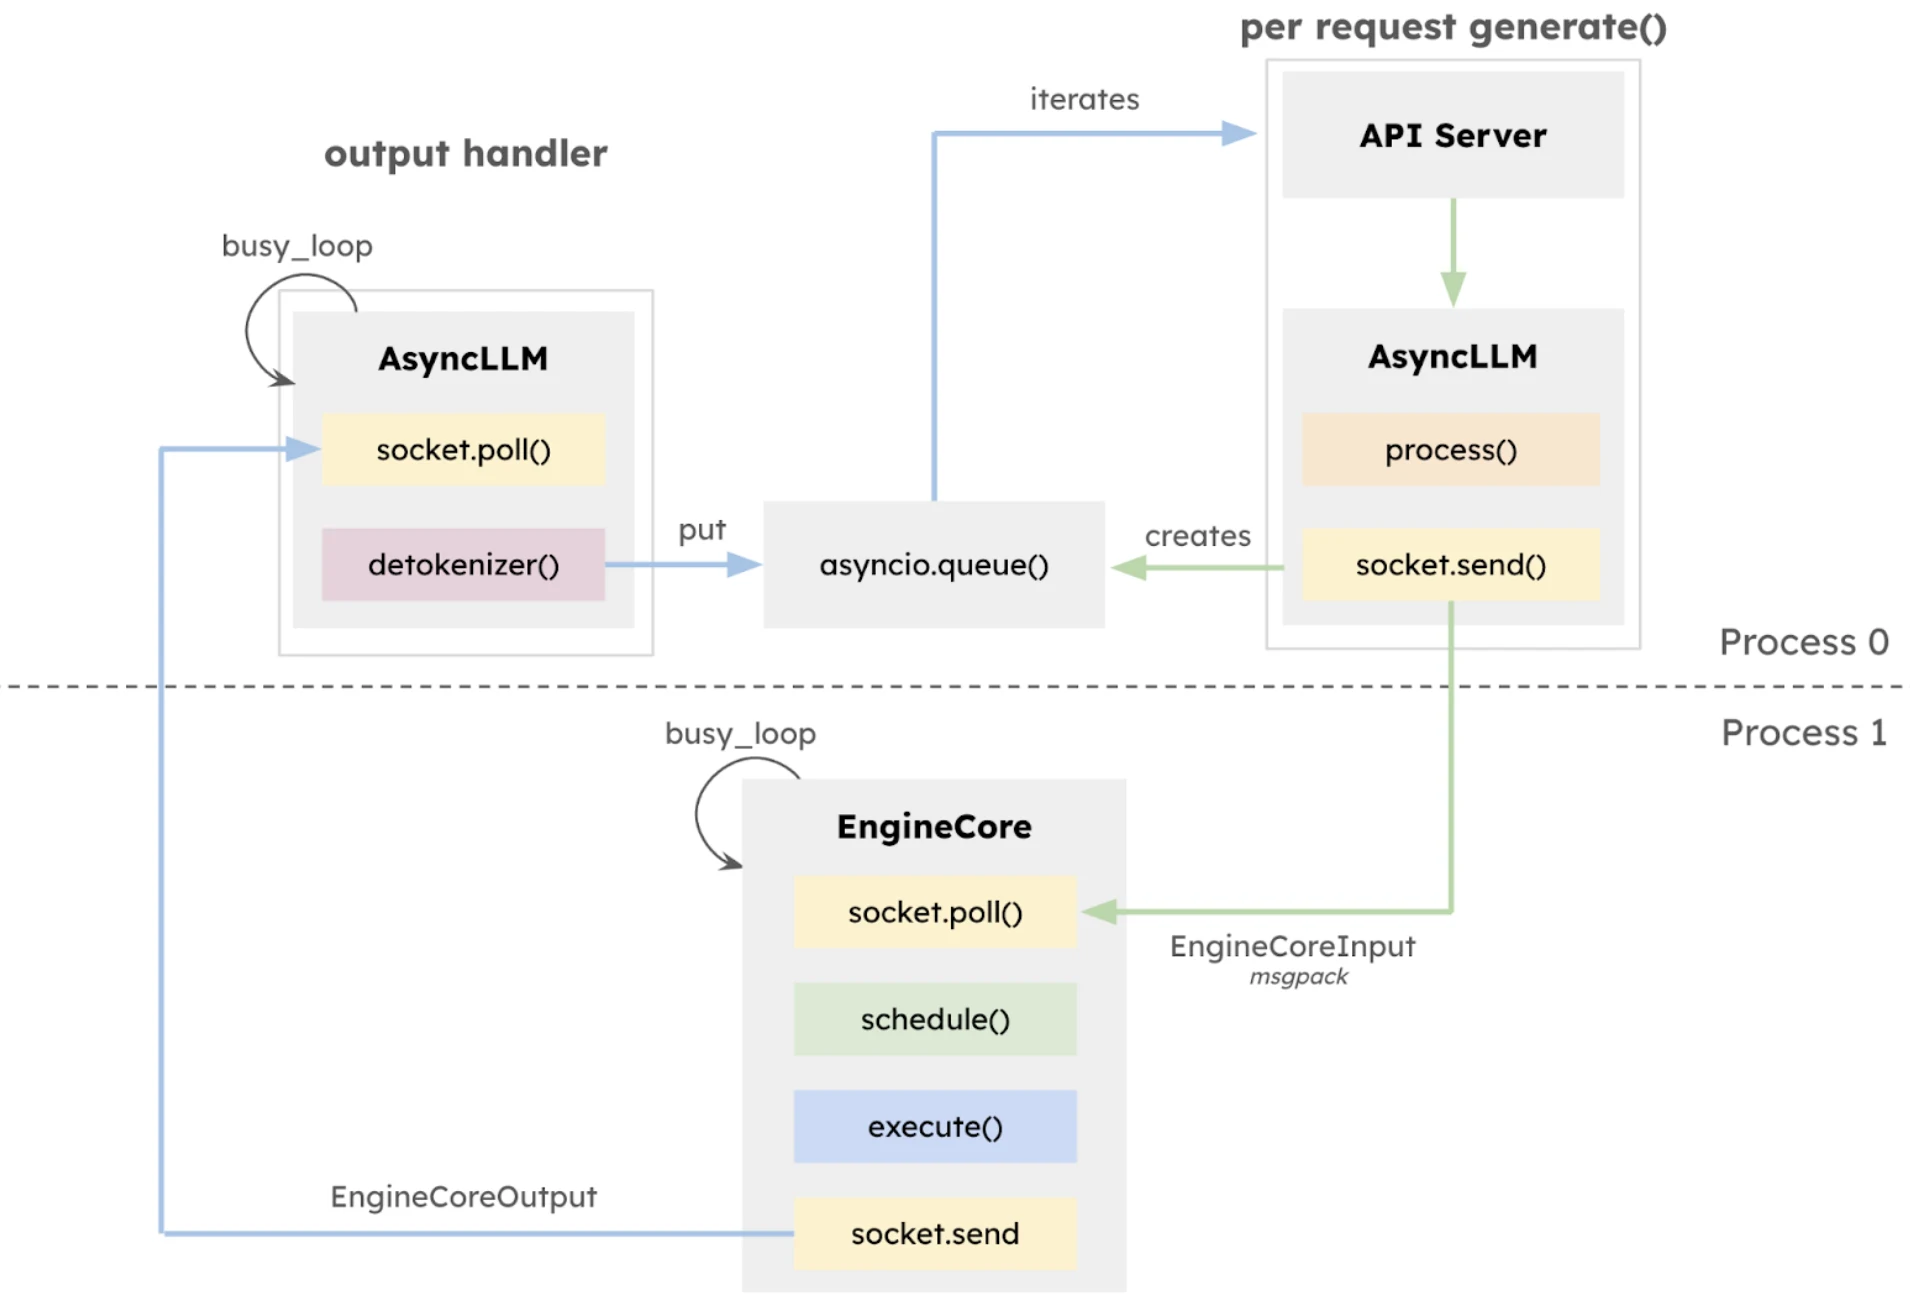
上图来自 vLLM 官方 V1 架构说明。取消命令之所以要跨进程,是因为 API Server 进程只持有 HTTP 连接和请求状态,引擎进程持有调度器与 KV 块。两者之间是一条消息队列,这条队列决定了取消从”被侦测到”到”被真正执行”要经过几跳。
请求的三种”还活着”的方式
要讲清楚取消,先要知道一条请求在引擎里可能处于哪些阶段,因为每个阶段的取消代价不同。
| 阶段 | 请求在哪里 | 取消时需要做什么 | 已占用资源 |
|---|---|---|---|
| 排队等待 | 调度器 waiting 队列 | 从队列移除,不做前向 | 通常已分配部分块(前缀命中或预分配) |
| 分块预填中 | running 队列,只跑了一部分 prompt | 停止调度剩余分块 | 已写入的部分 KV |
| 解码中 | running 队列,每步产出一个 token | 下一步不再调度 | 全部 KV |
| 等待远端 KV | WAITING_FOR_REMOTE_KVS | 标记待释放,等待载入结束 | 已分配但未写入的块 |
| 前端尚未派发 | API Server 的输出处理器 | 不必通知引擎 | 无 |
| 已结束、块未回收 | 调度器 finished_req_ids 集合,请求已移出字典 | 不能再取消,只能等回收 | 块仍归请求所有 |
最后一行是关键:一条请求”结束后”并不马上从调度器的字典里删除。P/D 分离的 KV 传输、编码缓存等场景会让它短暂停留在这张表里。取消一个已经结束的请求应当被当作空操作,而不是报错。
状态机的样子
vLLM 把请求状态定义成一个整数枚举,并且用一个很巧妙的约定简化判定:只有排在 PREEMPTED 之后的状态才算”已结束”。
class RequestStatus(enum.IntEnum): WAITING = enum.auto() WAITING_FOR_STRUCTURED_OUTPUT_GRAMMAR = enum.auto() WAITING_FOR_REMOTE_KVS = enum.auto() WAITING_FOR_STREAMING_REQ = enum.auto() RUNNING = enum.auto() PREEMPTED = enum.auto() # Note: anything after PREEMPTED will be considered # as a finished status. FINISHED_STOPPED = enum.auto() FINISHED_LENGTH_CAPPED = enum.auto() FINISHED_ABORTED = enum.auto() FINISHED_IGNORED = enum.auto() FINISHED_ERROR = enum.auto() FINISHED_REPETITION = enum.auto()
@staticmethod def is_finished(status: "RequestStatus") -> bool: return status > RequestStatus.PREEMPTEDis_finished 写成了 status > PREEMPTED。这要求所有”结束态”必须排在 PREEMPTED 之后。好处是新增一个结束原因时不需要同步修改任何判定函数;代价则是枚举顺序本身成了不变量,插入新状态的位置必须小心。FINISHED_ABORTED 就是取消对应的状态,它和 FINISHED_STOPPED、FINISHED_LENGTH_CAPPED 走的是同一条回收路径,只在最终 FinishReason 映射上有区别。
侦测:前端怎样知道”用户走了”
取消的起点在前端。前端必须回答两个问题:什么时候侦测,以及侦测到之后向谁报告。
协程取消是 vLLM 的主要信号
FastAPI 的流式响应本质上是一个异步生成器。客户端断开 TCP 连接后,服务器端的 ASGI 框架会在下一次往生成器里写数据时抛异常,这个异常让整个生成器任务被取消。于是 vLLM 的 generate() 只要在流式循环里有一次 yield 落到断开的连接上,就会收到 asyncio.CancelledError。非流式请求同理,最终调用方也会以同样的方式退出。
vLLM 在 generate() 的最外层用 except 捕获几类异常并统一执行取消:
# If the request is disconnected by the client, generate() # is cancelled or the generator is garbage collected. So, # we abort the request if we end up here. except (asyncio.CancelledError, GeneratorExit): if q is not None: await self.abort(q.request_id, internal=True) if self.log_requests: logger.info("Request %s aborted.", request_id) raise
# Engine is dead. Do not abort since we shut down. except EngineDeadError: ...这里有三处值得停一下。
第一,GeneratorExit 也在捕获之列。生成器被垃圾回收时抛出的就是这个异常,而不仅仅是被 cancel()。这意味着即使上层某处忘了取消任务,只要生成器对象被 Python 回收,取消仍然会生效。这是一个非常可靠的兜底。
第二,EngineDeadError 被明确排除。引擎已经死了,再去给一个死掉的进程发 abort 没有意义,反而可能卡在队列上。所有”引擎不可用”的路径都跳过取消,只有”引擎活着但请求不该继续”的路径才取消。
第三,捕获了 VLLMClientError、GracefulHTTPError、GenerationError 这类请求校验或准入错误。它们的注释解释了原因:暂停中的引擎可能只拒绝了同一次调用里的一个子请求,其他子请求还在跑,必须一并回收。这体现了”外部 ID 展开”的必要性。
SGLang:轮询断开
SGLang 的信号来源不一样。它在等待服务器状态的循环里设置一个超时,超时后调用 request.is_disconnected() 主动探测:
if request is None: # Engine requests have no HTTP client to poll for disconnects. await state.event.wait() else: await asyncio.wait_for( state.event.wait(), timeout=_REQUEST_STATE_WAIT_TIMEOUT ) except asyncio.TimeoutError: if ( request is not None and not obj.background and await request.is_disconnected() ): # Abort the request for disconnected requests (non-streaming, waiting queue) self.abort_request(obj.rid) raise ValueError( f"Request is disconnected from the client side (type 1). Abort request {obj.rid=}" ) continue和 vLLM 的协程取消相比,轮询有三个隐含差别。其一,取消只在”等待超时”时被侦测,也就是大约每个超时周期才可能发现一次,队列里的请求不会在断开那一刻立刻被标记。其二,request is None 的分支说明了引擎内发起的请求没有 HTTP 客户端可探测,只能被动等待结果。其三,obj.background 为真时不做探测,因为这类请求本来就是”提交后不管”的,连接断开是正常行为。
SGLang 还提供了两条显式取消通道,适合网关层主动清理:
- 流式响应结束时返回的
StreamingResponse带一个background任务,create_abort_task会先await asyncio.sleep(2),再对仍存活的状态调用abort_request。这个 2 秒的窗口给正常结束留出”收尾已到达”的余地,避免把正常完成的请求误判为断连。 - 一个独立的 HTTP 端点
POST /abort_request,接受AbortReq结构,支持rid与abort_all两种粒度。这允许路由或负载均衡层在客户端断开后仍然”记得”该请求 ID 并代为取消,即使 tokenizer manager 侧的探测漏掉了它。
llama.cpp:HTTP 层的关闭函数
llama.cpp 的 server 把”连接是否关闭”抽象成一个可调用的判断函数。HTTP 层从底层 httplib 拿到 is_connection_closed,打包进 server_http_req 的 should_stop 字段,交给处理器:
server_http_req_ptr request = std::make_unique<server_http_req>(server_http_req{ get_params(req), get_headers(req), req.path, build_query_string(req), req.body, {}, req.is_connection_closed });处理器在等待结果时把 req.should_stop 传给等待接口。对于非流式请求:
if (!stream) { // non-stream, wait for the results auto all_results = rd.wait_for_all(req.should_stop); if (all_results.is_terminated) { return res; // connection is closed }这里的语义是”停止等待”,而不是”停止计算”。连接关闭后,HTTP 线程放弃读结果管道并直接返回,但任务已经在 queue_tasks 里进入 slot。真正让计算停下的是另一条通道:如果部署了 router 与子进程,router 通过标准输入向子进程发送控制指令;子进程里的控制任务会按 control_cmpl_id 找到对应 slot,并调用它的响应通道 cancel()。
} else if (slot->rt) { // a cancel acts now, everything else runs after what is already queued if (task.params.control_action == SERVER_CONTROL_ACTION_RESPONSE_CANCEL) { slot->rt->cancel(); } else { slot->rt->push({...}); }注释”a cancel acts now”点明了设计取舍:取消这类控制指令不走正常排队的路径,而是立即作用于 slot 的响应通道,让正在生成的那一步在下一个 token 边界上看到”不再需要输出”。
执行:取消命令如何穿过进程边界
侦测到之后,取消要交给真正持有调度器的那一侧。
vLLM:abort 要打两份工
vLLM 的 AsyncLLM.abort() 并不只发一条消息。它先整理输出处理器里的本地状态,再把内部 ID 列表交给引擎:
async def abort( self, request_id: str | Iterable[str], internal: bool = False ) -> None: """Abort RequestId in OutputProcessor and EngineCore.""" request_ids = ( (request_id,) if isinstance(request_id, str) else as_list(request_id) ) all_request_ids = self.output_processor.abort_requests(request_ids, internal) await self.engine_core.abort_requests_async(all_request_ids)
if self.log_requests: logger.info("Aborted request(s) %s.", ",".join(request_ids))internal=True 是给生成器内部的调用用的,这时传进来的已经是内部 ID;而外部调用(例如业务侧通过 LLM 对象取消)传外部 ID,由输出处理器展开。
为什么必须先在输出处理器里处理?因为输出处理器是唯一知道”外部 ID 到内部 ID”映射的组件。如果跳过它,引擎会收到一个不认识的 ID,这条取消就落空了,而且前端对应的等待队列永远不会被唤醒。
输出处理器:展开、回收、投递最终输出
abort_requests 做三件事,每一件都对应一个容易踩的坑。
internal_req_ids = [] for request_id in request_ids: if internal: # Internal ID - this may be a parent request internal_req_ids.append(request_id)
# Remove internal ID from the external->internal mapping if req_state := self.request_states.get(request_id): external_req_id = req_state.external_req_id internal_ids = self.external_req_ids[external_req_id] internal_ids.remove(request_id) if not internal_ids: del self.external_req_ids[external_req_id] elif internal_ids := self.external_req_ids.pop(request_id, []): # External ID - abort all requests in the external->internal mapping internal_req_ids.extend(internal_ids)第一件是展开。传入外部 ID 时,external_req_ids.pop() 把整组内部 ID 取出来;传入内部 ID 时,只从组里删掉这一个,组空则整条映射删除。
第二件是清理并产出终态输出:
for request_id in internal_req_ids: req_state = self.request_states.pop(request_id, None) if req_state is not None: self.lora_states.request_finished(request_id, req_state.lora_name) request_ids_to_abort.append(request_id) # Produce final abort output. if req_state.queue is not None and ( request_output := req_state.make_request_output( new_token_ids=[], ... finish_reason=FinishReason.ABORT, stop_reason=None, ... ) ): req_state.queue.put(request_output)这里往等待队列里塞了一条 finish_reason=ABORT 的终态输出。它保证了 generate() 的消费循环即使没收到引擎侧的结束消息,也能正常退出而不是永远阻塞。这正是 vLLM 注释”both OutputProcessor and EngineCore handle their own request cleanup”的含义:两侧各自负责自己那份状态,不依赖对方一定成功。
同时,LoRA 槽位在这里被释放。多 LoRA 服务中,adapter 是有容量上限的,取消不释放会让租户后续请求一直卡在”无可用槽位”。
第三件是父请求递归:如果被取消的是 n>1 的父请求,子请求也要逐一取消,并收集它们的内部 ID 一并交给引擎。漏掉这一层,子请求就会在引擎里继续跑,而前端已经没有任何人消费它们的输出。
一个细节是 req_state is None 的情况:输出处理器里已经没有这条状态,可能因为它已经结束、也已经从表里移除。这时只是跳过,不报错。这说明取消必须是幂等操作。
引擎侧:一个专用取消队列
取消消息到达 EngineCore 后进入 aborts_queue。真正执行是在主循环里两个时点:
def _process_aborts_queue(self): if not self.aborts_queue.empty(): request_ids = [] while not self.aborts_queue.empty(): ids = self.aborts_queue.get_nowait() # Should be a list here, but also handle string just in case. request_ids.extend((ids,) if isinstance(ids, str) else ids) # More efficient to abort all as a single batch. self.abort_requests(request_ids)abort_requests 只是把请求列表交给调度器:
def abort_requests(self, request_ids: list[str]): """Abort requests from the scheduler.""" # TODO: The scheduler doesn't really need to know the # specific finish reason, TBD whether we propagate that # (i.e. client-aborted vs stop criteria met). self.scheduler.finish_requests(request_ids, RequestStatus.FINISHED_ABORTED)注意那条 TODO:调度器并不知道这次结束是”客户端走了”还是”引擎暂停”,它只知道”结束原因 = ABORTED”。这在日志和指标上会造成一个盲区:运维看到的 aborted 计数包含暂停、拒绝、断连等多种来源。理解这一点,在排查”abort 数很高但没人主动取消”时非常重要。
取消的执行时点:为什么在采样之后、更新之前
step() 里 _process_aborts_queue() 的位置值得单独讨论:
with self.log_error_detail(scheduler_output): model_output = future.result() if model_output is None: model_output = self.model_executor.sample_tokens(grammar_output)
# Before processing the model output, process any aborts that happened # during the model execution. self._process_aborts_queue() engine_core_outputs = self.scheduler.update_from_output( scheduler_output, model_output )取消处理放在当前批次已经算完、但还没回填到调度器之前。为什么要等到算完?
如果在中途把请求从 running 里拿掉,当前这一步已经发出的 GPU 工作会写 KV 到一个已经不在 running 列表里的请求上,而随后输出回填需要遍历调度时的请求列表。更麻烦的是投机解码与结构化输出:它们的回填依赖”这一步调度了什么”的记录。先把本步完整回填,再统一”结束请求并回收”,可以保证回填逻辑不受取消影响。
这与 llama.cpp”取消在下一个 token 边界生效”是同一个思想,只是粒度更粗:vLLM 以整个前向步为边界。代价是取消有最多一个 step 的延迟;收益是正确性和代码简单。
step_with_batch_queue()(多批次流水线执行)里同样的注释出现在阻塞拿到结果之后、回填之前。也就是说,无论是一步一批还是一步多批,取消都只在”一个批次完成时”被批量处理:
# Block until the next result is available. future, scheduler_output, exec_model_fut = batch_queue.pop() with self.log_error_detail(scheduler_output): model_output = future.result() ... # Before processing the model output, process any aborts that happened # during the model execution. self._process_aborts_queue() engine_core_outputs = self.scheduler.update_from_output( scheduler_output, model_output )一个容易被忽视的细节是开始阶段的清空:
if self.input_queue.empty(): # Drain aborts queue; all aborts are also processed via input_queue. with self.aborts_queue.mutex: self.aborts_queue.queue.clear() ...引擎完全空闲时,取消队列会被清空而不是逐个处理。原因在于这些取消此刻已经没有资源可回收,并且所有 abort 消息实际上也以客户端请求的形式进入了输入队列,会在空闲唤醒后被处理。这个约定把”空闲时取消”与”忙碌时取消”分开,避免空闲循环被无意义的处理反复唤醒。
调度器:真正回收块的地方
走到调度器时,取消变成一次普通的”外部结束请求”,finish_requests() 的文档写得很直接:例如客户端断开时,API Server 会中止请求。
它分成两遍:先收集并一次性从各队列删除,再逐个设置状态并释放。第一遍用批量删除而不是逐个删除,是为了避免 O(n²) 的链表操作——长队列里一次取消一百条请求时差别明显。
第二遍里有两段值得细看。
for request in valid_requests: delay_free_blocks = False if request.status == RequestStatus.WAITING_FOR_REMOTE_KVS: # A deferred load never started, so it will not report done. delay_free_blocks = ( self.deferred_loads.pop(request.request_id, None) is None and request.request_id not in self.finished_recving_kv_req_ids ) self.finished_recving_kv_req_ids.discard(request.request_id) self.failed_recving_kv_req_ids.discard(request.request_id)
request.status = finished_status self._free_request(request, delay_free_blocks=delay_free_blocks)延迟释放:取消一个正在等 KV 传输的请求
WAITING_FOR_REMOTE_KVS 是 P/D 分离里解码实例排队等远端 KV 的状态。取消它时,块能不能立即释放取决于一个三层判断:
- 如果它是延迟载入(deferred load,调度器注册了但还没真正开始发起的载入),
deferred_loads.pop()能拿到条目,说明载入从未开始,不会有人再来使用这些块,可以立即释放。 - 如果它已经在传输中,但
request_id已经出现在finished_recving_kv_req_ids里,说明载入刚刚完成、结果还没被本轮处理,块里已经有有效数据,可以立即释放。 - 其余情况,载入仍在进行,
delay_free_blocks = True,块要等到连接器的完成回调才会被放回。
这个判断的直觉是:块是否释放完全取决于”还有没有在飞的操作会访问它”。一个正在被远端 DMA 写入的块,如果此刻被登记为空闲并被下一次分配复用,远端数据就会覆盖别人的 KV,造成难以复现的串话。
同时它把这条请求从”已收完""已失败”两个集合里剔除,避免后续轮次重复计数。这类”集合里的残留”在取消路径上是最常见的泄漏源。
_free_request 与连接器契约
立即释放块之前,_free_request 依次触发若干钩子:
def _free_request( self, request: Request, delay_free_blocks: bool = False ) -> tuple[dict[str, Any] | None, dict[str, Any] | None]: assert request.is_finished()
if self.aux_output_connector is not None: self.aux_output_connector.request_finished(request) self._inflight_prefills.discard(request) self._set_kv_fetch_stage(request, None) connector_delay_free_blocks, kv_xfer_params = self._connector_finished(request)
ec_xfer_params: dict[str, Any] | None = None if self.ec_connector is not None: ec_delay_free, ec_xfer_params = self.ec_connector.request_finished(request) connector_delay_free_blocks |= ec_delay_free
self.encoder_cache_manager.free(request) self._pending_encoder_input_ids.pop(request.request_id, None) request_id = request.request_id self.finished_req_ids.add(request_id) ... delay_free_blocks |= connector_delay_free_blocks if not delay_free_blocks: self._free_blocks(request)顺序本身就是设计。连接器钩子必须在块释放前触发,因为连接器需要读取块号(例如把已写入的 KV 推送给解码节点);编码缓存管理器也要在块释放之前释放,因为多模态请求的编码缓存与 KV 块的生命周期需要对齐。
连接器侧的契约在基类注释里写得很清楚:
def request_finished( self, request: "Request", block_ids: list[int], ) -> tuple[bool, dict[str, Any] | None]: """Called exactly once when a request has finished, before its blocks are freed.
The connector may assumes responsibility for freeing the blocks asynchronously by returning True.
Returns: True if the request is being saved/sent asynchronously and blocks should not be freed until the request_id is returned from get_finished(). Optional KVTransferParams to be included in the request outputs returned by the engine. """ return False, None“called exactly once”与”returning True 意味着块由连接器异步释放”这两句话,构成了取消路径上最容易出错的地方。如果连接器返回了 True,块的所有权就转移了;如果连接器因为某种原因没返回 ID,块就永久悬空。框架里对”取消后连接器仍然有在飞任务”的处理(如请求被延迟释放),就是在尽量少地打破这个契约的同时,让用户感知的取消延迟最小。
另外,request_finished 钩子在 FINISHED_ABORTED 下也会被调用,并且可能出现在”从未真正调度过”的请求上。vLLM 为此有一个专门的入口:
async def notify_kv_transfer_request_rejected(self, request_id, kv_transfer_params, ...): """Submit a pre-aborted request so the connector's request_finished hook runs to free any pre-admission KV-transfer resources (e.g. NIXL prefill blocks pinned on the P node).""" request = EngineCoreRequest( request_id=request_id, prompt_token_ids=[0], ... abort_immediately=True, )也就是说,准入阶段就被拒掉的请求,会被包装成一条 abort_immediately=True 的假请求送进引擎,目的只有一个:走完连接器的生命周期钩子,回收预备填节点已经固定的中转块。如果没有这个机制,预填节点会在每次准入拒绝时泄漏一点显存。
收尾:当取消发生在分块预填中间
取消分块预填中的请求时,prefill_stats 已经被记录,但调度器不会再调度剩余分块。需要注意两条不变量:
- 已写入的 KV 必须与块表记录一致,否则前缀缓存后续命中会读到不完整的块。
- 编码缓存与多模态输入列表必须在这里清理,而不是等到下一次请求带着同样的
mm_hash来时才发现状态错乱。
这两点都由 _free_request 中按顺序调用的钩子完成,顺序在取消路径上同样成立,因为它就是所有结束路径共用的唯一出口。
取消的第二个来源:输出处理器主动收回
并非所有取消都来自断连。vLLM 输出处理器在某些时刻会主动追加 reqs_to_abort,回到引擎执行取消:
if req_state.is_prefilling: if streaming_chunk_boundary: ... else: self._finish_request(req_state) if req_state.streaming_input or not engine_core_output.finished: # EngineCore may still have the request: a stop string # was detected here, or an in-flight streaming-input # chunk may re-create the session. reqs_to_abort.append(req_id)这是一个”前端先结束、引擎后清理”的典型场景:停止字符串由前端的分词器检测,而引擎并不知道这个字符串。前端一旦判定结束,就必须确保引擎侧的请求也停下来,否则它还会继续产出 token,白白占着 KV 和算力。
reqs_to_abort 随后在引擎主循环里被批量交给取消队列,与断连取消走同一条执行路径。这一点很重要:这意味着取消路径需要容忍”请求其实已经结束”的情况,也意味着”前端判定结束”与”引擎判定结束”之间存在一个短暂的竞态窗口。窗口内到达的引擎输出会被输出处理器的 req_state is None 分支直接忽略。
SGLang:取消的层次更多
SGLang 的取消链路比 vLLM 多了几层,原因是它的调度器、tokenizer manager 与 disaggregation 服务是分离的。
manager 侧:状态与防重发
abort_request 最先处理的是本地状态:
def abort_request(self, rid: str = "", abort_all: bool = False): # Empty rid would startswith-match every request on the scheduler. if not abort_all and not rid: logger.warning("Ignore abort_request with empty rid and abort_all=False") return state = None if abort_all else self.rid_to_state.get(rid) if not abort_all: if state is not None: if state.abort_sent: return state.abort_sent = True elif get_serving().tokenizer_worker_num == 1: return req = AbortReq(rid=rid, abort_all=abort_all) try: self._dispatch_to_scheduler(req) except BaseException: if state is not None: state.abort_sent = False raise这里有三个值得注意的设计。
空 rid 被拒绝。 调度器用 rid.startswith() 匹配,空字符串会匹配所有请求。如果不加保护,前端的一个 bug 会变成”清空整个服务器在途请求”。
abort_sent 防止重复下发。 断连探测和流式收尾可能同时触发取消,如果两条 abort 都发给调度器,调度器侧的资源回收会被执行两次。状态上的布尔位让第二条静默返回。
回滚 abort_sent。 如果消息没成功投递出去,必须把标记恢复,否则后续真正的取消会被这个”已发送”标记挡住,请求永远无法停止。
abort_all 还会遍历所有状态,把尚未派发的标记为已取消,从而在之后的派发路径上被跳过。
派发前的跳过
_skip_dispatch_if_aborted 是一个”取消先于派发”的拦截器:
if self._skip_dispatch_if_aborted(tokenized_obj.rid): self._cancel_cuda_ipc_features((tokenized_obj,)) return它检查请求的 abort_sent 位且尚未派发。命中时不发往调度器,而是直接在本地走一次 abort 处理。这样做的好处是,被取消的请求不会在调度器的队列里出现再被删除,节省了两处状态转换,也让调度器的日志更干净。对于带有 CUDA IPC 特征的请求,还要额外释放跨进程的共享特征。
_drop_aborted_before_dispatch 则是在批量派发中一次性过滤掉这些请求,并返回它们以便单独发送 abort 输出。
调度器侧:队列、分块、多模态、DP 四个层面
SGLang 调度器的 abort_request 分别处理每个层面:
def abort_request(self, recv_req: AbortReq): if self._deferred_responses: self._abort_deferred_responses(recv_req) if (chunked_req := self.chunked_req) is not None: if recv_req.abort_all or chunked_req.rid.startswith(recv_req.rid): self._pending_chunked_abort_req = chunked_req
# Disaggregation: abort requests still waiting for encoder embeddings (EPD language-only) if self.mm_receiver is not None: self.mm_receiver.abort_waiting_requests(recv_req)
# Delete requests in the waiting queue to_del = [] for i, req in enumerate(self.waiting_queue): if recv_req.abort_all or req.rid.startswith(recv_req.rid): to_del.append(i)分块预填的请求是单独处理的:它不在 waiting 队列里,而是作为”当前分块”的特殊字段存在。取消时不能直接销毁它,因为它的剩余分块可能在别的 rank(DP attention 下)已经收过 token,需要一套撤销。SGLang 把它挂到 _pending_chunked_abort_req,在步骤边界处理,这与 vLLM”步末取消”异曲同工。
等待队列里的请求被就地结束并发送 abort 输出:
for i in reversed(to_del): # Abort method 1: directly pop from the queue req = self.waiting_queue.pop(i) if req.finished_reason is None: req.finish_outside_step(FINISH_ABORT()) self._release_aborted_request(req) self.beam_coordinator.retire_group(req) self.send_abort_output( _make_abort_req(req, finished_reason=recv_req.finished_reason), req )reversed(to_del) 是在遍历期间按索引删除的标准做法。beam_coordinator.retire_group 说明束搜索的分组也要整体退役——同 vLLM 的父请求递归一样,取消一条等于取消一组。
TensorRT-LLM:C++ 执行器里的取消请求队列
TensorRT-LLM 的取消由一个 C++ 请求队列承载。Python 侧的 cancel_request 只是把 ID 入队:
def cancel_request(self, id: int): ... self.executor_request_queue.enqueue_cancel_request(id)真正的处理发生在 _handle_canceled_requests,它由引擎主循环在固定时点调用。逐条判断是否真的可以取消:
def _try_cancel_request(self, request: LlmRequest) -> bool: """Check if a request can be canceled and attempt cancellation if needed.
Returns: bool: True if the request can be canceled (either successfully cancelled or doesn't need cancellation). """ connector = getattr(self, "kv_connector_manager", None) if connector is not None: connector.release_unstarted_prefix_loads(request) if connector.defer_load_termination(request): return False if self._is_preemption_pending(request): return False ...注释写得很清楚:返回 True 表示”可取消”或”无需取消”,返回 False 表示”现在不能取消”。有三类必须推迟:
连接器延迟载入终止。 前置操作还没结束,此刻释放会让连接器在已失效的对象上继续工作。
抢占尚未完成。 源码注释解释:现在结束这条请求会被”撤销”,因为它的页由结束抢占的完成回调释放,之后还会被放回待重算状态。此时挂起取消,让它跟着完成回调一起应用到重新交回的请求上。
注意力数据并行下的 DMA 未完成。 “The generic worker API cannot cancel DMA”——在飞的数据搬运不能被通用 worker 接口停下,只能等 get_finished 确认块不再使用。
无法取消的 ID 会被放回 canceled_req_ids,下次主循环再试。这形成了一个自然的重试机制,而不是抛弃取消。
一次成功取消时的收尾也很有特点:
request.py_kv_transfer_timed_out = False request.finish_by_reason(FinishReason.CANCELLED) request.decoding_iter = request.py_decoding_iter if self._kv_connector_moves_kv: # A request cancelled mid-prefill can have a connector save # outstanding against the blocks it has filled so far, and # the response pass below frees them as soon as it sees this # request finished. self._start_connector_async_save(request)取消时先把”传输超时”标记清掉,避免错误路径误报。然后在连接器模式下,对分块预填到一半的请求发起一次异步保存:既然已经写进来的 KV 是有价值的,就让它走连接器的异步写路径,之后由响应阶段在”看到请求已结束”时释放块。这与 vLLM”连接器返回 True 则延迟释放”是同一个思路的两种写法:一个让连接器接管块,一个让连接器先存再放。
FinishReason.CANCELLED 是 TensorRT-LLM 对用户可见的取消原因;Python 前端据此在生成器里让调用提前结束。
横向前沿:同一个问题,五种答案
| 框架 | 侦测信号 | 命令通道 | 执行时点 | KV 回收 | 特殊处理 |
|---|---|---|---|---|---|
| vLLM V1 | 协程取消 / GeneratorExit | AsyncLLM → EngineCore abort 队列 | 一个前向步完成、回填之前 | 调度器 finish_requests + 连接器钩子,可延迟 | 外部 ID 展开、终态输出、拒绝请求的预中止钩子 |
| SGLang | 状态等待超时后 is_disconnected | AbortReq 消息;HTTP /abort_request | 调度器接收时 / 步边界处理分块 | 就地结束等待队列 + 连接器 / 分层缓存回收 | abort_sent 防重发、派发前跳过、beam 组退役 |
| TensorRT-LLM | 前端调用 cancel_request | C++ 请求队列 enqueue_cancel_request | 主循环 _handle_canceled_requests | finish_by_reason + 连接器异步保存 | 三类不可取消情形放回队列重试 |
| llama.cpp | HTTP 连接关闭(should_stop) | httplib 连接状态 + router 控制指令 | 立即放弃等待 / 控制任务即时作用于 slot | slot 释放,KV 槽位随 slot 回收 | 取消不走排队,异步保存策略视连接器 |
| DeepInfer | 前端调用 | C++ 调度器 abort_sequence | prefill 队首或 decode 开头扫描 | 标记 FINISHED_ABORTED,后续从队列清理 | 多模态未就绪、DP 投票的兜底清理 |
这张表最有信息量的是两列:命令通道和执行时点。
命令通道决定了取消的”延迟来源”。vLLM 与 SGLang 有消息队列,取消要在下一轮输入处理时被看见;TensorRT-LLM 的请求队列同样如此;llama.cpp 的 HTTP 关闭是即时的,但只影响”等待”这一侧,计算侧要靠控制通道;DeepInfer 的调度器直接暴露 abort_sequence(),但把它当作”标记”,真正的删除也发生在调度循环里。
执行时点决定了取消的”代价来源”。所有框架都选择在步边界或调度循环里处理,没有一家尝试中断 GPU 前向。这背后的共同约束是:一次前向的中间状态(部分 KV 写入、投机草稿、结构化输出位掩码)只有在步末才是自洽的,中途停止会让状态机进入不一致的状态。
再看 KV 回收,可以归纳成三种模式:
- 请求结束即释放:最直接,适合没有跨实例 KV 传输的场景。
- 请求结束、块延迟释放:由引擎判断是否有在飞操作,等待回调再释放。vLLM 的
delay_free_blocks、TensorRT-LLM 的挂起重试都属于这一类。 - 请求结束、所有权转移:连接器返回”我接管”,块在其完成回调中释放。vLLM 的
request_finished返回 True、TensorRT-LLM 的异步保存都属于这一类。
三种模式本质上都在回答同一个问题:谁最后知道自己不再需要这块 KV。答案越靠近数据搬运层,取消的延迟就越长,但泄漏风险越低。
取消与 P/D 分离的相互作用
P/D 分离让取消变得复杂,值得单独展开。DistServe 提出的两阶段分离把预填与解码拆到不同机器,KV 需要跨机器传输。下图是 DistServe 论文中的两阶段流水线示意,它说明了为什么请求会在两阶段之间”悬空”:
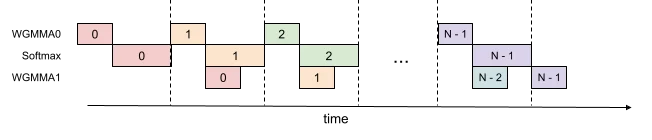
在这种结构下,一条请求可能同时”存在于”两个节点:
- 预填节点已经把 KV 写好,正在把它推给解码节点;
- 解码节点已经登记了请求,正在等待 KV 到达;
- 用户在这一刻取消。
此时如果解码节点直接释放块,预填节点的推送会写进一块”已被别人重新占用”的显存;如果预填节点直接释放块,正在进行的读出会读到未定义数据。vLLM 的处理方式是:
- 解码侧进入
FINISHED_ABORTED,但WAITING_FOR_REMOTE_KVS的块按前述三层判断决定是否延迟释放; - 预填侧在
request_finished中通过连接器得知请求不再需要,取消或完成在飞的推送; - 任何一侧都不依赖对方”一定会”完成,各自有独立的回收路径。
SGLang 的 _try_cancel_request 把这类判断写成了显式的布尔链;TensorRT-LLM 用”放回队列下次再试”;llama.cpp 的 RPC 后端则用整个 slot 的存亡来兜底。不同写法的共同结论是:取消路径必须有”等一等”的选项,否则必然要在”泄漏”和”错误”之间二选一。
取消的代价:该不该立刻取消
把链路拆完后,回到一个工程问题:既然取消本身有代价,是不是应该全部立刻取消?
从源码能看到几种成本:
一次被取消的预填是纯浪费。 已经在 GPU 上跑了若干分块,结果全被丢弃,没有产出任何 token。如果用户只是暂时失去连接(移动网络切换),这种取消就是净损失。
取消消息本身要穿过多个进程。 在高 QPS 场景下,大量 abort 消息与正常请求抢占同一条输入队列,可能会让调度器在短时间内频繁处理取消而降低有效吞吐。
延迟释放期间块仍然被占用。 虽然请求已经不在 running 里,但 KV 块还没回到空闲池,显存水位没有下降。短时间内大量取消,看起来”释放了”,实际可用容量并没有立刻恢复。
指标失真。 前面的 TODO 已经说明:abort 计数混合了多种来源,不能直接当作”用户流失率”。
工程上的常用做法有三类,都能在这几个框架里找到体现:
- 宽限期:SGLang 的流式收尾任务
await asyncio.sleep(2)再取消;llama.cpp 把连接关闭当作”停止等待”,给计算侧留下完成当前步的余地。 - 批量处理:vLLM 的
_process_aborts_queue一次性取出所有取消 ID 交给调度器批量删除;TensorRT-LLM 把无法取消的 ID 放回队列集中重试。 - 优先级:llama.cpp 的控制任务在 slot 上”立即作用于响应通道”,与普通排队的任务区分开。
这些机制说明一个共识:取消不应该是”越早越好”,而应该是”在正确的边界上执行”。真正的目标是让错误的请求尽快停止占用,而不是让停止动作本身尽快发生。
调试取消问题的方法
根据源码结构,可以把排查路径画成一张有向的判断链。
症状一:取消后显存不下降。 先看调度器是否收到 FINISHED_ABORTED;再看连接器 request_finished 是否返回了 True 而没有后续完成回调;重点检查 WAITING_FOR_REMOTE_KVS 的延迟释放判断,尤其是 deferred_loads 与 finished_recving_kv_req_ids 两个集合。如果请求曾被拒绝、从未调度,检查是否走了 abort_immediately 的预中止入口。
症状二:取消后仍产出 token。 这通常意味着取消只到了输出处理器、没到引擎。检查前端的 abort() 是否真的将 all_request_ids 传给了 EngineCore;如果请求已经结束、块仍在回收中,调度器本就不会再调度,此时出现的 token 来自取消前已发出的批次。
症状三:abort 数异常高。 回看 RequestStatus.FINISHED_ABORTED 的几个来源:客户端断开、暂停/拒绝、流式收尾、reqs_to_abort。如果服务里有大量短请求并设置了流式收尾,计数会显著偏高但不代表故障。
症状四:取消一个请求导致另一条请求出错。 最可能是 ID 展开或父子请求处理出错。vLLM 的 external_req_ids、SGLang 的 rid.startswith() 语义、束搜索组退役,是三个需要核对的地方。startswith 尤其危险:如果两条请求 ID 是前缀关系,取消一条会顺带取消另一条。
症状五:取消后下一次请求前缀缓存命中错乱。 检查取消时块表与连接器是否对同一个块做了两次释放;检查延迟释放的块是否在释放前被重新登记为可分配。
与本站其他文章的衔接
本篇讨论的是请求的”退出路径”。与之配套的几篇可以按阅读顺序串起来:
- 请求的入场与准入,可参考 vLLM 源码完全拆解(二十五):请求准入的五层关卡,那里讲了请求从 HTTP 到 RUNNING 的每一层阀门;
- 块的分配与回收账本,可参考 vLLM 源码完全拆解(二十二):BlockPool 与 KV 块的三张映射表;
- P/D 分离下的 KV 传输,可参考 vLLM 源码完全拆解(十七):KV Connector;
- SGLang 的状态机,可参考 SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环;
- DeepInfer 的 C++ 调度器与 abort 标记,可参考 DeepInfer 源码完全拆解(十六):C++ 调度器;
- 调度器的整体节拍,可参考 vLLM 源码完全拆解(三):Scheduler.schedule;
- 异步调度与回填,可参考 vLLM 源码完全拆解(二十九):异步调度——取消若发生在异步调度的”在途批次”里,回填规则会更加敏感。
把这七篇拼起来,一条请求从进入到退出就已经闭环。后续章节将讨论引擎空闲态的进入条件、watchdog 与健康检查如何与取消链路交互。
小结
取消在推理框架里不是一个 API,而是一段跨组件的协议。
第一层是侦测:vLLM 依赖协程取消与生成器回收,SGLang 依赖状态等待的断开探测,llama.cpp 依赖 HTTP 连接状态。不同的信号带来不同的响应延迟。第二层是传递:取消需要先在前端展开为内部 ID,再通过专用队列送到引擎,并在两侧各自产出终态输出。第三层是执行:所有框架都选择在步边界处理,“先算完这一批,再统一结束并释放”,而不是中断 GPU 工作。第四层是回收:块是否立即释放取决于是否还有在飞操作,连接器负责告诉引擎”我还在用”或”我接管了”。
真正的难点在第四层。一旦涉及跨实例 KV 传输,取消就必须在”尽快停止”和”绝不误释放”之间做选择;所有框架最终都选择了”等一等”,并把等待逻辑写成显式可读的状态判断。这一点比任何一行代码都更值得记住。
参考资料
- vLLM V1 AsyncLLM 源码(abort 与断连处理)
- vLLM V1 OutputProcessor 源码(abort_requests 与终态输出)
- vLLM V1 EngineCore 源码(取消队列与 step 时点)
- vLLM V1 Scheduler 源码(finish_requests 与延迟释放)
- vLLM KVConnectorBase_V1 源码(request_finished 契约)
- vLLM V1 架构说明(serving 与 engine 进程边界)
- SGLang tokenizer_manager 源码(断连探测与 abort_request)
- SGLang scheduler 源码(分块预填与等待队列取消)
- SGLang HTTP server 源码(/abort_request 端点与流式收尾任务)
- TensorRT-LLM PyExecutor 源码(_handle_canceled_requests 与不可取消情形)
- llama.cpp server 上下文源码(should_stop 与控制任务)
- DistServe 论文:Prefill 与 Decode 分离推理服务
- PagedAttention 与 vLLM 论文
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



