


KV 块的三张映射表:逻辑块号、物理块号与 KV 槽号如何串成一条 64 位索引
从调度器交出「一块」说起
站在一个推理请求的时间轴上,同一段 KV 数据会被至少四个不同的人称呼,而且每次叫法都略有不同:
- 调度器说「这块归你了」,它手里只有从内存池里借出来的物理块号,并不知道这串块号后来会被写给谁;
- 模型执行器说「这条请求的第 37 个 token 要写 KV」,它手上有请求的行号、token 位置和这张请求的块号序列;
- 写 KV 的内核说「把第 个 token 的输出 scatter 到
slot_mapping[j]」,它只认识一个扁平的 64 位整数,再也不知道块号序列长什么样; - 注意力内核说「请给我页表」,它要么要一整张二维块表,要么要一份 CSR 格式的页索引,取决于它用的是哪套内核接口。
如果这四句话不能严丝合缝地接上,最轻的症状是 decode 读到自己没写过的 KV,最重的症状是开了 CUDA Graph 之后偶发的随机 token 漂移。这篇文章就用 vLLM 的 V1 引擎做主线,把这条链路上的每一张表拆开:它们由谁构建、用什么数据结构、存的是哪个坐标系、什么时候会与另一张表交换。
为什么以 vLLM 为主线?因为这套机制来自 2023 年 Kwon 等人的 PagedAttention,vLLM 是这个抽象最接近「教科书」级别的实现:块表、槽映射、页索引三种物化都在同一份代码里齐备,而且 vLLM 在 V1 架构里把这几张表的管理单独抽成了 BlockTable 类,边界非常干净。其余四个框架只用来做对照——它们对同一个问题给出了不同的记法,正好用来检验「表」与「坐标系」是否被区分清楚。
源码基线为 vLLM 主分支的 vllm/v1/worker/block_table.py、vllm/v1/worker/gpu_model_runner.py 以及 vllm/v1/attention/backends/flash_attn.py 与 flashinfer.py;论文为 vLLM 的 PagedAttention 论文(arXiv 2309.06180)。
先把坐标系列清楚:四种「号」不是同一种东西
讨论映射表之前,必须先钉死它们所在的空间。这四个数在整个推理栈里都叫「id」,但含义完全不可以互换:
| 名字 | 空间 | 取值范围 | 谁分配 | 谁读 |
|---|---|---|---|---|
| 逻辑块号 | 请求内 | 推导得到,不占资源 | CPU 侧构造表时 | |
| 物理块号 | 整个 KV 池 | KV 管理器(allocate_slots) | GPU 内核 | |
KV 槽号 slot | 扁平 KV 缓冲 | 由 与块内偏移算出 | 写 KV 的 scatter 内核 | |
请求行号 row | 常驻批次 | 执行器的 InputBatch | 表的第一维下标 |
这张表里最容易混淆的是物理块号与槽号。物理块号是「第几页」,槽号是「第几个 KV 位置」,后者等价于 ( 是块内偏移)。写 KV 的 scatter 内核接受槽号而不是页号,是因为它想把「按页寻址」这一步省掉:一旦得到扁平偏移,它就是一次普通的张量下标操作。正因为如此,槽号必须同时携带页号与页内偏移这两条信息。
这里有一个常见误解:槽映射的 64 位并不是因为槽数会超过 。 按本节末尾的例子,单层槽数只有 量级,32 位在数值上绰绰有余。vLLM 选 int64 是工程约定:它的 KV scatter 内核把 slot_mapping 声明为 const int64_t* __restrict__,并在内核里直接用它做 / block_size、% block_size 以及「块号 × 块 stride」的指针偏移计算;Triton 侧同样按 int64 load。块号可以用 int32,因为它只作为表内数据被读取;槽号是一段地址运算的起点,用 64 位可以避免「块号 × 块 stride」这样的中间乘积在 32 位下溢出。两张表的数据类型差异,本质上是「数据」与「地址」的差异,而不是容量差异。
先给一个量级,好让后文的字节数有感觉。设 80 层、8 个 KV 头、128 维、FP8、块大小 、可用 KV 显存 100 GiB:
一个槽在单层里存一个 token 的 K 与 V: 字节(FP8,每元素一字节)。,这个数远小于 ,说明按当前主流显存规模,32 位槽号在数值上也够用。64 位的真正原因是上一段说的地址运算约定;容量只是一层额外的保险。
第一张表:block table——把逻辑块号翻成物理块号
第一张表的职责很简单:block_table[row][b_log] = p。它的数据结构在 vLLM 里是 BlockTable 类,构造时一次性分配三块存储:
class BlockTable: def __init__(self, block_size, max_num_reqs, max_num_blocks_per_req, max_num_batched_tokens, pin_memory, device, cp_kv_cache_interleave_size, slot_mapping_mode): self.block_table = self._make_buffer( self.max_num_reqs, self.max_num_blocks_per_req, dtype=torch.int32 ) self.num_blocks_per_row = np.zeros(max_num_reqs, dtype=np.int32) self.slot_mapping = self._make_buffer( self.max_num_batched_tokens, dtype=torch.int64 )三个细节值得停下来看:
- 类型是
int32。 物理块号上限是 ,即上例的 ,5 位数级别,32 位足够。块表作为内核数据被读取,而不是下标,所以不必受int64约束;省下的带宽直接落在注意力内核的每次查表上。 num_blocks_per_row是 CPU 侧的 numpy 数组,不是 GPU 张量。 它记录每行「已经写了多少个块号」,用来做追加式写入;CPU 侧维护它,是因为 append 这个动作发生在调度器线程里,等张量大到需要拷到 GPU 时,内核根本不需要知道「这一行有效长度是多少」——内核只需要页表内容,至于这行末尾之后是什么,由后面的「坑」来兜底。slot_mapping缓冲按max_num_batched_tokens而不是按请求数分配。 因为它是一个每步重算的临时张量,而不是持久状态。它随 batch 形状变化,每前进一步就整体覆盖一次。
追加式的行写入
每次调度给出新增的块,执行器并不会重建整张表,而是调用 append_row:
def append_row(self, block_ids, row_idx): if not block_ids: return num_blocks = len(block_ids) start = self.num_blocks_per_row[row_idx] self.num_blocks_per_row[row_idx] += num_blocks self.block_table.np[row_idx, start : start + num_blocks] = block_ids为什么是追加而不是全量写?因为一条请求的块序列是前缀单调增长的。tokens 只能往后加,块只能往后借,前面已分配好的块号不会改(除非发生抢占,见下一段)。而前缀缓存命中时,命中的那一段前缀块号也已经确定,同样只需要把新算那一段的块号接在后面。于是 CPU 侧的追加工作量是 ,而不是 。注意这不等于拷贝量:提交仍然按整行宽拷贝,这笔账留到字节账一节再算。
append_row 的代价是:它假定原表这一行的前 start 个位置已经被正确填写。这个假定在第一块新块被追加时成立,但在下面两种情况下会被破坏。
move_row 为什么要把源行清零
批次里请求的行号并不是恒定的。一条请求结束后,执行器会把后面的请求往前挪一格以保持紧凑——这正是 GPUModelRunner 如何把动态请求拼成一次 GPU 前向 里讲过的「压紧」动作。对应的块表操作是 move_row(src, tgt):
def move_row(self, src, tgt): num_blocks = self.num_blocks_per_row[src] block_table_np = self.block_table.np block_table_np[tgt, :num_blocks] = block_table_np[src, :num_blocks] self.num_blocks_per_row[tgt] = num_blocks # Clear the vacated source row: dummy-run batches dereference stale # rows as mamba state slots and write state in place there, possibly # after the blocks have been freed and reallocated. block_table_np[src, :num_blocks] = 0 self.num_blocks_per_row[src] = 0清零被移出的源行,源码注释给出的理由是:dummy 批次会把这些已经搬空的旧行当成 mamba 状态槽来解引用,并且原地写状态,而这些块可能已经被释放并分配给别的请求。这一句非常值得单独讨论,因为它揭示了一个在别的框架里也广泛存在的事实:表里的无效项不是「无人问」的,而是「有人在读」的。dummy 行(为图捕获或对齐而构造的假请求)总要有一条块表,而它的行号可能是任意一个刚被搬空、当前无主的旧行。如果不清零,dummy 的去引用就会落到已被回收的块上,可能把垃圾写进别的请求的 KV。
这里有一个表内坐标的漏洞:move_row 把整行搬过去了,但它并没有把表搬过去之后继续维持「源行的内容为 0」这个不变量在所有其它操作上都成立。例如 swap_row 就是一次成对的数据交换,它交换两行的有效长度与内容;clear_row 只清有效长度范围内的项,不碰之后的项。所以「未初始化项等于 0」在 row 语义层面并不成立:块表行的末尾永远是上一次写入留下的旧值。这引出后文那块表末尾残留的坑——它之所以无害,靠的是「注意力内核按 seq_lens 遍历、槽映射对无效 token 写 -1」这两道闸门,而不是块表本身干净。
双缓冲:CPU 上的 numpy 才是权威
_make_buffer 返回的是 CpuGpuBuffer,它把同一份数据在 CPU(pinned)和 GPU 上各存一份,并提供 np 视图直接改 CPU 那份、copy_to_gpu(n) 把前 行拷过去:
class CpuGpuBuffer: def __init__(self, *size, dtype, device, pin_memory=PIN_MEMORY, with_numpy=True): with torch.inference_mode(False): self.cpu = torch.zeros(*size, dtype=dtype, device="cpu", pin_memory=pin_memory) self.gpu = torch.zeros_like(self.cpu, device=device) if with_numpy: self.np = self.cpu.numpy()
def copy_to_gpu(self, n=None): cpu, gpu = self.cpu, self.gpu if n is not None: cpu, gpu = cpu[:n], gpu[:n] return gpu.copy_(cpu.pin_memory() if PIN_MEMORY else cpu, non_blocking=True)这个结构回答了块表映射的一个关键设计问题:权威数据放在 CPU 还是 GPU? 放在 CPU,因为追加、搬移、清零这些修改都发生在控制面,Python 里改 numpy 数组是最便宜的方式。GPU 那份是只读镜像,每次前向之前整体刷新一次。pin_memory=True 让这次刷新走的是不需要额外暂存的分页锁定内存(pinned memory),non_blocking=True 则让它挂到当前流上异步执行。
异步就带来一个顺序问题:CPU 那边改完之后,GPU 需要多久才能看到新值?vLLM 的答案是把这件事提前。执行器的 _prepare_inputs 里有一句注释说得很直白:
# OPTIMIZATION: Start copying the block table first.# This way, we can overlap the copy with the following CPU operations.self.input_batch.block_table.commit_block_table(num_reqs)commit_block_table(n) 在CPU 侧所有后续准备工作开始之前先发起拷贝,这样后续计算 positions、query_start_loc、slot_mapping 等 CPU 计算的几微秒里,拷贝已经在 DMA 引擎上跑着。这是一种把「拷表」隐进关键路径缝隙的调度技巧,用一句话概括:把表刷新做到最前面,让它后面的每一条 CPU 指令都变成它的掩护。
第二张表:slot mapping——把 token 位置翻成扁平槽号
块表只回答「这条请求的第几页在哪」,但它无法直接告诉内核「这个具体 token 的 KV 该写到哪一格」。把这两件事接起来的是槽映射:一个长度为「本步 token 数」的数组,slot_mapping[j] 就是扁平 token 流里第 个 token 的 KV 目标槽号。
不在 CPU 上算的理由
这个映射可以完全在 CPU 上算出:
对 落在第 条请求内、在该请求内位置为 的 token,CPU 只要查一次块表乘以 再加上偏移。为什么 vLLM 反而把它做成一个 Triton 内核?表面上的答案是「减少 CPU 开销」,但真正的原因更深:
块表在 GPU 上已经有了权威副本。 一旦 commit_block_table 把表拷到 GPU,在 GPU 上直接算 slot 就不需要再读 CPU 侧的表,也不需要为每个 token 维护一份 CPU 侧的 num_blocks_per_row 之外的中间结果。CPU 只需要把 positions 张量准备好,剩下的「乘 加偏移再查表」全部交给 GPU 的 ComputeSlotMappingKernel:
@triton.jitdef kernel(num_tokens, max_num_tokens, query_start_loc_ptr, positions_ptr, block_table_ptr, block_table_stride, slot_mapping_ptr, KV_CACHE_BLOCK_SIZE: tl.constexpr, TOTAL_CP_WORLD_SIZE: tl.constexpr, TOTAL_CP_RANK: tl.constexpr, CP_KV_CACHE_INTERLEAVE_SIZE: tl.constexpr, PAD_ID: tl.constexpr, BLOCK_SIZE: tl.constexpr): req_idx = tl.program_id(0)
if req_idx == tl.num_programs(0) - 1: # Pad remaining slots for CUDA graph compatibility. for i in range(num_tokens, max_num_tokens, BLOCK_SIZE): offsets = i + tl.arange(0, BLOCK_SIZE) tl.store(slot_mapping_ptr + offsets, PAD_ID, mask=offsets < max_num_tokens) return
start_idx = tl.load(query_start_loc_ptr + req_idx).to(tl.int64) end_idx = tl.load(query_start_loc_ptr + req_idx + 1).to(tl.int64)
virtual_block_size = KV_CACHE_BLOCK_SIZE * TOTAL_CP_WORLD_SIZE row_offset = req_idx * block_table_stride for i in range(start_idx, end_idx, BLOCK_SIZE): offsets = i + tl.arange(0, BLOCK_SIZE) mask = offsets < end_idx pos = tl.load(positions_ptr + offsets, mask=mask, other=0) virtual_block_indices = pos // virtual_block_size virtual_block_offsets = pos - virtual_block_indices * virtual_block_size is_local = (virtual_block_offsets // CP_KV_CACHE_INTERLEAVE_SIZE) % TOTAL_CP_WORLD_SIZE == TOTAL_CP_RANK local_block_offsets = ( (virtual_block_offsets // (TOTAL_CP_WORLD_SIZE * CP_KV_CACHE_INTERLEAVE_SIZE)) * CP_KV_CACHE_INTERLEAVE_SIZE + (virtual_block_offsets % CP_KV_CACHE_INTERLEAVE_SIZE) ) block_numbers = tl.load(block_table_ptr + row_offset + virtual_block_indices, mask=mask & is_local, other=0).to(tl.int64) slot_ids = block_numbers * KV_CACHE_BLOCK_SIZE + local_block_offsets slot_ids = tl.where(is_local, slot_ids, PAD_ID) tl.store(slot_mapping_ptr + offsets, slot_ids, mask=mask)逐个部分读:
- 每个 program 处理一条请求(
req_idx = tl.program_id(0)),再用query_start_loc把这条请求在这一步产生的 token 区间取出来。为什么按请求而不是按 token?因为块表的行偏移是req_idx * block_table_stride,按请求切分意味着每一行只算一次行偏移,块表读取的索引计算在寄存器里完成一次即可。 positions是全局位置,不是请求内位置。virtual_block_indices = pos // virtual_block_size直接用全局位置做除法,这意味着这个 kernel 假设块表是按请求从 0 号位置连续编号的,因此pos // B恰好等于该请求内的逻辑块号。如果某条请求因为抢占而从头重算过,positions已经归零重新开始,这个假定依旧成立。PAD_ID = -1是无效槽号。它被写进两处:数组尾部多出来的部分(最后那个 program 负责 pad,这部分填充由槽映射独立承担,第三张表不必知道它);以及不属于本 rank 的 token(CP 相关的那几个is_local判断)。对绝大多数非 CP 部署,TOTAL_CP_WORLD_SIZE = 1、is_local恒为真,这个 kernel 退化成一个非常朴素的「查表乘 加偏移」。do_not_specialize=["num_tokens", "max_num_tokens"]让 Triton 不把这两个长度当成编译期常量,否则每换一个 batch 形状就要重新编译一次。
最大的坑:提交宽度与有效项的错位
槽映射的计算依赖两个不变量:
positions是这条请求从上次计算点继续往后数的全局位置;- 块表行在每步 commit 前已经被正确追加。
任何一个不成立,算出来的槽号就会是错的。其中最容易踩的是第二个:commit_block_table(n) 只拷 n 行,但 get_device_tensor(num_reqs) 返回的是 block_table.gpu[:num_reqs]——切片的尾部没有拷贝。如果某次提交前,GPU 这一行的前 num_blocks_per_row 项里残留的是上一次的旧值(例如一个已经释放的块号),那么本步 kernel 会把一个 token 写进不在本请求页表内的块,而不会报任何错。注意这里说的是「有效范围内」的残留:内核按 positions 推出块号下标后按 mask 只查有效项,因此真正被读出并使用的,永远是提交时应该被刷新到的那一段。这正是为什么 move_row 必须清零源行,为什么 clear_row 要维护 num_blocks_per_row,也是为什么每个分配与提交点都要严格对齐。
第三张表:页索引——把块表重新打包成内核认识的样子
前两张表都是引擎内部的记法,但注意力内核有自己的接口语言。这里先把 FlashAttention 与 FlashInfer 两条路线的差异讲清。
FlashAttention:直接吃二维块表
vLLM 的 FlashAttention 后端把公共元数据里的 block_table_tensor 原样接收,再在自己的 forward 里把它传给底层 kernel:
block_table_tensor = common_attn_metadata.block_table_tensor...attn_metadata = FlashAttentionMetadata( ... block_table=block_table_tensor, ...)传进去的正是 block_table.gpu[:num_reqs] 的切片,宽度是 max_num_blocks_per_req。这意味着内核看到的是一个规整的二维张量:每一行对应一条请求,行宽是最大块数,行内有效元素之后的内容可能是旧值或 0。为什么这里右侧未初始化不致命? 因为内核并不按「行宽」去遍历,它按的是 seq_lens(或 block_table 中有效块数)来遍历;行宽只是地址步长(stride)。只要行宽对齐、strides 符合期待,后面那一段读到什么都无所谓——在地址层面它永远不会被访问。这是「块表映射」与「页索引映射」最本质的一点:同一份信息,二维表靠 stride 表达,CSR 表靠指针表达,两侧的「无效区域」有不同的容错方式。
FlashInfer:先做一次 CSR 重打包
FlashInfer 的 paged attention 接口要的是 CSR 格式的三张表:paged_kv_indptr(每条请求的页起始偏移)、paged_kv_indices(拼接后的页号)、paged_kv_last_page_len(最后一页的有效长度)。vLLM 用 _compute_flashinfer_kv_metadata 从二维块表推导出这三张:
np.cumsum(num_blocks_np, dtype=np.int32, out=self.paged_kv_indptr.np[1 : num_reqs + 1])paged_kv_indptr = self.paged_kv_indptr.copy_to_gpu(num_reqs + 1)
num_actual_pages = self.paged_kv_indptr.np[num_reqs]paged_kv_indices = self.paged_kv_indices[:num_actual_pages]_copy_page_indices_kernel[(num_reqs,)]( paged_kv_indices, block_table_tensor, block_table_tensor.stride(0), paged_kv_indptr, BLOCK_SIZE=1024,)
paged_kv_last_page_len_np = seq_lens_np % page_sizeself.paged_kv_last_page_len.np[:num_reqs] = np.where( (paged_kv_last_page_len_np == 0) & (seq_lens_np != 0), page_size, paged_kv_last_page_len_np,)self.paged_kv_last_page_len.copy_to_gpu(num_reqs)这里值得讲的不是这段代码本身,而是它的三步里每一步都在 CPU 与 GPU 之间搬一次账:
cumsum在 CPU 上做,因为num_blocks_np是「每条请求需要多少页」,它恰好是块表num_blocks_per_row在 CPU 上的另一份推导,CPU 侧已经有这个信息。- 页号拷贝在内核里做,但不跨请求。
_copy_page_indices_kernel的每个 program 只负责一条请求:从该请求行里按[indptr[r], indptr[r+1])的区间把块号拷进平铺的page_indices中对应位置。它不会做跨程序的数据依赖,因为每个 program 的写入区间互不重叠——这正是 CSR 重打包能做成并行的原因:
@triton.jitdef _copy_page_indices_kernel(page_indices, block_table, block_table_stride, cu_num_blocks, BLOCK_SIZE: tl.constexpr): req_idx = tl.program_id(0) row_ptr = block_table + req_idx * block_table_stride start_idx = tl.load(cu_num_blocks + req_idx) end_idx = tl.load(cu_num_blocks + req_idx + 1) num_blocks = end_idx - start_idx offset = tl.arange(0, BLOCK_SIZE) for i in tl.range(0, num_blocks, BLOCK_SIZE): block_ids = tl.load(row_ptr + i + offset, mask=i + offset < num_blocks) tl.store(page_indices + start_idx + i + offset, block_ids, mask=i + offset < num_blocks)paged_kv_last_page_len的np.where是一个不显眼但常见的坑:当序列长度恰好是页大小的整数倍时,seq_lens % page_size == 0,按语义最后一页应该是满的,不是 0。FlashInfer 用 0 表示「空页」,所以必须显式改成page_size。这条规则和块表里的「一行末尾是旧值」不是同一类问题:后者是无效区域,前者是有效信息。
CSR 打包的代价是额外一次 GPU 内核与几次 CPU 侧同步(paged_kv_indptr.np[num_reqs] 需要读到 CPU 值以确定 num_actual_pages),换来的是内核只需线性读取 page_indices,不需要再处理二维 stride。同一个信息在两条路线上被物化成了两种形状,本质上是「谁是查表的受害者」的不同选择:FlashAttention 让内核承担 stride,FlashInfer 让引擎承担打包。
从槽号到字节地址:布局决定最后一步
槽号到这里还只是一个「第几格」的编号,真正落到显存地址还要乘上 head 与 head_dim 两个维度。设块大小 、KV 头数 、每头维度 ,一个 token 在单层的 K 或 V 占 个元素。两种常见布局给出的地址公式不同。
NHD 布局([num_blocks, B, H, D],vLLM 的默认 KV 布局)把一个块内的 token 维放在 head 维之前:
注意 正是 slot,所以这个式子可以写成:
HND 布局([num_blocks, H, B, D])把 head 维放到 token 维之前:
此时 、,所以:
两个式子的差别不在「槽号是多少」,而在「谁乘谁」:NHD 让同一个 token 的所有 head 连续,HND 让同一个 head 的所有 token 连续。槽映射本身与布局无关——它只回答「第几格」;把格号变成地址是内核的事,内核必须知道自己用的是哪种布局。这也解释了为什么同一份 slot_mapping 可以在不同 attention backend 之间复用,而不同 backend 的块表/页索引视图却不能直接互换:前者是逻辑编号,后者已经带有布局与 stride 的约定。
这也是一处常见的性能取舍:NHD 布局里,一次写入覆盖「一个 token 的全部 head」,天然与 reshape_and_cache 的按 token 处理对齐,因此 vLLM 把它作为默认;HND 布局里,一次寻址覆盖「一个 head 的全部历史 token」,更贴近部分注意力内核与 MLA 类模型对 latent 连续遍历的需求。vLLM 的 KV cache 张量形状与后端的 stride 必须严格对齐,任何一处对不齐,症状都是「写进去了但读出来错位」,而不是报错。
页索引的第三种形态:DeepInfer 的压缩块
DeepInfer 在「压缩 KV」之上又加了一层块级筛选:它维护一份压缩 KV 的候选块 topk 列表(见 候选块 topk 管线),并且对 SWA 使用 ring 槽位与块粒度装载计划。它的页索引并不等同于块表的平铺,而是块级的描述符列表:每个描述符是一段「起始页、长度」的区间。它的写与读两个方向在 InputMetadata 的构造 中有完整拆解。它的存在说明了第三张表的另一种可能性:页索引不一定是逐页的,也可以是一组区间——前提是内核能理解区间语义。
三张表的字节账:拷贝宽度与带宽
前面一直说「拷表很便宜」,但便宜与否取决于表宽。把三张表的体积写成公式:
其中 是最大并发请求数, 是模型最大上下文, 是块大小。取 K、、:
如果上下文是 1M(),同样的并发下这张表是 64 MiB。而每步 commit_block_table(num_reqs) 拷的是整个行宽,不是「这一行实际用了多少块」——CpuGpuBuffer.copy_to_gpu(n) 只按行数切片,不按行内有效长度切片。所以稳态 decode 的每步拷贝量就是 字节。
按 50 step/s、batch=256、32K 上下文估算:
这个量级在 PCIe 上还能被 CPU 计算盖住;但如果上下文是 1M,同样的负载会变成 3.1 GiB/s,拷贝就不再是「顺手做的」,而是会挤压真正的输入传输。这解释了为什么 vLLM 的块表宽度要按 max_model_len 算、并且用 get_block_table_width 做对齐:
def get_block_table_width(max_num_blocks, block_size, *, token_alignment=128): if token_alignment is not None: block_alignment = token_alignment // math.gcd(token_alignment, block_size) max_num_blocks = cdiv(max_num_blocks, block_alignment) * block_alignment return max_num_blockstoken_alignment=128 的作用是把块表宽度对齐到 128 个 token 对应的块数。对 而言,块对齐是 8;对 而言是 1. 它带来两个结果:一是宽度不再随模型长度取任意奇数,Triton 内核的 block_table_stride 特化分支更少;二是任何按 128 token 对齐的访问(比如某些内核的块级循环)都能恰好落在块边界上。这不是省字节,而是省内核重编译与边界判断。
槽映射的体积小一个量级:max_num_batched_tokens × 8 字节,8192 token 的 batch 只有 64 KiB/步。页索引体积介于两者之间:num_actual_pages × 4 字节,256 条请求各 1000 页是 1 MiB,且它只在 FlashInfer 原生路径上生成。
三张表的拷贝频次也完全不同:块表每步整段拷(前 num_reqs 行,含本步未变化的行);槽映射每步重算(不拷,直接由 GPU 内核写 GPU);页索引在 FlashInfer 路径上每步重打包(并在 paged_kv_indptr 处引入一次 CPU→GPU 的小拷贝)。频次与体积共同决定谁值得优化:块表的优化方向是「减少行宽与脏行」,槽映射的优化方向是「减少一次内核启动」,页索引的优化方向是「避免一次同步」。
共享与分叉:一张表如何同时属于两条请求
到这里,块表还被当成「一条请求一张」。但 PagedAttention 的核心收益之一正是两条请求可以共享物理块,于是同一段物理块会同时出现在两张表里。这种共享有两种来源:
前缀命中。 新请求的前缀与池里某个请求完全相同(按块哈希),调度器直接把那些物理块号接进新请求的表。此时新请求的块表前半段是「别人分配过的块」,后半段才是自己新算的。块的释放由引用计数决定:只有最后一条引用它的请求结束时,块才回到空闲队列。这也是为什么块表的 clear_row 必须与引用计数的递减成对出现——表里的块号消失了,但物理块不一定能回收。
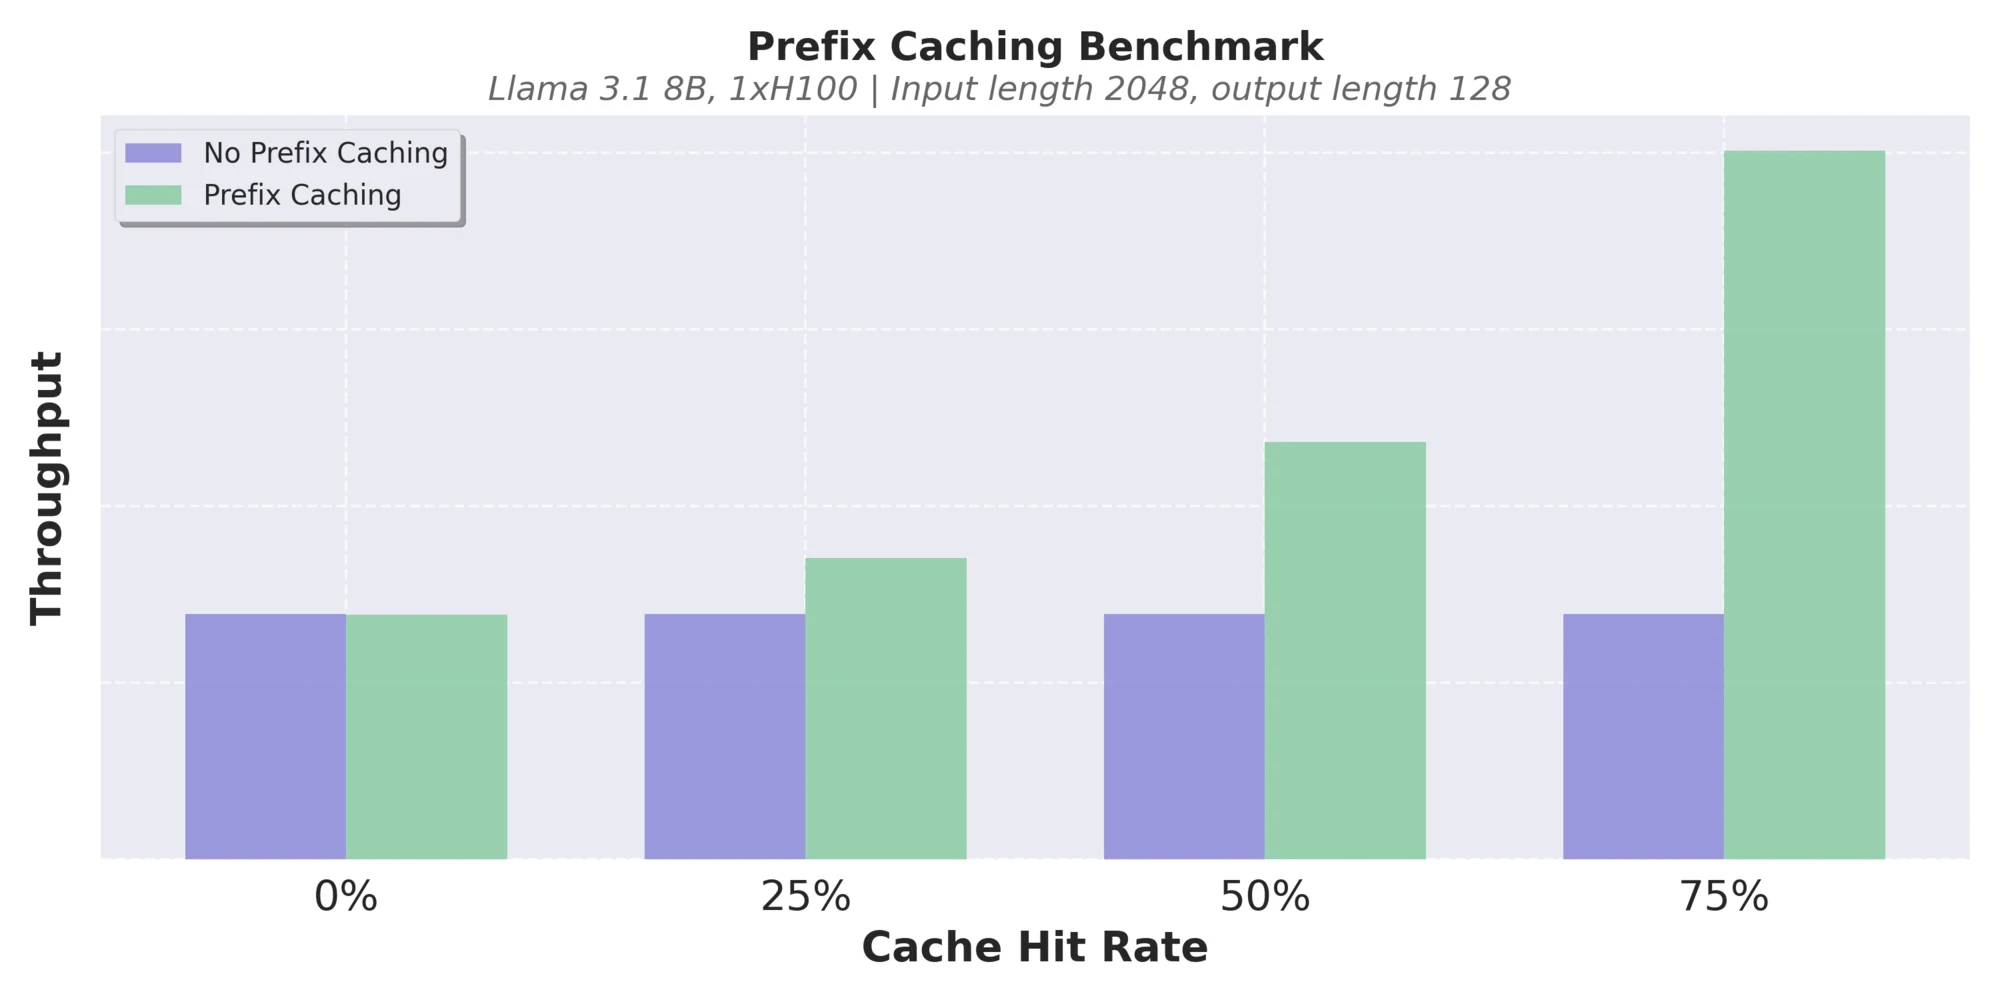
vLLM V1 的发布博客讨论了这套块级前缀缓存:块的内容哈希(连同父块哈希)决定复用关系,命中之后多条请求的块表在相同位置指向同一批物理块。下图是这套共享关系的整体示意。
分叉。 并行采样(一条 prompt 生成 条输出)与 beam search(同一条前缀分出多条候选)都会让多条序列共享同一段 KV。PagedAttention 论文的 Figure 8 与 Figure 9 画的就是这个场景:分叉之后,子序列各自拥有独立的块表行,但这些行在分叉点之前指向完全相同的物理块。之后每条子序列只会往自己的尾部追加块,分叉点之前的部分永不修改,于是共享是安全的。
共享带来一个必须处理的边界:一个块只有在被填满之后才可能被共享。前缀命中按整块哈希,最后那个残块不进入哈希表,因此它不会出现在别的请求的表里。分叉则要考虑「最后一块是否已满」:如果未满,子序列在该块上的后续写入会互相踩,必须在分叉时为每条子序列复制这一块(写时复制,COW)。这条规则的实际含义是:块表中「共享的项」永远指向满块,只有每行末尾那一个块是私有的。 一旦这个不变量被打破(比如按 token 粒度做哈希、把残块也共享),两条请求就会在同一个槽位上互相覆盖,症状是某条请求生成的文本在分叉点后开始漂移。
这条不变量也解释了为什么「每请求一张表」是必须的:共享发生在物理层,但每条请求的逻辑→物理对应关系是独立的。两条请求可以共享前缀的物理块,但它们后续追加的块不同、长度不同、结束时间不同,表必须分开记。
混合模型下的多张块表
当模型的不同层使用不同的 KV 结构时,一张块表不够用。vLLM 用 MultiGroupBlockTable 管理「每个 KV cache group 一张表」,每张表的块大小可以不同:
self.block_tables = [ BlockTable(block_size, max_num_reqs, max_num_blocks_per_req, ...) for block_size, max_num_blocks_per_req, slot_mapping_mode in zip(block_sizes, max_num_blocks, slot_mapping_modes)]两种典型情况:
- 滑窗层与全注意力层共存(如 Gemma 2/3 一类交替注意力模型)。滑窗层的 KV 只需要保留窗口内的内容,块粒度与全注意力层不同,各 group 的块表宽度与块大小都不同。
- 线性注意力 / Mamba 状态层。这类层没有「KV 块」的概念,块表被当作状态槽的下标使用,因此在构造时把槽映射模式设为
SlotMappingMode.NONE,compute_slot_mapping直接返回:
if self.slot_mapping_mode == SlotMappingMode.NONE: # Mamba/GDN groups consume the block table as recurrent state # indices and do not use per-token slot mappings. return也就是说,「块表」这个名字本身在混合模型里已经不够准确:对 Mamba 组,它是「状态槽表」;对滑窗组,它是「窗口块表」;只有对全注意力组,它才是真正的分页 KV 块表。三者在同一个 BlockTable 类里共用一套追加/搬移/清零逻辑,但它们的语义由 slot_mapping_mode 区分。这也是为什么 move_row 偏偏要在注释里提到 mamba 状态槽——它是这套共用逻辑里唯一会「原地写状态」的组,也因此对源行残留最敏感。
对推理服务来说,混合模型的多组块表意味着每步的提交要对每个 group 各走一遍:每个 group 有自己的 BlockTable(块大小可能不同),共享同一组 num_reqs、query_start_loc 与 positions,元数据构建循环按 group 逐个进行:
for kv_cache_gid, kv_cache_group in enumerate(kv_cache_groups): cm = copy(cm_base) # shallow copy if kv_cache_gid > 0: cm.block_table_tensor = _get_block_table(kv_cache_gid) cm.slot_mapping = slot_mappings[kv_cache_gid] ...注意这里只换「块表与槽映射」两项,其余公共元数据(seq_lens、query_start_loc、positions)全部复用。这就是「一张块表」和「多组块表」在实现上的最小差异:公共的 batch 几何只有一份,分页的记法按 KV 结构分家。
三个「坏位置」:-1 槽号、0 号块与 dummy 行
前文两次提到无效区域的容错,现在把它集中讲清楚。有三类「坏位置」,它们的数字各不相同,作用机制也各不相同:
无效槽号:-1
PAD_SLOT_ID = -1,它进入槽映射有两个来源:一是 ComputeSlotMappingKernel 里 pad 尾部与 cross-rank 的 token,二是执行器 _get_slot_mappings 对尾部 token 的显式填充:
slot_mapping[num_tokens_unpadded:num_tokens_padded].fill_(-1)-1 被接受的前提是写 KV 的内核认识它,并会跳过它。 vLLM 的注释写得很清楚:Needed for reshape_and_cache in full cuda graph mode。在无图的 eager 模式下,slot_mapping 的长度恰好等于真实 token 数,尾部压根不存在,-1 也不会出现。只有在图捕获(形状必须固定)时,num_tokens_padded > num_tokens_unpadded,才会有一小段槽号落进「假 token」的范围:
reshape_and_cache_flash(key, value, key_cache, value_cache, slot_mapping, self.kv_cache_dtype, layer._k_scale, layer._v_scale)这个 op 用的是 slot_mapping 的形状来决定写多少个 token,所以它必须能对 -1 项做「不写」的处理。这同时是一个顺序约定:KV 写入发生在注意力计算之前,而注意力只读 seq_lens 范围内的 KV,写进去的假 token 不会被读到。于是即使假 token 真的被写了,影响也只是覆盖了几个以后会被覆盖的 KV 落点。
0 号块:被保留的 null block
物理块号 在 vLLM 中不是普通块,而是被保留的 null block。执行器在给 pad 行填块表时,用的就是 NULL_BLOCK_ID = 0:
def _get_block_table(kv_cache_gid: int): ... blk_table = self.input_batch.block_table[kv_cache_gid] blk_table_tensor = blk_table.get_device_tensor(num_reqs_padded) # Fill unused block table entries with NULL_BLOCK_ID (null block) # for CUDAGraph padding. Block 0 is reserved for padding. blk_table_tensor[num_reqs:num_reqs_padded].fill_(NULL_BLOCK_ID) return blk_table_tensor这里的设计逻辑比 -1 更微妙。当 num_reqs < num_reqs_padded 时,多出来的行是一条假的请求:块表全 0,seq_lens 是一个约定值(由后端决定,见 CUDA Graph 的桶与垫),它的注意力输出是垃圾,采样结果会被丢弃。但由于它是一行真实存在于批次中的请求,注意力内核会去读它的块表,去计算它的注意力。
为什么不能把它填成「别的块」,而必须是 0?有三个理由:
- 0 号块是整个池里唯一一个必须「谁都别写」的块。 物理分配器从 0 号块之后开始发块,因此 0 号块永远不会被任何请求的真实 KV 写入。假行的 attention 读到的是一块恒为零的 KV,输出自然也是零或极小的值,不会污染真实的 batch 内别的任何东西。
- 0 号块是常数,不随步态变化。 CUDA Graph 捕获的时候不能绑定一个会变的块号(否则图内地址计算全乱),0 是唯一保证永远不变的选择。
- 它把「无效」表达成一个有效的数据值,而不是一个越界值。 如果填的是
max_num_blocks这种越界值,内核会真的越界访存;填 0 则是一次完全合法的读取。
0 号块是由 BlockPool 在初始化时从空闲队列里直接摘下来「没收」的,它带一个 is_null 标记,并且引用计数不维护,因此永不会被回收:
# To represent a placeholder block with block_id=0.# The ref_cnt of null_block is not maintained, needs special care to# avoid freeing it.self.null_block = self.free_block_queue.popleft()self.null_block.is_null = True这带来了 null block 的第二类用途:被跳过的块也用 0 号块占位。调度器在稀疏注意力或 remove_skipped_blocks 时,会把「不再需要、但表里位置仍然要有内容」的块名替换成 null block——KVCacheManager.remove_skipped_blocks 的文档里写得很直接:
Remove the blocks that are no longer needed from
blocksand replace the removed blocks with null_block.
也就是说,块表中出现 0 号的两种情形在语义上是统一的:「这里读什么都无所谓」。无论它是 pad 行、是被淘汰的稀疏页、还是被前缀命中替换掉的占位,注意力内核都可以安全地读它。这种「用一个保留块表示空」的做法与软件工程里用 NULL 指针表示空引用是同构的;唯一要注意的是,它并没有把空引用变成「不引用」——内核仍然会走一遍访存路径,只是访存目标被钉在一个可写的常量块里。
这里也有一个与上文「块表右侧未初始化」呼应的点:fill_(NULL_BLOCK_ID) 只填了新增 row 的整行,却没有清除已有 row 右侧的残留。前者是必须清,后者可以不清,区别在它是否会在某个路径里被实际解引用。这正是 move_row 注释里说到的 dummy 行问题:dummy 行有时会落到一条被搬空的行上,而那条行右侧的旧值可能就是它要解引用的位置。
dummy 行与 slot 的「不写」语义
把 -1 与 0 拼起来,才能看清 pad 行在图里的完整语义:
| 表 | 无效行的值 | 谁跳过它 | 跳过的方式 |
|---|---|---|---|
| block table | 0(null block) | 分配器 | 从 0 号块之后开始发块 |
| slot mapping | -1(PAD_SLOT_ID) | reshape_and_cache_flash | 通过槽号形状确定真实 token 数;-1 项不写 |
| seq_lens | 后端定义的常数 | 视后端而定 | 后端在最小块长度/零长度下的行为 |
这三者必须一起对齐。比如 DeepInfer 的 dummy 用 seqlen_q=1, seqlen_k=1 并显式跳过槽位 0,TensorRT-LLM 的 dummy 行 block_table=[0]、mtp_info_write_slot 落在 pad 槽位 0。它们是在各自的引擎里,靠三张表各自选了一个「最不容易被撞上的数」来保护真实算子的。
五路对照:同一件事的五种记法
到这里足以做横向比较。对照只比较三张表的物化形态与访问方式,而不是逐个框架的 API 细节。
| 框架 | 块表形态 | 槽映射 | 页索引(注意力内核侧) | 关键差异 |
|---|---|---|---|---|
| vLLM | 二维 int32 [max_reqs, max_blocks],CPU pinned 权威 + GPU 镜像 | 每步 Triton 重算,int64,-1 标记无效 | FA 吃二维块表;FlashInfer 另做 CSR 打包 | 三张表都齐备,且 CPU/GPU 双份 |
| SGLang | 默认按 page size 1 组织(并按注意力后端自动改写为 16/32/64/128),用逐 token 的 req_to_token 映射 | 逐 token 的 out_cache_loc | 后端决定(FA/FlashInfer/TRT-LLM 各异) | 把「块表」换成「token→槽」大表,省掉乘法 |
| TensorRT-LLM | 两级池 + 前缀复用树,块表以块表 view 暴露给 prepare | 块句柄 → 块表/页表的转换 | AttentionMetadata.prepare() 翻译页表 | 块句柄是独立对象,表在 prepare 时物化 |
| llama.cpp | 不分页,用 seq × cell 二维切分 | cell 即槽号 | 无 paged 内核,直接连续访问 | 用「cell 槽」替代三张表 |
| DeepInfer | 固定 128 token 的块表 | slot 映射 | 压缩 KV 的区间描述符 + SWA 装载计划 | 多一层压缩块,页索引是区间 |
这张表本身不必展开(各自细节在站内对应单篇里),但它给了三条结论:
第一,分页与否,本质上是「要不要那张乘法式的表」。SGLang 的 page size 1 把乘法消掉了——每条 token 直接对应一个槽号,代价是表宽变成上下文长度。这就是 KV Cache 的页粒度 里拆过的那笔账在这个视角下的另一面。
第二,槽映射几乎是所有分页框架共有的。原因很实际:无论怎样组织块,最终写 KV 的那个 kernel 都只认平铺槽号。区别只是槽映射由谁来算——CPU 侧算(SGLang 的 out_cache_loc 在调度期就产生),还是 GPU 侧重算(vLLM 的 Triton 内核)。
第三,第三张表是否物化,取决于内核接口。FlashAttention 系吃二维表,FlashInfer 系吃 CSR,这中间必然有一层转换。把转换放到什么位置、用 CPU 还是 GPU 做,不同框架给出了不同解。
一次 prefill 的映射账:为什么预填充要再单独算一遍
decode 每步只有一个 token,映射几乎「一条请求一条」。预填充(以及分块预填充)完全不同:一条请求在这一步可能产生成千上万个 token,块表在这一步里本身也是长度增长的。看三个量在此处的相互作用:
- 本步请求产生的 token 数 可以大于一个块,它可以跨越多个块,也可以把一个残块填满并续上新块;
- 块表在调度时就被追加了「够写 个 token 所需的新块」,追加发生在
compute_slot_mapping之前,因此槽映射能读到新块; positions从num_computed_tokens开始连续编号,块内偏移自然接上残块的未满部分。
所以预填充这一步里,槽映射不是「一条请求一个槽号」,而是「一条请求一段连续槽号」,且这段槽号可能并不连续(跨块处出现跳变)。这也是为什么 ComputeSlotMappingKernel 要用 for i in range(start_idx, end_idx, BLOCK_SIZE) 循环,而不是一条请求只算一个标量。
一个容易忽略的点:跨块的边界位置
考虑一条请求在两次分块预填充之间切换:
- 第一轮算到 token 1000,块表有 63 块(63 × 16 = 1008),第 63 块(逻辑块 62)已用 8 个槽。
- 第二轮从 token 1000 开始算 500 个 token。第二轮新增的块从逻辑块 63 起,但它们被追加到块表行的末尾,与逻辑块 62 相邻。
- 槽映射对 token 1000
1007 仍落在块表第 62 项指向的块里(偏移 815),token 1008 起才落进第 63 项。
这段推导里唯一的风险是块表行在第二轮开始时是否完整。第一轮结束后块表的 63 项已经提交给 GPU;第二轮的追加从第 64 项开始,不影响前 63 项。所以跨块边界正确的前提是「第一轮提交之后没有发生块表搬行」——一旦中间发生了一次请求被抢占或压紧,第二轮的 positions 会从 0 重来,块表也会被重写,这时「前缀部分」与前一轮的物理块可能已经不一致。这正是为什么抢占必须把整条请求从头重算:只重算残块、不重算前面已提交的块,就等于假定物理块映射没有变,而抢占恰恰收回了这些块。
query_start_loc 在映射中的双重身份
query_start_loc 是「每条请求在这步 token 流中的起始位置」,但它在两个不同阶段扮演了两个角色:
- 在
compute_slot_mapping里,它把 program 映射到「哪条请求、哪一段 token」,因此它必须是在 GPU 上已经写好的张量; - 在元数据里,它是注意力内核的
cu_seqlens_q,因此它必须描述有效 token 的真实边界,不能包含 pad token。
两者之所以能共用一个张量,是因为 pad token 永远排在 token 流的最末尾(num_tokens_unpadded 之后)。这也解释了为什么执行器的填充是这一段:
slot_mapping[num_tokens_unpadded:num_tokens_padded].fill_(-1)fill 从「未 pad 的末尾」开始,而不是从「每条请求的末尾」开始。batch 的几何是「真实 token 在前,pad 在后」的单一前缀形结构,三张表都建立在这个结构上。如果某天为了负载均衡把 pad 插进中间,这三张表都要跟着改。
一次 decode step 的完整映射走查
把前面各节串成一条时间线。设一条请求已经预填了 1000 个 token,块大小 ,正处于 decode 阶段,本步要生成第 1001 个 token。
- 调度:调度器确认这条请求本步要算的位置仍落在已分配的块内(1000 个已算 token 占满逻辑块 0~61,第 1001 个 token 位于逻辑块 62),不需要新块,返回本步调度结果。此时块表不变。
- 追加(如需要):若这一步需要新块,执行器在对应行上
append_row(new_block_ids, req_index)——只在 CPU 侧 numpy 里改。 - 提交:
commit_block_table(num_reqs)把前num_reqs行异步拷到 GPU。 - 位置与长度:CPU 计算
positions = num_computed_tokens + query_pos,seq_lens = num_computed_tokens + num_scheduled_tokens。 - 槽映射:
compute_slot_mapping(num_reqs, query_start_loc, positions)启动 Triton 内核,在 GPU 上查块表算出本步 token 的槽号,写入slot_mapping.gpu;尾部(如果有 pad token)填 -1。 - 元数据构建:
CommonAttentionMetadata携带query_start_loc、seq_lens、block_table_tensor(block_table.gpu[:num_reqs_padded],尾部行填 0)、slot_mapping,交给后端 Builder。 - 后端 prepare:FlashAttention 直接把这几个张量搬到 metadata;FlashInfer 走 CSR 重打包。
- 前向:模型中每一层注意力,先调用
do_kv_cache_update用slot_mapping把本步新产生的 K/V scatter 进 KV 缓存(-1 项跳过),再调用注意力 forward,用块表/页索引读全部历史 KV。 - 尾部:本步结束后,
num_computed_tokens加一,下一次循环回到第 2 步。
这条时间线上有两处顺序依赖特别值得标出:第 3 步必须先于第 5 步,否则槽映射读到的块表是旧值;第 8 步的写必须先于读,否则注意力看不到刚写进去的本步 KV。vLLM 用 copy_to_gpu 的 non_blocking=True 与同一条 CUDA 流把这两个顺序都隐式保证了,但这也意味着:任何跨流的重叠调度都必须显式地建立事件依赖,否则顺序不再被保证。
一个可手算的例子:为什么槽映射必须每步重算
设上面那条请求在第 1001 步之后被抢占,恢复时重新分配到的物理块与之前不同——逻辑块 62 指向的物理块换成了另一个。如果槽映射是持久状态,它里面保存的 就全部失效了。
这就是槽映射与块表生命周期不同的根本原因:
| 表 | 生命周期 | 修改时机 | 何时刷新到 GPU |
|---|---|---|---|
| block table | 与请求同寿命(除抢占) | 分配、命中、搬行、回收 | 每步前向之前 |
| slot mapping | 一步 | 每步重算 | 无需「刷新」,重算即产生 |
块表是持久的,槽映射是瞬时的。 把两个东西合成一张表意味着每步都要拷一次整张上下文长度的映射(SGLang 的 page size 1 在需要持久表的路径上就是这个代价的具体形式),而把两个表分开、用 Triton 每步重算,意味着每步都重新做一次「乘 加偏移」的算术。哪个更划算取决于 : 越大,重算的那次乘法省得越多; 时乘法消失,表退化成逐 token 的映射(SGLang 的 req_to_token),「重算」与「持久保存」的边界也随之改变。这个分界与 KV Cache 的页粒度 里对页大小的分析是同一笔账。
第三张表的编译期:Builder 在什么时候才见到表
前面把第三张表说成「块表的物化」,但它在 vLLM 里并不是在任何时候都被构建出来的。执行器构造元数据时,会先尝试复用上一步的 builder 结果,只在必要的时候才走完整的 build_metadata:
cached_attn_metadata = {}...cache_key = (kv_cache_spec, type(builder))if for_cudagraph_capture: attn_metadata_i = attn_group.build_metadata_for_cudagraph_capture( common_attn_metadata, ubid or 0 )elif cache_key in cached_attn_metadata and builder.supports_update_block_table: attn_metadata_i = builder.update_block_table( cached_attn_metadata[cache_key], attn_group.map_to_kernel_block_table( common_attn_metadata.block_table_tensor, ubid or 0 ), common_attn_metadata.slot_mapping, )else: attn_metadata_i = attn_group.build_metadata( common_attn_metadata, ubid or 0, **extra_attn_metadata_args ) if builder.supports_update_block_table: cached_attn_metadata[cache_key] = attn_metadata_i源码注释交代了这段缓存存在的理由:混合 KV 缓存(hybrid)模型通常有多个 KV cache group,这些 group 之间的公共元数据几乎完全相同,只有块表与槽映射不同。所以同一种 KVCacheSpec + 同一种 builder 的组合,只需要构建一次,其余 group 只做一次 update_block_table 换掉那两个张量。FlashAttention 的 update_block_table 就是这个「换张量」:
def update_block_table(self, metadata, blk_table, slot_mapping): new_metadata = copy.copy(metadata) new_metadata.block_table = blk_table new_metadata.slot_mapping = slot_mapping return new_metadata这一段揭示了第三张表与「每步重算」的槽映射之间的一个不对称:
- 槽映射每步必然新建。 它的内容完全由本步的 token 分布决定,没有复用价值。
- 第三张表可以跨步复用。 因为它依赖的是
seq_lens与块表;前者在 decode 稳态下每步只加 1,后者只在分配/回收时有变化。只要 builder 声明自己能安全地原地替换块表(supports_update_block_table),完整的页索引就可跳过一次。
这意味着第三张表的正确性要同时满足两个状态:构建它时依据的是某个 seq_lens,替换块表时依据的是新的块表。如果替换后的块表指向一个与构建时不同的页号(例如前缀命中换了物理块),页索引里的页号必须跟着更新;这就是 map_to_kernel_block_table 存在的原因——它把执行器那张「按 KV cache group 组织」的块表翻译成「内核视角」的块表,比如 MLA 或其他分组布局下块表可能被拼成不同的形状。一旦某一步的映射逻辑与上一次构建时不一致,页索引就会带着旧页号进入 forward。
另一个不对称:seq_lens_cpu 的代价
FlashInfer 走原生分页路径时,需要先在 CPU 上算出每条请求的页数 num_blocks_np:
seq_lens_np = seq_lens_cpu.numpy()num_blocks_np = (seq_lens_np + (page_size - 1)) // page_size而在投机解码开启时,seq_lens_cpu_upper_bound 不再是精确值,于是它必须走一次真正的 GPU→CPU 同步:
with gpu_sync_allowed(): seq_lens_cpu = common_attn_metadata.seq_lens.cpu()一次 tensor.cpu() 就是一次流同步,它会把整条流水线的重叠打穿。这正是为什么 FlashInfer 把「把块表重打包成 CSR」这件事限定在原生分页路径:needs_native_paged_prefill、needs_native_paged_decode 判断下,XQA 与 trtllm-gen 路径直接吃 GPU 上的 block_tables,完全不进这条分支。同一条映射信息,不同内核接口的代价差别可能大到一个同步点。判断第三张表是否值得物化,首先要看它会不会把一个 GPU 张量拉回 CPU。
工程上容易踩的坑与调试方法
这一节写给「拿到一份 KV 相关 bug 要去查」的场景。
坑一:块表末尾残留。 症状是 decode 偶发读到一个不属于本请求的 KV。排查顺序:先查 move_row 是否清源行;再查 clear_row 是否重置了 num_blocks_per_row;最后查 commit_block_table 的拷贝宽度是否恰好等于 num_reqs(拷贝多了会把未被更新过的行也带过去,拷贝少了会让老行留在 GPU)。一个可靠的调试方法是打印 block_table.np 与 block_table.gpu.cpu() 的前 行做逐行比对。
坑二:num_blocks_per_row 与块表内容失配。 一旦它被错误地设为「这一行已有多少个块」,下一次 append_row 会从错误的起点写,整行错位且不报错。它只在 CPU 侧维护,因此最好的调试方法是同时 dump 它和 block_table.np 的各行前几个有效项。
坑三:-1 与 0 的混用。 槽映射的无效值是 -1,块表的无效行值却是 0。两个值如果被互相填进对方,症状是「假 token 的 KV 被写进了 0 号块」,或者「假行拿着 -1 去查块、越界访存」。前一种不报错但污染 null block;后一种通常直接触发非法访存,反而容易定位。
坑四:图捕获前后的表形状。 图捕获时传入的块表必须是已 pad 的形状(num_reqs_padded),否则捕获的地址与重放时的形状不一致。这个「先 pad 再捕获」的顺序在 CUDA Graph 的桶与垫 里被五个框架分别讲了一遍,结论一致:pad 行必须先补齐块表。
坑五:前缀命中之后的表接续。 命中之后的接续不在本篇展开,但它的正确性依赖本篇的三张表:块表接在命中段之后、槽映射只重算新算段、页索引要把命中段一起纳入内核可寻址范围。这正是 前缀缓存命中之后 讨论的核心,本篇把底下的三张表先讲透了。
vLLM V1 的块表与 PagedAttention 论文的原始图
下面两张论文图能把上面的抽象落到视野上。第一张是 PagedAttention 论文 Figure 6,它画的正是第 62 行那条映射:
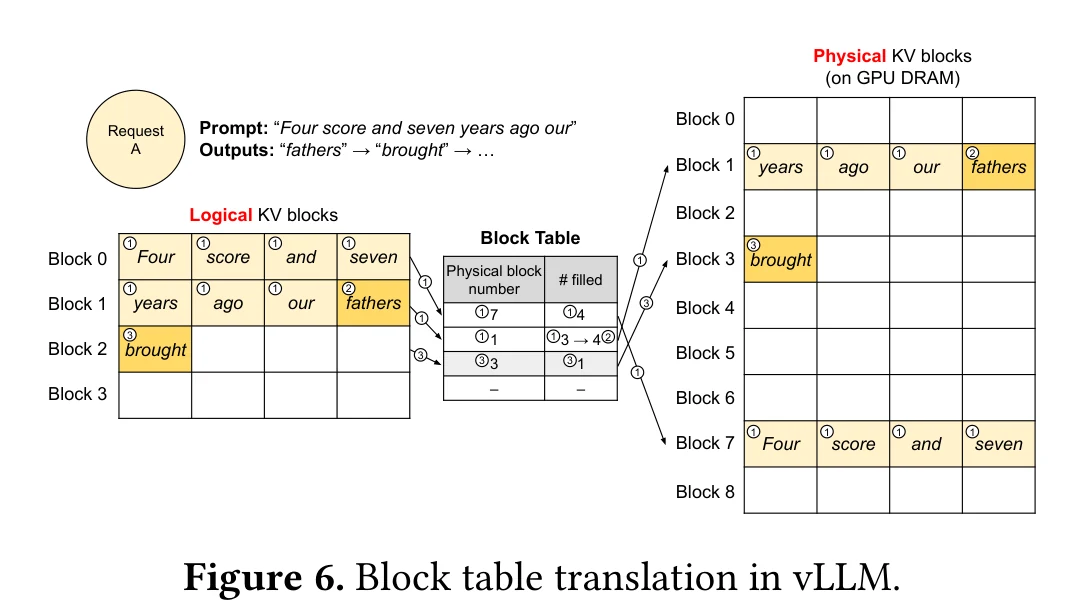
图的左边是这条请求被切成的逻辑块(Logical KV blocks),中间是块表,右边是物理 KV 块所在的位置。可以逐块核对:逻辑块 0 的 token 在物理块 7、逻辑块 1 在物理块 1、逻辑块 2 在物理块 3;块表把「第几页」这一步做完,之后任何一个 token 的槽号都是「物理块号 × + 块内偏移」。图中不同逻辑块分散在非连续的物理块里,正是分页的核心收益:块表把「连续的逻辑地址」翻译成「任意物理地址」,从而允许两条请求共享同一物理块(前缀复用),也允许物理块不必相邻。
第二张是 SGLang 的 RadixAttention 论文 Figure 3,它从另一个视角展示了同样的「表」问题:一棵前缀树里,多个请求共享树上的同一段前缀,于是每个共享段对应同一个逻辑段,但表里只需要一行物理块号:
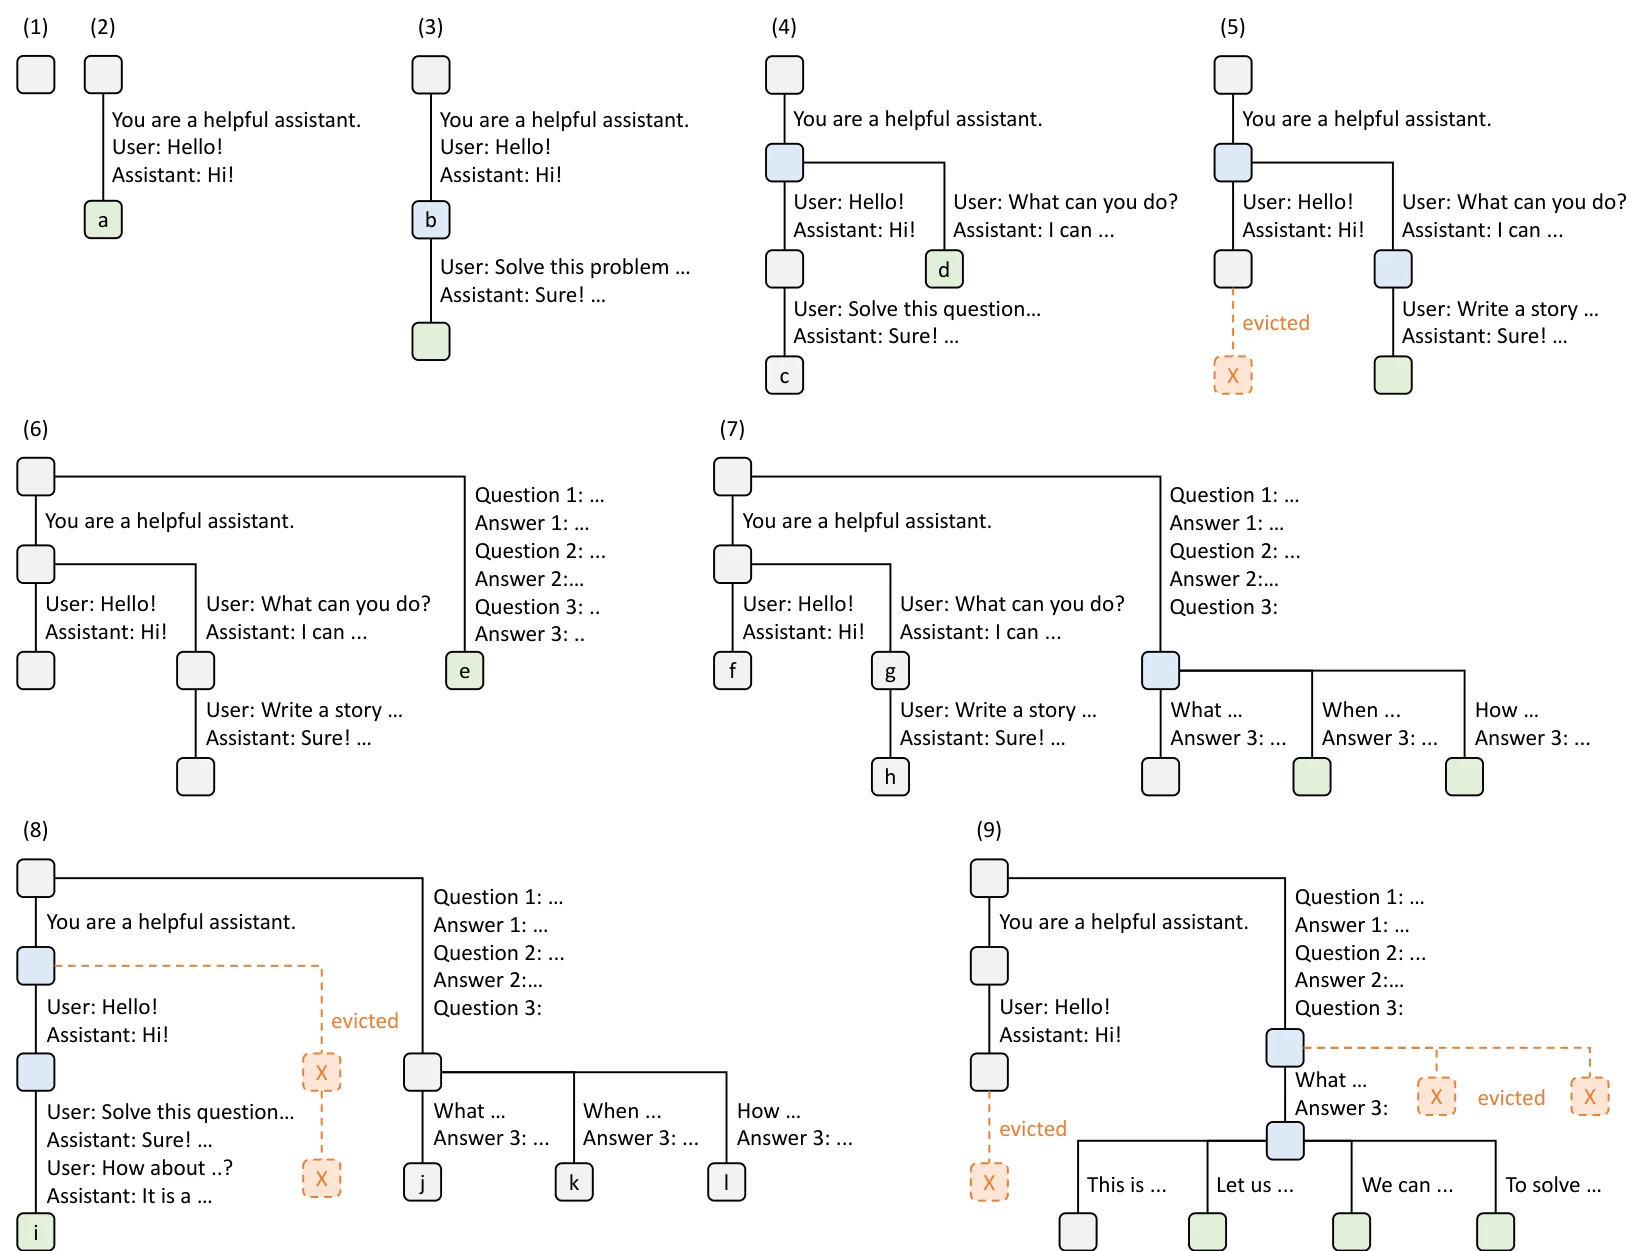
这两张图并排看,说明了本篇的第二个中心观点:块表是「每请求一张」,共享发生在物理层,不在表这一层。 两条请求共用一段前缀,各自都有一张块表,但两张表在对应位置上指向同一个物理块号。表是按请求独立的、物理块是可以复用的——这个分离在 PagedAttention 论文里是一次完整的创新,而不是一个实现细节。
小结
本篇的核心结论可以压成一段:
- 一个 KV 位置要从「请求的第 个 token」变成「扁平缓冲里的第
slot个格」,需要穿过四个坐标系:请求行号、逻辑块号、物理块号、槽号。 - 第一张表块表(逻辑 → 物理)是持久的、按请求独立、CPU 权威 GPU 镜像;它的正确性靠追加式写入与显式清行维护。
- 第二张表槽映射(token 位置 → 槽号)是瞬时的、每步重算,用一个 Triton 内核在 GPU 上查块表直接算,并用 -1 标记无效 token。
- 第三张表页索引不是一种独立的数据,而是块表在不同内核接口下的物化形式:二维 stride(FlashAttention)或 CSR 指针(FlashInfer)。
- 无效区域的容错靠三类数分工:块表用 0 号 null block、槽映射用 -1、序列长度用后端定义的常数。三者的对应关系一旦错位,症状是 KV 污染而不是崩溃。
- 是否用这套分页机制,就是 KV Cache 的页粒度 那笔账的另一种表述;SGLang 的 page size 1 是乘法消去之后的一种替代记法。
参考资料
- Efficient Memory Management for Large Language Model Serving with PagedAttention — Kwon et al., SOSP 2023
- SGLang: Efficient Execution of Structured Language Model Programs — Zheng et al., 2023(RadixAttention 与前缀树)
- vLLM V1 源码:
vllm/v1/worker/block_table.py—BlockTable、ComputeSlotMappingKernel - vLLM V1 源码:
vllm/v1/worker/gpu_model_runner.py—commit_block_table、_get_block_table、_get_slot_mappings - vLLM V1 源码:
vllm/v1/attention/backends/flashinfer.py—_compute_flashinfer_kv_metadata、_copy_page_indices_kernel - vLLM V1 源码:
vllm/v1/attention/backends/utils.py—PAD_SLOT_ID、NULL_BLOCK_ID - vLLM V1: A Major Upgrade to vLLM’s Core Architecture — 持久化批处理与前缀缓存的新架构
- vLLM 文档:Prefix Caching 设计
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



