


TensorRT-LLM 源码完全拆解(二十八):迭代统计与性能监控——一次 GPU 前向的时间、KV 与吞吐,是在哪个进程里被记成账的
一、先把三本账分开
讨论“推理框架的性能监控”时,最容易犯的错误是把三件不同的事混成一件:
- 单请求账:一条请求从到达、被调度、第一次前向、第一次吐字,到最后一个 token,各段时间是多少。它关心的是尾延迟,回答“这一条为什么慢”。
- 迭代账:引擎第 N 步调度了多少条请求、多少 context token、多少 generation token、KV 块用了多少、GPU 显存涨了多少、草稿 token 被接受了几成。它关心的是稳态行为,回答“这台引擎现在在干什么”。
- 进程与硬件账:进程的 CPU 时间、GPU 利用率、显存峰值、能耗。它关心的是容量规划,回答“这台机器还能不能加负载”。
TensorRT-LLM 把前两本账做得非常细,第三本账则部分交给外部工具(Nsight Systems、Prometheus node exporter)。本文只讲前两本,因为它们最贴近“读源码”这件事。
1.1 为什么在 TensorRT-LLM 里记账特别难
如果引擎是单进程、单卡、同步执行,记账会很简单:一次循环开始时取时间戳,结束时再取一次。但 TensorRT-LLM 的 PyExecutor 恰好把三个复杂度叠在了一起。
第一,执行是异步的。 _forward_step 只是把 kernel 发射到 stream 上就返回了,CPU 侧时间戳记下的是“发射完成”,不是“算完”。如果直接用 time.time() 包住前向,量出来的是 launch 开销,可能只有几百微秒,而真正的 kernel 执行在 GPU 上跑了几毫秒。这就是必须用 CUDA Event 的原因:Event 由 GPU 时间线打点,elapsed_time 才是设备侧真实耗时。
第二,CPU 与 GPU 可以错开一拍。 overlap scheduler 的设计是:本拍先把上一拍的采样结果处理掉、把下一批组好,同时 GPU 还在跑本拍的前向。这意味着“这一拍的 CPU 墙钟”和“这一批的 GPU 时间”描述的不是同一段时间。源码里对此有非常明确的注释(后面第六节会展开),如果读账的人不知道这一点,就会把 iterLatencyMS 当成单步耗时,得出完全错误的结论。
第三,账本要跨进程、跨 rank。 PyExecutor 跑在独立的 worker 进程里,HTTP 前端在另一个进程;开了 attention DP 之后,每个 rank 只看得见自己那一份 batch;开了 PP 之后,一条 batch 的生命周期横跨多个 rank 的多次循环。任何“全局统计”都必须先定义清楚:谁负责采集、谁负责汇总、汇总时如何对齐。
这三条决定了 TensorRT-LLM 的监控代码不是“打日志”,而是一套小型分布式系统。
1.2 全篇地图
本文沿着一条请求和一次迭代的路径,依次拆开下面这些东西:
PerfMetricsManager:怎样用一对 CUDA Event 切出 forward 与 sample 两段;PerfTimingInfo:逐请求保存的ctx_chunk_metrics与step_metrics;IterationStats:引擎级快照的字段来源与构造时机;kv_cache_stats:两级池、pool group、life cycle 的 KV 账本序列化;ADPIterStatsBuffer与TLLM_METRICS_ALL_RANKS:多 rank 下谁记账、谁汇总;MetricsCollector与/metrics:从 dict 到 Prometheus 指标的最后一跳;perf_metrics.py:响应头、SSE 事件、JSONL 落盘与跨机时钟对齐;PyExecutorProfileManager:统计之外的 trace 路径。
先看整体位置。下面这张图来自 TensorRT-LLM 官方文档,画的是引擎的模块分层:Executor/Worker 在进程边界一侧,模型执行与 kernel 在另一侧。本文讨论的统计代码,全部位于 Executor 与 Worker 之间的那一层——它看得见调度决策,也看得见前向发射,但不进入 kernel 内部。
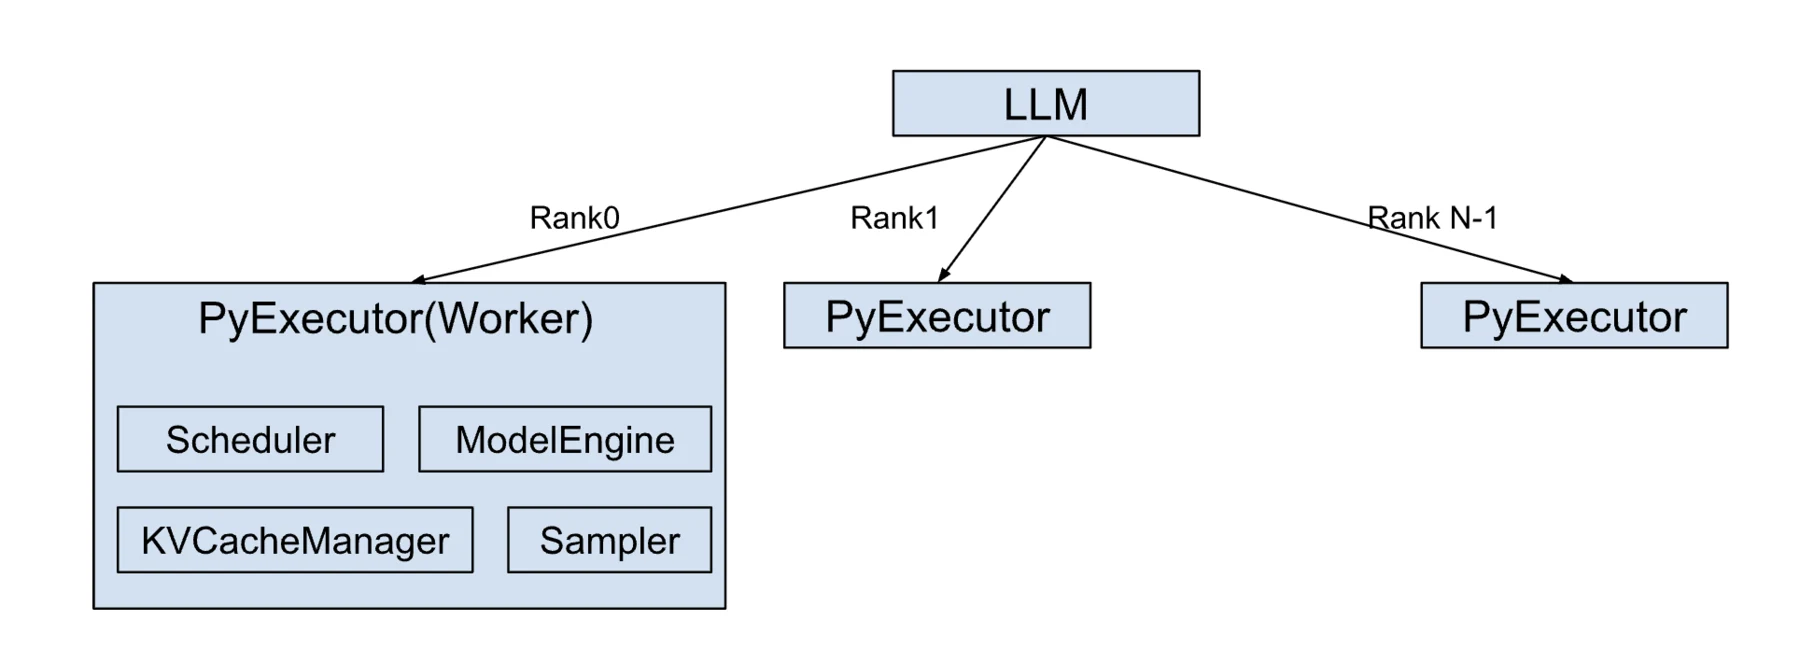
图源:TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Architecture_Overview.png。
理解这张图的关键是:统计的粒度由进程边界决定。跨进程之后,一条 IterationStats 必须先序列化成 JSON 才能通过 RPC 传出去;这也解释了为什么源码里到处是 to_json_str() 和 camelCase 键名。
二、PerfMetricsManager:一对 Event 切出的两段
2.1 为什么是“两段”而不是“一段”
直觉上,一次 decode step 就是一次前向。但源码切成三段:forward 前、forward 后、sample 后。
def create_timing_events(self): if not self.enabled: return None, None, None if self._perf_events is None: self._perf_events = [ tuple(torch.cuda.Event(enable_timing=True) for _ in range(3)), tuple(torch.cuda.Event(enable_timing=True) for _ in range(3)), ] self._perf_event_idx = 0 events = self._perf_events[self._perf_event_idx % 2] self._perf_event_idx += 1 return events返回三元组 (gpu_forward_start, gpu_forward_end, gpu_sample_end)。在 executor 循环里,用法是这样的:
with self.perf_manager.record_perf_events( gpu_forward_start, gpu_forward_end) as fwd_timing: batch_outputs = self._forward_step(scheduled_batch)... with self.perf_manager.record_perf_events( None, gpu_sample_end) as sample_timing: sample_state = self._sample_async(scheduled_batch, batch_outputs)第一次 record_perf_events 记录 gpu_forward_start(进入前)与 gpu_forward_end(退出前)。第二次 record_perf_events 的 start 传 None,只记录 gpu_sample_end。于是:
其中 elapsed 是 torch.cuda.Event.elapsed_time,单位毫秒。
为什么要单独量 sample? 因为 decode 阶段每一步都要做 top-k/top-p 过滤与采样,在词表几十万、batch 几百的情况下,采样层的耗时有几百微秒,有时甚至超过该 step 的 GEMM 时间(decode step 的每个 GEMM 都是 thin GEMM,算力利用率本就不高)。把 sample 单独切出来,才能判断“step 慢是模型慢还是采样慢”。
为什么不把 logits 后处理也切出来? guided_decoder.execute() 在两次 record_perf_events 之间执行,它会被算进 gpu_sample_time 里。也就是说,“sample” 这一段在源码里实际含义是“从 logits 产生到 token 的整段”,包含语法掩码。这一点在解读数据时很重要:开了结构化输出后,这一段的时间会明显变长,但它不是随机采样本身变慢了。
2.2 乒乓:为什么两组 Event
Event 对象在 CUDA 里是轻量但并非免费的资源,每一步都新建 3 个 Event 会在长时间运行中累积可观开销。源码用两组三元组交替使用,第 N 拍用 A 组,第 N+1 拍用 B 组,第 N+2 拍再用 A 组:
拍 0: A0 A1 A2 ← 记录拍 1: B0 B1 B2 ← 记录,同时读取 A 组结果拍 2: A0 A1 A2 ← 复用前,A 组的结果必须已在拍 1 被读完源码注释写得很直白:
Uses ping-pong pattern (two sets of events, alternating per iteration) to avoid creating new events every step. Each set persists until the next same-parity iteration, which is safe because compute_batch_gpu_times reads the previous iteration’s events before they are reused.
这句话里藏着一个正确性约束:compute_batch_gpu_times 必须在同一组 Event 下次被复用之前完成读取。在 overlap 模式下,本拍结束时 GPU 可能还在跑本拍的前向,Event .query() 返回 False,所以读取时必须 synchronize():
if cache_key not in gpu_times_cache: if not perf.gpu_forward_end_event.query(): perf.gpu_forward_end_event.synchronize() if perf.gpu_sample_end_event and not perf.gpu_sample_end_event.query(): perf.gpu_sample_end_event.synchronize()cache_key 里包含三个 Event 的 id() 和 forward_start_time。为什么要加 CPU 时间戳?因为乒乓 Event 会被跨拍复用,只靠 Event 身份无法区分“这是哪一批”。加上 CPU 侧的 forward_start_time 之后,同一组 Event 在不同拍有不同的 key,缓存才能按批生效。
代价是什么? synchronize() 是阻塞的。为了不把这一个阻塞直接压在 executor 线程上,非 overlap 模式下 compute_batch_gpu_times 放在 _handle_responses 之后调用;overlap 模式下放在响应生成之前,并且用 gpu_times_cache 保证同一批只有一个请求真正触发同步,其余请求直接读缓存。
2.3 “按批算一次,摊给每个请求”
所有请求共享同一组 Event,因此 GPU 时间天然是批级的。源码的做法是:找到每个请求最新的那条 metric(gpu_forward_time == 0 的那条),把批级时间填进去。
target = Noneis_ctx = Falseif perf.ctx_chunk_metrics and perf.ctx_chunk_metrics[-1].get("gpu_forward_time", 0) == 0: target = perf.ctx_chunk_metrics[-1] is_ctx = Trueelif perf.step_metrics and perf.step_metrics[-1].get("gpu_forward_time", 0) == 0: target = perf.step_metrics[-1]这个“等于 0 表示还没填”的约定,是一种廉价的哨兵值。它带来的副作用是:如果某次真的算出了 0ms(例如事件记录失败被兜底成 0.0),下一次调用会重复填同一个位置。实际影响很小,因为出错的批本来就没有有效数据。
对 context 阶段,还要把每个 chunk 的 GPU 时间累加:
if is_ctx: if perf.ctx_gpu_forward_time is None: perf.ctx_gpu_forward_time = 0.0 perf.ctx_gpu_sample_time = 0.0 perf.ctx_gpu_forward_time += batch_gpu_forward_time perf.ctx_gpu_sample_time += batch_gpu_sample_time为什么 context 要累加而 generation 不用?因为一条长 prompt 会被 chunked prefill 切成多个 chunk,每个 chunk 可能落在不同拍(甚至与其它请求合批),单次 chunk 的 GPU 时间不能代表这条请求的 prefill 开销。累加后的 ctx_gpu_forward_time 才是“这条请求真正为 prefill 花了多少 GPU 时间”。
2.4 一次迭代被切成的三段
下面这张图把一次 decode 迭代的 CPU 与 GPU 两条时间轴画在一起,标出三段时间与两组 Event 的对应关系。
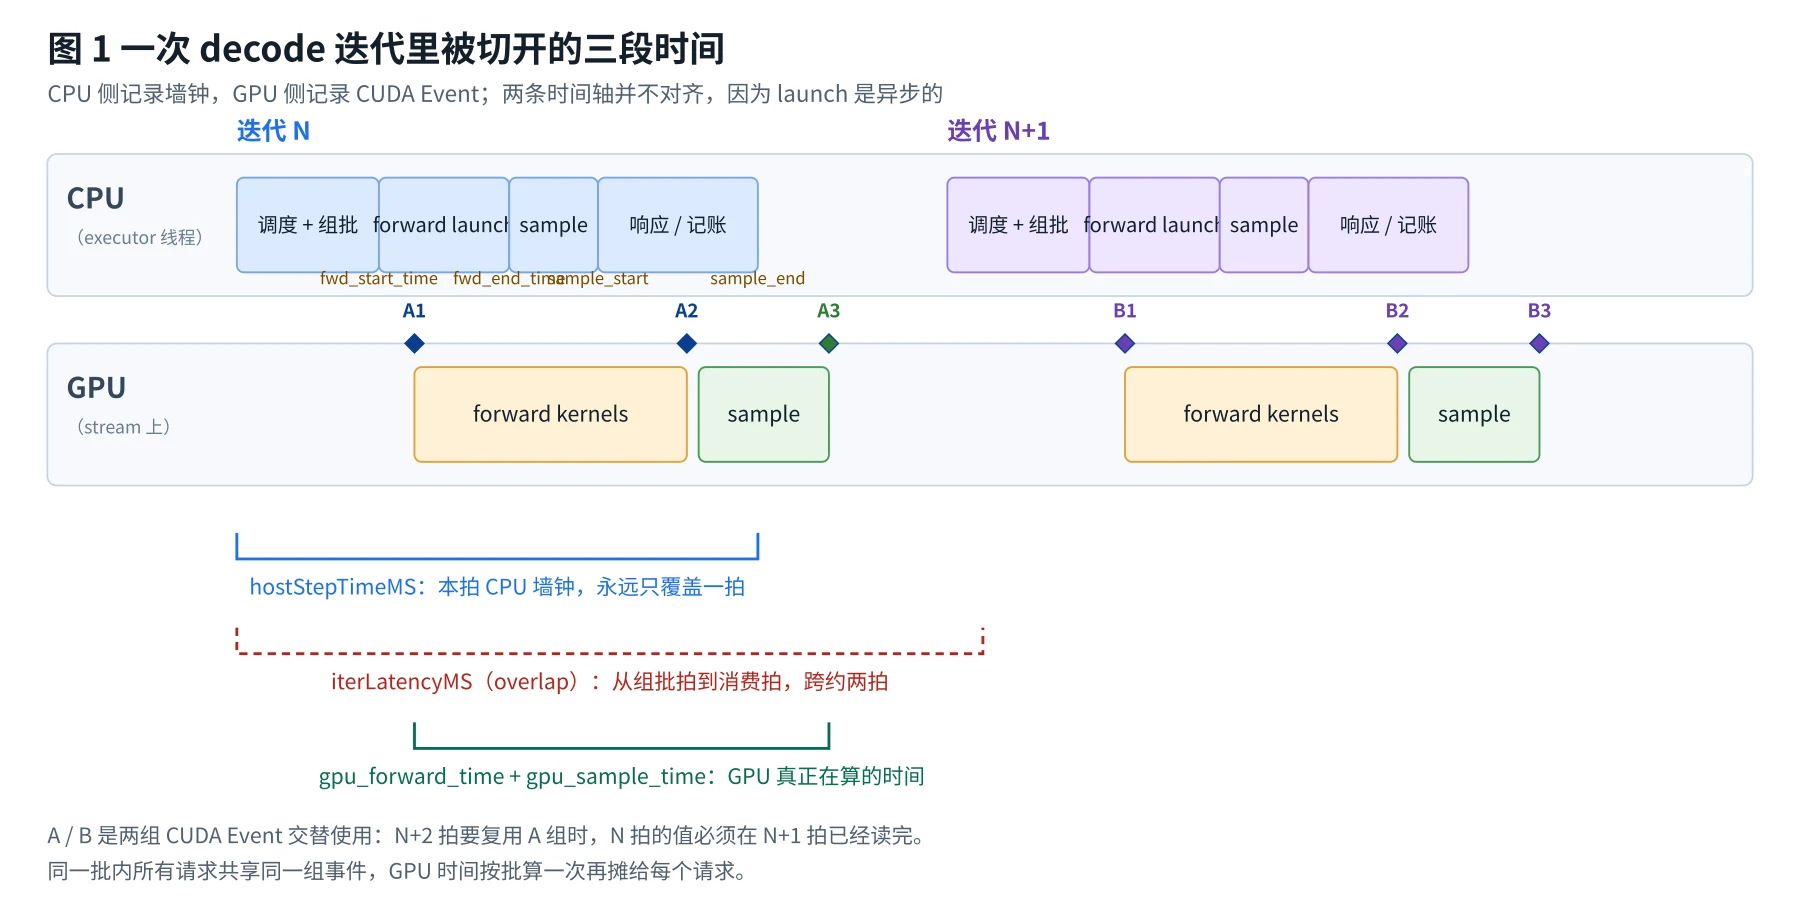
图为本文据源码绘制。A1/A2/A3 与 B1/B2/B3 是交替使用的两组 CUDA Event;红虚线是 overlap 模式下 iterLatencyMS 的实际跨度。
读图要点:
- CPU 侧
fwd_start_time与 GPU 侧 A1 之间有一个时间差,那是 launch 延迟;越往后的迭代,CPU 越“跑到前面”,差值越大。 - 在非 overlap 模式下,一条请求的
iterLatencyMS就对应图中迭代 N 的整段;在 overlap 模式下,它对应“迭代 N 开始组批”到“迭代 N+1 消费完成”的整段,约等于两拍。 - GPU 时间(A1→A2、A2→A3)与 CPU 时间不在同一坐标系,不能相减。
三、逐请求账本:PerfTimingInfo 的两种列表
3.1 结构
每个 LlmRequest 上挂一个可选字段:
@dataclassclass PerfTimingInfo: step_metrics: List[Dict] = field(default_factory=list) ctx_chunk_metrics: List[Dict] = field(default_factory=list) forward_start_time: Optional[float] = None forward_end_time: Optional[float] = None sample_start_time: Optional[float] = None sample_end_time: Optional[float] = None gpu_forward_start_event: Optional[torch.cuda.Event] = None gpu_forward_end_event: Optional[torch.cuda.Event] = None gpu_sample_end_event: Optional[torch.cuda.Event] = None ctx_gpu_forward_time: Optional[float] = None ctx_gpu_sample_time: Optional[float] = None ctx_chunks_complete: bool = False注意它是惰性创建的:构造请求时 py_perf_timing 为 None,只有在该请求被调度、且 return_perf_metrics 打开时,save_timing_to_requests 才会第一次实例化。这是为了让“不开监控”的请求不承担任何额外内存。
3.2 ctx 与 gen 的分界
append_step_metrics 决定这条 metric 该进哪个列表:
is_ctx = ( not request.is_generation_only_request and not perf.ctx_chunks_complete and request.py_decoding_iter <= 1)三个条件缺一不可:
not is_generation_only_request:P/D 分离的 decode 端,请求一进来就是 generation,不能算 context。not ctx_chunks_complete:context 的所有 chunk 已记录完。py_decoding_iter <= 1:py_decoding_iter == 0是中间 chunk(这一拍还没跑采样器),== 1是最后一个 chunk(或唯一的 chunk)。
这个判据的解释在第 2 节的时间线里很清楚:chunked prefill 的中间 chunk 不更新 py_decoding_iter,直到最后一个 chunk 采样出第一个 token 时才变成 1。
并且,函数开头有一个去重检查:
for metrics_list in (perf.step_metrics, perf.ctx_chunk_metrics): if metrics_list and metrics_list[-1]["forward_start_time"] == perf.forward_start_time: return这条检查处理的情况是:这一拍该请求没被调度,forward_start_time 还是上一拍的值,那就不要重复记一条。这个条件也说明,append_step_metrics 是在 _handle_responses 对每个活跃请求逐个调用的,而不是对“本拍被调度的请求”调用——它必须先自己筛一遍。
3.3 每个 metric 条目里有什么
metric = { "forward_start_time": perf.forward_start_time, "forward_end_time": perf.forward_end_time, "sample_start_time": perf.sample_start_time, "sample_end_time": perf.sample_end_time, "gpu_forward_time": 0, "gpu_sample_time": 0,}step_token_time = batch_token_time or get_steady_clock_now_in_seconds()metric["token_time"] = step_token_timetoken_time 是整批共用的时间戳(batch_token_time 在 _handle_responses 开头取一次)。它存在的意义是给“批内所有请求的打点”一个共同锚点,方便外部分析时按批聚合。
generation 条目额外有 iter 字段:
else: metric["iter"] = request.py_decoding_iter perf.step_metrics.append(metric)也就是说,一个请求的 step_metrics 列表长度等于它实际被调度解码的步数,iter 是它自己的解码步号,而非引擎的全局 iter_counter。这两个编号会分叉:一条请求可能在第 100 步才加入,它的 iter=1 对应引擎的 iter_counter=100。分析时如果混用,会得到毫无意义的对齐。
3.4 为什么不随流式响应发送
create_response 里有一段:
time_breakdown_metrics = Noneif is_final and self.py_perf_timing is not None: time_breakdown_metrics = {} if self.py_perf_timing.step_metrics: time_breakdown_metrics['step_metrics'] = self.py_perf_timing.step_metrics.copy() ...注释直接给出了原因:
Only include time_breakdown_metrics in the final response to avoid O(N²) overhead during streaming (copying all step_metrics for every token is very expensive)
一条生成 4000 token 的请求,如果在每个流式包都复制 step_metrics,就是 4000 次长度为 1 到 4000 的列表复制,总量是 8×10⁶ 级 dict 拷贝。对于前端高并发场景,这足以把服务打满。所以只在 final 包里带一次。
这也意味着:流式用户拿不到逐请求的时间明细。要拿明细,只能走 JSONL 落盘(第七节)或等 final 包(非流式)。这是设计上的取舍,不是缺陷:流式场景关心的是实时首字延迟,整段明细留到请求结束时一次性写出更合适。
3.5 内存估算
一条 4000 token 的请求,step_metrics 有 4000 条 dict,每条大约 6 个键,Python dict 开销约 230 字节加上 6 个 float/int 约 200 字节,合计约 430 字节,4000 条约 1.7 MB。一个 512 并发的服务,假设平均生成长度 1000,总量约 220 MB。这个数不小,所以:
- 默认关闭,只有
return_perf_metrics打开才创建; - 请求结束时随响应送出(非流式)或写入 JSONL,之后请求对象整体释放;
- 没有“只保留最近 N 步”的截断机制——要做持续采样,源码的选择是关闭逐请求开关,改用采样后的迭代账本。
四、IterationStats:引擎级快照怎么造出来
4.1 构造点决定了 iter 字段的语义
def _get_init_iter_stats(self, num_new_active_requests, new_active_requests_queue_latency_ms): stats = IterationStats() # Stamp iter at construction time so the JSON `iter` field identifies # the loop that CONSTRUCTED this batch. stats.iter = self.iter_counter stats.timestamp = datetime.datetime.now().strftime("%m-%d-%Y %H:%M:%S.%f") stats.num_new_active_requests = num_new_active_requests stats.num_active_requests = len(self.active_requests) stats.new_active_requests_queue_latency_ms = ...源码特意强调:iter 必须在构造时打,不能在消费时用 self.iter_counter 重打。原因写在注释里——在 overlap 与 PP 调度器下,_process_iter_stats 是在后面的某一拍消费这条记录的,如果那时再读 iter_counter,记录会错位 1 拍以上。
这是一个非常典型的“分布式记账”问题:记录的生成时间与记录的落账时间不是同一时刻。所有以 self.iter_counter 为基准的关联(KV 统计的间隔判断、ADP 按 iter 对齐、外部按 iter 对时)都依赖 stats.iter 正确,所以必须把“这批是哪一拍组的”作为一个不可变字段随记录一起传递。
4.2 只在被抽样的拍建记录
if not self.enable_iter_perf_stats: return Noneself._pending_num_new_active_requests += num_new_active_requestsif self.iter_counter % self.iter_perf_stats_interval != 0: return Nonereturn self._get_init_iter_stats(0, self._get_new_active_requests_queue_latency())两件事同时发生:
- 新请求计数先累加到
_pending_num_new_active_requests,不论这一拍是否被抽样; - 只有
iter_counter % interval == 0的拍才真正建对象,并且把 pending 计数转账进记录(_take_pending_new_active_requests)。
为什么要转账?因为 numNewActiveRequests 是“这一段时间内新进了多少请求”,如果只统计被抽样那一拍的增量,interval=10 时读数会周期性地变成 0 或 1,看起来像流量骤降。转账之后,每条记录覆盖的是“自上一个被抽样的拍以来”的区间,累计和才准确。
完成数也是同样的逻辑,在 _process_iter_stats 里累加、在建立记录时清空。
4.3 采样间隔不是随便设的
iter_perf_stats_interval 有两个约束:
- 它必须整除 KV 统计的
iteration_stats_interval。源码在启动时会检查并抛错:
kv_cache_config.iteration_stats_interval (...) is not a multiple of ...- 它的值决定了
iterLatencyMS的粒度。interval 太大,短时的抖动(比如一次抢占引发的尖峰)会被平均值抹平;interval 太小,采集本身(构造对象、拷贝字段、序列化)会成为负担。
实践中 1 到 10 都是常见取值;默认接近每拍一次,用于压测时观察每一步。
4.4 提前采集:为什么 ScheduledBatchStats 要在 forward 之前算
def _collect_scheduled_batch_stats(self, scheduled_batch): """Collect scheduled-batch counters before forward mutates requests."""forward 会修改请求状态:context_current_position 前进、context_chunk_size 归零、py_decoding_iter 递增。如果等在 _process_iter_stats 里再读,读到的是“跑完之后”的状态,算出来的 num_ctx_tokens 就会错。
所以源码在组批完成、forward 之前先抓一份快照:
num_ctx_tokens += chunk + encoder_replay_tokens(req)num_ctx_kv_tokens += startnum_ctx_kv_tokens 用的是 start(chunk 的起始位置),这是这条请求在这一拍里需要读取的历史 KV 长度;num_ctx_tokens 是这一拍新算的 token 数。两者相加才是 attention 在这一拍实际处理的 KV 总长。把这两个数分开,是判断“这一拍是算力受限还是带宽受限”的关键依据:
- 若
num_ctx_tokens远大于历史长度,说明是 prefill 主导,算力受限; - 若历史长度远大于新增 token(典型的 decode),说明是 KV 读取主导,带宽受限。
这比只看 “context 请求数” 要有信息量得多。
4.5 _update_iter_stats 逐字段拆解
这个函数负责把“这一拍的观测”填进记录。挑几个关键字段。
iter_latency_ms
iter_latency_ms = (iter_end_time - batch_state.iter_start_time) * 1e3看起来平平无奇,但下一节会专门讲它为什么在 overlap 下等于两拍。这里先记住:iter_start_time 是 BatchState 带过来的,跟着这一批走。
gpu_mem_usage
end, total_gpu_memory = torch.cuda.mem_get_info()stats.gpu_mem_usage = total_gpu_memory - endstats.cpu_mem_usage = 0stats.pinned_mem_usage = 0注意 cpu_mem_usage 与 pinned_mem_usage 被明确置 0。这两个字段在 C++ 执行路径里有意义,在 PyTorch 路径里没有采集。留 0 而不是删字段,是为了让下游按固定 schema 解析时不至于缺键;但它也意味着“看到 0 就以为是 0 字节”是错的,应该理解为“未采集”。
KV 统计的间隔与对齐
if (stats.iter % self._kv_iter_stats_interval == 0 and self._last_kv_iter_stats_fetch_iter != stats.iter): self._latest_kv_iter_stats = kv_cache_manager.get_iteration_stats() self._last_kv_iter_stats_fetch_iter = stats.iterelse: self._latest_kv_iter_stats = None三个细节:
- 用
stats.iter而不是self.iter_counter取模。原因同 4.1:消费拍 ≠ 构造拍。 _last_kv_iter_stats_fetch_iter去重,防止同一拍被消费两次(PP 的 micro batch 场景)。- 不在间隔拍时显式置
None,避免把上一拍的 KV 快照“粘”到这一拍。如果粘了,Prometheus 侧会把一个 delta 计两次。
投机解码统计
acceptance_length = float(total_accepted_tokens + num_requests_with_draft) / float(num_requests_with_draft)draft_overhead = 0.0 if iter_latency_ms <= 0.0 else float(draft_latency_ms) / float(iter_latency_ms)acceptance_length 定义为“每个有草稿的请求,平均产出多少个 token”。分子里 + num_requests_with_draft 是加上每条请求必得的那个 target token;分母是请求数。所以 acceptance_length = 1 表示草稿全被拒(每条只出 1 个),= 4 表示平均接受 3 个草稿 token。这个定义与 EAGLE 论文里常用的 “accepted tokens per step” 口径一致,但和 “acceptance rate”(接受 token 数 / 草稿 token 数)不是一回事。二者容易混淆:acceptance_length 上界是 1 + draft_len,acceptance_rate 上界是 1。
draft_overhead 是草稿耗时占整步耗时的比例。它在工程上比 acceptance_length 更能反映“这一枪开得值不值”:接受长度 3 但草稿耗时占了 60%,实际端到端收益可能只有 1.2 倍。
4.6 一个完整的 IterationStats 字段表
把散落在 _update_iter_stats 与 _get_init_iter_stats 的字段汇总:
| 字段 | 类型 | 来源 | 含义 |
|---|---|---|---|
iter | int | 构造时 | 组这一批的循环号 |
timestamp | str | 构造时 | 本地时间,微秒 |
iterLatencyMS | float | 消费时 | 见下一节,overlap 下跨两拍 |
numActiveRequests | int | 消费时 | 本拍结束时活跃请求数 |
numQueuedRequests | int | 消费时 | 请求队列长度 |
numNewActiveRequests | int | 转账 | 自上个抽样拍以来新增 |
numCompletedRequests | int | 转账 | 自上个抽样拍以来完成 |
maxNumActiveRequests | int | 配置 | 引擎上限 |
gpuMemUsage | int | mem_get_info | 全进程 GPU 占用 |
cpuMemUsage / pinnedMemUsage | int | 置 0 | 未采集 |
kvCacheStats | dict | KV 管理器 | 池容量、命中率、块增量 |
inflightBatchingStats | dict | 组批 + 快照 | 上下文/生成请求数、token 数 |
specDecodingStats | dict | 投机层 | 草稿数、接受数、接受长度、开销占比 |
inflightBatchingStats.numCtxTokens 等 | int | forward 前快照 | ctx/gen 的 token 与 KV 长度(由 ScheduledBatchStats 折算进来) |
hostStepTimeMS(JSON 附加) | float | profiler | 干净的 CPU 单拍墙钟 |
gpuForwardTimeMS(JSON 附加) | float | Event | 与这批匹配的 GPU 前向时间 |
schedulerMode | str | overlap / non_overlap | 解释 iterLatencyMS 的前提 |
最后三行是后来加的,加它们的原因,正是下一节要讲的“语义歧义”。
五、两拍还是三拍:iterLatencyMS 的语义陷阱
5.1 源码里那段罕见的长注释
_process_iter_stats 开头写着:
# iterLatencyMS semantics differ by scheduler:# - Overlap / PP: batch_state.iter_start_time was captured at the top# of the loop that BUILT this batch (one or more loops ago). The# end timestamp is taken here, during the consuming loop. So# iter_latency_ms spans roughly two loops and tracks the batch's# full lifecycle, not the loop body that produced it. Under steady# state, sum(iterLatencyMS) ≈ 2 × wall_time.# - Non-overlap: iter_start_time was captured at the top of THIS# loop and the end is taken at the bottom of the same loop, so# iterLatencyMS is the clean per-loop CPU wall.这段话值得逐句拆。
为什么 overlap 下会跨两拍? 因为 overlap scheduler 把“组批 + 调度”和“处理上一批的结果”放在同一拍里,而前向是在组批之后发射的、结果要到下一拍才被消费。于是 BatchState 在拍 N 创建(带 iter_start_time = t_N),在拍 N+1 被 _process_iter_stats 消费,iter_end_time = t_{N+1}。差值就是“一批从诞生到被结算”的全生命周期。
为什么说 sum(iterLatencyMS) ≈ 2 × wall_time? 因为稳态下每一拍都在结算上一批、同时开启下一批,任何时刻都有约两批“在账上”。把一秒内的所有 iterLatencyMS 加起来,约等于两倍的实际墙钟。如果有人拿这个数除以步数去算“平均单步延迟”,会得到约两倍的真实值。
为什么又说它其实也有用? 因为它衡量的正是端到端排空时间:一条请求从被调度到结果可用,确实要经历这约两拍。对于吞吐不敏感、对单步延迟敏感的场景,这个数更贴近用户感知。但前提是读者知道自己看的是哪一个口径。
5.2 三个时间字段同时存在
正是因为上面这种歧义,源码在同一份记录里放了三个时间:
| 字段 | 谁采集 | 语义 | 适用场景 |
|---|---|---|---|
iterLatencyMS | executor | overlap 下跨两拍;non-overlap 下单拍 | 需要“端到端排空时间” |
hostStepTimeMS | profiler 的 profile_step | 永远是一个干净的 CPU 循环墙钟 | 需要“单拍 CPU 耗时” |
gpuForwardTimeMS | 与这批匹配的 CUDA Event | 这批的 GPU 前向时间 | 需要“GPU 算得多快” |
schedulerMode 字段存在的唯一目的,就是让消费方知道该按哪种口径解释 iterLatencyMS:
is_overlap_like = (not self.disable_overlap_scheduler or self.dist.pp_size > 1)scheduler_mode = "overlap" if is_overlap_like else "non_overlap"注意 PP 被无条件归入 overlap-like:因为 _executor_loop_pp 在拍 N 入队 BatchStatePP,在后面的拍消费,结构上就是跨拍。
5.3 怎么用这些数
如果要做容量规划,用 hostStepTimeMS 与 gpuForwardTimeMS:它们都只描述一拍,可以安全地取平均、求和、算 P99。
如果要评估“加了 batch 之后单请求变慢多少”,用 iterLatencyMS 反而更合适,因为它包含了在 overlap 结构里等一整拍的成本。
如果要做 kernel 级归因,三个都不够,得上 Nsight Systems。
一个常见的误用:把 iterLatencyMS 求和除以 token 数,得到 “每 token 毫秒”。这个数在 overlap 下会偏大一倍;正确的是用 1 / (吞吐 × 1000) 反推,或者用 TPOT 指标(在请求级账本里由采样点差值算出)。
六、采样间隔与计数器的“转账”
下面这张图展示 iter_perf_stats_interval = 3 时,哪些拍被抽样、pending 计数如何累积到被抽样的拍,以及“批跑空”时的例外补发。
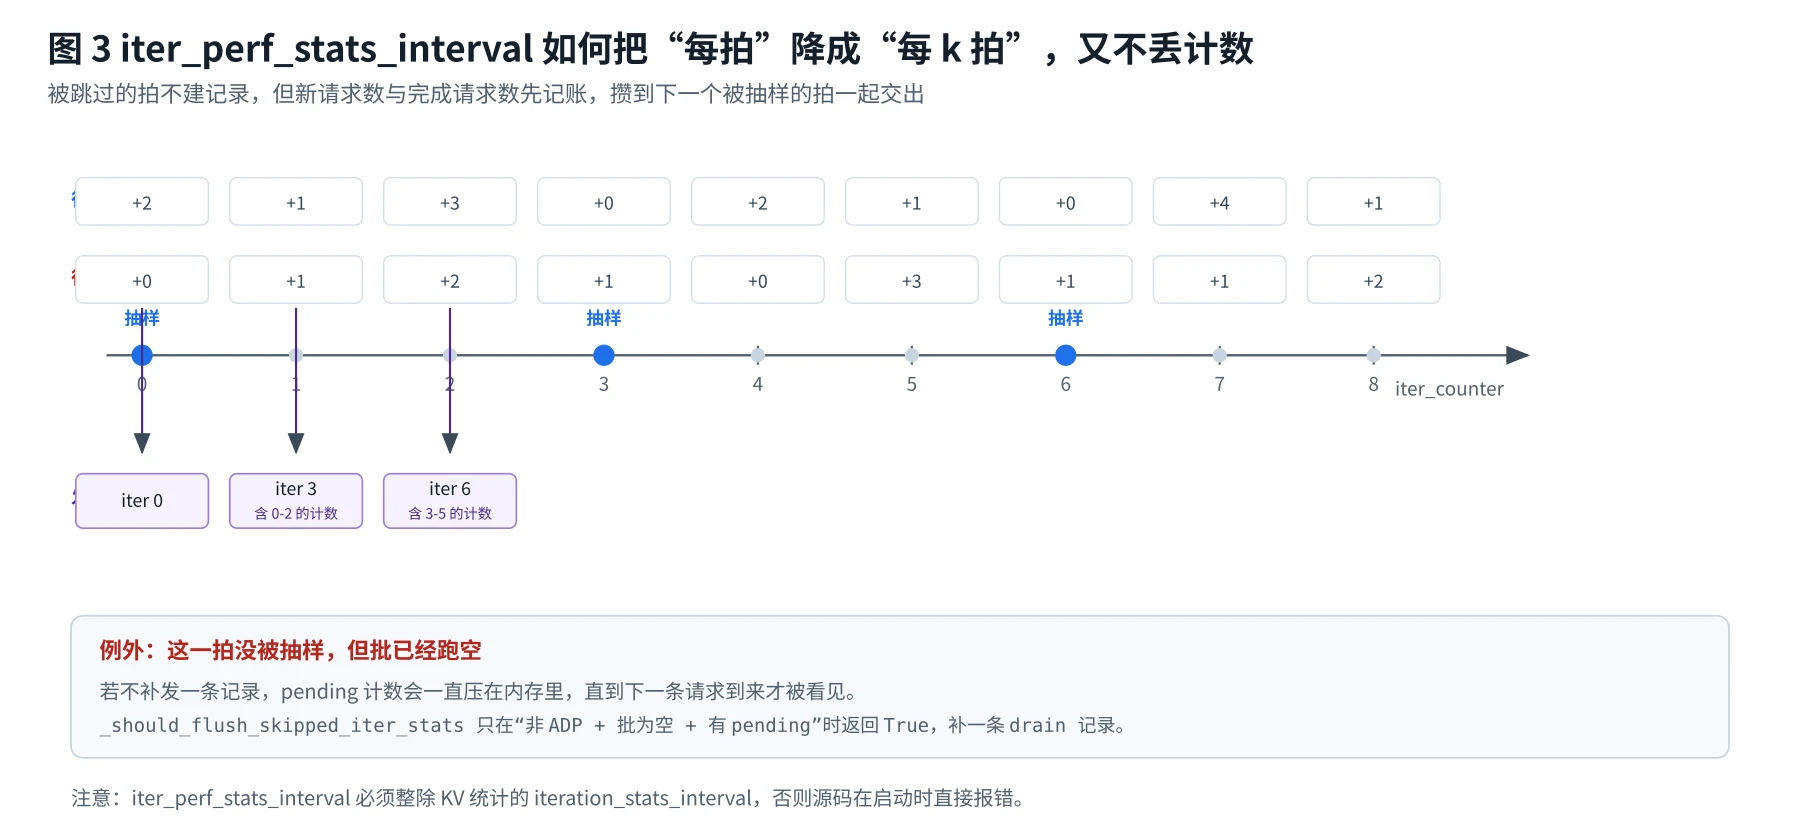
图为本文据 _init_iter_stats_if_sampled、_take_pending_new_active_requests、_should_flush_skipped_iter_stats 绘制。
图中三个机制,逐个解释:
机制一:抽样只由 iter_counter 决定。 注释说明这是为了让 attention DP 的各个 rank 抽到相同的拍:
The decision only depends on
iter_counter, which advances in lockstep on all ranks, so Attention-DP ranks sample the same iterations and their stats payloads stay aligned.
如果改用“每 rank 自己的计数”或“本拍是否有活”,各 rank 的采样就会错开,ADP fanout 时无法按 iter 对齐。
机制二:pending 计数转账。 未被抽样的拍不建对象,但 _pending_num_new_active_requests 与 _pending_num_completed_requests 继续累加;到被抽样的拍,一次转入记录并清零。这样,记录的累计和是精确的,只是分布被压缩了。对 Prometheus 的 counter 语义来说,这是正确的:counter 只关心总量,不关心采样密度。
机制三:批跑空时补发 drain 记录。
return (self.iter_perf_stats_interval > 1 and not self.enable_attention_dp and not active_requests and (self._pending_num_completed_requests > 0 or self._pending_num_new_active_requests > 0))如果没有这条,引擎在最后一批完成之后会进入空转,再也不会有被抽样的拍,pending 一直压在内存里,直到下一条请求到来才被一起交出。对“做基准测试、跑完就停”的场景,这会直接导致最后一段统计数据丢失。
为什么 ADP 下不补发?因为 ADP 的 fanout 需要所有 rank 在同一 iter 上齐步;某个 rank 单独补一条,会让它的 payload 领先其它 rank,破坏对齐。宁可丢这一点,也不能让 fanout 卡死。
为什么 interval = 1 时不补发?因为每拍都抽样,不存在 pending 堆积。
6.1 一个容易忽略的细节:pending 计数与“本拍”的关系
_init_iter_stats_if_sampled 传入的 num_new_active_requests 参数并没有直接使用,而是先加到 pending,再以 0 传给 _get_init_iter_stats。真正转账发生在组批之后:
iter_stats = self._take_pending_new_active_requests(iter_stats)位置很关键:它发生在 can_queue 分支里、_process_iter_stats 之前。也就是说,“这一拍新进的请求”会先进入本拍的记录,而不是下一拍。如果顺序反过来,第一条记录永远是 0,第二条才补上,外部看会出现“启动时零流量”的假象。
七、KV 的迭代账本:两级池、pool group 与 life cycle
7.1 为什么 KV 统计不能只报“用了多少块”
V1 时代的 KV 统计很朴素:总块数、空闲块数、已用块数、命中率。到了 V2,KV 管理器支持了多级缓存(GPU hot、host cold、甚至 disk)、多种窗口长度(全注意力层与滑窗层共用池)、KV connector 与 SSM 状态槽。一个“已用块数”已经无法回答下面这些真实问题:
- 这 1000 个已用块里,有多少是 GPU 上的活跃块,有多少已经沉到 host 层?
- 前缀命中率是 0.6,但这 0.6 是全命中(整块复用)还是部分命中(块内部分 token 复用)?
- 上一步 onboard 了多少字节?offload 了多少字节?搬运是否成为了瓶颈?
- 滑窗层的窗口长度不同,它们各自的池水位是多少?
V2 的统计报告就是为了回答这些问题而设计的。
7.2 四种分组维度
kv_cache_stats.py 定义了一组 dataclass,把报告按四种维度切分:
按 window size 分组:by_window_size: dict[int, ...]。一条模型里可能同时存在全注意力层(窗口 = 序列长度)与滑窗层(窗口 = 固定值)。它们的 KV 生命周期不同,混在一个池里统计会让命中率没有意义。
按 pool group 分组:by_pool_group: dict[int, KVCacheV2PoolGroupIterationStats]。pool group 是一组共享同一物理池的层。不同 pool group 可以有不同 slot_size 与 window_sizes:
@dataclass(slots=True)class KVCacheV2PoolGroupIterationStats: pool_group_id: int slot_size: tuple[int, ...] window_sizes: tuple[int, ...] stats: Anyslot_size 是元组而不是整数,因为一个池里可能同时存 MLA latent(每 token 一份)与普通 K/V(每 token 两份)。
按 life cycle 分组:by_life_cycle。life cycle 描述的是“一批块从分配到释放的完整生命周期”,它可能跨多个请求(前缀复用)、多个 pool group。源码对 life cycle 单独统计,是因为“复用”这件事只有跨越请求边界才有意义。
按 cold pool group 分组:by_cold_pool_group。这是最容易读错的一个,源码特意加注释:
# Keyed by *cold* pool-group id, which is unrelated to the hot ids used by by_pool_group.hot pool group 里没有 cold 块,cold level 又独立地组织 life cycle,所以 cold 的 id 与 hot 的 id 在编号空间上毫无关系,不能互相索引。注释还解释了这样切分的原因:
A cold group spanning several hot groups is attributed to none of them above, so this is the only complete account of host/disk blocks.
也就是说,如果一个 host 层池对应了三个 GPU 池,那三个 GPU 池的统计里都不会包含它;只有 by_cold_pool_group 是完整的。
7.3 序列化的键名为什么是 camelCase
fields = { "primaryMaxNumBlocks": stats.primary_max_num_blocks, "primaryFreeNumBlocks": stats.primary_free_num_blocks, ... "iterAllocTotalBlocks": stats.iter_alloc_total_blocks, "iterReusedBlocks": stats.iter_reused_blocks, "iterFullReusedBlocks": stats.iter_full_reused_blocks, "iterPartialReusedBlocks": stats.iter_partial_reused_blocks, "iterMissedBlocks": stats.iter_missed_blocks, "iterCacheHitRate": stats.iter_cache_hit_rate,}Python 侧字段是 snake_case,序列化后是 camelCase。这不是随手起的名字,而是与 C++ 侧 IterationStats::to_json_str() 的键名保持一致。因为同一份 /metrics JSON 里,IterationStats 的顶层字段(numActiveRequests 等)来自 C++,KV 子字典则来自 Python;如果两边命名风格不同,下游解析器要写两套规则。
7.4 三种“复用”口径
iterFullReusedBlocks、iterPartialReusedBlocks、iterMissedBlocks 是三个互斥的计数:
- full reuse:整个块的全部 token 都能复用到,块被直接挂到新请求上,零拷贝;
- partial reuse:块内只有一部分 token 命中(典型场景是 prompt 的末尾与已有前缀共享前半块),需要拷贝或重算未命中部分;
- miss:这块完全没有命中,需要新分配并计算。
iterCacheHitRate 是由这三者算出来的(通常是 (full + partial) / total,具体分母看实现),所以它不能用来区分“命中质量”。一个 0.8 的命中率,可能是 80% 全命中,也可能是 80% 部分命中——后者的实际收益远小于前者。做容量评估时必须三个数一起看。
这三者的价值还在于它们的方向性:full 高说明前缀复用做得好,partial 高说明存在大量“前缀尾巴不一致”的请求(常见于多轮对话中被截断的历史),miss 高则可能是前缀缓存的淘汰策略太激进。
7.5 传输与搬运的四个字节计数器
"iterOnboardBlocks": ..., "iterOnboardBytes": ...,"iterOffloadBlocks": ..., "iterOffloadBytes": ...,"iterIntraDeviceCopyBlocks": ..., "iterIntraDeviceCopyBytes": ...,"iterHostDroppedBlocks": ..., "iterHostDroppedBytes": ...,这四个分别对应:从 host/disk 搬到 GPU、从 GPU 搬到 host/disk、GPU 内(或跨 GPU)的拷贝、因为空间不足被丢弃的块。
iterHostDropped* 是最值得盯的一个:它不为 0,意味着“本来想搬到 host 的块被扔了”,等价于缓存容量不足,命中率会随之下降。这个指标比 cacheHitRate 更早报警——命中率下降是结果,drop 是原因。
iterIntraDeviceCopyBytes 则在 copy-on-write 与部分复用时会增长。如果它很大,说明大量块在“部分命中”路径上被复制,这部分带宽会直接挤占 attention 的 KV 读取带宽。
7.6 冷池与 SSM 的快照统计
@dataclass(slots=True)class KVCacheV2SsmSnapshotIterationStats: iter_snapshot_lookups: int iter_snapshot_hits: int iter_snapshot_misses: int iter_reused_tokens: int iter_unreused_tokens: int iter_aligned_snapshot_hits: int iter_unaligned_snapshot_hits: int这是 Mamba/SSM 层的“状态快照”统计。SSM 层没有 KV Cache,只有一份递归状态;前缀复用时不能像 KV 那样按块挂接,只能靠周期性快照。aligned 与 unaligned 区分的是快照边界是否与请求的前缀长度对齐——不对齐的快照只能部分复用,收益打折。
这个字段组说明了一件事:“KV 统计”在混合模型里已经不是 KV 了。同一个报告里同时装着 attention 的块账本与 SSM 的快照账本,因为对服务系统来说它们都是“为了复用而缓存的历史状态”。
7.7 只在按需时计算
def get_iteration_stats(self): if not self.enable_stats: return None整个 V2 报告的构造(遍历所有 window、所有 pool group、所有 life cycle、读两级池的 storage statistics)开销不小。源码用 enable_stats 与调用侧的 _kv_iter_stats_interval 双重限制:只有打开迭代统计、且到了 KV 采样间隔,才真正构造一次。
调用侧还做了“按记录 iter 去重”的保护(见 4.5)。这两层限制叠加起来的效果是:即使外部 /metrics 被高频轮询,KV 统计也不会被反复重算。
八、多 rank:谁记账、谁汇总、collective 放在哪
8.1 Attention-DP 下的三份事实
开了 attention DP 之后,同一拍里每个 rank 处理的请求集合不同。于是出现了三份不同的事实:
- rank 0 独占的事实:请求队列只有 rank 0 有(前端把请求发给 rank 0,再由 router 分发)。因此
numQueuedRequests、numCompletedRequests、numNewActiveRequests这几个字段本质上是全局量,只有 rank 0 知道。 - 每 rank 独有的局部事实:本 rank 调度了多少 context/gen 请求、消耗了多少 token、KV 池用了多少块。这些必须每 rank 一份。
- 所有 rank 一致的事实:
iter、timestamp、iterLatencyMS的起点、gpuMemUsage的量级(同机同卡)。
ADPIterStatsBuffer._make_rank_iter_stats 做的正是按这三类分别处理:
for attr in _ITERATION_STATS_SCALAR_FIELDS: setattr(stats, attr, getattr(rank0_stats, attr))
if payload.kv_cache_stats is not None: stats.kv_cache_stats = _restore_kv_cache_stats(payload.kv_cache_stats)...if rank != 0: stats.num_queued_requests = 0 stats.num_completed_requests = 0 stats.num_new_active_requests = 0 stats.new_active_requests_queue_latency_ms = 0.0第一次循环把全局标量从 rank 0 复制过去;中间把本 rank 的 KV 快照“还原”成对象;最后把非 0 rank 的队列类字段清零。清零不是“没有数据”,而是“这个 rank 对这些字段不拥有真相”。如果不清零,下游做 sum 聚合时会把 rank 0 的队列长度重复算 N 次。
注释里也点明了这一点:
Queued fields remain rank-0/global because the executor request queue lives on rank 0.
8.2 为什么要输出“每 rank 一行”
一个自然的疑问:既然最终要聚合,为什么不直接输出一行全局汇总?
源码给的理由是负载不均的诊断:
Attention-DP emits one stats row per rank so downstream FPM consumers can see scheduling distribution and diagnose load imbalance.
如果只给汇总,你只能看到“这一拍总共 512 条请求”;给每 rank 一行,你能看到 rank 3 只有 40 条、rank 7 有 90 条,从而定位 EPLB 或者 router 的问题。对于 MoE 服务,这种不均是延迟的主要来源之一。
8.3 fanout 的对齐协议
ADPIterStatsBuffer.finalize 是一段值得细读的对齐逻辑:
iter_stats_iter = rank0_state.iter_stats.iter_stats_iterself._drop_before(iter_stats_iter)self._ensure_zero_payload(iter_stats_iter)
matching_states = [ s for s in all_rank_states if (s.iter_stats.has_iter_stats and s.iter_stats.iter_stats_iter == iter_stats_iter)]if len(matching_states) != len(all_rank_states): logger.debug(...) return []三个动作:
- 丢弃更老的 payload:
_drop_before。防止某个慢 rank 的旧数据永远卡在队首。 - 补零占位:
_ensure_zero_payload。某个 rank 这一拍没被抽样(比如它本地没有 batch),不代表它“缺席”;补一条has_iter_stats=1但计数为 0 的 payload,保证所有 rank 的 payload 数一致。 - 严格对齐后再 fanout:只有收齐所有 rank 同一 iter 的 payload,才生成记录;否则返回空,等下一拍再试。
为什么必须严格对齐?因为输出的是“同一 iter 的 N 行”。如果 rank 3 还是上一拍的数据,它会被标成当前 iter,导致时间错位。这种错位在下游按 iter 做差分会算出负值。
补零占位还有一层考虑,注释写得很好:
Ranks without local work for that iteration contribute an explicit zero payload on the next piggyback allgather instead of forcing a mixed-iteration skip.
也就是说,宁可多传一条零,也不要跳过一整拍——跳过会让统计出现空洞,空洞在监控上表现为“断点”,很难和真实故障区分。
8.4 TLLM_METRICS_ALL_RANKS:另一条 gather 路径
除了 ADP 的 fanout,还有一条更底层的路径:当 TLLM_METRICS_ALL_RANKS=1 且开了 TP 与 ADP 时,每个 rank 会把自己的 IterationStats 序列化成 dict,通过 tp_allgather 汇总到 rank 0:
local_dict = _json.loads(stats.to_json_str())if req_stats: local_dict["requestStats"] = [_json.loads(r.to_json_str()) for r in req_stats]append_kv_cache_iteration_stats(local_dict, kv_iter_stats)...self._pending_iter_stats_dict = local_dict然后在拍末统一 flush:
def _flush_iter_stats_synced(self): ... gathered = self.dist.tp_allgather(local_dict) if self.dist.tp_rank != 0: return这段代码里有两个非常工程化的细节。
为什么先序列化成 dict 再 gather,而不是直接 gather 对象? 因为 tp_allgather 走的是 Python 层集合通信,传对象需要 pickle,而 pickle 一个含有 torch.cuda.Event 引用的对象代价很高、且容易出错。序列化成纯标量 dict 之后,通信量可控。
为什么 flush 要单独提到循环末尾?
Lifted out of _append_iter_stats (same divergent-gate problem as the coordinator’s handle_timeouts_synced). Under ADP every rank sends either the local dict or
Noneevery iter so the gather stays in lockstep with peer collectives.
这是一条硬约束:collective 必须被所有 rank 在同一个“程序点”调用。如果它写在 if enable_attention_dp and stats is not None 这样的分支里,某些 rank 因为本地没数据而不进分支,就会和别的 rank 的 collective 错位,轻则挂起,重则数据错乱。
把 flush 从“按需 append”里提出来、放到每拍必到的位置,是修复这类 bug 的标准做法。同样的模式在 disagg.handle_timeouts_synced() 上也能看到。
8.5 三个 buffer 的职责边界
# All ranks: local per-iteration payloads waiting to piggyback on the# next ADP rank-state allgather.self._payloads: Dict[int, RankIterStatsPayload] = {}# Iteration IDs whose pending payload is an explicit zero placeholder,# not real measured local stats.self._synthetic_iters: Set[int] = set()# Rank 0 only: full IterationStats objects waiting for ADP fanout.self._rank0_iter_stats: Dict[int, IterationStats] = {}# Rank 0 only: per-request stats preserved for compatibility.self._rank0_req_stats: Dict[int, Optional[List[RequestStats]]] = {}四行注释把设计意图讲完了:
- 所有 rank 持有“轻量 payload”(一串整数与小型 KV 快照),挂在 rank-state allgather 上免费传输,不额外开 collective;
- rank 0 额外持有“重量对象”(完整的
IterationStats与RequestStats列表),因为 fanout 时需要把 rank 0 的全局字段复制到每一行; synthetic_iters标记占位 payload,避免在 fanout 时把零值当成真实测量。
RequestStats 只在 rank 0 保留,注释理由是“兼容性”。这其实是一个妥协:逐请求统计在 ADP 下天然是 rank-local 的,但如果每个 rank 都输出一行 RequestStats,下游按 request id 聚合时会重复。折中方案是只让 rank 0 输出,代价是其它 rank 的请求看不到逐请求明细。
8.6 PP 的额外复杂度
PP 下每一拍不止一批:BatchStatePP 带 microbatch_id,同一个 iter 可能有多个 micro batch。_process_iter_stats 接受 micro_batch_id 参数并写进 inflightBatchingStats。于是下游看到的是 “同一 iter、不同 micro_batch_id” 的多行记录。
这也是为什么 iterLatencyMS 在 PP 下必须按 overlap-like 解释:micro batch 的起点与结算点本来就隔了好几拍,再按单拍去理解就完全错了。
九、从 dict 到指标:Prometheus 侧的二次加工
9.1 两条消费路径
/metrics 端点返回的是 List[dict],也就是若干条 IterationStats 序列化后的 JSON。这些 dict 进入 MetricsCollector.log_iteration_stats 之后,被翻译成 Prometheus 的 gauge 与 counter。
但真正重要的不是字段名翻译,而是累积量到增量的换算。
9.2 为什么不能直接把 KV 计数当 counter 加
KV 管理器报出来的 reusedBlocks、missedBlocks 是累积值(自引擎启动以来),而不是本拍的增量。Prometheus 的 counter 只接受增量。所以收集器维护一份 per-rank 基线:
def _log_cumulative_kv_counter(self, counter, value, previous, rank, *, field_name): previous_value = previous.get(rank, 0) delta = value - previous_value if delta < 0: logger.warning( f"Cumulative KV cache {field_name} decreased for dp_rank={rank} " f"from {previous_value} to {value}; " "skipping increment and updating baseline.") elif delta > 0: self._log_counter(counter, {self.labelname_dp_rank: rank}, delta) previous[rank] = value这段代码里有两处值得说的地方。
第一,负增量不抛错,而是告警+重置基线。 为什么会出现负增量?因为服务可能经历了引擎重启、或者是 C++ 侧计数器回绕。如果直接把负值加到 counter 上,Prometheus 会报“counter went backwards”,更严重的是 rate() 会算出负速率,导致告警规则全部失真。跳过并更新基线,是唯一安全的选择。
第二,注释里明确说“这不解决问题”。
A decrease emits a warning and updates the baseline without incrementing the counter. This does not make stale or reordered snapshots safe.
也就是说,如果快照本身顺序错乱(本拍的数先到、上一拍的数后到),换算出来的 delta 就是错的,代码并不会帮你修正。这是一个明示的边界:上游必须保证按拍、按 rank 有序交付。
9.3 两套指标的归属
def log_iteration_stats(self, iteration_stats: dict) -> None: rank = str(int(iteration_stats.get("attentionDpRank", iteration_stats.get("rank", 0)))) if rank == "0": self._log_rank0_iteration_stats(iteration_stats) self._log_rank_iteration_stats(iteration_stats, rank)注释把归属讲得很清楚:
KV and local scheduling metrics use the dp_rank label, resolved from attentionDpRank, then rank, then 0 for unranked rows. Other iteration metrics are rank-0-owned measurements, not global aggregates.
具体地:
| 指标组 | 是否有 dp_rank 标签 | 原因 |
|---|---|---|
kv_cache_hit_rate、kv_cache_utilization、各种块计数 | 有 | 每 rank 独立 KV 池 |
num_context_requests、num_generation_requests、num_paused_requests | 有 | 每 rank 独立调度 |
iteration_latency_seconds、num_requests_running、num_requests_waiting | 无(仅 rank 0) | 全局视角 |
spec_decode_* | 无(仅 rank 0) | ADP fanout 时从 rank 0 复制而来 |
这个划分对外部仪表盘的设计有直接影响:如果你要画“集群 KV 利用率”,必须对 dp_rank 维度做聚合(sum by (instance));如果直接取一条曲线,你只能看到 rank 0 的利用率。
9.4 gauge 与 counter 的选择
源码对每类指标都做了明确选择:
kv_cache_hit_rate、kv_cache_utilization、iteration_latency_seconds是 gauge:它们表达“当前状态”,只需要最新值;kv_cache_reused_blocks、kv_cache_missed_blocks、kv_cache_gen_alloc_blocks_total是 counter:它们表达“累计发生了多少次”,需要随时间累加;prefill_batch_tokens之类的还有 histogram:它们需要分布统计。
一个容易踩的坑:kv_cache_utilization 是由 usedNumBlocks / maxNumBlocks 现算出来的,而不是 KV 管理器直接给的。源码这样做的理由是,不同版本的 KV 管理器给出的“已用”口径可能不同(是否包含预留块、是否包含可驱逐块),在收集器里统一算,可以保证同一套指标跨版本可比。
9.5 collector loop:为什么 /metrics 不能直接读引擎队列
openai_server.py 里有一段很长的注释:
When the background collector loop is active it is the sole consumer of the engine stats queue; serve /metrics from the tee buffer it populates so we do not race it for queue items. Racing caused >80% iteration loss and ~2s per-call latency (nvbug 6102381).
这句话描述了一个真实事故:如果 get_stats() 被两方同时消费(后台 collector 与 /metrics 请求),队列元素会被随机抢走。后果是两个:/metrics 拿到不完整的记录,>80% 的迭代被丢弃;以及阻塞式读取把调用压到 2 秒一次。
修复方案是把“读”与“消费”解耦:
- 后台 collector loop 是唯一的队列消费者;
- 它每读到一条,同时做两件事:喂给 Prometheus(
log_iteration_stats)、塞进一个有界deque(_iteration_stats_buffer); /metrics从这个deque里取快照并清空。
deque 的 maxlen 由 iter_stats_max_iterations 决定;溢出时最老的记录被静默丢弃。这也是设计取舍:宁可丢老数据,也不能让内存无限增长。
max_buf = self._iteration_stats_buffer_maxlen(...)self._iteration_stats_buffer = deque(maxlen=max_buf)self._iteration_stats_collector_task = asyncio.create_task( self._iteration_stats_collector_loop())还有一条注释值得注意:collector loop 在启动时会被立刻唤醒一次,目的是处理引擎启动时发出的初始统计(如 cache_config_info)。如果不做这件事,启动后的第一条统计会一直等到第一次请求完成才被取走。
9.6 collector loop 的节奏
try: await asyncio.wait_for( self._iteration_stats_wakeup_event.wait(), timeout=self._iteration_stats_poll_interval)except asyncio.TimeoutError: woken_by_timer = Trueself._iteration_stats_wakeup_event.clear()...for llm_stat in await asyncio.get_running_loop().run_in_executor( self._metrics_stats_executor, self.generator.get_stats, 0 if woken_by_timer else 0.5): self._record_iteration_stat(llm_stat)两个唤醒源:请求完成事件(立即)、定时器(兜底)。这保证了在没有请求的时候也能周期性拉取(比如 ADP dummy 或 warmup 期间产生的统计)。get_stats 的超时也区分:事件唤醒时 0 秒(不等待),定时唤醒时 0.5 秒(给引擎一点时间产出)。
run_in_executor 是因为 get_stats 是阻塞的 RPC 调用,不能直接放在 asyncio 事件循环里,否则会阻塞所有流式响应。
9.7 Prometheus 多进程模式
TensorRT-LLM 默认会处理 PROMETHEUS_MULTIPROC_DIR:
def set_prometheus_multiproc_dir(): global prometheus_multiproc_dir if "PROMETHEUS_MULTIPROC_DIR" in os.environ: prometheus_multiproc_dir = tempfile.TemporaryDirectory( dir=os.environ["PROMETHEUS_MULTIPROC_DIR"]) else: prometheus_multiproc_dir = tempfile.TemporaryDirectory() os.environ["PROMETHEUS_MULTIPROC_DIR"] = prometheus_multiproc_dir.name为什么需要多进程模式?因为 PyExecutor 跑在子进程里,MetricsCollector 却在 HTTP 进程里;子进程写的指标如果放在默认 registry 里,父进程是看不见的。prometheus_client 的 multiprocess 模式把每个进程的指标写到共享目录下的 mmap 文件,父进程的 /metrics 请求时再把它们合并。
源码注释还标明了来源:
Adapted from: https://github.com/sgl-project/sglang/blob/v0.4.10/python/sglang/srt/utils.py#L1266
这是一个跨框架的共用实践——SGLang 与 TensorRT-LLM 在这件事上做了相同的选择。
顺带一提,如果用户在环境变量里指定了目录,TemporaryDirectory(dir=...) 会在那个目录下再建一个临时子目录,退出时自动删除。这看起来有点绕,但它避免了用户指定的目录被清空——只删除自己创建的子目录。
9.8 从 GPU 角度理解“指标到底在说什么”
有了上面的推导,可以给每条常用指标一句“通俗翻译”:
| 指标 | 通俗翻译 | 误读风险 |
|---|---|---|
num_requests_running | 本拍结束时还在跑的请求数(全局) | 不等于本拍被调度的请求数 |
num_requests_waiting | 队列里的请求数(全局) | 不包括被抢占挂起的请求 |
iteration_latency_seconds | 单拍“排空时间” | overlap 下是两拍 |
kv_cache_utilization{dp_rank} | 物理块使用比例 | 不含主机层,不含预留 |
kv_cache_hit_rate{dp_rank} | 本拍复用块占比 | 不分全命中/部分命中 |
spec_decode_acceptance_length | 每请求平均产出 token 数 | 不是接受率 |
spec_decode_draft_overhead | 草稿耗时占整步比例 | 与接受率相乘才是净收益 |
最后一行值得展开:投机解码的净加速约等于
更直观的经验式是:只有在 acceptance_length × (1 - draft_overhead) > 1 时才可能获益。这个经验式来自“草稿与验证串行发生在同一拍”的假设,如果草稿与验证能部分重叠(如 one-model 架构),实际收益会比上式更高。
十、请求级出口:响应头、SSE 与 JSONL
前三节讲的是“引擎内怎么记账”,这一节讲“账怎么送到人手里”。
10.1 一条请求记录长什么样
phase_record: Dict[str, Any] = { "first_iter": metrics.first_iter, "last_iter": metrics.last_iter, "timing_metrics": timing_metrics, "kv_cache_metrics": {name: getattr(metrics.kv_cache_metrics, name) for name in _KV_FIELDS},}if speculative.total_draft_tokens > 0: phase_record["speculative_decoding"] = {...}if getattr(result, "time_breakdown_metrics", None) is not None: phase_record["time_breakdown_metrics"] = result.time_breakdown_metrics拆开看:
first_iter/last_iter:这条请求在引擎里的起止迭代号,可以把请求与IterationStats对齐;timing_metrics:arrival_time、first_scheduled_time、first_token_time、last_token_time、kv_cache_transfer_start/end;kv_cache_metrics:块分配、复用、miss 的逐请求口径;speculative_decoding:只在有草稿时出现,避免零值噪音;time_breakdown_metrics:逐 step 的明细,只在该请求开了return_perf_metrics时才存在。
注意所有时间都是 steady clock 的浮点秒,不是 Unix 时间戳。这是刻意的:steady clock 单调,不受墙上时钟跳变影响;代价是跨机器对比时必须做时钟对齐(第 11 节)。
10.2 Server-Timing:把明细塞进响应头
非流式响应里,PerfMetricsMiddleware 会往响应头里追加:
Server-Timing: server_queue;dur=1.250000, server_ttft;dur=8.500000, server_e2e;dur=24.000000X-TRTLLM-Start-End-Time: server-start;ts=12345.123456, server-end;ts=12345.147456, server-srv-start;ts=12345.122000, server-srv-ttft;ts=12345.132000X-TRTLLM-Step-Metrics: server-step-0-forward;dur=2.100000, server-step-0-sample;dur=0.400000X-TRTLLM-Ctx-Chunk-Metrics: server-ctx-chunk-0-forward;dur=4.200000这是 W3C Server-Timing 格式的复用:浏览器开发者工具、curl 的 --write-out、以及很多 APM 都能直接解析。选择它而不是自定义 JSON 头,是为了让外部工具零成本接入。
dur= 是相对时长,ts= 是绝对时间戳。为什么两种都要?因为相对时长可以直接画瀑布图,绝对时间戳才能把多个阶段拼起来(尤其 P/D 分离时,ctx 与 gen 在两种机器上,只有绝对时间才能对齐)。
头部大小是有预算的。
_PERF_METRICS_HEADER_BUDGET_BYTES = 80 * 1024超过 80 KB 时,只保留 Server-Timing 与 Start-End-Time,把逐 step 的明细丢掉并告警:
logger.warning( "Performance metrics payload exceeds %d bytes; omitting step and context-chunk metrics", _PERF_METRICS_HEADER_BUDGET_BYTES)为什么是 80 KB?因为大多数 HTTP 服务器与中间代理对单头部的默认上限在 8 KB 到 64 KB 之间,但 TensorRT-LLM 走的是自己的前端,放宽到了 80 KB。再大就会导致某些客户端解析失败。丢掉明细而不是报错,是因为明细是“附加价值”,核心的 TTFT/E2E 必须保住。
10.3 流式响应:用 SSE 事件补发
流式无法在响应头里带 final 才有的数据,所以改用尾随事件:
data: [DONE]
event: trtllm.perf_metricsdata: { "Server-Timing": "server_queue;dur=1.250000, server_ttft;dur=8.500000", ...}event: trtllm.perf_metrics 是自定义 SSE 事件名。标准 SSE 客户端会把不认识的 event 当普通消息处理,兼容性没有问题;专门写的客户端可以按事件名过滤。
[DONE] 之后再发一个事件,是 OpenAI 兼容协议里的一个“灰色地带”。严格来说,客户端看到 [DONE] 就应当结束解析;所以源码在中间件里显式地把这个事件拼在 body 尾部,并且吞掉 OSError(客户端已断开是常态)。这是一处“宁可多发也不漏发”的工程处理——多发的数据,标准客户端会忽略。
10.4 JSONL:给离线分析用的
class PerfMetricsJsonlWriter: async def start(self): ... filename = (f"perf_metrics-{self._server_kind}-{socket.gethostname()}-" f"{os.getpid()}-{timestamp}.jsonl")文件名里带 hostname、pid、UTC 时间戳。三个字段各有用途:
- hostname:多机部署时区分来源;
- pid:同一台机器可能重启过多次前端,同一个 host+time 可能重名;
- 时间戳:避免覆盖,便于按时间排序。
写入是有界队列 + 后台协程:
self._queue = asyncio.Queue(maxsize=_WRITER_QUEUE_SIZE) # 1024...try: self._queue.put_nowait(record)except asyncio.QueueFull: self.dropped_records += 1 if self.dropped_records == 1 or self.dropped_records % 1000 == 0: logger.warning("Dropped %d performance metrics records", self.dropped_records)注意告警节流:只在第 1 次和每 1000 次时打日志。如果磁盘写满导致每秒丢几千条,不打节流会把日志系统也压垮——这是一个“故障时的故障”问题。
close() 有 5 秒的总超时:
_WRITER_SHUTDOWN_TIMEOUT_SECONDS = 5超时就丢剩余记录。为什么不允许无限等待?因为这是服务关闭路径,关闭被统计写盘卡住,会拖垮整个优雅停机流程。丢掉最后几秒的统计,比停不下来要好。
10.5 一个完整的请求生命周期
HTTP 到达 └─ ServerArrivalTimeMiddleware 打 server_arrival_time └─ 路由、模板、分词 └─ 引擎 arrival_time(Executor 收到) └─ first_scheduled_time(首次被调度) └─ first_token_time / last_token_time └─ PerfMetricsMiddleware 生成 Server-Timing / JSONL / SSE这五个时间点对应四个可算的指标:
分母为什么是 output_len - 1?因为第一个 token 的耗时已经算在 TTFT 里,剩下的 output_len - 1 个 token 才是 decode 阶段的产出。如果把 TTFT 也算进 TPOT,长 prompt 会把 TPOT 拉高,失去“每 token 速度”的含义。
这张“时间骨架”也是排查问题时的第一把尺子:TTFT 高而 TPOT 正常,说明 prefill 或者排队有问题;两者都高,可能是整个引擎过载;TTFT 正常而 TPOT 抖动,通常是 batch 组成变化或 KV 缓存水位变化带来的。
此外,统计字段与逐请求账本的交点只有 first_iter 与 last_iter。把这两个迭代号拿去 IterationStats 里查,就能得到“这条请求在引擎里经历了哪些拍的调度状态”。如果一条请求的 first_iter 落在两次 /metrics 拉取之间,那它的批次数据只会在 JSONL 或采样拍上出现一次,事后很难追溯——这也是为什么生产环境通常同时开两种出口:Prometheus 看趋势,JSONL 看个案。
十一、跨机时钟:P/D 分离下的时间对齐
11.1 为什么两台机器的秒不能直接相减
P/D 分离时,一条请求的第一段(prefill)在 ctx 节点上执行,第二段(decode)在 gen 节点上执行,而聚合发生在第三个进程(disagg server)里。三者的 steady clock 各自从各自机器开机算起,起点不同、频率也有微小偏差。
如果直接用 gen 节点的 last_token_time 减 ctx 节点的 first_token_time,得到的可能是一个荒谬的数字:负数,或者几万秒。这是分布式 tracing 的经典问题。
11.2 源码里的 NTP 式估计
def build_clock_sync_header(receive_time, transmit_time) -> str: return f"receive;ts={receive_time:.9f}, transmit;ts={transmit_time:.9f}"
def adjusted_clock_from_headers(headers, originate_time, destination_time): ... offset = ((receive_time - originate_time) + (transmit_time - destination_time)) / 2 return AdjustedSteadyClock(-offset)这是 NTP 四时间戳公式的简化版:
其中 是客户端发起时间(originate_time), 是服务端收到时间(receive_time), 是服务端发出时间(transmit_time), 是客户端收到时间(destination_time)。 是“服务端时钟减客户端时钟”的偏移估计。
注释解释了为什么要取负:
NTP offset is worker clock minus client clock. Metrics need the inverse correction because combined disaggregated records use the client clock.
也就是说,记录统一用客户端(disagg server)的时钟域,所以要把 worker 的绝对时间戳加上 映射过来。
11.3 精度与假设
四时间戳法假设往返路径对称,于是可以把单程延迟近似为 。在数据中心同 pod 或同交换机内,这个假设基本成立,误差通常在几十微秒量级。跨可用区时误差会增大,但仍好于完全不对齐。
AdjustedSteadyClock 把偏移保存成常量,而不是动态跟踪:
class AdjustedSteadyClock: def to_reference_time(self, timestamp): return float(timestamp) + self._reference_offset这是一个有意为之的简化:偏移在握手时估计一次,之后固定使用。如果两台机器的晶振差别较大,长时间运行会积累漂移(典型晶振 50 ppm,一天累积约 4 秒)。对“单请求内几毫秒到几十毫秒的分解”来说,几秒的漂移显然不可接受。
所以源码另外暴露了 /steady_clock_offset 端点,支持由 disagg server 持续更新:
async def set_steady_clock_offset(self, offset: Annotated[float, Body(embed=True)]) -> Response: self._adjusted_steady_clock.set_reference_offset(offset)注意参数叫 offset,但内部调用 set_reference_offset,也就是直接把传进来的值当成“参考时钟域的偏移”。外部系统(例如一个定期跑 NTP 测量的 sidecar)负责算出正确值并推送。
11.4 一条断开的请求怎么拼
P/D 分离时,ctx 与 gen 各自返回一条 worker 记录,disagg server 把它拼成三阶段:
phases: Dict[str, Any] = {"disagg": disagg_phase}if ctx_record: add_worker_phase("ctx", ctx_record)if gen_record: add_worker_phase("gen", gen_record)build_metrics_record_from_headers 会把 Server-Timing 头里的 server- 前缀重写成阶段前缀(ctx- 或 gen-):
value.replace("server_", f"{phase}_").replace("server-", f"{phase}-")这解释了源码里那条看似奇怪的字段命名禁令:
Names must not contain a second “server-”/“server_” substring, because the receiving side rewrites the phase prefix with an unqualified str.replace().
如果用 str.replace 做前缀改写,任何包含 server- 的字段名都会被一起改掉。所以字段命名里不能出现第二个 server- 子串。这属于“实现约束反过来约束命名”的例子,在监控系统里很常见。
11.5 丢失的字段怎么表示
_as_seconds 的实现:
def _as_seconds(value): try: seconds = float(value.total_seconds()) except (AttributeError, TypeError, ValueError): return None return seconds if seconds > 0 else None只有 seconds > 0 才返回,否则返回 None。为什么用 > 0 而不是 >= 0?因为 steady clock 的读数在请求开始前是正的,一个恰好为 0 的值只可能是“未打点”,不可能是真实时间。
这个约定随后影响了 JSONL 的字段裁剪:
for name in ("kv_cache_transfer_start", "kv_cache_transfer_end"): if not timing_metrics.get(name): timing_metrics.pop(name, None)注释特意解释,不能依据 kv_cache_size 是否存在来决定是否保留 KV 传输时间戳:
Keying this off kv_cache_size instead discards timestamps that the Server-Timing header transport carried successfully, because kv_cache_size is worker-local and never reaches a header-derived record
也就是说,kv_cache_size 是 worker 本地量,跨机传输时不存在;而 KV 传输时间戳却可以通过头部传输。如果按 kv_cache_size 裁剪,会误删有效数据,导致所有分离请求的 KV 传输段显示为 0 宽度。这是一条“用错字段做哨兵,会静默破坏数据”的典型。
11.6 对齐做砸时的症状
如果时钟对齐没有做,分离请求的聚合会出现下面这些典型症状:
- 某些阶段时长为负:直接相减得负数,仪表盘上出现折线穿过零轴;
- TTFT 接近 E2E:ctx 段的结束时间被映射到 gen 段的“很久以前”,排队时长被吃掉一部分,看起来所有时间都花在等首字上;
- 同一请求的多阶段瀑布图重叠:ctx 段覆盖了 gen 段的一部分;
- P99 异常高:个别请求的偏移估计失败,误差被放大,进入尾分位。
排查时,第一步永远是输出 X-TRTLLM-Clock-Sync 头,检查 receive 与 transmit 的差值是否合理;第二步是对比 /steady_clock_offset 的返回值在两端是否一致;第三步才是看逐阶段时长。
十二、Profiling:统计之外的第二条路
统计告诉你“慢了多少”,trace 告诉你“慢在哪一行 kernel”。TensorRT-LLM 把这两件事分开实现,代码分别在 perf_metrics_manager.py 与 profiling.py。
12.1 两种触发方式
环境变量:
TLLM_PROFILE_START_STOP=10-20 # 采集第 10 到 20 拍TLLM_TORCH_PROFILE_TRACE=/tmp/t.json # 输出路径TLLM_PROFILE_LOG_RANKS=0,1 # 哪些 rank 打迭代日志解析函数支持区间与单点混合:
# "start1-stop1,start2-stop2,..." 或 "iter1,iter2,..."def load_iteration_indexes(env_var): ... return frozenset(starts), frozenset(stops)返回两个集合而不是区间列表,是因为判断“这一拍是否要开始/结束”只需要 O(1) 的成员查询。
运行时接口:/start_profile / /stop_profile,可以指定 num_steps、activities、output_dir。
两种方式共用同一个状态机:PyExecutorProfileManager。
12.2 为什么必须在 executor 线程调用
Runs on the executor thread;
torch.profiler.start/stopMUST happen on the same thread.
这是 Kineto 的硬约束:start 与 stop 必须在同一线程调用,否则内部状态会错乱。但 /start_profile 的调用方是 FastAPI 的线程池线程。源码的解法是“调用方只投递一个特殊请求,真正的开关在 executor 线程执行”:
eq.enqueue_profile_start_request(profile_config)这个特殊请求会被 RequestBroadcaster 广播到所有 rank,然后在 _handle_special_queue_items 里被处理——不产生一次前向。注释特意强调了这一点:
no forward pass runs for this iteration, so the chrome trace captures only real user workload
如果 profile 的 start 请求本身触发了一次前向,trace 里就会出现一条“空批前向”,干扰分析。
12.3 原子性:为什么需要 pending marker
start_profile 里有一段临界区:
with executor._profile_state_lock: already_active = executor._profile_enabled pending_start = executor._runtime_profile_pending_start_iter claimed = not already_active and pending_start is None if claimed: executor._runtime_profile_pending_start_iter = 0注释解释了为什么 check 与 set 必须原子:
Two POST /start_profile requests are dispatched through asyncio.to_thread onto different worker threads… A non-atomic check-then-set would let both callers pass the guard and broadcast a profile start, and the second apply_start_config would overwrite the trace path and activities of the first window.
这是一条很典型的并发坑:HTTP 接口天然并发,而 profiling 是全局状态。用 0 做“已认领但未调度”的哨兵,真正的时间点要等广播到达 executor 才确定(因为每个 rank 必须用自己的 iter_counter 算起点,否则 rank 0 会“抢跑”)。
12.4 失败路径必须回滚
started = Falsetry: self._prepare_and_broadcast_start(...) started = Truefinally: if not started: self._release_pending_start()_prepare_and_broadcast_start 里可能失败的地方很多:输出目录建不了、num_steps <= 0、broadcast 入队失败。任何一处失败后如果不回滚,下一次 start_profile 会被告知“已有 pending start”,永远无法开始。
源码在这个函数里写了一句很实在的理由:
Returning success here would schedule a profile window that later blows up in export_chrome_trace() on the executor thread, after the HTTP caller has already been told the request was accepted.
也就是说,失败必须发生在 HTTP 返回之前,而不是延后到 executor 线程里炸。否则调用方会拿到 200 OK,然后 trace 永远出不来。
12.5 迭代日志:统计的“低配版”
profile_step 里还负责打印迭代日志。它的字段设计与 IterationStats 有重叠但更轻量:
iter = 1234, global_rank = 0, rank = 0, num_scheduled_requests = 256,adp_dummy_ctx_tokens = 0, adp_dummy_gen_tokens = 0, kv_cache_util = 0.873,currank_total_requests = 100/1000, host_step_time = 2.1ms,prev_device_step_time = 1.9ms, timestamp = ..., states = ...,num_active = 256, num_fetched = 4, num_dummy = 0, num_unscheduled = 3三个细节:
第一,kv_cache_util 每 16 拍才刷新一次。
ITER_LOG_KV_UTIL_REFRESH_ITERS = 16因为 get_kv_cache_stats() 在 V2 里是一次完整遍历,每拍都算会把日志变成瓶颈。16 拍约等于几十毫秒,对观察趋势足够。
第二,prev_device_step_time 的命名与滞后一拍。
注释说它来自 profile_step 里乒乓的 Event 对,值比 host_step_time 滞后一拍。字段名里带 prev_ 就是为了提醒这一点。
第三,num_fetched 是增量而不是累计。
num_fetched = executor.num_fetch_requests_cur_rank - prev_fetch_requests_cur_rank日志是给人看的,累计值看不出来“这一拍发生了什么”。增量才是信号。
12.6 一条请求在 trace 里长什么样
打开的 trace 里能看到几类标记:
step[...]用户注解:每一拍一个范围,名字里带批信息;- 层级别的 NVTX 标记(如果开了
enable_layerwise_nvtx_marker):每层一个范围; - kernel 本身的名字。
把统计与 trace 对齐的常用方法是利用 first_iter / last_iter:先在统计里找到慢请求的迭代号,再在 trace 里定位同一编号的 step 范围。如果这两个编号不一致,说明请求跨了 profile 窗口,需要重新采集。
十三、工程取舍:这套设计为什么长成这样
把前面所有细节抽出来,能看到几条反复出现的设计原则。
13.1 默认零开销,按需打开
每一个采集点都有开关或惰性创建:
PerfMetricsManager.__init__(enabled=...),关的时候create_timing_events直接返回三个None;PerfTimingInfo惰性创建;- KV V2 报告在
enable_stats=False时直接返回None; - 迭代日志的 KV 刷新按 16 拍降频;
_log_mem_snapshot由TLLM_LOG_MEM_PROFILE=1门控。
这不是“顺手加的”,而是因为推理服务的利润率极薄:一个每拍都跑的统计函数,如果有 50 微秒开销,在 2 毫秒的 decode step 上就是 2.5% 的吞吐损失。
13.2 采样而不是全量
iter_perf_stats_interval、_kv_iter_stats_interval、ITER_LOG_KV_UTIL_REFRESH_ITERS 是三个不同粒度的采样器。分层的理由是:不同指标的“变化速度”不同。
- 每拍都要看的:请求数、token 数、迭代耗时;
- 每 k 拍看就够的:KV 池水位、命中率;
- 每十几拍看就够的:KV 利用率这类重计算指标。
13.3 序列化边界在进程边界
为什么 IterationStats 一开始就要能 to_json_str()?因为它要过 RPC。为什么 KV 统计的键名要 camelCase?因为要和 C++ 侧拼在同一份 JSON 里。为什么 RequestStats 在 ADP 下只留 rank 0?因为逐请求数据跨 rank 去重很麻烦,干脆只输出一处。
数据的形状是被传输方式决定的,这在分布式系统里几乎是定律。
13.4 用哨兵值而不是可选类型
gpu_forward_time == 0表示“还没填”;_runtime_profile_pending_start_iter = 0表示“已认领未调度”;cpu_mem_usage = 0表示“未采集”;seconds <= 0表示“未打点”。
哨兵值的优点是省一个字段、JSON 更紧凑;缺点是同一个 0 有三种含义。源码用注释把每个哨兵的语义钉死,但外部消费者仍然容易误读。这是这套设计里最值得批评的一点:如果重写,应该用 null 或显式的 collected: bool。
13.5 故障时降级而不是崩溃
- Event
elapsed_time失败 → 记 0 并告警,不抛; - 累计 counter 回退 → 告警并重置基线,不抛;
- JSONL 队列满 → 丢弃并节流告警;
- header 超预算 → 丢掉明细,保留核心;
- profile 失败 → 回滚 pending,让下一次可以重试。
这些处理共同指向一个目标:监控系统不能成为服务可用性的单点。统计代码抛一个异常,可能让整个 executor 循环退出,代价远大于丢几条数据。
13.6 一张图收束
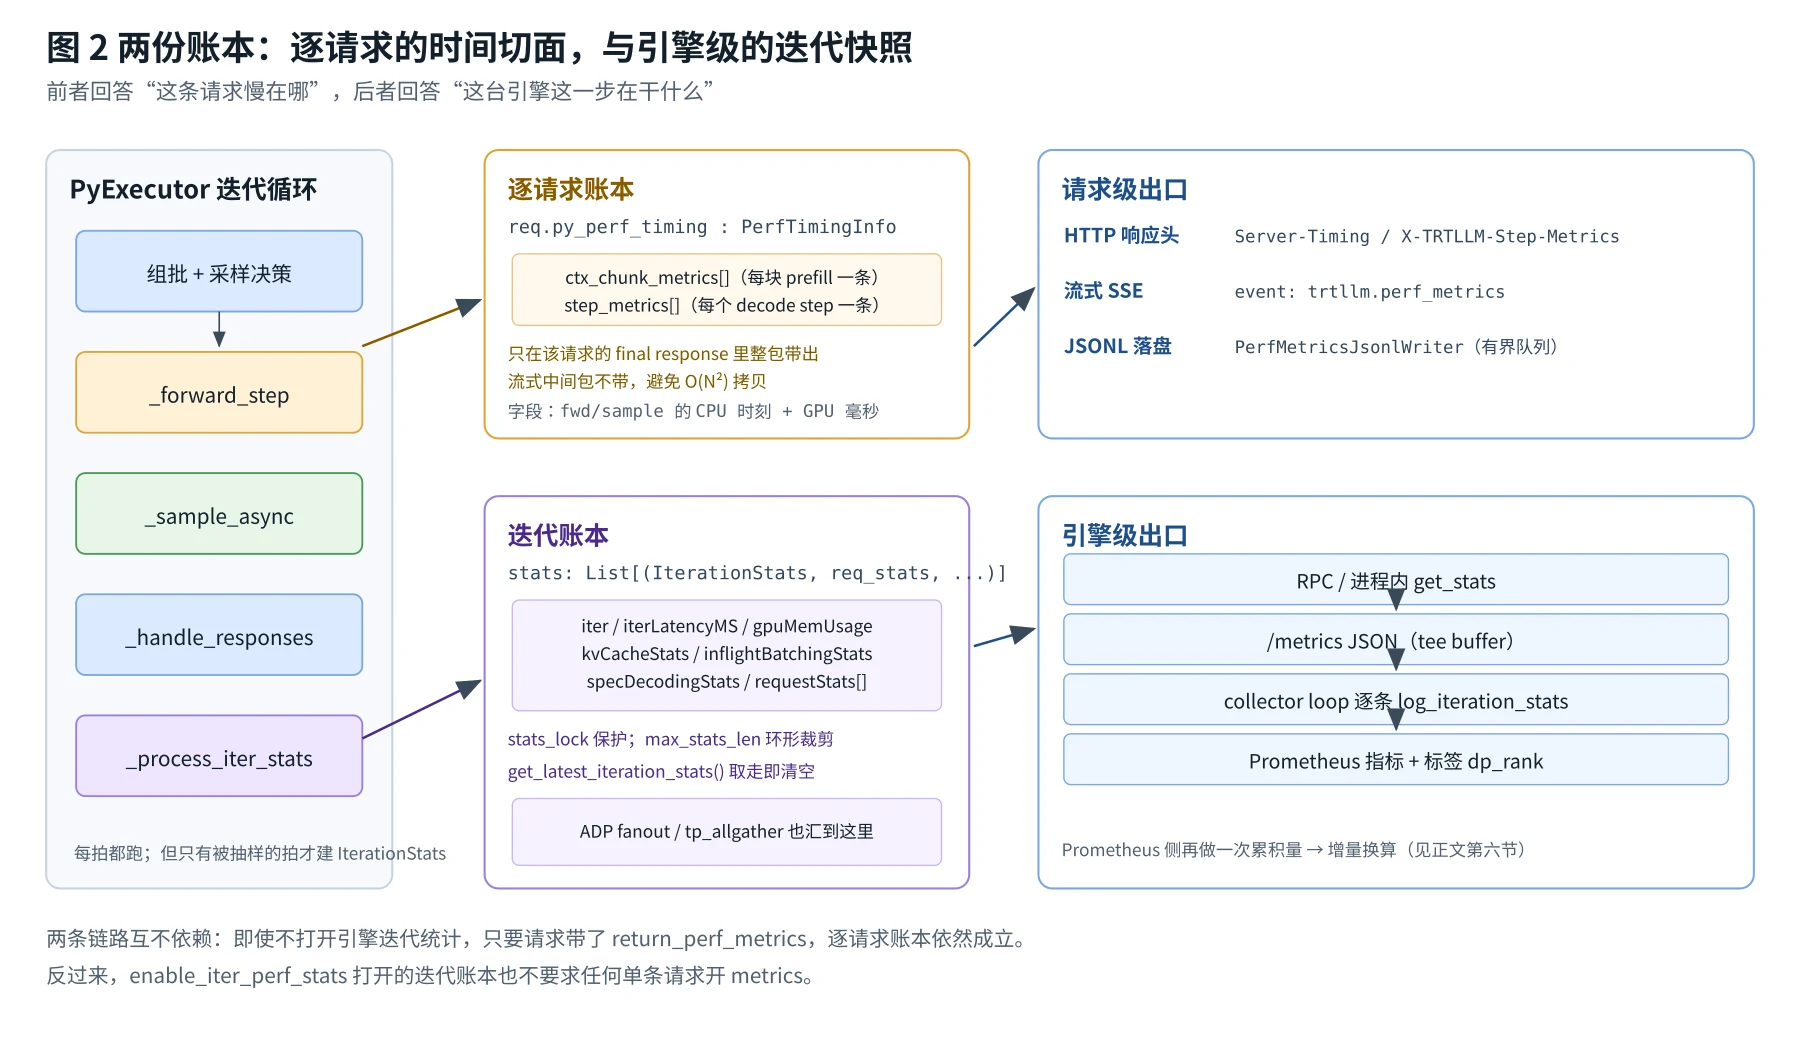
图为本文据 PerfTimingInfo、IterationStats、MetricsCollector 与 perf_metrics.py 的实际数据流绘制。
图的左半部分是 executor 循环;中间两摞是两份账本;右侧是请求级与引擎级出口。三个要点:
- 两份账本互不依赖:不开
enable_iter_perf_stats也能用return_perf_metrics,反之亦然; - 逐请求账本只在该请求的 final 响应里整包带出,避免 O(N²);
- 迭代账本必须经 buffer + RPC + collector loop 才能变成 Prometheus 指标,中间任何一环阻塞都会反映为“指标停了但服务还在跑”。
13.7 和其他框架的对照
把同类设计放在一起看,差异很有信息量。
vLLM 的统计走的是 StatLogger 体系:引擎每步产出 SchedulerStats 与 IterationStats,由一组 logger 分别写日志、Prometheus、以及可选的 RequestStats,这条管线在 vLLM 源码完全拆解(二十六):Metrics 与统计管线 里逐段拆过。与 TensorRT-LLM 最大的不同是:vLLM 的 IterationStats 直接由调度器在 Python 侧构造,不需要跨 RPC 序列化,因此字段更自由、嵌套更少。
SGLang 的观测性分成“按角色的采集器体系”:TokenizerManager、Scheduler、TP Worker 各有自己的 metrics collector,再统一汇聚(可对照 SGLang 源码完全拆解(二十四):可观测性)。它更强调“每个角色只报自己知道的事”,这一点和 TensorRT-LLM 的 ADP rank-0-owned 划分思路一致,但组织方式更分散。
DeepInfer 的统计更贴近“调度器账本”:StatsLogger 维护滑动窗口,吞吐与 MFU 都是现算的派生量,而不是先落原始计数再换算。
llama.cpp 则几乎没有内建指标系统,主要靠日志行与 server 的 /metrics(可选)。它的取舍是“端侧不需要 Prometheus”,这与它的目标场景吻合。
四者的共同点是:都选择了采样 + 增量换算,因为原始累积量直接暴露给 Prometheus 会产生巨大的基数与错误的速率。
13.8 读这套代码的建议顺序
如果要在源码里自己走一遍,推荐这个顺序,每一步都能单独验证:
perf_metrics_manager.py(305 行):先把 Event 的用法看明白;llm_request.py里的PerfTimingInfo:理解两份列表;py_executor.py的_get_init_iter_stats/_update_iter_stats/_process_iter_stats:理解记录的构造与消费;kv_cache_stats.py:理解序列化契约;adp_iter_stats.py:理解多 rank 对齐;metrics/collector.py:理解指标翻译;serve/perf_metrics.py:理解出口。
每一层都可以用“关掉下一层”的方式单独测试:只开 return_perf_metrics 就能验证第 1-3 层;只开 enable_iter_perf_stats 可以验证 3-5 层;把 TLLM_METRICS_ALL_RANKS 打开又能验证 gather 路径。这种“分层可关闭”本身也是设计的优点。
小结
TensorRT-LLM 的统计系统看起来是一堆零散的 logger.info 与 dict,实际上它回答了推理服务里最难回答的三个问题,且三者各自有明确的技术手段:
“这一步慢在哪”,答案是两段 GPU 时间加两段 CPU 时间,用乒乓 CUDA Event 采集、按批摊给请求、按 final 响应整包送出。它要求读者理解异步执行与事件复用的约束,否则量出来的是 launch 延迟而不是 kernel 耗时。
“这台引擎在干什么”,答案是 IterationStats:字段按“谁拥有真相”分层——rank 0 的队列、每 rank 的调度与 KV、全体一致的迭代号与时间。记录在组批时诞生、在消费拍结算,中间跨了 overlap 的一拍甚至 PP 的多拍,因此 iterLatencyMS、hostStepTimeMS、gpuForwardTimeMS 三个字段并存,schedulerMode 负责标注口径。
“多机多卡怎么对齐”,答案是 fanout 对齐 + 零占位 + collective 提到公共路径 + NTP 式时钟偏移。任何一条做错,症状都不是“数据不准”,而是“数据错乱到无法解释”。
这套设计里最值得借鉴的三点,与技术栈无关:
- 把“谁拥有真相”写进 schema,而不是靠聚合时去重;
- 把采样间隔与派生量的计算频率分开,让重计算的指标降频;
- 让监控代码在故障时降级,不要让它成为服务可用性的单点。
最值得批评的一点也很清楚:大量用 0 当哨兵值,把“未采集”“恰好为零”“待填充”三种语义压进同一个数。读这套指标时,凡是看到 0,都应该先问一句:这是真的 0,还是没采到?
参考资料
- TensorRT-LLM GitHub 仓库
- TensorRT-LLM Performance Analysis 文档(Nsight Systems 与 profiler 协作)
- TensorRT-LLM Performance Overview 文档(吞吐测量与 benchmark 口径)
- TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/perf_metrics_manager.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/kv_cache_stats.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/adp_iter_stats.py - TensorRT-LLM 源码:
tensorrt_llm/_torch/pyexecutor/profiling.py - TensorRT-LLM 源码:
tensorrt_llm/serve/perf_metrics.py - TensorRT-LLM 源码:
tensorrt_llm/metrics/collector.py - TensorRT-LLM 官方文档媒体:架构总览图
- Prometheus 文档:histograms and summaries
- W3C Server-Timing 规范
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



