


混合注意力模型的推理内存怎么排:粗粒度共享页、循环检查点内分页、卷积槽打包与原生双池
背景与问题定义
把一个大模型放进推理引擎,显存里的“状态”通常被默认为一种东西:随 token 增长的 KV Cache。全注意力模型确实如此,第 个 token 的 key/value 一旦算出来就留在显存里,后续每个解码步都要把它们读一遍。可一旦模型是混合注意力结构,这个默认假设就碎了。
混合模型把一部分层换成线性注意力或状态空间模型(State Space Model,SSM),例如 Falcon-H1 系列把注意力头与 Mamba2 风格的 recurrent 头混在同一套主干里。于是显存里同时出现三类状态:
- 注意力 KV:随保留的 token 历史线性增长,按 token 分页最自然;
- 循环状态(recurrent state):对给定模型配置是固定大小,不随上下文增长,但只在特定 token 位置有意义,必须配合“检查点”保存;
- 卷积状态(convolution state):更小,通常只有几十 KiB,却同样与某个位置绑定。
三者的大小、增长方式和寿命都不同。论文把这种局面称为“异构状态”(heterogeneous state)。异构本身不是问题,问题是它们必须一起生效:一个前缀要能被复用,注意力 KV 和完整的循环检查点必须同时有效,并且落在同一个输入位置上。少了任何一半,前缀就只能重算。
这直接引出一个服务层的指标。论文定义 有效状态容量(effective state capacity):在固定显存预算下,引擎能支撑的“有用状态”总量。它不是简单的空闲字节数,因为一块状态即使还占着显存,只要它的搭档已经失效,就不能再被任何请求复用。有效容量同时受分配粒度、池的可行性和状态寿命影响。
本文讨论的工作来自韩国电子通信研究院(ETRI)的 Dongwook Kang,论文题为 Native Dual Pools or Shared Paging? Memory Organization for Concurrent Hybrid LLM Serving,arXiv 编号 2610.15755,2026 年 10 月公开。作者在修改过的 vLLM V1 运行时里实现了四种内存组织,并在单张 A100 40GB 上做了并发服务实验。本文按“物理布局—执行路径—服务行为—寿命”的顺序拆解这套设计,重点放在机制,而不是榜单式的吞吐数字。
为什么现有做法不够
分页注意力(PagedAttention)解决了全注意力 KV 的碎片与重复问题:逻辑块与物理块解耦,块表负责映射。前缀树缓存(如 RadixAttention)进一步把共享前缀组织成树,命中后直接复用物理块。这些机制都假设“可复用的单位”是一段 KV 块。
混合模型多了一个约束:前缀命中不仅要 KV 块有效,还要有一个在相同边界上的完整循环检查点。检查点内部包含 SSM 状态和卷积状态,二者大小相差两个数量级。已有工作分别研究检查点选择、异构状态分配、缓存淘汰与保留,例如 Marconi 研究混合检查点的准入与驱逐,Sparse Prefix Caching 在重叠与预算约束下选检查点位置,Jenga 把异构分配、分层缓存与请求依赖放在一起。这些工作把检查点当成一个整体对象。
这篇论文把视角再往里推了一层:检查点内部的物理表示,是否也会影响并发服务?把一个大检查点拆成更小的物理页、把很小的卷积状态塞进共享槽,会改变分配浪费、页映射、所有权和失效工作。逻辑检查点仍然是一个原子复用单位,但物理上可以分散在多个页里。这个“逻辑原子、物理分散”的组合,正是全文的主线。
三种状态的物理量:先把账算清楚
讨论布局之前,必须先知道每种状态到底占多少。论文给出了一套代表性的 Falcon 几何参数,后面所有公式都以它为例。单位统一用 KiB(1 KiB = 1024 字节)。
| 状态对象 | 逻辑粒度 | 物理载荷 |
|---|---|---|
| 注意力块 | 512 token | 512 KiB KV |
| 循环检查点 | 512 token | 1536 KiB SSM + 21 KiB 卷积 = 1557 KiB |
| 原生注意力块(D0) | 16 token | 16 KiB |
| 原生循环检查点(D0) | 1792 token 间隔 | 1,594,368 B ≈ 1557 KiB |
这张表里最值得盯住的是比例关系:
- 注意力块比检查点小,但数量更多。一个 8K 上下文在 512-token 网格上对应 16 个注意力块;检查点也按这个网格落点,但实际驻留多少取决于缓存与保留策略,通常不会把所有边界都留下。下面做算术示例时假设只保留 4 个检查点,对应大约每 2K token 一个。
- 卷积状态只有 21 KiB,约为检查点的 1.3%。如果给它单独分配一个 512 KiB 或 1557 KiB 的页,浪费率是 96% 以上。
- 检查点内部并不均匀:1536 KiB 的 SSM 状态可以整齐地切成三个 512 KiB 成员页,21 KiB 的卷积状态却切不出一个有意义的页。
这三条比例决定了后面所有设计的取舍。S0 用统一大页,必然在小对象上浪费;S1 把检查点内部切开,注意力页从 1557 KiB 降到 512 KiB,代价是检查点从 1557 KiB 涨到 2048 KiB;S2 再处理 21 KiB 的卷积状态,用 32 KiB 槽位替代整页;D0 则完全换一套原生粒度,用两个静态池分别装注意力和循环状态。
这里有一个容易忽略的工程细节:512 token 的检查点网格并不是这篇论文优化出来的,而是继承自开发路径。作者明确说明,之前统一分配路径使用 1792 token 的 Falcon 单元,后来把逻辑边界移到 512 token,以保留检查点载荷;整个共享池改进过程都固定这个网格,没有按组织逐个调优。这意味着 S0–S2 的对比是“同一逻辑网格下的物理表示对比”,而 S2–D0 的对比则混入了网格差异、分配单位和池可行性差异。解读实验结果时必须记住这一点。
四个组织:物理布局一览
论文实现了四种内存组织,它们共享同一套“完整状态有效”规则,差别只在物理表示。
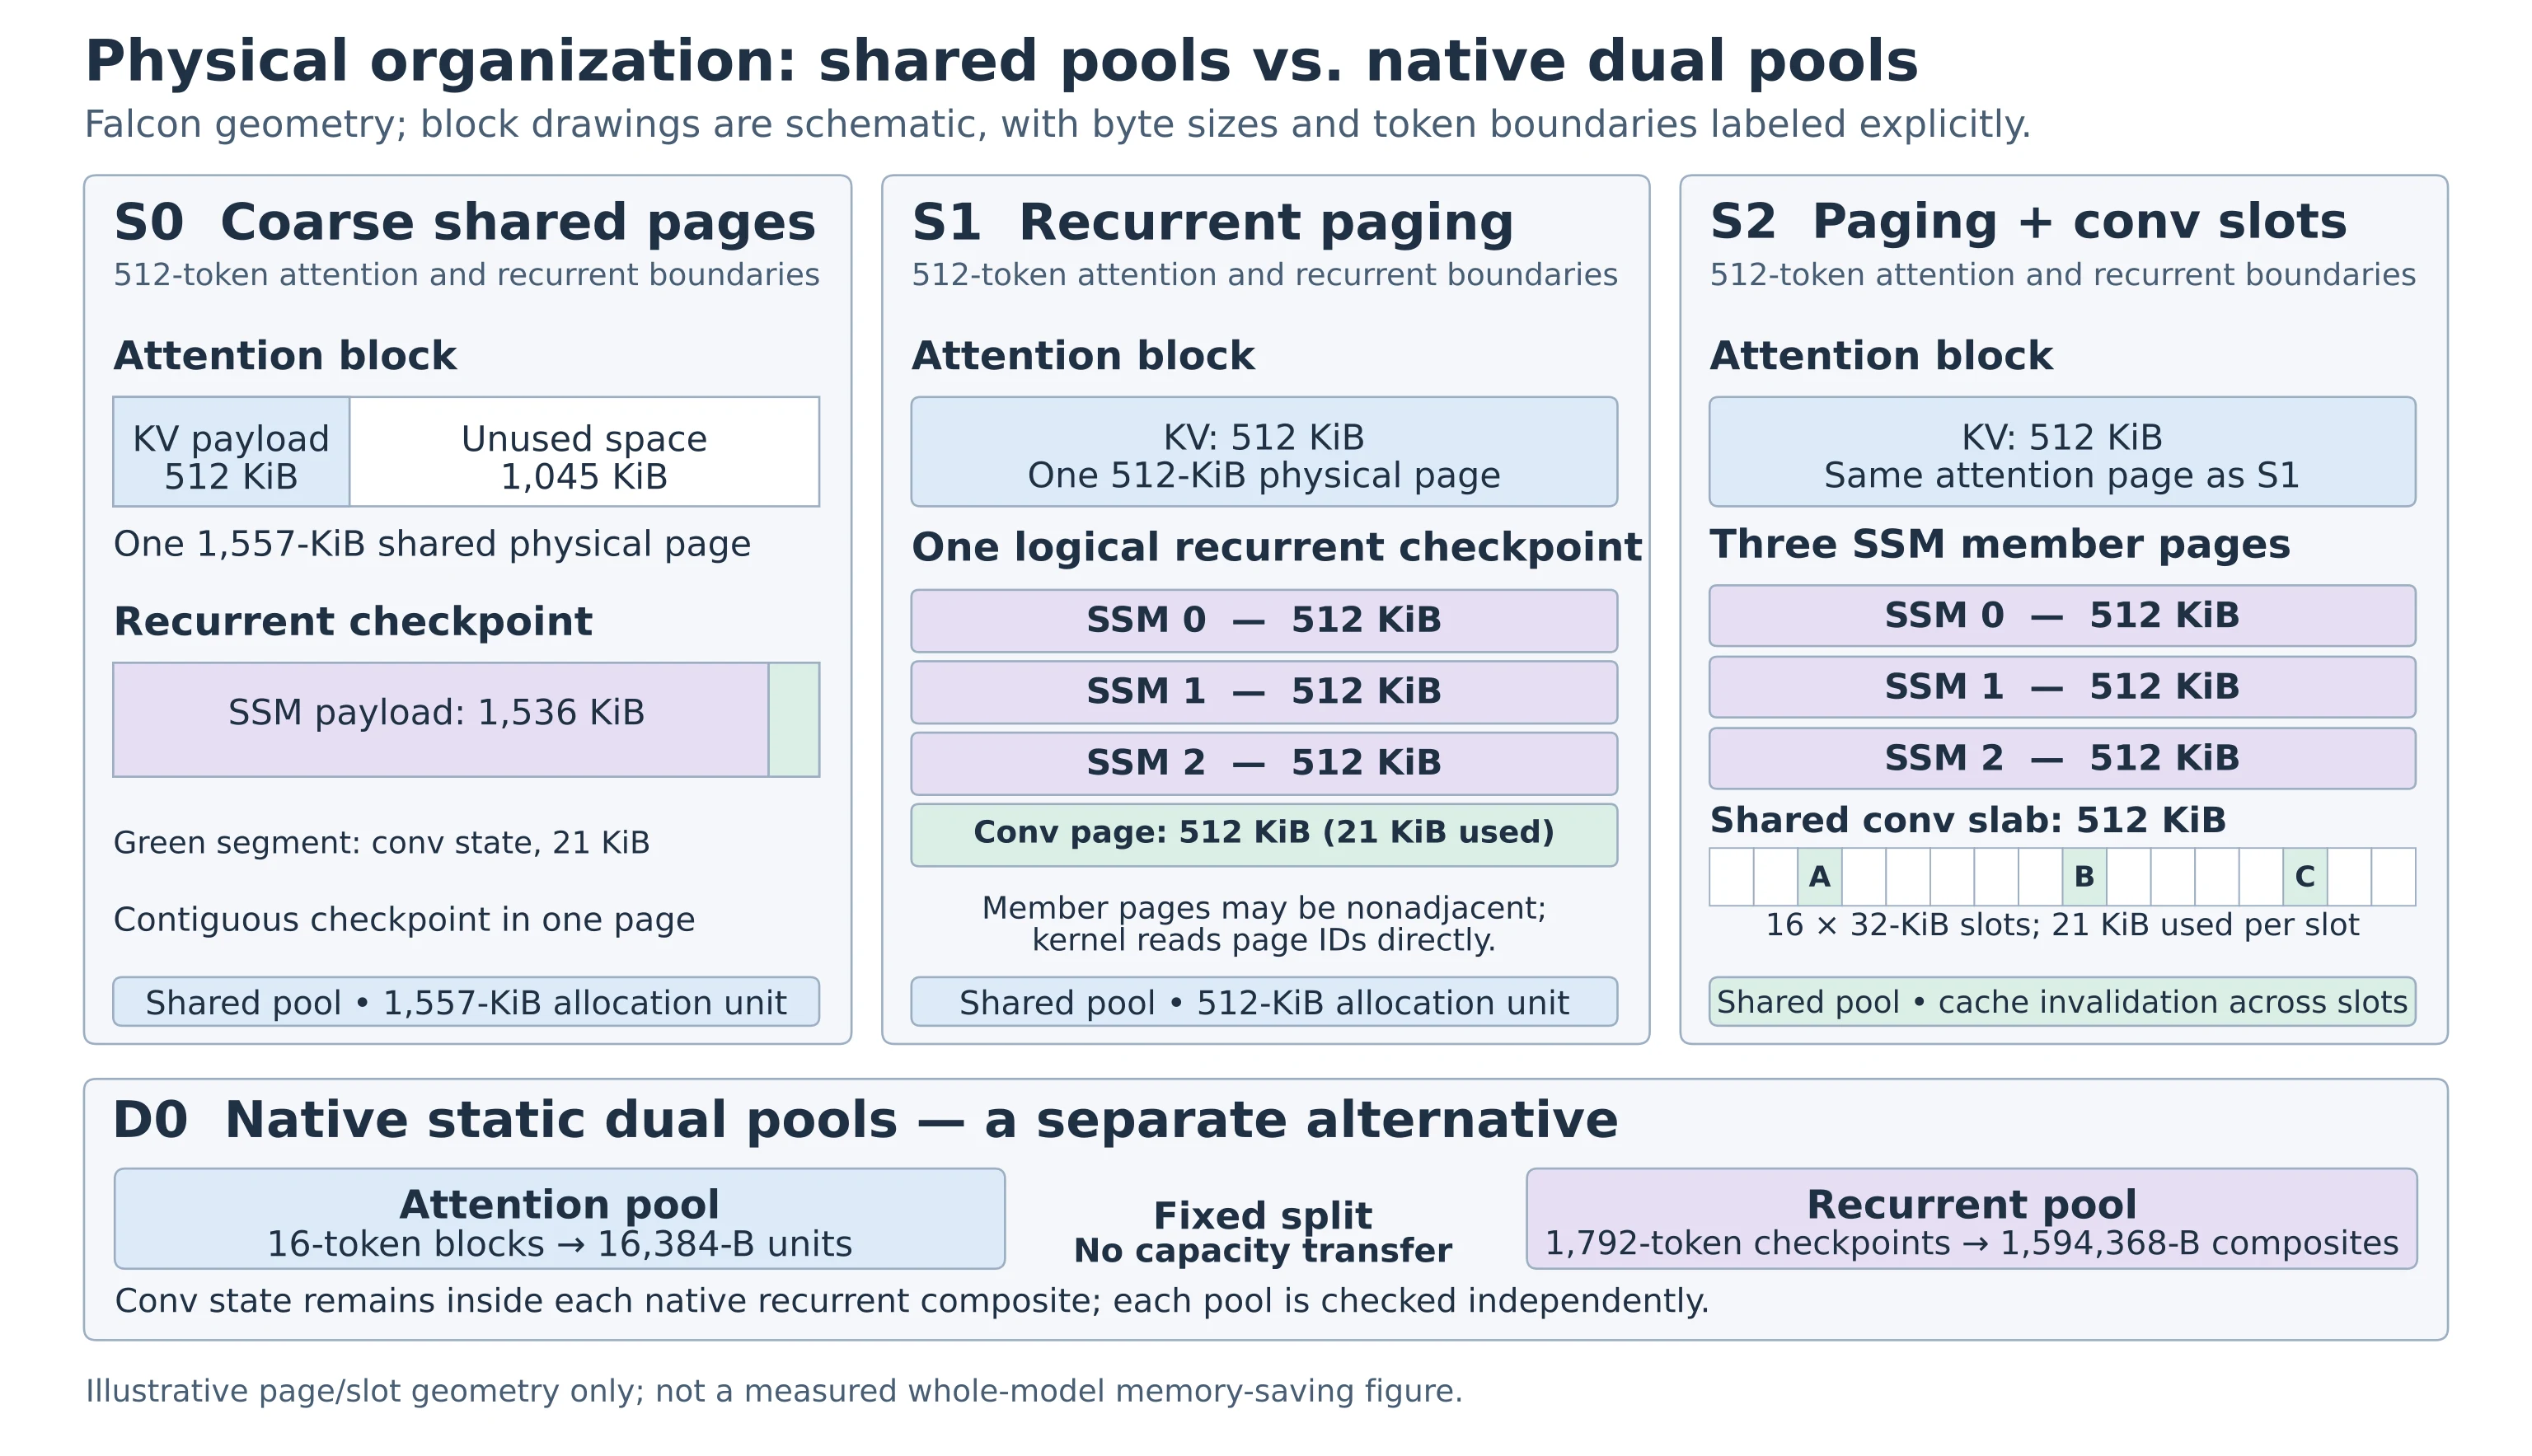
图中四列从左到右依次对应 S0、S1、S2、D0。每一列里,浅色块表示注意力状态,深色块表示循环(SSM)状态,最窄的那条表示卷积状态。可以看到 S0 用同一个大格装下两类状态,S1 把一个大格拆成“三页 SSM 加一页卷积”,S2 把卷积从独立页挪进共享的槽位板(slab),D0 则把注意力切成很细的 16-token 小格、把检查点整块放在独立池里。图源:论文 Fig. 1。
S0:粗粒度共享页
S0 是最朴素的方案:一个统一池,所有逻辑对象都拿一个 1557 KiB 的物理页。注意力块和检查点的逻辑边界都是 512 token,但物理单元相同,都是 1,594,368 字节(约 1557 KiB)。
一个检查点几乎填满这页:1536 KiB SSM 加 21 KiB 卷积,合计 1557 KiB,几乎没有余量。一个 512-token 注意力块只包含 512 KiB KV,却占掉 1557 KiB,页内浪费 1045 KiB。以注意力块为主的负载下,这种浪费会随上下文线性放大。
S0 的逻辑语义其实很干净:检查点是一个整体,执行跨越边界时,运行时读取旧状态,把新状态算进目标页,旧检查点保留在原页;缓存条目在被重新分配前一直可查,一旦物理页被重分配,对应的逻辑条目必须失效。灵活性和浪费在 S0 里同时存在。
S1:检查点内部分页
S1 保持 512-token 逻辑网格,但改变了检查点内部的物理表示:
- 注意力块仍然用一页,但这一页是 512 KiB;
- 一个检查点由三个 512 KiB 的 SSM 成员页加一个专用的 512 KiB 卷积页组成,共 2048 KiB。
逻辑上检查点仍是一个对象:查找只有在全部成员有效时才成功,任一必需成员被重分配,整个缓存检查点失效。
S1 真正的执行层变化是:循环内核直接消费页映射,不再先把检查点重组成连续缓冲区。设检查点边界为 ,第 个 SSM 成员页的物理页号为 ,页间字节步长为 ,元素 在成员内的页内字节偏移为 ,则循环内核访问元素 的地址是
其中 是该实例 SSM arena 的基地址。这个公式看起来简单,工程含义却很重:页可以在任意时刻被分配、回收、交换,内核只需要一张从成员序号到物理页号的表,就能在不拷贝的情况下走遍检查点。代价是每次解码步都要做一次额外的间接寻址,而不是顺序读取。
分块预填充或恢复预填充时,S1 允许把初始检查点聚合到一个连续 arena,因为这类路径本来就要处理大块状态,间接寻址的收益不如连续访存。这个细节说明实现者把“解码”和“预填充”两条路径分开权衡,而不是一刀切。
S1 的成员保护也更复杂:查找需要保护所有必需成员,任何一个成员被重分配都会让整个检查点失效。于是引用计数从“一个检查点一个”变成“一组成员页”,失效需要沿页反向找到所有依赖它的逻辑条目。
S2:卷积槽打包
S2 保留 S1 的分页 SSM 表示,注意力块仍是 512 KiB 一页,检查点仍用三个 512 KiB SSM 成员页,但把 21 KiB 的卷积状态从专用页中挪进共享板:每块 512 KiB 的板被切成 16 个 32 KiB 槽位,一个卷积状态占一个槽。
内核同样不需要重建独立的连续卷积缓冲区:给定槽位板号与槽内序号,内核面对的行标识是 ( 为板页索引, 为槽索引),行步长为 32 KiB。用一个显式的无效哨兵表示“无卷积状态”,防止缺失条目错误地别名到 0 号页或负偏移存储。
共享板带来的第一个副作用是寿命耦合。一块板里可能同时躺着十几个不同检查点的卷积槽,有的被活跃请求引用,有的只是缓存。活跃引用保护对应槽位和它的检查点关系;但在板页被重分配之前,必须把所有使用该板的缓存检查点全部失效。这意味着一次回收可能要扫描一整块板的依赖关系,论文的附录专门给出了引用计数与失效规则。
D0:原生双池
D0 是另一套完整组织,刻意避开 S0 的注意力浪费和 S1 的循环页取整:
- 注意力按原生 16-token、16,384 字节的单元分配;
- 循环检查点按原生 1,594,368 字节的连续复合体分配,间隔 1792 token;
- 两类对象来自两个独立池,池容量在启动时固定,一边的空闲容量不能挪给另一边。
D0 的单元更紧凑,但必须满足池可行性约束。设池预算为 、(单位 KiB),原生注意力块数为 ,检查点数为 ,则一个状态组合可行当且仅当两个不等式同时成立:
两条约束必须同时成立,即使两类状态的总分配量小于 。这就是静态池的结构性风险:一个池被填满时,另一个池可能还剩大量空闲,但引擎无法挪用。它和分页共享池形成了鲜明对照,也解释了后文 D0 与 S2 的排序为什么会随负载和预算翻转。
对比口径
S0–S2 共用同一个 512-token 注意力块与检查点网格,物理表示、内核访问方式和生命周期支持是累积变化的;D0 使用原生的 16-token 注意力块与 1792-token 检查点,且两个池的比例在对比前固定。因此 S2–D0 的对比并不只是“分页和原生哪个好”,而是把网格、分配单位与池可行性三条差异打包在一起。论文在讨论部分承认了这一点,读者也需要把结论限定在这个口径下。
分配算术:每个组织的账本
论文用一组公式把“组织”变成可计算的分配成本。设一个逻辑状态组合为 ,分别表示注意力对象数、检查点数、卷积载荷数;记 为组织 下为这组状态分配的总字节数,标称预算为 。论文关注的存储指标是 ,即预算能装下多少份这样的状态组合。
S0 的成本
S0 的每个注意力块和检查点都拿一个 1557 KiB 的页,因此
这里 表示按组织规则计算出的标称分配量。它完全忽略了检查点内部的实际构成,卷积载荷 不单独计入,因为检查点已经作为整体包含它。
S1 的成本与切换条件
S1 的注意力块变成 512 KiB,检查点变成 2048 KiB:
两者相减,得到 S0 到 S1 的节省量:
这个式子把取舍说得很直白:每个注意力块省 1045 KiB,每个检查点多花 491 KiB。只有当
时,S1 才比 S0 省。换句话说,平均每 2.13 个检查点至少要配一个注意力块,分页检查点才划算。对长上下文、共享前缀多的负载,注意力块数量远多于检查点,S1 稳赢;对上下文很短、检查点密集(例如小分块预填充)的负载,S1 反而更贵。这是一个可以在线计算的判断,不需要跑实验。
S2 的成本
S2 的注意力块 512 KiB、检查点 1536 KiB SSM,卷积状态每 16 个共享一块 512 KiB 的板。设 为实际分配的板数,则下界是 :
S1 到 S2 的节省量是
理想情况下 ,每 16 个检查点省 15 个 512 KiB 页。但由于分配历史会留下半满的板,实际 往往大于下界,节省量相应缩水。这提醒一个容易被忽略的工程事实:打包类设计的理论收益取决于分配器能否保持高占用率,而不是公式里的下界。
分配浪费的直观对比
把三种共享组织放在同一组代表性状态上,浪费的来源就很清楚。假设 (8K 上下文的粗略注意力块数),:
- S0: KiB,其中注意力页浪费 KiB;
- S1: KiB,无页内浪费,但检查点多了 KiB;
- S2: KiB,卷积板即使只用了 4 个槽也按一整块计。
在同一预算下,S2 能装下的有效状态接近 S0 的两倍。这不是吞吐数字,而是分配账本:同样的显存,装得下更多可复用状态,后续调度和准入空间自然更大。
D0 的容量口径
D0 没有统一的分配公式,而是用两个池预算的可行性约束描述容量。它的优势在于原生注意力块只有 16 KiB,一个 512-token 的注意力对象只需 32 个块,取整误差最多 16 token;缺陷在于池比例固定,一旦某一类状态的需求比例偏离启动时的设定,池就会被冻结。
工程上的取舍可以这样总结:
| 组织 | 注意力页内浪费 | 检查点取整 | 卷积浪费 | 结构性风险 |
|---|---|---|---|---|
| S0 | 1045 KiB / 块 | 无 | 无独立页 | 注意力量大时浪费线性放大 |
| S1 | 无 | 491 KiB / 检查点 | 491 KiB / 检查点(专用页) | 注意力块少时总成本上升 |
| S2 | 无 | 无(SSM 整切) | 至多 511 KiB / 板 | 板占用率依赖分配历史 |
| D0 | ≤ 16 token | 1792 token 网格 | 包含在检查点内 | 双池比例不匹配时冻结容量 |
换成别的模型几何,结论会怎么变
论文的数字绑定在 Falcon-H1 的几何上:每 512 token 一个检查点、检查点 1557 KiB、注意力 1 KiB/token。换一个混合模型,比例会变,结论也可能变。把上面的算术抽象一下,就能在不跑实验的情况下判断某种组织是否值得。
设注意力块大小为 KiB,完整检查点大小为 KiB,页粒度取 。S0 给每个对象一个 KiB 页;S1 把检查点切成 个成员页,每页 KiB。于是
第一项是 S0 在每个注意力块上浪费的字节数,第二项是 S1 在检查点上多付的取整字节数。只要 是 的整数倍,第二项为零,S1 恒优于 S0; 越接近整数倍,S1 的代价越小。Falcon 的 1557 KiB 不是 512 的整数倍,所以每个检查点多付 491 KiB,这是它最不利的情形之一。
反过来,如果某个模型的检查点只有 1024 KiB,页粒度 512 KiB,S1 的检查点正好两页,没有额外取整,每个注意力块还能省 512 KiB,S1 几乎无条件胜出。如果检查点达到 2500 KiB,页粒度 512 KiB,S1 用五页装下(2560 KiB),每个检查点多付 60 KiB,但每个注意力块省 1988 KiB,只要注意力块不是极度稀疏,S1 仍然占优。
再看卷积槽。S2 的收益来自“把远小于页的对象塞进共享槽”,其节省上限是每个检查点省下一整页,实际节省取决于板占用率。若卷积状态从 21 KiB 涨到 200 KiB,32 KiB 槽位就装不下,必须换成更大的槽或独立页,S2 的打包假设失效。实现时要先算清楚:最小状态对象的尺寸是否远小于页粒度。如果答案是“只小一个数量级以内”,打包的复杂度可能不值。
D0 的适用条件则取决于两类状态的需求比是否稳定。若注意力与检查点的比例随请求长度剧烈变化,静态双池会在某些时段把一侧撑爆、另一侧闲置;若比例稳定且能提前估准,原生单元能把取整浪费压到最低。判断标准不是“原生好还是共享好”,而是需求比的可预测性。
这套泛化分析也解释了论文为什么反复强调“组织要与工作负载一起评估”。同一套公式,在不同模型几何、不同上下文分布下会给出不同的胜负,单看某一组配置的吞吐排名没有迁移性。
引用计数、反查表与回收顺序
物理分散之后,最容易出错的地方不是分配,而是回收。S1 把一个检查点拆成四个成员页,S2 再让多个检查点共享一块卷积板。逻辑上仍然原子,物理上却出现了“一个页被多个逻辑条目依赖”的多对多关系。要把这套关系维护正确,至少需要三样东西:成员级引用计数、页到逻辑条目的反查表、以及确定的失效顺序。
成员级引用计数
对 S1,引用计数不能只记在检查点上,而要记在每个成员页上。原因很实际:一个检查点的四个成员页可能在不同时刻被不同路径访问。例如预填充只读 SSM 成员、不解码卷积;或者某个成员页被替换成只读快照。若只在检查点级别计数,回收器无法判断“这个成员页现在到底还有没有人用”。
计数规则可以写成:
adopt(cp): for m in members(cp): # 3 个 SSM 页 + 1 个卷积页 ref[m] += 1 mark_logical(cp, active)
release(cp): for m in members(cp): ref[m] -= 1 if ref[m] == 0: candidate_pages.push(m)
reassign(page): for cp in reverse_index[page]: # 所有依赖该页的逻辑检查点 invalidate(cp) # 整个逻辑条目失效 unmap(page) free(page)reverse_index 是页到逻辑检查点的反查表。没有它,回收器只能顺序扫描所有缓存条目,代价随缓存规模线性增长;有了它,一次回收的代价与依赖该页的条目数成正比,通常很小。但反查表本身也要维护:每次 adopt/release 都要同步更新,更新失败会导致“页被回收但条目仍可查”的悬空引用。
板共享下的失效传播
S2 把问题再放大一层。一个 512 KiB 板里有 16 个槽,可能属于 16 个不同检查点;板被重分配时,所有依赖这块板的缓存检查点都必须失效。失效不是把槽清零那么简单,还要把逻辑条目从查找结构里摘掉,否则下一次查找仍会命中一个物理上已被覆盖的条目。
论文的附录给出了引用计数与失效规则的细节,核心是“先失效逻辑条目,再释放物理页”。顺序反了,就会出现短暂的窗口:页已经可以被写,但逻辑条目还在。并发场景下,这个窗口足以让另一个请求读到正在被覆盖的状态。
一个稳妥的实现顺序是:
- 冻结该页对应的逻辑条目,阻止新的 adopt;
- 等待已有执行引用释放,或把请求标记为需要重算;
- 从查找结构中摘除条目;
- 清除反查关系;
- 归还物理页到空闲队列。
每一步都可能失败,因此实现上通常需要一个“回收事务”状态,保证中断后可以继续,而不是留下半失效的中间态。
抢占与固定
混合模型的抢占比全注意力更棘手。全注意力抢占只需要把 KV 块换出或丢弃,恢复时重算缺失部分;混合模型还必须保证检查点与注意力边界对齐,否则恢复后无法接上。论文提到抢占时的 pinning:被抢占请求的检查点不能被回收器覆盖,直到该请求被恢复或明确放弃。
pinning 与 retention 的区别在于强制性:pinning 是执行正确性的要求,retention 是性能策略。实现时不要把两者混在一个计数器里,否则会出现“为了性能保留的页阻止了必要的回收”或“强制固定的页被策略误释放”的问题。
失效的代价在哪里
把检查点拆小,单次失效的范围理论上更小:S0 让一整个逻辑对象失效并重分配一整页;S1 让四个成员页上的同一个逻辑条目失效;S2 让三个 SSM 成员页与一个卷积槽所服务的条目失效。但共享板让失效范围重新变大:一块板上的 16 个槽可能牵动 16 个检查点。于是 S2 的失效代价取决于板的占用率与依赖集中度,而不是单纯的页大小。
这解释了一个反直觉的现象:S2 的页内浪费最小,但它的失效工作不一定最小。论文在讨论部分指出,紧凑表示需要跨页和槽边界追踪依赖,这是它换来的复杂度。工程上如果失效路径不是瓶颈,S2 值得;如果请求生命周期很短、失效极频繁,S1 的规则更简单,可能更稳。
执行路径:内核如何直接吃物理布局
三种共享组织的执行路径有一个共同点:逻辑原子,物理分散,内核直接寻址。这一点决定了 S1/S2 能否在减少浪费的同时不引入重建开销。
解码步的状态访问
在标准全注意力解码里,每个线程块按块表读 KV,块表是“逻辑块号 → 物理块号”的数组。S1 把这套间接寻址扩展到循环状态:SSM 内核需要三个成员页,它同样通过一张页表得到 ,然后按上面的地址公式逐元素访问。S2 把卷积状态的寻址变成“板号 + 槽偏移”,内核只用一次乘法得到行首。
这样做的好处不是“省一次拷贝”那么简单,而是消除了每个解码步对整块检查点的顺序读。如果一个检查点 1557 KiB,每个 step 都从 HBM 完整读一遍,单是带宽就足够吃掉不少帧时间;按成员页访问,活跃请求实际只需要读它当前所在的页段加上少量边界,读放大被控制在页粒度。
预填充与恢复路径
预填充往往需要写一个新检查点,并且可能要读旧检查点做恢复。论文观察到,分块或恢复预填充允许先把初始检查点聚合到连续 arena,再走顺序读写。原因是这条路径本身的分块很大,间接寻址的额外开销相较于大块连续传输可以忽略;而解码步的访问次数极多,间接寻址的固定开销摊到每次访问并不划算。这种“按路径选表示”的做法值得在实现任何状态管理层时借鉴:不要假设一种物理布局对所有阶段都最优。
完整校验与失效
S0–S2 共用一条完整状态有效规则:注意力、SSM、卷积必须在同一边界上有效。候选边界跟随各组织的检查点网格,S0–S2 是 512 token,D0 是原生循环间隔。
执行引用保护活跃请求可能访问的存储。最后一个执行引用释放后,逻辑条目可以继续留在缓存;但重分配它的底层存储时,必须先让这个条目失效。
S1 和 S2 把这条规则从“一个检查点一个引用”细化到“一组成员页”:
- 查找命中时,同时增加所有必需成员的引用;任一成员引用为零并且要被重分配时,需要查反查表,把依赖它的逻辑检查点全部标记失效;
- S2 的板共享让失效范围扩大到整块板上的所有依赖条目;
- 可选的保留(retention)策略会延长选中检查点的保护期,使其在请求完成后仍不被释放,用于跨请求复用。
抢占时的固定
论文的补充材料描述了抢占时的 pinning。当一个活跃请求被抢占时,引擎要保证它的检查点不会被其他请求或回收器覆盖,否则恢复就无法接上。pinning 与保留策略共同构成了检查点寿命控制的两个旋钮:一个是执行层面的“必须保”,一个是策略层面的“尽量保”。
一个小内核伪代码
把上面的寻址规则写成伪代码,能更直观地看出 S1/S2 的差别:
# 解码步:读一个检查点的 SSM 与卷积状态def read_checkpoint(boundary b, members pi[3], conv_slot): for j in 0..2: page = pi[j] for u in range(page_elements): ssm_val[u] = hbm[base + page * PAGE_BYTES + delta(j, u)] if conv_valid(conv_slot): line = slab_of(conv_slot) * 16 + slot_of(conv_slot) # S2 conv_val = hbm_slab[line * 32KiB ... ] # 32 KiB 行 else: conv_val = ZERO # 无效哨兵,不回落到 0 号页S1 里 是一次独立的 512 KiB 页读;S2 里它变成一次 32 KiB 行读。伪代码中的 conv_valid 检查就是论文强调的无效哨兵:没有它,缺失条目可能被错误地解释为某个合法地址,导致静默读到别人的状态。
服务层:准入余量、并发与共享
存储组织的收益要落到服务行为上,必须经过调度器和准入策略。论文设计了一个容易被忽略但效果明显的旋钮:准入余量(admission headroom)。
准入余量是什么
设某个组织的总块数为 ,调度器在接纳一个等待中或已被抢占的请求时,要求额外预留 个块,其中 是余量比例。这个余量在分配之前作为可行性条件检查,字节值取决于各组织的分配单元,结果直接影响运行集合的大小。
直觉上,余量是给“下一个请求”留出的安全垫:如果总是把块池用到最后一页才拒绝新请求,抢占会变得频繁而昂贵;留一点余量,可以让新请求和恢复请求更容易接上,减少等待队列的抖动。
为什么余量对不同组织的效果不同
论文在不同组织上扫描了五个余量比例(),覆盖 b63、b83、b108 三个预算,每组用 12 个新种子做确认。曲线形态差异明显:
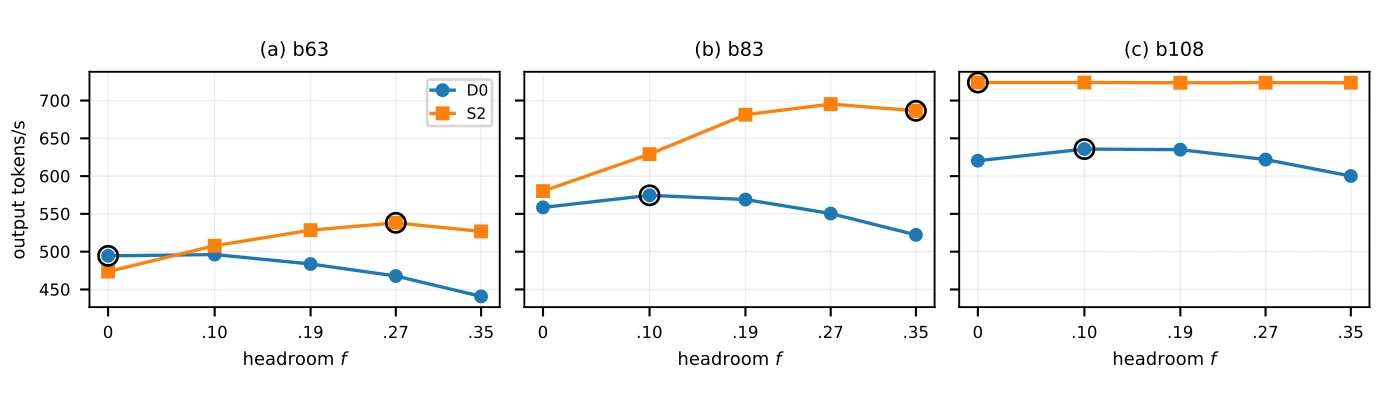
横轴是余量比例 ,纵轴是 3 req/s、cap 63 负荷下的吞吐;实线为 S2,虚线为 D0,不同颜色对应不同预算。可以看到 S2 在 b63、b83 上随余量先升后平,而 b108 的曲线几乎水平;D0 则在 b83/b108 的小正余量处达到峰值,随后随余量增大而下降。图源:论文 Fig. 6。
原因在于两种组织的余量“价格”不同。S2 的块是 512 KiB 或更小的槽, 个块对应的字节数相对温和,换来的是更少的抢占和更平滑的队列;D0 的注意力块只有 16 KiB,但检查点块很大,余量按块数算时,检查点侧的余量可能吃掉大量池容量,曲线因此更早下降。
论文给出的确认结果:相对各组织自己的基准余量,S2 在 b63 上提升 13.61%,b83 上提升 18.81%;D0 在 b83、b108 上只提升 2.86% 和 2.50%。当采用共同余量时,顺序会随预算变化:b63 上 D0 更高,b108 上 S2 更高,b83 则不确定。当使用各组织的预选余量时,S2 在所有三个预算上都更高。
这段结果的技术含义不是“S2 更好”,而是:内存组织的优劣会随准入策略变化。物理布局决定了余量的单位成本,准入策略决定了余量用多少,两者共同决定运行集合。只比较布局、不比较策略,会得到有偏的结论。
共享前缀与工作点
论文的主工作点使用 ShareGPT-V3 派生负载:8 个共享上下文,约 3,332 输入 token,模型上限 8,192,生成上限 1,024。共享前缀比例记为 ,实验比较了 、、 三档。
在 时,S1/S0 的端点交互比 强 9.623 个百分点,S2/S1 强 10.043 个百分点(Holm 校正后显著,p 值分别为 0.01074 和 0.0391)。这说明分页和打包的收益主要来自联合复用机会:共享前缀越多,注意力 KV 与检查点同时被命中的概率越高,物理表示带来的浪费减少和失效范围收窄才真正转化为吞吐。
但论文还做了一个关键对照:无共享控制组(removes common-prefix reuse opportunity,但保留缓存创建与查找)。在这个条件下,记录到的初始输入工作量与总 token 数在 S0/S1/S2 之间完全相同,抢占为零,吞吐仍从 293.836 提升到 405.376、415.862 输出 token/s。这意味着收益并不完全依赖共享,物理布局本身对执行路径(少读、少失效、少争用)的改善也能体现出来。这个对照设计值得单独记下来,因为很多缓存类优化在“关掉命中率”后就失效,而这里没有。
记录工作量与运行状态
Q2 在 b63、3 req/s 工作点记录到:初始输入 token 从 S0 约 766k/run 降到 S2 约 612k/run,等待中位数从 78.8 降到 25.7,运行中请求中位数从 6.7 升到 17.0。在 b108、4.5 req/s 下,初始输入从约 698k 降到 430k,等待中位数从 67.7 降到 8.5。
这些计数是服务层计数器,不是总 GPU 工作量。论文在附录中明确提醒这一点:等待中位数下降、运行中请求增加,说明运行集合变大了,但单请求的 GPU 实际计算量未必成比例减少。解读这类指标时要区分“服务行为”与“硬件工作”。
预算与负载如何翻转 D0–S2 排序
在固定的 3 req/s、cap 63、零余量条件下,D0/S2 的配对差异为:b63 上 +4.978%,b83 上 −1.728%,b108 上 −12.556%。b63 和 b108 显著,b83 不确定。这组数字与前面的取整分析吻合:小预算下 D0 的原生单元更紧凑,能多装一点;预算越大,S2 避免大页取整的优势越明显。
随负载变化,顺序还会再变。b63/cap 63 下两者在低负载几乎相同,高负载端 D0 略快;b108/cap 109 下 S2 在 3.0、4.5 req/s 明显更快。在 b108 的共同种子上,D0 相对 S2 的差距从 3.0 req/s 的 −13.17% 缩小到 4.5 req/s 的 −4.74%。负载越高,运行集合越大,S2 的紧凑表示越能抵消 D0 的单块优势。
这段结果的工程启发是:静态池与共享池之间没有全局胜者。启动时按一个比例切两个池,在负载结构变化时会变成负担;共享池用统一的块表换取了灵活性,代价是大对象和小对象的取整浪费。如果产品负载结构稳定、且能事先估准两类状态的比例,D0 的紧凑性值得;如果负载变化大,共享池更稳。
检查点寿命:复用深度真正的天花板
前几节都在讨论“同一时刻能装下多少状态”。但混合模型的联合复用还有一个时间维度:一个前缀能否被复用,取决于检查点在查找时是否还在。论文用 Q7–Q9 三组实验把这条线索单独拿出来。
复用深度与检查点供给
Q7 追踪了 b83 预算下准入时的联合复用。设 为与注意力窗口无关的最深可用检查点深度, 为可用注意力前缀内最深完整检查点。查找时的注意力深度与循环深度遵循 M1 供给掩码账本(附录 G.2),trace-ON 历史与 trace-OFF 吞吐运行配对。
在全部六个测试的 S2 单元里,可用的循环检查点决定了被采纳的联合复用深度。则 或更浅,差距 。在 与 两档、三个种子上 ;余量从 0 升到 0.19 时,配对提升分别为 785.1、650.2、554.7 token。
这句话是全文最值得记住的结论之一:瓶颈不在注意力 KV 的可用量,而在检查点的存在量与位置。注意力前缀再长,如果没有在边界上的完整检查点,联合复用就只能退回到更浅的位置。这也解释了为什么“加深前缀树、多存 KV 块”对混合模型的收益有限:树里可能有许多 KV 段,但循环检查点只有固定间隔上的少数几个。
延长生产侧检查点寿命
Q8 在 S2 固定的 254 页预算下改变检查点寿命。S2+Retention 对满足“不同请求需求阈值”的 512-token 检查点,在生产请求运行期间豁免释放;请求完成或被抢占后,普通缓存和固定规则照常生效。
结果很直接:同样的 254 页预算下,生产侧保留提高了循环可用性和联合复用。 在 seed 79010–79012 上分别提升约 +703、+1439、+1092 token/request;注意力可用性只提升约 +51、+123、+72 token/request(一个种子存在 [0, +5.12] 的不确定性)。三个种子的吞吐效应均为正,账本口径 +17.8%,请求跨度口径 +23.5%。
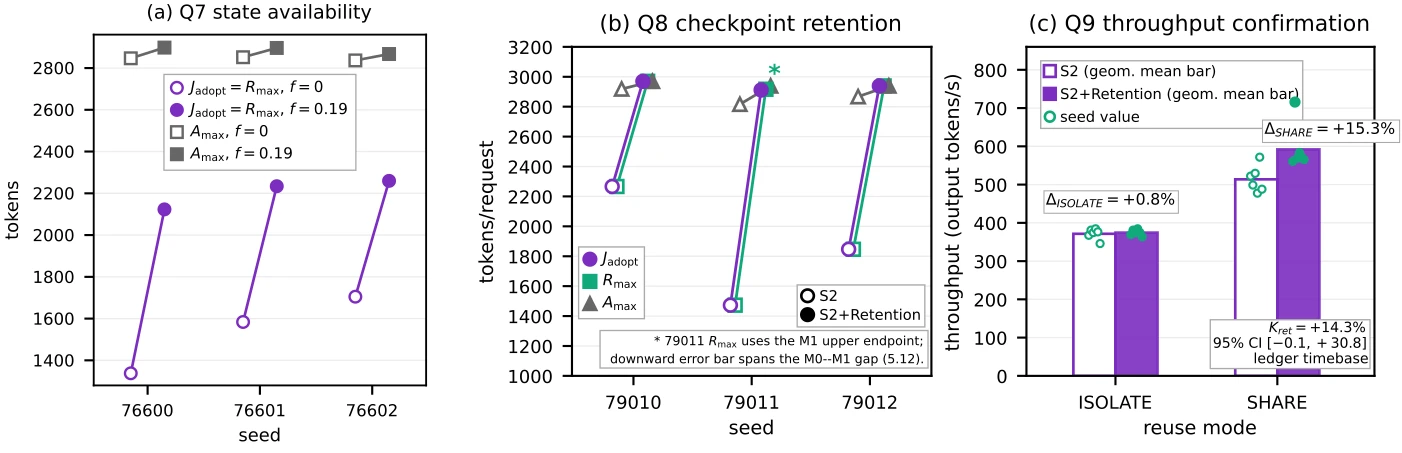
三个面板分别对应:左图是 Q7 在两档余量下的状态可用深度,中间是 Q8 在 254 页预算下 S2 与 S2+Retention 的绝对深度,右侧是 Q9 在 SHARE/ISOLATE 两种跨请求复用模式下的账本吞吐。中间图的提升几乎全部发生在 (联合深度)上,而注意力可用性增幅很小;右图显示保留带来的增益在 SHARE 下远大于 ISOLATE。图源:论文 Fig. 7。
SHARE / ISOLATE 与保留的交互
Q9 用新种子 88001–88006 做了平衡顺序的四条件交叉:S2/S2+Retention × SHARE/ISOLATE。SHARE 省略 cache_salt,允许跨请求复用;ISOLATE 使用稳定的请求唯一 salt 阻止跨请求复用,但保留缓存与同请求续跑。
六种子几何平均账本吞吐:
- ISOLATE:S2 371.42,S2+Retention 374.52 输出 token/s,效应 +0.8%(95% CI 含零);
- SHARE:S2 513.70,S2+Retention 592.07,次口径效应 +15.3%(95% CI [+0.8, +31.8])。
预注册的主分析是保留交互 ,点估计 +14.3%,95% CI 包含零([-0.1, +30.8])。这是一个点估计为正、但统计上不足以排除零的结果。论文如实报告了这一点,没有把它包装成确定结论。
工程上可以这样读:保留策略的价值集中体现在“有跨请求共享”的场景;在完全隔离的场景里,保留几乎不改变吞吐,只是延长了本请求的检查点寿命。这也说明保留策略的代价不是零:它占用的页本来可以供其他请求使用,只有当复用机会真实存在时,这笔占用才划算。
保留与准入的耦合
Q7 与 Q8 合起来揭示了一个耦合:准入余量提高,会让更多等待/被抢占请求进入运行集合,从而在准入时刻看到更多检查点仍在;生产侧保留,则让检查点在请求结束后继续存在。两个旋钮都作用于“检查点供给”,但一个作用于时间维度的入口,一个作用于生命周期的尾部。
把它们分开调,容易在某个维度上过度优化:只加余量,检查点在请求结束后被销毁,复用深度仍然卡住;只加保留,等待队列仍然因为余量不足而长期积压。论文的讨论部分明确建议把“物理状态表示”和“请求准入、检查点寿命”放在一起设计,而不是只改其中一项。
正确性与未解决的问题
这套设计的核心语义是“逻辑检查点原子,物理成员分散”。它依赖三条规则:
- 完整有效:注意力、SSM、卷积必须在同一边界有效,任一成员被重分配就让整个逻辑条目失效;
- 执行保护:最后执行引用释放前,成员页不能被覆盖或重分配;
- 可重分配需要失效:缓存条目可以保留,但底层存储重分配前必须失效。
S2 的板共享把这套规则推到了最复杂的形态:一块板上的槽位分属不同逻辑检查点,回收时要沿依赖关系失效一整个集合。引用计数、反查表和失效顺序如果有一处出错,后果不是崩溃,而是静默读到别的请求的状态,输出错乱且难以定位。
持续续写的正确性尚未定论
论文在局限部分明确提到:对部分保留状态路径与独立重算做干净续跑对比时,发现输出存在差异;在禁用跨请求保留状态复用的情况下,全负载隔离也出现了可变性。原因尚未确定,精确续跑正确性仍然开放。这意味着目前不能把“保留的检查点续跑”当作完全等价于重算。
对实现者来说,这条限制非常关键:在把混合状态缓存用在生产之前,需要设计可控的重算与可重复性测试,确认检查点续跑与全量重算在 token 级一致,而不只是“看起来差不多”。
测量口径的边界
论文的多处结果来自有限种子和特定预算配置,部分历史运行缺少精确 commit、运行时可用显存字段或完整原始记录。作者在附录中记录了这些边界。引用这些数字时,应同时引用其预算、负载、余量与种子口径,避免把单点差异泛化成普遍结论。
实验口径的完整清单
为了便于把结论放回上下文,这里把论文的实验设置集中列出。读结果时对照这张表,比记住单个百分比更有用。
| 维度 | 设置 |
|---|---|
| 模型 | Falcon-H1-7B-Instruct,BF16,张量并行 1 |
| 硬件 | 单张 NVIDIA A100-PCIE-40GB,修改过的 vLLM V1 |
| 预算标记 | b63、b83、b108(planner 目标,非 GiB 值;各组织按同一字节目标换成自己的块数) |
| 主负载 | ShareGPT-V3 派生:8 个共享上下文,约 3,332 输入 token,上限 8,192,生成长 1,024 |
| 主工作点 | 3 req/s,cap 63;另设 0.8 req/s 与 4.5 req/s 低/高负载检查 |
| 吞吐口径 | 测量区间内成功完成的输出 token 数;绝对吞吐按 run 算术平均,相对效应先在种子内成比再平均 |
| 延迟口径 | 各种子 run 级 p99 的算术平均 |
| 统计 | 配对种子;Q1 的 6 个对比做 Holm 校正;Q6 用 12 个新种子 76400–76411 确认 |
| 寿命实验 | Q8 在 254 页固定预算,Q9 用种子 88001–88006 做平衡顺序交叉 |
两个值得注意的口径细节:
- 预算标记不是 GiB。b63、b83、b108 是 planner 匹配的标称预算,各组织按同一个字节目标换算成自己的整数块数,保留各自的取整误差。这意味着同一标记下,不同组织实际可用的字节数略有差异,比较时要把取整算进去。
- 吞吐的两种时基。Q9 的主分析用账本时基,包含基准编排与完成轮询,服务启动与关闭不计入;请求跨度时基作为灵敏度分析(附录 G.3–G.4)。两种时基给出的百分比不同,论文对 Q8 同时报告了 +17.8% 与 +23.5%,原因就在这里。
如果要在自己的引擎里落地
把论文的机制简化成一条可执行的路径,大致是这样:
- 先量化几何。测出注意力块大小、检查点大小、卷积状态大小,以及检查点间隔。计算 的系数,判断分页检查点在你当前负载下是否划算。
- 确认最小对象与页粒度的比例。如果卷积状态远小于页,考虑槽/板打包;如果只小几倍,先不要引入槽位的失效复杂度。
- 决定池形态。负载比例稳定且可估,原生双池更省;比例波动大,共享池更稳。注意静态池的冻结风险在峰值负载时才暴露。
- 把寻址做进内核。成员页映射与槽行标识直接传给循环内核,禁止每步重建连续检查点;预填充路径例外,允许聚合。
- 重写失效与引用。按成员页计数、建页到逻辑条目的反查表、固定“先失效后释放”的顺序;抢占 pinning 与 retention 分开计数。
- 准入与布局联合调。余量比例的单位成本取决于布局,先在小预算上扫曲线,再决定生产值;不要拿一个组织的余量直接套到另一个组织上。
- 正确性先行。在启用跨请求保留之前,做“保留续跑 vs 全量重算”的 token 级对照,至少覆盖不同上下文长度与抢占恢复路径。
对未来设计的启发
从这套实验里可以提炼几条可迁移的原则:
- 物理布局与逻辑原子解耦:逻辑上仍是一个检查点,物理上可以拆成成员页,前提是把失效与引用规则沿着成员维度重写,而不是只把页做小。
- 按路径选表示:解码步走间接寻址,预填充走连续聚合;不要追求一套物理布局同时服务所有阶段。
- 把打包的收益和分配器的占用率挂钩:公式里的下界不等于现实收益,板/槽的占用率是必须单独度量的指标。
- 布局与准入一起评估:余量的单位成本由布局决定,布局的相对排序又由余量决定,二者存在反馈。
- 检查点供给是天花板:在混合模型里,前缀可用性的上限常常是检查点,而不是注意力 KV。
- 小对象要有专用粒度:21 KiB 的卷积状态需要一个能容纳它的槽位,而不是一整页。
和其他方案的对照
把这篇的系统放到更广的推理框架语境里,可以看到它在几个已有方向上的边界。
全注意力平台的块池与前缀树已经把这些机制打磨得很成熟:vLLM 的块池与前缀复用、SGLang 的 radix 前缀缓存,都解决“KV 块如何复用、如何淘汰”。它们的可复用单位是一段 KV,没有额外约束。混合模型需要把复用单位扩展到“KV + 检查点”的联合边界,这层约束在传统前缀树里没有位置。关于 vLLM 如何让全注意力、滑窗与 Mamba 层共用块池,可参考 混合 KV Cache 的组账本:KVCacheCoordinator;前缀树的调度与批次约束可参考 RadixAttention 完全拆解;混合模型前缀命中跑不进同一批的执行气泡问题,可参考 RadixFlow 完全拆解。
递归状态在 llama.cpp 里也有对应表示:Mamba、RWKV 与混合模型的“KV Cache”并不真的是一块随 token 增长的缓存,而是固定大小的状态加检查点。这部分实现可参考 llama.cpp 的递归状态缓存。
状态压缩是另一条正交路线。KV 量化把块内字节数降下来,但与分配粒度、检查点寿命不在同一层面:量化可以让同样的页装更多 token,却不能解决“检查点只有 21 KiB 却占一整页”的问题。相关机制可见 KVQuant 与 KIVI;对分页缓存上的 KV 量化内核,可参考 vLLM TurboQuant KV Cache 量化。
与本文最接近的讨论是内存组织的“原生 vs 共享”之争。D0 的静态双池代表原生,S0–S2 代表共享分页。这场争论在 CPU/GPU 统一内存、NUMA 分配、对象池设计里都反复出现,结论也相似:原生单元减少浪费,静态池冻结容量;共享单元灵活,但受取整与失效传播拖累。混合模型把这个老问题具体化成了“1536 KiB + 21 KiB”这一对极度不对称的对象。
小结
这篇工作把混合注意力模型的状态管理从“缓存什么”推进到“物理上怎么摆”。四组组织共享同一套完整有效语义,差别只在页的大小、检查点内部分割、卷积槽打包与池的静态/共享选择;它们对应的分配公式可以离线比较,节省量只取决于注意力块与检查点的数量比。
执行层的关键是让循环内核直接消费成员页映射与槽位行标识,避免每步重建连续检查点;预填充路径则允许聚合,体现了按路径选表示的工程判断。
服务层的结论更有意思:布局的相对优劣会随内存预算、负载与准入余量翻转;共享前缀放大收益,但无共享对照表明收益并非只来自命中;检查点供给才是联合复用的天花板,延长生产侧检查点寿命能在固定页预算下提升复用深度,但在隔离场景下几乎无效。
正确性方面,保留状态续跑与重算的一致性尚未解决,这是把该设计推向生产前必须补齐的一环。
参考资料
- Native Dual Pools or Shared Paging? Memory Organization for Concurrent Hybrid LLM Serving(arXiv:2610.15755)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(PagedAttention, SOSP 2023)
- Falcon-H1: A Family of Hybrid-Head Language Models Redefining Efficiency and Performance(arXiv:2507.22448)
- RadixAttention 论文:Efficiently Programming Large Language Models using SGLang(arXiv:2312.07104)
- vLLM 官方仓库
- SGLang 官方仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



