


vLLM 源码完全拆解(二十二):BlockPool——空闲块队列、LRU 淘汰与引用计数如何管住整块 KV
前情提要
这个系列已经沿着 vLLM V1 的源码走过了调度、块管理与前向的大部分环节:可参考 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block,以及 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block。在那两篇里,KVCacheManager 是主角,它按请求的 token 预算决定“该给谁分配几块、从哪里找前缀命中、不够了该抢占谁”。
但 KVCacheManager 本身并不持有任何一个物理块。真正存放全部 KVCacheBlock 对象、维护空闲块链表、记录引用计数、执行前缀哈希淘汰的,是 vllm/v1/core/block_pool.py 里的 BlockPool。前几篇在讨论“分配与回收闭环”时,把它当作一个黑盒仓库一笔带过。这一篇把这个仓库本身打开:一块 KV 缓存在它的整个生命里会经历哪些状态,空闲块按什么顺序被取出,引用计数在什么时候增减,哈希表里的条目在什么时候被抹掉,以及这些细节与站内讲过的块表、槽映射如何衔接(见 KV 块的三张映射表:逻辑块号、物理块号与 KV 槽号如何串成一条 64 位索引)。
先划定边界:BlockPool 不知道注意力内核长什么样,不知道分页寻址,也不知道 HTTP 层;它唯一的工作是把 num_gpu_blocks 个整数编号的物理块当成可借可还的资源来管。V1 架构中,KVCacheManager 负责“记账的策略”,BlockPool 负责“记账的账本”。
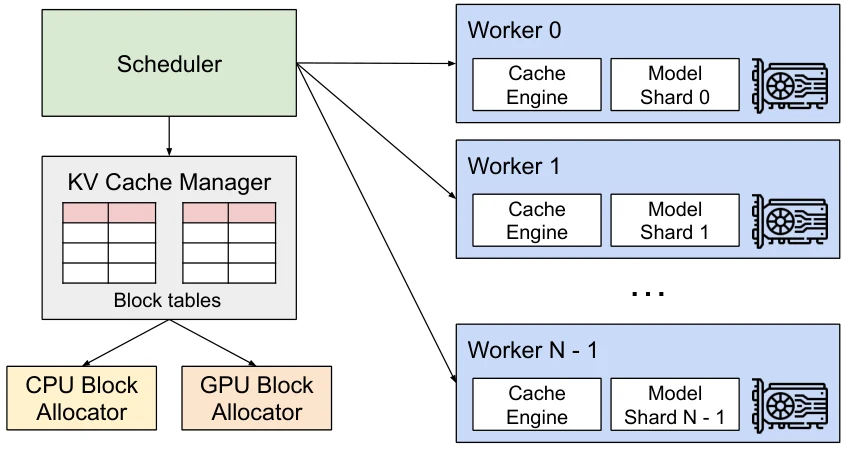
上图出自 PagedAttention 论文(SOSP 2023)。逻辑上连续的序列被切成固定大小的块,块表把逻辑块映射到物理块。BlockPool 管理的正是右侧那一排物理块的“分配权”:块表里的物理块号必须由它发放,也只有在它允许时才可能被回收。
为什么不直接把物理块做成一个数组加一个空闲计数?因为 vLLM 要同时支撑三件事:前缀缓存要求“块被释放后可能还会被再次命中”;调度器需要 O(1) 的空闲块统计与批量分配;异步传输(KV connector、CPU 卸载)要求“块已被逻辑释放,但内容还能被读一会儿”。三件事叠加,一个计数器远远不够,必须有链表、引用计数与哈希表三套结构协同。本篇按这三套结构逐一展开,最后回到“这些结构如何在一次调度步骤里被调用”。
一块 KV 缓存的一生:状态与字段
KVCacheBlock 定义在 vllm/v1/core/kv_cache_utils.py,是一个 @dataclass。字段不多,但每一个都直接决定这块缓存能被谁用、还能被谁命中。
@dataclassclass KVCacheBlock: # Block ID, ranging from 0 to num_gpu_blocks - 1. block_id: int # Reference count. ref_cnt: int = 0 # Deferred frees may contain blocks from multiple pools. pool: "BlockPool | None" = field(default=None, repr=False, compare=False, kw_only=True) # The hash key (block hash + group id), only available # when the block is full and cached. _block_hash: BlockHashWithGroupId | None = None # Number of prefix tokens covered by _block_hash. _block_hash_num_tokens: int | None = None # Used to construct a doubly linked list for free blocks. prev_free_block: "KVCacheBlock | None" = None next_free_block: "KVCacheBlock | None" = None # Whether the block is a null block that should never be cached. is_null: bool = False逐字段解释:
block_id:池内下标,也是块表、槽映射、KV connector 上报块号时使用的唯一身份。它在池初始化那一刻就固定,内容变了、身份不变。ref_cnt:引用计数。谁“正在依赖这块内容”——运行中的请求、前缀命中后的使用者、在途的异步拷贝——都持有一份引用。归零只意味着“没有人再声明依赖”,并不等于“内容被立刻抹掉”。pool:块归属的池。V1 允许一个调度器管理多个BlockPool(不同 KV 组可以有自己的池),释放时可能把属于别的池的块混进同一批列表,free_blocks靠这个字段分拣。compare=False让它在比较两个块对象时被忽略。_block_hash:前缀哈希键,包含块哈希与组 id。未满块为None;一旦块被写满并被登记进前缀缓存,它会被设置。_block_hash_num_tokens:这个哈希键覆盖的前缀长度。对满块而言就是块边界 token 数;引入部分前缀条目后,同一个块可以挂一个“边界落在块内部”的哈希,因此这个字段是判断“条目已经过时”的依据。prev_free_block/next_free_block:双向链表指针。注释写明“只应由FreeKVCacheBlockQueue操作”,它们不是一般意义上的前驱后继,而是空闲队列的结构。is_null:占位块标记。占位块不持有数据,也永远不进缓存。
对外访问通过属性封装,设置与重置都带断言:
@propertydef block_hash(self) -> BlockHashWithGroupId | None: return self._block_hash
def set_block_hash(self, block_hash, num_tokens=None) -> None: assert self.block_hash is None and self._block_hash_num_tokens is None, ( "The block already has a hash. This should not happen." ) self._block_hash = block_hash self._block_hash_num_tokens = num_tokens
def reset_hash(self): self._block_hash = None self._block_hash_num_tokens = Noneset_block_hash 的断言是池的核心不变量之一:一个块只能有一个主哈希。需要多级前缀边界时(部分块、不同组块大小的倍数关系),额外哈希走 cached_block_hashes_by_block 这个旁路字典,而不是覆盖主哈希。后面讨论多条目淘汰时会再次用到这个设计。
从生命周期看,一块物理块大致在六种状态之间迁移:
| 状态 | ref_cnt | 有哈希 | 在空闲队列 | 能写入 | 能命中 |
|---|---|---|---|---|---|
| 空闲、无缓存身份 | 0 | 否 | 是 | 分配后即可写 | 否 |
| 空闲、缓存候选 | 0 | 是 | 是(尾部区) | 否(一旦被分配即失效) | 是(命中即 touch) |
| 某请求的私有尾块 | 1 | 否 | 否 | 是(is_block_writable) | 否 |
| 某请求的满块,已登记哈希 | 1 | 是 | 否 | 否 | 是 |
| 多请求共享 | ≥ 2 | 通常有 | 否 | 否 | 是 |
| 异步读取中(已 unpin) | 0 | 可能 | 是(队尾) | 分配即触发回调 | 可能 |
最关键的一列是“能写入”,由 BlockPool.is_block_writable 判定:
def is_block_writable(self, block: KVCacheBlock) -> bool: """Return whether a block can be mutated by its sole owner.""" return not block.is_null and block.ref_cnt == 1 and block.block_hash is None三个条件缺一不可。is_null 排除占位块;ref_cnt == 1 保证没有别的请求在同时读它——投机解码的目标序列与草稿序列、前缀命中后的复制者都可能在同一份 KV 上同时挂引用;block_hash is None 保证这块内容没有以某个前缀身份被登记,否则原地改写会让那个前缀命中到错误的数据。这个函数在投机解码与部分命中路径中被反复调用。
构造:一次性分配对象与占位块
BlockPool 的构造函数把资源一次性准备到位:
self.blocks: list[KVCacheBlock] = [ KVCacheBlock(idx, pool=self) for idx in range(num_gpu_blocks)]self.free_block_queue = FreeKVCacheBlockQueue(self.blocks)self.cached_block_hash_to_block: BlockHashToBlockMap = BlockHashToBlockMap()self.cached_block_hashes_by_block: dict[int, set[BlockHashWithGroupId]] = {}self.null_block = self.free_block_queue.popleft()self.null_block.is_null = True第一,块对象在启动时一次性创建,运行期不再分配 Python 对象。每个 decode step 的调度循环里没有堆分配,也就没有 GC 压力;池的 Python 侧内存是一份定长列表,真实数据在 GPU 显存里,由 KVCacheManager 在初始化时按层分配。
第二,null_block 把 0 号块从队头摘出来并标记为占位块。占位块的含义是“这个逻辑位置没有有效数据”:滑动窗口注意力中被窗口跳过的前缀、分块本地注意力中被跳过的段、Mamba 混合模型的状态槽位,都会在块表里放占位块。用 block_id = 0 而不是 -1 的理由很实际:块表全是非负整数,内核无需负索引分支;代价是队列里实际可分配的块比 num_gpu_blocks 少一块,因此所有“总量”计算都要减一:
def get_usage(self) -> float: total_gpu_blocks = self.num_gpu_blocks - 1 if not total_gpu_blocks: return 0 return 1.0 - (self.get_num_free_blocks() / total_gpu_blocks)get_usage 还有一个细节:它只按空闲队列长度算,不区分队列里的块“是否真的被请求使用”。有哈希的空闲块(缓存候选)也算“已用”。这符合 KV 缓存的实际占用语义,却是排查“利用率一直 100%”时最常见的误解来源——状态表里“空闲、缓存候选”一列正是这种情况的合法状态。
第三,cached_block_hashes_by_block 是“块 id → 额外哈希集合”。它让一个块可以挂多个哈希条目(主哈希一个、旁路若干),并在块被淘汰时把全部条目一次性删除。
reset_prefix_cache 借助占位块做完整性检查:
def reset_prefix_cache(self) -> bool: num_used_blocks = self.num_gpu_blocks - self.get_num_free_blocks() if num_used_blocks != 1: # The null block is always marked as used logger.warning( "Failed to reset prefix cache because some " "blocks (%d) are not freed yet", num_used_blocks - 1, ) return False self.cached_block_hash_to_block = BlockHashToBlockMap() self.cached_block_hashes_by_block.clear() ...占位块永远“在用”,所以 num_used_blocks != 1 意味着还有请求或异步传输持有块。此时拒绝重置而不是强行清空,是为了避免把仍在写的块登记进一个“已经清空”的缓存。这个接口在 RL 微调更新权重后(旧前缀缓存不再对应新权重),或 benchmark 需要干净起点时使用;后者需要先释放所有请求再调用。
构造期的链表初始化
FreeKVCacheBlockQueue 的构造与常见的“头尾哨兵”写法不同,这里用两个虚拟节点:
class FreeKVCacheBlockQueue: def __init__(self, blocks: list[KVCacheBlock]) -> None: self.num_free_blocks = len(blocks) # Initialize doubly links of consecutive blocks for i in range(self.num_free_blocks): if i > 0: blocks[i].prev_free_block = blocks[i - 1] if i < self.num_free_blocks - 1: blocks[i].next_free_block = blocks[i + 1] # Create a fake head and a tail block for the doubly linked list # to reduce branching in the code self.fake_free_list_head = KVCacheBlock(block_id=-1) self.fake_free_list_tail = KVCacheBlock(block_id=-1) if self.num_free_blocks > 0: self.fake_free_list_head.next_free_block = blocks[0] blocks[0].prev_free_block = self.fake_free_list_head self.fake_free_list_tail.prev_free_block = blocks[-1] blocks[-1].next_free_block = self.fake_free_list_tail类注释写明了两个设计动机:
- 用链表而不是
deque:需要在任意位置 O(1) 摘除(touch命中一个位于队列中间的块时)。deque的中间删除是 O(n),而 Python 层遍历几十万个节点会非常慢。 - 不分配任何 Python 对象:链表操作只改块的
prev_free_block/next_free_block属性,不建新节点。为了缩小与内置deque(C++ 实现)的性能差距,这是刻意的,代价是接口必须小心维护一致性。
哨兵节点的作用是减少分支:有了 fake head 与 fake tail,任何真实块的 prev、next 都必然非空,remove / popleft 不必为“块在头部”“块在尾部”写特判。注释强调两个哨兵永远不会被弹出,否则上述假设失效——popleft 里那条 raise RuntimeError("Invalid block found in popleft() ...") 就是该不变量被破坏时的诊断。
类注释还描述了两条顺序规则:
The queue is ordered by block ID in the beginning. When a block is allocatedand then freed, it will be appended back with the eviction order:1. The least recent used block is at the front (LRU).2. If two blocks have the same last accessed time (allocated by the same sequence), the one with more hash tokens (the tail of a block chain) is at the front.Note that we maintain this order by reversing the block order when freeblocks of a request. This operation is outside of this class.初始顺序按块号 0、1、2……递增,因此启动后前几次分配拿到的是相邻编号的块,显存访问局部性更好,调试日志也容易读。第二条规则依赖“释放时先释放尾块”,下一节展开。
队列的六个操作:出队只有一个方向
队列的接口有 popleft、popleft_n、remove、append、append_n、prepend、prepend_n,外加只读的 iter_blocks_after 与测试用的 get_all_free_blocks。
| 接口 | 语义 | 复杂度 | 调用方 |
|---|---|---|---|
popleft / popleft_n | 从队头取出 n 块 | O(n) | get_new_blocks、构造时取占位块 |
remove | 任意位置摘除一块 | O(1) | touch 命中复用 |
append / append_n | 放到队尾 | O(n) | 有哈希块释放、unpin_blocks |
prepend / prepend_n | 放到队头 | O(n) | 无哈希块释放 |
iter_blocks_after | 从游标之后按序迭代 | O(队列长度) | 特殊池按淘汰序扫描 |
popleft_n 的实现很直白:从 fake head 的 next 开始取 n 个块,逐块清空 prev/next,最后把 fake head 接到第 n+1 块上:
def popleft_n(self, n: int) -> list[KVCacheBlock]: if n == 0: return [] assert self.num_free_blocks >= n self.num_free_blocks -= n curr_block = self.fake_free_list_head.next_free_block ... ret = [] for _ in range(n): ret.append(curr_block) last_block = curr_block curr_block = curr_block.next_free_block # Reset prev_free_block and next_free_block of all popped blocks last_block.prev_free_block = None last_block.next_free_block = None if curr_block is not None: self.fake_free_list_head.next_free_block = curr_block curr_block.prev_free_block = self.fake_free_list_head return ret取出后的块指针被置为 None,这不是多余操作:remove 以 prev is None or next is None 判定非法调用,指针干净才能让“重复移除”“移除一个不在链上的块”立刻报错,而不是悄悄破坏链表。
append_n / prepend_n 分别把列表接在 fake tail 之前、fake head 之后。它们接受列表而不是单块,是因为一次释放往往是一批块;代码里没有对列表排序或去重,顺序完全由调用方给定,因此“批内顺序”是调用方的契约——下一节会看到管理器如何用 reversed 把尾块排到前面。
remove 是 touch 路径的核心:
def remove(self, block: KVCacheBlock) -> None: prev_block = block.prev_free_block next_block = block.next_free_block if prev_block is None or next_block is None: raise RuntimeError(f"remove() called on an invalid block: {block}") prev_block.next_free_block = next_block next_block.prev_free_block = prev_block block.prev_free_block = block.next_free_block = None self.num_free_blocks -= 1这里没有遍历或查找:只要块对象还挂着链指针,删除就是改两个指针。这是双向链表相对 deque 的唯一优势,也是这类“按对象摘除”的调度结构普遍采用双向链表的原因。SGLang 的前缀缓存选择 radix 树形态,vLLM 选择链表,两者的数据结构差异直接决定了命中与淘汰的实现方式。
回收顺序:LIFO 与 FIFO 为何同时存在
BlockPool.free_blocks 是理解整个池的钥匙:
def free_blocks(self, ordered_blocks: Iterable[KVCacheBlock]) -> None: blocks_to_evict_last = [] blocks_to_evict_first = [] other_pools: dict[BlockPool, list[KVCacheBlock]] = {} for block in ordered_blocks: if block.is_null: # never pooled; its ref_cnt is not maintained continue if block.pool is not None and block.pool is not self: other_pools.setdefault(block.pool, []).append(block) continue block.ref_cnt -= 1 if block.ref_cnt == 0: if block.block_hash is None or not self.enable_caching: # LIFO reuse of non-cached blocks for better GPU locality. blocks_to_evict_first.append(block) else: # FIFO reuse of cached blocks for LRU eviction behavior. blocks_to_evict_last.append(block) self.free_block_queue.prepend_n(blocks_to_evict_first) self.free_block_queue.append_n(blocks_to_evict_last) for pool, blocks in other_pools.items(): pool.free_blocks(blocks)源码注释已点明两条规则的理由,这里从性能与语义两方面展开。
无哈希块走 LIFO(放到队头)。只写了几个 token 的尾块、被 reset_hash 过的不完整块、CoW 复制产生的新块,在不满足满块条件时都不可能是前缀命中目标,下次被分配时内容一定会被覆盖。既然如此,刚释放的无哈希块应立刻被优先分配:它与请求当前活跃块表的空间距离最近,GPU 侧页表项、块表缓存的迁移代价都更低;调试时块号变化也更小,更容易追踪。
有哈希块走 FIFO(放到队尾)。已登记的块是前缀缓存候选,未来有两种命运:被同前缀请求命中并 touch,或排到队头被重新分配。要最大化命中率,应让最久未被命中的块最先淘汰,也就是 LRU。而“命中”在代码里等价于“remove 出队列、引用清零后 append 回队尾”,因此队尾顺序天然是“越晚释放或命中越靠后”,popleft 从队头取就是最古老的候选。这就是注释所说的“FIFO reuse of cached blocks for LRU eviction behavior”。
一个重要的推论:空闲队列不是单一的 LRU。它同时承载栈语义(无哈希块)与 LRU 语义(有哈希块),入队端由 block_hash is None 决定。把两者混在一个队列里是为了减少结构数量,不必维护两套队列;代价是调试时不能把“位置”理解为唯一含义。
批内顺序:为什么先释放尾块
free_blocks 只“按给定顺序”入队,真正的批内顺序由调用方决定。各管理器的 free 方法这样写:
def free(self, request_id: str) -> None: """Free the blocks for the request.""" # Free blocks in reverse order so that the tail blocks are freed first. self.block_pool.free_blocks(reversed(self.pop_blocks_for_free(request_id)))一个请求的块列表按 token 位置排列。释放时先放尾块:
- 对于无哈希块,
reversed让尾块排在 prepend 批次前面,在队头更靠前,下一步先被分配——符合“无复用价值的块优先重用”。 - 对于有哈希块,
reversed让尾块先 append,因此尾块在队尾区更靠前、更早被淘汰;头部块排在更靠后的位置,更晚被淘汰。头部的块哈希链更长(覆盖前缀更多),一旦被淘汰会损失更多潜在命中,因此应尽量保留。
用一张图表示这个批内排序:
请求 R 的块序列(逻辑顺序): B0 B1 B2 B3 B4pop_blocks_for_free 返回: B0 B1 B2 B3 B4reversed(...) 入队顺序: B4 B3 B2 B1 B0
无哈希块 -> prepend_n: [B4 B3 B2 B1 B0 ...其余空闲...] <- B4 最先被分配有哈希块 -> append_n : [...其余空闲... B4 B3 B2 B1 B0] <- B4 最先被淘汰,B0 最后淘汰这里说的“头部保留更久”是针对哈希淘汰价值的判断,不是硬编码保证:如果 B0 长期没被任何请求命中,它最终也会被挤出队头。池里没有“按前缀长度排序”的逻辑,顺序完全来自“同一请求先尾后头 + FIFO 淘汰”两条规则叠加。这也是队列注释第二条规则的实际落地方式:同一时刻释放的一批块里,哈希链短的先到队头。
多池分拣
other_pools 处理“一个调度器、多个池”的情况。V1 中不同 KV 组(MLA latent、SWA 状态、索引器缓存)可以由不同的池管理,KVCacheManager 释放一个请求时通常会把所有组的块合并成一个列表交给其中一个池。free_blocks 遍历时遇到 block.pool is not self 的块,不直接扣引用计数,而是分拣到对应池并在最后递归调用:
for pool, blocks in other_pools.items(): pool.free_blocks(blocks)为什么递归而不是让调用方多重循环?因为调用方只持有“一个池对象”的引用,块列表可能跨池;递归让每个池处理自己的块,调用方不必知道有几类池。这里有一个隐藏契约:每个块必须严格属于一个池,且 block.pool 在分配时设置正确。如果某个块被误设或加入两个池,引用计数会被重复扣减;源码只有 assert block.ref_cnt == 0 与 remove() 的非法指针检查能间接暴露问题。排查多组 KV 的“块不释放”时,应优先检查这个字段。
引用计数:入口、不变量与回收
ref_cnt 的生命周期只有几处入口:构造时为 0;get_new_blocks 分配时 +1;touch 命中复用时 +1;free_blocks 与 unpin_blocks 释放时 -1;CoW 路径额外 +1(后文展开)。get_new_blocks 的写法值得逐行看:
def get_new_blocks(self, num_blocks: int) -> list[KVCacheBlock]: if num_blocks > self.get_num_free_blocks(): raise ValueError(f"Cannot get {num_blocks} free blocks from the pool") ret: list[KVCacheBlock] = self.free_block_queue.popleft_n(num_blocks) if self._reuse_watchers: self._notify_reuse(ret) if self.enable_caching: for block in ret: self._maybe_evict_cached_block(block) assert block.ref_cnt == 0 block.ref_cnt += 1 if self.metrics_collector: self.metrics_collector.on_block_allocated(block) else: for block in ret: assert block.ref_cnt == 0 block.ref_cnt += 1 ... return ret四个关键点:
- 不查哈希表。
get_new_blocks只从队列取块,不关心内容是否与当前请求相关。前缀命中是更早的get_cached_block阶段完成的,命中块通过touch增引用,而不走分配。 - 先清哈希。
_maybe_evict_cached_block把该块所有哈希条目从哈希表删除并reset_hash;块在被重新分配的那一刻就失去了缓存身份。 assert block.ref_cnt == 0。这是池的完整性不变量:空闲队列中所有块的引用计数都必须为零。断言触发说明有代码在未释放引用的情况下把块放进了队列,通常是对free_blocks调用不当。- 不足时抛错而不是部分分配。
num_blocks > free直接抛ValueError;部分分配会破坏调用方“块预算 = token 预算”的假设,错误可能表现为注意力元数据里块表长度不对,而非显式分配失败。让它在源头失败更容易诊断。
touch 是反向操作:
def touch(self, blocks: Sequence[KVCacheBlock]) -> None: for block in blocks: if block.is_null: continue # ref_cnt=0 means this block is in the free list (i.e. eviction # candidate), so remove it. if block.ref_cnt == 0: self.free_block_queue.remove(block) block.ref_cnt += 1 if self.metrics_collector: self.metrics_collector.on_block_accessed(block)if block.ref_cnt == 0 是把块拉出队列的唯一判断:引用为 0 意味着它在队列里作为淘汰候选;引用大于 0 的块被活跃请求持有,本来就不在队列中。remove 同时维护 num_free_blocks,因此空闲统计与使用率不必单独计数。
池的两条核心不变量可以写成:
(1) free_block_queue 中的块 <=> ref_cnt == 0(占位块除外)(2) 块对象一经创建,block_id 不变;块被重新分配时哈希必然先被清除占位块是第一条的例外:它在构造时被 popleft 出来,ref_cnt 恒为 0 且永不维护,因此 touch 与 free_blocks 都显式跳过 is_null。第二条保证了块表在 worker 侧可以只追加——已被分配出去的块号不会变,变的只是它被谁持有。
分配时的“最后一次读”回调
get_new_blocks 取出块后先调用 _notify_reuse:
def _notify_reuse(self, blocks: Iterable[KVCacheBlock]) -> None: for block in blocks: watcher = self._reuse_watchers.pop(block.block_id, None) if watcher is not None: watcher(block)这段逻辑专门服务于 unpin_blocks 注册的“复用回调”:块被 unpin 后进入队列,但仍可能在 CPU 侧或 NIC 侧被读取;当它真正被分配出去的那一刻,回调被触发,调用方可以停止读取。把回调放在 get_new_blocks 开头、早于清哈希和加引用,是因为“读出”和“覆盖写”发生在同一个调度步,回调需要尽早发出停止信号,避免传输还在进行时 GPU 前向已经写入。这是“释放但保留可读”语义的实现核心。
unpin_blocks:被释放但还能读的块
绝大多数释放走 free_blocks,有一类特殊场景走 unpin_blocks:
def unpin_blocks( self, blocks: Iterable[KVCacheBlock], on_reuse: Callable[[KVCacheBlock], None],) -> None: """Release references to blocks that stay readable until reused.
The blocks become last-resort eviction candidates regardless of prefix caching: they join the tail of the free queue and count as free. ``on_reuse`` fires when ``get_new_blocks`` hands a block out (or the cache is reset), so the caller can stop reading it. """ released: list[KVCacheBlock] = [] for block in blocks: assert block.ref_cnt > 0 and not block.is_null block.ref_cnt -= 1 self._reuse_watchers[block.block_id] = on_reuse if block.ref_cnt == 0: released.append(block) self.free_block_queue.append_n(released)三个要点:
- 无论是否开启前缀缓存,都放队尾。
unpin的块不是缓存候选,而是“最后才考虑淘汰”的块:排在队尾意味着它们要等所有有哈希候选与无哈希块都被分配完后才轮到。 - 注册
on_reuse回调。每个块只保留一个回调(字典按block_id存储,后注册覆盖先注册)。这要求调用方保证同一块同一时刻只有一份在途读取;若两个传输并发读同一块,后一个回调覆盖前一个,前者不会收到停止信号。 - 回调在块被真正取出时触发。注册发生在
ref_cnt减到 0 之前,触发发生在块被重新分配或缓存被重置时;pop保证每个回调只触发一次。
这个接口的真实用途是 KV connector 的 D2H 拷贝与跨实例传输:读写方在 CPU/NIC 侧还有在途操作,若按普通 free_blocks 放进队头,下一步调度可能立刻把它重新分配并写入,传输中的内容就被覆盖;unpin_blocks 把它放到队尾,并把“传输完成”的时间点精确传递到复用的那一刻。reset_prefix_cache 里也有一处 _notify_reuse,用来在强制重置缓存时告知所有挂着的 watcher 其块将被复用。
unpin_blocks 只做 -1 再入队,不参与 LIFO/FIFO 分拣——这是它与 free_blocks 最本质的区别。两者合起来覆盖“释放并立即重用”(普通路径)与“释放但延迟可读”(异步路径)两类语义。
前缀哈希表:多条目、不去重与淘汰
前缀缓存的整体形态可以用 vLLM 官方文档的这张图概括:多个请求的前缀共享同一批物理块,命中时不需要重新计算 KV,只需要把请求的块表指向已存在的块。
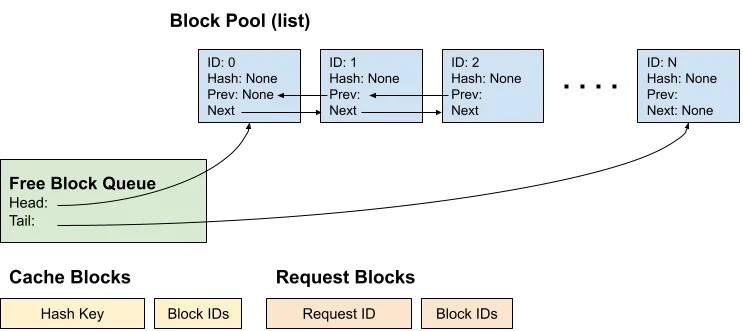
图中每个请求的逻辑块表指向同一批物理块;共享部分的块引用计数大于 1,任何一个请求结束时都不会真正释放它们,只有最后一个持有者离开后,块才回到空闲队列并进入 LRU 候选区。这张图里没有出现池的内部结构,但共享得以成立的两个前提——哈希相等与引用计数正确——都由 BlockPool 保证。
BlockHashToBlockMap 的结构技巧
哈希到块的映射由 BlockHashToBlockMap 实现:
self._cache: dict[BlockHashWithGroupId, KVCacheBlock | dict[int, KVCacheBlock]] = {}键只对应一个块时,值就是 KVCacheBlock;出现相同键的多个块时,值升格为 dict[int, KVCacheBlock]。类注释指出这个 union 是为了减少内层字典带来的 GC 开销——绝大多数键只有一个块,没必要为每个键都建字典。get_one_block 在重复时返回“任意一个”,因为重复块内容相同,谁被命中都等价。
注释同时给出了一个反直觉的设计——不做去重:
NOTE #1: We currently don't de-duplicate the blocks in the cache,meaning that if a block becomes full and is cached, we don't checkif there is already an identical block in the cache. This is becausewe want to make sure the allocated block IDs won't change so thatblock tables are append-only.如果新请求的块与缓存中已有块内容相同,去重意味着把块表里这一格改为指向旧块,块表中段随之变化。vLLM worker 侧的块表对运行请求只追加,每步调度器生成的是追加列表而不是完整重建;中段变化会打乱增量更新与 CUDA Graph 的输入布局。用多占一块显存换块表严格追加,是简单得多的工程选择。这一取舍与站内 KV Cache 的页粒度:128 token 一块的账,以及五个推理框架为什么选了五个不同答案 中讨论的“块表追加性 vs 内部碎片”是同一类账。
多条目:一个块为什么可以挂多个哈希
_remove_cached_block_hashes 负责把块上全部哈希找出并删除:
def _remove_cached_block_hashes(self, block: KVCacheBlock) -> list[BlockHashWithGroupId]: block_hashes: list[BlockHashWithGroupId] = [] if block.block_hash is not None: block_hashes.append(block.block_hash) block_hashes.extend(self.cached_block_hashes_by_block.pop(block.block_id, ())) if not block_hashes: return [] removed_hashes: list[BlockHashWithGroupId] = [] for block_hash in block_hashes: if self.cached_block_hash_to_block.pop(block_hash, block.block_id) is not None: removed_hashes.append(block_hash) block.reset_hash() return removed_hashes主哈希来自 block.block_hash,额外哈希来自 cached_block_hashes_by_block。一个块可能挂多个哈希的原因有四类:
- 部分块晋升到满块。
cache_partial_block先在“写了一半”的边界登记哈希;块随后写满,主哈希变成满块边界,旧的部分条目需要先作废。cache_full_blocks里有一条专门的断言:如果“新的满块”已经有哈希,只可能是同一个块从部分条目晋升为满块,那么block_hash_num_tokens必然小于新长度。 - 混合注意力模型的 SWA 组。滑动窗口组的命中查找只看窗口可达的块,窗口外的块即便被缓存也永远不会命中;
cache_full_blocks用block_mask把这些块排除,避免哈希表积累无用条目。 - 不同
hash_block_size的组。不同 KV 组的块大小可能不同,一个组块实际大小可能是哈希块大小的倍数,因此同一组块会对应多个哈希边界。 move_block_hashes的 CoW 迁移(后文详述)。当请求必须继续原地写一个已被前缀登记的块时,缓存条目被迁移到私有副本,源块保持原主哈希,副本获得新条目。
_maybe_evict_cached_block 是“块被重新分配时清哈希”的核心:
def _maybe_evict_cached_block(self, block: KVCacheBlock) -> bool: if self.metrics_collector: self.metrics_collector.on_block_evicted(block) evicted_hashes = self._remove_cached_block_hashes(block) if not evicted_hashes: # The block doesn't have hash, eviction is not needed return False self._emit_block_removed_events(evicted_hashes) return True返回 True 表示这块确实有哈希并被淘汰,False 表示本来没哈希。get_new_blocks 不使用返回值(它总要先清哈希),但 evict_blocks 会用到:后者是 KV connector 上报某个块已从远端失效时调用的接口,它不释放块,只把哈希条目抹掉;False 说明该块本来就不是缓存条目。
evict_blocks 还有一条断言:
assert block_id < len(self.blocks), ( f"Invalid block_id {block_id} >= {len(self.blocks)}. " "This indicates a bug in the KV connector - workers should " "only report block IDs that were allocated by the scheduler.")远端连接器上报的块号必须是调度器分配过的;越界说明连接器的块号映射与本地不一致,这类问题不能靠“忽略越界”掩盖,否则会误删别的块。
BlockStored / BlockRemoved 事件
池负责生成 KV 缓存事件:cache_full_blocks 生成 BlockStored,携带块哈希、父块哈希、token 范围、LoRA 信息与 extra_keys;_maybe_evict_cached_block 生成 BlockRemoved;reset_prefix_cache 生成 AllBlocksCleared。
事件系统服务于前缀缓存卸载器与外部 KV 存储:GPU↔CPU 分层缓存需要知道“哪些块刚写满、可以导出”“哪些块要被淘汰、先别导出”“整套缓存何时被清空”。extra_keys 是哈希之外的附加信息,如多模态特征位置、cache_salt(按租户隔离前缀缓存)。这些信息不在 token 序列里,却在语义上决定“这段前缀是否相同”,因此哈希键与事件都要带上。
命中、写时复制与部分块
get_cached_block 的“全有或全无”
前缀命中在池里的入口是 get_cached_block:
def get_cached_block(self, block_hash, kv_cache_group_ids): cached_blocks = [] for group_id in kv_cache_group_ids: block_hash_with_group_id = make_block_hash_with_group_id(block_hash, group_id) block = self.cached_block_hash_to_block.get_one_block(block_hash_with_group_id) if not block: return None cached_blocks.append(block) return cached_blocks它要求所有组对同一个块哈希都能命中,否则返回 None。在混合模型里这是必要的:普通 KV 组命中而 SWA 组没命中,拿到的只是“半套状态”,注意力 kernel 读到的状态与序列并不一致。这与站内 前缀缓存命中之后:五个推理框架如何把一段旧 KV 接进一次新前向 讨论的“命中后重算位置、补齐元数据”是同一层面的问题:命中判断必须在“完整状态”的粒度上做。
find_longest_cache_hit 在 SingleTypeKVCacheManager 子类中实现,逐块调用 get_cached_block;FullAttentionManager 沿块链从前往后找,SlidingWindowManager 从窗口开始找,MambaManager 找状态块。池本身不参与“找最长命中”的策略,只提供“某哈希能否命中”的原语——这正是“策略在管理器、机制在池”的分工。
部分块与 cache_partial_block
cache_full_blocks 只登记写满的块。它从 num_cached_blocks 到 num_full_blocks 逐块登记,每个块的哈希覆盖的前缀长度是:
num_hash_tokens = (num_cached_blocks + i + 1) * block_size(i + 1) 的偏移意味着第 i 个满块的哈希覆盖前 i+1 个块长度,每一级哈希都包含之前所有 token 的影响,前缀链天然成立。
cache_partial_block 是较新的扩展,允许一个未满块对应一个前缀边界:
def cache_partial_block(self, request, block, num_tokens, kv_cache_group_id, block_size, replace_existing_hashes=False): if block.is_null: return None assert block_size % self.hash_block_size == 0 block_hash = self._get_partial_block_hash(request, num_tokens) num_hash_blocks = num_tokens // self.hash_block_size ...它服务的场景是“写了一半就被别的请求命中”。比如请求 A 写入若干 token 后暂时结束,之后请求 B 的前缀与 A 相同但更短;若只登记满块,B 会整体未命中;若 A 的最后一个块被登记了部分哈希,B 就能命中,只需把剩余部分算完。代价是块上可能挂多个边界,调度器需要记录每个命中块对应的逻辑块数,num_computed_tokens 的计算要使用这部分信息。
部分命中带来的直接后果是写时复制(copy-on-write,CoW):命中的最后一个块仍可能被继续写入,而它同时是另一个请求的缓存前缀。is_block_writable 的 block_hash is None 条件在这里起关键作用:命中块哈希不为空,不能被原地写,必须复制出私有块。
move_block_hashes:缓存条目如何搬到私有副本
move_block_hashes 的 docstring 写得很清楚:
def move_block_hashes(self, src_block: KVCacheBlock, dst_block: KVCacheBlock) -> None: """Re-point ``src_block``'s prefix-cache entries to ``dst_block``.
Used when the request owning ``src_block`` keeps writing into it : the prefix cache holds a private copy (``dst_block``) under the same hashes instead. Entries stay live; no events emitted. """ assert dst_block.block_hash is None assert dst_block.block_id not in self.cached_block_hashes_by_block num_tokens = src_block.block_hash_num_tokens for block_hash in self._remove_cached_block_hashes(src_block): # `num_tokens` only applies to the first (primary) insertion. self._insert_block_hash(block_hash, dst_block, num_tokens=num_tokens)它一次“搬运引用”,而不是一次“删除再重建”:哈希条目的值从源块改成目标块,条目本身始终存活,因此命中不会在这中间出现空洞,也不产生 BlockRemoved 事件。调用点位于运行请求的续写路径:
if partial_hit is not None: block_idx, source_block = partial_hit cow_block = new_blocks[0] new_blocks = new_blocks[1:] if blocks_allocated: # The worker block table of a running request is append-only, so the # request must stay on source_block. Move the cache entry to cow_block # instead; the queued copy fills it before forward overwrites source_block. assert req_blocks[block_idx] is source_block self.block_pool.move_block_hashes(source_block, cow_block) self._pending_cow_copies.append((source_block, cow_block)) source_block.ref_cnt += 1这里同时满足两个约束:worker 块表只追加,所以请求继续使用 source_block;缓存身份搬到 cow_block,worker 在前向写 source_block 之前先把内容复制到 cow_block。池在调度器侧先把两块的引用计数安排妥当——source_block 由请求继续持有,额外 +1 给正在读取它的缓存条目;cow_block 作为缓存持有人。如果复制完成前 source_block 就被回收,写入会覆盖缓存内容,这是此类路径最容易出错的点。
另一种情形是“请求尚未开始运行”的部分命中,此时 _apply_cow 直接把请求块表的那一格替换为私有副本,并对两个端点各加一份引用:
def _apply_cow(self, request_id, block_idx, source_block, cow_block) -> None: req_blocks = self.req_to_blocks[request_id] assert req_blocks[block_idx] is source_block assert not source_block.is_null and source_block.ref_cnt > 0 req_blocks[block_idx] = cow_block self._pending_cow_copies.append((source_block, cow_block)) cow_block.ref_cnt += 1两种 CoW 路径的共同点是:块表怎么指向是调度器的事,引用计数怎么记账是池的事。池不判断路径,只保证“复制两个端点都保持存活,直到复制完成后各自的持有者释放”。
与 KVCacheManager 的接口边界
vLLM V1 的前缀缓存总体结构可以对照官方博客的示意图来读:调度器侧持有哈希表与块池,worker 侧只持有块表与实际的 KV 张量。
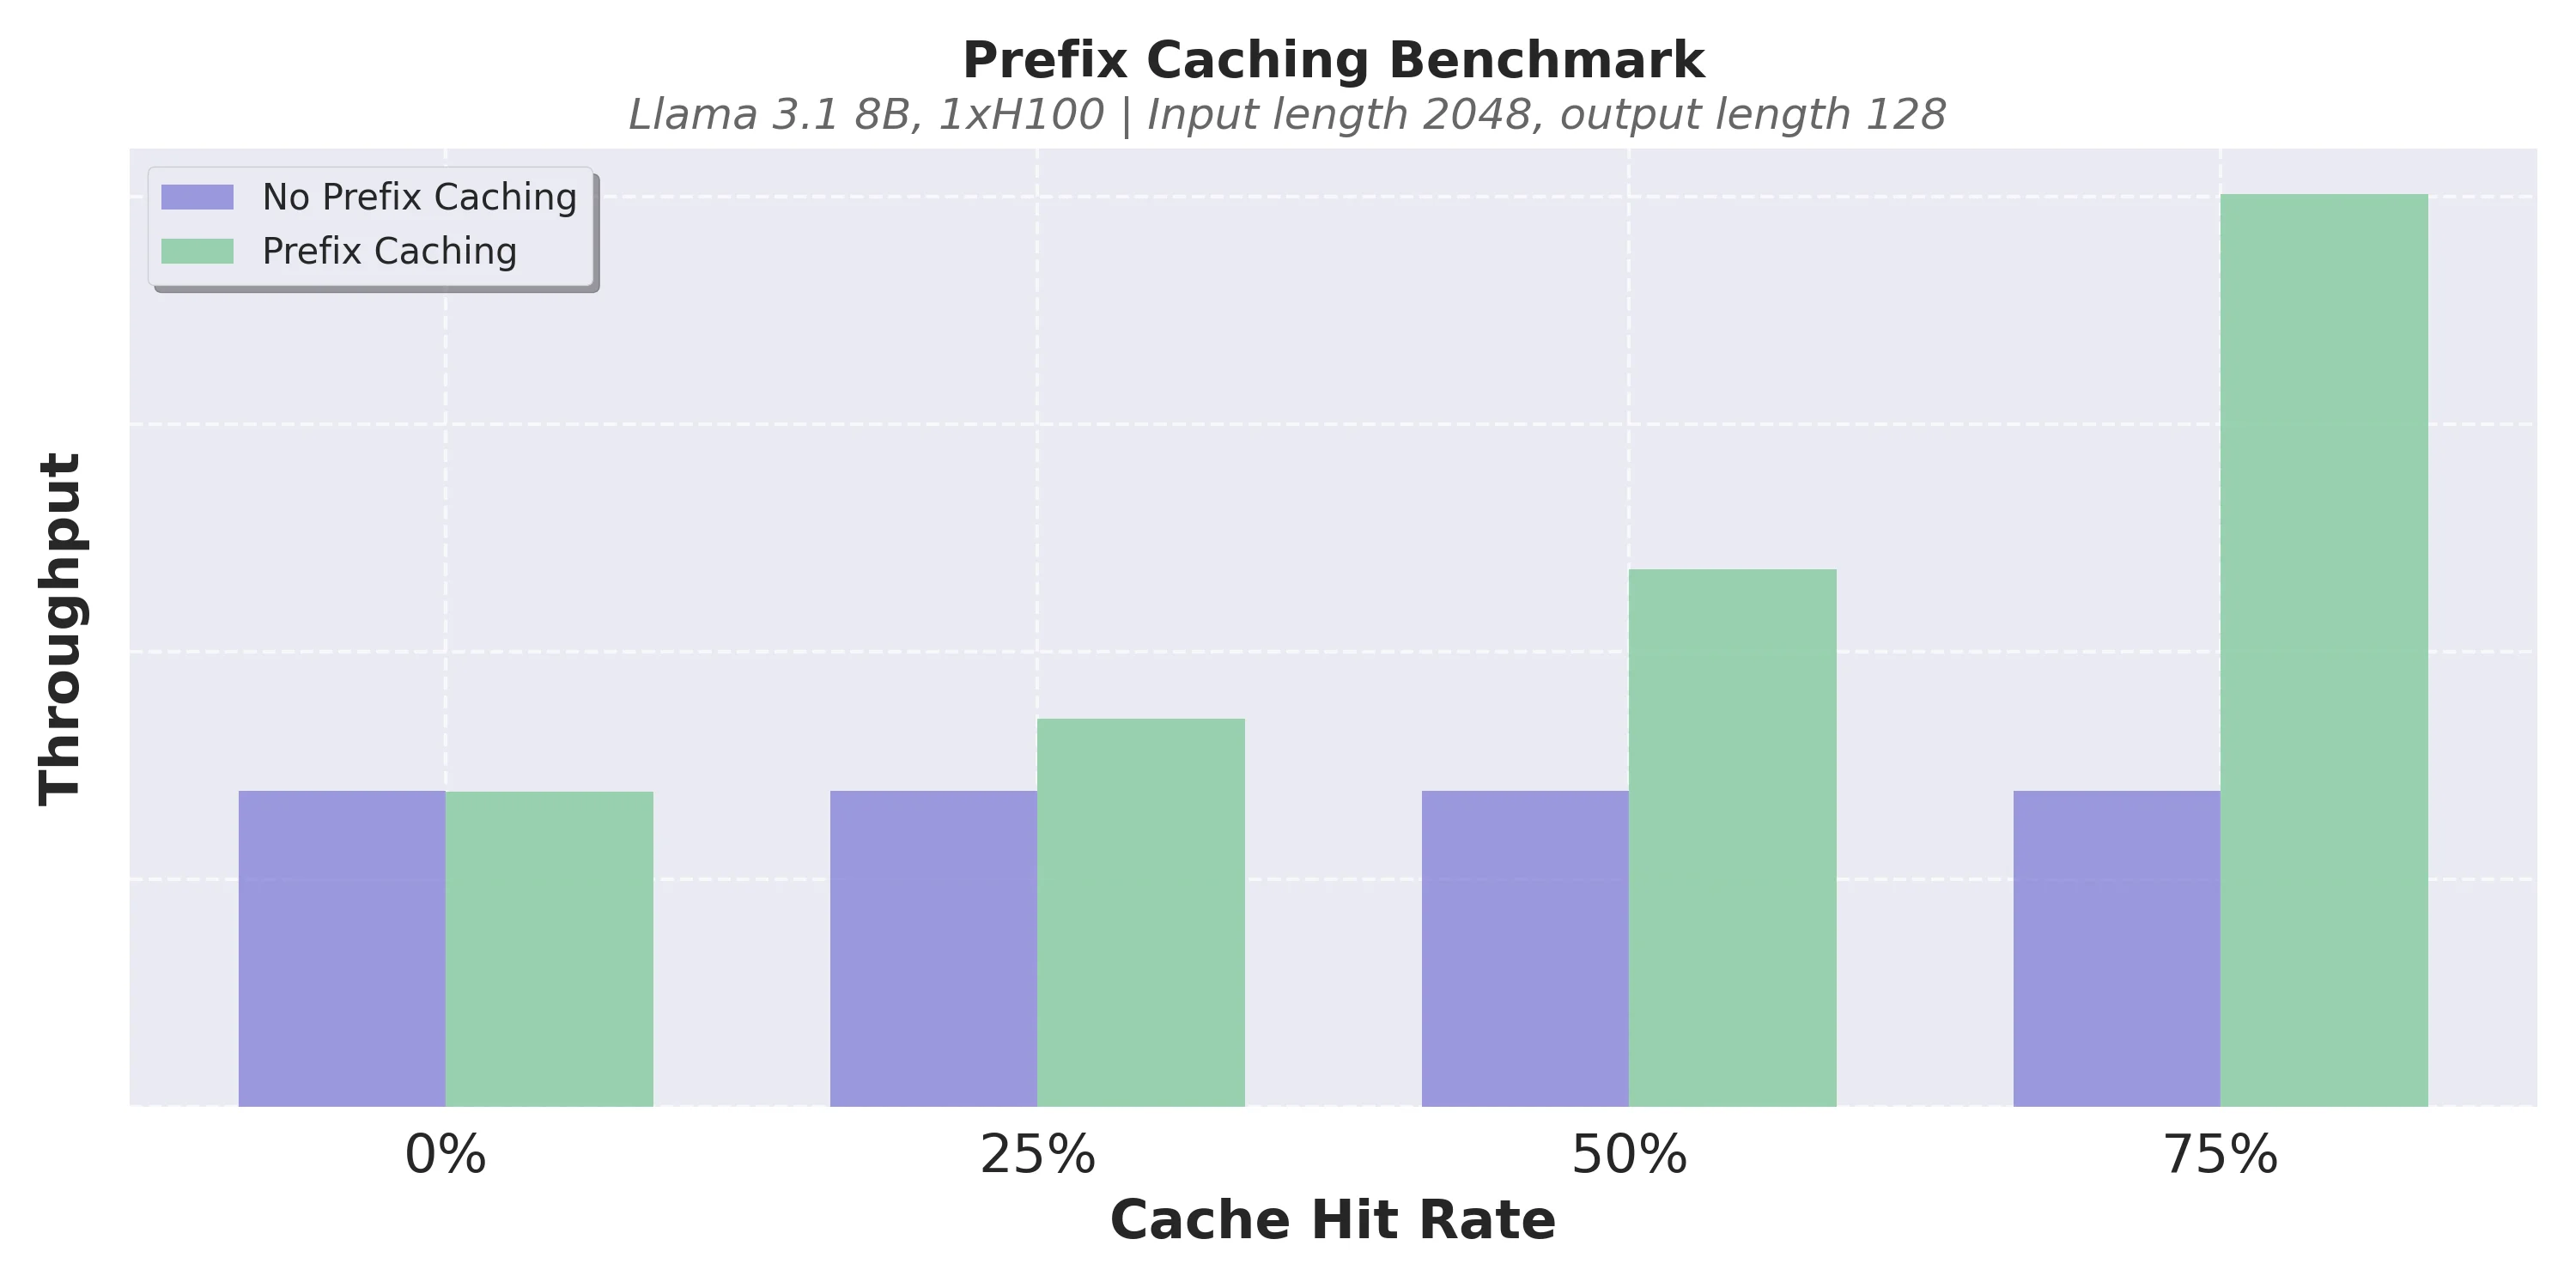
图中“调度器侧”的哈希表就是本篇讨论的 cached_block_hash_to_block,块池就是 BlockPool;worker 侧拿到的只是每步调度生成的块表与槽位映射。BlockPool 的所有状态都在调度器进程里,worker 侧没有副本,因此池的引用计数与哈希条目是全局唯一事实来源。这也是为什么所有 KV 事件都从池发出,而不是从 worker 发出。
典型调用点:
# 分配新块num_required_blocks = cdiv(num_tokens, self.block_size)num_new_blocks = num_required_blocks - len(req_blocks)if num_new_blocks > 0: new_blocks = self.block_pool.get_new_blocks(num_new_blocks)
# 释放self.block_pool.free_blocks(reversed(self.pop_blocks_for_free(request_id)))
# 命中前查询if cached_block := block_pool.get_cached_block(block_hash, kv_cache_group_ids): ...
# 写满后登记self.block_pool.cache_full_blocks( request=request, blocks=self.req_to_blocks[request.request_id], num_cached_blocks=num_cached_blocks, num_full_blocks=num_full_blocks, block_size=self.block_size, kv_cache_group_id=self.kv_cache_group_id, block_mask=block_mask,)源码中有一处调度顺序要求值得记录:
Must run only after every group's local blocks have been touched via`add_local_computed_blocks`, so this group's `get_new_blocks` cannotevict another group's cache-hit blocks.原因是 get_new_blocks 会淘汰缓存候选。如果某一组先分配新块,它可能把另一个组的缓存命中块挤出队列,导致同一请求在混合模型里“一组命中、一组未命中”。强制“先 touch 所有本地命中、再分配外部块”的顺序,是为了让命中的块先被拉出淘汰区。这类跨组顺序约束正是多池结构下最容易踩的坑。站内 GLM-5.3 推理全链路(九):混批——一条 8K 预填请求并进 32 条解码请求之后 里对“混批时块数与 token 预算如何对齐”的分析,也依赖同一套池语义。
get_num_free_blocks 是调度器判断“还能不能再来一个请求”的唯一依据:
def get_num_free_blocks(self) -> int: return self.free_block_queue.num_free_blocks它是维护好的计数器而非遍历长度——每次出队、入队、移除都同步更新,O(1) 读取。
三个子管理器在池上的特殊用法
环形缓冲:每请求一块
class CircularBufferManager(FullAttentionManager): """Claims the ring's single block per request; prefix caching disabled.""" supports_fine_grained_hash_lookup: ClassVar[bool] = False
def _claim_ring_block(self, request_id: str, record_for_zeroing: bool = True) -> list[KVCacheBlock]: req_blocks = self.req_to_blocks[request_id] if req_blocks: return [] new_blocks = self.block_pool.get_new_blocks(1) req_blocks.extend(new_blocks) return new_blocks池在这一用法上没有任何特殊分支:它不关心块如何被“循环使用”,只负责发块与回收。环形语义(每步覆盖块内某一列)由注意力内核负责。“环形”也意味着池不必为每步分配新块,长时间运行不产生碎片。
滑动窗口与块掩码
滑动窗口组的块表在窗口之前大量使用占位块:
computed.extend([block_pool.null_block] * block_idx)这些占位块在块表里充当“这个逻辑位置没有数据”,池不需要为它们发块——这就是占位块存在的意义:在不分配真实显存的情况下维持块表与序列位置的对应关系。cache_full_blocks 对这类组的 block_mask 决定哪些块进入哈希表:窗口外的块即使被写满也不会被命中,不应占据缓存条目。
Mamba 状态与检查点
MambaManager 会给状态块登记哈希,并定期把“检查点”块从缓存中淘汰:
self.block_pool._maybe_evict_cached_block(checkpoint_block)return self.block_pool.cache_partial_block(...)Mamba 的状态不是按 token 逐列增长的,而是“每块对应一个状态快照”;可以从前缀重启的边界比普通注意力更少,因此它会挑选少量检查点保留在哈希表里,其余状态块即便写满也不登记。这再次体现了池的通用性:它只提供“登记/淘汰某个块”的原语,具体登记哪些块由管理器按模型语义决定。
哈希是怎么算出来的:前缀链、组 id 与 salt
池里所有淘汰与命中判断都建立在“块哈希”之上,而哈希本身在 kv_cache_utils.py 中计算。理解它的构造方式,才能理解 get_cached_block 为什么按组查询、以及 extra_keys 为什么会进入哈希。
链式哈希:父哈希 + 本块 token + 附加键
def hash_block_tokens( hash_function: Callable[[Any], bytes], parent_block_hash: BlockHash | None, curr_block_token_ids: Sequence[int], extra_keys: tuple[Any, ...] | None = None,) -> BlockHash: if not parent_block_hash: parent_block_hash = NONE_HASH curr_block_token_ids_tuple = tuple(curr_block_token_ids) return BlockHash( hash_function((parent_block_hash, curr_block_token_ids_tuple, extra_keys)) )这是前缀缓存能正确工作的根本原因:一个块的哈希包含了父块哈希,而父块哈希又包含它自己的父块,依此类推直到序列起点。因此“同一个块哈希”在语义上等价于“从序列开头到该块结尾完全相同的前缀”。不同前缀只要有一个 token 不同,后面所有块的哈希都会不同,不会出现“块内容巧合相同但前缀不同”的误命中——这一点单看块内 token 无法保证。
哈希元组里还有 extra_keys。它承载 token 序列之外的语义信息:
- 多模态特征:图像、音频经编码器后产出的向量。两个请求的 token 序列可能完全相同,但图片内容不同,前缀并不相同,必须让特征参与哈希计算。
- LoRA 适配器:同一个基础模型挂不同 LoRA 时,同一段 token 产生的 KV 不同,不能跨适配器共享。
cache_salt:按租户或会话隔离前缀缓存。即便 token 完全一样,只要 salt 不同就视为不同前缀,防止不同租户通过命中时间侧信道推断对方的 prompt。
NONE_HASH 是“第一个块的父哈希”,来自一个种子。注释说明了种子的选择逻辑:加密哈希(如 SHA-256)使用固定默认种子,使独立进程对相同内容算出相同哈希,从而支持跨节点共享前缀缓存;非加密哈希(xxhash 等)在未设置 PYTHONHASHSEED 时使用随机种子,因为碰撞抗性依赖种子保密。这解释了一个常见的运维困惑:换一个实例就命中不了别的实例的缓存,不一定是配置错,可能是哈希算法选了非加密版本且没有统一种子。
hash_block_tokens 用 LRU 缓存避免对相同块内容重复计算。在长提示的 prefill 中,每个块只算一次哈希,总成本与提示长度成正比,与注意力计算相比可以忽略。
组 id 从哪里来、hash_block_size 与 block_size 的差异
哈希键实际上是 BlockHashWithGroupId:
def get_block_hash(key: BlockHashWithGroupId) -> BlockHash: return BlockHash(key[:-4])
def get_group_id(key: BlockHashWithGroupId) -> int: return int.from_bytes(key[-4:], "big", signed=False)末尾 4 字节是组 id。这意味着一个多组模型(普通 KV、SWA、Mamba 状态)里,同一个前缀在每个组里各有一个独立条目,组之间的哈希表互不干扰。这也是 get_cached_block 要求所有组都命中的结构基础:只有每组都找到了同一前缀对应的块,才能拼成一致的状态。
第二个差异是 hash_block_size 与 block_size。resolve_block_hashes 处理两者不一致的情况:
if block_size == hash_block_size: return block_hashes...assert block_size % hash_block_size == 0return BlockHashListWithBlockSize(block_hashes, hash_block_size, block_size)调度器可能以更粗的粒度(block_size)分配块,而哈希以更细的粒度计算:若组块是哈希块的倍数,一个组块对应多个哈希边界,BlockHashListWithBlockSize 提供一个“按 block_size 视角”的迭代器。池不直接处理这种映射,它只接收“本次要登记哪个边界”的请求;cache_full_blocks 收到的 block_size 与 hash_block_size 的约定,决定了哈希键的边界粒度。
resolve_block_hashes 还有一条“细粒度部分命中”分支:当组声明 supports_fine_grained_hash_lookup 且 alignment_tokens < block_size 时,保留原始哈希而不是折叠到大块粒度。这对应 cache_partial_block 的使用场景——部分命中需要一个落在组块内部的哈希边界。CircularBufferManager 显式把该标志设为 False,说明它的缓存不做部分命中。
理解了这一层,再回到池:池的哈希表只是“按 (哈希, 组) 查询块”的索引,哈希如何算、边界多大、附加键是什么,全部由上层决定。这再一次印证“机制在池、策略与管理在管理器”。
工程上的坑与排查建议
- KV Cache usage 接近 1.0,但请求很快完成。先看是否有大量有哈希块停留在空闲队列。它们计为“已用”,
get_usage只按队列长度计算。这是 LRU 组的预期行为;若持续逼近上限,说明缓存候选过多、新请求挤不进来。 - 前缀命中率低于预期。检查
hash_block_size与block_size是否一致,cache_partial_block是否启用,SWA 组的block_mask是否排除过多块,以及num_hash_lookahead_tokens是否让边界变粗。 - 多组 KV 命中率异常。
get_cached_block要求所有组命中;任何一个组缺少同一块哈希都会整体 miss。同时检查allocate_external_computed_tokens的调用顺序是否违反“先touch后分配”。 reset_prefix_cache返回False。检查是否有请求未释放,或unpin_blocks注册的 watcher 仍存在。占位块永远“在用”,num_used_blocks至少为 1 才能重置。- KV connector 上报块号时报错。
evict_blocks的block_id < len(self.blocks)断言说明 worker 上报了调度器从未分配过的块号,通常是远端连接器的块号映射没对齐。 - 块数账对不上。多池场景下
block.pool设错或同一块被两个池释放,会造成引用计数重复扣减。排查时对每个块打印(block_id, ref_cnt, block_hash, pool),核对free_block_queue里每块ref_cnt == 0。 - 异步传输后内容被覆盖。检查是否误用了
free_blocks而非unpin_blocks:前者放队头,可能在同一调度步被重新分配;后者放队尾并注册回调。 - 块表在运行请求中被“改写”。这违反只追加不变量,常见于部分命中路径误用
_apply_cow之外的方式改块表,正确做法是move_block_hashes搬运哈希而非改块表。
小结
BlockPool 并不起眼,但没有它,KVCacheManager 的策略只能悬浮在数字上。它把“物理块”变成一个可借、可还、可共享、可淘汰、可上报事件的对象,用少量字段和一条双向链表把全部状态收进可推理的范围。几条最重要、也最容易被误解的决定:
- 空闲队列同时承载 LIFO 与 LRU 两种语义。无哈希块走栈语义(放队头,立即重用,利于局部性);有哈希块走 LRU 淘汰(放队尾,越久未命中越早淘汰,利于前缀命中)。位置不代表唯一含义。
- 引用计数是“能否被分配”的唯一依据。共享、命中、异步传输都通过引用计数表达;
unpin_blocks把“逻辑释放但保留可读”编码为引用计数与回调的组合。 - 哈希表不做去重,块可以挂多条目。前者保证块表严格追加;后者让部分块、组间块大小差异与 CoW 都能在一个哈希空间里正确表示。
- 策略在管理器、机制在池。找最长命中、决定分配多少、何时抢占由
KVCacheManager做;池只提供get_new_blocks、touch、free_blocks、cache_full_blocks、get_cached_block这些原子操作。
弄清这些机制后,再看调度器的抢占、前缀命中与混批,许多“块为什么没释放”“命中为什么少一块”的问题会变得有迹可循:它们大多不是内核问题,而是池里的状态与引用计数没有按约定流转。
下一篇讨论 KVCacheManager 在多组模型(MLA latent、SWA、DSA 索引器)之间做协同分配时,如何在“全有或全无”命中之外,用每组独立的块预算与掩码把池的原子操作拼成一个完整调度步。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



