


请求的取消与抢占:五个推理框架为什么在同一个「停」字上,走出五条不同的回收路径
推理服务里最容易被当成”胶水代码”的,是停止这条路径。请求开始很容易讲清楚:分词、排队、拼接成 batch、跑一次前向、采样出一个 token。但它怎么”不再跑了”,却牵扯到五个彼此独立的账本:
- 调度器里这条请求待在哪个队列(等待、运行、在途、暂停、分片传输中);
- KV 缓存池里它名下的块什么时候能还回去,还没还回去之前会不会被别人的前向读到;
- 采样器与输出处理器里,还有几个 token 已经算出来但还没交付,交付之前请求被撤了算不算”越权”;
- 在多卡、P/D 分离、投机解码里,一个”停”字要跨几个进程、跨几条通信链路;
- 在流式接口里,客户端断连这件事本身要以多大延迟被感知。
这五本账任何一本记错,结果都不是”少生成几个字”这么温和:轻则显存泄漏出 OOM,重则新请求分到了旧请求的块、读到了别人的残缺 KV,输出开始出现莫名其妙的串话。生产环境里 Request id ... preempted 之后吞吐突然掉一截、KV cache pool is full. Retract requests 之后首 token 延迟暴涨、客户端断连之后 GPU 利用率持续走低,多半都能追到这条路径上的某个记账漏洞。
本文做一次跨框架的横向拆解,对象是 vLLM、SGLang、llama.cpp、TensorRT-LLM 与 DeepInfer 五个推理框架。每个框架的单独源码拆解在站内都有专篇,这里不再逐行讲一遍;这篇聚焦的是它们各自解决的同一个问题:一次”停”发生之后,如何既保证正确性(不读到脏 KV、不重复交付、不多消耗),又把代价压到最低(少停顿、少重算、少延迟)。
贯穿全文的是一条简单的分解:停止通知 → 在途输出处理 → KV 块回收 → 状态与内存交接。五个框架在这四步上各自做了不同的取舍,取舍的背后是不同的架构约束:vLLM 前段与核心进程分离、SGLang 有重叠调度和分片预填充、llama.cpp 是单进程共享 context 的 slot 机器、TensorRT-LLM 有 C++ 调度层与 P/D 分离、DeepInfer 有延后一拍处理(ZOS)与上下文并行。
先把”停”拆成四种语义
讨论之前得先说清楚,“停”并不是一件事。
其一,客户端主动取消。用户在流式对话里按了停止按钮,或者关掉了网页,HTTP 连接断开。服务端应当尽快停止这条请求,已经吐出去的内容不再撤回。
其二,资源驱动的抢占。这不是任何一方想停,而是 KV 池满了、新请求排不进来。调度器要挑一条正在 decode 的请求腾位置。被挑中的请求通常并不”结束”,而是被退回等待队列,之后要么重算,要么恢复。
其三,系统判定的终止。max_tokens 用完、命中 EOS、命中 stop string、命中结构化输出的终止符。这类”停”是正常路径,应当走与完成相同的记账。
其四,异常终止。请求本身坏了(例如图像损坏导致多模态处理失败)、传输超时、worker 出错。这类”停”既要释放资源,又要给客户端一个明确的错误原因。
四种语义在接口层的区别只是 finish_reason 的不同字段,但在调度器内部,它们的执行位置、时机、是否允许浪费一个 step、KV 块是否要落盘备份、是否需要重算,全都不一样。五个框架最大的分歧,恰恰在于它们把这些语义合并到什么程度。合并得越彻底,代码越短,但取消延迟越高、抢占代价越大;拆得越细,路径越多,但每一种停都能按最低代价执行。
| 语义 | 触发位置 | 典型代价 | 是否重算 |
|---|---|---|---|
| 客户端取消 | 前端 HTTP 层、调度器 | 1 个 step 的在途输出 | 否(直接丢弃) |
| 资源抢占 | 调度器内部、KV 池不足时 | 被抢占者的前缀重算 | 是(或从备份恢复) |
| 系统终止 | 采样器、停止条件检查 | 无 | 否 |
| 异常终止 | 各层都可能 | 视层级而定 | 否 |
下文的讨论会反复回到这张表:看每个框架把某个语义落在了哪一行。
在途输出:为什么”已经算出来但没交付”是麻烦的根源
任何流水化的推理系统,都会出现”计算已经发生,结果还没交付”的状态。在最简单的实现里,“计算”与”交付”是同步的:算出一个 token,立刻返回给用户,再算下一个。只要把计算放进异步、重叠或者延后一拍的流水线,“已算未交付”就出现了。
DeepInfer 的 DeferredRelease 把这个状态说得最明白:每一步的输出对象由对象池管理,调用方读完之前不能归还;回收动作被”延后一轮”,在下一步的 pre_sampler_sync 时才真正释放,从而与 GPU 计算重叠。
class DeferredRelease: """延后一轮释放 step 产出的资源,保证调用方读完。
回收(collect)要释放的资源;在下一次的 pre_sampler_sync 时释放(release),与 GPU 计算 overlap。 """
def collect_request_outputs(self, request_outputs: np.ndarray[np.uint64]) -> None: self.request_outputs_to_release = np.concatenate( [self.request_outputs_to_release, request_outputs] )
def release(self) -> None: """在 pre_sampler_sync 调用,释放资源""" ... self.request_output_pool.release(self.request_outputs_to_release) self.request_outputs_to_release = np.empty(0, dtype=np.uint64) ...这段注释背后是 ZOS(零开销调度)的结构约束:调度器在这一拍下发的是”上一拍”的输出所对应的请求状态,所以上一拍的对象还必须活着。站内有一篇专文拆过这套延迟一拍的编排与 seqlens 修正,可以参考 DeepInfer 源码完全拆解(二):异步调度与零开销调度 ZOS。
一旦”已算未交付”成为常态,取消请求时就会冒出几个本来不该有的问题:
- 这条请求最后一步算出来的 token 要不要交给客户端?用户已经点了停止,交出最后一个 token 在语义上是否越权?
- 这些输出对象的内部计数器(已生成多少 token、统计里累计了多少)要不要加?如果不加,用户看到两段之间差了一个 token;如果加了,又等于承认”取消了还生成”。
- 对象池里这一份输出、以及更底层对应的 KV 块,什么时候能回收?如果立即回收,上一拍的异步回调可能还在读;如果太晚回收,取消的请求会占着资源直到下一轮。
vLLM 的 V1 异步调度对这个问题有段很有代表性的处理。它承认”在途输出不能被丢弃”——因为丢弃会扰动投机解码的接受率统计;但它把这些 token 标记为”陈旧”,计数的更新推迟到 update_from_output 里按份额逐步完成:
# Async scheduling: mark all in-flight output as stale. Its tokens are # still delivered on return (dropping them would perturb spec-decode # acceptance) but must not mutate the reset counters; each step drains # its share in update_from_output. request.num_stale_output_tokens = request.num_in_flight_tokens request.num_output_placeholders = 0 request.num_preemptions += 1注意这里的细节:这段代码之前还有一处 request.num_computed_tokens = 0(抢占路径里已把已计算 token 数清零),num_output_placeholders 也被清零,但 num_stale_output_tokens 被设成了当前”在途”的 token 数。之后这些 token 照常交付,只是不再修改已被重置的计数器。这一手同时满足了三个要求:输出连续(用户不会看到计数跳变)、统计不失真(投机解码的接受率仍然按实际算出的 token 计算)、资源可回收(计数器已归零,后续按正常路径释放)。
llama.cpp 则选了另一条路。它的 slot 与 client 之间隔着一条任务队列与一条结果队列,“取消”就是把槽位释放掉。已经排进结果队列、还没被 HTTP 线程读走的 token,在概念上仍然存在;但 slot 一旦 release(),该槽位就回到空闲状态,是否清掉 prompt 与 KV 取决于槽位类型(后文详述),后续请求可以立刻使用这个槽位。这里没有”陈旧输出”的概念,因为单个 slot 的结果不会跨请求复用:下一次请求会带上新的 id_task,旧结果在 reader 里已经对不上了。
TensorRT-LLM 的做法介于两者之间:取消请求只是 finish_by_reason(FinishReason.CANCELLED),输出照常进入 _enqueue_responses,由响应端统一处理;但”是否真的可以取消”取决于它当前是否处于某些特殊状态(例如 KV 传输中、正在被抢占),不能取消的请求会被放回 canceled_req_ids 等下一轮再试。这套”尝试取消”的设计后面会细讲。
由此得出第一张横向对照:
| 框架 | 在途输出处理 | 计数策略 | 回收时机 |
|---|---|---|---|
| vLLM | 照常交付,标记为陈旧 | 冻结计数,后续按份额排空 | 由块引用计数决定,可延后 |
| SGLang | 由 to_finish 标记,本 step 结束后统一回收 | 正常推进,结束原因由 FINISH_ABORT 决定 | 下一 step 的收尾阶段 |
| llama.cpp | 旧结果留在队列中,不再交付 | 无跨请求计数 | 槽位释放时立即清状态 |
| TensorRT-LLM | 照常进入响应队列 | 正常推进 | _handle_canceled_requests 收尾 |
| DeepInfer | 由 DeferredRelease 延后一拍归还 | 输出对象池统一记账 | 下一 step 的 pre_sampler_sync |
这张表已经能解释很多现象。比如为什么某些框架在取消之后还能看到”取消请求占着显存好几个 step”——因为输出对象或块引用还没有归还。又比如为什么投机解码的接受率统计在某些框架里对取消特别敏感——因为”已算未交付”的 token 在取消时若被一并丢掉,接受率就成了错的。
vLLM:把取消做成”完成”,把在途做成”围栏”
vLLM V1 的整体架构是”前端进程 + 引擎核心进程”:API server 在前端,负责分词、模板、detokenize、流式输出;EngineCore 在另一个进程里,拥有调度器、KV 管理器与 worker。两者之间用 ZeroMQ 传消息,前端只能发 ADD、ABORT、UTILITY 等几类请求。这套架构意味着取消必须跨进程,而且必须是消息而不是直接函数调用。
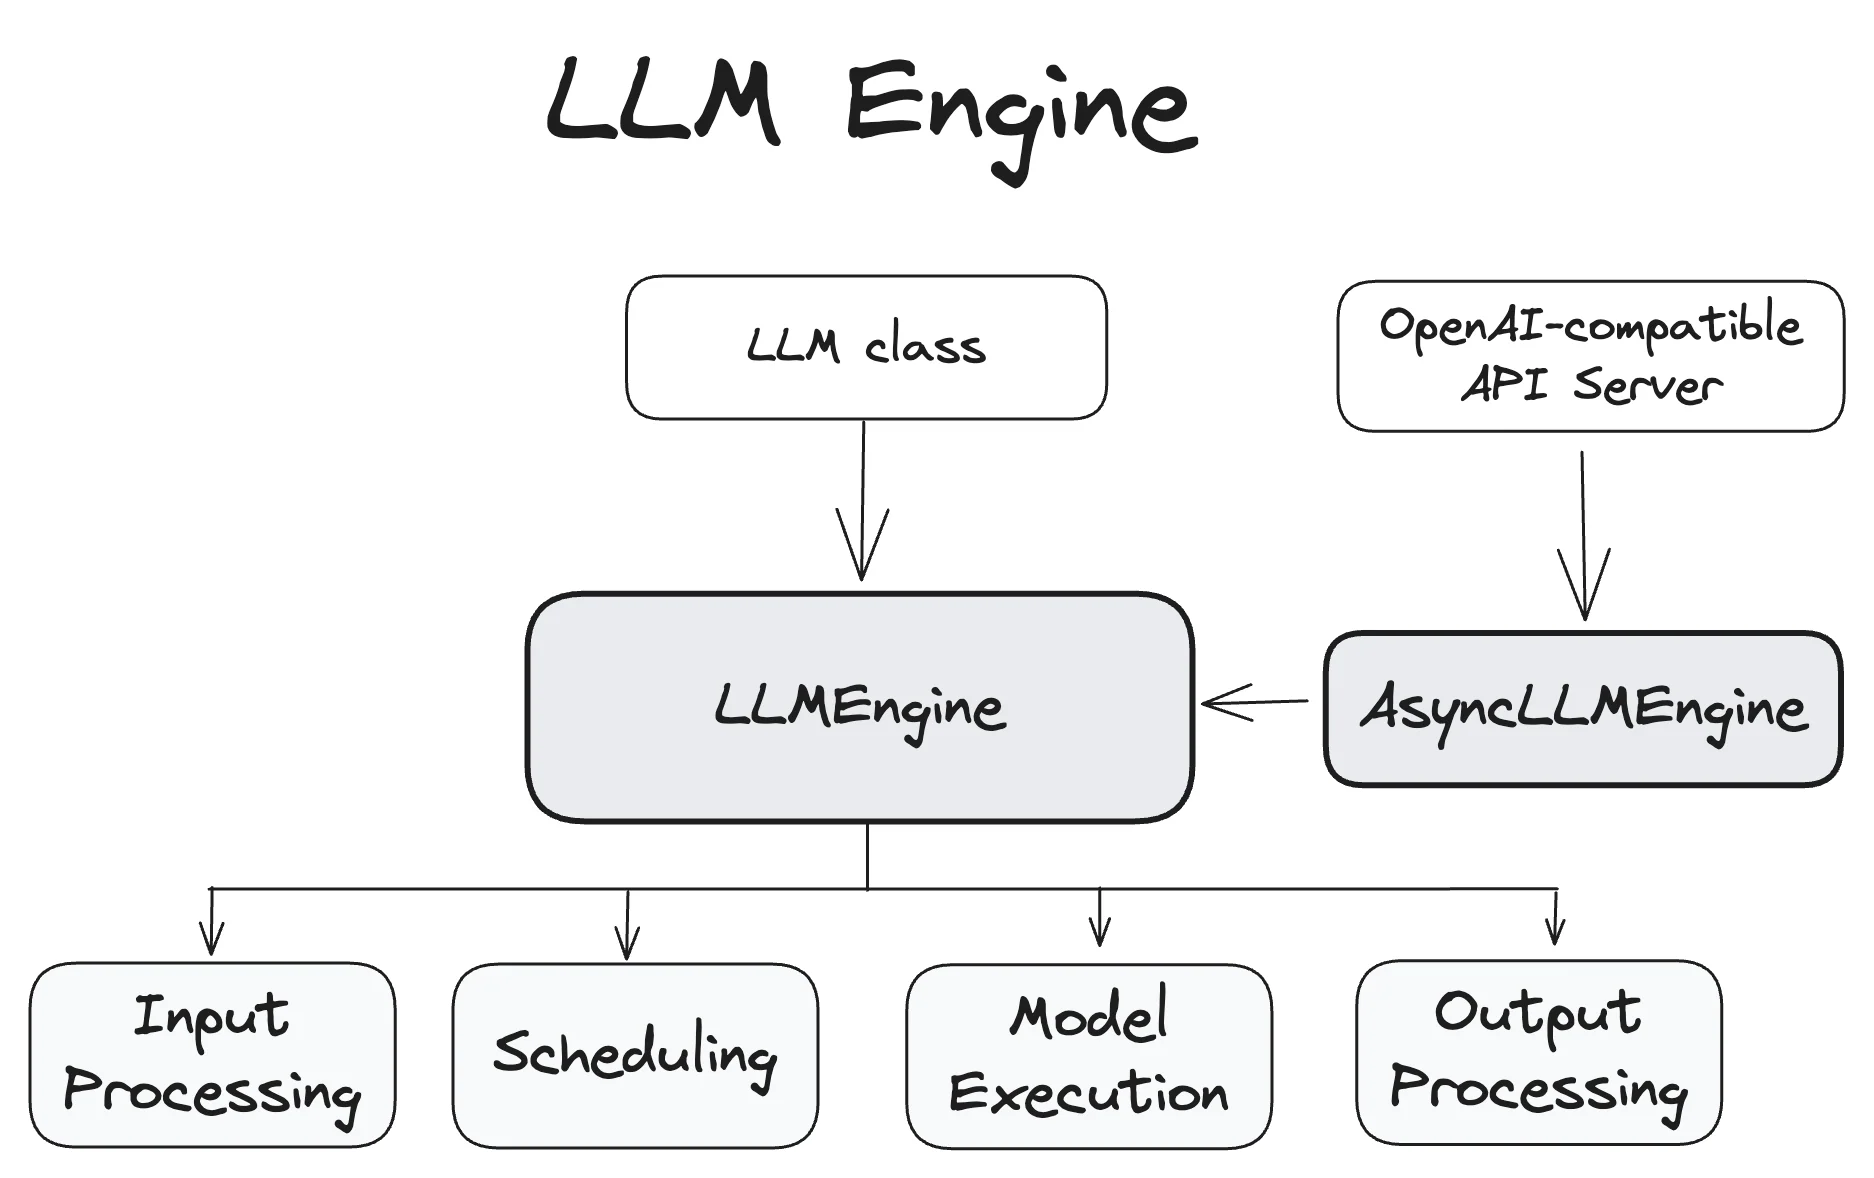
图源:vLLM 官方架构文档。取消消息正是沿着图中从 API server 到 Engine Core 的那条通道传递:前端只能发消息,核心进程收到后只在调度器里生效。
从 HTTP 断连到 ABORT 消息
入口处的 with_cancellation 装饰器同时监听两条路径:handler 本身,以及 raw_request.is_disconnected()。任何一条先完成,另一条被取消。装饰器的注释说得很清楚,它没有用 request.is_disconnected,因为那个方法在中间件下不工作,所以借用了 Starlette StreamingResponse 的模式,用两个任务竞速。
async def wrapper(*args, **kwargs): request = args[1] if len(args) > 1 else kwargs["raw_request"]
handler_task = asyncio.create_task(handler_func(*args, **kwargs)) cancellation_task = asyncio.create_task(listen_for_disconnect(request))
done, pending = await asyncio.wait( [handler_task, cancellation_task], return_when=asyncio.FIRST_COMPLETED ) for task in pending: task.cancel()
if handler_task in done: return handler_task.result() # The client is gone; an empty response skips response_model validation.handler 被取消后,流式生成器收到 asyncio.CancelledError 或 GeneratorExit。AsyncLLM.generate 在 except (asyncio.CancelledError, GeneratorExit) 里调用 await self.abort(request_id)。
abort 分为两段,一段在前端、一段在核心:
async def abort(self, request_id: str | Iterable[str], internal: bool = False) -> None: """Abort RequestId in OutputProcessor and EngineCore.""" request_ids = (request_id,) if isinstance(request_id, str) else as_list(request_id) all_request_ids = self.output_processor.abort_requests(request_ids, internal) await self.engine_core.abort_requests_async(all_request_ids) ...abort_requests_async 把请求 ID 打包成一条 ABORT 消息,走 PC 队列送进 EngineCore。EngineCore 那边的 _handle_client_request 只会做一件事:
def abort_requests(self, request_ids: list[str]): """Abort requests from the scheduler.""" # TODO: The scheduler doesn't really need to know the # specific finish reason, TBD whether we propagate that # (i.e. client-aborted vs stop criteria met). self.scheduler.finish_requests(request_ids, RequestStatus.FINISHED_ABORTED)那句 TODO 本身就是一个设计决策的备注:取消与完成在调度器层被合并成”带不同结束原因的正常完成”,结束原因不做区分。这种合并的收益是路径极短;代价是调度器无法根据”是取消还是正常完成”做差异化处理,比如取消的请求本来可以完全不把 KV 块写回前缀缓存。
在总线这一侧,abort 被同时塞进两条队列:
if request_type == EngineCoreRequestType.ABORT: # Aborts are added to *both* queues, allows us to eagerly # process aborts while also ensuring ordering in the input # queue to avoid leaking requests. This is ok because # aborting in the scheduler is idempotent. self.aborts_queue.put_nowait(request)
# Push to input queue for core busy loop.self.input_queue.put_nowait((request_type, request))这段注释值得细读。注释说 aborts 同时进两条队列:一条让它在”空转期”被立刻处理,一条保证它与前后 ADD 消息的相对顺序不被破坏;重复处理是允许的,因为 finish_requests 对已结束的请求会直接跳过(第一道循环里 request.is_finished() 的判断)。这就是分布式系统里常见的”至少一次 + 幂等”组合,用一次冗余投递换”取消永远不被饿死”。
OutputProcessor:先丢”前端账”
调度器的视角里只有请求 ID;但在前端,请求可能已经变成了一组 RequestState——并行采样时一个外部 ID 对应多个内部 ID,投机解码时子请求挂在父请求下。OutputProcessor.abort_requests 的职责就是把外部 ID 展开成所有相关的内部 ID,逐条从 request_states 里弹出,执行 LoRA 状态清理,并向请求的 RequestOutputCollector 队列塞一个 finish_reason=ABORT 的终态输出:
for request_id in internal_req_ids: req_state = self.request_states.pop(request_id, None) if req_state is not None: self.lora_states.request_finished(request_id, req_state.lora_name) request_ids_to_abort.append(request_id) # Produce final abort output. if req_state.queue is not None and ( request_output := req_state.make_request_output( new_token_ids=[], pooling_output=EMPTY_CPU_TENSOR if req_state.detokenizer is None else None, finish_reason=FinishReason.ABORT, ... ) ): req_state.queue.put(request_output)为什么要在前端先塞一个终态输出?因为客户端的流式消费协程可能正在 await queue.get()。如果只把状态 pop 掉,那个协程会挂在那里,连接句柄与生成器都不会释放。塞一个 ABORT 终态,是最短路径的”通知消费方:这条流结束了”。
注意这段代码同时在做 LoRA 清理。LoRA 适配器的生命周期挂在每个请求上:请求结束时,适配器的引用计数要减一,如果归零则卸载。取消路径上这一步不能漏,否则多 LoRA 服务在长时间的取消风暴之后会出现 adapter 泄漏。站内讲 SGLang 多 LoRA 服务的那篇里也有相似的池化设计,可以参考 SGLang 源码完全拆解(十三):多 LoRA 服务。
调度器:两条执行路径,“完成”是唯一出口
调度器里的 finish_requests 先把请求从队列里一次性移除,再逐条做状态与释放:
def finish_requests( self, request_ids: str | Iterable[str] | None, finished_status: RequestStatus) -> list[Request]: """Handles the finish signal from outside the scheduler.
For example, the API server can abort a request when the client disconnects. ... """ ... # First pass: collect requests to remove from queues for req_id in request_ids: request = self.requests.get(req_id) if request is None or request.is_finished(): # Invalid request ID. continue ...
# Remove all requests from queues at once for better efficiency if running_requests_to_remove: self.running = remove_all(self.running, running_requests_to_remove) if waiting_requests_to_remove: self.waiting.remove_requests(waiting_requests_to_remove) self.kv_holding_waiting.remove_requests(waiting_requests_to_remove) self.deferred_waiting.difference_update(waiting_requests_to_remove)
# Second pass: set status and free requests for request in valid_requests: delay_free_blocks = False if request.status == RequestStatus.WAITING_FOR_REMOTE_KVS: delay_free_blocks = ( request.request_id not in self.finished_recving_kv_req_ids ) ... request.status = finished_status self._free_request(request, delay_free_blocks=delay_free_blocks)两遍处理是性能考量:running 是列表,逐条 remove 是 一次,一批取消就是 ;remove_all 一次扫描是 。第二遍只为真正移除的请求做释放。这两遍的拆分在取消风暴里很关键:一个客户端断连可能同时撤掉几十条并行采样请求,逐条删除会让调度循环卡顿。
_free_request 是统一的”完成与取消”释放路径,它按顺序做了几件事:
aux_output_connector.request_finished:通知辅助连接器(比如 encoder cache 连接器)请求结束;- 从在途预填充集合里摘除:
self._inflight_prefills.discard(request); _connector_finished:让 KV 连接器决定是否要延迟释放块(P/D 分离或 KV 缓存卸载时,块可能正在被异步搬运);encoder_cache_manager.free:释放多模态编码缓存;- 记录
finished_req_ids,供 worker 那边的输出过滤使用; - 如果不需要延迟,则
_free_blocks—— 释放 KV 块并从requests字典里删除。
这六步的顺序是固定的:先通知连接器与辅助连接器,再释放编码缓存,最后才归还块。块放在最后,是因为它是这批资源里最难回滚的一项——一旦回池,就可能立刻被别的请求写入;而连接器与编码缓存的清理都只是”通知与摘除”,顺序提前不会有副作用。
块回收的”围栏”:不立即还池
V1 最近的调度器里引入了一个容易忽略但很关键的机制:延迟释放块与步序围栏。当异步调度的输出还在路上、或异步 KV 连接器可能马上要写入这些块时,块不能立刻还给空闲池:
def _request_blocks_can_be_freed(self, request: Request) -> bool: # We must defer freeing blocks if an async kv connector may # write to them immediately (not ordered with GPU stream). return not self.defer_block_free or ( request.last_sched_seq <= self.processed_step_seq )
def _free_request_blocks(self, request: Request): """Free the request's KV blocks, deferring the return to the block pool when an in-flight GPU step may still write them. """ if self._request_blocks_can_be_freed(request): self.kv_cache_manager.free(request) return blocks = self.kv_cache_manager.pop_blocks_for_free(request) if blocks: self.deferred_frees.append((self.sched_step_seq, blocks))这里有两个序列号:last_sched_seq 是请求最后一次被调度的步号,processed_step_seq 是”输出已经处理完”的步号。只有当请求的最后调度步号不晚于已处理步号时,才说明这一请求的所有 GPU 写入都已经有结果返回,块可以安全回到空闲池。否则,块先从该请求名下摘除(pop_blocks_for_free),进入 deferred_frees 等待围栏推进。
取消正是最容易撞上这道围栏的路径:abort 在任意时刻被处理,而被取消的请求的最后一次前向可能还在 GPU 上排队。如果此时直接把块还给空闲池,紧接着的新请求就可能分到这些块,在新请求的写 KV 之前,GPU 队列里旧请求的那次写就会把数据覆盖进去。这就是”取消后仍然要等一拍”的根本原因。
站内讲 KV 块分配与回收的那篇把空闲队列、引用计数、前缀复用讲得更细,可以参考 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block。
另一种”停”:抢占走独立路径
客户端取消走的是 finish_requests,但资源不足时的抢占不走这条路径。_preempt_request 是一条独立的函数:
def _preempt_request( self, request: Request, timestamp: float, drop_stale_output: bool = False) -> None: """Preempt a request and put it back to the waiting queue.
NOTE: The request should be popped from the running queue outside of this method. ... """ assert request.status == RequestStatus.RUNNING, ( "Only running requests can be preempted" ) if self.aux_output_connector is not None: self.aux_output_connector.request_finished(request) self._free_request_blocks(request) self.encoder_cache_manager.free(request) self._inflight_prefills.discard(request) request.status = RequestStatus.PREEMPTED request.num_computed_tokens = 0 if request.spec_token_ids: request.spec_token_ids = [] ... request.num_preemptions += 1 ... # Put the request back to the waiting queue. self.waiting.prepend_request(request) self.reset_preempted_req_ids.add(request.request_id)和 finish_requests 对比,有三处根本不同:
- 状态是
PREEMPTED而不是FINISHED_*,请求仍然活着; num_computed_tokens = 0——全部前缀作废,将来重新预填充;waiting.prepend_request——插到等待队列的队首,而不是队尾,让被抢占者优先恢复。
为什么抢占不落盘 KV、直接放弃?在单实例、纯 GPU 场景里,把 KV 挪到 CPU 或磁盘的成本,很可能比重算前缀还高:decode 阶段的请求输出通常不长,重算几十个 token 的前缀对 GPU 来说只要几十微秒到几毫秒;而一次 H2D 回填要考虑 PCIe 带宽与 CPU 侧内存管理,加上调度同步,反而更贵。所以 vLLM 在无连接器的场景下选择”直接重算”,这与 SGLang 的取舍不同,后者会在 P/D 分离时做 host 备份。
还有一处细节值得单提:drop_stale_output 参数。注释说它用于 reset_prefix_cache,因为同一 step 里的”恢复”可能导致乱序交付;也用于有未完成 KV 交接的连接器场景,因为抢占时释放的块会让 KV 失效。这是一个很好的例子:在异步化之后,“取消/抢占”这件看似简单的事,会因为在途输出的存在而需要额外的处理模式。
SGLang:用状态标记代替删除,用重抽取代替逐条停
SGLang 的整体架构与 vLLM 相似:TokenizerManager(前端)与 Scheduler(核心)分离,通过 ZeroMQ 传递请求。但它有几个结构性的差异:RadixCache 前缀树、重叠调度(Overlap Scheduler)、to_finish 标记式取消、以及把”抢占”叫做 “retract”(撤回)并引入 token 比例调节。

图源:SGLang 论文 Figure 1。图中 Runtime 这个方框在源码里展开为 TokenizerManager、Scheduler、内存池、前缀缓存与模型执行器;取消要在 TokenizerManager 与 Scheduler 之间往返。
前端:abort 的三个层次
TokenizerManager.abort_request 会先检查本地是否已有这条请求的状态,并且用 abort_sent 去重——同一个请求被取消两次时,只有第一次会真正下发:
def abort_request(self, rid: str = "", abort_all: bool = False): # Empty rid would startswith-match every request on the scheduler. if not abort_all and not rid: logger.warning("Ignore abort_request with empty rid and abort_all=False") return state = None if abort_all else self.rid_to_state.get(rid) if not abort_all: if state is not None: if state.abort_sent: return state.abort_sent = True elif get_serving().tokenizer_worker_num == 1: return req = AbortReq(rid=rid, abort_all=abort_all) ...AbortReq 有个容易被忽略的字段:abort_all。当它为真时,调度器会按 rid 前缀匹配,把一批请求一起取消。这个特性是为了并行采样与多轮会话:一个外部请求 ID 可能对应若干内部子请求,前缀匹配能一次撤干净,不需要前端逐个列举子请求 ID。代价是 rid 不能为空,否则会匹配到全部请求,所以才有了开头那句防御。
断连检测放在 create_abort_task 里,作为 FastAPI 的 background task:HTTP 流式响应结束时,background task 被调度,先 await asyncio.sleep(2) 再取消。那 2 秒是一个刻意的”缓冲”——很多客户端在收完最后一段后正常断开,这个窗口期让正常结束的请求先完成,避免误取消。
SGLang 源码里有一张表格,把”中止”从入口、是否流式、请求状态三个维度列全了:
# | entrypoint | is_streaming | status | abort engine | cancel asyncio task | rid_to_state |# | ---------- | ------------ | --------------- | --------------- | --------------------- | --------------------------- |# | http | yes | validation | background task | fast api | del in _handle_abort_req |# | http | yes | waiting queue | background task | fast api | del in _handle_abort_req |# | http | yes | running | background task | fast api | del in _handle_batch_output |# | http | no | validation | http exception | http exception | del in _handle_abort_req |# | http | no | waiting queue | type 1 | type 1 exception | del in _handle_abort_req |# | http | no | running | type 3 | type 3 exception | del in _handle_batch_output |这张表的读法是:流式请求的取消统一走”background task + asyncio 取消”;非流式请求的取消靠抛异常来中断阻塞的 HTTP 等待;而 rid_to_state 的清理时机,取决于请求当时处在哪个状态——在”验证阶段”或”等待队列”时由 _handle_abort_req 清理,在”运行中”时由 _handle_batch_output 清理。最后一条的差异在于:运行中的请求在调度器那边是”下一 step 才真正结束”,所以状态要等到那一 step 的输出回传后才能删。
调度器:三种 abort 方法,按能不能立即停来选
SGLang 的 abort_request 把取消分成三种执行方式:
方法 1,直接从等待队列弹出。 还没开始任何计算,直接 pop,释放资源,立即给前端回一个 abort 输出。
方法 2,标记语法队列中的请求。 正在等待语法编译的请求不在 JSON 队列里,单独走 grammar_manager.abort_requests;它不是立即强删,而是把输入收成单 token,让这条请求用一次极廉价的 prefill 走完结束路径。
方法 3,标记 to_finish,让它本 step 之后结束。 运行中的请求不强行打断,只是打一个标记:
# Delete requests in the running batchfor req in self.collect_inflight_reqs(): if not req.finished() and ( recv_req.abort_all or req.rid.startswith(recv_req.rid) ): # Abort method 3: set `to_finish` # The request will still run one decode forward pass. # Then we reuse all existing code to clean up the KV cache allocation. logger.debug(f"Abort running request. {req.rid=}") if recv_req.abort_message: # Timeout aborts carry an SLA message + 503 for the client. req.to_finish = FINISH_ABORT( recv_req.abort_message, HTTPStatus.SERVICE_UNAVAILABLE ) else: req.to_finish = FINISH_ABORT()这段注释准确描述了取舍:「请求仍会跑一次 decode 前向,然后复用所有已有代码清理 KV 分配」。为什么不在调度器内部”踢掉”请求?因为调度器正在准备或执行一个 batch,running_batch 的采样元数据、KV 索引、MTP 信息都是按这个 batch 静态编排好的。中途把一行抠掉,意味着要重新构造 batch 的输入张量,代价不比重算一次还低。所以 SGLang 选择”花一个 step 的算力,换一条最简路径”。
被标记的请求走的是正常结束路径:req.to_finish 在 process_batch_result 阶段被消费,设置 req.finished_reason,随后从 batch 中过滤,release_req 释放 KV。整个过程没有一处”取消专用代码”,这是它最大的可维护性收益。
方法 3 的一个隐藏代价是:如果 batch 非常大(比如 1024 条并发),被取消的这条请求在它自己的 decode 前向里消耗的算力可以忽略,但它在 step 末尾的过滤、状态更新、结果回传都可能触发一些 per-request 的操作。若在取消风暴里,一批请求同时被标记,这个”下一 step”的收尾阶段会成为抖动点。
在具体执行上,to_finish 并非只设置不消费。send_abort_output 会在合适的位置把 abort 结果发给前端;对于正在分片预填(chunked prefill)的请求,SGLang 还有一条 _pending_chunked_abort_req 的专用路径:
def abort_request(self, recv_req: AbortReq): if (chunked_req := self.chunked_req) is not None: if recv_req.abort_all or chunked_req.rid.startswith(recv_req.rid): self._pending_chunked_abort_req = chunked_req ...之所以单独处理,是因为分片预填充的当前 chunk 在 chunked_req 这个独立槽位里,不在 running_batch 中。若只是设置 to_finish,这条请求会一直占着 chunked_req 直到整个 prompt 预填完,取消就变成了”等你的长提示词填完再停”,对长上下文服务来说延迟巨大。所以这里直接记进待取消列表,在 chunk 结束时立刻收尾:
reason = req.discard_output_reason or FINISH_ABORT("Aborted")prepare_abort(req, reason.message, reason.status_code)...release_kv_cache(req, self.tree_cache, checkpoint=False)
self.chunked_req = Noneself._pending_chunked_abort_req = None这也解释了为什么 collect_inflight_reqs 不仅要收 running_batch、last_batch,还要收 result_queue 里预排但尚未成为 last_batch 的批次:
def _collect_inflight_batches(self) -> list[ScheduleBatch | None]: if get_parallel().pp_size == 1: inflight_batches = [self.running_batch, self.last_batch] else: inflight_batches = [*self.running_mbs, *self.mbs] if self.enable_continuous_input_polling and self.result_queue: # Polling can run intake before the newest queued batch becomes last_batch. inflight_batches.extend(batch for batch, _ in self.result_queue) return inflight_batches在重叠调度里,“正在 GPU 上跑的批次”(last_batch)与”刚调度出来还没跑的批次”(running_batch)是分开的。abort 必须把它们都扫到,不然会漏掉一类在途请求。
Retract:用”自适应长度”逼调度器腾地方
SGLang 对”抢占”的处理与 vLLM 不同,它叫 retract,并且引入了 token 比例的自适应调节。
当 decode batch 发现 KV 池不够用时,retract_decode 会按一个排序依次撤回请求:
sorted_indices = self._get_decode_retraction_order(self.reqs)...while first_iter or ( not self.check_decode_mem(selected_indices=sorted_indices)): if len(sorted_indices) == 1: # Always keep at least one request break first_iter = False idx = sorted_indices.pop() req = self.reqs[idx] ...排序键(非优先级策略)是 (len(output_ids), -len(origin_input_ids)),列表按降序排,撤回时从末尾弹出。于是被撤回的顺序是:输出最少的先撤;输出相同时,prompt 最长的先撤。代码注释也留了 TODO,说明这套排序还在演进——它并不是一个”从原理上最优”的策略,而是一个可以工作的启发式。
这背后的直觉是:撤回是一种”浪费”,浪费的是已生成 token 对应的 KV 与已经消耗的算力。输出多的请求,撤回的浪费大;prompt 长的请求,占用的 KV 多,优先撤它能在同一时刻腾出更多位置。两个方向一加,结果就是”少生成、长 prompt”的请求先被撤回。但站内讨论前缀缓存的那篇也提醒过另一面:长 prompt 往往正是前缀缓存命中率最高的部分,撤掉它再重算,可能反而更贵。retraction_policy=priority 就是给这种场景留的旁路。
这个策略并非免费。它的一个隐含假设是”输出的 KV 长度与开销成正比、与重算代价不成正比”——对 MLA(Multi-head Latent Attention)这类 KV 压得很小的模型,长 prompt 重算代价可能并不高;而对普通 MHA 模型,长 prompt 撤回的代价可能非常大。SGLang 允许通过 retraction_policy=priority 改成优先级策略,给产品层一个”哪些用户该等、哪些用户不该等”的旋钮。
撤回之后,请求被重置并插回等待队列,同时还调整了一个关键参数——新 token 比例:
self.new_token_ratio_tracker.current = new_token_rationew_token_ratio 控制”调度时按每条请求预留多少 token 的 KV”,撤回后降低它,就能在同样的 KV 池里挤进更多并发请求。这是 SGLang 对”抢占”的一个更主动的解法:不只腾位置,还把每个人的”座位”坐得更挤一些。代价是更长的时间到 OOM 边界擦边,调度器判断不足要更频繁地重试。
撤回还涉及”KV 备份”——在 P/D 分离的 decode 角色里,撤回后的 KV 会被拷贝到 host,这样恢复时可以避免重算。release_req 的签名与注释写得很清楚:
def release_req( *, req: Req, remaing_req_count: int, req_to_token_pool: ReqToTokenPool, token_to_kv_pool_allocator: BaseTokenToKVPoolAllocator, tree_cache: BasePrefixCache, hisparse_coordinator: Optional[HiSparseCoordinator], offload_kv: bool = True,) -> bool: """Returns False when the KV backup failed and the request cannot be resumed.""" ... if get_disagg().disaggregation_mode == "decode" and offload_kv: backup_saved = backup_kv_cache(...) # TODO (csy): for preempted requests, we may want to insert into the tree release_kv_cache(req, tree_cache, checkpoint=False) # NOTE(lsyin): we should use the newly evictable memory instantly. num_tokens = remaing_req_count * envs.SGLANG_RETRACT_DECODE_STEPS.get() evict_from_tree_cache(tree_cache, num_tokens)
req.reset_for_retract() return backup_saved这里有一句非常重要的注释:“we should use the newly evictable memory instantly”。撤回请求的 KV 已经释放了,但 RadixCache 里可能还有别的缓存节点占着块。如果不能立刻用上,撤回就白做了。所以 release_req 会主动从前缀树里驱逐一定量的 token——驱逐量是 剩余请求数 × RETRACT_DECODE_STEPS 的函数,也就是估算”剩下这些请求还能跑几步”,把这几步的 KV 空间都预先挤出来。
这有一个微妙后果:撤回不仅是”撤这一条”,而是”撤这一条 + 顺带驱逐共享前缀树”的缓存。对高前缀命中的工作负载(多轮对话、共享 system prompt),这会让后续请求的前缀命中率降低,间接增加 prefill 开销。这正是 RadixAttention 图里那些”共享分支”被牺牲的地方:图中多个请求共用同一段前缀,撤回长 prompt 请求时,被驱逐的节点可能同时属于别的好几条请求。
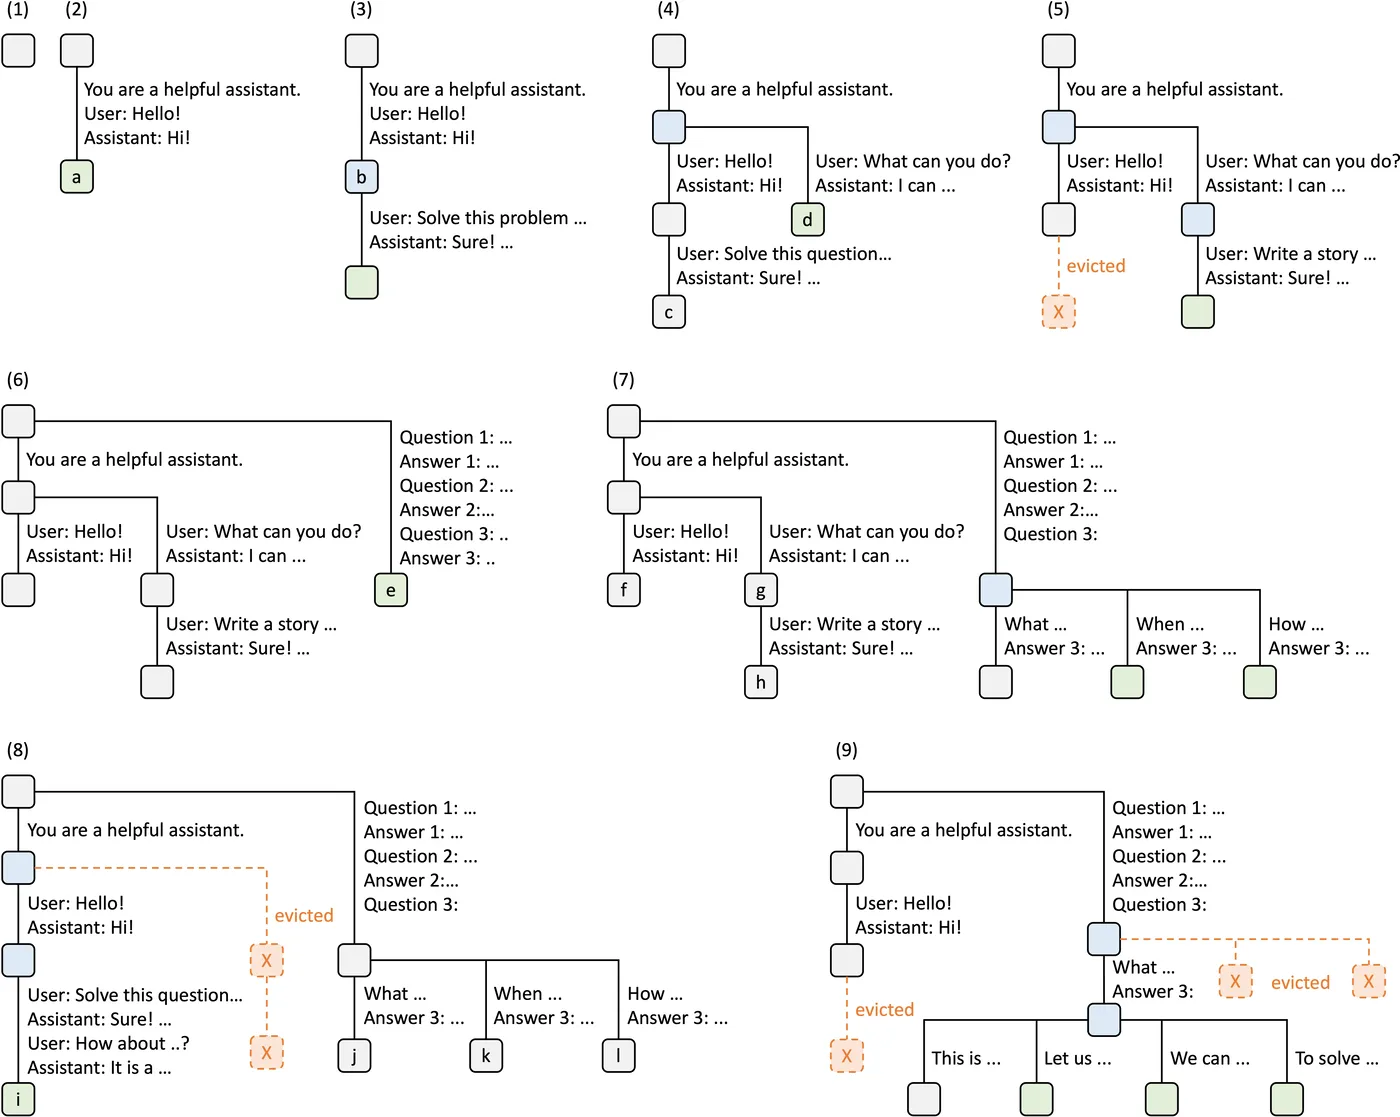
图源:LMSYS SGLang 博客 中的 RadixAttention 示意。撤回请求时调用 evict_from_tree_cache,驱逐的是树上可被复用的 token 节点;对共享前缀,这会同时影响后续请求的命中率。
这是站内讨论 RadixFlow 那篇文章所讲的”混合注意力 LLM 的前缀缓存命中”问题的另一面,可以参考 RadixFlow 完全拆解:混合注意力 LLM 的前缀缓存。
reset_for_retract 是另一处值得注意的地方:它只重置”与本次调度相关”的字段,并不完整重建请求:
def reset_for_retract(self): # Increment retraction count before resetting other state. We should not reset this # since we are tracking the total number of retractions for each request. self.retraction_count += 1
self.prefix_len = 0 self.routed_experts = None self.indexer_topk = None self.last_node = None self.kv.cache_protected_len = 0 ... self.is_retracted = True self.retracted_stain = Trueretraction_count 是保留的,因为它是”这条请求被糟蹋了多少次”的账;retracted_stain 之类的标记是给后续调度、采样阶段的逻辑读的。这种”部分重置”的设计在长生命周期请求管理里非常常见:你要记住”它曾被撤回了几次”用于公平性、统计、超时判定;但也不能让它带着上一次的 KV 索引、routed experts、MTP 状态进入下一次调度,否则会跑出脏数据。
与取消的差别:retract 的目标是”能恢复”,abort 的目标是”不再恢复”
把两条路径放在一起看,会发现一个有趣的对照:
| 维度 | abort(取消) | retract(抢占) |
|---|---|---|
| 请求是否继续 | 否 | 是 |
| 是否保存 KV 备份 | 否 | 在 P/D decode 分离下可选 |
| 是否触发前缀树驱逐 | 否 | 是 |
| 排队位置 | 丢弃 | 队尾(作为新请求重新进入) |
| 结束原因 | FINISH_ABORT | 无(继续) |
这两条路径之所以要分开,是因为它们对缓存系统的副作用完全相反。取消请求不应该触发驱逐——它已经不消耗资源了;但抢占必须触发驱逐——否则腾出来的位置会被缓存的块立刻吃掉。这也是为什么 SGLang 在架构上比 vLLM 更复杂:它需要区分”资源回收导致的位置释放”与”资源不再需要导致的位置释放”。
llama.cpp:单进程、共享 context,“取消”落到槽位释放
llama.cpp 与前面两个框架在结构上完全不同:它是 C++ 单进程、多线程的 server。一个 llama_context 被所有 slot 共享,每个 slot 是一个逻辑上的请求位。KV 缓存是上下文级的连续或分页存储(视 memory 模块),slot 之间通过 seq_id 划分区域。
这意味着”取消”在 llama.cpp 里的形状和另外几个框架完全不一样:它没有独立的调度器、没有独立的块管理器、没有前端与核心进程的分离——它有”任务队列 + 槽位状态机”。
两套取消机制:连接断开与显式删除
llama.cpp 的 server 里至少有两条”取消”通道。
其一,连接断开。 HTTP 处理器拿到的 should_stop 是一个闭包,绑定到 socket 是否仍打开:
conn_impl conn(sock);const std::function<bool()> should_stop = [&sock]() { return !sock.is_open();};server_http_req request{ get_params(req), get_headers(req), req.path, build_query_string(req), req.body, {}, should_stop};handler(request, conn);这个闭包被一路传进流式响应生成器、结果 reader 的 next() 轮询、乃至 prompt 补全的循环。一旦检测到断开,生成器停止拉取更多结果,HTTP 线程返回。
断开之后,SSE 循环返回 false,响应对象析构,server_response_reader 的析构函数调用 stop(),于是下面这条 CANCEL 链被触发。
其二,显式 DELETE。 新的流式 API 支持 DELETE /v1/stream?conv_id=<id>,文档注释说这就是”用户显式停止”:
// DELETE /v1/stream?conv_id=<id> is the explicit user Stop, cancels the producer and evicts...g_stream_sessions.evict_and_cancel(conv_id);evict_and_cancel 先调用 session 的 cancel(),把 cancelled 原子变量置真,再 finalize 唤醒所有 reader:
void stream_session::cancel() { // the should_stop closure on both the producer and any HTTP reader polls is_cancelled() cancelled.store(true, std::memory_order_release);}
void stream_session_manager::evict_and_cancel(const std::string & conversation_id) { ... // cancel first so the producer's on_complete() drain loop and any pending HTTP reader // observe is_cancelled() and stop pulling further output, then finalize to wake readers s->cancel(); ...}注意注释里那句”cancel first … then finalize to wake readers”。这是一个经典的取消陷阱:reader 可能正阻塞在条件变量上等新字节,单纯把 cancelled 置真不会唤醒它;必须先置标志、再 finalize,才能让 reader 从等待中醒来并检查标志。如果顺序反过来,reader 会在 finalize 之后又阻塞,造成”取消失败”的假象。
槽位释放:release 的时候”清什么”有讲究
真正把请求从”占用中”变回”空闲”的,是槽位的 release():
void release() { if (is_processing()) { GGML_ASSERT(task); SLT_INF(*this, "stop processing: n_tokens = %d, truncated = %d\n", prompt.n_tokens(), truncated); t_last_used = ggml_time_us(); state = SLOT_STATE_IDLE;
// do not keep context of the child slots - the parent's context is enough // nor of the stateless slots - no task ever reuses it if (task->is_child() || task->is_stateless() || audio_stream) { prompt_clear(); } ... // mtmd_helper always re-eval the whole prompt if (task->type == SERVER_TASK_TYPE_TTS) { prompt_clear(); }
callback_on_reset(*this); reset(); callback_on_release(id); }}这里最有趣的是那段”什么时候清 prompt”的判断。prompt_clear() 会把 slot 的 prompt 标记为需要重新评估,并释放其 KV 相关状态。但它只在几种情况下执行:
- 子槽(
is_child()):子槽的上下文与父槽共享,父槽会保留 KV,所以子槽自身的 prompt 状态不需要保留,也可以丢弃。 - 无状态槽(
is_stateless()):设计上就不为下一个任务保留上下文。 - TTS 槽与音频流:TTS 的
mtmd_helper总是重评估整个 prompt,保留缓存没有意义。
对于普通的”有状态”槽(--slot-ctx 之类允许复用 KV 的场景),release() 不清 prompt:下一次任务若与上一次的 prompt 有共享前缀,可以复用 KV。这是一个取消路径上的缓存保留决策,恰好和 vLLM/SGLang 的做法相反:vLLM 在取消时照常走完成路径,KV 可以进前缀缓存;SGLang 在取消时明确不驱逐;llama.cpp 在取消时(对一个有状态槽)保留完整 prompt 的 KV,以便下一个请求复用。
代价是:如果取消的请求是一个”一次性请求”(下一个请求与它没有共享前缀),保留的 KV 就白占着显存,直到被下次 re-eval 覆盖。这解释了 llama.cpp server 为什么在一些使用场景下”取消后显存没降”或”取消后新请求速度没有提升”——不是泄漏,而是设计上就不清。
任务层的取消:SERVER_TASK_TYPE_CANCEL
llama.cpp 的 cancel 还有一层”任务层”:server_response_reader::stop() 在请求还没收完结果时,会向任务队列投递一组 SERVER_TASK_TYPE_CANCEL:
void server_response_reader::stop() { queue_results.remove_waiting_task_ids(id_tasks); if (has_next() && !cancelled) { // if tasks is not finished yet, cancel them cancelled = true; std::vector<server_task> cancel_tasks; cancel_tasks.reserve(id_tasks.size()); for (const auto & id_task : id_tasks) { SRV_WRN("cancel task, id_task = %d\n", id_task); server_task task(SERVER_TASK_TYPE_CANCEL); task.id_target = id_task; queue_results.remove_waiting_task_id(id_task); cancel_tasks.push_back(std::move(task)); } // push to beginning of the queue, so it has highest priority queue_tasks.post(std::move(cancel_tasks), true); } ...}这段代码有几个值得反复体会的点:
- 先移除等待任务 ID,再投递取消任务。 这样结果队列不会再为这条请求缓存结果;即便后续来了结果,也会因为没有等待者而被丢弃。
- 取消任务被投到队列队首(
front = true)。 如果队列前面还积压着一堆 COMPLETION 任务,取消任务插到队首才能被优先处理;否则取消的效果要排在”还没开始的任务”后面,用户会看见”点了停止但还是一步一步出字”。 - 去重标志
cancelled。 多次stop()只投一次。 - 真正的取消动作是
id_target匹配槽位并release():
case SERVER_TASK_TYPE_CANCEL: { // release slot linked with the task id for (auto & slot : slots) { if (slot.task && slot.task->id == task.id_target) { slot.release(); break; } } } break;而且 server_queue::post 在接收取消任务时,还会清理同一个 id_target 的”延后任务”(还没拿到 slot 的任务):
if (task.type == SERVER_TASK_TYPE_CANCEL) { cleanup_pending_task(task.id_target);}这一步很关键。一个请求可能被拆成多个子任务(多结果、并行采样、多模态输入片段等),排队等待 slot。取消只清理已经在 slot 上的任务是不够的;还在延后队列里排队的同类任务也必须一并清掉。否则会出现”槽位释放了,但很快又分给了这个被取消请求的另一个子任务,用户取消后又看到了输出”。这是分布式系统里典型的”取消后子任务复活”问题,llama.cpp 用”在投递时清延后队列”这个入口点一次性解决了。
生成循环内部:靠 should_stop 轮询
在采样循环里,llama.cpp 用 should_stop 做周期检查——结果等待、TTS 拉取、SSE 发送、metrics 拉取,各处都带一个 next(should_stop) 或 read(..., should_stop)。它的设计是”等待时可中断”:reader 的 next() 每 polling_interval_seconds 醒来一次,检查取消条件;HTTP 的 SSE 发送每帧检查 should_stop();流式 session 的 reader 在阻塞等待新字节时也带一个 should_stop,最多等待一个短时间就返回并重新检查。
这一套”轮询式取消”的优点是无锁、简单、不会因为抢不到锁而卡住;缺点是取消的感知延迟有一个上界——polling_interval_seconds。llama.cpp 把轮询周期设得比较短,代价是空闲时会有一些唤醒开销。这与 vLLM/SGLang 的”事件驱动 + 标记”形成对照:后者没有周期延迟,但引入了”状态标记必须在正确的 step 消费”的复杂度。
llama.cpp 的”抢占”:不存在
llama.cpp server 没有主动抢占——KV 不足时,任务会留在延后队列里等某个 slot 释放;它不会把正在解码的请求撤回以腾位置。这与它的定位一致:单机、小规模、优先保证每个请求的质量,而不是在极限并发下权衡公平性。
TensorRT-LLM:C++ 调度层、两段式取消与”不可取消”状态
TensorRT-LLM 的运行时历史上经历了从 TensorRT 引擎到 PyTorch 后端的迁移,现有的核心是 C++ 的 batch manager 与 Python 的 PyExecutor。取消要走两段进程:前端(Executor / openai_server)通过 request_queue 把请求交给 worker 线程,PyExecutor 在 worker 里跑调度循环。
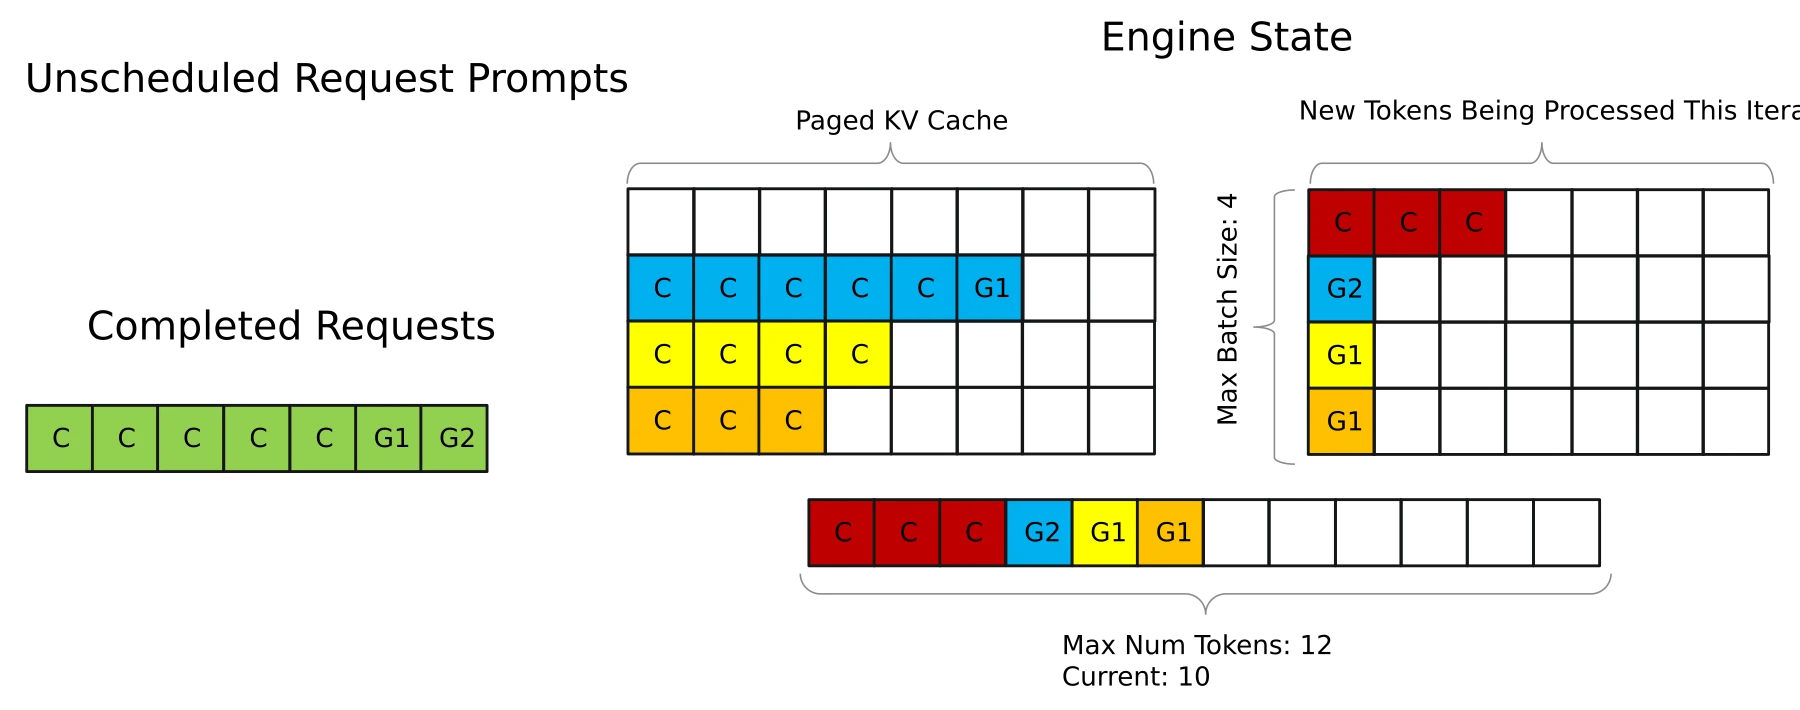
图源:NVIDIA/TensorRT-LLM 官方文档 docs/source/media/TRTLLM_Scheduler_Vis_4.svg。图中 Max Batch Size 与 Max Num Tokens 两重约束同时生效,Completed Requests 展示完成的请求如何离开引擎状态;取消的请求要等这一轮微批收尾之后,才能沿同一路径离开。
前端:每秒一次的断连轮询
TensorRT-LLM 的 OpenAI server 在流式请求开始时启动一个后台任务,每秒检查一次请求是否断开:
async def await_disconnected(self, raw_request: Request, promise): if raw_request is None: return # A batched request is synthesised without a client socket, so # is_disconnected() can never become true and this poll would run at # 1Hz for the life of the process, holding the Request and its # RequestOutput -- one leaked task per batched request. if getattr(raw_request.state, "no_client_connection", False): return while not await raw_request.is_disconnected(): await asyncio.sleep(1) if not promise.finished: promise.abort() logger.info( f"{raw_request.client} is disconnected, abort {promise.request_id}" )promise.abort() 进入 Executor,转发到一个代理的 abort_request:
def abort_request(self, request_id: int) -> None: """Abort a request by sending a cancelling request to the request queue.
Args: request_id (int): The id of the request to abort. """ # NOTE, it just sends a cancelling request to the request queue, but it # may take a while for the request to be cancelled in the worker and # send back a finished result. self.request_queue.put(CancellingRequest(request_id))注释说得清楚:它只是把一条取消请求塞进队列,不保证立即生效——取消的延迟取决于 worker 何时处理这条消息。这与 vLLM 的 ABORT 走独立高优先级队列的做法不同:TensorRT-LLM 的取消是 FIFO 的,必须排在前面那些请求的后面。当 worker 线程繁忙(例如正在为一整批新请求做准入与初始化),取消的生效被推迟到执行器下一次处理这条消息为止。
为什么不做高优先级?因为 request_queue 是跨进程/跨线程的通道,它同时承担新请求与取消的投递。如果让取消插队,就要引入”多队列”或”优先级队列”,复杂度上升;对 TensorRT-LLM 来说,取消频率在设计目标里不是主要负载,而简单可靠的 FIFO 更好维护。
Worker:canceled_req_ids 与”尝试取消”
取消到达 PyExecutor 后进入一个列表:
elif req_item.is_canceled_request: self.canceled_req_ids.append(req_item.id)真正处理在 _handle_canceled_requests:
def _handle_canceled_requests(self): if len(self.canceled_req_ids) == 0: return
# Create set from list of canceled request ids to speed up canceled test canceled_req_ids_set = set(self.canceled_req_ids)
# Remove canceled requests from the waiting queue self.waiting_queue.remove_by_ids(canceled_req_ids_set)
still_pending_canceled_ids = [] for request in self.active_requests: req_id = request.py_request_id if not request.is_child else request.parent_request_id if req_id not in canceled_req_ids_set: continue
is_cancelled = self._try_cancel_request(request) if is_cancelled: # Mark requests as finished, then, we reuse all existing code # to clean up the KV cache resources. request.py_kv_transfer_timed_out = False request.finish_by_reason(FinishReason.CANCELLED) request.decoding_iter = request.py_decoding_iter if self._kv_connector_moves_kv: # A request cancelled mid-prefill can have a connector save # outstanding against the blocks it has filled so far, and the # response pass below frees them as soon as it sees this # request finished. self._start_connector_async_save(request) else: still_pending_canceled_ids.append(req_id)
# Clear list of requests marked for cancellation and add back those that failed to cancel. self.canceled_req_ids.clear() self.canceled_req_ids.extend(still_pending_canceled_ids)这里的设计与 vLLM 有相似之处——“把它标记为完成,复用现有的清理代码”——但有一个独特的机制:取消可能失败。_try_cancel_request 返回假时,取消被放回 canceled_req_ids,下一轮再试。
_try_cancel_request 的判断条件如下:
def _try_cancel_request(self, request) -> bool: """Check if a request can be canceled and attempt cancellation if needed.
Returns: bool: True if the request can be canceled (either successfully cancelled or doesn't need cancellation). """ connector = getattr(self, "kv_connector_manager", None) if connector is not None: connector.release_unstarted_prefix_loads(request) if connector.defer_load_termination(request): return False if self._is_preemption_pending(request): # Finishing it now would be undone: the victim's pages are # released by the completion that ends the preemption, which # then puts it back in context state to be re-prefilled. Held # here, the cancellation outlives that and is applied to the # request the completion hands back. return False if self.kv_cache_transceiver is None: return True
async_transfer_manager = getattr(self, "async_transfer_manager", None) if (getattr(request, "is_context_only_request", False) is True and async_transfer_manager is not None and request.py_request_id in async_transfer_manager.requests_in_transfer()): if self.disagg.inflight_cancel_active(): self.disagg.request_cancellation(request) return False
if not self._is_request_in_transmission(request): return True
if self.disagg.inflight_cancel_active(): self.disagg.request_cancellation(request) return False
return self.disagg.request_cancellation(request)这里有四种”不能直接取消”的状态:
其一,连接器还有未完成的加载。 defer_load_termination 说加载还在进行中,现在结束会让加载器处于半完成状态。取消要等到加载完成或出错之后再生效。
其二,请求正处于”抢占中”。 这是最微妙的一条。注释解释得很清楚:被抢占请求的页会在”结束抢占的完成”那一步被释放,而那个完成会把请求送回 context 状态并重新预填充。如果现在把这条请求结束掉,那条完成路径会再把它”复活”——先完成、后被重新预填充,取消就等于被冲掉了。所以取消必须”活过”那次完成,在这一步之后作用于”完成路径交回来的请求”。这一段注释几乎是一份”取消与抢占竞态”的教科书。
其三,请求正在跨实例传输 KV。 P/D 分离下,如果请求的 KV 还在传输途中,直接结束请求会让接收端的资源泄漏。这里选择向 disagg 层发一个取消通知,由传输层负责收尾,再返回假让上层下一轮重试。
其四,is_context_only_request 正在传输。 同上,但它只出现在 context-only 角色(P/D 的 P 端)上。
这种”尝试—失败—重试”的设计,是 TensorRT-LLM 取消路径最复杂的地方,也是最值得借鉴的地方。它承认了”取消可能会失败”这件事,用”下一轮再试”把跨状态的竞态收敛成”取消最终会发生,但时机由状态机决定”。
抢占与取消的交汇点:为什么要”活过”那次完成
TensorRT-LLM 的抢占机制在 C++ 的 Scheduler 里实现(站内有一篇专文拆过 CapacityScheduler、MicroBatchScheduler 与 paused_requests 的生命周期,可以参考 TensorRT-LLM 源码完全拆解(三):调度器内部)。被暂停的请求会在”上下文阶段”重新做 prefill;“结束抢占”往往发生在下一次成功预填充 completion 处理完成时。
取消与抢占相遇的场景有两种:
- 请求被抢占后,客户端取消它。 如果不拦住,取消会结束请求,但那条 completion 路径会以为”这条请求仍在抢占池里”,把页释放、把请求塞回 context 状态。结果是:请求在调度器视角已经结束,但 worker 视角还有它。所以取消被推迟到 completion 之后。
- 请求正在传输 KV,客户端取消。 传输是异步的,取消必须让传输层感知,否则接收端会一直等一个不会到来的 KV。
这两类问题在 vLLM 与 SGLang 里也存在,但它们用不同的解法:vLLM 把延迟释放块做成调度器内的 deferred_frees 队列;SGLang 在 abort_request 里对 P/D 的队列逐条分类,用 kv_receiver.abort() / kv_sender.abort() 显式通知传输层。TensorRT-LLM 的解法是”取消可能失败”,把复杂性交给重试循环。
三种解法没有绝对优劣,取决于框架对”取消频率”与”传输复杂度”的假设。vLLM 假设取消频率适中,用围栏延迟一两步;SGLang 假设取消频率高(面向大量短交互),愿意在 abort_request 里把 P/D 的各种队列全枚举一遍;TensorRT-LLM 假设取消频率不高、传输状态复杂,用重试换代码简单。
DeepInfer:C++ 调度器、延后一拍与”不做 PE 取消”
DeepInfer 是 DeepSeek 的官方推理引擎。它的核心是由 C++ 实现的 Scheduler(被 Python 通过 pybind 包成 Scheduler 对象),配 Python 的 LLMEngine 与 TileLang 写的 kernel 层。它与前几个框架最显著的不同是”延后一拍”的 ZOS 调度,以及请求级与序列级的分离(一个请求可以派生出多个序列,比如 fork)。
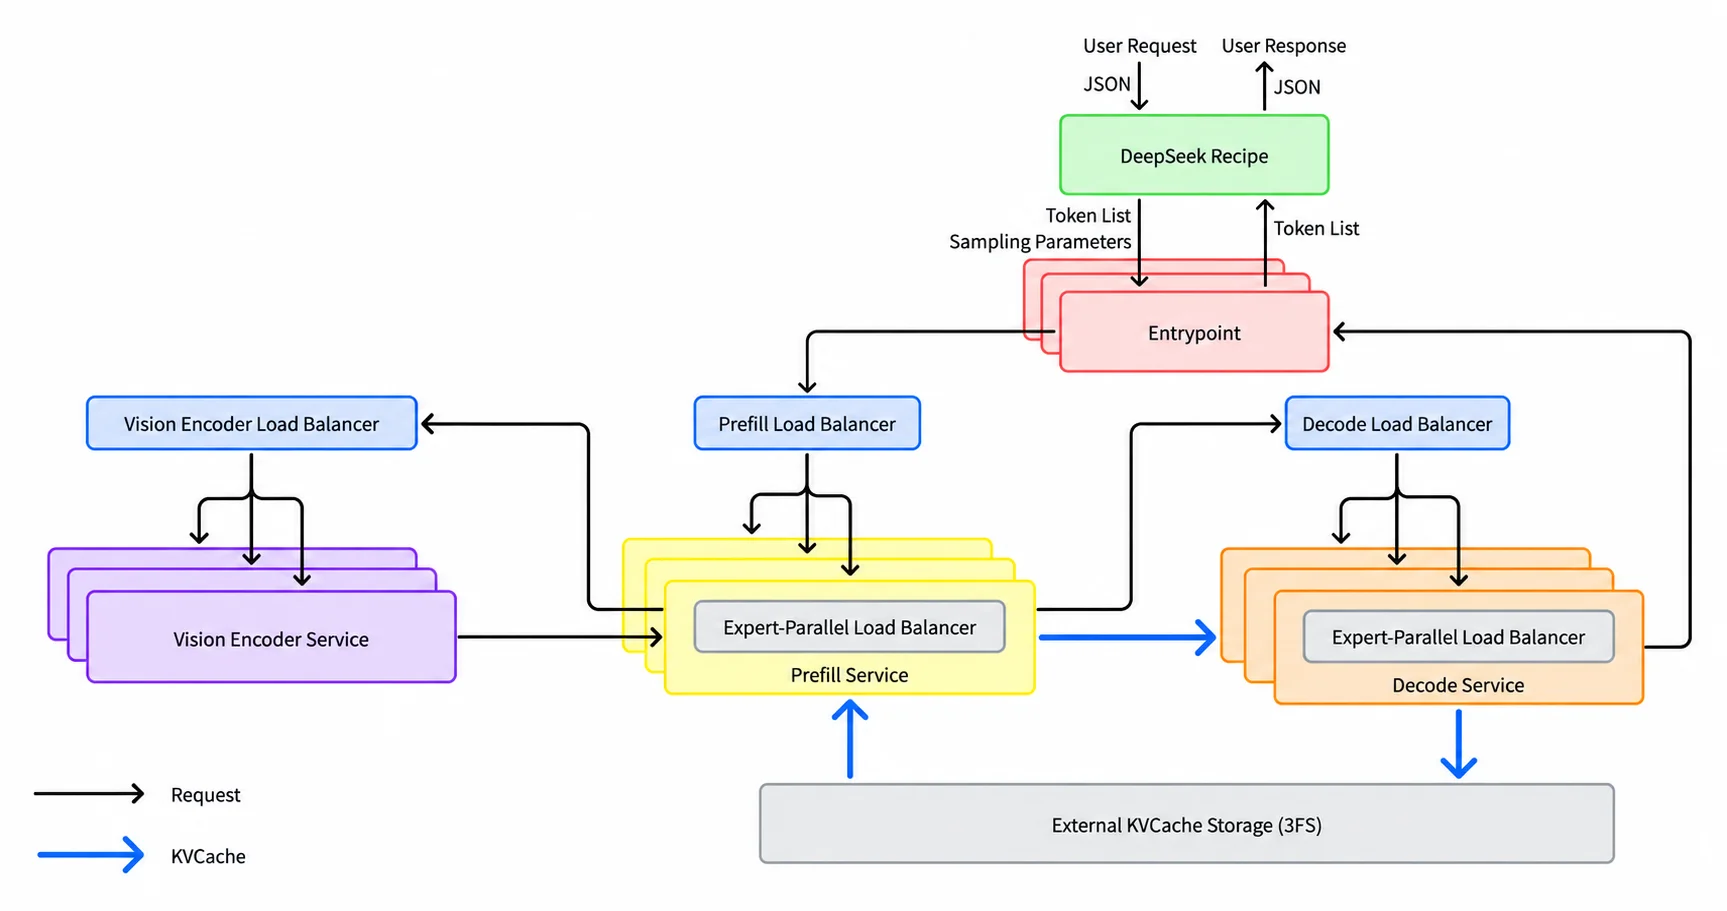
图源:DeepInfer 仓库的 doc/images/architecture_overview.png。取消只发生在 Python 引擎调用 C++ 调度器这一小段;图中更长的那些链路(worker 执行、EP/CP 通信)在取消时并不参与,这正是 DeepInfer 取消路径看起来”短”的原因。
入口:取消从 Python 进 C++
LLMEngine.abort_request 的第一步就是把请求 ID 交给 C++ 调度器:
def abort_request(self, request_id: str | Iterable[str]) -> tuple[int, int]: """Aborts a request(s) with the given ID.
Args: request_id: The ID(s) of the request to abort.
Returns: (Num of aborted seqs, Sum of aborted tokens) ... """ assert isinstance(request_id, (str, dict, set, list, tuple)), f"invalid request_id type: {type(request_id)}" request_id = [request_id] if isinstance(request_id, str) else list(request_id)
seqs = self.scheduler.abort_sequence(request_id) if self.multi_modal_processor is not None: self.multi_modal_processor.abort(request_id) for seq in seqs: # 真正取消的 seq 归还未消费完的共享池块 free_multi_modal_pool_handles(seq.multi_modal_data) return len(seqs), sum(seq.get_len() for seq in seqs)C++ 的 abort_sequence 逻辑非常短:
std::vector<SequencePtr> abort_sequence(std::vector<std::string> &request_ids) { std::vector<SequencePtr> abort_seqs; // 多模态处理失败的 seq 会带着 schedule.schedulable=false 滞留在 waiting,两个队列都要扫。 auto abort_in_queue = [&](auto &queue, auto &request_id) { for (auto &seq : queue) { if (seq->request.request_id == request_id && !seq->is_finished()) { // NOTE: We do NOT abort in PE, so we don't need to maintain // store ids of aborted seqs to release in scheduler. seq->schedule.status = SequenceStatus::FINISHED_ABORTED; num_aborted += 1; abort_seqs.push_back(seq); } } }; for (auto &request_id : request_ids) { abort_in_queue(running, request_id); abort_in_queue(waiting, request_id); } return abort_seqs;}注意这里的两个细节。
其一,“两队列都要扫”的注释。 默认情况下,失败的请求可能因为 schedulable=false 滞留在等待队列里;如果只扫运行队列,它们会留在那里耗着 DP 投票。这是”异常终止”路径与”正常取消”混合的一个例子:取消路径被要求顺便覆盖”因为错误而滞留的请求”。
其二,“We do NOT abort in PE” 的注释。 PE 是 prompt engine(P/D 分离里的 P 端),它负责 prompt 预填充并保存 KV。DeepInfer 的设计是”PE 不处理取消”——P 端的任务一旦开始,就跑到自然结束或写盘完成。这带来两个后果:取消在 P 端要等 prompt 预填完才生效;但 P 端不需要维护”哪些快照是可取消的”这种记账,代码简单了许多。这与 SGLang 的”分片预填充也能取消”形成对照:SGLang 让分片预填可以在 chunk 之间被打断,代价是 chunked_req 的独立记账;DeepInfer 让 PE 完整跑完,代价是取消的感知延迟在最坏情况下取决于 prompt 长度。
状态标记与延迟清理
C++ 这边的取消只是”改状态”,真正的清理不在这一步。abort_sequence 只把序列状态置为 FINISHED_ABORTED,返回被取消的序列列表;KV 块的释放、结果对象的归还,都交给后续的调度与 DeferredRelease。为什么要这样分阶段?
其一,ZOS 的结构约束。 调度器在这一拍决定的是”上一拍”的输出如何处理。如果在 abort_sequence 里当场释放块,上一拍的异步输出处理可能会碰到已经释放的块(它的输出对象还指向这些块对应的 KV 元数据)。所以只能先标记”该结束”,等上一拍的输出处理完、到了可以安全释放的那一拍,再在调度器里清理。
其二,DP 投票与”空转拖死”的防护。 DeepInfer 有 DP(数据并行)协同,每个 rank 调度前会给一个”我这一拍有没有活”的投票。被取消的请求如果一直滞留在某个 rank 的等待队列里,该 rank 永远有”未完成请求”,投票恒为 true,让全组空转。C++ 调度器里有一段专门的兜底清理:
std::vector<SequencePtr> finished_seqs = free_finished_seqs();
// waiting 里已终结的 seq(abort / VE 失败入队)只有调度器能弹出,原本由// _schedule_prefill 顺手清理。现在 prefill 只在本 rank want=true 时才走到,// 某 rank 的 waiting 只剩这类 seq 时 want 恒为 false,它们会永远滞留:// has_unfinished 恒真拖着全组空转,ALL 投票也被这个 rank 永久压死。// 所以在 decode 分支兜底清理;abort 可命中队列中间,需要扫全队列。std::vector<SequencePtr> ignored_seqs;for (auto it = waiting.begin(); it != waiting.end();) { if ((*it)->is_finished()) { ignored_seqs.push_back(std::move(*it)); it = waiting.erase(it); } else { ++it; }}这段注释写的是 DeepInfer 独有的问题:它的调度器有”本 rank 是否需要调度”的投票机制,以及”预填充阶段可能整个跳过”的路径。一旦取消的请求滞留在等待队列里,清理的代码路径可能根本走不到,整组就永久空转。解决办法是在 decode 分支兜底扫全队列。这是一个”取消与并行协同交互”的例子,这类问题在前几个框架里都不会出现——因为它们的调度器是单实例、无投票的。
free_finished_seqs 是另一处清理:
std::vector<SequencePtr> free_finished_seqs() { auto predicate = [this](SequencePtr &seq) { return seq->is_finished(); }; std::vector<SequencePtr> result; for (auto &seq : running) { if (predicate(seq)) { release_mtp_info_slot(*seq); result.push_back(seq); } } running.erase(std::remove_if(running.begin(), running.end(), predicate), running.end()); return result;}注意它顺手释放了 MTP(投机解码里的多 token 预测)信息槽。这又是一个”取消路径上容易被漏掉的东西”:MTP 状态是按请求槽位分配的,取消时若不清,槽位会被耗尽,后续请求就无法开启投机解码。MTP 槽位的释放必须和序列状态一起做,否则会出现”引擎跑着跑着投机解码突然退化成普通解码”的诡异现象。
抢占与取消的交汇
DeepInfer 的抢占发生在 decode 调度里:在 _schedule_decode 中按 LCFS 排序挑选可解码序列,当块不够时就抢占输出长度最长的请求:
// LCFSstd::vector<SequencePtr> scheduled;std::sort(running.begin(), running.end(), [](const SequencePtr &a, const SequencePtr &b) { return a->get_output_len() > b->get_output_len(); });...while (l < r && scheduled.size() < max_seqs) { auto &seq = running[r - 1]; while (!block_manager->can_allocate_single_nolock() && r - l > 1) { auto victim_seq = running[l]; _preempt(victim_seq, ignored_seqs); l += 1; } ...}_preempt 是一个值得读的函数:
void _preempt(SequencePtr &seq, std::vector<SequencePtr> &ignored_seqs) { TORCH_CHECK(seq->schedule.status == SequenceStatus::RUNNING, "status ", int(seq->schedule.status)); // COMPLETION + !stop_preempted_request 已在构造函数被拦截。 // SO 请求抢占目前不支持重算,直接结束 const bool so_blocks_recompute = seq->structured_output.status != 0; if (stop_preempted_request || so_blocks_recompute) { if (so_blocks_recompute && !stop_preempted_request) { LOG_WARN("Request {} is preempted and stops: structured output (so_status {}) can not be recomputed.", seq->request.request_id, seq->structured_output.status); } else { LOG_WARN("Request {} is preempted and stops.", seq->request.request_id); } seq->schedule.status = SequenceStatus::FINISHED_PREEMPTED; free_seq_nolock(*seq); ignored_seqs.push_back(seq); } else { LOG_WARN("Request {} is preempted and will be recomputed.", seq->request.request_id); seq->reset_for_recompute(); // 复位 seq 自身的滚动状态(cache.num_tokens、inflight 计数、MTP 状态),清单见 // Sequence::reset_for_recompute waiting.push_front(seq); seq->schedule.status = SequenceStatus::WAITING; free_seq_nolock(*seq); } num_preempted += 1;}这里的策略选择很有意思:结构化输出请求不允许重算。为什么?因为结构化输出的语法状态是一个有限状态机,它依附于”已经生成的 token 序列”。被抢占后重算,会把已生成的前缀再生成一遍;而如果状态机已经走过了某几步,重算时生成的 token 序列可能因为浮点差异不完全一致(尤其是 batch 组合不同之后),状态机的前进路径就会偏离。为避免这种不一致,DeepInfer 直接结束这类请求(FINISHED_PREEMPTED),而不是”撤回重算”。站内有一篇专文拆过结构化输出与投机回滚,可以参考 DeepInfer 源码完全拆解(六):结构化输出与确定性。
reset_for_recompute 是另一处细节:撤回重算不能只把 num_computed_tokens 置零,还要复位 MTP 状态、in-flight 计数、滚动状态。这与 SGLang 的 reset_for_retract 相似,但 DeepInfer 的 reset 清单更直接提到了 MTP 状态。这类”复位清单”是隐藏 bug 的高发地:漏一个字段,下次调度就会用上次的残留值构造输入,跑出”输出明显错乱但又不报错”的症状。
取消与延后一拍的交汇
ZOS 的”延后一拍”让取消多了一个复杂性:abort_request 在 Python 里同步调用 C++ 的 abort_sequence 时,上一拍可能还在 process_output 中。如果请求在这一拍被标记为结束,上一拍的结果处理会在”请求已从状态里被弹出”的情况下收到它的输出吗?
答案取决于实现。DeepInfer 的 process_outputs 处理的是 scheduler_outputs 里携带的序列引用,而不是”从字典里按 ID 查找”。这保证了即使请求在下一拍被删除,上一拍的输出处理仍然能拿到序列对象;序列对象的引用计数在输出处理完成后才归零,块释放才真正发生。结合 DeferredRelease 的”下一拍再还对象池”,就形成了一条完整的安全链:
abort_sequence(标记 FINISHED_ABORTED,收集序列对象) → 下一步 schedule 的 free_finished_seqs(从 running 里移除,释放 MTP 槽) → 下一步 pre_sampler_sync 的 deferred_release.release(归还输出对象池) → 块释放(由 block_manager 在序列析构或显式 free 时归还)这条链对”取消延迟”的代价是:从客户端按下停止,到 KV 块真正回池,至少经过一个 step 的边界。在 decode 一个 step 1-3ms 的节奏下可以接受;但它解释了一个现象:当吞吐很高、step 时间很长的解码场景里,“取消后还能看到这条请求占显存”可能持续几十毫秒。这不是泄漏。
横向对比:四个岔路口与五个答案
把五个框架的取消与抢占路径放在同一张表上,能看见四个关键岔路口,每个岔路口都恰有五个不同的答案(或五个近似答案),而答案的差异都能追溯到架构约束。
岔路口一:取消是”立即停”还是”下一拍停”
| 框架 | 策略 | 延迟量级 | 代价 |
|---|---|---|---|
| vLLM | 核心进程立即处理 ABORT,调度器 finish_requests | 最多一个 step 的在途输出 | 块释放需等围栏 |
| SGLang | running 批次标记 to_finish,下一 step 收尾 | 一个 step | 取消风暴时有收尾抖动 |
| llama.cpp | 投递 CANCEL 任务(队首),下一次 slot 处理 | 一次任务循环 | 共享 context 上正在进行的 llama_decode 不中断 |
| TensorRT-LLM | 1Hz 轮询 → 取消请求进队列 → 下一次执行器循环 | 最长约 1s + 一次执行器循环 | 取消与其他请求排队 |
| DeepInfer | C++ 调度器直接标记状态 | 一个 step(ZOS 延后一拍) | PE 端不取消 |
llama.cpp 的特殊之处在于它的”取消”落到 slot 释放,但已开始的 llama_decode 无法中断——那是 C++ 中一次阻塞的 GPU 运算。所以用户按下停止之后,直到当前 decode 结束才会真正让出资源。这也解释了为什么 llama.cpp server 的取消在单卡、长上下文时感觉更”钝”:一次 decode 可能因为大 batch 或长上下文需要十几毫秒甚至更多。
TensorRT-LLM 的 1 秒轮询是一个被低估的细节。在低延迟对话里,用户的”停止”按钮按下后,模型可能又生成了一句话才停——那 1 秒的轮询周期就是来源之一。要缩短它,可以降低 await_disconnected 的轮询间隔,代价是每个活跃请求一个每秒唤醒的任务。
DeepInfer 的 PE 端不取消,是另一种”延迟量级”:取消的延迟与 prompt 长度成正比。对短 prompt 的请求,这几乎无感;对长上下文请求,可能意味着”等几秒才停”。
岔路口二:KV 块何时归还
这是正确性最高危的一条线。五个框架的做法:
vLLM:引用计数 + 步序围栏。 块管理器计算引用计数,调度器在”最后调度步号 ≤ 已处理步号”时才调用 kv_cache_manager.free;否则进 deferred_frees。这个”围栏”是异步调度与 P/D 连接器共用的基础设施。
SGLang:在下一 step 的 batch 收尾里释放。 被标记 to_finish 的请求在 process_batch_result 里被过滤,release_req → release_kv_cache。对 retract(抢占),额外触发前缀树驱逐。SGLang 有一个更”主动”的清理:evict_from_tree_cache(tree_cache, num_tokens)——按估算的”还要跑几步”提前驱逐缓存。
llama.cpp:由 prompt_clear / reset 决定是否复用。 没有块级引用计数(分页模式下有页管理,但语义不同)。对普通有状态槽,KV 保留;对子槽、无状态槽、TTS 槽,全部清空。
TensorRT-LLM:两级池 + 块管理器。 完成时的 finish_by_reason 会触发块回收(在 response pass 里),对被取消的预填充请求,还会顺带 _start_connector_async_save,让连接器决定是否把已填充的部分 KV 保存下来。
DeepInfer:状态标记 + 下一拍释放。 块由 C++ BlockManager 管理,free_seq_nolock 释放;取消链路通过 free_finished_seqs / ignored_seqs 的移除触发,MTP 槽同步释放。
从”块何时归还”往下推,可以直接判断一个框架在”取消风暴”下的行为:vLLM 的块归还受围栏保护,风暴期间块数量会短暂变少;SGLang 的块归还与 batch 收尾同步,风暴期间收尾阶段变重;llama.cpp 的取消不立刻归还(对有状态槽),风暴期间显存”不降”;TensorRT-LLM 的块归还依赖 response pass,风暴期间收尾阶段积压;DeepInfer 的块归还延后一拍,若取消的请求很多,下一拍的 free_finished_seqs 变重。
岔路口三:抢占的取舍
| 框架 | 抢占策略 | 是否重算 | 是否备份 KV | 是否为撤销抢占而驱逐缓存 |
|---|---|---|---|---|
| vLLM | 直接撤回,num_computed_tokens=0,队首优先恢复 | 是 | 否(无连接器时) | 否(但前缀块可由 LRU 自然回收) |
| SGLang | retract,按 (out_len, -prompt_len) 排序,new_token_ratio 下调 | 是(或从 host 恢复) | P/D decode 下可选 | 是(主动驱逐) |
| llama.cpp | 无抢占 | — | — | — |
| TensorRT-LLM | pause / paused_requests | 是 | 取决于连接器 | 取决于连接器 |
| DeepInfer | LCFS 调度,victim 取输出最长者(队首) | 是,但 SO 请求不可重算 | 否 | 否 |
这几行的差异主要来自”KV 存储假设”。vLLM 与 DeepInfer 假设”重算便宜”,因此不备份;SGLang 在 P/D decode 场景里假设”恢复比重算便宜”,所以加了一条备份路径;TensorRT-LLM 把这一切交给连接器。llama.cpp 干脆不做,因为它的定位是”小规模、每个请求都很贵”——它宁可排队等,也不愿意牺牲已经生成的请求。
SGLang 与 DeepInfer 的 victim 选择策略恰好相反:SGLang 的 victim 是”输出最少、prompt 最长”的请求,DeepInfer 的 victim 是”输出最长”的请求。前者优先保护已经生成很多的请求,避免把已有输出作废;后者(LCFS)优先服务刚起步的请求,在显存不足时牺牲最老、生成最多的那条。哪个更优取决于负载:长对话服务里,SGLang 的”保住老请求”更友好;大量短请求的开放域服务里,DeepInfer 的”保住刚起步的”能压低尾部延迟。
岔路口四:在途输出的处理
| 框架 | 是否交付在途输出 | 是否冻结计数 | 是否回收中间对象 |
|---|---|---|---|
| vLLM | 交付,标 stale | 是 | 延迟,按份额 |
| SGLang | 不交付(to_finish 后该 step 不输出) | 正常推进 | 在收尾阶段 |
| llama.cpp | 不交付(slot 已释放,reader 已移除等待) | 无 | slot 释放时 |
| TensorRT-LLM | 交付(进 response queue) | 正常推进 | response pass |
| DeepInfer | 交付(在 DeferredRelease 窗口内) | 正常推进 | 下一拍 |
vLLM 与 DeepInfer 都选择”交付 + 冻结/正常”,因为它们的异步结构导致”中间对象还在被上层读”;SGLang 与 llama.cpp 选择”不交付”,是因为它们的”停止”发生在采样结果被消费之前,可以让结果直接从路径上消失;TensorRT-LLM 选择”交付”,但由 response pass 统一处理结束。
对投机解码特别敏感的是”SGLang 与 llama.cpp 不交付”这一选项。投机解码的接受率统计发生在”草稿 token 与验证结果比较”的那一步;如果这一步被取消,统计里就缺了一个样本。小样本下不影响什么,大规模长跑下,对接受率的估计会漂移。vLLM 的注释直接说了这一点(dropping them would perturb spec-decode acceptance)。SGLang 与 llama.cpp 对投机解码的实现路径不同,SGLang 的 EAGLE 草稿头走的是另一条链路,llama.cpp 的投机解码把输出记在 common/speculative.cpp 里,取消时对接受率的影响与 vLLM 不同。站内有两篇对照文章:SGLang 源码完全拆解(十一):投机解码 与 llama.cpp 源码完全拆解(九):投机解码。
多卡与 P/D:取消跨几个进程
五个框架里,取消的跨度差别极大:
- vLLM:前端进程 → EngineCore 进程(ZMQ)→ 调度器;PP 下 KV 块释放要下发到每个 rank,但控制面只有一个调度器。
- SGLang:TokenizerManager → Scheduler(ZMQ);P/D 下要分别向 kv sender / kv receiver 发 abort。
- llama.cpp:单进程,取消在 HTTP 线程 → 任务队列 → slot 所在线程。
- TensorRT-LLM:前端 → proxy → worker(queue);P/D 下还有 disagg 层的传输取消。
- DeepInfer:Python 引擎 → C++ 调度器(pybind);CP 组与 EP 组通过自定义通信缓冲协同;PE 不取消。
流式并行那篇文章讨论过 PP 下的取消:一次取消要穿过几张卡、EngineCore 会阻塞在正在执行的 execute_model 上。可以参考 流水并行推理完全拆解:五个框架为什么选了五种流水形态 里”一次取消会穿过几张卡”一节,这里不再重复。
值得补一句 TensorRT-LLM 在 P/D 下的特殊处理:disagg.request_cancellation 是一个跨层的协议——取消不是简单的”删掉请求”,而是”让传输层知道有一个请求不会到达终点”。这与 SGLang 的 kv_sender.abort() / kv_receiver.abort() 思路相近,都是”把取消责任下沉到传输层”。
从源码里能读出的工程经验
到这里,五个框架的差异已经铺开。可以从中提炼出几条对读源码与设计系统都有用的结论。
第一条:所有”取消”都必须回答”块什么时候能还”
不管是哪个框架,取消路径的最后一步都是”某个块回到了某处”。在代码里,这一步通常会被写成几行不起眼的 free 或 release。但它前面的条件判断——引用计数、步序围栏、状态标记、连接器完成——才是真正的难点。阅读源码时,建议把”块归还”这个动作作为锚点,反向追到”谁在决定取消生效”,往往就能看清整套取消路径。
比如 vLLM 的 _request_blocks_can_be_freed 在调度器里,SGLang 的 release_kv_cache 在 schedule_batch.py 里,TensorRT-LLM 的块回收集中在 response pass 的”看到 finished 就释放”逻辑里,DeepInfer 的 free_seq_nolock 在 C++ 调度器里。它们的函数名不同,位置不同,语义却是一致的。
第二条:取消延迟不是 bug,是权衡
用户视角的”取消延迟”取决于三件事:取消通知能多快到达执行者、执行者何时能停下、资源何时能腾出。三个环节各有成本:
- 到达执行者:轮询(TensorRT-LLM 1Hz)vs 事件驱动(vLLM ZMQ)vs 任务队列(llama.cpp);
- 停下:等一个 step(SGLang、DeepInfer)vs 立即中断(没有真正”立即中断”的);
- 腾出:等围栏(vLLM)vs 等在途输出归还(DeepInfer)vs 等传输层收尾(TensorRT-LLM)。
没有哪个框架做到了”全链路零延迟”。一个合理的工程选择是把延迟压在”用户可感知的首位”上——取消的效果是”不再出新字”最快,其次是释放显存。vLLM 的路径很好地体现了这个顺序:前端先把终态输出塞进队列让用户看到”停了”,核心进程再慢慢回收资源。
第三条:“取消可能失败”是分布式系统的必然
TensorRT-LLM 的”尝试—失败—重试”不是过度设计,而是对”取消失败”这件事的显式承认。在多状态机(抢占、传输、连接器加载)协同的系统里,取消只能”最终发生”,不能”立刻发生”。如果一个框架声称”取消立即生效”,你需要问:它是不是漏了某个状态的竞态?
反过来,如果一个框架的取消路径完全没有失败分支(比如 DeepInfer 的 C++ 调度器标记),你需要问的是:它是否在结构上让”不能取消”的状态根本不会出现?DeepInfer 的答案是”PE 不取消 + ZOS 延后一拍 + DP 投票兜底清理”,它把避免的状态直接排除在结构之外,而不是靠重试处理。
第四条:在途输出是取消”正确性”与”统计”的公共难点
只要系统是异步、重叠、延后的,就存在”已算未交付”。取消时必须回答三个问题:交付还是丢弃、计数加不加、对象何时归还。vLLM 用 stale 标记 + 份额排空解决了三者;llama.cpp 用”按新任务 ID 过滤旧结果”回避了;TensorRT-LLM 用”进 response queue”把三者推到了统一的收尾;SGLang 用”下一个 step 的完成路径”把三者合并;DeepInfer 用对象池 + DeferredRelease 把它们变成”生命周期”而不是”取消逻辑”。
哪一种更好?如果一个系统的投机解码对接受率统计敏感(例如自适应的验证深度受接受率驱动),那么 vLLM 的”交付 + 冻结”策略会显著优于 SGLang 的”丢弃”。DeepInfer 的 graph_timer 与 decode 性能曲线正是一个被接受率统计驱动的自适应机制——它决定 MTP 的深度;如果取消时丢弃样本,深度选择会漂移。站内那篇 DeepInfer 源码拆解(二十九):CUDA Graph 内的计时器与 decode 性能曲线 讲了这套机制的另一半。
第五条:取消是前缀缓存策略的敌人
SGLang 的 retract 会主动驱逐前缀树;vLLM 的取消尽管照常走完成路径,但被取消的请求已经生成的 KV 前缀仍可能被后续请求复用(如果它被写进了前缀缓存);llama.cpp 对有状态槽的取消刻意不清 prompt,等于”保留前缀缓存”。这三者都是”取消与前缀缓存”的交叉问题。
从工程视角看,这个问题有一个通用的框架:取消时这条请求的 KV 前缀”值不值得保留”,取决于”它接下来会被复用的概率”与”保留所占的显存代价”。对多轮对话(同一用户的后续请求大概率共享前缀),保留更值;对一次性问答,保留不值。llama.cpp 的槽位语义天然适合多轮对话,所以它保留;vLLM 与 SGLang 面向更通用的服务,需要靠前缀缓存淘汰策略(LRU 等)来平衡,所以它们不专门为取消做保留。
第六条:取消与抢占在代码里常常是”两条路径、一个出口”
vLLM 有 finish_requests 与 _preempt_request,但最终都走 _free_request_blocks;SGLang 有 abort_request 与 retract_decode,最终都走 release_req(一个 FINISH_ABORT,一个 reset_for_retract);DeepInfer 有 abort_sequence 与 _preempt,最终都走 free_seq_nolock。这种”两条入口路径、一个出口”的模式,是维护这类复杂逻辑的关键:入口路径负责”语义上的差别”,出口负责”资源回收的共性”。
如果你正在阅读或改造一个推理框架,建议先找到”那个出口”,再梳理入口。这样看代码,会感觉清晰很多。
一张可直接查的对照表
最后,把散落在全文里的对照集中到一张表里,供阅读源码与设计系统时参考。表中”语义合并程度”指”是否用同一路径处理多种停”;“跨进程”指取消消息要经过多少个进程边界;“回收完整性”指”取消之后所有关联资源(块、MTP 槽、LoRA、编码缓存)是否都有对应清理点”。
| 维度 | vLLM | SGLang | llama.cpp | TensorRT-LLM | DeepInfer |
|---|---|---|---|---|---|
| 取消语义合并 | 高:cancel = finish | 中:waiting 直接 pop,running 标记 | 高:CANCEL 任务释放槽 | 高:finish_by_reason(CANCELLED) | 中:C++ 标记 + 下一拍清理 |
| 语义合并带来的代价 | 结束原因不区分 | 需要 to_finish 专门消费 | — | “尝试取消”重试 | P 端取消要等预填充完成 |
| 取消检测方式 | HTTP 断连任务竞速 | background task(2 秒缓冲) | socket 关闭 + should_stop 轮询 | 1Hz 轮询 | 由上层入口调用 |
| 在途输出 | 交付并标 stale | 不交付 | 不交付(新任务 ID 过滤) | 交付至 response queue | 交付(DeferredRelease 窗口) |
| 块归还有无围栏 | 有(步序围栏 + deferred_frees) | 无(batch 收尾即释放) | 无(槽位清或不清) | 无(response pass 释放) | 无(下一拍释放) |
| 取消消息跨进程 | 前端→核心(ZMQ) | 前端→调度(ZMQ) | 任务队列(进程内) | 前端→worker(queue) | pybind 调用 |
| P/D 取消 | 连接器 request_finished | kv sender/receiver 显式 abort | 无 P/D | 传输层取消协议 | PE 不取消 |
| 抢占 victim 选择 | 调度器在 running 队列中挑选受害者(具体策略随版本变化) | 输出最少的先撤;同长度下 prompt 最长的先撤 | 无抢占 | paused_requests | LCFS 调度,victim 取队首(输出最长) |
| SO 请求可否重算 | 可(视策略) | 视情况(beam 组直接 abort) | — | — | 不可,直接结束 |
| MTP 槽位清理点 | 调度器 update_from_output | 前缀树相关字段 | — | request finish | free_finished_seqs |
| 典型取消代价 | 1 step + 围栏 | 1 step | 1 次 decode 循环 | 最长约 1s 轮询 + 一次执行器循环 | 1 step(PE 更久) |
使用这张表时注意:表中每一列不是”谁更好”,而是”谁在什么约束下选择了什么”。如果你要在生产环境里选框架,请先把你的约束摆出来——是极致低延迟对话(关注取消检测方式),还是高并发混合负载(关注抢占策略与块归还),还是 P/D 分离的弹性场景(关注传输层取消的完备性),还是单机多用户(关注槽位语义)。约束不同,正确的选择也不同。
小结
“取消”在推理服务里是一件事,“抢占”是另一件事,“在途输出”是第三件事,但它们最终会在同一段代码路径上重逢。五个推理框架给出的答案分别是:
- vLLM 把取消做成完成的特例,用步序围栏处理异步与传输场景,用 ABORT 双队列保证取消不被饿死;
- SGLang 用
to_finish标记与三种 abort 方法按状态分流,用 retract 实现主动抢占,用 token 比例自适应来”挤座位”; - llama.cpp 把取消落到槽位释放,用
should_stop轮询与 CANCEL 任务的双重通道保证各种流式结构都能停; - TensorRT-LLM 承认”取消可能失败”,用尝试与重试处理抢占、传输、连接器加载的竞态;
- DeepInfer 用 C++ 调度器做状态标记、用 DeferredRelease 做延后一拍归还,用 DP 投票兜底清理覆盖并行协同的边缘情况。
它们没有一个”完美的取消路径”。所谓的正确,是在各自的架构约束下,把四种”停”都回答清楚:谁通知、谁标记、谁释放、什么时候能还。读这些代码时,如果能把每个 free、release、finish 都对应到”这是四种停中的哪一类、这一步为什么要等”,就已经读懂了这套机制。
继续追这条线时,一个自然的下一步是KV 块在请求结束、抢占、P/D 交接之间的所有权如何转移:以五个框架的块管理器为中心,把本文里提到的”围栏”、“驱逐”、“备份”、“延迟释放”放进同一张所有权图谱中。所有权一旦画清楚,“这块什么时候能还”就不再需要靠零散的注释去猜。
参考资料
- vLLM Scheduler V1 源码(
vllm/v1/core/sched/scheduler.py) - vLLM OutputProcessor 源码(
vllm/v1/engine/output_processor.py) - vLLM EngineCore 源码(
vllm/v1/engine/core.py) - vLLM API 服务取消装饰器(
vllm/entrypoints/serve/utils/api_utils.py) - SGLang Scheduler 源码(
python/sglang/srt/managers/scheduler.py) - SGLang ScheduleBatch 源码(
python/sglang/srt/managers/schedule_batch.py) - SGLang TokenizerManager 源码(
python/sglang/srt/managers/tokenizer_manager.py) - llama.cpp server 上下文与任务队列源码(
tools/server/) - TensorRT-LLM PyExecutor 源码(
tensorrt_llm/_torch/pyexecutor/py_executor.py) - TensorRT-LLM ExecutorProxy 源码(
tensorrt_llm/executor/proxy.py) - TensorRT-LLM OpenAI 兼容服务源码(
tensorrt_llm/serve/openai_server.py) - DeepInfer 仓库与文档
- DeepInfer C++ 调度器源码(
csrc/engine/scheduler.hpp) - DeepInfer LLMEngine 源码(
deepinfer/engine/llm_engine.py)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



