


vLLM 源码完全拆解(二十九):异步调度——调度器为什么可以在采样结果落回 CPU 之前,就决定下一步跑谁
前二十八篇里,vLLM 的请求路径是这样串起来的:请求从 API 入口进入,经 EngineCore.step 调度,GPUModelRunner 把一批请求拼成一次前向,Sampler 采出 token,update_from_output 再把结果写回请求对象,Scheduler.schedule 据最新的状态决定下一步跑谁,KVCacheManager 分配与回收块,最后从 OutputProcessor 流式吐给客户端。这一整套顺序在同步模式下是严格的因果链:前一步的采样 token 必须先完整落回 CPU、写进请求对象,下一步的调度才能基于它算出 token 预算、检查停止条件、决定投机解码下一步要验证几个位置。这条链干净、正确,但有一个代价:每一步解码,GPU 都必须停下来等 CPU 把结果搬回去。
AsyncScheduler 就是为了把这一等等掉而存在的。本文沿 V1 源码拆解异步调度的全部机制:它如何用「占位符」让调度器在采样结果落回 CPU 之前就完成下一批计划,update_from_output 如何在结果回来时把账本对上,模型执行器如何把上一步的采样 token 留在 GPU 上、下一步直接当输入用,投机解码与结构化输出在这种「迟到一拍」的视图下如何被特殊处理,以及这个机制成立的前提与边界。
同步解码的关键路径上,CPU 在等什么
先看清楚要省掉的是什么。一次 decode step 在同步调度下的时间线大致是:
CPU: schedule(S_t) ──启动前向──┐ ┌── update_from_output(S_t) ── schedule(S_{t+1})GPU: │ execute(S_t) → sample → D2H ────┘CPU 把 S_t 交给执行器后,前向启动即返回(execute_model(..., non_block=True) 得到一个 future),然后在 future.result() 上等待采样完成与结果回传。GPU 真正的工作量很小——每请求一个 token 的 decode 本来就是访存密集型,算力利用率低——但 CPU 在等的这段时间里什么都没做:它既不能提前调用 schedule,也不能提前准备下一批输入。整个系统在 decode 阶段被压成「GPU 跑一下、CPU 等一下」的锯齿,而这个锯齿里 CPU 侧的等待往往与 GPU 的实际执行时间同量级,因为中间还夹着采样结果从 GPU 拷回主机、多进程间传递 SamplerOutput、以及 Python 侧的逐请求记账。
异步调度的目标很明确:让 CPU 在 GPU 执行第 t 步的同时,就把第 t+1 步的调度做完。时间线变成:
CPU: schedule(S_t) → schedule(S_{t+1}) → update(S_t) → schedule(S_{t+2}) → update(S_{t+1}) ...GPU: execute(S_t) → sample → execute(S_{t+1}) → sample → ...但问题立刻出现:第 t+1 步的调度依赖于第 t 步的采样结果。如果 token 还没采出来,调度器怎么知道第 t+1 步该给这个请求分配多少 token、它是否已经达到 max_tokens、KV 需要预留几个块?
答案是先按最坏情况记账,等结果回来再对账。这正是异步调度全部复杂度的来源。
在架构上,这套「同时维持两批在途」的能力来自 EngineCore 的批量队列:异步调度把 max_concurrent_batches 从 PP 专属的 1 提升到 2(V1 模型执行器)或 pp_size + 1(V2 模型执行器),于是 EngineCore.step_fn 从单步的 step 切换为 step_with_batch_queue。下文的占位符账本,全部是在这个双缓冲结构里成立的。
异步调度是建立在 V1 的多进程拓扑之上的:每个 API Server 对应一个 EngineCore,再向一组 GPU Worker 分发前向。异步调度省掉的那次「等待」发生在图中的 API Server ↔ Engine Core ↔ GPU Worker 这条链路上——CPU 侧的三段各自可以并行推进。
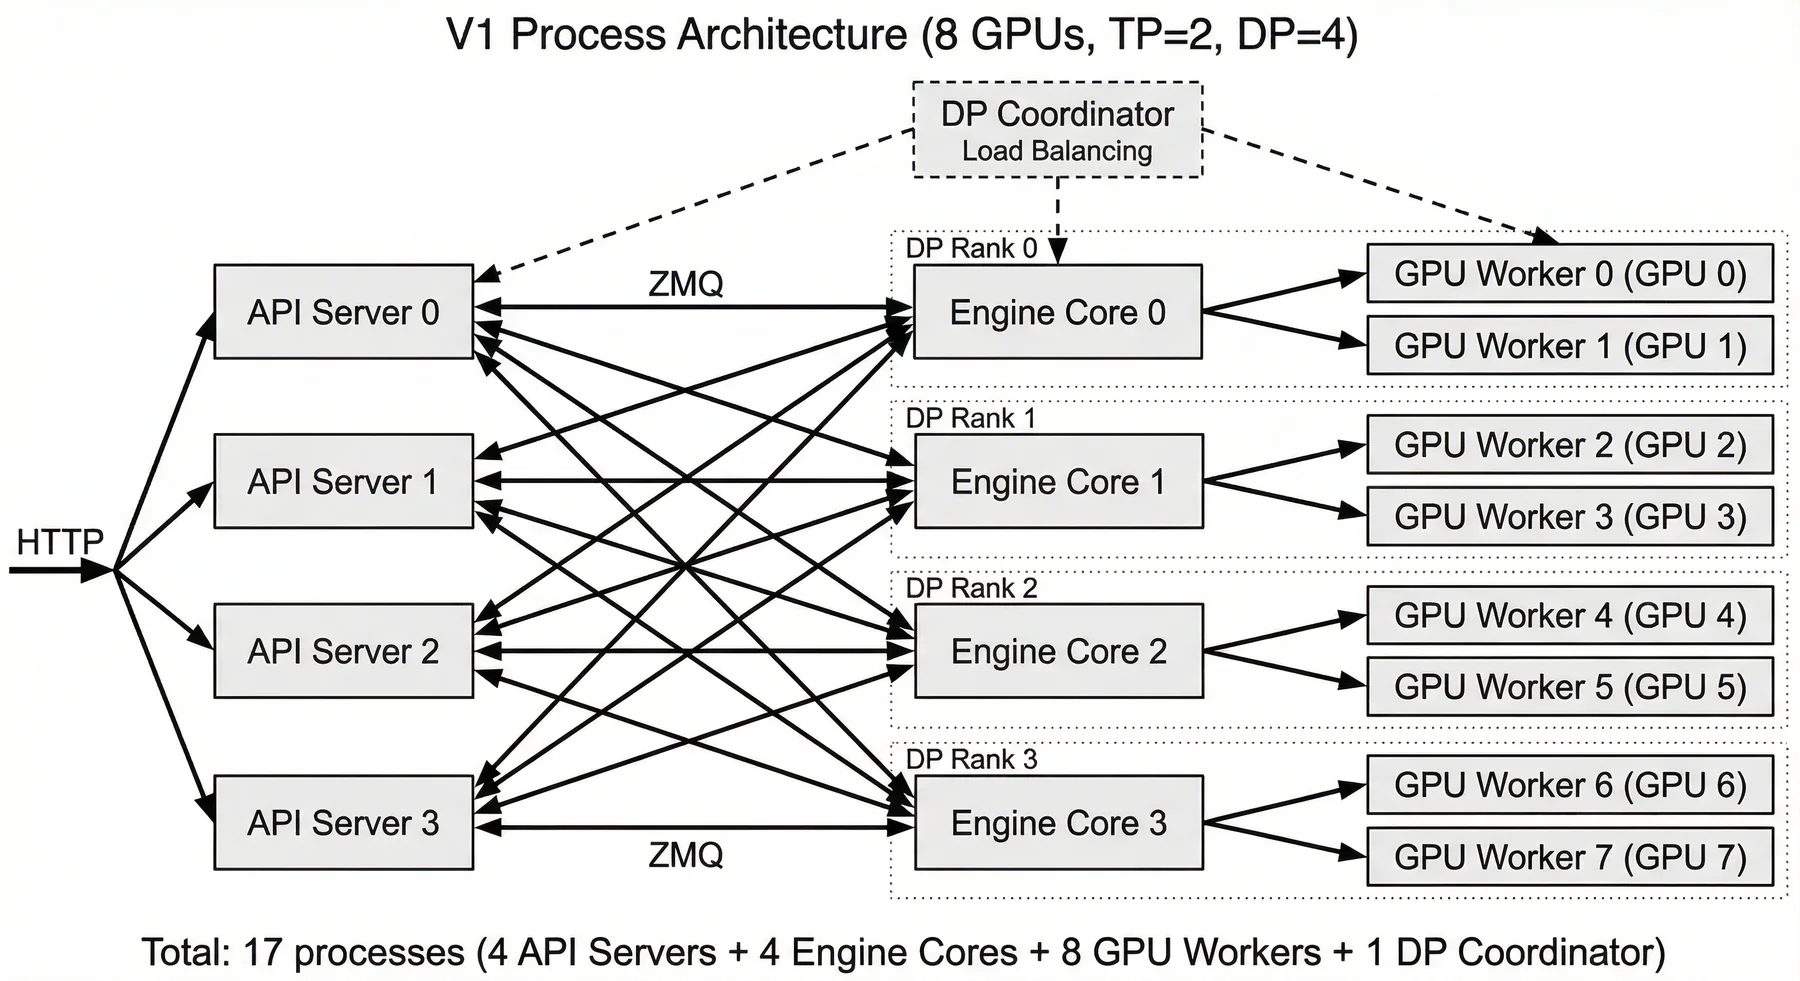
图 1:vLLM V1 进程架构(TP=2、DP=4,共 17 个进程:4 个 API Server + 4 个 Engine Core + 8 个 GPU Worker + 1 个 DP Coordinator)。来源:vLLM 官方设计文档 arch_overview.md。
开关、默认值与兼容性边界
入口在 SchedulerConfig 的 async_scheduling 字段(vllm/config/scheduler.py 中声明为 async_scheduling: bool | None = None),对应 CLI 的 --async-scheduling / --no-async-scheduling。
缺省值是 None 不是小事:VllmConfig 的初始化阶段会把它解析成真正的布尔值。解析逻辑很值得读——它决定了在什么组合下异步调度「想开但开不了」:
executor_supports_async_sched = executor_class.supports_async_scheduling()...# Async scheduling incompatibilities specific to the V1 model runner.v1_async_sched_incompat: str | None = Noneif not self.use_v2_model_runner: spec_config = self.speculative_config if spec_config is not None and ( spec_config.method not in get_args(EagleModelTypes) and spec_config.method not in get_args(NgramGPUTypes) and spec_config.method not in ("draft_model", "dspark", "dflash") ): v1_async_sched_incompat = f"{spec_config.method}-based speculative decoding" elif spec_config is not None and spec_config.disable_padded_drafter_batch: v1_async_sched_incompat = "disable_padded_drafter_batch=True" elif self.parallel_config.pipeline_parallel_size > 1: v1_async_sched_incompat = "pipeline parallelism"
if self.scheduler_config.async_scheduling: # Async scheduling explicitly enabled, hard fail any incompatibilities. if v1_async_sched_incompat is not None: raise ValueError( "Async scheduling is not supported by the V1 model runner " f"with {v1_async_sched_incompat}." ) ...elif self.scheduler_config.async_scheduling is None: # Enable async scheduling unless there is an incompatible option. if self.model_config.runner_type == "pooling": self.scheduler_config.async_scheduling = False elif not executor_supports_async_sched: ... self.scheduler_config.async_scheduling = False elif v1_async_sched_incompat is not None: ... self.scheduler_config.async_scheduling = False else: self.scheduler_config.async_scheduling = True三条信息:其一,在 V1 模型执行器上,异步调度目前是默认开启的(用户没显式关、执行器支持、没有不兼容项);其二,V1 上它不支持流水并行,也不支持不经过草稿头对齐的投机方法(除 EAGLE 系、N-gram 系与 draft_model、dspark、dflash 之外,例如 Medusa 式的多头草稿在 V1 上与之不兼容);其三,用户显式打开时遇到不兼容组合不是「静默降级」,而是直接抛错。这条「显式开=硬失败,默认开=软降级」的区分,是为了防止用户在以为开了异步调度的情况下实际跑在同步路径上。
开关打开之后,这个标志在四个地方被观察:
SchedulerConfig.get_scheduler_cls()据此返回AsyncScheduler而不是Scheduler;VllmConfig.max_concurrent_batches据此把在途批次数从 PP 专用的pp_size提升到至少 2(V1 是 2,V2 是pp_size + 1),EngineCore再据此启用batch_queue并把step_fn切到step_with_batch_queue;Scheduler基类根据它决定update_from_output是否要扣减占位符、是否延迟释放 KV 块;GPUModelRunner读取self.use_async_scheduling,几乎每一处需要「CPU 与 GPU 同步」的地方都会分叉。
批次数这条是容易被忽略的根:没有第二批在途,占位符就无从预支。VllmConfig.max_concurrent_batches 的注释写得很直白:
@propertydef max_concurrent_batches(self) -> int: # PP requires PP-size concurrent batches to fill the pipeline. # Async scheduling requires 2 concurrent batches to overlap. pp_size = self.parallel_config.pipeline_parallel_size if self.scheduler_config.async_scheduling: if self.use_v2_model_runner: return pp_size + 1 # V1 Model Runner does not fully support async scheduling with PP. if pp_size <= 1: return 2 return pp_size此外 V1 里还有一个与之正交的 VLLM_USE_V2_MODEL_RUNNER(use_v2_model_runner)标记,异步调度与它组合时多出流水并行下的「错拍解码」(decode_stagger),本篇后面单独讲。只开异步调度、不开投机解码,是最干净的形态,我们先把它讲透。
class AsyncScheduler(Scheduler): def __init__(self, *args, **kwargs) -> None: super().__init__(*args, **kwargs) # reusable read-only placeholder list for speculative decoding. self._spec_token_placeholders: list[int] = [-1] * self.num_spec_tokens self.pp_size = self.parallel_config.pipeline_parallel_size # Only XPU can disable PP decode microbatching via VLLM_XPU_PP_MICROBATCH. self.decode_stagger = self.pp_size if current_platform.is_xpu() and not envs.VLLM_XPU_PP_MICROBATCH: self.decode_stagger = 1AsyncScheduler 本身只是一个很薄的子类,它没有重写 schedule,只重写了 _update_after_schedule——在每次调度完成后,立刻为下一步预支账本。真正的语义分叉散落在 Scheduler、Request、EngineCore、GPUModelRunner 与 InputBatch 里。
占位符:num_output_placeholders 到底是什么
异步调度全部机制的枢纽,是 Request 上的一个计数器 num_output_placeholders。它长在 V1 的统一调度模型上——V1 不再区分 prefill 与 decode 阶段,每个请求每一步拿到的就是「本步允许计算的 token 数」,调度结果是一个 {request_id: num_tokens} 的字典:
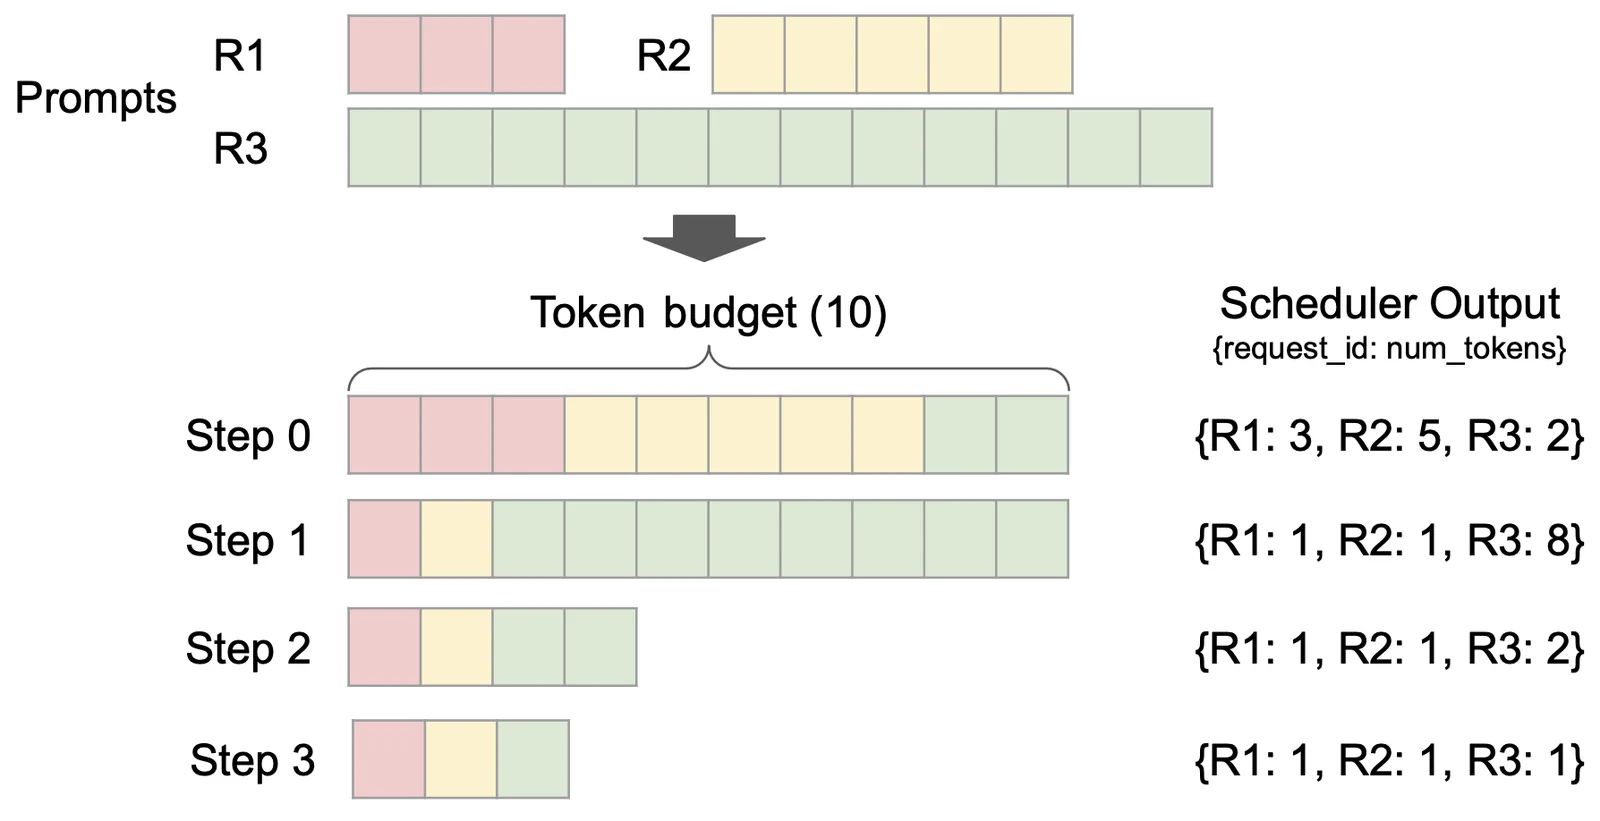
图 2:V1 调度器的统一预算视图。三个请求在每一步各拿到多少 token,由同一个 token budget 决定,prefill 与 decode 不再分两套调度器。来源:vLLM V1 发布博客。
理解占位符需要先理解 Request 上的三个 token 相关计数:
num_prompt_tokens:提示词长度,请求创建后不变;num_output_tokens:已经确认的输出 token 数,即这些 token 已经在 CPU 侧写进请求对象、可以被客户端看到、可以被停止条件检查;num_computed_tokens:已经被 GPU 计算过 KV 的 token 总数(提示词 + 输出)。
第四个量是 num_tokens_with_spec = num_tokens + num_spec_tokens,即在开启投机解码时,「如果草稿全部被接受,这个请求一共会有多少 token」的乐观估计。
num_output_placeholders 是第五个量,含义是:调度器已经替这个请求预支了、但还没有被真实采样结果确认的输出 token 数。它同时被计入 num_computed_tokens 的推算,也就是说调度器在规划时「假装」这些 token 已经被算过 KV。
这三个量之间的不变量可以写成:
在 decode 稳态下,若上一步调度的 token 已经全部落在 KV 里,num_tokens_not_yet_computed 为 0,于是 num_computed_tokens = num_tokens + num_output_placeholders。换句话说,调度器把「下一步将要采出来的那个 token」也算进了已计算。
为什么要这样算?因为异步调度的下一步调度发生在第 t 步前向执行期间,调度器不知道第 t 步会采出什么、更不知道它会被接受还是不接受(投机场景)。它唯一能做的,是假设「第 t 步的采样一定会成功、一定会产生一个 token」——这是 decode 的正常情况——然后据此推进账本。如果假设错了(请求在 max_tokens 边界停住、投机草稿全部被拒、KV 装载失败导致 token 被丢弃),update_from_output 就必须把这笔预支还回来。
调度循环里预支账本的三处细节
Scheduler.schedule 的运行队列循环里有三处与占位符直接相关的判断,它们分别回答了「还能不能继续跑」「要不要多跑一拍」「投机草稿能塞几个」:
if ( request.num_output_placeholders > 0 # This is (num_computed_tokens + 1) - (num_output_placeholders - 1). # Since output placeholders are also included in the computed tokens # count, we subtract (num_output_placeholders - 1) to remove any draft # tokens, so that we can be sure no further steps are needed even if # they are all rejected. and request.num_computed_tokens + 2 - request.num_output_placeholders >= request.num_prompt_tokens + request.max_tokens): # Async scheduling: Avoid scheduling an extra step when we are sure that # the previous step has reached request.max_tokens. req_index += 1 continue这段判断防止「多跑一拍」。注释里写得很清楚:num_output_placeholders 里既有已经确认的 token,也有投机草稿这种「乐观预支」的 token。调度器想知道的是:在最坏情况下(所有投机草稿都被拒),如果我现在还跑这一步,这个请求会不会超过 max_tokens? 真实可数的 token 下界是 num_computed_tokens + 1 - (num_output_placeholders - 1)(加的那个 1 是这一步即将采出来的 token,减去的 (num_output_placeholders - 1) 是预支的草稿)。如果这个下界已经达到上限,就让出这一拍。没有这个判断,异步调度会为一个已达上限的请求白跑一次前向,浪费一个 batch 槽位。
对 max_tokens 的停止判定也有专门的函数,它要回答同样的问题——「如果这一步全部是采样、下一步全部是验证,这个请求最早什么时候停」:
# Case 2: this step samples the request's last output token. Drafts may# all be rejected, so count only the output tokens the request is sure# to have once this step finishes: the verified ones, plus one from each# step that samples. This step samples one.min_num_output_tokens = request.num_output_tokens + 1if request.num_output_placeholders > 0: # Async scheduling: a step that samples is still in flight, and it # adds one more. min_num_output_tokens += 1# Reaching max_tokens finishes the request, so no step verifies the drafts.return min_num_output_tokens >= request.max_tokens同步模式下 num_output_placeholders 恒为 0,+1 就是这一步的采样;异步模式下,因为有一个还在途中的采样步骤,所以再加一。这个 +1 +1 正是「一拍延迟」的显式表达。
第三处出现在投机解码的 token 预算计算里:
num_scheduled_spec_tokens = ( num_new_tokens + request.num_computed_tokens - request.num_tokens - request.num_output_placeholders)num_new_tokens 是这一步要算的 token 数(公式见下文块分配一节,它已经包含了占位符),num_computed_tokens - num_tokens 是已经算过 KV 但尚未进入 num_tokens 的那部分(通常是投机草稿),再减去占位符,得到真正需要验证的草稿位置数。异步调度下这个量会因预支而变化,所以调度器会用它来裁剪 spec_token_ids 的长度:
if num_scheduled_spec_tokens > 0: spec_token_ids = request.spec_token_ids if len(spec_token_ids) > num_scheduled_spec_tokens: spec_token_ids = spec_token_ids[:num_scheduled_spec_tokens] scheduled_spec_decode_tokens[request.request_id] = spec_token_ids_update_after_schedule:调度完立刻预支下一步
AsyncScheduler._update_after_schedule 是每次调度完成后、执行前向之前被调用的钩子。它做三件事:为输出与草稿各预支占位符、为结构化输出标记 pending、为 V2 模型执行器标记下一步的 decode 资格。
def _update_after_schedule(self, scheduler_output: SchedulerOutput) -> None: super()._update_after_schedule(scheduler_output) spec_decode_tokens = scheduler_output.scheduled_spec_decode_tokens # Use the latest num of scheduled draft tokens in next step as placeholder. self._spec_token_placeholders = [-1] * scheduler_output.num_spec_tokens_to_schedule for req_id in scheduler_output.num_scheduled_tokens: request = self.requests[req_id] if request.is_prefill_chunk: continue
scheduler_output.pending_structured_output_tokens |= ( request.use_structured_output and request.num_output_placeholders > 0 ) # The request will generate num_sampled_tokens_per_step new tokens # plus num_spec_tokens in this scheduling step. Diffusion has no AR # bonus token (num_sampled_tokens_per_step == 0) — only the canvas # (spec) tokens. cur_num_spec_tokens = len(spec_decode_tokens.get(req_id, ())) request.num_output_placeholders += ( self.num_sampled_tokens_per_step + cur_num_spec_tokens ) # Add placeholders for the new draft/spec tokens. # We will update the actual spec token ids in the worker process. request.spec_token_ids = self._spec_token_placeholders
if self.use_v2_model_runner: # Set the next step index in which this request is eligible to be # scheduled for decode (for PP microbatching). request.next_decode_eligible_step = ( self.current_step + self.decode_stagger )逐条拆开:
它只对 decode 段生效。is_prefill_chunk 的请求直接跳过——分块预填充的中间块不采样任何 token,没有可预支的东西。
预支的额度是「每步采样数 + 草稿数」。在 AR(自回归)模型里,num_sampled_tokens_per_step 是 1:每个 decode 步骤采一个 token。若开了投机解码,还要加上这一步调度的草稿数 cur_num_spec_tokens,因为下一步的验证会把这几个草稿位置当作「已计算的候选 token」,若草稿被接受它们就会成为真实输出。对扩散语言模型(diffusion LLM)来说,num_sampled_tokens_per_step 为 0——没有 AR 的 bonus token,只有 canvas 上的 spec token——这一行注释说明框架已经为「非自回归采样」做了区分。
spec_token_ids 被替换成占位列表。这是异步调度里最反直觉的一笔:调度器在调度完下一步时,直接把这个请求的 spec_token_ids 填成 [-1] * num_spec_tokens,而不是等真正的草稿生成出来再回填。
# reusable read-only placeholder list for speculative decoding.self._spec_token_placeholders: list[int] = [-1] * self.num_spec_tokens注意「read-only」这个注释——这个列表是多个请求共享的同一个对象,所有请求的 spec_token_ids 都指向它。之所以能共享,是因为在 worker 进程里它会被整体替换:真正的草稿 token 在上一步 GPU 采样完成之后、下一步输入准备之前,由模型执行器自己取出来并写入 InputBatch,根本不需要经过调度器。调度器这边只是在「下一步要几个验证位置」的记账里占个位。
pending_structured_output_tokens 的标记也建立在占位符上:只要这个请求使用结构化输出并且还有未结算的占位符,这一步就存在「语法要依赖上一步才能算出的 token」的可能性,因此要告知 EngineCore 这一拍的采样需要推迟(机制见后文「结构化输出」一节)。
流水并行的错拍标记只在 V2 模型执行器上启用:next_decode_eligible_step = current_step + decode_stagger。同步流水并行里,一条请求的 decode 结果要从最后一个 rank 回传到第一个 rank 才能进入下一步输入,这本身就有 pp_size 拍的固有延迟。异步调度在 V2 上把这个延迟显式写进请求状态,让调度器不要让这条请求在下一个 rank 准备好之前就进入下一拍。
预支账本如何流进块分配
_update_after_schedule 的基类部分还维护着另一个计数器 num_in_flight_tokens:
for req_id, num_scheduled_token in num_scheduled_tokens.items(): request = self.requests[req_id] request.num_computed_tokens += num_scheduled_token request.num_in_flight_tokens += num_scheduled_token ... request.is_prefill_chunk = request.num_computed_tokens < ( request.num_tokens + request.num_output_placeholders )这三个字段的关系值得厘清:
num_computed_tokens是调度器已经计划让 GPU 计算的 token 总数,在调度时就加上去(而不是等结果回来),因为下一步的分块预填需要据此继续切分;num_in_flight_tokens是已经调度、但结果还没有回到请求对象的 token 数,它在调度时加上、在update_from_output里按num_tokens_scheduled扣减;is_prefill_chunk是「这条请求还算不算预填」的判断:只要num_computed_tokens还小于「已确认 token + 占位符」的乐观总长,就说明预填还没走完。
异步调度在这里的影响是:num_tokens + num_output_placeholders 这个右端项被占位符抬高了,于是 is_prefill_chunk 在 decode 请求上更容易被判为 false——这正是异步调度想要的「decode 请求不要被当成还在预填」。但副作用是:如果在预填的最后一块里就预支了输出占位符,is_prefill_chunk 的边界会提前越过,_update_after_schedule 的异步部分会跳过这类请求(if request.is_prefill_chunk: continue)。这也是为什么 AsyncScheduler 只在 base 钩子算完 is_prefill_chunk 之后才预支占位符——顺序反了就会把「预填最后一块」误判成 decode。
块分配同样吃这笔账。KVCacheManager.allocate_slots 按 num_new_tokens 申请物理块,而 num_new_tokens 在调度循环里已经包含了这一步要验证的草稿位置:
num_new_tokens = ( request.num_tokens_with_spec + request.num_output_placeholders - request.num_computed_tokens)也就是说,异步调度会在采样结果还没回来之前就为「这一步可能采出的 token + 全部草稿位置」预留 KV 槽位。如果草稿全部被拒,这些槽位对应的 num_computed_tokens 与占位符会在 update_from_output 里回滚,但块本身不一定立刻归还:defer_block_free 会让释放请求按「栅栏序号」排队,直到确认没有在途的 GPU 写还在引用它才真正回池。这个「先按最坏情况占块、再按真实情况回滚」的流程,与调度器里「先按最坏情况记 token、再对账」是同一套哲学的两次应用。
抢占时这套账本必须一次清零,否则恢复后的请求会带着上一轮的占位符继续跑:
request.num_computed_tokens = 0if request.spec_token_ids: request.spec_token_ids = []request.num_stale_output_tokens = request.num_in_flight_tokensrequest.num_output_placeholders = 0这里 num_stale_output_tokens = num_in_flight_tokens 的意义是:在途 token 的结果还会回来,但不能再修改已经清零的计数;update_from_output 会按 num_tokens_scheduled 逐步「排干」这笔 stale 份额(num_stale_output_tokens -= num_tokens_scheduled),直到清零。若请求是可恢复的(resumable),safe_frontier = num_computed_tokens - num_output_placeholders 的约束保证恢复点不会越过任何未结算的 token。
一个具体的抢占场景能把这套对账完整走一遍:假设请求 R 在第 t 拍被调度了 4 个 token(1 个采样 + 3 个草稿),占了 num_output_placeholders = 4;第 t+1 拍调度时显存不足,R 被抢占。此时抢占代码把 num_computed_tokens 清零、num_output_placeholders 清零、num_stale_output_tokens = num_in_flight_tokens(此刻仍为 4)。第 t 拍的结果在 t+2 拍回来,update_from_output 发现 output_is_stale,于是跳过 token 写入与占位符扣减(因为占位符已经是 0,扣减会下溢),只把 num_stale_output_tokens 扣到 0。R 之后从等待队列重新调度,从长度为 0 的 KV 开始重算提示词——它此前算过的 KV 可能已被新请求覆盖。整个过程里没有哪一步「多扣」或「少扣」,这正是 output_is_stale 检查在每一处扣减前都要出现的原因。
边界条件与已知限制
异步调度的正确性建立在一份账、两处写之上:调度器写一次(预支),模型执行器写一次(回填与对账)。以下边界条件在这套结构下被显式处理,任何改动都需一并审视:
其一,请求在途被中止。EngineCore 在每个 worker 响应返回、update_from_output 执行之前,会先 _process_aborts_queue() 处理这一拍期间收到的中止请求。update_from_output 的循环里对 request is None or request.is_finished() 的请求直接跳过——注释点明这种情况在流水并行与异步调度里都会出现。被跳过的请求不再扣占位符,其 KV 块通过「块回收围栏」延迟归还。
其二,KV 装载失败(前缀缓存/P/D 分离)。kv_connector_output.failed_recving 涉及的请求会被移出本轮更新,num_computed_tokens 回退到「最后一批成功装载的块」的末尾,并要求重新计算失效块。异步模式下这个回退必须与占位符同步,否则下一步的 num_new_tokens 会基于错误的 num_computed_tokens 计算。
其三,扩散语言模型(diffusion LLM)。num_sampled_tokens_per_step 在扩散模型上是 0——没有 AR 的 bonus token,只有 canvas 上的 spec token 需要被验证。_update_after_schedule 的注释专门说明了这一点,意味着 diffusion 的异步调度在「预支多少」上与 AR 不同:只预支草稿位置,不预支额外采样位置。EngineCore 在 diffusion 配置下还会把 scheduler_cls 显式设为 vllm.v1.core.sched.diffusion_scheduler.DiffusionAsyncScheduler 或 DiffusionScheduler,说明扩散路径有自己一套占位符语义。
其四,多引擎与 DP。异步调度默认把 disable_nccl_for_dp_synchronization 置为 True,DP 同步改走 Gloo。注释给出的理由是 MoE 模型在 DP>1 时 NCCL 同步与异步流水冲突;这个默认值可以被用户覆盖,但覆盖后的行为需要单独验证。
其五,混合 KV Cache(Mamba、滑窗)。GPUModelRunner 在准备输入时有一段专门的跳过逻辑:
# Skipped under async scheduling (non-align): the CPU copy races with# the in-flight D2H copy and with input-batch row moves.needs_cpu_accepted_counts = self.num_accepted_tokens_event is not None and not ( self.use_async_scheduling and self.cache_config.mamba_cache_mode != "align")num_accepted_tokens 是投机解码(EAGLE 式动态树)里每个请求已接受 token 的计数,混合模型需要它来决定状态槽的回滚位置。异步调度下这份 CPU 副本与在途的 D2H 拷贝、以及 batch 行的重排(condense)会竞争,所以框架主动跳过读 CPU 副本,改在 GPU 上直接按 prev_positions 映射重排。这是「异步模式下所有 CPU 副本都要重新审视」的一个典型例子:一个在同步模式下理所当然的读取,在异步模式下变成了竞态源。站内 vLLM 混合 KV Cache 那篇(KVCacheCoordinator 如何让全注意力、滑窗与 Mamba 层共用一个块池)讲过这类模型的块池组织,异步调度在它之上再叠一层「迟一拍」的输入语义。
update_from_output:结果回来时怎么对账
update_from_output 在异步模式下做两件事:把在途的采样 token 写回请求对象(并扣减占位符),以及处理比预期少的 token(停止、KV 装载失败、投机被拒)。
先说返回 token 的写入:
def _update_request_with_output( self, request: Request, new_token_ids: list[int], is_stale: bool = False) -> tuple[list[int], bool]: num_new_tokens = len(new_token_ids) stopped = False for num_new, output_token_id in enumerate(new_token_ids, 1): request.append_output_token_ids(output_token_id) # Check for stop and update request state. stopped = check_stop(request, self.max_model_len) if stopped: # num_computed_tokens covers all new tokens but the last one. # Keep that true after trimming: resumable requests resume from it. if not is_stale: request.num_computed_tokens -= len(new_token_ids) - num_new del new_token_ids[num_new:] # Trim new tokens if needed. break
if not is_stale and request.num_output_placeholders > 0: # Resolve all returned tokens, including those trimmed at a stop. request.num_output_placeholders -= num_new_tokens assert request.num_output_placeholders >= 0 return new_token_ids, stopped几个关键点:
减的是「返回的 token 数」,不是「被采纳的 token 数」。注释里说得很清楚——「including those trimmed at a stop」。如果一个请求在停止符处被截断,append_output_token_ids 之后的循环提前 break,后面的 token 被删掉,但它们对应的占位符仍然在这笔扣减里结算。这是因为从调度器的视角,这一步已经预支了这么多 token,不管它们最终是否被保留,KV 都已经算过了,账本必须平衡。
num_computed_tokens 的回退。当请求被截断时,最后一个 token 的 KV 虽然被算了却没有进入输出列表,num_computed_tokens 要扣回去,否则可恢复请求(resumable)的恢复点会错位。可恢复请求这一族在取消与抢占那篇里讲过——流式会话结束一条、下一条从「已计算但未输出的最后一个 token 之前」继续。
is_stale 的语义。在 KV 装载失败或者请求被中途打断时,模型执行器可能返回了一批属于旧步骤的 token。这些 token 不能进入请求对象(否则客户端会看到重复或错序的输出),但占位符已经在调度时预支了,所以 is_stale 分支扣的是 request.num_in_flight_tokens。safe_frontier 的概念也来自这里:
safe_frontier = request.num_computed_tokens - request.num_output_placeholdersassert safe_frontier >= 0safe_frontier 是「不依赖任何在途结果的最小安全进度」——num_computed_tokens 里包含了预支的占位符,减去它们之后剩下的才是真正确定的 KV 长度。当一条请求被停掉需要恢复时,它必须从这个安全边界开始,而不是从乐观的 num_computed_tokens。
KV 块回收的延后一拍在异步模式下也有专门处理。注释说得很直接:
# Every GPU write enqueued by this and earlier steps has completed, so it is# safe to return deferred-free blocks to the pool.if self.defer_block_free and scheduler_output.total_num_scheduled_tokens > 0: self.processed_step_seq += 1 self._drain_deferred_frees() self._drain_deferred_loads()defer_block_free 即「延后释放」模式:一个块在被请求释放之后,不一定立即回到空闲池,因为可能还有一次已经入队但还没有真正执行完的 GPU 写(例如上一步调度里引用它写 KV)。异步模式下块释放一律走延迟队列——这正是取消与抢占那篇里说的「块回收的围栏」,在异步模式下变成了常态。
模型执行器:采样结果不落 CPU,直接当下一步的输入
光有调度器预支账本还不够。如果每步仍然要把 SamplerOutput.sampled_token_ids 拷回 CPU、传给 EngineCore、再由它传回给 GPUModelRunner 作为下一步的 input_ids,那条往返本身就吞掉了大半收益。异步调度的另一半在模型执行器里:采样结果留在 GPU 上,下一步的输入准备直接从 GPU 张量里填。
结果对象:AsyncGPUModelRunnerOutput
同步模式下 sample_tokens 直接返回 ModelRunnerOutput,里面 sampled_token_ids 是 Python 的 list[list[int]];异步模式下它返回 AsyncGPUModelRunnerOutput,其中的 token 还是 GPU 张量:
class AsyncGPUModelRunnerOutput(AsyncModelRunnerOutput): def __init__(self, model_runner_output, sampled_token_ids, logprobs_tensors, invalid_req_indices, async_output_copy_stream, vocab_size, ...): self._model_runner_output = model_runner_output self._invalid_req_indices = invalid_req_indices # Event on the copy stream so we can synchronize the non-blocking copy. # Blocking (sleep) event to avoid busy-polling the CUDA driver lock. self.async_copy_ready_event = torch.cuda.Event(blocking=True) # Keep a reference to the device tensor to avoid it being # deallocated until we finish copying it to the host. self._sampled_token_ids = sampled_token_ids
# Initiate the copy on a separate stream, but do not synchronize it. default_stream = torch.cuda.current_stream() with torch.cuda.stream(async_output_copy_stream): async_output_copy_stream.wait_stream(default_stream) self.sampled_token_ids_cpu = self._sampled_token_ids.to( "cpu", non_blocking=True ) ... self.async_copy_ready_event.record()这里有三个设计点:
拷贝发生在独立的 CUDA 流上。async_output_copy_stream 与默认流不同,它先 wait_stream(default_stream) 确保采样张量已经写完,然后把采样 token、logprobs、NaN 计数一次性非阻塞拷到已锁页的主机内存,最后在拷贝流上记录一个事件。整个过程中调用方没有被阻塞——sample_tokens 返回时,拷贝可能还在进行。
事件是 blocking=True 的。注释里解释了原因:拷贝流上的事件若用忙轮询来等,会一直占用 CUDA 驱动锁;用阻塞等待(线程休眠)可以把 CPU 核心让出去。这个细节说明异步调度在设计上是把等待做得「可被操作系统调度」,而不是把等待换成一个更快的忙等。
执行器给 EngineCore 的是一个 future。sample_tokens(..., non_block=True) 走 collective_rpc 的非阻塞路径,返回 FutureWrapper;EngineCore 把它压进 batch_queue 就继续去调度下一拍。真正阻塞发生在 future.result()。而「阻塞」这一步不是白等:worker 进程的响应线程在 enqueue_output 里先调用 get_output(),它才是整个异步链路上唯一真正 synchronize() 的地方:
def enqueue_output(self, output: Any): if isinstance(output, AsyncModelRunnerOutput): try: output = output.get_output() except Exception as e: ...get_output() 内部 self.async_copy_ready_event.synchronize() 之后,把 GPU 张量 tolist()(或经 RejectionSampler.parse_output),再替换掉 ModelRunnerOutput.sampled_token_ids 与 logprobs。换句话说,异步调度并没有消灭「从 GPU 把 token 拷回 CPU」这件事,它只是把这件事移出了关键路径:拷贝被启动的时机是「采样刚完成」,被消费的时机是「两步之后 EngineCore 真的需要这个结果来对账」。这两步之间,GPU 已经在跑第 t+1 步了。
_bookkeeping_sync:异步模式下账本只留「指针」
GPUModelRunner._bookkeeping_sync 是每步采样后把结果写回请求状态的地方,它在异步模式下的分叉点:
if not self.use_async_scheduling: with gpu_sync_allowed(): # Get the valid generated tokens. max_gen_len = sampled_token_ids.shape[-1] ...else: # Cache the sampled tokens on the GPU and avoid CPU sync. # These will be copied into input_ids in the next step # when preparing inputs. # With spec decoding, this is done in propose_draft_token_ids(). if self.input_batch.prev_sampled_token_ids is None: assert sampled_token_ids.shape[-1] == 1 self.input_batch.prev_sampled_token_ids = sampled_token_ids self.input_batch.prev_req_id_to_index = { req_id: i for i, req_id in enumerate(self.input_batch.req_ids) if i not in invalid_req_indices_set }同步模式在这里调 sampled_token_ids.to_list() 并逐个请求写进 req_state.output_token_ids,这是一次 CPU 同步,CPU 必须等 GPU 这一步完全结束;异步模式不做转换,只是把整块 GPU 张量挂在 InputBatch.prev_sampled_token_ids 上,并记下「这步每个请求在旧 batch 里的下标」prev_req_id_to_index。
在异步模式里,req_state.output_token_ids.extend(sampled_ids) 写进去的是 [-1]——模型执行器内部维护的请求状态也不保留真实值,只记录「这里有个 token 还没结算」。这个 -1 会一路传到 ModelRunnerOutput:
for req_idx in range(num_sampled_tokens): if self.use_async_scheduling: sampled_ids = [-1] if req_idx not in invalid_req_indices_set else None else: sampled_ids = valid_sampled_token_ids[req_idx]那么 update_from_output 在异步模式下拿到的 sampled_token_ids 是不是全是 [-1]?这里的时序值得说清楚。AsyncGPUModelRunnerOutput.get_output() 在 worker 的响应线程里先把真实值替换回 ModelRunnerOutput.sampled_token_ids,而 EngineCore 是在 future.result() 拿到的是已经过 get_output() 的 ModelRunnerOutput。所以调度器看到的仍然是真实 token;[-1] 存在于两个拍内的位置:一是模型执行器的 req_state(等待下一步回填),二是 InputBatch.sampling_metadata.output_token_ids(等待 update_async_output_token_ids 回填)。两处都是「同一拍内部」的中间态,不会漏到调度器。
下一步输入:GPU 上的 scatter_
下一步输入准备的关键在 GPUModelRunner._prepare_inputs(对应函数 _prepare_input_ids)里的 prev_sampled_token_ids 分支——这是异步调度「省掉往返」落地的最后一公里:
if self.input_batch.prev_sampled_token_ids is None: # Normal scheduling case self.input_ids.copy_to_gpu(total_num_scheduled_tokens) ... return
# Async scheduling case, where some decode requests from the previous# iteration won't have entries in input_ids_cpu and need to be copied# on the GPU from prev_sampled_token_ids.prev_positions = self.prev_positions.np[:num_reqs]for cur_index in range(num_reqs): prev_index = prev_positions[cur_index] if prev_index < 0: continue ... flattened_index = cu_num_tokens[cur_index].item() - 1 sample_flattened_indices.append(flattened_index - draft_len) spec_flattened_indices.extend( range(flattened_index - draft_len + 1, flattened_index + 1) )逐条拆:
prev_positions 建立了「当前 batch 下标 → 上一拍下标」的映射,新请求映射为 -1,直接跳过——它们的输入 token 全在 CPU 侧的 input_ids_cpu 里,照常上传。
flattened_index 是「这一步扁平化后的最后一个 token 的位置」。vLLM 把这一拍的输入拼成一条一维序列,每个请求占 num_scheduled_tokens 个位置,cu_num_tokens 是前缀和。最后一个位置前面的 draft_len 个位置放的是草稿 token,再前面一个位置才是「上一拍采样出来的 token」——也就是 flattened_index - draft_len。
草稿 token 也被单独记下标(spec_flattened_indices),因为它们同样不在 CPU 侧的 input_ids_cpu 里:调度器在 _update_after_schedule 把 spec_token_ids 填成了 -1,worker 侧的 _draft_token_ids 才是真值。
真正执行回填的两段代码,分别对应「batch 完全没变」与「batch 有增删/重排」:
if common_indices_match and max_flattened_index == (num_common_tokens - 1): # Common-case optimization: the batch is unchanged # and no reordering happened. # The indices are both the same permutation of 0..N-1 so # we can copy directly using a single slice. self.input_ids.gpu[:num_common_tokens].copy_( self.input_batch.prev_sampled_token_ids[:num_common_tokens, 0], non_blocking=True, ) return# Upload the index tensors asynchronously so the scatter can be non-blocking.sampled_tokens_index_tensor = torch.tensor( sample_flattened_indices, dtype=torch.int64, pin_memory=PIN_MEMORY).to(self.device, non_blocking=True)prev_common_req_indices_tensor = torch.tensor( prev_indices, dtype=torch.int64, pin_memory=PIN_MEMORY).to(self.device, non_blocking=True)self.input_ids.gpu.scatter_( dim=0, index=sampled_tokens_index_tensor, src=self.input_batch.prev_sampled_token_ids[prev_common_req_indices_tensor, 0],)稳态路径是一次 GPU 到 GPU 的切片拷贝。当这一拍的 batch 与上一拍完全相同、顺序也相同时,prev_sampled_token_ids[:, 0] 本身就按顺序对应每个请求最后一个位置,一句 copy_ 搞定——CPU 一行都不碰。
非稳态路径是 scatter_。下标张量先在 CPU 侧构造(pin_memory)再异步传到 GPU,然后用 scatter_ 把「上一拍的采样列」按 sample_flattened_indices 散布到这一拍的 input_ids 上。整个过程没有 CPU 读取 token 值,CPU 只知道位置。
上一步的采样张量还受输入准备事件的保护:
@contextmanagerdef synchronize_input_prep(self): if self.prepare_inputs_event is None: yield return # Ensure prior step has finished with reused CPU tensors. # This is required in the async scheduling case because # the CPU->GPU transfer happens async. self.prepare_inputs_event.synchronize() try: yield finally: self.prepare_inputs_event.record()CPU 侧的 input_ids_cpu 这类张量在两步之间是复用的,异步上传是 non_blocking=True 的,所以第 t+2 拍准备输入前必须确保第 t+1 拍已经用完这些主机缓冲——prepare_inputs_event 就是这把锁。注释里说得直白:「prior step has finished with reused CPU tensors」。
这一步「只改位置、不读值」的做法,与 V1 从一开始追求的方向一致:调度输出是一个 {request_id: num_tokens} 的字典,下一拍的输入尽量复用上一拍已经落盘的持久化 buffer。异步调度把这个思路再推进一层——连「上一拍最后一个 token」也只在 GPU 上原地搬移,CPU 全程不读它的值。
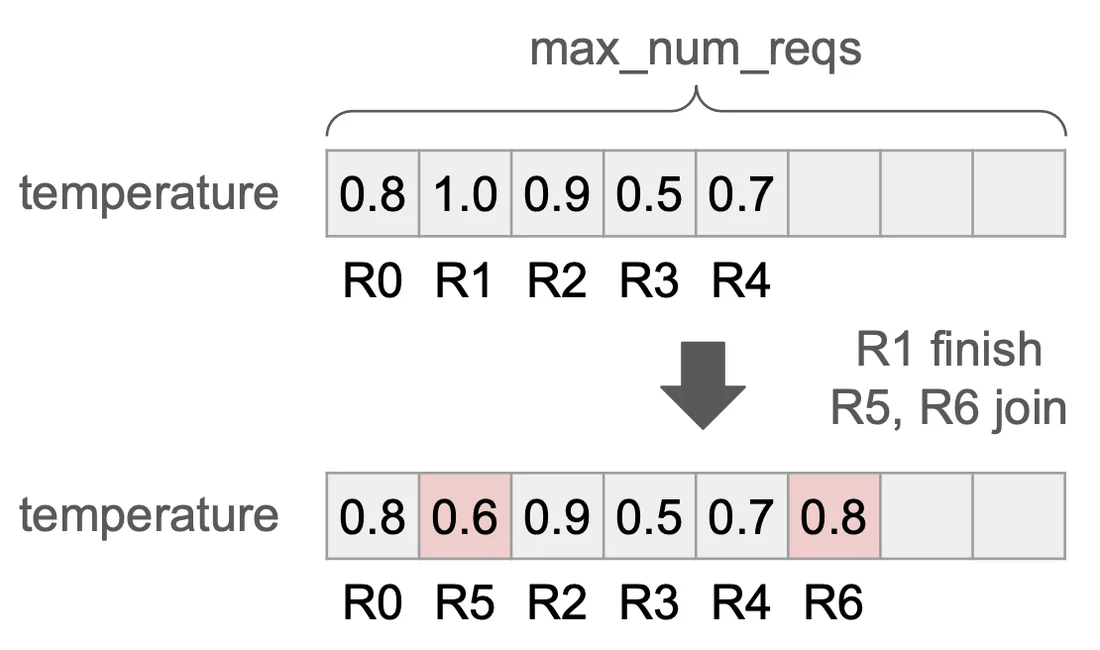
图 3:V1 的持久化批处理概念图——请求进出时只做局部压缩,不重建整套输入张量。异步调度的 prev_positions 到 prev_req_id_to_index 这套映射,正是建在这套「位置稳定」的持久化 batch 上的。来源:vLLM V1 发布博客。
按需的 CPU 侧副本:update_async_output_token_ids
那 CPU 什么时候才需要 token 的真值?两个时机:下一步采样要做 logits 处理(重复惩罚、bad_words、logprobs、结构化输出);以及需要把 token 交给输出处理器。第一个时机发生在 GPUModelRunner._sample 之前:
# Update output token ids with tokens sampled in last step# if async scheduling and required by current sampling params.self.input_batch.update_async_output_token_ids()InputBatch 的实现:
def update_async_output_token_ids(self) -> None: """In async scheduling case, update output_token_ids in sampling metadata from prior steps sampled token ids once they've finished copying to CPU. This is called right before they are needed by the logits processors. """ output_token_ids = self.sampling_metadata.output_token_ids if self.sampled_token_ids_cpu is None or not output_token_ids: # Output token ids not needed or not async scheduling. return assert self.prev_req_id_to_index is not None ... if sampled_token_ids is None: assert self.async_copy_ready_event is not None self.async_copy_ready_event.synchronize() sampled_token_ids = self.sampled_token_ids_cpu.tolist()这段代码的信息量很大,逐条看:
「按需同步」。sampled_token_ids_cpu is None 意味着这一步的采样参数不需要输出历史(无 presence_penalty、frequency_penalty、bad_words、结构化输出),于是同步直接被跳过——GPU 采样后的张量根本不必拷回 CPU。这是异步调度最干净的路径:每一步 CPU 只在「准备下一拍」和「回收上一拍结果」时与 GPU 发生最小交互。
占位替换是按请求逐个做的,不是整体覆盖。因为 batch 的组成在两拍之间可能变了(新请求加入、完成请求离开),prev_req_id_to_index 记下的是上一拍的下标,按 req_id 查回当前拍的 output_token_ids。新加入的请求没有上一拍下标,直接跳过;离开的请求在当前拍不存在,也无须处理。
-1 是占位符的哨兵值。当前拍的 output_token_ids 末尾是 -1,表示「上一拍采出来的值还没落回 CPU」。while 循环找到末尾连续 -1 的起点,然后把上一拍的采样值复制进去:
first_placeholder = len(req_output_token_ids)while ( first_placeholder > 0 and req_output_token_ids[first_placeholder - 1] == -1): first_placeholder -= 1num_placeholders = len(req_output_token_ids) - first_placeholdernum_to_replace = min(num_sampled_ids, num_placeholders)del new_ids[num_to_replace:]req_output_token_ids[first_placeholder:] = new_ids占位数与真实数不一致是常态,这段代码显式承认了两种偏移:
- 占位符可能多于实际采样值:投机解码时调度器会乐观地多预支几个草稿位,接受数比草稿数少时就会多出来。
del new_ids[num_to_replace:]截断采样值,末尾剩下的-1在下一步被当作「不存在的 token」,后续预算计算会自动排除。 - 占位符可能少于采样值:KV 装载失败时 token 会被丢弃。
min取小,多余的采样值不要。
num_sampled_ids 的计算方式尤其值得注意:len(new_ids) if new_ids[-1] != -1 else new_ids.index(-1)。采样输出里末尾可能是 -1(表示这个请求这一步没有被接受任何 token,例如投机验证全部被拒),这时真实数量要取第一个 -1 的位置。
sampled_token_ids_cpu 本身不是每步都准备。它在 set_async_sampled_token_ids 里被挂上,而且只在需要时挂:
if self.sampling_metadata.output_token_ids: self.sampled_token_ids_cpu = sampled_token_ids_cpu self.async_copy_ready_event = async_copy_ready_eventelse: self.sampled_token_ids_cpu = None self.async_copy_ready_event = Nonesampling_metadata.output_token_ids 是否为空,取决于这一拍有没有请求用到「历史 token」——没有惩罚、没有 bad_words、不做 logprobs、不跑结构化输出。绝大多数纯贪心或纯温度采样的解码请求根本不需要它,于是 CPU 那侧的拷贝虽然已经在拷贝流上入队,但没有任何人 await 它。
与批队列的配合:step_with_batch_queue
上面这些机制在 EngineCore 里汇合,入口是 step_with_batch_queue——异步调度开启时 EngineCore 走的就是这条路径(因为 max_concurrent_batches 至少为 2):
if self.scheduler.has_requests(): scheduler_output = self.scheduler.schedule(self._should_throttle_prefills()) with self.log_error_detail(scheduler_output): exec_future = self.model_executor.execute_model( scheduler_output, non_block=True ) ... if not scheduler_output.pending_structured_output_tokens: # We aren't waiting for any tokens, get any grammar output # and sample immediately. grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output) future = self.model_executor.sample_tokens(grammar_output, non_block=True) else: # We need to defer sampling until we have processed the model output # from the prior step. deferred_scheduler_output = scheduler_output
if not deferred_scheduler_output: # Add this step's future to the queue. batch_queue.appendleft((future, scheduler_output, exec_future)) if len(batch_queue) < self.batch_queue_size and ( model_executed or self.scheduler.has_requests() ): # Don't block on next worker response unless the queue is full # or there are no more requests to schedule. return None, model_executed...# Block until the next result is available.future, scheduler_output, exec_model_fut = batch_queue.pop()model_output = future.result()self._process_aborts_queue()engine_core_outputs = self.scheduler.update_from_output( scheduler_output, model_output)三件事串起来:
一批进队列立刻返回。调度完这一步后,把 (采样 future, scheduler_output, 执行 future) 压进队尾(appendleft 在双端队列的头部插入,pop() 在尾部取出,所以先进先出),只要队列没满就直接 return None——CPU 不在这一拍上等任何东西,马上去调度下一拍。
对账发生在「队满」或「无事可调」时。batch_queue.pop() 取出最早那一批的 future 并 result(),这才是 CPU 真正阻塞的点;阻塞返回后立刻用这个结果调 update_from_output,把第 t 步的账对完。
「有在途 token 需要语法」的请求被推迟采样。当 pending_structured_output_tokens 为真,这一拍不做 sample_tokens,只把 execute_model 的 future 放进队列,scheduler_output 记为 deferred_scheduler_output,等到下一拍取出时再补做语法掩码与采样:
if deferred_scheduler_output: ... draft_token_ids = self.model_executor.take_draft_token_ids() ... grammar_output = self.scheduler.get_grammar_bitmask(deferred_scheduler_output) future = self.model_executor.sample_tokens(grammar_output, non_block=True) batch_queue.appendleft((future, deferred_scheduler_output, exec_future))这就是结构化输出的代价:它在双缓冲里多占了半个槽位,采样被后移一拍,但前向本身不受影响。deferred_scheduler_output 携带的模型输出(logits)被保存在 worker 侧,等语法机拿到「上一拍的 token」再计算掩码并采样。对 TTFT 影响不大,对 TPOT 的影响取决于语法请求在 batch 中的比例。
投机解码与异步调度:占位草稿与真实草稿的两段写入
投机解码在异步模式下需要额外处理,因为存在两类 token 都需要「迟一拍」:
- 采样出的真实 token:这是上一步的
SamplerOutput,异步调度让它留在 GPU; - 草稿模型/草稿头生成的下一个 token:这是上一步末尾跑草稿产生的候选位置,下一步验证要用到。
同步模式下这两类都走 CPU:采样 token 拷回来,草稿 token 拷回来,回填到 spec_token_ids 里。异步模式下它们必须分开处理。
先看草稿侧。Scheduler.post_step 在同步模式下从执行器取草稿 token,异步模式下这一步被跳过:
def post_step(self, model_executed: bool) -> None: # When using async scheduling we can't get draft token ids in advance, # so we update draft token ids in the worker process and don't # need to update draft token ids here. if self.check_for_draft_tokens and not self.async_scheduling and model_executed: draft_token_ids = self.model_executor.take_draft_token_ids() if draft_token_ids is not None: self.scheduler.update_draft_token_ids(draft_token_ids)草稿的「真实值」被推给了 worker:在 GPUModelRunner 里,下一步输入准备前,执行器自己从 _draft_token_req_ids 对应的草稿输出里取出 token,写进 InputBatch:
if self.use_async_scheduling and self._draft_token_req_ids is not None: draft_token_ids_cpu, _ = self._get_draft_token_ids_cpu() self.input_batch.update_async_spec_token_ids(draft_token_ids_cpu)这一步只在「需要历史输出」时才做:注释写着「only when output_token_ids is needed (penalties or bad_words are in use)」。不需要时,草稿 token 根本不需要让 CPU 看到值——它们只在下一次前向里作为「待验证位置」被 GPU 读到。
另外,占位符还是调度器与 worker 之间的一份显式契约。调度器在构造 CachedRequestData 发给 worker 时,输出长度也带着占位符一起发过去:
num_output_tokens.append( req.num_output_tokens + req.num_output_placeholders)worker 因此被要求把「已确认的输出 token + 预支的占位 token」当作这条请求的当前输出长度来准备输入,而不是等下一步从调度器再拿一次真实值。
模型执行器内部同样保留着占位符语义——_bookkeeping_sync 在异步模式下写进 req_state.output_token_ids 的是 -1:
if self.use_async_scheduling: sampled_ids = [-1] if req_idx not in invalid_req_indices_set else Noneelse: sampled_ids = valid_sampled_token_ids[req_idx]这一组 [-1] 写进 req_state.output_token_ids 后,就成了下一步采样时 sampling_metadata.output_token_ids 末尾的占位位——也就是 update_async_output_token_ids 要回填的位置。调度器与输出处理器之间走的仍然是真实 token(由 get_output() 在响应线程里回填),-1 只存在于模型执行器内部、并跨过一拍。
草稿的「验证」与「拒绝」也在调度器里用占位符对齐。update_from_output 对每个调度过草稿的请求算出一笔拒绝账,并在异步模式下从两个计数里同时扣掉:
num_draft_tokens = len(scheduled_spec_token_ids)num_sampled = self.num_sampled_tokens_per_stepnum_accepted = max(len(generated_token_ids) - num_sampled, 0)num_rejected = num_draft_tokens - num_accepted# Rejections roll back num_computed_tokens (and, under async# scheduling, num_output_placeholders, which covers the spec# tokens). A stale rejection count predates the preemption# rollback and must not apply.if not output_is_stale: if request.num_computed_tokens > 0: request.num_computed_tokens -= num_rejected if request.num_output_placeholders > 0: request.num_output_placeholders -= num_rejected这里的 num_sampled 是每步必采的 token 数——在投机验证里它对应「接受若干个草稿之后额外补采的那个 bonus token」。len(generated_token_ids) - num_sampled 即被验证接受的草稿数。被拒的草稿 KV 白算了,所以要回滚 num_computed_tokens;但它们在调度时已经被计入了占位符,所以占位符也要同额回滚。output_is_stale 的检查同样必要——如果这一步的输出本来就属于更早一次被抢占回滚过的旧账,再扣一次就会把占位符扣成负数。
补充一个容易被忽略的点:KV 块的回收在异步模式下默认走延迟队列(
defer_block_free),被拒草稿占过的块不一定当拍归还。这与 请求的取消与抢占:五个推理框架的五条回收路径 里讨论的块回收围栏是同一个机制,只是异步调度把它变成了常态路径。
惩罚计算:update_async_spec_token_ids
InputBatch.update_async_spec_token_ids 专门处理「惩罚/受限采样需要看到草稿值」的情形——草稿被用于 presence_penalty 的计数时,CPU 必须知道它的真实值,所以在 rejection_sampler 被调用之前,把真实草稿替换进去:
def update_async_spec_token_ids(self, draft_token_ids: list[list[int]]) -> None: """In async scheduling case, update spec_token_ids in sampling metadata with real draft token ids from prior step. This is called right before they are needed by the rejection sampler for penalty/bad_words computation. """ if not draft_token_ids or not self.prev_req_id_to_index: return if (spec_token_ids := self.sampling_metadata.spec_token_ids) is not None: for req_id, spec_ids in zip(self.req_ids, spec_token_ids): if spec_ids: prev_index = self.prev_req_id_to_index.get(req_id) if prev_index is not None: draft_ids = draft_token_ids[prev_index] if draft_ids: del draft_ids[len(spec_ids) :] spec_ids.clear() spec_ids.extend(draft_ids)del draft_ids[len(spec_ids):] 同样是「占位数可能多于实际草稿数」的截断保护——调度器乐观预支的位置,实际草稿头不一定生成了那么多,多的位置不进入惩罚计算。
结构化输出:语法机不能在占位符上工作
结构化输出(JSON Schema / 正则 / EBNF)的限制采样依赖两件事:一个用「已生成 token 前缀」驱动的 FSM 状态,以及每步根据 logits 计算的 bitmask。异步调度下,「已生成前缀」的末尾是 -1 占位符,语法机没法在它上面推进。
调度器在 _update_after_schedule 里把这类请求标记出来:
scheduler_output.pending_structured_output_tokens |= ( request.use_structured_output and request.num_output_placeholders > 0)pending_structured_output_tokens 是 SchedulerOutput 上的一个布尔字段。它的作用相当于告诉 EngineCore:「这一步里至少有一个请求的语法状态依赖上一步的采样结果」。EngineCore.step_with_batch_queue 据此把采样推迟一拍:只要该标记为真,这一拍只提交 execute_model(前向与 logits 计算不受影响),采样 future 留到下一拍、等上一拍的 token 真正回来后,用真实前缀算语法 bitmask 再提交:
if not scheduler_output.pending_structured_output_tokens: grammar_output = self.scheduler.get_grammar_bitmask(scheduler_output) future = self.model_executor.sample_tokens(grammar_output, non_block=True)else: # We need to defer sampling until we have processed the model output # from the prior step. deferred_scheduler_output = scheduler_output在延迟采样那一拍里,模型执行器的状态(logits、隐状态)被保留在 worker 侧,等 deferred_scheduler_output 被处理时再调 sample_tokens。换句话说,语法约束的正确性没有被牺牲,代价是「语法请求」在双缓冲里多占半个槽位、采样被后移一拍。注意这个标记是整批的,不是逐请求的:只要 batch 里有一个结构化输出请求带着未结算占位符,整批的采样都会被推迟。所以在结构化输出-heavy 的负载里,异步调度可能让所有请求的 TPOT 都多一拍——这是引擎层面的 amortization 取舍,而非逐请求优化。
站内结构化输出那篇讲过「语法掩码的增量计算」——异步调度把「更新语法状态」与「使用掩码采样」这两个原本同步的动作拆到了两拍,工程实现必须保证 worker 侧保留的 logits 与延迟后的 bitmask 是对应同一批请求的。
流水并行与 V2 模型执行器:错拍解码
V1 模型执行器的异步调度不支持流水并行——这是 VllmConfig 初始化里那条硬性不兼容判断,显式开启会抛错、默认开启会降级。原因在于 V1 的请求状态是「调度器一份、worker 一份」各自记账的:PP 下采样只发生在最后一个 rank,而第一步的输入需要每个 rank 都预支同一个占位符,V1 没有为这条链路设计统一的采样广播与回填,所以直接判定为不兼容。
V2 模型执行器上这条路走通了,但要额外记一笔账。采样只发生在最后一个 rank,第一步的输入在各个 rank 之间有序传播;同步模式下最后一个 rank 采出 token 后回传第一个 rank,第一个 rank 才能在下一拍准备输入。异步调度把部分回传留在 GPU 上:sample_tokens 里若 use_async_scheduling、PP 世界大小大于 1、且当前是最后一个 rank,就调用 _pp_broadcast_prev_sampled_token_ids(sampled_token_ids) 把采样张量广播给其他 rank;其他 rank 在下一步的 _bookkeeping_sync 路径被跳过(execute_model_state is None)时,用 _pp_receive_prev_sampled_token_ids_to_input_batch() 收下:
if self.execute_model_state is None: kv_connector_output = self.kv_connector_output self.kv_connector_output = None # receive sampled token ids from the last PP rank. if self.use_async_scheduling and not get_pp_group().is_last_rank: self._pp_receive_prev_sampled_token_ids_to_input_batch() return ModelRunnerOutput.with_kv_conn_output_only(kv_connector_output)decode_stagger 就是为这个节拍对齐而生:当 V2 模型执行器启用时,next_decode_eligible_step = current_step + decode_stagger,一条请求至少隔 decode_stagger 拍才能再次解码。默认值是 pp_size,也就是说每一条请求在 pp_size 拍之内只能出现一次 decode。注释里说这个值与 worker 侧采样 token 广播的 slot ring 节拍匹配——把「错拍」写进调度器的判断,而不是靠同步去保证。若平台上禁用 PP 解码微批(XPU 的 VLLM_XPU_PP_MICROBATCH 未开),decode_stagger 退化成 1,也就是每一拍都可以解码。
调度循环里对应的判断:
if self.current_step < request.next_decode_eligible_step: # V2+PP+async: enforce `pp_size` steps between same-req decodes # to match worker-side sampled-tokens broadcast slot ring cadence. req_index += 1 continue一张图看懂:双缓冲里两拍之间发生了什么
把上面的机制拼成一条时间线。同步模式的 step 一次只处理一拍,调度、执行、取结果、对账严格串行:
同步(单缓冲):时间 →CPU schedule(S_t) ──────────────┐ 等待 future.result() ┌ update(S_t) ─ schedule(S_{t+1})GPU execute(S_t) → sample → D2H ───────────┘ ↑ GPU 跑完后,CPU 才能继续异步模式(step_with_batch_queue,队列容量 2)的稳态是「排队—取结果」交替:
异步(双缓冲):时间 →CPU schedule(S_t) → execute(S_t) 入队 → 立刻返回 schedule(S_{t+1}) → execute(S_{t+1}) 入队 → 队列满 pop(S_t) → future.result() 等待 update(S_t) → schedule(S_{t+2}) ...GPU execute(S_t) → sample execute(S_{t+1}) → sample对应到账本上:
S_t 调度时: num_output_placeholders += 1 (AR 采样) + k (草稿) spec_token_ids = [-1] * k
S_t 结果回来时 (update_from_output): 真实 token 写回 request num_output_placeholders -= 返回的 token 数 被拒草稿: num_computed_tokens -= num_rejected num_output_placeholders -= num_rejected异步模式换来的是:同一时刻,CPU 在准备第 t+2 拍的计划,而 GPU 还在跑第 t+1 拍;采样结果的 D2H 拷贝被启动在第 t 拍,消费在第 t+1 拍的对账里。代价是调度器必须一直带着至少一批「在途账」运行,且模型执行器内部任何需要精确输出 token 的子系统(惩罚、语法、logprobs)都必须知道 -1 是占位符。
收益与代价:什么时候该开,什么时候不该开
vLLM 引擎参数文档对 --async-scheduling 的描述只有一句话:「helps to avoid gaps in GPU utilization, leading to better latency and throughput」。这句话里的关键词是「避免 GPU 空转间隙」——它要省的不是 GPU 的计算量,而是 GPU 等 CPU 的那段时间。在 decode 阶段,GPU 单步的计算本身就很短;真正决定每 token 延迟的往往是 CPU 侧的调度、记账与同步往返。异步调度把这些 CPU 工作从「GPU 执行期间」挪到「GPU 执行期间照常进行」,让 GPU 的利用率曲线更平。
但「默认开」不等于「任何场景都更好」。结合源码里的几条硬性判断,可以归纳出异步调度的适用边界:
适合的场景:纯 AR 解码为主、无结构化输出或结构化输出比例很低、无投机解码或使用 V1 兼容的 EAGLE/N-gram 系投机、单机多卡(无流水并行)、CPU 主频较低但核心充足的部署(调度开销占比高时收益明显)。vLLM 在 VllmConfig 里对池化模型(embedding/rerank)专门关闭默认异步调度,注释写明「negatively impacts performance of pooling models」——池化请求一次前向就完成,没有「连续 decode 步」可重叠,反而被双缓冲拖累。
需要显式关闭的场景:ROCm + DeepEP 高吞吐 DBO(与异步调度同时开启会破坏 DP+EP 的生成精度,代码里直接禁止);V1 模型执行器 + 流水并行;V1 + Medusa 式多头草稿或其他未经草稿头对齐的投机方法;使用不支持异步调度的分布式执行器后端。
组合时需要实测的场景:结构化输出(整批采样被推迟一拍)、惩罚/bad_words/logprobs(每步都要 CPU 侧真实 token 副本)、高比例短请求(调度工作量本身很小,收益低而状态复杂度不变)。
它的代价可以归纳成四条:
- 增加状态复杂度。
num_output_placeholders、prev_sampled_token_ids与-1哨兵在三层代码里(调度器、模型执行器、引擎核心的批队列)都要保持一致;任何一处漏减/漏替换,结果都是「输出错位」或「请求卡住不退」。新写调度相关代码时,最常犯的错就是在update_from_output的某个早退分支里忘了扣占位符。 - 对依赖精确前缀的子系统加了一拍延迟。结构化输出整批推迟采样,惩罚与
bad_words需要跨流同步等 CPU 副本,停止条件的判定要在「最坏情况」下保守推算。 - 投机解码的收益被削薄。异步调度的成本大头在「CPU 与 GPU 的同步往返」,投机解码用一次前向产出多 token,同样降低了每一步中同步的占比——两者在「每 token CPU 开销」这个维度上部分替代,组合时的收益不一定线性叠加,需要实测。
- 与 DP/EP、故障恢复的耦合更紧密。异步调度默认会把 DP 同步从 NCCL 切到 Gloo(
disable_nccl_for_dp_synchronization),因为异步模式下 NCCL 的 DP 同步会与调度流水冲突;开启故障恢复时这个设置又必须关掉。这类组合规则散落在配置校验里,部署时值得逐条核对。
在 AsyncScheduler 之外,vLLM 这套机制的抽象其实很值得借鉴:「以最坏情况预支账本、在结果回来时对账」 是任何想把 CPU 从 GPU 关键路径上摘掉的系统都可以用的模式。DeepInfer 的 ZOS 用「延后一拍」做同样的事:调度结果不是预支给执行器,而是延后一层落到自己的状态机上,并在延后期间用估计器修正 seqlens——细节可以参考 DeepInfer 源码完全拆解(二):异步调度与零开销调度 ZOS。SGLang 的 Overlap Scheduler 用的是「两条流」的思路,让 CPU 调度和 GPU 执行在两套独立流上各跑各的、只在关键同步点汇合(详见 SGLang 源码完全拆解(六):Overlap Scheduler)。三者在同一个问题上走的是三条路:vLLM 预支账本、DeepInfer 延后一拍、SGLang 双流并行。哪条路在什么硬件与场景下最合适,取决于系统的同步粒度与 batch 形态。
小结
异步调度是 vLLM V1 里「调度器与执行器解耦」的极端形态。它把 EngineCore 的两批在途、调度器的 num_output_placeholders 预支、模型执行器的 GPU 常驻采样、输入准备的 scatter_ 回填与输出对象的异步流拷贝串在一起,把 CPU 从「等 GPU 采样」的关键路径上移了出去。代价是整套引擎必须把「在途结果」当作一等状态来管理:调度器按最坏情况预支算账、执行器按真实结果对账、输入准备按占位符回填、语法机推迟采样、投机解码分两段写入草稿。
读懂它之后,再回看 step_with_batch_queue 里的「一批进队立刻返回、队满才取结果」,它的含义已经与同步模式完全不同:那不再是一次等待,而是一次「把这份计划交给 GPU、我自己去准备下一份」的交接;而 num_output_placeholders 就是这次交接的欠条。
下一篇将讨论 vLLM 的可视化调度诊断:当一条请求的 TTFT 异常升高、或者 update_from_output 里的对账数字与客户端看到的 token 数对不上时,如何从 EngineCore 的指标、batch_queue 的长度与 num_output_placeholders 的演变里定位问题;以及异步调度开启后,Metrics 中哪些时间戳的语义发生了变化。这条诊断链路与本文的账本机制直接衔接:不理解「两批在途」,就看不懂为什么一条请求的 IterationDetails 会跨两个 step。
延伸阅读:
- vLLM 源码完全拆解(二):从 add_request 到 EngineCore.step,一次请求如何穿过 V1 引擎——本文反复引用的
EngineCore.step在这里被逐行拆过; - vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block——占位符是如何进入
num_new_tokens预算的,在这篇里能看到完整上下文; - vLLM 源码完全拆解(五):GPUModelRunner 如何把动态请求拼成一次 GPU 前向——
InputBatch的字段与condense/swap_states在这里; - vLLM 源码完全拆解(九):Sampler——从 Logits 到 Token 的采样管线与输出回传——
SamplerOutput的结构与logprobs的计算; - vLLM 源码完全拆解(十):投机解码——草稿模型、批量验证与 token 接受流水线——
num_sampled_tokens_per_step与接受/拒绝账的原始出处; - vLLM 源码完全拆解(十五):停止条件与增量解码——stop string、detokenizer 流水线与输出回传——真实 token 回到客户端的那一段;
- DeepInfer 源码完全拆解(二):异步调度与零开销调度 ZOS——把 CPU 后处理移出关键路径——同一问题的另一种解法;
- SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行——双流重叠的第三种解法。
参考资料
- vLLM V1: A Major Upgrade to vLLM’s Core Architecture
- vLLM 设计文档
- vLLM 引擎参数(Engine Arguments)
- vLLM 源码:
vllm/v1/core/sched/async_scheduler.py - vLLM 源码:
vllm/v1/core/sched/scheduler.py - vLLM 源码:
vllm/v1/worker/gpu_input_batch.py - vLLM 源码:
vllm/v1/worker/gpu_model_runner.py - vLLM 源码:
vllm/v1/engine/core.py - vLLM 源码:
vllm/v1/outputs.py - vLLM 源码:
vllm/v1/executor/multiproc_executor.py - vLLM 源码:
vllm/config/scheduler.py - vLLM 源码:
vllm/config/vllm.py
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



