


llama.cpp 源码完全拆解(二十八):ggml-cuda 的 RoPE 家族——两种布局、YaRN 修正与融合 norm-rope kernel
RoPE 是 llama.cpp 计算图里出现频率最高的算子之一:每一层、每一个 token、每一份 Q 和 K 都要过一次旋转。它看起来只是「按位置查一对 cos/sin,做四次乘加」,但真正落到 GPU 上,会牵出一串不那么显然的工程问题:cos/sin 是预计算成表还是每个线程现算?一个头的 128 维在内存里怎么摆放,决定了线程该读哪两个元素;部分旋转(只转前 64 维)怎么处理剩下的维度;YaRN 的长度外推修正为什么要写成一个分段线性 ramp;多模态模型的 M-RoPE 又如何把位置拆成时间、高度、宽度三段。
这篇文章只读一个文件:ggml/src/ggml-cuda/rope.cu。它在 llama.cpp 的 CUDA 后端里独自承担了全部旋转位置编码,包含四个前向 kernel(rope_norm、rope_neox、rope_multi、rope_vision)、一个用于反向传播的模板分支,以及一个把 RMSNorm 和 RoPE 融进同一趟访存的 rms_norm_mul_rope_f32。读懂它的价值不只是「知道 RoPE 怎么写」,而是能看到一个推理框架如何在最底层的 kernel 里做取舍:牺牲一点重复计算,换掉一张可能要跟着序列长度增长的 cos/sin 表;牺牲一个通用 kernel 的可读性,换掉一次额外的显存往返。
先看清 RoPE 在计算图里的位置
在进入 kernel 之前,需要先把 llama.cpp 里 RoPE 的调用形态固定下来。否则很容易把「数学上的旋转」和「工程上的张量布局」混为一谈。
一个 ggml_rope_ext 节点携带的全部参数
llama.cpp 的模型图在 llama-graph.cpp 里构建,注意力部分大致是:Q/K 经过线性投影和可能的 QK-Norm 之后,分别接一个 ggml_rope_ext 节点。这个节点的函数签名比教科书写法长得多,因为它要把所有长度外推和布局约定都编码成参数:
struct ggml_tensor * ggml_rope_ext( struct ggml_context * ctx, struct ggml_tensor * a, // 输入,形状 [head_dim, n_head, n_tokens] struct ggml_tensor * b, // 可选的位置张量(mrope 时为 [4, n_tokens]) struct ggml_tensor * c, // 可选的频率因子张量 int n_dims, // 实际参与旋转的维度数,常见等于 head_dim int mode, // 布局与变体:NORM / NEOX / MROPE / VISION 等 int n_ctx_orig, // 训练时的原始上下文长度,YaRN 修正用 float freq_base, // 基频,常见 10000 或 500000 float freq_scale, // 位置缩放,PI 时为 1/scale float ext_factor, // 外推强度,0 表示纯内插 float attn_factor,// 注意力温度补偿 float beta_fast, // YaRN 修正的快速边界 float beta_slow // YaRN 修正的慢速边界);这些参数里,n_dims、mode、freq_base、freq_scale 决定「旋转什么、怎么摆」,n_ctx_orig、ext_factor、attn_factor、beta_fast、beta_slow 决定「超长时怎么修正」。后面的 kernel 分析会逐一落到它们身上。
为什么 llama.cpp 不预计算 cos/sin 表
多数推理框架会给每个模型预先算一张 [max_position, head_dim/2] 的 cos/sin 缓存,kernel 里只做查表。llama.cpp 的 CUDA 路径没有这么做:rope.cu 里没有任何 cos/sin 张量,每个线程在寄存器里现算自己那一对角度。原因有三层。
第一,表的大小和「最大位置」绑定。llama.cpp 支持运行时改上下文长度、支持 --rope-scaling 的多种组合,还可能在同一进程里切换 LoRA 或不同的 RoPE 配置;一张按最大长度预分配的表会把这些自由度变成显存和初始化时间的开销。现算则把成本摊到每次前向,且与序列长度无关。
第二,RoPE 的每个角度只被用到一次。对 decode 阶段的一个 token,n_dims/2 = 64 个角度,乘上 32 层的 Q 和 K,也不过几千次 powf。这些计算与同时发生的矩阵乘、KV 读取相比完全可以藏在访存延迟里;而预计算表反而要多一次全局内存读取,解码时显存带宽才是稀缺资源。llama.cpp 的选择本质上是拿空闲的 SFU(特殊函数单元)算力,换掉一次全局访存。
第三,现算让 YaRN 的修正可以逐线程完成,不需要在宿主侧维护一张「按维度分段」的修正表。代价是每个线程都要执行一次 rope_yarn_ramp 的分段判断,这正是下一节要拆开的部分。
四个 kernel 的分工:布局决定一切
rope.cu 里并排躺着四个 __global__ 函数,它们的数学完全一样,差别只在「一个头的维度在内存里怎么排」以及「位置从哪来」。先把分工列成表,再逐个拆。
| kernel | 维度配对方式 | 位置来源 | 典型使用者 |
|---|---|---|---|
rope_norm | 相邻配对:第 对是 | 单个 pos | GPT-J 风格、部分自定义模型 |
rope_neox | 前后半配对:第 对是 | 单个 pos | LLaMA、Qwen、Mistral 等主流 decoder |
rope_multi | 同 rope_neox,但按 section 选不同位置 | 位置张量给出 4 段 | Qwen2-VL 一类多模态模型 |
rope_vision | 二维:行、列各一套频率 | 位置张量给出 2 段 | 视觉编码器(ViT) |
这四者的选择不是运行时按张量形状自动推断,而是由 mode 里的位标志决定,在 ggml_cuda_rope 的宿主侧代码里分支。这样做的原因是布局属于模型定义的一部分,同一个 head_dim 既可能是 interleaved 也可能是 split-half,靠形状无法区分。
角度是怎么算出来的:theta_scale 与 rope_yarn
把四个 kernel 的公共部分抽出来,核心只有六行:算基准角、套 YaRN 修正、算 cos/sin、乘温度系数、做旋转、写回。真正值得逐行看的是「基准角」和「修正」这两步。
基准角只算一次标量,指数在设备上累乘
宿主侧在启动 kernel 之前先算好一个标量:
const float theta_scale = powf(freq_base, -2.0f / n_dims);它对应 RoPE 定义里的 :第 对维度()的频率是
把 提到宿主侧算一次,设备端每个线程只需要一次 powf(theta_scale, iw/2.0f)。这里的 iw 是相对旋转窗口的维度下标(i0 - n_offs),除以 2 是因为线程以「一对」为单位工作。这个写法避免了每个线程都去算一次以 为底的幂,但保留了 powf——为什么不把整张频率表也预计算?因为表的长度是 (通常 64 或 128),很小,但预计算意味着额外一次显存读取;而 powf 在 GPU 上走的是 SFU 的近似指令,吞吐不低,且与随后的 cosf、sinf 共享同一条特殊函数管线。对一个以访存为主要成本的算子来说,多算几次幂比多读一张表更划算。
rope_yarn:内插与外推的线性混合
rope_yarn 是一个 __device__ 函数,被四个 kernel 共享。它做的事情可以用一个公式概括:
其中 是 freq_scale(位置缩放系数的倒数), 是每个维度自己的混合权重。代码里的实现是:
float theta_interp = freq_scale * theta_extrap;float theta = theta_interp;if (ext_factor != 0.0f) { float ramp_mix = rope_yarn_ramp(corr_dims.v[0], corr_dims.v[1], i0) * ext_factor; theta = theta_interp * (1 - ramp_mix) + theta_extrap * ramp_mix; mscale *= 1.0f + 0.1f * logf(1.0f / freq_scale);}cos_theta = cosf(theta) * mscale;sin_theta = sinf(theta) * mscale;if (!forward) { sin_theta *= -1.0f;}这段代码有三个容易被忽略的点。
第一,ext_factor 同时充当「是否启用 YaRN」的开关和混合强度的上限。当它为 0 时,整段修正被跳过,theta 就等于 freq_scale * theta_extrap——这正是位置插值(PI)的形态。当它为 1 时,每个维度按 ramp_mix 在「完全内插」和「完全不内插」之间取值。
第二,rope_yarn_ramp 的自变量是 i0(原始维度下标,偶数),但内部除以 2:
static __device__ float rope_yarn_ramp(const float low, const float high, const int i0) { const float y = (i0 / 2 - low) / max(0.001f, high - low); return 1.0f - min(1.0f, max(0.0f, y));}返回值的含义是「外推权重」:维度对索引小于 low 时返回 1,表示完全保持原频率(外推);大于 high 时返回 0,表示完全内插;中间线性过渡。这一点容易看反,因为 ramp 在 rope_yarn 里被当作 theta_extrap 的系数使用。max(0.001f, high - low) 是防止 beta_fast == beta_slow 时除零,代价是把过渡区强行拉宽到至少 0.001 个维度——实际上不会发生,因为两个 beta 的默认值相差 32 倍。
第三,mscale 的更新被硬编码在 kernel 里,但宿主侧会预先把它抵消掉。这一点值得单独展开,因为它展示了「kernel 的公式」和「模型配置的公式」不是一回事。
宿主侧先算好两个修正维度
corr_dims 不是运行时拍脑袋定的,而是由 ggml_rope_yarn_corr_dims 在宿主侧算出来的:
static float ggml_rope_yarn_corr_dim(int n_dims, int n_ctx_orig, float n_rot, float base) { return n_dims * logf(n_ctx_orig / (n_rot * 2 * (float)M_PI)) / (2 * logf(base));}
void ggml_rope_yarn_corr_dims(int n_dims, int n_ctx_orig, float freq_base, float beta_fast, float beta_slow, float dims[2]) { float start = floorf(ggml_rope_yarn_corr_dim(n_dims, n_ctx_orig, beta_fast, freq_base)); float end = ceilf(ggml_rope_yarn_corr_dim(n_dims, n_ctx_orig, beta_slow, freq_base)); dims[0] = MAX(0, start); dims[1] = MIN(n_dims - 1, end);}这个公式来自 YaRN 论文里的「按波长分工」:一个维度对应的波长是 (即该频率分量走完一个完整周期的位置跨度),把它和原始训练长度 相比,比值 越小,说明这个维度的波长比上下文还长,应该内插;比值越大,说明波长短、局部位置关系敏感,应该保持外推。论文定义了两个阈值 ,落在两者之间的维度线性混合。代码里的 n_rot 就是 ,反解出对应的维度下标。
用一组真实参数算一遍。LLaMA-3 8B:n_dims = 128、freq_base = 500000、原始上下文 n_ctx_orig = 8192,YaRN 默认 beta_fast = 32、beta_slow = 1。代入:
向下取整、向上取整后得到 corr_dims = {18, 35}。也就是说,64 对维度里前 18 对完全按缩放后的频率内插,第 35 对之后完全保持原频率,中间 17 对线性过渡。这个结果与「高频维度不该动、低频维度该压」的直觉一致:索引越大,频率 越小、波长越长。
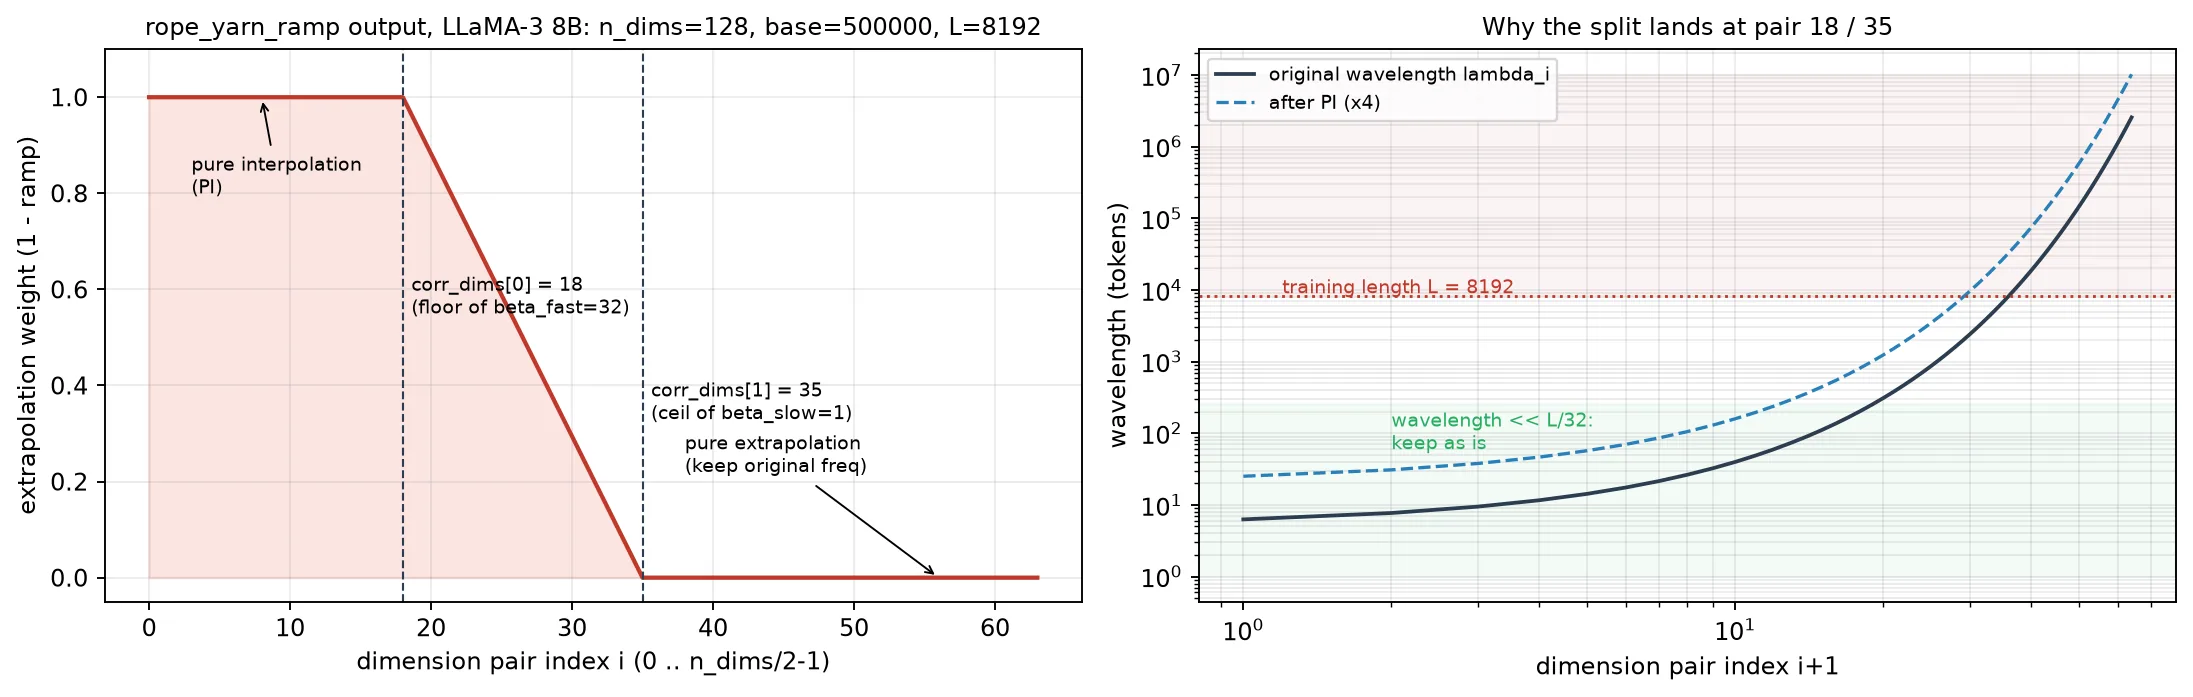
上图直观展示了 rope_yarn_ramp 的输出形状,以及它为什么在维度对 18 与 35 之间切分。横轴是维度对的波长,纵轴是外推权重:落在「原波长」一侧的维度保持原频率,落在「按 PI 缩放后波长」一侧的维度完全内插,两者之间用一段线性 ramp 过渡。beta_fast = 32 与 beta_slow = 1 分别对应这段 ramp 的两端,18 和 35 正是它们经 ggml_rope_yarn_corr_dim 反解、再取整后的落点。
mscale 为什么要在宿主侧抵消
kernel 在 ext_factor != 0 时会把 mscale 乘上 。如果只看 kernel,会以为这就是 YaRN 的温度补偿。但宿主侧的 llama_context 在设置参数时做了这样一件事:
cparams.yarn_attn_factor = get_mscale(factor, mscale) / get_mscale(factor, mscale_all_dims);// ...// when YARN is applied with yarn_ext_factor != 0.0f, we need to cancel this factor:cparams.yarn_attn_factor *= 1.0f / (1.0f + 0.1f * logf(factor));也就是说,kernel 里乘的 会被宿主预先除掉,真正留下来的是模型配置里 mscale 与 mscale_all_dim 的比值。这样做的原因是:不同模型(尤其是 DeepSeek 系列)在 config 里给出的 mscale_all_dim 并不等于 1,而 kernel 的硬编码公式只对应「mscale = 1」的经典 YaRN。把补偿拆成「kernel 负责经典项、宿主负责模型差异」,既保持了 kernel 的通用性,又不用为每个模型编译一份特化代码。这类「在参数里预先抵消」的技巧在推理框架里很常见,读代码时如果只看 kernel 很容易误判公式。
顺带解释 attn_factor 的最后一次乘法:cparams.yarn_attn_factor *= hparams.rope_attn_factor,后者来自模型超参数,用于少数在预训练阶段就约定了额外缩放系数的模型。这样 RoPE 的幅度修正就有三层来源:模型自带的 rope_attn_factor、YaRN 的 mscale 配置、以及 kernel 里的经典补偿项,最终合成一个标量传进 kernel。
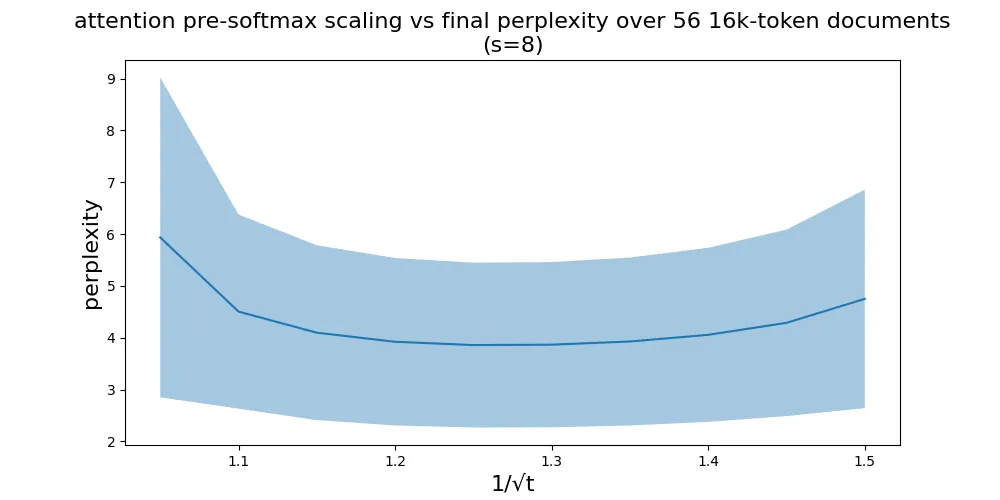
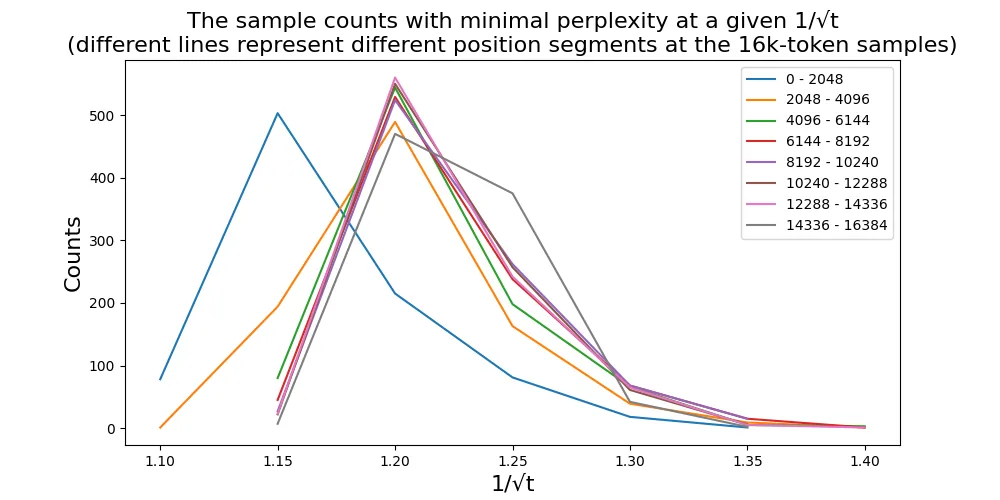
这两张实验图解释了「为什么 mscale 只能是一个标量」。上图是 56 篇 16k token 文档上,注意力 pre-softmax 缩放因子 与最终困惑度的关系:离开某个区间后,困惑度会明显上升,说明这个缩放确实在补偿注意力分布的熵。下图按位置区间统计「每个样本在哪一个缩放因子取到最小困惑度」,不同区间的分布并不重合——最优缩放会随位置段漂移。kernel 里那个由 与模型配置合成的单一标量,只能取这些分布的一个折中;这也正是宿主侧要按模型配置再做一次比值修正、而不是让 kernel 自己决定全部缩放的原因。
反向传播只改一个符号
rope_yarn 是模板函数,模板参数 forward 决定 sin_theta 是否取负。原因很直接:正向旋转矩阵是
反向就是它的转置,等价于用 再转一次。把 sin 取负比在 kernel 里再写一套索引简单得多。推理路径只会实例化 forward = true,ggml_cuda_op_rope_back 才走另一支;两者共享同一份索引与访存逻辑,这是模板化最直接的收益。
两种布局:rope_norm 与 rope_neox
数学上,RoPE 把 head_dim 切成 个二维平面,每个平面转一个角度。但「哪两个维度构成一个平面」在工程上有两种约定,而且这两种约定互不兼容:用错了不会报错,只会让模型输出变成噪声。
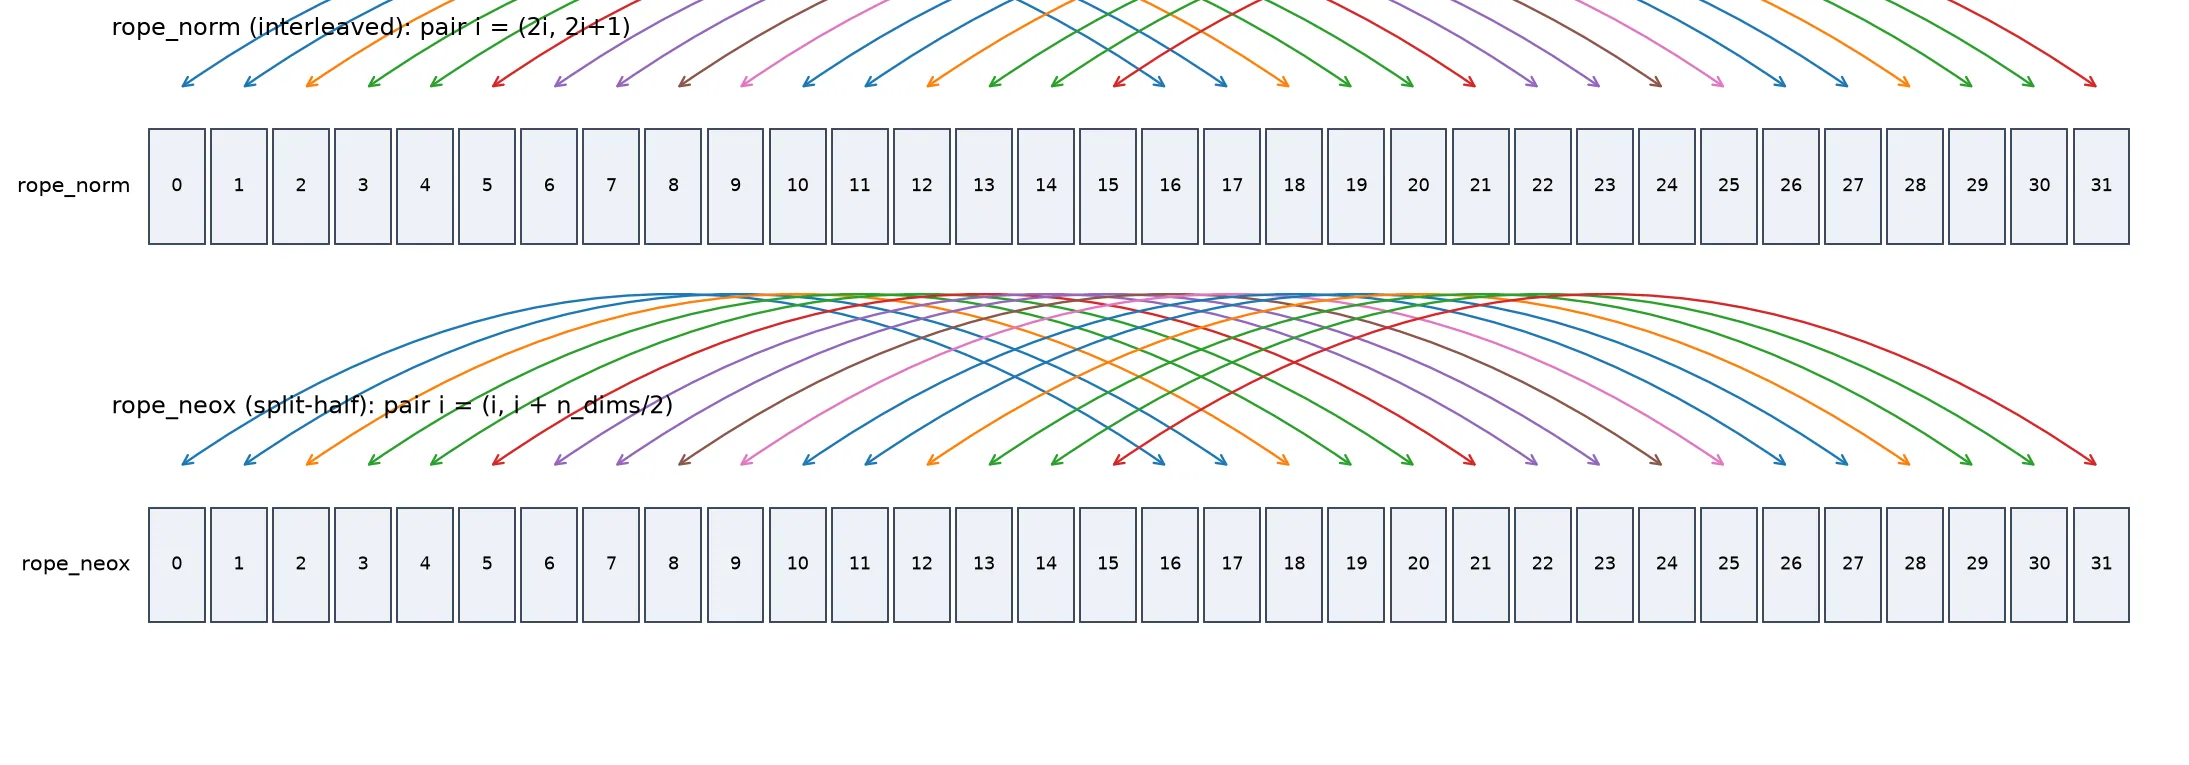
上图把同一组维度按两种约定各配对一次。上半部分是 rope_norm 的 interleaved 配对,第 对的两个元素在内存里相邻;下半部分是 rope_neox 的 split-half 配对,第 对的两个元素分别位于前半区和后半区、相隔 。下面的两个小节逐一展开这两种布局在线程里怎么读写,以及为什么它们决定了向量化写回和合并访存的方式。
interleaved:相邻两维一对
rope_norm 采用相邻配对:第 对是 。代码里一个线程负责一对:
const int i0 = 2*(blockDim.y*blockIdx.y + threadIdx.y);// ...const float x0 = x[ix + 0];const float x1 = x[ix + 1];store_coaelsced(x0 * cos_theta - x1 * sin_theta, x0 * sin_theta + x1 * cos_theta);i0 一定是偶数,ix 指向这一对的第一个元素。写回时用 float2 或 half2 一次写 8 字节或 4 字节:
const auto & store_coaelsced = [&](float x0, float x1) { if constexpr (std::is_same_v<float, D>) { float2 v = make_float2(x0, x1); ggml_cuda_memcpy_1<8>(dst + idst, &v); } else if constexpr (std::is_same_v<half, D>) { half2 v = make_half2(x0, x1); ggml_cuda_memcpy_1<4>(dst + idst, &v); }};这段 lambda 里的 ggml_cuda_memcpy_1<8> 不是普通的 memcpy,而是按字节宽度选择的向量化搬运,确保生成的是一条 64 位或 32 位存储指令,而不是两次 32 位/16 位标量写。对 interleaved 布局来说,相邻线程写相邻的 8 字节块,一个 warp 的写入天然连续,合并访存没有问题。
split-half:前后半各取一维
rope_neox 采用前后半配对:第 对是 。同样是 256 个线程,i0 仍然是偶数,但所有下标都要除以 2:
int idst = i0 / 2 + i1 * s1 + i2 * s2 + i3 * s3;const int ix = i0 / 2 + i1 * s01 + i2 * s02 + i3 * s03;// ...const float x0 = x[ix + n_offs/2 + 0];const float x1 = x[ix + n_offs/2 + n_dims/2];dst[idst + n_offs/2 + 0] = x0 * cos_theta - x1 * sin_theta;dst[idst + n_offs/2 + n_dims/2] = x0 * sin_theta + x1 * cos_theta;这里有两个细节。
一是 n_offs/2。n_offs 是「从第几个原始维度开始旋转」的偏移量,单位是元素;而 ix 已经是一个「对索引」,所以偏移要除以 2。注释里专门写了这一点,因为它是最容易写错的地方:如果直接用 n_offs,窗口会整体偏移一倍。
二是两次标量写,而不是一次向量写。因为配对的两个元素相隔 n_dims/2 个位置,无法用一条向量指令同时写。但相邻线程的 i0/2 连续,所以第一个半区的写入是一个连续的 32 位流,第二个半区也是;一个 warp 会发出两条合并的存储事务,代价可以接受。相比之下,interleaved 的一条 64 位写只产生一次事务,这也是它在带宽上略优的原因;但主流 LLaMA 系列权重是按 split-half 训练的,布局不能由推理框架随意改。
为什么两种布局都必须支持
权重文件里的 Q/K 投影矩阵是按训练时的布局排好的。要把 interleaved 的模型转成 split-half,等价于对每个头的维度做一次固定的置换,可以在加载时重排权重;但这样做会让 GGUF 的量化块与重排后的维度错位,还得重新量化,代价远高于在 kernel 里多写一个分支。llama.cpp 的选择是保留两种布局,用 mode 位标志区分,在宿主侧分派到不同 kernel。这就是为什么 rope_norm 和 rope_neox 的代码有 90% 重复却没有合并:合并需要在每个线程里多一次分支判断,而分支的两侧访存模式完全不同,编译器也无法把两种索引方式向量化到同一条路径上。
部分旋转与偏移窗口
n_dims 可以小于 ne00。例如某些模型只旋转前 64 维,后 64 维保持原样。kernel 的处理方式是:
if (i0 < n_offs || i0 >= n_offs + n_dims) { if (inplace) { return; } store_coaelsced(x[ix + 0], x[ix + 1]); return;}不参与旋转的维度被原样拷贝(同时完成 F32 到 F16 的类型转换)。inplace 为真时直接返回,因为输入输出是同一块内存,拷贝没有意义。这也解释了为什么宿主侧要判断 dst_d == src0->data:in-place 时不能写窗口外的维度,否则会把还没被其他线程读取的数据覆盖掉。
对 split-half 布局,窗口外的判断仍然用 i0 与 n_dims 比较,但实际写入位置带 n_offs/2 偏移。这要求 n_offs 是偶数,否则「对索引」会落在半个元素上;宿主侧没有显式断言这一点,属于调用方(图构建)需要保证的约定。
原地旋转为什么是安全的
RoPE 是逐对的可逆变换,每一对只读自己的两个元素、只写自己的两个元素。即使 dst 与 src 是同一块内存,线程之间也没有交叉读写:线程 A 的写入位置恰好是它自己读过的位置,不会影响线程 B 的输入。唯一需要小心的是窗口外的拷贝分支——如果 in-place 还去拷贝,就会把源数据写回同一位置,纯属浪费,所以代码直接返回。
这个性质让 llama.cpp 可以在注意力路径上省掉一次临时张量分配。Q 和 K 都是「投影输出 → RoPE → 送入注意力/KV 缓存」,如果 RoPE 不是原地,每层每 token 都要多分配一块与 Q/K 等大的临时缓冲,显存峰值和分配器压力都会上升。原地实现把这一步的成本压到零。
一个 block 一行:launch 几何与它背后的取舍
rope_norm_cuda 的 launch 配置只有三行,但每一行都对应一个设计选择:
const dim3 block_dims(1, CUDA_ROPE_BLOCK_SIZE, 1);const int n_blocks_x = (ne00 + 2 * CUDA_ROPE_BLOCK_SIZE - 1) / (2 * CUDA_ROPE_BLOCK_SIZE);const dim3 block_nums(nr, n_blocks_x, 1);CUDA_ROPE_BLOCK_SIZE 在 rope.cuh 里定义为 256。block_dims 是 (1, 256):x 维只有 1 个线程,y 维 256 个线程。block_nums.x = nr,而 nr = ggml_nrows(src0),也就是 n_head × n_tokens × n_batch 展开后的行数。换句话说:
- 一个 block 处理一个扁平行号(把一个头在一个 token 上的整个 head_dim 视为一行);
- block 内的 256 个线程按 y 维编号,每个线程负责一对维度;
- 如果 head_dim 超过 512(256 对),
n_blocks_x大于 1,一个行会拆给多个 block。
对最常见的 head_dim = 128,一个 block 只有 64 个线程真正干活,占用率 25%。这不是疏忽,而是「按行切」的必然结果:head_dim 是模型固定的,不能为了凑满 256 线程而把多个头塞进一个 block,因为不同头的行在内存里可能不连续(s01 是行步长,但 ne01 与 ne02 的 strides 由张量视图决定)。按行切保证每个 block 的访存是局部的,索引计算也最简单。
低占用率是否意味着性能差?要分场景看。decode 阶段一个 token、32 个头,nr = 32,grid 只有 32 个 block;在 132 个 SM 的 H100 上只用到 32 个 SM,每个 SM 上两个活跃 warp。但整个 kernel 的工作量是 32×64 次旋转,约 4096 次乘加和 4096 次特殊函数调用,执行时间在微秒量级,真正的大头是 kernel launch 与前后依赖。此时提高占用率没有意义,减少 launch 次数才有意义——这就是后面 PDL 与算子融合要解决的问题。
prefill 阶段则相反:8192 个 token、32 个头,nr = 262144,grid 有 26 万个 block,每个 block 仍然只有 2 个活跃 warp。block 调度本身成为不可忽略的开销,但 RoPE 只占 prefill 总时间的一小部分(大头是 GEMM 与注意力),所以这个设计没有被优先优化。如果要把 prefill 的 RoPE 做得更快,正确方向是「一个 block 处理多行」,让 256 个线程全部有活干,同时把多行的写回合并成更大的事务;但这会引入行边界判断和更复杂的索引,收益需要实测才能确认。
还有一个容易被忽略的点:nr 是 int,而 block_nums.x 的类型是 unsigned int。对 26 万行没有问题,但如果把 n_tokens × n_head 推到 20 亿以上(比如极端的长上下文 prefill 加多头模型),会溢出。实际使用中不会接近这个量级,代码里也没有做保护。
步长参数为什么这么多
kernel 签名里有六个步长:s01/s02/s03 是源张量的行、头、token 步长,s1/s2/s3 是目标张量的对应步长。它们的存在是为了支持非连续视图:Q 可能是 [head_dim, n_head, n_tokens] 的转置视图,K 可能被 view 成 [head_dim, n_kv_head, n_tokens] 后写入 KV 缓存,目标步长与源步长不一定相同。把步长显式传进来,而不是假设连续,换来的是「同一个 kernel 能处理所有视图组合」,代价是每个线程多做几次整数乘法。
i1、i2、i3 的分解方式是标准的「扁平索引还原多维坐标」:
const uint32_t i3 = row_dst / (ne01 * ne02);const uint32_t i2 = (row_dst - i3 * ne01 * ne02) / ne01;const uint32_t i1 = row_dst - i3 * ne01 * ne02 - i2 * ne01;这里用整数除法而非编译期常量除法,因为 ne01、ne02 是运行时参数。每个线程做两次除法和两次乘法,相比它要执行的 powf、cosf、sinf 可以忽略;但在 decode 的极小 grid 下,这些指令的延迟会直接暴露在关键路径上,这也是 PDL 能把索引计算藏到前一个 kernel 执行期间的原因之一。
宿主侧分派:ggml_cuda_op_rope_impl 做了什么
kernel 前面的那层宿主代码比 kernel 本身还长,原因在于 ggml_tensor 的参数存储方式和数据类型的组合爆炸。
参数从 op_params 里按位读出
ggml 把算子的全部标量参数压进一段 int32_t 数组 op_params。n_dims、mode、n_ctx_orig 直接按下标取整;浮点参数则用 memcpy 把四个字节重新解释为 float:
const int n_dims = ((int32_t *) dst->op_params)[1];const int mode = ((int32_t *) dst->op_params)[2];const int n_ctx_orig = ((int32_t *) dst->op_params)[4];const int n_offs = ((int32_t *) dst->op_params)[15];
memcpy(&freq_base, (int32_t *) dst->op_params + 5, sizeof(float));memcpy(&freq_scale, (int32_t *) dst->op_params + 6, sizeof(float));memcpy(&ext_factor, (int32_t *) dst->op_params + 7, sizeof(float));memcpy(&attn_factor, (int32_t *) dst->op_params + 8, sizeof(float));memcpy(&beta_fast, (int32_t *) dst->op_params + 9, sizeof(float));memcpy(&beta_slow, (int32_t *) dst->op_params + 10, sizeof(float));memcpy(§ions.v, (int32_t *) dst->op_params + 11, sizeof(int)*4);用 memcpy 而不是 (float *)op_params + 5 的强制转换,是为了避免严格别名规则(strict aliasing)带来的未定义行为——前者总是合法,后者在开启优化时可能被编译器错误地重排。这种写法在 ggml 里随处可见,属于「在不引入 union 的前提下解析异构参数块」的标准做法。
下标 3(n_ctx)在代码里被注释掉了,因为它已经从运行时上下文长度里取;下标 11 到 14 是 mrope_sections 的四个整数,分别代表时间、高度、宽度和额外的维度划分。注意这些位置是跨算子复用的:同一个 op_params 结构在不同算子里有不同含义,这是 ggml 为节省内存做的紧凑设计,代价是读代码时必须知道每个下标对应什么。
位标志决定走哪个 kernel
mode 的解析用的是位运算:
const bool is_neox = mode & GGML_ROPE_TYPE_NEOX;const bool is_mrope = mode & GGML_ROPE_TYPE_MROPE;const bool is_imrope = mode == GGML_ROPE_TYPE_IMROPE;const bool is_vision = mode == GGML_ROPE_TYPE_VISION;前两个是「包含」判断,后两个是「相等」判断。原因在于枚举值的编码:NEOX 是一个独立的位,可以和 MROPE 叠加(M-RoPE 默认就是 split-half 布局);而 IMROPE(交错式 M-RoPE)和 VISION 是互斥的独立编码。这种混合判断方式在阅读时最容易出错的地方是:is_mrope && is_vision 为真时代码仍然走 is_mrope && !is_vision 分支,也就是先用 mrope 的 section 逻辑排除视觉,再进 vision 分支。所以判断顺序不能随意调换。
宿主侧还有几个断言,它们定义了调用方必须满足的契约:
if (is_vision) { GGML_ASSERT(n_dims == ne00/2); GGML_ASSERT(n_offs == 0); // offset not supported for vision, as the rotated pairs span the whole row}视觉分支的配对方式与文本不同:它把整行切成「前半」和「后半」,每半再用不同的位置(行、列)旋转,所以 n_dims 必须恰好是行宽的一半,偏移也必须为 0。断言在这里的作用是「把错误尽早暴露在调试版本里」,正式构建通常会关掉 NDEBUG 之外的断言——但 ggml 的 GGML_ASSERT 不等同于标准 assert,它在所有构建里都生效,所以这些约束是硬性的。
三种数据类型组合
rope_norm、rope_neox、rope_multi 都是 template <bool forward, bool has_ff, typename T, typename D>,宿主侧按源类型和目标类型展开成三条分支:
if (src0->type == GGML_TYPE_F32 && dst_type == GGML_TYPE_F32) { rope_neox_cuda<forward, float, float>(...);} else if (src0->type == GGML_TYPE_F32 && dst_type == GGML_TYPE_F16) { rope_neox_cuda<forward, float, half>(...);} else if (src0->type == GGML_TYPE_F16 && dst_type == GGML_TYPE_F16) { rope_neox_cuda<forward, half, half>(...);} else { GGML_ABORT("fatal error");}三种组合对应三种真实场景:
- F32 → F32:普通推理,Q/K 以 F32 存储时的通用路径;
- F32 → F16:RoPE 之后要写进 F16 的 KV 缓存(或融合的
set_rows目标为 F16); - F16 → F16:模型权重已经是半精度,投影输出也是 F16,旋转后保持 F16。
没有 F16 → F32 的组合,因为 ggml 的图里不会出现这种方向:类型提升发生在算子之前,不会发生在 RoPE 输出。GGML_ABORT 而不是静默回退,体现了「类型组合是封闭集合」的设计——如果出现第四种组合,说明上游图构建出了问题,应当崩溃而不是给出可能错误的数值。
has_ff 是第二个模板布尔参数,表示是否传入频率因子张量(src2)。它来自模型文件里的 rope_freqs 权重:LLaMA-3 系列在预训练时就学了一套每维度的频率因子,用来调整各维的旋转速度。kernel 里对应这一行:
const float freq_factor = has_ff ? freq_factors[iw/2] : 1.0f;rope_yarn<forward>(theta_base/freq_factor, ...);把基准角除以因子,而不是除以因子再乘回来,避免了额外的除法:theta_base 已经包含了位置与频率的乘积,直接把它压小等价于降低该维度的旋转速度。模板参数把这一层完全编译掉,没有频率因子的模型不会付出任何分支代价。
频率因子的长短期选择
freq_factors 并不是一张表,而是模型里可能存了两张:rope_long 和 rope_short。llama.cpp 在不同上下文长度下选用不同的那张(部分较早的模型只有一个 rope_freqs,此时总是用它):
ggml_tensor * llama_model::get_rope_factors(const llama_cparams & cparams, int il) const { const uint32_t n_ctx_seq = cparams.n_ctx_seq;
if (layers[il].rope_freqs != nullptr) { return layers[il].rope_freqs; } if (n_ctx_seq > hparams.n_ctx_orig_yarn) { return layers[il].rope_long; } return layers[il].rope_short;}这是 LLAMA-3.1 起采用的「渐进式扩展」策略的落点:模型提供了两套频率修正,短上下文用一套、长上下文用另一套,切换条件就是「当前序列是否超过原始训练长度」。从 kernel 的角度看,这只是换了一张指针;从模型的角度看,它意味着「同一份权重在不同序列长度下使用不同的频率映射」,而权重本身不需要重新加载。
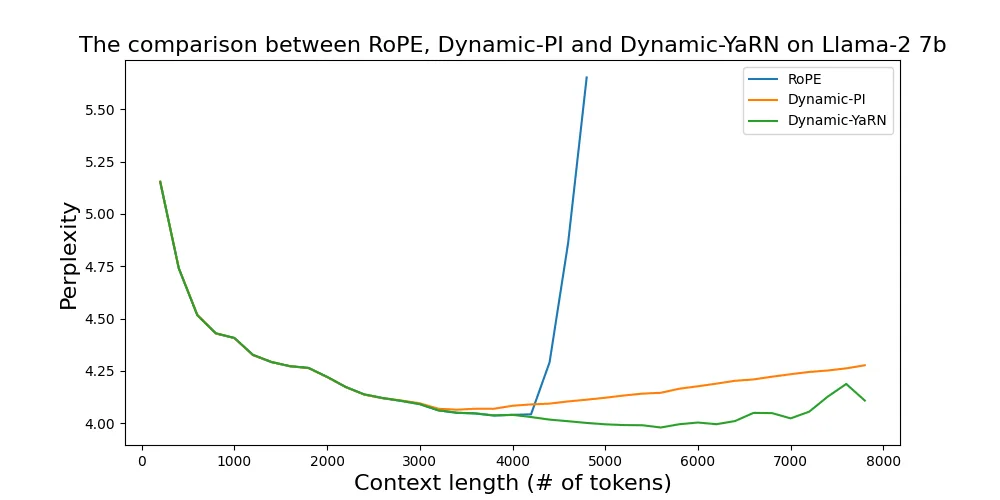
另一条路线是运行时动态调整缩放:Dynamic-PI 根据当前长度改变位置插值系数,Dynamic-YaRN 再在它之上叠加 YaRN 的维度 ramp。上图比较了 Llama-2 7B 在 RoPE、Dynamic-PI 与 Dynamic-YaRN 下困惑度随上下文长度的变化;在训练长度之外,两条动态方案的曲线明显更平缓。llama.cpp 的 kernel 本身不参与这类动态决策——它只接收宿主侧算好的 freq_scale、ext_factor 与 corr_dims,所以策略部分留在调用方,rope.cu 只负责把给定的参数落到每一次旋转上。
M-RoPE:位置不再是单个整数
多模态模型(Qwen2-VL 之后的一系列 VLM)遇到一个新问题:一张图片在 token 序列里占几百个位置,这些位置在空间上是二维的(行、列),而文本位置是一维的。如果用一维位置编码,图片 token 之间的相对关系会变成一条奇怪的折线。M-RoPE 的解法是给每个 token 三个位置:时间 、高度 、宽度 ,再把 head_dim 按比例切成三段,每段用其中一个位置来旋转。
section 的划分与位置查找
rope_multi 在 rope_neox 的基础上加了一段 section 逻辑:
const int sect_dims = sections.v[0] + sections.v[1] + sections.v[2] + sections.v[3];const int sec_w = sections.v[1] + sections.v[0];const int sector = (iw / 2) % sect_dims;
if (sector < sections.v[0]) { theta_base = pos[i2] * powf(theta_scale, iw / 2.0f);} else if (sector >= sections.v[0] && sector < sec_w) { theta_base = pos[i2 + ne02 * 1] * powf(theta_scale, iw / 2.0f);} else if (sector >= sec_w && sector < sec_w + sections.v[2]) { theta_base = pos[i2 + ne02 * 2] * powf(theta_scale, iw / 2.0f);} else if (sector >= sec_w + sections.v[2]) { theta_base = pos[i2 + ne02 * 3] * powf(theta_scale, iw / 2.0f);}理解这段代码需要先知道位置张量的内存布局。pos 的维度是 ne02 × 4:ne02 是 token 数与批大小的乘积(src1 的第 2 维),四个分量依次是 、、 和额外一段。所以 pos[i2 + ne02 * 1] 取得的是第 i2 个 token 的 ,ne02 * 2 是 ,ne02 * 3 是第四段(常用于「时间之外的绝对位置」)。
sector = (iw/2) % sect_dims 把维度对索引折回 section 的总长度,于是每个 section 会周期性地重复出现。为什么要取模而不是只判断一次?因为 Qwen2-VL 的配置里 sections 通常之和小于 n_dims,也就是说 section 模式会在整个 head 上重复铺开,每个周期里 、、 各占一段。取模让代码只需要一个分支树就能覆盖所有周期,代价是每个线程都多一次整数取模——在 GPU 上整数除法/取模是相对昂贵的指令,这也是 4 段判断被写成顺序比较而不是查表的原因:比较的分支预测在 warp 内可能发散,但只有 4 段,且相邻线程的 sector 大量相同,实际开销可以接受。
注意频率部分 powf(theta_scale, iw/2.0f) 用的是全局的 iw,而不是 section 内的局部下标。这意味着第 2 个周期里的 段会沿用它在整个 head 上的频率位置,与第 1 个周期不同。这正是 M-RoPE 的意图:不同周期承担不同的频率分辨率,而不是简单重复。
is_imrope:另一套交错顺序
GGML_ROPE_TYPE_IMROPE(interleaved M-RoPE)对应一部分模型在训练时采用了「、、 每三个维度一组交错」的布局,而不是「三段连续」。kernel 里用另一套判断:
if (is_imrope) { if (sector % 3 == 1 && sector < 3 * sections.v[1]) { // h theta_base = pos[i2 + ne02 * 1] * powf(theta_scale, iw / 2.0f); } else if (sector % 3 == 2 && sector < 3 * sections.v[2]) { // w theta_base = pos[i2 + ne02 * 2] * powf(theta_scale, iw / 2.0f); } else if (sector % 3 == 0 && sector < 3 * sections.v[0]) { // t theta_base = pos[i2] * powf(theta_scale, iw / 2.0f); } else { theta_base = pos[i2 + ne02 * 3] * powf(theta_scale, iw / 2.0f); }}sector % 3 决定这一维属于哪一个分量,sector < 3 * sections.v[x] 决定它是否仍在对应分量的作用区间内;超出三个分量覆盖范围的部分回落到第四段。把两个条件写成 && 而不是嵌套判断,是为了让编译器把条件合并成一次谓词计算。
图构建侧对应的逻辑在 llm_graph_input_pos 里,它负责把「、、」三个 source 按 section 顺序展开成 [4, n_tokens] 的位置张量,并对 section 的顺序做置换:
switch (rope_section_order) { case LLAMA_ROPE_SECTION_ORDER_TYXZ: break; case LLAMA_ROPE_SECTION_ORDER_ZYXT: slot_of_section = { 3, 1, 2, 0 }; break; default: GGML_ABORT("unsupported rope section order");}ZYXT 顺序是为少数把宽度放在最前面的模型准备的。把这种「顺序差异」放在图构建侧、而不是 kernel 里再加一层判断,是典型的「把不变的东西编译进布局」的取舍:位置张量只构造一次,kernel 每层都要读它,所以重排应该在构造时完成。
视觉编码器:二维位置的完整做法
rope_vision 比 rope_multi 更直接:它把整行按 sections[0] + sections[1] 切成两半,前半用行位置、后半用列位置,而且频率下标在每半里都从 0 重新开始:
const int sect_dims = sections.v[0] + sections.v[1];const int sector = (i0 / 2) % sect_dims;
if (sector < sections.v[0]) { const int p = sector; theta_base = pos[i2] * powf(theta_scale, p);} else if (sector >= sections.v[0] && sector < sect_dims) { const int p = sector - sections.v[0]; theta_base = pos[i2 + ne02] * powf(theta_scale, p);}与 rope_multi 的两处区别值得注意。第一,指数用的是局部下标 p,所以行、列两段都从最低频开始,覆盖同样的频率范围;这符合视觉二维编码的对称性要求。第二,配对方式为 (ix, ix + n_dims):
const float x0 = x[ix + 0];const float x1 = x[ix + n_dims];dst[idst + 0] = x0 * cos_theta - x1 * sin_theta;dst[idst + n_dims] = x0 * sin_theta + x1 * cos_theta;rope_vision 里没有 n_offs 参数,宿主侧也断言了偏移必须为 0,所以索引比 neox 干净一截。视觉编码器的注意力通常没有 KV 缓存,也不需要把 RoPE 结果写进分页池,所以这个 kernel 只支持 F32/FP16 的原位类型,没有 F32 → F16 的组合,也不需要 set_rows。
PDL:把索引计算藏到上一个 kernel 的运行时间里
读 rope_neox 时会看到一个奇怪的东西:ggml_cuda_pdl_lc() 出现在函数最开头,ggml_cuda_pdl_sync() 出现在索引计算之后:
ggml_cuda_pdl_lc();const int i0 = 2*(blockDim.y*blockIdx.y + threadIdx.y);if (i0 >= ne00) return;// ... 计算 i3, i2, i1, idst, ix ...ggml_cuda_pdl_sync();两个原语分别做什么
在 common.cuh 里它们是转发到 Hopper 之后的 CUDA 原语:
static __device__ __forceinline__ void ggml_cuda_pdl_sync() {#if defined(GGML_CUDA_USE_PDL) && __CUDA_ARCH__ >= GGML_CUDA_CC_HOPPER cudaGridDependencySynchronize();#endif}
static __device__ __forceinline__ void ggml_cuda_pdl_lc() {#if defined(GGML_CUDA_USE_PDL) && __CUDA_ARCH__ >= GGML_CUDA_CC_HOPPER cudaTriggerProgrammaticLaunchCompletion();#endif}cudaTriggerProgrammaticLaunchCompletion 告诉驱动:本 grid 的 launch 阶段已经完成,后继 kernel 可以被调度上来。cudaGridDependencySynchronize 则是「等到前一个 kernel 真正写完数据再往下读」。两者配合,让下一个 kernel 的线程可以提前启动、先做不需要前驱数据的准备工作(比如算索引、读常量),然后再阻塞在同步点上等数据就绪。
宿主侧需要在 launch 时打开 cudaLaunchAttributeProgrammaticStreamSerialization,ggml-cuda.cu 在 GGML_CUDA_USE_PDL 打开时统一加上这个属性。没有打开时两个函数都是空操作,kernel 退化为普通的串行执行。
为什么偏偏把索引计算放在中间
rope_neox 里,pdl_lc 放在最前、pdl_sync 放在索引计算之后,意味着「求 i3/i2/i1、求行列偏移」这部分纯计算被放到同步点之前。这不是随意安排的:前一个 kernel(通常是 QKV 投影的 GEMM)还在跑时,当前 kernel 的 warp 已经被调度到 SM 上,此时它们能做的只有与输入数据无关的计算。索引计算恰好满足这个条件——它只依赖 blockIdx、blockDim 和步长参数,不依赖 Q 的实际内容。
这个优化对 RoPE 尤其有效,因为 RoPE 的每个线程的工作非常简单:算两次 powf、两次 cosf/sinf、四次浮点乘加、读两个元素、写两个元素。如果全部放在同步点之后,那么从「数据就绪」到「kernel 结束」的时间几乎就是全部执行时间;把索引挪到前面,能把几十个周期的整数运算藏进前驱 kernel 的尾巴里。对 decode 阶段每次只用几十微秒的 RoPE 来说,这个比例不可忽略。
反过来看,rope_norm 里没有出现 PDL 原语,rope_multi 和 rope_vision 里只在索引计算之后出现一次 pdl_sync(没有 pdl_lc)。这种不一致不是 bug,而是维护过程留下的差异:PDL 是逐个 kernel 加的,加 pdl_lc 要求确认「本 kernel 早于数据就绪所做的事」都是安全的,不同布局的验证进度不同。阅读时不必过度解读,但可以据此判断哪条路径被优化得更积极——主流 LLaMA 走的是 rope_neox,所以它拿到了最完整的 PDL 处理。
与 CUDA Graph 的关系
PDL 和 CUDA Graph 解决的是不同层次的 launch 开销:CUDA Graph 消灭的是「每次 launch 的驱动侧开销」,PDL 消灭的是「kernel 之间的启动气泡」。在 llama.cpp 里两者可以叠加:CUDA Graph 把整段图录制成一次重放,PDL 则让图内相邻 kernel 之间不留启动间隙。RoPE 在这个组合里是个很好的受益者,因为它前后紧邻的都是计算量小、间隙明显的算子(norm、mul、set_rows),启动气泡的相对占比大。
融合:RMSNorm + 乘 + RoPE 写进同一个 kernel
rms_norm_mul_rope_f32 是 rope.cu 里最复杂的部分,也是「为什么推理框架要写融合 kernel」的一个完整样本。它由 rms_norm_mul_rope_fused 入口调用,在 ggml-cuda.cu 的子图匹配阶段被自动触发。
什么情况下会融合
融合不是无条件的,宿主侧有一整套判定:
static bool ggml_cuda_should_fuse_rms_norm_mul_rope(const ggml_tensor * rms_norm, const ggml_tensor * mul, const ggml_tensor * rope) { if (rms_norm->op != GGML_OP_RMS_NORM || mul->op != GGML_OP_MUL || rope->op != GGML_OP_ROPE) { return false; } // 全部必须是 F32... if (rope->src[0] != mul) { return false; } // 必须行连续... // 融合 kernel 只处理 norm/neox 两种模式 const int mode = ((const int32_t *) rope->op_params)[2]; if (mode != GGML_ROPE_TYPE_NORMAL && mode != GGML_ROPE_TYPE_NEOX) { return false; } // n_dims 必须为偶数,且不支持 n_offs != 0 const int n_offs = ((const int32_t *) rope->op_params)[15]; if (n_offs != 0) { return false; } return true;}逐条看,它们都是「融合 kernel 的语义与单算子组合不完全等价」的边界:
- F32-only:融合 kernel 把 RMSNorm 的归约、乘法和旋转混在一趟循环里,全程用 F32 中间结果;如果任一环节允许量化或半精度,数值路径会与分开执行不同,得另写一份;
rope->src[0] != mul:图里的 RoPE 输入必须正好是乘法结果,否则融合会跳过中间的节点;- 行连续:RMSNorm 每个线程沿行读取做平方和,如果行不连续,访存会退化成分散的跳跃;
- mode 只支持 NORMAL/NEOX:M-RoPE 和 VISION 的位置逻辑塞不进同一趟循环;
n_offs != 0:偏移窗口的情况尚未实现。
子图匹配在 ggml-cuda.cu 里由两个列表驱动:
std::initializer_list<enum ggml_op> rms_norm_mul_rope_ops = { GGML_OP_RMS_NORM, GGML_OP_MUL, GGML_OP_ROPE };std::initializer_list<enum ggml_op> rms_norm_mul_rope_set_rows_ops = { GGML_OP_RMS_NORM, GGML_OP_MUL, GGML_OP_ROPE, GGML_OP_VIEW, GGML_OP_SET_ROWS };第二个列表把 VIEW + SET_ROWS 也吸收进来,于是「norm → 乘 → RoPE → 视图 → 写进 KV 缓存」这五步变成一次 kernel。这一点和前面提到的「expand k later to enable rope fusion」注释相互印证:图构建时刻意把 K 的展开放到后面,以便融合能直接写进 KV 池。
kernel 的结构:一个 block 一行,归约与旋转共用线程
rms_norm_mul_rope_f32 的 grid 是三维的:
const dim3 blocks_num(nrows, MIN(nchannels, UINT16_MAX), MIN(nsamples, UINT16_MAX));三个维度分别是「行(头)」「通道(token)」「样本(批)」。一个 block 负责一行×一个通道×一个样本的整条 head_dim。block 内先用标准的两阶段方式做平方和归约:
float tmp = 0.0f;for (int col = tid; col < ncols; col += block_size) { const float xi = xc[col]; tmp += xi * xi;}tmp = block_reduce<block_reduce_method::SUM, block_size>(tmp, s_sum);const float scale = rsqrtf(tmp/ncols + eps);然后是第二趟循环,这一趟把「乘权重」和「旋转」两步合在一起:
for (int i0 = 2*tid; i0 < ncols; i0 += 2*block_size) { int ix0, ix1; if (is_neox && i0 < n_dims) { ix0 = i0/2; ix1 = i0/2 + n_dims/2; } else { ix0 = i0 + 0; ix1 = i0 + 1; }
const float x0 = scale * xc[ix0] * mulc[fastmodulo(ix0, mul_ncols_packed)]; const float x1 = scale * xc[ix1] * mulc[fastmodulo(ix1, mul_ncols_packed)];
if (i0 >= n_dims) { dstc[ix0] = ggml_cuda_cast<D>(x0); dstc[ix1] = ggml_cuda_cast<D>(x1); continue; } // ... 计算 theta,旋转后写回 ...}这里有几个设计点。
第一,q 乘权重的那个 mul 张量不是逐元素形状,而是可以广播的。代码用 fastmodulo(ix0, mul_ncols_packed) 把下标折回 mul 的实际宽度,fastdiv 的预计算值在宿主侧算好,避免每个线程做整数除法。这是 ggml 里通用的广播实现技巧:用固定宽度的模运算模拟循环回绕。
第二,is_neox && i0 < n_dims 的条件同时承担了「布局选择」和「窗口判断」两件事。当布局是 neox 且还在旋转窗口内,配对为 split-half;否则(interleaved 或超出窗口)配对为相邻。这个写法省掉了一个额外的分支,但含义比字面看起来复杂:窗口外的维度无论布局都按 i0、i0+1 这组下标读取和写回,因为拷贝只需要把两个相邻元素写出去,与旋转配对无关。
第三,block_size 是模板参数,按 ncols 选择 256 或 512(ncols < 1024 用 256,否则 512),共享内存只有 32 * sizeof(float)——一个 warp 的归约暂存。一个 block 只做一次归约,所以共享内存很少,占用率受限于寄存器而不是共享内存。第二趟循环末尾有一段 __syncthreads()(仅 block_size > WARP_SIZE 时),原因是在外层循环里同一块共享内存被复用给下一次归约,如果不隔开就会读到上一次的残余。注释里引用了一个 issue 编号,说明这是一个真实踩过的坑:最初版本在多通道循环里没有同步,归约结果偶尔串扰。
融合到底省了什么
把三到五个节点合成一个 kernel,收益来自三处:
- 省掉中间张量的读写:分开执行时,RMSNorm 输出、乘法输出各要写一次再读一次,按
[n_embd, n_tokens]计,prefill 8192 token 时每层每份要 8192 × 4096 × 2 字节 ≈ 64 MiB 的往返;融合后这些往返全部消失; - 省掉两次 kernel launch:prefill 时 launch 数占比不高,但 decode 时每次前向只有几十个 kernel,少两次启动是实打实的;
- 省掉一次全局内存的「归一化再读」:第二趟循环直接在寄存器里同时完成乘权重和旋转,输入只读一次。
代价是代码复杂度:融合内核必须处理广播、两种布局、窗口外拷贝、类型转换、写 KV 缓存这些所有情况,任何一条路径写错都会产生难以察觉的数值偏差。这也是判定函数写得这么保守的原因——宁可少融合,也不能把不一致的语义悄悄混进来。
被融合路径覆盖不到的情况
有些组合即使「看起来该融合」也不会触发。比如 M-RoPE 的模型(大量多模态),RoPE 走 rope_multi,而融合内核只认 NORM/NEOX;再比如带 n_offs 的部分旋转模型。这些路径只能老老实实执行分开的几个节点。ggml_cuda_should_fuse_rms_norm_mul_rope 的结构也因此很直白:一组互不相关的「不允许」条件,任何一条命中就放弃。
另一点值得留意:融合要求 rms_norm->src[0] 与 mul->src[0/1] 都是行连续。ggml 的视图可以很自由地表达转置和分块,但融合内核沿行扫描,必须保证每一行的元素在内存里是连续的。如果某个模型的注意力前 norm 输入来自一个非行连续的视图,融合会自动失效,回退到逐算子路径——这个回退是静默的,不会打印日志,所以「为什么这个模型没吃到融合」往往需要用子图匹配的判定逐个条件去排查。
运行时视角:这些 kernel 在真实请求里各跑几次
理解了机制,最后把它放回到一次真实的前向里,才算把这篇读完。
prefill 与 decode 的调用量
以 LLaMA-3 8B(32 层、32 个 Q 头、8 个 KV 头、head_dim 128)为例,一次前向里 RoPE 的调用次数是:
| 阶段 | 输入规模 | ggml_rope_ext 节点数 | 说明 |
|---|---|---|---|
| prefill(8192 token) | 8192 行 Q + 8192 行 K | 每层 2 次,共 64 次 | Q 与 K 各一次,K 结果再写入 KV 缓存 |
| decode(单 token) | 1 行 Q + 1 行 K | 每层 2 次,共 64 次 | 次数不变,规模缩小 |
节点数相同,但每节点的 nr(行数)相差 8192 倍。prefill 时 Q 的 nr = 32 × 8192 = 262144,K 的 nr = 8 × 8192 = 65536;decode 时 nr 分别是 32 和 8。这直接决定了 launch 几何:
- prefill 的 Q 图用
(262144, 1, 1)的 grid,每个 block 处理一行,共 26 万个 block; - decode 的 Q 图只有 32 个 block,每个 block 只有 64 个活跃线程。
再叠加融合:LLaMA-3 的注意力前 norm 是 RMSNorm,后面接一个可选的 mul(某些变体会在 norm 后乘一个缩放),再进 RoPE。如果图里恰好构成 RMSNorm → MUL → ROPE 且满足所有条件,这三个节点会变成一个 rms_norm_mul_rope;如果 K 还带 VIEW → SET_ROWS 直接写进缓存,五节点合成一个。对 32 层、每层 Q 和 K 各一次,最多能省下 32 × 2 × 4 = 256 个节点——在 decode 的几十个 kernel 量级下,这是相当可观的减少。
显存带宽视角
RoPE 的带宽消耗很直接:读一份 Q 或 K,写一份。以 decode 的 Q 为例,32 个头 × 128 维 × 2 字节(F16)= 8 KiB,K 是 2 KiB,每层合计 10 KiB;32 层就是 320 KiB。对比同一时刻 KV 缓存的读取量(8 个 KV 头 × 8192 token × 128 维 × 2 字节 × 2(K 和 V)≈ 32 MiB),RoPE 的带宽占比不到 1%。这也解释了为什么 llama.cpp 敢在 kernel 里每个线程都现算 powf、cosf、sinf:算力有富余,带宽才是瓶颈,而 RoPE 的带宽需求很小。
真正让 RoPE 在 decode 里显得重要的不是带宽,而是在关键路径上的位置。它位于「投影 GEMM → RoPE → 写 KV → 注意力」这条链上,每一步都要等上一步完成。对一个 TPOT 在 10 毫秒量级的解码来说,每个 kernel 的启动和同步开销累计起来就不可忽略。PDL 与融合正是在这个意义上服务于「把每一步都缩短」——不是让 RoPE 本身更快,而是让它与前后邻居之间的空隙消失。
与 KV 缓存量化的关系
llama.cpp 支持把 KV 缓存量化为 Q8 或 Q4。RoPE 与量化的相遇点有两处。
第一处是写入:融合的 set_rows 目标类型只允许 F32 或 F16(判定函数里有专门的检查),所以量化 KV 缓存不会走到「RoPE + VIEW + SET_ROWS」的融合,而是分开执行,再由 KV 写入路径完成量化。rope.cu 只负责把旋转后的 F32/F16 值交给下游,量化本身发生在别处。
第二处是 KV 平移(context shift)。当上下文满了需要丢掉最早的一段时,llama.cpp 会把缓存里的 K 整体往前挪,再用一次 RoPE 把每个 K 旋转回「新的位置」对应的相位。这正是 llama-kv-cache.cpp 里 build_rope_shift 做的事:
if (ggml_is_quantized(cur->type)) { // dequantize to f32 -> RoPE -> quantize back tmp = ggml_cast(ctx, cur, GGML_TYPE_F32); tmp = llama_mul_mat_hadamard(ctx, tmp, rot); tmp = ggml_rope_ext(ctx, tmp, shift, factors, n_rot, rope_type, ...); tmp = llama_mul_mat_hadamard(ctx, tmp, rot); tmp = ggml_cpy(ctx, tmp, cur);} else { tmp = ggml_rope_ext_inplace(ctx, cur, shift, factors, n_rot, rope_type, ...);}这段代码里有一个不容易理解的细节:为什么旋转前后各套一次 Hadamard 变换?原因在量化的坐标系:部分 KV 量化会把 Hadamard 变换吸收进坐标系(把 K 乘上一个 Hadamard 矩阵),使量化的量化步长分布更均匀;这样缓存里的 K 已经处于「旋转过的」坐标系,直接在上面做 RoPE 会把「位置旋转」叠到「基旋转」上。代码因此先乘一次 Hadamard 回到原坐标系,做 RoPE,再乘一次转回去。两次变换是同一正交矩阵的正反应用,不改变信息,只是把它搬到 RoPE 期望的坐标系。对未量化的缓存,直接 ggml_rope_ext_inplace 即可,一次就能完成。
build_rope_shift 里还有一处对 M-RoPE 的 workaround:
const auto & rope_type = hparams.rope_type == LLAMA_ROPE_TYPE_MROPE || hparams.rope_type == LLAMA_ROPE_TYPE_IMROPE ? LLAMA_ROPE_TYPE_NEOX // @ngxson : this is a workaround : hparams.rope_type;注释说明了原因:M-RoPE 在训练时每个 token 的 t/h/w 各段位置都不同,平移缓存时只需整体减去同一个偏移,用普通 neox RoPE 旋转整个向量就够了——只要「顺序」正确。这也是为什么 M-RoPE 的 kernel 默认采用 split-half 配对:使得平移退化成的普通 RoPE 与原始 kernel 的配对方式一致。
写在最后:一个 kernel 背后的设计账本
把 rope.cu 从顶到底读一遍,能看到六笔清晰的取舍账:
- 拿算力换带宽:不建 cos/sin 表,每个线程现算角度。对带宽敏感的 decode 阶段,这省掉了一次全局读;对 SFU 有富余的 GPU,几乎免费。
- 拿代码重复换访存效率:四种布局各自实现,不合并成一个通用 kernel。合并需要在线程内做分支,而每种布局的向量化方式都不同,编译器无法兼顾。
- 拿复杂度换启动次数:融合 kernel 把一个五节点子图压成一个,代价是判定条件保守、边界多。保守的理由是「语义不等价的融合比不融合更危险」。
- 拿宿主侧的预先抵消换 kernel 的通用性:YaRN 的
mscale由 kernel 的硬编码公式与宿主侧的模型差异合成,kernel 不需要知道具体模型。 - 把不变的东西提前处理:section 顺序置换在图构建时完成,
corr_dims在宿主侧算好,theta_scale在 launch 前算一次,设备端每线程只保留一次幂运算。 - 把「安全可提前做的事」放在同步点前面:PDL 的
lc/sync把索引计算藏进前驱 kernel 的尾巴,代价是要逐个 kernel 证明「提前做的事不依赖输入数据」。
这六笔账里,没有一笔是为「让这个 kernel 单独跑得更快」而记的。RoPE 本身的计算量微不足道,它的价值在整条推理链路的时序结构里:它在关键路径上,它的邻居都是小算子,它的输入输出可以被吸收进 KV 写入,它的参数在宿主侧可以预先算好。理解这一点,比记住 rope_norm 和 rope_neox 哪个用相邻配对更有用——布局的差异十分钟能背下来,而「为什么这样组织代码」的思维要在一个又一个 kernel 上反复对照才能建立。
如果后续要读 llama.cpp 里其他类似的「小算子 + 大宿主」模块,可以带着同样的三问进去:这个 kernel 在链路中的位置决定了哪些开销值得优化?融合的判定条件揭示了哪些语义边界?宿主侧预先算好的东西又有多少被悄悄藏进了 kernel?
参考资料
- RoPE 论文:RoFormer: Enhanced Transformer with Rotary Position Embedding
- YaRN:Efficient Context Window Extension of Large Language Models
- ggml-cuda 的 RoPE 实现 rope.cu
- ggml 的 RoPE 算子定义与 YaRN 修正维度计算 ggml.c
- llama.cpp KV 缓存与 RoPE 平移 build_rope_shift
- llama.cpp 上下文参数与 yarn_attn_factor 的合成逻辑
- vLLM 的 RotaryEmbedding 基类(预计算 cos/sin 缓存的对照实现)
- M-RoPE 相关的 llama.cpp PR #13870
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



