


llama.cpp 源码完全拆解(二十九):Meta device 与张量并行——一个虚拟设备如何把权重、KV 与归约切成多卡的一份
引言:默认按层切,为什么还要一个「虚拟设备」
在 llama.cpp 里,多卡的第一种直觉做法是按层切分(--split-mode layer,默认值):第 09 层放 GPU0,第 1019 层放 GPU1,数据像单条流水线一样依次穿过每块卡。KV Cache 跟着层走,第 l 层的 KV 就放在持有第 l 层的那块卡上。这种方案通信量最小——每步只需要把一页隐状态按顺序交给下一块卡——但它有一个天然的效率上限:任何时刻只有一块卡在干活。解码阶段每步只有一个 token,穿过 40 层的耗时是这 40 层串行时间之和,而其他卡全部空转。批量越大,流水线越容易被喂满;批量越小(尤其是持续的单序列解码),层切分的 GPU 利用率就越难看。
另一种做法是张量并行(Tensor Parallelism,TP,中文也叫张量并行或行并行):把同一层的权重矩阵按列或按行切成若干份,每块卡各算一份,再用一次跨卡归约把各部分和加回完整结果。这样每层所有卡同时工作,单步延迟被摊薄,代价是每一层都要做一次跨卡同步,对卡间互联带宽极其敏感。Megatron-LM 在 2019 年的论文里把 Transformer 的 MLP 与自注意力块各自切成「列并行 + 行并行」两段,中间只放一次 AllReduce,这套切法后来成了几乎所有大规模训练框架和 TensorRT-LLM、vLLM 的张量并行标准形态。
llama.cpp 对这个问题的回答分两步走。第一步是旧的 --split-mode row:把张量按行切片,但每层要靠 CPU 往返做归约,实测性能通常不如层切分,官方在多卡使用文档里直接把它标为已弃用(deprecated),只在新方案用不了时才该碰它。第二步是 --split-mode tensor,它引入了一个此前 llama.cpp 里不存在的东西:Meta device(虚拟设备)。这个设备不对应任何一块物理 GPU,而是把 N 块真实 GPU 包成一个,对外表现为「一块显存等于全体之和大、带宽等于全体之和的显卡」,对内则负责把这张大显卡上的每个张量拆成若干个切片、分给真实设备、并在需要时组织一次跨卡归约。
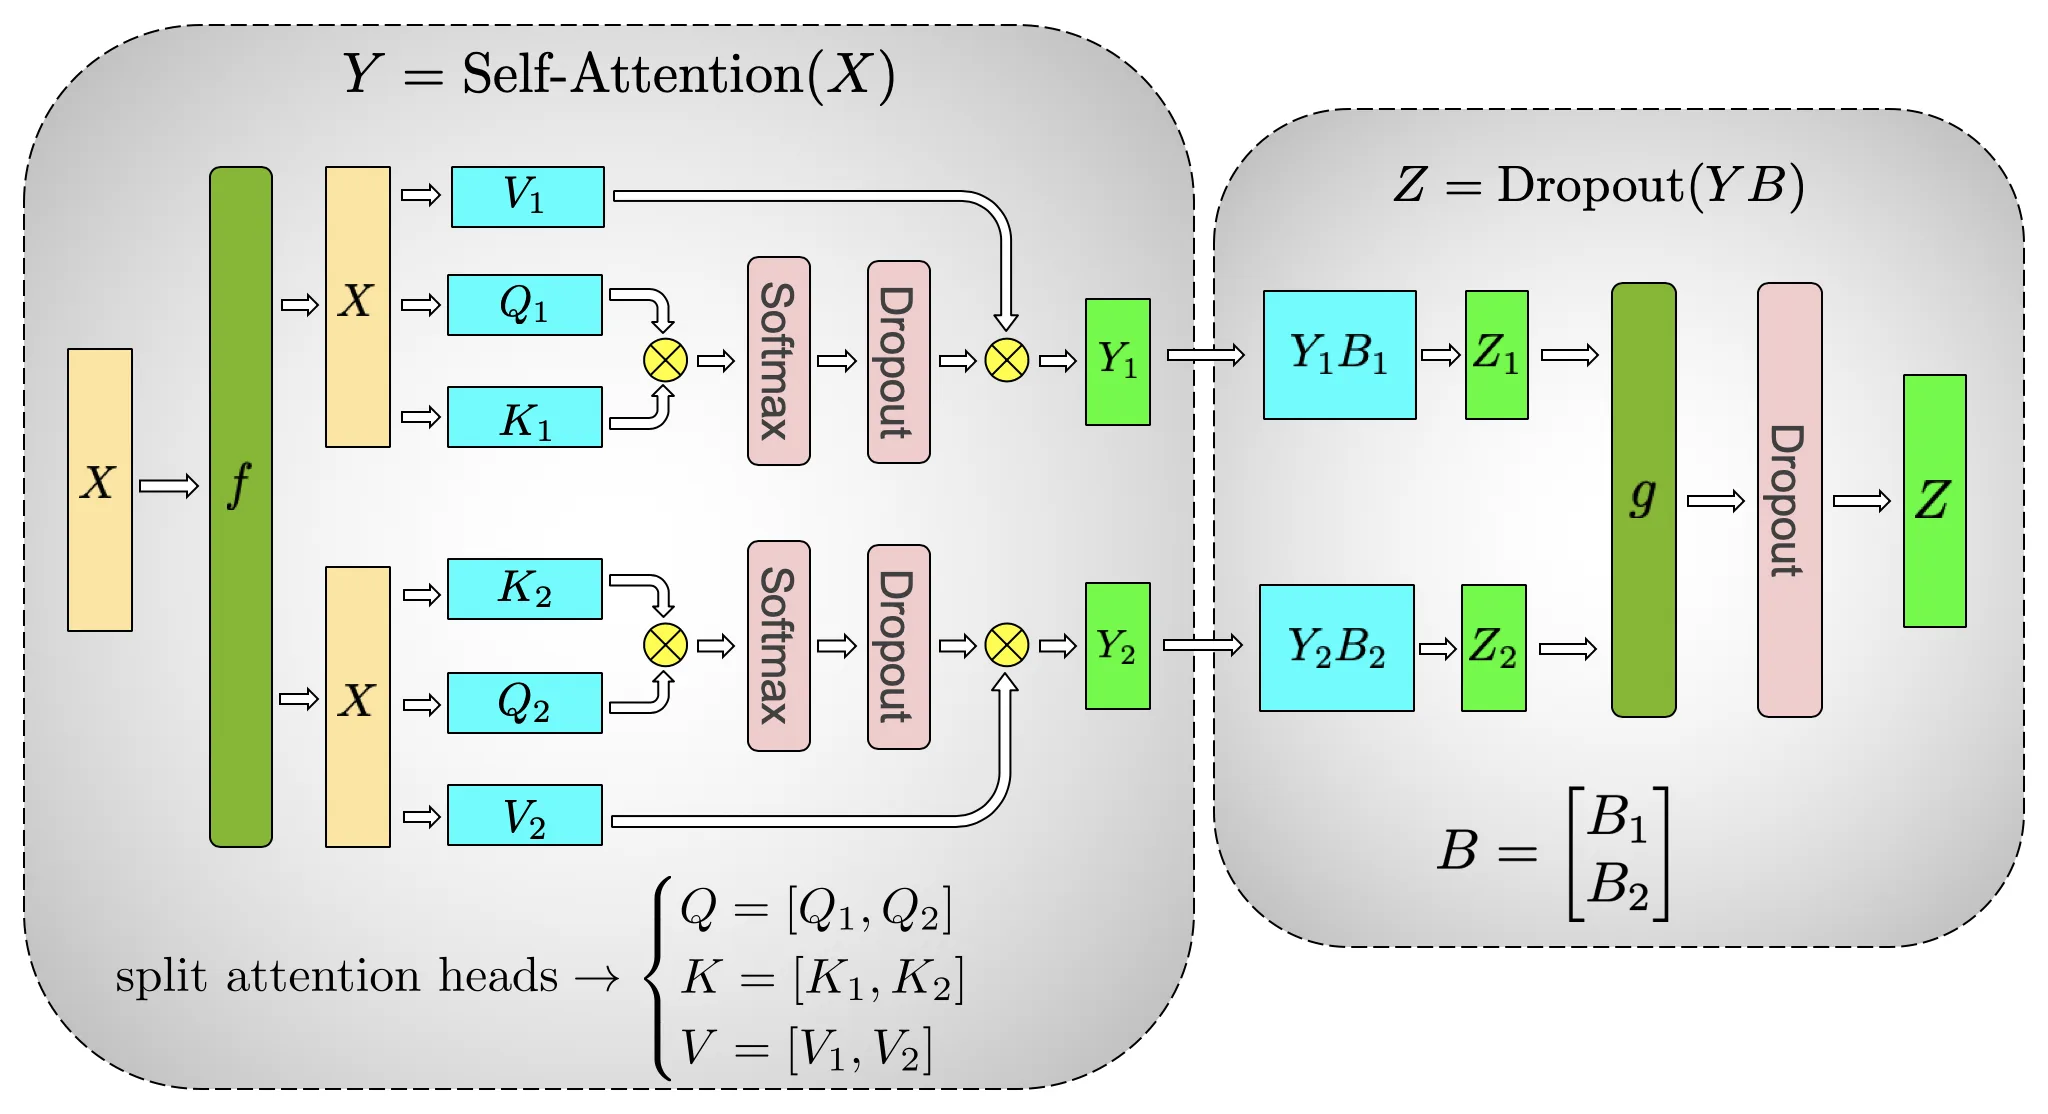
Megatron-LM 论文 Figure 2:左侧是 MLP 块,第一个 GEMM 按列切分(A=[A1 A2]),GeLU 可以在各卡独立计算,第二个 GEMM 按行切分(B=[B1;B2]),各卡得到部分和,在进入 dropout 前用一次 AllReduce 相加;右侧是自注意力块,多头注意力天然可以按头切开,输出投影再按行切分,同样只有一次归约。llama.cpp 的 Meta device 在做的事,本质就是把这一套切法搬进 ggml 的执行图里。图源:Megatron-LM 论文(arXiv:1909.08053),2019 年。图片为论文 PDF 第 4 页原图。
本篇沿着 ggml/src/ggml-backend-meta.cpp、ggml/src/ggml-backend.h、src/llama-model.cpp、src/llama.cpp 与 ggml/src/ggml-cuda/ggml-cuda.cu 的源码,回答三个问题:
- 切什么:一个 ggml 张量(权重、激活、KV 缓存)在 Meta device 上被切成多个切片时,切在哪个维度、切成多大、为什么必须先切成「段」再切段内;
- 怎么算:元信息(镜像 / 部分和)如何表达「这块卡要完整的值」和「这块卡只有一份部分和」,执行图里的
mul_mat、mul_mat_id、add、norm等算子如何在这个语义下自动推导出「这里需要一次 AllReduce」; - 怎么通信:一次归约什么时候被推迟、什么时候可以合并,NCCL、内部流水线、Butterfly 三条路径如何选择以及各自的前置条件。
四种切分模式:从 -sm 参数到真正接管模型的那一行
llama.cpp 的切分模式定义在 llama.h 的 llama_split_mode 枚举里:
enum llama_split_mode { LLAMA_SPLIT_MODE_NONE = 0, // single GPU LLAMA_SPLIT_MODE_LAYER = 1, // split layers and KV across GPUs LLAMA_SPLIT_MODE_ROW = 2, // split layers and KV across GPUs, use tensor parallelism if supported LLAMA_SPLIT_MODE_TENSOR = 3,};命令行入口在 common/arg.cpp 的 --split-mode:
{"-sm", "--split-mode"}, "{none,layer,row,tensor}","how to split the model across multiple GPUs, one of:\n""- none: use one GPU only\n""- layer (default): split layers and KV across GPUs (pipelined)\n""- row: split weight across GPUs by rows (parallelized)\n""- tensor: split weights and KV across GPUs (parallelized, EXPERIMENTAL)",把官方文档与源码放在一起看,四种模式的边界很清楚:
| 模式 | 权重 | KV Cache | 执行形态 | 现状 |
|---|---|---|---|---|
none | 全在一张卡 | 一张卡 | 单卡 | 稳定 |
layer | 按层连续切 | 跟层走 | 单进程内多 backend 流水 | 默认、兼容性最好 |
row | 按行切张量 | 未完整参与 | 旧 split buffer 方案 | 已弃用,官方建议改用 tensor |
tensor | 按张量维度切,含注意力头、FFN 中间维、词表 | 按 KV 头切 | Meta device,层内并行 + 每层归约 | 实验性,CUDA 上表现最好 |
row 被弃用的原因不是「行切分」这个想法本身错了,而是它在 llama.cpp 里的实现路径太局部:它通过 ggml_backend_split_buffer_type 让单个张量的行落在多块卡上,但调度器、KV 缓存、图切分并没有围绕「一份张量属于多块卡」重新组织,于是大量算子仍然需要回退、拷贝或串行化。tensor 则从 buffer 类型、设备抽象、图执行三个层次一起改,才把「一张量多卡」变成一等公民。
tensor 模式的入口:一个虚拟设备替换整张设备列表
真正把 LLAMA_SPLIT_MODE_TENSOR 变成执行形态的,是 src/llama.cpp 里的 llama_prepare_model_devices。默认设备选择路径下,它会跳过 CPU,把所有 GPU 收进一个列表,然后只向 model->devices 里放一个元素:
if (params.split_mode == LLAMA_SPLIT_MODE_TENSOR) { std::vector<ggml_backend_dev_t> devs; for (size_t i = 0; i < ggml_backend_dev_count(); ++i) { auto * dev = ggml_backend_dev_get(i); if (ggml_backend_dev_buffer_type(dev) == ggml_backend_cpu_buffer_type()) { LLAMA_LOG_INFO("%s: skipping %s (%s) for tensor parallelism\n", ...); continue; } devs.push_back(dev); } ... model->get_split_state_ud.n_devices = devs.size(); model->get_split_state_ud.model = model; gpus.push_back({ true, ggml_backend_meta_device( devs.data(), devs.size(), llama_meta_device_get_split_state, &model->get_split_state_ud) });}注意 gpus.push_back({true, ...}) 里的 true:它标记这个设备是 Meta device,而不是普通 GPU。后面的 model->devices 只会看到这一个「设备」;llama_model::n_devices() 返回的也是 1。换句话说,从 llama.cpp 的上层视角看,tensor 模式就是单卡;多卡的事实被完全封装在 Meta device 内部。这也解释了一个容易误会的现象:llama_context 里开启流水并行的条件是 model.n_devices() > 1 && split_mode == LAYER,tensor 模式天然不满足,也不会和层流水叠加。
ggml_backend_meta_device 的实现把 N 个真实设备包成一个 ggml_backend_meta_device_context,并提供三样东西:一个 Meta buffer type、一个 Meta buffer、一个 Meta backend。它的 get_memory 把子设备的 free/total 相加,get_props 对能力取交集(async、host_buffer、events、mmap 等都必须所有子设备支持),设备类型返回 GGML_BACKEND_DEVICE_TYPE_META。llama.cpp 在默认设备枚举里遇到 META 类型会直接 GGML_ABORT("fatal error"),防止把一个 Meta device 再套进另一个 Meta device。
硬性前置条件:FlashAttention 与架构白名单
tensor 模式不是所有模型、所有配置都能开。llama_context 构造时有两道检查:
if (model->split_mode() == LLAMA_SPLIT_MODE_TENSOR) { if (params.flash_attn_type == LLAMA_FLASH_ATTN_TYPE_AUTO) { LLAMA_LOG_INFO("%s: enabling flash_attn since it is required for SPLIT_MODE_TENSOR\n", __func__); params.flash_attn_type = LLAMA_FLASH_ATTN_TYPE_ENABLED; } if (params.flash_attn_type != LLAMA_FLASH_ATTN_TYPE_ENABLED) { LLAMA_LOG_ERROR("%s: SPLIT_MODE_TENSOR requires flash_attn to be enabled\n", __func__); return nullptr; } if (model->get_split_state_ud.n_devices == 1) { LLAMA_LOG_WARN("%s: SPLIT_MODE_TENSOR being used for a single device is not recommended\n", __func__); }}为什么必须开 FlashAttention?因为 KV Cache 在 tensor 模式下是按 KV 头切开的:第 r 块卡只持有自己那几颗头的 K/V。非 FlashAttention 的注意力路径在 llama.cpp 里默认把 K/V 当作一整块连续缓存来索引,无法直接吃「每块卡只有一段头」的布局;而 FlashAttention kernel 本来就是按 head 分块、按 KV 分块计算的,天然适配这种切片。把这条约束写成启动检查,比运行到一半再越界安全得多。
第二道检查在模型创建时:
if (params.split_mode == LLAMA_SPLIT_MODE_TENSOR && !llm_arch_supports_sm_tensor(arch)) { throw std::runtime_error(std::string("LLAMA_SPLIT_MODE_TENSOR not implemented for architecture '") + llm_arch_name(arch) + "'");}llm_arch_supports_sm_tensor 是一个「默认支持、显式排除」的白名单:绝大多数 Llama、Qwen 系架构直接返回 true;被排除的包括 Grok、MPT、PLAMO2、MiniCPM3、Gemma3n、Mamba/Mamba2、Jamba、Falcon-H1、OLMoE、DeepSeek2/DeepSeek3.2、GLM-DSA、Nemotron-H、Granite-Hybrid、Minimax-M2/M3、Mistral4、Kimi-Linear、BitNet、T5 等。原因不统一,但可以归成三类:
- KV 结构不是「每头一份连续 K/V」:MLA 的 latent KV、DeepSeek 的压缩 KV、GLM-DSA 的索引器缓存、Mamba 的递归状态,Meta device 的
AXIS_0/1/2 + MIRRORED + PARTIAL三态语义表达不了「一个 latent 向量跨头共享」这种布局; - 有跨设备的标量/全局统计:比如某些 MoE 架构的
amax缩放因子必须在全专家范围上求最大值,不能按设备切开后再合并(llama-graph.cpp里有一条专门的注释:the amax op cannot be split across devices, so these architectures are denied -sm tensor); - 混合/递归层:同一模型里既有全注意力层又有 SSM/滑窗层,KV 与状态槽的生命周期不同,Meta 切分需要额外的跨设备一致性证明,当前没有实现。
官方 docs/multi-gpu.md 还列出两条运行期约束:--fit(自动按显存拟合参数)在 tensor 模式下不支持,需要手动设置 --ctx-size;tensor 模式要求 KV Cache 使用非量化类型(f32/f16/bf16),量化 KV 的路径与 TP 的组合当前没有实现。这两条都不是「忘了做」,而是 Meta device 的切分粒度和量化块粒度、显存拟合逻辑之间还没对齐。其中量化 KV 这一条,维护者在 PR #23792 里写得非常具体:KV cache rotation 把张量展平后丢失了形状信息,而 Meta backend 的切分状态需要形状才能推导;这个 PR 的解法不是改计算图,而是给 split_state 加上「段重复次数」(本文前面讲的 n_r),让展平后的维度仍能保留段布局——这也解释了为什么 n_segments / nr 在代码注释里被强调是给 llama.cpp 的固定图准备的。
最后是一个容易忽略的细节:llama_context::set_sampler 在 tensor 模式下会拒绝后端采样器,并打印 backend sampling not supported with SPLIT_MODE_TENSOR; using CPU。原因是输出层按词表维切开后,每块卡只持有词表的一段 logits,而后端采样器假设自己能在一张卡上看到完整词表;退回到 CPU 采样,由 Meta buffer 的 get_tensor 把各卡的分片拼成完整 logits,逻辑上最省事。这个细节后面讲输出层切分时还会回来。
切分账本:三种轴语义与两种非轴语义
Meta device 的所有魔法都落在 ggml_backend_meta_split_state 这个结构上。它只有四个字段,却足以描述「一个张量在 N 块卡上怎么放」:
struct ggml_backend_meta_split_state { enum ggml_backend_meta_split_axis axis; int64_t ne[16*GGML_BACKEND_META_MAX_DEVICES]; uint32_t nr[16]; uint32_t n_segments;};axis 是切分轴;ne[s*n_bufs + j] 是第 j 块设备在第 s 段上分到的元素数;nr[s] 是该段在张量里重复的次数;n_segments 是段数。轴的定义在 ggml-backend.h:
enum ggml_backend_meta_split_axis { GGML_BACKEND_SPLIT_AXIS_0 = 0, GGML_BACKEND_SPLIT_AXIS_1 = 1, GGML_BACKEND_SPLIT_AXIS_2 = 2, GGML_BACKEND_SPLIT_AXIS_3 = 3,
GGML_BACKEND_SPLIT_AXIS_MIRRORED = 10, // all values on all backends GGML_BACKEND_SPLIT_AXIS_PARTIAL = 11, // each backend has a partial sum};轴 0/1/2/3 是「真切片」:每个设备拿到沿该维的一段连续切片。MIRRORED 是「全量复制」:每个设备都拿完整张量。PARTIAL 是「部分和」:每个设备都拿完整形状的张量,但内容只是某一部分贡献,需要跨设备求和后才能得到最终值。后面两种不是维度的特例,而是执行语义,Meta backend 的图切分、归约、零切片处理都围绕它们展开。
ggml 的维度约定:ne[0] 是行内维,ne[1] 是行数
要读懂切分表,必须先统一 ggml 的维度约定。ggml 张量的 ne[0] 是最内层、连续存储的维度,ne[1] 是下一层。一个线性层权重 W 的形状是 [in_features, out_features],ggml_mul_mat(W, X) 计算的是 W^T X,输出形状 [out_features, n_tokens]。所以:
- 切
ne[1]:把输出特征(列)分给多块卡。每块卡拿到W_i(形状[in_features, out_features/p]),输入X完整复制,输出Y_i = W_i^T X是完整输出向量的一段。这就是 Megatron 的列并行,各卡可以独立算,不需要立即通信。 - 切
ne[0]:把输入特征(行)分给多块卡。每块卡拿到W_i(形状[in_features/p, out_features])和输入的一段X_i,计算Y_i = W_i^T X_i。Y_i的形状是完整的[out_features, n_tokens],但它只是部分和,必须把各卡的Y_i相加才是最终结果。这就是行并行,输出侧需要一次 AllReduce。
把这个约定套到 Transformer 上,切分表几乎是自明的:Q/K/V 权重按输出维切(每块卡分到几颗头),输出投影按输入维切(每块卡只贡献自己那几颗头的结果),FFN 的 up/gate 按中间维切,down 按输入维切。llama_meta_device_get_split_state 就是把这套规则写成了一张正则表。
权重与 KV 的切分表
下表来自 llama_meta_device_get_split_state 的 get_tensor_config,是理解整个 Meta device 的核心。表中「轴」是枚举值,「对齐张量」是同一层里决定 rotation 的参考张量:
| 张量名模式 | 轴 | 对齐参考 | 含义 |
|---|---|---|---|
blk.*.attn_q.weight | AXIS_1 | attn_output.weight / ssm_out.weight | Q 投影按输出头切 |
blk.*.attn_k.weight / attn_v.weight | AXIS_1 | 同上 | K/V 投影按 KV 头切 |
blk.*.attn_qkv.weight | AXIS_1 | 同上 | 融合 QKV 按段切(见下一节) |
blk.*.attn_q.bias / attn_k.bias / attn_v.bias | AXIS_0 | 同上 | bias 只有一维,切法与权重的输出维等价 |
blk.*.attn_output.weight | AXIS_0 | — | 输出投影按输入维切,结果是部分和 |
blk.*.attn_output.bias | MIRRORED | — | 输出 bias 每卡一份 |
blk.*.attn_sinks.weight | AXIS_0 | attn_output.weight | 每头一个 sink,按头切 |
blk.*.attn_q_norm.weight / attn_k_norm.weight | AXIS_1(每头独立)或 MIRRORED(全头共享) | attn_output.weight | 依赖 ne[1] 是否为 1 |
blk.*.ffn_up.weight / ffn_gate.weight | AXIS_1 | ffn_down.weight / ffn_down_exps.weight | 按中间维切 |
blk.*.ffn_down.weight | AXIS_0 | — | 按输入维切,结果是部分和 |
blk.*.ffn_down.bias | MIRRORED | — | 每卡一份 |
blk.*.ffn_down_exps.bias | PARTIAL | ffn_down_exps.weight | MoE 的 down bias 是部分和 |
output.weight | AXIS_1 | — | 词表维切开,每卡一段 logits |
output.bias | AXIS_0 | output.weight | 与词表切片对齐 |
cache_k_l* / cache_v_l* | AXIS_0 | attn_output.weight | KV 缓存按 n_embd_k_gqa 维切,即按头切 |
cache_idx_k_l* / cache_idx_v_l* | MIRRORED | — | 索引器的单头投影镜像,缓存不能切 |
blk.*.ssm_* | AXIS_0 / AXIS_1 | ssm_out.weight | SSM 的 dt/a/beta、conv1d、out 各有切法 |
token_embd.weight / 其他 | MIRRORED | — | 默认镜像 |
这张表里有三个值得展开的设计点。
第一,为什么 Q/K/V 按输出维切,而 Q/K/V 的 bias 按轴 0 切? 因为 bias 的形状是 [out_features],它只有一维;权重的输出维是 ne[1],bias 的输出维就是 ne[0]。两者在物理上是同一个特征维,只是 ggml 的维度编号差了一位。所以 attn_q.bias 用 AXIS_0 不是「切输入维」,而是「切 bias 唯一的维」,这样每个 bias 切片才和对应的 Q 权重切片落在同一块卡上。
第二,attn_output.weight 为什么按 AXIS_0? 它的形状是 [n_embd_q, n_embd],输入维是 n_embd_q,也就是所有头的输出拼起来。第 r 块卡只持有自己那几颗头的 Q/K/V 和对应的注意力输出,所以它只能计算 W_o 中与这些头对应的输入行;各卡的结果相加才是完整的 attn_output。这就是 Megatron 图右侧的第二个 GEMM:行并行 + AllReduce。
第三,KV Cache 按 AXIS_0 切,切的是 n_embd_k_gqa。 在 llama.cpp 的 KV cache 张量里,cache_k 的形状是 [n_embd_k_gqa, n_ctx, n_stream](ne[0] 是每层所有 KV 头拼起来的维度,ne[1] 是上下文长度,ne[2] 是流数)。按 AXIS_0 切,意味着第 r 块卡只存自己那几颗头的 K/V,而 n_ctx 维完整保留——这正好匹配「每块卡独立做自己那几颗头的注意力」。如果按 n_ctx 切,每块卡只有一段上下文,就无法独立完成任一头的全上下文注意力,还要在每步做跨卡拼接,完全得不偿失。
段(segment):融合张量必须先拆成逻辑段再切
split_state 里的 n_segments 与 nr 不是装饰。很多模型会把 Q、K、V 拼成一个 attn_qkv.weight,甚至把 Q 和 gate 拼在一起;如果直接沿输出维按设备数均分,很可能把某个逻辑段从中间切断,导致某块卡拿到「半个 Q + 半个 K」这种无法解释的切片。Meta device 的做法是:先按逻辑段切,再在每个段内按设备切。
get_split_segments 里最典型的是融合 QKV:
if (std::regex_match(tensor_name, pattern_qkv_weight) || std::regex_match(tensor_name, pattern_qkv_bias)) { const int64_t n_embd_q = hparams.n_head(il) * hparams.n_embd_head_k(il); const int64_t n_embd_k = hparams.n_embd_k_gqa(il); const int64_t n_embd_v = hparams.n_embd_v_gqa(il); GGML_ASSERT(tensor->ne[axis] == n_embd_q + n_embd_k + n_embd_v); if (n_embd_k == n_embd_v) { return {{n_embd_q, 1}, {n_embd_k, 2}}; } // uneven K/V head sizes (e.g. MiMo d_k=192 d_v=128): split K and V as separate // segments so each device gets whole heads of both return {{n_embd_q, 1}, {n_embd_k, 1}, {n_embd_v, 1}};}当 K 和 V 的头维度一致时,返回两段:Q 一段(重复 1 次),K/V 合并一段(重复 2 次)。这样每块卡分到的输出切片是 [Q_i, K_i, V_i] 的拼接,Q/K/V 三段各自连续,且每段内部按同样比例切。当 K/V 头维度不一致(例如 MiMo 的 d_k=192, d_v=128),K 和 V 必须各自成段,否则按元素均分会把某个头切成两半。
Qwen3-Next/3.5 这类带 Q gate 的融合张量更复杂:Q 段要按 2 * n_embd_q 切(因为 Q 和 gate 拼在一起),K/V 段按 GQA 的比例重复。代码里还有专门处理 n_v_heads > n_k_heads 的广播模式:
// Qwen 3 Next: [k0_v0, k0_v1, k1_v2, k1_v3] (this is the default split pattern)// Qwen 3.5: [k0_v0, k1_v1, k0_v2, k1_v3] (needs segmenting of V on the scale of K)if (ud->model->arch == LLM_ARCH_QWEN3NEXT) { return {{key_dim, 2}, {value_dim, 1}};} else { const int64_t head_ratio = n_v_heads / n_k_heads; return {{key_dim, 2 + head_ratio}};}前者的 V 头按 K 头自然分组,后者的广播模式要求 V 段以 K 头为单位重复,才能保证每块卡上的 K/V 配对关系不被切错。这些细节说明:张量并行的切片不是「按元素数均分」,而是「按语义边界对齐」;均分只是最后一步。
对齐粒度:一个量化块不能被切成两半
确定了轴和段,还要确定每块卡的切片边界落在哪里。如果模型是 Q4_K 量化,一个块是 256 个元素(blck_size);如果把一个块从中间切开,两边都无法独立反量化。get_split_granularity 因此为每类张量计算一个「最小可切粒度」:
- 普通 FFN/注意力权重的粒度是
lcm(blck_size, 128)。128 是 CUDA 上很多量化 GEMM kernel 的 tile 宽度,取 128 的倍数可以让每块卡的切片仍然被高效 kernel 覆盖;如果模型头维度是 80 这种非 2 的幂,代码会逐步把blck_size_perf翻倍,直到「再翻倍会让每卡分到的元素少于一个 tile」为止。 - 注意力的粒度还要对齐头:
granularity_q = lcm(n_embd_q, blck_size_perf),其中n_embd_q = n_gqa * n_embd_head_k;K 的粒度是granularity_q / n_gqa,V 的粒度再按n_embd_head_v / n_embd_head_k缩放,保证 K/V 头大小不一致时仍按整头切。 attn_output.weight的粒度是granularity_head * n_embd_head_v,即「一颗头的输出维」的整数倍;这样行并行的切片边界与头边界对齐,每块卡贡献的输出行恰好是完整的头。- KV Cache 使用与 K/V 权重相同的粒度,保证缓存切片和权重切片一一对应。
真正分配时,代码先用 tensor_split 比例算出每块卡的「理想上界」,再向下取整到粒度:
int64_t high = tensor_split_scan.back() == 0.0f ? ne_s * (j+1)/ud->n_devices : ne_s * tensor_split_scan[j]/tensor_split_scan.back();if (high % g_s != 0) { high -= high % g_s;}split_state.ne[is*ud->n_devices + (j + tc.rotation) % ud->n_devices] = high - low;low = high;最后一块卡拿剩余的全部元素(ne_s - low),因此余数只会落在最后一块卡上;但 rotation 会按层轮换「哪块卡是最后一块」,避免某个 GPU 在所有层都多拿一截。rotation 的来源是 get_il_eff(il) % n_devices:它只统计「同类型的前序层」(是否递归层、是否滑窗层),这样在混合模型里,全注意力层和滑窗层各自形成独立的轮换序列。对注意力张量,rotation 用的是 hparams.kv_source(il) 的有效层号,保证「某层的 Q/K/V 切片」和「它实际读取的 KV 缓存所在层」落在同一块卡上——这是混合注意力模型正确性的前提。
镜像与部分和:不是所有张量都需要切
Embedding、输出 bias、LayerNorm 权重、RoPE 的 cos/sin 表、采样参数等,要么太小,要么被所有卡以相同方式使用,切成多份反而增加通信。默认分支返回 MIRRORED,每块卡各存一份完整副本。
PARTIAL 只出现在少数地方,最典型的是 MoE 的 ffn_down_exps.bias:每个专家对输出的贡献是一个部分和,多个专家并行时,bias 也要按专家贡献累加。代码里把它标成 PARTIAL,并在 split_state 初始化时用对齐张量 ffn_down_exps.weight 推导每块卡的分段大小:
if (split_state.axis == GGML_BACKEND_SPLIT_AXIS_PARTIAL) { GGML_ASSERT(tc.tensor_axis_0 != tensor); const ggml_backend_meta_split_state source_split_state = llama_meta_device_get_split_state(tc.tensor_axis_0, userdata); for (size_t j = 0; j < ud->n_devices; j++) { for (size_t is = 0; is < source_split_state.n_segments; is++) { split_state.ne[j] += source_split_state.ne[is*ud->n_devices + j] * source_split_state.nr[is]; } }}这段代码的含义是:PARTIAL 张量本身不按轴切,但它的「贡献分布」要跟它依赖的权重切片一致;ne[j] 记录的是第 j 块卡上那段贡献对应的元素数,后续零切片判断、归约延迟都会用到它。
Buffer 层:一个大张量,切成 N 个「简单张量」
切分表只描述了「怎么切」,真正让权重能落在多块卡上的是 buffer。Meta buffer type 的 alloc_buffer 为每块子设备各分配一个普通 GPU buffer:
for (size_t i = 0; i < n_simple_bufts; i++) { bufs.push_back(ggml_backend_buft_alloc_buffer(ggml_backend_meta_buft_simple_buft(buft, i), size)); max_size = std::max(max_size, ggml_backend_buffer_get_size(bufs.back()));}注意每个子 buffer 申请的都是完整的 size。这是因为 Meta buffer 在分配时并不知道里面会放什么张量、每块卡最后会分到多少;它只能保守地按「一个张量可能完整落在一块卡上」来预留。真正的裁量发生在 init_tensor:当装载一个张量时,Meta buffer 按 split_state 为每块卡创建一个形状缩小的 simple_tensor:
for (size_t j = 0; j < n_simple_bufs; j++) { if (split_dim >= 0 && split_dim < GGML_MAX_DIMS) { ne[split_dim] = 0; for (size_t s = 0; s < split_state.n_segments; s++) { ne[split_dim] += split_state.ne[s*n_simple_bufs + j] * split_state.nr[s]; } for (int i = 0; i < GGML_MAX_DIMS; i++) { if (tensor->nb[i] > tensor->nb[split_dim]) { nb[i] = tensor->nb[i] * ne[split_dim]/tensor->ne[split_dim]; } } } ggml_tensor * t_ij = ggml_new_tensor(simple_ctx, tensor->type, GGML_MAX_DIMS, ne); ...}这段代码里有两个关键点。第一,ne[split_dim] 不是「总量除以设备数」,而是该设备所有段的元素数按 nr 加权求和——对融合 QKV,第 j 块卡的 ne[1] 是 Q_j + K_j + V_j。第二,nb(stride)按比例缩放,而不是重新计算;这样 simple_tensor 仍然保持和原张量相同的布局语义,外部对它的切片、视图操作才能和原张量一致。
simple_tensor 的 data 默认指向子 buffer 的同一偏移:
t_ij->data = (char *) ggml_backend_buffer_get_base(simple_buf) + size_t(tensor->data) - size_t(ggml_backend_buffer_get_base(tensor->buffer));也就是说,第 j 块卡上的副本和原张量在各自 buffer 里处于同一个相对偏移。这一点看起来无关紧要,实际上是让「视图」能自动切片的基础:一个 attn_output 权重是 ggml_view_2d(attn_qkv) 的视图时,视图在原 buffer 里的偏移是已知的;simple_tensor 只要用同样的偏移,就能在每块卡的 buffer 里找到对应的那段数据。如果视图的偏移落在 split 维的「切缝」上,代码还会按比例缩放偏移:
if (!split_internal_offset) { t_ij->view_offs = t_ij->view_offs * ne[split_dim]/tensor->ne[split_dim];}split_internal_offset 的判断在代码里写得比较绕:如果偏移小于 split 维上单个元素的 stride,或者偏移小于 split 维之前所有维度的总大小,就认为它是「段内偏移」,不缩放;否则是「跨段偏移」,按比例缩放。对于 llama.cpp 的固定图结构,这个规则能覆盖所有真实出现的视图形态。
两个「计算容器」与旋转复用
除了 simple_tensor,Meta buffer 里还维护了 stc_compute[2] 两个计算容器。注释解释得很直白:外部视图如果直接使用同一个 buffer,会慢慢把 Meta buffer 的内存耗尽;当前方案是用两个轮换的「计算容器」来承载外部视图,每轮重建时切换一次。这是一个工程折衷:ggml 后端调度器在 Meta backend 执行图之外仍会创建一些视图,而这些视图的生命周期不由 Meta backend 控制,所以只能靠轮换容器兜底。
同时,split_state_cache 按「张量指针 + assume_sync」缓存推导结果,因为 get_split_state 要递归遍历 src,重建代价不低;缓存键还保存了张量结构体的快照,结构体一旦变化就整体清空。代码里有一条 FIXME:缓存大小理论上无界;这条 FIXME 在 llama.cpp 的固定图结构下不会真的爆掉,但对任意 ggml 图并不安全。
装载:切片怎么真正写进各块卡
权重从 GGUF 读出后,ggml_backend_meta_buffer_set_tensor 负责把连续的一整块数据拆分并写入各卡。它按 split_state 分三种情况处理:
简单切片(n_segments == 1 && nr[0] == 1) 走 switch,利用「张量连续」这一点把数据按 chunk_size_full = nb[axis + 1] 切成 chunk,每个 chunk 再按每块卡的 chunk_size_j = simple_tensor->nb[axis + 1] 分出去:
for (size_t j = 0; j < n_bufs; j++) { const ggml_tensor * simple_tensor = ggml_backend_meta_buffer_simple_tensor(tensor, j); const size_t chunk_size_j = simple_tensor->nb[split_state.axis + 1]; if (chunk_size_j == 0) continue; const size_t simple_offset = i_start * chunk_size_j; ggml_backend_tensor_set_2d(simple_tensor, (const char *) data + offset_j, simple_offset, chunk_size_j, i_stop - i_start, chunk_size_j, chunk_size_full); offset_j += chunk_size_j;}GGML_ASSERT(offset_j == chunk_size_full);镜像直接对每块卡写同一份数据。部分和则把数据按贡献者数量平均分给各卡:
size_t n_contributors = 0;for (size_t j = 0; j < n_bufs; j++) { n_contributors += split_state.ne[j] != 0;}...for (size_t i = 0; i < n_values; i++) { tmp[i] = ((const float *) data)[i] / n_contributors;}这一点很容易忽略:PARTIAL 张量在每块卡上存的不是「自己那部分原始贡献」,而是把总值除以贡献者数。这样每个设备都能在本地读到「平均贡献」,而一旦需要完整值,一次求和就能还原。这种写法让 PARTIAL 张量在不需要归约的路径上仍然可以被安全读取(读到一个不完整的近似值),同时保证了归约路径的正确性。
多段(融合 QKV) 走复杂分支:先按段取出,段内再按设备均分;对轴 0 的多段,按行切片(row_stride = nb[1]);对轴 1 的多段,按 stride 为 nb[2] 的行切片。代码里有大量断言,核心约束是「每块卡的切片元素数必须是量化块大小的整数倍」。这些断言在开发期把「切歪了」的问题挡在前面,而不是等运行时输出异常。
读取:把 N 份切片拼回一个完整张量
反向操作是 get_tensor。对 MIRRORED,取第 0 块卡的完整数据;对切片张量,按 offset / size 对齐到 chunk 边界,逐块卡读回再拼:
const size_t chunk_size_full = tensor->nb[split_state.axis + 1];const int64_t i_start = offset / chunk_size_full;const int64_t i_stop = (offset + size) / chunk_size_full;...for (size_t j = 0; j < n_bufs; j++) { const size_t chunk_size_j = simple_tensor->nb[split_state.axis + 1]; const size_t simple_offset = i_start * chunk_size_j; ggml_backend_tensor_get_2d(simple_tensor, (char *) data + offset_j, simple_offset, chunk_size_j, i_stop - i_start, chunk_size_j, chunk_size_full); offset_j += chunk_size_j;}这里没有实现 PARTIAL 的读取分支,default 直接 GGML_ABORT。这是有意的:部分和在语义上不是合法张量值,任何尝试直接读它完整内容的行为都应该被视为使用错误。llama.cpp 在采样时才需要完整 logits,而 logits 是普通切片(词表维切),并不走 PARTIAL;PARTIAL 只出现在 MoE down bias 这类中间量上,它们最终会作为计算图节点的一部分被归约吸收。
切分状态的推导:一个算子一张「语义表」
权重和 KV 的切分表只覆盖了「静态张量」。执行图里大量张量是计算出来的激活,它们的切分状态不能凭空查表,而要从输入推导。ggml_backend_meta_get_split_state 里按 op 类型分派了一整组 handler,每个 handler 的职责是:给定各输入源的 split state,推导出输出张量的 split state。这组 handler 是整个 Meta device 的语义核心,也是最适合拿来当「ggml 算子语义速查表」的部分。
行内算子:逐行处理,轴不变
handle_per_row 处理的算子有一共同点:每个输出行只依赖对应的输入行。RMSNorm、LayerNorm、softmax、sum_rows、argmax、cumsum、argsort、top_k、交叉熵等都归这一类:
auto handle_per_row = [&](const std::vector<ggml_backend_meta_split_state> & src_ss) { GGML_ASSERT(src_ss[0].axis != GGML_BACKEND_SPLIT_AXIS_0); return src_ss[0];};实现只有一句「返回输入状态」,但那个断言很关键:轴 0(行内维)被切开的张量不能逐行计算。一个 RMSNorm 需要对一行内所有元素求均方根;如果一行被切成两半放在两块卡上,每块卡只能算出「半行的均方根」,这不是正确的归一化。所以在 Meta device 的语义里,轴 0 切分是「危险的」,只有少数算子可以消费它;一旦把一行切给多块卡,后续逐行算子就必须拒绝,而不是悄悄算错。llama.cpp 的切分表之所以让 attn_output、ffn_down 的输出落在轴 0,正是因为紧跟它们的是需要归约的 add,而不是逐行算子。
广播二元运算:区分「切的那维被广播」与「真的元素级」
handle_bin_bcast 处理 add、sub、mul、div,以及 add_id:
if (src_ss[0].axis >= 0 && src_ss[0].axis < GGML_MAX_DIMS && tensor->src[1]->ne[src_ss[0].axis] == 1 && src_ss[1].axis == GGML_BACKEND_SPLIT_AXIS_MIRRORED) { return src_ss[0];}第一种情况:如果第一输入在切的那一维长度是 1(即它被广播),而第二输入是镜像的,那么输出沿用第一输入的切分。典型例子是 mul_mat 的部分和加上一个镜像的 bias:bias 在每个设备上都有完整副本,所以对每个设备的局部和做 add 不会引入额外语义,结果仍然是「部分和」。
第二种情况是 add_id:MoE 路由里把专家输出按 ids 写回 token 位置。代码里的断言要求 src[2](第三输入,通常是 token id 或 slot 表)是镜像的:
GGML_ASSERT(tensor->src[2] == nullptr || src_ss[2].axis == GGML_BACKEND_SPLIT_AXIS_MIRRORED);如果 ids 本身也被切开,每个设备只看到部分 token 的映射,输出就会漏行。这条断言是对「路由表必须在每块卡上都有完整副本」的强制。
matrix multiply:四象限规则
handle_mul_mat 是整组 handler 里信息量最大的。它对 mul_mat 与 mul_mat_id 共四个典型状态给规则,其他状态直接 GGML_ABORT:
src0(W) | src1(X) | 输出 | 解释 |
|---|---|---|---|
MIRRORED | MIRRORED | MIRRORED | 全复制矩阵乘,无需切分 |
AXIS_1 | MIRRORED | AXIS_0 | 列并行:输出沿输出维切,每卡一段 |
MIRRORED | AXIS_1 | AXIS_1 | 输入被切(如注意力后,token 维不切,头维切) |
AXIS_0 | AXIS_0 | MIRRORED(sync)/ PARTIAL(异步) | 行并行:输出是完整形状的部分和 |
最后一行最值得停一下。AXIS_0 + AXIS_0 的输出形状完整,这正是行并行的定义;但代码返回的是 assume_sync ? MIRRORED : PARTIAL。这意味着:推导时如果假定已经同步(assume_sync = true),结果就直接视为完整值;否则视为部分和。 这个布尔量在整份代码里无处不在:在 init_tensor 里,给 simple_tensor 定形状时用 assume_sync = true,因为此时讨论的是「结构上这块卡应有多大」;在执行图里切分并决定哪里插 AllReduce 时用 assume_sync = false,因为需要知道这里还没归约。一个 bool 把「值是否已经是全局值」和「内存布局」两件事区分开了。
对 MoE 的 mul_mat_id,同一个 handler 也适用:专家权重 ffn_*_exps 按轴 1 切分(每个设备持有部分专家或部分中间维),token 激活镜像,输出沿轴 0 部分和。代码里专门有一个 handle_mul_mat_id 之外的细节:当 mul_mat_id 的 ids 为镜像、专家权重沿轴 1 切时,每个设备只计算「自己那份专家 × 全部 token」的贡献,这正是专家并行(EP)与专家权重的行并行的结合。llama.cpp 把 MoE 的 TP 限制在「不切专家维」的架构上,正是因为这个组合还没在 Meta device 内部被完全证明。
reshape / view / permute / transpose:布局变化如何带动轴变化
这四个算子的输出和输入形状不同,切分轴也要跟着变换:
handle_reshape的核心逻辑是「找到输出里与输入切分轴前后元素数相同的那一维」。如果base_ne_in(输入切分轴及之前的所有元素数)可以整除输出某维前缀,返回{dim, nr = base_ne_out / base_ne_in};否则断言输入只有一段、无重复,返回{dim, nr = 1}。特殊情况是「完整维 0 切分变到下一个单例维」,那是为了适配 ggml 里[n, 1]与[1, n]的常见 reshape。handle_view先尝试「用 reshape 处理连续视图」;对非连续视图,比较 stride 找出「输出哪个 stride 等于输入切分维的 stride」,据此得到新轴。对 permute 过的张量,只有镜像/部分和状态才能直接沿用,其余形式还没有实现(代码里GGML_ABORT("view of permuted tensor not implemented"))。handle_permute与handle_transpose把轴按op_params或axis ^ 1重映射,只有轴 0/1 在转置下互换;轴 2/3 以及镜像/部分和保持不变。
这些 handler 的复杂度说明了一个事实:张量并行不是「切一下权重」就结束,而是要让整个计算图都保留「这份数据在哪几块卡上有哪一段」的信息。 一旦任何一环推导错误,输出就静默错误,而不是报错;所以代码里到处都是 GGML_ASSERT,宁可崩溃也不静默。
FlashAttention、RoPE 与 SSM 的专项 handler
ggml_flash_attn_ext 是唯一一个把「头」变成切分轴 2 的算子:
GGML_ASSERT(src_ss[0].axis == GGML_BACKEND_SPLIT_AXIS_2);const bool kv_split = src_ss[1].axis == GGML_BACKEND_SPLIT_AXIS_2 && src_ss[2].axis == GGML_BACKEND_SPLIT_AXIS_2;const bool kv_mirrored = src_ss[1].axis == GGML_BACKEND_SPLIT_AXIS_MIRRORED && src_ss[2].axis == GGML_BACKEND_SPLIT_AXIS_MIRRORED;GGML_ASSERT(kv_split || kv_mirrored);GGML_ASSERT(tensor->src[4] == nullptr || src_ss[4].axis == GGML_BACKEND_SPLIT_AXIS_0);return {GGML_BACKEND_SPLIT_AXIS_1, {0}, {1}, 1};为什么 Q 的切分轴是 2 而不是 1?FlashAttention 的张量布局是 [d_head, n_head, n_tokens](ne[0] 是头维度,ne[1] 是头数,ne[2] 是 token 数)。Q 权重按头切开后,Q 激活沿 n_head 维切,也就是 ne[1];但 FlashAttention 的输出是 [d_v, n_head, n_tokens],而注意力输出后接 attn_output 的行并行,它消费的输入沿 ne[0](n_head * d_v 拼成的维)切。handle_flash_attn_ext 返回轴 1 不是错,它与 attn_output.weight 的轴 0 对齐是同一次 reshape 的结果;代码里靠 handle_reshape 把 [d_v, n_head, n_tokens] 重排成 [n_head*d_v, n_tokens] 后轴从 1 变到 0。这条链说明:轴号在不同张量布局里的含义不一样,推导规则是围绕 stride 和元素数,而不是头本身。
handle_rope 很简洁:位置编码只在 ne[0] 内成对旋转,cos/sin 是镜像的,输入轴不变。这意味着如果某块卡持有的是一整颗完整的头(ne[0] 是完整 n_embd_head_k),RoPE 就能在这块卡上独立完成;这也解释了为什么 K/V 权重与 KV 缓存的切分粒度必须按整头对齐。
handle_ssm_conv 与 handle_gated_delta_net 是给递归/线性注意力准备的,它们处理轴 0 与轴 1 的互换,以及 Gated DeltaNet 的 6 源输出。handle_lightning_indexer 则强制所有输入镜像,这与「索引器是单头、其投影与缓存不能切」的设计一致(切分表里 cache_idx_k/v 也是 MIRRORED)。
未实现的算子:宁可停,不静默
calculate_split_state 的 default 分支:
default: { GGML_ABORT("ggml op not implemented: %s", ggml_op_name(tensor->op));}这是一条极其重要的设计选择。如果遇到没写 handler 的算子时返回一个「看起来合理」的状态,结果可能在某些层刚好正确、在某些层悄悄错误,排查代价极高;直接 abort,至少能在第一次运行就发现「这个算子不能被 Meta device 拆分」。llama.cpp 的架构白名单和这些 GGML_ASSERT/GGML_ABORT 是一对:白名单决定「哪些模型能用」,handler 决定「模型里哪些算子能用」;任何一边缺口,启动或首步就会暴露。
零切片与计算禁用
切分粒度可能导致某块卡在某个张量上分到 0 个元素(例如专家数少于设备数、或者某个融合段的切片刚好落在粒度边界)。对一个 simple_tensor 来说,ne 为 0 合法,但执行这个节点会毫无意义。init_tensor 在处理完源张量后,遍历所有源,若某源在某个设备上的元素总和为 0,就把该设备的 simple_tensor 的 GGML_TENSOR_FLAG_COMPUTE 清除:
for (int i = 0; i < GGML_MAX_SRC; i++) { ... for (size_t j = 0; j < n_simple_bufs; j++) { int64_t ne_sum = 0; for (size_t s = 0; s < split_state_src.n_segments; s++) { ne_sum += split_state_src.ne[s*n_simple_bufs + j] * split_state_src.nr[s]; } if (ne_sum == 0) { simple_tensors[j]->flags &= ~GGML_TENSOR_FLAG_COMPUTE; } }}清掉 COMPUTE 意味着该设备不会真正执行这个节点;后续归约时,代码会把这个节点的数据「置零」再参与求和。这与 PARTIAL 张量在装载时「除以贡献者数」的写法配合:没有贡献的设备会给出全零,而不是未初始化内存,求和后结果正确。
执行图切分:在每个「部分和」处切开,再一次性归约
推导出每个节点的 split state 之后,Meta backend 要做的事就明确了:把整张 ggml 图切成若干段,每段在所有子设备上并行执行,段与段之间插入一次 AllReduce。 切点不是随便选的,而是由 PARTIAL 状态决定。
ggml_backend_meta_graph_compute 的主循环大致如下(省略了节点映射和内存池细节):
int i_start = 0;for (int i = 0; i < cgraph->n_nodes; i++) { ggml_tensor * node = cgraph->nodes[i]; if (node->view_src != nullptr && node->view_src->op == GGML_OP_NONE && ggml_backend_buffer_is_host(node->view_src->buffer)) { continue; } const ggml_backend_meta_split_state split_state = ggml_backend_meta_get_split_state(node, /*assume_sync =*/ false); if (split_state.axis == GGML_BACKEND_SPLIT_AXIS_PARTIAL) { max_tmp_size = std::max(max_tmp_size, ggml_nbytes(node)); } const bool new_subgraph = i + 1 == cgraph->n_nodes || split_state.axis == GGML_BACKEND_SPLIT_AXIS_PARTIAL; if (!new_subgraph) { continue; } const int i_delayed = get_i_delayed(i); ... i = i_delayed; for (size_t j = 0; j < n_backends; j++) { bcj.cgraphs[n_subgraphs].offset = i_start; } n_subgraphs++; i_start = i + 1;}逐行解释:
- 跳过主机视图:
view_src是主机 buffer 的视图不参与 Meta 切分(后面init_tensor里也专门有ggml_backend_meta_is_host_view的判断),它们不是张量并行语义的一部分,而是 llama.cpp 图里用于常量、token 映射之类的辅助张量。 - 以
PARTIAL为切点:任何输出为部分和的节点,都意味着「下游需要完整值」,所以在这里结束当前子图;最后一个节点无条件结束。 get_i_delayed:这是性能优化的入口。它尝试把切点往后推,把「多个部分和节点的归约」合并成一次。后面单独讲。- 记录每个子图的起始节点:所有子设备共享同一组切点偏移(因为它们执行的是同一张图的同一段),但每个子设备用自己的
nodes[i](即该节点的simple_tensor)来构建子图。
一个例子:一层注意力的切点
以标准多头注意力为例,假设一个解码步的图大致是:
x = inputq = mul_mat(wq, x) // wq 轴1,输出轴0(头维切成完整头)k = mul_mat(wk, x) // 轴0v = mul_mat(wv, x) // 轴0q = rope(q)k = rope(k)kv = cpy(k, v, cache) // cache 轴0,与头对齐attn = flash_attn_ext(q, kv) // 输出轴1(头数),再 reshape 成轴0o = mul_mat(wo, attn) // wo 轴0,attn 轴0 → PARTIALo = add(o, attn_bias) // bias 镜像,仍是 PARTIALh = add(x, o) // x 镜像?在残差处需要完整值 → 切点o 是 PARTIAL,所以图在 o(或 add(o, bias))处切开:所有子设备先算到 o,然后对 o 做一次 AllReduce,得到完整输出;之后每个设备用完整 h 继续算下一层。这里有一个容易忽略的细节:attn 在 flash_attn_ext 的输出是轴 1,而 wo 的输入是轴 0;中间必然有一次 reshape/view 把 [d_v, n_head, n_tokens] 变成 [n_head*d_v, n_tokens]。handle_reshape 会把轴从 1 搬到 0,从而让 mul_mat 看到 src0=AXIS_0, src1=AXIS_0,推导出 PARTIAL。如果没有这一步,mul_mat 会因为状态不匹配直接 abort。
一个标准层因此至少有两个切点:注意力输出投影之后、FFN 的 down 投影之后。40 层的模型每步大约有 80 次 AllReduce;这就是张量并行「延迟换通信」的账单。
延迟归约:把多次 AllReduce 合并成一次
如果严格按每个 PARTIAL 节点切一次,MoE 层会非常吃亏。MoE 的 mul_mat_id(down_exps, ...) 输出形状是 [n_embd, n_expert_used, n_tokens],每个专家一份部分和;随后图里会对专家维做一系列 view 和 add,把 top-k 专家的贡献加起来。如果每个专家单独归约一次,就要做 n_expert_used 次 AllReduce;但 AllReduce 是线性的,先加再归约 与 先归约再加 结果相同:
只要这些部分和分支之间没有别的消费者,就可以把「加」提前到归约之前。get_i_delayed_branch 就是干这个的:
- 从当前
PARTIAL节点出发,跳过一串「只被下一个节点消费、且本身是镜像」的中间节点; - 识别
ADD_ID模式:src[1]是PARTIAL、src[2]是镜像(路由 id / slot 表),允许把归约推迟到ADD_ID之后; - 识别「
MUL链」:部分和乘以镜像标量(比如路由权重、缩放因子),乘法对每个设备独立,因而可以推迟; - 识别「
VIEW× n +ADD× (n-1)」:这是把[n_embd, n_expert_used, n_tokens]按专家维切片再逐个相加的模式;只要每个 view 的view_src、偏移、形状、使用次数都严格匹配,就把整段归约推迟到最后一个ADD之后。
get_i_delayed 还在两个独立的部分和分支之间做合并:如果 AllReduce(a) 和 AllReduce(b) 的结果随后被一个 ADD 消费,且 a、b 形状/类型一致,那么可以把两个分支先相加,再做一次归约。代码里用 ggml_node_get_use_count 严格检查「每个节点只被消费一次」,避免把还有别的消费者的部分和提前合并。
零切片与延迟归约的交互
延迟归约把切点推到后面,会带来一个边界问题:如果某块卡在原始 PARTIAL 节点 i 上分到 0 个元素(COMPUTE 被清掉),那么它后面的节点(直到新切点 i_delayed)也不会产生有效数据。代码的处理是:
if (i_delayed > i) { for (size_t j = 0; j < n_backends; j++) { if ((bcj.nodes[i]->flags & GGML_TENSOR_FLAG_COMPUTE) == 0) { for (int ii = i + 1; ii <= i_delayed; ii++) { bcj.nodes[ii]->flags &= ~GGML_TENSOR_FLAG_COMPUTE; } } }}也就是说,零切片的「不计算」状态要沿着延迟区间传播;否则某块卡在 i 处跳过计算,却在 i+1 处用未初始化数据参与了一个 add,归约结果就会被污染。归约时还会有一个专门的「置零」步骤(allreduce_fallback 开头),把 COMPUTE 被清掉的节点用 GGML_OP_FILL 写成 0,确保它们对求和的贡献确实是零。
这一段是 Meta device 里最不显眼、却最容易出正确性问题的部分:它同时涉及「部分和」「零切片」「延迟归约」「使用次数」四个状态,任何一个组合漏掉都会导致偶发的数值错误,而不是稳定的崩溃。代码里大量 use_count 断言和 GGML_ASSERT 就是为此存在的。
三条通信路径:NCCL、内部流水线与 Butterfly 兜底
Meta backend 自己不实现具体的 AllReduce,它把通信委托给子设备所属的 backend registry。构造函数里先取第一个子 backend 的 registry,查找 ggml_backend_comm_init:
if (n_devs > 1) { ggml_backend_comm_init_t comm_init = (ggml_backend_comm_init_t) ggml_backend_reg_get_proc_address( ggml_backend_dev_backend_reg(ggml_backend_get_device(simple_backends[0])), "ggml_backend_comm_init"); if (comm_init != nullptr) { comm_ctx = comm_init(simple_backends.data(), simple_backends.size()); }}if (comm_ctx != nullptr) { comm_allreduce = (ggml_backend_comm_allreduce_tensor_t) ggml_backend_reg_get_proc_address(..., "ggml_backend_comm_allreduce_tensor"); GGML_ASSERT(comm_allreduce != nullptr);}这是一套典型的「可选能力」协议:backend 不提供 comm_init,Meta device 就不创建通信上下文,所有归约走自己的通用实现;提供就优先用 backend 的专用实现。对 CUDA 来说,ggml-cuda.cu 实现了这套协议,并且内部还有三层选择。
CUDA 的三层选择:NCCL → 双卡内部流水线 → Butterfly
ggml_backend_cuda_comm_init 先检查所有子 backend 是否都是 CUDA;只要有一个不是,就返回 nullptr,Meta device 走通用路径。然后读环境变量 GGML_CUDA_ALLREDUCE:
const char * env = getenv("GGML_CUDA_ALLREDUCE");if (!env) {#if defined(__linux__) ggml_backend_cuda_comm_init_nccl(ret);#else ggml_backend_cuda_comm_init_internal(ret);#endif} else { if (env_str == "nccl") { ggml_backend_cuda_comm_init_nccl(ret); } else if (env_str == "internal") { ggml_backend_cuda_comm_init_internal(ret); } else if (env_str == "none") { ggml_backend_cuda_comm_init_none(ret); } else { GGML_LOG_WARN("unknown GGML_CUDA_ALLREDUCE value: %s\n", env); ggml_backend_cuda_comm_init_none(ret); }}三条路径的分工:
- NCCL:Linux 默认,编译时需
-DGGML_CUDA_NCCL=ON(官方文档称默认开启)。用ncclCommInitAll为每块卡建 communicator;如果 CUDA 用了虚拟设备(device_count > physical_device_count),NCCL 路径会被禁用并退回内部路径,因为 NCCL 要求每个 rank 对应一个不同的物理 GPU。NCCL 失败也会退回内部路径,并打印NCCL init failed (...); falling back to internal AllReduce。 - 内部流水线(internal):只支持 2 块卡。
ggml_cuda_ar_pipeline_init成功才启用;代码里ggml_backend_cuda_comm_allreduce_internal直接GGML_ASSERT(n_backends == 2)。这意味着 3 卡及以上、又没编 NCCL 的机器,不会用这条路径,而是直接落到 Butterfly。 - Butterfly:
comm_init_none把try_allreduce设为一个永远返回 false 的函数。返回 false 后,Meta backend 的allreduce_fallback接手,用 ggml 图在每块卡上做「拷贝 + 相加」,按 log2 步数做蝶形归约。它不依赖 NCCL,也不要求卡数等于 2,是最通用的兜底。
ggml_backend_cuda_comm_allreduce_tensor 只是把调用转发给初始化时选中的函数指针;任何一次调用返回 false,Meta backend 都会对这一次调用走通用 fallback,而不是整体切换。这种「按次回退」的设计允许 NCCL 在某些形状/类型上失败时仍然继续跑,只是慢一点。
NCCL 路径内部:小张量 FP32,大张量 BF16
NCCL 路径不是无脑 ncclAllReduce。代码先按「张量元素数」和「卡数」决定是否走 FP32:
// For small tensors, simply reduce them as FP32.// The following heuristic for how "small" a tensor should be is based on RTX 4090s connected via 16x PCIe 4.0.if ((n_backends <= 2 && ne < 32768) || (n_backends == 3 && ne < 131072) || (n_backends >= 4 && ne < 262144)) { ...}小张量直接 FP32 求和,避免 BF16 压缩/解压的额外 kernel 和精度损失;大张量则先转 BF16,做 ncclBfloat16 求和,再转回 FP32。这个阈值的注释很坦诚:它是按 RTX 4090 + PCIe 4.0 x16 实测出来的经验值,不是理论最优。对带宽受限的大张量,BF16 把通信量减半,收益远大于转换开销;对小张量,转换的固定开销和精度损失更不划算。
NCCL 路径还会处理「零切片」:对 GGML_TENSOR_FLAG_COMPUTE 被清掉的 rank,先 cudaMemsetAsync 把它的张量置零,再参加 ncclAllReduce。这保证没有贡献的 rank 不会把未初始化数据加进去。
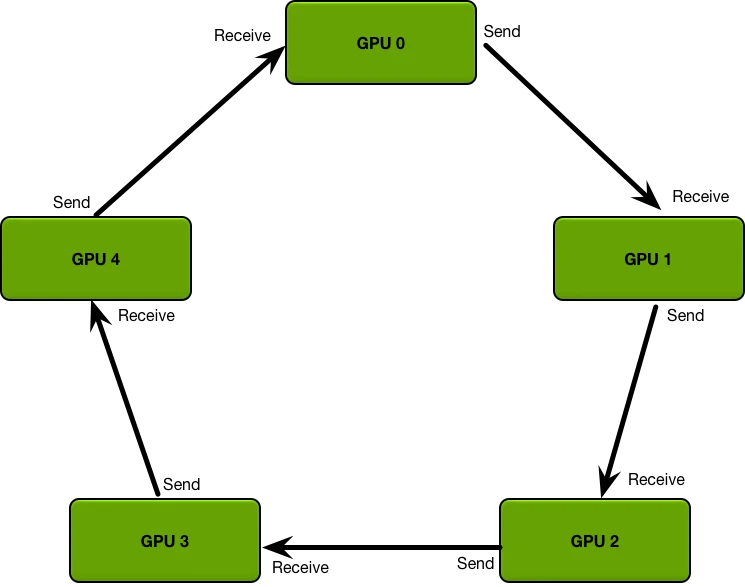
Ring AllReduce 的拓扑。NCCL 在实际选择算法时会根据拓扑和消息大小在 Ring、Tree 等算法之间切换,但核心思想都是「每块卡只与邻居交换」,从而把带宽压力摊到所有链路上。llama.cpp 的 CUDA 路径把归约交给 NCCL,自己不关心具体是 Ring 还是 Tree;它只负责在正确的位置调用 `ncclAllReduce`。图源:Andrew Gibiansky, Bringing HPC Techniques to Deep Learning,2017 年 2 月。
Butterfly 兜底:不依赖 NCCL 的通用归约
通用 fallback 的实现值得逐段看,因为它展示了「没有集合通信库时,如何用已有后端 API 拼出 AllReduce」。
首先,步数在 Meta 上下文构造时就定了:
n_reduce_steps = std::ceil(std::log2(n_devs));然后,每一步都在每个子设备上分配一块 max_tmp_size 的临时 buffer;max_tmp_size 是所有 PARTIAL 节点里最大的 ggml_nbytes。这块 buffer 是「接收对端数据」的暂存区,使用双缓冲(i_buf 在步骤间切换)以避免同一块 buffer 同时被读写。
接着处理非 2 的幂的卡数。代码取 offset_j = n_backends/2,再向下找到最大的 2 的幂:
size_t offset_j = n_backends/2;while ((offset_j & (offset_j - 1)) != 0) { offset_j--;}const size_t offset_j_max = offset_j;例如 6 卡:offset_j_max = 2;先把第 4、5 块卡的数据折进第 0、1 块(push_data(4,0)、push_data(5,1)),然后在 0..3 上做 offset=2,1 的蝶形归约;最后把结果从 0、1 拷回 4、5。3 卡:offset_j_max=1,先把第 2 块折进第 0 块,再做 offset=1 的蝶形。
push_data 做三件事:
ggml_tensor * node_tmp = get_node_aux(node_dst);set_tmp_data(node_tmp, j_dst, i_buf);ggml_backend_tensor_copy_async(bcj_src.backend, bcj_dst.backend, node_src, node_tmp);
ggml_tensor * node_red = get_node_aux(node_dst);node_red->view_src = node_dst->view_src == nullptr ? node_dst : node_dst->view_src;node_red->view_offs = node_dst->view_offs;node_red->op = GGML_OP_ADD;node_red->src[0] = node_dst;node_red->src[1] = node_tmp;node_red->flags |= GGML_TENSOR_FLAG_COMPUTE;ggml_backend_view_init(node_red);...- 把源卡上的结果异步拷贝到目标卡的临时 buffer;
- 在目标卡上构造一个单节点的
ADD图,把「目标卡当前值」和「临时 buffer」相加,结果写回目标卡; - 用
ggml_backend_graph_compute_async执行这个单节点图。
这一套完全用 backend 的 tensor_copy_async 和 graph_compute_async 实现,不依赖任何集合通信 API;代价是每一步都要走一次 host 侧的图构造与提交,延迟远高于 NCCL,但胜在「任何 backend 都能跑」。set_tmp_data 的注释也说明了这一点:临时 buffer 是按 backend 分配的,拷贝是跨 backend 的,所以即使子设备分属 CUDA、Vulkan、RPC 等不同 backend,也能工作(只是更慢)。
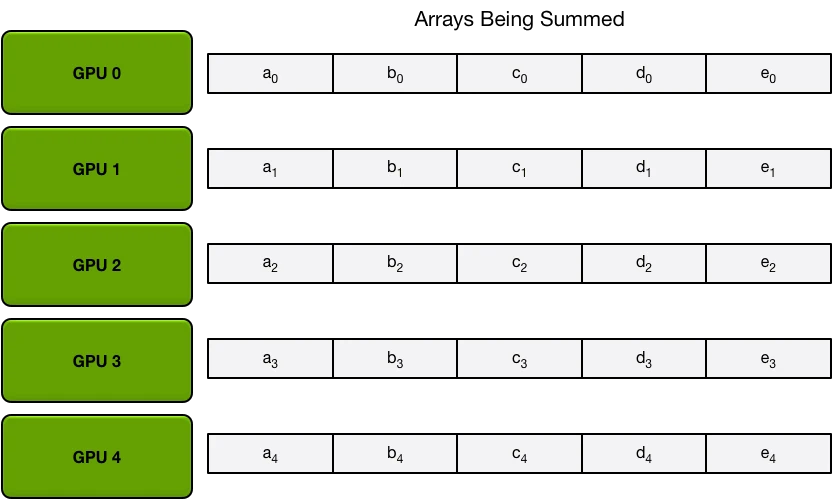
AllReduce 的数据分块视角。无论 Ring 还是 Butterfly,归约的本质都是把一条长向量切成块,让每个 rank 负责一块的最终结果,再通过若干轮交换把其他 rank 的贡献汇总过来。llama.cpp 的 Butterfly fallback 不切块,而是按 log2 步数直接对整条向量做「拷贝 + 相加」,因此实现简单,但每步的临时 buffer 要能装下整个部分和。图源:同上,Andrew Gibiansky,2017 年。
归约的账单:每层两次,每 token 几十次
把切点和通信路径放一起,就能算出张量并行的通信账单。设隐藏维为 ,元素字节数为 ,卡数为 ,层数为 。每个标准层至少两次归约:
- 注意力输出投影之后一次,向量长度 ;
- FFN 的 down 投影之后一次,向量长度 。
每 token、每层的归约数据量是 。Ring AllReduce 在每个 rank 上的流量约为:
对整个模型( 层),每 token 每 rank 的流量约为:
取 、(BF16)、、,则 。这个数字看起来不大,但它是每 token 的;解码速度 100 token/s 时约 78 MB/s,带宽不是瓶颈,延迟才是:每 token 有 次 AllReduce,如果每次因同步、kernel launch、NCCL 调用花 2050 µs,单 token 就要多出 1.33.2 ms。这就是为什么张量并行在 decode 阶段对「小消息、低延迟」的互联(NVLink)极其敏感,而在普通 PCIe 上往往不如层切分。
预填充阶段则是另一笔账。预填充一次处理 个 token,每次归约的向量长度变成 ,每层流量变成 ;层切分只需要在层边界传递 一次,张量并行却要传 次。于是:
对 、,张量并行的预填充通信量约为层切分的 21 倍。这解释了官方文档的结论:layer 适合预填充吞吐,tensor 适合解码延迟;两者不是替代关系,而是不同阶段的取舍。
张量并行的典型切法:Llama 层与注意力头
把前面所有机制放到一个具体的层上,就能看清一次 decode 步的实际数据流。以 Llama 系列的 GQA 注意力为例,设隐藏维 、32 个 Q 头、8 个 KV 头、头维度 128、FFN 中间维 11008、4 卡 TP。
Q/K/V 投影。attn_q.weight 形状 [4096, 4096],沿 AXIS_1 切成 4 份,每卡 [4096, 1024],正好是 8 颗 Q 头。attn_k.weight 形状 [4096, 1024](8 个 KV 头 × 128),每卡 [4096, 256],2 颗 KV 头。attn_v.weight 同理。输入 x 是镜像的,每卡算自己那 8 颗 Q 头和 2 颗 KV 头。
RoPE。q 的形状 [128, 8, T](在 ne[1] 上是每卡的 8 个头),handle_rope 要求 cos/sin 镜像、输入轴不变;因为每颗头的 128 维完整落在一张卡上,RoPE 可以在本卡独立完成。
KV 缓存写入。cache_k 沿 AXIS_0 切,每卡缓存自己的 2 头 K/V;写入时 ggml_backend_meta_buffer_set_tensor 把 K 切片按头边界分到各卡。因为切分粒度按整头对齐,写入的每一段都是完整头。
注意力。ggml_flash_attn_ext(q, k_cache, v_cache, ...),Q 的轴是 2(头数),K/V 缓存也是 2(头数),handler 断言 kv_split || kv_mirrored,返回输出轴 1。每卡算自己 8 颗 Q 头对 2 颗 KV 头的注意力(GQA 每颗 KV 头被 4 颗 Q 头共享,这 4 颗 Q 头和它共享的那颗 KV 头在同一块卡上,因为切分粒度按头对齐)。
输出投影。attn_output.weight 形状 [4096, 4096],沿 AXIS_0 切成 4 份,每卡 [1024, 4096]。注意力输出经 reshape 变成 [1024, T](每卡 8 头 × 128),与 wo 的输入维匹配;每卡算出 [4096, T] 的部分和。这里是第一个切点:AllReduce 后得到完整 o。
残差与 FFN。h = x + o,x 是镜像的完整值,o 归约后也是完整值,残差在本卡完成。FFN 的 ffn_gate/up 沿 AXIS_1 切(中间维 11008 → 每卡 2752),ffn_down 沿 AXIS_0 切;第二个切点在 ffn_down 之后。
这里有一个很实际的约束:KV 头数必须能被卡数整除,且每卡至少 1 个 KV 头。8 个 KV 头用 4 卡正好;如果 16 个 KV 头、8 卡也可以;但 8 个 KV 头用 16 卡就会出现「每卡分不到整头」,代码会按粒度向下取整,某些卡分到 0 个头,被 COMPUTE 禁用后在归约里贡献零——功能上仍正确,但那几块卡实际上只是在帮忙做通信,没有计算收益。官方对 --split-mode tensor 的推荐是「卡数不要超过 KV 头数」,原因就在这里。
输出层与采样:词表维切开后怎么拿 logits
output.weight 形状 [d, V],沿 AXIS_1 切,每卡 [d, V/p]。输出 logits 形状 [V, T],沿 AXIS_0 切,每卡 [V/p, T]。这就带来采样问题:argmax、top-k、top-p 都需要全局词表视图。
llama.cpp 的做法是:llama_context::set_sampler 在 tensor 模式下拒绝后端采样器,退回 CPU 采样。CPU 侧的采样器通过 get_tensor 读 logits;get_tensor 按 AXIS_0 切片把各卡的 [V/p, T] 拼成完整的 [V, T],再在 CPU 上做 argmax/top-k。这个方案正确性没问题,但代价是把每步的完整 logits(BF16 下 字节,V=15 万、T=1 时约 300 KB)从 GPU 拷回 CPU,并做一次拼接;采样本身在 CPU 上比 GPU 慢不少,但对单 token 解码的绝对延迟影响还在可接受范围。
另一种做法是「分布式 argmax + 分布式采样」:每卡先算自己那段词表的局部最大/局部分布,再做一次跨卡合并。这需要额外的通信和 GPU 侧归约,llama.cpp 目前没有做,原因很可能是:采样参数(温度、top-p、惩罚)复杂,greedy 与采样的合并逻辑不同,而且 token 频率很低,CPU 往返的收益不明显。将来如果解码批量变大、采样成为瓶颈,这块会是 Meta device 的一个自然扩展点。
哪些地方「不需要」通信
张量并行的设计之所以可行,是因为很多算子只在局部数据上工作,切分后仍然是正确的:
- 逐行算子(RMSNorm、softmax):每行完整落在已归约的完整张量上(切点之后),所以每卡可以独立算自己的行。
- RoPE:每颗头完整,每卡独立。
- SiLU/GELU、逐元素缩放、bias 加法:镜像或已归约张量上的逐元素操作,无通信。
- 残差:切点之后
x和o都是完整值,无通信。 - KV cache 写入:每卡写自己那几颗头,无通信。
- 注意力的 QK^T 与 PV:每颗 Q 头只和同卡上的 KV 头交互(由切分粒度保证),无通信。
这正是张量并行的核心设计原则:把通信压到「必须跨卡求和」的两处(wo 与 ffn_down),其余算子保持局部性。任何需要「全张量视图」的算子,要么在切点之后(此时已完整),要么必须被明确拒绝(handle_per_row 的轴 0 断言、GGML_ABORT 的未实现算子)。
调优:把归约藏进计算,还是把计算摊给更多卡
Meta device 的实现决定了几个可以调的旋钮,调优的目标只有一个:让每次 AllReduce 的等待时间小于它前面那段计算的收益。
卡数不要超过 KV 头数
这是最硬的一条。每块卡至少要分到一颗完整的 KV 头,否则它的计算量为零,只剩下通信和显存占用。Llama-3 8B 有 8 个 KV 头,最多用 8 卡 TP;Qwen2.5 7B 有 4 个 KV 头,最多 4 卡;一些 GQA 比例更激进的模型只有 2 个 KV 头,2 卡以上就没有意义。-sm tensor 在超过 KV 头数时不会报错,它会按粒度把某些卡切成 0 头并禁用其计算,功能正确但性能不会提升——这是「能跑」和「值得跑」的区别。
用 -ts 处理异构显存
-ts 3,1 让第一块卡拿 3/4 的模型、第二块拿 1/4。Meta device 在分配每个张量时按这个比例算上界,再对齐到粒度;rotation 会把余数轮换到不同卡,避免固定某块卡总是多拿。对「一张 24GB + 一张 12GB」的机器,-ts 2,1 比默认均分更合理。注意 -ts 的比例对所有张量都生效,包括 KV 缓存;如果比例和 KV 头数不匹配,可能出现某块卡分不到整头,代码会按粒度向下取整,最终仍能跑,但负载会更偏。
优先 NCCL,2 卡可对比 internal
Linux + CUDA + 编译了 NCCL 时默认走 NCCL;如果 2 卡机器上 NCCL 表现异常,可以临时 GGML_CUDA_ALLREDUCE=internal 对比。internal 路径只支持 2 卡,且要求张量是 F32/F16/BF16、连续、16 字节对齐;不满足时会按次回退到 Butterfly。GGML_CUDA_ALLREDUCE=none 强制 Butterfly,适合排查「通信库本身是否有问题」。GGML_CUDA_P2P=1 打开 CUDA peer-to-peer,能减少跨卡拷贝走主机内存的开销,但官方文档明确警告:某些主板/BIOS(尤其开 IOMMU)会崩或算错,出现不稳定就先关掉。
批量越大,TP 越划算
decode 单序列时,每层计算量小、归约次数多,TP 的收益被延迟吃掉;当 --parallel 或并发请求把 batch 撑大,每层计算量随 token 数增长,而归约次数不变(每层两次),TP 的摊薄效果才明显。llama-server 场景下,适当提高并发、让调度器把多条请求拼进同一批,比单纯增加卡数更有效。预填充阶段则相反:token 数一大,归约数据量按 token 数增长,TP 的通信量迅速超过层切分;如果业务以长 prompt 预填充为主,layer 往往更稳。
显存账:镜像张量是隐形成本
MIRRORED 的张量在每块卡上都有一份完整副本,包括 token embedding、输出 bias、部分 norm 权重、RoPE 表。Embedding 往往很大(V×d,15 万×4096×2 字节 ≈ 1.2 GB),如果它在每块卡上都镜像,4 卡就多花 3.6 GB 显存。当前切分表把 token_embd.weight 放在默认的 MIRRORED 分支,这是一个明确的取舍:embedding 查表是随机访问,切开后需要跨卡 gather,反而更慢;镜像则让每块卡都能本地查表。对显存紧张的配置,这部分开销要靠 -ts 或减少卡数来平衡。
观测:先确认「真的在用 Meta device」
启动日志里应该出现:
llama_prepare_model_devices: creating a Meta device for tensor parallelism from 4 devices:llama_prepare_model_devices: - device 0: CUDA0 (NVIDIA ...)...如果看到 SPLIT_MODE_TENSOR being used for a single device is not recommended,说明只选到了一块卡;如果看到 NCCL is unavailable, multi GPU performance will be suboptimal,说明没编 NCCL 或加载失败,正在走较慢的路径;如果看到 NCCL disabled: virtual devices in use; falling back to internal AllReduce,说明 CUDA 虚拟设备与 NCCL 冲突。把这几条日志和 nvidia-smi topo -m 的互联拓扑对上,基本就能判断瓶颈在计算还是通信。
与其他框架的张量并行对照
张量并行的原理在 vLLM、SGLang、TensorRT-LLM 里是相同的,但「切分决策放在哪一层」差别很大。llama.cpp 的 Meta device 把决策放在 ggml 后端,用「张量名字正则 + split state 推导 + 图切点」完成;其他框架一般把决策放在 Python 层模型定义,在构造模型时就决定每层的切法。
vLLM。vLLM 的 TP 是 Megatron 式:MergedColumnParallelLinear、RowParallelLinear、QKVParallelLinear 等专用层在 __init__ 里按 tensor_parallel_size 决定切多少,RowParallelLinear 内部调用 tensor_model_parallel_all_reduce。切点固定写在层类里,不需要「推导」。优点是直观、可读;缺点是新模型、新算子需要新层类,无法自动覆盖任意图。llama.cpp 的 Meta device 则反过来:模型代码完全不变,切分由 llama-model.cpp 的正则表与 meta.cpp 的 handler 决定,代价是每加一个算子/一个架构都要补表、补 handler。
SGLang。SGLang 的 TP 与 vLLM 类似,基于同一套 *ParallelLinear 层,并额外支持 DP Attention 与 EP。llama.cpp 的 Meta device 在 tensor 模式下是「纯 TP」,没有 DP Attention,因为 n_devices() == 1 的上层视角让调度器无法把「每卡一条序列」暴露出来。
TensorRT-LLM。TensorRT-LLM 在构建期就把 TP 切分固化进引擎:ColumnParallelLinear、RowParallelLinear 在 build 阶段按 tp_size 切权重,通信节点插入 TensorRT 图,运行时直接执行。llama.cpp 的切分是「运行期装载时切 + 每次图执行时推」;TensorRT-LLM 的切分是「构建期一次算好 + 运行时零决策」。后者的运行时开销更小,但要求模型在构建期是可静态分析的;llama.cpp 的动态图与 GGUF 量化让构建期切分很难统一。
DeepInfer。DeepSeek 的 DeepInfer 选择了另一条路:不做张量并行,而是 DP Attention + Wide-EP + CP。原因从通信账单里可以看出来:DeepSeek 的 MLA 让 KV 极小,瓶颈更多在专家通信上,专家并行(EP)的收益比 TP 更高。llama.cpp 的 llm_arch_supports_sm_tensor 明确把 DeepSeek2/3.2 排除在 tensor 模式之外,与 DeepInfer 自己不做 TP 的结论一致。
Megatron 的原始切法与 llama.cpp 的对应关系可以总结成一张表:
| Megatron 概念 | llama.cpp Meta device 实现 |
|---|---|
| ColumnParallelLinear | 权重 AXIS_1,handle_mul_mat 返回输出 AXIS_0 |
| RowParallelLinear | 权重 AXIS_0,输出 PARTIAL,图切点 + AllReduce |
列并行 + 行并行之间的 AllReduce | PARTIAL 节点 → new_subgraph 切点 |
| 融合 QKV 的段切分 | get_split_segments 的 n_segments / nr |
| 头级切分 | granularity_head、attn_output 的 granularity_head * n_embd_head_v |
| 词表并行 | output.weight 的 AXIS_1,CPU 采样回拼 |
| 通信库 | comm_init 协议 → NCCL / internal / butterfly |
llama.cpp 与 vLLM/SGLang 最大的区别不在切分本身,而在 「图切点」是推导出来的而不是规定好的。这使得它能覆盖融合算子(如 mul_mat_id 的 MoE、flash_attn_ext 的注意力、ggml_add_id 的路由回写)而不需要为每个模型重写层;代价是推导逻辑必须覆盖图中出现的所有算子,任何一个新算子都可能触发 GGML_ABORT。
局限与当前边界
Meta device 已经在主线里跑通,但它仍被标记为 实验性(EXPERIMENTAL),这不是谦虚。从代码可以清楚列出当前边界:
- 架构覆盖不全:
llm_arch_supports_sm_tensor排除了大量 MoE、MLA、SSM、混合模型;这些架构不是「性能差」,而是「不能正确切」。 - KV Cache 只能是非量化:官方文档明确要求
f32/f16/bf16;Meta 的切分粒度按整头对齐,而量化 KV 的块大小通常小于头维度,切分与量化块的组合还没有被证明。 --fit不支持:自动按显存拟合参数依赖对真实设备的显存探测,Meta device 把显存相加后是一个虚拟总量,无法指导「哪个参数放哪张卡」。- 后端采样器不可用:输出层词表切分让后端采样器失去完整视图,退回 CPU 采样。
split_state_cache无界:对 llama.cpp 的固定图结构安全,但对任意 ggml 图不安全;代码里有FIXME。get_tensor不实现PARTIAL:任何尝试直接读部分和的行为会 abort,这是有意的,但限制了更通用的张量运算。- 多阶段张量的布局限制:只有轴 0/1 的规则被充分验证;轴 2/3 的切分在
handle_flash_attn_ext等少数地方出现,但通用的多层axis推导仍偏保守(多处GGML_ABORT)。 - 通信延迟敏感:小 batch、PCIe 互联下,tensor 模式常不如 layer 模式;官方文档也明确说「tensor 适合快速 token 生成、layer 适合快速预填充」。
从演进方向看,meta.cpp 里已经在补的几块很清晰:handle_lightning_indexer、handle_ssm_conv、handle_gated_delta_net 说明 SSM/混合模型正在被纳入;RPC 后端在 2026 年已经能跑 -sm tensor(PR #26610),多节点张量并行(PR #28967)也在推进。可以预期,架构白名单会逐步缩小,而「哪些算子能被切、哪些不能」会继续以 handler + assert 的形式固化在源码里。
小结
llama.cpp 的张量并行不是给每个模型写一套切分代码,而是引入了一个 Meta device:把 N 块 GPU 包成一块虚拟 GPU,把「切分决策」下沉到 ggml 后端,把「切分语义」表达成 split_state,把「切点」交给 PARTIAL 推导。这条路径的核心构件可以归纳成四点:
- 切分账本:
AXIS_0/1/2/3描述真切片,MIRRORED描述全复制,PARTIAL描述部分和;n_segments/nr让融合张量(QKV、gate/up)按逻辑段切;粒度按量化块与头对齐。 - Buffer 层:一个 Meta buffer 对应 N 个真实 buffer,每个张量在每块卡上有一个形状缩小的
simple_tensor;装载时按段、按轴、按粒度拆分,读取时再拼回。 - 图推导:每个算子一个 handler,
mul_mat的四象限、flash_attn_ext的头轴、add_id的镜像断言、reshape/view的轴变换,共同保证「切分语义」在整张图里被正确传递。 - 图切分与通信:以
PARTIAL为切点,用get_i_delayed合并多次归约,再交给 NCCL / 内部双卡流水线 / Butterfly 兜底。
理解这套机制之后,再看 --split-mode tensor 的适用边界就很自然:它适合「KV 头数足够多、卡间有 NVLink、以 decode 延迟为主」的场景;当模型是 MLA/SSM/MoE 混合、KV 需要量化、或者卡间只是 PCIe 时,层切分反而更稳更快。这也是 llama.cpp 把默认值留给 layer 的原因——张量并行的优雅依赖于一整套前提,Meta device 的代码只是把这些前提逐条写成了断言。
参考资料
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism(arXiv:1909.08053)
- llama.cpp: ggml/src/ggml-backend-meta.cpp(Meta device 实现)
- llama.cpp: ggml/include/ggml-backend.h(
ggml_backend_meta_split_state与 comm 协议) - llama.cpp: src/llama-model.cpp(
llama_meta_device_get_split_state切分表) - llama.cpp: ggml/src/ggml-cuda/ggml-cuda.cu(CUDA 通信上下文与 NCCL/内部归约)
- llama.cpp: docs/multi-gpu.md(多卡使用指南与
-sm tensor约束) - llama.cpp PR #19378: ggml: backend-agnostic tensor parallelism (experimental)
- llama.cpp PR #26610: RPC: add
-sm tensor - llama.cpp PR #23225: ggml: allow split-mode tensor to use different quantization types
- Andrew Gibiansky: Bringing HPC Techniques to Deep Learning(Ring AllReduce 图解)
- NVIDIA NCCL 用户手册:Collectives
- 本站:AllReduce 完全拆解——Ring、树算法与 NCCL
- 本站:流水并行推理完全拆解——五个框架为什么选了五种流水形态
- 本站:KV Cache 的页粒度——128 token 一块的账
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



