


TensorRT-LLM 源码完全拆解(二十三):Linear 与层内张量并行——一个 Linear 模块如何同时管住切分、加载、GEMM 与 AllReduce
从一张卡装不下说起
以 Qwen3-32B 为例,BF16 权重约 65.6 GB,加上激活、workspace 和 KV Cache,一张 80 GB 的 H100 在长上下文场景下并不宽裕。张量并行(Tensor Parallelism,TP)的做法是把同一层内的权重矩阵沿某个维度切开,让每张卡只保存其中一块,在一次前向中协作算出这一层的完整输出。TP=4 时,单卡权重降到约 16.4 GB,剩下的显存可以留给 KV Cache 和更大的 batch。
TP 和另外两种常见并行方式的边界需要先分清。数据并行(Data Parallelism,DP)让每张卡保存完整模型、各跑不同的请求;流水并行(Pipeline Parallelism,PP)把不同层放到不同卡上,按层传递激活。TP 则是把单层内部的矩阵切开,每层前向都要跨卡同步一次。三者的组织方式对照可以看下面这张图。
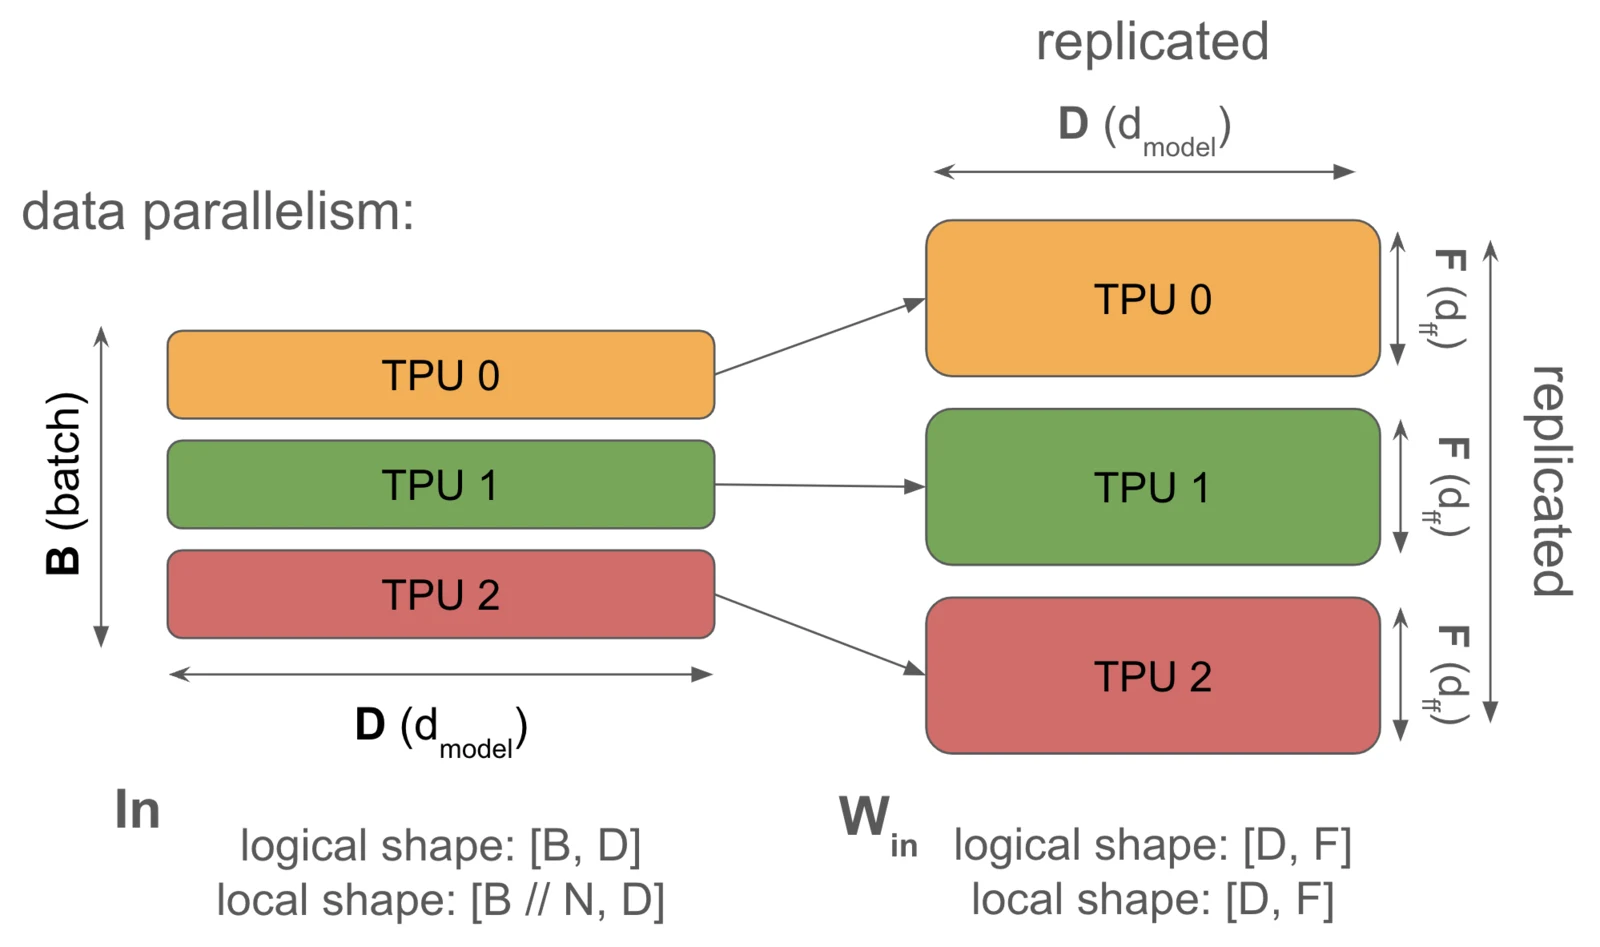
图片来源:JAX Scaling Book,How to Scale Your Model
图中数据并行是“每卡一份完整模型、数据切分”,模型并行是“模型切分到多卡、数据复制”。TP 属于后者的层内版本。它的代价很直接:每层都要做集合通信,通信量与激活大小成正比。解码阶段每步只处理很少的 token,计算量小、通信延迟占比高,所以 TP 的工程难点不在“能不能切开”,而在“切开之后如何让加载、执行和归约三件事保持一致”。
这篇文章只讨论 TensorRT-LLM 的层内张量并行基础设施:Linear、RMSNorm、Embedding、GatedMLP 这些模块如何切权重、如何从 checkpoint 取自己那一块、前向后如何归约。注意力内部的 QKV 切分已经在 TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行 里逐行拆过,本文不复述 head 级布局,而是把 Linear 这个所有层共用的契约讲透。
一个 Linear 模块的四个职责
如果只看模型定义,线性层似乎只做一件事:y = x @ W.T + b。但在 TP 场景下,一个 Linear 至少要同时回答四个问题:
- 本 rank 实际持有的权重形状是什么? 调用方通常按“全局形状”书写模型,例如“hidden 7168 到 intermediate 18432”;模块内部必须把它换算成单卡的局部形状。
- 权重加载时从 checkpoint 的哪一段取数据? 列切分沿输出维切,行切分沿输入维切;融合 QKV、融合 Gate/Up 还要按子张量分别取。
- 前向时用哪个量化 GEMM? 权重可能是 BF16、FP8、NVFP4、W4A16、AWQ 等,切分方式必须和量化方法的对齐要求兼容。
- GEMM 之后要不要通信? 行并行的部分和需要 AllReduce,列并行一般不需要;开启了注意力数据并行后,归约规则又会改变。
TensorRT-LLM 把这些职责全部收进 tensorrt_llm/_torch/modules/linear.py 的 Linear 类。它的构造函数参数很长,但真正决定 TP 行为的是其中几项:
class Linear(nn.Module): def __init__( self, in_features: int, out_features: int, bias: bool = True, dtype: torch.dtype = None, mapping: Optional[Mapping] = None, tensor_parallel_mode: Optional[TensorParallelMode] = None, gather_output: bool = False, # COLUMN parallel only quant_config: Optional[QuantConfig] = None, weights_loading_config: Optional[WeightsLoadingConfig] = None, reduce_output: bool = True, # ROW parallel only override_tp_sharding: Optional[...] = None, ... ):in_features 和 out_features 是全局尺寸。构造函数随后做两件事:
self.in_features = self.calculate_local_in_features(in_features)self.out_features = self.calculate_local_out_features(out_features)也就是说,模块对外仍然用全局尺寸描述这一层,对内保存的 self.in_features、self.out_features 已经是本 rank 的局部尺寸。后面创建权重、选择 GEMM、计算输出形状,全部用局部尺寸。这个“入口全局、内部局部”的约定看起来只是命名问题,实际上决定了整个代码库的读写方式:模型代码可以像单卡一样书写层形状,而所有 kernel 只面对本 rank 的真实张量。
构造函数里还有一段不显眼的逻辑,决定了“无对齐约束”和“有对齐约束”两种切分路径:
if override_tp_sharding is not None: self.tp_sharding = override_tp_sharding self._tp_sharding_is_auto = Falseelif self.tp_size > 1 and self.tp_mode is not None \ and self.weights_loading_config.weight_mode == WeightMode.VANILLA \ and not skip_create_weights_in_init: self.tp_sharding = self._auto_tp_sharding(features, quant_config)else: self.tp_sharding = None assert features % self.tp_size == 0, ...三种情况对应三种责任归属:显式覆盖时由模型代码负责切分;普通 VANILLA 权重且已创建权重时由 Linear 自动按量化对齐切分;其余情况(融合权重、延迟创建权重、NVFP4_ARC 等不支持不均切的量化)则退化为“必须整除”的严格要求。这段代码没有一行注释解释“为什么是这三种”,但从加载侧可以看出原因:融合权重需要按子张量名取区间,自动均分无法表达;延迟创建权重时构造函数还不知道具体形状;某些量化方法的 scale 布局不允许不均切。
mapping 提供 tp_size 与 tp_rank,tensor_parallel_mode 提供切分方向,weights_loading_config.weight_mode 提供 checkpoint 的权重组织方式。三者合起来,才构成一个完整的切分契约。
切分:只有两个模式,为什么会引出这么多分支
TensorParallelMode 只有两个取值,却足够表达 Transformer 里绝大多数线性层:
class TensorParallelMode(str, enum.Enum): COLUMN = 'column' ROW = 'row'
@classmethod def split_dim(cls, mode): return 1 if mode == cls.ROW else 0
@classmethod def flip(cls, mode): return cls.ROW if mode == cls.COLUMN else cls.COLUMNPyTorch 的 nn.Linear 权重形状是 [out_features, in_features]。COLUMN 沿第 0 维切,也就是切输出特征;ROW 沿第 1 维切,也就是切输入特征。名字来自并行计算里的习惯:列并行把权重按列分块,行并行把权重按行分块;放到 [out, in] 的存储顺序里,COLUMN 恰好是切第 0 维。
两种模式对应的数学关系可以用分块矩阵写清楚。设输入 X 的形状为 [M, K],权重 W 的形状为 [N, K],输出 Y = XW^T 的形状为 [M, N]。
列并行把 W 沿输出维切成 tp_size 块:
每个 rank 拿到 [N/p, K] 的权重,独立算出一段输出特征。只要下游不需要立刻看到完整的 Y,就不需要通信。Transformer 里的 QKV 投影、MLP 的 Gate/Up 投影都属于这种情况:它们的输出会继续被本 rank 的后续算子消费。
行并行把 W 沿输入维切成 tp_size 块,同时输入 X 也按同样的方式切分:
每个 rank 拿到 [N, K/p] 的权重和 [M, K/p] 的输入分块,算出一个部分和。单看任一 rank,结果都是不完整的;必须把所有 rank 的部分和相加,才能得到完整的 Y。这就是行并行后面那次 AllReduce 的来源。
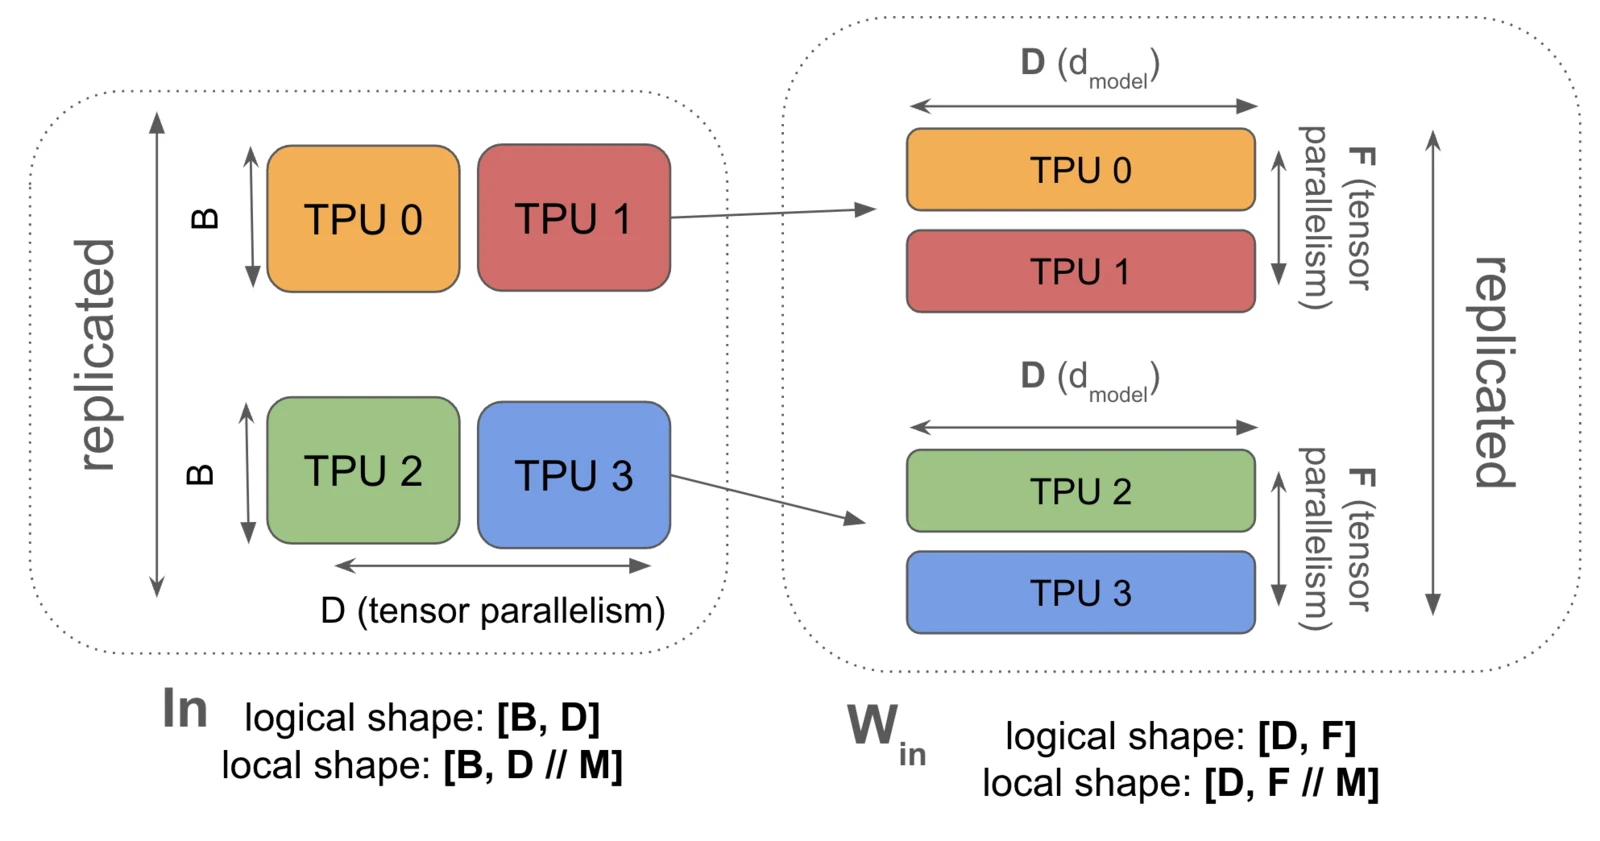
图片来源:JAX Scaling Book,How to Scale Your Model
图中把两种切分的“谁持有哪一块、谁需要通信”画在一起。实际工程里还会遇到两个细节:特征维度不一定能被 tp_size 整除,量化方法还要求切分边界落在对齐块上。Linear 用两个辅助函数处理这两件事。
第一个是 _calc_shard,它把 total 个元素尽量均匀地分给 tp_size 个 rank,余数依次分给前面的 rank:
@staticmethoddef _calc_shard(total, tp_size, rank): return (total // tp_size) * rank + min(total % tp_size, rank)取 total=10、tp_size=4,四个 rank 的区间是 [0,3)、[3,6)、[6,8)、[8,10),宽度分别是 3、3、2、2。这个函数在 GatedMLP 计算 local_intermediate_size 时也直接使用。
第二个是量化对齐。很多低比特格式以固定大小的块存储缩放因子,例如 NVFP4 每 16 或 32 个元素共享一组 scale,MXFP8 以 32 个元素为一块。如果切分边界落在块中间,本 rank 拿到的权重会缺少完整的 scale,反量化就无法进行。_auto_tp_sharding 的做法是先把特征维按 alignment 换算成“块数”,再把块分给各个 rank:
alignment = get_quant_method(quant_config).get_tp_alignment( self.tp_mode, quant_config)if alignment <= 1: start = self._calc_shard(features, self.tp_size, rank) end = self._calc_shard(features, self.tp_size, rank + 1)else: num_blocks = features // alignment block_start = self._calc_shard(num_blocks, self.tp_size, rank) block_end = self._calc_shard(num_blocks, self.tp_size, rank + 1) start = block_start * alignment end = block_end * alignment这段代码解释了一个常见疑问:为什么同一个 Linear 在不同量化方法下,单卡权重形状可能不同。BF16 按元素均分即可;FP8 per-tensor 的 alignment 可能是 1;NVFP4 的 alignment 可能是 32。切分单位从“元素”变成“量化块”,局部形状随之改变。
tp_sharding 最终保存为区间。普通模式是一个二元组 (start, end);融合模式是一个字典,按子权重名分别保存区间:
if isinstance(self.tp_sharding, tuple): start, end = self.tp_sharding return end - startelif isinstance(self.tp_sharding, dict): return sum(end - start for start, end in self.tp_sharding.values())这也是 _calculate_local_features_helper 能同时服务普通 Linear 和融合 Linear 的原因:前者只有一个区间,后者把 gate、up 各自的区间宽度加起来。
加载:checkpoint 里的完整张量怎么变成每个 rank 的一小块
构造阶段只决定了“我要拿哪一段”,真正取数据发生在 load_shard。它接受某个张量(可能是普通 torch.Tensor,也可能是 safetensors 的惰性切片)以及若干控制参数,返回属于本 rank 的切片:
def load_shard( self, weights: Union[Dict, torch.Tensor], label: Optional[str] = None, device: torch.device = torch.device('cpu'), name: Optional[str] = None, flip_tp: bool = False, # for input activation scales scale_span: Optional[int] = None, elm_packing: int = 1,) -> torch.Tensor:flip_tp 和 scale_span 两处最容易读错,后面单独解释。先看主路径:
if self.tp_mode is None or self.tp_size <= 1: return maybe_convert_to_torch_tensor(weight)
tp_mode = TensorParallelMode.flip( self.tp_mode) if flip_tp else self.tp_modesplit_dim = TensorParallelMode.split_dim(tp_mode)
width = tensor_shape[split_dim]if width == 1: return maybe_convert_to_torch_tensor(weight)
if self.tp_sharding is None: slice_start = self._calc_shard(width, self.tp_size, self.tp_rank) slice_end = self._calc_shard(width, self.tp_size, self.tp_rank + 1)else: if isinstance(self.tp_sharding, tuple): slice_start, slice_end = self.tp_sharding elif isinstance(self.tp_sharding, dict): slice_start, slice_end = self.tp_sharding[name]
if scale_span: assert slice_end % scale_span == 0 and slice_start % scale_span == 0 slice_start //= scale_span slice_end //= scale_span ...这里有几个判断值得逐个说明。
width == 1 直接返回完整张量。 典型场景是逐通道 scale 张量:如果某张量的切分维只有 1 个元素,切它没有意义。例如某个量化方法的 input_scale 形状为 [1],行并行切第 1 维时会看到宽度为 1,这时每个 rank 都应当保留完整的一份。
scale_span 处理的是“一个 scale 对应多少个权重元素”。 假设权重是 INT8,每 128 个输入元素共享一个 scale,那么 scale 张量的长度是 in_features / 128。行并行按权重元素切 [start, end) 后,对应到 scale 张量要在同一位置除以 128。代码里先断言 start、end 都是 scale_span 的整数倍,再整除,这样 scale 切片和权重切片严格对应。如果量化方法选了对齐块,这个断言一定成立;如果不成立,说明切分配置和量化方法不匹配,属于应当在加载阶段暴露的错误。
elm_packing 处理的是低比特打包。 NVFP4 每 2 个权重元素被塞进 1 个字节,形状上第 1 维长度已经减半。按 in_features 算出的 start、end 需要除以 2 才是张量上的真实下标:
assert slice_start % elm_packing == 0 and slice_end % elm_packing == 0slice_start //= elm_packingslice_end //= elm_packing断言的含义是:每个 rank 的切片边界必须落在完整的打包单元上,不能让一个字节里的两个半精度值分属两个 rank。
flip_tp 用于激活 scale。 权重的切分方向和激活 scale 的切分方向是正交的。行并行时权重沿输入维切,输出的激活 scale 却是逐输出通道的,应当沿第 0 维按完整长度复制;列并行时权重沿输出维切,输出激活 scale 需要跟着切第 0 维。TensorParallelMode.flip 就是把这个方向翻过来:
@classmethoddef flip(cls, mode): return cls.ROW if mode == cls.COLUMN else cls.COLUMN对 COLUMN 模式的权重调用 load_shard(..., flip_tp=True),就会在第 1 维切;对 ROW 模式则会切第 0 维。各量化方法的 load_weight_scales 里都能看到这个写法,例如 W4A8 NVFP4 方法会先算出一个 scale_span,再把它传给 load_shard:
scale_span = 32 if module.tp_mode == TensorParallelMode.ROW else 1ws = module.load_shard(w["weight_scale"], device=device, scale_span=scale_span, name=shard_key)scale_span = 32 是因为该格式每 32 个输入元素共享一个 scale;只有行并行切输入维时才需要把下标除以 32,列并行切输出维时 scale 的下标本来就与权重输出下标一一对应。
惰性切片和显存占用。 load_shard 同时支持普通张量和带 get_shape 的对象(safetensors 的 PySafeSlice):
elif hasattr(weight, "get_shape"): tensor_shape = weight.get_shape()
def maybe_convert_to_torch_tensor(tensor, indices=slice(None)): return tensor[indices].to(device)这意味着加载时可以只把本 rank 需要的那一段从磁盘读到显存,而不必先把整个 65 GB 的 checkpoint 搬到某张卡上。对 TP 部署来说,这直接决定了加载阶段会不会 OOM。另一个细节是集成显卡系统上的跳过逻辑:如果目标是共享内存的集成 GPU,代码会放弃 CPU 到 GPU 的搬运,直接在原设备上切片,避免把一份权重复制成两份。
前向:GEMM 之后的那次 AllReduce 花在哪里
Linear.forward 的骨架只有三个分支:行并行、列并行、无并行。真正复杂的是行并行分支里的几个优化开关:
if self.tp_mode == TensorParallelMode.ROW: use_fused_gemm_allreduce = (not use_locality_domain and self.use_fused_gemm_allreduce and lora_params is None) bias = None if (self.tp_rank > 0) else self.bias if self.reduce_output: if use_fused_gemm_allreduce: output = self.apply_linear_allreduce(input, self.bias, layer_idx) else: ... output = self.apply_linear(input, bias, lora_params, layer_idx) output = self.all_reduce(output, all_reduce_params=all_reduce_params) else: output = self.apply_linear(input, bias, lora_params, layer_idx)这里有三个设计要点。
偏置只在一个 rank 上加。 行并行的每个 rank 都会算出部分和,如果在每个 rank 都加一次 bias,AllReduce 之后偏置会被加 tp_size 次。代码的做法是只让 tp_rank == 0 携带偏置,其余 rank 传 None。当偏置需要融合进 AllReduce 后面的 residual + RMSNorm 时,又通过 _maybe_fuse_bias_into_allreduce 把偏置交给归约算子统一处理。
reduce_output=False 是有意义的。 并非所有行并行都需要立刻归约。如果下游还会继续在分片维度上计算,或者当前处于注意力数据并行模式,归约会破坏局部性,甚至产生错误结果。reduce_output 把这个选择显式暴露出来,而不是写死在模块类型里。
融合 GEMM-AllReduce 只在特定硬件和形状下启用。 _refresh_fused_gemm_allreduce 把条件列成了一张清单:
enabled = all([ self.reduce_output, not mpi_disabled(), self.dtype in (torch.float16, torch.bfloat16), self.in_features % 128 == 0, self.out_features % 64 == 0, self.tp_mode == TensorParallelMode.ROW, self.tp_size > 1, quant_valid, get_sm_version() >= 100, self._enable_gemm_allreduce_fusion, os.environ.get("TRTLLM_GEMM_ALLREDUCE_FUSION_ENABLED", "0") == "1",])条件里同时出现输入维 128 对齐、输出维 64 对齐和 SM100 以上,说明这是一个为 Blackwell 及以上架构设计的融合路径:GEMM 的 epilogue 直接把结果写进对称内存或 NVLS 缓冲区,归约紧接着读取,省掉一次中间张量的写回和读取。默认关闭、靠环境变量打开,则是工程上的保守选择:融合路径的调试成本高,先让用户显式选择。
不融合时,归约由 AllReduce 类完成。TensorRT-LLM 提供多种实现,选择逻辑在 tensorrt_llm/_torch/distributed 下:NCCL 的 ring/tree、基于 IPC 的自定义 AllReduce、以及基于对称内存的 multimem 版本。具体算法和 NCCL 的选路逻辑在 AllReduce 完全拆解:Ring、树算法与 NCCL 里有完整推导,这里只算一次显存账。
CustomAllReduceHelper.max_workspace_size_auto 的注释给出了一个可直接套用的例子:Llama 8B,hidden 4096,max tokens 8192,BF16,TP=4。
每个子缓冲:8192 × 4096 × 2 = 64 MiB三缓冲:3 × 64 MiB = 192 MiBLamport 分配再乘 tp_size:3 × 64 MiB × 4 = 768 MiB / GPU也就是说,仅仅为了自定义 AllReduce 的融合 kernel,每张卡就要预留 768 MiB。三缓冲的目的是让连续几层的归约可以流水起来:当前层读 buffer A 时,上一层的结果还在 buffer B 里被消费,下一层可以写 buffer C。Lamport 标志位用来在没有全局同步的情况下判断数据是否就绪,代价是每张卡都要保留一份按 tp_size 放大的缓冲区。
归约本身的通信量也值得算。Ring AllReduce 分两个阶段,Reduce-Scatter 和 All-Gather,每个 rank 收发约 2 × (tp_size - 1) / tp_size × M × H × dtype_size 字节。TP=8、BF16、M=1、H=7168 时,单次归约每卡约 125 KB;单看不大,但一层有两个这样的归约(注意力和 MLP 各一次),78 层就是 156 次,解码每步的通信时间会累积成不可忽略的固定开销。这也解释了为什么解码场景更偏好低延迟的 NVLS/multimem 实现,而不是纯 ring。
列并行分支简单得多:默认不做归约,只在 gather_output=True 时做 AllGather。gather_output 的典型用途是把分片的输出重新拼成完整张量,例如词表维的输出头;普通注意力投影和 MLP 中间层不会打开它,因为下游本来就能消费分片结果。注意 gather_output 与不均等切分同时出现时,代码还要显式传 sizes,否则 AllGather 无法知道每个 rank 的宽度:
if self.gather_output: from ..distributed import allgather output = allgather(output, self.mapping, sizes=self.gather_output_sizes)层边界的融合:为什么 RMSNorm 永远不在 TP 里切
RMSNorm 的构造函数没有 mapping,也没有 tensor_parallel_mode。它的权重长度就是完整的 hidden_size,每个 rank 保存一份完整副本:
self.weight = nn.Parameter( torch.ones(hidden_size, dtype=dtype, device=device))这不是偷懒,而是由数据布局决定的。行并行的输出经过 AllReduce 后,每个 rank 都持有完整的 hidden 向量;RMSNorm 沿 hidden 维求均方根,输入本来就是完整的,权重也应当是完整的。如果把 norm 权重切分,每个 rank 只能算出一部分平方和,还得再做一次 AllReduce 才能得到正确的分母,反而增加通信。
从显存角度看,复制一份 norm 权重的代价可以忽略。hidden 7168 的 BF16 norm 权重是 14 KB,78 层也就 1 MB 左右,相比每卡十几 GB 的模型权重可以忽略不计。用 1 MB 换掉每层一次的额外归约,是明确的划算买卖。
更重要的是融合。RMSNorm.forward 支持把残差加法、归一化和下一层 Linear 的输入量化合并进一个 kernel:
nvfp4_scale = self.nvfp4_scale if self.is_nvfp4 else Noneif nvfp4_scale is not None and not self.use_gemma: return self._fused_nvfp4_quant(hidden_states, residual, nvfp4_scale, return_norm_out)nvfp4_scale 是下游 Linear 的静态输入 scale。norm 在加载完成后由模型代码把这个 scale 挂上来,前向时直接把 BF16 激活量化成 FP4,省掉一次单独的量化 kernel。这条路径只在 SM100 到 SM119 的 Blackwell 上可用,因为融合的 FP4 epilogue 依赖特定架构的 warp 协同指令;在不支持的架构上,代码会回退到 flashinfer 的 RMSNorm,再让下游 Linear 自己做量化。
这段逻辑放在这里讲,是因为它和 TP 的边界直接相关:norm 是每层里唯一天然“全复制”的部件,也是最适合承接跨层融合的位置。理解了“norm 不切”,才能理解为什么 TensorRT-LLM 的层边界 kernel 可以放心地假设 hidden 完整。
门控 MLP:四个 Linear 拼成一个残差单元
Llama 类模型的 MLP 是门控结构:gate_proj 和 up_proj 把 hidden 投到 intermediate,SwiGLU 逐元素相乘,down_proj 再投回 hidden。TensorRT-LLM 把它收进 GatedMLP,默认只创建两个 Linear:
self.gate_up_proj = Linear( self.hidden_size, self.intermediate_size * 2, weights_loading_config=WeightsLoadingConfig( weight_mode=WeightMode.FUSED_GATE_UP_LINEAR), fused_weight_shard_indices_mapping=gateup_shard_indices_mapping, override_tp_sharding=override_tp_sharding, tensor_parallel_mode=TensorParallelMode.COLUMN, reduce_output=False, ...)
self.down_proj = Linear( self.intermediate_size, self.hidden_size, tensor_parallel_mode=TensorParallelMode.ROW, reduce_output=reduce_output, ...)gate_up_proj 的全局输出维是 2 × intermediate_size,对应 checkpoint 里两个独立张量 gate_proj.weight 和 up_proj.weight 的拼接。列并行切分后,每个 rank 持有 2 × local_intermediate_size 行;down_proj 的全局输入维是 intermediate_size,行并行切分后每个 rank 持有 local_intermediate_size 列。两者的局部宽度必须严格相等,否则中间激活对不上。GatedMLP 在构造时用同一个 _calc_shard 算出 local_intermediate_start/end,并把它们同时写进两个映射表:
gateup_shard_indices_mapping = { 'gate': (0, local_intermediate_size), 'up': (local_intermediate_size, local_intermediate_size),}
override_tp_sharding = { 'gate': (local_intermediate_start, local_intermediate_end), 'up': (local_intermediate_start, local_intermediate_end),}第一张表描述的是“在本 rank 的拼接缓冲区里,gate 和 up 各占哪一段”,用于把加载到的子权重写进正确位置。第二张表描述的是“在全局权重里,本 rank 应当取哪一段”,用于 load_shard 切片。两张表的分工在融合权重加载里非常关键:前者是目标偏移,后者是源区间。很多“加载后数值不对”的问题,根源就是把这两个偏移混用了。
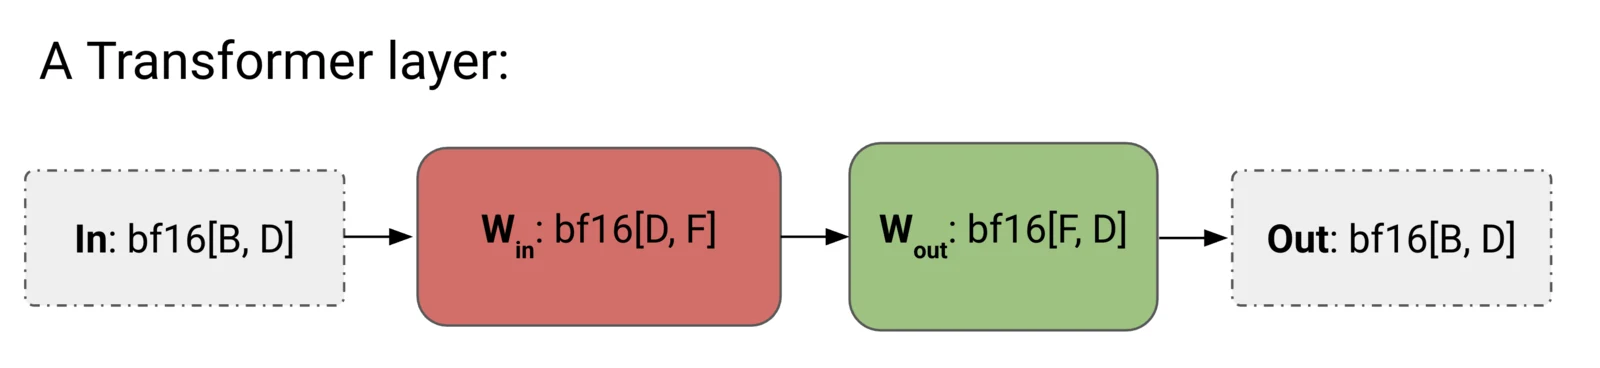
图片来源:JAX Scaling Book,How to Scale Your Model
图中把一个 Transformer 层拆成注意力和 MLP 两条残差支路,MLP 内部是两次投影夹一次逐元素激活。对应到 TP,gate_up_proj 是列并行,输出保持分片;SwiGLU 是逐元素运算,分片状态下可以直接执行;down_proj 是行并行,执行完必须归约,才能与残差相加。因此一个 MLP 块恰好贡献一次 AllReduce,一个注意力块也贡献一次,每层共两次。这个“每层两次归约”的账,是估算 TP 解码延迟的起点。
GatedMLP 还保留了一个 split_gate_up 选项,把 gate 和 up 拆成两个独立 Linear。默认不拆,原因是融合成一个 GEMM 有三个好处:一次 kernel launch 完成两个投影、共享同一份量化后的激活、GEMM 的 N 维更大更容易喂满 Tensor Core。拆分模式主要服务于“两个投影各自有独立校准 scale”的量化检查点,融合会丢掉其中一份 scale。代码在 post_load_weights 里检查两个投影的 input_scale 是否一致,只有一致时才允许共享量化结果。
SwiGLU 本身是逐元素运算,不涉及跨 rank 归约。设本 rank 的 gate 输出为 G、up 输出为 U,激活结果是 SiLU(G) ⊙ U;每个 rank 用自己的分片独立计算,拼起来恰好等于全局结果。这也是为什么列并行适合放在 SwiGLU 前面:逐元素操作对分片是“天然透明”的,不需要任何通信。反过来说,如果把 down_proj 放在前面做成列并行、再让 SwiGLU 处理分片结果,形状就对不上了,因为 down_proj 的输出是 hidden 维,门控需要的是 intermediate 维的两份配对张量。层的切分方向必须服从算子的数据依赖,而不是反过来。
split_gate_up 打开后,加载走普通 VANILLA 路径,gate_proj 和 up_proj 各自从 checkpoint 取自己的张量,不再需要 FUSED_GATE_UP_LINEAR 的映射表。这也从侧面说明:融合模式的存在是为了 kernel 效率,不是为了表达模型结构。
回到注意力:层内 TP 的完整闭环
把 Linear 的契约套回注意力层,可以看到一个完整的 TP 数据流。注意力模块的 QKV 投影是列并行,输出投影是行并行:
self.qkv_proj = Linear( self.hidden_size, tp_size * self.q_size + 2 * tp_size * self.kv_size, tensor_parallel_mode=TensorParallelMode.COLUMN, weights_loading_config=WeightsLoadingConfig( weight_mode=WeightMode.FUSED_QKV_LINEAR), ...)
self.o_proj = Linear( tp_size * self.q_size, self.hidden_size, tensor_parallel_mode=TensorParallelMode.ROW, ...)qkv_proj 的全局输出宽度是 tp_size × (q_size + 2 × kv_size),本 rank 只持有 q_size + 2 × kv_size 行;注意力头因此天然按 rank 分片,每个 rank 只算自己的 head。o_proj 的全局输入宽度是 tp_size × q_size,行并行再把它切回去,每 rank 拿 q_size 列。GEMM 结束后做一次 AllReduce,hidden 重新变成完整向量,交给 RMSNorm 和 MLP。
这个闭环解释了为什么注意力和 MLP 各只有一次归约:QKV 列并行的输出不需要拼回完整 head 维度,注意力计算就在分片状态下完成;o_proj 行并行的部分和才需要相加。若在 QKV 之后多做一次 AllReduce,等于把已经分好的 head 又拼回去,既浪费带宽,又让后续 kernel 失去分片布局。
MLA 是一个例外。它的 KV 被压成低秩隐向量,head 之间共享同一份 latent,简单按 head 切分会破坏共享结构;因此 MLA 的 TP 布局要把隐空间与 head 维分开处理,完整推导见 MLA 完全拆解。这也是读 TensorRT-LLM 时值得记住的一条边界:Linear 只提供通用切分语义,具体模型要在自己的约束下选择切哪一维。
融合 QKV 与融合 Gate/Up:一类张量、两种切法
融合权重的加载逻辑可以抽象成同一条流水线:checkpoint 里的多个子张量先分别切片,再按 fused_weight_shard_indices_mapping 写进本 rank 的拼接缓冲区。load_weights_fused_gate_up_helper 和 load_weights_fused_qkv_helper 的骨架几乎一样:
gate_weight = module.load_shard(weights[0], 'weight', device=device, name='gate', elm_packing=elm_packing)up_weight = module.load_shard(weights[1], 'weight', device=device, name='up', elm_packing=elm_packing)真正的差异在形状。Gate/Up 的两个子张量宽度相同,Q/K/V 在 GQA 下宽度不同:q_size 和 kv_size 可能相差数倍。Linear 的自动均分只保证“总宽度被均分”,无法保证“每个子张量的边界都落在 rank 边界上”。因此只要 weight_mode 是 FUSED_QKV_LINEAR 或 FUSED_GATE_UP_LINEAR,构造时就必须显式提供 override_tp_sharding。代码里甚至有断言把这条规则钉死:
assert self.weights_loading_config.weight_mode == WeightMode.VANILLA, \ f"_auto_tp_sharding only supports VANILLA mode, got {...}"这个约束经常被误解为“融合层不能做 TP”。实际上融合层完全可以 TP,只是切分边界必须由模型代码给出,因为只有模型代码知道子权重的语义。Linear 可以做的是把“源区间”和“目标偏移”分开记账,保证加载时不越界、不重叠。
GQA 的具体 head 布局、QKV 融合权重的全局宽度如何写成 tp_size × q_size + 2 × tp_size × kv_size、以及 MLA 为什么不能照搬这套切法,已经在注意力张量并行那一篇里逐项计算过。读完那一篇再回来看 load_weights_fused_qkv_helper,会发现它只是把本文这套 load_shard 契约用在三个宽度不同的子张量上。
数据并行里的张量并行:enable_attention_dp 如何改写归约
前面讨论的前提都是“所有 TP rank 持有同一批 token,hidden 状态在 rank 间复制”。注意力数据并行(Attention Data Parallelism,ADP)打破了这个前提:每个 DP rank 处理不同的请求,注意力层不做 TP,各 rank 的 hidden 和 KV 都不一样;MoE 层则通过专家并行把不同专家放到不同 rank 上。这样做的动机是解码阶段的算术强度:注意力在 M 很小时做 TP 收益有限,反而每次都要归约;把注意力改成数据并行,可以让每张卡独立处理自己的请求,只在 MoE 的 dispatch/combine 处通信。
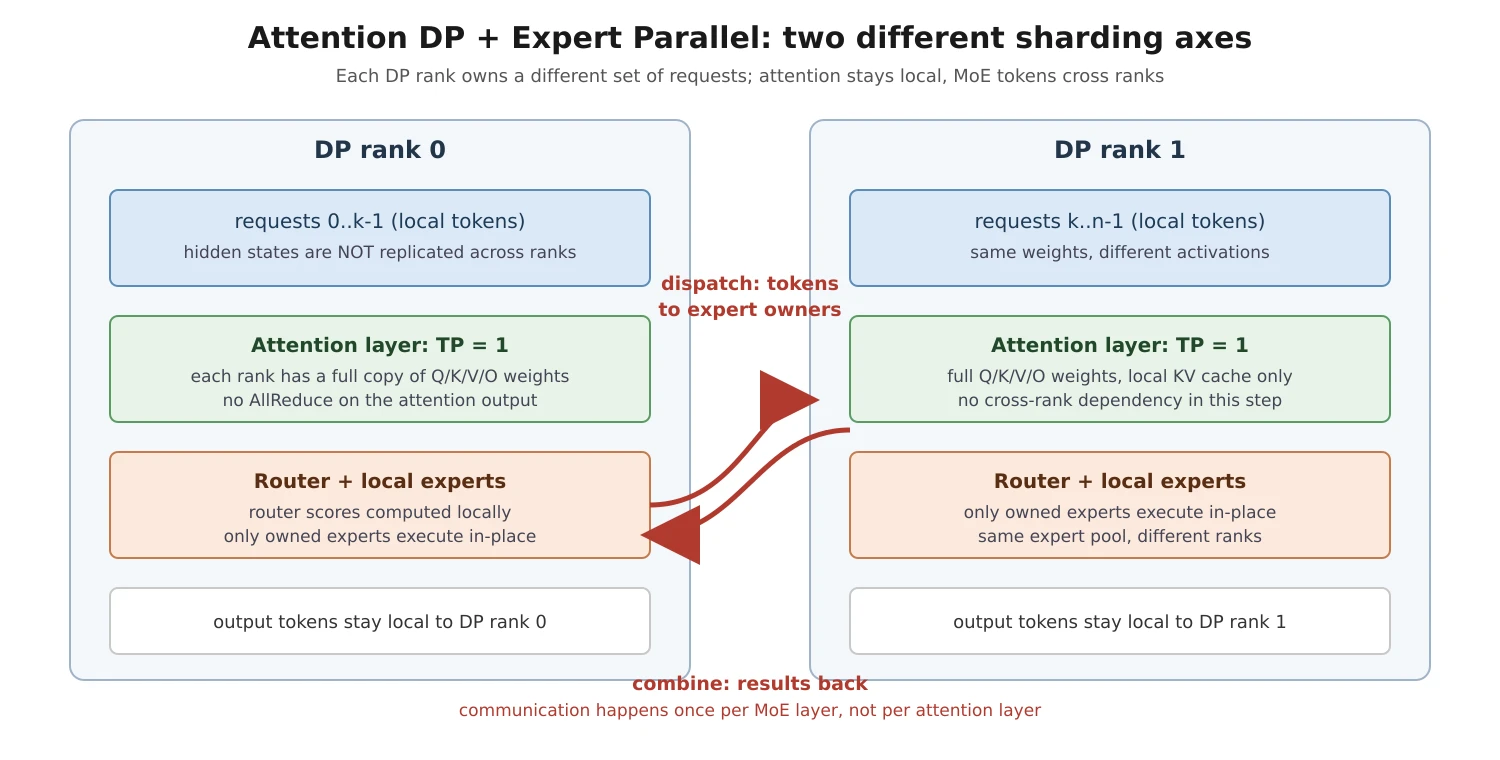
示意图:注意力层按请求做数据并行,MoE 层按专家做并行;两者在同一次前向中共存
Mapping 用一组字段描述这种混合拓扑:
self.tp_size = tp_sizeself.attn_tp_size = attn_tp_sizeself.moe_tp_size = moe_tp_sizeself.moe_ep_size = moe_ep_sizeself.enable_attention_dp = enable_attention_dptp_size × pp_size × cp_size = world_size 仍然是总约束,但注意力、MoE 可以各自有更小的 TP 组。Linear 在构造时读取 mapping.enable_attention_dp,并对列并行做一次特殊处理:
if self.tp_mode == TensorParallelMode.COLUMN: reduce_output = False if self.mapping.enable_attention_dp else reduce_output为什么列并行在 ADP 下必须关掉归约?因为在 ADP 中,列并行的输入 hidden 本来就是各 rank 不同的 token,输出也应当按 rank 保持独立。如果此时做 AllReduce,等于把不同请求的激活混在一起,结果直接错误。同理,行并行层在 ADP 下也不能盲目归约,除非它明确知道当前这一层的输入在 TP 组内是复制的。
LMHead 里还有一处相关的特化。ADP 模式下词表维默认不切分,因为每个 DP rank 的 token 不同,logits 也应当各算各的;只有在投机解码的草稿头等需要额外张量并行的场景,才会打开 enable_lm_head_tp_in_adp,并按 ceil_div 切分权重、再对超出词表的部分做裁剪。词表并行的完整账本可以参考 词表维上的并行账:嵌入查表、LM Head 切分与 logits 收集。
ADP 对 Linear 的影响可以总结成一句话:归约与否不取决于模块类型,而取决于输入在 TP 组内是否一致。 普通 TP 下,行并行的输入是同一份 hidden 的不同切片,必须归约;ADP 下,列并行的输入是不同请求的 hidden,不能归约。把这条判断写进 reduce_output,比在模型层里到处写 if adp 要干净得多。
附属张量:偏置、scale 与 LoRA 跟谁一起切
主权重之外,Linear 还挂着偏置、量化 scale 和可选的 LoRA 分支。它们的切分方向并不一致,是源码里最容易读错的一层。
偏置形状是 [out_features]。列并行沿输出维切,每个 rank 拿自己那一段;行并行需要完整偏置,但只有 rank 0 在归约前加上,否则会被加 tp_size 次。load_shard 里的一维分支正好承接这件事:
if len(tensor_shape) == 1 and split_dim == 1: return maybe_convert_to_torch_tensor(weight)行并行的 split_dim 是 1,一维张量因此直接完整返回。norm 权重和逐通道 bias 都不需要额外的加载逻辑,原因就在这里。
量化激活 scale 的切分方向与权重正交。列并行的每个 rank 收到同一份完整输入,输入 scale 必须整份复制;行并行的输入被切开,scale 也要跟着切。flip_tp 就是把这个方向翻转一次。如果 scale 存成 [1],width == 1 分支会让它继续完整,这也符合“标量不应被切”的直觉。
LoRA 的 B @ A 与主权重同形。列并行时 A 的输入维完整、B 的输出维分片;行并行时方向相反。Linear.apply_linear 用 LoraLayer.forward_with_base 把主 GEMM 和低秩分支包在一起,但切分方向仍要由加载端保证。记法很简单:B 跟着主权重切,A 跟着输入切。方向弄反不会报形状错误,只会让适配器效果异常。
Embedding 与 LMHead:词表维上的另一种通信
LMHead 把词表当输出维,列并行就是切词表;Embedding 把词表当查找表,列并行仍是切词表,但通信方向完全不同。
LMHead 在词表不能被 tp_size 整除时,先向上取整补 padding,再按 rank 切分:
local_out_features = math.ceil(num_embeddings / tp_size)self.padding_size = tp_size * local_out_features - num_embeddings加载时末 rank 临时去掉 padding 行,gather 输出后再裁掉 padding 列。这套“补、切、摘、裁”是词表并行的标准流程。
Embedding 列并行时,每个 rank 只持有词表的一段。token id 属于本 rank 才查表,否则填零;查完做一次 AllReduce,把零向量与唯一一份真实向量相加。于是出现一个反直觉现象:列并行的 Embedding 需要 AllReduce,而普通列并行 Linear 不需要。 行并行则相反:每个 rank 只产出 hidden 的一段,需要 AllGather 拼完整。完整账本见 词表维上的并行账。
量化方法如何改写切分
同一份 Linear 换成 FP8、NVFP4 或 W4A16,切分沿三条线变化。
第一是对齐。get_tp_alignment 给出最小切分单位:per-tensor FP8 可以是 1,块量化格式则要求 16、32、64 或 128 的倍数。_auto_tp_sharding 按“块数”分配,保证每个 rank 拿到完整 scale 块。
第二是打包。NVFP4 两个元素占一个字节,elm_packing=2,下标要再除以打包因子。按元素下标去读打包张量,会得到整体错位的结果。
第三是加载后的布局变换。Marlin W4A16 会把 K pad 到 64 的倍数、N pad 到 128 的倍数,再重打包。因此 self.in_features 是逻辑局部形状,self.weight.shape 可能是 pad 后的物理形状;GEMM 用物理形状,输出再裁回逻辑形状,显存估算必须按物理形状算。量化全链路与 Marlin 位布局分别见 量化全链路 和 Marlin 完全拆解。
一次 TP=8 解码步骤的账本
以 Qwen3-32B 为例:hidden 5120、64 层、64 个注意力头、8 个 KV 头、head_dim 128、intermediate 25600,TP=8,BF16。
单卡权重可以逐项核对:
QKV 融合:每 rank (8+1+1)×128 = 1280 行,1280×5120×2 B ≈ 13.1 MBo_proj: 每 rank 1024×8192×2 B ≈ 16.8 MBgate_up: 每 rank 6400×5120×2 B ≈ 65.5 MBdown: 每 rank 5120×3200×2 B ≈ 32.8 MB单层约 128.2 MB,64 层约 8.2 GB8.2 GB 正好等于 32.8B 参数除以 8 再乘 2 字节。对不上就说明某个融合权重宽度写错,或某个 norm 被误当成可切分。
归约账:batch 32 个 token,每次 AllReduce 传 [32, 5120] BF16,即 327,680 字节。Ring 每卡收发约
每层两次、64 层共 128 次,每卡每步约 73.4 MB。按 10 GB/s 有效带宽约 7.3 ms;若每次还有 5–10 微秒启动延迟,再叠加 0.6–1.3 ms。对 10 ms 级 TPOT 的解码,这笔开销与 GEMM 已属同一量级。
这也解释了三个工程选择:解码更看重归约延迟而非带宽;GEMM-AllReduce 融合能把启动藏进 epilogue;ADP 把注意力改成数据并行后,每层只剩 MoE 的一次 dispatch/combine,归约次数大幅下降。
加载顺序:为什么 Linear 要区分 create、load 与 transform
Linear 的权重生命周期被拆成三段:create_weights 只按局部形状分配空张量,load_weights 把 checkpoint 切片写进去,transform_weights 再做布局重排。三段分开的原因是显存峰值。若在构造时就按全局形状分配,再把切片拷进来,加载阶段会额外占用一份近乎全局大小的显存;对 TP=8 的 671B 模型,这个峰值足以让整个进程 OOM。
延迟创建权重(skip_create_weights_in_init)是另一层优化:构造阶段只记录形状和切分配置,等到权重加载器真正要写入时才分配。TensorRT-LLM 的模型加载流程会用这个开关,把“模块创建”和“权重物化”分成两遍,方便先规划显存预算,再按预算分配。
transform_weights 只执行一次,由 _weights_transformed 标记保证幂等。它会调用量化方法的同名方法,可能改变 self.weight 的物理形状(例如 pad、重排、打包),并在最后缓存派生状态。前向时的 GEMM 用变换后的张量,cache_derived_state 里记录 _marlin_size_k、_marlin_size_n 等物理尺寸供 kernel 使用。
理解这三段之后,就能看懂一个常见的困惑:同一个 Linear,在 create_weights 之后、transform_weights 之前,weight.shape 是逻辑形状;变换之后可能变成另一副样子。日志里打印权重形状时,要看它处在哪个阶段。
五个框架的横向对照
把 TensorRT-LLM 的做法放回整个推理框架生态,可以看出各家的差异主要在“切分单元”和“归约实现”两点。
| 框架 | 切分单元 | 归约实现 | 量化与切分的耦合 | 融合权重 | ADP |
|---|---|---|---|---|---|
| 本篇(TensorRT-LLM) | Linear 模块,全局尺寸入口、局部尺寸内部 | 可插拔 AllReduce:NCCL、自定义 IPC、对称内存;支持 GEMM-AllReduce 融合 | get_tp_alignment 把切分单位提升为量化块;scale_span、elm_packing 处理 scale 与打包 | FUSED_QKV、FUSED_GATE_UP 加显式区间映射 | 支持,reduce_output 随拓扑改写 |
| vLLM | ColumnParallelLinear、RowParallelLinear、QKVParallelLinear、MergedColumnParallelLinear | 自定义 AllReduce 与 NCCL,按硬件和形状选路 | 量化方法自带切分逻辑,scale 随权重切 | QKV、Gate/Up 融合层类 | 支持 DP Attention |
| SGLang | 与 vLLM 类似的并行线性层族,复用 sgl-kernel 的融合算子 | NCCL 与自定义集合通信,专家并行依赖 DeepEP | 量化方法注册后接管权重加载与切分 | QKV、Gate/Up 融合层类 | 支持 DP Attention 与大规模 EP |
| llama.cpp | 按张量名切分,split-mode 决定层切或行切 | ggml_backend_sched 跨后端调度,跨机走 RPC | k-quants 块量化按块切分,CPU/GPU 共用同一套块布局 | 模型加载器直接拼接/放置张量 | 以多副本服务为主,不走注意力 DP |
| DeepInfer | 自定义 Linear,面向 FP8/NVFP4 的显存布局 | 自定义通信与对称内存,配合 DP Attention 与 Wide-EP | 量化格式与切分、Hadamard 旋转、分页写入耦合 | 模型层自行组织融合权重 | 原生支持 |
这张表只描述“层内并行”的组织方式,不比较绝对性能。可以看到三个趋势:
第一,切分单元从“张量”上移到“模块”。TensorRT-LLM、vLLM、SGLang 都把切分方向、加载、GEMM、归约收进一个层类,模型代码只描述全局形状。llama.cpp 则更接近“按名字放置张量”,把切分逻辑放在模型加载器里,适合 CPU/GPU 混合和多种后端。
第二,量化对齐成为切分的一等约束。低比特格式的 scale 块不能跨 rank 切开,所以切分边界必须按 16、32、64 等粒度对齐。TensorRT-LLM 把这套约束写成 get_tp_alignment 与 scale_span,vLLM 和 SGLang 则把它藏进各自的量化方法里。读源码时如果只盯着 tp_size 做除法,很容易在低比特模型上算错局部形状。
第三,归约实现越来越硬件特化。NCCL 是通用底座,但低延迟场景更依赖 NVLS、multimem、对称内存或 GEMM epilogue 融合。TensorRT-LLM 的 AllReduceStrategy 枚举把这些实现列在一起,按拓扑和形状选择;这也是“同一个 Linear 在不同机器上走不同通信路径”的原因。
调试 TP 问题的三条检查线
层内 TP 的 bug 很少以“形状错误”的形式直接暴露,更常见的是“能跑但数值不对”或“单卡正常、多卡变慢”。按下面三条线排查,通常能快速缩小范围。
第一条:全局与局部的换算。 模型代码传入的 in_features、out_features 是全局值,日志里打印的 self.in_features 是局部值。看到某个权重形状与预期差 tp_size 倍时,先确认读的是哪一个。融合权重的宽度尤其容易写错:QKV 的 tp_size × q_size + 2 × tp_size × kv_size 里每个 q_size、kv_size 都已经是局部值。
第二条:源区间与目标偏移。 override_tp_sharding 描述 checkpoint 里的源区间,fused_weight_shard_indices_mapping 描述拼接缓冲区里的目标偏移。加载后数值异常,可以把两个表都打印出来,核对“源区间宽度之和”是否等于“目标偏移覆盖的总宽度”。两者混用通常不会越界,但会把 gate 的权重写进 up 的位置,表现为激活值整体偏移。
第三条:归约的触发条件。 行并行默认归约,列并行默认不归约,ADP 下列并行必须关掉归约。若发现不同 rank 的输出不一致,先确认这一层的输入在 TP 组内是否复制;若发现输出被放大了 tp_size 倍,先检查偏置是否在每个 rank 都加了一次,或归约是否被重复执行。
小结
TensorRT-LLM 的 Linear 把层内张量并行拆成四个可独立验证的环节:
- 形状:入口传全局尺寸,构造函数用
_calc_shard和量化对齐算出局部尺寸;tp_sharding保存源区间。 - 加载:
load_shard按切分方向切片,用flip_tp处理正交的 scale,用scale_span和elm_packing处理量化块与打包;融合权重再按子张量名取区间。 - 执行:量化方法负责 GEMM,列并行一般不归约,行并行在
reduce_output为真时归约;偏置只在 rank 0 上加。 - 归约:NCCL、自定义 IPC、对称内存按硬件选路;SM100 以上且形状对齐时可以走 GEMM-AllReduce 融合,代价是一块可观的 Lamport 工作区。
围绕这套契约,RMSNorm 选择全复制以换取免归约和融合空间,GatedMLP 用“列并行 Gate/Up + 行并行 Down”把每个 MLP 块的归约次数压到一次,Embedding 与 LMHead 则把词表维的取舍交给上层配置。ADP 再把“是否归约”从模块类型里解耦出来,变成拓扑相关的运行时决策。
读这类代码时,最值得反复确认的三个不变量是:局部形状与全局形状的换算是否一致、加载区间的源与目标是否用对、归约的触发条件是否与输入复制状态匹配。三处任意一处错位,表现出来的往往不是形状报错,而是“能跑但数值不对”或“单卡正常、多卡变慢”。把这三条盯住,再看注意力、MoE、KV Cache 的并行实现,会容易得多。
参考资料
- TensorRT-LLM 官方仓库
- TensorRT-LLM
Linear模块源码 - TensorRT-LLM
GatedMLP源码 - TensorRT-LLM
RMSNorm源码 - TensorRT-LLM
Mapping定义 - NVIDIA 技术博客:Optimizing Inference on Large Language Models with TensorRT-LLM
- NCCL User Guide: Overview
- JAX Scaling Book:How to Scale Your Model
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- TensorRT-LLM
Embedding与LMHead源码 - TensorRT-LLM 自定义 AllReduce 工作区实现
- TensorRT-LLM
SwiGLU融合算子
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



