


SGLang 源码完全拆解(二十六):MOE 的代码架构——一个 MoE 算子从模型层出发,要跨过几道后端分派
回顾:路由与分组 GEMM 已经讲完,MoE 还缺一层「调度」
SGLang 的 MoE 链路在这一系列里已经拆过两块。第二十篇讲了路由的前半程——打分、偏置、分组 topk、逻辑专家号到物理专家号的映射,以及 moe_align_block_size 如何把每个专家要处理的 token 排成连续段;第二十一篇接着讲 FusedMoE 如何把对齐表喂给分组 GEMM,让每个专家的几行 token 塞满 Tensor Core。需要补课的读者可以回看 SGLang 源码完全拆解(二十):门控 Router 与按专家对齐 和 SGLang 源码完全拆解(二十一):从对齐表到分组 GEMM。两篇合起来回答了「一个 MoE 算子内部怎么算」。
但真实部署里,MoE 从来不只是一个算子。SGLang 支持的模型有稠密也有稀疏,专家可能放在一张卡上(TP + 本地专家),也可能切到几十张卡上(EP,配合 DeepEP 做 all-to-all),还有单卡但专家多于 SM 数、需要分组 GEMM 以外的回退路径;量化方法有 FP8、INT4、W4A16,注意力后端有 FlashInfer、Triton、FlashAttention、Ascend;不同硬件平台又各自有不同的通信实现。同一个高层调用 gate(...),到了底层可能落进五六种完全不同的代码路径。这层「从模型层的一句话到具体后端实现」的调度与分派,就是本文的主题。
本文不再重复路由数学和 GEMM kernel 的内部结构,而是沿着源码回答三个问题:MoE 模块在模型层怎么被调用;调用要跨过哪几层抽象才能落到后端;每一层抽象在 MoE 场景下各自决定什么、为什么这样切。
一次门控调用经过的五层:从模型层到 kernel
把 SGLang 当前的 MoE 实现按调用深度展开,一次 DeepseekV2MoE.forward 里调用的 self.experts(hidden_states, topk_output) 会依次穿过下面五层。每一层都只回答一个问题,问题之间互不重叠:
| 层 | 位置 | 回答的问题 |
|---|---|---|
| 1 模型层 | models/deepseek_v2.py 的 DeepseekV2MoE | 这一步走哪条「形态」:MegaMoE、A2A、双流、普通?共享专家在哪条流上算? |
| 2 方法层 | layers/moe/fused_moe_triton/layer.py 的 FusedMoE | 本层有哪些物理专家、量化方法是谁、dispatcher 是谁、runner 是谁? |
| 3 分发层 | token_dispatcher/base.py 的 BaseDispatcher | 这一段隐藏状态要不要离开本卡?发给谁、以什么格式收回来? |
| 4 执行层 | moe_runner/runner.py 的 MoeRunner | 交给哪个运算后端(Triton / DeepGEMM / FlashInfer……),是否需要预置换布局? |
| 5 量化方法层 | quantization/fp8.py 的 Fp8MoEMethod.apply | 这个后端配上这个量化格式,具体调用哪个 kernel、带哪些权重与 scale? |
这五层里,第 3、4 层是真正的「分派」,第 1、2 层是「选型」,第 5 层是「落实」。读者最容易混淆的地方在于:--moe-runner-backend 与 --moe-a2a-backend 是两个互相独立的开关,最终执行路径是两者的笛卡尔积,而不是一条线性链条。下面逐层展开。
模型层:一条 forward 里的四条形态
DeepseekV2MoE.__init__ 在构造阶段就埋好了绝大多数分支判断。self.experts = get_moe_impl_class(quant_config)(...) 决定「用哪个专家类」,self.topk = TopK(**topk_kwargs) 决定「用哪套路由」,然后 self.topk.bind_runner_backend(self.experts.runner_backend, routing_method_type=self.experts.routing_method_type) 把执行后端的身份传给路由层——这一步很关键,它意味着路由实现本身也会按执行后端分叉(flashinfer_trtllm 与 flashinfer_trtllm_routed 允许把 topk 与分组 GEMM 融进同一个 kernel)。
到了前向时,DeepseekV2MoE.forward 的判断顺序是:
模型层:一条 forward 里的四条形态
DeepseekV2MoE.__init__ 在构造阶段就埋好了绝大多数分支判断。self.experts = get_moe_impl_class(quant_config)(...) 决定「用哪个专家类」,self.topk = TopK(**topk_kwargs) 决定「用哪套路由」,然后 self.topk.bind_runner_backend(self.experts.runner_backend, routing_method_type=self.experts.routing_method_type) 把执行后端的身份传给路由层——这一步很关键,它意味着路由实现本身也会按执行后端分叉(flashinfer_trtllm 与 flashinfer_trtllm_routed 允许把 topk 与分组 GEMM 融进同一个 kernel)。
到了前向时,DeepseekV2MoE.forward 的判断顺序是:
if should_use_mega_moe(self, hidden_states): return forward_mega_moe(...) # 形态 A:整层融合的 MegaMoEif not self._enable_a2a_moe: if self._can_dual_stream_graph(hidden_states): ... # 形态 B:双流 CUDA Graph elif self.alt_stream is not None and ... get_is_capture_mode() ...: return self.forward_normal_dual_stream(...) else: return self.forward_normal(...) # 形态 C:同卡普通路径else: return self.forward_deepep(...) # 形态 D:跨卡 all-to-all这四条形态的区别不在数学,而在共享专家与路由专家在哪条时间轴上跑、要不要通信:
- 形态 C(
forward_normal)是最朴素的:路由专家算完得到final_hidden_states,共享专家在同一张卡上另算一份shared_output,后者经过maybe_fuse_routed_scale_and_shared_add做「乘 routed_scaling_factor 再相加」,如果 TP 启用了reduce_results再走一次 all-reduce。 - 形态 B(
forward_normal_dual_stream)把共享专家挪到self.alt_stream上并发执行,主链只跑路由专家。源码注释里写明「Issued after the router so the main chain stays on the main stream at replay」——这条顺序约束是为了让 CUDA Graph 捕获时主链落在主 stream 上,副链只做旁路。共享专家与路由专家读取同一份hidden_states,二者在数学上完全并行,因此天然适合双流。 - 形态 D(
forward_deepep)走 EP:专家分散在多个 rank 上,self.experts变成DeepEPMoE,dispatcher变成MaybeTboDeepEPDispatcher,隐藏状态要先按路由结果打包、经 DeepEP 的 all-to-all 发到持有对应专家的 rank,算完再发回来。这一形态下共享专家通常_shared_expert_tp1 = True——共享专家在 EP 下不做 all-reduce,而是每个 rank 各算一份再相加(fused_shared_experts_scaling_factor = 1.0 / moe_ep_size的理由在__init__注释里:在 EP 模式下每张卡都算一份共享专家,所以要除以 EP 规模才与 TP 模式下的结果等价)。 - 形态 A(
forward_mega_moe)是最新的融合形态:should_use_mega_moe在满足条件时把路由、分组 GEMM、共享专家与部分归约全部交给一个融合 kernel,模型层不再分步调度。
选择哪条形态的条件写得很死:_can_dual_stream_graph 要求 FlashInfer TRT-LLM 执行后端、处于 piecewise CUDA Graph 捕获中、没有融合共享专家槽、没有 EP、没有专家重映射(is_expert_remapping_enabled())、且 ep_dispatch_algorithm 不是 fake/lp。这些条件本质上是在说:只有在「静态布局、无通信、形状可重放」的情况下,才允许把共享专家塞进副流参与图回放。
方法层:FusedMoE 在构造时就定下四件事
get_moe_impl_class 只做一件事:看 --moe-a2a-backend 是否开启了 DeepEP 类通信库,开启就返回 DeepEPMoE,否则返回 FusedMoE。DeepEPMoE 复用 FusedMoE 的大部分逻辑,只在有 EP 时改写 dispatch/combine 与部分执行路径。
FusedMoE.__init__ 则在构造时依次确定四件事:物理专家数、量化方法、dispatcher、runner。
物理专家数:self._num_global_routed = num_experts - num_shared_slots,然后 self._num_local_routed = self._num_global_routed // storage_ep_size,self.num_local_experts = self._num_local_routed + num_fused_shared_experts。其中「共享专家是否作为融合槽位出现在每个 rank」取决于 has_per_rank_fused_shared_slots——DeepEP 类与 MegaMOE 用 per-rank 槽位,其他后端用全局共享槽位。elastic EP(ep_join_mode == "scale")下,存储规模取 elastic_ep_initial_size,而不是当前的 EP 规模,这样扩容时已有 rank 的专家位置不会被重新切分。
量化方法:self.quant_method = quant_config.get_quant_method(self, prefix),若无量化则落到 UnquantizedFusedMoEMethod。若启用了 KT EP(Keep Tensor 的分片包装)则包一层 KTEPWrapperMethod。量化方法在构造时调用 create_weights 分配 w13_weight / w2_weight 与对应 scale,并在 create_moe_runner 里决定执行后端——所以量化方法不是「加法」,而是 MoE 分派的真正起点。
dispatcher:self.dispatcher = create_moe_dispatcher(self.moe_runner_config, quant_method=self.quant_method)。工厂函数按 --moe-a2a-backend 返回五种实现之一:StandardDispatcher、MaybeTboDeepEPDispatcher、DeepEPv2Dispatcher、FlashinferDispatcher、AscendTPDispatcher。
runner:self.quant_method.create_moe_runner(self, self.moe_runner_config),随后 self.runner = self.quant_method.runner。注意 runner 不是由 FusedMoE 直接创建,而是由量化方法创建——量化方法知道自己的权重格式能配哪个 kernel。
这四件事的确定顺序很关键:量化方法先于 dispatcher。因为 create_moe_dispatcher 会读 quant_method,例如 deepep_v2 需要根据 quant_method 是否 FP8 决定 dispatcher 的输出 dtype(get_deepep_v2_dispatcher_output_dtype(_deepep_v2_experts_are_fp8(quant_method)))。如果顺序反过来,dispatcher 就无法知道上游发出去的数据该以什么格式打包。
方法层内的第一张图:共享专家与路由专家是两条独立支路
MoE 的代码之所以复杂,根源在于模型结构本身就有两条支路。DeepSeek-V3 的架构图把这个结构画得很清楚:每个 MoE 层由「共享专家」与「路由专家」两部分组成,前者对所有 token 生效,后者只对被选中的 top-k 专家生效。
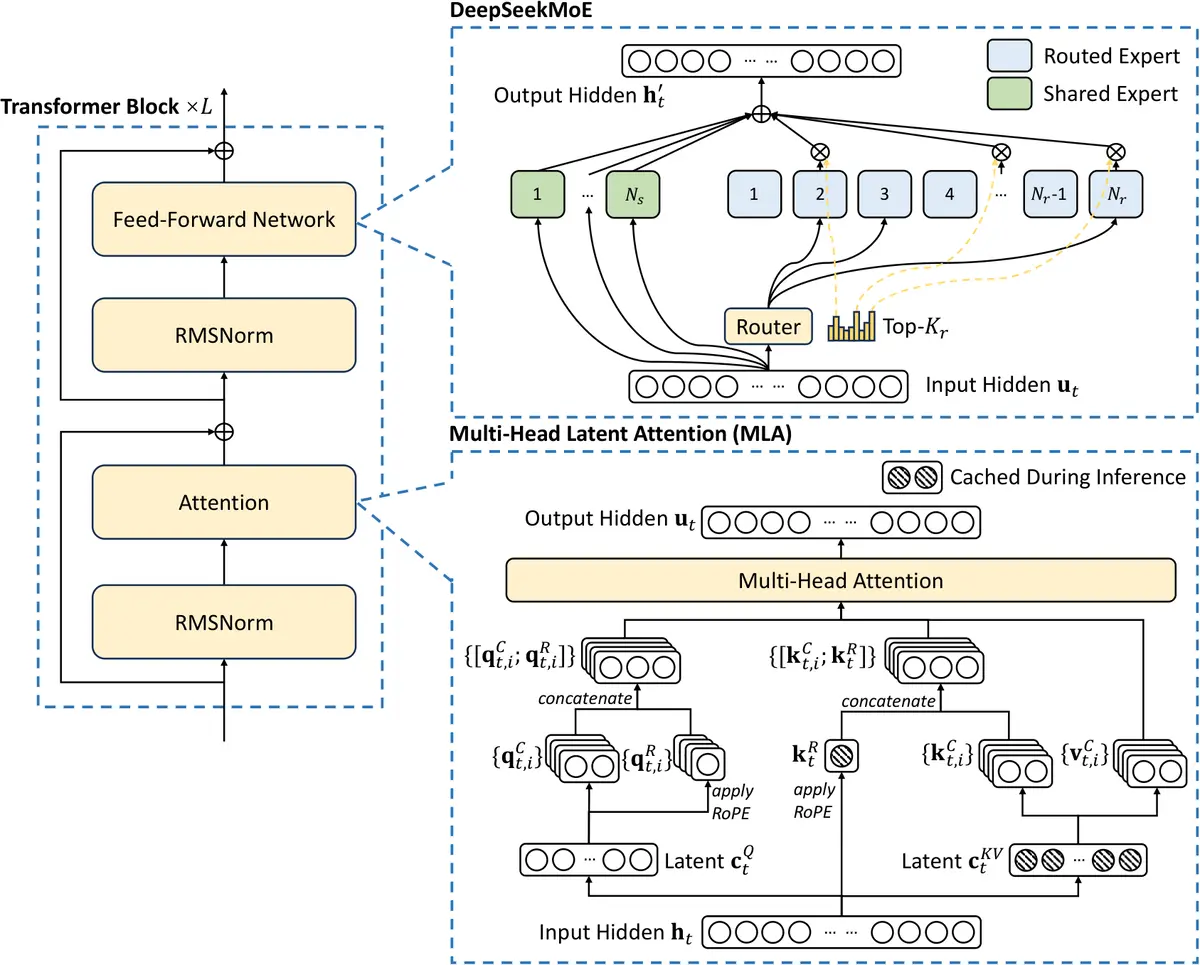
图中上半部分是 MLA 注意力,下半部分是 DeepSeekMoE:左侧的共享专家对所有 token 都计算,右侧的 256 个路由专家只按门控结果选 8 个。SGLang 模型层里的 shared_experts 与 experts 恰好对应这两条支路。理解这一点,就能理解为什么 forward_normal 里要分别处理 final_hidden_states(路由)与 shared_output(共享),以及为什么 _shared_expert_tp1、fused_shared_experts_scaling_factor 这些看似奇怪的变量会出现——它们都在回答同一个问题:共享专家在并行布局变化时,怎么保持与训练时等价的求和语义。
分发层:Dispatcher 决定的不是「怎么算」,而是「数据在哪张卡上算」
BaseDispatcher 的抽象极简,只有两个抽象方法:
class BaseDispatcher(ABC): @abstractmethod def dispatch(self, hidden_states: torch.Tensor, topk_output: TopKOutput) -> DispatchOutput: ...
@abstractmethod def combine(self, combine_input: CombineInput) -> torch.Tensor: ...但这层抽象真正承载了整条 MoE 链路上最昂贵的决策:要不要通信。工厂函数的分支逻辑就是一张部署形态表:
--moe-a2a-backend | dispatcher | dispatch 的实际行为 |
|---|---|---|
none(GPU) | StandardDispatcher | 不搬数据;只做局部专家号映射(EP>1 时) |
none(NPU) | AscendTPDispatcher | 走 Ascend 的 TP 分发 |
deepep / mooncake / nixl / mori / pplx | MaybeTboDeepEPDispatcher | 按路由结果打包,经 all-to-all 发到持有专家的 rank |
deepep_v2 | DeepEPv2Dispatcher | 按量化格式(FP8 或 BF16)打包后 all-to-all |
flashinfer | FlashinferDispatcher | 走 FlashInfer 的通信路径 |
megamoe / flashinfer_megamoe / ascend_fuseep | StandardDispatcher | 通信被融合进 kernel 或由专用路径接管,dispatcher 退化为直通 |
这张表里最容易被误读的是最后一行:StandardDispatcher 在 MegaMoE 下确实是直通,但在普通 GPU 部署下并不是空操作。它的 dispatch 会做一件至关重要的记账工作:当 moe_ep_size > 1 且执行后端不自行处理全局专家号时,它构造一张 local_expert_mapping,把路由产出的全局专家号映射成「本 rank 的本地专家下标」,并把不属于本 rank 的专家映射成 -1。执行层的 Triton / DeepGEMM 内核只认本地下标,-1 表示这一条路由在该 rank 上被丢弃。
if (self.moe_ep_size > 1 and not self.skip_local_expert_mapping and TopKOutputChecker.format_is_standard(topk_output)): # local_expert_mapping[global_id] = local_id 或 -1 ... topk_ids_local = _map_topk_ids_to_local_experts(topk_output.topk_ids, self.local_expert_mapping) topk_output = topk_output._replace(topk_ids=topk_ids_local)skip_local_expert_mapping 的判定同样是一张后端清单:flashinfer_cutlass、flashinfer_cutedsl、flashinfer_trtllm、hpc_ops、flashinfer_megamoe 等后端在 kernel 内部自己消费全局专家号,所以 dispatcher 不能替它们改写。这就是「同一份 topk_ids,在不同执行后端下含义不同」的根源:有的后端要全局号,有的要本地号,有的要带 -1 的掩码。dispatcher 与 runner 的职责边界,本质上就是这条语义转换的归属问题。
跨卡形态则完全是另一套逻辑。DeepEP 类 dispatcher 的 dispatch 需要按 topk_ids 把 token 复制并打包,经由 NVLink 或 RDMA 的 all-to-all 发到目标 rank;combine 再把各 rank 算完的结果按原顺序收回并加权求和。下图来自 MoE Parallel Folding 论文,画出了 TP 与 EP 混合时 dispatcher 的工作流:token 先被路由、按目标专家排序打包,再跨 rank 传输,计算完再回到原 rank。
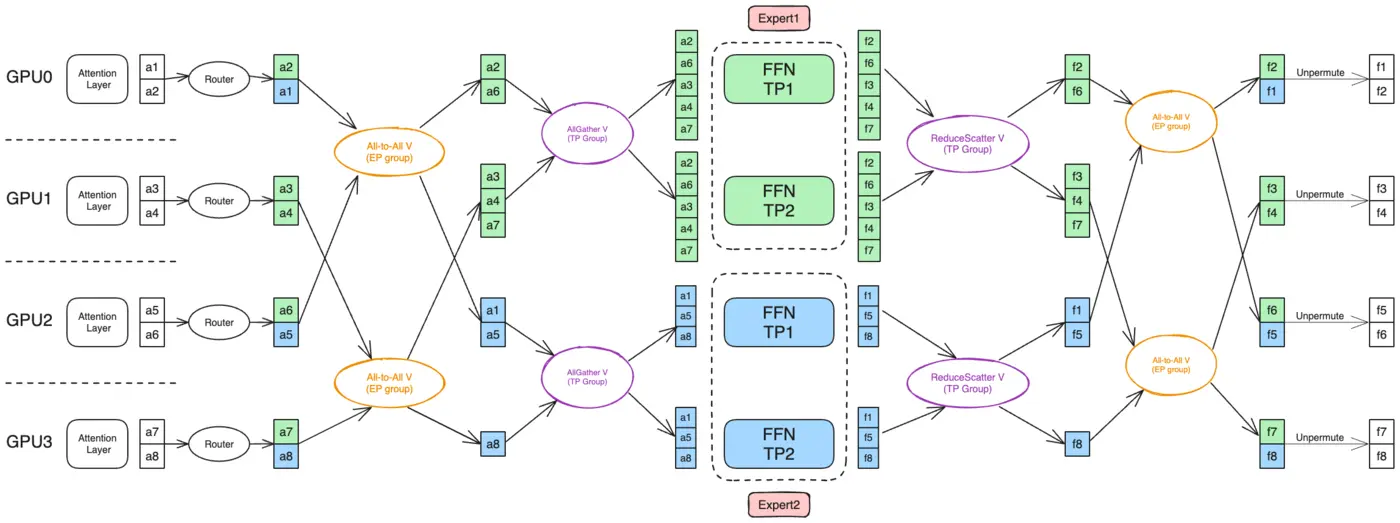
图中可以看到 dispatcher 的两端并不对称:dispatch 侧要做 permute(按专家重排),combine 侧要做 unpermute(恢复原 token 顺序)并乘上路由权重。SGLang 把这两个动作分别放在 dispatch 与 combine 里,但中间的计算并不感知重排——执行层拿到的就是「已按专家排好序的 token 行」,这也是分组 GEMM 能高效工作的前提。
执行层:runner 是「后端 + 布局」的组合,不是单一后端
MoeRunner 的构造过程决定了 MoE 计算实际落到哪个 kernel。它的 __init__ 里有一长串 elif,把 MoeRunnerBackend 映射到具体的 RunnerCore:
if runner_backend.is_triton(): self.runner_core = TritonRunnerCore(config)elif runner_backend.is_deep_gemm(): self.runner_core = DeepGemmRunnerCore(config)elif runner_backend.is_aiter(): self.runner_core = AiterRunnerCore(config)elif runner_backend.is_ascend(): self.runner_core = AscendRunnerCore(config)...但真正的设计密度在 run():它并不总是走 runner_core.run,而是先查两个注册表。
第一个表是 FusedOpPool,键是 (a2a_backend, runner_backend)。如果某个组合存在融合实现,run 直接调用它,跳过 runner_core 与布局转换:
if self.fused_func is not None and not self.lora_enabled: return self.fused_func(dispatch_output, quant_info, self.config)例如 flashinfer_trtllm 与 flashinfer_cutedsl 在多个 a2a 组合下都注册了 fused func,这些实现把 dispatch 后的布局、路由权重应用与 GEMM 全部吃进一个 kernel。这也是为什么某些后端「只支持融合路径」——它们的 runner_core 被显式设为 None,因为非融合路径根本没有实现。
第二个表是 PermuteMethodPool,键是 (dispatch_format, runner_format) 与 (runner_format, combine_format)。当没有融合实现时,run 会做两次布局转换:
self.pre_permute_func = PermuteMethodPool.get_pre_permute(dispatch_format, runner_format)runner_input = self.pre_permute_func(dispatch_output, quant_info, self.config, running_state)runner_output = self.runner_core.run(runner_input, quant_info, running_state, hooks=hooks)self.post_permute_func = PermuteMethodPool.get_post_permute(runner_format, combine_format)combine_input = self.post_permute_func(runner_output, quant_info, self.config, running_state)这一步解释了一个常见疑问:为什么 --moe-runner-backend 换了以后,同样的模型会出现不同的显存占用和不同的数值误差?因为不同 runner 需要的输入布局不同。DeepGEMM 的 contiguous layout 要求 token 行按专家连续排列且对齐到特定粒度,Triton runner 接受的是 (hidden_states, topk_weights, topk_ids) 三元组,FlashInfer 的 TRT-LLM 后端要求 topk_output.format 是 BYPASSED(路由与 GEMM 融合,不物化 topk_ids)。pre-permute 函数就是把这些格式互转的适配层。
DeepGemmRunnerCore 还展示了另一种分叉:即使同属 DeepGEMM,是否使用 masked GEMM 也会走不同函数:
if not runner_input.use_masked_gemm: hidden_states = self._run_contiguous_gemm(runner_input, quant_info, running_state)else: hidden_states = self._run_masked_gemm(runner_input, quant_info, running_state)masked 路径适合 token 数很少、无法形成整齐分组的解码场景;contiguous 路径适合 prefill 那种 token 多、分组饱满的场景。同一个 runner 后端,在 prefill 与 decode 下可能走两条不同的 kernel,这是阅读 MoE 性能数据时必须注意的口径问题。
量化方法层:runner 的可用集合由权重格式决定
Fp8MoEMethod.create_moe_runner 是「量化格式约束执行后端」最清晰的例子。它先处理 auto 的解析:
if moe_runner_backend.is_auto(): if self.is_deepgemm_moe_runner_backend_enabled(): moe_runner_backend = MoeRunnerBackend.DEEP_GEMM elif _is_hip and (_use_aiter or _use_hip_int4) and get_moe_a2a_backend().supports_aiter(): moe_runner_backend = MoeRunnerBackend.AITER else: moe_runner_backend = MoeRunnerBackend.TRITON然后在真正创建 runner 前做一次能力校验:如果用户显式指定了 flashinfer_cutlass 或 flashinfer_cutedsl,但这两个 runner 没有 FP8 MoE 路径,就打印一条日志并悄悄回退到 Triton:
if (moe_runner_backend.is_flashinfer_cutlass() or moe_runner_backend.is_flashinfer_cutedsl()): logger.info("Fp8MoEMethod has no %s path; using triton for its fp8 experts.", ...) moe_runner_backend = MoeRunnerBackend.TRITON这段逻辑值得单独拿出来讲,因为它揭示了一个工程原则:auto 不是「随便选一个」,而是「按量化格式、硬件架构与通信后端选一个已知可用的」。FP8 权重在 Hopper 上有 DeepGEMM 的 blockwise 路径,在 ROCm 上有 AITER,在其它情况下退回 Triton。用户如果强行指定一个不兼容的后端,代码不会直接崩溃,而是降级并留下日志——这让「以为开了某个后端」成为最常见的性能误判来源。
apply() 则是最后一层落实。以 FP8 为例,它按平台与 runner 分叉:
if use_intel_amx_backend(layer): ... torch.ops.sgl_kernel.fused_experts_cpu(...) # CPU AMXif _is_hip and self.runner.runner_backend.is_aiter(): return self.runner.run(...) # ROCm AITERif is_xpu() and not get_moe_runner_backend().is_triton(): ... sgl_kernel.fused_experts(...) # XPU...return self.runner.run(dispatch_output, quant_info) # 通用 runner 路径量化方法层并不只是一张「权重怎么存」的说明书,它同时是 kernel 分派表。FP8 的 blockwise 缩放布局与 per-tensor 布局对应不同的量化信息对象(TritonMoeQuantInfo 里 block_shape 是否为空),这直接决定了底层 kernel 读 scale 的方式。DeepSeek-V3 的 FP8 训练框架图(下图)说明了这种 blockwise 缩放的来源:权重与激活都按 128×128 或 1×128 的块共享一个 scale,MoE 的 grouped GEMM 必须按同样的块粒度读取 scale 才能复现训练时的数值语义。
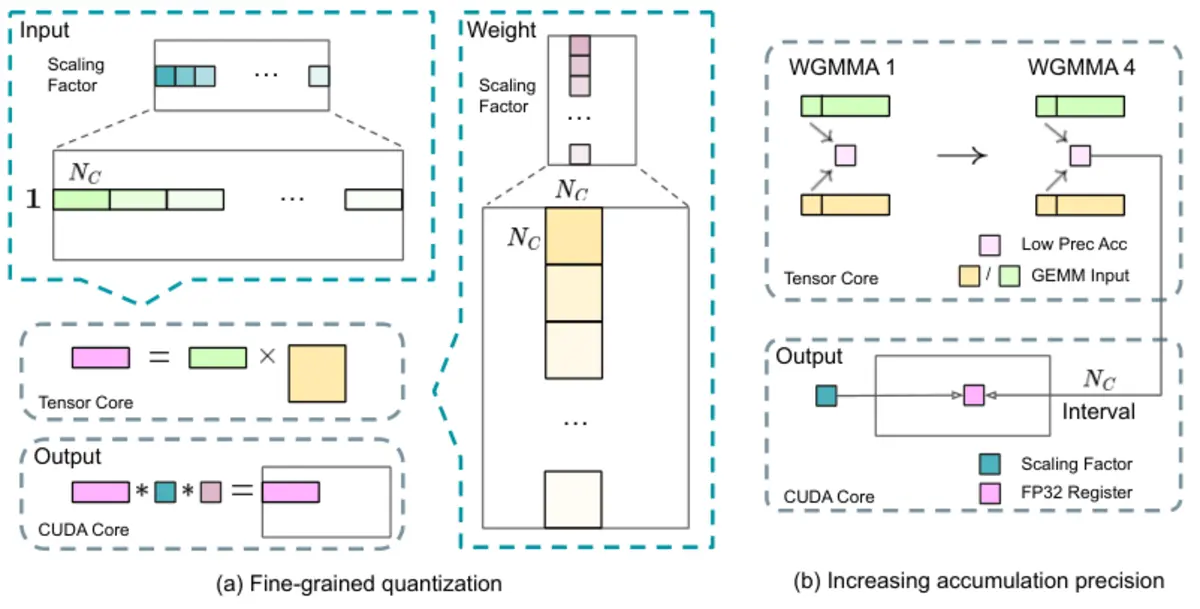
图中 (a) 是前向的细粒度量化,(b) 是反向的 128 累加器方案。推理侧只关心 (a),但正是这张图解释了为什么 SGLang 的 FP8 MoE 路径要区分 block_quant 与 per-tensor:scale 的粒度决定了权重在显存里的布局,也决定了 kernel 需要按什么形状索引 scale。
三条轴同时约束:兼容矩阵与那些「启动就报错」的检查
把上面的内容压缩成一张表,可以看到 MoE 的执行路径其实是三条正交轴的组合:
| 轴 | 开关 | 取值示例 | 影响 |
|---|---|---|---|
| 计算轴 | --moe-runner-backend | triton / deep_gemm / flashinfer_trtllm / cutlass / marlin / aiter / ascend / hpc_ops | 选哪个 GEMM kernel、要不要布局转换 |
| 通信轴 | --moe-a2a-backend | none / deepep / deepep_v2 / mooncake / nixl / mori / flashinfer / megamoe | 选哪个 dispatcher、要不要 all-to-all |
| 格式轴 | 模型 checkpoint 的量化配置 | FP8 blockwise / FP8 per-tensor / NVFP4 / MXFP4 / W4A16 / BF16 | 权重布局、scale 粒度、可用 runner 集合 |
三条轴并非自由组合。代码里用一系列「启动即失败」的断言把非法组合挡在前面,这些断言本身就是一张兼容性文档:
MoeRunner.__init__:--moe-runner-backend hpc_ops要求该层最终真的选到 hpc_ops runner,否则报错,因为 hpc_ops 要求 dispatcher 保留全局专家号,而退回其它 runner 会把全局号当本地号用,EP>1 时直接错路由。MoeRunner.__init__:--moe-a2a-backend deepep_v2要求deep_gemmrunner,因为 deepep_v2 的分发结果是 DeepGEMM 的 grouped-GEMM 布局(FP8 激活加 scale,或 BF16 激活)。_validate_hpc_ops_quant_method:hpc_ops 只支持Fp8MoEMethod。FusedMoE.__init__:use_flashinfer_trtllm_moe时若intermediate_size_per_partition不是 128 的倍数,会向上取整补齐——这是 kernel 的形状约束,不是模型约束。
这些检查的共同点是:它们校验的不是「参数是否合法」,而是「三条轴交叉后是否仍然自洽」。这也是为什么单看某一个开关的文档无法判断部署是否可行,必须同时看量化格式与通信后端。
走一遍真实路径:DeepSeek-V3 在单机 EP 与跨机 EP 下的分派
以一个典型部署为例:DeepSeek-V3,FP8 blockwise checkpoint,256 个路由专家、每 token 选 8 个,另有 1 个共享专家。
单机 TP 部署(--moe-a2a-backend none,TP=8):get_moe_impl_class 返回 FusedMoE;num_local_experts = 256/8 = 32(TP 切分下每个 rank 持有 32 个专家);create_moe_dispatcher 返回 StandardDispatcher;因为 moe_ep_size == 1,不做局部专家号映射;量化方法为 Fp8MoEMethod;auto 在非 EP 场景通常解析到 triton,只有在 DeepEP 类通信后端且 DeepGEMM JIT 可用时才解析到 deep_gemm;每层前向走 forward_normal 或双流形态,共享专家单独计算后与路由输出相加,最后做一次 TP all-reduce。
单机 EP 部署(--moe-a2a-backend none 但启用 EP,EP=8):FusedMoE 的 _num_local_routed = 256/8 = 32;StandardDispatcher 的 local_expert_mapping 生效,把全局专家号映射到本地 0..31 或 -1;执行层只算本地专家,combine 之后仍需要一次 all-reduce 把各 rank 的部分和加起来——因为每个 token 的 8 个专家可能分散在不同 rank,每个 rank 只贡献自己那部分。
跨机 EP 部署(--moe-a2a-backend deepep,EP=32 跨 4 台机器):get_moe_impl_class 返回 DeepEPMoE;dispatcher 变成 MaybeTboDeepEPDispatcher;dispatch 按路由结果把 token 打包发往目标 rank,combine 收回并加权;共享专家在 EP 下通常走 _shared_expert_tp1,每个 rank 各算一份、不做 all-reduce,再由 _adds_replicated_output() 决定哪一侧负责把这份重复输出加回去(融合共享槽位时另用 1/ep_size 补偿重复计算);模型层进入 forward_deepep 形态,并可能叠加 Two-batch Overlap 与 hook(register_pre_combine_hook、register_post_dispatch_hook)。
这条路径上的每一步都能在日志里找到对应字段。部署后如果发现「EP 开了但吞吐没涨」,第一件事不是调参,而是确认 self.experts 到底是 FusedMoE 还是 DeepEPMoE、dispatcher 到底是 StandardDispatcher 还是 MaybeTboDeepEPDispatcher——这两者决定了 token 有没有真的跨卡。
为什么要把分派拆成五层
这种「模型层 → 方法层 → 分发层 → 执行层 → 量化方法层」的拆法,看起来比「一个 MoE 函数调一个 kernel」复杂得多,但它解决了三个现实问题。
第一,模型结构的差异被关在模型层。DeepSeek 有共享专家,Qwen 的 MoE 没有;DeepSeek-V4 的哈希路由层(HashTopK)与普通层走不同路由实现;GLM 系列的分组方式又不同。如果让 kernel 直接理解这些差异,每个 kernel 都要写一遍共享专家分支、一遍哈希路由分支。现在的做法是模型层把结构差异消化成统一的 topk_output 与可选的 shared_output,下游只处理「路由结果 + 隐藏状态」。
第二,通信与计算可以独立演进。DeepEP 从 v1 到 v2、Mooncake、NIXL、MORI 这些通信库的接入,不需要改任何一个 GEMM kernel;反过来,新增一个 runner(比如 Humming、Marlin)也不需要改 dispatcher。两条轴通过 DispatchOutput 与 CombineInput 这两个数据协议解耦。
第三,量化格式的约束可以集中表达。create_moe_runner 与 apply 都在量化方法里,新增一种量化格式时,作者只需要回答「我的权重布局能配哪些 runner、每个 runner 的 quant_info 长什么样」,而不必修改调度器或模型层。
代价也很明显:调用链变长,出错时的定位成本变高。一次 MoE 前向可能跨过四五个 Python 抽象层,每层都有自己的格式约定;当输出出现 NaN 或数值偏差时,问题可能出在 pre-permute 的布局转换、dispatcher 的专家号映射、还是量化方法的 scale 读取,需要逐层核对。这也是下一节要讲的调试方法。
定位一条 MoE 路径的实操方法
给定一个部署,按下面的顺序核对,基本可以在不读完整源码的情况下确定它走哪条路径。
第一步,看模型配置。n_routed_experts、num_experts_per_tok、n_shared_experts、quantization_config 决定物理专家数、top-k 与共享专家是否存在。若 n_shared_experts > 0 且 num_fused_shared_experts == 0,共享专家是一条独立的 DeepseekV2MLP 支路;若启用了融合共享槽,它会被塞进 experts 的专家表里,num_local_experts 会相应增加。
第二步,看 get_moe_impl_class 的返回。只取决于 --moe-a2a-backend 是否属于 DeepEP 类。这一步决定 self.experts 的类型,也决定后续调度器是否存在「真正的 all-to-all」。
第三步,看 dispatcher 的 skip_local_expert_mapping。如果执行后端在 kernel 内处理全局专家号(FlashInfer 家族、hpc_ops、megamoe),topk_ids 保持全局;否则 EP>1 时会被改写成带 -1 的本地号。同一份路由结果在这两种情况下含义不同,跨层调试时最容易在这里对不上账。
第四步,看 runner 是否有 fused func。FusedOpPool.get_fused_func(a2a_backend_name, runner_backend_name) 返回非空时,run 跳过 runner_core,直接调用融合实现;此时 pre_permute 与 post_permute 都不参与。反过来,如果日志里看到 runner_core is None 相关的断言失败,说明所选后端只支持融合路径,而当前组合没有注册融合实现。
第五步,看量化方法的 apply 分叉。即使 runner 相同,CPU AMX、ROCm AITER、XPU 与 CUDA 也会走不同的最终调用;同一份 FP8 权重在 block_quant 与 per-tensor 下 TritonMoeQuantInfo 的字段不同。
这套核对顺序的价值在于:它把「读源码」变成「按轴查表」。绝大多数 MoE 部署问题——吞吐不符合预期、显存比预估多、数值与训练不一致、EP 扩容后延迟反而上升——都能定位到某一条轴的某一个判定上。
小结
SGLang 的 MoE 实现不是「一个算子」,而是一套由三条轴(计算、通信、量化格式)张成的分派系统。模型层用四条形态决定共享专家与路由专家在哪条时间轴上跑;FusedMoE 在构造时定下物理专家数、量化方法、dispatcher 与 runner;dispatcher 决定 token 是否跨卡以及专家号以什么语义出现;runner 决定落到哪个 kernel、是否需要布局转换;量化方法在最后一层把权重格式翻译成具体 kernel 的调用参数。
理解这套结构的收益不是记住某个开关的名字,而是获得一种判断力:看到一个新模型、一个新量化格式或一个新的通信库时,能迅速判断它应该插在哪一层、会与哪些既有路径冲突、需要补哪些断言。MoE 推理的性能问题,十有八九不是数学写错了,而是三条轴中某一条的判定与预期不符。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



