


GEMM Epilogue 完全拆解:推理内核的最后一公里——累加器布局、融合归约与量化写回
背景:GEMM 的最后一公里到底有多长
一个 LLM 推理引擎里,被调用次数最多的算子几乎一定是 GEMM。注意力里的 QKV 投影、MLP 的 gate/up/down 投影、输出层的 logits 计算,全部落成同一个形状的运算:
其中 是 token 隐状态矩阵,形状为 ( 是被服务的 token 数,prefill 时可以到几万,decode 时只有几十), 是权重矩阵,形状为 , 是输出,形状为 。
围绕这个乘法,工程界已经写了海量文章:怎么分块、怎么用共享内存、怎么上 Tensor Core、怎么做异步流水线。可一旦把目光从”乘加本身”移开,会发现另一个常常被忽略的事实:GEMM 的输出很少被原样写进显存就完事了。写出去之前,总还有一段”尾声”要做:
- 残差要加上();
- RMSNorm 要乘上权重向量(,以及一个按行求出的缩放因子);
- 激活要算(SiLU、GELU,或 SwiGLU 把两条通路相乘);
- RoPE 要旋转相邻的一对维度;
- 量化要乘 scale、加零点、截断成 INT8/FP8,再写成紧凑布局;
- 输出层还要做一次全词表的 log-sum-exp 才能拿到交叉熵。
这些都是访存受限的运算:每处理一个元素只做几次浮点操作,却要读写 2~6 字节。如果每种都单独发一个 kernel、把 GEMM 结果先落回显存再读出来,那么”最后一公里”的代价会一路膨胀:显存带宽被吃掉、kernel 启动开销翻倍、本来可以藏起来的尾段被摊到关键路径上。
本文讨论的就是这一公里的工程做法:GEMM epilogue(尾声)。它是主循环算完一个输出瓦片之后、把结果写回全局内存之前,在那块还在寄存器或张量内存里的数据上就地执行的一段可编程计算。文章以 2026 年 5 月发表的论文 CODA: Rewriting Transformer Blocks as GEMM-Epilogue Programs 为主线,结合 CUTLASS 的 Collective Epilogue、Epilogue Visitor Tree 与推理框架里的量化写回,把以下几件事拆开讲:
- 主循环与尾声的分工,以及尾声为什么天然适合融合;
- 累加器在片上的真实布局——为什么 epilogue 里”相邻元素”和”相邻行”是两件完全不同的事;
- 融合的元素级、逐对、向量广播、瓦片读写、瓦片归约与有状态变换六类原语;
- 跨瓦片归约(RMSNorm 的 、交叉熵的 LSE)如何拆成”瓦片内部分和 + 小型辅助 kernel”,又如何用代数重排把依赖推迟到尾声;
- 量化写回:从 FP32/FP16 累加器到 FP8/INT4,scale 在尾声的什么位置生效、字节账怎么算;
- 尾声的工作如何藏进其他瓦片的主循环背后(Hopper 乒乓、Blackwell TMEM);
- 尾声的边界:它只能看到局部瓦片,哪些算子注定融合不进去。
先放一张总览图。图 1 是 CODA 论文里 Transformer 一层前向的两种写法:上一行是标准框架写法,算子被拆成计算受限的 GEMM 和访存受限的 Norm/激活/残差;下一行是重参数化后的写法,那些访存受限的算子被塞进了相邻 GEMM 的尾声里。
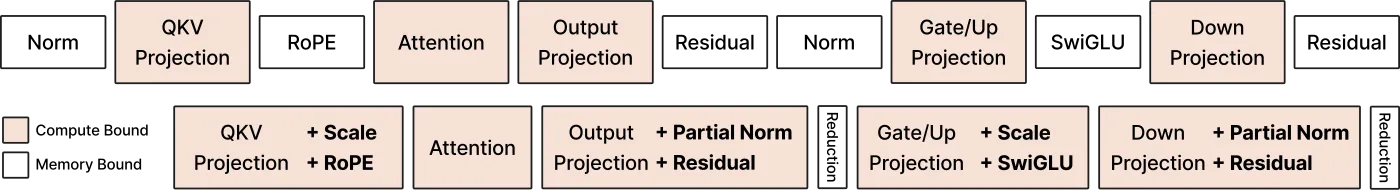
图 1:Transformer 层前向的重参数化。上一行为标准算子序列,下一行把大部分访存受限运算并入计算受限 kernel 的尾声。来源:CODA 论文(arXiv:2605.19269)图 2。
主循环与尾声:GEMM kernel 的两段式结构
现代高性能 GEMM 库(CUTLASS 是最具代表性的一个)把一个 GEMM kernel 显式地切成两部分:
- Collective Mainloop(主循环):负责搬运 、 分块到片上、发起 MMA 指令、把乘积累加进累加器。它只关心”把乘加算对、算满”,是 Tensor Core 利用率的所在地。
- Collective Epilogue(尾声):主循环交出累加器之后,负责把累加器里的数取出来、做变换、按目标类型转换、写回全局内存。
CUTLASS 3.x 起,二者通过一个 tile scheduler 串起来,epilogue 里还可以挂一棵 Epilogue Visitor Tree(EVT),把”乘 alpha、加 beta·源、加 bias、激活、类型转换”这些叶节点组合成一棵树,由工具链生成对应的尾声 kernel。
图 2 是 CODA 画的最简示意:主循环产出输出瓦片,尾声在每个瓦片落盘之前对它做变换。
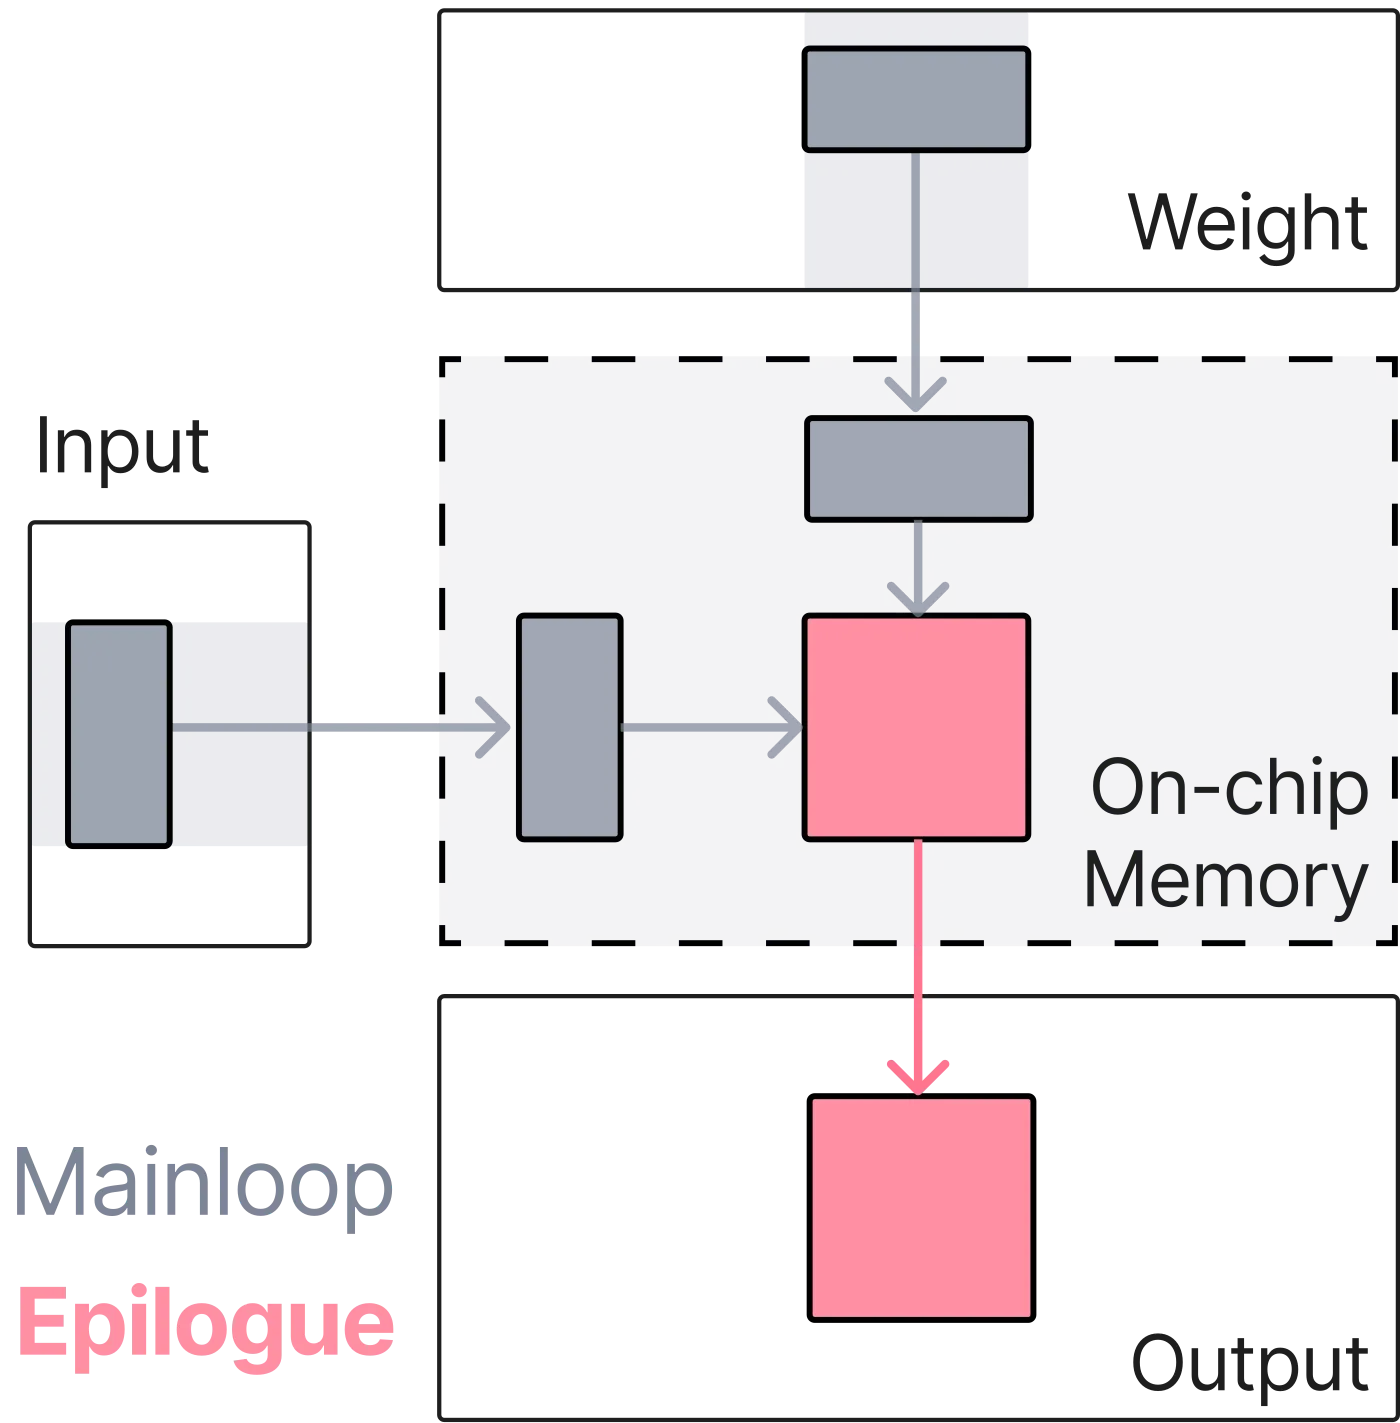
图 2:主循环与尾声的关系。尾声只能看到当前瓦片、它的累加器和”索引一致”的辅助张量。来源:CODA 论文图 3。
为什么尾声”天生”适合融合
把算子塞进尾声,本质上是利用一个内存层次事实:瓦片算完时,数据已经在离计算核最近的地方(寄存器 / 张量内存 / 共享内存),而全局内存往返一次要几十到几百个周期。如果让 GEMM 结果先写回 HBM、再起一个 kernel 读回来做 Norm,那么对一个 的中间张量,至少多出一次写 + 一次读。以 BF16 为例,每元素 2 字节,两次往返就是 4 字节的额外流量;若中间还要物化 SwiGLU 的 gate 与 up 两份、再乘出第三份,流量还要再翻。
CODA 在 LLaMA-3 风格 1B 模型(H100、TorchTitan 训练栈)上统计:在算子级 GEMM 已经被充分优化的前提下,非 GEMM 算子仍占端到端运行时间的一个不可忽略比例。注意这个数字来自训练栈,但同一组算子形态在推理侧同样存在——decode 时 GEMM 已经退化成访存受限的 GEMV,Norm/激活同样不可省略;prefill 时则是访存受限的尾段叠加在计算受限的主循环后面。
尾声的”局部性约束”——最重要的一条规则
尾声能做好这个工作,靠的是它的限制:它只看到当前输出瓦片、它自己的累加器,以及以”一致索引”访问的辅助张量。凡是需要跨越整个输出维度或整个序列维度才能得到的量(行内求和、全词表最大值),它都没法在自己的视野里直接算出来。
这条约束贯穿全文。后面所有的”重参数化”技巧,本质上都是在回答同一个问题:怎样把一个全局归约改写成”瓦片内局部计算 + 一次开销很小的合并”,或者怎样用代数等价把全局量推迟到一个更便宜的位置再乘上去。
累加器布局:尾声里”相邻”到底是什么
写 epilogue 的第一个坑不是数学,而是数据布局。一个从 CuTe/CUTLASS 里取出的累加器 fragment,其元素在线程间的分布并不等于矩阵里的几何排布。
瓦片、warp、线程与元素的四级映射
以 Hopper 上经典的 warpgroup MMA(wgmma.mma_async, 形状)为例,一个 warpgroup(4 个 warp、128 个线程)产出一个 的输出瓦片。 的元素在这 128 个线程里的分布大致是:
- 把 行按 16 行为一组切成 4 份,每个 warp 负责 16 行;
- 列再按一定宽度切成若干组,同一 warp 内 32 个线程沿列方向交错;
- 每个线程的寄存器里持有若干组”列相邻”的元素:以 的累加器布局为例,同一线程拿到的是 、、、 这样一个 2×2 元组——列相邻,但行隔了 8 行。
这一点极其关键,因为它直接决定了三件事的正确性:
- 逐对运算(RoPE、SwiGLU):如果一对相邻维度恰好落在同一个线程的同一组寄存器里,那么成对的旋转/乘法就是纯寄存器操作;如果它们跨线程,就必须经共享内存或 shuffles 交换。CODA 的做法是让成对特征”沿输出特征维相邻”,并以此决定 GEMM 的输出布局,从而与 Hopper 累加器暴露给尾声的形态对齐。
- 逐行归约(RMSNorm):一行元素分散在同一 warp 的多个线程里,行内求和要求同一 warp 内做一次 shuffle 归约;如果一行跨越多个 warp(例如瓦片列宽较大),就要再走共享内存汇聚。
- 逐列归约:列方向的元素通常跨 warp 分布,只能先由每个 warp 算部分和,再经共享内存合并。CODA 的文字说明明确写了这一点:行归约由拥有该行的 warp 累加,列归约各 warp 先产出部分结果、再通过共享内存汇总。
一个可以手算的例子
考虑 的瓦片、128 个线程(4 个 warp)。瓦片共 个元素,平均每个线程持有 64 个累加器元素;每个 warp 持 个,四个 warp 合计恰好覆盖整个瓦片。在这种切分下:
- 一行 128 个元素分布在一个 warp 的 32 个线程上,每线程 4 个,行内求和需要 轮 shuffle,外加每线程先把自己那 4 个累加进 1 个;
- 一列 64 个元素分布在 4 个 warp 上,每 warp 16 个,需要 4 份部分和写入共享内存,再由一个 warp 读出求和。
如果尾声要做的是”残差加 + 乘 + 写回”,这套映射完全不需要关心,因为都是逐元素操作,原地进行即可;一旦要做 Norm,就必须把上面的归约路径写出来。这也是为什么 CODA 把”瓦片归约”单独列为一类原语,而不是让人在每个 kernel 里重写一遍 shuffle 树。
末尾布局调整:维度变化的场合
逐对运算不仅涉及”怎么取对”,还会改变输出特征维:
- RoPE:每个相邻维度对(2 个输入)旋转后输出 2 个值,维度不变,只是值变化。
- SwiGLU:gate 与 up 两个相邻值相乘,输出 1 个值,维度减半。尾声需要做压缩:把”成对的”结果按连续位置紧凑写出。
- SwiGLU 反向:上游 1 个梯度需要分别乘 gate/up 两侧的激活导数,输出 2 个值,维度翻倍。尾声需要做扩张:把 16 位值两两打包,写出双倍宽度。
CODA 在实现层的说明是:当映射改变特征维度时,尾声要执行相应的局部布局调整,比如压缩降维输出、或把成对的 16 位值打包用于升维输出。这些调整必须考虑上文提到的累加器元组布局,否则写出的向量顺序会与下游 kernel 的假设不一致。
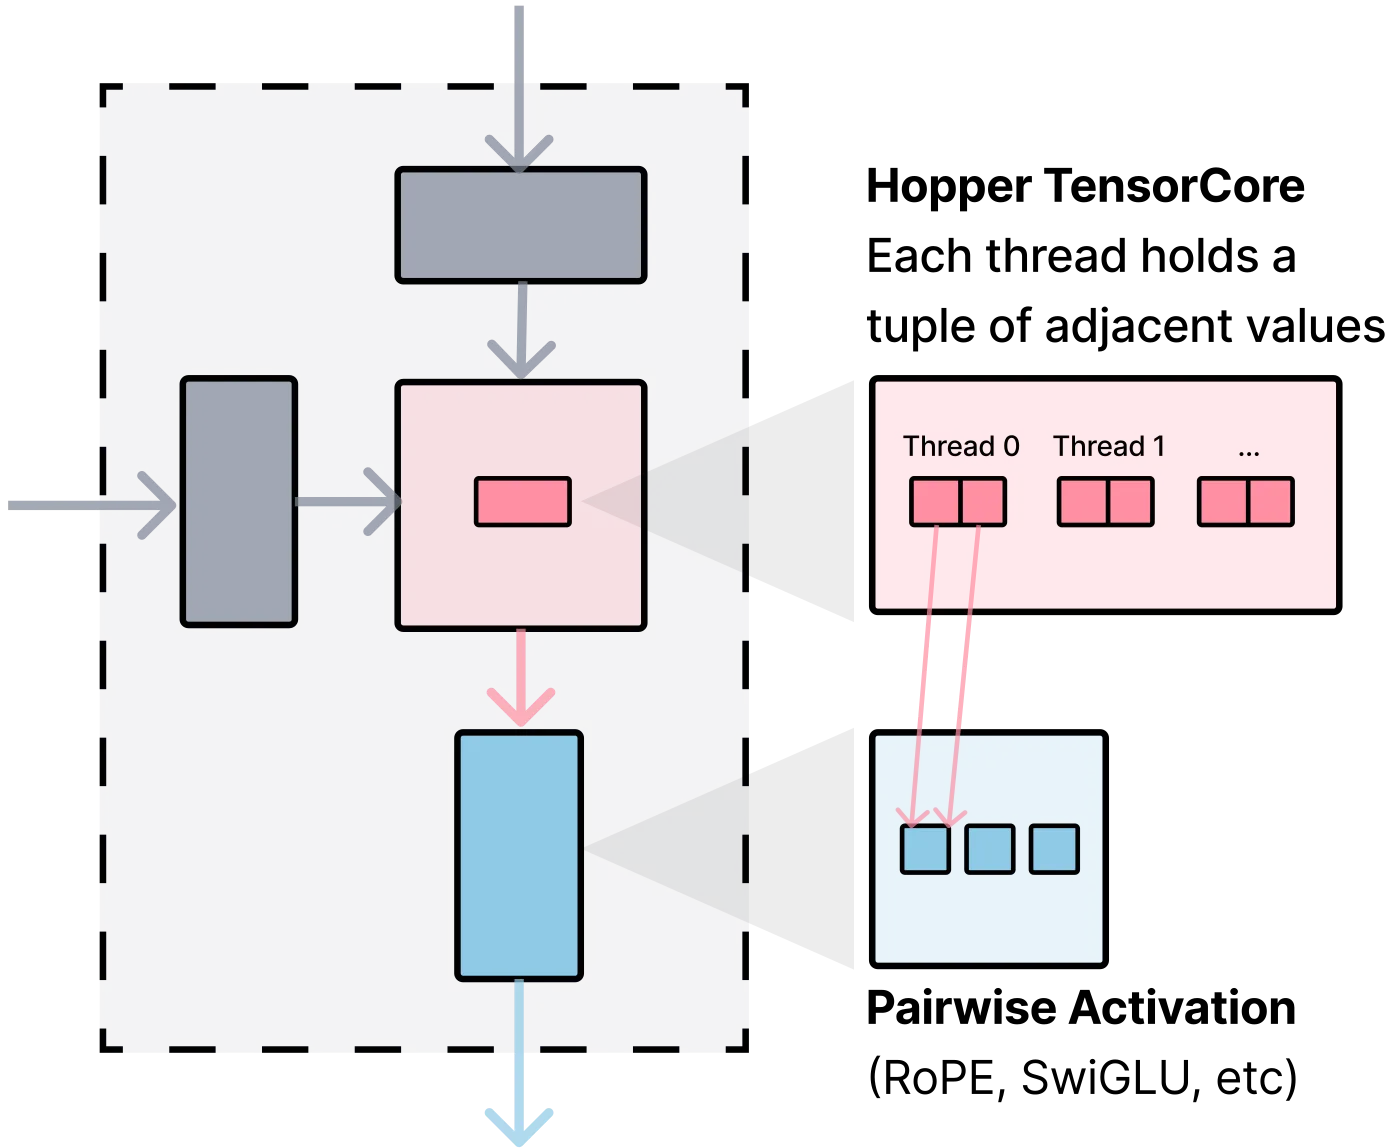
图 3:逐对激活(pairwise activation)在 GEMM 尾声里作用于局部特征对。来源:CODA 论文图 7。
六类尾声原语:一个刻意收窄的接口
CODA 的核心主张之一是:主循环固定不动,只用一类规模很小、可组合的原语去编写尾声。它的原语表共五类,其中第一类同时容纳元素级与逐对映射;按用途把它们拆开讲更清楚,因此下面按六类组织,每一类都恰好落在”能编译成高效尾声代码”的粒度上:
- 元素级映射:对累加器逐元素变换,例如残差更新、逐元素激活、类型转换。
- 逐对映射:作用于相邻特征对的变换,例如 RoPE 式旋转、SwiGLU 式门控。
- 向量(秩 1)读写:加载行向量或列向量,广播到整个瓦片,并可写出向量型附属结果。
- 瓦片(秩 2)读写:加载或写出矩阵瓦片,例如残差流、需要保存的激活、反向传播所需中间值。
- 瓦片归约:对瓦片的行或列求部分归约,稍后由轻量级辅助 kernel 合并。
- 有状态变换:维持瓦片级的运行状态,例如在线 log-sum-exp 与交叉熵所需的”当前最大值与 sum-exp”。
这个接口像 EVT 一样是”树”的结构:固定的主循环 + 可编排的尾声组合。下面的伪代码给出一个典型尾声程序的形状(不是论文原代码,而是按其原语语义组织的示意):
// 伪代码:尾声的语义骨架(C++ 语法示意;实际可用 CuTeDSL 或 C++ 模板实现)// acc: 当前瓦片的累加器 fragment;out_ptr: 主输出地址// 原语 4:加载残差瓦片 z(TMA,可与计算重叠)auto z = tile_load<M, N>(residual_ptr, tile_coord);// 原语 3:加载 gamma 的列切片并广播(共享内存暂存一次)auto g = vector_load<N>(gamma_ptr, tile_coord.col);// 原语 1:元素级映射 residual add + scaleauto h1 = acc + z; // h1[i][j] = h0[i][j] + z[i][j]auto h2 = h1 * broadcast(g); // h2[i][j] = h1[i][j] * gamma[j]// 原语 5:瓦片归约 —— 逐行部分平方和auto partial = row_reduce(h1, square_op); // 每行一个部分值// 原语 4:写回变换后的主输出 + 写部分和store_tile(h2, out_ptr, tile_coord);store_tile(partial, partial_ptr, tile_coord);后面的辅助 kernel 只需读取每个瓦片一行的部分和,把它们按行累加、开方、取倒数,就得到了 。这个辅助 kernel 读写的字节数比”完整读一遍激活张量”低一到两个数量级——这是”局部计算 + 轻量合并”的收益来源。
重参数化:把 Norm、残差与激活写进尾声
有了原语,还需要一个代数步骤:把”看起来必须在两个 GEMM 之间单独执行”的算子,改写成”落在某个 GEMM 尾声里的瓦片局部函数”。CODA 把目标形态统一写成:
其中 索引一个输出瓦片, 是该瓦片在其尾声里执行的瓦片函数。若 是纯瓦片局部的,就可以完整塞进尾声;若它依赖”瓦片内部分和”,就允许它输出部分结果,交给辅助归约合并。
模式 A:GEMM → 残差 → RMSNorm → GEMM
这是 pre-norm Transformer 里反复出现的一段结构,在相邻子层之间以三种形式出现:
- 注意力输出投影 → 残差 → RMSNorm → MLP gate/up 投影;
- MLP down 投影 → 残差 → RMSNorm → 注意力 QKV 投影;
- 最后一层 MLP down 投影 → 残差 → 最终 RMSNorm → LM Head。
写成公式:
其中 是残差流, 是 RMSNorm 的学习权重, 是按行一个的缩放因子。
拆开看每一项的局部性:
- 加法 :逐元素,瓦片局部。
- 乘 :沿列方向的广播,瓦片局部(只要尾声能取到自己列的 )。
- :沿隐藏维求均方、开方、取倒数——隐藏维通常大于一个瓦片宽度,需要跨瓦片归约。
直觉上,这似乎意味着 Norm 必须”横在”两个 GEMM 中间。CODA 用两步化解:
第一步,把归约拆成两级。 第一个 GEMM 的尾声对每个瓦片分别算出部分平方和 ,一个开销很小的辅助 kernel 把这些部分和按行合并,得到 。辅助 kernel 读的是”每瓦片一个部分值”,不是整个激活张量,因而访存量远小于独立的 RMSNorm kernel。
第二步,用代数把依赖推迟。 因为 对整行是同一个标量,它可以穿越第二个 GEMM:
最后一步把 提出括号外,靠的是一条逐行成立的等式:记 为按行缩放前的激活,则对第 行
因为 是标量、矩阵乘对左乘标量线性。所以”先乘 再乘 “与”先乘 再乘 “逐行等价。于是 完全可以从”第二个 GEMM 之前”搬到”第二个 GEMM 的尾声”——第二个 GEMM 照常吃未缩放的 ,算完之后在尾声里乘上 再写出。注意只有”按行共享”的标量才有这个性质;任何按列不同的量(如 的不同分量)都不能这样搬。
整个计算于是分解成两个 GEMM 加一次轻量归约:
其中 。注意 与两个 GEMM 都不存在”必须在中间”的依赖:GEMM 2 可以直接开跑,辅助 kernel 与 GEMM 2 主循环并行地算出 ,到尾声 2 时才被需要。这就把一次全局同步变成了”可重叠的小任务”。
图 4 是这一重参数化的示意。
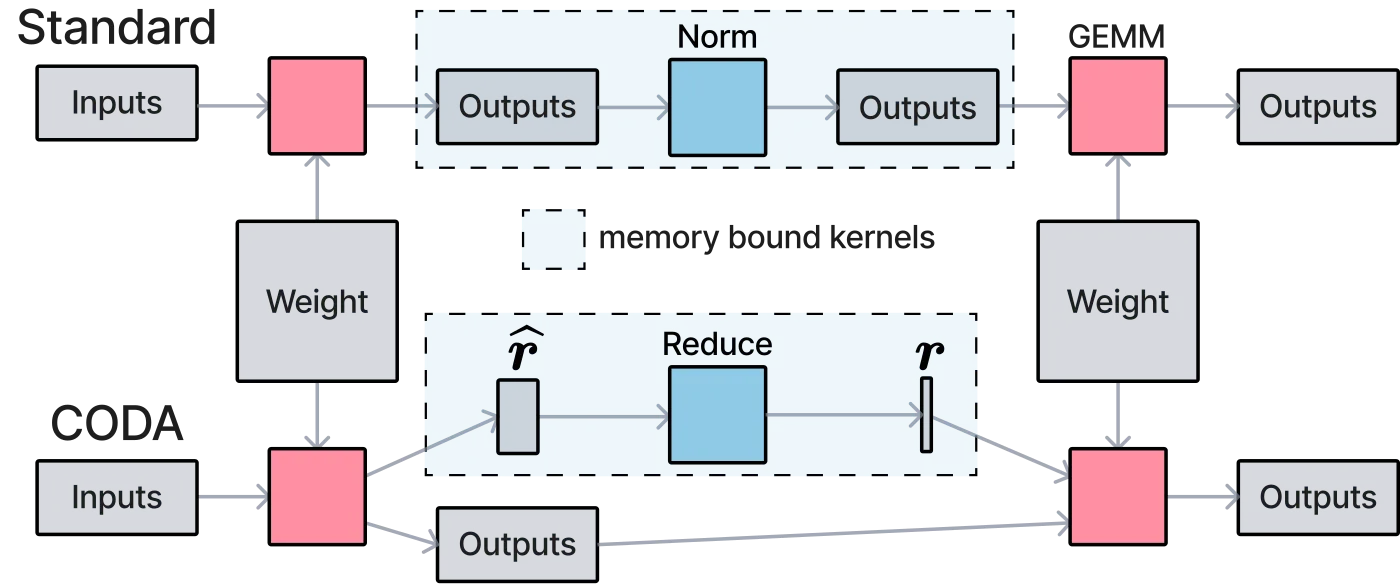
图 4:GEMM-RMSNorm-GEMM 的重参数化:残差加与 缩放进尾声 1,行缩放因子 推迟到尾声 2,中间只留一次轻量归约。来源:CODA 论文图 4。
数值问题。 重参数化把逐行缩放从”第二个 GEMM 之前”挪到了”之后”,在 BF16 下这两条路径的舍入行为不同。CODA 在 Llama-3 8B 层上用 FP32 参考对比了输出误差,并报告:更精确的主循环本身能降低误差,而重参数化后的尾声能进一步降低误差。这个结论并不”反直觉”: 是整行一个标量,先做矩阵乘、再乘标量,避免了在低精度下把激活整体除以一个不精确的 后再进矩阵乘的累积误差。不过,是否在所有 dtype 组合下都成立需要逐层验证——这是融合改写必须做的一件工程事。
模式 B:GEMM → 逐对激活
第二种高频模式是”GEMM 后接逐对激活”。逐元素激活对每个特征独立变换;逐对激活则吃两个相邻特征、产出一或两个结果:
这一类覆盖的算子不止一个:
- RoPE:每对特征做二维旋转,返回两个值;
- SwiGLU:gate 与 value 两路相乘,返回一个值;
- SwiGLU 反向:一个上游梯度映射成两个输入梯度。
朴素实现会先把 GEMM 输出物化到显存、切成对、再起一个 kernel 做激活;SwiGLU 还会多物化一份扩张后的中间量。而如果按前文所述,让成对特征沿输出特征维相邻、与累加器的元组布局对齐,尾声就能直接在寄存器里对每一对调用 ,既不物化、也不额外读写。
模式 C:GEMM → 交叉熵
LM Head 的交叉熵是一个特别典型的”尾声即归约”案例(Cut Cross-Entropy 走的也是这条路)。设 是第 个 token 的 logits, 是它的目标标签,则:
两项都能在尾声里处理:
- :从瓦片输出里按标签索引取出一个值——这是一次”索引选择”,只依赖局部瓦片和该 token 的标签;
- :词表维度(常在 32K~256K)远大于瓦片宽度,需要对每个瓦片维护”运行最大值 、运行 sum-exp “这种有状态变换,最后由辅助归约按行合并。
这里正好用上第六类原语:“有状态变换”。在线 softmax 的递推为:
其中 是处理到当前瓦片之前的运行最大值与对应的指数和, 与 都由当前瓦片在本线程/本 warp 内做归约得到。每个瓦片吐出 一对,辅助 kernel 沿词表方向再做一次相同的在线合并:合并两段统计量 、 时取 ,。这样,原本”先写出全部 logits、再读回做 softmax”的两趟全局访存,被压缩成”logits 不必落盘(或只按需要落盘)+ 每瓦片少量统计量”。CODA 说明它使用单独的最终归约而非原子操作,并保留 logits 的物化以简化反向——这两条都是工程取舍:原子合并虽然省一次 kernel,但会产生不确定顺序,对需要可复现的场合并不友好。
模式 D:反向传播为什么保持了同一结构
CODA 论文还包括训练栈的整体重参数化,其中证明了一个对推理侧理解尾声很有帮助的定理。考虑一串”GEMM + 逐元素尾声”的块:
若每个 只作用于自己的瓦片,则反向的梯度同样具有”GEMM + 瓦片局部尾声”的形态:
区别只在融合方向:前向时 被塞进”产生 的那个 GEMM”的尾声;反向时乘 被塞进”产生 的那个 GEMM”的尾声。对本文主题而言,这条结论的价值在于它说明:瓦片局部性是可以在前向、反向两侧同时维持的不变量,因此尾声融合不是”推理侧的小技巧”,而是围绕 GEMM 的一类可组合程序结构。
量化写回:尾声中真正决定字节数的环节
推理系统里尾声最常见的职责其实不是激活,而是量化。一个 FP8/INT4 的量化推理 kernel,主循环用 FP32(或 FP16/BF16)累加,尾声负责把累加器变换到目标类型再写出。这里的每一步都有明确的字节账。
仿射量化与尾声的五步
设权重在显存里已经是以 (INT4/INT8)存储、按块带 scale;激活在尾声里实时量化,块大小为 (例如每 128 个输入元素一个缩放因子 ,)。尾声对一个 的 FP8 激活瓦片做的五步是:
- 计算块最大值:对沿 方向分组的累加器块求 ,得到 。若累加器是瓦片布局,这一步是瓦片归约的一种变形(跨瓦片的部分最大值,再全局合并)。
- 缩放与舍入:,并截断到 。对 FP8 E4M3 而言,“舍入到 FP8”本身包含指数对齐与尾数舍入;对 INT8 而言是定点的四舍五入或就近偶数舍入。
- 可选:缩放因子修正:若采用带校正系数的量化(如 SmoothQuant/QuaRot 式预处理),尾声里还要乘上反向的平滑系数,使其与上游 kernel 的假设一致。
- 写出紧凑布局:INT4 要把两个 nibble 打包进一个字节;NVFP4 要连同块级 scale 一起写成”值 + scale”的成对结构。
- 写出 scale 附属数组:块 scale 是额外的一趟写,但相对主数据小得多(INT4 每 32 元素一组时,额外 1 字节/32 元素)。尾声能把它们和主输出一次性写出,避免再来一个 kernel 专门写 scale。
为什么量化必须在”最后一步”做
一个常见的困惑是:既然输出要 FP8,为什么不干脆在主循环里就用 FP8 输入做乘加?答案是精度与效率的权衡——累加精度和输出精度不是一回事。Tensor Core 的 FP8 MMA 内部通常用较高精度累加(Hopper 一代的 FP8 乘法以高精度累积),但”累加器存成什么类型”决定了片上带宽和寄存器压力。如果把累加器降到 FP8,会损失有效位数;保持 FP32 累加、只在尾声降低精度,则是”计算精度最大化、存储精度最小化”的标准做法。尾声是这条链路上唯一合适的转换点:它既能看到块的完整统计量(用于求 scale),又处在写回前。
DeepSeek 的 FP8 GEMM(DeepGEMM 完全拆解)里采用的 1×128 细粒度缩放,就是尾声侧做缩放的一种具体形态;Tensor Core 一侧的混合精度累加细节,可参考 GPU GEMM 优化完全拆解(三):Tensor Core、MMA/wgmma 指令与异步流水线。低比特权重在 Tensor Core 上”边解码边计算”的路线,另见 BitBLAS 完全拆解 与 Marlin 完全拆解。
一个瓦片的字节账
以 decode 场景的 KV 写回为例(这也是尾声常被忽略的一处):设新生成 1 个 token,KV 头数 、头维 、层数 。若以 BF16 存 KV,每层每 token 写 字节;若尾声里直接量化成 FP8,则减半为 字节。对一个 的 GQA 模型,每层每 token 从 4096 字节降到 2048 字节;在 的模型上,每条请求每次 decode 的 KV 写回量从 128 KiB 降到 64 KiB。吞吐越高、batch 越大,这半份字节越值钱。这类量化实现的细节,可参见 vLLM 源码完全拆解(十九):TurboQuant KV Cache 量化 与 KIVI 完全拆解:非对称 2-bit KV Cache 量化。
量化尾声的完整形态:低比特 GEMM 的尾声为什么要单独设计
前一小节讲的是”输出侧量化”(激活写完时降精度)。推理里还有另一类尾声:输入侧低比特、累加器 FP32,输出再做一次类型变换,例如 W4A16 的 LM Head 与 MLP。这类 kernel 的尾声和普通 GEMM 尾声有三处实质区别。
低比特的解包发生在哪一侧
4-bit 权重在显存里以 nibble 打包,一个字节装两个权重。解包可以在两个位置做:
- 主循环中:把权重解成 BF16/FP16 后再交给 MMA。这会把片上带宽需求和寄存器压力放大 4 倍(对照 nibble 原尺寸),并使”解包 + MMA”串行。
- 尾声中(或紧邻主循环的输入路径上):在数据搬进共享内存/张量内存之前或在 MMA 之前紧贴着解码,使主循环看到的仍然是紧凑数据,解包的结果只在一小段时间内在片上存在。
后者的代价是主循环逻辑更复杂:需要对 nibble 做打散、按 CUDA core 的向量化宽度重排成 MMA 需要的 fragment 布局。这正是 Marlin 等 kernel 的核心工程点之一(参见 Marlin 完全拆解:4-bit 权重如何喂满 GPU Tensor Core)。
尾声里的”量化权重反解”与 per-group scale
4-bit 权重通常按 group(例如每 128 个输入元素一组)配一个 scale,且 scale 可以为 BF16 或 FP8(如 NVFP4 的每 16 元素一个 FP8 scale)。当主循环在输入路径完成 之后,累加器已经是”按比例正确”的乘积和——尾声不需要再乘权重 scale。但有一类 kernel 为了节省片上操作,故意在累加器里保持”未乘 scale 的部分和”,并在尾声里乘以 scale:
其中 索引 group,、 分别是权重和激活在该组上的 scale。这个式子说明:scale 乘积是”group 级”的常量,尾声对每 个输出只需把各个 的部分和按 scale 加权相加即可。代价是累加器需要按 group 分开保存(即”多路累加器”),否则无法在尾声里乘上不同 scale。这就解释了为什么低比特 kernel 的累加器往往比”一个矩阵”更大——累加器里装的是 份部分和, 是 group 数。
一个粗糙的字节账:对 K=4096、group 大小 128 的 W4 权重,每个输出列有 32 个 group。若累加器按 group 分开保存,同一 的寄存器占用就乘 32——这对寄存器压力是致命的。因此实际实现通常在 K 方向分几段处理,每段只保留少量 group 的部分和,段间用共享内存/张量内存归约。这类”分段累加 + 尾声合并”的结构与后文的”跨瓦片归约”是同一套思想,只不过归约发生在 K 上而不是行/列上。
尾声的输出类型组合
一个低比特推理 kernel 的尾声可能要同时写出:
- 主输出:BF16/FP16/FP8 的激活,形状 ;
- 辅助输出:若下一层需要激活量化,则同时写出 FP8 激活与逐块 scale(常见的是”值 + scale 紧耦合”的布局);
- 诊断输出:如可选的最大值/最小值(用于调试量化误差)。
三路输出可以通过一次 TMA 描述符的多个段或多次异步存储写出,关键在于它们共用同一份已解码到片上的瓦片数据,而不是”写完再读回来补第二个”。
图 5 给出了 CODA 的 kernel 级基准:横轴是 尺寸,纵轴是相对 cuBLAS + torch.compile 的加速比。可以看到不同原语组合的收益与尺寸相关,这正是尾声收益依赖”瓦片是否够大、主循环能否藏住尾段”的直接反映。
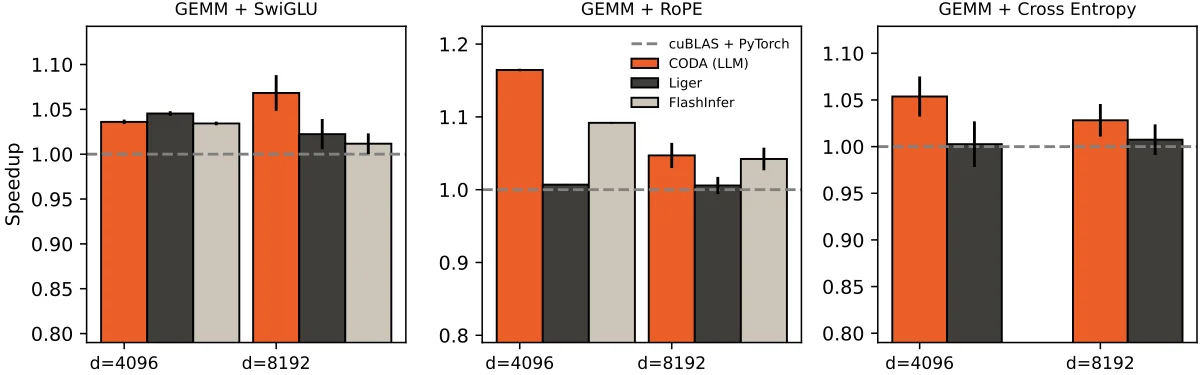
图 5:代表性 GEMM-plus-epilogue 原语在不同 尺寸下的加速比(RoPE 用 输出维,交叉熵用 32K 词表)。来源:CODA 论文图 8。
把尾声藏起来:它凭什么”几乎免费”
尾声本身有计算和访存开销。它能被接受的真正原因是:在现代流水线里,一段瓦片的尾声可以与其他瓦片的主循环重叠。
Hopper 的乒乓模式
Hopper 上的 CUTLASS 3.x 采用 “Ping-Pong” 调度:两个 warpgroup 交替执行 MMA 与 epilogue,当一组在做尾声(从累加器取数、变换、经 TMA 写回)时,另一组正在进行下一个瓦片的 MMA。尾声的开销因此被摊进另一个瓦片的主循环时间中,而非叠加在其后。
尾声要放进这段”阴影”里,必须满足两个工程条件:
- 访存走 TMA:尾声的瓦片加载与写回使用 Tensor Memory Accelerator 的批量搬运,与计算异步进行;CODA 的实现说明中就写了这一点——瓦片加载用 TMA 在全局与共享内存之间搬运,从而与尾声计算重叠。
- 不要把依赖全部串成一条链:尾声里的归约、写回、下一瓦片的取数最好能交错发射,否则阴影只够藏一部分。
Blackwell 的张量内存
Blackwell 的 MMA 结果先落在 Tensor Memory(TMEM),再经尾声读出、变换、写回共享内存或全局。TMEM 的读写有专门指令与配额(按列分配),这使得”产出瓦片 → 尾声变换 → 写出”可以与同 SM 上另一组 warp 的下一次 MMA 同时进行。对尾声设计者的直接影响是:累加器布局换了一套规则——TMEM 里每列的所有权、lane 与 col 的映射,决定了逐对操作能不能还是纯寄存器操作、行归约要跨多少个 lane。GPU GEMM 优化完全拆解(四)对此有更细的拆解:见 GPU GEMM 优化完全拆解(四):tcgen05 与 Blackwell。
一个实用的判断:当你把某个”算子融合进尾声”当作性能优化时,先问它是否能被切成”每瓦片独立、无跨瓦片同步”的形态;如果不能,就会变成一个把 Pipeline 打断的同步点,收益可能为零甚至为负。
从”能手写”到”能被编排”:尾声的接口化
CODA 的一个值得借鉴的设计取向是:它不要求作者(人或 LLM)从零综合 CUDA 或发现硬件调度,而是要求其在”固定的高性能主循环 + 一小套尾声原语”的空间里组合程序。原语本身就编码了高效实现策略(TMA 怎么用、行归约怎么走、逐对怎么打包),作者只需要决定”这段尾声由哪些原语按什么顺序组成”。
这样做有两个好处:
- 可复用:同一组原语能覆盖残差 + Norm、RoPE、SwiGLU、交叉熵、反向等多类尾声;新 kernel 由已有示例改编而成。
- 可编程:尾声作为一个组合出来的小程序,更容易被自动化工具(包括代码生成模型)理解、生成与校验,因为它被限制在一个可枚举的语义空间里。
这与”整 kernel 生成 + 搜索”的路线是互补的:后者在未知调度空间里搜索,前者在固定主循环上做受限组合。对推理框架来说,同一条思路已有现实对应——FlashInfer 把分页 KV、动态批与定制注意力”编译成服务级 kernel”,vLLM 的 Attention Backend 则统一了不同实现的元数据接口(参见 FlashInfer 完全拆解 与 vLLM 源码完全拆解(六):Attention Backend)。
尾声融合做到哪里为止:边界与坑
把尾声当作”万能融合点”是危险的。以下几条边界值得在看代码、写 kernel 时反复对照。
边界一:全局归约必须被改写或外置
尾声看不到整个输出维或整个序列维。因此:
- 行内 norm 需要一个辅助归约 kernel 或跨瓦片的部分和;
- 全词表 softmax / 交叉熵需要每个瓦片吐统计量;
- 需要跨层、跨头聚合的量(例如逐层注意力统计)不可能在单 kernel 尾声内完成。
代价的账要算清楚:辅助 kernel 的启动与访存不是零,它是否划算取决于”部分和”的规模相对完整张量有多小。对宽隐藏维(如 8192)而言,每瓦片一个部分值只有几百个元素,相比完整激活是几个数量级的差异;但如果在瓦片极窄(如 )的情形下,部分和相对主输出就不再”微不足道”,需要重新评估。
边界二:改变的依赖顺序会影响数值
前文中把 从 GEMM 2 之前推迟到之后,改变了舍入序列。同理,把”跨瓦片的最大值”替换为”瓦片内最大值 + 合并”在数学上等价,但在浮点下不同;把”先乘 再归一”替换为”先归一后乘”的变体也同理。这些改写需要与框架的精度基准对齐(例如与 torch 参考输出的误差是否在允差内),不能只在 BF16 下”看起来对”。
边界三:布局即约定,约定要文档化
一旦尾声改变了输出布局(压缩成对输出、打包 16 位对、写块 scale 数组),下游算子(下一个 GEMM 的输入加载、注意力 kernel 的 KV 读取、采样器的 logits 读取)都必须按同一约定解读。CODA 自己也把这一点列入局限:重参数化在提升效率的同时会模糊模块边界与算法语义,给与框架级抽象的对接带来困难。工程上可操作的做法是把布局约定写进 kernel 接口说明、并用一致性校验/单测钉住(例如对每个 kernel 输出,检查”与参考实现的差小于阈值且布局完全一致”)。
边界四:它不是分布式的答案
CODA 明确说明其重参数化聚焦单个 GPU kernel,不涉及分布式执行。若一个算子需要跨卡通信(例如张量并行下的 AllReduce、专家并行的 dispatch/combine),尾声只能负责”通信之前/之后”的那一段变换,通信本身仍要按原有机制组织。
边界五:epilogue 的”免费”依赖整条流水
尾声被藏进阴影,前提是主循环足够长、调度能把两个瓦片错开。在 decode 这类 极小、主循环很短(甚至退化成 GEMV)的场景中,尾声的相对开销会显著上升——此时”能不能减少一个 launch”往往比”能不能藏进阴影”更重要,设计取舍会反过来。
端到端账本:把尾声的收益与代价放到同一个尺度上
前面各部分大多是定性或局部定量的。这一节把”一个 Transformer 子层”的访存字节,按”无融合”与”尾声融合”两种写法各算一遍,给出一份可以自己套用的账本。
设隐藏维 ,FFN 中间维 ,一个 token 的激活以 BF16 计(2 字节),残差流与激活同维。考虑”注意力输出投影 → 残差 → RMSNorm → gate/up 投影”这一段:
无融合写法的字节账(每 token):
| 步骤 | 读 | 写 |
|---|---|---|
| O 投影 GEMM 写出 | — | 个元素 |
| 残差 add kernel | 投影输出 + 残差 | 残差流 |
| RMSNorm kernel | 残差流 + (可常驻) | 归一化输出 |
| gate/up GEMM 读入 | 归一化输出 | 输出 |
粗算主数据(不含权重):写入 ,读取 ,合计约 个元素;以 、BF16 计约 64 KiB/ token( 字节)。
尾声融合写法:
| 步骤 | 读 | 写 |
|---|---|---|
| 尾声 1:残差加 + 乘 + 部分平方和 | 残差 | 中间 + 部分和(每瓦片一个,随 极小) |
| 辅助归约 | 部分和 | (每行 1 个) |
| 尾声 2:乘 写出 | — | 输出 |
写入约 ,读取约 ,合计约 个元素(权重读取两边相同,未列);同样条件下约 32 KiB/ token。这一段的主数据往返被压掉了一半。这里没有把权重读取算进去——对 decode( 小)而言,权重读取才是大头,激活侧的节省影响有限;对 prefill( 大)而言,激活侧往返与权重读取同量级甚至更大,尾声融合的收益才明显。这正是”尾部收益依赖形状”的原因。
再看一个与本文主线不完全相同的例子:SwiGLU 的两条通路。无融合写法里 gate 与 up 是 GEMM 的同一段输出(宽 ),需要先写出、再起 kernel 读取两条通路相乘、再写出 ;融合写法里 的结果根本不落盘(或只在需要保存激活时落一次),直接乘出 写出。以 、 计,无融合多出 × 2 字节 ≈ 107 KiB/token 的额外流量,融合后这部分基本消失。
这两个账本说明了一件事:尾声融合的收益大小是可算的,而且是”每 token 字节”级别的。在决定是否写一个融合 kernel 之前,先把上表按目标模型的 、、dtype 填一遍,再对比目标场景(prefill/decode、batch 大小)中权重读取与激活读写谁占主导,就能判断得失,而不是凭”融合一定更快”的直觉。
尾声的输出布局约定:谁来保证下游读得对
融合尾声改变布局时,正确的读法不止一种”正确”。同一个 张量可以按行主序、按列主序、按”成对交织”或”块交织”写出;下游 kernel(下一个 GEMM 的 A 矩阵加载、注意力 kernel 的 QKV 切分、采样器的 logits 读取)只认其中一种。尾声化最容易被忽略的故障模式不是”算错”,而是”算对了但下游按不同约定解释”。
用形状与步长把约定钉死
一种稳妥做法是在 kernel 接口上同时给出逻辑形状与物理步长(stride),下游一律通过步长访问:
QKV epilogue 输出(LLaMA 风格,三个头数 N_q, N_k, N_v 拼接为总宽 2N_q + N_k):逻辑形状: [M, 2*N_q + N_k] # 未 reshape 的拼接输出物理布局: 行主序,行步长 = 2*N_q + N_k切分约定: Q = [:, 0:N_q], K = [:, N_q:N_q+N_k], V = [:, N_q+N_k:2*N_q+N_k]RoPE 融合: 旋转在 epilogue 内完成,K 段已旋转,下游不再旋转只要”拼接顺序 + 段界 + 是否已旋转”三件事写在接口说明里,尾声做的旋转与下游的读取就不会错位。反过来,如果只在代码里”顺手”把 K 段旋转写回,而下游默认”读到的 K 未旋转”,就会出现”数值对、结构错”的隐蔽 bug。
一致性校验
对每个融合 kernel,至少要做两类校验:
- 布局校验:用参考实现(PyTorch 算子序列)生成输出,与融合 kernel 输出逐元素比较,同时核对步长/形状完全一致;
- 端到端校验:把融合 kernel 接入真实模型,在固定随机种子下比较整段输出的误差是否落在允差内。第二类尤其能发现”布局对但边界条件错”的问题,例如最后一个不完整瓦片的写出。
这类校验的成本远低于上线后发现错误,值得成为融合 kernel 的标准动作——这也是 CODA 把”重参数化模糊模块边界”列为局限的背景:重参数化越激进,越需要显式的约定与校验来补上被模糊掉的东西。
一个可操作的检查清单
当你考虑把一个算子融合进某个 GEMM 的尾声时,可以用以下顺序判断:
- 它是不是逐元素? 是 → 直接进尾声,基本无成本。
- 它是不是作用于相邻特征对? 是 → 检查累加器元组布局,必要时调整输出布局使”对”落在同线程寄存器内;注意维度变化时的压缩/打包。
- 它是不是沿行/沿列的归约? 是 → 拆成”瓦片内部分和 + 轻量合并”,并计算部分和的规模相对完整张量是否值得。
- 它依赖的全局标量能否被代数延迟? 能(如 RMSNorm 的 按行共享)→ 推迟到下一个 GEMM 的尾声,并用重叠隐藏辅助归约。
- 它是不是输出类型转换? 是 → 放在尾声的最后一步,同时写出附属的 scale/辅助数组。
- 它的输出布局有没有改变? 有 → 写下约定、加一致性检查,通知所有下游。
- 它的数值改写是否在允差内? 逐层对比参考实现。
- 在目标场景(prefill/decode)下,被藏起来的可能性有多大? 主循环很短时优先考虑”减少 launch”。
小结
GEMM 主循环决定了”乘法能跑多快”,尾声决定了”这个乘法能多便宜地变成下游要的东西”。尾声之所以重要,是因为推理里大量字节消耗发生在 GEMM 外围:残差、Norm、逐对激活、量化转换、log-sum-exp。把它们放进瓦片落盘之前的尾声里,本质上是把若干次全局内存往返压缩成一次片上局部计算。
本文从三个角度拆开了这件事:
- 结构:主循环固定、尾声可编排;尾声受”只能看到局部瓦片”的约束,所有融合技巧都在消解这条约束的影响。
- 布局:累加器在线程间的分布决定了逐对操作与归约怎么写,维度变化时还要做压缩与打包。
- 代数:按行共享的标量(RMSNorm 的缩放因子)可以穿越线性层;需要全局求和的量(LSE、均方和)拆成”瓦片部分值 + 轻量合并”;交叉熵与在线 softmax 是”有状态尾声”的实例;量化是尾声最后一步、也是字节账最关键的一步。
再往外看一层:尾声能否真正”免费”,取决于它能否被藏进其他瓦片主循环的阴影里(Hopper 乒乓、Blackwell TMEM),以及它会不会引入改变数值的同步点。把这两件事判断清楚,尾声融合才是稳赚的;判断不清,它就会变成为了一处融合而牺牲整条流水线的亏本买卖。
参考资料
- CODA: Rewriting Transformer Blocks as GEMM-Epilogue Programs(Han Guo、Tri Dao 等,2026-05)
- CODA 开源实现 coda-kernels
- CUTLASS GitHub 仓库
- CUTLASS 3.x GEMM API 与 Kernel 组织文档
- CuTeDSL 文档(CODA 所基于的 Python 级 Kernel 编写框架)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
- Cut Your Losses in Large-Vocabulary Language Models(Cut Cross-Entropy)
- QuACK:基于 CuTeDSL 的 GPU Kernel 库(CODA 主循环模板的基线)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



