


AllReduce 完全拆解:Ring、树算法与 NCCL——张量并行推理的通信账单从哪来
一个原语,两个半步:Reduce-Scatter 与 All-Gather
ncclAllReduce 的语义是:对 个 rank 的输入做元素级归约,让每个 rank 的输出缓冲里都出现完整的归约结果。NCCL 官方文档给出的图示很直观:
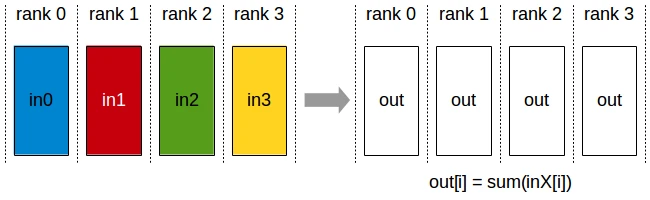
把这个定义当成不可分割的黑盒,就没法解释后面任何算法的设计。正确的打开方式是先看另外两个原语:
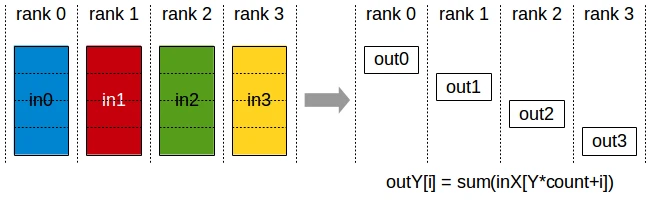
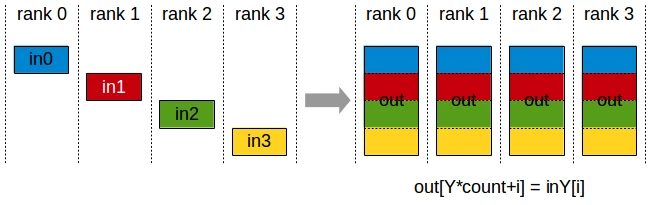
注意图 2 与图 3 的输出拼起来正好是图 1:Reduce-Scatter 先把归约结果按块切开、分散到 个 rank;All-Gather 再把 块拼回去。于是:
两个原语的传输量各是多少?以 Reduce-Scatter 为例:每个 rank 最终持有 ,其余 必须沿某条路径流向持有者。在最优调度下,每个 rank 恰好发送 字节、也接收这么多。All-Gather 完全对称:每 rank 发出自己那份 给其余 个 rank,收发量同样各是 。
两个阶段加起来,就是一个 AllReduce 里每个 rank 的总传输量:
对比一个朴素实现——每个 rank 把自己的 发给所有对端、各自在本地归约——单是接收就要收 字节,通信总量是 量级。 这个系数把每 rank 通信量从「随 rank 数线性增长」压到「渐近 2 倍」,这就是集合通信算法设计要争夺的空间。后面 Ring、树、Rabenseifner 的全部设计差异,本质就是在为这两个半步各选一条最优拓扑。
通信代价模型: 与
分析集合通信算法的标准记法是 - 模型(Hockney 模型):一次点对点消息大小为 的传输时间写成
- 是延迟项:完成一次消息启动所需的固定时间——软件协议栈处理、网络跳数、握手确认——与消息大小无关;
- 是每字节传输时间,等于链路带宽的倒数();
- 是带宽项:真正搬数据花的时间。
任何集合通信算法都能归约为「每个 rank 发了多少次消息 × 每字节流过链路多少遍」,于是每个算法都有一条形如
的账。 在当代硬件上的量级值得建立体感:NVLink 域内一次小消息往返的启动开销在微秒级(几微秒的 kernel/同步开销);跨节点走 IB/RoCE 时,网络本身的跳转延迟加上软件层的发送/放行路径,有效 往往抬升一个数量级。当一个 AllReduce 要分几十步走时,光是延迟项就可能积累到数百微秒——这正是小消息场景的痛点,也是树算法存在的理由。
这个模型也是理解 NCCL 全部行为的钥匙:它后来按消息大小在算法与协议之间切换,切换点就是「延迟项」与「带宽项」在账本上交界的那个位置。
Ring:把带宽顶到最优的
Ring 的概念在 HPC 社区早已成熟;2009 年 Patarasuk 与 Yuan 在 JPDC 上系统证明了在其通信模型下 ring 达到带宽最优;真正让它出圈的是 2017 年百度 Deep Speech 2 的训练实践——团队把算法写成一篇广为流传的博客,随后开源了 ring-allreduce 库(后来并入 Uber 的 Horovod)。Horovod 论文(arXiv:1802.05799)复刻了那幅经典示意图:
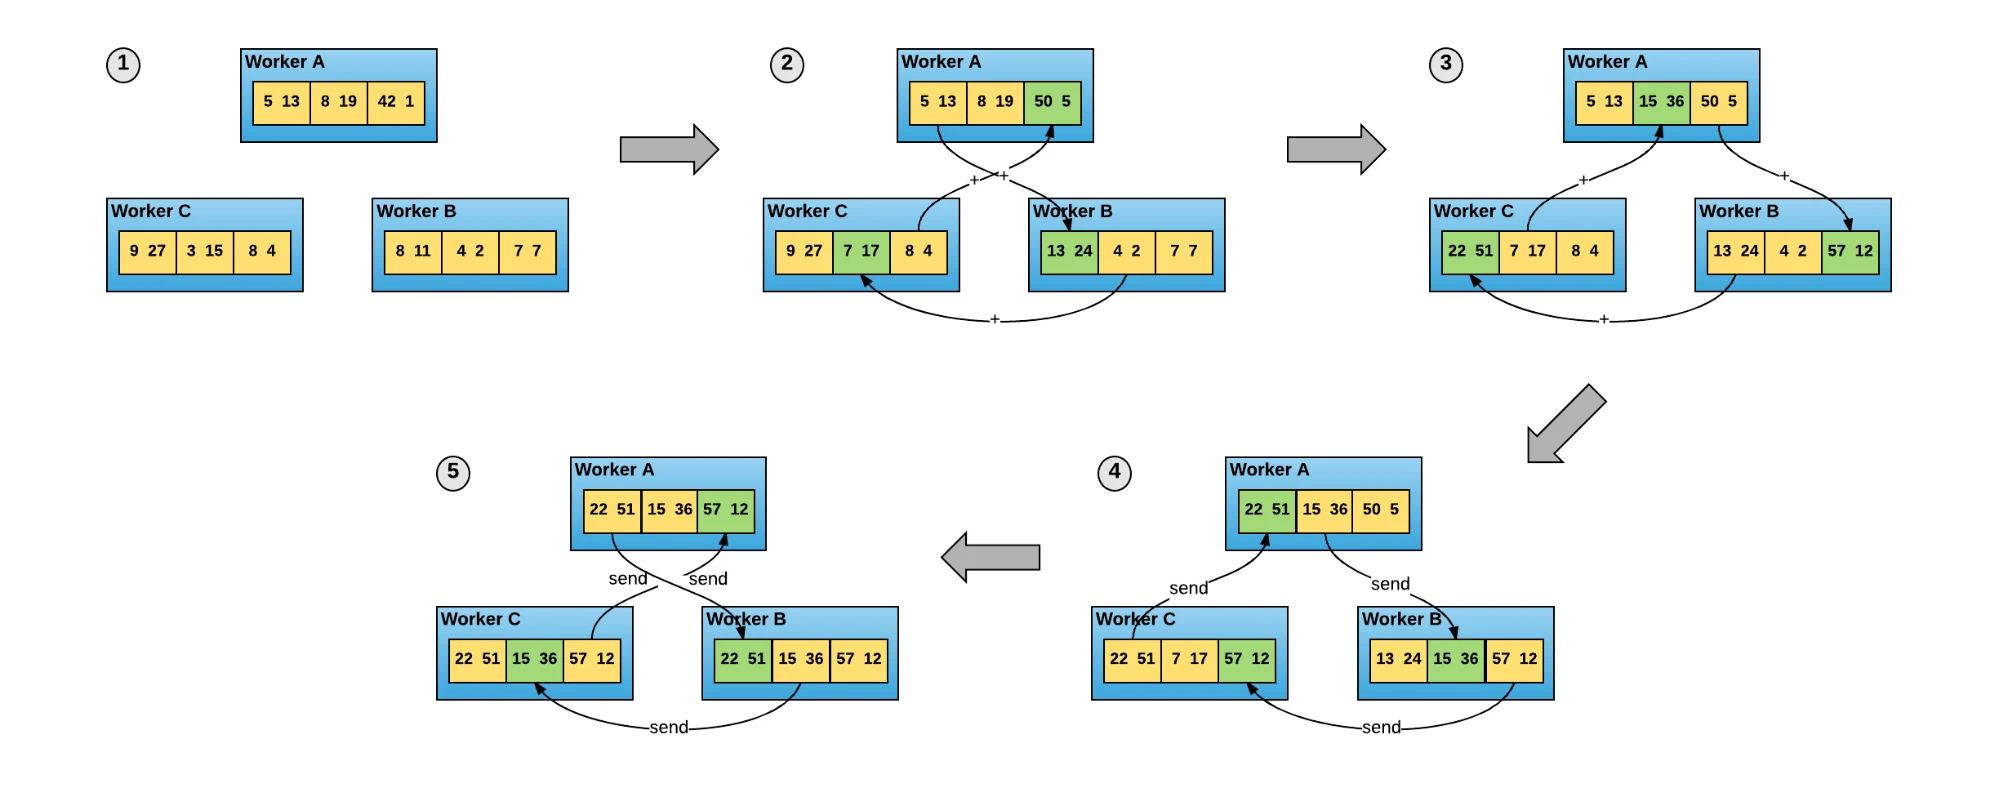
算法走查。把 均分为 份,第 份记作 。每个 rank 本地只有 ,目标是最终拿到 :
- Reduce-Scatter 段( 步):每一步,rank 把手中的一份分片发给环上的下家、同时从上家接收一份分片并就地累加。走完 步后,rank 恰好「路过」了所有 个 rank 对某一个分片的贡献——此时它持有一块完整的归约结果,且不同 rank 持有的是不同分片。
- All-Gather 段( 步):沿同一个环继续转发,各 rank 每步把上一轮收到的完整块传给下家。 步后每个 rank 手里是全部 块,即完整归约结果。
以 为例,Reduce-Scatter 段结束时各 rank 持有的完整块是:rank 0 持有 、rank 1 持有 、rank 2 持有 、rank 3 持有 (环方向从 流向 时)——每个 rank 独占一块,这正是 All-Gather 段要分发的库存。
为什么它把带宽顶到最优? 关键在每一步:环上所有 rank 同时发出一块、接收一块,每条链路在每一时刻都在传数据。一个分片要被 个其他 rank 的贡献累加,就需要沿环流动 次;而这些流动被均匀摊到 步里,没有任何一步在排队。总传输量达到上一节推导的下界 。
代价模型:
- 带宽项:。当 增大,系数 ,即带宽项几乎与 无关——这是 ring 的核心优势。
- 延迟项:,随 线性增长。128 卡时是 ;若 取 5 微秒,仅延迟项就是约 1.3 毫秒。大消息时带宽项占数十毫秒,这点延迟可以忽略;小消息时它反过来压垮一切。
所以有一条常被引用的结论:ring 适合大消息,不适合小消息。这不是经验之谈,而是 - 账本上的直接推论。
顺带一提,ring 泛化性好还有个工程原因:环对每个 rank 的度数要求恰为 2,不要求全连接。NVLink 交换机把多卡连成全互联时当然能用;当卡间连不成全互联(PCIe 拓扑、跨节点的 IB 网络),ring 也能沿任何一条哈密顿回路工作。这是它比下面 one-shot 这类「每 rank 直连所有对端」的算法泛化性好的根本原因。
树算法家族:延迟项对数化
递归倍增(recursive doubling)
递归倍增是小消息场景最经典的设计。 取 2 的幂时,第 步里 rank 与相距 的对端互换并归约彼此当前的向量, 步后每个 rank 都拥有完整归约结果。
- 延迟项:。128 卡只需 14 步对 2 个方向的各 7 轮,比 ring 的 少一个数量级。
- 带宽项:每步每 rank 收发 ,共 步,合计 。128 卡时约 ,大于 ring 的 。
所以递归倍增与 ring 正好互补:小消息、rank 数不大时延迟项主导,对数步数带来压倒性优势;消息变大后 倍的带宽开销反过来压垮它。对应到推理场景:TP = 8 时,解码单步的 hidden state 在极小 batch 下只有几 KB 到几十 KB,递归倍增的 6 步对 ring 的 14 步是实打实的延迟差;消息超过几百 KB 后 ring 反超。
Rabenseifner:两阶段各取最优
Rabenseifner 算法(Rolf Rabenseifner 在 1990 年代末提出,后被 MPICH、Open MPI 采纳为主力算法之一)的思路很清晰:把 AllReduce 拆回 Reduce-Scatter 与 All-Gather 两个半步,每个半步都用递归折半完成,而不是像 ring 那样把整条消息走满 步。
- Reduce-Scatter 用递归折半:第 步里,相距 的对端交换各自持有向量的一半(只交换当前阶段还需要的那一半),数据量逐级减半; 步后得到 的分片归约结果。
- All-Gather 是这个过程的逆:数据量逐级加倍, 步拼回完整向量。
有意思的是带宽项的账:每步发收 ,对 求和:
每半步都是等比级数,总和逼近 而不是 。所以在 为 2 的幂时,Rabenseifner 的带宽约等于 ring 的 ,同时延迟项只有 ——同时拿下 ring 的带宽与树的延迟。这就是它至今仍是主流 MPI 实现大中消息主力算法的原因。
代价在工程侧有两点:一是非 2 幂的 rank 数要靠虚拟 rank 补齐处理;二是每步消息大小逐级变化、没有稳定的流水线节拍,kernel 化实现不如 ring 顺滑。NCCL 没有把 Rabenseifner 作为独立算法暴露出来(其 Tree 实现内部有类似折半结构),但它标出了「带宽-延迟同时最优」这条可达边界的位置。Thakur、Rabenseifner 与 Traeff 对 MPICH 各集合通信算法的综述给出了这一批算法的统一代价表,是核对公式的标准出处。
双树:NCCL Tree 的核心思想
NCCL 的 Tree 算法采用双二叉树结构。单个二叉树的 reduce 与 broadcast 是串行的:先把数据聚到根、再从根散开,两阶段中总有一半链路闲着。双树把 个 rank 分成两棵父子关系互补的二叉树——一棵树里的父子,在另一棵树里是不同子树的兄弟:
- 第一棵树向上做 Reduce:叶子把数据往上传,逐级归约;
- 第二棵树同时向下做 Broadcast:把另一半数据往叶子散;
- 同一个 rank 在同一时刻既是一个方向上的接收者、又是另一个方向上的发送者——两棵树的通信在时间上重叠。
重叠正是补齐树算法带宽短板的关键:单树的链路利用率只有一半左右,双树把有效带宽拉高约一倍。NCCL 的 tree 实现还支持在多层网络上构造分层树:NVLink 域内先归约、IB 域间再拼接,让慢速跨节点链路只承载一次归约结果而非全部中间数据。
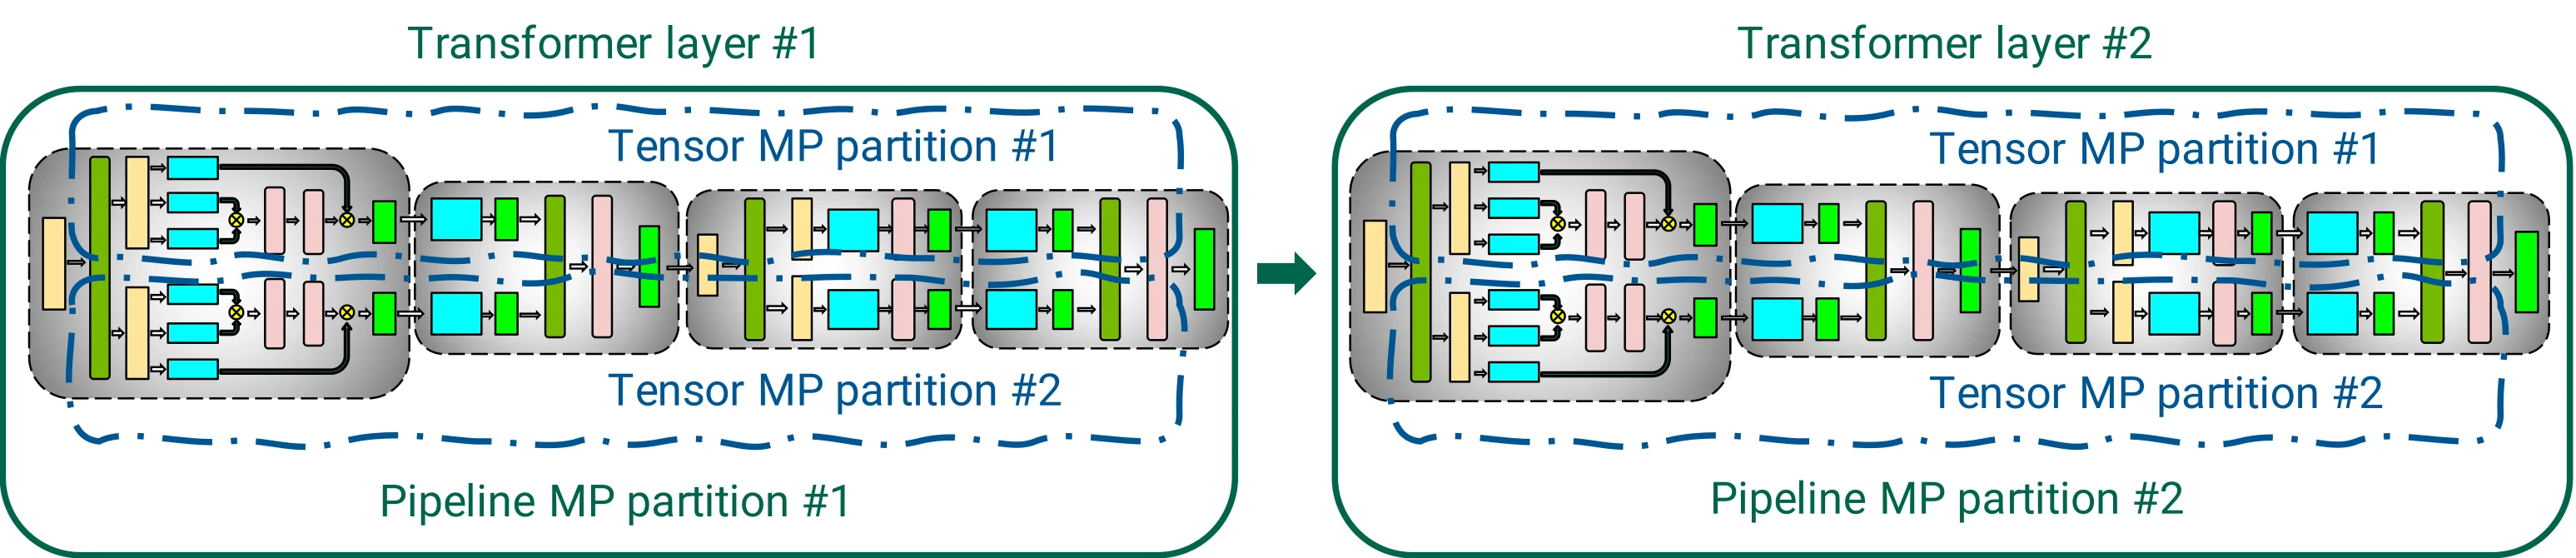
NCCL 的选路逻辑
有了代价模型,NCCL 的行为就不再是黑盒。它每次 AllReduce 前的决策大致分三层。
拓扑发现与通道搜索
初始化时 NCCL 扫描系统:GPU 之间的链接类型(NVLink/NVSwitch、PCIe P2P)、网卡位置(IB/RoCE/以太网)、CPU 亲和性,形成一个带权拓扑图。在这个图上,NCCL 为每个 rank 搜索若干条通道(channel):每条通道是一棵生成树或一个环,覆盖一部分链路,目标是让所有通道的可用带宽最大化且负载均匀。一次 AllReduce 会同时用多条通道并行推进——这是 NCCL 能把 ring 跑出接近链路聚合带宽的原因。NCCL_DEBUG=INFO 在初始化阶段打印的那一长串拓扑日志,就是这次探索的痕迹。
按消息大小选算法与协议
NCCL 在运行时按消息大小在算法与协议两个维度上选择,官方文档列出的可选项是:
NCCL_ALGO:Ring、Tree、CollNet(2.14 起拆分 CollNetChain/CollNetDirect)、NVLS(2.17 起,走 NVLink SHARP 的网内归约)、NVLSTree(2.18 起);NCCL_PROTO:Simple(标准块传输)、LL(低延迟协议)、LL128(LL 的改良)。
匹配出来的决策树大致是:大消息走 Simple 协议 + Ring 或 NVLS(带宽项主导,选带宽最优的路径);小消息走 LL/LL128 协议 + Tree(延迟项主导,选步数少的路径);中间区间是两者交界的「战场」,切换点随拓扑与链路类型变化——这正是 NCCL_ALGO/NCCL_PROTO 环境变量要留给用户强制指定的空间,也是官方文档把自动选择作为默认值的原因。
协议细节:Simple、LL 与 LL128
Simple 协议是教科书式的:发送方把数据块完整写入接收方缓冲,随后信号翻转确认。它带宽最高,但接收方要等一整块到齐才能确认,步与步之间产生等待。
LL(low latency)协议打破这一点:把消息拆成小片段,数据和「数据已就位」的信号打包在同一组字节里推送,接收方轮询到信号即读数据,不需要单独的确认步骤。优点是步进延迟最小(适合小消息),代价是有效带宽明显低——数据与信号共享链路,实测通常只有 Simple 的四分之一到三分之一。
LL128 是 LL 的改良:利用 GPU 缓存行为的规律,在一个 128 字节缓存行里装下 120 字节数据和少量信号字节,把有效带宽拉回到 Simple 的约 95%,同时保持接近 LL 的低延迟。代价是对 GPU 架构与链路有硬约束——NCCL 官方文档明确警告 LL128 在不支持的平台上启用会导致数据损坏——所以协议自动选择必须结合拓扑。
网内归约:CollNet 与 NVLS
以上的算法都在「端点」上做归约,交换机只负责搬运。当交换机或网卡芯片本身具备归约能力时,可以把归约搬到网内:
- CollNet(
NCCL_ALGO=CollNetDirect/CollNetChain)走 IB SHARP 或支持聚合的网络:rank 把数据发往交换机,交换机把多路输入累加成一份再回送。AllReduce 的通信模式从「每 rank 沿环转发」变成「每 rank 发一份、收一份」,带宽项从 降到接近 ,且总步数不再随 线性增长。 - NVLS(NVLink SHARP)是 NVSwitch 第三代起在机内做的事情:NVSwitch 芯片自带归约单元,8 卡 H100 做一次 AllReduce 只需每卡向 NVSwitch 发一次,由 NVSwitch 归约后经 NVLink 多播回去。相比 Ring,它把 NVLink 链路上的流量接近减半。
两种网内归约都有硬件约束:要求特定芯片(NVSwitch SHARP、支持 SHARP 的 IB 交换机);数据类型必须是交换机归约单元支持的几类(如 FP8/FP16/BF16/FP32);链路上的秩数也要满足条件,不满足时退回 Ring/Tree。这就是自动选择比手写常量更有价值的原因——它知道当前系统到底支持什么。
张量并行推理的通信账单
把前面的账本翻译回推理服务里能感知的数字。
AllReduce 藏在切分图的哪里
在 Megatron 风格的切分里,MLP 第一个线性层按列切、第二个按行切,注意力同样 QKV 按头切、输出投影按行切——每一层的出口都站着一次跨卡归约:
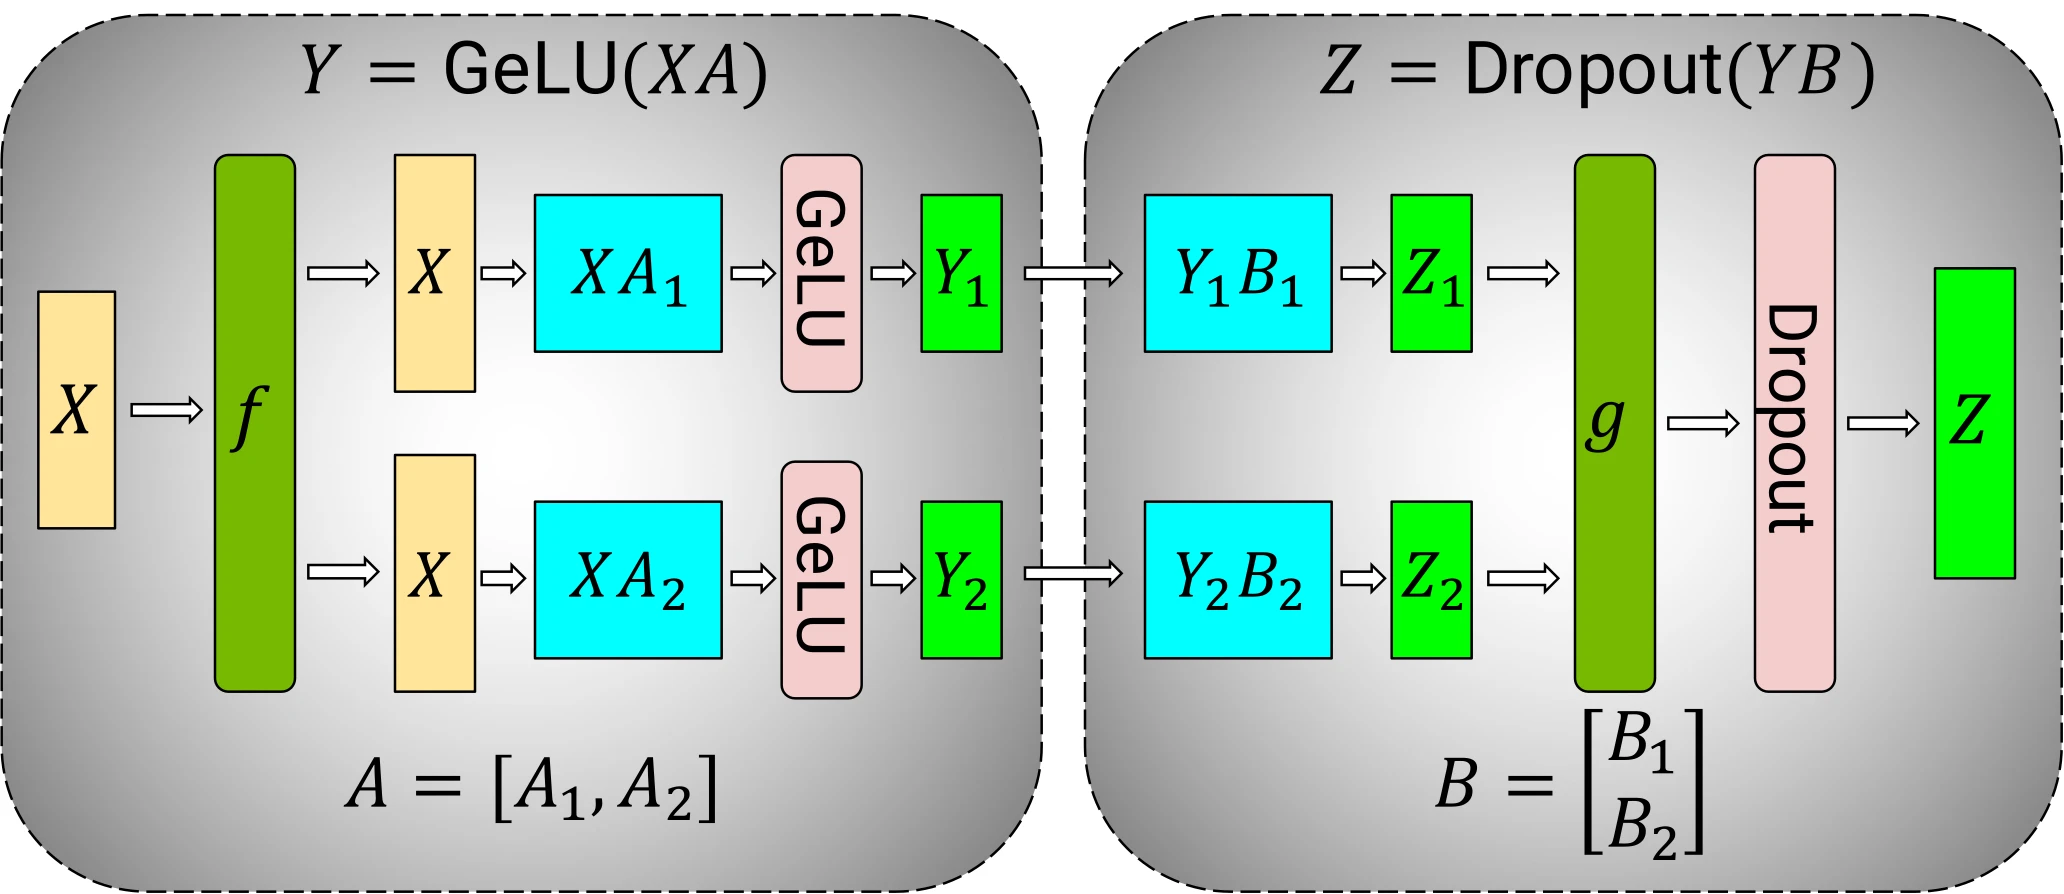
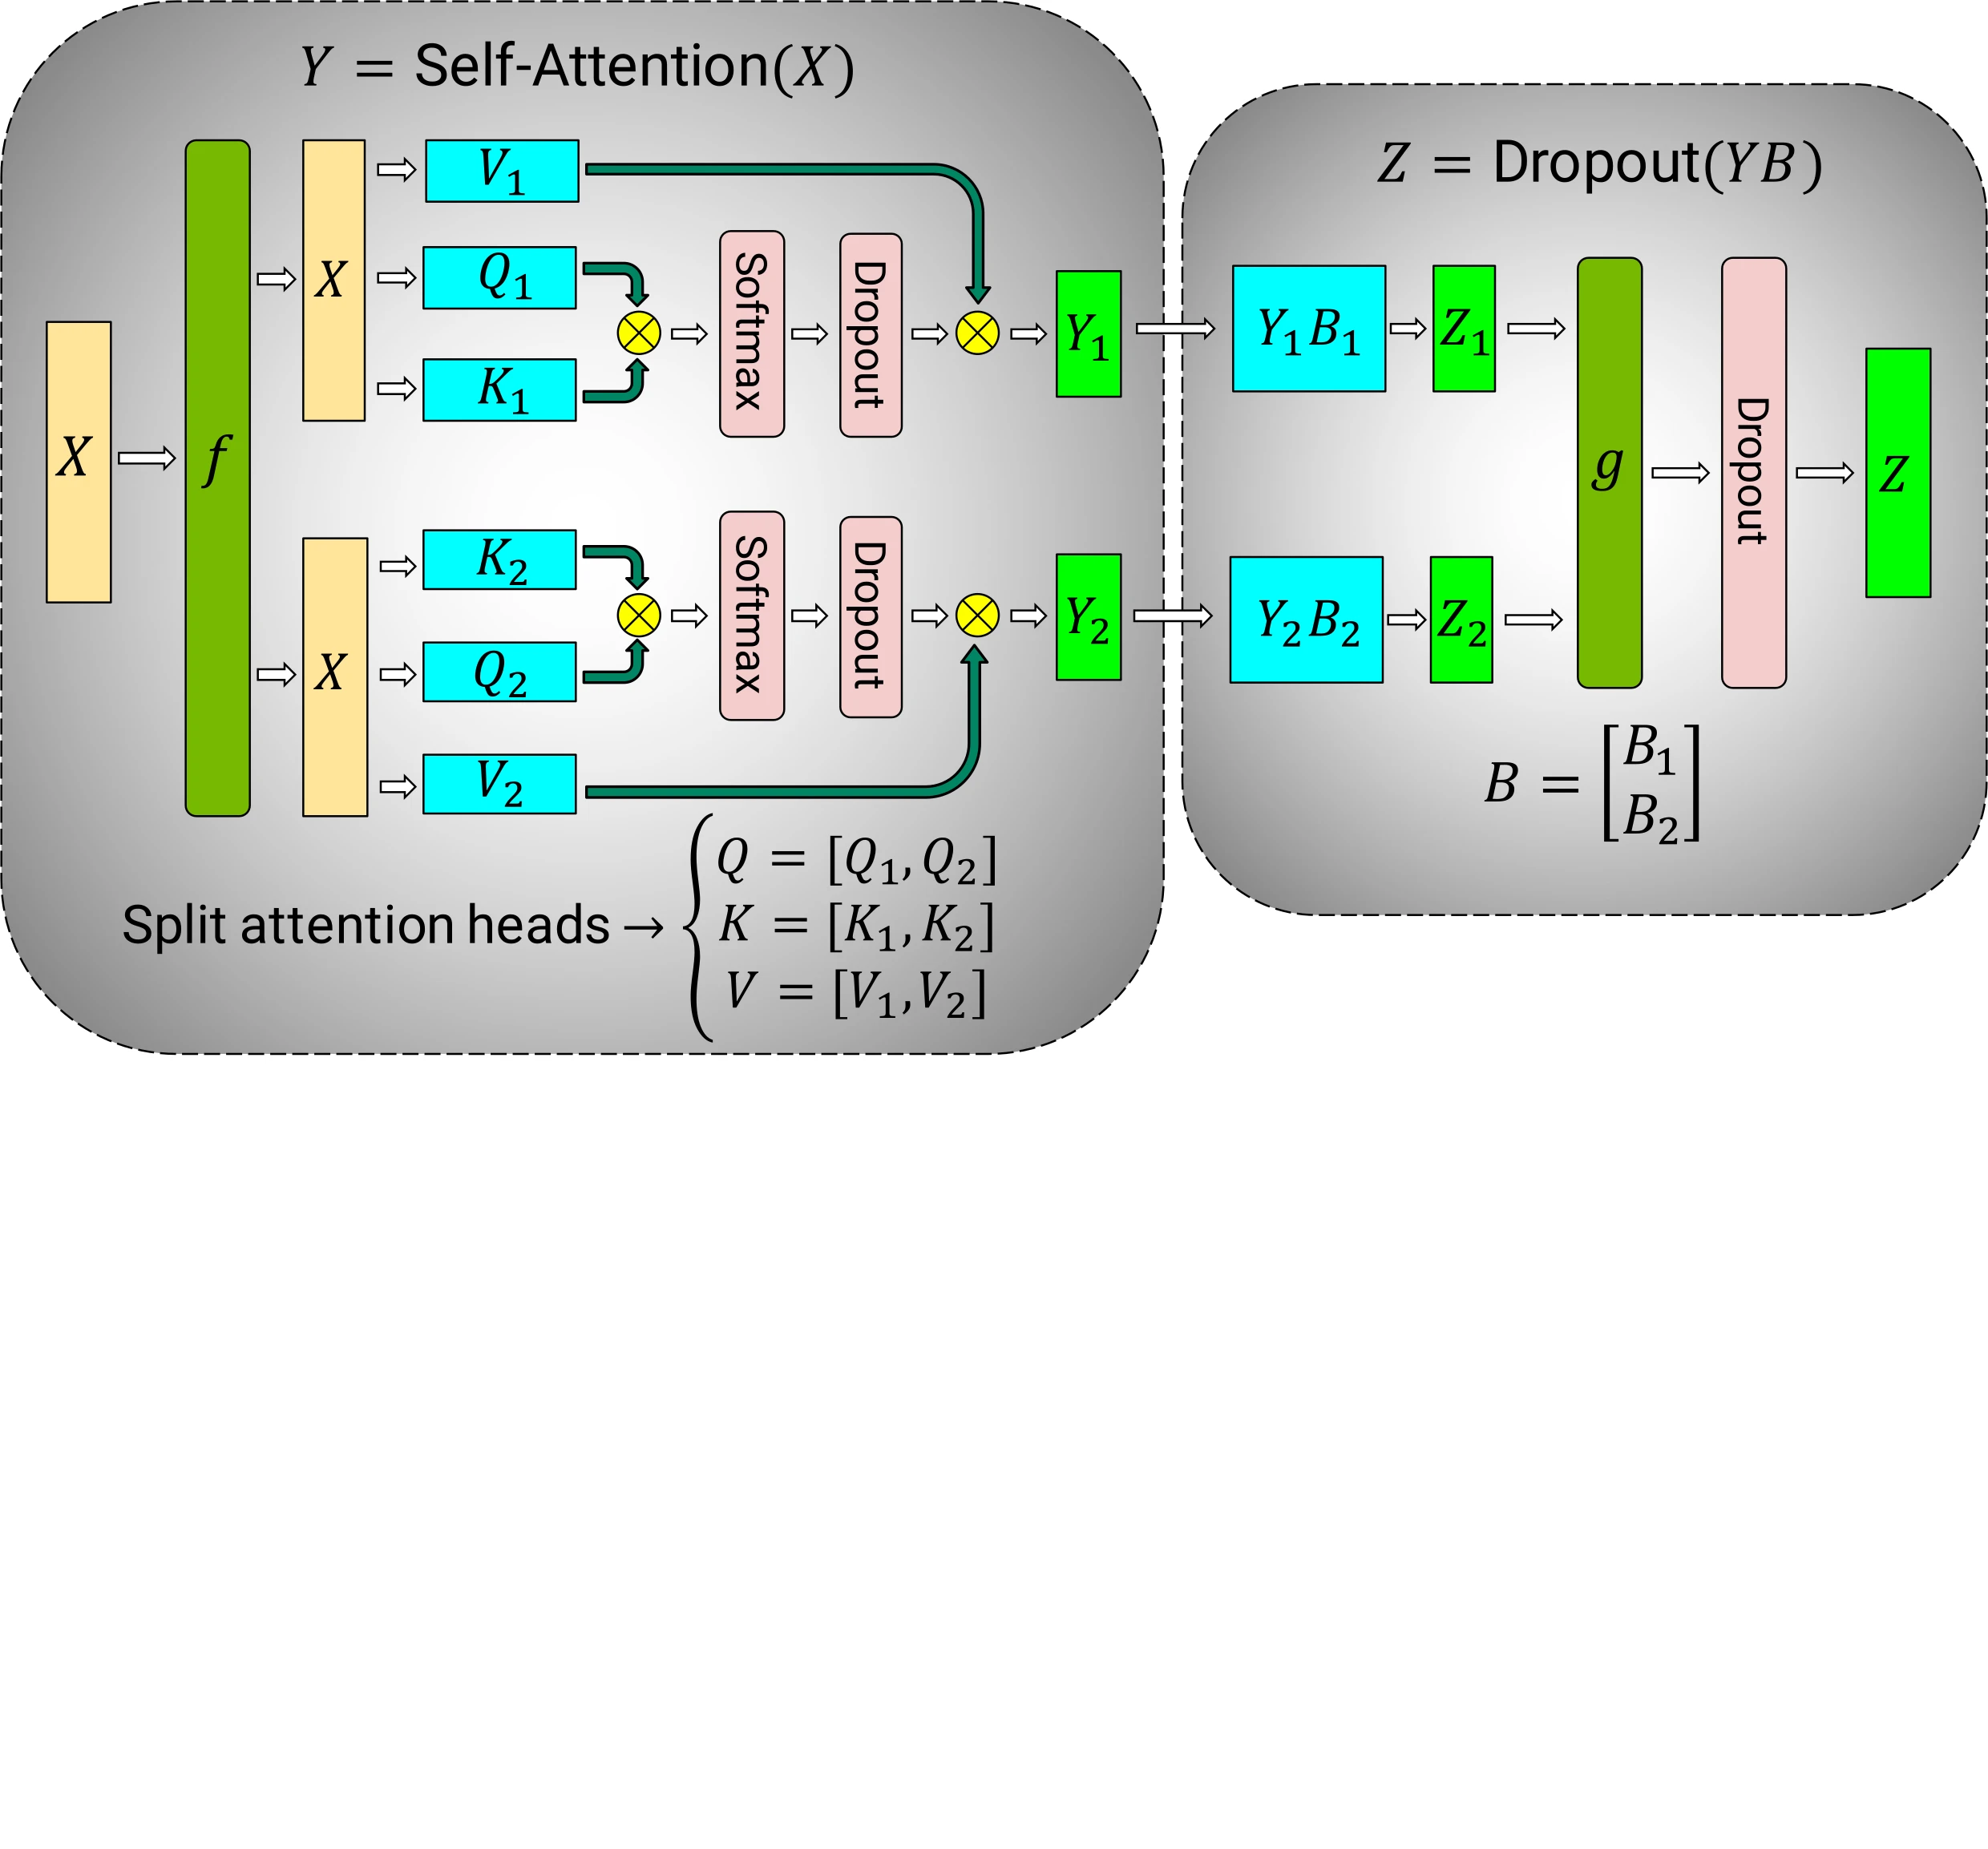
按图 6、图 7 的标注,每个子层前向一次 AllReduce、反向一次,一个 层模型的一步是 次调用。以 70B 级稠密模型为例:80 层、hidden size 8192、BF16 权重约 140 GB。TP = 8 时每卡分到约 17.5 GB 权重,单步解码先读完全部权重(这是 GPU GEMM 优化系列讨论的算力/带宽账本),再在每层出口做 2 次 AllReduce。
decode 与 prefill 的配比不同
拿 H100 单机 8 卡做一个量级核算(NVLink 单向约 450 GB/s,HBM 约 3.35 TB/s,数字用于数量级判断而非精确结论):
- batch = 1 解码:每层出口要归约的张量是 ,单步共 160 次。按 ring 计算,每 rank 传输 ,在 450 GB/s 下带宽项不到 0.1 微秒;延迟项占绝对主导,每次调用的实际开销在几微秒级,160 次合计约半毫秒到一毫秒。同时每卡读权重 17.5 GB 需要约 5 毫秒——通信占比在 10% 至 20% 之间,已经是值得优化的份额。
- batch = 32 解码:每次归约的张量变成 512 KB,带宽项约 2 微秒,与延迟项同量级;权重读取时间不变、计算量却放大 32 倍后开始进入算力区,通信与计算的相对占比发生变化。通信量随 batch 线性增长,而「读权重」的时间不变,正是中间这段 batch 区间里通信税最明显。
这两点合起来解释了推理框架为什么在 decode 路径上对通信格外挑剔:decode 的每次 AllReduce 是小消息,延迟项主导;prefill 单步处理数百上千 token,消息虽大但计算时间增长更快,通信占比反而下降。DistServe 等方案把 prefill 与 decode 拆到不同机器组,依据正是两个阶段的计算/通信配比完全不同;Sarathi-Serve 的分块 prefill 则通过把大请求切块、与 decode 混批,给通信与计算留出可重叠的节拍。
vLLM 为什么自己写一个 AllReduce
NCCL 的通用性在这里反成了开销来源:它要处理任意拓扑、任意 rank 数、任意数据类型,这套抽象本身有固定成本。vLLM 的 custom_all_reduce.cu 做了一个很说明问题的取舍——只处理最有利的那一小块场景:
- 只支持单机内 2/4/6/8 卡,且要求物理拓扑全连接、进程间能建立 P2P 映射;
- 通过 IPC 句柄把所有 rank 的输入缓冲互相映射进自己的地址空间,归约 kernel 直接跨卡读数据,不经过任何网络协议栈;
- 更大的模型(如 6/8 卡上的更大向量)或跨节点场景下,退回 NCCL。
它的两个 kernel 正对应本章的两种策略:
cross_device_reduce_1stage(one-shot):每个线程把所有 rank 对应位置的数据读来就地求和,一个 kernel 完成整个 AllReduce。每 rank 的读取量是 (要把 份数据各读一遍),但只有一次 kernel 启动、一次同步——延迟最小。cross_device_reduce_2stage(two-shot):就是 Reduce-Scatter + All-Gather 的两阶段,第一阶段各 rank 对自己负责的分片求和并写入临时缓冲,第二阶段各 rank 从所有 rank 的临时缓冲里 gather 属于自己的部分。每 rank 只读 ,带宽最优,但多一次全组同步。
派发阈值写在源码里:world_size 为 2 恒走 one-shot;全连接拓扑下,world_size ≤ 4 且消息 < 512 KB 或 world_size ≤ 8 且消息 < 256 KB 走 one-shot,否则走 two-shot。这个阈值正是 - 账本的具象:小消息时两阶段同步的延迟成本超过读满 份数据的带宽成本,one-shot 赢;大消息反之。NCCL 之所以不这么做,是因为 one-shot 要求全连接、单机、rank 数有限且输入缓冲可以被 IPC 映射——这些条件在通用场景里并不总成立。
与 MoE 的 All-to-All 对照
专家并行里 token 派发(dispatch)与回传(combine)不是「每个 rank 拿到同一份归约结果」,而是「每个 token 精确流向它被路由到的专家所在节点」——通信模式是 AllToAll,每 rank 流量与 这条公式无关,阻塞形态也不同。DeepEP 一文对它的 kernel 设计有专门拆解;DeepSeek-V3/R1 推理系统则展示了这些通信操作在实际集群里的排布方式。而 AllReduce 本身在新硬件上的压缩空间(如 FP8 传输、误差补偿)也是当前活跃的方向,例如 Echo(2026)研究的 4-bit 张量并行通信。
融合与重叠:省掉的不是算法,是同步次数
最后回到账本上那个常被忽略的项:AllReduce 前后的同步与 kernel 启动次数。一次 AllReduce 哪怕只花 10 微秒,紧随其后的一次 RMSNorm 又要再 5 微秒——单独看都可接受,累加起来就是 decode 延迟的大头。这也是为什么近年若干推理优化工作都围绕「把归约和它前后的计算粘在一起」:TokenWeave 把 AllReduce 与 RMSNorm 融合成一个 kernel、并用粗粒度 token 切分让通信不挡住计算;vLLM 与 NCCL 的多通道机制本质上也是在为这个重叠创造条件。省掉 1 次同步的价值,不亚于把带宽项再降一半。
小结
把这一篇的账本浓缩成几行:
- AllReduce = Reduce-Scatter + All-Gather。两个半步各 的传输量是所有算法共同的下界,差异只在拓扑怎么走;
- Ring 带宽最优()但延迟线性();递归倍增/双树延迟对数()但带宽带 因子;Rabenseifner 用两个折半半步在 为 2 幂时同时拿下两者;NVLS/CollNet 把归约搬进交换机,直接把 压到接近 1;
- 大小消息的分界不是经验,是 - 账本上两项的交点。NCCL 的自动选择、vLLM one-shot/two-shot 的 512 KB/256 KB 阈值、协议与硬件绑定关系,全是这个模型的具象化。
下次 profile 里 AllReduce 占了大头时,先回答三个问题:消息多大?是单机 NVLink 还是跨节点?当前算法与协议是什么?答案基本就能定位到该调 NCCL_ALGO、该切分重叠加,还是该换个并行方案。
参考资料
- NCCL User Guide: Collective Operations —— NVIDIA 官方集合通信原语定义与图示
- NCCL User Guide: Environment Variables ——
NCCL_ALGO、NCCL_PROTO等可选项的官方定义 - Bringing HPC Techniques to Deep Learning(Horovod,arXiv:1802.05799) —— 把 ring-allreduce 带进深度学习训练的经典论文
- Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM(arXiv:2104.04473) —— 张量并行切分与 AllReduce 共轭算子标注的出典
- Bandwidth Optimal All-Reduce Algorithms for Clusters of Workstations(Patarasuk & Yuan,JPDC 2009) —— ring 算法带宽最优性的系统化证明
- Optimization of Collective Communication Operations in MPICH(Thakur, Rabenseifner & Traeff,IJHPCA 2005) —— 各集合通信算法的统一代价表与实现对比
- NCCL GitHub 仓库 —— NCCL 源码与 algorithm/protocol 实现
- vLLM custom_all_reduce.cuh —— one-shot/two-shot kernel 与派发阈值的源码
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



