


vLLM 源码完全拆解(三十七):MLA 注意力后端——矩阵吸收之后,576 维 latent KV 如何被四种内核读走
MLA(Multi-head Latent Attention)的论文公式并不复杂:把每个 token 的 K/V 压成一个 latent 向量,再把投影矩阵吸收进 query 和输出。真正难的是把它做成一个能服务动态 batch、支持分块预填、支持投机解码、还要在 FP8 下跑得快的推理后端。vLLM 的 MLA 实现跨了三个层次:模型层的 MultiHeadLatentAttentionWrapper、注意力层 MLAAttention,以及 vllm/v1/attention/backends/mla/ 下的一组专用后端。本文沿着一次请求的路径,把这三层拆开,重点回答四个问题:
- latent KV 在显存里究竟长什么样,为什么 head 数被写成 1;
- 矩阵吸收具体发生在哪些张量上,为什么 decode 能变成 MQA;
- prefill 为什么又要退回 MHA,分块上下文如何避免显存爆炸;
- FlashMLA、Cutlass MLA、Triton MLA 这几种后端,面对同一份 576 维缓存各自做了什么取舍。
从模型层看:MLA 交给注意力的只有三样东西
普通的 Attention 层接收 q、k、v 三个张量,形状都是 [tokens, heads, head_dim]。MLA 不是。模型层先做完低秩投影和 RoPE,只把下面三样东西交给 MLAAttention:
q:形状[tokens, num_heads, qk_nope_head_dim + qk_rope_head_dim],其中后半段已经过 RoPE;kv_c_normed:形状[tokens, kv_lora_rank],是压缩后的 KV latent,已经过 RMSNorm;k_pe:形状[tokens, 1, qk_rope_head_dim],是共享的单头 RoPE key。
这三样东西来自 vllm/model_executor/layers/mla.py 的 MultiHeadLatentAttentionWrapper.forward。以 DeepSeek-V3 的配置为例,qk_nope_head_dim=128、qk_rope_head_dim=64、v_head_dim=128、kv_lora_rank=512、q_lora_rank=1536,q 的最后一维是 192,而 KV 侧只留下 512 + 64 = 576 个元素。也就是说,每个 token、每一层,MLA 写进缓存的不是一个 [128, 256] 的 K/V 矩阵,而是一条 576 维的向量:前 512 维是 latent,后 64 维是 RoPE key。
模型层实际做的事情可以压缩成几行伪代码:
qkv_lora = fused_qkv_a_proj(hidden_states)[0]q_c, kv_lora = qkv_lora.split([q_lora_rank, kv_lora_rank + qk_rope_head_dim], dim=-1)q_c = q_a_layernorm(q_c)kv_c, k_pe = kv_lora.split([kv_lora_rank, qk_rope_head_dim], dim=-1)kv_c_normed = kv_a_layernorm(kv_c)k_pe = k_pe.unsqueeze(1)
q = q_b_proj(q_c)[0].view(-1, num_heads, qk_head_dim)q[..., qk_nope_head_dim:], k_pe = rotary_emb(positions, q[..., qk_nope_head_dim:], k_pe)注意两个细节。第一,RoPE 只作用在 query 的尾部 64 维和共享的 k_pe 上,latent kv_c_normed 本身不带位置信息,这正是“解耦 RoPE”的含义。第二,k_pe 被显式加了一个 head 维,变成 [tokens, 1, 64],因为它在缓存里只有一个头,后面做 MQA 时直接广播到所有 query head。
在 MLA 中,K 的 NoPE 部分和 V 都不是独立存储的,它们都由同一个 kv_c_normed 经 kv_b_proj 上投影得到。缓存里只存“原料”,不存“成品”。这是后面所有设计的前提。
缓存的形状:576 个元素、一个 KV 头,以及被隐藏的 V
MLAAttention.__init__ 里有两行不起眼但决定全局的赋值:
self.head_size = kv_lora_rank + qk_rope_head_dimself.num_kv_heads = 1第一行让 head_size 等于 576(DeepSeek-V3),第二行让缓存只有一个 KV 头。于是 vLLM 在构造 MLAAttentionSpec 时,num_kv_heads=1、head_size=576、head_size_v=0。head_size_v=0 是一个很直观的信号:MLA 的缓存里没有单独的 V,V 和 K 的 NoPE 部分共用同一段 latent。
这件事对显存账本的影响可以直接算出来。BF16 下每个 token、每层 576 × 2 = 1152 字节;FP8 下 576 字节,另外 vLLM 在 MLACommonBackend.customize_spec 里按 per-token-head 追加两枚 FP32 scale(K 与 V 各一枚),所以一条 FP8 MLA 状态的实际行宽是 576 + 8 = 584 字节。对比同样 128 个 head、192 维 QK、128 维 V 的普通 MHA,BF16 下每 token 每层需要 128 × (192 + 128) × 2 = 81920 字节。两者相差 71 倍。MLA 不是“少存一点”,而是把 KV 从按 head 展开的矩阵换成了按 token 的一条向量。
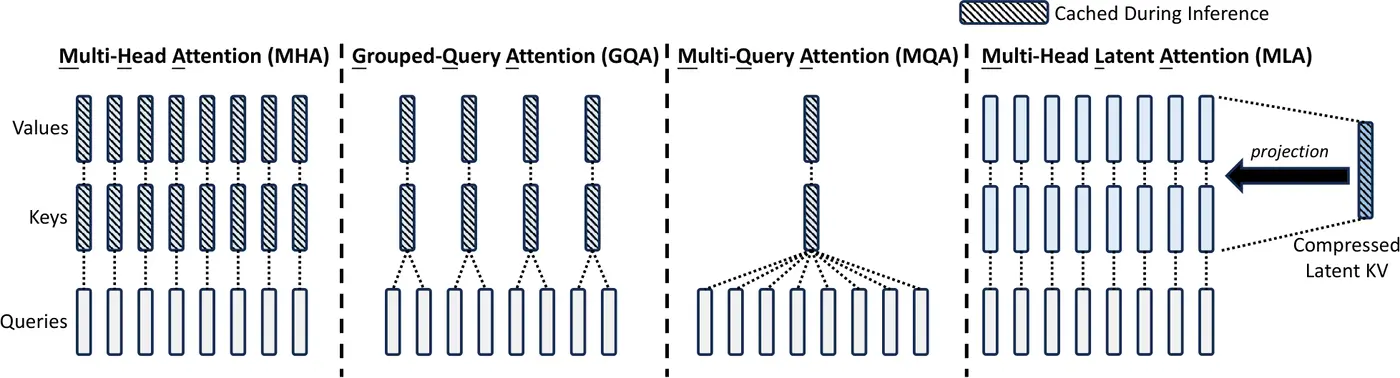
这张图来自 DeepSeek-V2 论文,左边是 KV 的低秩压缩路径,右边是推理时的矩阵吸收形态。看图时抓住两点:c_KV 是缓存里真正保存的 latent;W_UK 和 W_UV 在训练时是 kv_b_proj 的一部分,在推理时可以被乘到 query 与输出上,从而不再需要每个 token 都上投影出完整的 K/V。
缓存页大小也是 MLA 后端的一个硬约束。FlashMLA 只接受 64 token 一块的页,因此 FlashMLABackend.get_supported_kernel_block_sizes() 直接返回 [64];Triton MLA 和 Cutlass MLA 的约束更松,但 vLLM 在选择后端时会把页大小作为能力匹配的一部分。页大小的取舍与普通注意力并不完全相同:MLA 每 token 的数据量小,页太小会让块表变长、索引开销上升;页太大又会在短序列上浪费。关于 128 与 64 的通用账本,可参考 KV Cache 的页粒度:128 token 一块的账,以及五个推理框架为什么选了五个不同答案。
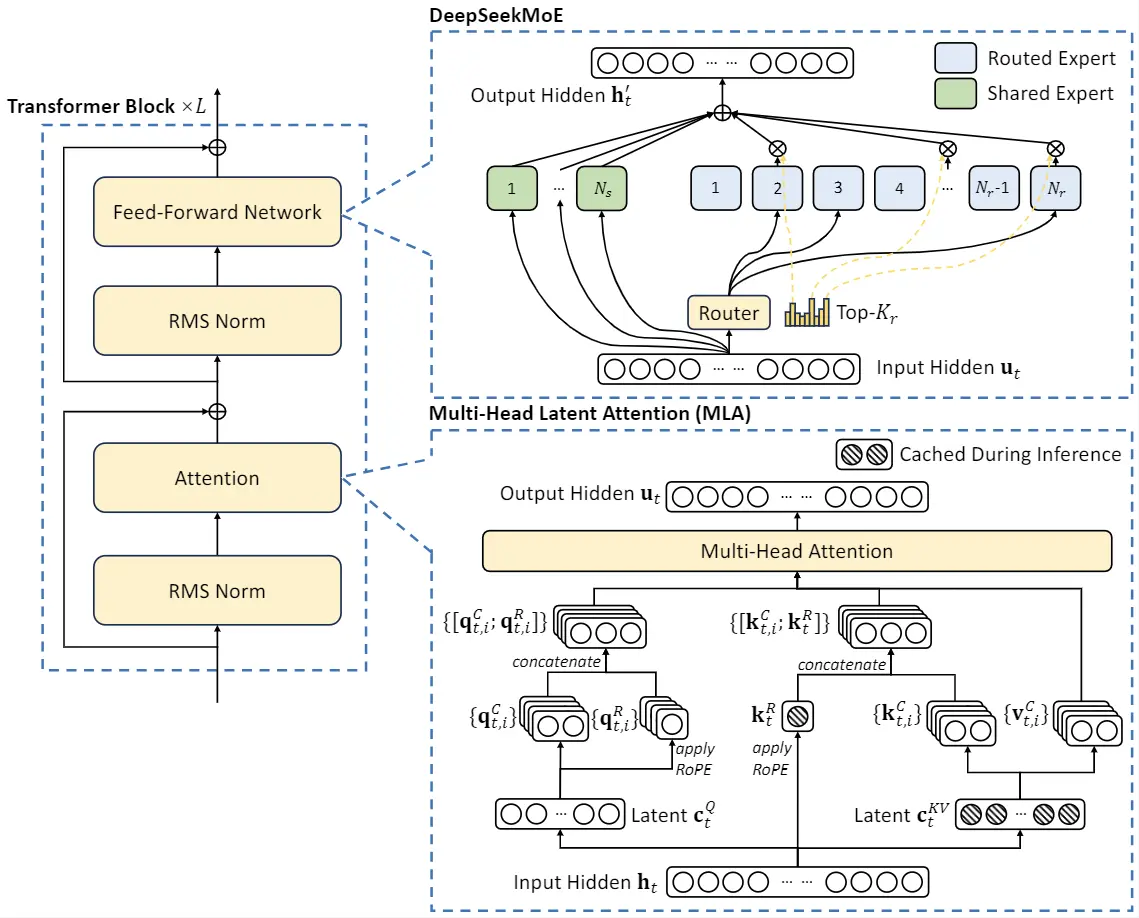
第二张图是 DeepSeek-V2 的整体架构。MLA 位于每个 Transformer block 的注意力位置,但它和 MoE 的 FFN 是两条独立的稀疏轴:MLA 压缩的是 KV 的状态维度,MoE 稀疏的是 FFN 的专家。读 vLLM 源码时不要把两者混在一起:MLA 后端只关心注意力缓存与内核,MoE 的 dispatch/combine 属于另一条执行路径。
权重准备:把 kv_b_proj 拆成 W_UK 与 W_UV
MLA 的 kv_b_proj 是一个 ColumnParallelLinear,输入 512 维 latent,输出 num_heads * (qk_nope_head_dim + v_head_dim)。在 DeepSeek-V3 里就是 128 × (128 + 128) = 32768。它同时承担两个角色:把 latent 变成每个 head 的 K NoPE,以及把同一个 latent 变成每个 head 的 V。权重加载完成后,MLAAttention.process_weights_after_loading 会调用 split_kv_b_proj 把它拆开。
split_kv_b_proj 的逻辑不长,但三个张量形状值得记住:
weight = get_and_maybe_dequant_weights(kv_b_proj, out_dtype=out_dtype).T# [kv_lora_rank, num_heads * (qk_nope_head_dim + v_head_dim)]weight = weight.view(kv_lora_rank, num_heads, qk_nope_head_dim + v_head_dim)return weight.split([qk_nope_head_dim, v_head_dim], dim=-1)返回的 W_UK 形状是 [L, N, P],W_UV 形状是 [L, N, V],其中 L=kv_lora_rank、N=num_heads、P=qk_nope_head_dim、V=v_head_dim。随后 MLAAttention 把它们换成两个更适合做批量矩阵乘的布局:
# W_UV: [L, N, V] -> [N, L, V]self.W_UV = W_UV.transpose(0, 1)# W_UK: [L, N, P] -> [N, P, L]self.W_UK_T = W_UK.permute(1, 2, 0)为什么要转置成 W_UK_T?因为 decode 阶段要对每个 head 做 q_nope[n, b, P] @ W_UK_T[n, P, L],把 query 从 128 维的 NoPE 空间吸收到 512 维的 latent 空间。torch.bmm 要求 batch 维在最前面,转成 [N, P, L] 之后,一次 batched GEMM 就能同时处理所有 head。W_UV 则是反过来,把注意力输出 [N, B, L] 乘成 [N, B, V],再 transpose 回 token-major。两个转置看起来只是内存布局,实际是把“按 head 一次算完”变成了可能。
这里还有一层工程考虑:如果 kv_b_proj 是量化权重,split_kv_b_proj 会先 get_and_maybe_dequant_weights,把权重反量化到 act_dtype 再拆分。也就是说,MLA 的这两个吸收矩阵目前是按激活精度保存的,而不是继续沿用 kv_b_proj 的量化格式。ROCm 路径上额外提供了 aiter 的 FP8/FP4 BMM,可以把吸收矩阵重新量化后直接走低精度 batched GEMM;CUDA 路径则主要使用 BF16 的 torch.bmm。这条差异在多卡大规模部署时会直接影响 decode 的算力开销,后文还会展开。
还有一组“可选布局”是 DCP(decode context parallel)专用的。启用 query replication 时,W_UK_T 会沿 head 维 all_gather 成 W_UK_T_dcp_qrep,让每个 rank 都能为完整的 query head 集合完成吸收。这段代码只在 dcp_world_size > 1 时生效,普通单卡阅读可以先跳过。
两套算法:prefill 走 MHA,decode 走 MQA
mla_attention.py 文件开头有一段很长的注释,几乎就是一份设计文档。它把 MLA 的两种计算方式命名为 compute-friendly 与 data-movement friendly:
- compute-friendly:先把 latent 上投影成完整的 K/V,再做标准 MHA。
Sq / Skv接近 1,计算密集,适合 prefill。 - data-movement friendly:把
W_UK吸收进 query,把W_UV吸收进输出,缓存只读 latent,注意力退化成 MQA。Sq / Skv接近 0,访存密集,适合 decode。
这两条路径的数学形式必须自己推一遍,否则很容易在源码里迷路。先看 compute-friendly:
这里 k_nope 和 v 是把缓存里的全部 latent 重新上投影得到的,形状分别是 [Skv, N, P] 和 [Skv, N, V]。只要 Skv 变大,这两个张量就会线性膨胀,这正是 prefill 长上下文时的显存风险。
再看 data-movement friendly:
第一行把 query 从 P=128 维投到 L=512 维;第二行的 K 直接就是缓存里的 kv_c 加 k_pe,V 直接就是 kv_c;第三行把输出从 L=512 投回 V=128 再乘 W_O。整个 decode 过程不再需要为每个 token 生成 k_nope 和 v,缓存读取量因此从 128 × 256 个元素降到 576 个元素。
但这里有一个非常容易被忽略的细节:吸收之后,QK 的点积维度从 P+R=192 变成了 L+R=576,softmax 的缩放系数却仍然是 1/sqrt(192)。 原因是吸收前后的点积在数学上相等:
两边是同一个标量,所以 softmax 的数值尺度不能跟着维度改成 576。vLLM 在 MLAAttention 里保存的 self.scale 来自模型层的 qk_head_dim ** -0.5,传给 FlashMLA 时也是这个值。第一次读源码时如果只看 head_size=576,很容易误以为 scale 是 576 ** -0.5,那会让所有 logits 缩小 1.73 倍,注意力分布完全变平。
forward_impl 就是这两条路径的分流器。它先根据 attn_metadata.num_decode_tokens 把 batch 切成 MHA 段和 MQA 段,再分别调用 impl.forward_mha 与 impl.forward_mqa:
num_mqa_tokens = attn_metadata.num_decode_tokensnum_mha_tokens = q.size(0) - num_mqa_tokensif num_mha_tokens > 0: self.impl.forward_mha(q[num_mqa_tokens:], ...)if num_mqa_tokens > 0: mqa_q_nope, mqa_q_pe = mqa_q.split([qk_nope_head_dim, qk_rope_head_dim], dim=-1) mqa_q_nope = mqa_q_nope.transpose(0, 1) mqa_ql_nope = torch.bmm(mqa_q_nope, self.W_UK_T, out=...) ... attn_out, lse = self.impl.forward_mqa(mqa_q, kv_cache, attn_metadata, self) self._v_up_proj(attn_out, out=mqa_output_slice)这段代码有两个顺序上的约定。第一,batch 已经被重排过,decode 行在前、prefill 行在后;所以 MHA 段取 q[num_mqa_tokens:],MQA 段取 q[:num_mqa_tokens]。第二,query 的吸收在进入后端之前完成,后端的 forward_mqa 只负责“拿吸收后的 query 去读 latent 缓存”;输出的 W_UV 上投影则在 _v_up_proj 里完成,后端返回的是 512 维的 latent 输出,不是 128 维的 V。
_v_up_proj 同样是一个按 head 的 batched GEMM:
x = x.view(-1, num_heads, kv_lora_rank).transpose(0, 1) # [N, B, L]out = out.view(-1, num_heads, v_head_dim) # [B, N, V]torch.bmm(x, self.W_UV, out=out.transpose(0, 1)) # [N, B, V] -> [B, N, V]注意 out 的内存是 token-major,而 bmm 的输出要求 head-major,所以这里用了 out.transpose(0, 1) 作为写入视图。转置视图不复制数据,bmm 直接按 head 维写回 token-major 的 buffer。这种“输入转置、输出转置”的写法在 MLA 里反复出现,目的是让每个 head 的 GEMM 连续,同时保持最终输出对上层是 [tokens, N*V]。
回到两条路径的成本对比。prefill 的 compute-friendly 路径需要为所有历史 token 生成 k_nope 和 v,计算量是 Skv × N × (P+V) × L 级别的矩阵乘;decode 的 data-movement 路径只需要对当前 query 做吸收,计算量是 Sq × N × P × L,而缓存读取是 Skv × 576。当 Sq=1、Skv=100k 时,前者要为 10 万个 token 做上投影,后者只读 10 万条 576 维向量。选择哪条路径不是风格问题,而是把计算放在 query 侧还是 KV 侧的问题。
正因如此,vLLM 没有把 MLA 塞进普通 Attention 层,而是单独实现了 MLAAttention:它需要同时持有两套算法、两套权重布局,还要根据 batch 的组成在运行时切换。下一节看 prefill 侧的细节,尤其是分块上下文如何把“上投影整个历史”这件昂贵的事拆成可控的 workspace。
Prefill:一次上投影、分块上下文与两段 LSE 合并
prefill 段的入口是 MLACommonBaseImpl.forward_mha。它先处理“本次新增的 token”,再处理“已经存在于缓存里的上下文”,最后把两段注意力结果合并。
先看新增 token 这一段:
kv_nope = self.kv_b_proj(kv_c_normed)[0].view( -1, num_heads, qk_nope_head_dim + v_head_dim)k_nope, v = kv_nope.split([qk_nope_head_dim, v_head_dim], dim=-1)k = self._concat_k_nope_k_pe(k_nope, k_pe)output_prefill = prefill_metadata.prefill_backend.run_prefill_new_tokens( q=q, k=k, v=v, return_softmax_lse=has_context, ...)kv_b_proj 的输出是 [Sq, N, P+V],split 之后 k_nope 是 [Sq, N, P],v 是 [Sq, N, V]。_concat_k_nope_k_pe 把 k_pe 从 [Sq, 1, R] 广播到 [Sq, N, R] 再拼到 k_nope 后面,得到 [Sq, N, P+R]。注意这里并没有把 k_pe 拼进 v;V 的维度仍然是 V,不是 V+R。这一点在写自定义内核时经常出错:K 的最后一维是 192,V 的最后一维仍然是 128。
run_prefill_new_tokens 是 MLAPrefillBackend 的接口,不是某个固定内核。vLLM 在 prefill 侧支持 FlashAttention、FlashInfer、TRT-LLM Ragged 等实现;MLA 层只负责把 q/k/v 准备成标准 MHA 的形状,具体用哪个内核由 get_mla_prefill_backend 根据平台和配置决定。这是 vLLM 在 MLA 上的一种“分层解耦”:decode 用专用 MLA 后端,prefill 则尽量复用成熟的 MHA 内核。
接着是上下文段。如果 chunked_context 不为空,说明本次 prefill 有历史 KV 需要参与注意力。forward_mha 会调用 _compute_prefill_context,后者按 chunk 循环:
for chunk in chunked_context.chunks: gather cache chunk -> workspace kv_c_normed = workspace[:toks][..., :kv_lora_rank] k_pe = workspace[:toks][..., kv_lora_rank:].unsqueeze(1) kv_nope = self.kv_b_proj(kv_c_normed)[0].view(-1, num_heads, P + V) k_nope, v = kv_nope.split([P, V], dim=-1) k = concat(k_nope, k_pe) attn_output, attn_lse = prefill_backend.run_prefill_context_chunk(...) accumulate_mla_context_chunk(...)这段循环做了三件事,每一件都对应一个工程问题。
第一,从分页缓存里 gather 到连续 workspace。kv_c_and_k_pe_cache 是按块表分页存储的,kv_b_proj 需要连续的行才能做 GEMM。ops.gather_and_maybe_dequant_cache 按 block_table、cu_seq_lens、token_to_seq 把需要的上下文行收集到 chunked_context.workspace。如果缓存是 fp8_ds_mla 或 nvfp4_ds_mla 的打包格式,则走 cp_gather_and_upconvert_*,在 gather 的同时把量化数据上转成 BF16;如果 prefill query 本身是 FP8,则走 cp_gather_cache,只搬运不反量化,让后面的 MHA 内核直接吃 FP8。
第二,按 workspace 预算切 chunk。如果一次把 10 万 token 的上下文全部上投影成 k_nope 和 v,中间张量会是 GB 级。build_mla_chunked_context_metadata 先算出每个 prefill 请求的 context 长度,再用 plan_mla_context_chunks 把上下文打包成若干行数不超过 row_budget 的 chunk。单个请求如果超出预算,会按 block_size 对齐切分;chunk 的起始位置必须落在块边界上,因为 gather_and_maybe_dequant_cache 不支持非对齐的 chunk 起点。这就是源码里 align_chunk_to_block=True 的来源。
workspace 的行数由 determine_chunked_prefill_workspace_size 决定:
其中 L_max 是模型最大上下文长度,B_seq 是最大并发序列数,P_block 是页大小。前两项的直觉是“至少能放下 8 条满长请求,或者每个请求至少 4 页”;上限 64k token 是为了不让 workspace 反过来挤占 KV 缓存。按 576 维、BF16 计算,64k 行的 gather workspace 是 72 MiB 量级,源码注释按更宽的口径写作 100 MB 级;真正占显存的是上投影后的 k_nope 与 v,它们按 N × (P+V) 展开,在 128 个 head 的 DeepSeek-V3 上是 GB 级。所以 chunk 的存在不是为了省 gather 的带宽,而是为了限制上投影张量的峰值。
第三,合并多段注意力。每个 chunk 都只看到上下文的一个切片,算出的 attn_output 和 attn_lse 只是部分结果;新增 token 段也只看到自己。最终要把“上下文各 chunk”与“新增 token”两段按 softmax 的权重合并,靠的是 merge_attn_states:
merge_attn_states( output=output.view(-1, num_heads, v_head_dim), prefix_output=context_output, prefix_lse=context_lse, suffix_output=suffix_output, suffix_lse=suffix_lse,)这是一个标准的 online softmax 合并:对每个 head、每个 query 行,把两段的部分输出按 exp(lse - max_lse) 重新加权。它要求两段的输出布局一致,所以 init_mla_context_partial 会按照 chunk partial 的形状分配 running buffer,neutralize_empty_context_partials 则把“没有上下文的 prefill 行”写成 output=0、lse=-inf,保证它们在最终合并里权重为零。accumulate_mla_context_chunk 处理 chunk 之间的合并,并且有一个容易忽略的边界:只有 chunk 的第一个请求可能是续接 chunk,续接 chunk 的头部 token 要与已有 partial 合并,其余 token 直接覆盖。
这套设计让 MLA prefill 的显存峰值与上下文长度解耦:无论请求有 8k 还是 128k 上下文,同一时刻只有 W 行 latent 被上投影。代价是多次 gather、多次 GEMM 和一次 LSE 合并;当上下文很长时,这些额外开销仍然比“一次性上投影爆显存”便宜。
还有一个优化分支是 masked MHA。对于稀疏 MLA(例如 DSA)的 prefill,vLLM 可以在满足条件时直接把稀疏 top-k 掩码交给 dense MHA 内核,而不是走 token 级的 MQA 路径。_use_masked_mha 用一张按 (qk_head_dim, v_head_dim)、后端名称和 TP size 索引的阈值表来决定:序列长度和 query 长度落在哪个区间时,masked MHA 更划算。阈值表里能看到 (2048, 1536)、(4096, 4096) 这类成对数字,含义是“当 max_seq_len <= 2048 且 max_query_len >= 1536 时走 masked MHA”。这不是一个通用规则,而是按内核实测出来的经验边界;也提醒读者,MLA 的 prefill 路径并不是“永远用 MHA”,而是一个按 batch 形状切换的策略集合。稀疏注意力的背景可参考 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现。
Metadata:一个 batch 如何被切成 decode 与 prefill 两半
MLA 的 metadata 比普通注意力多了一层“批次分栏”。MLACommonMetadata 里除了常见的 query_start_loc、slot_mapping、seq_lens,还有四个字段:
num_decodes: intnum_decode_tokens: intnum_prefills: intmax_seq_len: int以及两个子结构:prefill: MLACommonPrefillMetadata 和 decode: MLACommonDecodeMetadata。这套设计的核心是把一个混合 batch 明确分成两段:前 num_decodes 条请求走 MQA,后 num_prefills 条请求走 MHA,num_decode_tokens 是 MQA 段的 token 数。
分栏发生在 MLACommonMetadataBuilder.build 里,靠的是 split_decodes_and_prefills:
num_decodes, num_prefills, num_decode_tokens, num_prefill_tokens = \ split_decodes_and_prefills( common_attn_metadata, decode_threshold=self.reorder_batch_threshold, require_uniform=(self.query_len_support != QueryLenSupport.VARLEN), treat_short_extends_as_decodes=not self.use_pcp, )reorder_batch_threshold 是分栏的判据:query 长度小于等于它的请求被当成 decode,大于它的被当成 prefill。这个阈值不是固定的 1。FlashMLA 的 builder 把它设成 128,注释里写着“process small prefills with decode pathway”;也就是说,一个 128 token 的短 extend 会被送进 decode 的 MQA 内核,而不是走 prefill 的 MHA。为什么?因为 MQA 路径只读 latent、不生成完整的 k_nope 和 v,对短 query 来说更省。阈值是按后端内核的特性调的,不是语义上的“prefill/decode”。
分栏之后,两个子结构各自构造 metadata:
MLACommonPrefillMetadata持有block_table、query_start_loc、max_query_len、chunked_context、q_data_type、output_dtype与prefill_backend。其中chunked_context由build_mla_chunked_context_metadata生成,里面包含 workspace、每个 chunk 的请求切片、token 切片、上下文长度与cu_seq_lens。MLACommonDecodeMetadata至少持有block_table、seq_lens,具体后端会派生出自己的子类,例如FlashMLADecodeMetadata多一个scheduler_metadata,CutlassMLAMetadata则直接用 common 结构。
这里有两个性能上的“不要同步”约定。第一,prefill 的 context_lens 用 seq_lens_cpu_upper_bound 在 CPU 上算,避免为了拿精确长度做一次 GPU→CPU 同步;第二,decode 的 max_seq_len 在 DCP 下按 ceil(L / (N * I)) * I 重算,既保证每个 rank 的 workspace 够用,又不做同步。这些细节在普通单卡上感知不到,但在 TP/DP/DCP 组合的生产部署里,任何一次同步都会把调度器的流水打断。
QueryLenSupport 则决定了 decode 内核能接受什么样的 query 长度:
SINGLE_ONLY:只接受单 token query;UNIFORM:接受多 token query,但同一批里所有请求的 query 长度必须一致;VARLEN:接受变长 query,投机解码的验证批可以混合 1、2、3 个 token。
FlashMLA 声明的是 UNIFORM,Triton MLA 在注释里说明它会把 uniform 的多 token 块压成每条请求 query_len 行 decode;这直接决定了投机解码时 batch 的排布方式。reorder_batch_threshold 会随着 query_len_support 自动抬高,保证多 token 的 decode 行不会被误判成 prefill。关于投机解码在 vLLM 里的整体流水,可参考 vLLM 源码完全拆解(十):投机解码——草稿模型、批量验证与 token 接受流水线。
写缓存:latent 与 k_pe 在同一个 kernel 里落盘
MLA 的缓存写入发生在注意力计算之前。MLAAttention.forward 开头先调用 update_kv_cache:
self.prepare_kv_cache_update(attn_metadata)self.update_kv_cache( kv_c_normed, k_pe, self_kv_cache, layer_slot_mapping, attn_metadata, self.kv_cache_dtype, self._k_scale,)update_kv_cache 本身只做分发:如果启用 PCP,先用 maybe_gather_mla_latent_cache_inputs 把按 rank 切分的 latent 与 k_pe 收拢成完整行;如果有 HiSparse 缓存,用 cache.write_target 改写目标与行数;最后统一交给后端实现 impl.do_kv_cache_update。注意传入的最后一个布尔参数:
kv_cache_dtype in ("fp8", "fp8_e4m3", "fp8_e5m2") and self._k_scale_float == 1.0它的含义是“FP8 缓存且 scale 恰好为 1 时,写入可以省掉缩放”。这是一种快速路径判断,而不是跳过量化:do_kv_cache_update 仍然会把 BF16 的 latent 与 k_pe 转成 FP8 写进对应 slot,只是省掉乘以 scale 的那一步。对于 fp8_ds_mla、nvfp4_ds_mla 这类打包格式,写入逻辑更复杂:NoPE、RoPE 与 scale 被打包进一条固定宽度的行(V4.1 是 528 字节,FP4 是 288 字节),内核必须按这种“不透明行”格式写入,而不能当成普通的 576 维 BF16 向量。
slot_mapping 是写入的位置表:每个 token 对应一个目标 slot,由块管理器根据物理块与页内偏移算出。MLA 的 slot 映射与普通注意力的区别不在于格式,而在于每层只有一条 576 维行可写;因此同一个 token 在不同层的缓存分别是独立的一段 576 维空间,而不是 128 个 head 各一段。
在 torch.compile 路径上,写缓存与注意力计算是两个自定义算子:
kv_cache_dummy_dep = torch.ops.vllm.unified_mla_kv_cache_update(...)torch.ops.vllm.unified_mla_attention_with_output( q, kv_c_normed, k_pe, output, encoded, kv_cache_dummy_dep=kv_cache_dummy_dep, ...)unified_mla_kv_cache_update 返回一个空的 dummy 张量,唯一作用是让注意力算子把它当输入,从而在编译后的图里建立“先写后读”的数据依赖。如果只靠 side effect,Dynamo/Inductor 可能把两个算子重排;一旦重排,注意力就会读到尚未写入的 slot。这种“用 dummy 依赖表达顺序”的手法在 vLLM 的编译路径里很常见,读源码时不要把它误当成一个真实的数据传递。
多卡:DCP、PCP 与一份 LSE 的额外账
MLA 的 decode 本质上是 MQA:所有 query head 共享一份 KV。这个结构让它在数据并行和上下文并行上有一些不同于普通 MHA 的切法。
DCP(decode context parallel)把一条序列的 KV 按 token 维切到多个 rank 上,每个 rank 只读自己那一段,算出一份部分注意力输出与 LSE,最后跨 rank 合并。MLACommonMetadataBuilder.build 在 DCP 下会把 seq_lens 换成本 rank 的 dcp_local_seq_lens,同时保留 dcp_tot_seq_lens 给合并阶段用;max_seq_len 则按 ceil(L / (N * I)) * I 重新估算,避免每个 rank 按全局长度分配 workspace。
合并由 MLADCPManager.combine 完成:
attn_out = self.dcp_manager.combine( attn_out, lse, seq_lens=seq_lens, query_start_loc=query_start_loc)它需要 lse,所以 DCP 下的 MLA 后端必须返回 LSE。这也是 FlashMLAImpl.can_return_lse_for_decode = True、TritonMLAImpl 显式返回 lse 的原因。普通 MHA 的 FlashAttention 可以不返回 LSE;MLA 在 DCP 下没有这个选择。CutlassMLAImpl 则通过 need_to_return_lse_for_decode 控制是否分配 LSE buffer,只有 DCP 需要时才付这份显存。
DCP 下还有一个 query 侧的选择:dcp_q_replicate。启用后,q_b_proj 会换成 DCPGroupColumnParallelLinear,每个 rank 都持有完整的 query head 集合,省掉一次 all_gather,代价是每张卡多算一份 query 投影。MLAAttention.forward_impl 里能看到这个分支:
if q_dcp_replicated is not None: mqa_q = q_dcp_replicated[:num_mqa_tokens] qrep_decode = TruePCP(prefill context parallel)则作用在 prefill 侧。maybe_gather_mla_latent_cache_inputs 会把按 rank 切分的 kv_c_normed 与 k_pe 收拢,reorg_kvcache 负责把“按 rank 打包、带 padding”的上下文重排成“按请求连续”的布局。重排函数开头的注释给了一个很直观的例子:
allgatered_kv = [T0_0, T0_1, T0_2, T0_3, T1_0, T1_1, ..., T0_4, T0_5, pad, pad, T1_2, pad, ...]reorganized = [T0_0, T0_1, T0_2, T0_3, T0_4, T0_5, T1_0, T1_1, T1_2, ...]PCP 的每个 rank 只持有上下文的一段,all-gather 之后各段之间会夹着 padding;reorg_kvcache 按 local_context_lens_allranks 和 local_starts 把有效行挑出来,拼成注意力内核能直接消费的连续布局。如果不做这一步,kv_b_proj 会把 padding 也当成真实 token 上投影,既浪费算力又污染结果。
DCP 与 PCP 的组合还有额外约束。MLACommonMetadataBuilder 在 DSpark + DCP 下会检查后端是否支持变长 query;不支持就直接抛错,而不是悄悄退回单卡路径。这种“能力不匹配就显式失败”的策略在 MLA 里很常见,因为静默回退会让 KV 的切分账目与内核假设不一致,最后表现为数值错误而不是崩溃。
最后是 CUDA Graph。MLA 的 full CUDA Graph 只支持 decode-only 的捕获,build_for_cudagraph_capture 里有一句断言:
assert m.max_query_len <= self.reorder_batch_threshold # decode only也就是说,图捕获时 batch 必须全部落在 decode 栏。prefill 的形状太多变,无法静态化;decode 则可以通过 padding 到固定的 batch 桶来复用图。FlashMLA 的 FP8 路径甚至把 tile_scheduler_metadata 和 num_splits 复制进持久 buffer,避免图重放时重新分配。关于各框架图桶与 padding 的横向比较,可参考 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图。
QuantKey:融合 pass 交给 MLA 的“输出合同”
forward_impl 的开头有一段不显眼但很关键的逻辑:它先根据 output 的 dtype 与 scale 张量推断 QuantKey,然后决定是否在注意力之后追加一次输出量化。
quant_key = _detect_output_quant_key( output, output_scale, output_block_scale, self.num_heads * self.v_head_dim)if quant_key is not None: quant_output = output output = torch.empty(output.shape[0], self.num_heads * self.v_head_dim, dtype=q.dtype, device=output.device)也就是说,当上层融合 pass(例如 RMSNorm 之后要接一个 FP8 线性层)已经把 MLA 的 output 分配成 FP8 或 NVFP4 的 dtype 时,MLA 不能直接往这个 buffer 里写 BF16 结果。它先分配一个同形状的 BF16 临时 buffer,让注意力照常算完,再在末尾按 QuantKey 做一次动态量化:
kFp8Dynamic128Sym/kFp8Dynamic64Sym:用per_token_group_fp8_quant按 128 或 64 个元素一组量化,scale 写进output_block_scale;kFp8StaticTensorSym:按 per-tensor scale 做静态 FP8 量化,ROCm 路径有独立的 aiter 算子;kNvfp4Dynamic:两个 FP4 值打包进一个uint8,块 scale 单独写。
_detect_output_quant_key 的推断依据只有两样:output 的 dtype 和 scale 张量的形状。output_block_scale 存在时,如果 output 是 FP8,就按 group_size = output_dim // num_groups 反推是 128 还是 64 分组,其他情况一律拒绝;如果 output_block_scale 存在但 output_scale 为空,则视为 MXFP4 并直接报错。这个函数的注释里写得很直白:它只支持 128 和 64 两个 group size。
这段逻辑把 MLA 和 vLLM 的编译期融合链绑在了一起。没有融合时,MLA 的输出永远是模型精度的 BF16/FP16;有融合时,MLA 必须知道下游线性层要什么格式。mha_use_quant_output 进一步限制了融合路径的适用范围:只有当 prefill 后端支持该 QuantKey、没有 chunked context、DCP 规模为 1 时才走融合,否则仍然走临时 buffer。也就是说,融合不是“总能省一次读写”,而是一个有边界条件的优化。
对读者来说,这里最值得记住的是:MLA 后端的 forward_mqa 永远返回 latent 输出(512 维),W_UV 上投影发生在 MLA 层里,而不是在 FlashMLA 内核里。 所以量化融合的边界也在 W_UV 之后。如果下游要的是 FP8,MLA 层在 _v_up_proj 完成后统一做一次量化;FlashMLA 内核本身并不知道下游的 dtype。
四种 decode 后端:同一份 latent,四种读法
vllm/v1/attention/backends/mla/ 下的后端都继承 MLACommonBackend,共享 MLAAttentionImpl 接口,但 forward_mqa 的实现差异很大。下面按“从专用到通用”的顺序拆开。
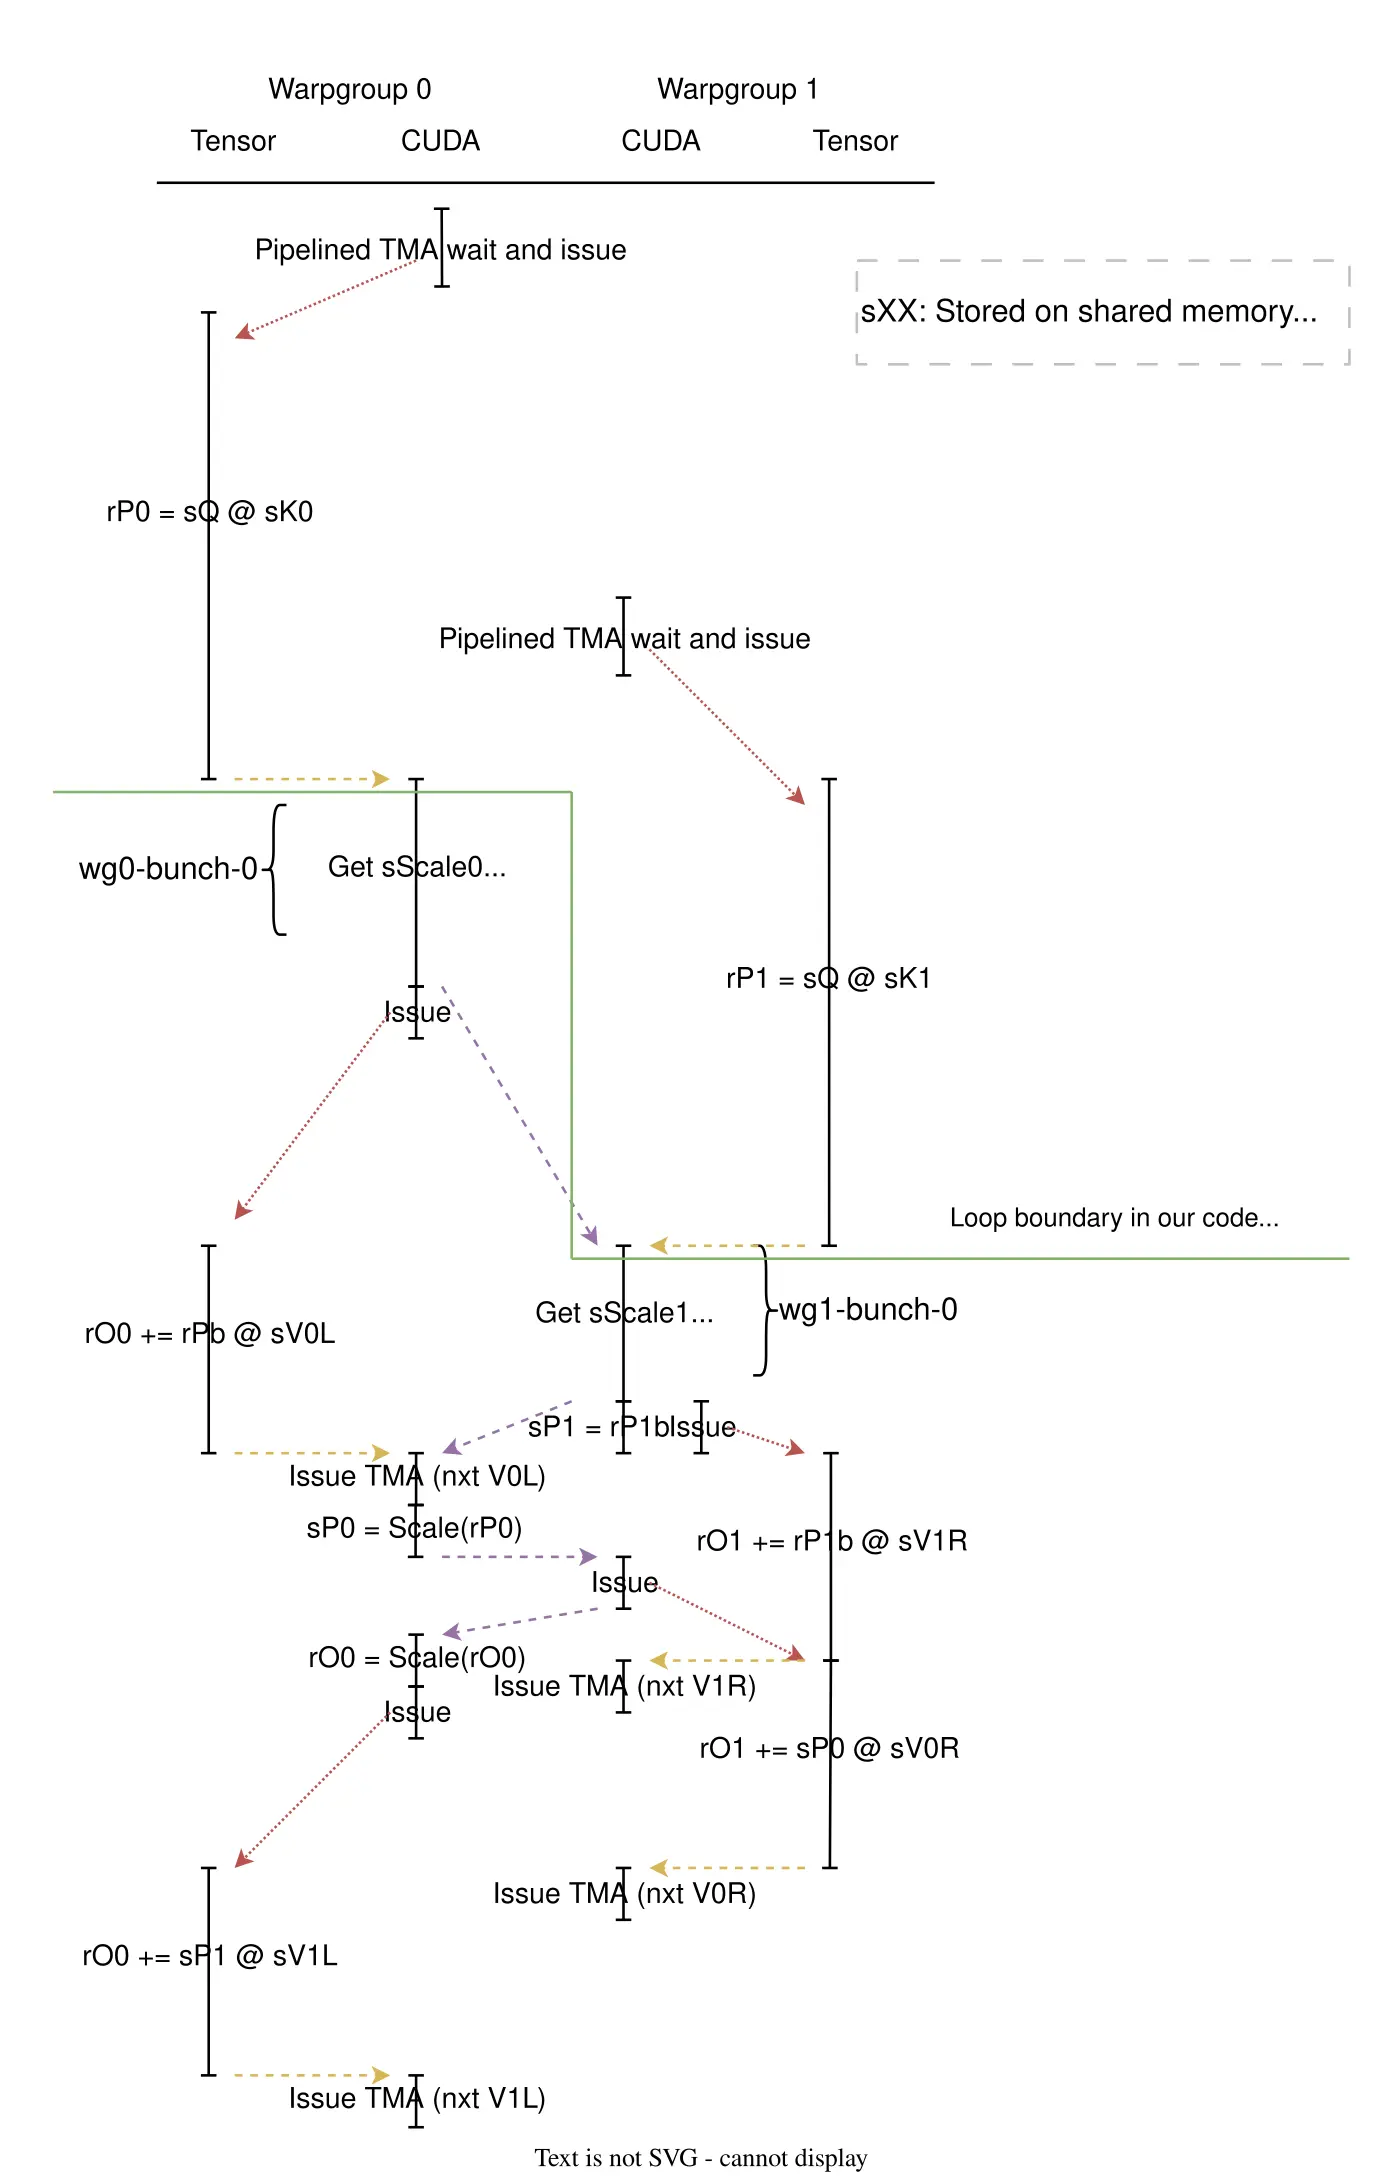
这张图来自 FlashMLA 官方仓库的 docs/assets,展示的是 MLA kernel 的调度形态。读图时注意两点:一是多个 query head 共享同一份 KV latent,二是调度器把不同序列的 KV 分片映射到 tile 上,由 tile_scheduler_metadata 驱动。FlashMLA 的高吞吐很大程度上来自这套“由 metadata 描述的分片调度”,而不是 kernel 内部写死的块划分。
FlashMLA:MQA、split-KV 与调度 metadata
FlashMLABackend 是 DeepSeek 官方 FlashMLA 内核在 vLLM 里的封装。它的约束最严格:
class FlashMLABackend(MLACommonBackend): supported_dtypes = [torch.float16, torch.bfloat16] supported_kv_cache_dtypes = ["auto", "float16", "bfloat16", "fp8", "fp8_e4m3"]
@staticmethod def get_supported_kernel_block_sizes(kv_cache_spec=None): return [64]只支持 FP16/BF16 的 query,KV 缓存可以是两者之一或 FP8,页大小必须是 64。FlashMLAImpl.__init__ 还会拒绝 alibi_slopes、sliding_window 和 logits_soft_cap,因为它只实现了 vanilla MLA decode。
forward_mqa 里有三个值得读的点。
第一,query 在模型层已经吸收,内核只做 MQA。传入的 q 形状是 [B, N, L+R],其中 L=512、R=64。内核内部把 head_dim_v 设成 kv_lora_rank,也就是输出是 512 维的 latent,不是 128 维的 V。这一点可以在调用处确认:
o, lse = flash_mla_with_kvcache( q=q, k_cache=kv_c_and_k_pe_cache.unsqueeze(-2), # 加一个 head 维,变成 MQA block_table=attn_metadata.decode.block_table, cache_seqlens=attn_metadata.decode.seq_lens, head_dim_v=self.kv_lora_rank, ...)unsqueeze(-2) 把缓存从 [num_pages, page_size, 576] 变成 [num_pages, page_size, 1, 576],让内核把它当成只有一个 KV 头的 MQA。这不是数据变形,只是告诉内核“所有 query head 共享这一份 KV”。
第二,split-KV 由 metadata 决定,kernel 不再自己猜。FlashMLAMetadataBuilder._build_decode 会在每次构造 decode metadata 时调用 get_mla_metadata:
num_q_tokens_per_head_k = max_query_len * num_q_heads // 1scheduler_metadata, _ = get_mla_metadata( seq_lens_device, num_q_tokens_per_head_k, 1, # MQA for the decode path is_fp8_kvcache=self.is_fp8_kvcache,)num_q_tokens_per_head_k 是“每个 KV 头要服务的 query token 数”,因为 MLA 只有一个 KV 头,它就是 max_query_len * num_q_heads。get_mla_metadata 根据这个量和每条序列的长度,计算每个序列应该切成几个 KV 分片、每个分片分给哪个 SM,输出 tile_scheduler_metadata。FP8 路径还会额外调用 get_mla_metadata_dense_fp8,得到 tile_scheduler_metadata 与 num_splits。
第三,FP8 metadata 要写进持久 buffer。full CUDA Graph 下,图重放时不能重新分配张量;所以 builder 在初始化时按 num_sms × 8 和 max_num_seqs + 1 预分配了 cg_buf_tile_scheduler_metadata 与 cg_buf_num_splits,每次构造 metadata 只是把结果 copy_ 进去。这个细节解释了为什么 FlashMLA 在 CUDA Graph 下也能吃 FP8:metadata 本身是图的一部分。
FlashMLA 的调度还有一个 batch-invariance 分支。启用 VLLM_BATCH_INVARIANT 且 KV 不是量化格式时,builder 会把 tile_scheduler_metadata 手动构造成“单分区”:
tile_scheduler_metadata[0, 0] = 0 # begin_idxtile_scheduler_metadata[0, 2] = B - 1 # end_idxtile_scheduler_metadata[0, 3] = end_block_idx原因是 split-KV 的归约顺序会随 batch 变化,破坏确定性;强制单分区后,每个序列的归约顺序固定。代价是并行度下降,所以只在 batch-invariant 模式启用。关于这一主题的整体设计,可参考 Batch-invariant 推理完全拆解:五个推理框架如何让同一请求不再随 batch 漂移。
FlashMLA 的官方 README 给出的性能口径是:2025 年 4 月的版本在 H800 SXM5 上针对 compute-bound 负载最高达到 660 TFLOPS;2026 年 9 月的 V4.1 稀疏内核在 Ascend 950 上 prefill 最高 410 TFLOPS、decode 最高 360 TFLOPS。这些是内核层面的数字,不等于端到端服务吞吐;vLLM 里 MLA decode 的端到端表现还会受调度、KV 页大小、batch 组成和 CUDA Graph 影响。另外要注意,FlashMLA 在 2026.09.30 版本中移除了 Hopper 架构与 V3/V3.2/V4.0 的旧格式支持,vLLM 实际可用的算子范围取决于它锁定的 FlashMLA 版本。
Cutlass MLA:SM100 上的 workspace 与固定 head 预算
CutlassMLABackend 面向 Blackwell(SM100)。它没有使用 DeepSeek 的 FlashMLA 库,而是调用 vLLM 自己封装的 ops.sm100_cutlass_mla_decode。读它的 _sm100_cutlass_mla_decode,能看到一组写死的校验:
D_latent = 512D_rope = 64MAX_HEADS = 128assert D_q_nope == D_latentassert D_q_pe == D_ropeassert D_ckv == D_latent + D_ropeassert H <= MAX_HEADSassert q_nope.dtype in (torch.float16, torch.bfloat16, torch.float8_e4m3fn)这意味着 Cutlass MLA 当前只支持 512 + 64 的 latent 布局、最多 128 个 query head,并且 KV 缓存的 dtype 必须与 query 一致。输出 buffer 按 MAX_HEADS 分配,然后再切出前 H 个 head:
out = q_nope.new_empty((B_q, MAX_HEADS, D_latent), dtype=dtype)...if H < MAX_HEADS: out = out[:, :H]为什么不直接按 H 分配?因为内核内部为了 tile 对齐,按 MAX_HEADS 做固定预算更简单;Python 侧多分配的一点显存可以用切片的视图回收。这种“按上限分配、按实际切片”的做法在 kernel 与 Python 边界上很常见,代价是 B_q × MAX_HEADS × 512 的临时显存,在 B_q=4096、BF16 下就是 512 MiB。SM100Workspace 则把 workspace 做成全局单例,初始 128 MiB,按 sm100_cutlass_mla_get_workspace_size 的结果增长;因为所有执行都共享同一个 workspace,这里隐含了一个约束:同一时刻不能有两次 MLA decode 并发使用该 workspace。vLLM 的模型执行是单流顺序的,所以这个假设成立。
Cutlass MLA 的分片参数 num_kv_splits 由一个通用的贪心计算决定,与 Triton MLA 相同,后文一起讲。
它的能力边界也比 FlashMLA 更窄:get_supported_kernel_block_sizes 返回 [128],页大小必须是 128;supports_compute_capability 要求 capability.major == 10,也就是只能跑在 SM100 系列上。它和 FlashMLA 在页大小上的分歧(64 对 128)说明 MLA 的页粒度不是一个可跨后端自由迁移的配置:选择后端时,块管理器会按后端声明的能力重新组织 KV 池。
Triton MLA:可调试的 split-KV 参考实现
TritonMLABackend 是四种里最容易读的。它不依赖外部库,forward_mqa 直接调用 decode_attention_fwd,并用一个显式的 attn_logits 缓冲保存每个分片的部分输出与 LSE。
分片数由 _compute_num_kv_splits 计算:
_MIN_WORK_PER_SPLIT = 512_SPLIT_OCCUPANCY_MULTIPLIER = 2
def _compute_num_kv_splits(max_seq_len: int, sm_count: int) -> int: ideal_splits = triton.next_power_of_2(max(1, max_seq_len // 512)) max_splits = sm_count * 2 return min(ideal_splits, max_splits)思路很直接:序列越长,越值得把 KV 切成更多分片并行;但分片数必须取 2 的幂(避免过多的 kernel 实例),并受 SM 数量乘 2 的占用上限约束。attn_logits 的形状是:
logits_shape = (B, q_num_heads, num_kv_splits, self.kv_lora_rank + 1)最后一维是 512 维的部分输出加上 1 个 LSE。stage 1 的 kernel 每个分片算出部分结果,stage 2 的 kernel 按 LSE 归约。这个缓冲从 workspace manager 里取,并且在 metadata builder 里按最坏情况预分配:
current_workspace_manager().get_simultaneous( ((max_decode_rows, q_num_heads, max_splits, kv_lora_rank + 1), torch.float32))预分配的意义是让 hot path 上不再有 torch.empty;q_num_heads 是取的最坏情况,因为不同层可能共享或切分 head。FP32 是必需的:LSE 的精度决定了归约后的数值稳定性,用 BF16 存 LSE 会在大序列长上引入可见误差。
Triton MLA 对变长 decode 的处理值得单独看。在投机解码或 DSpark 的草稿阶段,一个请求可能有多行 query。Triton 的做法是把每条请求的多 token 块直接展开成多行 decode,并用逐行 seq_len 表达块内因果:
if query_len > 1: block_table = block_table.repeat_interleave(query_len, dim=0) if attn_metadata.causal: offsets = torch.arange(1 - query_len, 1, device=...) seq_lens = (seq_lens.unsqueeze(1) + offsets).flatten().clamp(min=0) else: seq_lens = seq_lens.repeat_interleave(query_len)decode_attention_fwd 本身没有 causal 参数,它按每行的 seq_len 决定读多少 KV。于是第 t 行读的是“前缀 + 前 t 个块内 token”,天然表达块内因果。非因果草稿(例如非因果多 token 草稿)则让所有行都读同样的前缀。这个“用 seq_len 表达因果”的技巧在 MLA 的各后端里反复出现,因为 MLA 的 decode 内核普遍是 MQA 形式,没有逐 token 的 mask。
Triton MLA 的另一个分支是 VLLM_BATCH_INVARIANT:它强制 num_kv_splits = 1,让归约只发生一次,从而保证 batch-invariant。这与 FlashMLA 的单分区 metadata 是同一个思路的两种实现。
为什么是这四种
四种后端覆盖了不同的硬件与调试需求:FlashMLA 是 NVIDIA Hopper 上最成熟的 MLA 专用内核;Cutlass MLA 面向 Blackwell 的 SM100 tensor core;Triton MLA 是跨平台、可读可改的参考实现;ROCm 路径上还有 aiter 的 MLA 实现(rocm_aiter_mla.py),带 FP8/FP4 BMM 与 Triton fp8 bmm 的预编译路径。它们共享 MLACommonImpl 的 prefill、W_UV 上投影与 metadata 结构,只在 forward_mqa 上分道扬镳。
从工程角度看,这种“公共层 + 专用 decode 内核”的结构降低了新增后端的成本:新平台只需要实现一个 forward_mqa,prefill 可以直接复用现有的 MLAPrefillBackend,metadata 与权重拆分的逻辑不必重写。代价是公共层里积累了大量分支(DCP、PCP、sparse、CUDA Graph、FP8、NVFP4),源码读起来像一棵很深的决策树。
稀疏 MLA:索引器算一次,几十层共用
DeepSeek-V3.2 之后,MLA 不再是“每一层都对全量 latent 做 MQA”,而是先由一个轻量索引器挑出 top-k token,再让 MLA 只读这些 token 的 KV。vLLM 把这套结构收进了 MLA 层本身:MLAAttention.__init__ 接受 use_sparse、indexer、topk_indices_buffer 与 index_group_builder;如果 use_sparse=True,impl 会拿到 top-k 缓冲区,forward_impl 再根据 _use_sparse_mha 决定 prefill 是走“稀疏索引 + MQA”还是“带 mask 的 dense MHA”。
索引器与 MLA 层的分工是这套设计的关键。索引器本身是一个小模型:它用 query 的 latent 与 KV 的索引缓存打分,选出每个 query 的 top-k token。MLA 层不重复计算索引,而是从共享的 topk_indices_buffer 读结果。SparseMLAIndexGroup 把“生产索引的层”和“消费索引的层”绑成一个组:
@dataclassclass SparseMLAIndexGroup: logical_topk_indices: torch.Tensor physical_topk_indices: torch.Tensor valid_topk_counts: torch.Tensor side_stream: torch.Stream logical_topk_ready: torch.Event physical_topk_ready: torch.Event has_indexer: bool num_layers: int = 0has_indexer 标记这一层是不是索引生产者;logical_topk_indices 是索引器输出的逻辑下标,physical_topk_indices 是换算成物理页/槽位后的下标。convert_logical_to_physical_topk 会把同一组内所有层共用的逻辑索引只转换一次,避免每层都做一遍相同的地址换算。side_stream 与两个 event 则把索引计算放到旁路流上,让索引器与主干的其它算子重叠;MLA 层在消费前等待 physical_topk_ready。
这套“组”的设计解决了一个实际开销问题:DeepSeek-V3.2 有 61 层,如果每层都独立跑一次索引器,索引计算的成本会接近甚至超过 MLA 本身。让一部分层生产索引、其余层复用,可以把索引成本摊薄到整组。HiSparseMLAIndexGroup 进一步把索引缓存放到 host-backed 存储上,用 HiSparseCacheHandle 管理每层的物理缓存与 staging plan,适合索引缓存远大于显存的场景。
稀疏路径还有一个容易忽略的分支:prefill 并不一定要走稀疏。_use_sparse_mha 会检查 prefill 后端是否支持 masked MHA、DCP 是否关闭、以及 query/seq 长度是否落在阈值表里;满足条件时,它把稀疏 top-k 掩码交给 dense MHA 内核,让长 query 的 prefill 仍然吃满 Tensor Core。只有当 query 很短、masked MHA 不划算时,才退回 token 级的稀疏 MQA。换句话说,稀疏 MLA 的“稀疏”主要发生在 decode;prefill 仍然可以借用 dense 内核的吞吐。索引器与 DSA 的完整机制可参考 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现。
投机解码:query 不是 1 时,后端要改什么
MLA 的 decode 内核默认假设每条请求只有一行 query。投机解码打破了这个假设:草稿模型一次给出 k 个 token,目标模型要把这 k 个 token 拼成一个多 token query 块,一次前向验证。vLLM 在 MLA 层与后端之间加了一层形状适配。
第一步是 reshape_query_for_spec_decode。它把扁平的 query 张量按 num_decodes 和每请求的 query 长度重排成 [num_decodes, query_len, num_heads, head_dim] 之类的形状,让后端能按请求处理。FlashMLA 的 forward_mqa 一进来就调用它:
q = reshape_query_for_spec_decode(q, num_decodes)第二步是 query head 的补齐。某些后端(例如 FlashMLA 的 head padding 路径)要求 query head 数是某个值的倍数;MLAAttention 会通过 q_pad_num_heads 把 q_pe 先分配到一个更大的 buffer,再 resize_ 回真实 head 数。这样内核按对齐后的 stride 读,逻辑上仍然只处理真实 head。这个技巧在 forward_impl 里能看到:
if self.q_pad_num_heads is not None: B, N, L = mqa_q_pe.shape mqa_pe_padded = mqa_q_pe.new_empty((B, self.q_pad_num_heads, L)) mqa_pe_padded.resize_((B, N, L)) mqa_pe_padded.copy_(mqa_q_pe) mqa_q_pe = mqa_pe_paddedresize_ 把张量的逻辑形状改回 [B, N, L],但底层 storage 仍然是按 q_pad_num_heads 分配的;内核只要按 storage 的 stride 读,就不会越界。这是“逻辑形状”和“物理容量”分离的典型用法。
第三步是 metadata 的适配。FlashMLAMetadataBuilder._build_decode 用 max_query_len 算 num_q_tokens_per_head_k,所以多 token 验证块的调度 metadata 与单 token decode 不同;TritonMLAMetadataBuilder 则在 update_draft_decode_metadata 里把草稿批的 metadata 单独维护。QueryLenSupport 决定后端能否接受变长 query:FlashMLA 是 UNIFORM,同一批里所有请求的 query 长度必须一致;Triton 在注释里说明它会把 uniform 块展开成多行;VARLEN 才允许混合长度。
第四步是因果性。投机验证块的每一行只能看到“前缀 + 块内前 t 个 token”,但 MLA 的 MQA 内核普遍没有逐 token mask。FlashMLA 用 causal=True 加 per-row 的 cache_seqlens 表达;Triton 用 seq_lens 的逐行偏移表达;非因果草稿(例如 DSpark 的非因果多 token 块)则把所有行都设成同样的前缀长度。non_causal_multi_token_decode 这个字段就是为后者准备的:只有显式声明支持的后端与 metadata 组合才能走非因果路径,否则在 build 阶段就抛错。
这四步合起来,解释了为什么投机解码在 vLLM 里不是“草稿模型 + 目标模型”两个模型那么简单:它还要求 MLA 后端、metadata、CUDA Graph 与 KV 回滚全部按多 token query 重排。关于 DSpark 与 DFlash 的具体草稿机制,可参考 DSpark:半自回归生成与置信度调度的投机解码 与 DFlash 块扩散解码:以并行扩散替代自回归草稿,实现无损 6 倍推理加速。
一组具体数字:DeepSeek-V3 的单请求缓存账
把前面的公式落到 DeepSeek-V3 的配置上,可以得到一组很有用的数量级。假设 61 层、128 个 query head、kv_lora_rank=512、qk_rope_head_dim=64、BF16 缓存:
- 每 token、每层:576 × 2 = 1152 字节;
- 每 token、全部 61 层:1152 × 61 = 70,272 字节,约 68.6 KiB;
- 128k 上下文:70,272 × 131,072 ≈ 9.21 GB(十进制),约 8.58 GiB;
- 每页 64 token、每层:64 × 576 × 2 = 73,728 字节,正好 72 KiB;
- 128k 上下文需要 2048 页。
如果换成 FP8 缓存,vLLM 的 per-token-head 布局会在 576 字节数据后追加两枚 FP32 scale,行宽变成 584 字节:
- 每 token、全部 61 层:584 × 61 = 35,624 字节,约 34.8 KiB;
- 128k 上下文:35,624 × 131,072 ≈ 4.67 GB,约 4.35 GiB。
作为对照,同样 61 层、128 head、192 维 QK、128 维 V 的普通 MHA,BF16 下每 token 每层是 128 × 320 × 2 = 81,920 字节,128k 上下文约 655 GB。MLA 把这份账压到 9.21 GB,差了两个数量级。即便是 8 个 KV 头的 GQA,每 token 每层也要 8 × 256 × 2 = 4096 字节,128k 约 32.7 GB,仍然是 MLA 的 3.6 倍。
这组数字也能解释 prefill workspace 的设计。64k token 的 latent gather workspace 是 64 × 1024 × 576 × 2 ≈ 75.5 MB;但如果把同样 64k token 全部上投影成 k_nope 与 v,按 128 head × 256 维 × 2 字节算是 64 × 1024 × 128 × 256 × 2 ≈ 4.19 GB。两者的比例是 55 倍。分块上下文把后者限制在 W 行以内,代价是多次 gather 与 LSE 合并;这就是为什么源码注释反复强调 workspace 的大小,而不是 gather 的带宽。
| 后端 | 主要平台 | 页大小 | KV dtype | decode query | split-KV 调度 | 额外缓冲 |
|---|---|---|---|---|---|---|
| FlashMLA | NVIDIA Hopper 系(取决于版本) | 64 | FP16/BF16/FP8 | UNIFORM 多 token | get_mla_metadata 生成 tile scheduler 与 num_splits | FP8 metadata 持久 buffer、scheduler metadata |
| Cutlass MLA | SM100(Blackwell) | 128 | FP16/BF16/FP8 | 由 common builder 决定 | 通用 num_kv_splits 贪心 | 全局 128 MiB 起 workspace、MAX_HEADS 输出 buffer |
| Triton MLA | 跨平台(含 AMD) | 16 的倍数 | FP16/BF16/FP8 | 可展开变长行 | 显式 attn_logits 分片 + stage2 归约 | B × N × splits × (512+1) FP32 缓冲 |
| ROCm AITER | AMD | 由后端声明 | FP8/FP4 等 | 由 common builder 决定 | AITER 内核内部 | FP8/FP4 BMM 与预编译缓存 |
这张表只列差异,不列共性:四者都共享 MLAAttention 的权重吸收、W_UV 上投影、chunked prefill 与 metadata 分栏。选后端时先看硬件与页大小,再看 query 形态和 KV 精度;任何一个条件不匹配,vLLM 都会在 selector 或 builder 阶段拒绝,而不是在运行时悄悄降级。
一次 decode step 的完整走查
把前面的零件按执行顺序摆一遍,可以看到 MLA 在一条 decode step 里到底占了多少动作。假设一个 batch 有 32 条请求,每条请求刚采样出 1 个 token,没有投机解码、没有 DCP、KV 是 BF16。
- 模型层
MultiHeadLatentAttentionWrapper.forward先做fused_qkv_a_proj,得到q_c与kv_lora;q_c过q_a_layernorm、kv_c过kv_a_layernorm;q = q_b_proj(q_c),k_pe过 RoPE。 - 交给
MLAAttention.forward:prepare_kv_cache_update检查 HiSparse 组;update_kv_cache把 32 行kv_c_normed与k_pe按slot_mapping写进分页缓存。写完后hisparse_cache.finish_kv_update()。 forward_impl从attn_metadata取num_decode_tokens=32、num_mha_tokens=0;跳过 MHA 分支。- 把
q切成q_nope与q_pe;q_nope.transpose(0,1)变成[N, 32, P],与W_UK_T做一次bmm,得到[32, N, 512];再与q_pe拼成[32, N, 576]。如果 KV 是 FP8 且 query 支持量化,这一步的拼接与量化由_DecodeConcatQuantFP8融成一个算子。 - 调用
impl.forward_mqa。以 FlashMLA 为例:先把缓存unsqueeze(-2)成单头,再按decode.scheduler_metadata的 tile scheduler 与num_splits调用flash_mla_with_kvcache;内核返回[32, N, 512]的 latent 输出与 LSE。 _v_up_proj把[32, N, 512]与W_UV做bmm,写成[32, N, 128];再view成[32, N*128]。- 如果
quant_key非空,按 FP8/NVFP4 规则量化后写进融合 pass 预分配的 output;否则直接返回 BF16 输出。 - 采样器从 logits 里选出下一个 token,KV 块管理器为下一 step 记账;如果请求结束,
free掉它的块,写时复制的块在这里减引用。
这条走查里,MLA 自身只占第 2 到第 7 步;模型层的投影与 RoPE、采样器、块管理器都在 MLA 之外。读源码时如果只盯着 forward_mqa,会误以为 MLA 的全部成本都在内核里;实际上,q_b_proj、kv_b_proj 的拆分、bmm 吸收、v_up_proj 和量化融合都在 MLA 层完成,内核只负责“拿吸收后的 query 读 latent 缓存”这一段。用 torch.profiler 看一条 decode step 时,MLA 相关的 kernel 往往分散在五六个名字里,而不是一个 mla_attention。关于如何用 profiler 把这些 kernel 归位,可参考 GPU 推理性能分析完全指南:用 torch.profiler、Nsight Systems 与 Nsight Compute 逐层定位瓶颈。
几个容易读错的地方
最后列出几个源码阅读时高频的误读,作为对照。
误读一:把 head_size=576 当成 QK 维度。 576 是缓存行宽,等于 kv_lora_rank + qk_rope_head_dim;真正的 QK 维度在 prefill 是 qk_nope_head_dim + qk_rope_head_dim=192,在 decode 吸收后是 576。softmax scale 始终按 192 计算。
误读二:以为 num_kv_heads=1 就是 MQA 模型。 MLA 的模型表达仍然是多头注意力,只是缓存里只有一个 KV 头;decode 之所以能按 MQA 跑,是因为 W_UK 把每个 head 的 query 吸收到了共享 latent 空间。prefill 仍然按 128 个 head 做 MHA。
误读三:把 W_UK_T 当成 kv_b_proj 的转置。 kv_b_proj 的输出是 [L, N*(P+V)],拆分后 W_UK 是 [L, N, P];W_UK_T 是 [N, P, L],只取 NoPE 部分,不包含 V。V 在 W_UV 里,形状 [N, L, V]。
误读四:以为 prefill 一定走 dense MHA。 稀疏 MLA 的 prefill 会根据阈值在 masked MHA 与 token 级 MQA 之间切换;_use_masked_mha 的阈值表是按后端、TP size、head 维度分别配置的,不存在一个通用答案。
误读五:把 kv_cache_dummy_dep 当成真实数据。 它只是编译图里的顺序依赖;unified_mla_kv_cache_update 返回空张量,真正的写入发生在 side effect 里。删掉它,图可能重排,注意力会读到旧 slot。
误读六:以为 CUDA Graph 能捕获 prefill。 MLA 的 full graph 只接受 decode-only 的 batch;prefill 的形状、chunk 数与 workspace 都随请求变化,无法静态化。图捕获的断言就是这条边界的守门员。
从源码回到直觉:四条判断
读 MLA 后端源码,最后应该沉淀成几条可以讲给别人听的判断。
第一,MLA 的压缩发生在缓存布局上,不是在内核里。 内核看到的是一份 576 维、单 KV 头的 latent 缓存;压缩之所以有效,是因为模型层只把 latent 和 k_pe 写进缓存,K 的 NoPE 与 V 都在需要时才由 kv_b_proj 生成。
第二,矩阵吸收是 decode 的核心,但 prefill 必须反其道而行。 吸收把 decode 的访存取量化,却也把 QK 维度从 192 拉到 576;prefill 的 query 很长,吸收带来的额外计算不划算,所以 vLLM 选择在这种场景重新上投影成完整 MHA,并用分块 workspace 控制峰值。
第三,MLA 的 metadata 是一份“分栏合同”。 一个 batch 被切成 decode 段与 prefill 段,阈值由后端的 query 长度能力决定;CUDA Graph 只接受 decode-only 的 batch,投机解码的变长验证则由 QueryLenSupport 约束。任何改动都会同时影响调度、图捕获与采样。
第四,后端的差异不在算法,而在调度与数据格式。 FlashMLA 的 split-KV 由 get_mla_metadata 描述,Cutlass MLA 有固定 head 预算与全局 workspace,Triton MLA 用显式 attn_logits 与 seq_len 表达因果。它们都读同一份 latent,差别在于“怎么把 KV 分片分给 SM”和“用什么缓冲存中间结果”。
这四条放在一起,可以解释很多部署现象:为什么 DeepSeek-V3 在 H800 上选 FlashMLA 而不是 Triton;为什么 FP8 MLA 在 batch-invariant 模式下会掉并行度;为什么 128 token 的短 prefill 可能被当作 decode 跑;为什么同一个模型在不同框架上的 MLA 页大小不一样。
参考资料
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- FlashMLA 官方仓库
- vLLM MLA 注意力层源码
vllm/model_executor/layers/attention/mla_attention.py - vLLM MLA 模型层封装
vllm/model_executor/layers/mla.py - vLLM MLA FlashMLA 后端
vllm/v1/attention/backends/mla/flashmla.py - vLLM MLA Triton 后端
vllm/v1/attention/backends/mla/triton_mla.py - vLLM MLA Cutlass 后端
vllm/v1/attention/backends/mla/cutlass_mla.py - FlashInfer 的 MLA decode 实现 PR #551
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



