


SGLang Model Gateway 完全拆解:Rust 网关如何用缓存感知路由把 DP 推理吞吐翻倍
背景:当一份模型被复制成八份
SGLang 源码系列已经拆过引擎内部的很多块:调度器的状态机、RadixCache 如何复用前缀 KV、PrefillAdder 如何盘算 KV 预算、分块 Prefill 与重叠调度如何藏住 CPU 开销。这些讨论都默认了一个前提——请求已经落到了某一个 SGLang 引擎上,接下来只是引擎自己怎么跑的问题。
但在真实部署里,一台机器往往装不下全部压力。典型做法是把整个模型复制成 N 份(N 个 DP replica,每个 replica 本身可能再用 TP/EP 切到多卡),外面再挂一个前置路由层,负责把每条新请求分给其中某一个 replica。这个路由层不在本文讨论的引擎内部,它在引擎前面,是 SGLang 体系里最容易被忽略、却直接决定集群吞吐的一块:SGLang Model Gateway(早期叫 SGLang DP Router,入口包名仍是 sglang_router)。
路由层里最简单的算法是轮询:第 1 条给 replica 0,第 2 条给 replica 1……这对无状态服务是合理的。但对 LLM 推理服务,这是系统性地错失缓存。
轮询为什么会输给缓存
考虑这样一个典型负载:多组长前缀(比如同一个 Agent 系统提示词、同一个文档 QA 的上下文)被反复请求,组内请求的差异只在末尾几问。一个由 8 个 replica 组成的集群,每个 replica 自己维护一份 RadixCache。前缀复用能不能命中,取决于两件事:
- 这个前缀是否曾被写入这个 replica 的 RadixCache;
- 那个 KV 块是否还没有被驱逐。
轮询对两件事都是盲的。一条带着 8K 前缀的新请求落到 replica 3,而这段前缀的 KV 其实完好地躺在 replica 1 的缓存里,那么 replica 3 必须把 8K 个 token 从头 Prefill 一遍;replica 1 那边则可能在下一波新前缀涌入时,把这段”没人再来查”的缓存慢慢挤出去。
结果是双输:算力被浪费了(重复 Prefill),缓存也在变空。SGLang 团队在 v0.4(2024 年 12 月)发布的 Cache-Aware Load Balancer 里给过一组直接对照:在同一组多长前缀、组内均衡的负载下,8×A100 80GB、dp-size=8,朴素轮询的吞吐是 82,665 token/s、缓存命中率 20%;换成缓存感知路由后吞吐 158,596 token/s(约 1.9 倍)、命中率 75%(约 3.8 倍)。博客里也写得很直接:“benefits scaling as worker count increases”——worker 越多,朴素轮询浪费得越多。
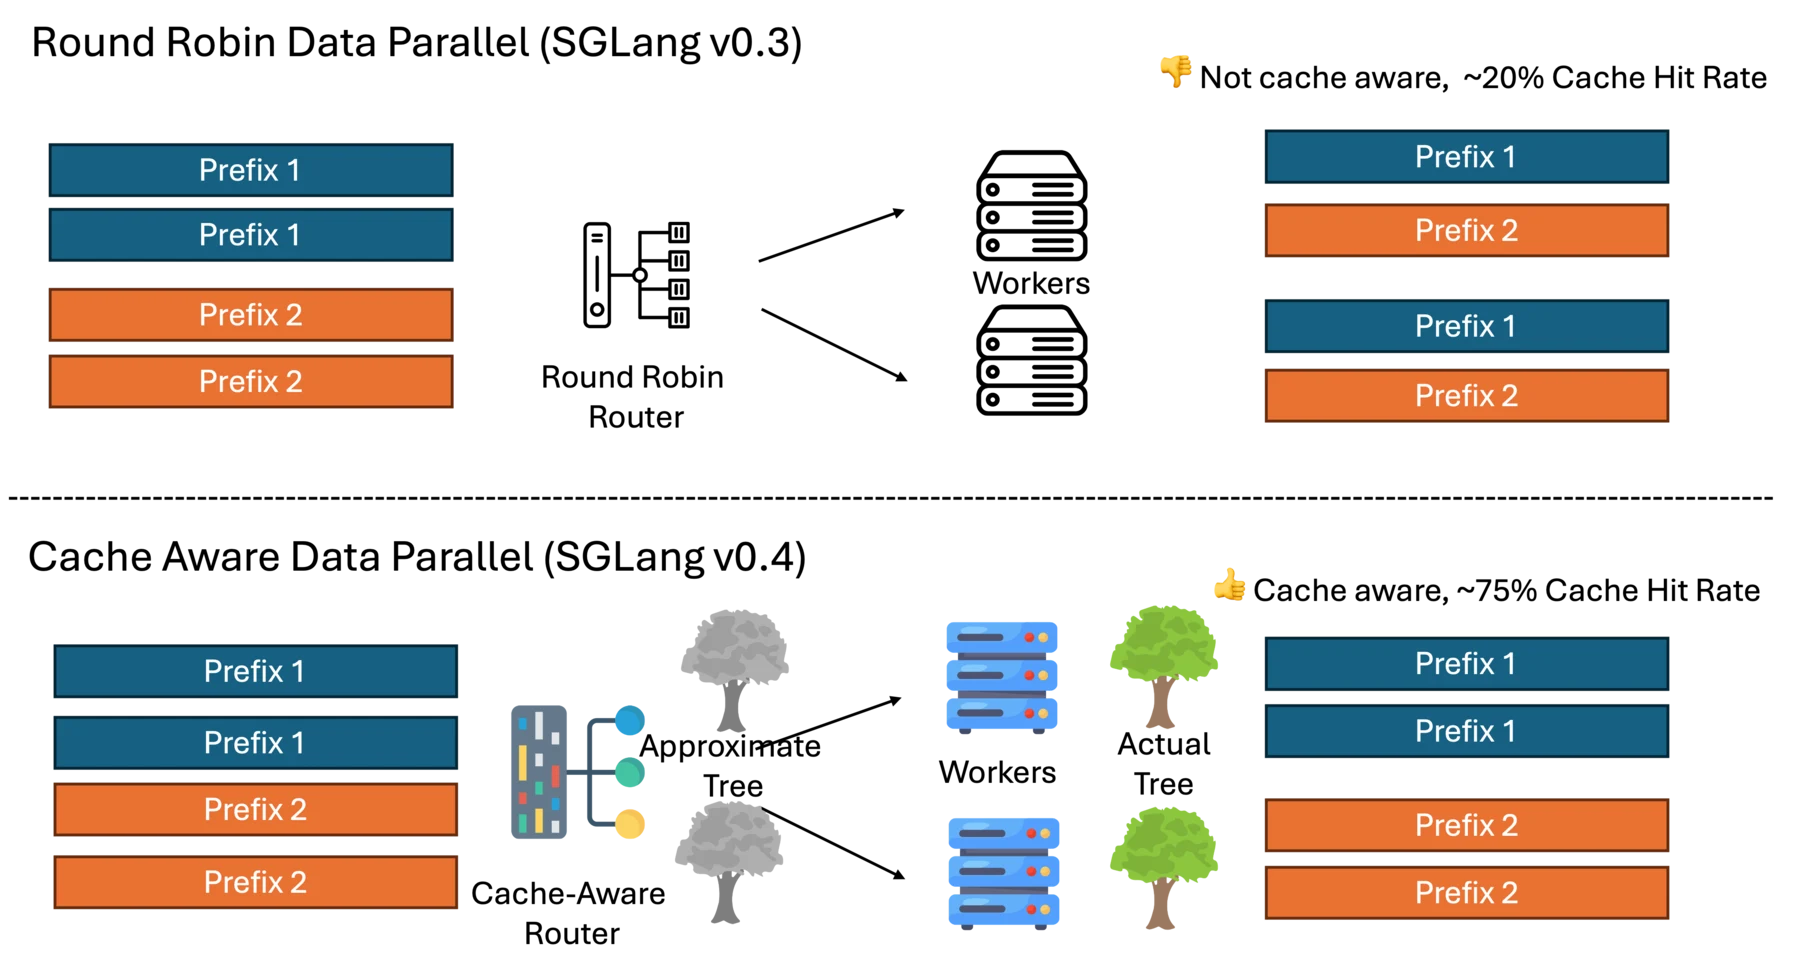
上图是 SGLang v0.4 官方博客给出的缓存感知负载均衡示意(图源:SGLang v0.4 博客)。它把请求前缀与不同 worker 的缓存状态画在一起,用来说明同前缀请求被聚集到同一 worker 后,后续请求可以直接复用已有 KV;朴素轮询则会把它们打散。下面要拆的,就是这张图背后那个用 Rust 写的、无通信的近似基数树,以及它上层的网关结构。
一个容易被误解的点:路由器不知道 worker 的缓存
读完前一段,很容易想象路由器在向每个 worker 查询”你有没有这段前缀”,再选一个有的。实际设计恰恰相反,v0.4 博客里把这一点作为关键特性写出来:Communication-Free Design——“No worker synchronization is required for cache state; instead, it uses passed information to simulate an approximate tree”。
也就是说,网关对 worker 缓存的全部认识,来自它自己分发出去的请求历史。对每条请求,网关记录”这段文本最终去了哪个 worker”,并据此在网关本地为每个 worker 维护一棵近似的基数树。它并不是 worker 上真实 RadixCache 的拷贝:没有驱逐通知、没有真实的块粒度、也不区分 token 与字符。它是一个推测器,只用来回答一个概率问题——“如果这条请求给 worker X,它大概能命中多少前缀?”
这带来了三个很实际的收益:路由路径上没有一次 RPC;worker 数量增长时,网关不需要跟着维护 N 条连接去同步状态;worker 挂掉重启、缓存清空这种”网关不知道的真相”,也只影响命中率,不影响正确性(只是退化为一条冷请求)。代价是它必须保守地处理一切不确定性,后面的小节会反复看到这种保守:只按字符不按 token、部分匹配时只取已有租户、LRU 只是近似。
网关的全貌:从单进程路由到 Rust 控制面/数据面
在拆路由算法之前,先把”网关”这个词对应的东西摆清楚。它不是一个薄薄的反向代理,而是一个带控制面和数据面的独立进程。
入口与两种部署形态
根据 SGLang Model Gateway 官方文档,网关对外的入口有三个:
python -m sglang_router.launch_router:只启动网关,用--worker-urls指向已存在的 worker;python -m sglang_router.launch_server:网关和一组 worker 一起拉起,参数--dp-size直接决定 worker 数;sgl-model-gatewayRust 二进制(cargo build --release)或 Docker 镜像lmsysorg/sgl-model-gateway。
三种形态跑的是同一套代码。launch_server 里带 --router- 前缀的参数会被剥掉前缀后交给网关,例如 --router-policy cache_aware、--router-prometheus-port 10001;不带前缀的交给 SGLang 引擎,比如 --tp-size、--dp-size。
代码上对应两个目录:引擎仓库里的 python/sglang/srt/entrypoints 一侧有旧结构,网关本体代码在 sgl-model-gateway/,而 sgl-router/ 是后来重构出的精简实现(lib.rs 的模块列表是 buckets_reorg / config / discovery / health / policies / policies_reorg / protocol / proxy / server / state / tokenizer / workers),设计文档里自述为 “slim KV-aware OpenAI-compatible router for SGLang workers”。理解网关时以 sgl-model-gateway/ 为主线更完整,sgl-router/ 的模块划分可以帮助快速定位。
控制面与数据面
文档把网关分成两层:
控制面负责”谁可用、谁负载多少、谁健康”:
Worker Manager:通过/get_server_info、/get_model_info发现 worker 的能力(模型名、DP rank、PD 角色等),跟踪负载,并把 worker 注册/移除写进共享注册表;Job Queue:把增删 worker 的请求串行化,对外通过/workers/{worker_id}暴露注册进度;Load Monitor:为缓存感知与 power-of-two 策略持续提供各 worker 的负载快照;Health Checker:周期探测 worker,更新就绪状态、熔断器状态和路由指标;Tokenizer Registry:管理和异步加载分词器(gRPC 路由、token 级策略需要)。
数据面负责”这条请求往哪发、怎么发”:
- HTTP 路由:
/generate、/v1/chat/completions、/v1/completions、/v1/responses、/v1/embeddings……以及管理端点。分为 regular 路由与 PD 路由两套; - gRPC 路由:带 tokenizer、reasoning parser、tool parser,全部在 Rust 进程内完成,直接以 token 形式流向 SRT 的 gRPC worker;
- OpenAI 后端模式:把外部厂商的 OpenAI 端点当作 worker,历史与多轮编排留在本地。
此外还有一层存储与隐私:会话/响应历史可以存在网关(内存、PostgreSQL 等),/v1/responses 的 Agent 流程、MCP 会话共享同一存储层。
对本文的主题——“请求被分到哪个 replica”——起作用的只有两处:控制面的 Worker Manager/Load Monitor 维护的 worker 视图,以及数据面 regular/PD 路由中的 worker 选取。其余模块(协议适配、解析器、历史存储)属于网关的其他职责,这里不展开。
代码骨架:谁能决定选哪个 worker
在源码里追这条线,可以先抓三个结构:
sgl-model-gateway/src/├── core/│ ├── worker.rs // Worker trait: url()/load()/is_healthy()/circuit_breaker()/worker_type()/dp_rank()│ ├── worker_registry.rs // 按模型、角色分组的注册表;持有 consistent hash ring│ ├── worker_manager.rs // 控制面:负载轮询、健康探测│ └── circuit_breaker.rs // 每 worker 一个熔断器├── policies/ // 负载均衡策略:cache_aware / power_of_two / bucket / consistent_hashing / round_robin / random├── routers/│ ├── router_manager.rs // 为一条请求挑用哪个"路由"(regular / PD / gRPC / OpenAI 后端)│ └── http/ // router.rs(regular)、pd_router.rs(PD)、decode_gate.rs└── server/ // HTTP/gRPC 服务与端点一句话概括职责:RouterManager 选路由,Router 选 worker,Policy 选下标。 三者是嵌套关系——网关先按请求的模型与 worker 能力决定走 regular 还是 PD 路由,路由再按”模型 + 角色”过滤出候选 worker 列表,最后交给某个 LoadBalancingPolicy 做选择。
RouterManager:一条请求先要过哪道门
RouterManager::select_router_for_request 负责第一层决定。源码里的逻辑值得原样走一遍,因为它解释了为什么网关能”同时服务多种部署形态”:
- 单路由模式(
enable_igw=false):始终用默认路由。这是大多数launch_server场景; - 多路由模式(
enable_igw=true):- 若请求头带
x-prefer-pd: true,会给 PD 路由额外加分; - 若请求能确定模型名,调
get_router_for_model,按 worker 能力打分选路由:外部 OpenAI 兼容 worker(4)> gRPC-PD(3)> HTTP-PD(2)> gRPC-regular(1)> HTTP-regular(0); - 若无模型名,用
routers_snapshot遍历所有路由,以ArcSwap原子快照加零分配的方式评分,再按router.is_pd_mode()与全局的 regular/PD worker 数量校验该路由是否真的可用。
- 若请求头带
选出的路由实现了 RouterTrait,之后的请求分发、重试、熔断都由它内部完成。这一层本身不关心缓存,它的价值是把”同一进程里并存 regular/PD/gRPC/OpenAI 后端”这种复杂部署收拢成一个整数评分。
缓存感知路由:用一棵”影子树”推测命中率
数据面里最重要的策略是 CacheAwarePolicy(policies/cache_aware.rs)。它的文件头注释就是整份算法说明,可以逐句对照代码看。
两套策略按需切换
CacheAwarePolicy 本质上是两个策略的联动:
- 缓存感知路由:为每个 worker 维护一棵近似基数树,请求到来时找出”前缀命中最多”的 worker;
- 最短队列:当集群负载明显失衡时,优先考虑负载。
失衡的判定是两个条件同时成立:
第一项是绝对差,防止 1 和 2 这种本来就没有意义的差值触发;第二项是相对倍率,防止负载整体很小时大倍率但小差值的情况。两者都要求”差值足够大 并且 比值足够大”,才是真的失衡。这种”绝对 + 相对”的双阈值写法在桶策略里也出现了一次,是这套代码的一个稳定习惯。
如果判定为失衡,就进入 select_worker_min_load:
let loads: Vec<(usize, usize)> = healthy_indices .iter() .map(|&idx| (idx, workers[idx].load())) .collect();let min_load = loads.iter().map(|&(_, load)| load).min()?;let min_load_idx = loads .iter().copied() .filter(|&(_, load)| load == min_load) .map(|(idx, _)| idx) .choose(&mut rand::rng())?;注意两个细节:
- load 快照后再比较:注释里写得很清楚,
load()是实时的原子计数,如果先算min再回头过滤,别的线程可能在中间把计数改掉,导致”找不到任何一个 worker 的 load 等于刚算出的 min”。所以这里先把所有(idx, load)收集成向量,再用这一份快照取最小、过滤; - 平局随机:多个 worker 同时最闲时,用
choose随机挑,避免所有新请求都压到下标最小的那个上。
即使进入失衡分支,树也会被更新:select_worker_min_load 把 (text, 选中的 worker url) 插进树里。这一点很重要——失衡期间的分配结果也是”以后猜命中率”的证据,不能丢。
如果判定为平衡,就进入缓存感知分支。核心只有几行:
let result = tree.prefix_match_with_counts(text);let match_rate = if result.input_char_count == 0 { 0.0} else { result.matched_char_count as f32 / result.input_char_count as f32};let selected_idx = if match_rate > self.config.cache_threshold { // 按 URL 找到 result.tenant 对应的 worker} else { // 低命中:选 load 最小的 worker(同样是快照后比较 + 随机平局)};tree.prefix_match_with_counts(text) 返回三个量:tenant(命中的最长前缀所归属的 worker URL)、matched_char_count(匹配上的字符数)、input_char_count(输入总字符数)。命中率按字符计,不按 token 计——这是后面要重点讨论的设计取舍。
命中率超过 cache_threshold(当前代码默认 0.5)就走缓存亲和:按 URL 在候选列表里找到那个 worker,并校验它还健康;否则退回最短队列。无论哪条路径,选中后都会 tree.insert(text, workers[idx].url()) 并 increment_processed()。
近似基数树:只认字符,不认 token
树实现在 policies/tree.rs。它是一棵压缩前缀树:每个节点存一段文本(NodeText)、一个字符数缓存、一个 children: DashMap<char, NodeRef>,以及每个租户在该节点上的最后访问时间。
普通基数树以”节点”为单位;这里的树以 “节点 × 租户” 为单位记录。租户就是 worker URL,经 intern_tenant 内部化以避免重复字符串分配。一个节点可以被多个租户”拥有”——因为同一段文本可能被不同的 worker 处理过(例如请求分发后又被驱逐、或不同前缀恰好共用一段开头)。
为什么用字符而不是 token? 文件头注释给了理由:“The tree stores raw text characters instead of token IDs to avoid tokenization overhead.” 路由器在 HTTP 路径上拿到的是原始请求 JSON,分词需要加载词表、逐条编码,而且不同模型词表不同;网关只是要一个”这段前缀像不像”的粗略比例,不需要与 worker 真实 RadixCache 的 token 粒度一致。代价是:一段英文的字符数与 token 数比例与一段中文截然不同,命中率阈值 0.5 在不同语言、不同 prompt 组成下的含义会漂移。这是”零开销”换来的近似。
插入 insert(text, tenant) 是标准的压缩树插入:
- 逐层找
children[first_char],用shared_prefix_count找出与节点文本的公共前缀长度; - 若无匹配:新建叶子,文本为剩余全部内容,写入租户与时间戳,结束;
- 若匹配多于剩余:把节点一分为二——新节点持有公共前缀部分,原节点持有剩余后缀(原节点的子节点挂到新节点下),新节点成为中间节点,原节点成为其子节点;
- 若匹配恰好等于节点全文:继续下沉到下一层;
- 中间节点经过时,若该租户尚不在这个节点的记录里,补上租户并累计
tenant_char_count;但中间节点不刷新时间戳(注释里写的是 “intermediate - no timestamp update”),只有叶子会刷新。
这段逻辑解释了后续 LRU 的真实行为:时间戳近似地记录了”这个租户最后通过这个节点走到了叶子”,而中间节点的”拥有”关系只是为了在驱逐时能顺着父链找到新的叶子。
查询 prefix_match_with_counts 则是从根开始,逐层走:
while !remaining.is_empty() { let first_char = remaining.chars().next().unwrap(); if let Some(matched_node) = prev.children.get(&first_char) { ... } else { break; }}- 完全匹配一层节点文本:累计字符数并继续下沉;
- 部分匹配:累计已匹配的字符数,仍然把
prev设为这个节点,然后break。这是关键:部分匹配时,树能提供的”最像”的租户就是当前节点的租户; - 找不到子节点:直接停,
prev是上一步的节点。
最后确定租户时,有一个值得注意的小优化:
let cached = curr.last_tenant.read();let tenant = if cached 有效 { Arc::clone(cached)} else { // 遍历 tenant_last_access_time,取第一个,并写回缓存};正常情况下,一个节点只属于一个租户,“第一个”就是它;用 last_tenant 缓存是为了避免每次在 DashMap 里迭代。当同一节点有多个租户时,“取第一个”就有点随机——这也是”近似”的一部分:路由器不打算在共享节点上做精确的多租户推断。
最后的时间戳更新是概率性的:
if epoch & 0x7 == 0 { // 1/8 概率 curr.tenant_last_access_time.insert(tenant, epoch);}注释解释:减少 DashMap 上的写竞争,LRU 驱逐不需要精确时间,近似足够。这是一个在高并发路由路径上非常典型的”用精度换吞吐”的决定。
驱逐:按租户计量的近似 LRU
树会无限增长,所以有后台驱逐。CacheAwarePolicy::with_config 在 eviction_interval_secs > 0 时启动一个 PeriodicTask,每轮对每棵树调用 tree.evict_tenant_by_size(max_tree_size)。
驱逐算法(evict_tenant_by_size):
- DFS 遍历整棵树,对每个节点计算
leaf_of(node)——该节点上”自身有、但子节点没有”的租户; - 把这些
(timestamp, tenant, node)放进最小堆,按时间戳升序; - 依次弹出:若该租户的 总字符数
tenant_char_count仍超过max_tree_size,且该节点对这个租户仍是叶子(子节点里都没有该租户),就从节点上移除该租户、把字符数减掉;节点如果既无子节点也无租户就删掉; - 移除后,父节点可能”变成”该租户的新叶子,补进堆里。
这里最重要的计量单位是每租户字符数,而不是节点数。max_tree_size 名字看起来像”树的节点上限”,实际代码默认值是 10000,用于每个 worker 的累积字符数上限,与 --max-tree-size 参数的文档描述(“Maximum nodes in cache tree”)存在字面出入,读源码时应以 tenant_char_count 为准。更准确的理解是:每个 worker 在网关本地有一本”它处理过多少字符的文本前缀”的预算,超额时按租户(即 worker)内部最久未用的叶子逐段释放。
驱逐为什么用”叶子 × 租户”而不是”节点”?因为前缀树的特点是:一条新前缀通常挂在某个已有前缀的下面,新文本往往增加的是叶子,而不是整条链。驱逐最新的叶子,既能把”这条请求当时的完整文本”从推测中抹掉,又不会误伤共享在中间节点上的更老前缀。这与 worker 侧 RadixCache 的 LRU 驱逐是类似的思路,可参考本站 RadixAttention 完全拆解 与 SGLang RadixCache 内部实现 里的真实驱逐逻辑对比。
树键:为什么按 (池, 模型) 分树
代码里树不是一棵,而是 DashMap<String, Arc<Tree>>,键由 make_tree_key(pool, model) 生成,pool_tag 取自 WorkerType:
WorkerType::Regular => "regular",WorkerType::Prefill { .. } => "prefill",WorkerType::Decode => "decode",注释讲得很明白:如果不同池共用一棵树,PD 模式下 prefill→decode 交替分发同一段 prompt 时,“insert(text, url)” 会把同一段文本的租户反复覆盖,缓存感知退化成在池之间来回跳。分树之后,prefill 池与 decode 池各自维护自己的近似缓存账本,model_id 也参与键的构成,多模型部署时同样隔离。
默认参数与它们的含义
CacheAwareConfig::default() 的当前取值:
| 参数 | 默认值 | 含义 |
|---|---|---|
cache_threshold | 0.5 | 前缀命中率超过它才走缓存亲和,否则走最短队列 |
balance_abs_threshold | 32 | 最大最小负载绝对差超过它才”可能失衡” |
balance_rel_threshold | 1.1 | 且最大负载至少是最小的 1.1 倍 |
eviction_interval_secs | 30 | 驱逐周期 |
max_tree_size | 10000 | 每个 worker 租户的累积字符上限 |
需要注意文档与代码的取值差异:官方网关文档的”Cache-Aware Policy Tuning”给的示例值是 --cache-threshold 0.5 --balance-abs-threshold 32 --balance-rel-threshold 1.5 --eviction-interval-secs 120 --max-tree-size 67108864,并注明默认值是 0.3 / 64 / 1.5 / 120 / 2^26。这套值与早期 sgl-model-gateway 的默认值差别很大,说明这块参数在演化;读源码时以当前检出(sgl-model-gateway 主分支)为准,并确认 --router- 前缀下的实际 CLI 默认。本文后面讨论阈值含义时,都按源码值 0.5 / 32 / 1.1 / 30 / 10000 来。
参数怎么选,直觉很直接:
cache_threshold太低(如 0.1),一个只有很少共同开头的请求也会被送往”命中最多”的 worker,造成热点;太高(如 0.9),只有几乎完全相同的前缀才会被归拢,共享前缀在中间位置的请求被分散,命中率上不去;balance_rel_threshold1.1 意味着只要最大负载比最小多 10% 且绝对差超过 32,就优先均衡;这对低 QPS 场景偏激进,高 QPS 场景下 1.5 更常见;max_tree_size越大,网关越”记得住”历史,但内存和驱逐成本也涨;它应当与每个 worker 的真实 KV 容量相匹配,否则网关认为”这里有缓存”而 worker 早已驱逐,命中率会虚高。
与 worker 侧前缀缓存的衔接
网关的近似树回答的是”哪个 worker 大概有”,而 worker 内部是否真的命中,仍然由引擎的 RadixCache 判断并可选择从多级存储回填(HiCache 等,可参考本站 SGLang HiCache 分层缓存)。所以缓存感知路由的最终收益是:提高到达 worker 后一次命中 RadixCache 的概率。它不会伪造命中,最坏情况只是一条冷请求。前文提到本站还有一篇 前缀缓存命中之后:五个推理框架如何把一段旧 KV 接进一次新前向,讲的正是”命中之后”的那段路径;本文关心的则是”命中之前”如何被路由到正确的那台机器。
其他策略:负载、桶、一致性哈希与显式指定
缓存感知不是唯一的选项。policies/ 目录下还有几种策略,它们在不同负载形态下各有位置。
power_of_two:两选一的最轻者
PowerOfTwoPolicy::select_worker 的思路来自负载均衡里的经典 “power of two choices”:随机抽两个健康 worker,选负载较低的那个。代码里有个 O(1) 保证两不相同的技巧:
let idx1 = rng.random_range(0..healthy_indices.len());let idx2 = (idx1 + 1 + rng.random_range(0..healthy_indices.len() - 1)) % healthy_indices.len();idx2 用”偏移 1 + 随机”的方式,保证 len ≥ 2 时一定与 idx1 不同,不需要循环重抽。
负载度量由环境变量 SGLANG_ROUTER_P2C_LOAD_METRIC 决定,有三种:
tokens(默认):优先比较轮询得到的 token 负载(cached_loads),缺失时退回在途请求数;requests:优先比较在途请求数,相等时用 token 负载破平;least_requests:在所有有轮询负载的 worker 中,按(在途请求, token 负载)取最小,随机起点保证平局分散。
cached_loads 来自控制面的 Load Monitor:worker_manager.rs 里的 fetch_loads 定期请求每个 worker 的 /v1/loads?include=core,parse_load 对 DP-aware worker 按 dp_rank 从 loads[] 里取 num_total_tokens,非 DP worker 把 loads[] 求和,老接口则读 aggregate.total_tokens。轮询失败(-1)的 worker 会被过滤掉,让策略退回”在途请求数”这一本地度量。PD 模式下文档建议 decode 侧用 power_of_two、prefill 侧用 cache_aware:解码的代价主要由负载决定,而不是前缀命中。
bucket:按前缀长度分桶的有序路由
BucketPolicy 是为 PD 场景设计的另一种思路。它按请求字符数把 prefill worker 划分成有序的区间(Boundary { url, range: [usize; 2] }),先用二分查找 find_boundary(char_count) 找到负责这个长度区间的 worker;同时在负载失衡时退回最短负载的 prefill worker。
关键机制是 adjust_boundary 的周期性重划:
- 每
bucket_adjust_interval_secs触发一次(默认 5 s); - 如果新的”每桶平均负载”与旧的相差不超过 2 倍(且旧值非零),认为无需调整,直接返回;
- 否则把当前所有请求的字符数收集成
hist_load排序,按”每个 worker 承担约总负载 / worker 数字符”的方式,从开头累加切分出新的区间。
注意文档里描述的是 bucket 策略在 worker 池上的表现,而源码的分桶只对 prefill worker 的 URL 进行,负载也只计入 post_process_request 里进来的请求字符。它解决的是”不同长度的 prefill 代价差异巨大”的问题:一条 128K 的 Prefill 和一条 512 的 Prefill 落在同一 worker 上,前者会长时间占用它。按长度分段分配可以把长短请求摊开。
更细的一层:select_worker 的三级优先级
consistent_hashing 的源码比文档描述得更细:select_worker_impl 实际有三级优先级,外加一个随机兜底:
X-SMG-Target-Worker:直接按 worker 下标路由。解析失败、越界、或该 worker 不健康时返回None,不退回一致性哈希——这是”显式指定即契约”的语义,调用方需要自己处理”目标不可用”;X-SMG-Routing-Key:以该 key 走一致性哈希环;- 隐式 key:依次取
authorization、x-forwarded-for、cookie作为隐式 routing key,实现”同一个客户端粘到同一 worker”; - 随机:三者都没有时,在健康 worker 中随机选,分支标签为
random_fallback。
每一级都会打 record_worker_consistent_hashing_policy_branch,四个分支 target_worker_hit / target_worker_miss / routing_key_hit / random_fallback 在生产上可直接用来判断”有多少请求其实没有任何亲和信息”。如果 random_fallback 占比很高,说明网关只是在一致性哈希的壳上做随机分布,应考虑换回 power_of_two 或加缓存感知。
环查询用的 WorkerRegistry 里维护的 HashRing,find_healthy_url 在顺时针查找时传入一个”当前健康 URL 集合”的可达性判定,因此环本身可以在 worker 状态变化时不必每次重建。
prefix_hash:按前缀 token 哈希的轻量替代
如果不想承担”每个 worker 一条完整字符历史”的内存,policies/prefix_hash.rs 提供了一个更轻的 KV 感知方案。它的注释里有一张对照表值得原样保留:
| 维度 | prefix_hash | cache_aware(基数树) |
|---|---|---|
| 查询 | O(log n) | O(prefix_len) |
| 内存 | O(workers × vn) | O(total_tokens) |
| 更新 | O(1) | O(prefix_len) |
| 精度 | 前缀分组 | 精确匹配 |
算法是”取前缀 token 的哈希,再走一致性哈希环”:
- 从
SelectWorkerInfo.tokens取前prefix_token_count(默认 256 个 token)——注意它需要 token,所以只能用于 gRPC 路由或已带 token 的路径,HTTP 路由下tokens: None,策略会返回None(分支no_tokens); - 把 token
u32数组按字节切片,用 xxh3 求 64 位哈希; - 以十六进制字符串作环上的 key,找到初始 worker;
- 如果初始 worker 的负载超过”
(总负载 + 1) / worker 数 × load_factor”(默认load_factor = 1.25),则在所有负载可接受的 worker 里取最小负载;若全部超载,仍用初始 worker。
这里有个与 cache_aware 的本质差异:prefix_hash 不维护增量历史。同一前缀无论什么时候来,哈希一样,环一样,落点一样——它比近似树更”确定”,但也更”僵”:worker 数量变化会让环重排,所有前缀一次性重新散开;前缀命中与否完全不反映”这些前缀以前有没有真的走过这个 worker”。它适合”前缀集合相对固定、worker 集合稳定”的场景,而 cache_aware 适合”前缀不断新增、网关需要跟着学习”的场景。
consistent_hashing:会话亲和与显式指定
ConsistentHashingPolicy 支持两件事:
- 请求头
X-SMG-Routing-Key:以它为 key 做一致性哈希,映射到会话/缓存亲和所需的 worker。与缓存感知不同,它不依赖历史,而是用 key 本身决定去向; - 请求头
X-SMG-Target-Worker:按 worker 下标(0 起)直接指定。若目标不可用或不存在,返回None,上层会走保底路径。
哈希环在 worker 增减时构建一次,查询时 O(log n) 二分,然后顺时针找到第一个健康 worker。目录注释里给出了复杂度:“O(n) to build healthy URL map + O(log n) ring lookup + O(k) walk”,k 是连续不健康 worker 的个数。WorkerRoutingKeyLoad 在 worker 侧维护一个 active_routing_keys 计数(每个 routing key 的在途请求数),用来观测”某个 key 是否把某 worker 拖住”。
一致性哈希与缓存感知有互补性:缓存感知依赖”网关看到过什么”,一致性哈希依赖”调用方知道该给谁”。对同一个用户会话必须落在同一 worker 的场景(不共享 KV、但要求稳定的专家缓存或 LoRA),一致性哈希更可靠;对无需稳定性的共享前缀负载,缓存感知能自动发现热点。
random 与 round_robin
random 与 round_robin 是基线策略。它们在无共享前缀、无状态、纯压测场景下都足够。这里有一个实务上的细节:朴素 DP 模式内置的就是后几种:文档明确写 native DP 的局限是 “Built-in in-process load balancing only (e.g., round_robin, total_requests, total_tokens), No cache-aware routing”,并强烈建议生产用 SMG(也就是本文这个网关)。
负载计数:load() 是谁在加、谁在减
缓存感知的”最短队列”分支与 power_of_two 的”在途请求数”都依赖 worker.load()。这个数字看着简单,实际上是一个跨响应生命周期的 RAII 计数,理解它的加减小节后,前面很多策略的取舍才讲得通。
WorkerLoadGuard:请求发出时加,响应读完时才减
regular 路由的 route_typed_request_once 在选中 worker 后:
let load_guard = ["cache_aware", "manual"] .contains(&policy.name()) .then(|| WorkerLoadGuard::new(worker.clone(), headers));也就是说,只有 cache_aware 与 manual 两种策略会维护这个 guard。power_of_two 用的是 worker 内部另一套原子计数(在 select_worker 里 increment_processed()),而不是这个 guard——两者口径不同,指标上也分开。
WorkerLoadGuard::new 做两件事:worker.increment_load(),如果请求带 X-SMG-Routing-Key,再对 worker_routing_key_load() 里该 key 的计数加一。Drop 时对称地减一。问题在于:如果 guard 在 route_typed_request_once 返回时就 drop,而流式响应还在后台继续推字节,负载会在响应还没读完时就被减掉,cache_aware 看到的”在途数”会系统性偏低。
源码因此把 guard 挂到响应体上:流式路径用 AttachedBody::wrap_response(response, guard),guard 的生命周期与 HTTP 响应体绑定——直到客户端真正读完或断开连接,load() 才减一。注释写得很明确:“Guard is dropped when response body is consumed or client disconnects”。这是一个非常实际的语义:
- 慢客户端会延长它在 worker 上的在途计数,
cache_aware会看到该 worker 更”忙”,进而更早触发均衡; - 客户端中途断开,
AttachedBody被 drop,guard 随之减一,不会有泄漏; - 非流式请求在响应体被读取完后 drop,时机与”请求真正结束时”一致。
这套设计让 load() 的语义从”网关手里的请求数”变成了”worker 身上仍在被消费的流数”,更贴近 worker 的真实占用。
熔断结果也挂在流上
同一个路径里还有 BreakerTrackedStream:把 reqwest 的字节流包起来,在 drop 时恰好一次更新熔断器的结果——干净结束记成功,流内错误记失败,客户端断开则两者都不记;非 2xx 响应在包装前预先 mark_errored(),避免”错误体很干净地流完”被误记为成功。注释里还补了一句:如果 send() 在拿到响应流之前就失败,流式分支会提前 record_failure,避免 TCP 层持续失败的 worker 永远留在可选集合里。
对 PD 路由,prefill 侧同样有 WorkerLoadGuard(_prefill_guard),因为 prefill 是一次完整读取,生命周期与响应一致;decode 侧若流式,则由 AttachedBody/BreakerTrackedStream 承担。这也是为什么 PD 路由的 load() 更接近”两侧同时在跑”的实际情况。
对策略的影响
把”load 在响应读完前不减少”与前面两条策略对照:
cache_aware的失衡判定用min/max load。慢流会把某个 worker 的 load 顶上去,让网关以为它”忙”;这正是想要的——慢流确实占着 worker 的 slot;power_of_two的Requests模式用的是 worker 的原子在途数,而非load(),两者的加减点不同,指标上会出现细微偏差;bucket的chars_per_url统计的是发出请求时的字符数,并在时间窗口period后回冲。它不关心响应是否读完,更关心”过去窗口里这个 worker 承担了多少 prefill 字符”。两种口径对同一批慢请求的解读不同:一个看”还在占”,一个看”窗口内过账”。
注册与控制面:worker 是怎样进入路由视野的
缓存感知树要靠 worker 的 URL 作为租户,负载轮询要靠 worker 的 base URL 聚合,熔断器与健康状态也挂在每个 worker 上——所以”worker 从哪里来”是理解网关行为的前置问题。
两种来源
- 静态:启动时通过
--worker-urls或--dp-size提供 URL 列表。网关会启动后逐个探测,读取能力,随后写进注册表; - 动态:HTTP
POST /workers。WorkerService::create_worker(core/worker_service.rs)的实现顺序值得一读:
config.dp_aware = self.router_config.dp_aware;let worker_url = config.url.clone();let worker_id = self.worker_registry.reserve_id_for_url(&worker_url);let job = Job::AddWorker { config: Box::new(config) };self.get_job_queue()?.submit(job).await?;先预留 worker id、再提交 Job::AddWorker,返回 {"worker_id":..., "url":..., "location":"/workers/<id>"},调用方可以轮询 location 看注册进度。预留 id 是为了让并发注册同一 URL 时能一致地返回同一个 id,而不是等到写入阶段才发现重复。
这里有一个容易踩的日志:如果网关配置了 api_key 而新增的 worker 没有带 api key,会打印警告(“Worker will be accessible without authentication”)。这说明 worker 的认证凭证是每个 worker 单独配置的,不是从网关全局继承。
worker 的能力与身份
Worker trait 把”能用来路由的全部门面”都放在一张表上:url()、api_key()、worker_type()、connection_mode()(HTTP / gRPC)、bootstrap_host()、bootstrap_port()、is_healthy()、load()、worker_routing_key_load()、processed_requests()、metadata()、circuit_breaker()、dp_rank()、dp_size()、model_id()、priority()、cost()、supports_endpoint()……
其中几个字段直接决定了路由行为:
worker_type():regular / prefill / decode,决定了它进哪个候选池、在哪棵树上;connection_mode():HTTP 还是 gRPC,决定了它走哪条路由(RouterManager 的打分就基于此);dp_rank()/dp_size():DP-aware 的虚拟 URLbase@rank与负载拆分的依据;priority()/cost():RouterManager选中路由后,理论上可以在路由内部再做优先级/成本裁剪(源码里这两个字段有 getter,但当前RouterManager尚未把它们用于路由评分,源码里以 TODO 的形式写着”Once routers expose worker stats, we can evaluate average worker priority vs priority_threshold”);is_dp_aware():为 true 时,base_url()用于聚合(共享引擎的多 rank 只算一个引擎)。
注册表 WorkerRegistry 提供 get_by_model()、get_prefill_workers()、get_decode_workers()、get_all()、get_worker_distribution() 等视图,并持有每个模型的 HashRing。路由层的每个策略拿到的是已经按池与模型过滤过的一小段 &[Arc<dyn Worker>],策略本身并不懂”模型”与”PD”,它只对一个 worker 切片做选择。这种分层让策略可以被任意组合,也解释了为什么 cache_aware 需要按 (pool, model) 分树——选择器拿到的切片是”同一池、同一模型”的 worker,但树是策略内部跨请求积累的,必须知道自己在为哪个池记。
负载轮询与策略的耦合
LoadMonitor(worker_manager.rs)是一个 tokio::spawn 的后台循环:
let power_of_two_policies = policy_registry.get_all_power_of_two_policies();if power_of_two_policies.is_empty() { continue; // 没有 P2C 策略就不轮询}let result = WorkerManager::get_all_worker_loads(&worker_registry, &client).await;这个 continue 很关键:只有当配置里至少有一个 power_of_two 策略时,网关才会持续向所有 worker 请求 /v1/loads。纯 cache_aware 部署不会产生这组额外请求——缓存感知只需要”网关自己记的 load 计数”(worker.increment_load()/decrement_load() 在请求生命周期里维护)。
拿到快照后,失败的(-1)被丢弃,避免旧值/错误值污染;成功的通过 watch::Sender 发布给所有 P2C 策略。这里还有一处需要注意:parse_load 对非 DP worker 是把 loads[] 全部求和,对 DP-aware worker 是按 dp_rank 取单条目。如果 worker 对外暴露了多个 DP 条目而网关把虚拟 URL 配成非 DP,就会把 N 个 rank 的负载加成一个数字,然后在 N 个虚拟 worker 之间平摊——这是配置与实现不匹配时的典型误读。
manual:比一致性哈希更强的粘性
policies/manual.rs 是一个容易被忽略但很实用的策略。它的文件头把定位写得很清楚:按 X-SMG-Routing-Key 做手动粘性路由,与一致性哈希的区别是三条:
- worker 增加时不重分配任何会话(一致性哈希会移动约 1/N 的 key);
- 只有当会话被分配的 worker 变得不健康时才重新映射;
- 每个 routing key 维护最多 2 个候选 worker(
MAX_CANDIDATE_WORKERS = 2),用于快速故障转移。
数据结构是 DashMap<RoutingId, Node>,Node { candi_worker_urls, last_access }。命中已存在的 key 时刷新 last_access,在候选列表里找健康 worker;找不到就按配置的分配模式选一个新的,并 push_bounded 进候选列表(超过 2 个就从头部移除最旧的)。分配模式有三种:
Random:随机;MinLoad:选worker.load()最小;MinGroup:选worker_routing_key_load().value()最小——也就是”当前活跃 routing key 数最少”的 worker,用来避免把太多会话压到同一个 worker 上。
后台每 eviction_interval_secs(默认 60 s)清理 last_access 超过 max_idle_secs(默认 4 小时)的会话条目。对”会话状态存在 worker 本地、丢了就真的丢了”的场景(本地对话历史、agent 工作区),manual 的强粘性比一致性哈希更合适:它宁可让负载不均,也不让会话漂移。代价是 worker 故障时这些会话会被重新分配,状态无法恢复——这与”缓存感知只管 KV、丢了可以重算”是两种不同的容错语义。
prefill/decode 分离:一次请求如何在两侧配对
PD 分离是 SGLang 规模部署的默认形态:prefill worker 只做预填充,decode worker 只做逐 token 解码,两侧的 KV 通过传输层交接(PD 分离本身的机制可参考本站 DistServe 完全拆解 和 GLM-5.3 的 PD 分离控制面)。在网关这一侧,PD 路由需要多解决两个问题:一次请求要同时选中一对 worker,以及两侧要怎么对上号。
选一对:先 prefill 后 decode
pd_router.rs 里的 select_pd_pair 很简单:
let prefill = self.select_worker(request_text, model_id, headers, false).await?;let decode = self.select_worker(request_text, model_id, headers, true).await?;select_worker(decode=false) 从 prefill 池取候选、用 prefill 策略(推荐 cache_aware);decode=true 从 decode 池取候选、用 decode 策略(推荐 power_of_two)。两个池的候选列表由 get_prefill_workers() / get_decode_workers() 给出,有模型名时再按模型过滤并检查 WorkerType 是否匹配。
pick_worker_by_policy_arc 在调用策略前做了两次过滤:
workers.is_empty()直接报 “No prefill/decode workers available”;- 过滤掉
!w.is_available()的 worker——is_available同时检查健康与熔断状态,所以”熔断打开”的 worker 不会进入候选; - 策略返回
None时报错,而不是静默兜底。
这种”不可用即报错”的选择让错误可以被重试机制捕获(见后文的 RetryExecutor),而不是把请求发给一个确定会失败的下游。
bootstrap:让两侧”约好在同一个房间见面”
PD 分离里有个不易解释的现象:prefill 要把它算出的 KV 交给 decode,谁也不知道对面的地址。SGLang 的 SRT 用了 bootstrap 机制:两侧通过一个约定好的地址与端口,以及一次性的房间号互相发现并建立传输连接。网关的角色是:在把请求发给 prefill 之前,把 bootstrap 坐标注入请求体。
inject_bootstrap_into_value 就是在做这件事,注入四个字段:
bootstrap_host:prefill worker 的bootstrap_host();bootstrap_port:prefill worker 的bootstrap_port()(WorkerType::Prefill { bootstrap_port }里携带,可能是None);bootstrap_room:随机房间号,generate_room_id()生成[0, 2^63-1]内与 Pythonrandom.randint(0, 2**63 - 1)兼容的值;- 如果是批量 prompt(
CompletionRequest.prompt是数组),注入的是数组:每个元素一套 host/port/room,容量等于batch_size = arr.len()。
这样 prefill 侧才知道去哪广播 KV、decode 侧才知道去哪接 KV,房间号保证并发请求之间不串线。
还有一个容易漏的细节:inject_prefill_dp_rank_for_decode 把 prefill worker 的 dp_rank 以 disagg_prefill_dp_rank 字段注入发给 decode 的请求。当 prefill 本身按 DP 切分(DPA),KV 可能驻留在某个 prefill DP rank 的显存里,decode 侧要按 rank 去找对应的数据源。这个字段是纯路由信息,不影响引擎的语义。
DecodeGate:按 prefill 控制 decode 的并发
routers/http/decode_gate.rs 里有一个很小的结构,但作用不小:DecodeGate 为每个 prefill URL 配一个 Semaphore,初始许可数为 decode_dispatch_limit;请求向 decode 发起前先 admit(prefill_url, slot) 拿到许可,DecodeSlot 在请求结束时释放。
它的目的不是限流 decode,而是给单个 prefill 的后继 decode 设一个上限。一个 prefill 可能在同一时间段内派生出很多 decode 流,如果 decode 侧被同一 prefill 的上百条流塞满,这个 prefill 后面请求的尾延迟会被拉长;按 prefill 维度限并发可以把压力摊平到其他 prefill 上。若网关配置里没有 decode_gate(self.decode_gate.is_none()),PD 路由走 select_pd_pair 同时选一对;否则先只选 prefill,由 gate 在真正开始 decode 前再决定时机。
可靠性:重试、熔断、限流、健康检查
路由层最危险的不是”选得不够优”,而是”选到一个坏 worker 后把整条链路拖垮”。网关为此叠了四层保护,全部在路由路径上。
重试:退避 + 抖动
core/retry.rs 里 BackoffCalculator::calculate_delay:
其中 jitter_n 在 [-jitter_factor, +jitter_factor] 内均匀取值,并把下限钳制到 -delay,最终不为负。默认参数在文档里是:--retry-max-retries 5、初始 50 ms、上限 5000 ms、乘子 2.0、抖动 0.1,可重试状态码为 408/429/500/502/503/504。源码里 let max = config.max_retries.max(1),is_last = attempt + 1 >= max,因此这个数字是总尝试次数的下限语义:最多尝试 5 次(含首次),而不是”失败后再重试 5 次”。
RetryExecutor::execute_response_with_retry 把一次”尝试”包装成闭包,只有状态码可重试才继续;每次重试都重新选 worker(PD 路由的重试闭包里,select_worker/select_pd_pair 在循环内部调用)。这意味着重试不是”对同一个坏 worker 再打一次”,而是”换一个候选再试”——这是它与普通 HTTP 客户端重试的关键差别。
熔断器:无锁三态机
core/circuit_breaker.rs 是每个 worker 一个的熔断器,状态用 AtomicU8 存(Closed=0 / Open=1 / HalfOpen=2),状态迁移用 CAS 完成:
Closed:累计连续失败数,达到failure_threshold(默认 5)转Open;Open:所有请求被can_execute()拒绝;check_and_update_state_returning在读取状态时顺便检查”距离上次状态切换是否已超过timeout_duration(默认 30 s)“,超过则 CAS 迁移到HalfOpen并清零计数;HalfOpen:放行少量请求试探;累计连续成功达到success_threshold(默认 2)回到Closed;任何一次失败立刻回到Open。
两个细节:
- 状态读取本身就是状态机的一部分:
can_execute调的state()会触发Open → HalfOpen的转换,不需要后台线程定时扫描; - 计数是按”连续”计,而不是按窗口。源码里
window_duration字段目前只在配置里存在,实际迁移判定用的是连续计数。理解这一点可以避免误以为”60 s 窗口内失败 5 次”就会熔断。
在 PD 路由里,record_outcome 的时机有额外考虑:prefill 是非流式、被完整读取后才返回,所以 prefill 的结果在拿到响应时就能记录;decode 若是流式,拿到 200 时流还没读完,源码用 BreakerTrackedStream 包住字节流,在流被 drop(真正结束或中断)时再记录——这样”200 之后断流”不会被误记为成功。
限流与排队
文档里给的是 TokenBucket 的 CLI 参数:--max-concurrent-requests(并发上限)、--rate-limit-tokens-per-second(每秒令牌)、--queue-size(排队长度)、--queue-timeout-secs(排队超时)。行为是:超出并发上限的请求进入 FIFO 队列;队列满返回 429,排队超时返回 408。
core/token_bucket.rs 的 TokenBucket 是经典实现:capacity 与 refill_rate,try_acquire 非阻塞,acquire_timeout 带超时;return_tokens_sync/tokens 允许请求失败时把消耗的令牌退回去。文档里令牌桶是按秒补充的速率,和”每个请求消耗多少令牌”的组合决定了实际限速。需要注意:这里的令牌是限流用的抽象令牌,和 LLM 的 token 数无关,不要把它与 SGLANG_ROUTER_P2C_LOAD_METRIC=tokens 里的 token 负载混淆。
健康检查:就绪态与熔断状态分开算
Worker trait 的 is_healthy() 与 is_available() 是两件事:前者是健康探测结果,后者是”健康 且 熔断器允许执行”。所有策略先通过 get_healthy_worker_indices 只看健康 worker;PD 路由的 pick_worker_by_policy_arc 再叠加 is_available。
HealthConfig 里可配置探测间隔、超时、成功/失败阈值(--health-check-interval-secs 30、--health-success-threshold 2、--health-failure-threshold 3);探测端点默认 /health,对 HTTP、gRPC 分别实现。check_health_async 失败时更新健康状态,但不会直接打开熔断器——两者是独立的旋钮:健康检查是”这个 worker 还活着吗”,熔断器是”它最近对我们的请求稳定失败吗”。前者多用于进程挂死/端口不通,后者多用于”活着但一直接 5xx”。
流式响应的最后一公里:PD 把两条流拼成一条
PD 路由最复杂的一段不是选 worker,而是把 prefill 与 decode 的应答合并成一条客户端可见的流。这段逻辑集中体现了”网关必须在两侧生命周期之间做翻译”的难度。
为什么需要一条自建泵
在 PD 模式下,客户端只调一次 /v1/chat/completions,但网关要:
- 先向 prefill 发一次非流式请求,等它完整返回,拿走它携带的 logprob 等元数据;
- 再把请求(带 bootstrap 坐标)发给 decode,decode 返回 SSE 流;
- 把 prefill 返回的元数据合并到 decode 流中,再转给客户端。
create_streaming_response 用一个 tokio::spawn 起了一个”泵”,把 decode 的 BreakerTrackedStream 逐块读出来,写入 mpsc 通道,再由 UnboundedReceiverStream 转成响应体。核心循环是:
tokio::select! { biased; chunk_result = tracked.next() => { ... } _ = tx.closed() => { break; } // 客户端断开}biased 让”上游有块”优先于”客户端断开”被检查:已经由 reqwest 生产出来的块先送到客户端,再拆掉循环。tx.closed() 分支处理客户端中途离开——上游流被 drop,reqwest 的 HTTP 连接关闭,引擎进而中止生成。没有额外的心跳、没有后台任务泄漏,因为断连就是一次 drop。
两处细节:logprob 合并与 [DONE] 语义
- logprob 合并:prefill 侧返回的
prefill_logprobs需要与 decode 流的每一块合并(merge_streaming_logprobs),让客户端在流式中看到 prefill 阶段的概率信息。这是把”两段响应”粘成”一段响应”最直观的部分; [DONE]的处理:流中一旦出现data: [DONE],先tracked.mark_completed()再tx.send,然后 break。注释解释:上游已经干净结束,即使客户端此时已不再监听,该 worker 也应当记一次成功。mark_completed在已标记 Errored 时是 no-op,所以合成错误路径不会被这段覆盖。
双向负载计数:两个 guard 一起挂到响应体
流式 PD 响应在收尾处这样构造:
let guards = vec![ WorkerLoadGuard::new(prefill, headers.as_ref()), WorkerLoadGuard::new(decode, headers.as_ref()),];AttachedBody::wrap_response(response, guards)也就是说,prefill 与 decode 两个 worker 的负载计数,都从流开始一直被记到客户端读完/断开。这与前文的”load 在响应读完前不减”一致,也让 cache_aware(prefill 侧)与 power_of_two/decode_gate(decode 侧)看到的是”仍在被消费的流”。prefill 虽然早已返回元数据,但它承担的 KV 交接在 decode 流期间仍未真正结束(decode 可能还在读它传过来的 KV),所以把 prefill 的 guard 挂到客户端流上在语义上是合理的。
非 2xx 的 decode 错误由 handle_decode_error_response 合成一个单块 SSE 错误包;包装前用 !(status.is_success() || status.is_client_error()) 预标记 Errored——4xx 视为客户端错误,不算 worker 的锅,5xx 才让熔断器记账一次失败。
对路由的连带影响
这段”最后一公里”解释了 PD 路由里几个策略选择的合理性:
- prefill 的选法用
cache_aware:前缀命中主要发生在 prefill; - decode 的选法用
power_of_two或bucket:decode 的代价与”流持续多久”直接相关,需要把慢流分散; DecodeGate的许可一直持有到流结束,等价于”这条 prefill 派生的 decode 还在占用配额”;- 客户端断开即释放所有 guard,不会因为流没读完而把 worker 永久标记为”忙”。
如果不理解这段,很容易把”网关的 load 偏高”误判成 worker 真的卡住,而实际上是某个慢客户端的流还没读完。
DP Attention:网关视角下的”一个 worker 内部还是多个”
DPA(Data Parallelism Attention)是 SGLang 针对 MLA 模型的一个优化:在 TP 组内部再切出 N 个注意力数据并行组,每个组有独立的调度器与 KV cache,而 FFN 仍按 TP 切分。官方 DP/DPA/SMG 指南 给出的动机很直接:DeepSeek 这类 MLA 模型只有 1 个 KV head,TP=8 时 8 张卡会各自复制整份 KV,显存被浪费、batch 变小。
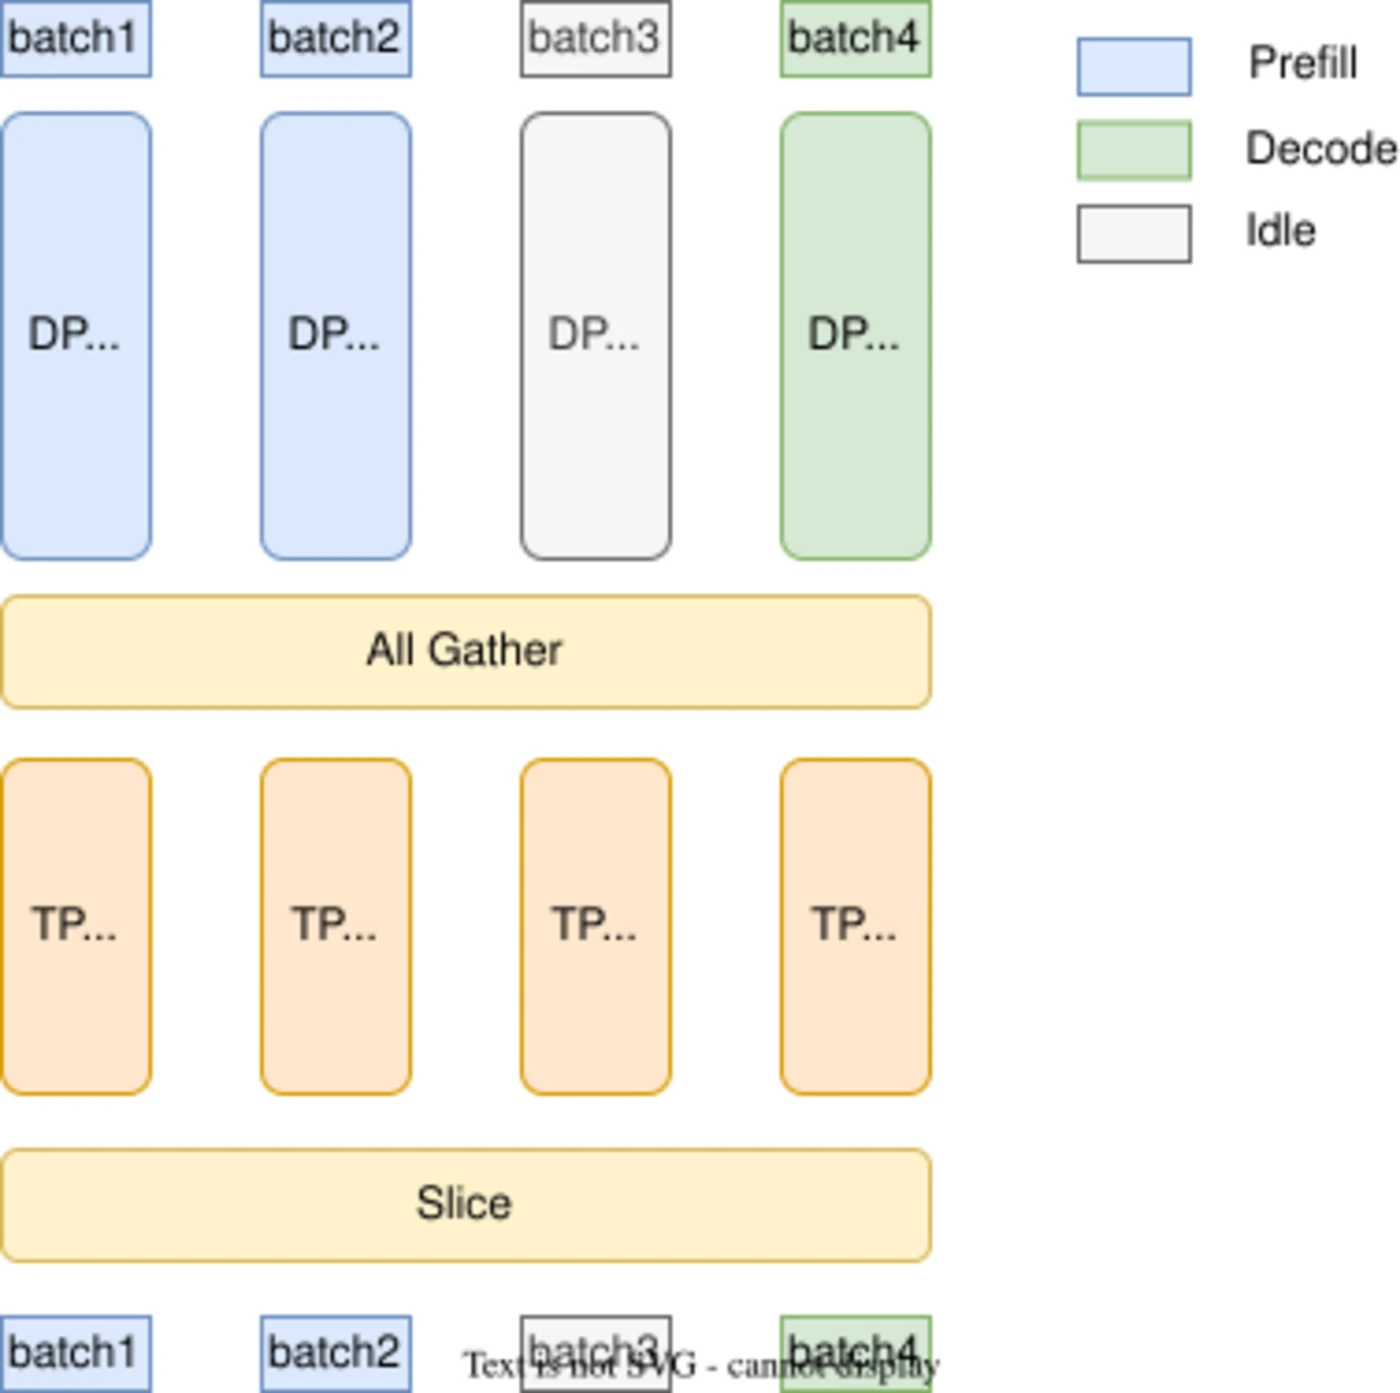
上图是 SGLang 官方文档中的 DPA + EP 架构示意(图源:SGLang DP/DPA/SMG 指南)。每个 DP replica 独立处理 batch、持有自己的 KV cache(不复制);MoE 层通过 All2All Dispatch 把 token 送至专家子组、再 Combine 回原位置。对网关来说,关键信息是:DPA 的 N 个注意力 DP rank 是同一个服务进程组内的 N 个逻辑”引擎入口”,但共享同一个 URL 前缀。
这就引出一个与本文主题高度相关的工程事实:DPA 的多个 DP rank 共享同一个引擎 HTTP 端口,网关的 Worker 抽象里用虚拟 URL base@rank 来描述这种关系(worker.rs 的注释里说得很清楚:“DP-aware workers share one engine (url() is a virtual base@rank)”)。
worker_manager.rs 的 get_all_worker_loads 因此做了专门处理:
if matches!(worker.connection_mode(), ConnectionMode::Http) { engines.entry(worker.base_url()).or_default().push(worker);}同 base_url 的 worker 被聚成一个 engine,对每个 engine 只请求一次 /v1/loads,再按每个 worker 的 dp_rank 从响应 loads[] 里选对应条目。如果 N 个 DP rank 各自被请求一次,网关侧就会看到 N 倍放大的负载采样成本。
在路由侧,dp_rank 还承担一个职责:PD 路由里 prefill 若是 DPA,就要把 disagg_prefill_dp_rank 注入 decode 请求(前文已讲)。这说明 DP-aware 不只是 URL 书写方式的方便,而是网关必须知道”逻辑 worker” 与 “物理引擎 + 逻辑 rank” 的区分。
文档还补充了一个容易踩的坑:--dp-size 与 --attn-dp-size 会合并成 dp_size × attn_dp_size 个 DP rank(各自一个调度器),两者总有一个为 1;/server_info 分开报告 ds_size(replica 数)与 attn_dp_size(每个 replica 内的注意力 DP 数),但 KV 事件描述、PD prefill server info、负载快照里出于兼容性仍保留名为 dp_size 的字段来代表 DP rank 数。读代码时不能按字段名想当然。
树的实现细节:UTF-8、字符计数与并发
近似基数树的代码之所以比概念复杂,是因为它要在高并发、UTF-8、内存受限三个约束下工作。把实现层的关键点列出来,可以解释很多”看起来奇怪”的写法。
字符数为什么被缓存
NodeText 不只是 String,而是 { text, char_count }。原因是树的判定全靠”字符数”:
insert比较公共前缀后,要按字符切分节点;prefix_match_with_counts要返回matched_char_count;- 驱逐按
tenant_char_count扣减。
而 Rust 的 String::len() 返回的是字节数,一个中文字符通常是 3 字节。若把字节数当字符数,中文 prompt 的命中率会被系统性高估(分母偏大、分子也偏大,比例却可能扭曲),驱逐预算也会偏大三倍。所以 NodeText 在构造时算一次 chars().count(),之后所有比较都用缓存值。文件开头的注释专门提醒:“in rust, .len() or slice is operated on the “byte” level. It causes issues for UTF-8 characters because one character might use multiple bytes.”
ASCII 快路径与 UTF-8 慢路径
shared_prefix_count(a, b) 先按字节比较,若公共前缀全是 ASCII,字节数就是字符数,直接返回;否则退回 shared_prefix_count_chars 逐字符比较。advance_by_chars 与 take_chars 也是同样的思路:ASCII 可以直接切片,UTF-8 用 char_indices 找到第 N 个字符的字节边界。
这是路由热路径上非常实际的选择:多数 prompt 的系统提示词与模板部分是 ASCII(英文指令、JSON、代码),只有内容部分是中文。按字节先比可以在最常见的情况下省掉一次 UTF-8 扫描。
每个节点一把小锁,而不是整棵树一把大锁
树节点的结构大致是:
struct Node { text: RwLock<NodeText>, children: DashMap<char, NodeRef, CharHasherBuilder>, parent: RwLock<Option<NodeRef>>, tenant_last_access_time: DashMap<TenantId, u64>, last_tenant: RwLock<Option<TenantId>>,}children是DashMap,按首字符分片;并发插入/查询不同首字符时互不阻塞;- 自定义
CharHasherBuilder:字符的分布本身均匀,用简单的混合哈希即可,省掉 SipHash 的开销; text与parent用parking_lot::RwLock,读多写少;tenant_last_access_time也是DashMap,因为驱逐线程与路由线程会同时读写。
insert 里的 prev.children.entry(first_char) 使用了 Entry API,保证”检查是否存在 + 插入新节点”是原子的;在拆分节点时,代码先 drop(matched_node_text) 释放读锁,再创建新节点、重挂 parent、写入文本——避免在持有读锁时分配内存或拿另一把写锁造成死锁风险。这类”先取数据、早释放锁、再构造”的写法在树代码里反复出现。
根节点的 children 是全局热点:每条请求都要查它的第一个字符。分片能缓解,但若所有请求都以同一个字符开头(例如都以 { 或 # 开头),仍会竞争同一个分片。这是无锁设计无法完全消除的成本,也是 prefix_hash 这类”不算树”的替代方案存在的理由之一。
内存账:每个节点存一段文本,每个租户记一笔字符数
近似树的内存由三部分组成:
- 节点文本:所有插入过的前缀的去重并集。共享前缀只存一份,这是基数树相对”每条请求存一份”的最大优势;
- 每个节点上的租户表:同一个节点可能被多个 worker 走过,条目数最多为 worker 数;
tenant_char_count:每个 worker 的累计字符数,用于驱逐预算。
因此它的内存大致是 O(不同前缀的总字符数 × 共享节点的租户重复度)。当所有 worker 都处理过同一段超长系统提示词时,这段文本在树里只存一份,但每个节点上都有 N 个租户条目;这部分开销与 worker 数成正比,是”多 worker 共享前缀”场景下需要留意的。
max_tree_size 限制的是每个租户的字符数,不是全局节点数。它的作用更像”每个 worker 的推测记忆预算”:worker 越多,总内存约等于 worker 数 × max_tree_size(再叠加共享节点的文本)。当前源码默认 10000,意味着每个 worker 只记住约一万字符的请求历史——对一条 8K token 的英文 prompt(约 32K 字符)来说,连一条完整请求都放不下。生产部署若依赖缓存感知,应显式把这个值调到与”典型前缀长度 × 预期并发前缀数”匹配的量级,而不是接受默认值。
阈值、块粒度与收益的上界
命中率是一个字符比例,不是一个缓存命中率
再强调一次公式:
其中 m 是树返回的 matched_char_count,n 是 input_char_count。rho > cache_threshold 只说明”这段请求与某个 worker 历史请求的字符前缀重合超过阈值”,并不等于 worker 的 RadixCache 真的能复用这么多 token。原因至少有三层:
- 字符 ≠ token:英文 4 字符可能 1 token,中文 1 字符可能 1 token,
rho在不同语言下含义不同; - token ≠ 块:worker 侧 RadixCache 以块为单位管理 KV(本站 KV Cache 的页粒度 讨论过 128 token 一块的账),只有完整匹配的块才能复用。字符层面的 90% 匹配,可能在最后一个块上断掉;字符层面的 40% 匹配,可能覆盖了好几个完整块;
- 历史 ≠ 现存:网关树里的”租户”只代表这条文本曾经被发往该 worker,不代表相应 KV 还在。
因此,路由层能优化的是”到达 worker 后一次命中的概率”,而不是”命中率本身”。把 sglang_cache_hit_rate(worker 真实命中)与网关推断的 rho 对照,才能判断阈值是否合适:若 rho 高但真实命中低,说明树记了太多已被驱逐的历史,应该降低 max_tree_size 或提高驱逐频率;若 rho 低但真实命中高,说明阈值过严,很多本可复用的请求被送去了最短队列。
为什么阈值比较用严格大于
代码里是 match_rate > self.config.cache_threshold,不是 >=。等号落在”低命中”分支,走最短队列。这是一个很小的保守选择:边界情况下宁可均衡,也不为了”刚好等于阈值”的模糊命中把请求堆到热点。类似的保守还体现在”部分匹配时只取已有租户”——树不会为了一个尚未见过的更深前缀去猜一个 worker。
缓存亲和与负载均衡的取舍
把缓存感知看成一次带约束的贪心:
- 无约束时,最优是把所有同前缀请求送到同一 worker(命中率最大);
- 但该 worker 的在途请求会涨,直到
(max-min) > abs且max > rel × min,路由切到最短队列; - 切换期间,树仍在记录,所以负载回落后又能迅速回到缓存亲和。
这形成了一个负反馈:缓存亲和制造局部热点,热点触发均衡阈值,均衡又把请求分散、降低命中率,负载回落再回到亲和。balance_abs_threshold 与 balance_rel_threshold 实际上是在调这个振荡的幅度与频率。阈值太大,热点会持续更久、尾延迟变差;阈值太小,路由在缓存与均衡之间频繁切换,命中率上不去。
还有一个被忽略的量:load() 数的是在途请求数,不是 token 数。一条 64K 的 Prefill 与一条 1 token 的 Decode 都算 1。对 prefill 池,这种口径会低估长请求的代价,所以 PD 场景下 prefill 侧更适合 bucket(按字符数分桶)或显式配置 token 负载的 power_of_two;对 decode 池,请求数近似等于持续占用的 slot 数,口径反而合理。
gRPC、token 级路由与多模型网关
gRPC 路由:把分词与解析搬进网关
HTTP 路由拿到的是 JSON 文本,SelectWorkerInfo.tokens 只能填 None(源码注释:“HTTP doesn’t have tokens, use gRPC for PrefixHash”)。这意味着依赖 token 的策略在 HTTP 路径上不可用,包括 prefix_hash 与所有想做 token 级前缀哈希的方案。
gRPC 模式改变了这一点:worker 以 --grpc-mode 启动,暴露 gRPC 端点;网关侧用 grpc://host:port 注册,RouterManager 按 worker 的 ConnectionMode::Grpc 选中 grpc-regular 或 grpc-pd 路由。文档说明 gRPC 路由”tokenizer, reasoning parser, and tool parser all reside in-process”——分词、思考内容拆分、工具调用解析都在 Rust 进程内完成,请求以 token 流直接进入 SRT 的 gRPC worker。
对路由层,这带来两个变化:
SelectWorkerInfo可以携带 token 序列,prefix_hash、基于 token 的一致性哈希等策略才有意义;- 少了 HTTP/JSON 的序列化与反序列化,路由本身的尾延迟更可控;代价是网关需要加载分词器(
Tokenizer Registry),并把模型路径或 tokenizer 路径传给网关。
gRPC PD 路由同样支持 prefill/decode 分离;bootstrap 字段的注入逻辑在 gRPC 路径上由对应的请求构造完成,语义与 HTTP 一致。选 gRPC 还是 HTTP,更多是”是否愿意让网关承担分词与解析”的取舍:HTTP 路由更通用、更容易接任意 OpenAI 兼容后端;gRPC 路由更贴近 SGLang 的原生协议,适合追求极致开销与 token 级策略的部署。
多模型网关:路由评分与策略都按模型分叉
enable_igw=true 的多路由模式支持一个网关后面挂多个模型,甚至同时挂 regular/PD/gRPC/OpenAI 后端。路由选择已经在 RouterManager 里按模型做了一次:
worker_registry.get_by_model(model_id)取该模型的 worker;- 按 worker 的能力给候选路由打分(外部 > gRPC-PD > HTTP-PD > gRPC-regular > HTTP-regular);
- 若请求没有模型名,则遍历路由快照,按
prefer_pd与可用性评分。
到了策略层,regular 路由用 policy_registry.get_policy_or_default(model)——每个模型可以有自己的策略实例;PD 路由则分别取 prefill/decode 策略。cache_aware 的树键里包含 model,所以多模型部署时不同模型的同名前缀不会互相污染。
这条链路解释了”多模型推理网关”的代价:每多一个模型,控制面多一组 worker 探测,缓存感知多一组树,指标多一组 model 标签。若模型数量很多,更合理的做法是让每个模型独立网关,再由上层(Kubernetes Service、负载均衡器)分流,而不是把所有模型塞进一个进程。
OpenAI 后端代理:路由层也可以是”出口”
--backend openai --worker-urls https://api.openai.com 时,网关把外部厂商当作唯一 worker,RouterManager 给它最高分(外部 worker 优先),但路由本身不做缓存感知——外部 API 不暴露 KV 状态,缓存感知没有意义。它保留的是网关的会话历史、MCP 会话与多轮编排能力,以及统一的 OpenAI 兼容入口。对本文的缓存主题,这是一个反例:缓存感知只对”自己能控制 KV 的 worker”成立。
扩缩容:冷启动与树的一致性
新 worker 为什么会”没活干”
缓存感知树里,一个新 worker 没有任何租户条目。于是:
- 它对任何请求的
prefix_match都是 0(树里没有它的文本); - 只有在负载失衡、进入最短队列分支时,它才可能被选中;
- 被选中一次后,
tree.insert(text, new_url)才开始为它积累条目。
所以在”集群整体负载均衡、没有触发失衡阈值”的稳态下,新扩容的 worker 可能长时间分不到流量。这不是 bug,而是缓存亲和与负载均衡双阈值共同作用的结果:系统认为”老 worker 有缓存、负载也没差到需要动”,于是没有动力把请求迁到冷 worker。
处理方式有三种,按侵入性从低到高:
- 临时调低均衡阈值(如
balance_abs_threshold从 32 降到 4、rel从 1.1 降到 1.0),让新 worker 在负载差很小时就进入最短队列分支,先拿到流量; - 预热:上线后主动向新 worker 发送一段代表性前缀(或回放近期请求),让网关树先建立租户条目;
- 换策略:扩容窗口内用
power_of_two或round_robin,等新 worker 积累足够请求后再切回cache_aware。
第三种最稳,但需要变更配置;前两种更接近”运维脚本”。
worker 下线后的懒清理
当 worker 被移除或不健康时,缓存感知树不会立刻删除它的所有条目——树只在”某次 prefix_match 命中该租户、但按 URL 找不到对应健康 worker”时,调用 tree.remove_tenant(tenant_url) 做懒清理。在此之前,这些租户条目会占用字符预算,直到驱逐把它们当成最久未用的叶子清掉。
这带来一个实际后果:滚动重启大量 worker 后,树的字符预算里可能堆着一批”僵尸租户”,新 worker 的条目被挤得更早驱逐。排查时可以观察 cache_aware 的 remove_tenant 日志,或直接调大 max_tree_size/缩短 eviction_interval_secs 让僵尸租户更快被清掉。
一致性哈希与 manual 在扩缩容下的行为
- 一致性哈希:环在 worker 集合变化时重建;增加一个 worker,约
1/(N+1)的 key 会迁移到新节点,其余不动。这是”最小迁移”的经典性质; manual:增加 worker 时完全不迁移已有会话,只会在会话原 worker 不健康时重新分配;每个 key 保留 2 个候选 worker 以便快速故障转移;cache_aware:没有”迁移”概念,只有”新请求往哪去”;已有请求不受影响,历史条目按 LRU 自然代谢。
三种策略对应三种一致性语义:哈希环的一致性是”确定映射 + 最小迁移”,manual 是”强粘性 + 故障重映射”,cache_aware 是”概率命中 + 无状态”。选择哪一种,取决于业务更怕”会话漂移”还是更怕”缓存浪费”。
部署与调参:把路由层放到正确的形态上
把前几节的机制代入真实部署,可以整理出几条选型与调参准则。
DP、DPA、SMG 各管什么
官方文档给了一张”参考表”,可以整理成一条判断链:
- 标准 DP(多个 replica,各持全模型):用于没有共享前缀、也不要求会话稳定的通用负载。用 SMG 加
--dp-size N跨进程聚合多个 worker; - SMG + cache_aware:共享前缀强、worker 多,缓存感知收益最大;
- DPA(
--attn-dp-size N):MLA 模型,目标是消除 KV 复制、扩大 batch;单进程内由 SGLang 引擎自己完成,网关看到的是一个 DP-aware 引擎; - DPA + EP:DeepSeek/MoE 类模型的大规模部署;推荐组合是 prefill 侧 cache_aware + decode 侧 power_of_two;
- PD 分离:prefill/decode worker 分开注册,网关注入 bootstrap 并分别选池。
把这张图”画”出来,大致是:
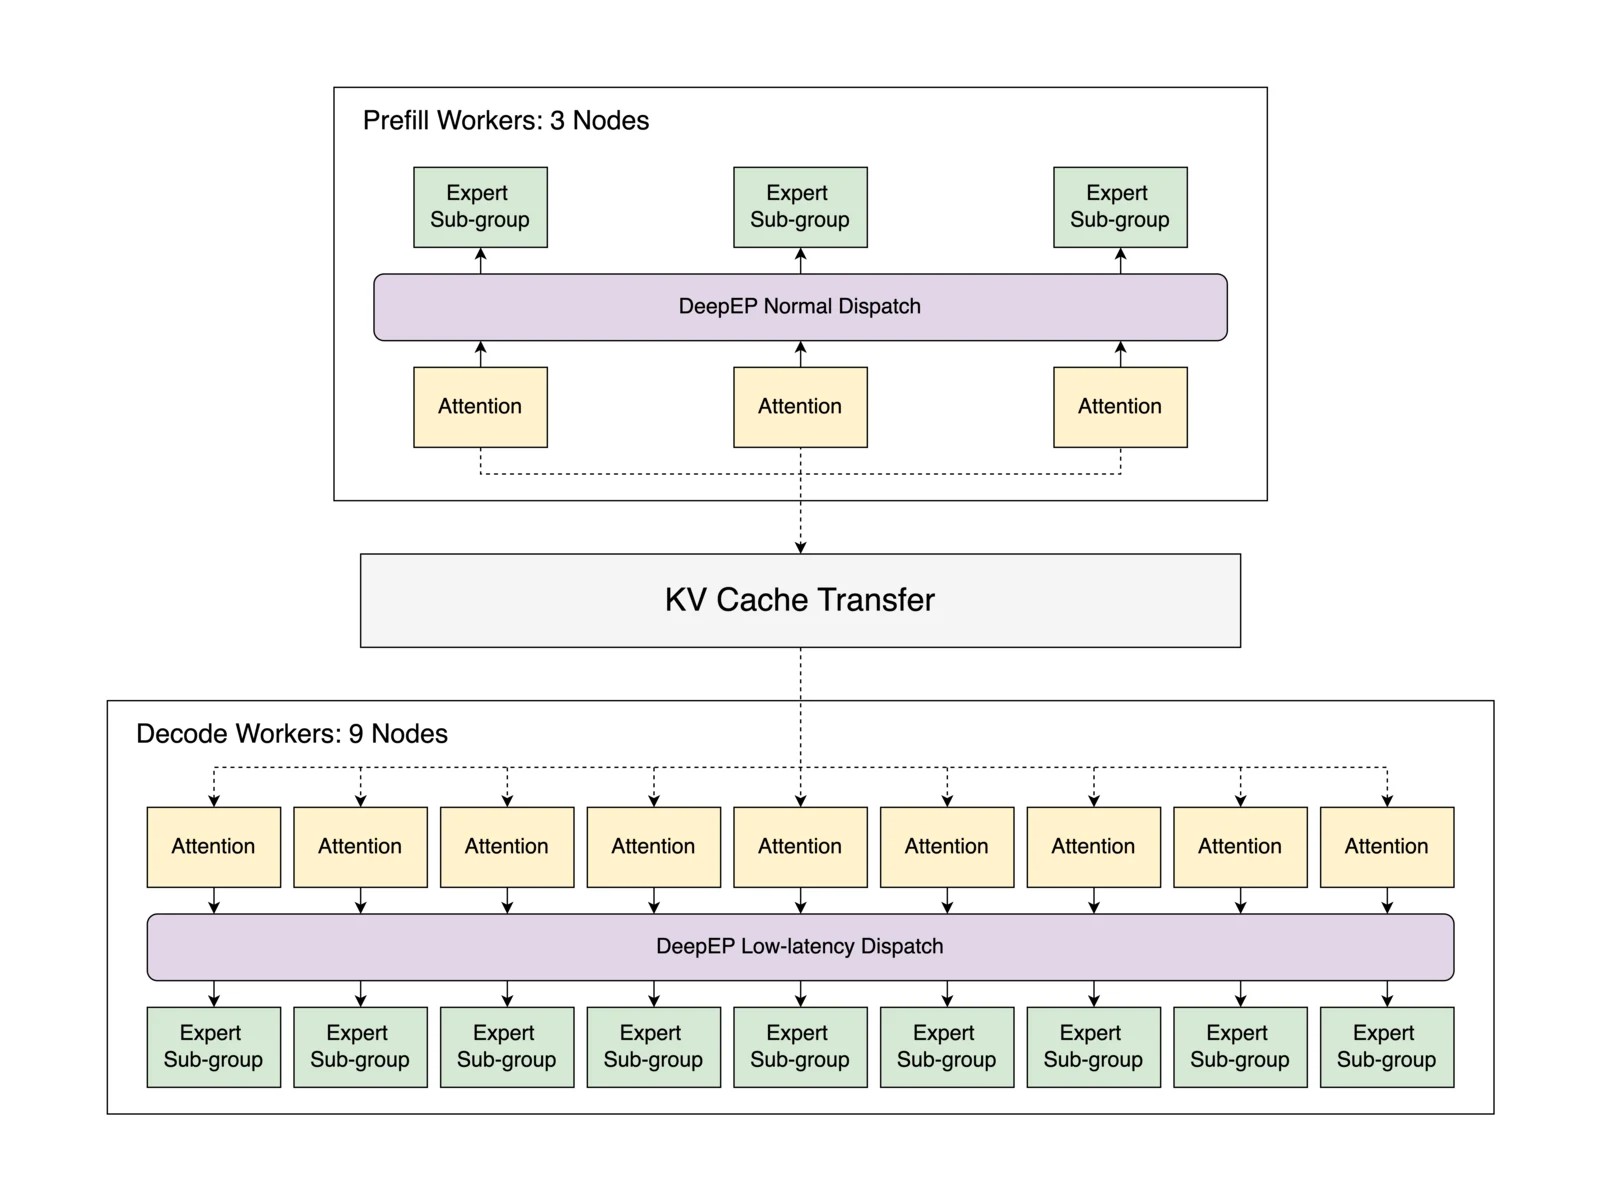
上图来自 SGLang 团队 2025 年的 大规模 EP 部署博客(图源:该博客的总体架构图)。它展示的是这类部署的整体形态:跨节点 worker、PD 分离、专家并行通信与流量入口如何组合;博客中的规模案例达到 96 卡级别。网关在这张图里是入口那一层,负责把请求分到正确的 prefill/decode 组,而节点之间的 All-to-All 通信由 DeepEP 等库完成(本站 DeepEP 完全拆解 有单独讨论)。
一个容易忽视的形态:先启 SMG 再动态注册 worker
生产环境最常见的是 worker 与网关分节点部署,worker 可能来自自动扩缩容。文档提供了第三种形态:先启动网关(不带 worker URL),再通过 HTTP 注册:
python -m sglang_router.launch_router --policy cache_aware --host 0.0.0.0 --port 30000
curl -X POST http://localhost:30000/workers \ -H "Content-Type: application/json" \ -d '{"url": "http://worker1:8000"}'这一点与控制面的 Job Queue 对应:注册是一个作业,通过 /workers/{worker_id} 追踪进度。缓存感知的树在 worker 加入时如何初始化,决定了新 worker 一开始能不能拿到前缀亲和——按源码,cache_aware 在树不存在时会警告 “pool tree was not seeded”,并临时退回随机选择;所以worker 注册后应当确认树键已被建立(PD 时还要确认 prefill/decode 两个池的树都建了)。监控中如果看到 cache_aware: no tree found for key,说明这段时间缓存亲和是关闭的。
常用的可观测手段
文档建议用这几条命令确认路由行为确实生效:
curl http://localhost:30000/workers # 当前 worker 列表与状态curl http://localhost:30000/get_loads # 各 worker 的负载快照若启用 Prometheus 端口(--router-prometheus-port 10001),关键指标包括 smg_router_requests_total{model=...}、smg_worker_requests_active{worker=...}、sglang_cache_hit_rate{source=...}。sglang_cache_hit_rate 才是”缓存感知路由到底有没有提高命中率”的直接证据;若它长期不高,先看 cache_threshold 与负载的匹配度,再看 worker 侧是否在快速驱逐(即 max_tree_size 与真实 KV 容量不匹配)。
源码层面还有几类指标标签与本文相关:
Metrics::record_worker_selection(worker_type, connection, model, policy.name()):记录每次选中的策略,按 prefill/decode/regular 分组;record_worker_retry、record_worker_retries_exhausted:重试次数与耗尽;record_worker_cb_transition/outcome/state:熔断器的状态迁移、结果与当前状态(gauge)。
注意 Metrics::record_router_duration 按路由类型/后端/模型/端点/是否流式分桶,PD 路由会把 prefill 与 decode 两侧的请求都计入 worker 指标,所以看 decode 的 tail latency 时要把两侧分开。
边界与局限
网关的缓存感知是近似且无通信的,这一点决定了它的能力上限。把局限列清楚,比把它夸成”精确缓存路由”更有用。
- 字符与 token 的错位:树的粒度是 UTF-8 字符。一条中文 prompt 的 1 个字符≈1 个 token,而英文可能 4 字符≈1 token;同一个
cache_threshold对不同语言、不同模板的敏感度不同。若负载以英文为主,可能需要提高阈值,否则”看起来一半匹配”的请求实际只匹配了少数 token。 - 网关不知道 worker 的真实状态:用户手动清缓存、worker 重启、KV 被抢占或淘汰,网关都可能仍然认为”这里有前缀”。这是命中率虚高的来源,也是为什么生产上要配套
sglang_cache_hit_rate而不是只看网关自己推断的命中。 - 共享节点上的租户猜测很粗:
last_tenant缓存与 “取第一个” 的策略在共享节点上无法区分多个租户的”最近访问程度”。对强会话亲和场景,consistent_hashing比cache_aware更可靠。 - 概率性时间戳让 LRU 不精确:1/8 概率刷新意味着驱逐顺序与真实 LRU 有偏差,尤其在大量短暂前缀与少量长文档前缀混排的负载里,后者可能被提前”认为过时”。把
eviction_interval_secs和max_tree_size调大可以缓解,但代价是内存。 - 文档与代码的参数漂移:
--balance-rel-threshold、--eviction-interval-secs、--max-tree-size的默认值在文档和当前源码之间明显不同;--max-tree-size文档写”节点数”,代码实际按”每租户字符数”执行。任何调参都应先以运行版本的源码为准。 - PD 的 bootstrap 是约定而非通用隧道:是否可用取决于 worker 的 bootstrap 端口与网络;若拓扑要求跨集群打通,需要额外处理(网关不做网络穿透)。
- decode_gate 只控制”开始 decode 的时机”,并非端到端背压:prefill 侧的排队、decode 侧的持续流式输出仍需引擎自身调度吸收(可参考 Sarathi-Serve 的分块 Prefill 与无停顿批处理,以及 连续批处理 的基本模型)。
把整条链路串起来:一条请求在网关里的完整路径
最后,用一条带共享前缀的聊天请求,把前文各块串成时间线(以 launch_server + PD 分离 + cache_aware/power_of_two + 默认重试配置为例):
- 入口:
/v1/chat/completions到达 HTTP 路由。RouterManager::select_router_for_request读x-prefer-pd与模型名,按 worker 能力选中http-pd路由; - 选路由后的重试外壳:
RetryExecutor::execute_response_with_retry捕获第一次尝试; - 选一对 worker:
- prefill 侧:
select_worker(decode=false)过滤出 prefill 池健康 worker,CacheAwarePolicy先算负载差(min/max),若失衡走最短队列;否则tree.prefix_match_with_counts(request_text)算命中率,超过 0.5 则命中租户,否则最短队列。选中后tree.insert(text, prefill_url); - decode 侧:
select_worker(decode=true)用PowerOfTwoPolicy,从两个随机候选里选负载低者;
- prefill 侧:
- 注入协作信息:
inject_bootstrap_into_value写入bootstrap_host/port/room,inject_prefill_dp_rank_for_decode写入disagg_prefill_dp_rank; - DecodeGate(若启用):按 prefill URL 取许可,控制由同一 prefill 派生的 decode 并发;
- 双发:先发 prefill(非流式、完整读取),再发 decode;prefill 的 KV 按 bootstrap 坐标流到 decode;
- 记录结果:prefill 的熔断结果立即记录;decode 若是流式,由
BreakerTrackedStream在流结束时记录。任何 5xx/429/408 命中重试条件则进入退避,重新选一对再试; - 返回与收尾:响应流写回客户端;
DecodeSlot释放许可;tree里这条请求的插入已在本轮开始时完成,下次相同前缀的请求就能被这棵影子树”看见”。
整条路径的关键事实是:网关没有向任何 worker 询问缓存、也没有在请求路径上等任何一个 worker 的确认。它只是按自己看到的请求历史,用一棵近似树,把”最可能命中”与”最不忙”两件事折中。这就是为什么它能用纯 Rust 复现在 Python 里做不到的路由吞吐,也让它在 worker 数量增长时仍然是一个几乎无状态的旁路。
对需要继续深入引擎内部读者,站内其他文章可衔接:引擎侧的前缀缓存可读 SGLang RadixCache 内部实现,KV 分页可读 PagedAttention 完全拆解,分布式 MoE 通信可读 DeepEP 完全拆解,PD 分离本身可读 DistServe 完全拆解。
参考资料
- SGLang Model Gateway 官方文档
- SGLang DP, DPA and SGLang DP Router 指南
- SGLang v0.4:Zero-Overhead Batch Scheduler, Cache-Aware Load Balancer, Faster Structured Outputs
- SGLang 大规模专家并行部署博客
- SGLang 源码仓库 sgl-model-gateway 目录(policies/cache_aware.rs、policies/tree.rs、routers/http/pd_router.rs 等)
- SGLang 精简路由实现 sgl-router 目录
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



