


GLM-5.3 推理全链路(四):PD 分离——57GB KV 与索引器缓存如何跨节点交接
前三篇留下的一个问题
前三篇分别走过了 SGLang 的 decode 全链路、vLLM 的 decode 路径,以及 SGLang 的 1M prefill。三条路径最后都落到同一个数字上:一条 1M 上下文的 GLM-5.3 请求,KV 约 57GB。第三篇只交代了这笔 KV 在 PD 分离时要跨节点搬走,没有展开搬的机制。
这一篇补上这段。GLM-5.3 的 PD 交接不是「把 KV 张量从一个显存池拷到另一个显存池」这么简单:它要搬两份缓存、要对齐两套页表、要在 DSA 的索引器缓存缺席时保证 decode 仍然能选对 Top-K,还要决定 decode 什么时候可以开始读第一层。
先把结论放前面。一次 PD 交接的完整对象是:
- 主 KV:78 层,每层每 token 656 字节,1M token 合计 53.7GB;
- 索引器 K 缓存:只有 21 个 full 层有,每层每 token 132 字节,合计 2.9GB;
- 两套页表与请求级元数据:本地块号到远端块号的映射、序列长度、块大小、缓存布局、TP/CP 拓扑;
- 以及一个状态机:decode 在
Bootstrapping → WaitingForInput → Transferring → Success之间迁移,只有最后一个状态才允许调度器真正把请求放进 decode batch。
57GB 不是「顺手传一下」的量。它决定了三件事:decode 节点必须在 prefill 开始前就预留容量;传输必须按层流水,和 decode 的计算重叠;索引器缓存必须和主 KV 一起被当作一等公民,而不是等 decode 报错再回头补。
PD 分离对 GLM-5.3 到底解决了什么
两种完全不同的账本
Prefill 与 decode 对硬件的要求几乎相反。
Prefill 一次处理成千上万个 token,GEMM 的 维很大,算术强度高,瓶颈在算力。GLM-5.3 还多了一笔别的模型没有的账:DSA 的闪电索引器要让每个 query 对全部前缀打分,prefill 的索引器是 的。第三篇算过,1M prefill 里 21 个 full 层的索引器约 94 PFLOP,主干约 100 PFLOP;索引器不仅吃算力,还要反复读前缀的索引 K。
Decode 每步每条请求只处理一个 token,算术强度低,瓶颈在显存带宽:要把 744B 参数里被激活的部分、当前请求的 KV、以及索引器缓存从 HBM 搬到 SM。batch 越大,权重读取越能被摊薄;但每条 1M 请求的 KV 是 57GB,batch 又被容量卡死。
把两段放在同一个引擎里,会得到一对互相牵制的参数:prefill 想要大 chunk、高并行度、更多算力;decode 想要大 batch、更多 KV 容量、更低单步延迟。同一组 TP/EP/DP 配置无法同时最优。PD 分离的本质不是「把两个阶段拆开」这么笼统,而是让两段各自拥有独立的并行拓扑、显存预算和调度目标。
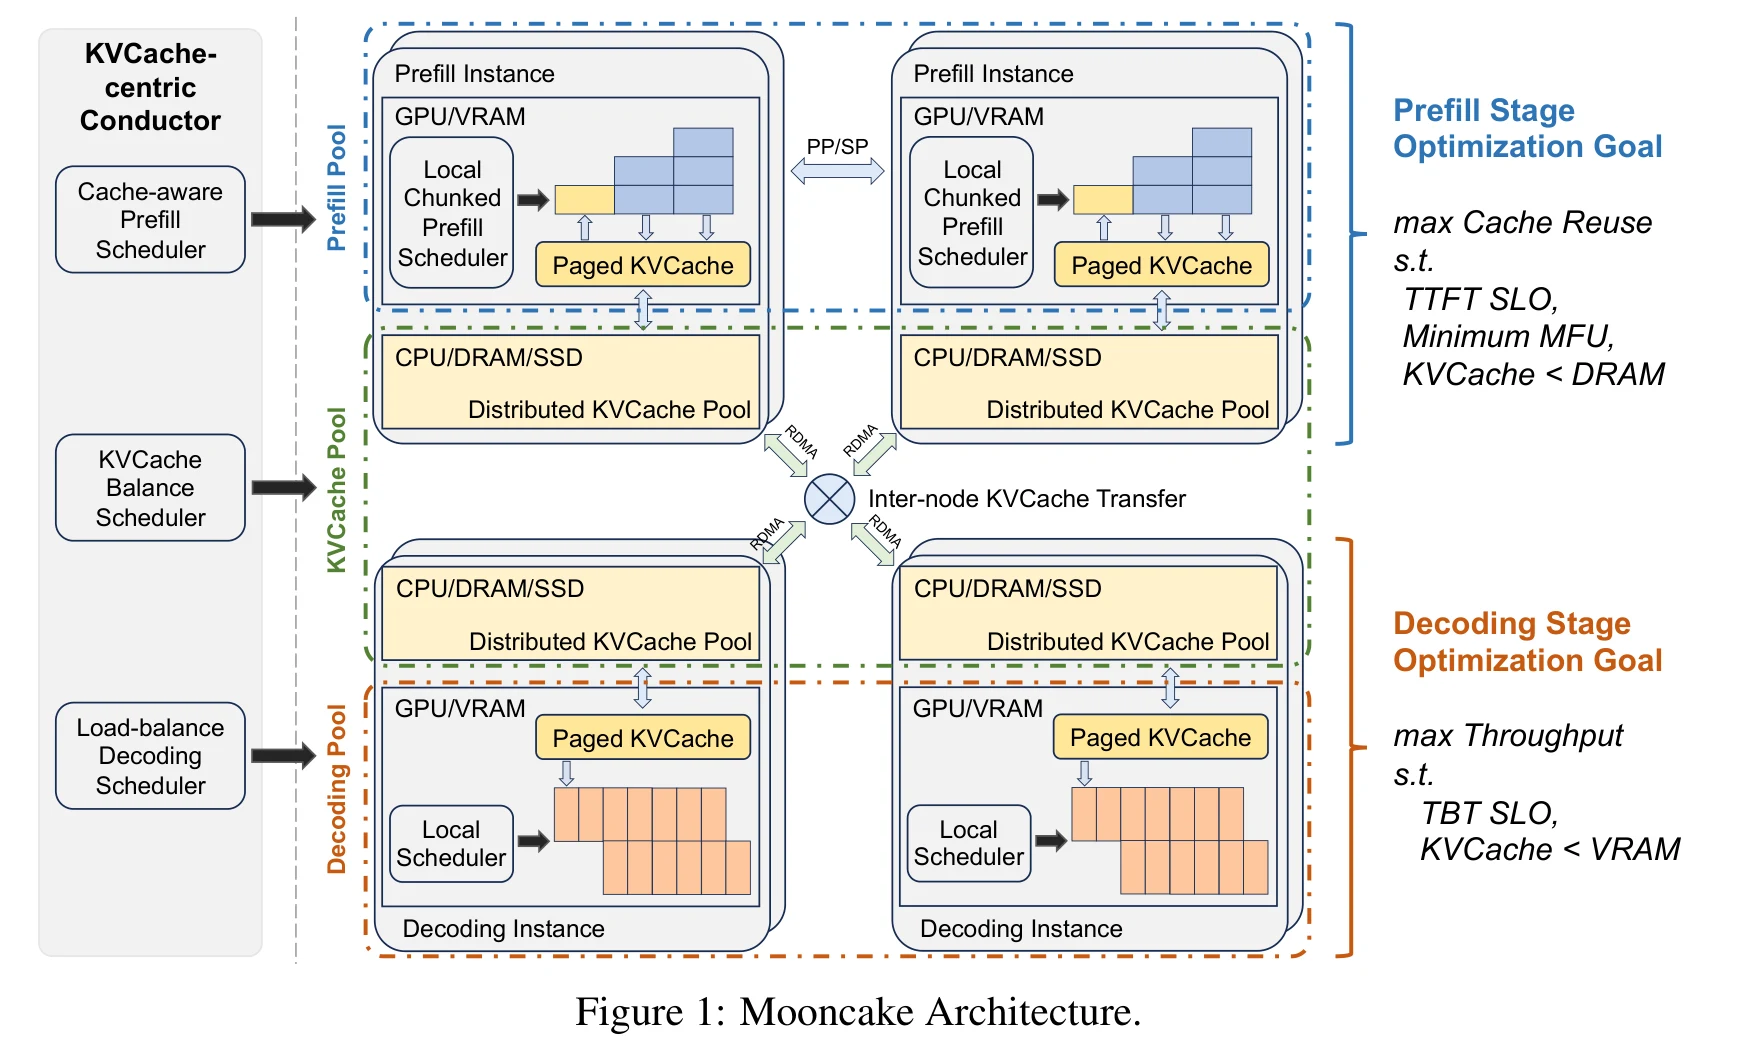
图源:Mooncake 论文(arXiv:2407.00079)Figure 1。图中 prefill 与 decode 是两组独立实例,KV 通过 RDMA 在实例间迁移,而不是留在本地。
57GB 是一道容量门槛
把第三篇的账再摆一次。主 KV 每 token 每层 656 字节:
1M token 就是:
索引器缓存每 token 每层 132 字节,只有 21 层:
合计 53.9KB/token,1M 请求约 56.6GB,工程上按 57GB 估。
这 57GB 在 PD 分离里有两个含义。第一,decode 节点必须在 prefill 还没算完时就为它留出 57GB 的 KV 池;否则 prefill 算完的 KV 无处落地,只能堆在 prefill 节点,失去分离的意义。第二,它必须跨网络搬一次;搬的时间直接落在 TTFT 上,因为 decode 要等 KV 到齐才能出第一个 token。
PD 让 1M 上下文变得可运维
如果没有 PD 分离,一条 1M 请求在统一引擎里会经历「长时间 prefill + 长时间 decode」:prefill 的几十秒里,decode 侧的其它请求被挤住;prefill 结束时,引擎要同时持有这条请求的 57GB KV 和所有 decode 请求的 KV。容量、尾延迟、故障域都混在一起。
PD 分离之后,prefill 节点可以按「算力型」配置(更高的 TP/CP、更激进的 chunk、更小的 KV 池),decode 节点按「带宽型」配置(更大的 batch、更大的 KV 池、更低的 TP 通信开销)。一条 1M 请求的 prefill 失败,不会拖垮 decode 池;decode 节点可以在请求到达前就完成容量准入,避免「算完了才发现装不下」。
代价是网络。57GB 的 KV 必须真实地跨节点走一遍,这引入了新的失败模式、新的元数据对齐问题,以及一个新的优化对象:交接本身。
还有一条容易被忽略的边界:PD 分离本身不自动提高吞吐。vLLM 的文档明确写了这一点。它换来的是两段可以独立调参、尾延迟可控、容量可以分别规划;如果两段的并行拓扑选得不对,或者交接开销过大,总吞吐反而可能低于统一部署。对 GLM-5.3 这种 prefill 与 decode 账本差异极大的模型,分离的收益主要来自「各自按自己的瓶颈配置」,而不是「多了一次网络传输」。
一次 PD 请求的控制面:从路由到握手
请求先被拆成两段
在 PD 部署里,客户端通常只看见一个入口(router 或 proxy)。入口做的第一件事不是转发,而是选一对实例:一个 prefill 实例和一个 decode 实例。
选择依据不只是负载。至少要匹配:
- 模型与并行拓扑:prefill 与 decode 的 TP/PP/CP 可以不同,但 KV 布局必须能互相翻译;
- KV 缓存格式:
fp8_ds_mla的 656 字节布局与fp8_e4m3的 576 字节布局不能混传; - 块大小与页大小:两边的页必须能建立块号映射;
- 是否有足够的 decode 容量装下这条请求的 KV。
选好之后,请求被分成两段:prefill 段只负责把 prompt 算完、把 KV 写进本机缓存;decode 段负责接收 KV、继续自回归。两段之间传递的不是 token,而是一组「KV 在哪里」的元数据。
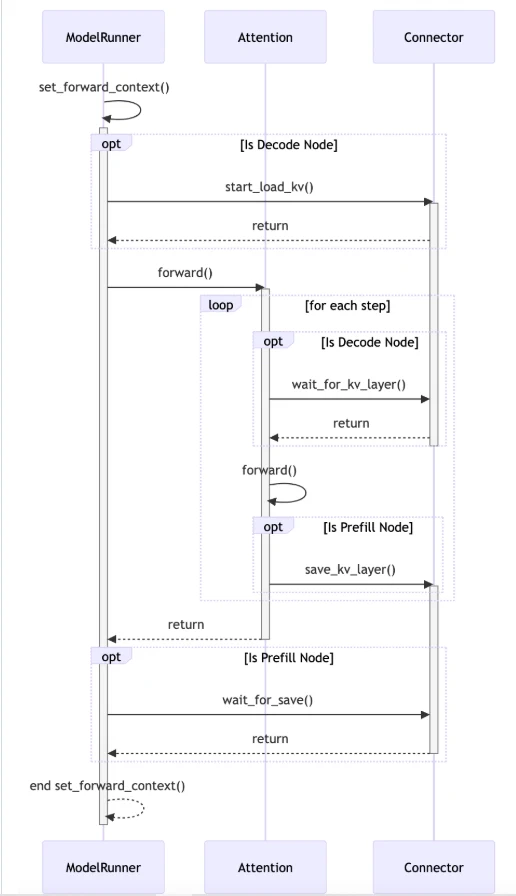
图源:vLLM 官方文档 Disaggregated Prefilling 的 workflow 图。控制面负责握手与元数据,数据面负责真正的 KV 搬运。
SGLang 的控制面:bootstrap server 与 room
SGLang 把控制面集中在一个 bootstrap server 上。prefill 与 decode 实例启动后向它注册,注册信息包括 DP/TP/CP/PP 的规模、页大小、KV 布局、是否开启 DSA 索引器缓存分片等。bootstrap server 的职责是给每条请求分配一个 room,并把 decode 的连接信息转给 prefill。
代码里能看到这个结构:
class CommonKVBootstrapServer(BaseKVBootstrapServer): def __init__(self, host: str, port: int): self.store = dict() self.prefill_port_table = {} self.room_to_dp_rank = {} self.page_size = None self.kv_cache_dtype = None self.kv_layout = None self.enable_dsa_cache_layer_split = None_setup_routes 里注册了 /route、/register_dp_rank、/query_dp_ranks、/health 四条路由。/route 的 PUT 用于 prefill 登记「我这条请求算完了,decode 来这里取」,GET 用于 decode 查询「我的 prefill 在哪」。_is_ready 会检查注册的 prefill 实例数是否达到 dp_size × attn_cp_size × attn_tp_size × pp_size,没达到就不接新请求。
请求进入后,SGLang 侧的状态机用 KVPoll 表示:
class KVPoll: Failed = 0 Bootstrapping = 1 WaitingForInput = 2 Transferring = 3 Success = 4这五个状态对应一条请求的真实生命周期:
Bootstrapping:decode 已分配本地 KV 槽位,正在和 prefill 交换transfer_id、远端地址、页表;WaitingForInput:握手完成,等 prefill 的前向真正算完(prefill 可能还在 chunk 中);Transferring:KV 正在按层/按页搬运;Success:所有需要的层都到齐,decode 可以调度;Failed:任一侧 abort、超时、校验失败。
decode 侧在握手阶段就把「这条请求要占多少」算清楚。SGLang 为此提供了一个显式开关 --disaggregation-decode-allocation-policy,取值为 early(默认)或 prefill_complete:前者在请求进入 decode 时就开始为它预留 KV,后者等 prefill 完成后再在 decode 上准入,期间 KV 留在 prefill。两者的取舍不同——early 让 decode 更早参与调度、也能在 prefill 中途失败时快速重算,代价是在 prefill 还没算完时就要占着容量;prefill_complete 把容量压力推迟到最后,但 decode 在 prefill 的整段时间里无法开始任何工作。官方要求 prefill 与 decode 两侧设置为同一个策略,否则两侧对「什么时候该有页」的判断不一致。
无论哪种策略,57GB 的请求都不能等 KV 到了再临时找地方放:容量必须提前判定,装不下就要在握手阶段拒绝,而不是传了一半才发现。
vLLM 的控制面:kv_transfer_params 与 connector
vLLM 不设独立的 bootstrap server,控制信息跟着请求走。prefill 实例在响应里带一个 kv_transfer_params,decode 实例在下一次请求里把它带回来。常见字段包括:
{ "do_remote_decode": true, "do_remote_prefill": true, "remote_block_ids": [[...], ...], "remote_engine_id": "prefill-engine-0", "remote_bootstrap_addr": "10.0.0.12:5600", "transfer_id": "req-7f3a..."}remote_block_ids 是按 KV cache group 组织的远端块号;remote_engine_id 用来在 connector 的远端引擎表里找到对应的 NIXL agent;remote_bootstrap_addr 是远端 connector 的控制地址,transfer_id 用来在远端匹配这条请求。字段名随 connector 不同会有差异(Mooncake connector 里远端地址以 remote_hostname:remote_port 的形式出现在 PullReqMeta 里),但语义相同。实际字段会随 connector 版本增加(例如 remote_request_id、remote_blocks_expiry_time、remote_registration_generation),但语义不变:decode 要知道去哪个引擎、哪些块、用什么会话取数据。
调度器侧通过 KVConnectorBase_V1 的两个钩子参与决策:
def get_num_new_matched_tokens(self, request, num_computed_tokens): """返回这条请求能从远端匹配到多少 token 的 KV。"""
def update_state_after_alloc(self, request, blocks, num_external_tokens): """本地块分配完成后,记录远端块到本地块的映射。"""前者决定「要不要走远端 prefill」以及「能复用多少」;后者在本地块分配后把映射记下来,供 worker 侧发起传输。decode 的调度器因此在请求还没进模型前就知道:这条请求会占多少本地块、要等哪些远端块。
worker 侧则是另一组钩子:
def start_load_kv(self, forward_context, **kwargs): """为当前 batch 发起 KV 加载。"""
def wait_for_layer_load(self, layer_name): """在某一层真正读 KV 前,等待该层的数据到达。"""
def save_kv_layer(self, layer_name, kv_layer, attn_metadata, **kwargs): """prefill 侧在某层算完后,把该层 KV 写出去。"""这四个函数把「传输」拆成了层粒度:prefill 每算完一层就能发一层,decode 每要用一层才等一层。57GB 因此不必等全部到齐才开始解码,传输可以和计算重叠。
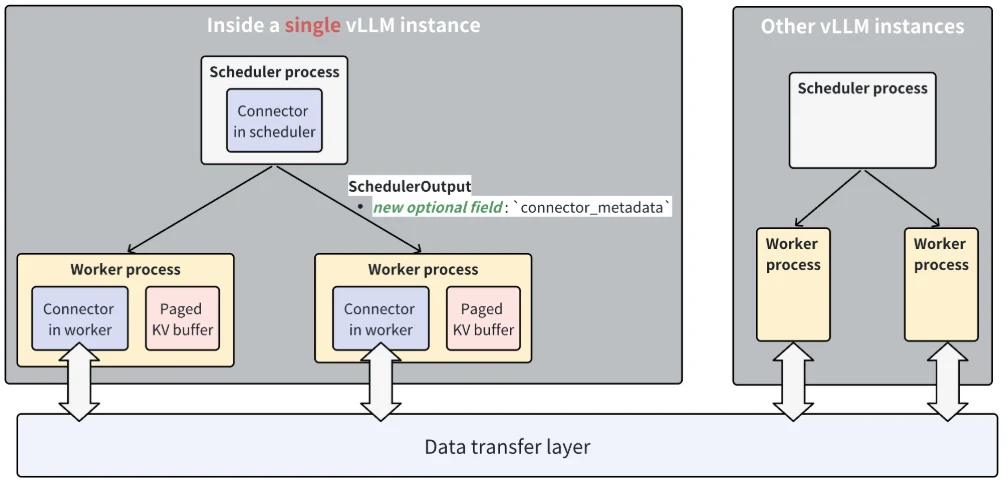
图源:vLLM 官方文档 Disaggregated Prefilling 的 high-level design 图。
沿着这条链路,前三篇里的站点文章可以作为背景:SGLang 的 decode 路径见 GLM-5.3 推理全链路(一),vLLM 的融合路径见 (二),1M prefill 的账本见 (三)。
数据面:57GB 由哪些张量组成
主 KV 的 656 字节
GLM-5.3 的 MLA 把每层的 KV 压成 576 维:512 维 NoPE 潜向量加 64 维 RoPE。vLLM 的 fp8_ds_mla 布局把 512 维存成 FP8(512 字节)、64 维 RoPE 存成 BF16(128 字节),再加 4 个 FP32 block scale(16 字节),合计 656 字节。
这个布局是字节寻址的,不是普通的 [num_blocks, block_size, num_heads, head_dim] 张量。传输层看到的是一块连续显存,每页里按 token 紧密排列 656 字节的行。页内偏移、页间 stride、block scale 的位置都由布局常量决定;如果发送端和接收端的布局常量不一致,搬过去的字节会被解释成错误的 K/V。
78 层、每层 1M token 的 KV 是:
78 层合计 53.7GB。也就是说,平均每层要搬约 688MB。这个数字决定了「按层流水」的粒度:一层 688MB 在 400GB/s 的链路上约 1.7ms,和一层 decode 计算的时间同量级,正好可以重叠。
索引器缓存的 132 字节
索引器缓存不是主 KV 的一部分。它存的是闪电索引器每层每 token 的 key 投影,头维度 128,FP8 下 128 字节,再加每个 128 维向量的 4 字节 scale,合计 132 字节。只有 21 个 full 层有独立索引器,57 个 shared 层复用某一层的 Top-K 结果。
21 层、1M token:
这笔钱不能省。decode 的每一步,索引器都要用当前 token 的 query 和全部前缀的索引 K 打分,选出 Top-2048,再让主注意力只读这 2048 个 KV。如果索引器缓存没搬过来,decode 只有两种结局:要么重算前缀的索引 K(需要前缀的 hidden states,而 hidden states 不在 KV 里),要么读到空的/别人的索引缓存,选出错误的 Top-K。后者不会报错,只会让输出悄悄变差,是 PD 里最危险的一类 bug。
页表与请求元数据
KV 不是按「一条请求一块连续显存」组织的,而是按页。以页大小 64 为例,1M token 就是 16384 页;页大小取 16 或 128 时,页数按比例变化,但下面的协议不变。两边的页号完全独立:prefill 的第 17 页可能对应 decode 的第 9031 页。因此交接必须带三样东西:
- 远端块号列表:每条请求在每个 KV group 里占了哪些块;
- 本地块号列表:decode 已经为它分配了哪些块;
- 块到字节的映射参数:块大小、每块字节数、层数、每层在块内的偏移。
SGLang 的 KVArgs 把这些信息拆成 kv_data_ptrs、kv_data_lens、kv_item_lens 和一组 state_* 字段;vLLM 的 NixlAgentMetadata 则把它们拆成 kv_caches_base_addr、block_lens、block_strides、region_names、region_group_ids 等。两边实现不同,但都在回答同一个问题:第 i 层的第 j 页,在远端显存的哪个字节开始,长度多少。
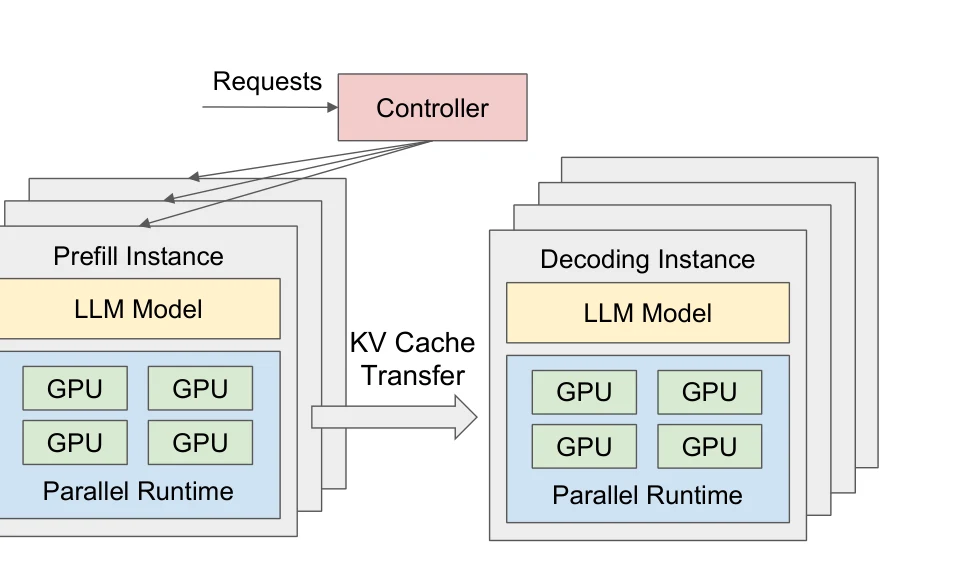
图源:DistServe 论文(arXiv:2401.09670)Figure 6。PD 系统的控制面通常由一个 controller/router 承担实例选择与生命周期管理。
为什么不能只传一个「大张量」
一个自然的想法是:把 78 层的 KV 拼成一块连续缓冲区,一次 RDMA 发过去。实际不可行,原因有三。
第一,层在显存里不连续。每层的 KV 池是单独分配的,中间夹着权重、激活、workspace;把它们拼起来需要一次额外的显存拷贝,57GB 的拷贝本身就要几十毫秒到上百毫秒,还多占 57GB 峰值显存。
第二,传输要和计算重叠。decode 的第一层只需要第一层 KV;如果等 57GB 全部到齐,TTFT 会多出整段传输时间。按层注册、按层通知,才能让第 0 层先到、先算。
第三,索引器缓存是独立的池。它的 132 字节行布局和主 KV 的 656 字节布局不同,生命周期也不同(只有 21 层有),必须单独注册为另一组区域。把它硬塞进主 KV 的连续缓冲区,会让布局和页表都变得不可维护。
所以所有主流实现都采用「多区域 + 页粒度 + 按层通知」的结构。SGLang 用 StateType 区分主 KV、DSA 索引 K、DSA tail 等状态;vLLM 用 region_names/region_group_ids 区分不同的 KV group。接下来的两节分别看这两套实现。
索引器缓存:PD 里最容易被漏掉的一份 KV
DSA 让「KV」变成了两份
GLM-5.3 的注意力是 DSA(DeepSeek Sparse Attention)在 MLA 上的实例化。每个 query 先经过闪电索引器,对前缀每个 token 的索引 key 打分,选出分数最高的 2048 个;主注意力只对这 2048 个 token 做 576 维的 MLA 点积。
索引器的 key 不是主 KV 的 key。它来自另一组投影:每层把 hidden state 投到 128 维,量化成 FP8,再加一个 4 字节 scale。它只用于打分,不参与最终的值加权。因此它必须单独存一份,也就必须在 PD 时单独搬一份。
21 个 full 层有独立索引器,57 个 shared 层复用别的层的 Top-K。这个 21/57 的分布对 PD 有两个影响:
- 索引器缓存只有 21 层,总量 2.9GB,比主 KV 小得多,但它决定主注意力读哪些 KV;漏掉它,主 KV 搬得再完整也没用。
- 21 个 full 层不是连续排列的,而是按
index_topk_freq/index_topk_pattern分布。传输侧不能假设「前 21 层」,必须按实际层号枚举。
SGLang:把索引 K 注册成独立的 StateType
SGLang 的 DSA KV 池除了主 KV,还持有 IndexKeyCache。它的 state_buf_infos() 返回每层的显存指针、缓冲区长度和单行字节数:
def state_buf_infos(self): layer_num = self.pool.layer_num data_ptrs = [self.buffer[i].data_ptr() for i in range(layer_num)] data_lens = [self.buffer[i].nbytes for i in range(layer_num)] item_lens = [self._item_len(i) for i in range(layer_num)] return data_ptrs, data_lens, item_lens_item_len 对 0 行层(skip-topk 或 CP layer split 下不归本 rank 的层)返回 0;这意味着索引器缓存不是每层都等长,传输侧必须逐层读 item_len,不能用一个全局常量算总字节。
在构造 PD 的 KVArgs 时,SGLang 把这份缓存追加为一个独立的状态组件:
if getattr(token_to_kv_pool, "use_dsa", False): dsa_pool = token_to_kv_pool.full_kv_pool dsa_ptrs, dsa_lens, dsa_item_lens = dsa_pool.get_state_buf_infos() append_state_component( kv_args, StateType.DSA, dsa_ptrs, dsa_lens, dsa_item_lens, )StateType.DSA 与主 KV 的 kv_data_ptrs 是两套并列的地址数组。主 KV 走 send_kvcache,索引 K 走状态组件;两者可以有不同的页大小、不同的层数、不同的单行长度。传输时按 state_types 的顺序逐项处理,prefill 与 decode 必须用同样的顺序注册,否则第 i 项会对错。
真正需要逐字读的,是索引 K 的索引列表只传 suffix这一点:
def _dsa_pages_payload(): # Decode already holds the indexer rows of the prefix it cached # (decode_prefix_len, page-aligned), and its rows for a prefix # still being restored point at no page yet: send only the # suffix, positionally matching decode's _dsa_pages_payload. return suffix_page_indices( self.req_to_token_pool.req_to_token, req.kv.req_pool_idx, req.disagg_decode_prefix_len, seq_len, page_size, )这段注释把协议说得很清楚:
- decode 侧如果已经有前缀缓存,那么前缀的索引 K 本来就在 decode 的池里,不需要重传;
- decode 侧如果正在从 HiCache 恢复前缀,对应的行还没有页号,此时写进去会与恢复冲突,所以也不传;
- prefill 只传
decode_prefix_len之后的后缀,decode 侧用同样的起始位置生成自己的页列表,两边按位置一一对应,不需要交换页号数组。
这是一个很省带宽的设计,但它依赖一个强假设:两边对 decode_prefix_len 的理解完全一致,且页对齐规则一致。只要一侧把前缀长度按 token 算、另一侧按页算,suffix 的起始位置就会错位,索引 K 会被写到错误的页上。SGLang 在 payload 里统一用页对齐后的长度,并在 prefill/decode 两侧复用同一个 suffix_page_indices 语义,就是为了避免这种错位。
MTP 草稿层还有一份自己的索引器缓存。SGLang 在构造 KVArgs 时会把 draft pool 的 state_buf_infos() 追加到主池后面,层数因此比目标模型的 21 层更多。接收侧必须知道哪些状态项属于 draft,否则会把草稿缓存写进目标模型的索引池。
vLLM:索引器缓存是一个带角色的 KVCacheSpec
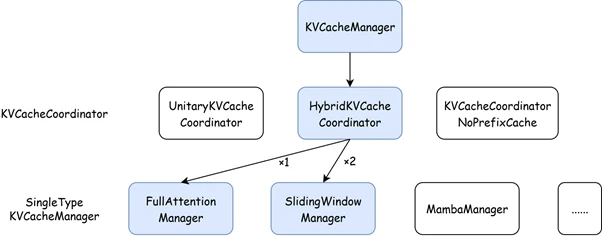
图源:vLLM 设计文档 Hybrid KV Cache Manager 的 overview 图。
vLLM 的处理更「类型化」。DeepseekV32IndexerCache 本身是一个 AttentionLayerBase,它的 get_kv_cache_spec() 返回:
return MLAAttentionSpec( block_size=self.cache_config.block_size, num_kv_heads=1, max_tp_shards=1, head_size=self.head_dim, dtype=self.dtype, cache_role=SparseCacheRole.INDEXER,)三个字段决定了 PD 行为:
num_kv_heads=1:索引器只有一个 key 向量,不是多头;max_tp_shards=1:它不按 TP 切分,每个 TP rank 都持有一份完整副本;cache_role=INDEXER:它在 KV 管理器里是一个独立角色,不能和主 MLA 缓存混为一组。
KV 管理器可能把同一层的 MLA 主缓存与索引器缓存并入一个 UniformTypeKVCacheSpecs 组(两者都是 MLAAttentionSpec,只是角色不同,且需要相同的 block table 宽度),也可能让它们分别成组。无论分组方式如何,NIXL 侧都会按 region_names / region_group_ids 把它们区分为可分别寻址的传输区域。源码里对这件事有一条明确的注释:
# Remote regions outside the row (e.g. a separate indexer) pass through.以及打包行的拆分逻辑:
# E.g. a BLHNC prefiller registers one region whose block is a full row# holding every layer's page, while a HiSparse decoder registers one# region per layer.也就是说,vLLM 允许 prefill 与 decode 使用不同的区域组织方式:prefill 可以把多层打包成一行注册,decode 可以每层一个区域;握手时通过 packed_member_layouts 把远端行拆成虚拟的每层区域。但打包行里的成员页大小必须一致,源码里对应的断言是:
assert page_size == self.block_len_per_layer[local_region], ( "Packed MLA page sizes must match for layer {layer_name!r}")索引器缓存因为单行 132 字节、和主 KV 的 656 字节不同,通常不会被打进同一个 packed row;在源码的打包行拆分逻辑里,这类位于行外的区域会「pass through」,用自己的 block_lens 和 block_strides 参与传输。这一点很关键:如果实现图省事,把索引器缓存按主 KV 的 656 字节页长去读,读出来的 132 字节行会跨页、错位,Top-K 直接错乱。
TP 映射是另一个坑。MLA 主缓存的潜向量是每层一份完整副本(不按头切开),索引器缓存同理。NIXL 的 compute_tp_mapping 对 MLA 有专门分支:当本地 TP 大于远端 TP 时,多个本地 rank 从同一个远端 rank 读;当本地 TP 小于远端 TP 时,一个本地 rank 从多个远端 rank 读不同的头分片。索引器只有 1 个头、且 max_tp_shards=1,它必须走「复制」路径,而不是「按头分片」路径。vLLM 用的判据是 replicates_kv_cache():
return self.is_mla or self.is_kv_replicated(remote_engine_id, remote_pp_rank)
def is_kv_replicated(self, remote_engine_id, remote_pp_rank=0) -> bool: return ( self._engines[(remote_engine_id, remote_pp_rank)].remote_tp_size > self.total_num_kv_heads )对 MLA 区域(is_mla 为真)或「TP 数大于 KV 头数」的区域(索引器只有 1 个头,TP8 时必然满足),缓存是跨 rank 复制的:任意一个远端 rank 都持有完整副本,decode 只需要从一个远端 rank 读完整数据,而不是按头分 8 份各读 1/8。索引器缓存因此走复制分支;如果误走头分片分支,decode 会只拿到 1/8 的索引向量,Top-K 直接失效。
漏掉索引器缓存会发生什么
主 KV 缺失会立刻炸:注意力读到未初始化的页,输出 NaN 或乱码,通常还能在日志里看到 shape/页号错误。索引器缓存缺失更隐蔽:
- 索引器读到空缓存,所有分数为 0 或垃圾值,Top-K 变成任意 2048 个 token;
- 主注意力仍然能算,输出仍然是「合法」的浮点数,只是每个 token 只看到了错误的上下文;
- 模型可能仍然流畅地生成,但在长上下文召回、精确引用、代码补全等任务上明显退化。
这类问题在短 prompt 上几乎看不出来,因为前缀短、Top-K 容易覆盖大部分 token;只有在 1M 上下文、关键信息位于前缀深处时才会暴露。因此 PD 的正确性检查不能只看「有没有报错」,还要看:
- 索引器区域的层数是否等于 21(加 MTP 草稿层);
- 每层
item_len是否等于 132(FP8)或对应格式的字节数; - 传输后的 checksum 是否与发送端一致;
- decode 第一步的 Top-K 是否落在合法页号范围内。
传输机制:页、区域与通知
SGLang + Mooncake:发送端主动推
SGLang 的 Mooncake 后端把 KV 传输做成「prefill 主动 send」。send_kvcache 的签名里有三组关键参数:
def send_kvcache( self, mooncake_session_id: str, prefill_kv_indices: npt.NDArray[np.int32], dst_kv_ptrs: list[int], dst_kv_indices: npt.NDArray[np.int32], executor: concurrent.futures.ThreadPoolExecutor, dst_layer_ids: Optional[List[int]] = None, dst_device_kv_indices: Optional[npt.NDArray[np.int32]] = None, dst_kv_item_len: Optional[int] = None, dst_attn_tp_size: Optional[int] = None,):mooncake_session_id:握手时建立的传输会话;prefill_kv_indices/dst_kv_indices:发送端与接收端的页号列表,长度相同、按位置对应;dst_kv_ptrs:接收端每层 KV 缓冲区的基地址;dst_kv_item_len/dst_attn_tp_size:接收端的单行长度与 TP 规模,用来校验两端布局是否兼容。
真正干活的是 transfer_worker。它从一个队列里取 TransferKVChunk,每个 chunk 带有 room、层号、页号、事件。取到之后先做三件事:
if kv_chunk.wait_event is not None: kv_chunk.wait_event.synchronize()if kv_chunk.indices_event is not None: kv_chunk.indices_event.synchronize()if isinstance(kv_chunk.prefill_kv_indices, torch.Tensor): kv_chunk.prefill_kv_indices = kv_chunk.prefill_kv_indices.numpy()第一行等的是「这一层的 KV 已经写进显存」的事件。prefill 的 attention kernel 是异步的,调度器把 chunk 入队时 KV 可能还没落盘;如果不 wait,RDMA 会读到上一层的旧数据。第二行等的是页号列表在 CPU 上就绪的事件。两个事件把「计算完成」和「元数据就绪」分开,传输线程不会被 GPU 的异步性骗过去。
然后检查 room 状态:
if (kv_chunk.room not in self.request_status or self.check_status(kv_chunk.room) == KVPoll.Failed): # 跳过已失败/已 abort 的 room continue这一步避免把带宽浪费在已经取消的请求上。最后按层调用 send_kvcache,把源页号、目标页号和目标指针交给 Mooncake 的 transfer engine。传输完成后再推进状态机,把该层标记为已到达。
SGLang 的页号不是原始 token 位置,而是经过 kv_to_page_indices 压缩后的页号:
def _full_kv_pages_payload(): kv_indices_full = self.req_to_token_pool.req_to_token[ decode_req.req.kv.req_pool_idx, :seq_len ] device_page_size = self.token_to_kv_pool.page_size return kv_to_page_indices(kv_indices_full, device_page_size)req_to_token 存的是每个 token 对应的物理槽位,kv_to_page_indices 把它按页去重、取每页首页号。索引器缓存也走同一套页号压缩,但使用自己的池和页大小。传输层因此只需要处理「页号数组」,不需要理解 token 级布局;这也是为什么页大小必须在握手时对齐。
SGLang 还有一个 checksum 模块。开启后,prefill 会在传输前对源页算摘要,decode 收到后对目标页算摘要并比对。对 57GB 的全量校验代价不小,通常只在调试或关键链路上开启;但它能抓住「页号对错」「布局不一致」「只传了一半」这三类最难定位的问题。
vLLM + NIXL:接收端按需拉
vLLM 的 NIXL 连接器默认是 pull 模式:decode 侧主动 READ 远端的块。握手时,decode 向 prefill 发 GET_META_MSG,prefill 返回 NixlHandshakePayload:
@dataclassclass NixlHandshakePayload(KVConnectorHandshakeMetadata): compatibility_hash: str agent_metadata_bytes: bytes # NixlAgentMetadata encodedcompatibility_hash 先比对,只有哈希一致才解析 agent_metadata_bytes。哈希覆盖的东西比想象中多:KV 布局、块大小、TP/DCP/PCP 规模、模型与 draft 配置、NIXL 传输模式,以及 packed layout 与 region 组织方式。源码里的版本历史写到第 15 版,新增过 physical_blocks_per_logical_kv_block、block_strides、dcp_size/pcp_size、packed_member_layouts 等字段;每一次不兼容改动都把版本号加一。PD 两端版本不一致时,握手会直接拒绝,而不是带着错误布局继续跑。
NixlAgentMetadata 描述的是「远端显存长什么样」:
@dataclassclass NixlAgentMetadata: engine_id: str agent_metadata: bytes kv_caches_base_addr: list[int] device_id: int num_blocks: int block_lens: list[int] block_strides: list[int] kv_cache_layout: str block_size: int ssm_sizes: tuple[int, int] attn_backend_name: str physical_blocks_per_logical_kv_block: int region_num_blocks: list[int] | None = None region_group_ids: list[int] | None = None region_names: list[str] | None = None region_mem_types: list[str] | None = None dcp_size: int = 1 pcp_size: int = 1 region_members: list[list[str]] = field(default_factory=list) packed_member_layouts: dict[str, tuple[int, int]] = field(default_factory=dict)每个区域有独立的基地址、块长、块 stride、块数、组号、内存类型。MLA 主 KV 是一个区域,索引器缓存是另一个区域;如果 prefill 做了 packed 布局,packed_member_layouts 会记录每个成员在打包行里的字节偏移和页长。decode 侧据此把远端的一行拆成多个虚拟区域,再按本地层名匹配。
TP 映射在 compute_tp_mapping 里完成。对 MLA 来说,cache 是复制的,所以本地 rank 只需要从一个远端 rank 读;如果本地 TP 更大,多个本地 rank 会分摊到不同的远端 rank;如果本地 TP 更小,一个本地 rank 会从多个远端 rank 读不同的头分片。索引器缓存因为只有 1 个头,在 TP8 下必然被判为复制,走「一个远端 rank 读完整副本」的分支。
实际传输时,decode 的 worker 按层发 READ:
def start_load_kv(self, forward_context, **kwargs): for layer_name in self._transfer_layer_names: self._read_blocks(layer_name, ...)读到本地后,wait_for_layer_load(layer_name) 在当前层注意力真正执行前做一次同步。由于传输是异步的,decode 可以先算 embedding、RMSNorm、A 投影,等 attention 要读 KV 时再等;这段计算正好覆盖传输延迟。
push 模式则反过来:prefill 侧用 WRITE 直接把层写进 decode 的显存,写完后发通知。push 的好处是 prefill 更清楚「这一层什么时候算完」,可以在 kernel 结束后立刻发;坏处是 decode 的容量必须提前预留,且 prefill 需要知道 decode 的注册信息。NIXL 的 push 模式在 PP/多级流水下还涉及按层名路由,源码里为此维护 region_members 和 _transfer_layer_names。
两种机制的共同点
无论 SGLang 的 push 还是 vLLM 的 pull,底层都要解决四个问题:
- 注册:把每层 KV 缓冲区的基地址、长度、页大小告诉对端;
- 映射:把本地页号翻译成远端页号,且保证两边页内布局一致;
- 通知:一层写完后通知对端「这层可读」,而不是让对端轮询;
- 回收:传输完成或请求 abort 后,释放 room/句柄,避免泄漏。
差别只在职责分配:push 把「什么时候发」放在 prefill,pull 把「什么时候读」放在 decode。对 1M 请求,pull 更自然,因为 decode 知道自己第一层什么时候要读;push 更激进,能把传输压到 prefill 的 kernel 末尾,但需要更严格的容量准入。
逐层交接与解码启动的重叠
一条 1M 请求的时间线
把一次 1M PD 交接画成时间线:
- decode 收到请求,向 router 注册,分配 57GB 的本地 KV 页;状态
Bootstrapping; - decode 与 prefill 交换元数据:块号、页大小、布局、TP 拓扑、索引器层号;状态
WaitingForInput; - prefill 开始 chunked prefill。每算完一层,就把该层主 KV 和(如果是 full 层)索引 K 写出;状态
Transferring; - decode 的第一层 attention 需要第 0 层 KV。如果第 0 层已到,decode 可以开始算 embedding、A 投影、RMSNorm,然后在 attention 前等第 0 层;
- decode 逐层推进,传输逐层追上;最后一层到齐后,LM Head 出第一个 token;
- 之后进入正常 decode,MTP 草稿与验证使用本地 KV,不再依赖 prefill。
关键在第三步和第四步的重叠。prefill 的一层计算时间远大于一层传输时间:1M prefill 的主干约 8 秒,78 层平均每层约 100ms;一层 688MB 在 400GB/s 上约 1.7ms。也就是说,只要传输在层计算结束时就启动,它几乎完全被下一层的计算掩盖。真正暴露在关键路径上的是:
- 第 0 层的传输(decode 要等它才能开始第一层 attention);
- 最后一层的传输(decode 要等它才能出 LM Head);
- 索引器缓存的传输(如果它晚于主 KV,decode 的索引器会等)。
因此实现上通常把「第 0 层优先」「索引器与主 KV 同层同发」作为调度策略。SGLang 的 transfer worker 按 chunk 队列顺序处理,chunk 的入队顺序由层号决定;vLLM 的 start_load_kv 按 _transfer_layer_names 顺序发 READ,索引器层与主 KV 层交错在同一个列表里。两边都没有「先传完所有主 KV 再传索引器」的做法,因为那会让 decode 的第一层索引器空等。
为什么不能等 57GB 全到再解码
如果 decode 等全部 57GB 到齐再开始,TTFT 会增加:
这是理想值。实际受页表打包、RDMA 注册、接收端写入、通知往返影响,通常要 0.5–1 秒。对 1M prefill 的几十秒来说,0.5 秒不算致命,但它发生在 TTFT 的尾部,而且 decode 在这段时间里完全空转。逐层重叠能把这 0.5 秒压到「最后一层 + 索引器尾块」的量级,通常只剩几十毫秒。
更重要的是,逐层交接让 decode 的算力在传输期间就开始工作。decode 的第一层 attention 只需要第一层 KV,后面的层可以边算边等;对 batch 里其它请求,decode 引擎也不必停等一条新请求的 57GB。
MTP 与 KV 回滚
GLM-5.3 的 MTP 层在 decode 时会产生草稿 token,目标模型验证后可能拒绝一部分。被拒绝的草稿 token 对应的 KV 要回滚,否则下一步会读到不属于当前序列的 KV。
PD 交接的边界在这里很重要:回滚只能发生在 decode 本地新写的 KV 上,不能碰 prefill 传来的前缀 KV。实现上通常用「已确认长度」而不是「物理页释放」来做回滚:把序列长度截断到接受长度,下一页写入时覆盖草稿页;前缀页的引用计数不变。SGLang 的 req_to_token 和 vLLM 的 block table 都支持这种逻辑截断,不需要真的把页还给池子。
MTP 草稿层自己的索引器缓存也要参与交接。它只覆盖草稿模型的前缀,如果缺失,草稿 token 的质量会下降,接受长度变短,PD 的收益被吃掉一部分;但它不影响正确性,因为目标模型会验证。工程上通常把 draft 的索引器缓存和主模型的索引器缓存一起注册,层数按 draft 的实际层数追加。
两套实现放在一起看
把 SGLang 与 vLLM 的 PD 实现按同一组问题对照,差异会清楚很多。
| 维度 | SGLang | vLLM |
|---|---|---|
| 控制面 | 独立 bootstrap server,/route 分配 room | kv_transfer_params 跟着请求走,connector 管理会话 |
| 状态机 | KVPoll 五态,集中在 decode 请求对象 | connector 回调 + KVConnectorOutput,分散在调度器与 worker |
| 索引器缓存 | 独立 StateType.DSA,与主 KV 并列注册 | 独立 MLAAttentionSpec(cache_role=INDEXER),独立 region |
| 页号传递 | 发送端与接收端各自生成页号数组,按位置对应 | remote_block_ids 按 group 传,NIXL READ/WRITE 指定块 |
| 默认方向 | prefill 主动 send(Mooncake) | decode 主动 pull(NIXL 默认别名 PullConnector) |
| 版本/布局校验 | bootstrap 注册 kv_cache_dtype、kv_layout,checksum 可选 | compatibility hash + NixlAgentMetadata + 每区域布局校验 |
| 索引器分片 | 索引池不按 TP 切分(等价于 max_tp_shards=1),CP layer split 用 item_len=0 跳过 | replicates_kv_cache():MLA 或 TP>头数即复制,避免按头切分 |
| 典型失败 | 无 IB 设备时静默回退 TCP | 版本哈希不匹配时拒绝握手 |
两套实现都绕不开同一组约束:索引器缓存必须独立成组、页内布局必须一致、TP 映射必须把复制型缓存当复制处理。差别只在把控制面放在哪、把「什么时候传」的决定权给谁。
站内还有两篇更偏接口层的拆解可以对照:SGLang 源码完全拆解(十二):Disaggregation 讲 SGLang 的 P/D 拆分与传输状态机,vLLM 源码完全拆解(十七):KV Connector 讲 connector 的通用生命周期。本篇的重点不是重复这些接口,而是把 GLM-5.3 特有的两份缓存、索引器分片与 1M 容量账放进同一张图里。
账单:一次 1M 请求的传输时间
理论下界
以 8 张 400Gbps 网卡、合计 400GB/s 为例,56.6GB 的理想传输时间:
主 KV 53.7GB 占 0.134 秒,索引器 2.9GB 占 0.0073 秒。索引器虽然只占 5% 的字节,但它必须在对应层的注意力之前到达,所以不能简单地按「先传大的」排序。
这里的 400GB/s 是 8 张 400Gbps 网卡的线速合计,工程上还要按消息大小打折:单次 RDMA 消息越大越接近线速,按页拆成 64-token 小块后,有效带宽通常只有线速的 60%–80%。所以更现实的下界应按 250–320GB/s 估,即 0.18–0.23 秒。
按层拆开,一层主 KV 688MB 约 1.72ms;一层索引器 132MB 约 0.33ms。21 个 full 层如果均匀分布,平均每 3.7 层就有一层要额外传索引器;这些层的关键路径是 1.72 + 0.33 ≈ 2.05ms,其余层 1.72ms。
实际开销从哪来
实际测量通常落在 0.5–1 秒,比理论值高 3–7 倍。差额来自五处:
- 页表打包:以页大小 64 为例,16384 个页号不是一次 RDMA 就能发完的。每个页号 4 字节,一条请求 64KB 的页表;分块、去重、按层切分都要 CPU 时间。SGLang 的 transfer worker 还要把 Tensor 页号转成 numpy,再交给 transfer engine。
- RDMA 注册:每层 KV 池的基地址要在 NIC 上注册内存区(MR)。78 层 + 21 层索引器 = 99 个区域;注册本身在启动时完成,但每层传输要查表、拼 scatter-gather 列表。
- 接收端写入:RDMA WRITE 到 decode 的显存后,decode 要等写入完成才能读;如果用了 staging buffer,还要多一次显存到显存的拷贝。SGLang 的
enable_staging就是为跨 NUMA/跨卡场景准备的。 - 通知往返:每层完成后要发通知,decode 的
wait_for_layer_load才被唤醒。通知走的是控制通道,不是数据通道;层数越多,通知次数越多(99 次),但每次只有几十字节。 - 尾块与重传:最后一层的传输无法被计算掩盖;任何一层校验失败都要重传该层。
与 TTFT 的关系
把 1M prefill 的时间线摊开(数量级示意):
| 阶段 | 主要成本 | 量级 |
|---|---|---|
| chunked prefill 主干 | 约 100 PFLOP | 数秒 |
| 索引器打分 | 约 94 PFLOP + 46TB 索引 K 读取 | 数十秒 |
| KV 写入 | 57GB 写 HBM | 十几毫秒 |
| KV 交接 | 57GB 跨网络 | 0.5–1 秒 |
| decode 首步 | 78 层前向 + 采样 | 数十毫秒 |
交接只占 TTFT 的百分之几,但它是串行在最后的百分之几:prefill 算完之前,decode 拿不到完整 KV;交接没完成,decode 不能出 token。逐层重叠能把这段串行时间压到「最后一层 + 索引器尾块」,但压不到零。对 1M 请求,这意味着 PD 的 TTFT 下界是:
而不是简单的 。任何声称「PD 不增加 TTFT」的说法,都忽略了这笔尾传输。
对 decode 吞吐的影响
交接完成后,57GB 的 KV 常驻 decode 的 HBM。decode 每一步要读:
- 当前层的主 KV(只读 Top-2048 个 token,约 1.3MB/层);
- 当前层的索引 K(要读全部前缀,1M × 132B = 132MB/层,21 层);
- 激活的专家权重。
把三种读取量按 1M 前缀算一遍,DSA 在 decode 侧的账本就清楚了:
前者是全部 21 个 full 层的索引 K,后者是全部 78 层读到的 Top-2048 个主 KV。两者相差约 27 倍:decode 一步里,索引器要读的字节数远大于主注意力。 这是 DSA 在 decode 侧的真实账本:稀疏化把 的主 KV 读取压成了常数级的 105MB,但索引器的 扫描仍要读 2.9GB。PD 把这条请求搬到 decode 节点,并没有改变这笔账;它只是让 decode 节点可以按「带宽型」配置,专门承受这笔读取。
故障模式与工程约束
静默回退到 TCP
SGLang 的 Mooncake 后端在容器里找不到 IB 设备时,会回退到 TCP。这个回退通常只打一条日志,不会让请求失败;但 57GB 走 TCP,传输时间会从 0.5 秒级掉到几十秒级,TTFT 直接崩坏。部署检查必须确认:
- 容器里能看到
/dev/infiniband/*; --disaggregation-ib-device指定的网卡存在且 UP;- Mooncake 日志里出现 RDMA 设备列表,而不是
TCP回退。
vLLM 的 NIXL 也有类似的 backend 选择(UCX/GDS 等)。如果 NIXL 初始化失败,连接器可能在启动时就报错,比静默回退好一些;但如果 backend 列表里同时有 RDMA 和 TCP,实际选哪条路径要看环境变量与设备发现结果,不能只看配置。
布局与页大小不匹配
三类最常见的布局错误:
- 主 KV 格式不同:prefill 用
fp8_ds_mla(656B),decode 用fp8_e4m3(576B)。两边都「能跑」,但 decode 会把 656B 的行按 576B 解释,K/V 全错。vLLM 在握手哈希里覆盖kv_cache_dtype,SGLang 在 bootstrap 注册里带kv_cache_dtype与kv_layout,就是为了尽早拒绝。 - 块大小不同:prefill 的页 64 token,decode 的页 32 token。页号无法一一对应,必须做 2:1 映射;如果实现直接按页号数组传,第二半页会丢。
- 索引器行宽不同:132B(FP8+scale)与 128B(纯 FP8,无 scale)不能混。少 4 字节 scale,索引器打分就会把 scale 当成下一个 token 的 key。
这些错误不一定在传输时报错。RDMA 只检查地址和长度,不检查语义;错误要等到 decode 输出退化才暴露。因此 checksum 与布局校验不是可选项,而是 PD 的必需组件。
拓扑不匹配
MLA 主 KV 在 TP 下是复制的,索引器缓存也是复制的;但 MoE 的专家是切分的。PD 两端可以有不同的 TP/EP,只要 connector 能把「本地 rank 该读哪个远端 rank 的哪一块」算对。
vLLM 的 compute_tp_mapping 处理了三种情况:
- 本地 TP = 远端 TP:一一对应;
- 本地 TP > 远端 TP:多个本地 rank 从一个远端 rank 读不同的头分片(MLA 例外,读完整副本);
- 本地 TP < 远端 TP:一个本地 rank 从多个远端 rank 读。
索引器缓存只有 1 个头,必须走「复制」分支;如果被当成头分片,decode 只拿到 1/N 的索引向量,Top-K 直接失效。SGLang 的 DSA 索引池有 max_tp_shards=1 的等价约束,CP layer split 下还会出现「某些 rank 不拥有某些层的索引器」的情况,item_len=0 就是为此准备的。
请求 abort 与超时
57GB 的传输不是瞬间完成的,请求可能在传输中途被取消:客户端断开、decode 容量不足、prefill 侧 OOM、上层网关超时。每一侧都要有 abort 协议:
- prefill 停止发送,释放 room;
- decode 停止等待,释放已分配的 KV 页;
- 已经发出的 RDMA WRITE 要等完成或丢弃,不能留下半写页;
- 状态机进入
Failed,后续调度不再碰这条请求。
SGLang 的 transfer worker 在每个 chunk 出队时检查 room 状态,失败就跳过;vLLM 的 connector 用 request_finished 与 KVConnectorOutput 把完成/失败回传给调度器。两者都必须保证:abort 后的页可以被安全复用,否则下一条请求会读到上一条的半截 KV。
块的租约与过期
vLLM 的 NIXL 元数据版本历史里,第 4 版加了「KV block lease renewal through heartbeats」,第 5 版加了 remote_blocks_expiry_time 与时钟同步时间戳。这不是过度设计:decode 可能因为调度延迟,在 prefill 算完很久之后才来取 KV;如果 prefill 已经把块还给池子,decode 会读到别人的数据。
租约机制让 prefill 在块被引用期间不回收,decode 通过心跳续租;过期后 prefill 才释放。对 1M 请求,57GB 的块不能无限期占着,租约时间是容量与安全之间的折中。
Prompt token 必须复用
PD 两段各自渲染 chat template、各自分词,是另一个隐蔽的错误源。模板里的日期、系统提示、工具定义如果有任何非确定性,两段得到的 token 序列就会不同;KV 的位置对不上,decode 会从错误的位置继续。
vLLM 的文档明确建议:prefill 请求带 return_token_ids,decode 请求把 prompt_token_ids 带回来,跳过重新分词。SGLang 的 tokenizer manager 也在请求对象里保留原始 token id。对 1M 请求,重新分词的代价不只是时间,还有「分出来不一样」的正确性风险。
容量碎片
以页大小 64 为例,57GB 的请求需要 16384 个 64-token 页。PagedAttention 的页式分配避免了连续 57GB 的要求,但页池本身会被大量小请求切碎;一条 1M 请求进来时,可能没有 16384 个可用页。decode 侧必须在准入时检查「最大连续可用页数」,而不是只看总空闲字节。SGLang 的 PrefillAdder 与 vLLM 的 KVCacheManager 都会做这类检查;PD 只是在它前面多加了一道「远端容量」的检查。
把这条 PD 链路压成一张表
把前面的内容按「阶段—算子—通信—数据量」排成一张表,方便和前三篇对照。
| 阶段 | 主要算子 | 集合通信 | 数据量/备注 |
|---|---|---|---|
| 入口与路由 | JSON 解析、chat template、选 P/D 实例 | 无(HTTP/gRPC) | 请求元数据;token id 必须两段一致 |
| 分词 | tokenizer | 无 | CPU;1M token 的 ids 约 4MB |
| prefill 每层 | A 投影 GEMM、q/kv RMSNorm+RoPE、索引器 Q/K 投影、FP8 MQA logits、Top-K、稀疏 MLA、o_proj | 层首 fused AllReduce、o_proj ReduceScatter(TP8) | 主 KV 656B/token/层;索引 K 132B/token/full 层 |
| prefill MoE | 门控、top-8 路由、dispatch、分组 GEMM、combine、共享专家 | DeepEP dispatch/combine;DP Attention 的 AllGather | 每 token 8 个专家;EP8 下跨卡 |
| prefill 收尾 | 最后一层 RMSNorm、LM Head、采样 | LM Head 词表 AllGather(TP8) | 只取最后一个位置 |
| KV 交接 | 页表打包、RDMA READ/WRITE、逐层通知、checksum | RDMA/RoCE(Mooncake 或 NIXL) | 56.6GB;78 层主 KV + 21 层索引 K |
| decode 每层 | 同上,但 Q 走吸收形态、索引器扫全前缀 | 同 prefill 的 TP/DP 通信 | 索引 K 读取约 2.9GB/step;稀疏 KV 约 105MB/step |
| decode MoE | 同 prefill,batch 为请求数 | 同 prefill | 权重读取占大头 |
| MTP | 草稿层 5 步、目标验证、KV 回滚 | 草稿侧不做 AllGather | 一次验证 6 个 token |
| 输出 | 采样、detokenize、SSE | 无 | 首 token 要等最后一层 KV |
这张表里,PD 新增的只有「KV 交接」一行;其余算子与通信和前三篇完全一致。换句话说,PD 没有改变模型的计算图,它改变的是计算图在两台机器上的切分位置,以及切分处多出来的一次数据搬运。
小结
把 PD 交接压成几句话:
- 交的是两份缓存,不是一份。 78 层 × 656B 的主 KV 是 53.7GB,21 层 × 132B 的索引器缓存是 2.9GB;后者决定主注意力读哪些 token,漏传不会报错,只会让长上下文悄悄退化。
- 控制面先于数据面。 SGLang 用 bootstrap server +
KVPoll状态机,vLLM 用kv_transfer_params+ connector 钩子;两者都在回答「去哪个引擎、哪些块、什么时候可以调度」。 - 按层注册、按页传输、按层通知。 57GB 不能打包成一个连续张量;每层独立注册,索引器缓存独立成组,页号按位置对应,通知按层推进。
- 解码启动靠重叠,不靠等齐。 第 0 层先到、索引器与主 KV 同层发、最后一层暴露在关键路径;1M 请求的 TTFT 下界包含一笔尾传输。
- PD 的正确性靠校验,不靠「没报错」。 布局哈希、页大小、TP 映射、checksum、租约、prompt token 复用,任何一项缺失都可能让系统「正常运行但输出错误」。
前三篇讲的是单机内的算子与通信;这一篇讲的是两台机器之间的交接。把四篇连起来,GLM-5.3 的一条 1M 请求才算真正走完:从 HTTP 入口、分词、调度、prefill 的索引器与稀疏 MLA、KV 落盘,到跨节点交接、decode 的逐层读取、MTP 验证与采样。每一段都有各自的瓶颈,而 PD 把其中最容易互相拖累的两段拆开了——代价是这 57GB 必须在网络上真实地走一遍。
参考资料
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving(arXiv:2407.00079)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving(arXiv:2401.09670)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与 MLA 结构,arXiv:2512.02556)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 与 KV 压缩,arXiv:2405.04434)
- vLLM 文档:NIXL KV Connector 使用说明
- vLLM 文档:Disaggregated Prefilling
- vLLM 源码:NIXL connector metadata 与握手协议
- vLLM 源码:NIXL base worker(区域注册、按层加载与等待)
- vLLM 源码:NIXL TP mapping(MLA 复制与头分片映射)
- SGLang 文档:PD Disaggregation
- SGLang 源码:disaggregation/utils.py(KVArgs、StateType 与状态缓冲)
- SGLang 源码:disaggregation/decode.py(KVPoll、页表与 DSA suffix payload)
- SGLang 源码:disaggregation/mooncake/conn.py(Mooncake 传输与 transfer worker)
- SGLang 源码:mem_cache/index_key_cache.py(索引器缓存的 132 字节行布局)
- FlashMLA:MLA 解码内核与分页 KV 实现
- DeepEP:MoE dispatch/combine 通信库
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(arXiv:2603.12201)
- vLLM GLM-5.3 部署配方
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



