


GLM-5.3 推理全链路(二):一条请求在 vLLM 里的算子融合、索引器复用与通信账本
承接上一篇:同一个模型,两套融合边界
上一篇沿着 SGLang 的源码,把 GLM-5.3 的一条请求从 HTTP 入口走到 SSE 返回:PrefillAdder 预算 KV、ScheduleBatch 拼 batch、ForwardBatch 展平输入,然后每一层依次经过 A 投影、q/kv RMSNorm、RoPE、闪电索引器、稀疏 MLA、o_proj 与 MoE;78 层里有 21 层运行 full 索引器,57 层直接复用上一层的 Top-K;MTP 草稿层跑 5 步,目标模型验证 6 个 token。结论可以压成三句话:
- DSA 不减少 KV 的存储,只减少 KV 的读取次数:每 token 每层仍是 576 维的 MLA latent,1M 上下文的 KV 账单不会因为 Top-2048 而变小。
- 索引器的跨层复用是 GLM-5.3 最值钱的结构性节省:21/78 个 full 层承担了全部索引计算,其余 57 层只读结果。
- 真正贵的不是矩阵乘,而是三类搬运:权重从 HBM 到 SM、KV 从 HBM 到 SM、hidden 在卡间搬。
这一篇换到 vLLM,仍然是同一个模型、同一份 1M 上下文、同样 8 卡 TP8 的部署,但代码路径完全不同。模型结构决定了哪些算子必须存在,框架决定了这些算子怎样被切开、融合、排序,以及哪一步要跨卡。把两边放在一起看,才能分清「模型决定的」和「框架决定的」。
先看模型本身。zai-org/GLM-5.3 的 config.json 给出的关键字段如下(这些数字后面每个账本都要用到):
| 字段 | 值 | 含义 |
|---|---|---|
num_hidden_layers | 78 | Transformer 层数 |
hidden_size | 6144 | 残差流宽度 |
num_attention_heads | 64 | 查询头数 |
q_lora_rank / kv_lora_rank | 2048 / 512 | MLA 的两个低秩维度 |
qk_nope_head_dim / qk_rope_head_dim | 192 / 64 | 每头 NoPE 与 RoPE 维度 |
v_head_dim | 256 | 每头输出维度 |
n_routed_experts / num_experts_per_tok | 256 / 8 | 路由专家总数与每 token 激活数 |
n_shared_experts | 1 | 共享专家数 |
moe_intermediate_size | 2048 | 单专家中间维 |
first_k_dense_replace | 3 | 前 3 层是稠密 FFN |
index_topk / index_n_heads / index_head_dim | 2048 / 32 / 128 | DSA 索引器的 Top-K、头数与头维 |
index_topk_freq / index_skip_topk_offset | 4 / 3 | 每 4 层一个 full 索引器,前 3 层不跳 |
indexer_types | 21 full + 57 shared | 78 层的索引器类型分布 |
index_share_for_mtp_iteration | true | MTP 草稿第 2 步起复用第 1 步的索引 |
routed_scaling_factor / scoring_func | 2.5 / sigmoid | MoE 路由缩放与打分函数 |
max_position_embeddings / vocab_size | 1048576 / 154880 | 上下文窗口与词表 |
indexer_types 的 21/57 分布不是随意的。vLLM 里计算某一层是否跳过索引器的公式是:
skip_topk = ( max(layer_id - index_skip_topk_offset + 1, 0) % index_topk_freq != 0)代入 offset=3、freq=4:层 0、1、2 的括号内都是 0,0 % 4 == 0,所以是 full;层 3、4、5 分别是 1、2、3,全部 skip;层 6 是 4,又回到 full。于是 full 层落在 0–2 和 6、10、14、…、74,共 3 + 18 = 21 层。前 3 层恰好就是 first_k_dense_replace=3 的三层稠密 FFN 层——索引器在最底层不省,是因为这三层的注意力输出要直接喂给稠密 FFN,误差没有后续层可以摊薄。
装配:架构名、配置修正与 GLM 专用补丁
vLLM 收到 architectures: ["GlmMoeDsaForCausalLM"] 后,先查注册表。vllm/model_executor/models/registry.py 把 GlmMoeDsaForCausalLM 指向 vllm.models.deepseek_v32,而该包的 __init__.py 在 CUDA 平台把 DeepseekV32ForCausalLM 直接别名成 GlmMoeDsaForCausalLM:
if current_platform.is_cuda(): from .nvidia.model import DeepseekV32ForCausalLM as GlmMoeDsaForCausalLM也就是说,GLM-5.3 与 DeepSeek-V3.2 共用同一套 DSA 主干,差异集中在三处:配置修正、GLM 专用的低延迟 GEMM 表、以及 MTP 层里的 index_share_for_mtp_iteration。这种「同主干 + 少量补丁」的复用在工程上很常见,但也意味着读 GLM-5.3 的推理路径时,必须同时盯住 deepseek_v2.py(通用 MLA/MoE)与 deepseek_v32/(DSA 特化)两棵目录。
配置修正:FP8 KV 与 DCP 默认值
vllm/model_executor/models/config.py 里的 GlmMoeDsaForCausalLM.verify_and_update_config 做了两件事:
if cache_config.cache_dtype == "auto" and current_platform.is_device_capability_family(100): cache_config.cache_dtype = "fp8_e4m3" ...# For Glm-Moe-DSA, qrep + a2a is better than the default all-gather + ag-rsvllm_config.parallel_config.set_dcp_defaults( comm_backend="a2a", q_replicate=True)第一件事把 SM10x(B200/B300 这一代)上的 KV 缓存默认值改成 fp8_e4m3。第二件事是给 decode context parallel(DCP)设默认通信方式:q_replicate=True 让查询在每个 rank 上复制一份,comm_backend="a2a" 用 all-to-all 而不是 all-gather + all-gather-reduce-scatter 的组合。对 GLM-5.3 这种 64 个查询头、每头 256 维输出的模型,复制查询比复制 KV 便宜得多——查询只有当前 token,KV 是整个上下文。
低延迟 GEMM 表:按 (N, K, M) 查表
DeepseekV32ForCausalLM.__init__ 在 model_type == "glm_moe_dsa" 时调用 enable_glm52_low_latency_gemm。这个函数是 GLM 系列在 vLLM 里最「非通用」的一段代码:它遍历模型里所有未量化的 LinearBase,按权重的 (N, K) 形状去一张实测表里查,命中就把 quant_method 换成 GLM52LowLatencyLinearMethod,由后者在运行时按 token 数 M 再选一次后端。
表里的数字是在 B300(SM103)和 VRNVL72(SM107)上实测的。以 q_a + kv_a 融合后的投影为例:N=2624, K=6144,在 SM107 上 M=4 时 CuTe DSL 的 skinny GEMM 是 5.84 微秒,cuBLAS 是 6.91 微秒;q_b_proj 在 TP4 下 N=4096, K=2048,表内实测 4.31 对 5.71 微秒;MTP 的 eh_proj(N=6144, K=12288)M=1 时 12.90 对 16.96 微秒。
为什么要为几个投影单独建表?因为 decode 的矩阵乘是「瘦 GEMM」:M 只有 batch 大小(通常 1–32),N 和 K 很大。cuBLAS 的通用分块按大 M 设计,M=1 时大部分 CTA 没有活干;而 SkinnyGemmConfig 明确指定了每 CTA 处理的 N 宽度、K 展开因子和 split-K 方式,能把一个 2624×6144 的权重读取拆成刚好铺满 SM 的数量。M 变大后又回到 cuBLAS 更划算,所以表里只对特定 M 生效,其余 M 直接 fallback:
def run_glm52_plan(plan, x, weight): if plan is None or not _runtime_ok(x, weight): return None entry = plan.get(x.shape[0]) if entry is None: return None backend, config = entry if backend == "cute": return shape_dynamic_skinny_gemm(x, weight, config) ...这张表只对 BF16 权重生效。GLM-5.3 官方发布的是 FP8 checkpoint,所以在 FP8 部署里这条路径通常不触发;它主要服务 GLM-5.3-BF16 与 NVFP4 变体里那些保持 BF16 的注意力投影。读源码时如果只盯着 FP8 路径,很容易以为这段代码是死代码。
请求怎么进来:入口、调度与 DSA 需要的额外元数据
vLLM 的请求入口与 SGLang 的职责划分相似,但进程结构不同:一个 API Server 进程处理 HTTP 与分词,再通过 ZMQ 把 EngineCoreRequest 发给 EngineCore 进程;EngineCore 里跑调度循环,再经 worker 把计划交给 GPU 进程。
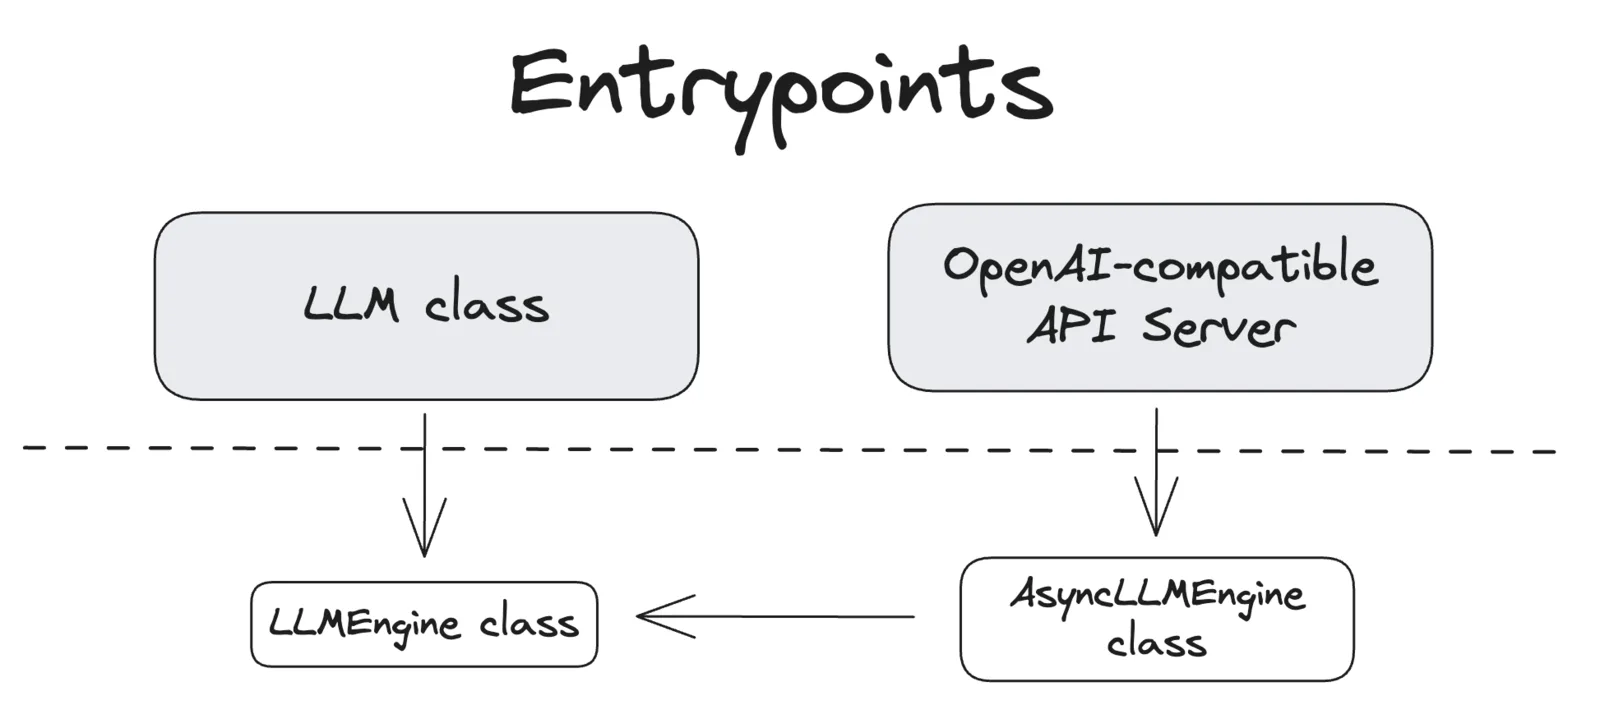
上图是 vLLM 官方设计文档里的入口关系图:LLM 是离线推理的 Python 接口,LLMEngine 是所有入口最终汇入的统一引擎,再往下是 Worker 与 ModelRunner。对 GLM-5.3 来说,请求进来之后要经过三件事才会变成 GPU 输入:
- 分词与模板渲染:GLM-5.3 默认开启思考模式,chat template 会把
reasoning_effort解析成Low/High/Max并注入系统提示词;这一步不碰 GPU,但它决定了 prompt 长度,也就决定了后面的 KV 预算。 - 加入调度器:请求进入等待队列,携带 prompt token、最大输出长度、采样参数。
- 调度计划:调度器产出本轮要跑的请求、每条请求本轮喂入的 token 数和 KV 槽位。
第三件事对 DSA 模型有一个额外产物:DSA 在 decode 阶段需要知道每条请求「当前能看多少历史 token」,索引器内核需要这个长度做分页 MQA logits 和 Top-K。调度器把这件事提前算好,写进 InputBatch。
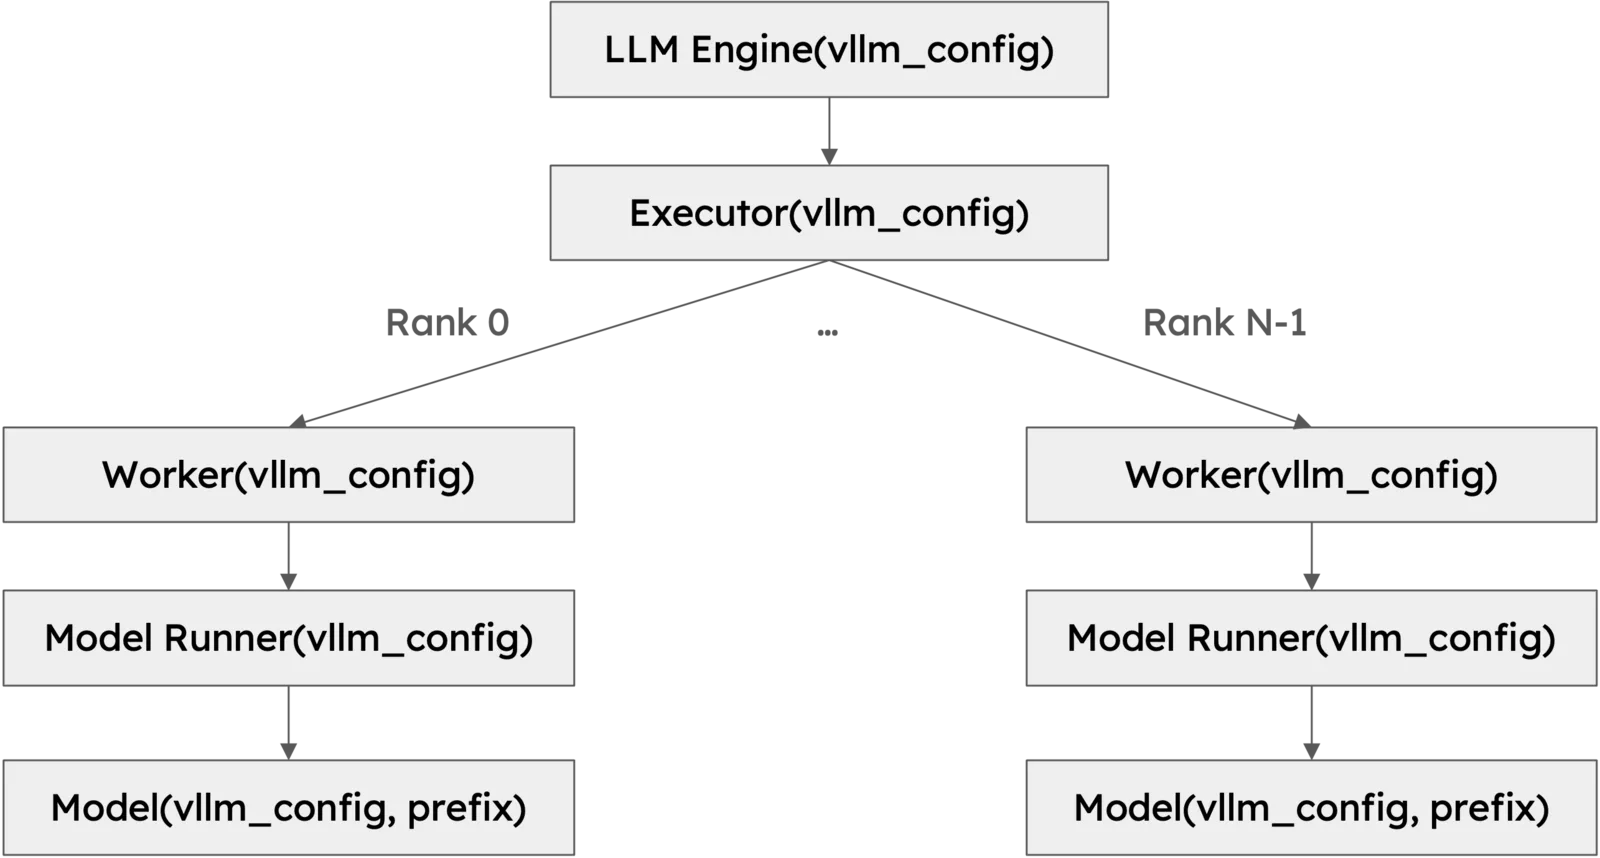
官方文档里的类层次图解释了为什么 GLM-5.3 的这么多「补丁」都挂在模块构造阶段:VllmConfig 从引擎一路传到每一层,DeepseekV32Attention.__init__ 在构造时就决定这一层有没有索引器、用哪种 RoPE、o_proj 要不要 reduce_results。一旦构造完成,前向阶段只做查表和启动 kernel,不再做结构判断——这是 CUDA Graph 能捕获整段前向的前提。
一层解码器内部:六段算子的融合边界
在进入层内之前,先看清「一次 step」在引擎里是什么。vLLM 设计文档把 LLMEngine 的职责拆成四段:输入处理(分词)、调度(决定这一步跑谁)、模型执行(可分布在多卡多机)、输出处理(detokenize 与流式回传)。
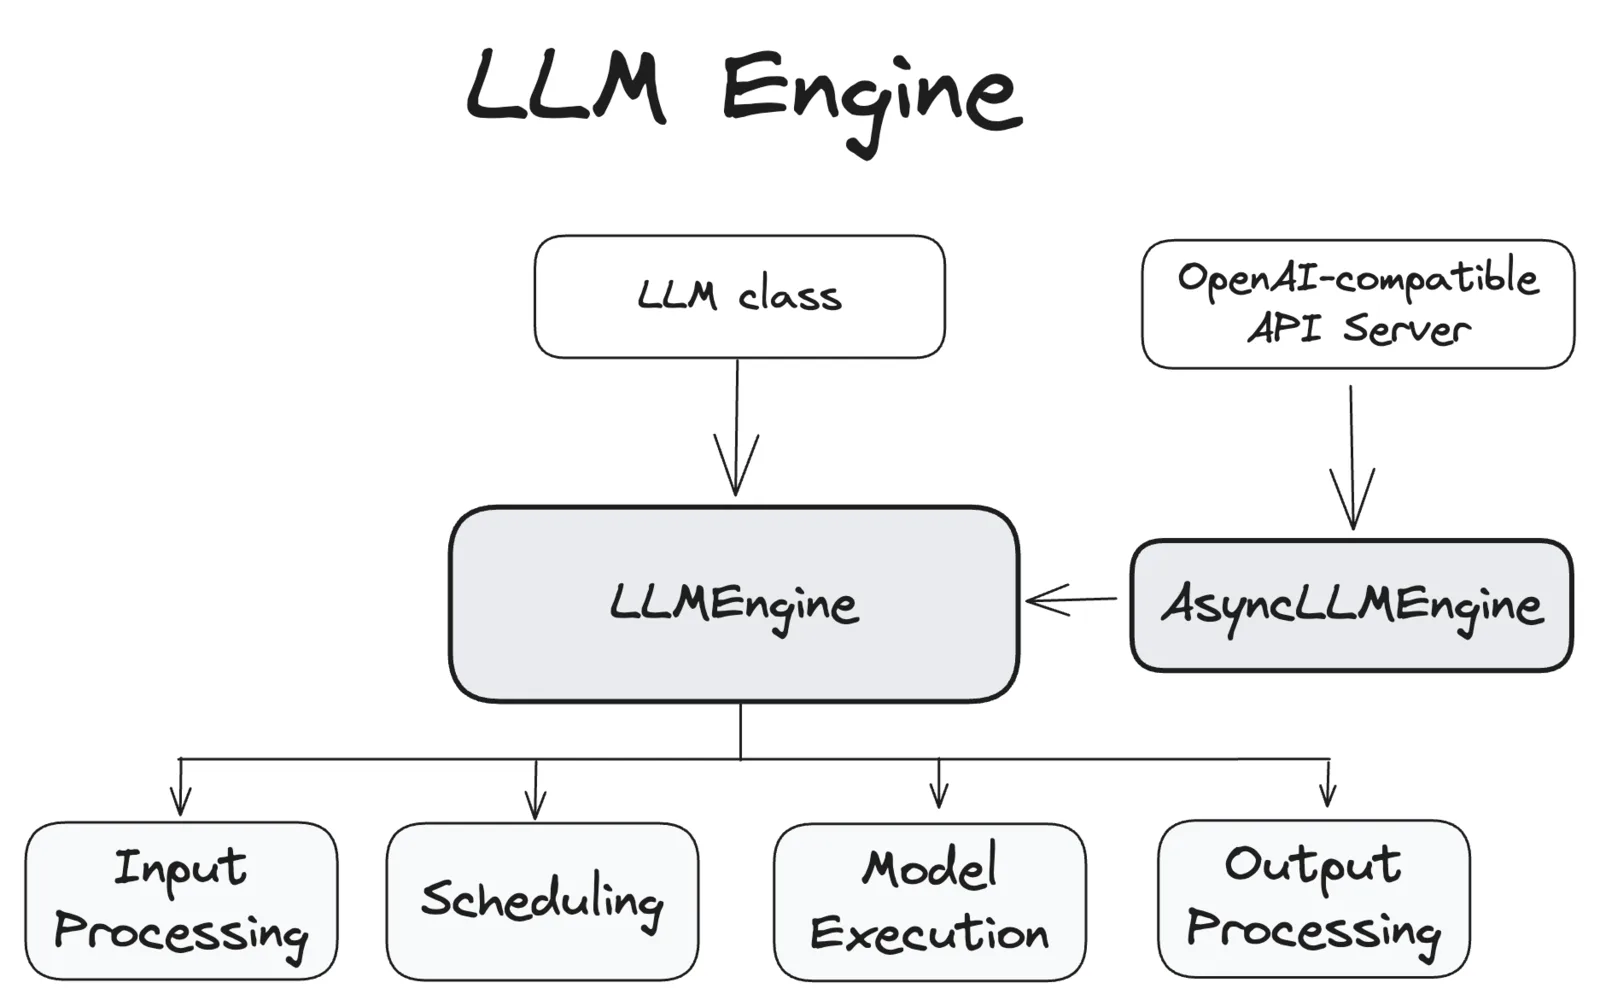
对 GLM-5.3,这张图要补上两件 DSA 特有的事:调度不仅产出 token 数与 KV 槽位,还产出每条请求的上下文长度(索引器内核要它);模型执行的内部不再是一个「整模型黑盒」,而是 78 次六段算子加 75 次 MoE,外加 MTP 的草稿环。下面拆的就是这个黑盒。
这是整篇文章的核心。以下是 vllm/models/deepseek_v32/attention.py 里 DeepseekV32Attention.forward 的全文骨架,我把它切成六段,每段对应一个或几个 kernel:
def forward(self, positions, hidden_states): # ---- 段 1:A 投影(融合 q_a 与 kv_a)---- qkv_lora = self.fused_qkv_a_proj(hidden_states)[0] q_c, kv_c, k_pe = qkv_lora.split( [self.q_lora_rank, self.kv_lora_rank, self.qk_rope_head_dim], dim=-1 ) # ---- 段 2:索引器的 K 与权重投影 ---- if self.indexer is not None and not self.skip_topk: kw = self.indexer.wk_weights_proj(hidden_states)[0] index_k = kw[:, :self.indexer.head_dim] index_weights = kw[:, self.indexer.head_dim:] # ... # ---- 段 3:fused_norm_rope:q/kv RMSNorm、RoPE、索引 K 的 LayerNorm、 # 索引 K 与 MLA KV 的分页写入、Top-K 缓冲清零 ---- q_c = fused_norm_rope(positions, q_c, self.q_a_layernorm.weight, ..., ...) # ---- 段 4:q_b 投影、查询吸收、fused_q(RoPE + 量化 + 索引权重缩放)---- q = self.q_b_proj(q_c)[0].view(-1, self.num_local_heads, self.qk_head_dim) q_nope, q_pe = q.split([self.qk_nope_head_dim, self.qk_rope_head_dim], dim=-1) if prepare_mqa_query: ql_nope = torch.bmm(q_nope.transpose(0, 1), self.W_UK_T).transpose(0, 1) index_q = self.indexer.wq_b(q_c)[0].view(-1, self.indexer.n_head, self.indexer.head_dim) index_q_fp8, index_weights_out, mqa_q = fused_q(...) # ---- 段 5:索引器 Top-K 与稀疏 MLA(CUDA Graph 之外,需要 break)---- self._sparse_indexer_and_attn(...) # ---- 段 6:输出吸收 + o_proj(reduce_results=False)---- return self.o_proj(output)[0]这六段与上一篇 SGLang 的九段分解几乎一一对应,融合的边界也大体重合:SGLang 的 fused_norm_rope 同样把 q/kv 归一化、RoPE、主 KV 与索引器 K 的写入融成一个 kernel。真正的差异在粒度:vLLM 把同一条链拆成同一个 Triton kernel 的 4 个 program 分支,每个 token 的四个分支并行执行,并且把 Top-K 缓冲清零也放进了第 4 个分支;SGLang 则在 kernel 内按 has_indexer 决定是否更新索引缓存。两边的选择都指向同一个目标——把 decode 小 batch 下的 launch 次数压到最低。
段 1:A 投影为什么是融合的
MLA 的两个「A 投影」都是从同一个 6144 维的 hidden 出发:q_a_proj 把 hidden 压到 2048 维的 q_c,kv_a_proj_with_mqa 把它压到 576 维(512 的 kv_c 加 64 维的 RoPE key k_pe)。两者共享同一份输入,vLLM 用 DeepSeekV2FusedQkvAProjLinear 把两次 GEMM 合成一次 (6144 → 2624) 的 GEMM,然后一次 split 分出三段:
q_c, kv_c, k_pe = qkv_lora.split( [self.q_lora_rank, self.kv_lora_rank, self.qk_rope_head_dim], dim=-1)注意这个线性层的构造参数里 disable_tp=True——它是在 TP 组内复制的。原因是它输出的是低秩 latent:q_c 只有 2048 维、kv_c 只有 512 维,如果按 TP=8 把它切开,后面的 q_b_proj 和 kv_b_proj 就要先 all-gather 才能拿到完整的 latent,反而多一次通信。所以 A 投影每个 rank 算一整份,多花的是算力(8 个 rank 算同一件事),省的是通信。
decode 时这一步的算术强度极低:每 token 读取 2624×6144 个 BF16 权重(约 32MB),只做约 32M 次乘加。带宽受限,时间基本等于「读权重 / 单卡带宽」。在 8 卡 H200 上,单卡约 4.8TB/s,32MB 大约 7 微秒;再乘以 78 层、以及 8 个 rank 各自重复一遍,这就是 decode 每 token 的固定开销底座。
段 2:索引器的两组投影
索引器的权重投影 wk_weights_proj 是一个 MergedColumnParallelLinear,输出宽度是 [index_head_dim, index_n_heads] = [128, 32],合计 160 维。前 128 维是索引器的 key index_k,后 32 维是每个索引头的权重。它同样 disable_tp=True——索引器在每个 rank 上完整复制,这和上一篇 SGLang 的结论一致:索引器是「按 TP 复制 + Top-K 广播」的,不是按头切分的。
index_k 在进入缓存前要经过 LayerNorm(k_norm),而主流 MLA 的 kv_c 走的是 RMSNorm。这个差别来自 DSA 的原设计:索引 key 是 128 维的单头表示,LayerNorm 带偏置、去均值,能让后续的 FP8 量化分布更窄;RMSNorm 无偏置、不去均值,对离群值的控制更弱。vLLM 在 DeepseekV32Indexer 里把 k_norm 建成了 LayerNorm(head_dim, eps=1e-6, dtype=torch.float32),并以 FP32 存权重、算归一化。
段 3:fused_norm_rope——一个 kernel、四类 program
这是 vLLM 对 GLM-5.3 最激进的一段融合。_fused_norm_rope_kernel 的网格是 (num_tokens, 4),第 0 维是 token,第 1 维是 pid ∈ {0,1,2,3},四个分支各干一件事:
| pid | 分支名 | 做什么 | 写给谁 |
|---|---|---|---|
| 2 | Q RMSNorm | 对 q_c 做 RMSNorm | q_c_out(供 q_b 投影) |
| 1 | KV Norm + RoPE + MLA 写入 | 对 kv_c RMSNorm、对 k_pe 做交错 RoPE、把两者拼成 576 维写进 MLA 分页缓存 | kv_c_out / k_pe_out / mla_kv_cache |
| 0 | 索引 K 的 LayerNorm + RoPE + FP8 量化 + 写入 | 对 index_k 做 LayerNorm、RoPE、按块 FP8 量化,写入索引器 K 缓存 | indexer_k_cache 与 scale 区 |
| 3 | Top-K 缓冲清零 | 把该 token 在共享 Top-K 缓冲里的 2048 个槽位填成 -1 | topk_indices_buffer |
为什么能融成一个 kernel?因为四件事共享同一组输入——同一个 token 的 positions、同一个 slot_mapping、同一个 cos_sin_cache——融成一个 kernel 后,位置与余弦正弦表只读一次,launch 开销从四次变一次。对 decode 这种每次只处理几十个 token 的小 kernel,launch 开销本身就是可观的比例。
pid 2 的 Q RMSNorm 有一个容易踩的细节,源码注释写得直接:
if pid == 2: # Q RMS norm. Runs for every row: under DCP a negative slot only # means another rank owns this token's KV slot, but the query is # still needed on every rank (queries are not sharded), so the # slot-based skip below must not gate it.也就是说,slot_mapping < 0 表示「这个 token 的 KV 归另一个 rank(DCP 场景)」,此时 pid 0/1/3 都应当跳过,但 pid 2 必须照常执行——查询在每个 rank 上都要有,因为它后面还要和本 rank 负责的那段 KV 做注意力。少算一个 rank 的查询,就会丢掉这段 KV 的贡献。
pid 1 的 KV 分支在写缓存时,会把「归一化后的 kv_c」与「RoPE 后的 k_pe」直接拼成一行写进去,全程留在寄存器里:
kv_c = _rms_norm(kv_c, kv_rms_w, kv_rms_eps, KV_DIM)...r1 = x1 * cos - x2 * sinr2 = x2 * cos + x1 * sin...# MLA concat_and_cache: write [kv_c_normed, k_pe_roped] to cache.slot_idx = tl.load(slot_mapping_ptr + tok_idx)mla_block_idx = slot_idx // mla_block_sizemla_block_off = slot_idx % mla_block_sizek_pe 在写入之后就不再需要,因此源码显式跳过了对 k_pe 原缓冲的回写——decode 的 MLA 只从 KV 缓存里读。这一点在 prefill 时略有不同:如果开了 prefill context parallel(PCP),需要把 kv_c_out/k_pe_out 物化出来供跨 rank gather,内核里那两段 tl.store(kv_out_ptr ...) 就是为 PCP 准备的。
pid 0 的索引 K 分支负责量化。索引器缓存的元素尺寸不是 128 字节,而是:
head_dim=self.head_dim + self.head_dim // self.quant_block_size * 4,# 128 + 128 // 128 * 4 = 132 字节128 字节的 FP8 数据后面跟 4 字节的 UE8M0 scale(scale_fmt = "ue8m0")。1×128 的块缩放让索引 key 的量化误差被限制在一个 128 维的块内,比整头一个 scale 的精度高得多,代价是每 128 维多 4 字节的 scale 开销——约 3%。
pid 3 的清零是给 Top-K 选择做「墓碑标记」。索引器写 Top-K 时采用「边写边比较」的方式:缓冲初始为 -1,新的 token 值更大才覆盖。这样即使这一层是 shared 层(跳过索引),缓冲里残留的上一层 Top-K 也不会被误读——shared 层直接读缓冲,full 层先清零再写。
段 4:fused_q——查询侧的 RoPE、量化与权重缩放
fused_q 把三件事融在一起:
- 对
q_pe(64 维)做 RoPE,得到可以和第 1 段k_pe对齐的旋转位置编码; - 对索引器查询
index_q做它自己的一套 RoPE(indexer_rope_interleave=true时是交错式),并量化成 FP8; - 把索引头的权重
index_weights乘上head_dim^-0.5 × n_head^-0.5,把两个缩放因子提前并进权重,省掉后面 logits 计算时的逐元素乘法。
这里有两个 RoPE 共用一份 qk_rope_head_dim=64,但 is_neox_style 方向相反:
self.rotary_emb = get_rope(..., is_neox_style=False)self.indexer_rope_emb = get_rope( ..., is_neox_style=not getattr(config, "indexer_rope_interleave", False))GLM-5.3 的 indexer_rope_interleave=true,所以主注意力用交错式(相邻两维配对旋转),索引器用非交错式(前后半段配对旋转)。两者维度相同但排列不同,读源码时如果只看到 head_dim 相同就以为可以复用同一张 cos_sin_cache,会得到完全错误的索引分数。
查询吸收也在这一段。MLA 的解码有两种等价形式:
- 不吸收(MHA 形态,prefill 的常态):把 576 维 latent 通过
kv_b_proj上投影成每头 192 维的 NoPE key 与 256 维的 value,再和 192 维的 NoPE 查询做点积; - 吸收(MQA 形态,decode 的常态):查询用
W_UK_T吸收到 512 维的 latent 空间,KV 以 576 维 latent 的 MQA 形式被读取,输出再用W_UV吸收回 256 维。
vLLM 在 _should_prepare_mqa_query 里决定走哪条:
return ( attn_metadata is None or not self._use_sparse_mha(attn_metadata) or cudagraph_runtime_mode == CUDAGraphMode.FULL or torch.cuda.is_current_stream_capturing())短路预填和 CUDA Graph 全图捕获时强制走吸收形态,平时则交给后端判断。吸收形态下 torch.bmm(q_nope.transpose(0, 1), self.W_UK_T) 是一次 64×512×192 的批量矩阵乘:64 头各自把 192 维查询映射到 512 维 latent。
上图对比两种形态的访存路径:MHA 形态每读一个 token 的 KV 需要把 576 维 latent 上投影成 64 个头共 28672 维(192 + 256)的 K/V;MQA 形态直接读 576 维 latent。对长上下文 decode,前者的 KV 读取量是后者的约 50 倍。这就是吸收的意义——它把「每 token 的 KV 读取」锁死在 576 维。
段 5:索引器与稀疏 MLA——CUDA Graph 里的一个「可断开」点
_sparse_indexer_and_attn 带了一个装饰器 @eager_break_during_capture:
@eager_break_during_capturedef _sparse_indexer_and_attn(...):这是 vLLM piecewise CUDA Graph 的「断点」:捕获时这个函数被放回 eager 执行。索引器的执行需要读调度器在 GPU 之外算好的元数据,且内部有 side stream(后面讲跨层复用时会展开)与事件同步,无法整段被 CUDA Graph 捕获;vLLM 的做法是在捕获时把它切成 eager 段,前后仍是图段。这与上一篇提到的「SGLang 的 CUDA Graph 桶 + 索引器 idle 行特判」是同一个问题的两种解法。
段 5 的输出是多头注意力结果 attn_out(形状是 (tokens, 64, 512) 的 latent 空间输出)与可选的 LSE(log-sum-exp,用于上下文并行时合并多个 rank 的部分注意力)。
段 6:输出吸收与 o_proj
kv_b_proj 是 ColumnParallelLinear(512 → 64×448),其中 448 = 192 + 256(NoPE key 与 value)。在吸收形态里,它的 K 半边(W_UK)被查询吸收掉,V 半边(W_UV)被输出吸收:
x = attn_out.view(num_actual, self.num_local_heads, self.kv_lora_rank).transpose(0, 1)out = output[:num_actual].view(num_actual, self.num_local_heads, self.v_head_dim).transpose(0, 1)torch.bmm(x, self.W_UV, out=out)return self.o_proj(output)[0]一次 bmm 把 512 维的注意力输出映射到 256 维,然后 o_proj(RowParallelLinear(64×256 → 6144))再把它投影回残差流。o_proj 被设成 reduce_results=False——它只算出本 rank 的部分和,真正的 AllReduce 被推迟到下一层入口的 fused_allreduce_rms_norm。这是下一节的重点。
解码器层的边界:把 AllReduce 塞进下一个 RMSNorm
上一篇在 SGLang 里已经讲过 flashinfer_allreduce_residual_rmsnorm 的动机:注意力与 MoE 的输出都不在最后一个层内归约,而是「欠一次 AllReduce」,到层边界用一次融合 kernel 还清。vLLM 用的是同一个 flashinfer 融合原语,但把「欠账」的时机与层的结构绑得更紧。
DeepseekV32DecoderLayer.forward 的结构如下:
def forward(self, positions, hidden_states, residual, attn_in=None): if residual is None: residual = hidden_states hidden_states = attn_in if attn_in is not None else self.input_layernorm(hidden_states) else: hidden_states, residual = fused_allreduce_rms_norm( hidden_states, residual, self.input_layernorm ) hidden_states = self.self_attn(positions=positions, hidden_states=hidden_states) hidden_states, residual = fused_allreduce_rms_norm( hidden_states, residual, self.post_attention_layernorm ) hidden_states = self.mlp(hidden_states) return hidden_states, residual把一个 decode step 的层边界时间线展开,每一层里发生的事是:
- 入口:上一层的 MLP/MoE 输出是各 rank 的部分和,
fused_allreduce_rms_norm一次完成 AllReduce、加 residual、input_layernorm归一化; - 注意力:六段算子,
o_proj输出仍是部分和; - 注意力出口:又一次
fused_allreduce_rms_norm,同时完成注意力的 AllReduce、残差累加与post_attention_layernorm; - MLP/MoE:输出仍是部分和,留给下一层入口。
所以每个非首层要做两次融合归约,78 层共约 155 次(首层只做注意力的那一次,模型末尾还有最后一次)。与「归约后立刻做」的朴素实现相比,每次省掉的是一次 6144 维残差的读写对(读旧 residual、读 partial、写新 residual)以及一次独立的 RMSNorm kernel launch。
fused_allreduce_rms_norm 的实现值得单独看,因为它把所有 fallback 条件都写在明面上:
def fused_allreduce_rms_norm(hidden_states, residual, norm): tp_size = get_tensor_model_parallel_world_size() if tp_size == 1: return norm(hidden_states, residual) if flashinfer_trtllm_fused_allreduce_norm is not None: ok, max_token_num = _can_use_flashinfer(hidden_states, tp_size) if ok: norm_out = torch.empty_like(hidden_states) flashinfer_trtllm_fused_allreduce_norm( allreduce_in=hidden_states, residual=residual, rms_gamma=norm.weight, rms_eps=norm.variance_epsilon, world_size=tp_size, weight_bias=0.0, launch_with_pdl=True, fp32_acc=True, max_token_num=max_token_num, pattern_code=_AR_RESIDUAL_RMS_NORM, norm_out=norm_out, ) return norm_out, hidden_states reduced = tensor_model_parallel_all_reduce(hidden_states) return norm(reduced, residual)三个细节:
weight_bias=0.0:标准 RMSNorm 的权重乘子不带偏置;Gemma 一类模型用 1.0 表示「权重 + 1」。同一个 kernel 服务两种归一化。fp32_acc=True:归约与平方和在 FP32 里做。BF16 的残差流累加 78 层后,若在 BF16 里归约,误差会累积;FP32 累加让 batch-invariant 的确定性讨论有一个明确的口径。- 返回值的复用:
hidden_states原缓冲被写成了「AllReduce 后的部分和 + 旧 residual」——也就是下一层的 residual。这让调用者省掉一次拷贝,代价是原来的部分和缓冲不再可用。源码注释里写得很清楚:传入norm_out时,kernel 把新 residual 写回hidden_states缓冲,把归一化结果写进norm_out。
还有一条只在 sequence parallel MoE(--enable-sequence-parallel-moe)下走的路径:token 在 TP 组内按序列维切开,MoE 只在本地 token 上算,层内不做 AllReduce,而是在层边界做 sp_all_gather / sp_reduce_scatter。对 GLM-5.3 这类 8 卡单机部署,它和 EP 是互斥的选择——SP 省的是 MoE 的权重读取(每个专家只在一部分 token 上算),代价是 hidden 的 gather/scatter;EP 省的是专家权重占用,代价是 dispatch/combine。
上文那张类层次图对应的 8 卡部署进程关系是:API Server 进程在前,EngineCore 是独立进程,再往下是 8 个 GPU worker 进程各自跑一套 Worker / ModelRunner;前两者通过 ZMQ 通信,EngineCore 通过共享内存与 IPC 把每一轮的执行计划分发出去。层内的两次融合归约发生在每个 GPU worker 自己的 CUDA 流上,跨 worker 的同步由 TP/EP 通信组完成,进程间只交换「这一步跑哪些请求、每条多少 token、槽位在哪」这类元数据。
索引器跨层复用:vLLM 怎么让 21 层的 Top-K 一次算完、57 层白嫖
上一篇讲过 GLM-5.3 的结构性事实:21 个 full 层产出 Top-K,57 个 shared 层直接消费。SGLang 里这件事是「21/78 个 full 层运行索引器,57 层复用 Top-K」——复用的动作藏在模型前向的层循环里。vLLM 把它提升成了一个有名字的运行时对象:索引组(index group)。这一个设计决定了好几个下游行为,值得单独用一节讲透。
索引组是什么
vllm/v1/attention/backends/mla/index_group.py 定义了 SparseMLAIndexGroup:
@dataclassclass SparseMLAIndexGroup: """Layers that consume one sparse-indexer result."""
logical_topk_indices: torch.Tensor physical_topk_indices: torch.Tensor valid_topk_counts: torch.Tensor side_stream: torch.Stream logical_topk_ready: torch.Event physical_topk_ready: torch.Event has_indexer: bool num_layers: int = 0三层含义全在字段名里:
logical_topk_indices是索引器直接产出的结果——请求内部的逻辑位置。一个 full 层跑完索引器,写进的就是这块缓冲。physical_topk_indices是换算成「全局 KV 槽位」的结果。稀疏 MLA 内核只认物理槽位,因为 KV 是按页挂在全局池里的。valid_topk_counts是每条 token 实际有效的 Top-K 数量。序列不满 2048 时,缓冲里后面是 -1(上一节 pid 3 的墓碑),有效数量比 2048 小。side_stream/ 两个torch.Event说明换算被挪到了另一条 CUDA 流上,与主计算流异步。
组的划分由 SparseMLAIndexGroupBuilder 决定:
def register_layer(self, is_index_producing_layer, vllm_config=None, *, ...): if is_index_producing_layer or self.current_group is None: ... self.current_group = group_cls( logical_topk_indices=self.logical_topk_indices, physical_topk_indices=physical_topk_indices, valid_topk_counts=..., side_stream=torch.Stream(device=...), logical_topk_ready=torch.Event(), physical_topk_ready=torch.Event(), has_indexer=is_index_producing_layer, ) group = self.current_group group_index = group.register_layer(vllm_config, ...) return group, group_indexDeepseekV32Attention.__init__ 在构造每一层时调用 register_layer(is_index_producing_layer=self.indexer is not None)。于是:
- 层 0 是 producing 层,开一个新组,
has_indexer=True,组内索引 0; - 层 1、2 也是 producing 层,各自开新组;
- 层 3、4、5 是 shared 层(
indexer=None),追加到层 2 的组里,组内索引 1、2、3。
最终 78 层被切成 21 个组:层 0、1 各是一个单层组,层 2–5 组成一个 4 层组,之后 6–9、10–13、…、74–77 共 18 个 4 层组。合计 2 + 19×4 = 78 层,producing 层正好 21 个。这个数字和 indexer_types 的 21 full + 57 shared 完全对得上。
逻辑到物理的换算为什么能「一组一次」
convert_logical_to_physical_topk 的注释写得很直白:
def convert_logical_to_physical_topk(self, layer_index, logical_topk_indices, attn_metadata, ...): """Convert one index result once for all layers in this group."""换算做的是:对每条 token,把索引器给出的「请求内第 j 个 token」翻译成「全局 KV 池第 (block_table[req][j // block_size], 页内偏移 j % block_size) 个槽」。它需要三样东西:每条 token 属于哪个请求(req_id_per_token)、该请求的块表(block_table)、块大小。三样东西都来自调度器的 AttentionMetadata,与层无关。
这就是索引组设计的核心洞察:Top-K 结果的逻辑坐标在组内是共享的,物理坐标也只需要算一次。如果每个 shared 层都自己去换算,一次 decode 要重复 57 次同样的整数除法与块表查表;按组换算,21 个组各换算一次——换算次数从 78 降到 21,节省约 3/4。
换算在 side stream 上跑,主计算流等待一个 event:
if layer_index == 0: if self.has_indexer and not in_piecewise_cudagraph(): self.side_stream.wait_event(self.logical_topk_ready) else: self.side_stream.wait_stream(compute_stream) with self.side_stream: triton_convert_req_index_to_global_index(...) self.physical_topk_ready.record(self.side_stream)compute_stream.wait_event(self.physical_topk_ready)logical_topk_ready 由 producing 层在写完 Top-K 缓冲后 record。set_logical_topk_ready 里有一条注释解释它为什么只在组内第 0 层记录:
def set_logical_topk_ready(self, layer_index: int) -> None: if layer_index != 0 or not self.has_indexer: return # In piecewise cudagraph mode the consumer converts on the side stream # from an eager break; ... if in_piecewise_cudagraph(): return self.logical_topk_ready.record(self._current_stream())在 piecewise CUDA Graph 模式下,捕获段里记录的事件是「图局部」的,图外对它的 eager 等待会报 cudaErrorInvalidValue;所以这条模式下改为 wait_stream,完全不碰 event。这跟上节 @eager_break_during_capture 是同一套约束的两个侧面。
消费侧:物理 Top-K 怎么进稀疏 MLA
FlashMLASparseImpl._forward_bf16_kv 里,消费组的结果有三条分支:
if cache is not None: num_decode_tokens = attn_metadata.num_decode_tokens if num_decode_tokens < q.shape[0] and cache.all_context_pages_resident: physical_topk, lengths = index_group.convert_logical_to_physical_topk(...) return self._bf16_flash_mla_kernel( q, index_group.physical_kv_cache(self.index_group_index), physical_topk, lengths, actual_num_heads, ) if num_decode_tokens > 0: decode_topk, decode_lengths = index_group.convert_logical_to_physical_topk(...) ...这段代码里有个隐藏开关 HiSparseMLAIndexGroup——那是 HiSparse(冷 KV 放到主机内存)模式下的索引组子类,physical_kv_cache 返回的是「热缓存」的注意力缓存,换算时还会做 swap-in。不启用 HiSparse 时,index_group.physical_kv_cache 这条路径不存在,cache is None,代码直接落到后面:
uses_host_cache = isinstance(index_group, HiSparseMLAIndexGroup)if not uses_host_cache and decode_only: topk_indices, topk_length = self._convert_logical_to_physical_topk(...)else: topk_indices, topk_length = triton_convert_req_index_to_global_index(...)也就是说,纯 decode 的 batch 走「组内转换」(_convert_logical_to_physical_topk,即 convert_logical_to_physical_topk);prefill、混合 batch、HiSparse 走逐层转换或换页路径。SparseMLACommonImpl 的类注释解释了这条分支的适用条件:
# Reuse the index group's top-k conversion only for uniform decode batches# of multi-layer groups; other batches convert per layer.group_conversion_decode_only: ClassVar[bool] = False为什么 prefill 不能复用组内转换?prefill 的 KV 可能被物化到一段连续 workspace(prefill 路径里的 flat_kv_row_view 与 block_stride_rows 就是为这种布局准备的),这时 Top-K 指向的是 workspace 偏移而不是全局页槽;混合 batch 还同时含 decode 的页槽与 prefill 的 workspace 两种坐标。因此源码把组内复用限制在最规整的 decode-only 场景,prefill 与混合 batch 走逐层转换。
MTP 层:组外的第二次复用
MTP 草稿层有自己独立的 Top-K 缓冲(DeepseekV32MultiTokenPredictorLayer.__init__ 里新建了一块 max_num_batched_tokens × index_topk 的 int32 缓冲)和自己的索引组。它本来按「一个 MTP 层一个组」划分,但 GLM-5.3 的 index_share_for_mtp_iteration=true 让草稿过程再做一次复用:第 1 个草稿步算 Top-K,第 2 步起直接读。
def set_skip_topk(self, skip: bool): # index_share_for_mtp_iteration: step 0 computes top-k, steps 1+ reuse. for layer in self.layers.values(): self_attn = layer.mtp_block.self_attn if self_attn is not None and hasattr(self_attn, "skip_topk"): self_attn.skip_topk = skip为什么要复用?一个草稿步只多预测一个 token,它和上一步的 token 在同一个请求、几乎同一个位置,Top-K 集合的差异极小;省掉的是索引器完整的 paged MQA logits 计算加 Top-K 选择,对一个 batch=32、5 个草稿步的 decode,这一步省掉的是 4 次索引器前向。而 skip_topk 打开后,段 3 的 pid 0/3 分支也会在 HAS_INDEXER=False 时不写、不清 Top-K 缓冲——否则复用会被覆盖。
代价:组内复用带来的正确性约束
索引组复用有两条硬约束,源码都有断言:
- 组内第 0 层必须是 producing 层,否则组不会建立。
register_layer的if is_index_producing_layer or self.current_group is None保证了这一点;如果 checkpoint 的indexer_types以 shared 开头,组会沿用「上一个组」的结果——也就是错的。 - producing 层与消费层的块表必须一致。同一组内的 4 层共享同一份逻辑 Top-K,换算依赖
req_id_per_token与block_table。vLLM 的 block table 是「每条请求一张表、所有层共用同一套块号」,所以 4 层拿到的槽位编号天然相同;真正要防的是前缀缓存导致不同层的块表出现分叉。MLAAttentionSpec把topk_buffer_width与is_index_group_leader写进 KV 规格并用merge()断言同组一致,就是在缓存管理层提前挡住这类分叉:
index_group_leader_set = {spec.is_index_group_leader for spec in specs}assert len(cache_dtype_str_set) == 1 and len(topk_buffer_width_set) == 1 and ... and len(index_group_leader_set) == 1这段断言的措辞是「同一 KV 缓存组内所有注意力层必须使用相同的量化方式、Top-K 缓冲宽度、每状态 token 数、模型版本、缓存角色与索引共享角色」。它同时也是给 HiSparse 用的:vllm/v1/hisparse/layout.py 里 if layer_spec.is_index_group_leader or not hot_units 决定哪一层的 host-backed 缓存要做热区布局。GLM-5.3 不开 HiSparse 时这条路径不触发,但字段仍会被填进 spec。
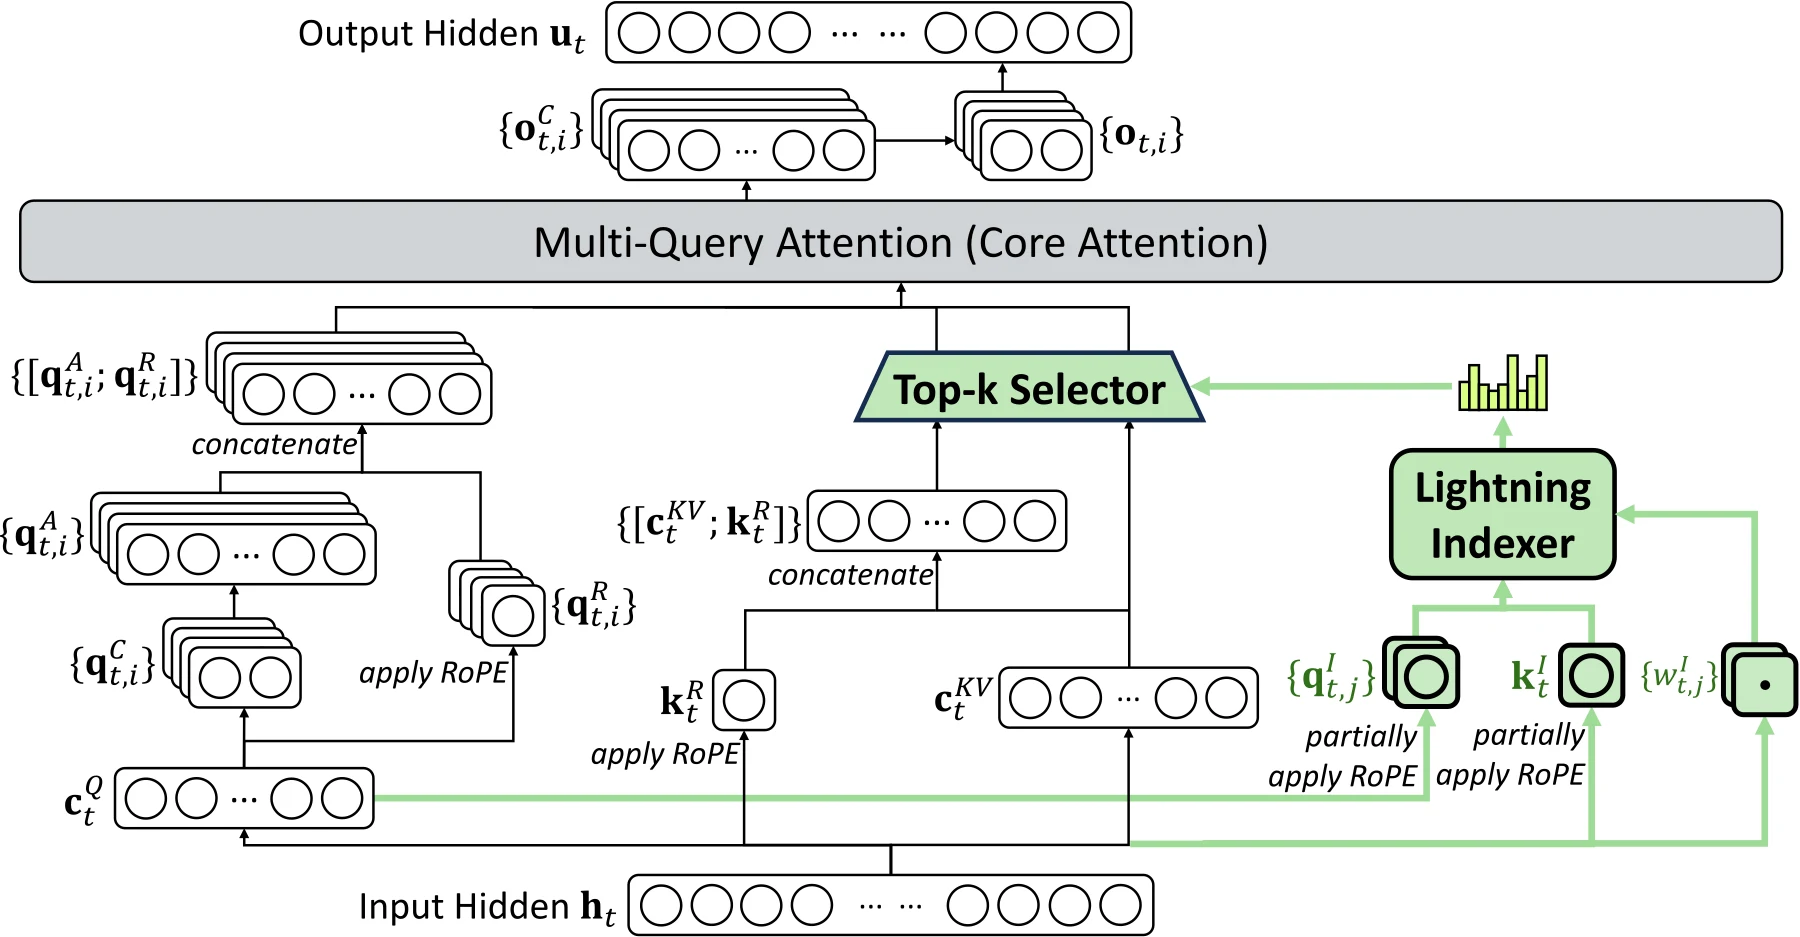
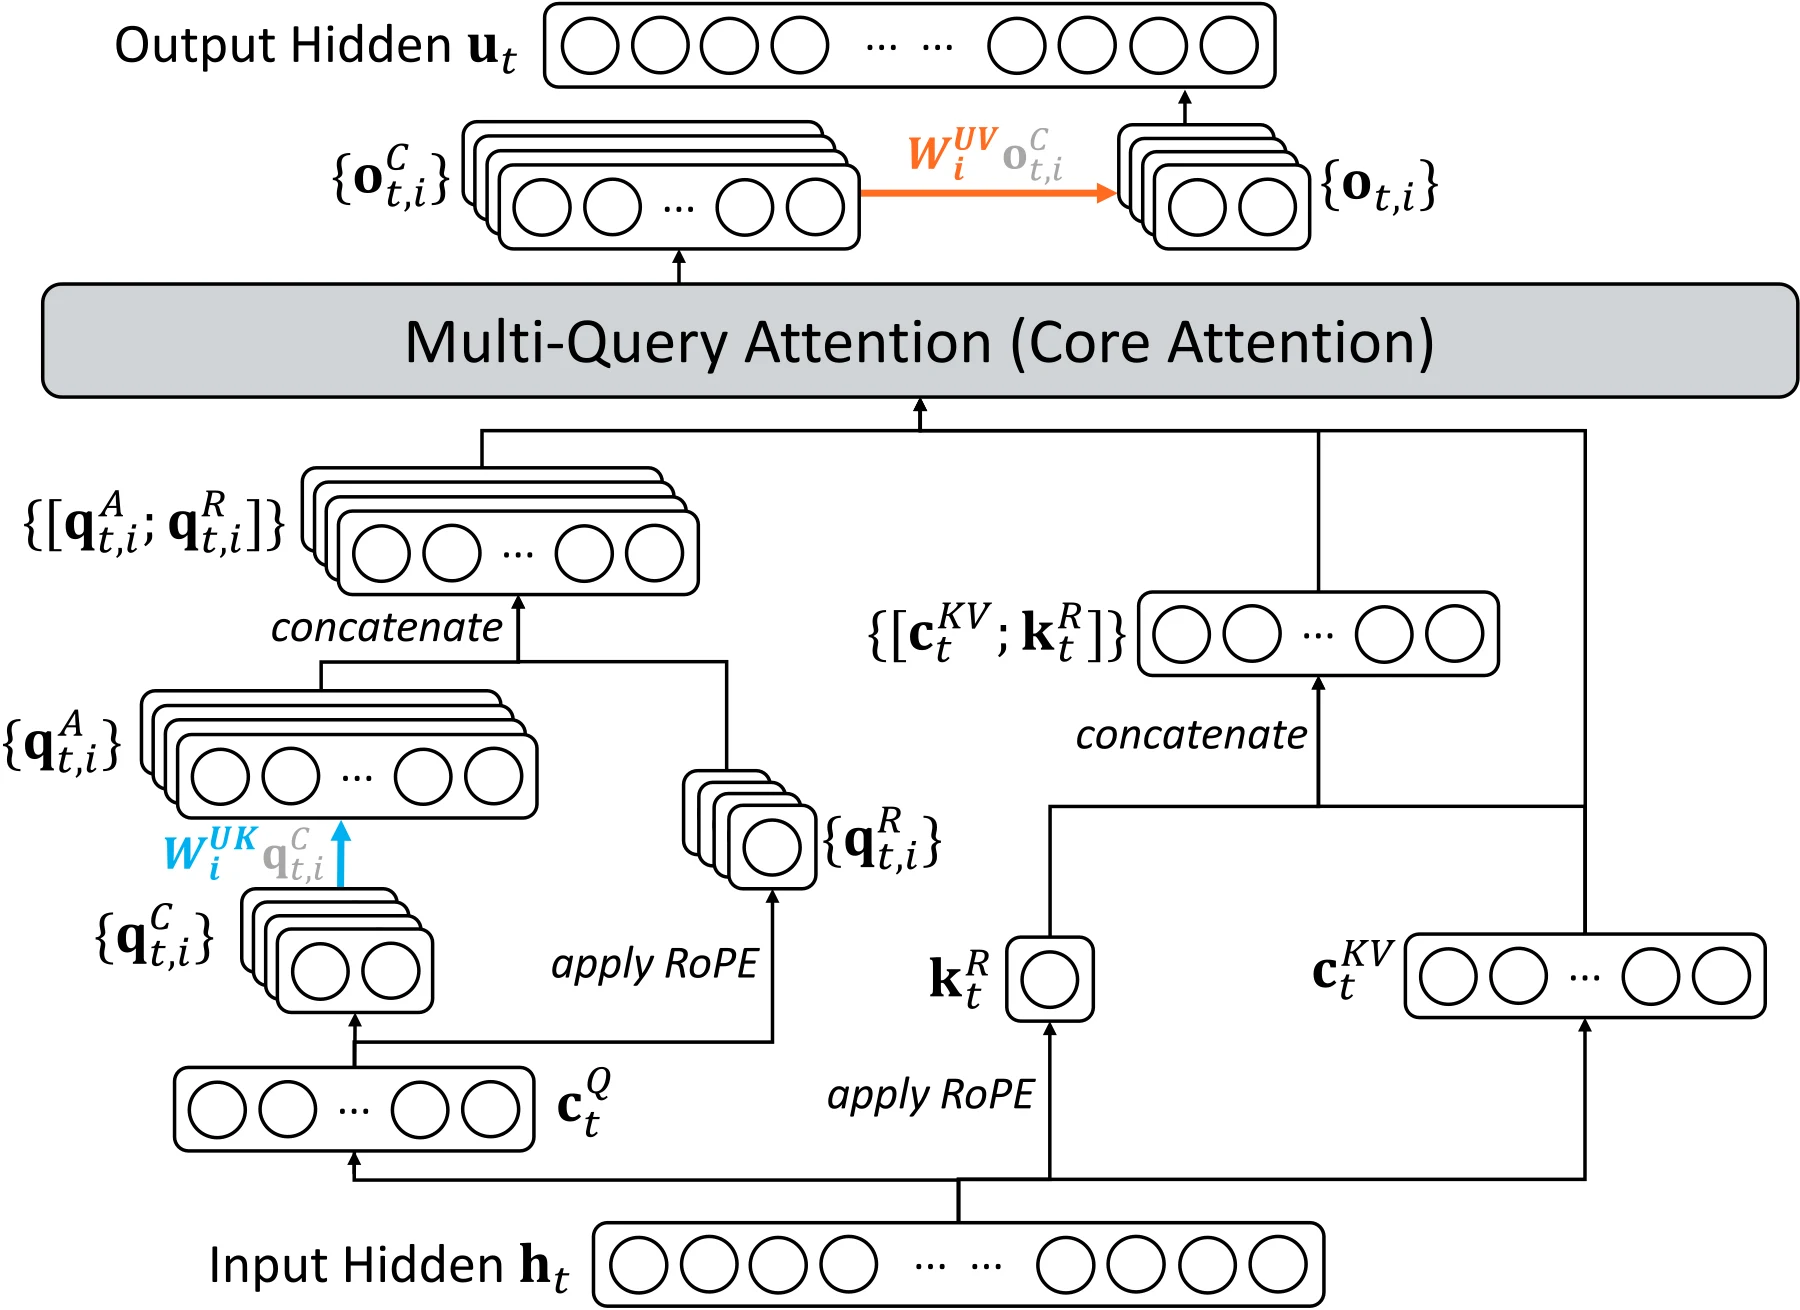
上图是 DSA 的整体结构。把索引组的视角叠上去:图中「Lightning Indexer → Top-K」这一步,在 GLM-5.3 里每 4 层只发生 1 次;图中每层都画出的「选择 Top-2048 个 KV」这一步,每层都要发生,只是那 4 层共享同一份选择结果。
索引器本身:一次 decode 的索引计算到底在算什么
索引组省的是「换算」和「重复的索引器前向」,但 full 层内部的索引器计算一笔都不能省。sparse_attn_indexer 的函数体在 decode 侧是四步:K 缓存写入、分页 MQA logits、Top-K 选择、DCP 合并。
第一步:K 缓存写入的两条路径
vLLM 有一条优化:段 3 的 fused_norm_rope 已经完成了索引 K 的 LayerNorm、RoPE、FP8 量化与分页写入,所以 decode 侧调用 sparse_attn_indexer 时传的是 skip_k_cache_insert=True:
sparse_attn_indexer( q_c, self.indexer.k_cache.prefix, self.indexer.k_cache.kv_cache, index_q_fp8, None, index_k, index_weights_out, ..., skip_k_cache_insert=not self.use_pcp, ...)函数内部对应地跳过 ops.indexer_k_quant_and_cache:
if not skip_k_cache_insert: k, slot_mapping_for_cache = maybe_gather_indexer_k(...) ops.indexer_k_quant_and_cache(k, kv_cache, slot_mapping_for_cache, quant_block_size, ...)只有开 PCP 时才需要在索引器入口单独写一次——因为 PCP 要在写入前把多个 rank 的 K 拼起来再量化,融合不了。这是「融合 kernel 一旦跨 rank 就失效」的一个典型例子。
第二步:分页 MQA logits——DSA 计算量的真正大头
decode 的 logits 由 fp8_fp4_paged_mqa_logits 计算:
logits = fp8_fp4_paged_mqa_logits( (padded_q_quant_cast, padded_q_scale), kv_cache, decode_weights, seq_lens, decode_metadata.block_table, decode_metadata.schedule_metadata, max_model_len=max_model_len, indices=decode_metadata.indices,)它算的是 :32 个索引头各自与缓存里的索引 key 做点积,再用头权重加权求和。头权重 已经在 fused_q 里乘过 ,所以这里只剩点积、加权与 scale 还原。
为什么索引器要 32 个头?这是 DSA 设计里的精度换速度:单头 128 维的点积对「哪些 token 重要」的判断太粗糙,32 个头的组合让它接近完整注意力的排名质量。代价是 logits 的计算量是单头的 32 倍——对每条 decode token、每个 full 层、每个历史 token 都要算 32×128 次的乘加。
但注意:32 个头只在索引器里。主注意力是 64 个查询头共享同一份 576 维 latent(MQA 形态),而索引器用 32 个独立头做「粗筛」。粗筛算得比主注意力便宜——它只在 128 维上做点积,不是 192+256 维的完整注意力。
vLLM 在 SM100(B200/B300)上把 logits 输出成 BF16:
# Keeping bf16 halves top-k/candidate reads. SM100 decode is varlen:# one context length per row.if fp32_decode_logits: logits = as_fp32_logits(logits, seq_lens.view(-1))fp32_decode_logits 在 topk_backend != "deep_select" 或 DCP 开启时为真。DeepSelect 是 SM100a/SM103a 上的专用 Top-K 内核,直接吃 BF16 logits,省掉一份 FP32 拷贝;开 DCP 时必须转 FP32 再合并。对 2048 个 Top-K 的选择精度,BF16(约 3 位十进制有效数字)足够——Top-K 只要排名正确,不需要绝对精度。
第三步:Top-K 选择的后端选择
Top-K 的后端由 kernel_config.sparse_indexer_topk_backend 决定,默认 "auto",候选包括:
| 后端 | 适用硬件 | 特点 |
|---|---|---|
deep_select | SM100a / SM103a | 专用内核,直接读 BF16 logits |
cooperative | SM90 及以上 | 一个 CTA 协作完成一个请求行的 Top-K |
persistent | 通用 CUDA | 常驻 CTA,减少 launch |
per_row | 通用 CUDA | 每行一个 CTA |
flashinfer | 有 FlashInfer | FlashInfer 的 ragged Top-K |
aiter | ROCm | AMD AITER 内核 |
auto 的语义是 cooperative → persistent → per_row 的链式回退,注释里写了「the other backends are opt-in」。为什么 Top-K 要这么多后端?因为它的输入形状极端不规则:一条请求可能有 1M 个 logits,另一条只有 2000 个;一个 batch 里几百条请求的长短差几个数量级。cooperative 内核适合长行,persistent 适合大量短行,per_row 是最朴素的兜底。这是 DSA 推理里最容易被忽视、但调优收益最直接的一个旋钮。
Top-K 内核调用在代码里只有一行:
topk_indices = topk_indices_buffer[:num_padded_tokens, :topk_tokens]get_indexer_topk(topk_backend)(logits, seq_lens, next_n, topk_indices, topk_tokens, max_seq_len)但它的入参 next_n = 1 + num_speculative_tokens:MTP 下每条请求的验证 batch 是 6 行(1 个位置 token + 5 个草稿 token),seq_lens 是 (B, next_n) 的二维张量,每一行的上下文长度相差 1。Top-K 内核要对 6 行各做一次独立选择——投机解码让 Top-K 的调用量乘以 6,这也是为什么 MTP 层要设计独立的 skip_topk 复用。
第四步:DCP 下的全局合并
开 decode context parallel 时,每条请求的 KV 被切到多个 rank,每个 rank 只在本地那段历史里选 Top-K,然后合并:
if decode_metadata.global_seq_lens is not None: _merge_dcp_topk_global( logits, topk_indices, topk_tokens, dcp_rank, dcp_world_size, cp_kv_cache_interleave_size, )合并的方式是「按位置重排」:每个 rank 把本地 Top-K 换算成全局位置后再选一次。DCP 的划分单位是 cp_kv_cache_interleave_size 个 token,所以合并时要把槽位号还原成全局 token 位置,再按 logits 排名取全局前 2048。这就是 __init__ 里那段断言存在的原因:
if (self.dcp_world_size > 1 and self.compress_ratio > 1 and (isinstance(self.kv_cache_spec, MLAAttentionSpec) and self.kv_cache_spec.model_version == "deepseek_v4" or self.cp_kv_cache_interleave_size % self.compress_ratio != 0)): raise NotImplementedError( "DCP with sparse indexer KV compression ... requires " "--cp-kv-cache-interleave-size to be a multiple of it; " "DeepSeek-V4 is not supported." )GLM-5.3 没有 KV 压缩(compress_ratio = 1),所以只受后半句约束:cp_kv_cache_interleave_size 必须能被 1 整除——永远成立。这段断言对 GLM-5.3 是「默认安全」,但对 DeepSeek-V4 的 CSA 压缩 KV 是硬限制。
索引器的算术强度账本
把以上四步合成一个数字。一个 full 层、一条 decode token、上下文长 时:
- 索引器点积: 次乘加,读取 字节的索引 K(含 scale);
- Top-K: 的比较操作,写 2048 个 int32;
- 主注意力:64 头 × 每头 576 维 × 2048 个被选中的 KV,读取 字节(FP8)或 字节(BF16)。
当 时,索引器读 13.2MB 的 K、做约 4 亿次乘加;主注意力读约 1.2MB(FP8)的 KV、做约 7500 万次乘加。索引器的访存是主注意力的 10 倍以上,计算量是 5 倍以上。这就是为什么「每 4 层一个索引器」能省掉约 3/4 的 DSA 开销——索引器才是 DSA 里更贵的那一半,而不是被 Top-K 选出来的稀疏注意力。
这个结论可以反过来解释 index_topk_freq=4 的选择:如果每层都跑索引器,索引器开销会盖过 DSA 省下的注意力开销;如果 8 层一个,Top-K 的近似误差会累积。4 层是两者之间的折中,而前 3 层(稠密 FFN 层)不参与共享,是因为最底层的注意力误差会直接放大到整个残差流。
一条 decode step 的通信总账
现在把前文的算子按「通信类型」重新排一遍。为了可复算,先固定场景:
- 硬件:8×H200(每卡 141GB、HBM 4.8TB/s、NVLink 900GB/s);
- 并行:TP8 + EP8(注意力按头切、专家按卡切),不开 DP Attention;
- 负载:32 条请求同时 decode,每条 1 个已确认位置 + 5 个草稿 token,即 192 个验证行;
- 上下文:平均 8K token;
- 缓存:
fp8_ds_mla(656B/token/层)。
逐阶段的通信清单
| 阶段 | 通信原语 | 触发条件 | 单步字节数(32 请求 / 192 行) |
|---|---|---|---|
| 词嵌入 | AllReduce(词表并行) | 默认词表切分 | 192 × 12KB = 2.36MB;复制词表时 0 |
| 层首 RMSNorm | AllReduce + 残差 + Norm 融合 | 每层 1 次,78 层 | 78 × 192 × 21.5KB = 322MB |
| 注意力出口 | 同上 | 每层 1 次,78 层 | 322MB |
| o_proj / q_b / kv_b | 无(行/列并行内部) | 部分和在上述 Norm 里归约 | 0 |
| MoE dispatch | All-to-All(EP) | 每层 1 次,75 层 | 75 × 192 × 8 × 12KB = 1.42GB |
| MoE combine | All-to-All(EP) | 每层 1 次,75 层 | 1.42GB |
| LM Head | AllGather logits | 目标模型采样 | 192 × 154880 × 2B = 59.5MB |
| 草稿 token | AllGather (value, index) | MTP 贪心草稿 | 192 × 2 × 8 × 4B ≈ 12KB |
| KV / 索引器 K | 无(HBM 读,不走卡间) | 每层 | 见下 |
把表里的卡间字节加总: MB ≈ 3.55GB/step。8 张卡平均每卡 444MB,按 900GB/s 算约 0.49ms。这个量级与权重读取(下一段)相当,说明 decode 的瓶颈不是单一侧,而是「权重 + KV + 通信」三者的叠加。
两个容易算错的点:
- AllReduce 的 ring 系数:一层 6144 维 BF16 是 12,288 字节,但 ring AllReduce 每个 rank 的发送量是 倍,即 1.75 倍。表中的 21.5KB 已经乘过这个系数。
- MoE 的 8 份 hidden:dispatch 与 combine 各搬 8 份,是因为每个 token 去 8 个专家、回来 8 份部分和;combine 可以在接收端归约,但网络上仍是 8 份字节。EP 组越大,单卡承担的专家越少,但跨卡份数不变。
HBM 侧:权重与 KV
卡间通信只是账本的一半。每个 decode step 每张卡还要从 HBM 读:
| 项目 | 每卡字节/step | 说明 |
|---|---|---|
| A 投影(复制) | 78 × 16.1MB = 1.26GB | 每层 2624×6144 FP8 |
| q_b / kv_b / o_proj(TP 切分) | 78 × (4.2 + 1.8 + 12.6)MB ≈ 1.45GB | 按头切分后每卡份额 |
| 索引器投影(复制) | 21 × 8.6MB ≈ 0.18GB | wq_b 与 wk_weights |
| 共享专家 + 稠密层 | 75 × 4.7MB + 3 × 28MB ≈ 0.44GB | 按 TP 切分 |
| 路由专家(EP 切分) | 约 0.76GB | 32 个本地专家中被本轮激活的部分 |
| 注意力 KV(656B/层/token) | 32 × 2048 × 656 × 78 ≈ 3.35GB | 6 行共享同一段 KV,按请求而不是按行计 |
| 索引器 K(132B/层/位置) | 32 × 8192 × 132 × 21 ≈ 0.73GB | 6 行共享,按请求计 |
| 权重合计 | 约 4.1GB | 每卡每 step |
按 4.8TB/s 算,权重约 0.85ms、KV 约 0.70ms、索引器约 0.15ms。加上卡间 0.49ms,一个 decode step 的理论下限约 2.2ms。192 个验证行、平均接受 2.77 个 token(vLLM recipe 在 MI325X 上的实测值)时,32 条请求每步产出约 88 个 token,折合 40K tok/s 的聚合吞吐上限。
这个数字显然远高于真实服务。原因不在公式,而在三个「理想化」:grouped GEMM 在专家分桶不均时利用率下降;AllReduce 与 GEMM 没有完全重叠;索引器 K 的读取在 8K 上下文下命中率不高。把效率按 25%–40% 折算,理论值落到 10K–16K tok/s;真实服务还要再乘上调度空转、前缀未命中与尾延迟的折扣,因此这个数只能当作上限参照,不能当作容量规划。这正好说明为什么所有推理框架都在做「通信与计算重叠」「专家负载均衡」「KV 量化」这三件事,而不是单纯堆算力。
上下文从 8K 拉到 100K,账本会明显倾斜:
索引器一项就从 0.73GB 涨到 8.9GB,是 8K 时的 12 倍;而权重与通信基本不变。到 1M 上下文,索引器读取约 89GB/卡/step,单这一项就要 18.5ms——这还没算 21 个 full 层的 Top-K 选择。长上下文 decode 的第一瓶颈不是主注意力,而是索引器扫描,这也是「跨层复用索引器」和「索引器 K 量化到 FP8/FP4」比「把 Top-K 从 2048 降到 1024」更值得做的原因:降 Top-K 省的是主注意力的 KV 读取,而索引器扫的是全部历史,与 Top-K 大小无关。
与 SGLang 的账本对照
同一个模型、同样 8 卡,上一篇的 SGLang 账本与本篇的 vLLM 账本在「必须发生」的部分完全一致:78 层、21 个索引器、8 个专家、5 步草稿、每 token 576 维 latent。差异都在「框架选择」这一侧:
| 维度 | SGLang(上一篇的形态) | vLLM(本篇源码) | 影响 |
|---|---|---|---|
| A 投影 | fused_qkv_a_proj_with_mqa,一次 6144→2624 的复制 GEMM | fused_qkv_a_proj,同样 6144→2624,但基类是 MergedColumnParallelLinear(disable_tp=True) | 融合程度相同,线性层基类与 kernel 选择不同 |
| Norm + RoPE + KV 写入 | fused_norm_rope 融合 norm、RoPE、主 KV 与索引 K 写入 | fused_norm_rope 拆成 4 个 program 分支,额外把 Top-K 清零放进 pid 3 | vLLM 的 kernel 粒度更细,单 token 内并行四类工作 |
| 层边界归约 | flashinfer_allreduce_residual_rmsnorm | fused_allreduce_rms_norm(同一个 flashinfer 原语,PDL 启动) | 语义相同,封装层不同 |
| 索引器复用 | 每层 skip_topk 标志,直接读共享缓冲 | 索引组 + 逻辑→物理换算一次 + side stream event | vLLM 多一次换算,但把换算移出主计算流 |
| MTP 索引复用 | 草稿步复用上一层的 Top-K | set_skip_topk + compact_topk_indices 按槽位重排 | 都需要处理「草稿行位置不同」 |
| KV 布局 | FP8 E4M3,576B/token/层 | fp8_ds_mla 656B 或 fp8_e4m3 576B,取决于后端 | 1M 请求差约 6.6GB |
| 索引器一致性 | SGLANG_DSA_TOPK_BROADCAST 可选地把 rank 0 的 Top-K 广播给全组 | 各 rank 复制索引器、各自计算;DCP 下用 _merge_dcp_topk_global 合并全局 Top-K | SGLang 用广播换确定性,vLLM 用合并换各 rank 只看本地 KV |
| 词表并行通信 | 采样前对 logits 做词表维 AllGather(6b × 154880 × 2B) | 目标模型同样 AllGather;草稿侧 get_top_tokens 只传 (value, index) 对 | 草稿通信从 MB 级降到 KB 级 |
| 并行拓扑 | DP Attention + EP,--attn-dp-size | TP + EP;开 DCP 时默认 a2a + q_replicate | 决定 hidden 是否复制、dispatch 是否重复 |
这张对照表里没有「谁更好」的结论,因为每一项都是带条件的取舍:融合越多,单 kernel 越复杂、越难被 CUDA Graph 捕获;索引组越省,对「同组块表一致」的约束越强;fp8_ds_mla 省一次反量化,却多 11% 的缓存。真正的工程判断发生在部署参数上:--attention-backend 决定 656 还是 576 字节,--max-num-seqs 决定 KV 预算能装多少条请求,--moe-backend 决定 grouped GEMM 的效率,--speculative-config.num_speculative_tokens 决定验证 batch 是 6 行还是 9 行。
两份 KV 账:656 字节与 132 字节
上一篇算过 GLM-5.3 的 KV 账:每 token 每层 576 维(512 的 latent 加 64 维 RoPE),FP8 下 576 字节,78 层合计 44.9KB/token。vLLM 的账本多了一本——索引器缓存——而且主 KV 的每 token 字节数取决于缓存格式。
主 KV:fp8_ds_mla 的 656 字节
vLLM 支持两种 DSA 缓存格式:
fp8_e4m3(标准格式):NoPE 部分 512 维 FP8 + RoPE 部分 64 维 FP8 = 576 字节;scale 是按张量一个标量,不计入每 token。这是 FlashInfer 稀疏 MLA 后端使用的格式。fp8_ds_mla(DeepSeek 专用布局):512 维 NoPE FP8(512 字节)+ 64 维 RoPE BF16(128 字节)+ 4 个 FP32 block scale(16 字节)= 656 字节。
选哪个格式不是纯配置问题,而是后端绑定的。MLAAttention._canonicalize_sparse_mla_kv_cache_dtype 会在构造时改写用户给的值:
if backend_name == "FLASHMLA_SPARSE" and is_quantized_kv_cache(kv_cache_dtype): # The NVFP4 DS-MLA format is used as-is; any other quantized dtype # (fp8, fp8_e4m3, ...) is served via the fp8_ds_mla format. if kv_cache_dtype == "nvfp4_ds_mla": return kv_cache_dtype return "fp8_ds_mla"也就是说,只要后端是 FLASHMLA_SPARSE,命令行写 --kv-cache-dtype fp8 或 fp8_e4m3,实际落地的都是 fp8_ds_mla。反过来,FLASHINFER_MLA_SPARSE 保持标准 fp8_e4m3,构造时还会打印一条提示:
logger.info_once( "Using standard fp8 KV cache format. To use DeepSeek's fp8_ds_mla " "KV cache format, please set `--attention-backend FLASHMLA_SPARSE`")对 GLM-5.3 的部署,这意味着「656 字节还是 576 字节」取决于选了哪个注意力后端,而不是 --kv-cache-dtype 的字面值。
fused_norm_rope 的内核里,这两种布局是分开写的:
if mla_cache_ds_mla: # Custom byte-addressed layout: 656 B/token for fp8_ds_mla, 352 B # for nvfp4_ds_mla. mla_cache_ptr is the 1-byte fp8 view, so # block/entry strides are byte offsets and the fp32/bf16 views # (fp8_ds_mla only) share the same buffer. assert kv_dim == 512, "ds_mla layouts require kv_lora_rank == 512"为什么 fp8_ds_mla 要把 RoPE 部分留在 BF16?因为 RoPE 是旋转,旋转后的 64 维 key 会与查询的 64 维 RoPE 部分逐元素相乘再求和;量化误差在旋转后会从「每个元素的小误差」变成「角度误差」,对长上下文的位置判别影响比 NoPE 部分更敏感。DeepSeek 的 FlashMLA 选择「NoPE 量化、RoPE 不量化」,代价是每 token 多 64 字节(FP8 的 64 维变成 BF16 的 128 字节),收益是解码时不用对 RoPE 部分做反量化。这是「省一次反量化 vs 多 11% 缓存」的权衡,和上一节 kv_b_proj 的「吸收 vs 不吸收」是同一类取舍。
nvfp4_ds_mla 更激进:512 维 NoPE 用 NVFP4(2 值/字节,256 字节)+ 64 维 RoPE BF16(128 字节)+ 32 字节 scale = 352 字节。它只在 Blackwell 的 NVFP4 checkpoint 上启用。
索引器缓存:21 层的 132 字节
索引器缓存是另一本独立的账。DeepseekV32IndexerCache.get_kv_cache_spec 返回的是一份 MLAAttentionSpec,但 cache_role 标成 INDEXER:
def get_kv_cache_spec(self, vllm_config): return MLAAttentionSpec( block_size=self.cache_config.block_size, num_kv_heads=1, max_tp_shards=1, head_size=self.head_dim, dtype=self.dtype, cache_role=SparseCacheRole.INDEXER, ) # Only has one vector instead of K + Vhead_size 是这个缓存自己的 head_dim + head_dim // 128 * 4 = 132 字节(见上一节段 3)。max_tp_shards=1 表示它不按 TP 切分,每个 rank 都留一份完整副本。GLM-5.3 的目标模型只有 21 个 full 层有索引器,所以索引器缓存的层数是 21,不是 78;MTP 草稿层另有一份自己的索引器缓存。
合账
以 1M 上下文、fp8_ds_mla 为例:
1M token 就是 56.6GB(52.7GiB)/请求。换成 fp8_e4m3 主 KV: 字节,约 46.6KiB/token,1M 是 50.0GB(46.6GiB)/请求。两种格式差约 11%,正好是「RoPE 留在 BF16」的代价。
8×B200 共 1440GB 显存,GLM-5.3 的 FP8 权重约 743GB,激活与 workspace 再占几十 GB,剩给 KV 的约 600GB 出头。按 53.9KB/token 算,理论上能装 10–11 条 1M 请求;如果按 8K 平均上下文,则能装 1400 条左右。vLLM recipe 给出的 --max-num-seqs 32 是「并发请求数上限」,不是「32 条 1M 请求」——32 条 8K 请求只占约 14GB KV,瓶颈在调度与算力,不在显存。真正的 1M 长上下文部署必须配合前缀缓存命中(同一份文档的重复前缀)、P/D 分离(prefill 与 decode 分开扩容)和 KV 卸载,单机把 32 条 1M 请求都塞进 GPU 是不现实的。
索引器缓存还有一条额外约束:它是 INDEXER 角色的缓存,前缀缓存命中时必须和主 KV 一起命中。如果只命中主 KV 而索引器缓存缺失,shared 层会读到空的 Top-K 缓冲——这不会报错,只会让注意力看到错误的 token 集合。vLLM 在 MLAAttentionSpec.merge() 里要求同组层的 cache_role 一致,并在 KV 管理器里把索引器缓存当作一份独立的 KVCacheSpec 参与块分配;两者共用同一张块表,前缀匹配的块号天然相同,所以「主 KV 命中、索引器未命中」在这套设计里不会单独发生——除非前缀缓存被人工按层禁用,那属于不支持的配置。
MoE:从 hidden 到 9 个专家的前向,与 EP 下的一次 all-to-all
注意力之后是 FFN。GLM-5.3 的 78 层里,前 3 层是 intermediate_size=12288 的稠密 FFN,后 75 层是 MoE:256 个路由专家(每个 moe_intermediate_size=2048)加 1 个共享专家,每 token 激活 8 个路由专家 + 1 个共享专家。路由打分用 sigmoid,带 e_score_correction_bias(不需要 auxiliary loss 的 noaux_tc 方法),最后乘 routed_scaling_factor=2.5。
一个 token 在 MoE 里经过的算子
DeepseekV2MoE.forward 的主体只有三行:
def forward(self, hidden_states, already_sequence_parallel=False): num_tokens, hidden_dim = hidden_states.shape if self.is_sequence_parallel and not already_sequence_parallel: hidden_states = sequence_parallel_chunk(hidden_states) final_hidden_states = self.experts(hidden_states=hidden_states, router_logits=hidden_states) ...self.experts 是 FusedMoEFactory 产出的融合 MoE 层。它内部依次完成:门控 GEMM(6144 → 256)、grouped_topk(sigmoid 打分、加偏置、按组选 Top-8、归一化)、共享专家 GEMM、路由专家的 grouped GEMM、以及把结果按 token 加权的 combine。对 GLM-5.3,分组参数是 n_group=1, topk_group=1,所以「分组」这一步退化为「全局取前 8」;真正的分组路由(n_group > 1)是 DeepSeek-V3 用来限制每个 token 的专家落在少数节点上的设计,GLM-5.3 不启用。
门控 GEMM 是 MoE 里唯一在 TP 下复制的部分。GateLinear(6144, 256) 的输出只有 256 维——比 hidden 窄得多,切分它的收益低于复制它的通信成本,所以 gate 权重在每个 rank 上完整存在。每个 rank 都算出同样的 Top-8 专家号和权重,这是 EP 下「先本地算路由、再按路由决定把 token 发给谁」的前提。
共享专家的形状值得单独提一句:intermediate_size = moe_intermediate_size × n_shared_experts = 2048 × 1,也就是说共享专家和小专家一样宽。这在 GLM-5.3 里意味着每个 token 的实际 FFN 计算量来自 9 个专家并行计算后的相加:8 个路由小专家(各 2048 中间维)加 1 个共享小专家。如果按「一个大共享专家 + 小路由专家」的直觉去估算,会高估计算量。
一次 decode 的专家计算量
每 token 的 MoE 计算(每个专家):
其中 3 是 gate_proj、up_proj、down_proj 三次矩阵乘,2 是乘加算两次运算。9 个专家合计约 680 MFLOP/token/层;75 个 MoE 层再加 3 个稠密层,decode 每 token 的 FFN 部分是几十 GFLOP 量级。对一张 B200(约 2.25 PFLOPS 密集 FP8),这个计算量在毫秒以下——真正的时间花在「读 9 个专家的权重」。
每个小专家的权重是 个参数;FP8 下约 37.7MB。8 个路由专家加 1 个共享专家约 340MB/层/rank,这是 decode 每一层必须从 HBM 搬到 SM 的权重。如果所有 256 个专家都放在每个 rank 上,78 层会让每张卡持有 ——远超单卡 141GB。所以 GLM-5.3 的 8 卡部署必须用专家并行(EP)。
EP 下的 dispatch / combine
EP=8 时,每张卡持有 32 个路由专家(256/8),共享专家在每张卡上复制。一个 token 的 8 个专家可能落在 8 张不同的卡上,于是每次 MoE 前向都有一次 all-to-all:
- dispatch:每张卡按「本卡 token 的 Top-8 专家」把 hidden 发到专家所在的卡;
- 专家 GEMM:每张卡对本卡接收到的所有 token 跑 grouped GEMM,按专家分桶;
- combine:把结果按 token 发回原卡,按门控权重加权求和。
这一往返的通信量与「所有 token 都被每个专家激活」时的全量 all-to-all 相比小得多:每个 token 只发 8 份而不是 256 份。但仍与 batch 大小成正比:一个 decode step 有 行(MTP 验证),每条行发往至多 8 个远端 rank。
DeepseekV2MoE.__init__ 里 EP 相关的字段把这件事讲清楚了:
self.n_logical_experts = self.n_routed_experts # 256self.n_physical_experts = self.n_logical_experts + self.n_redundant_expertsself.n_local_physical_experts = self.n_physical_experts // self.ep_size # 32 + 冗余n_redundant_experts 来自 EPLB 配置。如果热点专家集中在少数 rank,冗余副本可以把它们复制到负载轻的卡上;这对 GLM-5.3 的路由分布尤其重要,因为 sigmoid + noaux_tc 的偏置校正只会让路由分布在统计上均衡,不会保证每轮均衡。8 卡单机上常见的 TP8 + EP 组合里,TP 组与 EP 组都覆盖全部 8 张卡;--enable-expert-parallel 打开后 MoE 的权重按专家切分,注意力仍按头切分,路由专家被平均摊到每张卡上。
vLLM 的 MoE 后端选择(--moe-backend)在这个环节直接决定性能:Hopper 上 deep_gemm 或 cutlass 的 grouped GEMM、Blackwell 上的 flashinfer_cutedsl / deep_gemm 等。SGLang 那边对应的是 --moe-a2a-backend deepep 决定 dispatch 走 DeepEP 的低延迟内核。两边的差异不在模型,而在这层「哪套实现更适配当前硬件」。
投机解码:MTP 层内部、一次验证里的 6 个 token
MTP 层的前向结构
GLM-5.3 的 checkpoint 带 1 个 MTP 层(num_nextn_predict_layers=1),推理配置 --speculative-config.method mtp --speculative-config.num_speculative_tokens 5,也就是每次验证 6 个 token(1 个已确认位置 + 5 个草稿)。
MTP 层不是一个完整的 Transformer 层,而是「输入融合 + 共享的 1 个 Decoder 层 + 共享的 LM Head」:
self.enorm = RMSNorm(config.hidden_size, eps=...)self.hnorm = RMSNorm(config.hidden_size, eps=...)self.eh_proj = nn.Linear(config.hidden_size * 2, config.hidden_size, bias=False)...eh_input = fused_embed_eh_norm( positions, input_ids, embed_table, previous_hidden_states, self.enorm.weight, self.hnorm.weight, self.enorm.variance_epsilon,)hidden_states = run_glm52_plan(self._eh_plan, eh_input, self.eh_proj.weight)hidden_states, residual = self.mtp_block(positions=positions, hidden_states=hidden_states, residual=None)hidden_states, _ = fused_allreduce_rms_norm(hidden_states, residual, self.shared_head.norm)return hidden_states, hidden_statesenorm 归一化「下一个 token 的嵌入」,hnorm 归一化「主模型上一个位置的隐藏状态」,两者拼成 12288 维后经 eh_proj 压回 6144 维,送进一层 DSA Decoder 层,最后过共享的 LM Head。fused_embed_eh_norm 把查表、两个归一化、拼接合成一个 kernel;紧随其后的 eh_proj(N=6144, K=12288)正是 GLM 低延迟 GEMM 表覆盖的瘦 GEMM——草稿步每条请求只有一行,M 很小,K 却高达 12288。
return hidden_states, hidden_states 这个「返回同一个张量两次」的写法有讲究。源码注释解释了它的两个用途:
# Recycle the POST-final-norm hidden into the next draft step. The# residual-add is fused into the final RMSNorm so it is computed# exactly once, and the result is returned for both tuple positions:# the draft-logits hidden (compute_logits applies the LM head only) and# the recycled previous_hidden_states. Recycling the pre-final-norm# hidden mismatches the draft model's hnorm and lowers MTP acceptance;# post-norm recycle matches deepseek_mtp.py (PR #45895).第一次返回给 compute_logits——它直接把归一化后的 hidden 送进 LM Head,不再做第二次 RMSNorm;第二次返回给下一个草稿步当 previous_hidden_states。为什么必须用归一化之后的 hidden 回收,而不是归一化之前的?因为 MTP 训练时 hnorm 看到的输入就是某个位置的最终隐藏状态(归一化后),用未归一化的 hidden 会让草稿模型的输入分布偏移,接受率下降。这是投机解码实现里最容易写错、又最难以察觉的一处。
草稿环:5 步草稿 + 1 次目标验证
对一条请求,一个投机步的流程是:
- 目标模型上一步输出 hidden 与已确定的 token ;
- MTP 层用
(embed(t_0), h_0)预测 ,输出 ; - 用
(embed(t_1), h_1)预测 ,输出 ;依此类推 5 步,得到 ; - 目标模型一次前向验证 6 个位置 ,得到 6 组 logits;
- 按接受规则从左到右比对,接受前 个草稿 token,回滚其余 KV。
其中第 1 步的 Top-K 结果由 MTP 层自己的索引器算出;之后的草稿步因 index_share_for_mtp_iteration=true 直接复用(set_skip_topk(True)),这就是索引组一节的延伸。
一个 MTP 步的算力账:草稿 5 次单层前向 + 验证 1 次 78 层前向。按层数算,草稿部分是目标的约 ,但它每步还要过一次 154880 维的 LM Head;即便如此,只要接受长度 大于 1,草稿的额外开销就远小于它替目标模型省掉的 次完整前向。所以 MTP 的收益几乎完全取决于接受率——这也是 vLLM 设计 get_top_tokens 的原因。
草稿侧不该做的 AllGather
普通采样路径 compute_logits 需要把各 rank 的词表分片 logits AllGather 成 154880 维的完整 logits,再采样。对一个 batch=32、5 步草稿的 decode,每行一份 154880 维 BF16 结果就是约 310KB,32 条请求 × 5 步共约 50MB/步。vLLM 为此给 MTP 层单独提供了:
def get_top_tokens(self, hidden_states, spec_step_idx=0): """Greedy draft token ids via per-rank argmax over the vocab shard.
Saves the full-vocab all-gather ``compute_logits`` does; same tokens. Name is fixed by the protocol the proposer probes for (``use_local_argmax_reduction``). """它内部的实现是 LogitsProcessor.get_top_tokens:
local_max_vals, local_max_indices = logits.max(dim=-1)global_indices = local_max_indices + vocab_start...local_pair = torch.stack([local_max_vals.float(), global_indices.float()], dim=-1)gathered = tensor_model_parallel_all_gather(local_pair, dim=-1)通信量从「每行 154880 个数」降到「每行 2×TP 个数」:TP=8 时每行 16 个数。对 32 条请求的 5 个草稿步(160 行),总通信量从约 50MB 降到约 2.5KB。这个优化的前提是贪心草稿——Top-1 是单调的,每个 rank 先取本地最大,再在所有 rank 的最大值里取全局最大,与原词表的最大值等价。如果草稿要按概率采样,就不能这样做。
草稿阶段用贪心、验证阶段做完整采样校验,是投机解码的标准分工:草稿只需要「便宜的近似」,正确性由验证阶段保证。
KV 回滚
验证后被拒绝的草稿 token,其 KV 已经写进了分页池。回滚的做法是把这些槽位从块表里切除、必要时释放页。vLLM 的 KV 回滚与 SGLang 的「接受长度写回 + KV 截断」是同一个语义,区别在于 vLLM 把每个投机步的 6 行都当成 decode 行打包进同一个 batch,块表在调度器里就已经按 6 行扩展,回滚时按各请求实际接受长度截断。对 GLM-5.3 这种 kv_cache_dtype=fp8_e4m3 的部署,回滚不涉及反量化,只是页表算术。
最后一个 token:采样、投机校验与输出
78 层走完,hidden 进入 LM Head。GLM-5.3 的词表是 154880,按 TP8 切分后每张卡只算 19360 个 logits;要让采样看到完整分布,还是得把各 rank 的分片拼起来。这就是通信账本里那 59.5MB 的来源,也是整条链路最后一次集合通信。
目标模型的采样
vLLM 的 Sampler.forward 把采样拆成一串有严格顺序的步骤,docstring 本身就是一份算法说明:
- 如果请求了 logprobs,先按
logprobs_mode决定用原始 logits 还是原始 logprobs; - 把 logits 转成 FP32;
- 应用 allowed token ids 白名单与 bad words 排除;
- 应用会影响贪心结果的 logits processor(min tokens、logit bias);
- 应用重复、频率、存在三种惩罚;
- 先做贪心采样;若不是全贪心,再应用温度、min-p、top-k/top-p,按概率分布采样;
- 收集 top-N 与采样 token 的 logprobs;
- 返回
SamplerOutput。
对 GLM-5.3,这份顺序表里有两处与模型相关:词表规模让第 2 步的 FP32 转换变成一次 154880×4 字节/行的写回(batch 32×6 行约 119MB 的临时流量);思考模式下 logprobs 与 reasoning 内容的切分发生在后处理,不在采样器里。--reasoning-parser glm47 负责把输出文本切成 reasoning_content 与 content,--tool-call-parser glm47 负责把工具调用标记解析成结构化字段——这两个 parser 是服务层的字符串处理,不产生 GPU 算子。
投机验证的采样器
MTP 的验证不是「拿目标 logits 直接 argmax」那么简单。RejectionSampler 的类注释把术语定义得很清楚:
# accepted tokens: tokens that are accepted based on the relationship# between the "raw" draft and target probabilities.# recovered tokens: tokens that are sampled based on the adjusted probability# distribution, which is derived from both the draft and target probabilities.# bonus tokens:# If all proposed tokens are accepted, the bonus token is added to the# end of the sequence. The bonus token is only sampled from the target# probabilities.# output tokens = accepted tokens + recovered tokens + bonus tokens它严格遵循 speculative sampling 的原始算法(Leviathan 等人的 arXiv:2211.17192):对每个草稿 token,以 的概率接受;拒绝时从「目标分布减草稿分布的正部」重采样一个 recovered token;如果 5 个草稿全部被接受,再从目标分布在最后一个位置采样一个 bonus token。于是接受长度 对应的实际产出是 个 token(含 bonus),这也是「5 个草稿、6 个验证位置」的由来。
predict_bonus_token=True 是这条路径在采样器里的开关:Sampler.forward 在验证批上多采一个位置,交给 RejectionSampler 当作 bonus。bonus token 用完整的 top-k/top-p 采样,而草稿 token 的接受/拒绝只做概率比校验——两者用不同的采样策略,是因为草稿端只支持贪心,目标端要尊重用户的采样参数。
输出回传
采样结果写进 SamplerOutput,由 GPUModelRunner 回传给 EngineCore;EngineCore 把它变成 EngineCoreOutput,再经输出队列送到前端进程。前端做增量 detokenize:新 token 先拼进「未完成字节」缓冲,遇到 stop string 就截断并标记结束,遇到完整 UTF-8 字符才发给客户端。流式响应按 SSE 逐段下发,首 token 的延迟(TTFT)由 prefill 决定,后续 token 的间隔(ITL)由 decode step 决定——这两个指标在投机解码下的口径要特别小心:MTP 一次返回多个 token 时,ITL 应按「每个 token」还是「每个 step」统计,会得到完全不同的数字。
这一步没有新的集合通信:logits 的 AllGather 已经在采样前完成,之后的 token id、logprobs、finish reason 都是小张量。输出侧真正影响流式体验的是 detokenizer 的增量解码与 stop string 匹配——它们与模型无关,但对 1M 上下文、长时间思考的请求,累积的字符串处理不能忽略。
小结:模型决定常量,框架决定怎么搬
把两篇合起来看,GLM-5.3 的推理成本可以拆成三层:
第一层是模型常量,换框架不会变。 78 层、21 个 full 索引器、每层 576 维 MLA latent、256 选 8 的 MoE、1 个 MTP 层、2048 的 Top-K。这些数字决定了每 token 的 KV 至少 576 字节/层、每 token 的专家计算至少 8×3 次小 GEMM、每个 decode step 至少扫一遍上下文做索引。任何框架优化都只能改变「搬多少、搬几次、什么时候搬」,不能改变「必须搬」。
第二层是框架的融合边界。 vLLM 把 A 投影合成一个 GEMM,把 q/kv 归一化、两套 RoPE、两种缓存写入、Top-K 清零塞进一个四分支 kernel,把层边界的 AllReduce 塞进 RMSNorm,把索引器的逻辑→物理换算挪到 side stream。SGLang 在同样的位置做了不同的切分:A 投影同样一次融合,但 fused_norm_rope 是一个整体 kernel 而不是四分支,索引器复用靠每层的 skip_topk 标志而不是索引组。两者的收益都在「减少 launch 与减少 HBM 往返」,区别在于对 CUDA Graph 的友好程度与代码复杂度。
第三层是部署参数,直接改写账本。 同一个模型,fp8_ds_mla 与 fp8_e4m3 差约 6GiB/1M 请求;另外,KV 格式本身由后端决定(FLASHMLA_SPARSE 强制 fp8_ds_mla,FLASHINFER_MLA_SPARSE 保持标准 FP8),--kv-cache-dtype 的字面值与实际布局并不总是一致;num_speculative_tokens=5 把验证 batch 变成 6 行,索引器与注意力的 KV 读取按请求摊薄,但 Top-K 调用量乘 6;max_num_seqs=32 决定 KV 预算与专家负载的均衡点;--enable-expert-parallel 决定 724GB 的专家权重怎么摊到 8 张卡上。
如果只记一句话:DSA 把注意力的计算从「与上下文平方相关」压到「与上下文线性相关」,但没有把索引器的扫描压掉;GLM-5.3 的 21/57 分层是在「索引器太贵」和「Top-K 误差累积」之间找到的折中,而 vLLM 的索引组是把这份折中写成了运行时可复用的对象。
参考资料
- zai-org/GLM-5.3 模型卡(743B-A39B、78 层、256 专家、1M 上下文与 config.json)
- vLLM GLM-5.3 部署配方(TP8、FP8 KV、MTP 5 token、max-num-seqs 32)
- vLLM 源码:deepseek_v32/nvidia/model.py(DSA 主干、索引组、权重装载)
- vLLM 源码:deepseek_v32/attention.py(六段注意力与 fused_qkv_a_proj)
- vLLM 源码:deepseek_v32/common/kernels.py(fused_norm_rope、fused_q、fused_eh_norm)
- vLLM 源码:deepseek_v32/nvidia/mtp.py(MTP 层与索引共享)
- vLLM 源码:mla/index_group.py(SparseMLAIndexGroup 与逻辑→物理换算)
- vLLM 源码:mla/indexer.py(DSA 索引器元数据与 Top-K 后端)
- vLLM 源码:layers/sparse_attn_indexer.py(分页 MQA logits 与 Top-K 选择)
- vLLM 源码:mla/flashmla_sparse.py(稀疏 MLA 解码与索引组消费)
- vLLM 源码:models/deepseek_v2.py(MLA/MoE 通用实现与 DeepseekV32IndexerCache)
- vLLM 源码:nvidia/glm52_low_latency_gemm.py(GLM 专用 skinny GEMM 表)
- vLLM 设计文档:V1 进程架构与 Entrypoints
- DeepSeek-V3.2 技术报告(DSA 与稀疏 MLA 的原始设计,arXiv:2512.02556)
- FlashMLA:MLA 解码内核与分页 KV 实现
- DeepEP:MoE dispatch/combine 通信库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



