


GLM-5.3 推理全链路(一):一个请求在 SGLang 里经过哪些算子、哪些通信
从一次 HTTP 请求说起
GLM-5.3 是智谱(Z.ai)在 2026 年发布的开源旗舰模型。它的模型结构与 DeepSeek-V3.2 高度一致:744B 总参数、40B 激活的 MoE,注意力层用的是 MLA(Multi-head Latent Attention)加 DSA(DeepSeek Sparse Attention)稀疏索引器,外加一层 MTP(Multi-Token Prediction)草稿层,上下文窗口 1,048,576 token,权重以 FP8 发布。官方 README 给出的模型规格是 744B-A40B,SGLang 的 cookbook 则写明 78 个 Transformer 层、256 个路由专家(每 token 激活 8 个)、KV cache 用 FP8 E4M3。
这样大小的模型没人能在一张卡上跑。最常见的生产形态是 TP8,也就是 8 张卡共享一份激活值、按列/行切分权重;更大的部署还会叠加 DP Attention、EP(专家并行)、prefill context parallel,甚至可以做成 prefill/decode 分离。一次请求进来之后,它会在不同进程、不同 rank、不同算子之间来回穿梭:HTTP 层把 JSON 变成 token id,调度器决定这一步哪些请求能跑,模型前向里每个层都要走一遍 attention 与 MoE,每一步 decode 之间夹杂 AllReduce、AllGather、ReduceScatter、Dispatch/Combine 等集合通信。
这篇文章不讨论模型效果,也不讨论训练。它只回答一个问题:在 SGLang 里部署 GLM-5.3 之后,一个请求从到达服务器到返回第一个 token、再到每个后续 token,实际执行了哪些算子、触发了哪些通信。 全部结论都落到 SGLang 的源码路径上,所引代码取自仓库中支持 glm_moe_dsa 架构的版本。
文章按”时间线”组织,而不是按模块组织:
- 请求进入:HTTP 入口、tokenizer、请求对象
- 进队:调度器的队列与请求对象
- 一次调度:
get_next_batch_to_run到run_batch - 变成 GPU 输入:
ForwardBatch、ScheduleBatch.prepare_for_extend/decode - 模型前向的框架:
ModelRunner的分派、CUDA Graph 判定 - 一个 Decoder Layer 内部:RMSNorm → MLA 投影 → DSA 索引器 → 稀疏 MLA → o_proj → MoE
- MTP 投机解码:draft、verify、draft_extend 三段
- 每处集合通信的完整账单
- 四个值得单拎出来的细节:TopK 广播、prefix cache、AllReduce 融合、CUDA Graph 与 MTP
第二篇会横向对比 vLLM 的同一条路径,说明同一个架构在两个框架里被拆成了什么样。
先看清部署形态:744B 参数装在哪里
讨论”一个请求经过什么”,先要知道它经过的模型长什么样。GLM-5.3 的 Hugging Face 配置里,architectures 是 GlmMoeDsaForCausalLM,model_type 是 glm_moe_dsa。这两个名字已经说明了三件事:它是 MoE,它用 DSA 稀疏注意力,并且它的实现与 DeepSeek-V3.2 共用同一套模型代码。SGLang 里对应的类只有一行:
class GlmMoeDsaForCausalLM(DeepseekV2ForCausalLM): fused_shared_experts_architecture = "GlmMoeDsaForCausalLM"这段代码位于 python/sglang/srt/models/glm4_moe.py。GlmMoeDsaForCausalLM 直接继承 DeepSeek-V2 的因果语言模型,只改了一个用于共享专家融合的类属性;权重加载、前向结构、注意力与 MoE 全部复用 deepseek_v2.py。因此下文讨论的算子链,既是 GLM-5.3 的算子链,也是 DeepSeek-V3.2 的算子链——差别只在超参数。
先把关键超参数列出来。它们决定了每个矩阵的形状、每次通信的字节数,以及 KV Cache 的大小:
| 配置项 | 值 | 含义 |
|---|---|---|
num_hidden_layers | 78 | Transformer 层数,另有 1 层 MTP |
hidden_size | 6144 | 残差流宽度 |
num_attention_heads | 64 | 查询头数 |
head_dim / qk_nope_head_dim / qk_rope_head_dim | 192 / 192 / 64 | 每头 Q/K 总维度为 256,其中 64 维做 RoPE |
v_head_dim | 256 | 每头 V 的维度 |
q_lora_rank / kv_lora_rank | 2048 / 512 | MLA 的 Q 低秩压缩维度与 KV 潜向量维度 |
n_routed_experts / num_experts_per_tok | 256 / 8 | 每层 256 个路由专家,每 token 选 8 个 |
n_shared_experts | 1 | 每层 1 个共享专家 |
moe_intermediate_size | 2048 | 单个专家的中间维度 |
first_k_dense_replace | 3 | 前 3 层用稠密 MLP,其余 75 层是 MoE |
index_topk | 2048 | 每个 query 只对 2048 个 KV token 做注意力 |
index_n_heads / index_head_dim | 32 / 128 | 闪电索引器的头数与头维度 |
max_position_embeddings | 1,048,576 | 1M 上下文 |
num_attention_heads = 64 与 head_dim = 192 看起来矛盾,其实是 MLA 的两种投影维度:Q/K 的”NoPE 部分”每头 192 维,另有 64 维共享的 RoPE 分量,拼起来是 256 维;V 每头 256 维。GLM-5 的技术报告解释过这个选择:MLA 在解码时要做 576 维(512 潜向量 + 64 RoPE)的点积,比 GQA 的 128 维更重;把 head dimension 从 192 提到 256、头数减少三分之一,可以在训练计算量不变的前提下降低解码开销。
参数量的分布可以用矩阵形状直接算出来。每层注意力的四个投影:
- A 投影:M
- Q 上投影:M
- KV 上投影:M
- O 投影:M
合计约 165M 参数一层,78 层约 12.9B。索引器每层约 9.4M,但只有 21 层带独立索引器,约 0.20B。MoE 部分才是大头:单个路由专家有 w1、w3、w2 三个矩阵,参数量为 M;256 个专家就是 9.66B 一层,75 层约 724B。共享专家每层 37.75M,75 层约 2.8B;前三个稠密层每层 M,合计 0.68B。加上 154880 × 6144 的词嵌入与 LM Head,总量正好落在 744B 附近。这张账解释了为什么”总参数 744B、激活 40B”:每 token 只走 8 个专家,MoE 只激活约 22.7B,加上注意力 12.9B、共享专家 2.8B、稠密层 0.68B 与嵌入,约 40B。
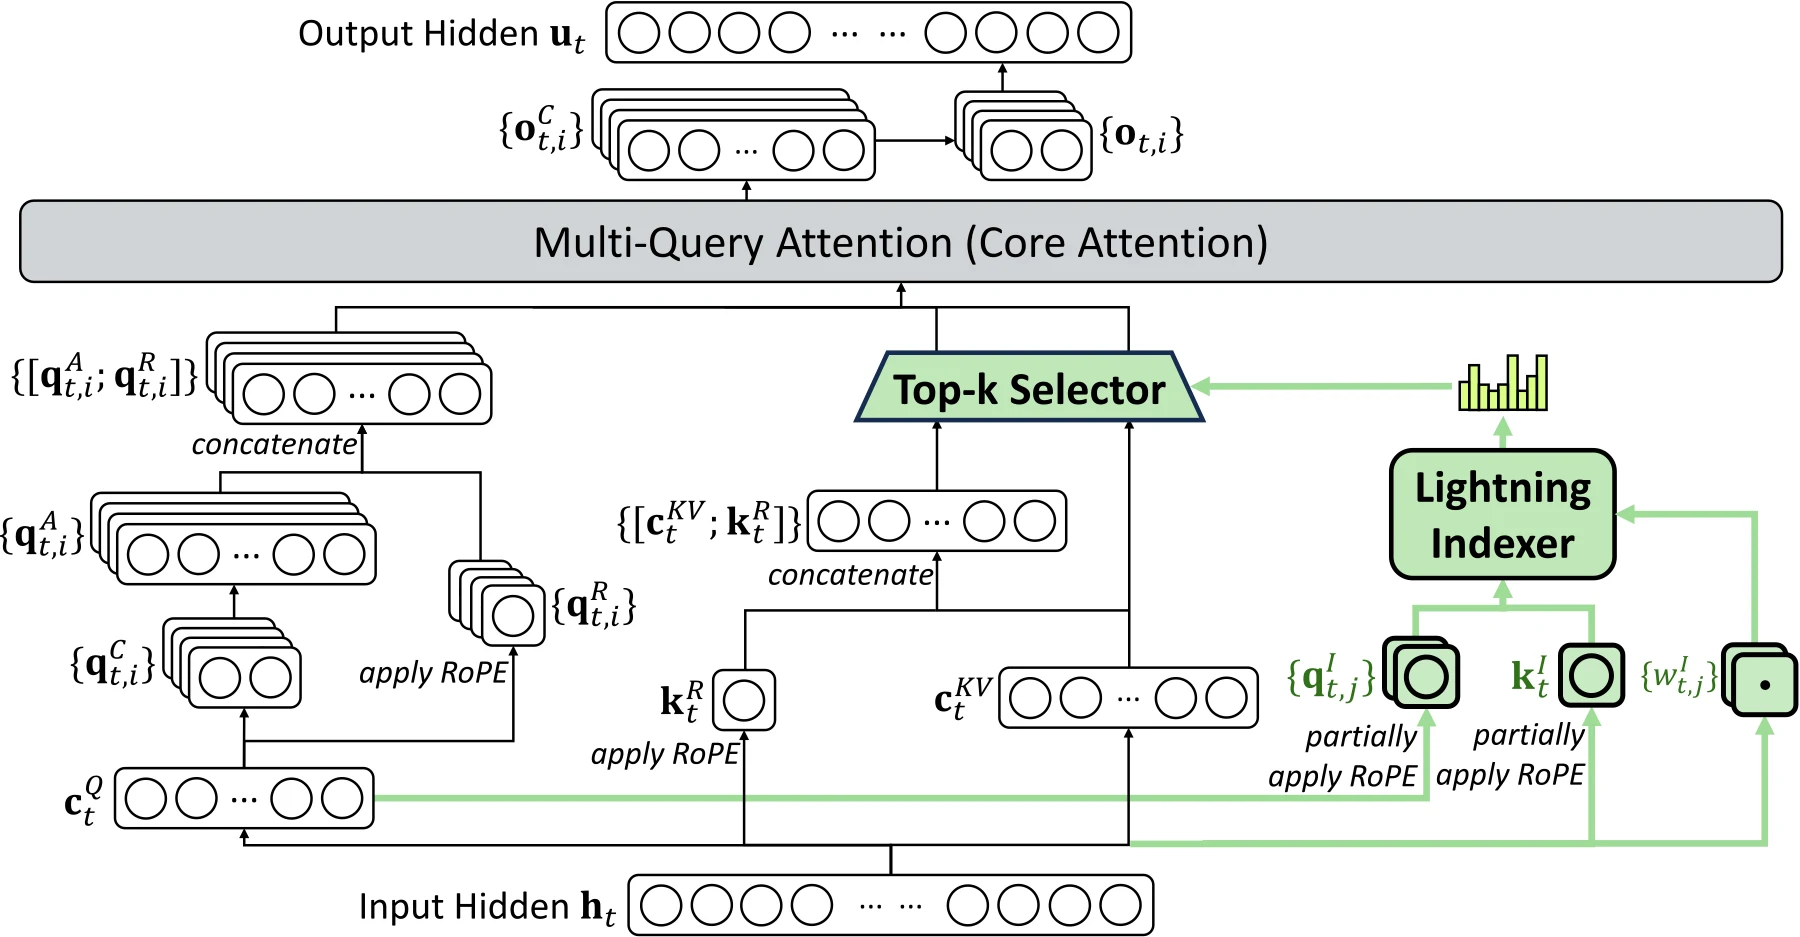
图源:DeepSeek-V3.2 技术报告(arXiv:2512.02556)Figure 2。GLM-5.3 与 DeepSeek-V3.2 共用
deepseek_v2.py的模型实现。
部署上,744B 的 FP8 权重约 744GB,单机 8 张 H200(141GB)才刚刚够放权重和一部分 KV。SGLang cookbook 的推荐做法是 --tp 8 起步;追求吞吐时叠加 DP Attention 与 EP,让每张卡只保留自己负责的专家,把注意力按请求分片。一个典型的单机吞吐型命令如下(来自 cookbook 的 GLM-5.3 配方,参数名以当前 SGLang 为准):
sglang serve --model-path zai-org/GLM-5.3 \ --tp 8 --ep-size 8 --moe-a2a-backend deepep \ --attn-dp-size 8 --kv-cache-dtype fp8_e4m3 \ --dsa-topk-backend sgl-kernel \ --dsa-prefill-backend flashmla_sparse_q8 \ --dsa-decode-backend flashmla_kv \ --speculative-algorithm EAGLE \ --speculative-num-steps 5 --speculative-eagle-topk 1 \ --speculative-num-draft-tokens 6这行命令里的每个开关,都会在后面的请求路径上留下痕迹:--attn-dp-size 8 决定注意力前要 AllGather、后要 ReduceScatter;--ep-size 8 决定 MoE 要走 DeepEP 的 dispatch/combine;--dsa-* 决定索引器 Top-K 用哪个 kernel;--speculative-* 决定每个 decode step 实际会算几次前向。
第一阶段:HTTP 请求如何变成一条待调度的请求
入口进程:OpenAI 兼容层
SGLang 的 sglang serve 拉起的是一个多进程体系。最前面是 OpenAI 兼容的 HTTP 服务(python/sglang/srt/entrypoints/openai/),后面是 TokenizerManager 进程,再后面是每个 TP/DP rank 各一个 Scheduler 进程与一个 ModelRunner(GPU 前向)。GLM-5.3 是推理模型,官方建议挂 --reasoning-parser auto(解析为 glm45)与 --tool-call-parser auto(解析为 glm47),这两项只影响输出解析,不进入模型前向。
一个 POST /v1/chat/completions 到达后,入口层做的事情按顺序是:
- 解析 JSON、校验参数,把 sampling 参数(temperature、top_p、max_tokens、stop 字符串等)规整为
SamplingParams; - 用 GLM-5.3 随模型发布的 chat template 把 messages 渲染成一整段 prompt 文本。template 会写入
<|system|>、Reasoning Effort: Max等控制行,并在需要时以<|begin_of_assistant|>之类的标记开启思考段; - 把渲染后的文本、tools 定义交给
TokenizerManager.generate_request。
这几步全部是 CPU 工作,不碰 GPU,也不产生任何通信。
TokenizerManager:分词与请求对象
generate_request 的核心是 _tokenize_one_request,它把文本交给 SentencePiece/Hugging Face tokenizer 得到 input_ids,再构造一个 TokenizedGenerateReqInput(定义在 python/sglang/srt/managers/io_struct.py)。这个对象携带了后续所有环节需要的东西:
input_ids:prompt 的 token 序列;sampling_params:采样配置;stream、return_logprob、top_logprobs_num:输出形态;rid、priority、lora_id、bootstrap_*:请求标识、优先级、LoRA 以及 P/D 分离所需的握手信息;time_stats:记录各阶段时间戳,用于后续metrics与日志。
随后 _send_one_request 把它序列化,经 ZMQ 通道发给 Scheduler 进程。这条 IPC 在 frontend-engine-process-boundary 一文里有专门拆解,这里只需要知道:它是整个链路里唯一一次”请求对象跨进程”,从这一步开始,后面所有工作都发生在 Scheduler 一侧。
需要注意,GlmMoeDsaForCausalLM 的 tokenizer 就是模型自带的,词表 154,880。prompt 里的 10 万个 token 在进入 GPU 之前只是一个 Python array。
Scheduler 收到请求
Scheduler 里的 event_loop_normal 每轮先 ingest_requests() 把 ZMQ 里的新请求收进 waiting_queue,再调用 get_next_batch_to_run。ingest_requests 会把 TokenizedGenerateReqInput 变成内部的 Req 对象——这是调度器的账本:保存 origin_input_ids、fill_ids、prefix_len(前缀缓存命中长度)、extend_end(本次要算到第几个 token)、采样状态、KV 池中的槽位等。Req 的构造会同步调用 prefix cache 的匹配逻辑(详见下文”prefix cache”一节),把可以复用的前缀长度算出来。
到这一步为止,GLM-5.3 还没有被”读到”。模型真正的执行从下一阶段才出现。
第二阶段:调度器决定这一步跑谁
两本账:token 预算与 KV 槽位
调度器面对的核心矛盾,是”能放的 token”和”能放的 KV”都有限。get_next_batch_to_run 的流程可以概括为三件事:
- 合并上一轮的 prefill 批次。上一轮作为
last_batch跑完的 extend 请求,如果还没释放,会被合并进running_batch,从这一轮起按 decode 处理; - 尝试收新的 prefill。调用
get_new_batch_prefill,由PrefillAdder逐个检查waiting_queue里的Req:它的extend_len是否超过rem_input_tokens(受--max-prefill-tokens控制)、KV 块是否够放、是否触发 chunked prefill; - 否则跑 decode。从
running_batch里挑出这一轮能跑 decode 的请求,构成 decode 批次。
对应的 event_loop_normal(managers/scheduler.py)每轮就是这一组动作:
while True: self.ingest_requests() plan = self.get_next_batch_to_run( running_batch=self.running_batch, last_batch=self.last_batch ) self.running_batch = plan.running_batch batch = plan.batch_to_run if batch: result = self.run_batch(batch) self.process_batch_result(batch, result) else: self.on_idle() self.last_batch = batchrun_batch 并不直接调模型,而是把 ScheduleBatch 交给 model_worker.forward_batch_generation;普通模型走 TpModelWorker,开了投机解码则走 EAGLEWorkerV2,后者会在同一次调用里做完 draft、verify、draft_extend 三段。这个分派点在 managers/tp_worker.py 与 speculative/eagle_worker_v2.py。
PrefillAdder 的账本(python/sglang/srt/managers/schedule_policy.py)有几项直接与 GLM-5.3 相关:
- page_size:KV 池按块分配,GLM-5.3 在 SGLang 里默认 page_size=64(FlashMLA 系列后端的约束);页越大、内部碎片越多,但索引器按块筛选与 TMA 传输越方便;
- memory_budget:由
token_to_kv_pool_allocator.create_prefill_budget生成,统计当前剩余可分配 token 数,扣掉 running batch 未来若干 decode token 的预留; - chunked prefill:当一条 prompt 超出剩余预算时,
PrefillAdder会把它切块,把chunked_req记为当前块,下一轮接着算;只有这一块被记录为chunked_req,其余部分等待。
对一个 1M 上下文请求,chunked prefill 几乎是必选项。把 --chunked-prefill-size 设成 32768 或 131072,会让一条超长 prompt 被切成若干段与正在解码的请求同批执行,从而避免一条长 prompt 独占 GPU 数分钟、把其他请求的 token 间隔拖成尖刺。
批次构造:ScheduleBatch
选定这一轮的请求集合后,调度器构造 ScheduleBatch(python/sglang/srt/managers/schedule_batch.py),随后调用 prepare_for_extend() 或 prepare_for_decode()。这一步是整个请求路径里”CPU 世界到 GPU 世界”的第一次交接,具体做了:
- 拼输入 token:
input_ids = [r.get_fill_ids()[r.prefix_len:] for r in reqs],即把每条请求”本次要算的部分”(跳过前缀命中部分)拼成一维张量,放在 pinned CPU 内存上; - 记录序列长度:
seq_lens(算完之后的总长度)、prefix_lens(前缀命中长度)、extend_lens(本次新增长度); - 分配 KV 槽位:
alloc_for_extend(batch)(定义在python/sglang/srt/mem_cache/allocation.py)调用alloc_req_slots为每条请求分配req_pool行号,再调用alloc_paged_token_slots_extend分配这一批要写入的 KV 页; - 写
req_to_token映射:把新分配到的块号与位置写进req_to_token_pool,之后注意力内核根据这张表把每个 token 的逻辑位置映射到物理 KV 页; - 给 decode 批次加一:
prepare_for_decode()里self.seq_lens = self.seq_lens + 1,并alloc_for_decode为每个请求分一个 token 的 KV 槽位。
prepare_for_extend 的关键几行是:
input_ids = [r.get_fill_ids()[r.prefix_len :] for r in reqs]extend_num_tokens = sum(len(ids) for ids in input_ids)seq_lens = [r.extend_end for r in reqs]prefix_lens = [r.prefix_len for r in reqs]...out_cache_loc, req_pool_indices_tensor, req_pool_indices_cpu = alloc_for_extend(self)prefix_len 是前缀缓存命中的长度:命中的部分不再进 input_ids,也不再写 KV;out_cache_loc 只覆盖新增的 token。对一条 128K prompt 命中 100K 前缀的请求,这一下把 prefill 的计算量从 128K 降到 28K,同时省掉 100K 个 token 的 KV 写入。
这几步在 decode 阶段每轮都会重复一次。一个 batch 有 条请求,每轮 decode 需要分配的 KV 是 个 token,对应的 个 slot,以及一次对 req_to_token 的写入。这一步全程在 CPU 侧调度器线程中完成,GPU 上的前向由后续 Worker 异步发起;开启了 --enable-overlap-schedule(默认)时,调度与上一个前向重叠,进一步把 CPU 时间藏起来。
第三阶段:从 batch 到 GPU 输入
ForwardBatch 里到底有什么
ScheduleBatch 是调度器的对象,它要跨进程、跨流变成 ForwardBatch,再被 ModelRunner 消费。ForwardBatch 是”一次前向的全部输入”,对 GLM-5.3 来说,关键字段包括:
forward_mode:EXTEND(prefill/chunked prefill)、DECODE、MIXED(prefill 与 decode 同批)或IDLE;batch_size:这一批多少条请求;input_ids:拼平后的 token id;prefill 是整段新增 token,decode 是每条请求一个 token;positions:每个 token 的绝对位置,供 RoPE 使用;前缀缓存命中时,位置从prefix_len开始,而不是从 0 开始;seq_lens/seq_lens_cpu:每条请求当前的总长度;out_cache_loc:本次要写入的 KV 物理槽位;req_pool_indices:每条请求在req_to_token表中的行号;attn_backend与每层的 attention metadata。
这些字段直接决定了内核的寻址方式。以 MLA 的 KV 为例:GLM-5.3 每 token 的 KV 潜向量是 512 维,加上 64 维 RoPE 的 k_pe,共 576 个元素;FP8 存储时约 576 字节。out_cache_loc 里的每个整数,就是这 576 字节在分页池中的页内偏移与页号的组合。
ModelRunner 的三条路径
ModelRunner._forward_raw(python/sglang/srt/model_executor/model_runner.py)先判断这次前向走哪条路径:
- decode CUDA Graph:
forward_mode.is_decode()且 batch 大小落在已捕获的桶里,直接 replay 预先捕获的图; - prefill CUDA Graph:piecewise 捕获的 extend 图,适用于形状可预测的 chunk;
- eager:其余情况(首次 prefill、形状超出桶、投机验证的特殊 batch),逐层执行 Python 代码。
三条路径最终都会调用同一个模型对象 GlmMoeDsaForCausalLM.forward。区别只在于:CUDA Graph 路径把 kernel 启动、Python 调度都”冻”进图里,eager 路径则每个算子都实打实地发一次 launch。对 GLM-5.3 这种 78 层、每层十几个算子的模型,decode 的 kernel launch 开销本来可以轻易吃掉一半时间,所以 SGLang 默认会对 decode 做图捕获,并把不同 batch size 分成若干桶(详见 cuda-graph-padding-five-frameworks)。
嵌入查表:第一个算子
进入 GlmMoeDsaForCausalLM.forward 后,第一件事是 embed_tokens(input_ids)。GLM-5.3 的词表 154,880,隐藏维 6144;VocabParallelEmbedding 把词表按 TP 切分,每个 rank 只持有自己那一段词向量。查表本身是纯 gather,不涉及浮点计算;但在 TP 模式下,每个 rank 只知道自己那一段的 embedding,需要一次 AllReduce 把各 rank 的贡献加起来,才能得到完整的 6144 维向量。开启 DP Attention 时,这个 AllReduce 被替换为”只在 attention TP 组内做”,或者干脆由 use_attn_tp_group 控制走更小的组。
这是全链路第一个集合通信,也是很多人忽略的一个:它发生在任何一层 Transformer 之前。对一个 batch 有 条请求的 prefill,这次 AllReduce 的消息量是 字节(BF16),按 TP8 的 ring 算法,每张卡收发约 的这份数据。
第四阶段:一层 Decoder 的内部世界
GLM-5.3 的 78 层结构完全一致,差别只在”这一层是稠密 MLP 还是 MoE”。前 3 层用稠密 MLP(DeepseekV2MLP),其余 75 层用 DeepseekV2MoE。每一层的执行逻辑在 DeepseekV2DecoderLayer.forward(python/sglang/srt/models/deepseek_v2.py):
hidden_states = self.attn_boundary.prepare(hidden_states, forward_batch, ...)with self.self_attn.maybe_use_decode_attn_tp(forward_batch): hidden_states = self.self_attn(positions, hidden_states, forward_batch, ...)hidden_states = self.attn_boundary.finish(hidden_states, forward_batch)hidden_states = self.ffn_boundary.prepare(hidden_states, forward_batch)with self.ffn_boundary.exit(forward_batch) as ffn_exit, _mlp_ctx: hidden_states = self.mlp(hidden_states, forward_batch, ...)hidden_states = ffn_exit.finish(hidden_states)attn_boundary 与 ffn_boundary 是 SGLang 的”层边界”抽象(layers/layer_boundary/),并不做真正的注意力或 MLP 计算,而是负责:
- 在注意力前:把上一个阶段的输出做残差相加、分片收集、RMSNorm,必要时量化成 FP8,再交给注意力;
- 在注意力后:把注意力输出做跨 TP 的 ReduceScatter/AllReduce;
- 在 FFN 前:把残差相加、再做一次 RMSNorm;
- 在 FFN 后:完成 MoE 输出归约,准备下一层。
真正值得逐项展开的,是这个”边界”里面到底调用了哪些算子和哪些通信。下面按一次前向的时间顺序拆。
4.1 残差流与输入 RMSNorm
每一层开始时,hidden_states 与 residual 要做加和,然后对和结果做 RMSNorm。SGLang 里这一步被融合成一个 fused_add_rmsnorm(或 fused RMSNorm + quant),输出归一化后的 hidden states 与新的 residual。
如果上一层的 MLP 是 MoE,而 MoE 的输出在 TP 下是”各 rank 部分和”,那么在这一步之前必须先做 AllReduce。SGLang 会尝试把 AllReduce 和 RMSNorm 融进一个 kernel:flashinfer_allreduce_residual_rmsnorm(layers/layernorm.py)。它的做法是:通信的 ring 里每收到一个 chunk,就在该 chunk 上做残差加法与 RMSNorm,边收边算。对一个 TP8 的层,这一下把”AllReduce + 两次读写显存 + RMSNorm”压缩成”一次 ring 传输 + 就地归一化”,节省的是带宽而不是 FLOPs。
这一步的通信量与 hidden 大小成正比: 字节, 是 batch 里的 token 数。对 prefill 一个 32768 token 的 chunk,就是约 400MB 的双向流量分摊在 8 张卡上;对 decode 一个 batch 32 的请求,就只有 384KB,但每层一次、每步一次——78 层 × 32 个 step,通信量会被层数放大。
4.2 A 投影:Q/KV 的低秩入口
MLA 的”低秩”体现在这里。注意力的第一步不是直接算 Q/K/V,而是两个压缩投影:
fused_qkv_a_proj_with_mqa:6144 → (2048 + 512 + 64),输出 Q 的潜向量q_c(2048 维)、KV 的潜向量kv_c(512 维)、以及带 RoPE 的k_pe(64 维);- 索引器的
wk_weights_proj:6144 → (128 + 32),输出索引器的 K 潜向量(128 维)与门控权重(32 维)。
前者是 ReplicatedLinear——权重不做切分,每个 rank 存一份完整的 矩阵;后者在 Indexer 里同样是 ReplicatedLinear(wq_b 也是)。这样设计的原因很直接:Q/KV 潜向量是后续所有通信的”输入”,如果这一层做了切分,下一层的 Q 上投影和注意力就得多一次 AllGather。让所有 rank 都持有完整 A 投影,就省掉了这一步通信,代价是这部分权重每层每卡多存约 25MB(FP8),8 张卡合计约 200MB/层,78 层约 15.6GB。
A 投影的输出形状:prefill 一个 chunk 有 个 token,就是 的矩阵。索引器的 wk_weights_proj 再输出 。这两个 GEMM 在 FP8 下由 w8a8_block_fp8_matmul 一类 kernel 完成,block size 128×128。
4.3 两个 RMSNorm 与 RoPE
A 投影之后,Q 潜向量和 KV 潜向量各过一个 RMSNorm:q_a_layernorm(2048) 与 kv_a_layernorm(512)。这一步纯 element-wise,每个 token 各 2048 + 512 个元素的平方和与缩放。
随后 RoPE 对上投影后的 q_pe 与 k_pe 做旋转。MLA 的 RoPE 只作用在 64 维的位置子空间上,而 512 维的 kv_c 不参与 RoPE——这是 MLA 能省 KV 的根本原因:KV 缓存只存 kv_c(512 维)与 k_pe(64 维),合计 576 维,且 K 与 V 共享同一份 kv_c。
SGLang 的实现里,RMSNorm 与 RoPE 经常被融合成一个 kernel:fused_norm_rope 一次完成 q_a_norm、kv_a_norm、q_pe 与 k_pe 的旋转,并且顺便把结果写进 KV 池(如果这一层是索引器层,还要把索引器的 k 写进索引器缓存)。在 GLM-5.3 的 GlmMoeDsaForCausalLM 实际执行时,这一步对应的 fused_norm_rope 还有一个额外参数:has_indexer。它决定这个 kernel 是否同时更新索引器缓存。
forward_absorb_prepare 里的真实顺序是(省略了 stream 分支):
q, latent_cache = ( get_attn_tp_context().fetch_qkv_latent() .split([self.q_lora_rank, self.kv_lora_rank + self.qk_rope_head_dim], dim=-1))k_nope = latent_cache[..., : self.kv_lora_rank]q = self.q_a_layernorm(q)k_nope = self.kv_a_layernorm(k_nope)if self.use_dsa: q_lora = q...topk_indices = self.indexer( x=hidden_states, q_lora=q_lora, positions=positions, forward_batch=forward_batch, layer_id=self.layer_id,)q = self.q_b_proj_forward(q)q_nope, q_pe, k_pe = self._split_q_nope_pe(q, latent_cache)fetch_qkv_latent() 就是 A 投影的结果;q_a_layernorm 与 kv_a_layernorm 输出后,q_lora 同时喂给索引器和 q_b_proj——同一份 2048 维向量被两条支路复用。
4.4 Q 上投影与索引器
接下来两个 GEMM:
q_b_proj:2048 → 64 × 256 = 16384,是ColumnParallelLinear,按输出维在 attention TP 组内切分。每个 rank 得到 64/TP 个头的 Q;- 索引器的
wq_b:2048 → 32 × 128 = 4096,是ReplicatedLinear。
在 GLM-5.3 里,q_b_proj 与索引器可以在不同 CUDA stream 上并行。forward_mla.py 里的实现是:在 decode 且有 alt_stream 时,主 stream 先做 q_a_layernorm,然后 fork 到 alt_stream 上算索引器 Top-K,同时主 stream 做 q_b_proj,两者在一个 wait_stream 处汇合。对 78 层来说,这意味着每层有一个约 173 微秒的窗口被两件事填满。
4.5 闪电索引器:DSA 的选择性
这是 GLM-5.3 区别于 DeepSeek-V2/V3 的重点。DSA 在每个”全层”(full layer)里运行一个轻量索引器,为每个 query 选出最重要的 2048 个历史 token。SGLang 的 Indexer 类(layers/attention/dsa/dsa_indexer.py)逻辑如下:
- 算索引 K:
wk_weights_proj得到 128 维的索引 K,过k_norm,加 RoPE(索引器有自己的 RoPE,indexer_rope_interleave为 True),量化成 FP8 后写入独立的索引器 KV 缓存; - 算打分:对每个 query 的 32 个索引头,与所有历史 token 的索引 K 做 QK 点积。这一步的维度是 32 × 128,远小于主注意力的 64 × 256;
- 头门控:每个索引头有一个由
wk_weights_proj后半部分(32 维)算出的门控权重,最终分数是这个头分数的门控组合; - Top-K:对每个 query 在所有历史 token 分数中取 Top-2048,结果写入
topk_indices_buffer(一个预分配的[batch_tokens, 2048]缓冲)。
关键在”每个 query 选 2048”这个数字。DeepSeek-V3.2 的 DSA 论文给出了一个解释:在长上下文中,约 90% 的注意力条目是冗余的,选出 2048 个关键 token 可以保留绝大多数注意力质量,同时把主注意力的计算从 降到 。
GLM-5.3 的索引器不是每层都有。它的配置里 indexer_types 是 78 项,只有 index_topk_freq = 4 的规律:第 3 层之后,每 4 层里有一层是 full(运行索引器),其余三层是 shared(复用上一层选出的 Top-K)。从配置里数出来,完整的索引器层是第 0、1、2、6、10……74 层,共 21 层;shared 层有 57 层。
dsa_layer_skips_topk(configs/model_config.py)正是这个逻辑的实现:
indexer_types = getattr(config, "indexer_types", None)if indexer_types is not None: return 0 <= layer_id < len(indexer_types) and indexer_types[layer_id] == "shared"forward_mla.py 里的 should_run_indexer() 根据 skip_topk 决定这一层是调用 self.indexer 还是直接复用 topk_indices_buffer。复用时不产生任何新的索引计算,也不产生新的索引器 KV 写入,省掉约四分之三的索引器 FLOPs。这个方法最初来自 Z.ai 的 IndexCache 工作(arXiv:2603.12201):相邻层的 Top-K 选择重叠度在 70%–100% 之间,因此绝大多数层可以共享同一组选出的 token。
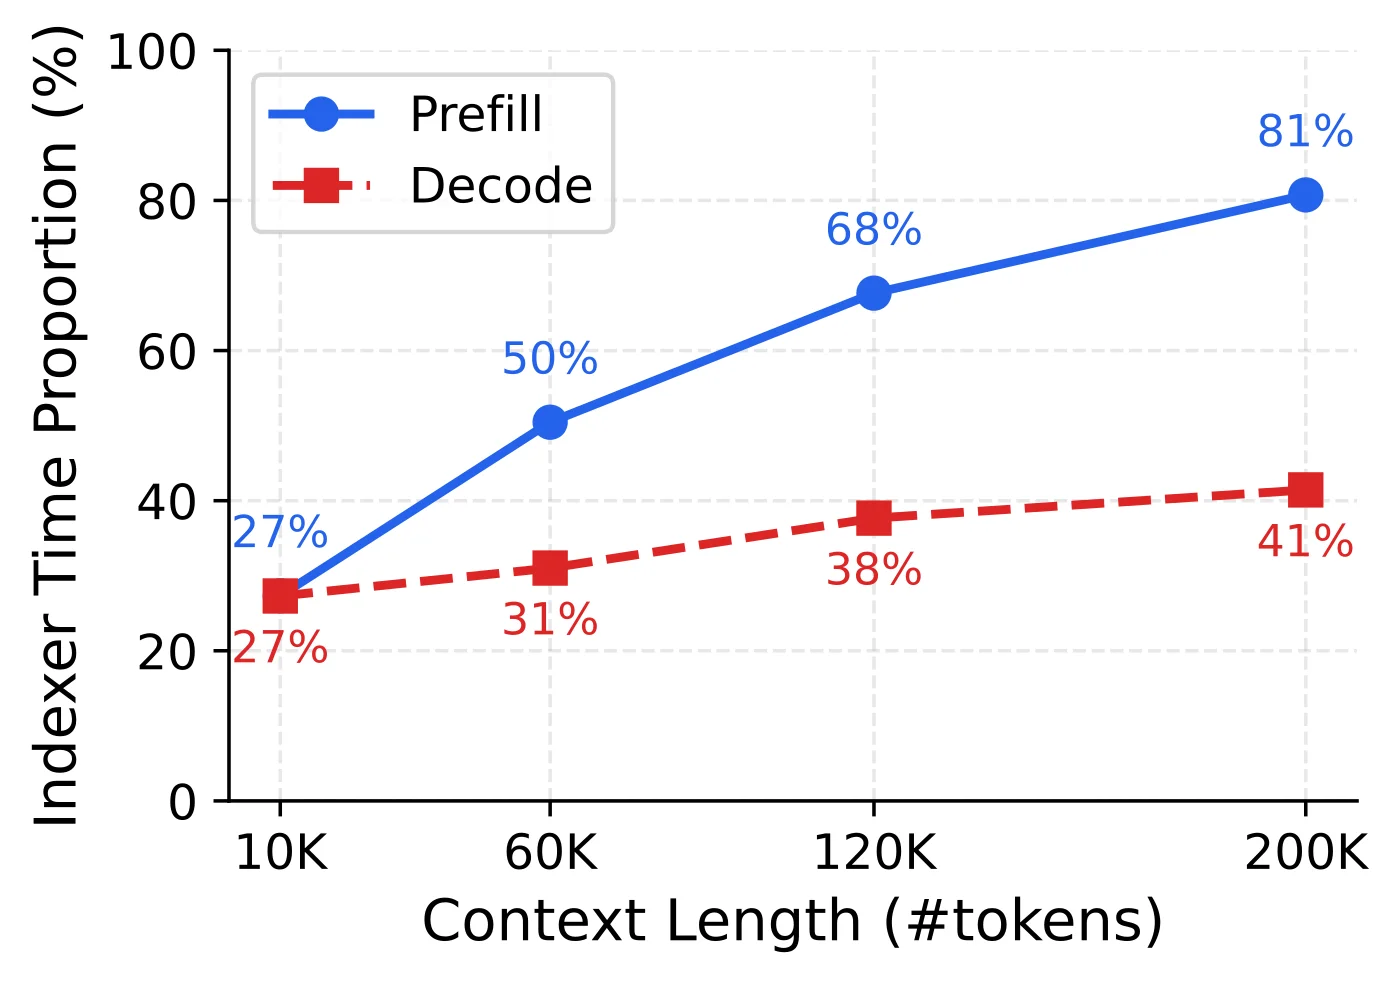
图源:IndexCache(arXiv:2603.12201)中的 profile 图。它说明了为什么”跨层复用索引结果”能直接减少长上下文推理的计算量。
4.6 主注意力:稀疏 MLA
选出 Top-K 之后,主注意力只对这 2048 个 KV 做计算。SGLang 的 MLA 注意力在 DSA 模型上的路径是:
- 吸收式点积:先算
q_l_nope = q_nope @ W_UK^T,把 192 维的 q_nope 投影到 512 维潜空间。这样注意力点积就是 512 维的潜向量对潜向量,而不是 192 维对 512 维再上投影。这是 MLA 的”吸收”技巧(absorp); - 索引 sparse attention:用
topk_indices_buffer取出被选中的 KV 页,只对这些页做点积与 softmax; - 输出上投影:注意力输出 维的潜向量,再与
W_UV做 bmm,得到 的 V 空间输出。
SGLang 的注意力后端由 --dsa-prefill-backend 与 --dsa-decode-backend 选择:H200 上 prefill 通常用 flashmla_sparse_q8,decode 用 flashmla_kv;Blackwell 上则自动切到 trtllm 后端;AMD 上用 tilelang 后端。它们的共同点是:直接读分页 KV 池,根据 topk_indices_buffer 做 gather,在 block 粒度上跳过不需要的页。
4.7 注意力的输出归约
MLA 的 o_proj 是 RowParallelLinear,它切分的是输入维(),权重按行切。因此每个 rank 只算出输出 hidden_size 维的一部分和,需要一次 AllReduce 才能还原完整的 6144 维 hidden states。
SGLang 在这里做了一个优化:把 o_proj 设成 reduce_results=False,然后在下一层的 attn_boundary.finish 里用 attn_tp_reduce_scatter 完成归约。attn_tp_reduce_scatter 做的事是:
local_hidden_states = hidden_states.tensor_split(parallel.attn_tp_size)[parallel.attn_tp_rank]attn_tp_reduce_scatter_tensor(local_hidden_states, hidden_states)return local_hidden_states这等价于把 AllReduce 拆成 ReduceScatter + AllGather,但把后半段 AllGather 推迟到真正需要完整 hidden 的地方。在 DP Attention 下,这一步只涉及 attention TP 组(若 attn_tp_size < tp_size);在传统的纯 TP 下,就是 TP 组内的一次 ReduceScatter。
4.8 FFN 与 MoE:每 token 的 9 个专家
经过 post_attention_layernorm(同样融合了 AllReduce)之后,hidden 进入 FFN。前 3 层是稠密 MLP,一次 gate_up_proj(6144 → 2 × 12288)加 SiLU 与 down_proj(12288 → 6144)。其余 75 层是 MoE,路径完全不同。
DeepseekV2MoE.forward(deepseek_v2.py)先算门控:
self.gate(hidden_states):一个6144 → 256的 GEMM,输出每个 token 对 256 个专家的 logits;self.topk(...):GLM-5.3 用noaux_tc打分法,sigmoid 分数加 e_score_correction_bias,再按组选 top-8(n_group=1时退化为全局 top-8)。这一步几乎全是小算子:sigmoid、加偏置、分组 top-k、归一化;- 共享专家:一个 2048 中间维的 MLP,所有 token 都经过;路由专家的输出先乘
routed_scaling_factor = 2.5,再加上共享专家的输出。
forward_normal 里的调用链就是这三步:
router_logits = self.gate(hidden_states, gemm_output_zero_allocator)topk_output = self.topk(hidden_states, router_logits)final_hidden_states = self.experts(hidden_states, topk_output)...if self.reduce_results: final_hidden_states = post_experts_all_reduce(final_hidden_states)接着是两条截然不同的执行路径:
- 纯 TP(
--ep-size 1):每个 rank 持有全部 256 个专家,每个专家按中间维切分。8 个被选中的专家由FusedMoE的分组 GEMM 一起算,每个 token 的计算在 8 个 rank 上各做一份”部分和”,最后由post_experts_all_reduce做一次 AllReduce; - EP(
--ep-size 8,--moe-a2a-backend deepep):forward_deepep把 hidden 按路由结果发送到对应专家所在的 rank,专家计算完再发回来。通信操作是 DeepEP 的dispatch与combine,两者在 decode 时走低延迟模式(NVSHMEM),在 prefill 时走普通模式(走 RDMA 或 NVLink)。
这就是整个请求路径上通信最重的一段。对一个 78 层、75 层 MoE 的模型,每层都有一到两次跨卡通信:要么是 AllReduce,要么是 dispatch + combine 各一次。一次 decode step 的通信次数,按层数算至少 150 次。
4.9 层内通信的完整账本
把一层从头到尾的通信全部列出来( 是 batch token 数,,FP8 / BF16 按 dtype 算):
| 位置 | 操作 | 触发条件 | 数据量 |
|---|---|---|---|
| 层首 | 输入 RMSNorm 前的 AllReduce | 上一层 MLP 输出未归约 | 字节 |
| A 投影 | 无通信(ReplicatedLinear) | — | 0 |
| Q 上投影 | 无通信(ColumnParallelLinear,输出头切) | — | 0 |
| 索引器 | 无通信(ReplicatedLinear) | — | 0 |
| 注意力 | 稀疏 MLA 读分页 KV(本地/远端视 EP 而定) | — | 0 |
| o_proj 后 | attn_tp_reduce_scatter | attention TP > 1 | 字节 |
| FFN 前 | post-attention RMSNorm 的 AllReduce(若 o_proj 已 ReduceScatter 则跳过) | 视 reduce 选项 | 0 或 |
| MoE 门控 | 无通信 | — | 0 |
| MoE 专家(TP) | AllReduce(post_experts_all_reduce) | ep_size=1,TP > 1 | 字节 |
| MoE 专家(EP) | DeepEP dispatch | ep_size > 1 | 约 字节(FP8) |
| MoE 专家(EP) | DeepEP combine | ep_size > 1 | 约 字节(BF16) |
在纯 TP 的单机部署下,一层有两次 AllReduce(层首与 MoE 后),合计 字节;在 EP + DP Attention 下,变成注意力组的 ReduceScatter、MoE 的 dispatch/combine,以及每层 DP gather/scatter。78 层意味着一次前向中至少有约 150 个集合通信点。
第五阶段:prefill 与 decode 是两套不同的算子组合
同一段模型代码,在 prefill 与 decode 下走的不是同一条路。GLM-5.3 的 MLA 有两套形态,SGLang 会根据 forward_mode 选择。
prefill:MHA 形态
prefill 的 batch 是”很多 token 一起算”,矩阵乘的 维很大,计算密度高。此时 MLA 走 MHA 形态:A 投影得到 q_c 与 kv_c 后,q_b_proj 把 q_c 上投影成每头 256 维的 Q,kv_b_proj 把 kv_c 上投影成每头 192 维的 K_nope 与 256 维的 V。随后按普通多头注意力计算:64 个 Q 头对 64 个 K/V 头,每个头 256 维(K 拼接 64 维 RoPE 后),输出 256 维。
注意 kv_b_proj 在 prefill 里是真实执行的:它把 512 维的潜向量展开成 64 × (192 + 256) 的 K/V。这一步的 FLOPs 是 ,对 的 chunk 约 0.96 TFLOPs。它只在 prefill 发生,decode 不发生。
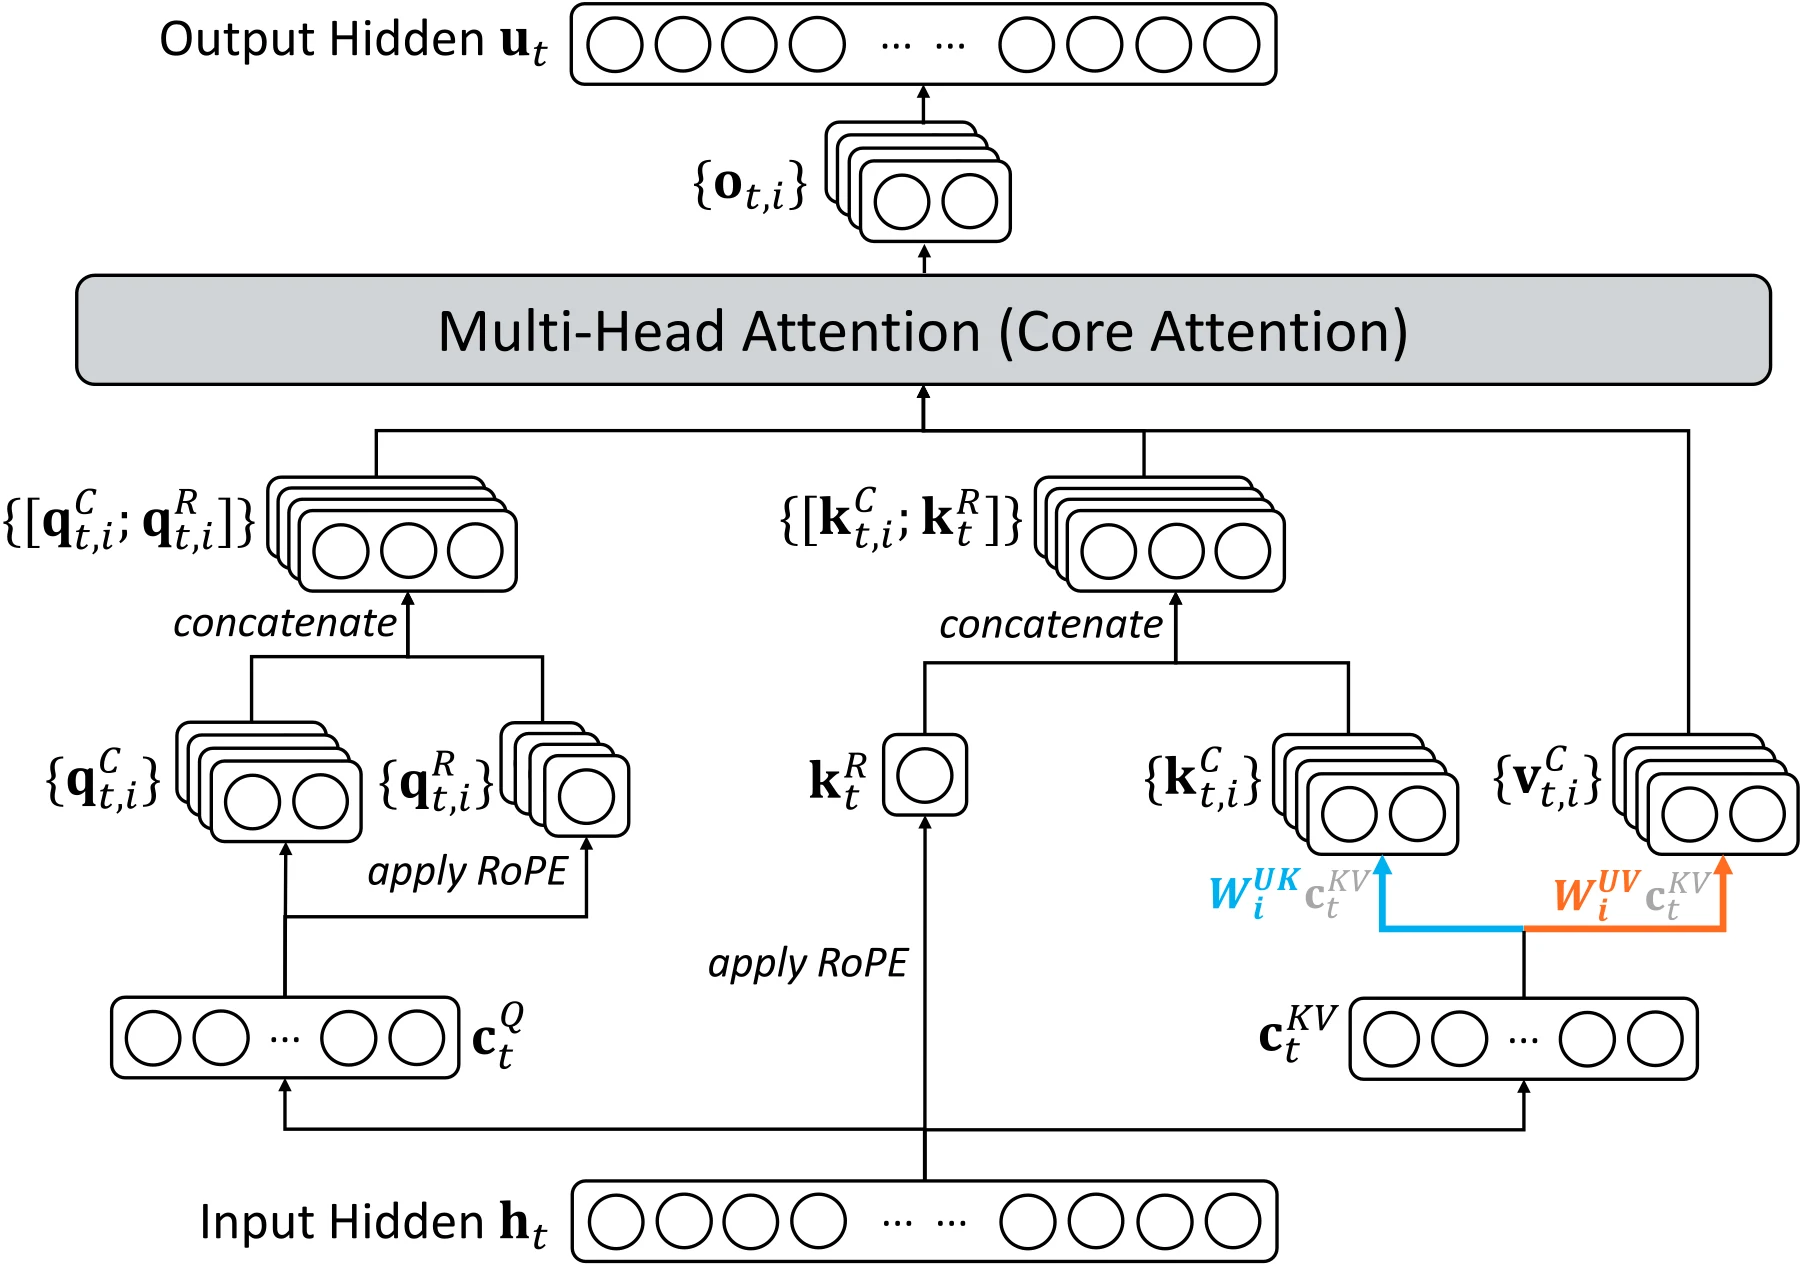
图源:DeepSeek-V3.2 技术报告(arXiv:2512.02556)附录中的 MLA 两种模式示意图。
decode:MQA 形态与吸收
decode 的 batch 是”每条请求一个 token”, 维极小,计算密度低,瓶颈从算力变成显存带宽。此时如果还按 MHA 形态做,kv_b_proj 要把每个历史 token 的 512 维潜向量展开成 28672 维的 K/V——这等于把 KV 缓存放大 56 倍,完全不可行。
MLA 的解法是”吸收”:把 kv_b_proj 的 K 部分()吸收进 Q 的投影里。具体做法是:
- 对当前 token 的 Q,先算
q_nope @ W_UK^T,把 192 维的 q_nope 投影到 512 维潜空间; - 于是注意力点积变成”512 维的 Q 潜向量”对”512 维的 KV 潜向量”,不再需要把历史 KV 展开;
- V 的上投影 放在注意力之后,对输出做一次 bmm: 的注意力输出乘 的 。
这样,KV 缓存只需要存 512 维的 kv_c 加 64 维的 k_pe,每 token 每层 576 个元素。Q 侧有 64 个头,但所有头共享同一份 576 维的 KV——这就是 MQA 形态:64 个 query 头对 1 个 KV 头。注意这不是真正的 MQA 模型,而是 MLA 在 decode 时”看起来像 MQA”。
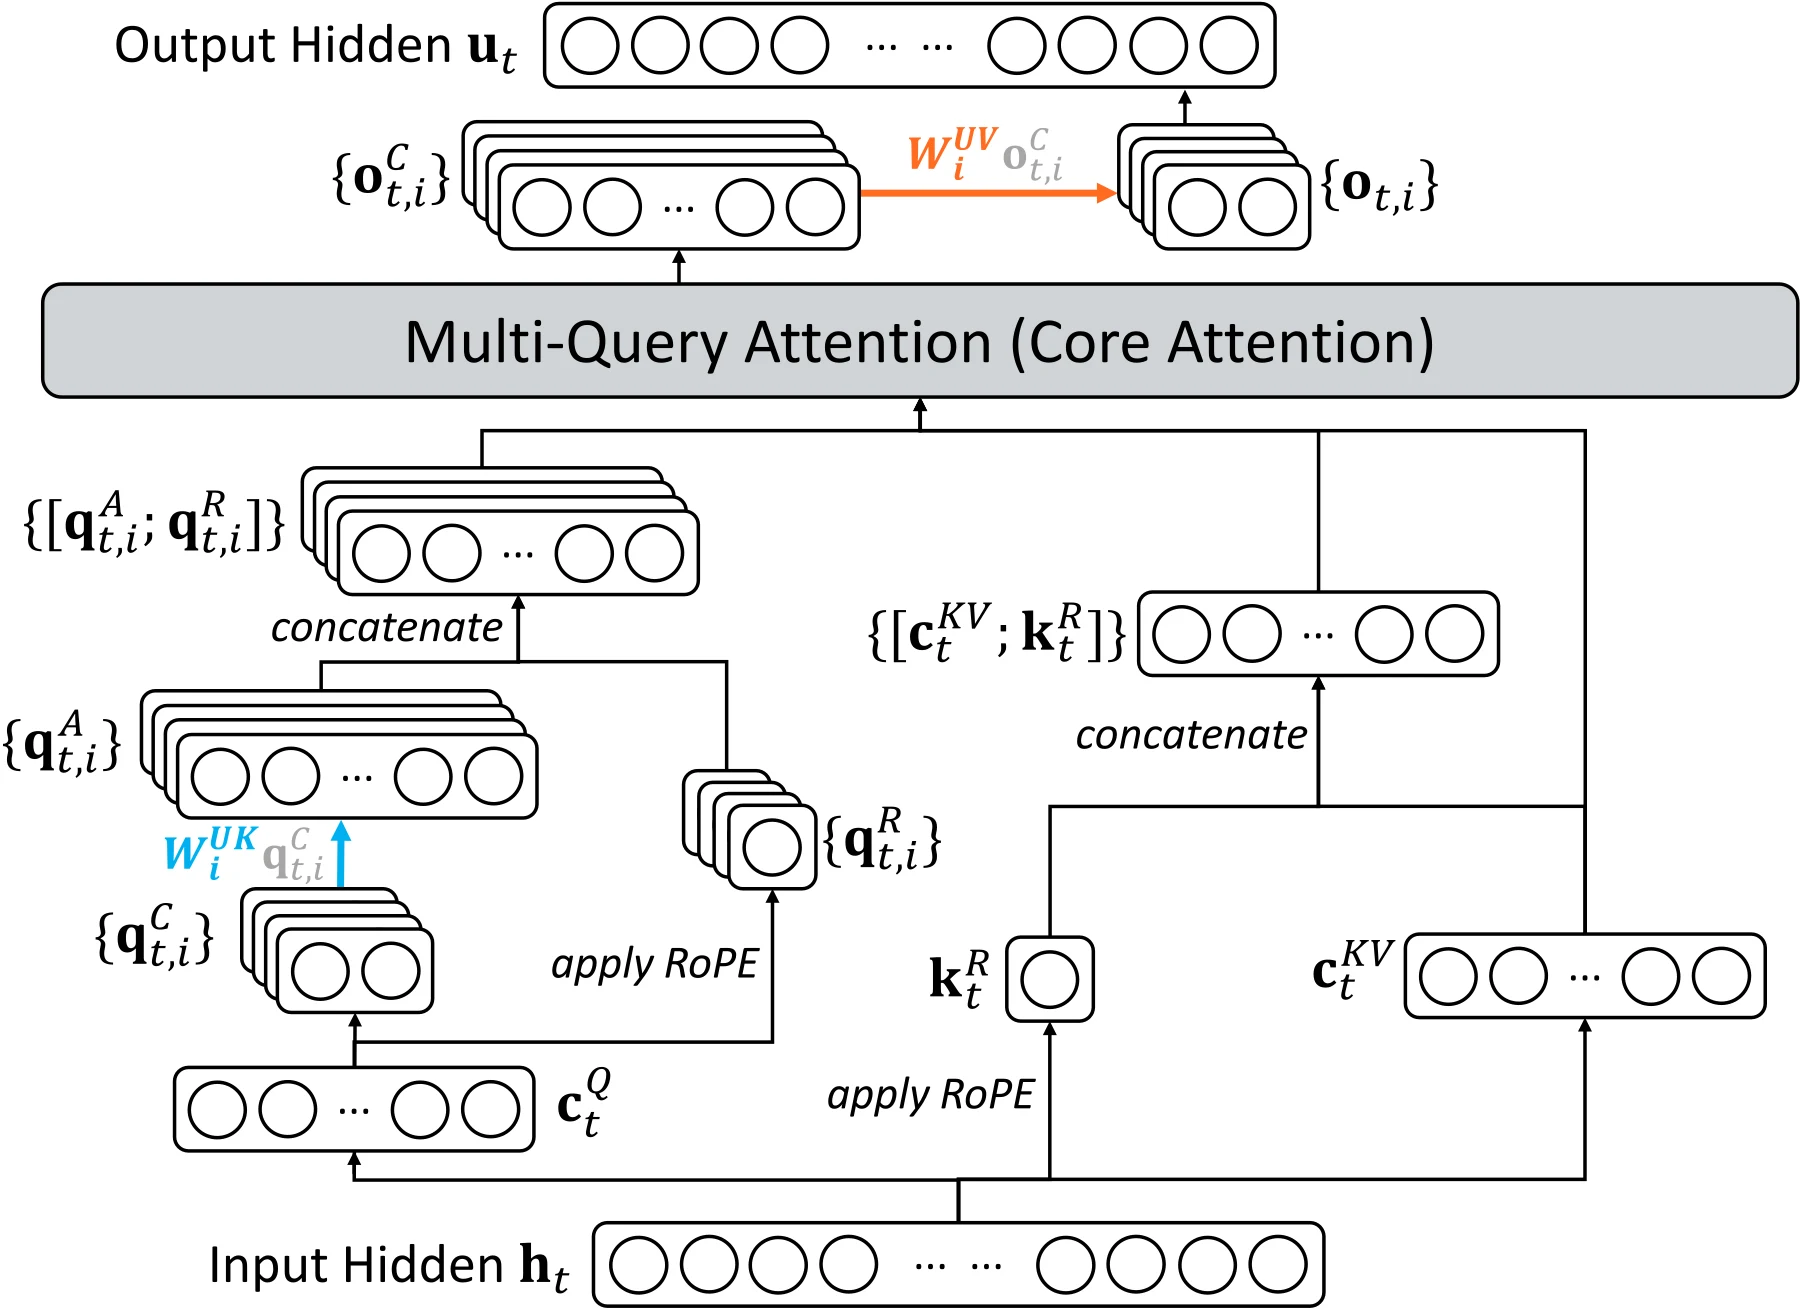
图源:DeepSeek-V3.2 技术报告(arXiv:2512.02556)附录中的 MLA 两种模式示意图。
这套形态带来两个直接后果:
- KV 缓存变小:每 token 每层 576 个元素。GLM-5.3 的 78 层加起来是 个元素,FP8 下约 44.9KB/token。1M 上下文的一条请求,KV 约 47GB(按 1,048,576 token 计)——这还没有算索引器缓存。也就是说,GLM-5.3 的 1M 上下文首先是一个显存问题,而不是算力问题;
- 注意力计算变轻:decode 时每个 query 头对 2048 个选中 token 做 512 维点积,FLOPs 是 M 一层,远小于 prefill 的 。
索引器缓存是另一笔账。每个”全索引器层”要为每个 token 存 128 维的索引 K(FP8 下 128 字节),21 层就是约 2.8KB/token(每 token 128 字节 key 加 4 字节 scale)。1M 上下文下,索引器缓存约 2.8GB/请求,是主 KV 的 6%。它不算大,但索引器的读取量很大:每个 query 要读所有历史 token 的索引 K 来打分。1M 上下文、21 层、每个 token 读取 21 × 1,048,576 × 128 字节 ≈ 2.8GB。这个读取量是 decode 在长上下文下的主要带宽开销之一,也是”跨层复用 Top-K”能把索引器计算砍掉四分之三后,仍然值得继续优化的原因。
decode 的算术强度:为什么 batch 这么重要
把 decode 一层的主要 GEMM 列出来( 为 batch token 数):
| 算子 | 形状 | FLOPs |
|---|---|---|
| A 投影 | M | |
| Q 上投影 | M | |
| Q 吸收 bmm | M | |
| 稀疏注意力 | M | |
| 输出 bmm | M | |
| O 投影 | M | |
| MoE(8 专家) | M |
一层约 M FLOPs,78 层约 G。当 时,一个 token 约 83.3 GFLOPs;当 时约 2.67 TFLOPs。H200 的 FP8 稠密算力约 4 PFLOPS,算力远不是瓶颈;真正的瓶颈是读权重。
按 EP8 切分,专家权重每卡约 91GB(724B 路由专家 / 8);注意力、共享专家、稠密层与词嵌入是复制的,再加约 18GB,所以每卡实际权重约 109GB。一个 decode step,如果 batch 足够大、每个本地专家都被路由到,这张卡必须把 91GB 专家权重从 HBM 读一遍(复制部分同样要读)。H200 的 HBM 带宽约 4.8TB/s,仅专家权重的理论下限就是 ms,加上复制权重约 23ms,即单卡最多约 44 个 step/s。这个数字与 batch 大小无关(权重读一次,batch 内所有 token 分摊),但与 batch 内实际触发的专家数有关:batch 很小时只有少数专家被选中,读取量按触发专家数下降。
这也解释了为什么 MoE 推理要追求大 batch、要 EP、要 EPLB:不是算力不够,而是权重太大,必须让一次权重读取服务尽可能多的 token。
第六阶段:DP Attention 与一次 decode 的真实拓扑
注意力按请求分片,MoE 按专家分片
当 --attn-dp-size 8 且 --tp 8 时,attn_tp_size = 1,这是一个值得单独讲清楚的配置:注意力不做张量并行,MoE 做专家并行。
- 每张卡持有完整的注意力权重(A 投影、Q 上投影、O 投影、索引器),只处理”分给自己的请求”的 KV 页;
- 每张卡只持有 32 个路由专家(),但所有卡都持有共享专家与稠密层;
- 一个 decode step 的顺序是:各卡先对自己那批请求做注意力(没有通信)→
dp_gather把 8 张卡的 hidden 拼成”全局 batch”(AllGather)→ MoE 在这个全局 batch 上按专家路由,走 DeepEP 的 dispatch/combine(通信在此发生)→dp_reduce_scatter把全局输出按归约结果散回各卡自己的请求(ReduceScatter)→ 进入下一层。
这条路径在 layers/dp_attention.py 里写得很清楚。_dp_gather_via_all_gather 在 attn_tp_size == 1 时直接对 tp_group 做 all_gather_into_tensor;dp_reduce_scatter_tensor 则对输出做 reduce_scatter_tensor(SUM + 分片)。
if get_parallel().attn_tp_size == 1: get_parallel().tp_group.all_gather_into_tensor(global_tokens, local_tokens) return注意这里的 all_gather_into_tensor 要求各 rank 的 local_tokens 长度相同;decode 阶段每条请求一个 token,天然等长;prefill 或变长 decode 则要先把各 rank pad 到最大长度,或者走 all_gatherv 变长路径(SGLANG_DP_USE_GATHERV)。对 8 卡、每卡 条请求的 decode,一次 gather 的消息量是 字节,scatter 同理;每层各一次,78 层就是 156 次。
这解释了为什么”DP Attention + EP”能在单机 8 卡上跑起来:注意力的权重只有十几 B,复制 8 份不心疼;MoE 的权重有 724B,必须切开。把”重”的 MoE 切分、把”轻”的注意力复制,正好与两者的通信需求匹配——注意力需要每张卡持有自己的 KV,MoE 需要每张卡只读自己的专家。
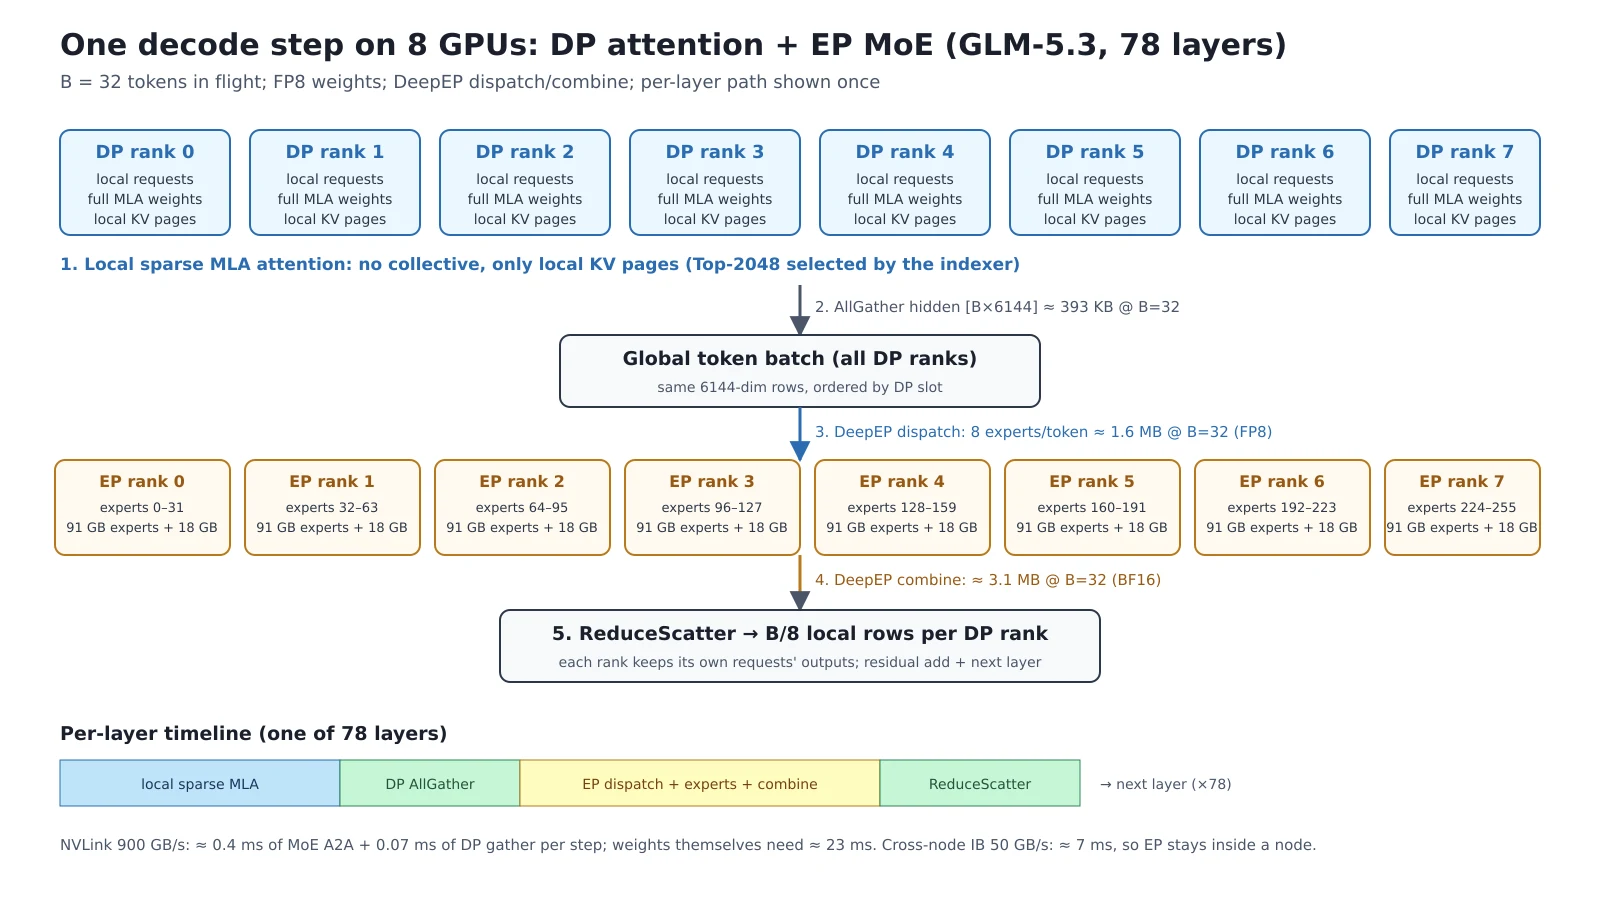
注:本图为按 SGLang
dp_attention.py与forward_deepep源码路径绘制的示意图;带宽与消息量为 时的估算,H200 NVLink 900GB/s、节点间 IB 50GB/s 的典型规格。
MTP:一次 decode step 到底算了几次前向
GLM-5.3 的 checkpoint 带 1 层 MTP(num_nextn_predict_layers = 1)。它的结构在 glm4_moe_nextn.py 里:
self.enorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)self.hnorm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)self.eh_proj = nn.Linear(2 * config.hidden_size, config.hidden_size, bias=False)...self.decoder = Glm4MoeDecoderLayer(config, 0, ..., is_nextn=True)self.shared_head.norm = RMSNorm(config.hidden_size, eps=config.rms_norm_eps)前向时,它把”当前 token 的 embedding”与”目标模型最后一层的 hidden states”分别过 enorm 与 hnorm,拼成 12288 维,过 eh_proj 压回 6144 维,再走一个完整的 GLM Decoder Layer(含注意力与 MoE),最后过 shared_head.norm 与 LM Head。
EAGLE 投机解码把一次 decode 拆成三段(speculative/eagle_worker_v2.py):
- draft:用 MTP 层自回归地草拟 5 个 token(
--speculative-num-steps 5),每一步都是一个小前向,topk=1表示每步只保留一条草稿链; - verify:把 5 个草稿 token 加上原 token 拼成 6 个 token,交给目标模型做一次前向(
--speculative-num-draft-tokens 6)。目标模型对 6 个位置各算一次 logits,从前往后比对:草稿 token 与目标采样结果一致就接受,遇到第一个不一致就停止,后面的草稿全部丢弃; - draft_extend:把已接受的 token 及其 hidden states 写回草稿模型的 KV,供下一轮 draft 使用;被拒绝的 token 对应的 KV 要回滚。
eagle_worker_v2.py 的 forward_batch_generation 把这三段串起来:
verify_input: EagleVerifyInput = self.draft_worker.draft(batch)assert verify_input.is_verify_input()batch.spec_info = verify_inputbatch_output = self.verify(batch, pp_proxy_tensors=pp_proxy_tensors, ...)...self.draft_worker._draft_extend_for_decode( batch, batch_output, kv_loc_plan=verify_input.kv_loc_plan)draft() 返回的 verify_input 不只是 token id,还包含 kv_loc_plan:它记录每个草稿 token 被写到了哪些 KV 槽位,验证后被拒绝的 token 就按这个计划回收。
对 GLM-5.3 来说,这意味着:
- 目标模型的 batch 变成 个 token,而不是 。78 层的所有算子都按 6 倍 token 数执行;MoE 的 dispatch/combine 也按 6 倍 token 数发送;注意力是 6 个 query 对同一段历史 KV 做稀疏选择;
- 草稿模型是 1 层 MTP,它的前向只有一层,但要做 5 次(每次 1 个 token),并且每次都要走 MoE——所以 MTP 层虽然只有 1 层,MoE 的权重读取却发生了 5 次;
- 索引器复用:配置里的
index_share_for_mtp_iteration = true让草稿的 5 个 step 复用同一组 Top-K,而不是每步重算。这个优化只在topk=1时有效,因为多链草稿需要每组草稿各自的历史选择。
GLM-5 的技术报告在 4 步草稿设定下给出的接受长度是 2.76(DeepSeek-V3.2 是 2.55);换成 5 步、6 个验证 token 的配置,接受长度会变,应以服务端实测为准。接受长度越低,被拒绝的验证 token 越多,6 倍验证计算里”白算”的比例越高。所以 MTP 不是无条件的加速:接受长度低于约 2 时,6 倍验证计算的开销会吃掉收益。SGLang 的 cookbook 建议观察服务端上报的 accept length,再调 --speculative-num-steps 与 --speculative-num-draft-tokens。
MTP 还改变了 KV 的记账。被拒绝的草稿 token 已经写入了目标模型的 KV 页(否则无法做 verify),拒绝后必须把 seq_len 回退到接受位置,并释放多分配的页。SGLang 在 speculative/spec_utils.py 里用 kv_loc_plan 记录”哪些 slot 属于哪条草稿”,在 draft_extend 时只保留接受部分。对一个 78 层、每层 576 维 KV 的模型,这一步的页回滚是纯元数据操作,不涉及数据搬运。
第七阶段:最后一个 token 怎样离开 GPU
LM Head 与词表并行
78 层走完、model.norm 做最后一次 RMSNorm 之后,hidden states 进入 lm_head。GLM-5.3 的 LM Head 是 ParallelLMHead,VocabParallelEmbedding 的变体:每个 attention TP rank 持有自己那一段词表对应的输出行。
如果词表完全复制,每张卡都有 154,880 × 6144 的矩阵,FP8 下约 0.95GB——8 张卡多存 6.6GB,代价很大。所以 GLM-5.3 与 DeepSeek-V3.2 一样按词表切分:每张卡算 个 logits。但对采样来说,需要完整词表的 logits 才能做 softmax。在纯 TP 模式下,SGLang 的 LogitsProcessor 在最后做一次 AllGather,把各 rank 的部分 logits 拼成完整的 [batch, vocab];在 DP Attention 且 attn_tp_size = 1 时,LM Head 不再按词表切分,每个 rank 直接持有完整词表,这次 gather 退化为 no-op,代价变成每张卡各自算一遍 154,880 维的输出。
这个 AllGather 的量很惊人:batch 按 6b 算(投机验证)、词表 154,880、BF16 logits, 字节。当 时,单次 gather 约 59MB;TP8 下每张卡要收发约 7/8 的这份数据。SGLang 的代码注释里专门写着,在 DP Attention 内存紧张时,这个 [batch × num_dp_ranks, vocab] 的 gather 足以 OOM,因此提供了跳过 LM Head 的选项,或只在需要 logits 的 rank 上收集。
采样
Sampler.forward(python/sglang/srt/layers/sampler.py)拿到 logits 后按顺序做:
- 惩罚项:重复惩罚、频率惩罚、存在惩罚,作用在 logits 上;
- 温度缩放:
logits.div_(sampling_info.temperatures); - softmax:
sampler_softmax或torch.softmax,一次性算出整个词表的概率分布; - top-k / top-p / min-p:用
sampling_info.top_ks、top_ps生成掩码; - 采样:按概率抽一个 token id;
- logprobs:如果请求了
return_logprob,额外算log(probs)或log_softmax(logits)。
开启投机解码时,这里不取”下一个 token”,而是给出整个验证 batch 的采样结果,再与草稿比对,确定接受长度。接受长度会写回 LogitsProcessorOutput,同时更新 Req 的 output_ids。
采样完,结果回到 Scheduler:process_batch_result 把新 token 写入每条请求的状态,构造 BatchStrOut 发回 TokenizerManager;TokenizerManager 再用 tokenizer 解码成文本,经 SSE 流式回传给 HTTP 客户端。如果请求带了 --reasoning-parser auto,文本在这一步被切成 reasoning_content 与 content 两段,分别下发给客户端。
一轮 decode 的时间分布
把上面的环节加起来,一个 decode step 在 H200、TP8、EP8、DP Attention 8 的配置下大致这样分布(数量级估计,具体随 batch 与上下文变化):
| 环节 | 主要内容 | 大致占比 |
|---|---|---|
| 调度 | 选 batch、分配 KV、写 req_to_token | 与调度重叠时接近 0 |
| 嵌入与 LM Head | 两次词表通信 | 与 batch 相关,通常 <3% |
| 78 层注意力 | A/Q/O 投影、索引器读数、稀疏 MLA | 长上下文时 20%–40% |
| 78 层 MoE | 权重读取、专家 GEMM、dispatch/combine | 50%–70% |
| 采样 | softmax 与采样 | <1% |
这个分布解释了为什么针对 GLM-5.3 的优化重点集中在三处:MoE 权重读取(EP、FP8、EPLB)、索引器(跨层复用、Top-K kernel)、通信(DP gather/scatter 的 overlap、DeepEP 的低延迟模式)。
第八阶段:把通信账单算清楚
前面把每个阶段的通信点散落在各处。这一节把它们按”一次请求、一次前向、一次 decode step”三个粒度汇总,给出可核算的数字。
三种并行拓扑的对比
GLM-5.3 单机 8 卡(H200)常见三种部署:
| 拓扑 | 参数 | 注意力 | MoE | 每层通信 |
|---|---|---|---|---|
| 纯 TP | --tp 8 --ep-size 1 | 头维切分,64 头分 8 份 | 256 专家全部按中间维切分 | 两次 AllReduce(o_proj、MoE),各 |
| TP + EP | --tp 8 --ep-size 8 | 头维切分 | 每卡 32 专家 | o_proj AllReduce,加 DeepEP dispatch/combine |
| DP Attention + EP | --tp 8 --ep-size 8 --attn-dp-size 8 | 每卡完整注意力,只算自己的请求 | 每卡 32 专家 | DP AllGather + dispatch/combine + ReduceScatter |
纯 TP 的通信最少(每层两次 AllReduce),但每张卡要存全部 256 个专家,744B 权重放不下;即使 FP8 也接近 744GB,8 卡总显存 1.1TB,留给 KV 的只剩 300 多 GB。TP + EP 把专家切开,但注意力仍然按头切分,每张卡只算 8 个头的注意力,KV 页也被切分;每层仍有一次 o_proj AllReduce。DP Attention 把注意力完全复制、按请求分片,代价是每层一次 AllGather + ReduceScatter,收益是注意力部分没有 TP 通信、KV 按请求本地化、prefix cache 更自然。
对 1M 上下文,DP Attention 还有一个隐性收益:每张卡只保留自己请求的 KV,不需要为了 TP 切分把一份 KV 分散到 8 张卡上,再在注意力时跨卡读远端 KV。MLA 的 KV 读取量是 decode 的主要带宽开销之一,本地化能显著减少跨卡流量。
一次 prefill 的通信量
假设 prompt 长 8,192 token,单条请求,TP8:
- 纯 TP:每层两次 AllReduce,每次 MB;78 层共 156 次,合计约 15GB。按 NVLink 900GB/s 的 ring 有效带宽约 787GB/s 计算,传输时间约 19ms;再叠加 156 次的启动延迟(每次约 5µs),约 0.8ms。prefill 本身是计算密集的,15GB 通信可以被打散在计算中,实际增加的时间通常小于 10%。
- DP Attention + EP:注意力不需要 AllReduce;MoE 的 dispatch/combine 每层约 字节(FP8 dispatch 48KB/token)≈ 0.4GB,combine 再约 0.8GB,一层合计 1.2GB;75 层约 90GB,这就不是 NVLink 能轻松吃下的量了。所以 SGLang 在 prefill 阶段通常让 MoE 走”普通模式”的 DeepEP,用 RDMA 和 NVLink 混合;如果跨节点,300GB 在 50GB/s 的 IB 上需要 6 秒,完全不可接受。这也是为什么跨节点 EP 要把 prefill 的 micro-batch 切小、并用双批重叠隐藏通信。
一次 decode step 的通信量
假设 batch 32、上下文 128K、TP8 + EP8 + DP8:
- DP AllGather + ReduceScatter:每次 KB,每层 2 次,78 层共 61MB;按 900GB/s 约 68µs,加上 156 次启动延迟约 0.8ms。
- DeepEP dispatch:每 token 8 个专家 × 6144 维 FP8 = 48KB;32 token 约 1.5MB 一层,75 层约 113MB;combine 按 BF16 翻倍,约 226MB。合计约 339MB,NVLink 上约 0.4ms;如果跨节点 IB,约 7ms——所以 EP 必须留在节点内。
- MTP 验证:目标模型一次验证 6 个 token,上述所有量乘以 6:DP gather 约 2.4MB/层,dispatch/combine 约 2MB/层。若 batch 32、每步验证 6 token,MoE 通信约 2GB/step,NVLink 上约 2.5ms;这也是为什么 MTP 的收益必须用接受长度来抵消。
每 token 的通信成本
把 decode 的通信量摊到每个输出 token 上(batch 32):
- DP gather/scatter:61MB / 32 ≈ 1.9MB/token;
- MoE dispatch/combine:339MB / 32 ≈ 10.6MB/token;
- 合计约 12.5MB/token。
以 40 token/s 的生成速度算,通信带宽需求是 500MB/s 量级;如果并发 8 个请求、每个都有独立 batch,等效带宽会到 4GB/s。这还没有算 KV 读取本身:128K 上下文、每 token 每层读 576 字节 × 2048 个选中 token,一层约 1.2MB,78 层约 92MB/token;索引器则要读 21 层 × 131,072 token × 128 字节 ≈ 352MB/token。上下文越长,索引器读取越占主导:到 1M 时主 KV 读取仍是 92MB(Top-2048 不随上下文增长),索引器读取却涨到约 2.8GB。所以 decode 的显存带宽账单远大于通信账单,这也是 HBM 带宽成为第一瓶颈的原因。
第九阶段:四个容易被忽略的工程细节
细节一:索引器在 TP 组内是复制的,Top-K 也是
A 投影与索引器都是 ReplicatedLinear,这意味着 TP8 的每个 rank 都持有同一份索引器权重,也会各自算出一组 Top-K。理论上各 rank 的选择应当一致,但 FP8 量化与归约顺序的差异可能让不同 rank 选出不同的下标;一旦下标不同,后续稀疏注意力读的 KV 页就不同,跨 rank 的注意力和 KV 统计会出现细微偏差。SGLang 提供了 SGLANG_DSA_TOPK_BROADCAST 开关:开启后,rank 0 的最终 Top-K 通过 broadcast_indexer_topk_from_rank0_ 广播给全组,覆盖其他 rank 的结果。
这段代码在 layers/attention/dsa/dsa_indexer.py:
def _broadcast_indexer_topk_from_rank0_impl(topk_indices: torch.Tensor) -> None: group = get_parallel().attn_tp_group if group.world_size == 1: return ... group.broadcast(topk_indices, src=0)它只在 attn_tp_group 内广播;在 DP Attention 配置下 attn_tp_size = 1,组大小为 1,广播直接返回。换句话说,这个开关只对”纯 TP/TP+EP”有意义,对”DP Attention + EP”没有意义——后者本来每张卡就只在算自己的请求,不存在跨 rank 的 Top-K 对齐问题。
这个开关解决的是确定性与一致性,不是算力:所有 rank 仍然各自计算索引器,只是最终下标以 rank 0 为准。它默认关闭,因为广播本身有延迟,且多数场景下各 rank 的 Top-K 已经足够一致。
细节二:前缀缓存不只缓存 MLA 的 KV,还要缓存索引器的 K
GLM-5.3 的 DSA 索引器为每个 token 在 21 个 full 层各写一份 128 维的索引 K。前缀缓存如果只复用主 KV(576 维 × 78 层),而不复用索引 K,那么命中前缀的请求仍然要重算索引器、重新写索引缓存,前缀缓存的意义就少了一半。
SGLang 的 PageInterleaveDSATokenToKVPool(mem_cache/page_interleave_pool.py)把主 KV 与索引器缓存放进同一个逻辑页的所有权与分片计划:
class PageInterleaveDSATokenToKVPool(PageInterleaveMLATokenToKVPool, DSATokenToKVPool): """DSA latent and indexer caches sharing one logical-page shard plan. - Latent KV: [num_tokens, 1, kv_cache_dim], one token per row. - Indexer: [num_pages, page_size * (128 + 4)] in uint8, one page per row. """它让两套缓存的页号一一对应:主 KV 的第 2 个本地页对应 latent 行 128..191(page_size=64),索引器的第 2 行则是一个 8448 字节的页(64 个 token × (128 字节 key + 4 字节 scale))。前缀 gather 时,主 KV 按行拷贝,索引器按整页拷贝;两者始终同步。这样 prefix cache 命中时,索引器缓存也一起命中,不需要重新计算。
页大小 64 不是随便选的。SGLang 的 arg_groups/overrides.py 里明确写着 FlashMLA 只支持 page_size=64;GLM-5.3 的 decode 后端 flashmla_kv 对页大小有同样约束。一个 64-token 页的索引器行是 64 × 132 = 8448 字节,恰好能放进一次 TMA 传输;主 KV 一行是 64 × 576 = 36,864 字节(FP8)。分页粒度与 kernel 的 TMA 尺寸是对齐的,这不是巧合。
细节三:reduce_results=False 与融合的 AllReduce
GLM-5.3 的注意力 o_proj、MoE 的专家输出都设了 reduce_results=False。这不是偷懒,而是把”归约”推迟到下一个 RMSNorm,用 flashinfer_allreduce_residual_rmsnorm 把三个操作合成一个 kernel:
- 对上一层的部分和做 AllReduce;
- 与 residual 相加;
- 对结果做 RMSNorm。
如果按朴素实现,顺序是 AllReduce → 加 residual(读+写 6144 维)→ RMSNorm(读+写 6144 维)→ 写回;融合后,ring 每收到一个 chunk 就就地完成加法与归一化,显存读写次数从 5 次降到 2 次。对一个 decode batch 32、每层 393KB 的消息,这节省的是每次两轮读写、合计约 2 × 393KB 的 HBM 流量,78 层累计约 61MB/step;按每卡 900GB/s 的有效带宽算约 0.07ms,属于几十微秒量级的收益,单看不大,但它与 kernel 启动次数的减少叠加后才有意义。
同样的思路也用在 DP Attention 的 gather/scatter:dp_gather_partial 只收集”部分和”,dp_scatter 只散回本地行,避免把完整的 6144 维 hidden 在每个 rank 上复制一遍。layers/dp_attention.py 里的 _dp_gather_via_all_reduce 和 _dp_gather_via_all_gather 是两条可选路径:前者用 AllReduce 的 SUM 语义把各 rank 的本地 token 写入全局缓冲的对应位置,后者用 AllGather 直接拼接。选择哪条取决于 token 数是否规整、是否能用 all_gather_into_tensor 的等长约束。
细节四:CUDA Graph 的桶与 MTP 的 6 倍 batch
GLM-5.3 的 decode 默认走 CUDA Graph。图捕获的关键约束是”形状必须固定”,而 decode 的 batch 大小随时变化,所以 SGLang 把 batch 分成若干桶(如 1、2、4、8、16、32、64),每个桶捕获一张图。对小 batch,图里 pad 到桶大小,多出来的行用 idle 标记,注意力和 MoE 都会跳过这些行。
MTP 让这件事变复杂:目标模型的验证 batch 是 个 token,而不是 。如果 batch 32,验证 batch 是 192,需要 192 对应的图桶;如果只捕获了 32 的桶,验证就只能走 eager,kernel launch 开销会把 MTP 的收益吃掉一部分。SGLang 为此把 draft 与 target verify 分成两套图:draft 用草稿模型自己的 batch 桶,verify 用目标模型的 6 倍桶;--speculative-num-draft-tokens 改变时,桶的划分也要跟着变。
图中的 idle 行还有一个细节:在部分融合索引器实现里,索引器对 idle 行仍然要算 Q 和 gate(否则图里的 buffer 形状对不上),但 K 的写入会跳过;dsa_indexer.py 的注释里明确写了”Padded graph rows still need Q/gate; only K write is skipped”。这是 CUDA Graph 与 DSA 结合时一个很容易踩的坑。
把整条链路串起来
现在把一次请求的全流程压缩成一条时间线。以单机 8×H200、TP8、EP8、DP Attention 8、EAGLE MTP 为例:
- HTTP 入口:OpenAI 兼容层解析 JSON,渲染 GLM-5.3 chat template,交给 TokenizerManager;
- 分词:tokenizer 把 prompt 变成 token id,构造
TokenizedGenerateReqInput,经 ZMQ 发给 Scheduler; - 调度:
PrefillAdder检查 token 预算与 KV 容量,决定整段 prefill 还是 chunked prefill;prepare_for_extend拼 token、分配 KV 页、写req_to_token; - 嵌入:
VocabParallelEmbedding查表,TP 组内一次 AllReduce; - 78 层循环,每层依次是:
- 层首 fused AllReduce + RMSNorm;
- A 投影(复制,无通信);
- q/kv RMSNorm + RoPE(融合 kernel,写 KV 页);
- 索引器(21 个 full 层运行,57 个 shared 层复用 Top-K);
- Q 上投影(头维切分);
- Q 吸收 bmm + 稀疏 MLA(读 Top-2048 个 KV 页);
- o_proj + ReduceScatter;
- post-attention RMSNorm + AllReduce;
- MoE 门控 + top-8 路由;
- DP AllGather → DeepEP dispatch → 专家 GEMM → combine → ReduceScatter;
- 共享专家、routed scaling、残差;
- MTP:草稿层跑 5 步,目标模型验证 6 个 token,接受长度写回,KV 回滚;
- 收尾:最后一层 RMSNorm → LM Head(词表 AllGather)→ 采样(温度、top-p、投机校验)→ token 回 Scheduler → TokenizerManager 解码 → SSE 流式返回。
这条链路里,真正”贵”的不是矩阵乘,而是三类搬运:权重从 HBM 搬到 SM、KV 从 HBM 搬到 SM、hidden 在卡间搬。GLM-5.3 的设计几乎每一处都在针对这三类搬运:
- MLA 把 KV 压到 576 维/层,减少 KV 读取;
- DSA 把注意力计算从 降到 ,减少 KV 读取的次数,但不减少 KV 的存储;
- 跨层复用索引器(21/78 个 full 层)把索引器的计算与索引 K 读取砍掉约四分之三;
- MoE 的 8/256 激活让每 token 只读 8 个专家,但 EP 让每张卡只存 32 个专家,把权重读取分摊到 8 张卡;
- DP Attention 让注意力在本地完成,把跨卡通信集中到 MoE 的 dispatch/combine。
有一笔账必须单独强调:DSA 不减少 KV 缓存。GLM-5.3 的 1M 上下文,KV 仍然是 44.9KB/token × 1,048,576 ≈ 47GB/请求(FP8),索引器缓存另加约 2.8GB。8×H200 共 1,128GB 显存,装下约 870GB 的实际权重占用(含复制)后只剩约 250GB;按每条 1M 请求约 50GB(KV 加索引器缓存)算,理论上最多同时服务 5 条左右,还要扣除激活和临时缓冲。实际部署 1M 上下文,通常要配合 PD 分离(prefill 与 decode 分开扩缩容)、HiCache(把冷 KV 换到主机内存)和 prefix cache;单机 8 卡把所有 1M 请求都放进 GPU,是不现实的。
这也解释了 SGLang cookbook 对 GLM-5.3 的调参建议为什么会落在这些点上:--mem-fraction-static 0.8 给 KV 留空间,--chunked-prefill-size 控制单次 prefill 的峰值,--attn-dp-size 与 --moe-a2a-backend deepep 决定通信形态,--speculative-* 决定每一步的实际计算量。每一个开关背后,都是这篇文章里某一段算子或某一次集合通信。
下一篇会把同一条路径放到 vLLM 里对照:同一个 glm_moe_dsa 架构,vLLM 把 A 投影融合成 fused_qkv_a_proj、把 norm+RoPE+KV 写入融成 fused_norm_rope,MoE 与 DP Attention 的拆分方式也与 SGLang 不同。两边的差异,正好能说明”哪些是模型决定的,哪些是框架决定的”。
参考资料
- GLM-5: from Vibe Coding to Agentic Engineering(GLM-5 技术报告,arXiv:2602.15763)
- zai-org/GLM-5 官方仓库(GLM-5.3 / 5.3-Flash / 5.2 / 5.1 模型说明与部署入口)
- zai-org/GLM-5.3 模型卡(744B-A40B、FP8、78 层、256 专家、1M 上下文)
- SGLang GLM-5.3 Cookbook(DSA 后端、MTP、DP Attention、PD 分离的启动参数)
- SGLang 源码:deepseek_v2.py(MLA、DSA、MoE 的前向实现)
- SGLang 源码:glm4_moe.py(GlmMoeDsaForCausalLM 与 GLM MTP 层)
- SGLang 源码:dp_attention.py(DP gather/scatter 与 attention TP 组)
- SGLang 源码:dsa_indexer.py(闪电索引器、Top-K 与广播)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与 MLA 结构,arXiv:2512.02556)
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(跨层复用索引器,arXiv:2603.12201)
- DeepSeek-V3 Technical Report(MoE 与 MLA 的基础设计,arXiv:2412.19437)
- DeepEP:DeepSeek 开源的高性能 MoE dispatch/combine 通信库
- FlashMLA:MLA 解码内核与分页 KV 实现
- vLLM GLM-5.3 部署配方(TP8、FP8 KV、glm47 parser 的参考配置)
- vLLM 源码:deepseek_v32(GLM-5.2/5.3 共用的 DSA 模型实现)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



