


GLM-5.3 推理全链路(十三):PD 分离的控制面——路由、bootstrap 握手、取消与失败在两侧怎么走
这一篇接在哪
前十二篇把 GLM-5.3 的一条请求拆到了极致:入口与模板、调度、DSA 注意力、MoE 的 dispatch/combine、1M 上下文的 prefill、PD 分离的 KV 交接、混批、输出侧的反分词、索引器的跨层读写,以及主 KV 与索引器缓存的分页预算。第四篇已经把 PD 分离的数据面算清楚了:57GB 的张量从 prefill 的显存怎样进到 decode 的显存、逐层交接怎样与解码启动重叠、哪一侧主动推、哪一侧按需拉。但那一篇里有一个被刻意跳过的部分:在 57GB 的第一页数据开始搬运之前,两侧是怎么“认识”彼此的? 一条请求在 decode 侧排队时,谁来告诉它“你的 KV 在对面哪个 rank、哪个 room”;prefill 侧什么时候知道“对面已经腾好了位置,可以往外写”;请求被客户端掐断、或者传输中途出错时,两侧又怎么把它从各自的状态表里干净地摘掉。
这些问题全部落在控制面上,和数据面一样是代码密集的。这一篇继续沿两套源码拆:
- SGLang:
disaggregation/prefill.py、disaggregation/decode.py、disaggregation/common/bootstrap.py、disaggregation/common/conn.py,调度器侧看managers/scheduler.py的abort_request,前置层看sgl-router/src/proxy/abort.rs、proxy/mod.rs与server/routes/chat/forward.rs。 - vLLM:
vllm/v1/core/sched/scheduler.py(RequestStatus.WAITING_FOR_REMOTE_KVS、_update_from_kv_xfer_finished、finish_requests)、vllm/v1/engine/core.py、vllm/distributed/kv_transfer/kv_connector/v1/base.py的KVConnectorBase_V1接口,以及 NIXL connector 的pull_scheduler.py与base_scheduler.py。
部署口径与前十二篇一致:单节点 8×H200,SGLang 走 TP8 + DP Attention + EP8,vLLM 走 TP8,GLM-5.3 用 FP8 权重与 fp8_ds_mla KV 布局,78 层 Transformer、21 层 full 索引器、57 层 shared 索引器。这一篇里所有“字节数”仍沿用第四篇的结论:1M 上下文的主 KV 53.7GB、索引器缓存 2.9GB。
先把结论放前面。PD 的控制面不是“传几个 JSON 字段”,它要同时回答三个问题:
- 配对:这条 decode 请求对应的 prefill 是哪台实例、哪个 DP rank、哪个 TP/CP/PP 坐标,数据要写到哪个 room;
- 准入:decode 什么时候为本请求预留 57GB 的本地页,prefill 什么时候可以开始写,写完后 decode 什么时候允许把请求放进 batch;
- 收尾:客户端取消、超时、节点死亡、传输失败时,两侧各自释放什么,怎样保证已经发出的 RDMA 写不会落到下一条请求的页上。
SGLang 用“router 铸 room + bootstrap server 注册表 + KVPoll 状态机”回答这三个问题;vLLM 没有独立 room,控制信息跟着 kv_transfer_params 走,由 connector 的钩子和调度器的 WAITING_FOR_REMOTE_KVS 状态回答。两条路线都能跑,但它们的故障边界、超时语义和取消协议完全不同。这篇文章把两条线并排拆开,最后压成一张控制面时间线。
控制面到底控制什么:三个判据
在数据面里,57GB 是连续搬运的字节;在控制面里,这条请求只是一组很小的状态:rid、bootstrap_room、prefill_dp_rank、target_tp_rank、target_cp_rank、target_pp_rank、页号数组、transfer_id。这些状态的字节数按几十 KB 到几 MB 计,相对 57GB 不到 0.01%。但它们的价值不在带宽,而在顺序:
- 页号必须在数据开始写之前到达 prefill,否则 prefill 不知道往 decode 的哪些槽位写;
- decode 的页必须在 prefill 写之前分配并锁定,否则写进来的地址可能已经被别的请求复用;
- 传输完成的信号必须在最后一页写完之后到达 decode,否则 decode 会把半截 KV 当成完整前缀开始解码;
- 取消信号必须比“页释放”更早到达对侧,否则对侧还在写,本侧已经把页还给了池子。
这四条顺序里任何一条反了,系统都不会立刻报错。它只会表现成“偶发的输出退化”“长上下文答非所问”“下一条请求读到上一条的 KV”。PD 的控制面之所以难,不是它复杂,而是它的错误大多是静默的。
把两套实现放在一张表里,先看它们各自把控制面放在哪:
| 控制面问题 | SGLang | vLLM |
|---|---|---|
| 请求配对 | router 生成 bootstrap_room,随两段请求注入 | prefill 在响应里返回 kv_transfer_params,decode 原样带回 |
| 远端定位 | bootstrap server 的 /route 返回 rank_ip:port | remote_engine_id 查 connector 的远端引擎表 |
| 准入状态 | KVPoll 五态 + decode prealloc/transfer 两级队列 | RequestStatus.WAITING_FOR_REMOTE_KVS + connector 钩子 |
| 完成信号 | sender/receiver 的 poll() 到 Success | worker 的 finished_recving 回到 KVConnectorOutput |
| 取消 | AbortReq → ABORT/ABORT_ACK | EngineCore.abort_requests → finish_requests + connector request_finished |
| 失败检测 | 300s 超时、bootstrap /health 心跳、KVPoll.Failed | connector 握手哈希、租约过期、failed_recving/invalid_block_ids |
| 页复用保护 | room + generation + drain ACK | delay_free_blocks + finished_sending/recving |
这张表里没有“谁更先进”,只有两种不同的工程取舍:SGLang 把控制面集中到一个可查询的注册表和一个显式状态机里,vLLM 把控制面拆进请求参数和 connector 生命周期。下面逐行展开。
路由:一条请求在哪里被劈成两半
PD 的第一步不是握手,而是路由。普通请求只需要选一个 worker;PD 请求要同时选一个 prefill 和一个 decode,并且保证两边对“这条请求是谁”有完全一致的认识。
SGLang router 先选 P/D,再铸一个 room
SGLang 的 router 在 server/routes/chat/forward.rs 里完成配对。它先选出 prefill 与 decode,然后为这条请求生成一个 BootstrapFields:
let pd = decode.map(|decode| { let bootstrap = BootstrapFields { host: prefill.bootstrap_host().to_string(), port: prefill.bootstrap_port(), room: match prefill_rank { Some(rank) => generate_room_id_for_rank(rank, prefill.dp_ranks()), None => generate_room_id(), }, }; (decode, bootstrap)});generate_room_id 只取 63 位:
pub(super) fn generate_room_id() -> u64 { rand::random::<u64>() & (i64::MAX as u64)}这个掩码不是随手写的。room 后面要作为 torch.int64 进入 metadata buffer;如果最高位是 1,Python 侧会把它解释成负数,room 匹配和日志都会出错。generate_room_id_for_rank 则保证 room % dp_ranks == rank:
pub(super) fn generate_room_id_for_rank(rank: u32, dp_ranks: u32) -> u64 { let dp_ranks = u64::from(dp_ranks); (generate_room_id() >> 1) / dp_ranks * dp_ranks + u64::from(rank)}这条约束对应 SGLang 的 follow_bootstrap_room 负载均衡策略:decode 侧不额外查询 prefill 的 DP rank,而是直接用 room % dp_ranks 推断“这条请求应该落在哪个 DP rank”。如果 router 选了 rank 3,但 room 算出来是 rank 5,CommonKVSender.__init__ 会直接记一条 follow_bootstrap_room conflict,把 room 标成 Failed,而不是让请求悄悄落到错误的 rank 上。
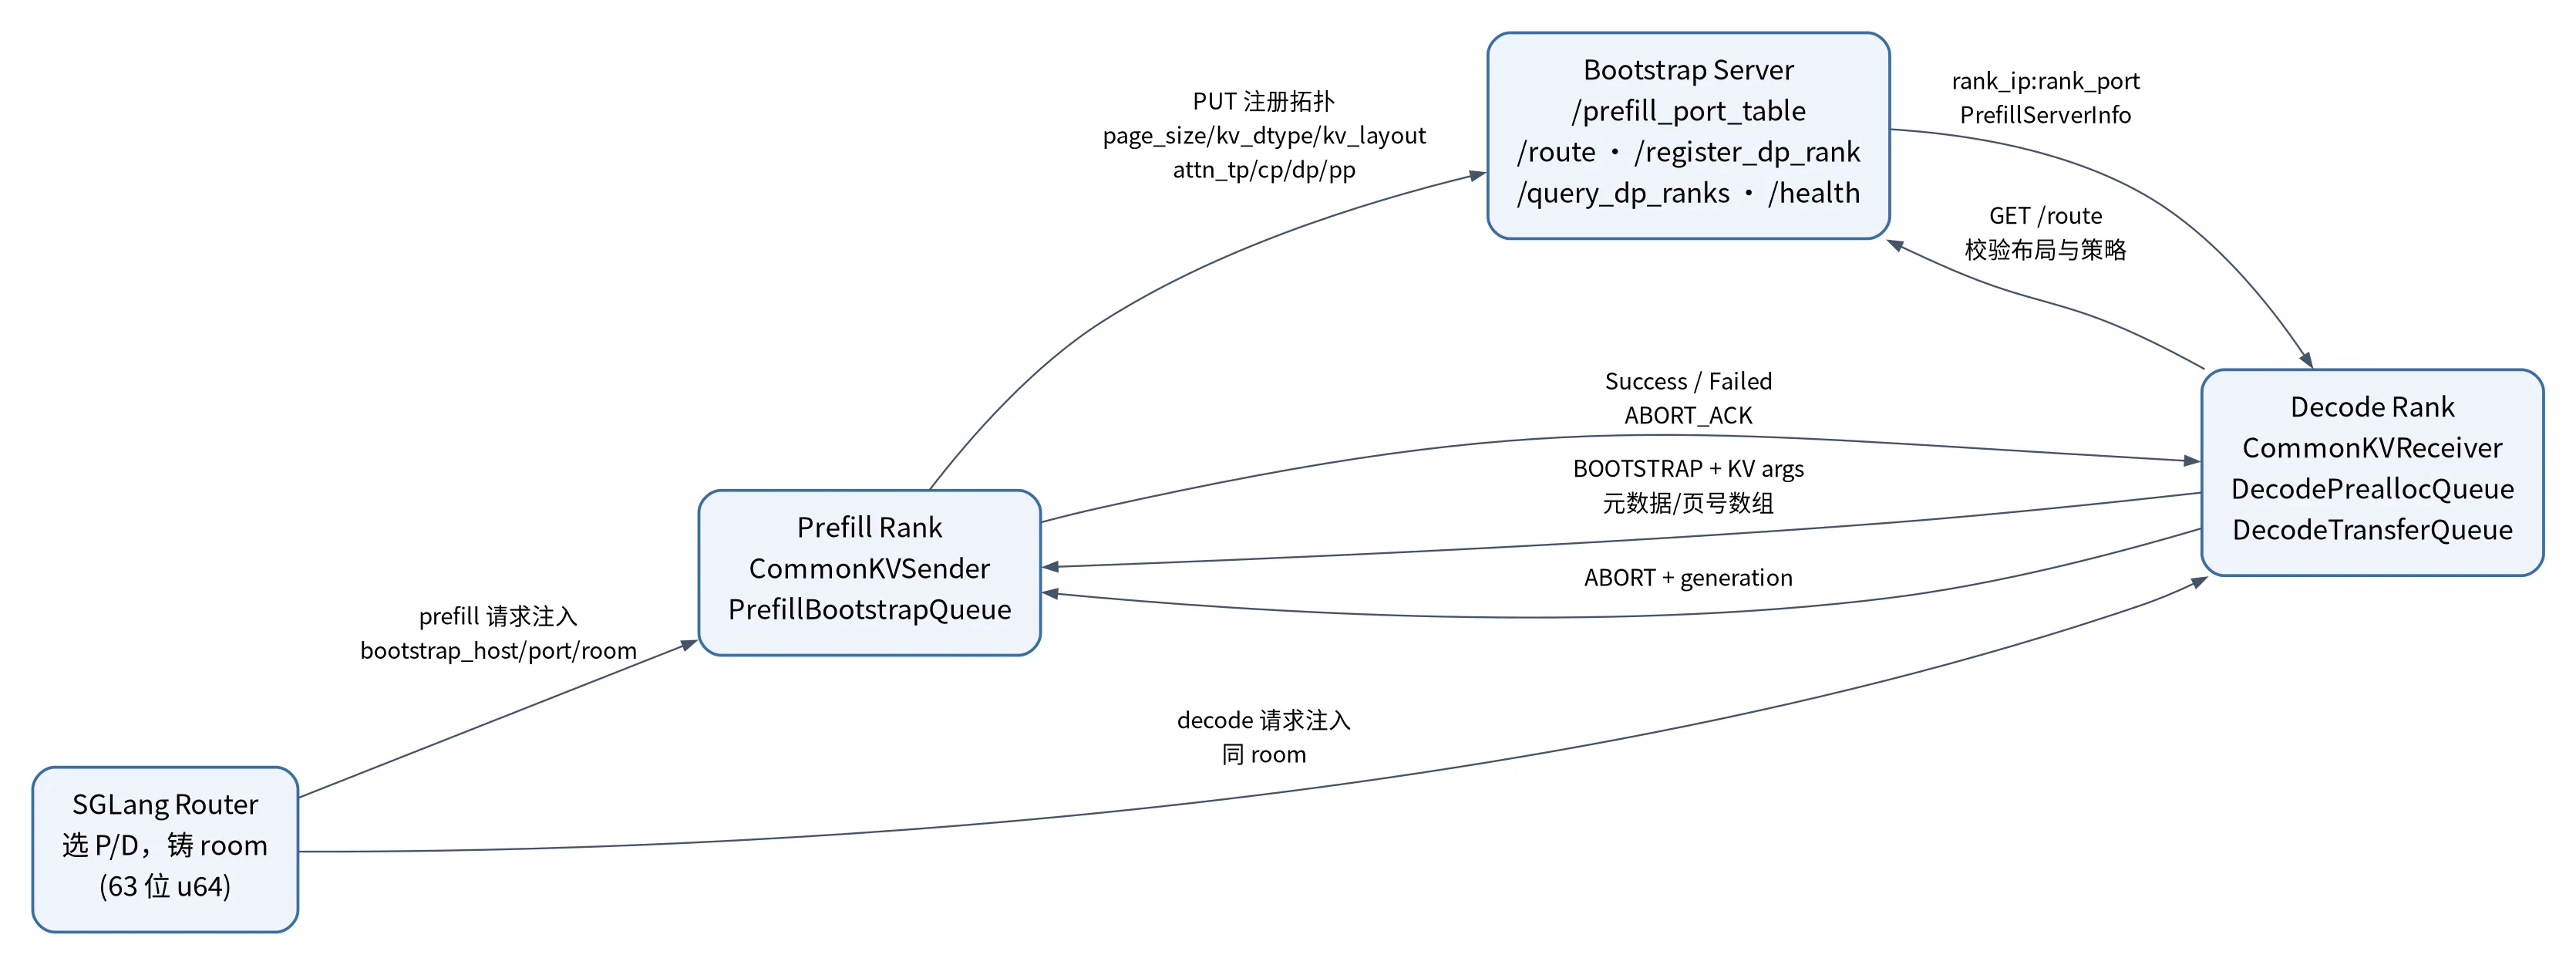
router 把同一个 room 注入两段请求的 body:
- prefill leg 拿到
bootstrap_host、bootstrap_port、bootstrap_room,prefill 的 tokenizer manager 会把它们挂到Req上; - decode leg 拿到同样的三个字段,decode 的
DecodePreallocQueue用它们创建CommonKVReceiver。
prefill 请求不是同步等待 decode 的。spawn_prefill_request 把 prefill leg 放进一个独立 task,decode 则走 admit_decode 的 decode_gate。两段并行推进,但 decode 的响应才是客户端看到的响应。这个结构带来两个控制面细节:
- prefill 失败要能取消 decode。prefill task 返回错误时,
stream_abort.cancel()会取消 decode 的流;如果 decode 还没出第一个 token,客户端看到的是 prefill 的错误,而不是一个空的 decode 流。 - decode 准入失败要能取消 prefill。
admit_decode失败时,router 侧持有的AbortOnDrop会在 drop 时向 prefill 发/abort_request,避免 prefill 继续算一条 decode 已经不接受的请求。
AbortOnDrop 的实现很短,但它定义了一条重要的安全边界:
pub(super) fn new( client: &Client, worker: &Url, headers: &HeaderMap, rid: Option<&str>,) -> Self { Self(rid.filter(|rid| !rid.is_empty()).map(|rid| { let mut request = client .post(worker.join("/abort_request").expect("validated worker URL")) .json(&serde_json::json!({"rid": rid, "abort_all": false})) .timeout(Duration::from_secs(5)); // ... 透传 Authorization request }))}注释里写着“Only router-minted IDs are safe: the engine aborts by prefix.”SGLang 的 abort_request 用 req.rid.startswith(recv_req.rid) 匹配请求;如果 rid 来自客户端,一个短 rid 可能前缀匹配到别的请求,把无关请求一起 abort。router 自己铸 rid,才能保证前缀匹配是精确的。这个约束在自建网关时经常被忽略:网关把客户端传来的 request_id 直接透传,PD 两侧又都拿它做前缀 abort,结果一次客户端断开可能清掉一整批请求。
vLLM 没有 room:kv_transfer_params 就是控制面
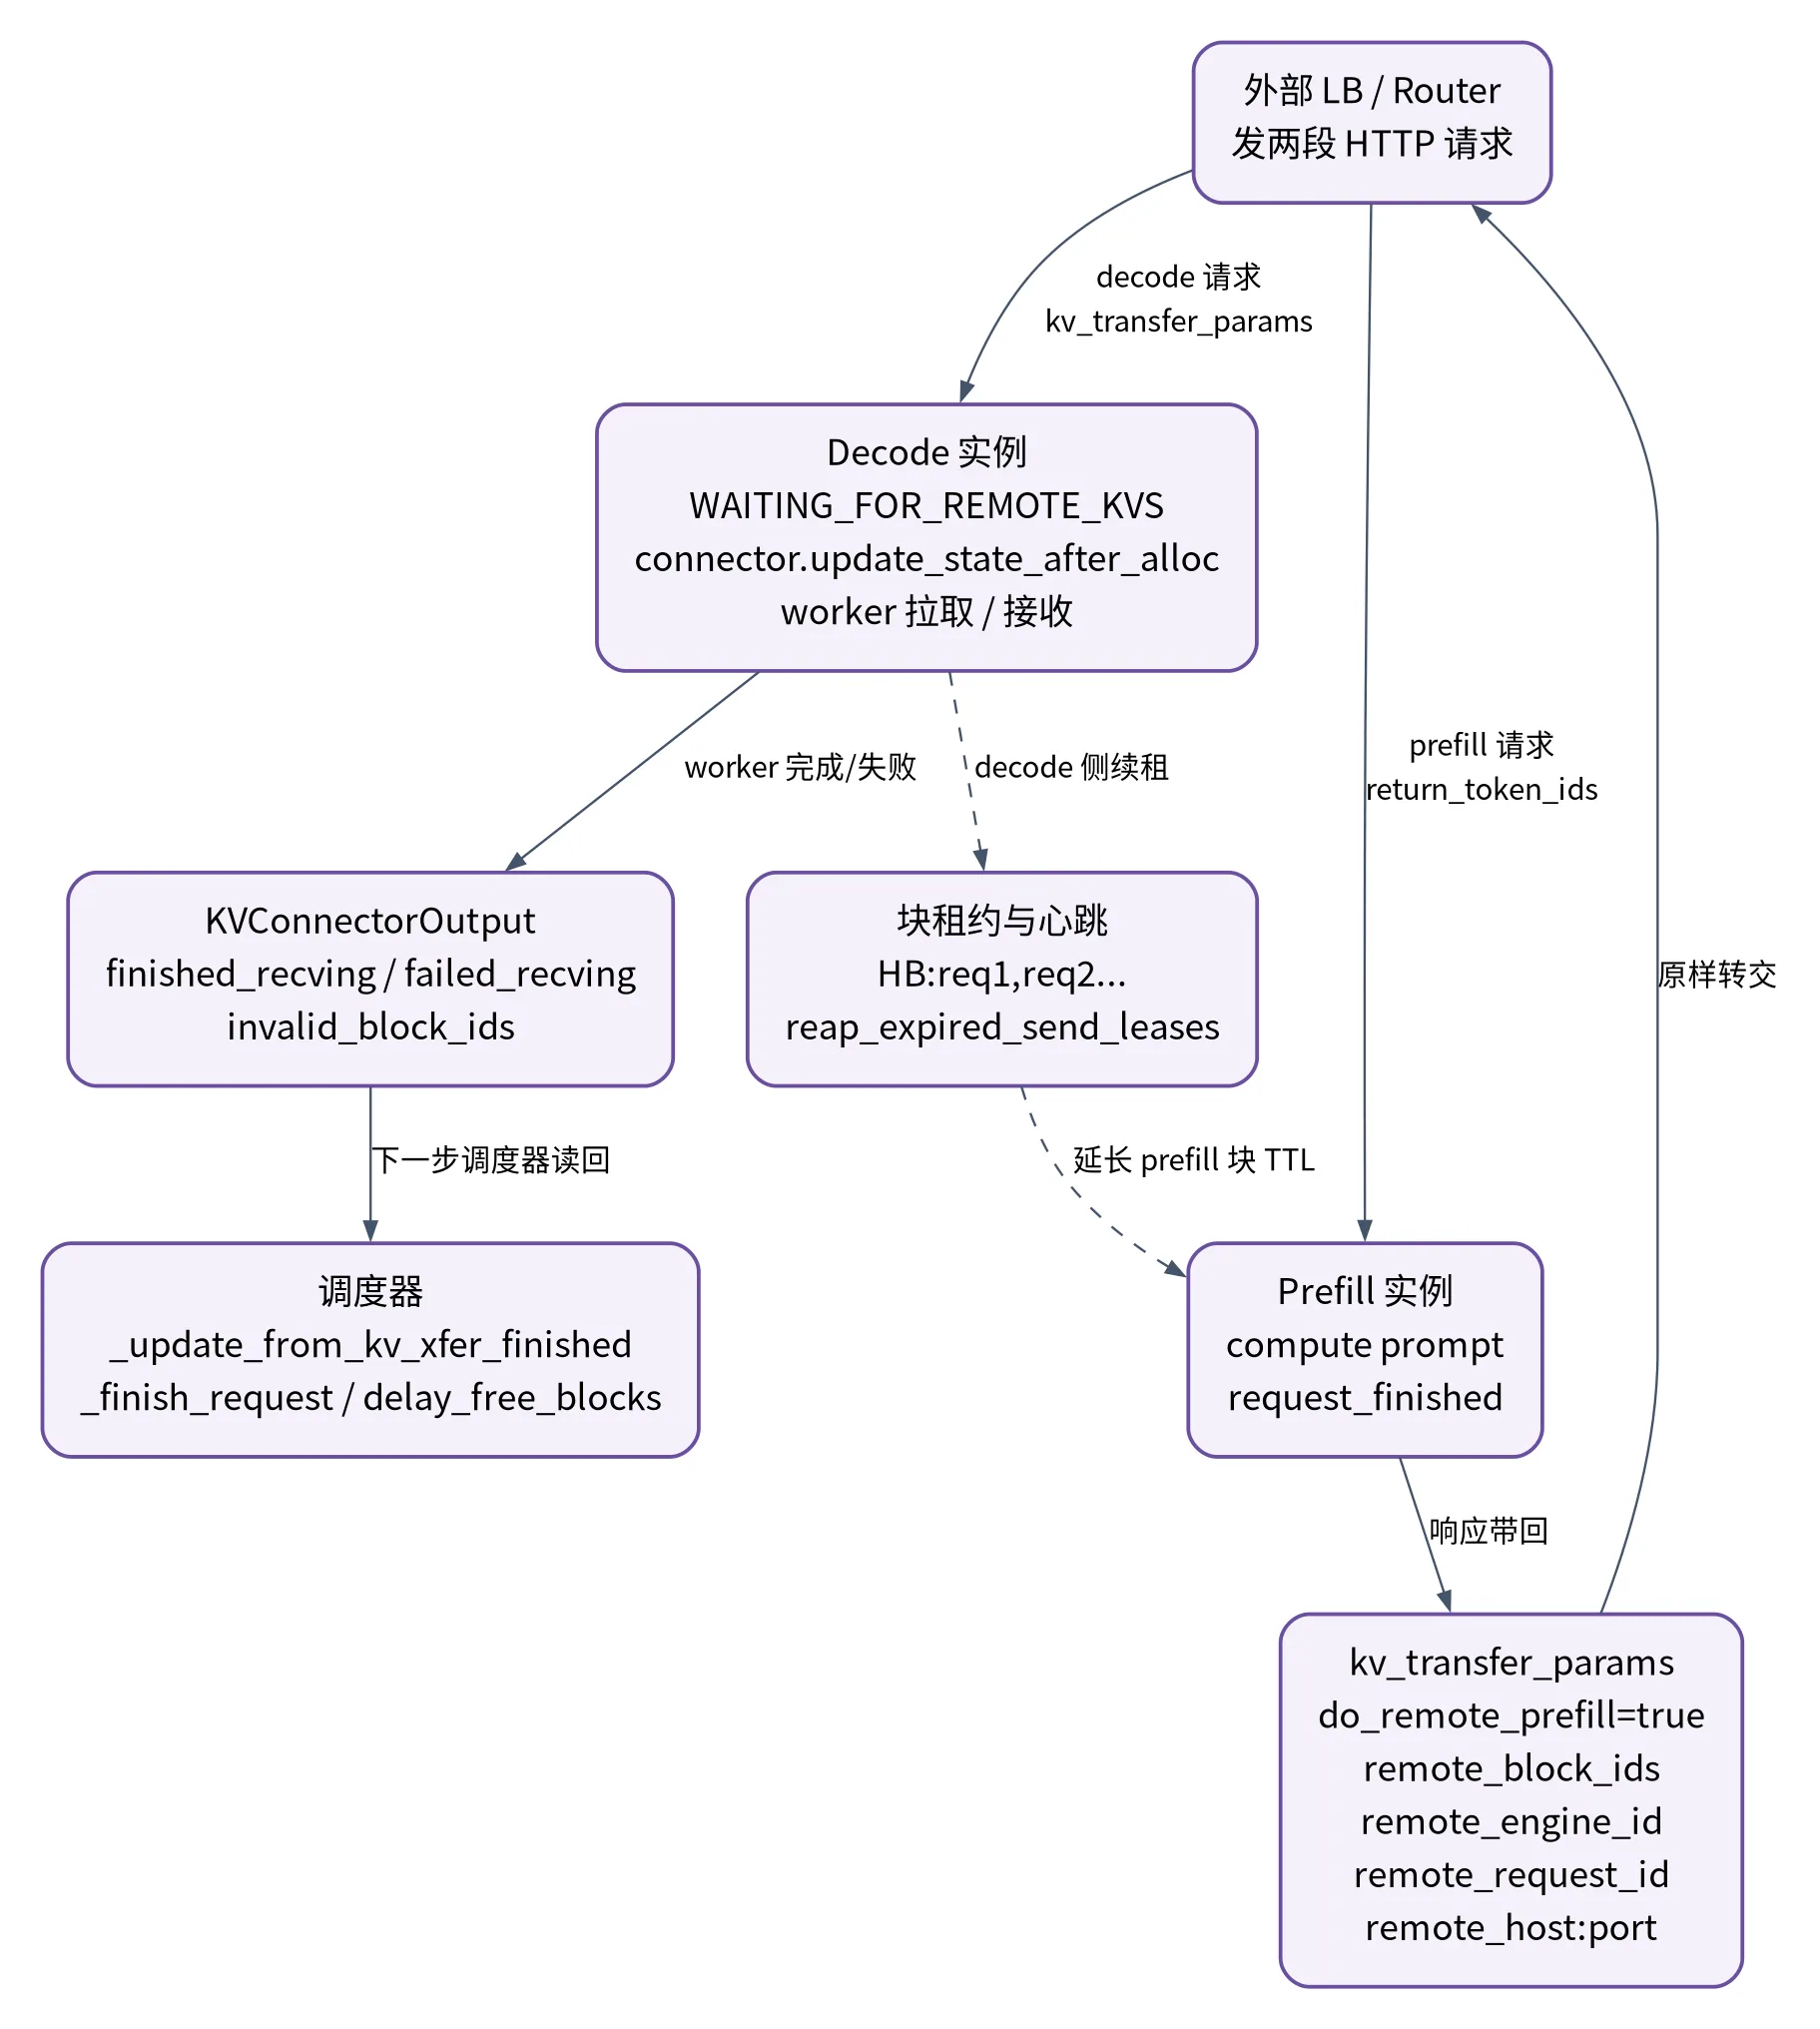
vLLM 不在 router 里铸 room。它的 PD 路由是“两段 HTTP 请求”的编排:
- 路由器先向 prefill 实例发请求,body 里带
kv_transfer_params: {"do_remote_decode": true}; - prefill 正常算完 prompt,
request_finished返回一组kv_transfer_params,随响应回到路由器; - 路由器把同一组参数改写成
do_remote_prefill: true,发给 decode 实例; - decode 的调度器看到
do_remote_prefill,走远端 KV 加载路径。
NIXL connector 的 request_finished 里能直接看到这组字段的来源:
return delay_free_blocks, dict( do_remote_prefill=is_p_node, do_remote_decode=is_d_node, remote_block_ids=block_ids, remote_engine_id=self.engine_id, remote_request_id=request.request_id, remote_host=self.side_channel_host, remote_port=self.side_channel_port, tp_size=self.transfer_tp_size, dcp_size=self.vllm_config.parallel_config.decode_context_parallel_size, pp_size=self.vllm_config.parallel_config.pipeline_parallel_size, remote_num_tokens=remote_num_tokens, remote_blocks_expiry_time=blocks_expiry_time, remote_registration_generation=self._registration_generation, transfer_mode=self._TRANSFER_MODE,)这里的 remote_block_ids 是按 KV cache group 组织的块号列表;remote_engine_id 用来在 connector 的远端引擎表里找到 NIXL agent;remote_host/remote_port 是 side channel 地址;remote_request_id 是 prefill 侧的请求 id;remote_blocks_expiry_time 是块租约的到期时间。字段名会随 connector 版本变化,但语义稳定:decode 要知道去哪个引擎、哪些块、用什么会话取数据,以及这些块还能活多久。
vLLM 的配对键不是 room,而是 (remote_engine_id, remote_request_id)。prefill 侧 on_new_request 会把 do_remote_prefill 的请求登记到 _heartbeat_req_engine:
if params is None or not params.get("do_remote_prefill"): returnremote_engine_id = params.get("remote_engine_id")remote_request_id = params.get("remote_request_id")# ... 校验 host/port/tp_sizeif remote_engine_id not in self._heartbeat_by_engine: self._heartbeat_by_engine[remote_engine_id] = HeartbeatInfo( req_ids=set(), host=host, port=port, tp_size=tp_size, ... )self._heartbeat_by_engine[remote_engine_id].req_ids.add(remote_request_id)decode 的调度器心跳会把 req_ids 发给 prefill,prefill 的 worker 收到 HB:req1,req2,... 后延长这些请求的块租约。这个机制解决的是“decode 还在排队,prefill 的块不能提前还给池子”的问题。SGLang 用 room + 每请求状态表解决同一个问题,vLLM 用 engine id + request id + 租约解决。前者的查询是显式的 /route,后者是隐式的“谁持有这个 request id”。
没有独立 room 也意味着没有“room 冲突”这一层保护。如果两个 decode 请求带相同的 remote_engine_id 和 remote_request_id 来拉同一组块,connector 只能靠请求 id 去重;如果路由器重试时复用了同一个 id,prefill 侧可能把第二次请求当成第一次的重复。vLLM 文档要求 decode 请求使用新的 request id,原因就在这里。
路由层最容易被低估的两个错误
第一个错误是把 room 当成可复用的分配槽。SGLang 的 DeferredBootstrap 注释写得很清楚:“A room identifies one request, not a reusable allocation slot.”一个 room 只属于一条请求;请求结束后,prefill 会在 clear() 里把 room 删掉,或者留一个有超时的 tombstone,防止迟到的 decode endpoint 挂到下一条请求上。如果实现把 room 当成固定槽位循环使用,迟到的 BOOTSTRAP 消息会注册到新请求的 room 上,decode 就会把旧请求的地址发给新请求。
第二个错误是在路由层做“前缀 abort”。SGLang 的 abort_request 用 startswith 匹配,vLLM 的 finish_requests 用精确 id。前者要求 rid 全局唯一且由 router 生成,后者要求 abort 的 id 与请求 id 完全一致。把两种语义混在一起,就会出现“取消一条请求,误伤一批请求”或者“取消根本没生效”。
SGLang 的 bootstrap:注册表、room 与 KVPoll
SGLang 的控制面有一个中心:bootstrap server。它不是一个额外的微服务,而是 prefill 实例启动时拉起的一个 aiohttp 应用,默认监听 --disaggregation-bootstrap-port。它只做三件事:登记 prefill 的拓扑、回答 decode 的 /route 查询、维护 room 到 DP rank 的临时映射。
注册:每个 prefill rank 往注册表里填一行
prefill 的 CommonKVManager.register_to_bootstrap() 会向 /route 发 PUT,payload 包含:
payload = { "attn_tp_size": attn_tp[0], "attn_tp_rank": attn_tp[1], "attn_cp_size": attn_cp[0], "attn_cp_rank": attn_cp[1], "attn_dp_size": self.attn_dp_size, "attn_dp_rank": self.attn_dp_rank, "pp_size": self.pp_size, "pp_rank": self.pp_rank, "system_dp_size": self.system_dp_size, "system_dp_rank": self.system_dp_rank, "rank_ip": self.local_ip, "rank_port": self.rank_port, "page_size": self.kv_args.page_size, "kv_cache_dtype": self.kv_cache_dtype_str, "kv_layout": self.kv_layout, "dsv41_spec_layout": self.dsv41_spec_layout, "load_balance_method": get_parallel().load_balance_method, "enable_dsa_cache_layer_split": get_parallel().enable_dsa_cache_layer_split, "enable_kv_cache_sharding": get_parallel().enable_kv_cache_sharding, "prefill_http_port": get_serving().port,}payload["decode_allocation_policy"] = ( get_disagg().disaggregation_decode_allocation_policy)这组字段里,rank_ip:rank_port 是数据面的 ZMQ 控制地址,page_size/kv_cache_dtype/kv_layout/dsv41_spec_layout 是兼容性判据,attn_tp/cp/dp/pp 是拓扑坐标,prefill_http_port 是重算/rebootstrap 时回打 prefill HTTP 接口用的。decode_allocation_policy 也会一起登记:bootstrap server 在第一次注册时记下策略,后续注册如果策略不一致,直接返回 400。
bootstrap server 用一张五层嵌套表存这些信息:
self.prefill_port_table: Dict[ int, Dict[int, Dict[int, Dict[int, PrefillRankInfo]]]] = {}维度依次是 DP group、CP rank、TP rank、PP rank。_is_ready() 检查注册数是否达到:
expected = self.dp_size * self.attn_cp_size * self.attn_tp_size * self.pp_sizereturn self._registered_count >= expected这个 expected 是 decode 侧决定“能不能开始握手”的门槛。如果 expected 算错,比如把 system_dp_size 和 attn_dp_size 混用,bootstrap server 会一直返回 503 Prefill server not fully registered yet,decode 的请求全部卡在 Bootstrapping。这类错误在异构 DP/CP 部署里很常见:prefill 是 DP8 + TP1,decode 是 TP8,bootstrap 的 DP group 应该按 system_dp_size 还是 attn_dp_size 取,取决于是否开了 DP Attention。
/route 同时支持 PUT 和 GET。PUT 用来注册;GET 有两种形态:
- 四个 rank 参数都是
-1:返回整台 prefill 的PrefillServerInfo,用于 decode 第一次接触时的兼容性检查; - 四个 rank 是具体坐标:返回该 rank 的
rank_ip、rank_port,用于建立具体的数据面连接。
/register_dp_rank 和 /query_dp_ranks 是给非 follow_bootstrap_room 的负载均衡策略用的:decode 的 sender 在创建时把 bootstrap_room -> dp_rank 写进 bootstrap server,prefill 侧后续用 /query_dp_ranks 批量查回。room_to_dp_rank 表有一个后台清理任务,超过 entry_cleanup_interval 的条目会被删掉,避免一张长生命周期的映射表无限增长。
握手:decode 拉地址,prefill 建 sender
decode 的 DecodePreallocQueue._create_receiver_and_enqueue 先创建 CommonKVReceiver,然后在 _init_receiver 里调用 kv_receiver.init(prefill_dp_rank)。init 做四件事:
- 如果
bootstrap_addr不在prefill_info_table,记录失败并返回; - 用
/route?prefill_dp_rank=-1&...拉整台 prefill 的信息,校验page_size、kv_cache_dtype、kv_layout、dsv41_spec_layout和 allocation policy; - 根据
target_tp_ranks、target_cp_ranks、target_pp_ranks逐个/route拉具体 rank 的地址,建立bootstrap_infos; - 把 decode 的 KV 布局参数注册给 prefill(
_register_kv_args),然后按策略决定是直接进入WaitingForInput,还是先等 prefill 完成。
兼容性校验是硬失败,不是 warning:
if info.page_size is not None and info.page_size != self.kv_args.page_size: raise RuntimeError( f"Page size mismatch: prefill server has page_size={info.page_size}, " f"but decode server has page_size={self.kv_args.page_size}. " f"Both servers must use the same --page-size value." )kv_cache_dtype 和 kv_layout 的校验同理。GLM-5.3 的 fp8_ds_mla 布局是 656 字节一行;如果 decode 按 fp8_e4m3 的 576 字节解释,KV 的 K/V 会整体错位。这个错误不会在传输层报错,只会在 decode 输出里表现为胡言乱语。把校验放在握手阶段,是 PD 控制面最重要的一条“尽早失败”原则。
_setup_bootstrap_infos 还有一个容易忽略的细节:它按 target_cp_rank 分组,组内按 target_pp_rank 倒序拉地址。PP 倒序是为了让高 PP rank 先 bootstrap,减少 PP 流水线在握手阶段的空转。bootstrap_infos 里每个条目带一个 is_dummy 标记:MLA 后端下,只有 target_tp_rank 对应的 rank 是真实目标,其余 TP rank 是 dummy,不参与实际写入;非 MLA 后端的所有 TP rank 都是真实目标,因为每个 rank 持有不同的 KV head 切片。
room 的语义:一条请求的临时地址簿
SGLang 的 room 不是 bootstrap server 分配的。router 铸 room,prefill 的 CommonKVSender 和 decode 的 CommonKVReceiver 各自用这个数字建本地状态。bootstrap server 只知道 room -> dp_rank 的临时映射,不知道 room 的完整生命周期。
prefill 侧的 DeferredBootstrap 是 prefill_complete 策略下的 room 表:
@dataclassclass BootstrapRoom: owner: object | None = None endpoint: tuple[str, int] | None = None ready: bool = False ready_notified: bool = False failed: bool = False expires_at: float = 0.0五个字段分别表示:谁拥有这个 room(sender 对象)、decode 的控制端点、prefill 是否已经完成、是否已经通知过 decode、是否失败、何时过期。open() 只允许一个 owner;register() 只允许一个 endpoint,第二个不同的 endpoint 会收到 (endpoint, True) 的失败通知;complete() 只在 owner 匹配且未失败时把 ready 置 True;close(success=True) 会删掉 room,让后续请求可以复用同一个数字。
DeferredBootstrap 的注释强调“It performs no I/O, including while holding its lock.”这是为了避免在持锁时向一个已经死掉的 decode 发消息:所有通知都通过 _notify_bootstrap 转成状态消息,在锁外发送。room 表本身只做内存状态,不做网络操作,这样即使 decode 挂掉,prefill 的调度线程也不会被一个阻塞的 socket 卡住。
失败时,room 不会被立即删除,而是留一个有 expires_at 的 tombstone:
state.owner = Nonealready_failed = state.failedstate.failed = Truestate.expires_at = time.monotonic() + self.timeout# Retain a bounded tombstone: a late endpoint must not wait forever# or attach to a second request using the same bootstrap room.这个 tombstone 的寿命是 waiting_timeout + bootstrap_timeout,默认 600 秒。它的作用是接住“取消已经发生,但 decode 的 BOOTSTRAP 消息还在路上”的竞态:迟到的 endpoint 会收到失败通知,而不是挂到一个不存在或已被复用的 room 上。
状态机:KVPoll 的五个值在两侧各是什么意思
SGLang 用同一个 KVPoll 枚举描述 sender 和 receiver,但两侧对同一个值的语义并不完全相同:
class KVPoll: Failed = 0 Bootstrapping = 1 WaitingForInput = 2 Transferring = 3 Success = 4Bootstrapping:room 已建立,但还没有拿到对端的完整元数据。decode 侧表示“已分配本地页,正在等/route/KV args 注册完成”;prefill 侧表示“sender 已创建,正在等 decode 的 metadata”。WaitingForInput:decode 侧表示“元数据已发出,等 prefill 算完/发完”;prefill 侧表示“已收到 decode 的 metadata,可以开始 prefill 或发送”。Transferring:KV 正在按 chunk 发送。SGLang 的request_status用max(current, status)推进状态,Transferring只是中间态;最终的Success要等所有 chunk 和所有 rank 都完成。Success:所有需要的层/页都到齐,decode 可以把请求放进 waiting queue。Failed:任一侧 abort、超时、校验失败或节点死亡。
CommonKVSender.poll() 有一个“结论缓存”:一旦看到 Success 或 Failed,就把 conclude_state 固定下来,后续 poll 不再查表。这个缓存避免了“状态已经 Success,但 room 被清理后查表变成 Failed”的抖动。CommonKVReceiver.poll() 则额外处理 WaitingForInput 的超时:它把 _prefill_wait_start 清零,改用 init_time 重新计时,因为“等 prefill 完成”和“等 KV 到达”是两个不同的阶段,不能共用一个 deadline。
两条准入时间线:early 与 prefill_complete
SGLang 有两个 decode 分配策略,差别就在“decode 什么时候占 57GB”。
early(默认) 的时间线:
- router 铸 room,prefill 与 decode 两段同时发出;
- decode 的
DecodePreallocQueue创建 receiver,init拉/route、校验布局、注册 KV args,状态Bootstrapping; - decode 按请求的 token 数计算需要的页,调用
pop_preallocated分配本地 KV 槽位;分配成功后进入DecodeTransferQueue,状态WaitingForInput; - decode 的
send_metadata把页号、aux_index、state indices 发给 prefill 的每个bootstrap_info; - prefill 的
PrefillBootstrapQueue.pop_bootstrapped看到WaitingForInput,finalize_bootstrap分配 metadata buffer、初始化 sender,把请求放进 waiting queue; - prefill 开始算 prefill,每算完一个 chunk 就
send_kv_chunk;decode 的pop_transferred轮询,直到所有 rank 返回Success; - decode 把请求放进 waiting queue,调度器才允许它进 batch。
early 的关键是第 3 步:decode 在 prefill 还没开始算的时候就把 57GB 的页占住了。对 1M 请求,这意味着 decode 的页池在整段 prefill 时间里都少了一条请求的容量。它的好处是 prefill 一开始算就能往外写,chunk 与传输可以重叠;坏处是长 prefill 会把 decode 的容量按住不放。
prefill_complete 的时间线:
- prefill 先算 prefill,不等待 decode 的页;
optimistic_prefill_attempts会被自动设成 1,允许 prefill 在没有 bootstrap 完成时先走一次前向; - prefill 算完最后一个 chunk,
mark_prefill_complete()把DeferredBootstrap的 room 标成ready,并通过状态消息通知 decode 的 endpoint; - decode 收到
WaitingForInput,这时才开始分配本地 KV 槽位、发 metadata; - prefill 收到 metadata 后,把已经保留在显存里的 KV 按页发出去;
- 传输完成,decode 进 batch。
这条时间线把 decode 的容量占用推迟到最后,代价是 prefill 必须把 KV 留在自己的显存里直到 decode 来取,而且 chunk 与传输的重叠消失了。SGLang 的文档明确说它“不是通用的吞吐优化”:它适合“长 prefill 与活跃 decode 争抢 decode 容量”的场景,不适合所有负载。它还要求 Mooncake(RDMA 或 mooncake_tcp)、Python bootstrap registry、attention TP/CP/PP 为 1;这些限制来自 prefill_complete 的实现路径,不是配置上的随意选择。
两条时间线里,PrefillBootstrapQueue 的 max_input_len 都是一道硬门槛:
self.max_total_num_tokens = ( self.scheduler.tp_worker.model_runner.effective_logical_max_total_num_tokens * self.scheduler.kv_shard_widening)self.max_input_len = max_bootstrap_input_len( capacity=self.max_total_num_tokens, page_size=self.scheduler.token_to_kv_pool_allocator.page_size, shard_size=self.scheduler.kv_shard_widening,)effective_logical_max_total_num_tokens 是 prefill 侧能装下的 token 数;kv_shard_widening 是逻辑页分片因子,开了 KV cache sharding 后每个 rank 只拥有部分逻辑页,容量按 N 倍放大,但准入上限要按最严格的 add_one_req_ignore_eos 路径算。max_bootstrap_input_len 在 shard_size == 1 时直接返回容量;在分片时返回:
(capacity - shard_size * page_size - 3) // page_size * page_size这条公式的意思是:分片模式下每条请求的 prompt 要按页对齐,每个 shard 至少留一页,再加 1 个 new token 和 1 个 spare token。1M 请求如果超过这个上限,_check_if_req_exceed_kv_capacity 会在 bootstrap 之前就 prepare_abort,返回 400,而不是等握手完成才发现装不下。
准入:57GB 的页不是握手时才找的
PD 的容量问题在控制面上表现为两个队列:
- decode 的
DecodePreallocQueue:等握手、等页; - decode 的
DecodeTransferQueue:等 KV 到齐。
pop_preallocated 不是简单地“有空间就分配”。它先算当前 running batch 的 retractable_tokens,再算 full_allocatable_tokens,减去 HiCache 的 pending restore tokens,然后按优先级排序。如果一条 1M 请求需要 16384 个 64-token 页,而当前池子里只剩 12000 页,它会等待,而不是先分配一半。这个“全有或全无”的语义是 PD 和普通 PagedAttention 最大的区别:普通请求可以边算边扩页,PD 的 decode 必须在 prefill 写之前把整条请求的页锁定,否则 prefill 会往一个还没分配的地址写。
DecodePreallocQueue 还维护一个 retracted_queue。当 decode 显存不足时,调度器可以把一些正在 decode 的请求 retract,把它们的 KV 备份到 host,再把页让给 prefill 的请求。pop_preallocated 在 retracted queue 非空时直接返回,不再接收新请求,这是为了避免“retract 的页还没还完,新请求又占走”的循环。对 1M 请求,retract 的代价是 57GB 的 host 拷贝,所以这条路径只在容量告急时启用。
PrefillBootstrapQueue 侧还有一个不太显眼的资源:metadata buffer。ensure_metadata_buffer 从 ReqToMetadataIdxAllocator 里取一个索引,这个索引对应一块用于 prefill 输出(output token、logprobs、DSA top-k indices、bootstrap room 等)的 buffer。metadata buffer 数量是有限的;如果所有 buffer 都被在途请求占满,finalize_bootstrap 会返回 False,请求继续留在 bootstrap queue。这不是“容量不足”的失败,而是一种背压:prefill 的调度器会在后续循环里重试,而不是 abort 请求。
取消:客户端断开、router 超时、上层 abort
PD 的控制面里,取消比失败更难,因为取消是“主动放弃”,两侧都要在正确的时刻释放资源,而且释放顺序不能反。
从 HTTP 到引擎:AbortReq 怎么走
SGLang 的取消入口是 /abort_request,body 是 {"rid": "...", "abort_all": false}。router 的 AbortOnDrop 在 decode 准入失败或客户端断开时发这个请求;引擎的 abort_request 按 rid 前缀匹配,分四条路径处理:
- waiting queue:直接 pop,
_release_aborted_request,如果是 decode 模式还要release_kv_cache;如果是 prefill 模式,调用release_aborted_prefill_waiting_req。 - bootstrap queue:prefill 还没完成握手的请求,
sender.abort(),释放 metadata buffer,清掉 pending chunk send。 - inflight queue:prefill 已经开始发 KV 的请求,
sender.abort();sender 会把 room 标 Failed,并让 transfer worker 在下一个 chunk 出队时跳过。 - decode 的 prealloc/transfer/retracted queue:prealloc 里的 receiver 直接
abort();transfer 里的 receiver 如果在 host staging,先prepare_abort但不立即释放,等 prefill 停止写;否则receiver.abort()。
这四个路径的共同点是:先让状态机进入 Failed,再释放本地资源。顺序反了,transfer worker 可能在资源释放后还拿着页号去写。
release_aborted_prefill_waiting_req 是 prefill 侧最完整的清理函数:
def release_aborted_prefill_waiting_req(self: Scheduler, req: Req) -> None: self.clear_pending_chunk_send(req) sender = getattr(req, "disagg_kv_sender", None) if sender is not None and hasattr(sender, "abort"): sender.abort() maybe_release_metadata_buffer(req, self.req_to_metadata_buffer_idx_allocator) if req.kv.holds_kv or req.kv.holds_mamba: release_kv_cache(req, self.tree_cache, checkpoint=False) req.pending_bootstrap = Falseclear_pending_chunk_send 清的是 disagg_prefill_pending_chunk_rids。这个集合记录“已经发出 chunk 但还没收到 last_chunk 确认”的请求;如果不清,它会让 unified memory 的 compaction gate 一直关着。注释里专门写了这个坑:“a stale entry holds the unified-memory compaction gate closed for the process lifetime.”
跨侧通知:ABORT、ABORT_ACK 与 generation
SGLang 的取消不是单向的。decode 的 CommonKVReceiver.abort() 会做两件事:
- 把本侧 room 标 Failed,记录 failure reason;
- 向所有
bootstrap_infos发ABORT消息。
ABORT 的 wire format 是:
class AbortNotification(msgspec.Struct, frozen=True): room: int decode_ip: Optional[str] = None decode_port: Optional[int] = None generation: Optional[int] = Nonegeneration 是 decode 侧为这次取消分配的代数。prefill 收到 ABORT 后,把 room 标 Failed,并检查是否需要等传输排空(drain)再回 ABORT_ACK。ABORT_ACK 的格式是:
class AbortAck(msgspec.Struct, frozen=True): room: int prefill_rank: int generation: Optional[int] = Noneprefill 的 _send_abort_ack 在 _staging_outstanding[room] == 0 时发送,表示“我这个 rank 的上一次传输已经排空,decode 可以安全复用这些页”。decode 的 _deferred_abort_ack_tracker 按 room 记录 generation 和已经 ACK 的 prefill rank 集合;is_abort_release_safe(room, required_acks) 只有在收到足够多的 ACK 后才返回 True。
这层 ACK 机制是为 host destination(staging buffer)准备的。如果 decode 的 KV 目标是 host 内存,prefill 的 RDMA 写可能还在 CPU 侧排队;仅仅把 receiver 标 Failed 并不能证明写已经完成。BaseKVReceiver.is_abort_release_safe 的注释说得很直接:“A failed poll or elapsed timeout alone does not prove the buffers can be reused.”所以 SGLang 引入了 deferred release:abort 后不立即释放 host buffer,等 ACK 或 release timeout。device destination 的路径通常不需要 ACK,因为 CUDA stream 的顺序性可以保证写完才复用。
generation 的另一个作用是防止“旧 ACK 迟到,误放新请求的页”。room 数字可以被复用,但 generation 每次取消递增;prefill 的 ACK 带 generation,decode 的 tracker 只接受当前 generation 的 ACK。没有 generation,一个迟到的 ACK 会让下一条复用同一 room 的请求提前释放页。
vLLM 的取消:finish_requests 与 delay_free_blocks
vLLM 的取消入口在 EngineCore.abort_requests:
def abort_requests(self, request_ids: list[str]): self.scheduler.finish_requests(request_ids, RequestStatus.FINISHED_ABORTED)finish_requests 的第一遍扫描把请求从 running/waiting 队列移除,第二遍统一设置状态并调用 _free_request。对 PD 最关键的一段是:
if request.status == RequestStatus.WAITING_FOR_REMOTE_KVS: delay_free_blocks = ( request.request_id not in self.finished_recving_kv_req_ids ) self.finished_recving_kv_req_ids.discard(request.request_id) self.failed_recving_kv_req_ids.discard(request.request_id)request.status = finished_statusself._free_request(request, delay_free_blocks=delay_free_blocks)如果 decode 请求还在 WAITING_FOR_REMOTE_KVS,而且 connector 还没有报告 finished_recving,delay_free_blocks 为 True,块不会立即还给池子。这个延迟是必要的:prefill 可能还在写这些块,decode 先释放会让下一条请求读到半截 KV。等 worker 的 finished_recving 或 finished_sending 回到 KVConnectorOutput,_update_from_kv_xfer_finished 再释放:
for req_id in kv_connector_output.finished_recving or (): req = self.requests[req_id] if req.status == RequestStatus.WAITING_FOR_REMOTE_KVS: self.finished_recving_kv_req_ids.add(req_id) else: self._free_blocks(self.requests[req_id])for req_id in kv_connector_output.finished_sending or (): self._free_blocks(self.requests[req_id])注意 finished_recving 的两种分支:请求还在等 KV 时,只记 id,不释放;请求已经 finished(客户端取消/超时)时,直接 _free_blocks。这就是 vLLM 的“取消后延迟释放”实现:取消先把请求标成 finished,块留给 connector 的完成回调来释放。
vLLM 的 connector request_finished 还有一条专门的“取消前没来得及调度”的路径。NIXL 的 pull scheduler 里:
if params.get("do_remote_prefill"): # If do_remote_prefill is still True when the request is finished, # update_state_after_alloc must not have been called ... self._reqs_need_recv[request.request_id] = (request, [], (), False) params["do_remote_prefill"] = False return False, None这条路径处理的是 decode 请求在调度前就被 abort 的情况:decode 还没有分配本地块,也没有发 metadata;connector 用空的 block_ids 登记一次“接收”,worker 侧会向 prefill 发通知,让 prefill 释放已经保留的块。没有这条路径,prefill 会一直持有这些块直到租约过期。
取消的工程边界:哪些资源必须等,哪些可以立即放
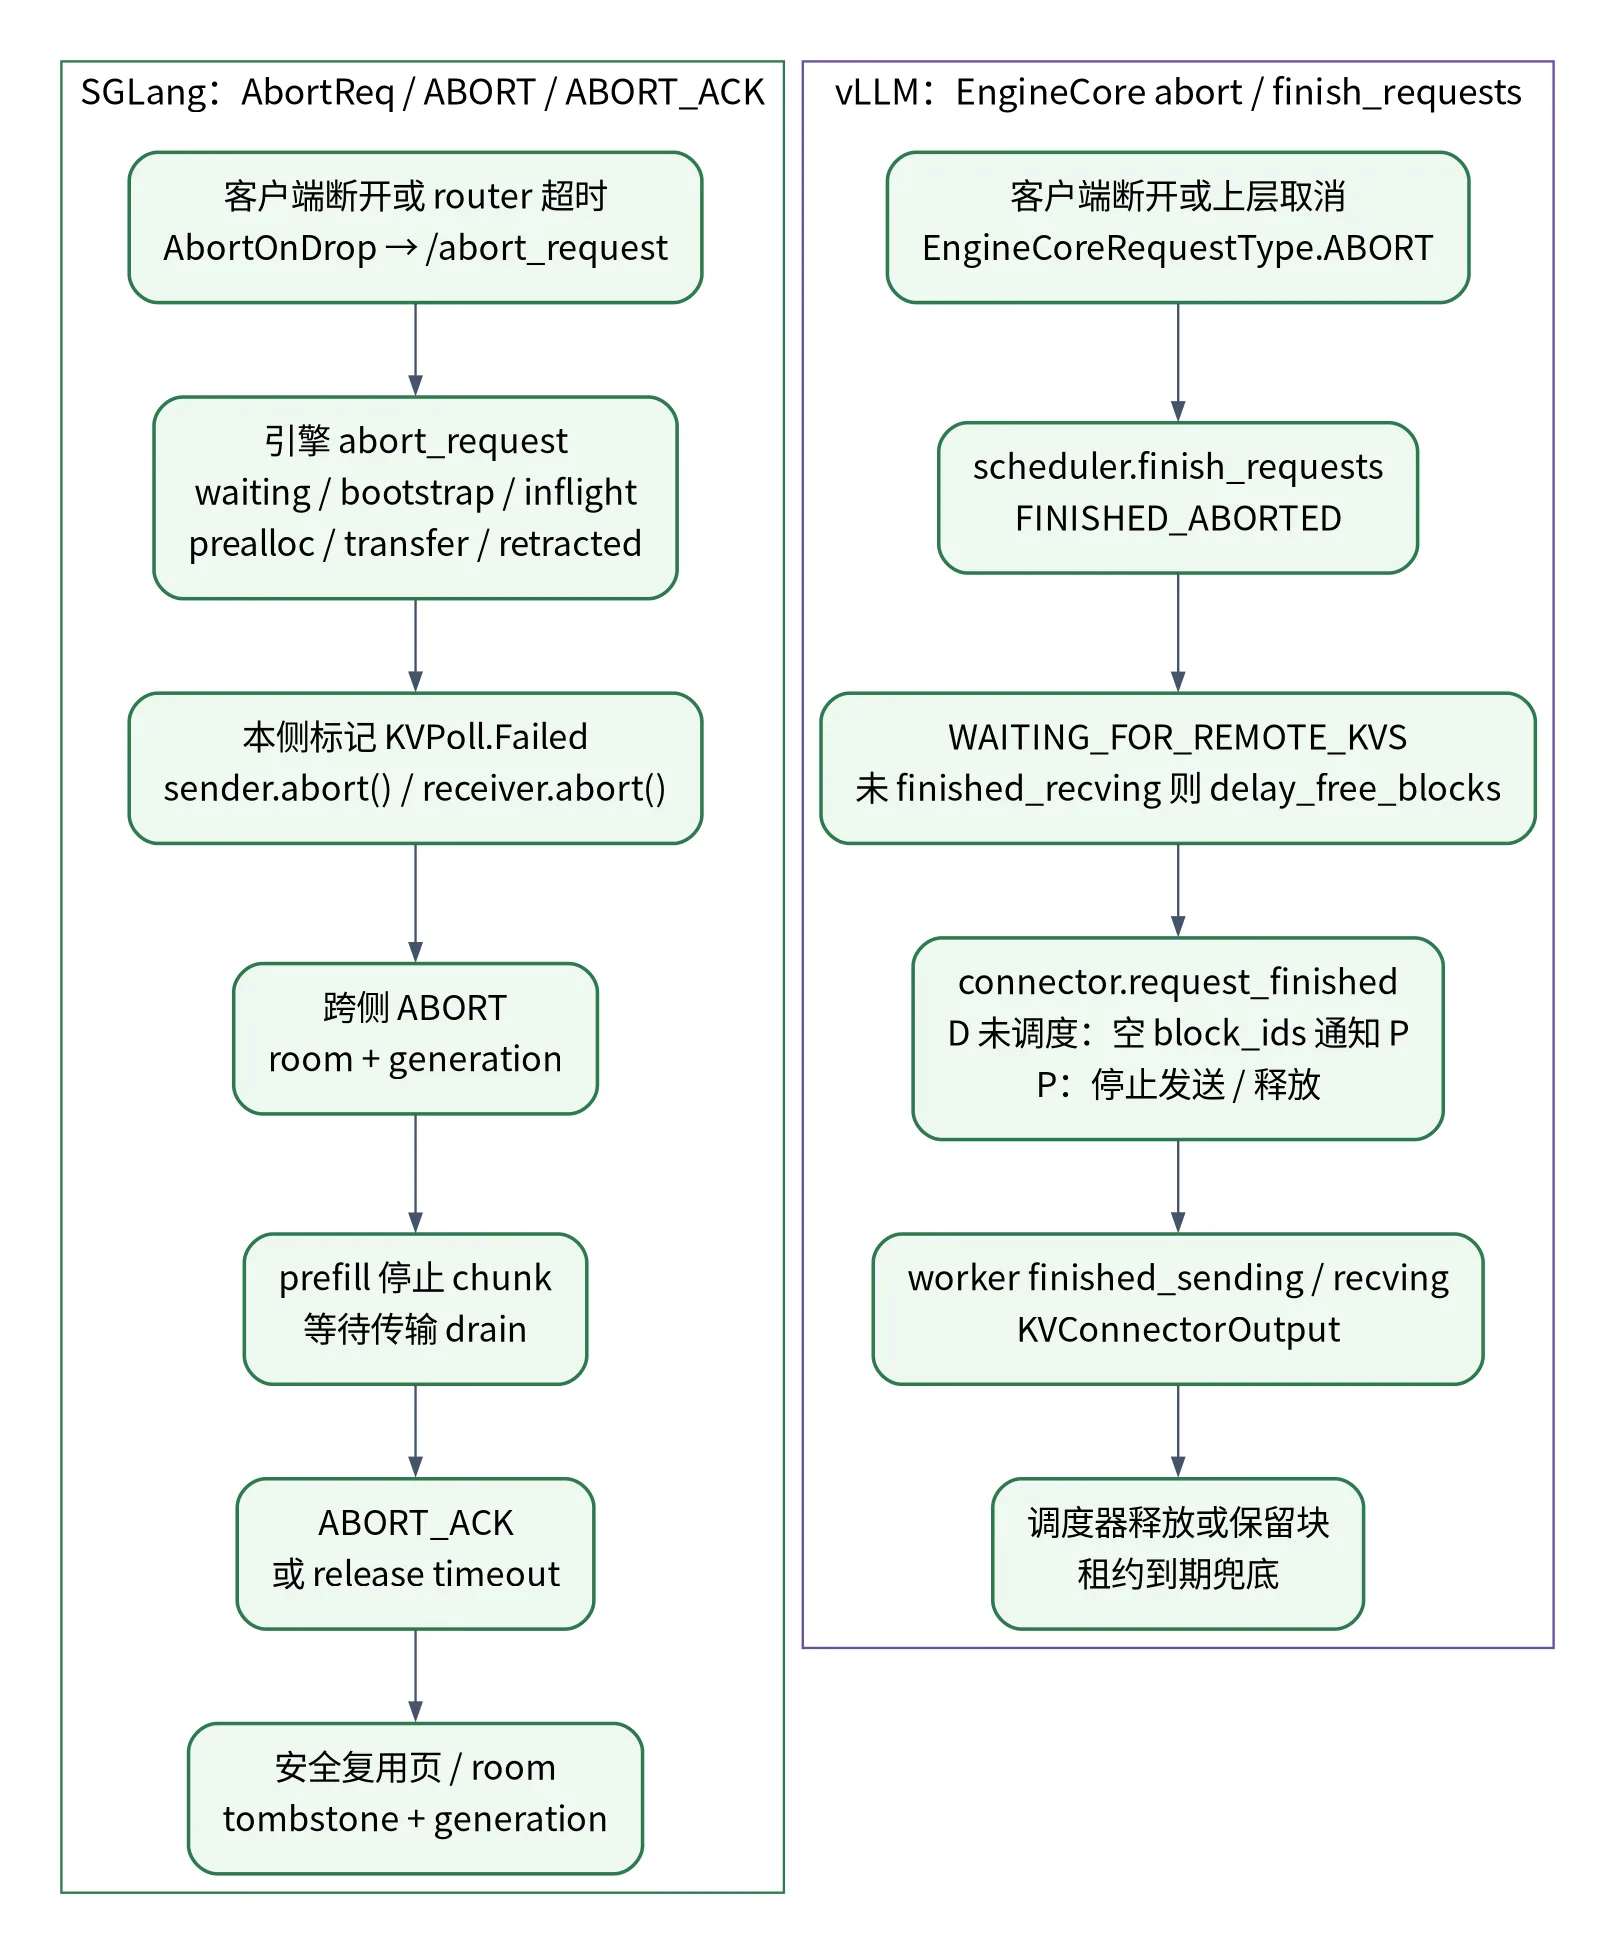
把两侧的取消路径放在一起,可以归纳出三条边界:
- device 页可以立即放,host staging 页要等 drain ACK。device 写有 CUDA stream 顺序,host 写没有;SGLang 的 deferred release 和 vLLM 的
delay_free_blocks都在处理这条边界。 - metadata buffer 可以立即放,但 transfer 的最后一个 chunk 不能。SGLang 的
clear_pending_chunk_send会在释放 metadata 之前清掉“已发未确认”的 chunk;vLLM 的finished_sending则在_free_blocks之前由 connector 统一收口。 - room/request id 不能立即复用。SGLang 的 tombstone 和 generation、vLLM 的 request id 去重,都是为了防止迟到的消息挂到新请求上。
失败:超时、节点死亡、传输错误
取消是“主动放弃”,失败是“被动终止”。PD 的失败模式比取消多,因为对侧可能已经死了,消息发不出去,本地只能靠超时和心跳来判断。
SGLang 的三类失败
第一类:bootstrap 超时。 prefill 的 CommonKVSender._check_bootstrap_timeout 从 init_time 开始计时,默认 300 秒:
start = ( self._prefill_complete_time if self.kv_mgr.defer_decode_allocation else self.init_time)elapsed = time.time() - startif elapsed < self.kv_mgr.bootstrap_timeout: return None超时后,sender 记录 failure reason,把 room 标 Failed。decode 的 CommonKVReceiver._check_waiting_timeout 从 send_metadata 的 init_time 开始计时,也是 300 秒;超时后除了标 Failed,还会主动发 ABORT,让 prefill 停止等待。
这里有两个不同的计时起点,容易混:
- prefill 的 bootstrap timeout 等的是“decode 的 metadata 什么时候到”;
- decode 的 waiting timeout 等的是“prefill 的 KV 什么时候发完”。
early 策略下,这两个阶段是串行的:decode 先发 metadata,prefill 再算 prefill。prefill 的 300 秒覆盖“从 sender 创建到 metadata 到达”;decode 的 300 秒覆盖“从 metadata 发出到 KV 完成”。如果 prefill 的排队时间很长,decode 的 waiting timeout 可能先到,即使 prefill 还没开始算。这就是为什么 SGLang 允许用 SGLANG_DISAGGREGATION_WAITING_TIMEOUT 单独调大 decode 侧的超时。
第二类:prefill 节点死亡。 decode 的 CommonKVManager 启动一个 heartbeat_checker 线程,默认每 5 秒请求一次每个 prefill 的 /health;连续失败 2 次就调用 _handle_node_failure:
self.heartbeat_interval = max( envs.SGLANG_DISAGGREGATION_HEARTBEAT_INTERVAL.get(), 2.0)self.max_failures = max( envs.SGLANG_DISAGGREGATION_HEARTBEAT_MAX_FAILURE.get(), 1)失败处理会清掉 connection_pool、prefill_info_table,断开缓存的 ZMQ PUSH socket,然后把 addr_to_rooms_tracker 里属于该 prefill 的所有 room 标 Failed。这个机制只覆盖“bootstrap server 还活着,但 prefill 数据面已经死了”的情况;如果整个 prefill 进程死了,bootstrap server 的 /health 也会失败,decode 会在 2 个心跳周期内发现。
第三类:传输失败。 SGLang 的 transfer worker 在发送 chunk 时检查 room 状态;如果 state 不是 Transferring,就跳过。真正的失败信号来自 poll == KVPoll.Failed:
- prefill 的
handle_inflight_transfer_failure会调用sender.failure_exception(),记录异常、abort trace、释放 KV cache,并把请求的 finish reason 设为FINISH_ABORT(如果之前没有); - decode 的
pop_transferred看到Failed,调用_abort_failed_transfer,再prepare_abort,把请求从 transfer queue 摘掉。
SGLang 还支持可选的 KV checksum:prefill 在 metadata buffer 里写一份 checksum,decode 在 _commit_transfer_to_req 里保存 expected_kv_checksum,进 batch 前再校验。校验失败会走 _handle_kv_checksum_mismatch,把请求 abort。这个功能默认关闭,因为 57GB 的校验本身要读一遍全部 KV,代价不小;但在“传输层没有端到端校验”的 RDMA 环境里,它是唯一能发现静默损坏的手段。
vLLM 的三类失败
第一类:握手/布局不兼容。 NIXL 的握手带一个 compatibility_hash,覆盖 vLLM 版本、模型、dtype、KV cache 布局、attention backend 等。prefill 和 decode 的 hash 不一致时,worker 直接抛 RuntimeError,请求失败。这个检查比 SGLang 的 /route 校验更早:它在数据面连接建立时发生,不需要等到第一页传输。
NixlAgentMetadata 还会校验 engine_id、tp_size、dcp_size、pp_size 和 region_group_ids。如果 decode 的 TP 拓扑与 prefill 的 block 布局不匹配,_validate_remote_parallel_config 会失败。GLM-5.3 的 MLA 在 TP8 下每个 rank 持有完整 KV 头的切片;如果 prefill 是 TP8、decode 是 TP4,block 里的 head 布局对不上,必须拒绝,而不是做隐式重排。
第二类:接收失败。 NIXL worker 的 get_transfer_results 会返回三组信息:
return KVConnectorTransferResults( finished_sending=done_sending, finished_recving=done_recving, failed_recving=failed_recv_reqs,)failed_recving 是“请求级”的失败集合,比 invalid_block_ids 更适合多 KV group 的模型,因为 block id 只在组内唯一。调度器的 _handle_invalid_blocks 会先处理 invalid_block_ids,再处理 failed_recving;失败策略由 kv_load_failure_policy 决定:
kv_load_failure_policy: Literal["recompute", "fail"] = "fail"默认是 fail:请求直接 FINISHED_ERROR,客户端收到错误。recompute 则把 num_computed_tokens 截断到第一个失败块之前,重新调度请求,让 decode 自己重算缺失的块。对 1M 请求,recompute 的代价是重算最多 1M token 的 prefill;但它比重试整条 PD 链路更便宜,因为本地块还在,只是缺了一段远端 KV。
第三类:远端死亡/租约过期。 vLLM 没有 SGLang 那样的 /health 心跳,而是用块租约:prefill 在 request_finished 时给块设置 remote_blocks_expiry_time,decode 的调度器按 _heartbeat_interval = _kv_lease_duration // 6 发心跳;worker 收到 HB:req1,req2,... 后把租约延长 _lease_extension。如果 decode 死了,prefill 的 _reap_expired_send_leases 会在租约到期后释放块,避免 57GB 永久占着。
租约过期后,decode 如果还活着但一直没来拉,会看到 failed_recving 或 invalid_block_ids,请求失败。这个设计的代价是“prefill 可能在 decode 还没开始拉之前就把块放了”;所以 decoder_kv_blocks_ttl 默认 480 秒,比一般的传输时间长得多。对 1M 请求,480 秒的租约足够覆盖排队和传输,但不能覆盖“decode 被上层暂停几分钟”的场景;那种场景需要调大 TTL 或改用 kv_load_failure_policy=recompute。
失败处理的共同原则
两套实现虽然机制不同,但失败处理遵循同一组原则:
- 失败要在最早的可判定点发生。布局、页大小、TP 拓扑、compatibility hash 都在握手阶段校验,不等到第一页数据。
- 失败必须同时终止两侧的状态机。SGLang 的
KVPoll.Failed会被 sender 和 receiver 同时看到;vLLM 的failed_recving回到调度器,同时request_finished让 connector 清理远端状态。 - 失败后的页不能立即复用。SGLang 用 tombstone + generation,vLLM 用
delay_free_blocks+finished_sending/recving。 - 失败要能被上层观察到。SGLang 的
prepare_abort会把错误写进输出流;vLLM 的FINISHED_ERROR带RequestError。没有可观测性的失败,在下一次请求里会变成“偶发输出错误”。
两侧并排看:控制面的一张长表
把前面拆开的细节压成一张表,方便和第四篇的数据面对照:
| 维度 | SGLang | vLLM |
|---|---|---|
| 配对标识 | bootstrap_room(63 位随机数) | (remote_engine_id, remote_request_id) |
| 配对生成 | router 铸 room,随两段请求注入 | prefill 在响应里返回 kv_transfer_params |
| 远端定位 | bootstrap server /route 返回 rank_ip:port | connector 的远端引擎表 + side channel 地址 |
| 拓扑校验 | 注册时校验 page_size/kv_dtype/kv_layout/dsv41_spec_layout | 握手时校验 compatibility hash + NixlAgentMetadata |
| 准入策略 | early / prefill_complete | 固定为“decode 先分配、再异步加载” |
| 准入状态 | KVPoll.Bootstrapping/WaitingForInput | WAITING_FOR_REMOTE_KVS |
| 完成信号 | sender/receiver poll() == Success | finished_recving 回到 KVConnectorOutput |
| 取消协议 | AbortReq → ABORT / ABORT_ACK | EngineCore.abort_requests → finish_requests |
| 取消后的页 | deferred release + generation | delay_free_blocks + connector 完成回调 |
| 超时 | bootstrap 300s、waiting 300s、heartbeat 5s×2 | 块租约(默认 kv_lease_duration,decode 侧 480s) |
| 节点死亡 | /health 心跳,2 次失败标所有 room Failed | 租约过期,prefill 释放块,decode 收 failed_recving |
| 传输失败 | KVPoll.Failed + 可选 checksum | failed_recving / invalid_block_ids |
| 失败策略 | abort 请求,错误写输出流 | kv_load_failure_policy=fail/recompute |
| 控制面消息量 | 页号数组 + 拓扑/room 元数据,几十 KB–几 MB | remote_block_ids + params,几百 KB–几 MB |
| 页复用保护 | room tombstone + generation + drain ACK | 块租约 + delay free + worker 完成回调 |
这张表里最值得注意的一行是“准入策略”:SGLang 给了 early 与 prefill_complete 两个选择,vLLM 的 NIXL pull 路径默认就是“decode 先分配,再异步拉”。这不是说 vLLM 没有容量问题,而是它把容量问题交给了 KVCacheManager 的 block 分配和 WAITING_FOR_REMOTE_KVS 状态;decode 在 get_num_new_matched_tokens 返回正数后,调度器会分配本地块并把请求放进等待状态,和 SGLang 的 early 语义接近。
把控制面压进一条 1M 请求的时间线
把上面的状态机放回 GLM-5.3 的 1M 请求,时间线大致是这样:
| 阶段 | 控制面事件 | 数据面事件 | 关键资源 |
|---|---|---|---|
| 路由 | router 选 P/D,铸 room,注入 bootstrap_host/port/room | 无 | room、rid |
| prefill 注册 | 每个 prefill rank 向 bootstrap server PUT 拓扑 | 无 | bootstrap 注册表 |
| decode 握手 | receiver /route 拉地址,校验页大小/布局/策略 | 无 | prefill_info_table |
| decode 准入 | pop_preallocated 分配 16384 个 64-token 页 | 无 | decode KV 页池 |
| 发 metadata | send_metadata 发页号、aux/state indices | 无 | ZMQ 控制 socket |
| prefill 准入 | pop_bootstrapped finalize sender,分配 metadata buffer | 无 | metadata buffer |
| prefill 计算 | 每 chunk 后 send_kv_chunk | 主 KV 逐层写、索引器同层发 | prefill 显存、RDMA |
| 传输完成 | sender/receiver poll() 到 Success | 57GB 到齐 | decode 页 |
| decode 调度 | 请求从 transfer queue 进 waiting queue | 第一层 decode 读 KV | decode batch |
| 结束/取消 | AbortReq 或 finish_requests;ABORT/ACK | 停止发送、释放页 | room/generation、块租约 |
这张表里,控制面事件全部落在 57GB 传输的两端:前面是“配对 + 准入”,后面是“完成 + 收尾”。数据面传输本身在 400GB/s 线速下约 0.14 秒,按 60%–80% 有效带宽算是 0.18–0.23 秒;控制面的 HTTP/ZMQ 往返是毫秒级,看起来可以忽略。但控制面的真正成本不在消息大小,而在等待:
- decode 的
pop_preallocated如果因为页池碎片化拿不到 16384 个连续页,会等几百毫秒到几秒; - prefill 的
pop_bootstrapped如果 metadata buffer 满了,会等下一个调度循环; - early 策略下,decode 的 57GB 页在整段 prefill 时间里被占着,其他请求的 TTFT 会被拉长;
- prefill_complete 策略下,prefill 的 KV 留在显存里等 decode 分配,prefill 的 batch 容量会被压缩。
所以控制面的优化目标不是“把握手消息压小”,而是“把等待从关键路径上移走”。SGLang 的 early/prefill_complete 是在“decode 容量等待”和“prefill 容量等待”之间做选择;vLLM 的租约和异步 pull 是在“prefill 块保留时间”和“decode 重算概率”之间做选择。两者都没有消除等待,只是把等待放到了不同的池子里。
工程清单:上线前要逐条核对的控制面项
把两套源码里的硬约束整理成一张检查表:
- 页大小、KV dtype、KV layout 必须两侧一致。SGLang 在
/route校验,vLLM 在 compatibility hash 校验;GLM-5.3 的fp8_ds_mla656B 布局不能在 decode 侧按 576B 解释。 - TP/CP/PP 拓扑必须在注册表里完整。SGLang 的
_is_ready按dp × cp × tp × pp计数;少一个 rank 就 503。vLLM 的NixlAgentMetadata校验tp_size/dcp_size/pp_size。 - room 必须唯一,且由 router 生成。不要把客户端
request_id直接当 room;SGLang 的abort_request是前缀匹配,短 id 会误伤。 - early/prefill_complete 必须两侧一致。SGLang 的 bootstrap server 会在注册时拒绝不一致的 policy;混用会让两侧对“页什么时候该存在”的判断相反。
- 超时预算要覆盖最慢的 prefill。默认 300s 对 1M 请求可能不够;调大
SGLANG_DISAGGREGATION_BOOTSTRAP_TIMEOUT/WAITING_TIMEOUT,或用 prefill_complete 把等待拆成两段。 - 心跳和租约要能覆盖 decode 的排队时间。SGLang 的
/health5s×2 适合快速发现节点死亡;vLLM 的块租约要按最长排队时间调decoder_kv_blocks_ttl。 - 取消后的页要等 drain ACK 或完成回调。host staging 尤其不能立即复用;SGLang 的
is_abort_release_safe和 vLLM 的delay_free_blocks是两条必须保留的路径。 - prompt token 要复用。PD 两段各自渲染模板、各自分词,任何非确定性都会让 KV 位置错位。vLLM 的
return_token_ids+prompt_token_ids是标准做法;SGLang 的 tokenizer manager 也要保证两段拿到同一组 id。 - 控制面指标要能定位到 room/request。至少记录
rid、bootstrap_room、prefill_dp_rank、target_tp_rank、KVPoll状态、失败原因;没有这些字段,线上只能看到“TTFT 变长”,无法判断是握手、准入还是传输。
小结
把 PD 控制面压成几句话:
- 控制面回答三个问题:配对、准入、收尾。 SGLang 用 router 铸 room + bootstrap 注册表 +
KVPoll;vLLM 用kv_transfer_params+ connector 钩子 +WAITING_FOR_REMOTE_KVS。 - room 是请求的临时地址簿,不是可复用的槽位。 63 位随机数、
room % dp_ranks的 DP 约束、tombstone 和 generation,都是为了防止迟到消息挂到新请求上。 - 准入策略决定 57GB 的页什么时候被占。 early 让 decode 提前占页、换取 chunk 与传输重叠;prefill_complete 把占页推迟到最后、换取 decode 容量,但要求 Mooncake、TP/CP/PP=1 和 optimistic prefill。
- 取消要跨两侧传播,且释放顺序不能反。
ABORT/ABORT_ACK与finish_requests/delay_free_blocks都在解决同一件事:对侧可能还在写,本侧不能先把页还给池子。 - 失败要尽早判定、同时终止两侧、保留可观测性。 布局哈希、
/route校验、KVPoll.Failed、failed_recving都是把静默错误变成显式错误的机制。
第四篇讲的是 57GB 怎样在数据面上走完;这一篇讲的是在这 57GB 开始走之前和走完之后,两侧的控制面怎样保证“走的是同一条请求、走到的是同一组页、走完之前没有人把页拿走”。把两篇连起来,GLM-5.3 的 PD 分离才算完整:数据面决定传输多快,控制面决定传输是否可信。
参考资料
- SGLang 源码:
python/sglang/srt/disaggregation/prefill.py - SGLang 源码:
python/sglang/srt/disaggregation/decode.py - SGLang 源码:
python/sglang/srt/disaggregation/common/bootstrap.py - SGLang 源码:
python/sglang/srt/disaggregation/common/conn.py - SGLang 源码:
python/sglang/srt/managers/scheduler.py的abort_request - SGLang Router 源码:
sgl-router/src/proxy/abort.rs - SGLang Router 源码:
sgl-router/src/server/routes/chat/forward.rs - SGLang 文档:PD Disaggregation
- vLLM 源码:
vllm/v1/core/sched/scheduler.py - vLLM 源码:
vllm/v1/engine/core.py - vLLM 源码:
vllm/distributed/kv_transfer/kv_connector/v1/base.py - vLLM 源码:NIXL
pull_scheduler.py - vLLM 文档:Disaggregated Prefilling
- 站内:GLM-5.3 推理全链路(四):PD 分离——57GB KV 与索引器缓存如何跨节点交接
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



