


GLM-5.3 推理全链路(三):1M 上下文的 Prefill——分块预填、上下文并行与索引器的二次方账
前两篇讲的是 decode,这一篇补 prefill
前两篇沿着同一个 glm_moe_dsa 架构,分别走完了 SGLang 与 vLLM 里的一条 decode 请求:调度器如何拼 batch、每一层如何经过 A 投影、索引器、稀疏 MLA 与 MoE、MTP 如何把一次 step 变成 6 个 token 的验证。那条路径的每一步只处理“每条请求一个 token”,算术强度低,时间几乎全花在把权重和 KV 从 HBM 搬到 SM。
prefill 是另一条路径。一次请求带着几千到上百万个 token 进来,模型要在这些 token 上做一次因果前向,把每个 token 每层的 KV 算出来写进缓存,最后只取最后一个位置的 logits 去采样第一个输出 token。对 GLM-5.3 这种 78 层、744B 参数、1M 上下文的模型,prefill 的账与 decode 完全不同:
- 它受算力约束,而不是受权重带宽约束。 一次 prefill 的 token 数是 batch 内所有请求的输入长度之和,GEMM 的 维很大,算力密度远高于 decode;权重在这段前向里只被读一遍,分摊到每个 token 上可以忽略。
- 它受显存容量约束。 prefill 要把整段输入每层每 token 的 KV 写进缓存,写满之后这条请求才进入解码阶段;1M token 的主 KV 约 53.7GB,这个数字必须先被预留出来。
- 它还受一个多数模型没有的东西约束:DSA 索引器在长上下文下的全量打分。 稀疏注意力省掉了“对每个历史 token 做完整 576 维点积”,但没有省掉“对每个历史 token 的 128 维索引向量打分”。prefill 有 个 query,每个 query 要对整个前缀打分,于是索引器在 prefill 上是 的,而主注意力是 。
这篇文章只回答一个问题:一条长上下文请求进入 SGLang 之后,prefill 阶段实际经过哪些算子、哪些通信,为什么 TTFT 会落在现在这个量级。 所有数字都从 GLM-5.3 的 config 与 SGLang 的源码推出来,并和已经上线的 decode 路径对齐。
前面两篇都以 decode 为主,prefill 只在讨论 batch 形态时顺带提过。要把同一条请求在 vLLM 里的走法讲清楚,先得有一条基准:vLLM 在 chunk 元数据、索引组复用和 KV 布局上的差异,只有先把 SGLang 这条 prefill 路径的账算清楚才看得懂。
先把模型常量摆出来
模型配置直接决定了 prefill 的每一笔账。GLM-5.3 的 config.json 里与 prefill 相关的字段如下(主干参数与 DeepSeek-V3.2 一致):
| 配置项 | 值 | 对 prefill 的意义 |
|---|---|---|
num_hidden_layers | 78 | 一次前向要完整走 78 层 |
hidden_size | 6144 | 每 token 每层残差流宽度 |
num_attention_heads | 64 | Q 头数;prefill 主注意力按头并行 |
qk_nope_head_dim / qk_rope_head_dim | 192 / 64 | Q/K 每头 256 维,其中 64 维 RoPE |
v_head_dim | 256 | V 每头 256 维 |
q_lora_rank / kv_lora_rank | 2048 / 512 | Q 低秩与 KV 潜向量维度 |
index_topk | 2048 | 每个 query 最终只对 2048 个历史 token 做稀疏注意力 |
index_head_dim / index_n_heads | 128 / 32 | 索引器的 K 维度与打分头数 |
index_topk_freq | 4 | 每 4 层重新算一次 Top-K,其余层复用 |
indexer_types | 78 项,full / shared | 第 0、1、2 层 full,之后每 4 层一个 full |
n_routed_experts / num_experts_per_tok | 256 / 8 | MoE 每层 256 选 8 |
first_k_dense_replace | 3 | 前 3 层稠密 MLP |
max_position_embeddings | 1,048,576 | 1M 上下文 |
index_topk_freq = 4 与 indexer_types 说的是同一件事:78 层里哪些层要自己做索引器打分。按 full 的分布数下来,第 0 到第 2 层连续三个 full,之后每 4 层一个 full,到第 77 层一共 21 个 full、57 个 shared。这是 GLM-5.3 与 DeepSeek-V3.2 共用的“跨层复用 Top-K”结构,decode 那一篇里已经讲过它如何把索引器的计算砍掉约四分之三。
prefill 里同一个结构的作用更大,因为每一层一次要处理 个 query:
- full 层: 个 query 各自对整个前缀打分,计算量随 增长;
- shared 层:不计算索引,直接拿来上一层已经选好的 2048 个下标,对每个 query 只做 2048 个 key 的稀疏注意力。
整个模型的前向因此是“21 层平方 + 57 层线性”。GLM-5.3 长上下文 prefill 的全部算力、显存与通信账,都是从这个混合结构里长出来的。
分块预填:一条 1M 请求如何被切成很多块
prefill 面对的第一件事不是算力,而是“一次能吃下多少 token”。如果在一次前向里塞进 1M 个 token:
- 激活值会爆掉。每层中间激活是 ,MoE 中间是 ,按 bf16 算,1M token 一层就要十几 GB;
- 索引器的打分矩阵会爆掉。 个 query × 个 key 的 fp32 logits 是 字节, 时是 4TB;
- TTFT 会被一条超长请求独占,后面的短请求只能排队。
SGLang 的做法是分块预填(chunked prefill):把一条长请求的输入切成若干块,每块不超过 --chunked-prefill-size 个 token,每次调度只跑一块,块与块之间可以插入其它请求的 decode 或 prefill。GLM-5.3 cookbook 对长输入、均衡负载的建议是从 --chunked-prefill-size 32768 起步,再按输入长度与 KV 容量调整。
调度器如何决定“这一块切到哪里”
这块逻辑在 PrefillAdder 里(managers/schedule_policy.py)。一条请求被接纳后,调度器先看前缀命中了多少(req.prefix_len),再算出“还没算的输入长度” cand_extend_input_len,然后用两重预算把它截成一个块:
_rem_tokens = self.memory_budget.available_chunk_tokens(self.rem_chunk_tokens)...cand_extend_input_len = len(req.full_untruncated_fill_ids) - req.prefix_len_rem_tokens = self.memory_budget.fit_chunk( extend_input_len=cand_extend_input_len, max_new_tokens=self._swa_new_tokens(req), chunk_limit=_rem_tokens,)truncated = cand_extend_input_len > _rem_tokensnew_len = min(cand_extend_input_len, _rem_tokens)req.extend_end = req.prefix_len + new_len三行决定了这条请求在这一步的命运:
available_chunk_tokens返回“本步还剩多少 chunk token 预算”。它同时受两步限制:全局的rem_chunk_tokens(本步所有请求共享的 token 预算)与memory_budget(KV 池里还能挤出多少 slot);fit_chunk再按“这条请求的 KV 预算”收缩一次——它不仅要为这 个新 token 写 KV,还要为它之后的解码预留 max_new_tokens 的位置;- 如果
truncated为真,这次只跑一个前缀块,请求被放回“被分块”的状态,下一次调度继续。
这里有一个常被忽略的设计:chunk 的边界与 KV 页面对齐。在开启 DP attention 的 KV shard 模式下,代码会把边界向下取整到页粒度:
if self.kv_shard_granule: prefix_len = req.prefix_len floored = (prefix_len + _rem_tokens) // self.kv_shard_granule \ * self.kv_shard_granule - prefix_len _rem_tokens = floored if floored > 0 else self.rem_chunk_tokens原因在于 SGLang 的 KV shard 会把物理页按 rank 交错分配,一个 chunk 的开头与结尾若都落在同一段页内,读写都只需要一段连续地址;跨页则要额外处理头部和尾部的部分页。
分块对 DSA 的副作用:每一块都要重新读前缀的索引 K
分块预填并不是“把 等分就完事”。对 DSA 模型,第 块里的每个 query 仍然要对已经写进缓存的前缀做索引打分,所以第 块的索引器工作量是“ 个 query × 前缀长度 ”,其中 是这块开始前已经提交的 token 数( 为前缀缓存命中长度)。
把 21 个 full 层在整个请求上的打分元素总数写出来:
前缀命中 的那部分不能省:即使 个 token 的 KV 已经在缓存里,索引器仍要对它们打分,才能选出这一块的 Top-K。真正随 增长的是块内那部分: 块内部的 query 与 key (都在同一块内)构成 对(因果下取一半),这部分不随分块次数改变,只随块大小 变小。对整条请求:
分块大小对这三项的影响各不相同。块内项 与块数成反比,块切得越细,块内平方项越小。跨块项 对 是平方的,但它与块数基本无关——这一项的存在说明“每个新 query 都要对全部已提交前缀打分”是分块预填改变不了的;每多一块,就要把前面所有已提交的索引 K 再读一遍,所以索引 K 的总读取量随块数 线性增长()。前缀项 每块都要重读一次,与块数成正比。这就是分块预填在 DSA 上的代价:用显存峰值与调度灵活性,换来了前缀 KV 的重复读取,重复的量与块数成正比。
对 1M 上下文,、、块大小 (),块内项约 个打分元素,跨块项约 。跨块项占了 97%。而每块的索引 K 读取量是 21 层 × 块开始时已有的前缀长度 × 132 字节,32 块加起来约 字节。这个数就是分块预填对 DSA 长上下文最直接的带宽账单,也是块不能切得太小的原因。
一个 1M 请求的调度时间线
把调度器的视角补上。M、--chunked-prefill-size 32768 时,这条请求会被拆成 32 个 chunk。每个调度 step 里,PrefillAdder 先看等待队列,把这条请求的下一块放进去,再尽量塞入其它短请求的 prefill 或正在解码请求的 decode token。时间线大致是:
| step | 本块范围 | 块开始时前缀 | 本步主要工作 |
|---|---|---|---|
| 1 | 0 – 32767 | 0 | 32K query 对 32K key,索引器块内平方项最大 |
| 2 | 32768 – 65535 | 32768 | 32K query 对 32K 前缀 + 块内 |
| … | … | … | 前缀每步增加 32K,索引 K 读取线性增长 |
| 32 | 1015808 – 1048575 | 1015808 | 最后一块;只有它的最后一行进入采样 |
这张表里有一个容易被忽略的变化:前三块的索引器计算量还比较小,越往后越贵,第 32 块的每个 query 要扫近 1M 个 key。1M prefill 的耗时曲线因此是“前快后慢”——不是模型变慢,而是索引器的前缀在变长。块切小能让后面的块更早开始、与其它请求交错,但总计算量不变;块切大则单块更久、前缀重复读更少。
每一块也不是“前一块跑完再跑下一块”这么简单。开启 DP Attention 与 EP 时,一个调度 step 里所有 rank 要一起执行:各 DP rank 先对自己的请求做注意力(没有跨卡通信),dp_gather 把各 rank 的 hidden 拼成全局 batch,MoE 在全局 batch 上按专家路由、走 dispatch/combine,dp_reduce_scatter 再把输出散回各 rank。prefill 的 chunk 有 32768 个 token,DP8 下每个 rank 约 4096 个;all_gather_into_tensor 要求各 rank 的 token 数相同,变长 chunk 会先 pad 到最大长度,pad 出来的行在 MoE 里要被 mask,否则会路由到专家、浪费带宽。
另一个细节是 --enable-mixed-chunk:允许 decode token 与 prefill chunk 在同一个 batch 里。对 GLM-5.3,它与 q8 稀疏 prefill 不兼容(q8 只支持 RAGGED extend),但默认配置下能显著降低短请求的排队延迟:正在解码的请求不用等长 prefill 跑完。代价是 prefill 的 batch 形状不再纯粹,CUDA Graph 捕获会变复杂。
如果这条请求命中了前缀缓存 个 token,第 1 块的 prefix_len 就是 ,KV 不需要重算,但索引器仍要对这 个 key 打分;同时 req.extend_end 从 开始,写入的 KV 只覆盖新增部分。前缀缓存把“投影 + KV 写入”省掉,把“索引选择”留下,这个区别在容量规划时经常被忽略。
一次 prefill 前向的算子清单
把一条请求的一个 chunk 当作一次前向来看。它和 decode 的差别集中在三处:MLA 走吸收形态而不是 MHA 形态、索引器走 ragged 路径、KV 是整块一次写入。其余部分与 decode 共用同一份 deepseek_v2.py。
入口:embedding 与 CP 切分
请求进入 ModelRunner 后,先取 input_ids,做词嵌入,得到 的 hidden states。开了 prefill CP(下文展开)时,这一步之后立刻把 hidden 与 position_ids 按 rank 切分:每个 rank 只保留属于自己的那一段 token,后续所有层的计算都只在本地 token 上进行。
一层里的算子顺序
对第 层(full 索引器层),prefill 的算子链如下:
- 输入 RMSNorm:
input_layernorm,逐 token 归一化; - A 投影:
fused_qkv_a_proj_with_mqa,输入 ,输出 ,即q_c、kv_c与k_pe一次算出; - q/kv 的 RMSNorm:
q_a_layernorm、kv_a_layernorm; - Q 上投影:
q_b_proj,; - Q 吸收:把
q_nope(每头 192 维)乘上 (),得到每头 512 维的q_nope_out;q_pe与k_pe走 RoPE。这一步是 bmm,不是kv_b_proj; - 索引器(仅 full 层):K 投影 + Hadamard 旋转 + FP8 量化 + 写索引 K 缓存,然后对前缀做分页 MQA 打分与 Top-K;
- 稀疏 MLA:按 Top-K 下标从分页缓存取 576 维的 KV latent,做 64 头 × 最多 2048 key 的注意力;Q 侧已经是 512 维吸收后的
q_nope_out加 64 维q_pe; - 输出吸收:注意力输出 乘 (),回到每头 256 维,再拼成 做
o_proj; - 残差 + FFN:前 3 层是稠密 MLP,其余 75 层是 MoE(门控 + 8 个路由专家 + 共享专家);
- 输出 RMSNorm,进入下一层。
shared 层跳过第 6 步,直接把上一层已经选好的 Top-K 传给第 7 步。第 5 步与第 8 步就是 MLA 的“吸收”:它让主注意力的 K/V 始终停留在 576 维的潜空间里,而不必把历史 token 展开成 64 头的完整 K/V。
一层 prefill 的算术:1313M FLOPs 花在哪
把第 层的每个算子按形状展开,以每 token 的 FLOPs 计( 个 token 再乘 )。这是一张 full 索引器层的账,shared 层要减掉索引器部分:
| 算子 | 形状 | 每 token FLOPs | 全模型合计(1M token) |
|---|---|---|---|
| A 投影 | 32.2M | 2.5 PFLOP | |
| Q 上投影 | 67.1M | 5.2 PFLOP | |
| Q 吸收 bmm | 12.6M | 1.0 PFLOP | |
| 索引 K 投影 | (21 层) | 1.6M | 0.03 PFLOP |
| 索引 Q 投影 | (21 层) | 16.8M | 0.35 PFLOP |
| 头门控投影 | (21 层) | 0.4M | 0.008 PFLOP |
| 稀疏 MLA(QK+PV) | 285M | 22.2 PFLOP | |
| 输出吸收 bmm | 16.8M | 1.3 PFLOP | |
| O 投影 | 201.3M | 15.7 PFLOP | |
| MoE(8 专家) | 604M | 45.3 PFLOP(75 层) | |
| 共享专家 | 75.5M | 5.7 PFLOP(75 层) | |
| 稠密 MLP | 453M | 1.4 PFLOP(3 层) | |
| 单层合计(full MoE 层) | — | ≈ 1.31G | 全模型 ≈ 100 PFLOP |
这张表把几个常见直觉纠正过来:
- MoE 的 8 个专家是最大单项之一,但不是全部。 45.3 PFLOP 占主干的一半左右;O 投影与 Q 上投影加起来 21 PFLOP,也不可忽略;
- 稀疏 MLA 只有 22 PFLOP。 因为每个 token 只对 2048 个 key 做 576 维点积,单个 token 的这部分开销与 无关,总计算量只随 线性增长;真正随 增长的是索引器;
- 索引器的参数只有 197M(21 层 × 9.4M),FLOPs 却接近主干的一半。 这就是“小参数、大计算”的典型:它的计算量来自 query × key 的组合数,而不是权重矩阵的规模。
把索引器的 94 PFLOP 与主干的 100 PFLOP 相加,1M prefill 的纯计算量约 194 PFLOP。按 8 张 H200 的有效算力 10–12 PFLOPS 估算,理论下限在 16–20 秒;但索引器是带宽受限的,单个算子的可达成算力远低于峰值,实际时间会被拉长,这就是后文 55–65 秒估算的来源。
两张 KV 账:主 KV 与索引 K
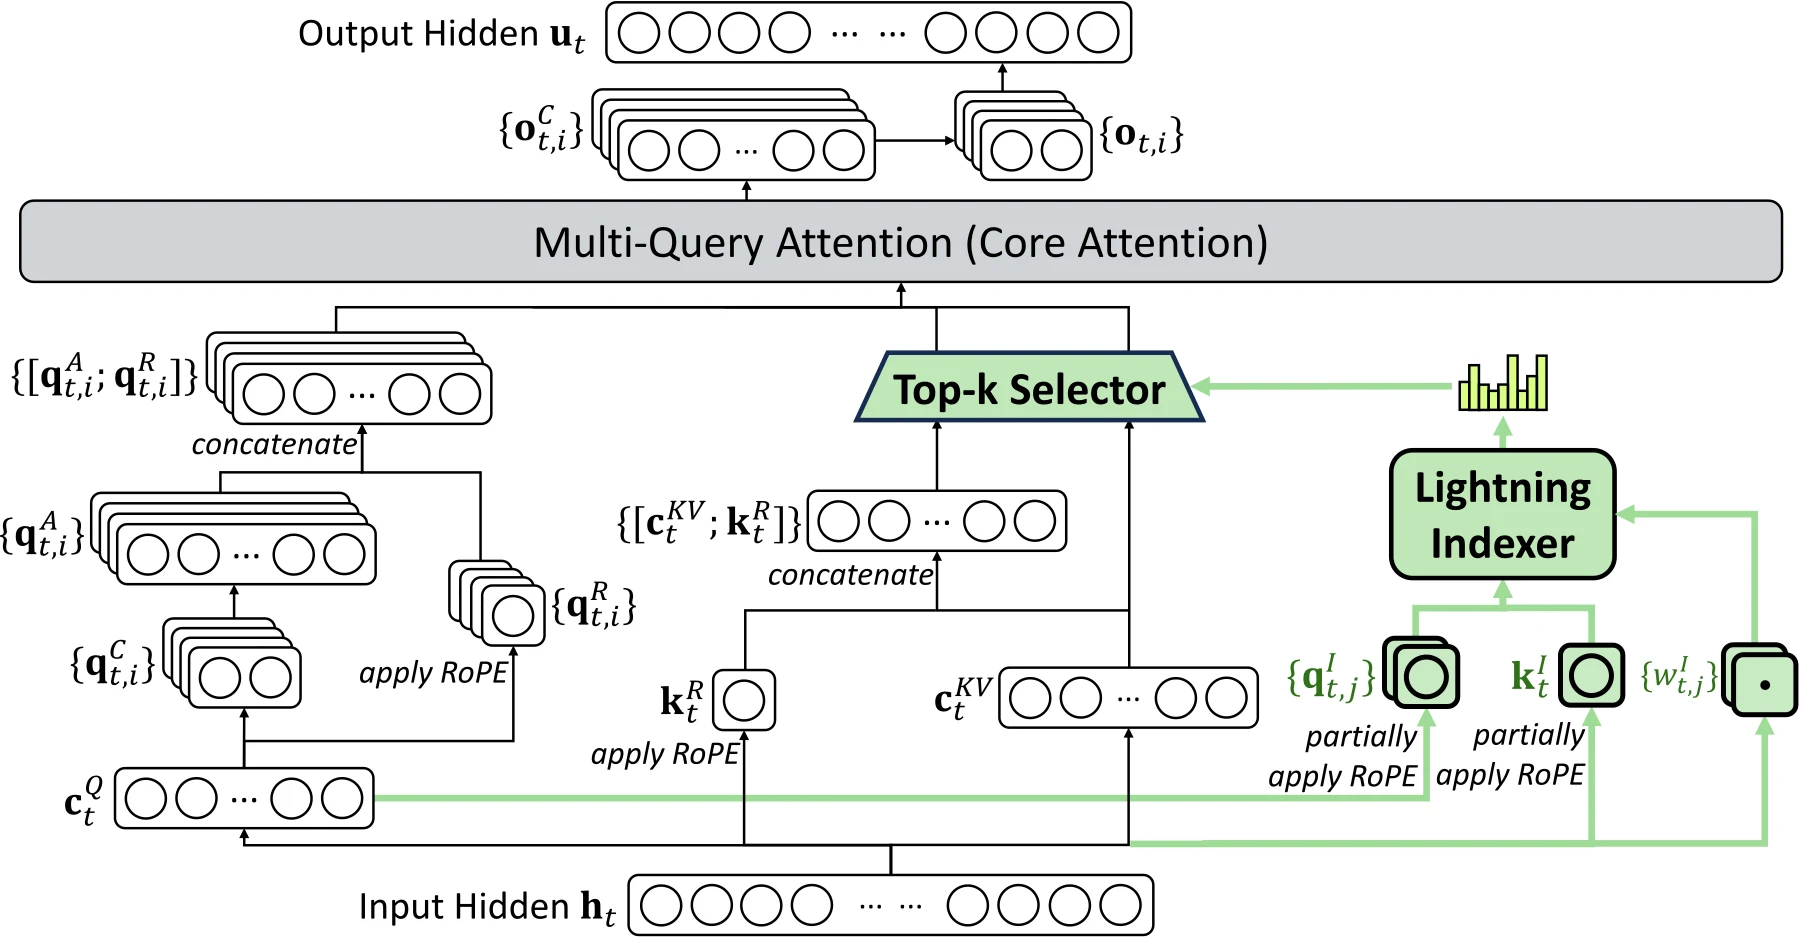
图源:DeepSeek-V3.2 技术报告(arXiv:2512.02556)中的 DSA / MLA 结构图。GLM-5.3 的
glm_moe_dsa复用同一结构。
这张图给出的关键信息是:索引器与主注意力用的是两份不同的 KV。
- 主注意力用 576 维的 MLA latent:512 维
kv_c加 64 维k_pe; - 索引器用 128 维的索引向量,独立投影、独立缓存,量化后每 token 占 132 字节(128 字节 FP8 加 4 字节 block scale)。
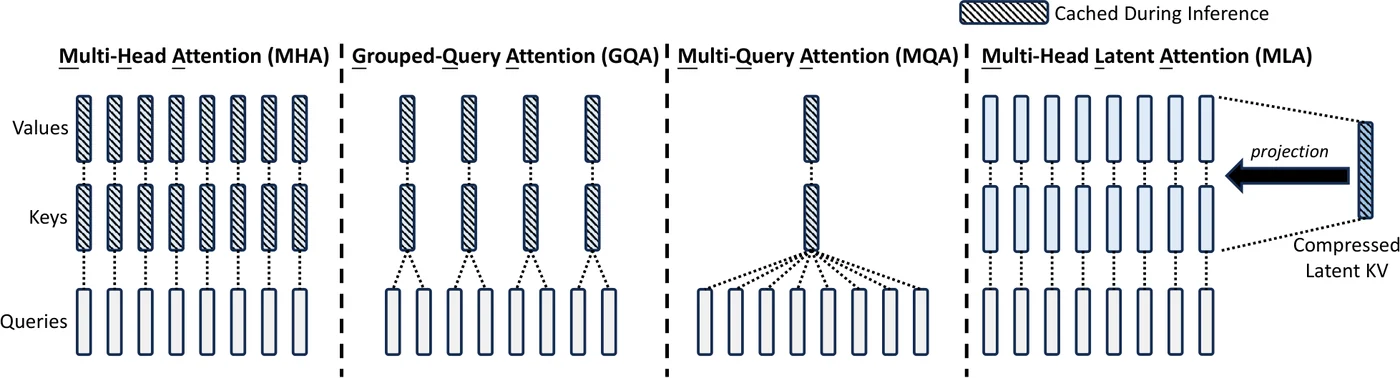
图源:DeepSeek-V2 论文(arXiv:2405.04434)中关于 MLA 与其他注意力机制 KV 缓存的对比图。GLM-5.3 的
kv_lora_rank = 512、qk_rope_head_dim = 64与这张图的口径一致。
完整 MHA 的 K/V 是每 token 每层 维;MLA 把它压到 576 维,约 50 倍。DSA 再在这个基础上做 token 维选择,但选择本身要先把全部历史 token 的 128 维索引向量读一遍。主 KV 的容量是 576 维 × 78 层,索引 K 的容量是 128 维 × 21 层;前者决定显存,后者决定 prefill 的索引器带宽。
prefill 走吸收形态,而不是 MHA 形态
decode 吸收后,kv_b_proj 完全不执行,注意力是“64 个 query 头对一份 576 维 KV 的 MQA”。prefill 是不是也这样?答案取决于序列长度,SGLang 在 set_dsa_prefill_impl 里画了一条硬线:
self.use_mha = ( self.supports_mha_one_shot and (device_sm == 90 or (100 <= device_sm < 110) or _IS_GFX95) and max_kv_len <= envs.SGLANG_DSA_PREFILL_DENSE_ATTN_KV_LEN_THRESHOLD.get() and self.token_to_kv_pool.dtype in [torch.bfloat16, torch.float8_e4m3fn] and sum_seq_lens <= forward_batch.get_max_chunk_capacity() and (not is_dsa_enable_prefill_cp()) and (self.hisparse_coordinator is None))SGLANG_DSA_PREFILL_DENSE_ATTN_KV_LEN_THRESHOLD 的默认值是 2048。也就是说:
- 短 prompt(前缀长度不超过 2048) 会走 MHA one-shot:把当前 chunk 与整个前缀的 K/V 用
kv_b_proj展开成 64 头的完整 K/V,交给 FlashAttention 类的 dense kernel; - 长上下文 prefill 一律走吸收 MLA:K/V 保持 576 维潜向量,
kv_b_proj不执行,注意力用稀疏 MLA kernel 直接读分页缓存。
对 1M 上下文,第一块就有 32768 个 token,max_kv_len 远大于 2048,所以整条请求从第一块开始就是吸收路径。这个阈值不是随手定的:MHA one-shot 的 K/V 包含前缀加当前 chunk 的全部 token,如果对 1M 前缀展开,单层临时 K/V 就是 字节 ≈ 57GB,要和 744GB 权重、KV 池抢同一张卡的显存,根本放不下。即使只看一个 32768 的 chunk,每层也要 GB 的临时 K/V,再叠加前缀缓存,收益远不足以抵消显存代价。
所以“prefill 用 MHA”这句话只对短 prompt 成立。长上下文 prefill 的真实算子链里,没有 kv_b_proj,只有 Q 吸收的 bmm 和输出吸收的 bmm。这两步的计算量是:
- Q 吸收:M FLOPs;
- 输出吸收:M FLOPs。
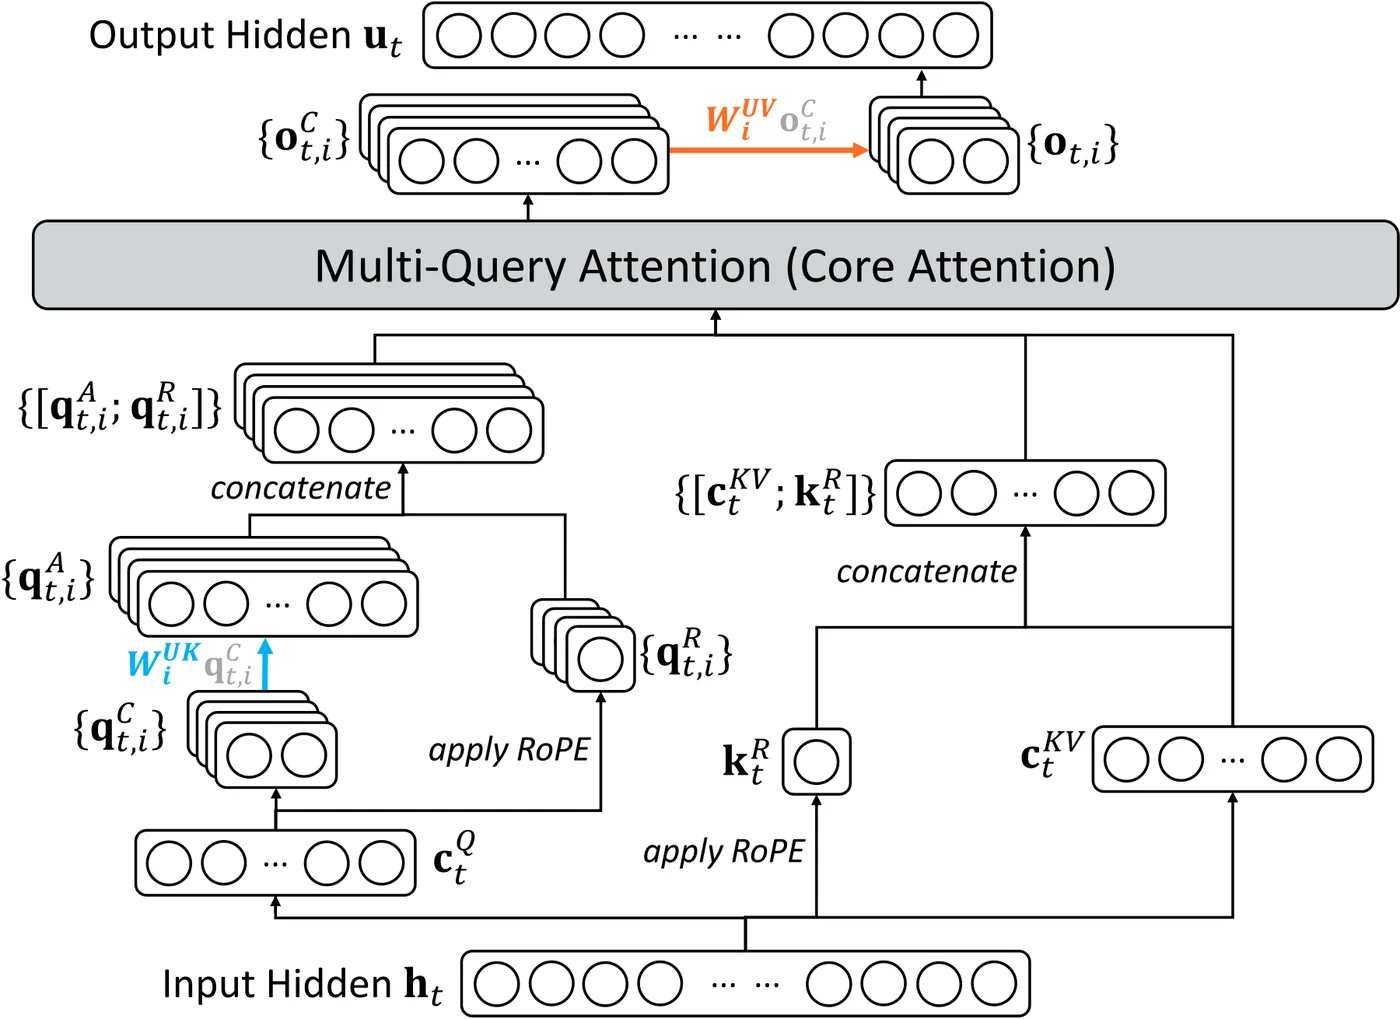
图源:DeepSeek-V3.2 技术报告(arXiv:2512.02556)附录中的 MLA MQA 模式示意图。prefill 的 query 是 个 token,但 KV 仍是每层一份 576 维潜向量,不是每 token 一份完整 K/V。
对 1M token,两项合计约 29.4 TFLOP,相对于索引器的近百 PFLOP 可以忽略。省掉 kv_b_proj 的意义不在算力,而在不物化 57GB 级的完整 K/V:它把 prefill 的显存峰值从“前缀长度的平方级临时张量”压回到“576 维分页缓存”。
索引器:prefill 的二次方项到底在算什么
索引器是 GLM-5.3 prefill 最值得单独讲的部分。它的参数量很小(每个 full 层约 9.4M),但它在长上下文下的计算量可以超过整个主干。
索引器一层做哪几件事
DeepseekV2AttentionMLA 在 full 层调用 indexer(...),内部按顺序做:
- K 投影:
wk,; - K 的 RMSNorm 与 RoPE:索引 K 也要位置信息;
- Hadamard 旋转与 FP8 量化:把 128 维向量转成 FP8,并算出一个 4 字节的 block scale,合计 132 字节写进索引 K 缓存;
- Q 投影:
wq_b,,输入是q_lora而不是 hidden; - 头门控:
weights_proj,,给 32 个索引头各一个权重; - 分页 MQA 打分:每个 query 的 32 个头分别与同一个 128 维索引 K 做点积,乘上门控权重求和,得到这个 query 对每个历史 token 的分数;
- 因果 mask 与 Top-K:只保留位置不超过当前 query 的 key,选出分数最高的
index_topk = 2048个下标; - 写回:Top-K 下标以 int32 形式传给主注意力;shared 层直接复用。
第 6 步是二次方项的来源。它不产生 的完整注意力矩阵,但会产生一个 的 fp32 logits 矩阵。对 32768 的 chunk 和 1M 的前缀,这个矩阵是 字节 ≈ 137GB,单张 H200 装不下,所以 SGLang 必须按 query 行再切一次。
为什么 Top-K 是 2048,而不是更大或更小
index_topk = 2048 是 DSA 在“选择精度”与“选择成本”之间的折中,它同时影响三笔账:
- 选择成本:索引器要对全部历史打分,这部分与 Top-K 无关;Top-K 越大,后续稀疏注意力的 KV 读取越多。每个 query 读 2048 个 KV,1M 上下文下是 1.18MB/层/query;如果 Top-K 翻倍,主注意力的 KV 读取也翻倍。
- 选择精度:Top-K 越小,漏掉关键 token 的概率越高。DSA 的假设是“每个 query 只需要少量关键 token”,但这个假设在需要精确回忆的任务(多跳检索、代码引用)上会更脆弱。GLM-5.3 用 21 个 full 层每隔 4 层重新选一次,就是为了让 shared 层的误差不连续累积。
- 跨层复用误差:57 个 shared 层直接复用上一层的 Top-K,如果层与层之间的注意力模式变化很大,复用就会选错。
index_topk_freq = 4是在“复用省下的计算”与“复用带来的误差”之间取的折中;21/78 的比例不是随意的,它是论文在长上下文评测上扫出来的工作点。
从系统角度看,2048 还有一个好处:它是 64 的整数倍,正好是 32 个 KV 页。Top-K 列表可以按页批量 gather,不需要处理页内偏移;如果选 2000 或 3000,页对齐就会被打破,gather 的地址算术会复杂很多。
logits 的显存预算:为什么一个 chunk 还要再切很多刀
_get_topk_ragged 在算 logits 之前先问 mqa_logits_should_chunk:
need_chunk, logits_budget_bytes = mqa_logits_should_chunk( num_rows=q_offset, num_cols=k_offset, get_budget_bytes=lambda: self._get_mqa_logits_budget_bytes(device_index), rocm=_is_hip,)预算不是拍脑袋给的,mqa_logits_static_budget_bytes 取两个上限的较小值:
total_mem_budget = int(total_mem * 0.3)static_free_mem = int(total_mem * max(0.0, 1.0 - mem_fraction_static))budget = min(int(static_free_mem * 0.2), total_mem_budget)在一张 141GB 的 H200、mem_fraction_static = 0.8 的典型配置下:
- 总显存的 30% 是 42.3GB;
- 静态预留之外的空闲是 28.2GB,其中 20% 是 5.6GB;
- 预算是两者较小值 5.6GB。
每行 logits 的字节数是 ,1M 前缀时一行 4MB,于是最多一次算约 1300 行。一个 32768 的 chunk 会被切成约 25 段,每段独立跑一次 fp8_mqa_logits、独立做一次 Top-K。这个数字解释了一个反直觉的现象:chunked prefill 的 chunk 大小并不等于索引器 kernel 的实际行数。调度器给的是 32768,索引器内部还会按显存预算再切到一千多行。
如果运行时空闲显存比静态估算更少(例如同一张卡上还有别的进程、或者 KV 池已经涨到高水位),mqa_logits_budget_bytes 还会用 torch.cuda.mem_get_info 再压一次预算。所以同一份配置在不同负载下,索引器的行切分数会变化,性能也会随之抖动。
RAGGED 与 PAGED:Top-K 结果怎么交给注意力
Top-K 算完之后,结果不是一张简单的 [n, 2048] 表。SGLang 按 forward mode 把它分成两种变换:
- RAGGED:每条请求的 Top-K 下标是“扁平化后的全局槽位”,注意力 kernel 直接按下标 gather KV。prefill 的 extend batch 走这条路,因为一个 chunk 里可能混着多条请求,每条请求的前缀长度不同;
- PAGED:Top-K 下标仍然按页表解释,注意力 kernel 用页表加偏移去取 KV。decode、target verify 与 draft extend 走这条路。
对 prefill 来说,RAGGED 是默认。_get_topk_ragged 在调 fp8_mqa_logits 时传 clean_logits=False,原因写在注释里:Top-K 变换自己会用 ks/ke/lengths 把无效位置 mask 掉,没必要先把整个 logits 矩阵填成 -inf——那个填充操作本身是 的,并且在 1M 上下文下会显著放大写入量。这是“把 mask 推迟到 topk 变换里做”的一个典型优化。
索引 K 的页大小固定为 64,主 KV 也是 64。这个选择让 Top-K 下标与页表可以共用同一套 64 粒度的地址算术:一个 2048 的 Top-K 列表最多跨 32 页,页表项是 int32,gather 时按页批量取,避免逐 token 的随机访存。q8 稀疏 prefill 只支持 RAGGED,也是因为它把 Top-K 当作扁平槽位直接 gather,不再经过 HiSparse 的页翻译。
索引器的算术强度与 FLOPs
索引器每个 (query, key) 对的计算是 32 个头 × 128 维点积,即 4096 次 MAC、8192 FLOPs。它读的 K 只有 128 字节(FP8),并且同一块 K 会被 32 个头复用,所以算术强度约
这个强度远低于 Tensor Core 的算力峰值对应的拐点,索引器因此是带宽受限的:一张 H200 的 4.8TB/s 只能喂出约 307 TFLOPS 的索引器算力,而不是 4 PFLOPS 的峰值算力。
把因果性与 21 个 full 层算进去,1M 上下文的索引器 FLOPs 是
即约 94 PFLOP。按每卡 300 TFLOPS、8 卡并行估算,纯计算时间约 39 秒。这个量级与主干模型本身的约 100 PFLOP 在同一量级:在 1M 上下文,索引器大约要吃掉 prefill 总算力的一半,最大单项不是 MoE,也不是主注意力。
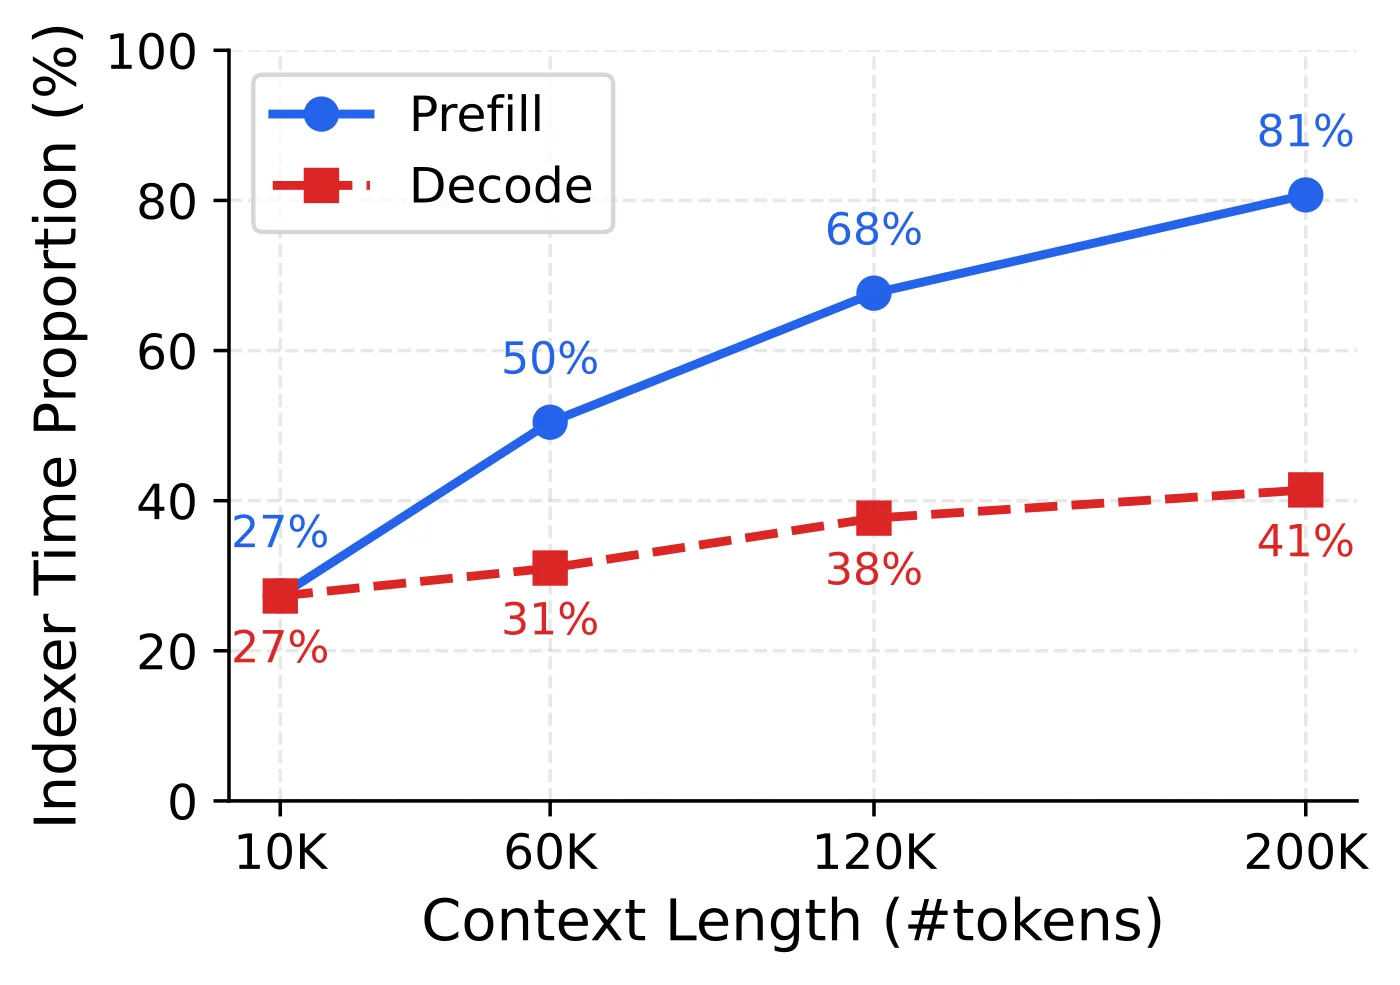
图源:DSA 索引器耗时占比实验,横轴为 10K–200K 上下文,曲线分别对应 prefill 与 decode。
这张图解释了一个常见的误解:DSA 把主注意力从 降到了 ,但那只是“选完之后”的计算;选择本身仍是 。上下文越长,选择在总时间里的占比越高。GLM-5.3 用 21/78 的跨层复用把选择砍掉了约四分之三,剩下的 21 层仍然是 1M prefill 的主要成本。
KV 写入:prefill 的存储账
prefill 的另一半工作是写缓存。每算完一层,当前 chunk 的每个 token 都要把这一层的 KV 写进分页池:
- 主 KV:
set_mla_kv_buffer写入k_nope(512 维,FP8)与k_pe(64 维,BF16),再加 4 个 4 字节的 block scale,每 token 每层 656 字节(512 + 128 + 16); - 索引 K:
fused_store_index_k_cache写入 128 维 FP8 加 4 字节 scale,每 token 每个 full 层 132 字节;shared 层不写,IndexKeyCache._layer_num_pages对这些层返回 0 行占位。
于是一条 1M 请求的 KV 总量是:
其中主 KV 53.7GB,索引 K 2.9GB。这个数字有几个直接后果:
- chunked prefill 不减少这笔存储。 它只把写入摊到多个 step,最终 1M token 的 KV 仍要全部驻留;分块降低的是激活峰值与 logits 峰值;
- 8×H200 的 1.1TB 显存要同时装权重和 KV。 FP8 权重约 744GB,注意力、共享专家、词嵌入等复制部分再加十几 GB;留给 KV 的只有两三百 GB,按每条 1M 请求 57GB 算,同时只能服务 4 到 5 条;
- 页大小是 64 token。 索引器
_get_topk_ragged里明确要求page_size == 64(XPU 为 64 或 128),主 KV 与索引 K 都按 64 token 一页分配;chunk 边界对齐页,正是为了让一次写入落在整数页上。
前缀缓存命中会跳过命中部分的 KV 计算,但不会跳过索引器对命中部分的打分。命中 个 token 的请求,索引器仍要读 字节的索引 K,并对每个新 query 与这 个 key 打分。前缀缓存省的是投影与 KV 写入,不是选择。
页布局与写放大
主 KV 与索引 K 都按 64 token 一页组织:
- 主 KV 一页是 字节,约 41KB;
- 索引 K 一页是 字节,约 8.25KB。
一个 32768 的 chunk 对应 512 页。prefill 写入时,out_cache_loc 是这 512 页在池中的槽位列表,set_mla_kv_buffer 按 token 把 512+64 维写进去;索引器则用 fused_store_index_k_cache 一次写 128 维 FP8 加 4 字节 scale。两层写入的粒度不同:
- 主 KV 是每层都写,78 层 × 512 页 × 41KB ≈ 1.68GB/chunk;
- 索引 K 只有 21 个 full 层写,21 × 512 × 8.25KB ≈ 91MB/chunk。
写放大主要来自“页内部分写”。如果 chunk 的边界没有对齐 64,最后 63 个 token 会落在半页里,写入要读改写(read-modify-write),这对 FP8 缓存尤其不友好——要先读出旧的 132 字节行,改掉前几个 token,再写回。PrefillAdder 的 kv_shard_granule 对齐逻辑就是为了避免这种半页写入:把 chunk 边界向下取整到页,宁可这一块少算几个 token,也不让写入跨半页。
上下文并行:把 1M 个 query 切开,把索引 K 合起来
单卡(或单机 TP8)处理 1M prefill 时,即使显存够,时间也太长:32 个 chunk 串行跑,每个 chunk 的索引器都要扫一遍前缀。prefill CP 把query 维切到多张卡上,让每个 rank 只算自己那份 query,从而把墙钟时间按 CP 度缩短。
开启方式与策略
GLM-5.3 cookbook 给出的参数是:
--attn-cp-size 8 \--enable-prefill-cp \--cp-strategy interleave三个参数的含义分别是:CP 组大小、启用 prefill CP、切分策略。cookbook 同时给了一条警告:zigzag prefill CP 目前对 GLM-5.3 不可用,CUDA 上要用 interleave。这不是实现偷懒,而是 DSA 的索引器与 zigzag 的 K/V 组织方式还没有对齐。
interleave 的切法在源码注释里写得很清楚(layers/cp/interleave.py):
For cp_size = 4, each rank owns every fourth token: cp0: token0, token4, token8, token12, token16, ... cp1: token1, token5, token9, token13, token17, ... cp2: token2, token6, token10, token14, token18, ... cp3: token3, token7, token11, token15, token19, ...它按“模 CP 度”取 token,而不是把序列切成连续的四段。这样做有一个直接好处:因果注意力下每个 rank 的负载是均衡的。连续切分时,拿前面四分之一的 rank 只需要对很短的前缀做注意力,拿最后四分之一的 rank 要对接近全长的前缀做注意力;交错切分后,每个 rank 都同时拿到早期 token 与晚期 token,平均前缀长度接近。
把这件事量化一下。序列长度 、CP 度 ,连续切分时第 个 rank 的 query 平均前缀长度约
第一段 rank 的平均前缀是 ,最后一段是 ,两者相差 倍; 时是 15 倍。交错切分时,第 个 rank 的 token 位置是 ,平均前缀长度约
八个 rank 的平均前缀几乎相同,差的只是每个 rank 比别的 rank 多一个 token 的边界效应。对索引器这种“每个 query 都要扫前缀”的计算,负载均衡直接决定墙钟时间:连续切分时最后一段 rank 要扫 15 倍于第一段的前缀,整条请求的 CP 收益会被最慢的 rank 吃掉。
代价是 token 顺序被打散,模型在进入第一层前把 hidden 与 position_ids 按 rank 切分(cp_split_before_forward),在最后一层后要把各 rank 的 hidden 重新拼回原顺序(cp_gather_after_forward)。这一步是每个 forward 一次 AllGather,不是每层一次。
CP 对 TTFT 的收益可以直接算。假设 1M 请求在 TP8、无 CP 时索引器需要 秒,开启 CP8 后每个 rank 只处理 的 query,索引器计算降到 ;代价是每层多一次索引 K 的 AllGather(合计约 90MB/chunk),以及每个 forward 一次边界 gather。对于 约 40 秒的 1M prefill,CP8 理论收益是省下约 35 秒,远远盖住 90MB 的通信成本。但同一组参数在 decode 上并不划算:decode 每步只有 batch 个 token,索引器本来就只扫描一次,边界 gather 的固定开销反而让短请求变慢。这正对应 cookbook 说“CP 会提高 decode 或短 prefill 延迟”的原因,也是它只推荐给 PD 分离 prefill 节点的原因。
索引器在 CP 下为什么要额外 AllGather
主注意力的 KV 是分页缓存,每个 rank 都能按页表读到任意 token 的 KV;但索引器打分要用当前 chunk 的索引 K,而当前 chunk 的索引 K 是各 rank 刚刚用自己的 token 算出来的,只存在于本地。于是 _get_q_k_bf16 在 CP 激活时做一次“物化全量索引 K”:
if is_cp_active(forward_batch): key = get_cp_strategy().materialize_full_indexer_k_cache(key, forward_batch)materialize_full_indexer_k_cache 的实现就是 gather_kv_cache → attn_cp_all_gather_into_tensor:把每个 rank 的本地索引 K 拼成完整 chunk 的索引 K,再让每个 rank 用它给本地 query 打分。cookbook 里那句“prefill CP 会在 indexer-topk 与 attention kernel 前引入额外 all-gather”,指的就是这一步。
这笔通信不大:chunk 32768、CP8 时,每 rank 本地 4096 行 × 132 字节 ≈ 540KB,一次 AllGather 合计约 4.3MB;21 个 full 层合计约 90MB。相比每层的 MoE dispatch/combine,它可以忽略。但它必须存在,否则每个 rank 只能看到自己那 1/8 的 key,Top-K 会选错。
KV 缓存是复制还是分片
默认情况下,prefill CP 的每个 rank 都持有完整的 KV 缓存。query 被切开了,但 KV 没有切;每个 rank 用本地 query 对完整 KV 做稀疏注意力。这样做实现简单,缺点是显存没有随 CP 度下降。
cookbook 里的 --enable-dsa-cache-layer-split 是另一种选择:把 KV 缓存按层分片到 CP 组内的 rank 上,需要时再预取。官方给出的收益是 KV 显存最多降低 75%(CP4 场景),代价是注意力要跨 rank 取远端层的数据。这个开关只在 PD 分离、prefill worker 使用 Mooncake 传输时启用,说明它服务的是“prefill 节点显存不够放 1M KV”的场景,而不是单机低延迟场景。
PD 分离:prefill 算完的 57GB 怎么交给 decode
1M 请求在生产里通常不会在同一个引擎里跑完 prefill 再 decode。prefill 阶段吃算力、decode 阶段吃带宽,两者的最优并行度与显存分配不同;P/D 分离把 prefill 放在一组节点、decode 放在另一组节点,中间用 KV 传输把两边接起来。
对 GLM-5.3,这条传输的账单很直接:
- prefill 节点算完 1M token 的 KV,主 KV 53.7GB + 索引 K 2.9GB,合计约 57GB;
- 这些 KV 要按页搬到 decode 节点的 KV 池里,decode 节点必须预留同样大的空间;
- 传输走 Mooncake(SGLang 的默认 PD 后端)或 NIXL(vLLM 的 KV Connector),底层是 RDMA/RoCE 或 NVLink;cookbook 特别提醒:容器里没暴露 IB 设备时,Mooncake 会静默回退到 TCP,性能会掉一个数量级。
按 8 个 400Gbps 网卡(每卡 50GB/s、合计 400GB/s)估算,57GB 的理想传输时间是 0.14 秒;实际受页表打包、RDMA 注册、接收端写入的影响,通常要 0.5–1 秒。这相对于 1M prefill 的几十秒不算大,但它发生在 TTFT 的关键路径上,而且 decode 节点必须等 KV 到齐才能开始解码。
LayerSplit 在这里的作用不是加速传输,而是让 prefill 节点装得下:把 KV 按层分片到 CP 组内的 rank 上,每个 rank 只存一部分层的 KV,显存占用最多降到 1/4(CP4);需要某层时再从 owner rank 预取。它把“57GB 必须同时驻留在一个 prefill 节点”变成“每个 rank 只驻留一部分”,代价是注意力要跨 rank 取远端层的数据。这个取舍只在 PD 分离、prefill worker 上成立;统一部署里开 LayerSplit,decode 的每步都要跨 rank 取层,得不偿失。
与经典 Ring Attention 的区别
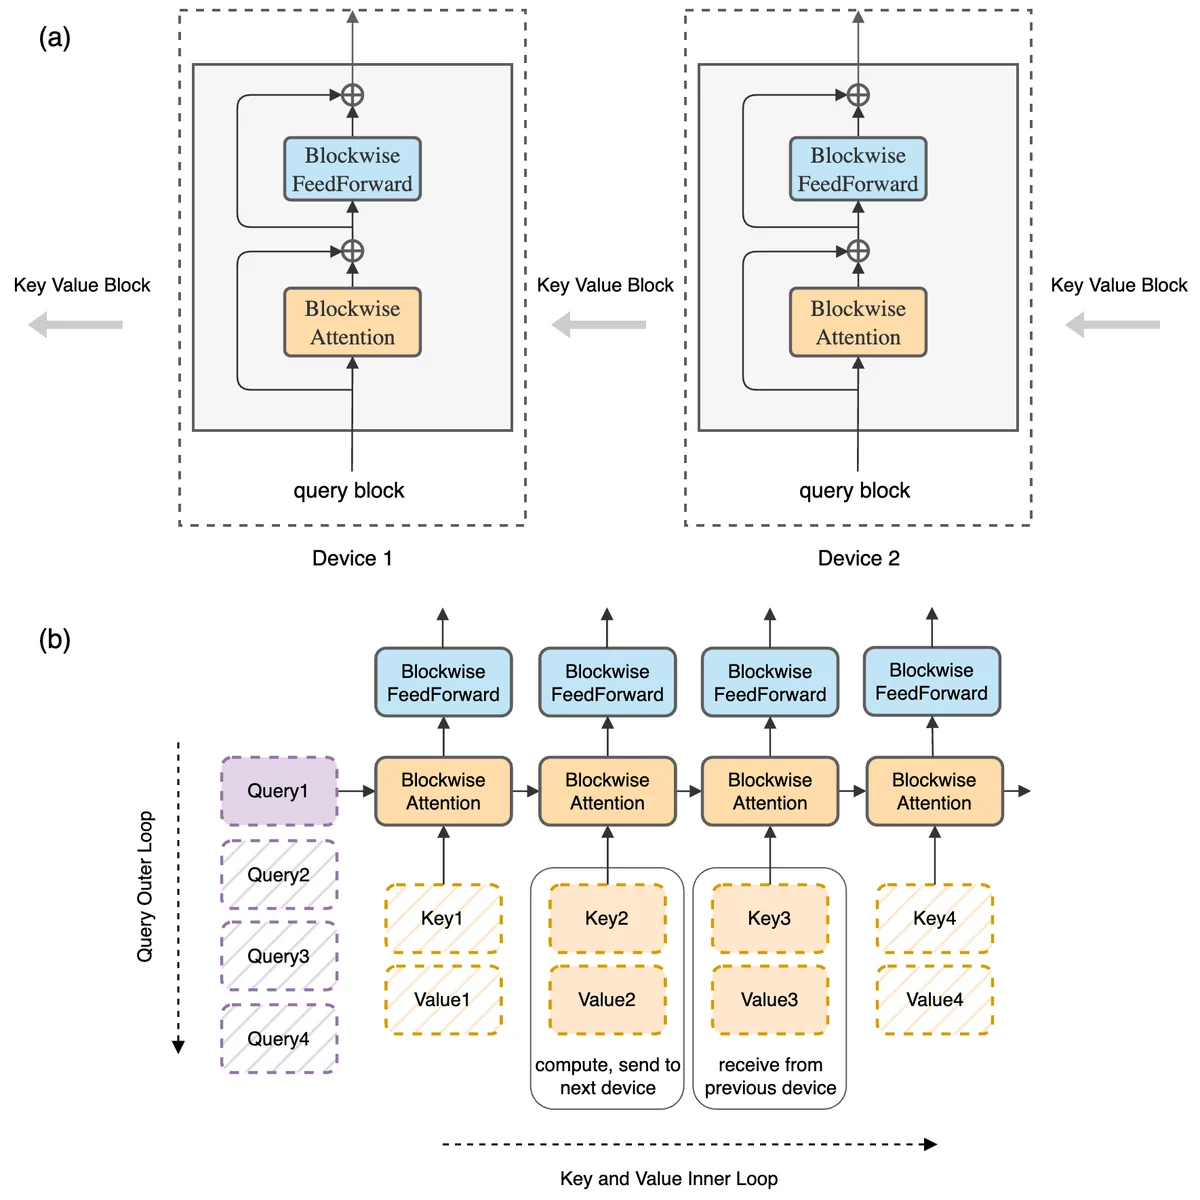
图源:Ring Attention 论文(arXiv:2310.01889)Figure 2。图中展示的是把序列切到多设备后,K/V 块沿环轮转的经典上下文并行方式。
Ring Attention 的解法是“每个 rank 持有一段 query,K/V 块沿环轮转”,每个 rank 最终都会看到全部 K/V,通信量是 KV 总量乘以环的轮数。SGLang 的 interleave 没有采用轮转:它让每个 rank 复制一份完整 KV,只 AllGather 当前 chunk 的索引 K 与最后的 hidden。两者是同一种“query 切分”思路的两种工程实现:
- Ring 适合 KV 显存也必须切的场景,代价是每层都要传 KV;
- SGLang interleave 适合 KV 可以复制、只想降 TTFT 的场景,代价是显存不省,收益是通信只发生在索引 K 与边界。
DSA 让后者的通信量特别小:要传的是 132 字节/token 的索引 K,而不是 576 字节/token 的主 KV;主注意力又只读 Top-2048,不需要每个 rank 都扫全量 KV。这是稀疏注意力给系统层带来的一个直接好处。
interleave 与 zigzag 的真正差别
GLM-5.3 只能用 interleave,原因藏在 zigzag 的元数据里。zigzag 把序列切成 段,第 个 rank 拿“第 段 + 第 段”,目的是让每段 rank 的 K/V 覆盖互补的两头;它的因果掩码需要知道“本地 token 在原始序列里的位置”,并且对首尾两个半段单独处理。
DSA 索引器需要的是每个 query 对完整前缀打分,而 zigzag 让同一个 rank 里的 token 来自序列两端,索引器要么把两端分别打分再拼,要么把两段都 AllGather 到本地。无论哪种,都会让“当前 chunk 的索引 K”物化复杂度从 变成 ,并且要额外处理两段之间的因果边界。interleave 的 token 是“每隔 个取一个”,索引器可以直接对完整前缀打分,Top-K 结果是全局位置,不需要任何分段拼接。
这也是为什么 SGLang 源码里的 CP 策略基类只声明 get_supported_attention_backend() 返回 DSA,而 zigzag 的注释里写着 “former in-seq-split strategy”——它是为 dense attention 设计的,DSA 需要的是另一种“不打散前缀”的切法。
MoE 在 prefill 里的形态
prefill 与 decode 共用同一份 MoE 权重,但 batch 形态不同,账本也因此不同。这一节只讲 prefill 特有的部分:大 batch 下的分组 GEMM、EP 的普通模式,以及 CP padding 行如何从路由里被排除。
- decode 每步只有 batch 个 token,可能只触发少数专家;
- prefill 一个 chunk 有 32768 个 token,每个 token 选 8 个专家,256 个路由专家几乎全部会被触发(期望每个专家分到 个 token)。
这带来两个结果:
- 权重读取被充分摊销。 75 个 MoE 层、每层 9.66B 参数的专家权重,一次 prefill 要把它们全部读一遍;32768 个 token 分摊之后,每 token 的权重带宽成本远低于 decode;
- 专家计算变成大 GEMM。
FusedMoE按专家分组做 grouped GEMM,每个专家一次处理约 1024 个 token,Tensor Core 利用率远高于 decode 的 skinny GEMM。
通信侧,prefill 的 EP 走 DeepEP 的普通模式而不是 decode 的低延迟模式:
dispatch:把每个 token 的 hidden 按路由结果发送到 8 个专家所在的 rank;FP8 下每 token 8 × 6144 字节 ≈ 48KB;combine:专家算完,把 8 份输出加和送回原 rank;BF16 下每 token 8 × 6144 × 2 字节 ≈ 96KB。
对一个 32768 的 chunk、75 个 MoE 层,dispatch 总量约 GB,combine 约 240GB。这是 prefill 通信账里最大的一项,比索引 K 的 AllGather 大三个数量级。
CP 与 MoE 叠加时还有一个细节:CP 的 padding 行不能参与路由。InterleaveCPStrategy.moe_num_token_non_padded 会把每个 rank 的有效 token 数传给 MoE,DeepEP 的 dispatch 只发有效行,combine 回来的 padding 行再丢掉。否则 padding 的零向量会被路由到专家,既浪费带宽又可能改变负载均衡。
门控与分组 GEMM 的细节
MoE 的门控不是简单的 top-k。GLM-5.3 用 noaux_tc 打分:gate 先做 的 GEMM 得到每个专家的 logits,再对 logits 做 sigmoid,加上 e_score_correction_bias,按组选 top-8,最后对选中的 8 个分数归一化。n_group = 1 时组选退化为全局 top-8,这一步几乎全是小算子:sigmoid、加偏置、top-k、归一化,单独看每个都不贵,但它们在 75 层 × 32 个 chunk 上重复,kernel launch 的固定开销会累积。
真正的计算在专家里。每个路由专家是三个矩阵:w1、w3()与 w2(),外加 SiLU 激活。8 个专家被选中后,FusedMoE 按专家分组做 grouped GEMM:把属于同一个专家的 token 拼成一个大 ,一次算完三个矩阵。prefill 的 chunk 有 32768 个 token,每个专家期望分到 1024 个 token, 足够大,grouped GEMM 的 Tensor Core 利用率远高于 decode 的 skinny GEMM。
共享专家是另一条路:每层一个 的 MLP,所有 token 都经过,输出乘 routed_scaling_factor = 2.5 后与路由专家的输出相加。共享专家的计算量是 75.5M FLOPs/token,正好等于 1 个路由专家;它不参与路由,也不参与 dispatch/combine,所以在 EP 部署下它是复制在每张卡上的。
专家负载不均是 prefill 的另一个隐藏成本。1024 token/专家只是期望值;实际路由会偏向某些“热门”专家,热门专家的 变大、计算变久,整个 chunk 要等最慢的专家。EPLB 会在 decode 阶段周期性重排专家副本,但 prefill 的 chunk 是一次性的,重排的收益有限;更实际的做法是让 --ep-size 与专家数匹配,避免一张卡上挤过多热门专家。
一条 prefill 的通信账本
把 chunk 32768、CP8、EP8、TP8 的单机配置下,一个 chunk 的通信量列出来(,,字节数按 FP8/BF16 分别标注):
| 阶段 | 操作 | 次数 | 单次数据量 | chunk 合计 |
|---|---|---|---|---|
| 索引器 | 当前 chunk 索引 K 的 AllGather | 21(full 层) | B ≈ 4.3MB | ≈ 90MB |
| 注意力输出 | o_proj 后的 ReduceScatter | 78 | ≈ 402MB | ≈ 31GB |
| MoE | DeepEP dispatch | 75 | ≈ 1.6GB | ≈ 120GB |
| MoE | DeepEP combine | 75 | ≈ 3.2GB | ≈ 240GB |
| CP 边界 | hidden 的 AllGather | 1 | ≈ 402MB | ≈ 0.4GB |
| DP Attention(若开) | gather + scatter | 78 × 2 | 各 | ≈ 63GB |
| LM Head | 词表 logits 的 AllGather | 1 | 只取每条请求最后一行 | 可忽略 |
单机 NVLink 900GB/s、8 卡聚合约 7.2TB/s 时,这些通信的理论下限约 60ms 到 100ms;如果 EP 跨节点、走 400Gbps IB(每卡 50GB/s、8 卡合计 400GB/s),单个 chunk 的通信就要约 1 秒,32 个 chunk 累计到几十秒。prefill 的 MoE 通信量决定了它非常吃节点内 NVLink 域:GLM-5.3 的 FP8 权重刚好能塞进 8×H200,正是为了让 75 层 MoE 的 dispatch/combine 留在 NVLink 内;一旦跨节点做 EP16/EP32,通信会从“可重叠”变成“主导项”。
这张表里还有一项容易被忽略:o_proj 后的 ReduceScatter 是 31GB/chunk,比索引 K 的 90MB 大 300 多倍。它之所以不显眼,是因为它可以和下一层的 RMSNorm、MoE 门控重叠;而索引 K 的 AllGather 位于关键路径上,索引器算完才能选 Top-K,选完才能做注意力。通信量小不等于影响小,关键路径上的 90MB 可能比旁路上的 31GB 更贵。
TTFT 的算术:一分钟量级的理论下限从哪来
把上面的账拼起来,一条 1M 请求的 TTFT 可以拆成:
其中 是 chunk 数, 只在 PD 分离时存在。按 8×H200、chunk 32768、CP 不开启的单机配置,对各项做量级估算:
| 项 | 计算依据 | 量级 |
|---|---|---|
| 索引器计算 | 94 PFLOP,按 8 卡 × 300 TFLOPS | ≈ 39s |
| 索引 K 读取 | 21 × × 132B ≈ 46TB,按每卡 4.8TB/s | ≈ 10s(与计算重叠) |
| 主干 FLOPs | 约 100 PFLOP,按 8 卡 × 1.5 PFLOPS | ≈ 8.3s |
| 稀疏注意力 KV 读取 | 78 × B ≈ 96TB,8 卡聚合 38TB/s | ≈ 2.5s |
| MoE 通信 | 360GB/chunk × 32 ≈ 11.5TB,NVLink 聚合 7.2TB/s | ≈ 1.6s |
| KV 写入 | 57GB,每卡 4.8TB/s | ≈ 12ms |
| 合计 | 以上重叠后的关键路径 | ≈ 55–65s |
这不是一张 benchmark 表,而是按源码与硬件规格推出来的理论下限。真实服务里还会叠加:
- 队列等待与调度开销:1M 请求通常不是第一个到,前面还有短请求;
- 索引器 logits 的行切分带来的 kernel launch 与流水气泡;
- MoE 的专家负载不均衡:1024 个 token/专家是期望值,实际会有专家过热;
- 如果 CP 开启,还要加上索引 K 的 AllGather 与边界 gather;如果 PD 分离,还要加上 57GB KV 的跨机传输。
把 chunk 从 32768 调到 8192,索引 K 的重复读取量会变成 4 倍(与 成正比),索引器计算中跨块的部分也会增加;调到 131072,logits 的行切分会变少、通信次数减半,但单块激活与 logits 峰值会把显存推到极限。cookbook 对长输入建议 32768,是在这三者之间取的折中。
把三种 chunk 大小的账并排放:
| chunk 大小 | 索引 K 重读量(相对 32768) | logits 峰值(1M 前缀) | 单块激活(bf16) | 调度次数 | 适用场景 |
|---|---|---|---|---|---|
| 8192 | 4× | 8192 × 1M × 4 ≈ 34GB(需行切) | 8192 × 6144 × 2 ≈ 100MB | 128 | 低延迟、多请求交错 |
| 32768 | 1× | 137GB(需行切) | 402MB | 32 | 长输入均衡负载(cookbook 默认建议) |
| 131072 | 0.25× | 549GB(需行切) | 1.6GB | 8 | 单条超长请求、显存充足 |
logits 峰值这一列都远超索引器预算(5.6GB 量级),所以三种大小都躲不开行切分;差别在于行切分的次数与索引 K 的重读量。8192 的索引 K 重读量是 32768 的 4 倍,等于把索引器的带宽账单放大 4 倍;131072 把重读量压到 1/4,但单块激活 1.6GB、MoE 中间激活更大,还要和 KV 池抢显存。32768 之所以成为默认建议,是因为它把“重读量”压到了一个可以接受的水平,同时单块激活还在几百 MB 量级。
几个工程上的坑
0. 索引器的 logits 与 KV 池抢显存
mqa_logits_should_chunk 的预算是“静态空闲的 20%”,但 logits 矩阵不在 mem_fraction_static 的核算里。启动时按 0.8 分给 KV 池的显存,到了 prefill 阶段还要再挤出几 GB 给索引器;如果 KV 池已经接近上限,第一块 prefill 就可能因为 logits 分配失败而 OOM。排查顺序是:先看 --mem-fraction-static 是否开得太高,再看同时的 1M 请求数,最后才怀疑索引器配置。
1. logits 预算会随负载漂移
SGLANG_DSA_MQA_LOGITS_FREE_MEM_FRACTION 默认 0.2,预算取“静态空闲的 20%”与“总显存的 30%”的较小值。如果同一张卡上还有别的进程,或者 KV 池已经接近上限,mem_get_info 会把预算压得更低,索引器的行切分数变多,prefill 变慢。这不是配置错误,而是显存压力的直接体现;排查 TTFT 抖动时,先看当时的空闲显存,再看 chunk 大小。
2. q8 稀疏 prefill 有一串启动期约束
--dsa-prefill-backend flashmla_sparse_q8 是 Hopper 上计算 FP8 稀疏注意力的快路径,但它在启动时会校验一串条件:
- 只支持 SM90;
- KV cache 必须是 BF16 或 packed FP8,且 NoPE 模型(
qk_rope_head_dim = 0)不支持 FP8 池; - 只支持 RAGGED 的 extend batch,因此
--enable-mixed-chunk会被直接拒绝; - 与 HiSparse 不兼容,因为 q8 路径把 Top-K 当作 ragged id,不带 HiSparse 的页翻译。
这些条件在启动时就会报错,而不是在第一个长请求上才崩。部署时如果看到 “q8 prefill runs on RAGGED extend batches only”,要检查的是 --enable-mixed-chunk,不是模型权重。
3. CP 对 decode 有副作用
cookbook 明确写了:prefill CP 会在 indexer-topk 与注意力 kernel 前增加 AllGather,在统一部署下会增加 decode 或短 prefill 的延迟。原因是 CP 组在每个 forward 都要做边界 gather,decode 每步只有 batch 个 token,gather 的固定开销占比很高。所以 CP 只适合“长上下文 prefill 为主、decode 延迟不敏感”的 PD 分离部署;统一部署里开 CP,短请求会被拖慢。
4. CUDA Graph 捕获与 prefill 形状
decode 可以用 CUDA Graph 把整步捕获成一张静态图,prefill 不行:chunk 大小、前缀长度、Top-K 行数每次都在变,图无法覆盖所有形状。SGLang 的做法是 piecewise / breakable CUDA graph——把可变的部分(索引器、注意力)拆成可断开的 custom op,其余部分(投影、norm、MoE)捕获进图。这也解释了源码里大量“in_piecewise_or_breakable_cuda_graph”的分支:在捕获模式下,seq_lens_cpu 不能读,否则 Dynamo 会为其生成形状 guard;索引器只能走 split op,不能逐段捕获。
prefill 的图捕获收益比 decode 小,因为 prefill 的 kernel 本来就跑得久,launch 开销占比低;但它对 host 端 CPU 开销更敏感——32768 个 token 的元数据构造如果全在 CPU 上做,会成为瓶颈。这是为什么 SGLang 把元数据复制融成 kernel、把 Top-K 的广播放在 GPU 上做的原因。
5. 1M 请求的准入是一道硬门槛
PrefillAdder 会为整条请求预留 KV,而不是只预留当前 chunk。1M 请求需要约 57GB 的 KV,8×H200 在装完 744GB 权重后只剩两三百 GB;如果同时来了 6 条 1M 请求,第 5、6 条会被拒绝或抢占。--mem-fraction-static 0.8 给 KV 留的空间、--max-running-requests 的上限、以及是否启用 PD/HiCache,决定了这台机器到底能接几条 1M 请求。这不是 prefill 算法能解决的问题,而是容量规划。
prefill 与 decode 的账本对照
把两篇的结论放在一张表里,能看清同一个模型为什么需要两套优化:
| 维度 | prefill | decode |
|---|---|---|
| 每步 token 数 | 一个 chunk,最多 32768 | 每条请求 1 个 token(投机解码 6 个) |
| 瓶颈 | 索引器算力 / 带宽、MoE 算力 | 权重与 KV 的 HBM 带宽 |
| 主注意力形态 | 吸收 MLA(短 prompt 例外走 MHA one-shot) | 吸收 MLA,MQA 形态 |
| 索引器 | 每层都要对全前缀打分, | 每步对全前缀打分一次,/step |
| 并行重点 | prefill CP、chunked prefill、PD 分离 | DP Attention、EP、大 batch |
| 通信重点 | 索引 K AllGather、MoE dispatch/combine | MoE dispatch/combine、AllReduce |
| 失败模式 | 索引器 logits OOM、KV 容量不足 | 权重带宽打满、batch 太小 |
| 优化目标 | TTFT | TPOT / 吞吐 |
这张表还指向一个部署误区:把 decode 的调参经验直接搬过来。decode 里“加大 batch”几乎总是对的,因为权重读取可以摊销;prefill 的 batch 本来就很大,加大 chunk 反而会把 logits 峰值与激活推高。decode 里 DP Attention 能把注意力分散到更多卡上;prefill 里 DP Attention 同样改变注意力的分片方式,但索引器仍要扫全前缀,TTFT 的改善远没有 decode 那么直接。
更根本的一点是:prefill 与 decode 优化的对象不同。 decode 优化的是“每个 token 的边际成本”,因此权重带宽、KV 读取、batch 大小是核心;prefill 优化的是“第一个 token 的到达时间”,因此 chunk 调度、上下文并行、索引器的二次方计算是核心。GLM-5.3 的 1M 上下文在 decode 侧是一个显存问题(KV 不能装下),在 prefill 侧是一个算力问题(索引器要扫两遍前缀),同一个 57GB 的 KV 数字在两边的含义完全不同。
工程上这意味着两套独立的调参目标:prefill 端关注 --chunked-prefill-size、--attn-cp-size、--dsa-prefill-backend;decode 端关注 --max-running-requests、--ep-size、投机解码步数。把它们混在一个统一部署里,往往两边的指标都拿不到最优;PD 分离之所以成为 1M 上下文的标准形态,根本原因是两套账本的形状不同,而不是单纯的扩缩容需要。
小结
把这条 prefill 路径压成几句话:
- prefill 的瓶颈在索引器,不在主注意力。 1M 上下文下,21 个 full 层的索引器约 94 PFLOP,主干约 100 PFLOP;DSA 省掉的是“选完之后”的 576 维点积,没有省掉“选择”本身的 128 维扫描。
- chunked prefill 是显存与带宽的交换。 块越小,块内平方项越小、调度越灵活,但每块都要重读前缀的索引 K;32768 是在这个交换里找到的工程折中。
- 长上下文 prefill 走吸收 MLA,不走 MHA。 2048 的 KV 长度阈值把 MHA one-shot 限制在短 prompt;1M 前缀如果展开成完整 K/V,单层就要 57GB。
kv_b_proj在长上下文路径里根本不执行。 - prefill CP 切的是 query,不是 KV。 interleave 让每个 rank 拿到交错的 token,因果负载均衡;代价是边界 gather 与索引 K 的 AllGather,收益是 TTFT 按 CP 度下降。
- 通信账里最大的是 MoE 的 dispatch/combine,最关键的是索引 K 的 AllGather。 前者量大但可重叠,后者量小但在关键路径上。
- 1M 请求的 KV 是 57GB,这是一道容量门槛。 chunked prefill 不减少这笔存储;PD 分离、HiCache 与 LayerSplit 才是把它放进生产集群的办法。
一条 1M prefill 的耗时分布
把 8×H200、chunk 32768、不开 CP 的 1M prefill 拆成几段(重叠后的关键路径):
| 阶段 | 主要成本 | 占比 | 能否靠并行摊薄 |
|---|---|---|---|
| 索引器打分 | 94 PFLOP,带宽受限,约 39s | 60%–70% | CP 切 query 是最有效的办法 |
| 索引 K 重复读取 | 约 46TB,可与打分重叠 | 10%–20% | 加大 chunk 减少重读 |
| 主干前向(MoE + 投影) | 约 100 PFLOP,约 8s | 10%–15% | EP / TP 已摊薄 |
| 稀疏注意力 KV 读取 | 约 96TB,约 2.5s | 4%–5% | 与索引器后段重叠 |
| MoE 通信 | 360GB/chunk,NVLink 内约 1.6s | 2%–3% | 跨节点会放大 |
| KV 写入 | 57GB,约 12ms | <1% | 与计算重叠 |
这张表说明了一件事:要让 1M prefill 变快,最该动的是索引器,而不是 MoE 或主注意力。 prefill CP 切的是索引器的 query;chunk 大小影响的是索引 K 的重读量;跨层复用 Top-K 已经在模型结构上砍掉了四分之三。三者之外,任何针对主干或主注意力的优化都只能吃到剩下的 10%–20%。
下一篇会把这条 prefill 路径放到 vLLM 里对照:同一个 glm_moe_dsa 架构,vLLM 如何组织 chunked prefill 的元数据、如何在 DSA 索引器里复用跨层 Top-K、以及它的 KV 传输在 PD 分离下如何与 SGLang 的 Mooncake 路径对齐。
参考资料
- zai-org/GLM-5.3 模型卡(744B-A40B、78 层、256 专家、1M 上下文与 config.json)
- SGLang GLM-5.3 Cookbook(chunked prefill、DSA 后端、prefill CP、PD 分离的参数与注意事项)
- SGLang 源码:schedule_policy.py(PrefillAdder、chunk 预算与 KV 准入)
- SGLang 源码:layers/cp/interleave.py(interleave 切分、AllGather 与 CP 元数据)
- SGLang 源码:layers/attention/dsa/dsa_indexer.py(索引器投影、FP8 MQA logits 与 Top-K)
- SGLang 源码:layers/attention/dsa_backend.py(MHA/MLA 预填充路径选择与稀疏 MLA kernel)
- SGLang 源码:models/deepseek_common/attention_forward_methods/forward_mla.py(Q 吸收、RoPE 与输出吸收)
- SGLang 源码:mem_cache/index_key_cache.py(索引 K 缓存的 132 字节行布局)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与稀疏 MLA 的原始设计,arXiv:2512.02556)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 与 KV 压缩,arXiv:2405.04434)
- Ring Attention with Blockwise Transformers for Near-Infinite Context(上下文并行的经典实现,arXiv:2310.01889)
- DeepEP:DeepSeek 开源的高性能 MoE dispatch/combine 通信库
- FlashMLA:MLA 解码与稀疏注意力内核
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(跨层索引复用,arXiv:2603.12201)
- vLLM GLM-5.3 部署配方(TP8、FP8 KV、MTP 与 DSA 后端参考)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



