


GLM-5.3 推理全链路(十五):部署之后的第一条请求——权重、显存、warmup 与图捕获
前十四篇的账本,都从哪一刻开始记
前十四篇沿着一条请求的时间线,把 GLM-5.3 在 SGLang 与 vLLM 里的入口、调度、嵌入、DSA 注意力、MoE、PD 交接、MTP 与输出侧逐段拆开。那些账本有一个共同的前提:服务已经处于稳态。KV 池按页切好,CUDA Graph 已经捕获,通信器已经建链,所有 kernel 至少跑过一次。账本从“调度器拿到一条请求”开始记,启动期做过的事被折叠成一个常量。
真实的服务不是这样开始的。部署完成的那一刻,进程里只装好了权重和配置;第一条请求到来时,它执行的算子集合与第 N 条请求几乎相同,但每个算子第一次运行时附带的一次性工作、每一块第一次被触碰的显存、每一个第一次建立的通信连接,都要算进这条请求的时间里。线上看到的现象是:第一条请求的 TTFT 明显高于稳态,随后迅速回落;某些形状的请求在特定 batch 下突然变慢;换一个并发档位,延迟曲线出现台阶。这些现象大多不是模型或调度的问题,而是启动期把哪些工作提前做掉了、哪些没有。
这一篇补上这段。它按“启动期替请求省掉了什么”来组织,而不是按进程启动的日志顺序:
- 部署完成意味着哪些进程、哪些 rank 已经就绪,HTTP 什么时候才开始接流量;
- 744B 的 FP8 权重怎样被切开、装进每张卡,哪些张量必须保持高精度;
- KV 池的页数不是配置出来的,而是用一次 dummy 前向量出来的;
- warmup 把哪些一次性开销花在了第一条请求之前;
- CUDA Graph 捕获为什么在 DSA 索引器处必须断开,第一条请求命中不了桶时会发生什么;
- 启动期的集合通信预演,如何让第一条请求不再支付建链成本。
读完这一篇,再回看前十四篇的账本,会知道哪些数字只属于稳态,哪些数字在第一条请求上要加一笔启动摊销。
部署完成意味着什么:进程拓扑与就绪门
先把“部署完成”定义清楚。它不是容器起来、端口监听成功,而是所有权重已在目标设备上、KV 池已按最终尺寸分配、图已捕获、各 rank 已互相握手。少任何一项,第一条请求都会撞上一个半初始化的状态。
SGLang 的进程拓扑可以压成三层:主进程里的 HTTP 服务与 TokenizerManager,每个 TP/DP rank 一个 Scheduler 进程,以及独立的反分词进程。主进程只负责协议、模板、分词与输出拼装;真正持有模型与 KV 池的是 Scheduler 进程。vLLM V1 的分法类似但命名不同:API Server 进程、EngineCore 进程、每个 rank 的 Worker 进程,控制面走 ZMQ,数据面走共享内存。
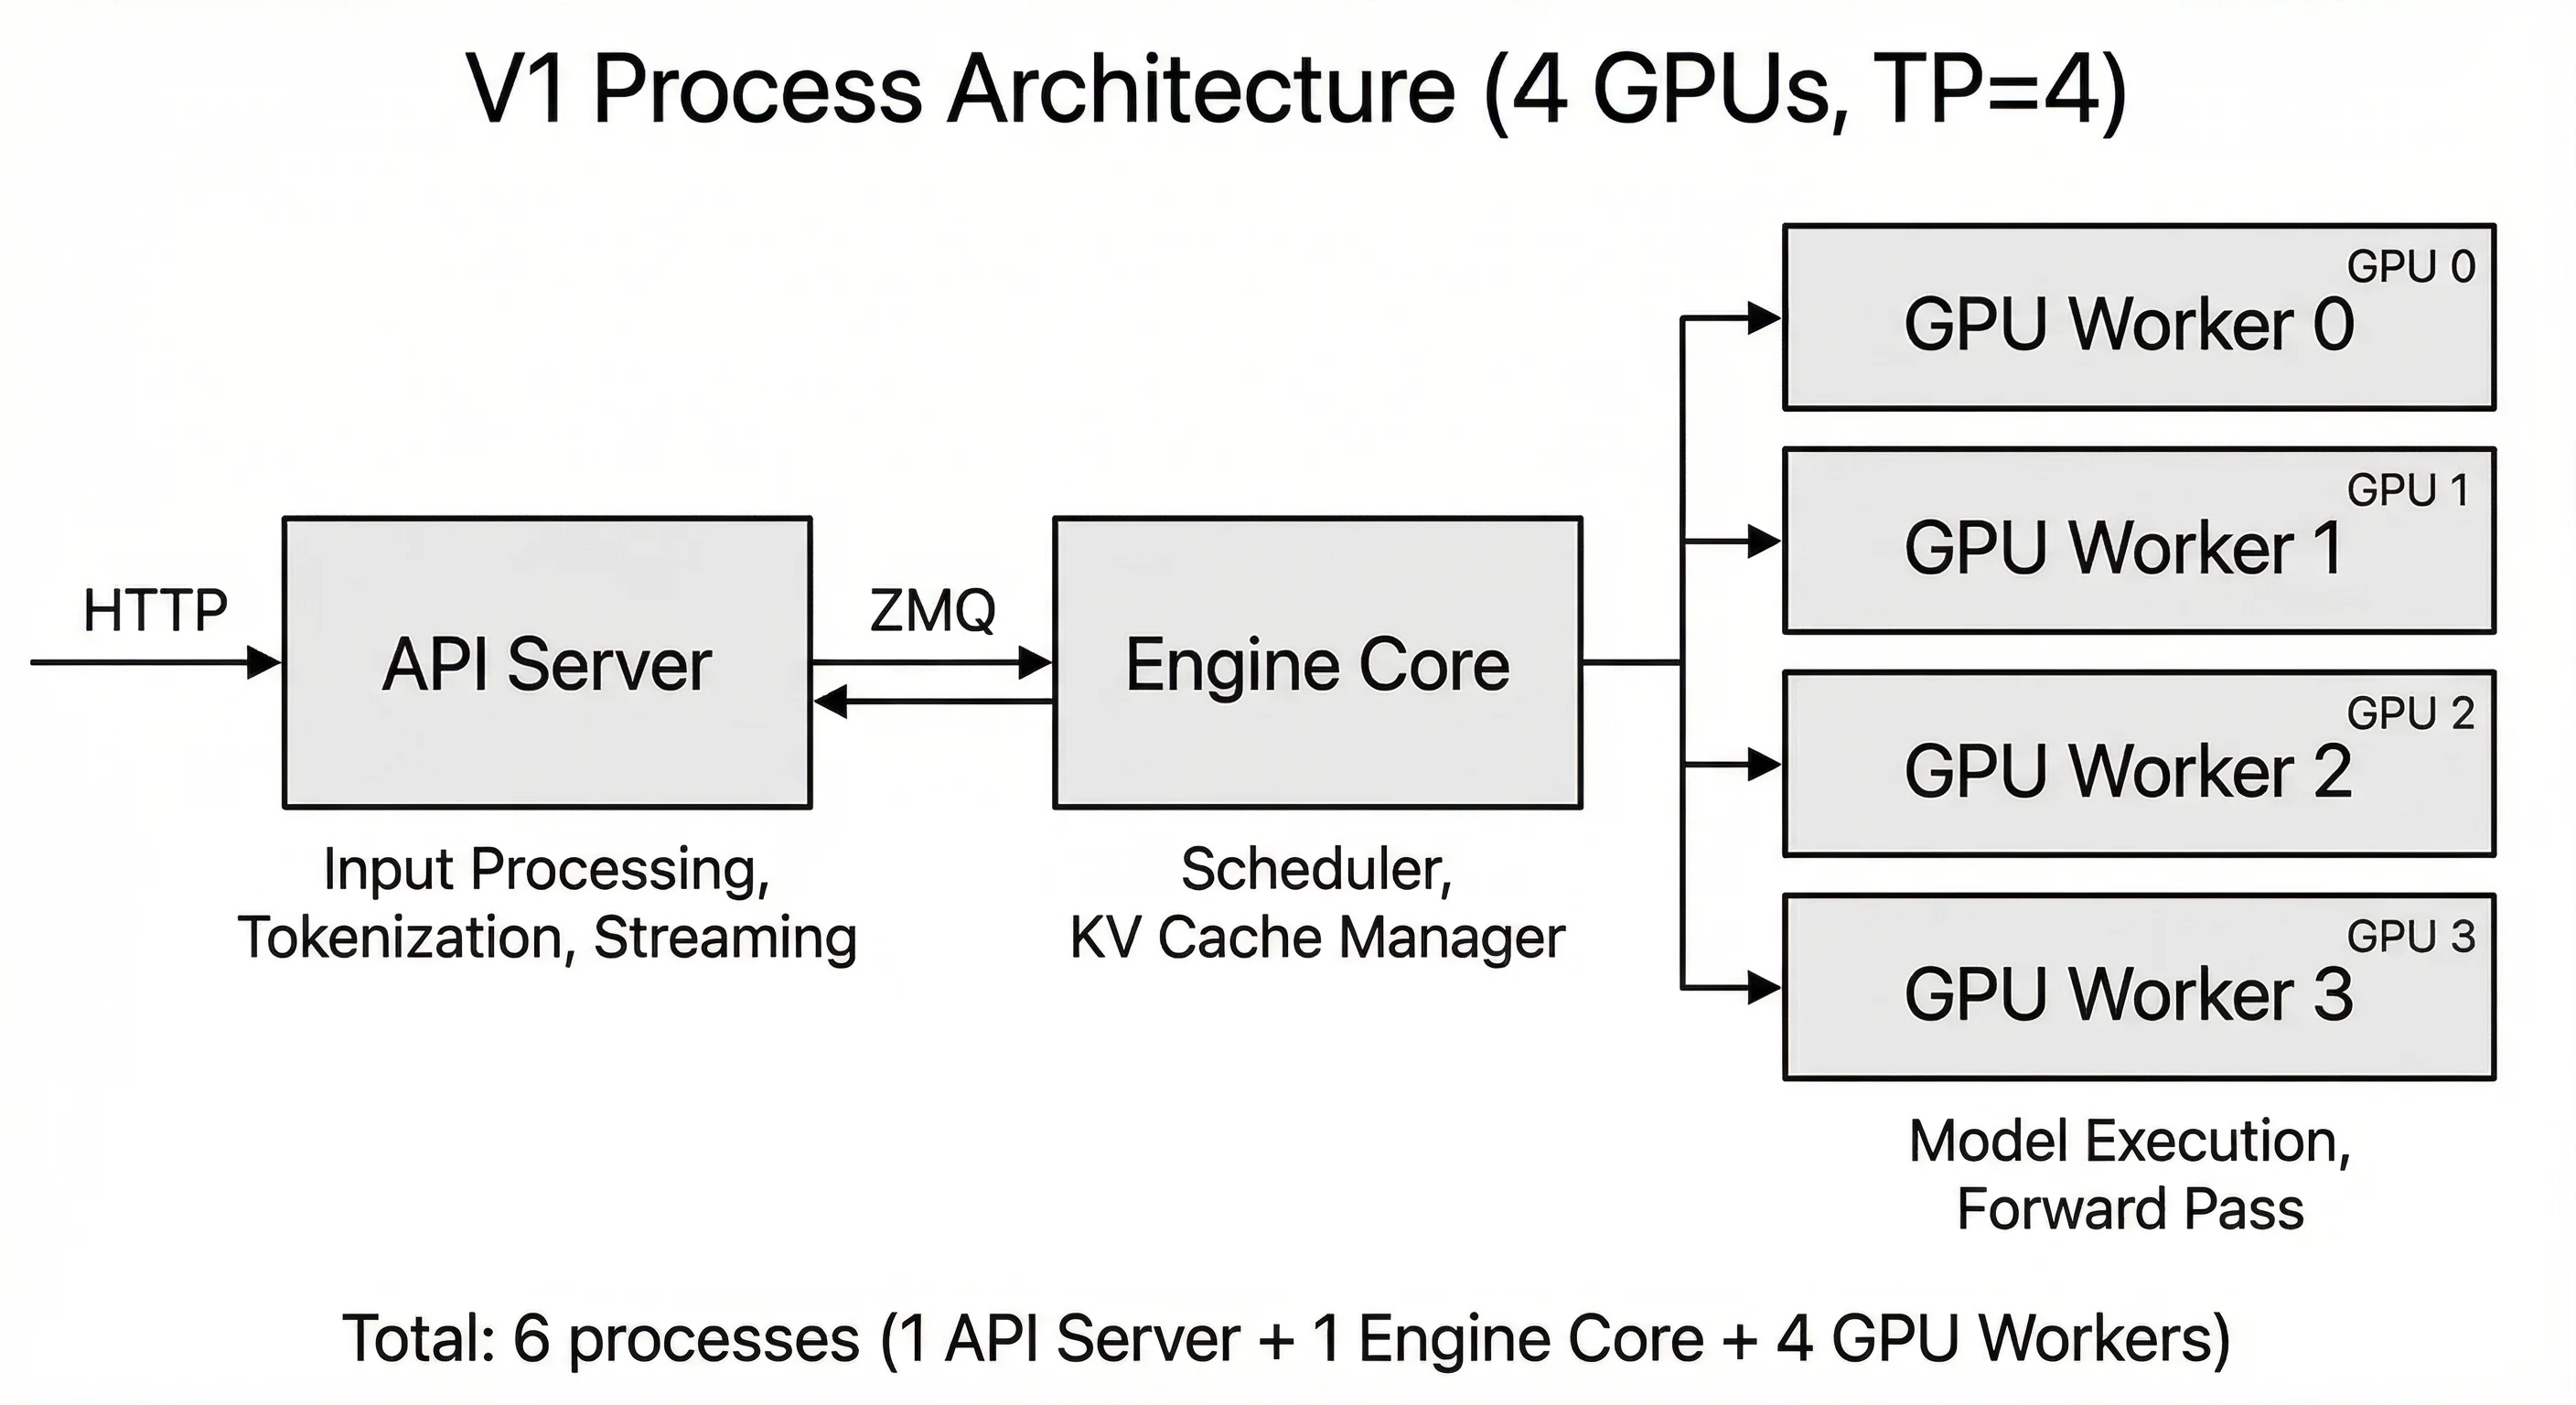
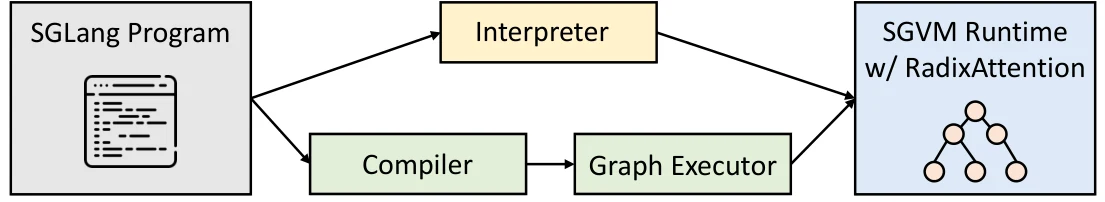
启动顺序在各框架里大同小异,且每一步都依赖前一步的产物:
spawn 进程 / 建立进程组 → 初始化分布式后端(NCCL / NVSHMEM / 自定义 allreduce) → 装载权重到各 rank 的显存 → 用 dummy 前向测峰值显存,反推 KV 池页数并分配 → 初始化通信缓冲(DeepEP、allreduce workspace) → warmup(JIT、autotune、首次集合通信) → 捕获 CUDA Graph → 各 rank 汇报 scheduler_info,HTTP 进入 Up这个顺序不能随意调换。显存 profile 必须发生在权重装载之后,否则不知道还剩多少显存;图捕获必须发生在 KV 池分配之后,否则捕获时引用的 KV 地址会在之后被重新分配;HTTP 必须在全部完成之后才转为就绪,否则第一条请求可能落在池尚未切页、图尚未捕获的窗口里。
SGLang 把这个顺序编码进了一个汇报结构。每个 Scheduler rank 在初始化结束时把三项常量报给主进程:
scheduler_info = { "max_req_input_len": max_req_input_len, # 上下文上限减去生成长度 "startup_time": startup_time, # 各阶段耗时,写入日志 "tp_size": tp_size, "dp_size": dp_size,}主进程把它们挂到 TokenizerManager 上:
tokenizer_manager.max_req_input_len = scheduler_info["max_req_input_len"]tokenizer_manager.set_startup_time(scheduler_info["startup_time"])max_req_input_len 由调度进程而不是 HTTP 层计算,这一点很关键:拒绝超长请求的尺子必须和调度器接受请求的尺子一致,否则会出现“HTTP 放行、prefill 阶段才失败”的半途错误。就绪状态则是一个三值枚举:Starting 阶段 /health 直接返回 503,Up 之后才做真实检查;真实检查不是读一个布尔值,而是发一条 input_ids=[0]、max_new_tokens=1 的请求,等反分词进程的时间戳前进。它验证的是 HTTP → 分词 → ZMQ → 调度器 → GPU → 反分词 → 回传的整条回路。
所以“部署完成”在外部观察者眼里只是一个 200,但在进程内部,它意味着权重、显存、通信、图四件事都已经尘埃落定。第一条请求真正要付的,只是它自己那一段计算,以及少数没有在启动期覆盖到的冷路径。
为什么启动期的工作不能推给请求
在往下拆每一段之前,先回答一个问题:为什么这些工作不能“用到再做”,让第一条请求顺手把它做了,省掉启动时的十几分钟?
有四个原因,每一个都足以让 lazy 方案失效。
第一,显存分配不可回退。 KV 池必须在知道剩余显存之后一次切好。如果让请求驱动增长,每条新请求都可能触发 cudaMalloc;而 CUDA 的显存分配会与原已分配的块产生碎片。跑上几小时后,剩余显存被碎片吃掉,一条中等长度的请求就分配不出连续的页。profile 一次、切一次,是让碎片远离主路径的唯一办法。
第二,地址必须稳定。 图捕获后,图里的每个地址都冻结。如果 KV 池、工作区、元数据缓冲可以随请求增长而搬家,图就会指向旧地址。要么永远不用图,要么在服务开始接流量之前把所有可能被图引用的缓冲分配完。
第三,通信资源不能按请求建。 NCCL 通信器、NVSHMEM 的 QP、IPC 句柄交换,建链成本与集群规模有关,与请求大小无关。让第一条请求去建链,它的耗时里就混进了整个集群的握手时间;让一万条请求各自建链,则是把一次性成本变成一万次。
第四,一次性 Kernel 编译不能放并发。 多个 rank、多个进程同时触发编译,会争抢同一份缓存目录,结果是互相覆盖或写坏缓存。预热阶段是串行控制的,请求阶段是并发的,前者能保证编译结果被正确落盘,后者不能。
理解了这四点,就能理解为什么几乎所有生产级推理框架都把启动期做成一条长的、串行的准备链,并在 HTTP 就绪之前把整条链走完。它牺牲的只是启动时间,换回的是稳态的可预测性。
权重装载:744B FP8 怎样落到每张卡上
GLM-5.3 的权重是 FP8 发布的。Hugging Face 仓库里是两百多个 safetensors 分片,配一个 model.safetensors.index.json,把每个张量名映射到所属分片。加载器先读索引,再按当前 rank 的并行策略决定“这个张量我要不要、要哪一段”。
先看模型常量。配置文件里 hidden_size=6144、num_hidden_layers=78、n_routed_experts=256、num_experts_per_tok=8、first_k_dense_replace=3、moe_intermediate_size=2048,注意力侧 num_attention_heads=64、q_lora_rank=2048、kv_lora_rank=512、qk_nope_head_dim=192、qk_rope_head_dim=64、v_head_dim=256;索引器侧 index_n_heads=32、index_head_dim=128、index_topk=2048;再加一层 MTP,总层号排到 78。量化配置是 fp8 e4m3、块大小 [128, 128]、激活动态缩放。
FP8 块量化的装载有一条容易踩的坑:每个权重旁边还有一个 weight_scale_inv,形状是
它不是逐通道的向量,而是按 128×128 的块给一个缩放因子。加载器如果只把 weight 搬进显存、漏掉对应的 weight_scale_inv,模型能跑、日志不报错,但 GEMM 的反量化会用错缩放,输出逐步漂移成 NaN 或胡言乱语。这类问题在启动期不会暴露,往往要等第一条请求返回一段明显异常的文本才被发现。因此成熟的加载器会在装载结束后做一次覆盖校验:索引里的每个浮点张量要么被消费,要么在“故意不加载”的白名单里。
quantization_config.modules_to_not_convert 就是那份白名单的雏形。它列出了不能量化的模块:各层的 input_layernorm、post_attention_layernorm、q_a_layernorm、kv_a_layernorm、MoE 的 mlp.gate 与 e_score_correction_bias、索引器的 indexer.k_norm、MTP 层的 enorm / hnorm / shared_head.norm,以及 lm_head。原因是清楚的:归一化与门控对数值范围敏感,路由偏置是一个会被反复加减的小向量,词表投影直接决定 logits 的精度,它们都必须留在 BF16 或 FP32。
装载时的切分规则由并行策略决定:
- 列并行:
q_b_proj、kv_b_proj、o_proj的输出维按头切,MoE 的gate_proj/up_proj按中间维切,lm_head按词表切; - 行并行:
down_proj的输入维按中间维切,结果需要一次 AllReduce; - 复制:
q_a_proj、kv_a_proj_with_mqa这类低秩入口权重很小,通常每个 TP rank 各存一份,避免为几百 MB 的矩阵引入一次集合通信; - 专家并行:256 个路由专家按
ep_size分给各 rank,每个 rank 只物化自己负责的专家,非本地专家在 dispatch 时通过 all-to-all 送来 token。
把切分规则写进加载器,大致是这样一个循环:
for name, tensor in shard.items(): if not is_local(name, tp_rank, tp_size, ep_rank, ep_size): continue param = model.get_parameter(name) weight_loader(param, tensor) scale = shard.get(name + "_scale_inv") if scale is not None: scale_loader(param_scale, scale)真正的复杂度在 is_local 与 weight_loader 两个函数里:前者要按名字判断这是列切、行切、复制还是专家张量,后者要按同样的规则切出属于本 rank 的那一段。名称映射表一旦有一项写错,症状往往不是启动报错,而是某层输出略偏——这类错误要靠逐层数值比对才能定位。
按 EP8 部署,每个 rank 只持有 32 个专家;每个专家有三组权重(gate、up、down),中间维 2048、隐藏维 6144,FP8 下每组约 12.6MB,一个专家约 37.7MB,32 个专家约 1.2GB。这部分权重在启动期按 rank 物化,运行期不再变化;dispatch 只搬运 token,不搬运权重。
GLM-5.3 还有几组只属于这个模型的张量。索引器只装在 21 个 full 层上,每组包含 indexers_proj(从 6144 维投到 32×128 的索引查询/键空间)和 indexer.k_norm(128 维的 RMSNorm);其余 57 个 shared 层没有这些权重,它们在运行时复用同一个索引组算出的 Top-K 下标。MTP 层(第 78 层)则多出 eh_proj(6144×12288)、enorm、hnorm 与 shared_head.norm,它是一层完整的小 Transformer,草稿前向要独立走一遍。装载器如果按“每层结构相同”的假设写死循环,就会在这两类层上出错:要么对 shared 层去找不存在的索引器权重,要么把 MTP 层当成普通层而漏掉 eh_proj。
权重装载阶段没有集合通信。它是纯粹的存储读取加 HBM 写入,瓶颈在 PCIe 与本地盘:两百多个分片、七百多 GB 的数据,多 rank 同时读同一批文件会互相争抢页缓存与存储带宽。启动日志里权重加载往往占据最大的一块时间,原因不在 GPU,而在 I/O。把 checkpoint 放在本地 NVMe、避免所有 rank 同时冷读同一分片、或者用更高带宽的加载格式,都是这一阶段的有效手段。
装载完成后,模型对象里的每个线性层都持有一份 FP8 权重与一份块缩放;接下来的问题变成:这些权重之外,显存还剩多少,能装下多少 token 的 KV。
显存预算:KV 池的页数是一次前向量出来的
权重装好之后,显存的使用量并不等于“权重大小”。同一次前向还会分配激活、通信缓冲、logits 工作区、索引器的打分矩阵,以及捕获 CUDA Graph 时需要固定的输出缓冲。KV 池必须避开这些峰值,否则第一条长请求一来就会因为临时缓冲与 KV 抢显存而 OOM。
SGLang 的做法是:不猜,而是跑一次。启动期它构造一个形状为“最大 batch、最大上下文”的 dummy 请求组,跑一遍完整前向,让 PyTorch 的显存分配器把这一次用到的所有临时张量都分配出来;测出峰值后,释放这些临时张量,剩下的余量就是 KV 池可以占用的空间。这个流程的关键参数是 mem_fraction_static:它告诉 profile 阶段“总量里有多少可以留给静态部分(权重、KV 池、图捕获缓冲)”,剩下的留给运行时临时分配。跑 profile 时临时分配的池本身要设得足够大,否则 profile 在途中 OOM,就测不出真实峰值。
由此得到每张卡能放多少个 token 的 KV:
其中 是 profile 之后的可用字节, 是单个 token 在全部 78 层上的 KV 字节数, 是每张卡持有的层比例(TP8 下是 1/8)。 要按两份缓存一起算:
- 主 KV:MLA 只存 576 维的压缩潜向量(
kv_lora_rank=512加 64 维的 RoPE 分量)与一个 8 字节的 FP32 缩放,FP8 下每 token 每层 656 字节; - 索引器缓存:只有 21 个
full层需要,每 token 每层 132 字节(128 维 FP8 索引键加 4 字节缩放)。
合起来,单个 token 在 78 层上的 KV 约 字节。一条 1M 上下文的请求,KV 约 53.9 GB,正好与前文 PD 分离里“57GB 量级”的口径一致——差额来自页对齐、请求槽位元数据与 token 计算方式的不同。
把数字代进一个具体部署:8 张 141GB 的卡做 TP8,权重 744GB 平均分到每卡约 93GB,加上通信缓冲、索引器工作区与图捕获缓冲,按 0.85 的静态比例,KV 池每卡大约还能拿到 20–30GB。按每卡 1/8 层计算,每 token 只占约 6,742 字节,20–30GB 对应每卡约 300–400 万 token;8 卡合计 2,400–3,200 万 token。一条 1M 请求跨 8 卡摊薄后每卡只占约 6.7GB,所以池子能同时容纳数条 1M 请求,但容不下十条以上。这个反直觉的结论来自 TP 对 KV 的切分:单卡看到的上下文很长,但它只存其中一部分层。
为什么 KV 池一定要在 profile 之后按最终尺寸一次性分配,而不是按需增长?因为后文要讲的图捕获要求 KV 地址固定。图里记录的每一个 KV 页地址,在重放时必须仍然指向同一块显存;如果池在捕获之后还能搬家或扩容,图就会读到错误地址。SGLang 因此把 KV 池放在一个独立的显存池里(torch.cuda.use_mem_pool),并在 profile 结束后冻结尺寸。vLLM 用 gpu_memory_utilization 表达同一件事:先设定总占用比例,profiling 之后算出块数,再一次性分配。
这份预算是启动期最重要的一次“定秤”。它决定了服务能并发多少条请求、能接受多长的上下文、1M 请求是否会被调度器直接拒之门外。把它调大,KV 池变大,但图捕获和运行时临时缓冲的空间变小,长 prefill 容易 OOM;调小,KV 池变小,并发下降,长请求排队。线上关于“长上下文请求大量排队”和“偶发 OOM”的抱怨,大多最终都落到这一个参数上。
warmup:把一次性开销提前花掉
profile 只关心显存,不关心 kernel 是否第一次运行。warmup 关心的是后者。推理路径上有大量“第一次执行才发生”的工作:
- Triton kernel 的首次编译。第一次调用某个 Triton kernel 时,仓库里并没有编译好的二进制,需要即时编译生成 cubin,耗时从几十毫秒到数秒;
- autotune。FlashInfer 的 plan、CUTLASS 的启发式选择、各类 split-K 方案,都会在遇到新形状时跑一组候选并选最快的一个;
- 通信库的一次性初始化。FlashInfer 的 allreduce workspace、FI all2all workspace、PCIe IPC workspace 的分配都会做同步与集合通信,必须发生在任何捕获之外,否则会和自定义 allreduce 的图缓冲注册死锁;
- 内存池的首次 grow。PyTorch 分配到新尺寸时不一定有现成块可复用,第一次会触发缓存扩张;
- 各种
__init__里的一次性同步,例如校准表、权重后处理、张量放置。
这些工作如果不提前做,全部会落到第一条请求身上。一条 decode 请求可能因此多花几百毫秒;一条长 prefill 则可能触发多个新形状的 autotune,叠加到秒级。
SGLang 的 BaseRunner.warmup 是所有 runner 共用的前置动作,用一个进程级标志保证只跑一次:
def warmup(self) -> None: mr = self.model_runner if getattr(mr, "_kernel_warmed_up", False): return mr._kernel_warmed_up = True if self.device != "cuda": return self._pre_initialize_flashinfer_allreduce_workspace() self._pre_initialize_fi_a2a_workspace() self._pre_initialize_pcie_ipc_workspace() prepare = getattr(mr.model, "prepare_before_cuda_graph_capture", None) if prepare is not None: prepare(mr) ..._dummy_run 是执行体。它构造一个形状合适的 dummy 批次,跑一遍前向。这里有一个约束写进了断言:传入的缓冲必须不小于 dummy 形状,且不再重新 padding。原因是 autotune 必须在“最终会用的形状”上进行,否则调优结果不适用于线上;同时复用已有缓冲能让 dummy 前向分配的临时张量与后续捕获共用同一个池,避免把池撑大。
warmup 覆盖哪些形状,决定了哪些请求在第一条时不会踩坑。SGLang 的 decode 路径按桶预热:每个将要捕获的 batch 档位都会跑一次 dummy 前向,让该档位相关的 kernel 编译、autotune 与临时分配都发生过。prefill 路径则按常见的分块尺寸做几次预热,长请求的分块组合很多,做不到全覆盖,因此长 prefill 的冷形状仍有可能在第一条请求上触发编译。
以 DeepGEMM 为例,FP8 块缩放 GEMM 的 kernel 按 与是否转置编译;78 层里大量层共享同一组形状,真正需要编译的 distinct 形状只有几十个,而不是 78 乘每层十几个投影。这也是 warmup 能在分钟级完成而不是小时级的原因。换模型、换 TP 尺寸、换 ep_size 都会改变形状集合,编译缓存随之失效,启动时间回到最长的那一档。
vLLM 对应的是 torch.compile 与 FlashInfer 的预热,思路相同:在服务就绪前,把“编译一次、调优一次”的工作全部做完,并把结果缓存到磁盘,让重启后的进程直接读取缓存而不是重新编译。缓存目录放在容器内而没有挂载到持久卷,是部署时容易忽略的问题:每次滚动重启,第一条请求都要再付一遍编译时间。
对运维来说,warmup 的可见成本是“启动时间变长”。744B 的模型在 TP8 上,仅权重加载、profile、warmup 与图捕获合起来就可能要十几分钟。这段等待换来的是稳态延迟的稳定;要缩短它,只能从 checkpoint 位置、编译缓存持久化、减少捕获桶数这几个方向做取舍,而不能简单地把 warmup 关掉。
图捕获:DSA 为什么把整图切开
warmup 让每个 kernel 至少运行过一次,但没有解决另一个问题:decode 每一步要提交上千次 kernel launch,CPU 侧的提交开销与 GPU 的计算时间同阶。CUDA Graph 把一整步的 kernel 序列录下来,之后用一次重放提交,能够把这部分开销压掉一个数量级。
代价是形状与地址全部冻结。图里引用的每个张量,在重放时必须仍然位于同一块显存;batch 大小、序列长度、页表内容这些每步都会变的东西,不能作为图内的动态输入,只能通过“捕获时留好的静态缓冲 + 重放前在主机侧改写缓冲内容”来注入。SGLang 的 decode runner 因此维护一组按 batch 大小分档的桶,每个桶一张图;重放时按当前 batch 向上取整选桶,把有效行数写进 seq_lens 之类的元数据缓冲。
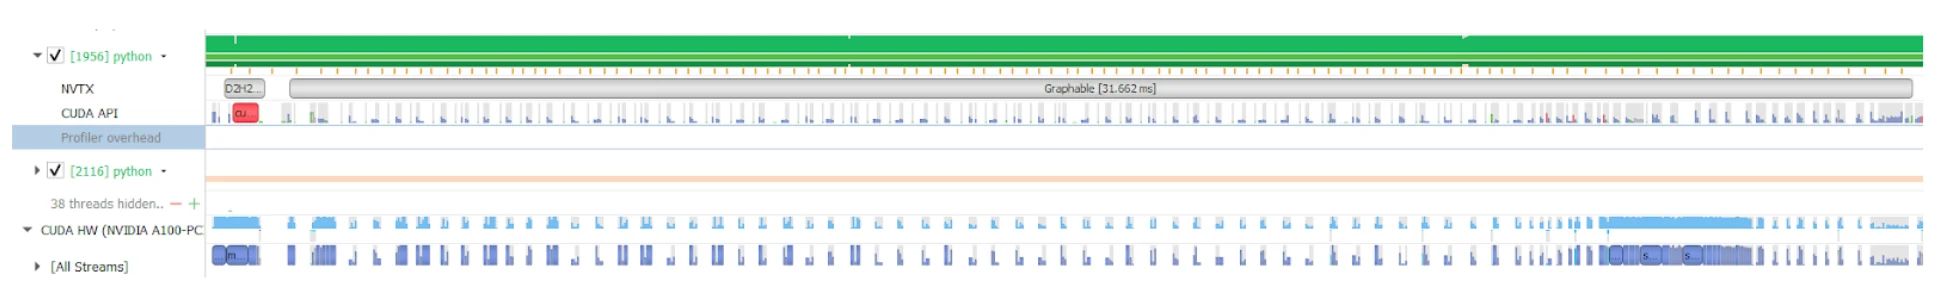
GLM-5.3 在这里有一个模型特有的麻烦:DSA 的索引器。每一步 decode,索引器要先用当前 token 的查询对全部历史键打分,选出 Top-K(index_topk=2048),再把这份下标交给稀疏 MLA 去读取对应的 KV。Top-K 的结果是数据相关的:下标内容每步都不同,长度也可能因为上下文短于 2048 而变化。图可以捕获“打分 GEMM”和“Top-K 选择”的 kernel 序列,但下标缓冲区的内容必须在重放前由真实计算写入;而下游的稀疏 MLA 又要根据这份下标去 gather KV,gather 的地址是数据相关的。
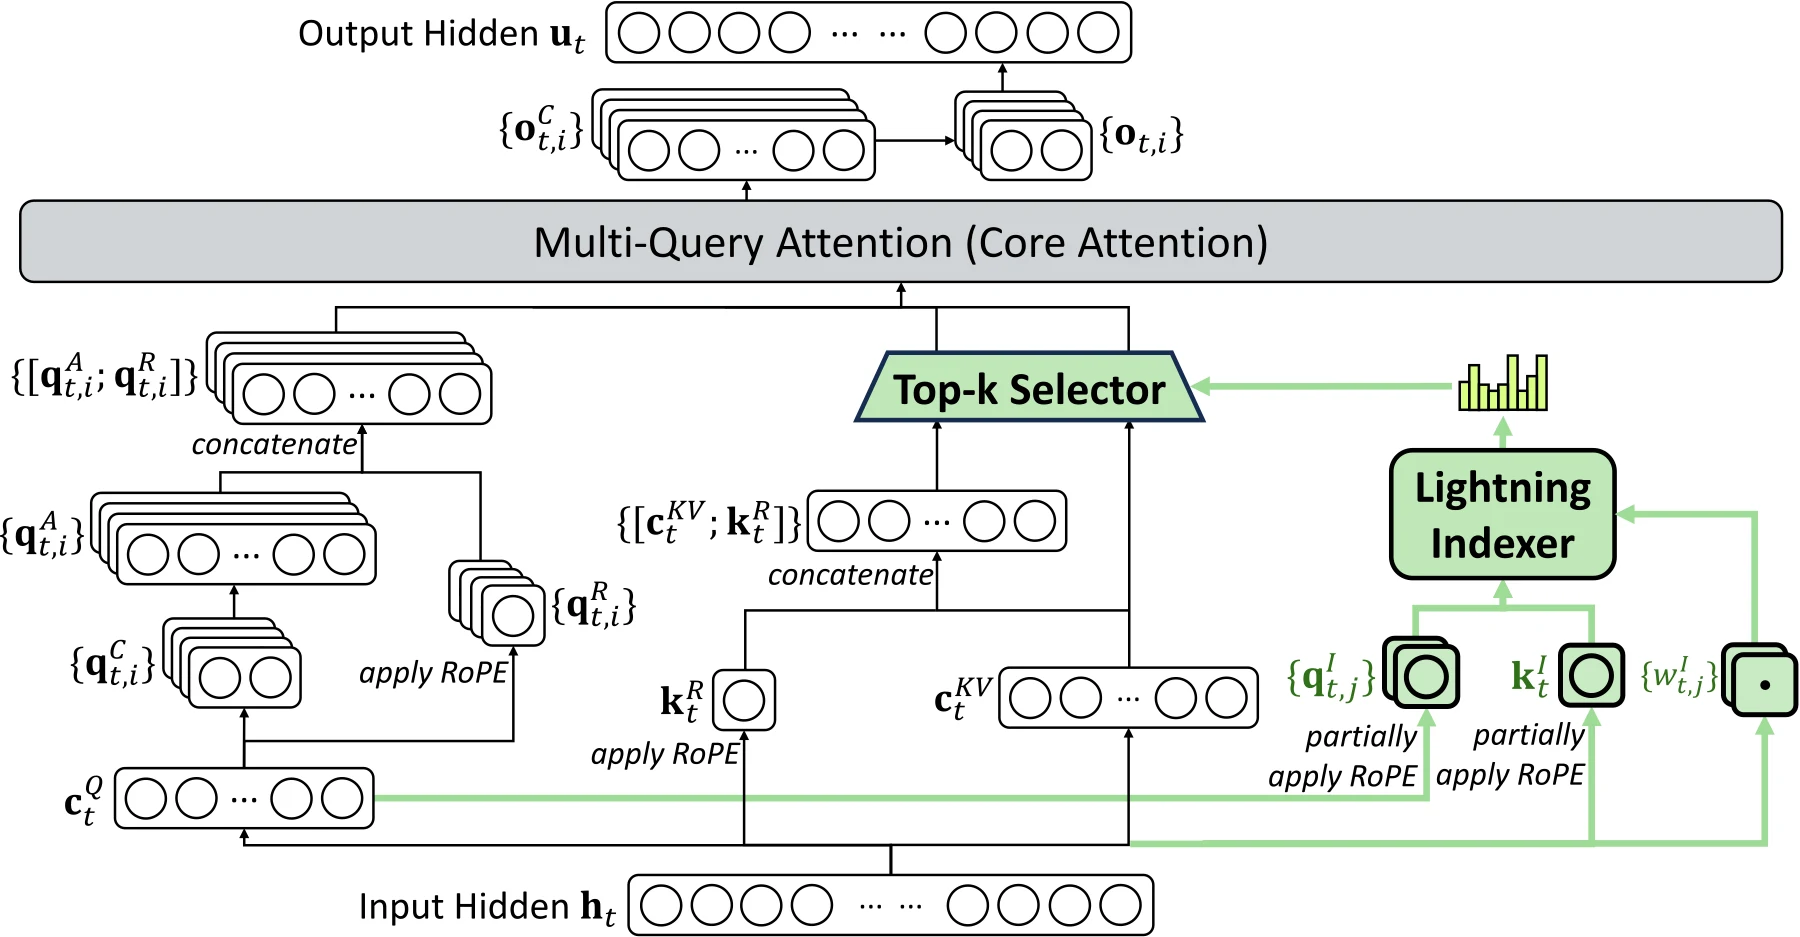
SGLang 的解法是把图切在注意力层。它把 decode 前向拆成若干段可捕获的区间,在注意力之前留一个断点:断点之前的元数据准备与索引器打分走图外或独立的小图,Top-K 结果写进固定地址的缓冲,断点之后的稀疏 MLA 再作为另一段图重放。vLLM 在 DSA 路径上同样在索引器与稀疏 MLA 之间留了一个“可断开”的位置,并把索引器跨层复用的下标换算安排在另一条流上,用事件与主计算流同步。两边做法不同,约束相同:图内不能出现依赖运行时数据的地址计算。
这条约束还影响显存。索引器的打分矩阵大小与当前处理的 token 数、上下文长度相关;prefill 阶段它按 chunk 切片,decode 阶段则是一行查询对整段上下文。图捕获要求这块工作区的地址固定,因此它必须在捕获前按上限分配好,并在整个服务生命周期里不搬动。GLM-5.3 的 1M 上下文下,这份工作区不是一个小数目;它和 KV 池抢的是同一块剩余显存,profile 阶段必须把它算进去。
MTP 让图的数目再翻一倍。开启投机解码后,一次 decode step 包含草稿前向、目标验证与 draft_extend 三段,每段的 batch 形状不同:草稿段是每条请求一行(或 k 行),验证段是 k+1 行,draft_extend 又是接受段的长度。SGLang 与 vLLM 都会为这三段分别捕获图,桶的数量按各自的 batch 上限划档。桶越多,捕获越久、占的显存越多;桶太少,线上请求稍大一点就回退 eager,延迟出现台阶。
捕获本身有一组硬约束,违反任何一条都会让捕获失败,或者录出一张错误的图:
- 捕获区间内不能有同步操作,不能新建内存池,不能走会触发显存分配的 Python 分支;
- 捕获时引用的所有缓冲必须已经分配,且在整个服务生命周期内不释放;
- 捕获必须在正确的流上进行;多流并行的部分要么一并录进图,要么在重放前后用事件对齐;
- 捕获后的图只能重放,不能再改其中的 kernel 参数;要变的量只能写进静态缓冲。
选桶的代码很短,但决定了第一条请求走图还是走 eager:
bucket = next((bs for bs in graph_buckets if bs >= batch_size), None)if bucket is None: return eager_forward(batch)graphs[bucket].replay()next 取不到值时没有异常,只有回退;线上表现为某些并发档位的 TPOT 突然抬高,而日志里没有任何报错。这也是为什么回退计数必须单独埋点。
第一条请求正好落在这些取舍的边界上。它在 batch=1 的桶里,通常能命中;但如果服务配置的 cuda-graph-max-bs 小于实际并发,或者请求带了结构化输出、让采样前的 logits 处理多出一条图外路径,它就会回退到 eager。回退本身不改变计算结果,只把每步的 kernel 提交开销从一次重放变回上千次 launch——对小 batch 的 decode,这是毫秒级的差别,足以让第一条请求的 TPOT 看起来“不正常”。
第一条请求真正走的路
把前面几节拼起来,第一条请求与稳态请求的差异可以逐段对照。
入口层:模板、分词、协议解析在启动时已经初始化,第一条请求不额外付费;唯一可能冷的是结构化输出。带 JSON Schema 的请求第一次到来时,语法编译器要为这份 schema 生成自动机并缓存;不同 schema 各自编译一次,压测时如果每条请求都换 schema,这部分开销会持续出现。
调度层:前缀缓存是空的,第一条请求的 prefill 必须从零算起;稳态下同一前缀的后续请求可以命中缓存,TTFT 差出一大截。KV 池的页已经切好,分配只是从空闲链表取页并建页表,不触发 cudaMalloc。
前向层:kernel 已经热,autotune 已经完成,形状如果落在预热覆盖范围内,第一条与第 N 条的执行时间应当接近。差异来自形状覆盖:一条 1M 请求会被切成许多 chunk,chunk 尺寸的组合不可能全部预热,第一次遇到某个尺寸时仍可能触发 Triton 编译或 CUTLASS 选择。
图层:batch=1 的桶通常已捕获;如果第一条请求是长 prefill,prefill 的图本就按分段捕获,命中率取决于分段边界是否与这条请求的 chunk 对齐。未命中时回退 eager。
通信层:NCCL 通信器、DeepEP 缓冲、自定义 allreduce workspace 都已在 warmup 中建立并跑过一次集合通信,第一条请求不再支付建链成本。PD 分离部署下,prefill 与 decode 两侧的握手是每请求一次的,但底层传输通道已经就绪。
输出层:反分词进程为每条请求维护增量解码状态,第一条请求创建状态的开销与后续相同;停止串检测、流式 chunk 的回传路径也已热。
把 eager 回退的代价算清楚:78 层、每层十几个算子,一次 decode step 的 launch 数在千次量级;每次提交 3–5 微秒,累计 3–5 毫秒。batch=1 时 GPU 的有效计算只有几百微秒,提交开销占了大头。第一条请求如果回退 eager,它每一步都多付这几毫秒;生成 100 个 token,就是几百毫秒的额外时间。稳态请求命中图之后,这部分被压到一次重放,差距才显现出来。
以一条 8K prompt 的第一条请求为例:模板与分词几毫秒;调度器为它分配 8K 个 token 的预算与约 128 个 KV 页(按 64 token 一页);prefill 走一个或两个 chunk,索引器要对 8K 上下文打分并选 Top-K,主 KV 写入 8K 乘 78 层的压缩潜向量;采样出首 token 后进入 decode,batch=1 命中图桶。整条路径里,唯一可能“冷”的是 prefill chunk 的形状与索引器的打分切片;如果这两个形状在 warmup 中跑过,第一条与稳态的差异只剩前缀缓存为空这一项。
把首 token 的时间拆开,量级大致如下:
| 组成 | 第一条请求 | 稳态请求 | 差异来源 |
|---|---|---|---|
| 模板与分词 | 数毫秒 | 数毫秒 | 基本无差异 |
| 排队与调度 | 微秒到毫秒 | 微秒到毫秒 | 队列长度不同 |
| 前缀匹配 | 全量 prefill | 可能命中前缀 | 缓存为空 |
| prefill 计算 | 与 token 数成正比 | 命中后大幅缩短 | 缓存与形状 |
| 采样与反分词 | 微秒级 | 微秒级 | 无差异 |
| 图命中 | 可能回退 eager | 通常命中 | 桶覆盖与形状 |
这张表解释了一个常见误判:第一条请求慢,不一定说明“服务没预热好”。如果它是一条 1M 上下文的请求,慢的主要原因是 prefill 本身的二次方项与 KV 写入,而不是冷启动;真正能归因于冷启动的,是同一形状、同一上下文长度下第一条与第 N 条的差值。做压测时把这两类差异分开,才能判断该调 warmup、调桶,还是调调度。
长 prefill 的第一条:一个最容易误判的场景
decode 的第一条请求与稳态差异很小,真正容易误判的是长 prefill。一条 1M 请求在稳态服务里也是“第一次见”——它长到没有前缀可命中,走到哪个 chunk 形状都要现场算。它和冷启动叠加,会让首请求的 TTFT 看起来异常糟糕。
拆开看,这条请求的时间由三段组成。
调度切块。 调度器按 token 预算把 1M 切成若干个 chunk,常见一块 32768,约 32 块。每块都要重新读前缀的索引键来打分,这是分块预填对 DSA 的副作用:上下文越长,后面块的前缀读取量越大,所有块的前缀读取量之和随块数线性增长,而每块的索引器计算随上下文线性增长,两者相乘就形成了长 prefill 的主要开销。
逐块前向。 每块前向里,索引器的打分是一个随上下文线性、随块内 token 数线性的矩阵乘,再加上 Top-K 选择;主注意力只读选出来的 2048 个 KV 条目,计算量与上下文无关,瓶颈在校验和 gather 的带宽。MoE 部分按块内 token 数算,块内 token 多时 GEMM 效率高,块内 token 少时 dispatch/combine 的固定开销占主导。
KV 写入。 每块算完都要把主 KV 与索引器缓存写进池。1M 上下文的主 KV 约 53.9GB,写进 HBM 的时间与写入带宽直接相关;索引器缓存只有 21 层,约 2.8GB。
这三段里,能与“冷启动”沾边的只有形状未覆盖导致的编译与 autotune,其余都是这条请求本身的成本。压测时如果用一条 1M 请求测量“冷启动开销”,会把 prefill 的二次方项全部算进来,得出的结论会把团队引向错误的优化方向——比如去调大 warmup 的覆盖范围,而真正该做的是分块大小与索引器切片。
相反,用一条 32K 请求做首请求测量更合适:它足够长、能触发索引器的真实路径,又不会让 prefill 成本淹没冷启动的差异。在此基础上再发一条 1M,观察增量,就能把两者的贡献分开。
启动期的通信账
前十四篇把稳态每一步的集合通信算得很细。启动期还有一笔一次性的通信账,它不进入每步账本,却决定了第一条请求会不会在某个集合操作上卡住。
第一笔是 NCCL 通信器的建立。TP、DP、EP、PP 各自是一个通信组,每组在第一次集合操作时建立连接、交换拓扑、选择 Ring 或 Tree 算法。NVLink 机器与 InfiniBand 集群的建链时间差一个量级;如果 NCCL_SOCKET_IFNAME 或 NCCL_IB_HCA 配错,NCCL 会静默回退到 TCP,建链能成功,但之后每一步的 AllReduce 都走慢路径。这个错误不会让服务起不来,只会让稳态吞吐莫名下降,是部署时最值得先排除的一项。
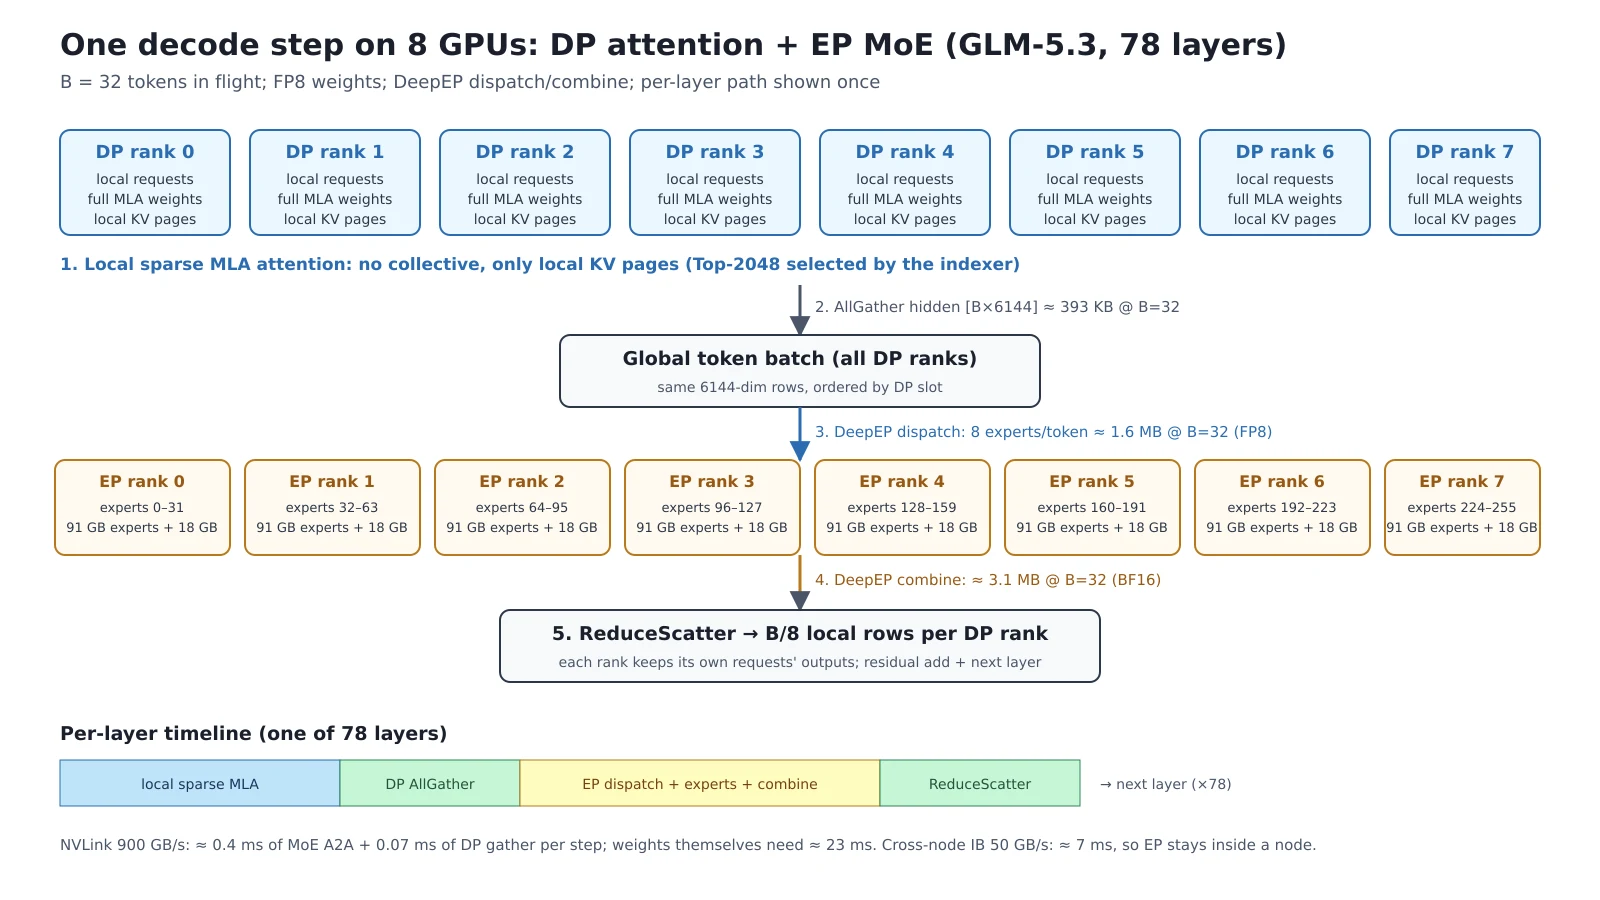
第二笔是自定义 allreduce 的 workspace。FlashInfer 的 allreduce 与 all2all workspace 需要在捕获之前分配并完成 IPC 句柄交换;这些操作带同步与集合通信,若被录进图内会与图缓冲注册死锁。SGLang 把它们放在 warmup 的前置步骤里,正是为了避免这一点。
第三笔是 DeepEP 的缓冲。MoE 的 dispatch/combine 需要一块按“每 rank 最大发送 token 数”预分配的缓冲,num_max_dispatch_tokens_per_rank 决定了它的容量。低延迟模式还会预建 QP、注册 NVSHMEM 内存。缓冲容量取小了,prefill 的大 batch 会在运行期报错;取大了,显存被吃掉,KV 池相应变小。这笔账在启动期一次定死,运行期不会自动扩。
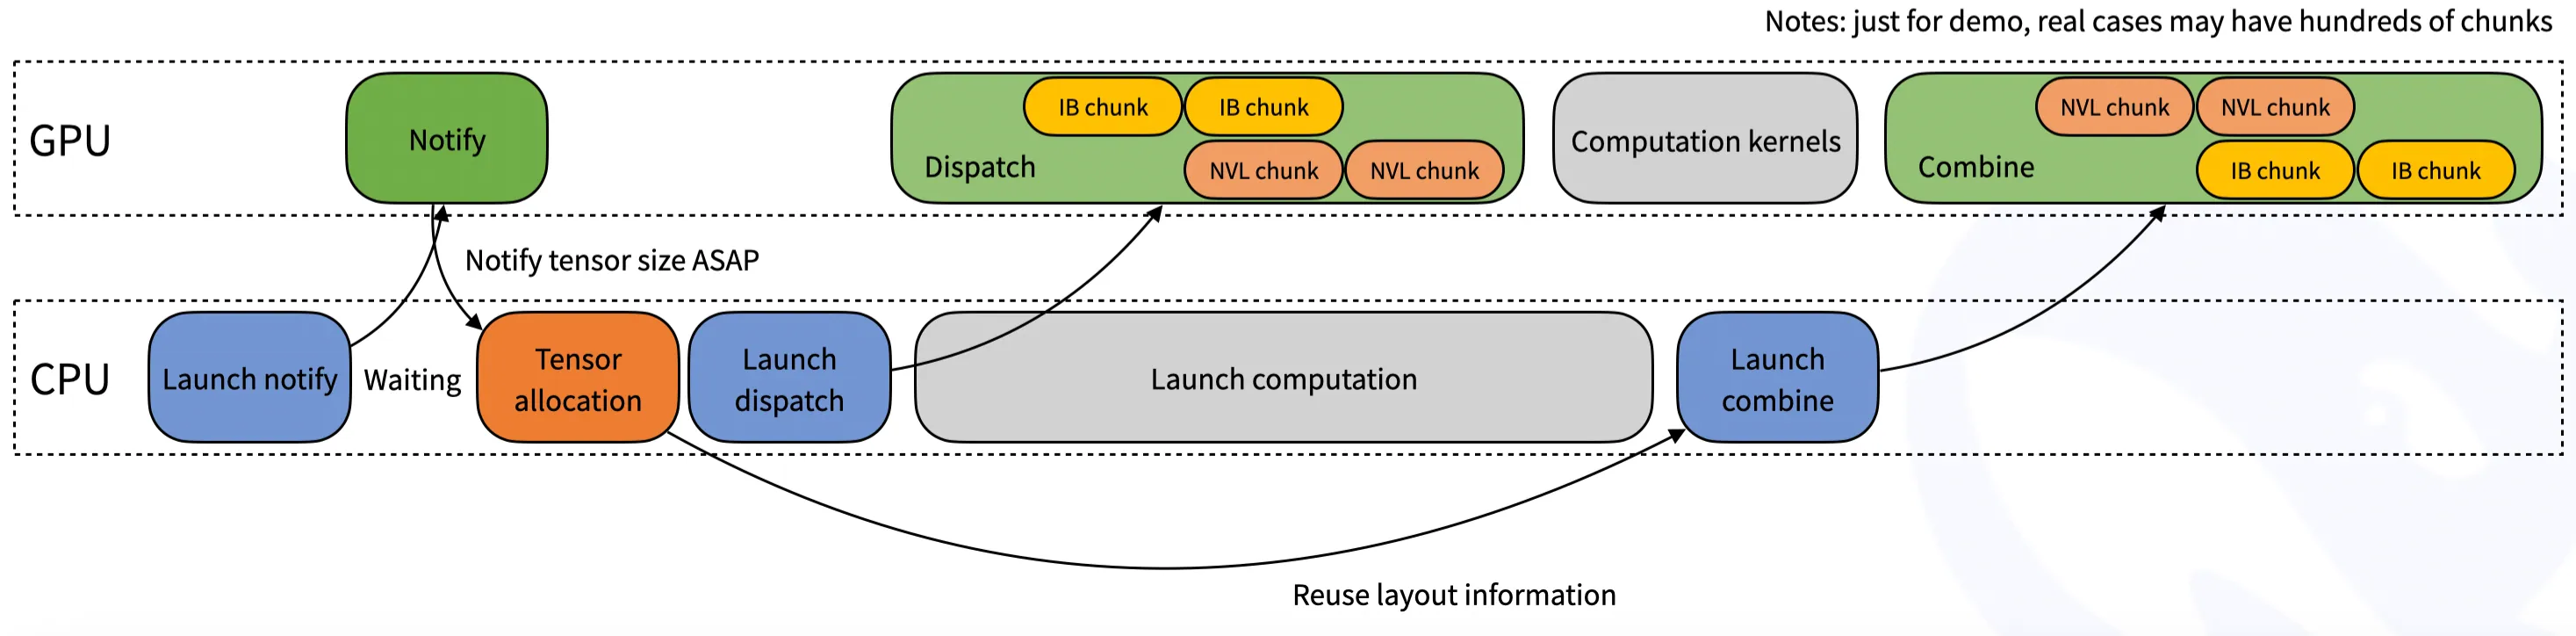
缓冲容量可以按最坏情况估:每 rank 最多发送的 token 数乘以隐藏维与元素字节,再乘上发送与接收两份。低延迟模式为了固定地址,会按上限一次分配,而不是按实际 token 数动态增长;这也是 num_max_dispatch_tokens_per_rank 取大了会明显吃掉 KV 池预算的原因。普通模式可以用更大的缓冲换吞吐,低延迟模式则要在容量与延迟之间取平衡。
第四笔是 PD 分离的启动顺序。prefill 实例要先起,把自己的传输端点注册到 bootstrap 服务;decode 实例后起,向注册表查询可用的 prefill rank。顺序反了,decode 侧握手会失败或超时;两侧的 max_req_input_len、页大小、KV 布局必须一致,否则第一条跨节点请求就会在传输阶段报布局不匹配。
PD 的启动顺序还有一层细节:prefill 侧注册的是可用的传输端点,decode 侧拿到端点后才建立连接;如果 decode 先起,它会反复重试直到 prefill 注册,日志里表现为一串连接失败,但不影响最终就绪。把重试次数设得太少,滚动发布时就会出现 decode 实例启动失败、需要重启的假故障。
这些通信资源有一个共同点:它们都是“一次建立、长期复用”。warmup 的 dummy 前向会把这些集合操作各跑一遍,让建链、QP、workspace 全部就位。第一条真实请求因此只付数据搬运的时间,不付建立连接的时间。反过来,如果为了缩短启动时间跳过 warmup,第一条请求就会在某个 AllReduce 或 dispatch 上等待建链,表现为一次无法复现的长尾。
稳态账本与首请求账本的换算
前十四篇给出的是稳态每一步的账本,单位是微秒、字节与通信次数。第一条请求的账本要在它上面加三项:启动摊销、冷路径、形状离散。
启动摊销已经尽量被启动期消化掉了,剩下的部分是那些“启动期无法覆盖”的项:未预热的 prefill 形状、未捕获的图桶、未生成状态的反分词。它们不随请求数量线性增长,只在第一次遇到时出现,可以用一个简单的模型估算:
其中 是同一形状、同一长度在稳态下的时间, 是第 个冷路径的成本, 是这条请求触发的冷路径集合。这个式子没有解释力,但它提醒一件事:首请求时间不是“稳态时间乘一个系数”,而是稳态时间加上若干离散的、一次性的事件。因此首请求的测量必须在同一服务实例上进行两次以上,第二次的时间才是稳态;只看第一次,会把所有冷路径都算成常数。
形状离散还有一层含义:同一 batch 大小在不同序列长度下的 decode,计算量可能差几个百分点,但提交开销几乎相同;所以对短序列,图带来的相对收益更大。第一条请求如果序列短、batch 小,回退 eager 的代价就显得特别大;如果序列长、batch 大,回退的代价被计算淹没。讨论“图有没有用”时,必须先固定形状。
故障案例:把启动期的账读出来
下面几个场景都发生在第一条请求或首批请求上,症状各异,但归因路径相同:先看 startup_time 的分项,再看第一条请求的时间构成。
案例一:滚动重启后首请求慢了三秒。 启动日志里 startup_time 正常,编译缓存目录位于容器可写层,容器重建后为空。第一条请求触发 Triton 与 torch.compile 的重新编译。把缓存目录挂到共享卷、或用镜像预热缓存,问题消失。判断依据是首次请求的耗时集中在 prefill 之前,且第二次请求立即恢复到稳态。
案例二:并发升到 16 之后,TPOT 出现 2–3 毫秒的台阶。 batch 1–8 命中图桶,batch 9–16 超出 cuda-graph-max-bs,回退 eager,每步多付上千次 launch。日志没有报错,只有回退计数上升。把桶上限提高到 32 并补捕获,台阶消失;代价是启动时间增加约一分钟、显存多占几百 MB。
案例三:启动后第一条 128K 请求在 prefill 中途 OOM。 mem_fraction_static 设到了 0.95,KV 池按 profile 峰值分配,几乎没给运行时临时缓冲留空间;128K 请求的索引器打分矩阵在运行时才分配,撞上了天花板。降到 0.85 之后,KV 池小了约一成,但长请求可以完成。这类 OOM 的典型特征是只在长 prompt 上出现,decode 阶段正常。
案例四:所有集合通信都比预期慢。 NCCL_IB_HCA 指向了不存在或未启用的网卡,NCCL 静默回退到 TCP。启动日志里通信器的建链时间异常长,warmup 阶段的一次 AllReduce 耗时是预期十倍。修正网卡枚举之后,不仅首请求变快,稳态吞吐也回升了一截。
案例五:多租户场景下,第一条带结构化输出的请求多出几百毫秒。 JSON Schema 第一次到来时要编译成自动机并缓存;schema 越复杂、嵌套越深,编译越慢。把常用的几个 schema 在启动期预热编译,第一条就回到与稳态一致的水平。
这五个案例的共同点是:问题不在模型、不在调度,而在“启动期应该做而没做”的那一栏。把 startup_time 拆成权重、profile、warmup、捕获四段,把首请求拆成 prefill、图命中、输出三段,两边的数字对不上时,冷路径的位置就暴露出来了。
可观测性上还缺什么。 推理框架普遍没有为“冷路径”单独打点:首次编译、首次 autotune、图回退、通信器首次建链都没有统一的事件类型。线上排查时,这些只能靠启动日志的文本、首请求的 trace 与回退计数器拼起来。一个成本不高但收益明显的做法,是在启动结束时输出一份“启动清单”——每个阶段耗时、编译缓存命中数、图桶列表、通信器实际选路——让运维不必再去日志里翻。
上线前的核对清单
把这一篇的结论压成一份可执行的清单:
- 确认权重完整:检查
weight_scale_inv是否与权重一一对应,检查加载日志里未消费的张量名单是否只包含modules_to_not_convert里的项; - 给 profile 留足临时池:
mem_fraction_static不要贴着显存上限设,profile 与图捕获都需要额外空间;先按 0.85 左右起,再根据 OOM 日志调整; - 确认图桶覆盖线上 batch:
cuda-graph-max-bs要大于等于预期的最大 decode batch;MTP 开启时,草稿、验证、draft_extend三段都要有对应桶; - 把编译缓存挂到持久卷:Triton、torch.compile、DeepGEMM 的缓存目录如果随容器销毁,滚动重启后第一条请求会重新编译;
- 预热代表性请求:用 1K、32K、128K 各发一条,覆盖常见的 chunk 形状;不要用 1M 请求做预热,成本过高且只覆盖一个极端;
- 核对 NCCL 选路:启动日志里确认走的是 NVLink/IB 而不是 TCP;PD 部署还要核对两侧的页大小与 KV 布局;
- 观察三个数:
startup_time的分项、首请求 TTFT 与稳态 p50 的比值、eager 回退计数。三者分别对应启动、冷路径与图覆盖。
小结
GLM-5.3 的第一条请求与第 N 条请求,在 GPU 上执行的算子集合几乎一样:嵌入、A 投影、索引器打分、稀疏 MLA、MoE、MTP、采样。差别在于这些算子第一次运行时附带的工作由谁支付。启动期把权重装载、显存 profile、kernel 编译与 autotune、通信建链、图捕获全部做完,第一条请求就只需要支付它自己的计算;任何一项没做完或没覆盖到,都会以长尾的形式出现在这条请求上。
从工程上看,启动期做的事可以按“替谁付钱”来归类。权重装载与显存 profile 替所有请求付了存储与容量的钱;warmup 替落在已覆盖形状上的请求付了编译与调优的钱;图捕获替batch 落在桶内的请求付了提交开销的钱;通信初始化替跨卡请求付了建链的钱。四类覆盖都有边界,边界之外就是冷路径。把边界记录下来,比一味拉长启动时间更有效。
这也是为什么“服务起来了”与“服务可用了”是两件事。前者只说明端口在监听,后者要求权重、显存、通信、图四本账都已经结清。判断服务是否真的可用,不看进程状态,看第一条真实形状的请求能否在预期时间内返回,以及它的时间构成里还有没有本应属于启动期的项目。
前十四篇的账本描述的是结清之后的稳态;这一篇描述的是结清的过程。两者合起来,才是一条请求从部署完成到稳定输出的完整路径。
参考资料
- GLM-5.3 模型卡与配置:https://huggingface.co/zai-org/GLM-5.3
- DeepSeek-V3.2 技术报告(DSA 与 MLA 的结构来源):https://arxiv.org/abs/2512.02556
- SGLang 论文:https://arxiv.org/abs/2312.07104
- SGLang 仓库:https://github.com/sgl-project/sglang
- vLLM 仓库与设计文档:https://github.com/vllm-project/vllm ,https://docs.vllm.ai/en/latest/design/arch_overview.html
- DeepEP:https://github.com/deepseek-ai/DeepEP
- DeepGEMM:https://github.com/deepseek-ai/DeepGEMM
- FlashInfer:https://github.com/flashinfer-ai/flashinfer
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



