


GLM-5.3 推理全链路(十):CPU 侧的那一半——模板、分词、ZMQ 与调度器控制面
先读这一篇的场景:谁在什么配置下跑
全篇以一条具体请求为准绳,后面所有代码与数字都围绕它:
- 部署:单节点 8×H200,SGLang 主干,
--tp-size 8 --attn-dp-size 8 --ep-size 8(即 TP8 + DP Attention + EP),GLM-5.3 FP8 权重,默认端口; - 请求:
POST /v1/chat/completions,单轮对话,带 3 个工具定义,不带图片;输入约 1,024 token(含模板),要求生成 256 token; - 客户端:
stream=true,n=1,未设置stop与stop_token_ids; - 观测:
--enable-metrics关闭,只看默认回传的queue_time、first_token_latency、decode_throughput。
选这个配置有两个原因。第一,TP8 + DP Attention 是 GLM-5.3 在单机上的常见形态,也必然经过 DP 控制器那一跳;第二,1K 输入意味着模板与分词的开销不会被长度淹没,便于看清每一站的比例。文中凡是涉及长度的讨论,都会单独指出放大到 100K 时的变化。
前九篇的起点,其实选在了半山腰
前九篇的空间从 ForwardBatch 开始:调度器选出 batch,ModelRunner 把它变成 GPU 张量,然后是 78 层、MoE、索引器、采样、KV 回收。这条路径里的每一步都发生在调度进程内,所有数据结构都是 Python 对象或 GPU 张量。
但在一次真实的 HTTP 请求里,ForwardBatch 既不是起点,也不是终点。起点是 socket 上的字节,终点是另一段 socket 上的 SSE 帧。中间隔着至少三个进程、三条 ZMQ 数据通道、一张请求状态表和两个 tokenizer(一个把文本变 id,一个把 id 变文本)。这一半的工作不产生任何 FLOP,却决定了三件事:
- 请求能否被正确地“翻译”成模型认识的形式(模板与分词);
- 请求在多个并行组之间如何被路由、排队、取消(控制面);
- 生成出来的 token 如何变回文本,并在什么时刻停止(输出面)。
第十篇补上这一段。GPU 内部的算子与通信已经在前九篇里拆过,本篇不再重复;所有关于前向细节的结论,都只作为“下一站”引用。
先把部署拓扑画出来:谁在哪个进程
SGLang 的 sglang serve 拉起来的不是一个进程,而是一组。entrypoints/engine.py 的注释把默认布局写得非常直接:
1. TokenizerManager: Tokenizes the requests and sends them to the scheduler.2. Scheduler (subprocess): Receives requests from the Tokenizer Manager, schedules batches, forwards them, and sends the output tokens to the Detokenizer Manager.3. DetokenizerManager (subprocess): Detokenizes the output tokens and sends the result back to the Tokenizer Manager.由此得到默认形态下的四个角色:
| 角色 | 所在进程 | 负责 |
|---|---|---|
| HTTP server(FastAPI/uvicorn) | 主进程 | 协议解析、模板渲染、SSE 回传 |
| TokenizerManager | 主进程 | 分词、请求状态表、输出分发 |
| Scheduler + ModelRunner | 每 TP/DP rank 一个子进程 | 调度、KV 分配、GPU 前向、采样 |
| DetokenizerManager | 独立子进程 | 增量反分词、停止串裁剪 |
注意第一行与第二行同属主进程:HTTP 与 TokenizerManager 之间没有 ZMQ,它们通过 asyncio 直接调用。真正跨进程的边界只有两条:主进程 ↔ 调度进程,调度进程 ↔ 反分词进程。若开启 --tokenizer-worker-num N(N > 1),主进程里只剩一个 MultiTokenizerRouter,分词被拆到 N 个 TokenizerWorker 进程里,边界会再多一条。
通道名定义在 server_args.py 的 PortArgs 里,每个名字都指明了方向:
class PortArgs: tokenizer_ipc_name: str # detokenizer -> tokenizer scheduler_input_ipc_name: str # tokenizer -> scheduler(rank 0) detokenizer_ipc_name: str # scheduler -> detokenizer nccl_port: int # torch.dist 初始化 rpc_ipc_name: str # Engine 与 Scheduler 之间的 RPC metrics_ipc_name: str # Scheduler 上报 metrics三条数据通道都用 ZMQ 的 PUSH/PULL 组合:发送端 PUSH、接收端 PULL。managers/scheduler_components/ipc_channels.py 把调度器这一侧的套接字一次建齐:
recv_from_tokenizer = get_zmq_socket(context, zmq.PULL, port_args.scheduler_input_ipc_name, False)send_to_tokenizer = get_zmq_socket(context, zmq.PUSH, port_args.tokenizer_ipc_name, False)send_to_detokenizer = get_zmq_socket(context, zmq.PUSH, port_args.detokenizer_ipc_name, False)注意只有 rank 0 的调度进程创建收件套接字,其余 rank 的 recv_from_tokenizer 为 None:请求只进 rank 0,调度结果再由 rank 0 按 TP 组的同步方式分发给同组其余 rank。这样避免了同一请求在多个 rank 上被重复解析、重复排队。
PUSH/PULL 没有应答,发送成功只代表消息进了队列,不代表对端处理完。这一点决定了后面所有“超时”“取消”“背压”的行为方式——它们都不是靠通道本身实现的,而是靠上层的状态表与轮询。还有一个例外值得记住:send_to_tokenizer 在 --skip-tokenizer-init 下被复用为“直发 API 侧”的通道,send_to_detokenizer 也指向同一个地址,因为没有反分词这一步。代码里对此有明确注释,改输出协议时两处要一起看。
如果开启 DP Attention(新参数是 --attn-dp-size N,旧写法 --dp-size N --enable-dp-attention 会被归一化成它),拓扑里还会多出一个 DataParallelController 进程。它站在 TokenizerManager 与各 DP 调度器之间,只做一件事:给每条请求选一个 DP rank。此时路径变成“主进程 → DP 控制器 → 第 r 个调度进程”,多了一跳。
多 tokenizer 模式:主进程只剩一个路由器
当 --tokenizer-worker-num N 大于 1,主进程里的 TokenizerManager 被替换成 MultiTokenizerRouter,它的职责只剩“把请求转发给某个 worker、把 worker 的输出路由回对应的 HTTP 连接”。启动数据通过共享内存传给各 worker:
self._multi_tokenizer_shm = write_data_for_multi_tokenizer( port_args, server_args, scheduler_info)这个模式有两个约束值得记住:
- API key 鉴权不可用。代码在拉起多 tokenizer worker 时直接断言
get_serving().api_key is None(注释:API key authentication is not supported in multi-tokenizer mode),因为鉴权发生在每个 worker 进程里,而 router 不做业务逻辑; - rid 必须全局唯一。健康检查的 rid 用
uuid4().hex而不是时间戳,注释写明了原因:多 worker 下时间戳可能碰撞,碰撞后共享的反分词进程decode_status会被覆盖,直接崩掉。
多 worker 的收益与风险都很明确:分词吞吐按 worker 数扩展,代价是每个 worker 都要维护自己的 tokenizer 状态与请求表,路由层不再有全局视图。排查问题时,rid 是唯一能跨 worker 对齐的键。
启动期的握手:第一条请求在等什么
主进程在监听端口之前,要先等所有调度进程报到一个初始化结果。这个结果不是“我起来了”这么简单,它带着三个后续要用的常量:
max_req_input_len:模型上下文扣掉生成长度后的最大输入长度,决定 HTTP 层在第 1 站就拒绝哪些请求;startup_time:各阶段耗时,用于日志与就绪判断;- 各 rank 的并行拓扑与显存池信息。
entrypoints/http_server.py 在初始化时把它们挂到 TokenizerManager 上:
tokenizer_manager.max_req_input_len = scheduler_info["max_req_input_len"]tokenizer_manager.set_startup_time(scheduler_info["startup_time"])也就是说,输入长度的上限来自调度进程,而不是 HTTP 层自己算的。这保证了“HTTP 拒绝”与“调度器接受”用的是同一把尺子;否则会出现请求进了调度器、在 prefill 阶段才因超长失败的情况。
就绪状态本身也有一个三元枚举:
class ServerStatus(Enum): Up = "Up" Starting = "Starting" UnHealthy = "UnHealthy"/health 在 Starting 阶段直接返回 503,在 Up 阶段才做真实检查。健康检查本身不是“读一个布尔值”,而是发一条 input_ids=[0]、max_new_tokens=1 的真实请求,然后等 TokenizerManager 的 last_receive_tstamp 更新:
task = asyncio.create_task(gen())tic = time.time()while time.time() < tic + HEALTH_CHECK_TIMEOUT: await asyncio.sleep(1) if _global_state.tokenizer_manager.last_receive_tstamp > tic: task.cancel() ... return Response(status_code=200)它验证的是一条完整回路:HTTP → 分词 → ZMQ → 调度器 → 反分词 → 回传。只要其中一段断了,last_receive_tstamp 就不会前进,HEALTH_CHECK_TIMEOUT(默认 20 秒)后返回 503。这个设计把“健康”定义为“端到端能走通一次最小请求”,而不是“进程还活着”。
第 1 站:从 socket 到 ChatCompletionRequest
先补一层协议栈。TCP 连接、TLS、HTTP/1.1 或 HTTP/2 的解析都由 uvicorn 与 h11/httptools 完成,这一层不在 SGLang 的代码里,但它决定了第 1 站的输入形态:
- HTTP/1.1 与 keep-alive:同一条连接上的多个请求顺序解析,队头阻塞在协议层就存在;SSE 流式响应会占住整条连接直到结束,所以浏览器对同一域名的并发请求数有上限(通常是 6)。压测高并发时,连接复用比协议本身更重要。
- HTTP/2:
--enable-http2会把 ASGI 服务器从 uvicorn 换成 Granian,由它做 HTTP/1.1 与 h2c 的自动协商,并给出http2_max_concurrent_streams与连接级窗口两个参数。多路复用让一个连接承载多个流,但每个流的读仍落在同一个进程的事件循环里;一条大请求体的读取照样会与分词竞争同一线程。 Content-Length与 chunked:SGLang 的入口层用一个ORJSONRequest覆盖Request.json(),走orjson.loads(await self.body()),必须先拿到完整请求体才能解析,因此流式上传的请求体也要全部读完。一个慢速客户端发送 1MB 的tools定义,会把这条连接的事件循环时间拉长。
协议层之后才是 FastAPI 的路由与 pydantic 校验。这一段的时间往往被低估:pydantic v2 的模型校验在带嵌套 tools、messages 数组与多模态内容时,单次可达几百微秒。对 TTFT 敏感的服务,把 tools 的 schema 提前编译缓存是常见做法。
HTTP 服务跑在主进程的 uvicorn 事件循环里。一个 POST /v1/chat/completions 到达后,先经过 FastAPI 的路由与依赖注入,再进入 OpenAIServingChat.chat_completion。这一段是纯 CPU、纯 Python:
- 请求体解析:
orjson把字节解析成字典,pydantic 模型ChatCompletionRequest做字段校验与类型转换。输入 1K token 的请求体通常只有几 KB,解析在几十微秒量级;带logit_bias、大量stop字符串或tools定义时会放大到毫秒级。 - 参数归一化:
temperature、top_p、top_k、max_tokens、stop、stream、stream_options被打包成SamplingParams。max_tokens缺省时按模型上下文上限与输入长度推算。 - 约束解码准备:若
response_format是 JSON schema,后端(xgrammar/outlines)会预编译一个 FSM,后续每个 step 生成 bitmask。这一步的代价与 schema 复杂度相关,和输入长度无关。 - 模板选择:按模型 id 或
--chat-template找到模板;GLM-5.3 走的是模型自带的模板(下一节展开)。 - 请求对象构造:把渲染后的 prompt、sampling 参数、
rid、stream等装进GenerateReqInput,交给 TokenizerManager。
这一段里最容易被误判为“开销很小”的是模板渲染。它不是字符串拼接:GLM-5.3 的模板要处理 reasoning effort、历史思考段、工具定义与多模态占位,逻辑量比普通 chat template 大得多。
第 2 站:GLM-5.3 的模板到底做了什么
SGLang 的 parser/glm53_chat_template.py 是 GLM-5.3 官方 Jinja 模板的 Python 等价实现,文件头写明“输出与 Jinja 模板逐字节一致”。把它读一遍,就能看清一个请求在进入 tokenizer 之前被改写成了什么。
控制行与思考段
模板会在系统段写入一行显式的推理预算:
effective_reasoning_effort = ( reasoning_effort if reasoning_effort in ("low", "high") else "max")f"Reasoning Effort: {effective_reasoning_effort.capitalize()}"也就是说,reasoning_effort 只接受 low、high,其余值一律按 max 处理。这不是校验松弛,而是模板的语义:GLM-5.3 的推理预算是一个离散档位,非法值回落到最高档。
历史消息里的思考段由 clear_thinking 决定是否保留:
if (not clear_thinking or index > last_user_index) and ( reasoning is not _UNDEFINED): parts.append("<think>" + reasoning + "</think>")clear_thinking=True 时,只有最后一条用户消息之后的思考段被保留,更早的思考段被丢弃。这条规则直接改变 prompt 长度:多轮对话里,如果每一轮都回传完整思考内容,prompt 会随轮数线性膨胀;清空之后,只剩最近一段。它是“同一段对话为什么第二次请求的 token 数差很多”的常见原因。
思考段为什么不能原样留到最后
clear_thinking=True 时保留“最后一条用户消息之后的思考段”,而不是“最后一段思考”。这两个说法在多轮对话里差别很大:一条消息可能先产生思考、再产生回答,回答之后又有工具结果;模板按消息在列表中的位置决定去留,而不是按内容类型。结果就是:
- 当前轮之前的思考被全部丢弃,prompt 只随对话轮数增长回答部分;
- 当前轮里如果包含工具调用循环,思考段仍会被保留,因为它们在最后一条用户消息之后。
对推理模型的成本核算,这条规则意味着“同一段对话重发时,prompt 长度不连续”:一次 clear_thinking 的切换可能让 prompt 从 50K 降到 8K。
工具定义改写成 XML
工具不是以 JSON schema 原样塞进 prompt,而是被改写成一段带固定格式说明的 XML:
# Tools
You may call one or more functions to assist with the user query.
You are provided with function signatures within <tools></tools> XML tags:<tools>...</tools>
For each function call, output the function name and arguments within thefollowing XML format:<tool_call>{function-name}<arg_key>{arg-key-1}</arg_key><arg_value>{arg-value-1}</arg_value>...</tool_call>这段文本本身会消耗 token:工具越多、参数 schema 越长,<tools> 块越大。工具调用的输出解析(--tool-call-parser)读的也是同一套 <tool_call> 标记,因此模板与解析器必须成对配置;只改一个,模型输出的工具调用就无法被正确解析。
多模态占位
图片、视频、音频在文本里被替换成特殊 token:
_IMAGE_TOKENS = "<|begin_of_image|><|image|><|end_of_image|>"_VIDEO_TOKENS = "<|begin_of_video|><|video|><|end_of_video|>"_AUDIO_TOKENS = "<|begin_of_audio|><|end_of_audio|>"不支持多模态的变体会把媒体块替换成一条 <reminder> 文本,说明无法处理该输入,而不是静默丢弃。这个设计避免了“用户发了图、模型却当没看见”的静默错误。
模板渲染完成后,prompt 是一段纯文本。它接下来要过的关卡是分词。
第 3 站:分词与请求对象的诞生
TokenizerManager.generate_request 是主进程里所有请求的总入口。它的骨架很短:
async def generate_request(self, obj, request=None): self.auto_create_handle_loop() obj.normalize_batch_and_arguments() self._set_default_priority(obj) ... self._init_req_state(obj, request) ... tokenized_obj = await self._tokenize_one_request(obj) ... await self._send_one_request(tokenized_obj) async for response in self._wait_one_response(obj, request): yield response三件事值得展开。
分词是异步的,但 GIL 仍然存在
_tokenize_one_request 把文本交给 tokenizer 后端(HF tokenizer 的 Rust/C++ 实现)。它被写成 async,但真正的编码发生在 C++ 层,释放 GIL 的时间取决于后端实现。多请求并发时,分词吞吐由 tokenizer 后端的线程模型决定,而不是 asyncio 的协程数。HTTP 与分词同进程的代价就在这里:一个超大 prompt 的分词会挤占事件循环所在进程的 CPU,影响同一时刻其他连接的网络读写。
--tokenizer-worker-num N 把分词拆成独立进程,正是为了把这段 CPU 从 HTTP 进程里挪走;代价是多一次进程间转发。
超长输入在这里被拒
长度校验发生在分词之后:_validate_one_request 已经拿到 input_ids,用 input_token_num(加上保留 token)与 context_len 比较。超过上限时有两种行为——默认直接 raise ValueError,由 HTTP 层返回 400;开启 --allow-auto-truncate 时改为截断输入,并打印一条警告。随后还会校验“输入 + max_new_tokens”是否超过 _max_req_len,同样支持截断。
这个“早退”很重要:如果放进去,调度器会为它分配 KV 页、尝试 prefill,最后在某个 step 里失败,代价是几十毫秒的 GPU 时间与一次 KV 分配回滚。它也是第 7 站里 max_req_input_len 的来源——校验用的就是调度进程上报的那个值。
n 参数把一条请求变成一批
OpenAI 接口的 n(平行采样数)在 SGLang 里不是在调度器实现的,而是在分词之前被展开成批次:
if self.parallel_sample_num > 1 and self.is_single: self.is_single = False if self.text is not None: self.text = [self.text] ...一次 n=4 的请求会变成 batch_size=4 的批请求,走 _handle_batch_request 而不是单请求路径。generate_request 里对应两个分支:
if obj.is_single: ... async for response in self._wait_one_response(obj, request): yield responseelse: async for response in self._handle_batch_request(obj, request, request_states): yield response这个展开带来三个后果:
第一,4 条请求共享同一段 prompt。分词只做一次:_handle_batch_request 走 _batch_tokenize_and_process 时把整批文本交给 _tokenize_texts,一次 batch_encode 得到 4 份相同的 input_ids。但调度器看到的是 4 个独立 Req,前缀缓存会在第一条上 miss、后三条上 hit,命中量在 cached_tokens 里逐条体现。
第二,4 条请求可以被路由到不同 DP rank。_send_batch_request 按条发送,DP 控制器逐条选路,不保证同组。这会让前缀缓存的收益打折:只有落在同一 rank 的后继请求才能命中第一条写入的 KV。要让 4 条请求共享 KV,要么用 input_ids 只发一条、在应用侧并行采样,要么在路由器层面按 prompt 哈希路由。
第三,输出侧要按 n 扇出。_handle_batch_request 为每个子请求维护一个 ReqState,合并 SSE 时要按 OpenAI 的 choices 格式编号(index=0..n-1)。这也意味着同一条 HTTP 连接的输出量是单请求的 n 倍,反分词进程与 SSE 写出的压力同比例增长。
--skip-tokenizer-init 是一条旁路
RL 训练与服务化场景常直接传 input_ids。开启 --skip-tokenizer-init 后,TokenizerManager 不加载 tokenizer,请求里必须自带 input_ids,输出也以 token id 形式返回,由调用方自行解码。这条旁路把“文本 ↔ token”的两次转换都移出了服务进程,代价是 HTTP 层不能再做模板渲染与停止串匹配。
分词完成后,TokenizedGenerateReqInput 携带 input_ids、sampling_params、rid、stream、time_stats 等字段,经 _send_one_request 序列化后 PUSH 给调度器。
第 4 站:ZMQ 之后,请求变成状态表里的一行
跨进程之后,“请求”不再是一个对象,而是状态表里的一个条目。TokenizerManager 用 rid_to_state 保存每条在途请求的 ReqState:
@dataclassclass ReqState: out_list: List[Dict[Any, Any]] finished: bool event: asyncio.Event obj: Union[GenerateReqInput, EmbeddingReqInput] time_stats: APIServerReqTimeStats dispatched: bool = False abort_sent: bool = False last_output_offset: int = 0 text: str = "" text_chunks: List[str] = dataclasses.field(default_factory=list)这张表承担了三个职责:
- 会合:请求侧在
_stream_one_response里等state.event,输出侧在_handle_batch_output里把结果追加到out_list后set()事件。ZMQ 是单向 PUSH/PULL,回程靠的就是这张表和事件对象。 - 断连检测:它有两条路径。排队中(还没有第一帧可发)时,
asyncio.wait_for(state.event.wait(), timeout=_REQUEST_STATE_WAIT_TIMEOUT)到点后检查request.is_disconnected()(超时来自SGLANG_REQUEST_STATE_WAIT_TIMEOUT,默认 4 秒);出流中,每次准备发送下一帧之前也会检查一次。任何一条命中都会调用abort_request(rid)并向调度器发出AbortReq。没有这一步,一个断开的客户端会留下一条永远在跑的请求,持续占 KV。 - 幂等取消:
abort_request用state.abort_sent去重。同一个 rid 的重复 abort(客户端断开与超时同时触发)只会向调度器发一次,避免调度器侧重复处理。
abort_sent 还有一层含义:取消是“尽力而为”。ZMQ PUSH 成功只说明消息进了队列;如果调度进程已经卡在 CUDA 同步里,abort 要等下一次 process_input_requests 才会被看到。在 decode 步长 5ms 的场景里这无感;在一条 1M prefill 正在跑的进程里,abort 可能要等一个 chunk 结束。
第 5 站:时间戳跨进程会“翻译”一次
在进入 DP 与调度之前,要先说清一个容易被忽略的细节:同一条请求在不同进程里,时间不是同一个时钟。
ReqState.time_stats 用 time.perf_counter() 记录 created_time、tokenize_finish_time、api_server_dispatch_time、api_server_dispatch_finish_time、first_token_time。perf_counter 是进程内的单调时钟,换一个 PID 就没有意义。
调度进程收到请求后,会换成自己的 perf_counter 口径。SchedulerReqTimeStats 因此把 API 侧的绝对时间字段标成占位:
# Placeholder: not used currently# propagated from tokenizer/grpc_server or dp controllercreated_time: float = 0.0api_server_dispatch_time: float = 0.0dpc_dispatch_time: float = 0.0替代品是调度器自己测得的阶段时长:wait_queue_entry_time、forward_entry_time、prefill_finished_time,以及累计字段 queue_duration_s。注释里写得很清楚:queue_duration_s 必须在客户端一侧读出,因为“时间戳无法重建时长”。这也是为什么线上监控里 queue_time 是一个时长而不是时间点——它由调度器测,随 BatchTokenIDOutput 回传,最后被 TokenizerManager 写进 meta_info。
DP Attention 下还有第三种时钟:DPControllerReqTimeStats 记录 dpc_dispatch_time 与 dpc_dispatch_finish_time。它同样不向后传播原始时间戳,只做阶段计时。多一跳之后,“请求在控制器里停了多久”只能靠这一对字段算出来。
三类时间统计的传播方向也不同:API 侧统计随请求去调度器,调度器统计随输出回反分词与 API 侧。方向相反,字段不同,不能混在一张表里算总延迟。要看端到端,只能用 first_token_latency 这类由 API 侧单侧计算的值。
第 6 站:DP Attention 下多出来的一跳
前面说过,开启 DP Attention 会多一个 DataParallelController 进程。它的存在不是为了转发,而是为了选路。managers/data_parallel_controller.py 定义了四种策略:
| 策略 | 选择依据 | 适用 |
|---|---|---|
round_robin | 轮转 | 请求长度均匀 |
follow_bootstrap_room | PD 分离的 room 号取模 | PD 部署,保证 prefill/decode 落在同一组 |
total_requests | 队列长度最小 | 请求长度差异大 |
total_tokens | 在途 token 总数最小 | 长上下文混短请求 |
total_tokens 的实现有一个细节值得注意:它用的“token 数”是请求到达时的估计值,也就是 len(req.input_ids),而不是实际会被算的 token 数:
def total_tokens_scheduler(self, req: Req): if self.maybe_external_dp_rank_routing(req): return estimated_tokens = len(req.input_ids) target_worker = self.dp_budget.dispatch( LoadBalanceMethod.TOTAL_TOKENS, estimated_tokens=estimated_tokens ) sock_send(self.workers[target_worker], req)这意味着两件事。第一,前缀缓存命中不会反映在路由上:一条 100K 输入但命中 90K 前缀的请求,仍按 100K 计入负载,可能被分到一个其实很空的 rank。第二,DP 控制器看不到各 rank 的实时队列,它维护的计数按每条路由消息递增,靠调度器周期性上报的 Load 校正。高并发下,这个估计会短暂失真。
maybe_external_dp_rank_routing 允许调用方用请求头 x-override-routed-dp-rank 直接指定 rank。它主要给 PD 分离与调试用:调用方知道请求应该去哪一组,就不需要控制器再猜。
选完 rank 后,请求被 PUSH 给对应调度进程。此后的所有调度、KV 分配、GPU 前向都只发生在那个进程里;DP 组之间不共享请求队列,也不共享 KV。
第 7 站:调度器的收件箱
调度进程的主循环在 managers/scheduler.py。默认的 event_loop_normal 每轮做四件事:
while True: self.ingest_requests() plan = self.get_next_batch_to_run(running_batch=self.running_batch, last_batch=self.last_batch) ... if batch: result = self.run_batch(batch) self.process_batch_result(batch, result) else: self.on_idle()对一条新请求来说,它首先出现在 ingest_requests() 里。这个函数从 ZMQ 收一批消息,再交给 process_input_requests 分发。分发的分支不多,但每个都对应一类控制面行为:
- 普通生成请求:构造
Req,调用init_next_round_input做前缀匹配,再进入waiting_queue; - 健康检查:
/health_generate的请求有一个特殊 rid 前缀,若服务正忙,调度器直接把“健康”结果回给对应的 HTTP worker,不占用调度步; - abort:找到
Req并从队列或 running batch 中移除,释放 KV; - 控制类请求:flush cache、暂停/继续、导出指标等。
前缀匹配发生在排队之前
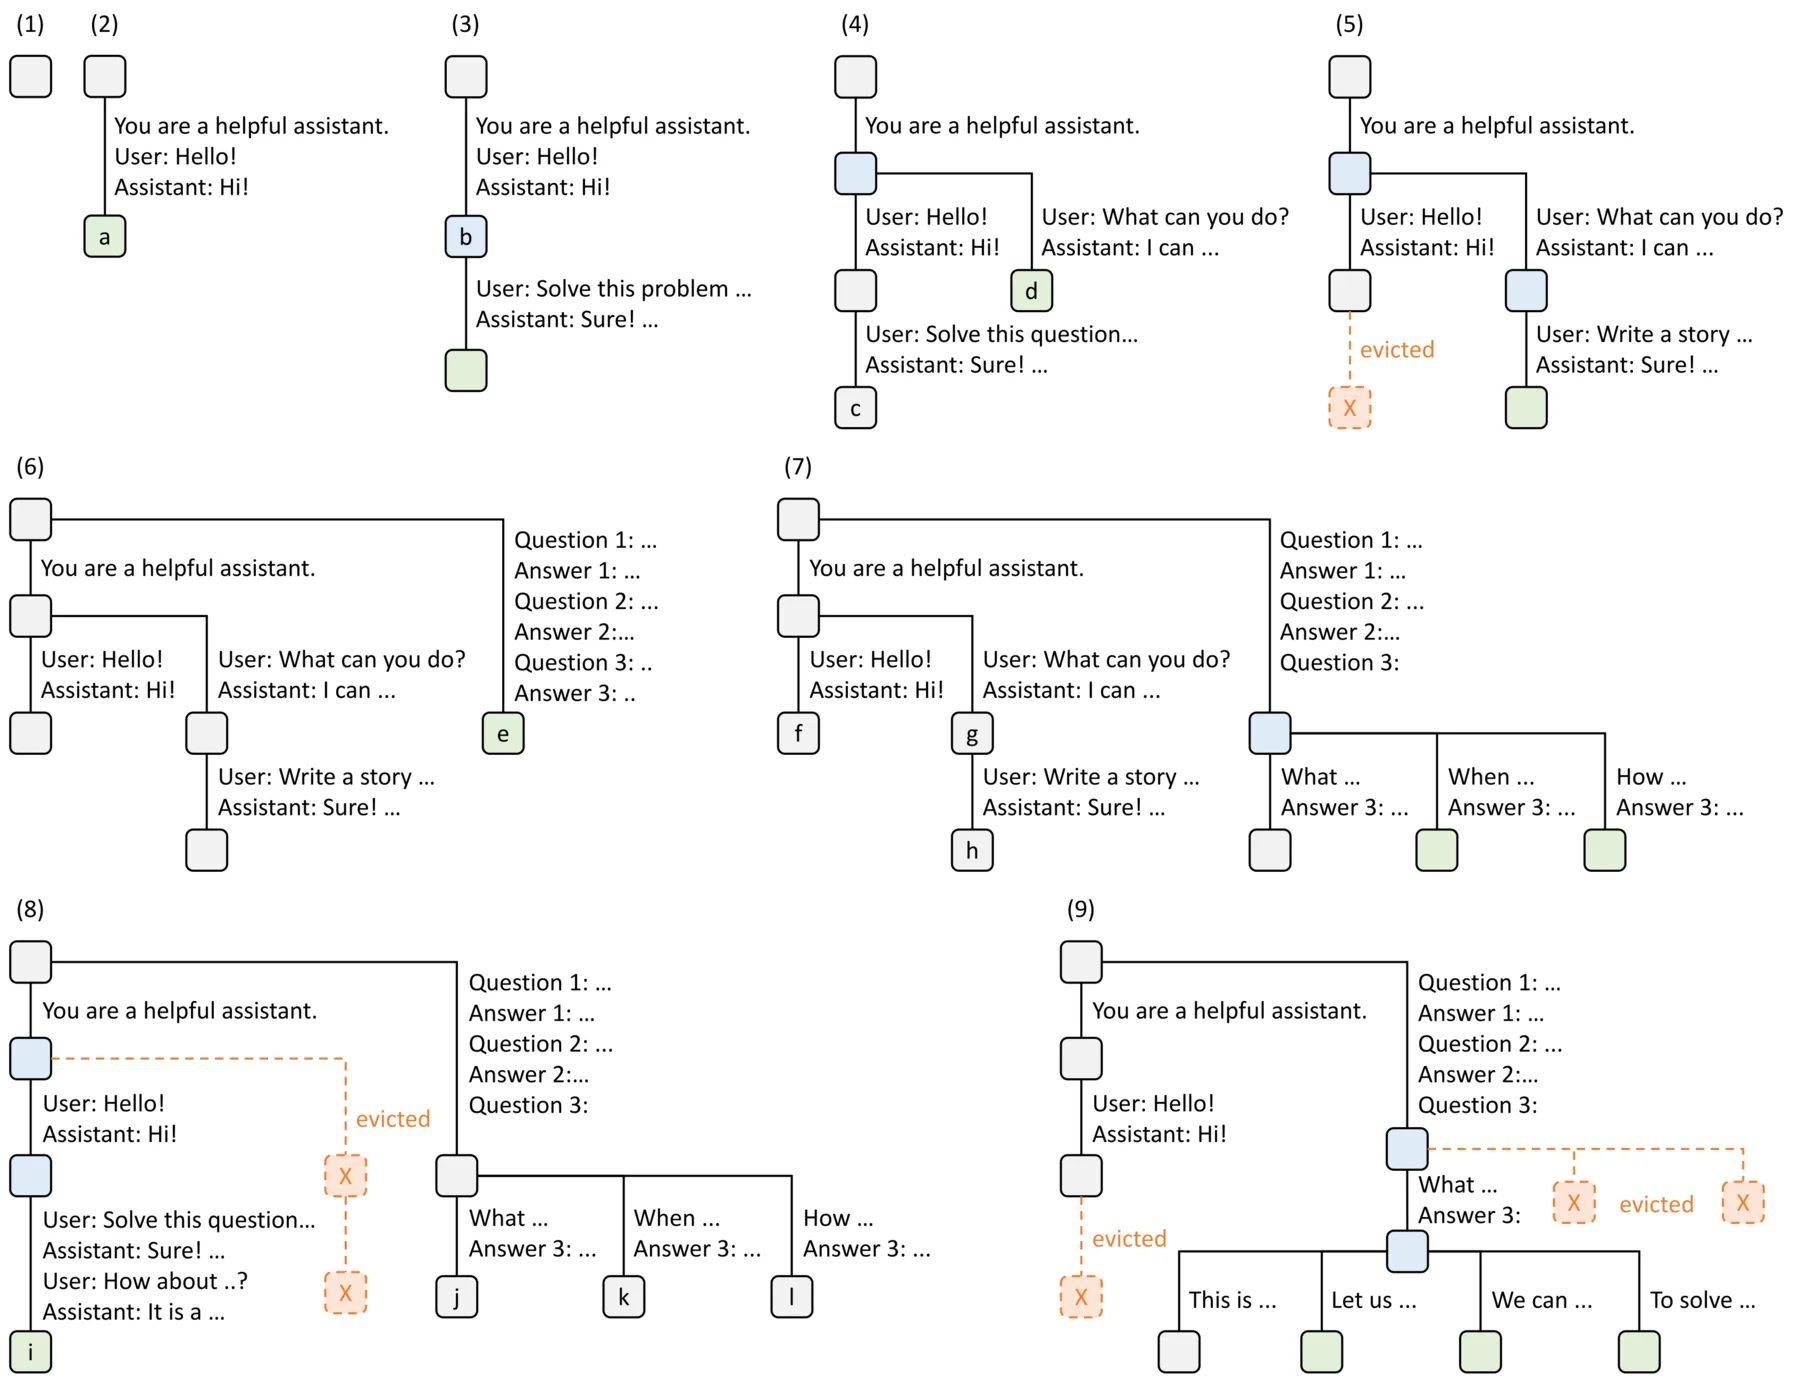
init_next_round_input 里最重的一步是 prefix cache 匹配:
match_result = match_kv_cache( self, tree_cache, token_ids_to_match, key_limit, ...)匹配结果决定 prefix_len,也就是这次 prefill 需要算多少 token。对一条命中 90% 前缀的请求,extend_len 只剩 10%,GPU 时间与 KV 写入都按 10% 计。但匹配本身是 CPU 工作:radix tree 按块比较 token,块越多、命中越深,比较次数越多。1M token 的请求在 64 token/块的粒度下是 16384 次块级比较,量级在毫秒到十几毫秒。
排队之后,请求还要等 KV 页
进入 waiting_queue 不等于马上被调度。get_next_batch_to_run 按策略取请求,取到之后要为新 token 分配 KV 页;池子不够时,请求留在队列里。对 1M 上下文的请求,这一步是硬门槛:57GB 的主 KV 加索引器缓存必须能在目标 rank 上凑齐,否则它永远不会被选中。前一篇文章算过这笔容量账,这里只强调一点——准入判断发生在 CPU 侧,早于任何 GPU kernel。
KV 命中不等于 HBM 命中
match_kv_cache 找到的前缀不一定在 GPU 上。SGLang 的多级缓存会把命中的 token 按来源拆成三类,随输出消息回传:
class CachedTokensDetails(BaseModel): device: int = 0 # Tokens from device cache (GPU) host: int = 0 # Tokens from host cache (CPU memory) storage: Optional[int] = None # Tokens from L3 storage backend storage_backend: Optional[str] = None这个拆分对 GLM-5.3 尤其重要。DSA 的前缀缓存命中不仅意味着主 KV 可以复用,还意味着 21 个 full 层的索引器 K 可以复用;但“复用”的操作数可能不在 HBM 里。如果命中来自 host 层,调度器要先发起一次 H2D 拷贝,把 KV 与索引器 K 搬进显存,再算增量 prefill。这次拷贝按 656 + 132 字节每 token 计算,1M token 满命中时是 788GB 的 H2D 数据传输——比重新做一次 1M prefill 便宜,但绝不是免费的。
所以观察一条请求的 cached_tokens 时,只看总数会误判:device 部分才是真正省掉了 GPU 计算与前缀读写;host 与 storage 部分省的是计算,换来的是传输。PD 分离下还有一层:prefill 节点命中了 L3,而 decode 节点本地可能根本没有 storage backend,storage 的数值是通过元数据带过去的,代码注释在 get_cached_tokens_details 里专门提到了这一点。
空闲时调度器在做什么
get_next_batch_to_run 返回空 batch 时,调度器不进入忙等,而是调用 on_idle。它的注释把职责分成五段:
"""Idle housekeeping: guard, check, metrics, reset, sleep."""- guard:发布一次负载快照。代码里特别说明,即使“没有 batch 但引擎没闲着”(KV 压力下请求停在队列、PD 传输卡住),也要发布,否则
/get_loads与 DP 均衡会冻结——这正是第 6 站里 DP 控制器依赖的实时负载来源。 - check:显存池的泄漏检查,包括 token 级与字节级两套账本,以及 radix tree 的一致性检查。它只在完全空闲时跑,因为忙时页被临时借出,计数本来就会短暂不一致。
- metrics / kv 事件:周期性上报,KV 事件发布给外部缓存管理器。
- reset:重置 token 比例追踪器。
- sleep:
maybe_sleep_on_idle,长时间空闲时降低 CPU 占用。
这段代码对理解“为什么空闲时的 /get_loads 也不撒谎”很重要:负载不是由请求到达时累加的,而是由调度器自己测的队列长度,经 publish_load_stat 推给控制器。路由侧看到的数字,源头在调度器的 waiting_queue 与 running_batch。
调度器也会主动“通知失败”
控制面不是单向的。调度器可以在输出流之外结束一条请求,并通过 AbortReq 主动告知 API 侧:
def send_abort_output(self, abort_req: AbortReq, req: Req) -> None: """Report a request the scheduler ends outside the output stream (aborted while queued, preempted, retracted or rejected).""" ... self.ipc_channels.send_to_tokenizer.send_output(abort_req, req)注意它走的是 send_to_tokenizer,不是 send_to_detokenizer:这是一条状态通知,不需要反分词。触发点有六处:排队的请求被 abort、被抢占(preempted)、被撤下重算(retracted)、在准备阶段被拒绝、输出侧检测到非法状态、以及取消正在 transfer 的请求。
对 GLM-5.3 的 1M 上下文场景,“被撤下重算”是常见的一种。KV 池装不下一条超长请求时,调度器可能先跑起来、再在 KV 紧张时把它撤下,放回等待队列。API 侧收到的 AbortReq 不是“请求失败”,而是“请求暂时退出”。_handle_batch_output 会把这类 finish_reason 当作 dict 处理,转成一条错误或重试提示。区分“真失败”与“暂时退出”,是客户端重试策略必须处理的问题。
API 侧对这类结束的翻译逻辑集中在 _handle_abort_finish_reason:
finish_reason = out["meta_info"]["finish_reason"]status_code = finish_reason.get("status_code")if ( finish_reason.get("type") != "abort" or status_code is None or not HTTPStatus.BAD_REQUEST <= status_code < 600): return None...if not is_stream: if status_code == HTTPStatus.BAD_REQUEST: raise ValueError(finish_reason["message"]) raise fastapi.HTTPException(status_code=status_code, detail=finish_reason["message"])return out三个分支值得注意:
- 非 abort 类型直接放行,按正常输出处理;
- 非流式请求把 abort 转成 HTTP 错误码,客户端看到的是 4xx/5xx,而不是一条“成功但内容为空”的响应;
- 流式请求不抛异常,而是把带
finish_reason的最后一个 chunk 发出去。客户端必须自己检查finish_reason.type == "abort",否则会把一次失败当成正常结束。
这解释了为什么同一个错误在流式与非流式下表现不同:一个表现为 HTTP 状态码,一个表现为最后一帧的字段。做网关重试时,两种都要覆盖。
一个 step 里既有 prefill 也有 decode
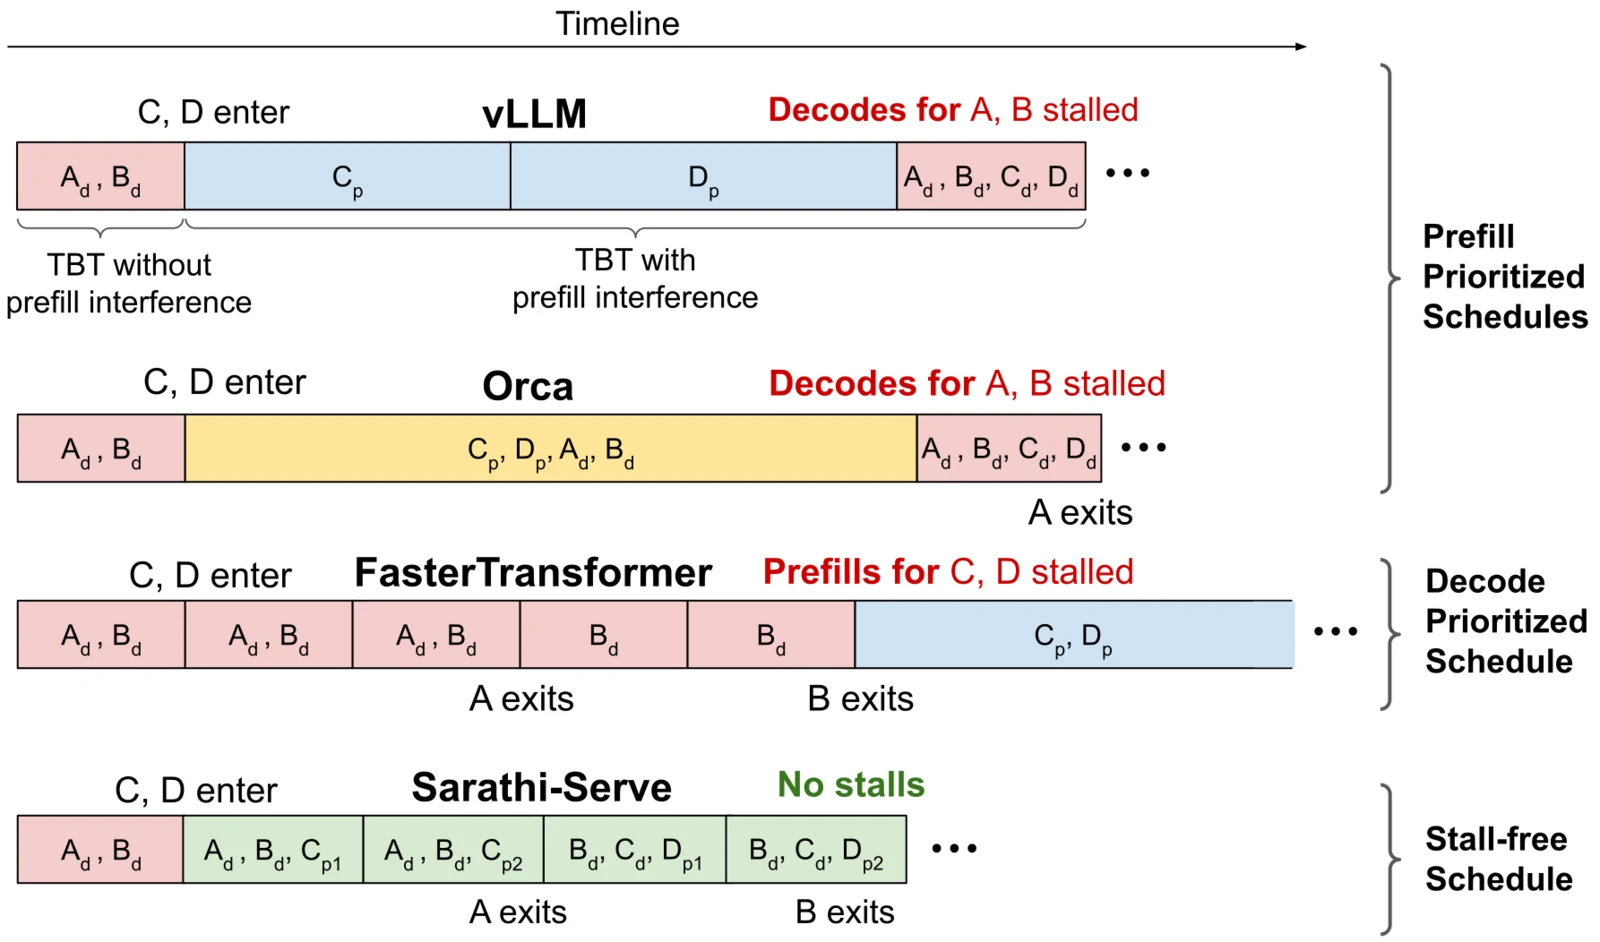
被选中的请求进入 ScheduleBatch,再被 prepare_for_extend / prepare_for_decode 整理成 ForwardBatch。从这一刻起,请求离开 CPU 控制面,进入前九篇讲过的 GPU 路径。值得注意的是,调度器的“一步”并不等于“一条请求的一次前向”:同一 step 里可以同时有正在 decode 的请求和刚开始 prefill 的请求,两者的形状在同一个 batch 里共存(第九篇专门拆过混批)。
第 8 站:GPU 回来时,输出先经过一道“节流阀”
一次 step 结束,调度器拿到 GenerationBatchResult,process_batch_result 更新每条 Req 的输出状态,然后调用 output_streamer.stream_output。这一步不是“有 token 就发”,而是先经过一道节流:
if req.stream: stream_interval = req.sampling_params.stream_interval or self.default_stream_interval num_unsent = len(req.output_ids) - req.send_token_offset should_output = ( stream_interval == 1 or num_unsent >= stream_interval or (req.send_token_offset == 0 and num_unsent > 0) ) if should_output: should_output &= not req.check_match_stop_str_prefix()else: should_output = (len(req.output_ids) % self.default_force_stream_interval == 0)四行逻辑,四个设计点:
- 流式默认每步都发(
stream_interval == 1)。这就是为什么观察 SSE 时,帧的节奏通常与 decode step 对齐。 - 首个 token 立即发。投机解码或扩散式解码一步能产出多个 token,若只按 interval 判断,首帧可能被推迟,TTFT 变差。
- 停止串前缀检查。如果当前已生成文本的尾部恰好是某个
stop字符串的前缀,就先不发,等下一步确认。否则客户端会先看到半截停止串,再看到它被裁掉。 - 非流式请求按固定间隔落一次输出。客户端要的是最终结果,但服务端不能把整段输出攒到最后才发:中间态要按
default_force_stream_interval周期性发给反分词进程,否则一条长输出的全部 token 都压在调度进程内存里。
stream_output 的产物是 BatchTokenIDOutput,一批请求共用一个消息。managers/io_struct.py 里的字段可以分成五组:
| 组 | 字段 | 用途 |
|---|---|---|
| 结束与调度 | finished_reasons | 每条请求是否结束、为什么结束 |
| 增量解码 | decoded_texts、decode_ids、read_offsets | 反分词进程据此拼出增量文本 |
| 反分词配置 | skip_special_tokens、spaces_between_special_tokens、no_stop_trim | 逐请求的 tokenizer 口径 |
| 计数 | prompt_tokens、completion_tokens、reasoning_tokens、cached_tokens | 计费与监控 |
| logprob | input_token_logprobs_*、output_top_logprobs_* 等 | 仅在请求了 logprob 时填充 |
注意它带的是 token id 与增量偏移,不是文本——文本要由反分词进程生成。而“配置字段也逐请求携带”是一个容易被忽略的设计:同一个 batch 里,不同请求的 skip_special_tokens 可能不同,反分词进程不能对整批用一套设置,这也是后面 _grouped_batch_decode 要分组的直接原因。
reasoning_tokens 单独计数,而不是混在 completion_tokens 里。对 GLM-5.3 这类推理模型,思考段的长度往往远超最终回答;把两者分开,才能在计费与 SLO 上区分“算得多”和“说得多”。
投机解码让输出一次多走几步
开启 MTP 或 EAGLE 后,一个 verify step 可以接受多个 token,output_ids 一次增长 1 到 个。stream_output 对此的处理是“按未发送数量判断”,而不是“按是否正好到了间隔”:
num_unsent = len(req.output_ids) - req.send_token_offsetshould_output = ( stream_interval == 1 or num_unsent >= stream_interval or (req.send_token_offset == 0 and num_unsent > 0))注释里解释了原因:一个 step 可能追加多个 token,若只判断“是否恰好等于间隔”,就会跳过多个间隔点,导致输出积压。按“累计未发送量”判断,保证无论一步产出几个 token,客户端都不会等过久。
这也解释了为什么投机解码下 SSE 帧的节奏不是均匀的:接受长度随内容波动,有的 step 一次发 4 个 token,有的只发 1 个。对客户端来说,帧的数量比 token 的数量更不规律,做前端动画或打字机效果时要注意这一点。
第 9 站:反分词进程——把 token 流拼回字符
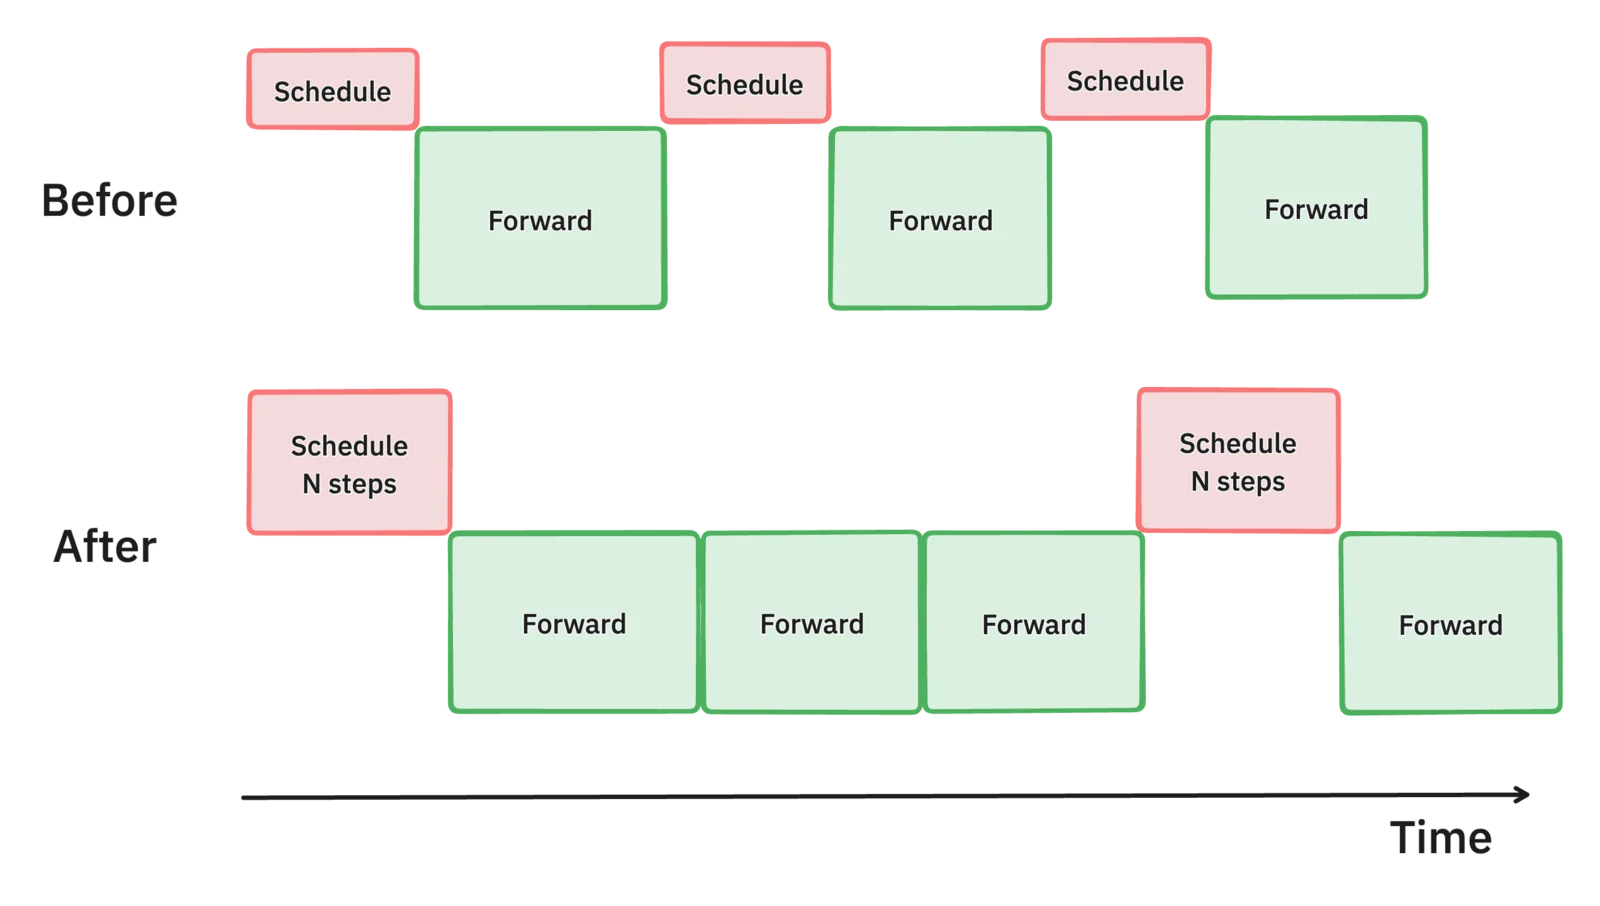
DetokenizerManager 是独立进程,主循环只有三行:
while True: recv_obj = sock_recv(self.recv_from_scheduler) output = self._request_dispatcher(recv_obj) if output is not None: sock_send(self.send_to_tokenizer, output)真正的逻辑在 _request_dispatcher 指向的处理函数里。每条请求维护一个 DecodeStatus,用四个游标记录“解码到哪、读到哪、发到哪”。增量解码的做法是:
- 把从
surr_offset到read_offset的 token 解码成“上一次看到的文本”; - 把从
read_offset到末尾的 token 解码成“这次看到的文本”; - 取两者的差集,作为本次新增文本。
为什么不能直接 decode 最后一个 token
因为 token 与字符不是一一对应。一个中文字符可能横跨 2–3 个 token,一个 emoji 可能横跨 4 个。只解码最后一个 token,得到的往往是一个不可打印的字节片段或替换字符 �。代码里的处理方式是:
pending = s.sent_offset - s.decoded_text_lenif new_text and not new_text.endswith("�"): s.append_decoded_text(new_text) ... output_strs.append(new_text[pending:] if pending else new_text)else: printable = find_printable_text(new_text) s.sent_offset = s.decoded_text_len + len(printable) output_strs.append(printable[pending:] if pending else printable)完整字符才提交(推进 decoded_text_len),不完整时只发可打印前缀,并把偏移留在原处等下一批 token 补齐。这条规则是流式输出不会出现乱码的根本原因,也是“为什么第一个中文字符比第一个英文字符晚一帧”的原因。
第 10 站:反分词进程的内部机制——裁剪、偏移与批解码
反分词进程只认四种消息
DetokenizerManager.init_request_dispatcher 的映射表很短:
self._request_dispatcher = TypeBasedDispatcher( [ (BatchEmbeddingOutput, self.handle_batch_embedding_out), (BatchTokenIDOutput, self.handle_batch_token_id_out), (FreezeGCReq, self.handle_freeze_gc_req), (ConfigureLoggingReq, self.handle_configure_logging_req), ])只有 BatchTokenIDOutput 会走文本拼接;BatchEmbeddingOutput 原样回传,因为 embedding 请求没有文本形态;后两种是运维控制消息,调度器收到 ShutdownReq、FreezeGCReq、ConfigureLoggingReq 时会转发一份给反分词进程,让两个进程同时停、同时冻结 GC、同时调日志级别。这类“控制消息双发”是多进程服务里常见但不显眼的细节:如果只发给调度器,关闭时反分词进程可能还挂着一个未完成的 DecodeStatus,进程不会被优雅回收。
映射表之外的消息走 TypeBasedDispatcher 的默认分支,通常是直接丢弃并打印警告。这一点对排查“输出突然没了”很重要:如果调度器侧改了输出消息的类型名,反分词进程不会报错,只会把整批消息丢掉,客户端表现为请求一直挂着直到超时。
DecodeStatus 的四个偏移
增量解码的全部状态压缩在几个字段里:
class DecodeStatus: decoded_text: str decode_ids: List[int] surr_offset: int read_offset: int sent_offset: int = 0 decoded_text_len: int = dataclasses.field(init=False)它们的分工是:
| 字段 | 含义 | 谁推进 |
|---|---|---|
surr_offset | 上一次“已完整解码”边界 | 提交新文本时推进到 read_offset |
read_offset | 本次解码的起点 | 每批 token 到达时推进到 len(decode_ids) |
sent_offset | 已发送到客户端的字符数 | 发送后推进 |
decoded_text_len | 已提交文本长度 | append_decoded_text 时递增 |
decode_ids | 全部已到达的 token | 每批追加 |
读代码时最容易混淆的是 sent_offset 与 decoded_text_len。正常情况下两者相等,但在“不完整 UTF-8”的分支里,sent_offset 会比 decoded_text_len 大:那一段可打印前缀已经发出,但没有提交。下一次新 token 到达时,pending = sent_offset - decoded_text_len 正好是“已经发出、但还没提交”的那一截,差集计算要把它跳过去,否则会重复发送。
每批 token 都会重新解码整段区间
这是反分词进程的隐性开销。处理函数对每条请求做两次 tokenizer.decode:
surr_texts = self._grouped_batch_decode(surr_ids, ...)read_texts = self._grouped_batch_decode(read_ids, ...)new_text = read_texts[i][len(surr_texts[i]):]surr_texts 解码的是“上次提交边界之前”的文本,read_texts 解码的是“截至当前”的文本;两次解码的公共前缀被丢弃,只取差集。这个做法保证了 token 与字符的对齐不依赖 tokenizer 的内部状态,代价是每步都要重复解码一段历史文本。
历史文本的长度取决于 surr_offset 与 read_offset 的距离。正常情况下两者相差一个 step 的输出,很短;但在投机解码下,一个 verify step 可能一次产出 6 个 token,两次解码的文本仍只有几十个字符。真正放大成本的是“长时间不提交”的情况:连续几个 token 都拼不出完整字符时,surr_offset 不推进,decode_ids 持续增长,两次解码的区间越来越长。
_grouped_batch_decode 把一批请求按相同的 skip_special_tokens、spaces_between_special_tokens 设置分组,每组一次 batch_decode 调用。按组而不是按请求,是为了把 Python 层的调用次数压到与“设置种类”成正比,而不是与请求数成正比。大 batch 下这一点很明显:64 条请求只有一组设置时,每步只有一次解码调用。
停止串在这里被裁掉
trim_matched_stop 是输出侧的最后一道剪裁:
if isinstance(matched, str) and isinstance(output, str): pos = output.find(matched) ... return output[:end] if no_stop_trim else output[:pos]no_stop_trim 控制是否保留停止串本身。默认裁掉,因为大多数客户端不希望把 </answer> 或 User: 这类标记当作正文。对工具调用场景,trim_matched_stop 还有特例:<|call|> 这类 token 即使匹配了也不裁,否则工具调用标记会丢失。
状态淘汰是一个真实的故障点
DecodeStatus 表有容量上限:LimitedCapacityDict(capacity=DETOKENIZER_MAX_STATES),默认 65536,可由环境变量 SGLANG_DETOKENIZER_MAX_STATES 调整。请求数超过上限时,最老的条目会被淘汰;之后若该请求还有输出到达,处理函数会抛出“找不到 decode status”的错误,并在日志里提示调大环境变量。这条限制在长连接、高并发的服务里值得提前检查:它不是性能问题,而是正确性问题。
第 11 站:回到 HTTP 进程——SSE 的最后一公里与三种停止条件
文本回到 TokenizerManager 后,_handle_batch_output 从输出消息里抽取 finish_reason,构造 meta_info,再把文本追加到 ReqState.out_list。等待中的 _stream_one_response 被事件唤醒,取走这一批输出,转成 OpenAI 格式的 chunk,交给 FastAPI 的 StreamingResponse。
这里的“最后一公里”不是比喻。一条 SSE 帧要走完下面这条链:
调度进程 → 反分词进程 → TokenizerManager → serving_chat 的生成器 → StreamingResponse → uvicorn → socket其中只有第一跳与第二跳是跨进程的,后面全在主进程的 asyncio 里。一个慢客户端会在最后两跳上堆积:uvicorn 的写缓冲满时,StreamingResponse 的 send 会等待 drain,生成器被反压,_stream_one_response 不再从 out_list 取数据;out_list 增长到一定程度,内存占用上升。流式接口没有“背压信号”回传给调度器,因此服务端唯一能做的限制是“单连接在途输出量”。
一个常见的工程做法是:客户端侧限制 max_tokens,网关侧限制单连接并发,服务端侧把 stream_interval 调到大于 1,减少帧数。三者都是在减少最后一公里的帧数,而不是减少 token 数。
三种停止条件
停止条件有三类,它们在不同层生效:
| 停止条件 | 判定位置 | 判定时机 |
|---|---|---|
| EOS token | 调度器采样后 | 生成该 token 的同一 step |
max_tokens / max_new_tokens | 调度器计数 | 生成到上限的 step |
stop 字符串 | 反分词进程 | 文本拼出之后 |
这个分层带来一个必然现象:stop 字符串的停止总是“晚一步”。GPU 可能已经多生成了几个 token,调度器也已经把它们写进 output_ids,反分词进程匹配到停止串时才把它们裁掉。工程上这被称为“过冲”(overshoot):客户端看到的文本是裁剪后的,但计费的 completion token 可能包含被裁掉的部分。要精确对齐,需要在调度器侧做前缀匹配(check_match_stop_str_prefix 已经在输出节流里做了预防),或在反分词后回写实际发送长度。
一条 100K 请求的 CPU 侧账
前面的量级都按 1K 输入算。把输入放大到 100K、并假设前缀缓存命中 90%(命中在 device 上),CPU 侧的账会变成另一种形状:
| 项目 | 1K 输入 | 100K 输入(90% 命中) | 说明 |
|---|---|---|---|
| 模板渲染 | 0.1–1ms | 1–5ms | 历史越长,模板遍历的消息越多 |
| 分词 | 1–3ms | 100–300ms | 与输入字节线性,是最大项 |
| 前缀匹配 | <0.1ms | 5–20ms | 与命中深度相关,按 64 token/块比较 |
| KV 页分配 | <0.1ms | 1–3ms | 只给未命中的 10K token 分配 |
| prefill 计算(GPU) | 10–50ms | 0.5–2s | 10K token 的实际计算 |
| 反分词 | 每步几十 µs | 每步几十 µs | 与输入无关,只与输出有关 |
两个结论:
第一,100K 输入下分词是 CPU 侧的大头。100–300ms 的分词时间已经接近小 chunk prefill 的 GPU 时间;如果 HTTP 与分词同进程,这段时间里事件循环被占住,其他请求的 SSE 帧、健康检查、甚至 keep-alive 的心跳都会延迟。--tokenizer-worker-num 正是为这种场景准备的。
第二,前缀命中把 GPU 时间砍掉 90%,但砍不掉 CPU 时间。模板渲染仍要遍历全部消息,分词仍要处理全部 100K 文本,前缀匹配仍要比较全部块。命中省的是“算”,不是“读”。这就是为什么长上下文场景里,CPU 侧优化(分词批处理、模板缓存、前缀索引)与 GPU 侧优化同样重要。
观测:三个数就能定位
线上排查时,不需要把上面的每一站都打点。三个数就能把问题归到一段:
queue_time:从请求进入调度器队列到被调度。它大,说明 GPU 侧被占满或 KV 不足,不是入口层的问题。first_token_latency - queue_time:首 token 延迟减去排队时间,剩下的是“入口 + prefill + 输出首帧”。它大而queue_time小,说明瓶颈在分词、模板、前缀匹配或 prefill 本身。decode_throughput:decode 阶段的 token 速率。它低而前两项正常,说明问题在 decode 的 batch 组成或输出侧。
这三个数分别来自三处:
queue_time由SchedulerReqTimeStats.queue_duration_s回传,注释里明确说“时间戳无法重建时长”;first_token_latency由 API 侧的APIServerReqTimeStats计算,是唯一跨进程仍可用的端到端指标;decode_throughput也是 API 侧算的,用completion_tokens除以 decode 时长。
要更细的分解,就得打开 --enable-metrics 或 tracing;否则调度器侧的 SchedulerReqTimeStats 在序列化时会直接返回空字典——__getstate__ 的第一行就是:
if not (self.enable_metrics or self.has_timing_data): return {}这个设计是有意的:默认情况下不把每条请求的详细阶段数据搬过进程边界,避免输出消息膨胀。代价是“默认观测只能看到粗粒度”,细粒度必须显式开启。
一条请求的 CPU 预算
把上面的站点按时间顺序排一遍,给出 8×H200、TP8 + DP Attention、输入约 1K token、输出 256 token 的量级估计。数字是数量级,不是实测值:
| 站点 | 所在进程 | 量级 | 主要变量 |
|---|---|---|---|
| JSON 解析 + pydantic 校验 | 主进程 | 0.1–0.5ms | 请求体大小、tools 数量 |
| GLM-5.3 模板渲染 | 主进程 | 0.1–1ms | 历史轮数、思考段长度 |
| 分词(1K token) | 主进程 | 1–3ms | tokenizer 后端、文本语言 |
| 序列化 + ZMQ PUSH | 主进程 | 0.1–0.5ms | 消息大小、pickle 字段 |
| DP 路由(若开启) | DP 控制器进程 | <0.1ms | 策略 |
| 前缀匹配 | 调度进程 | 0.1–5ms | 命中深度、块大小 |
| KV 页分配 | 调度进程 | 0.1–1ms | 池剩余、碎片 |
| 输出节流 + 组包 | 调度进程 | <0.1ms/step | batch 大小 |
| 反分词(增量) | 反分词进程 | 每 step 几十 µs | 文本语言、请求数 |
| SSE 写出 | 主进程 | 每帧几十 µs | 客户端消费速度 |
这张表里只有分词与前缀匹配会进入毫秒级。它们都不在 GPU 上,也都不受 batch 大小摊薄——batch 从 1 涨到 64,这两项的成本按请求数线性增长。吞吐场景下,它们比单个 kernel 的优化更容易成为瓶颈。
三个不变量
跨进程之后,正确性依赖三条不变量。任何一条被破坏,症状都不是报错,而是“偶发的错字、错序、错请求”。
不变量一:顺序
BatchTokenIDOutput 里一批请求共用同一组字段数组,靠下标对齐。反分词进程按 decode_ids 与 read_offsets 重建每条请求的文本,若某条请求的输出被跳过(例如 finished_output 已置位),数组下标就会错位。代码里用 skip_req 与逐条 continue 维持对齐;修改输出逻辑时,这是最容易出错的地方。
不变量二:大小
decoded_texts 是增量文本,decode_ids 是截至当前的完整 token 序列,两者长度不同步。反分词进程必须用 read_offset 而不是数组下标去截取增量。混用两者会导致重复字符或丢字符。
不变量三:归属
每条请求的 KV、Req 对象、ReqState、DecodeStatus 都必须属于同一个 rid。DP 路由把请求固定在一个 rank 上;PD 分离把请求拆成两段,靠 bootstrap_room 把两段对上。任何跨 rank 的“借用”都必须显式传播 rid 与 KV 元数据,否则回收时会释放错页。
三类常见故障
队列背压
PUSH/PULL 没有流控。当调度进程的处理速度低于请求到达速度时,消息堆在 ZMQ 队列里,主进程的 _dispatch_to_scheduler 仍然成功返回。表现为“HTTP 已返回 200,但 TTFT 极长”,而不是连接被拒。要发现它,只能看调度器侧的队列长度与 time_stats 里的 dispatch 到 schedule 间隔。
反分词状态淘汰
前面提过:DETOKENIZER_MAX_STATES 不够时,长请求的输出会“找不到状态”(默认 65536 条,单实例并发请求数超过它才会触发)。表现是 500 错误或连接中断,日志里有明确的提示。调大该变量即可,但更根本的做法是限制单实例的并发请求数。
断连未及时取消
断连检测分“排队中”和“出流中”两条路径:前者靠 _REQUEST_STATE_WAIT_TIMEOUT 超时轮询(默认 4 秒),后者靠每次发送前的 is_disconnected() 检查。若超时设得过大,或者请求正处在无法被打断的 prefill chunk 里,abort 会延迟生效。这一段延迟里,GPU 仍在为一条没有客户端接收的请求计算。监控上它表现为“GPU 利用率高、有效吞吐低”。
与 vLLM V1 的控制面对照
同一段时间线,vLLM V1 用的是另一套切法:
| 环节 | SGLang | vLLM V1 |
|---|---|---|
| 进程切分 | 主进程(HTTP + 分词)、调度进程、反分词进程 | API Server 进程、EngineCore 进程 |
| 反分词位置 | 独立进程 | API Server 进程内的 OutputProcessor |
| 输入通道 | ZMQ PUSH/PULL | ZMQ ROUTER 入、PULL 出 |
| 输出通道 | 调度 → 反分词 → 主进程,两跳 | EngineCore → API Server,一跳 |
| 请求状态表 | ReqState + rid_to_state | RequestState + RequestOutputCollector |
| 流式输出 | 逐帧 SSE,按 stream_interval 节流 | RequestOutputCollector 合并增量 |
差异的根源在“反分词放在哪”。vLLM 把反分词放进 API Server 进程,省掉一跳,代价是 API Server 进程要同时承担 HTTP、分词、反分词与输出合并;SGLang 把反分词拆出去,主进程只负责“翻译入口与出口”,代价是多一次跨进程。
两条路线在低并发下的延迟差别很小,在高并发下的资源竞争模式完全不同:vLLM 的 API Server 更容易成为 CPU 瓶颈,SGLang 的反分词进程则成为一个独立的、可单独扩容(多实例)的组件。选型时看的是“哪一段更容易被请求数压满”,而不是“哪条路径少一跳”。
五个框架的进程边界与通道细节,已在 前端与引擎之间的那道进程边界 里做过横向拆解;这里只把它作为 SGLang 控制面的参照。
与 GPU 侧的接口
把 CPU 侧做完的事压缩成三句话,就是它与 GPU 侧的接口:
- 形状:
ForwardBatch的input_ids、positions、out_cache_loc由 CPU 侧决定,错一个字段,RoPE 相位或 KV 页地址就会错; - 容量:准入判断在 CPU 侧完成,GPU 只接受已经分配到页的请求;
- 时序:abort、停止串、输出节流都在 CPU 侧生效,GPU 不知道“客户端已经走了”。
这也是为什么一条请求的端到端延迟不能只用 GPU 时间来估算。GPU 时间是下界,CPU 侧的分词、匹配、反分词、SSE 写出都是加法项;在低延迟场景里,加法项可能占掉 TTFT 的三分之一。
从 CPU 侧反推部署参数
这一篇拆的都是“默认路径”,但每一站都对应一个可以调的参数。下面这些是从 CPU 侧能直接影响的旋钮,部署时按瓶颈选择,而不是一次性全开:
| 站点 | 参数 | 解决什么 | 代价 |
|---|---|---|---|
| HTTP 与分词同进程 | --tokenizer-worker-num N | 长输入的分词阻塞事件循环 | 多一跳转发,api key 鉴权失效 |
| 协议层 | --enable-http2 | 单连接多路复用、减少建连 | 需装 sglang[http2],换用 Granian |
| DP 路由 | --load-balance-method total_tokens | 长上下文混短请求时的负载偏差 | 估计值不含前缀命中 |
| 调度准入 | KV 池大小、--max-running-requests | 长请求等待过久 | 并发下降 |
| 输出节流 | stream_interval | 帧数过多、反分词与 SSE 压力 | 首帧之后粒度变粗 |
| 反分词容量 | SGLANG_DETOKENIZER_MAX_STATES | 超高并发下的状态淘汰 | 内存占用上升 |
| 断连检测 | SGLANG_REQUEST_STATE_WAIT_TIMEOUT | 断连请求的取消延迟 | 轮询频率与误判的权衡 |
这张表也解释了为什么“把 GPU 跑满”不等于“把服务跑好”。上面七个参数里,只有 KV 池大小与 GPU 容量直接相关,其余六个都在 CPU 侧。在吞吐已经接近硬件上限的场景里,继续调 kernel 的收益会变小,而把这几个参数调对,往往能拿回 10% 以上的有效吞吐。
小结
第十篇把镜头从 GPU 移开,沿着一条 GLM-5.3 请求的 CPU 路径走了十个站点:
- 主进程里完成协议解析、模板渲染与分词;
- ZMQ 把请求交给调度进程,回程靠
ReqState的事件表; - DP Attention 下多一个控制器进程做路由;
- 调度器在排队之前做前缀匹配与 KV 准入;
- 输出先过节流,再进反分词进程做增量拼接与停止串裁剪;
- 最后回到 HTTP 进程,变成 SSE 帧。
前九篇解释了“GPU 上算了什么”,这一篇解释了“GPU 之前与之后发生了什么”。两者合起来,才是一条请求的完整生命周期。
下一篇将讨论这套控制面在 PD 分离部署下的变形:当 prefill 与 decode 分属两个进程组,ReqState、abort 与输出节流分别落在哪一侧。
参考资料
- SGLang GitHub 仓库
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv:2312.07104)
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve(arXiv:2403.02310)
- Llumnix: Dynamic Scheduling for Large Language Model Serving(arXiv:2406.03243)
- vLLM 官方博客:vLLM V1 的多步调度与批处理
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA 与 MLA 结构,arXiv:2512.02556)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



