


GLM-5.3 推理全链路(五):vLLM 的 Prefill——分块切片、索引器二次方账与 PCP 双端并行
前四篇留下的问题
这条链路已经写了四篇:第一篇在 SGLang 里把一个请求从 HTTP 入口走到采样输出,第二篇把同一条路径放到 vLLM 的 decode 侧,第三篇专门拆 SGLang 的 prefill(分块、上下文并行、索引器的二次方项),第四篇拆 PD 分离时 57GB KV 与索引器缓存如何跨节点交接。四篇合起来,一个请求在 decode 稳态里的算子与通信基本已经交代清楚。
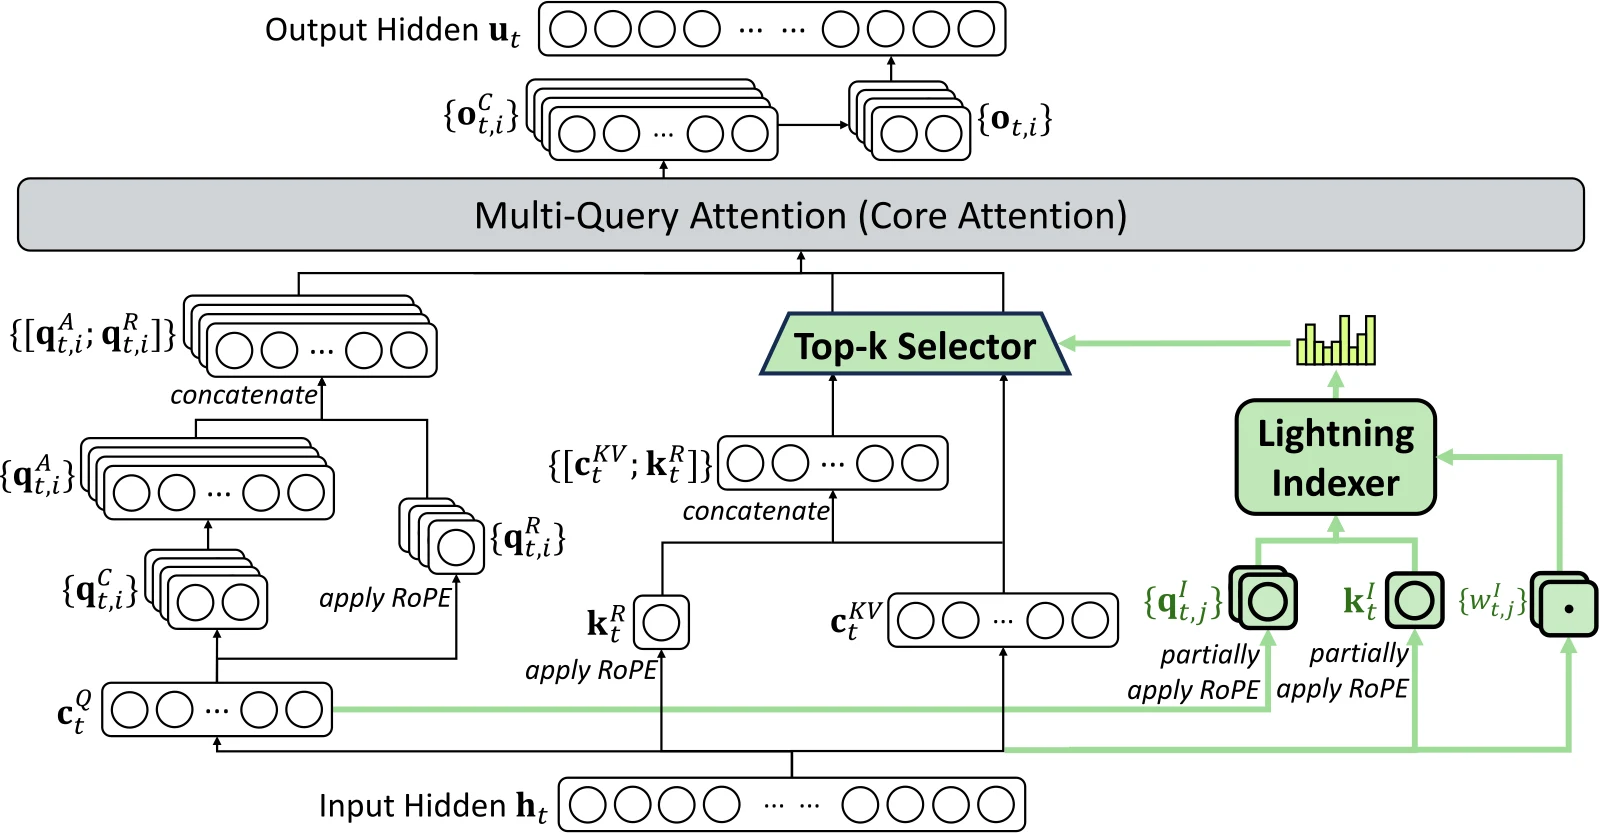
但 vLLM 的 prefill 还缺一篇。第二篇讲 vLLM 时,重心在 decode:融合边界、索引器跨层复用、6 个 token 的 MTP 验证,这些都是“每步只算一个 token”时的账。第三篇讲 prefill 时,代码取自 SGLang:PrefillAdder、page_size=64、interleave CP、DSATokenToKVPool,也是 SGLang 的账。同一个 glm_moe_dsa 架构,vLLM 在 prefill 上做了几件很不一样的事:
- 调度器不用“prefill 阶段/decode 阶段”这种划分,而是维护一条
num_computed_tokens追num_tokens_with_spec的总账; - 索引器在 prefill 里不是一个 kernel 从头算到尾,而是先按“工作区 token 数”和“logits 字节数”两个上限切成 q-chunk;
- 主稀疏注意力(FlashMLA sparse)要把选中的 KV 先 gather 进一块固定大小的 FP8 工作区,再转 BF16 送入 kernel;
- 上下文并行不是 SGLang 的 interleave 切法,而是
2×PCP段的“双端切分”,一个 rank 同时拿头部和尾部; - TP 组内还会把 prefill 的 query 行再切一次,只为把索引器的 打分摊到多张卡上,最后用变长 all-gather 把 Top-K 换回来。
这篇就沿 vLLM 源码把这五件事讲清楚,最后给出一张“一层 prefill 的算子与通信清单”,并与第三篇的 SGLang 路径对照。仍然只讨论推理,不讨论训练;仍然以 GLM-5.3 的常量(78 层、21 个 full 索引层、Top-K 2048、1M 上下文)为算例,代码取自仓库中支持 glm_moe_dsa 的版本。
先把 prefill 的边界划清
prefill 与 decode 的差别,不只是“一次算很多 token”。对 GLM-5.3 这种 DSA + MoE 的模型,至少有四个结构性差异会改变整个执行路径。
第一,矩阵乘的形状从“瘦”变“胖”。 decode 一步只处理 个 token( 通常是 1 到几百),所有 GEMM 的 维都很小,瓶颈在权重读取带宽;prefill 一个 chunk 有几千到几万个 token, 维足够大,GEMM 重新变成计算密集。第二篇里 GLM-5.3 在 vLLM 中那段 glm52_low_latency_gemm 的查表逻辑,只对 之类的“瘦 GEMM”生效;prefill 的 一大,就直接落回 cuBLAS 的通用路径。这不是实现偷懒,而是两类形状的最优 kernel 本来就不同。
第二,索引器的成本从线性变二次方。 decode 时每个请求只新增一个 query,索引器要对整个上下文 打分,成本是 ;prefill 一个 chunk 有 个 query,每个都要对截至当前位置的前缀打分,成本是 。当 和 都是几万到上百万时,索引器会成为 prefill 里唯一一个“随上下文长度平方增长”的项。第三篇已经算过 SGLang 的这笔账,vLLM 的差别在于它把这一项切成了很多小块。
第三,CUDA Graph 基本帮不上忙。 decode 的 batch 形状可以分桶、可以 pad,所以能整步捕获;prefill 的 query 长度、上下文长度、chunk 边界每一步都不同,而且 max_query_len 直接决定注意力 kernel 的调度,vLLM 只用 piecewise CUDA Graph 包住其中形状稳定的片段,主体仍是 eager。第三篇里 SGLang 的 CUDA Graph 桶与 MTP 的 验证 batch 是同一个问题,只是框架的取舍不同。
第四,通信的“每 token 成本”完全不同。 一层 TP 的 AllReduce 量与 token 数成正比:prefill 一个 16384 token 的 chunk,每层要搬 MB 的 hidden;decode 一个 32 token 的 batch 只有 384 KB。但 prefill 的这些通信可以摊到大量 FLOPs 上,decode 的通信则要摊到每个新 token 上。这个差别决定了 prefill 可以放心用更大的 TP/EP,而 decode 往往要靠 DP Attention 把通信压到最少。
理解了这四点,后面所有的设计就都有了解释:分块是为了让 可控,索引器切片是为了让 的中间结果可控,工作区是为了让 KV gather 不随上下文无限膨胀,PCP 是为了在单机 8 卡内把 再摊开。
调度器怎么切:一条总账 vs 相位划分
没有“prefill 阶段”
翻开 vLLM V1 的 Scheduler.schedule,第一段注释就把设计意图写得很直白:
# NOTE(woosuk) on the scheduling algorithm:# There's no "decoding phase" nor "prefill phase" in the scheduler.# Each request just has the num_computed_tokens and num_tokens_with_spec.# ... At each step, the scheduler tries to assign tokens to the requests# so that each request's num_computed_tokens can catch up its# num_tokens_with_spec.这句话是理解 vLLM prefill 的钥匙。对每个请求,调度器只维护两个数:
num_computed_tokens:已经算过、KV 已经落盘的 token 数;num_tokens_with_spec:prompt 长度 + 已输出 token 数 + 投机草稿 token 数。
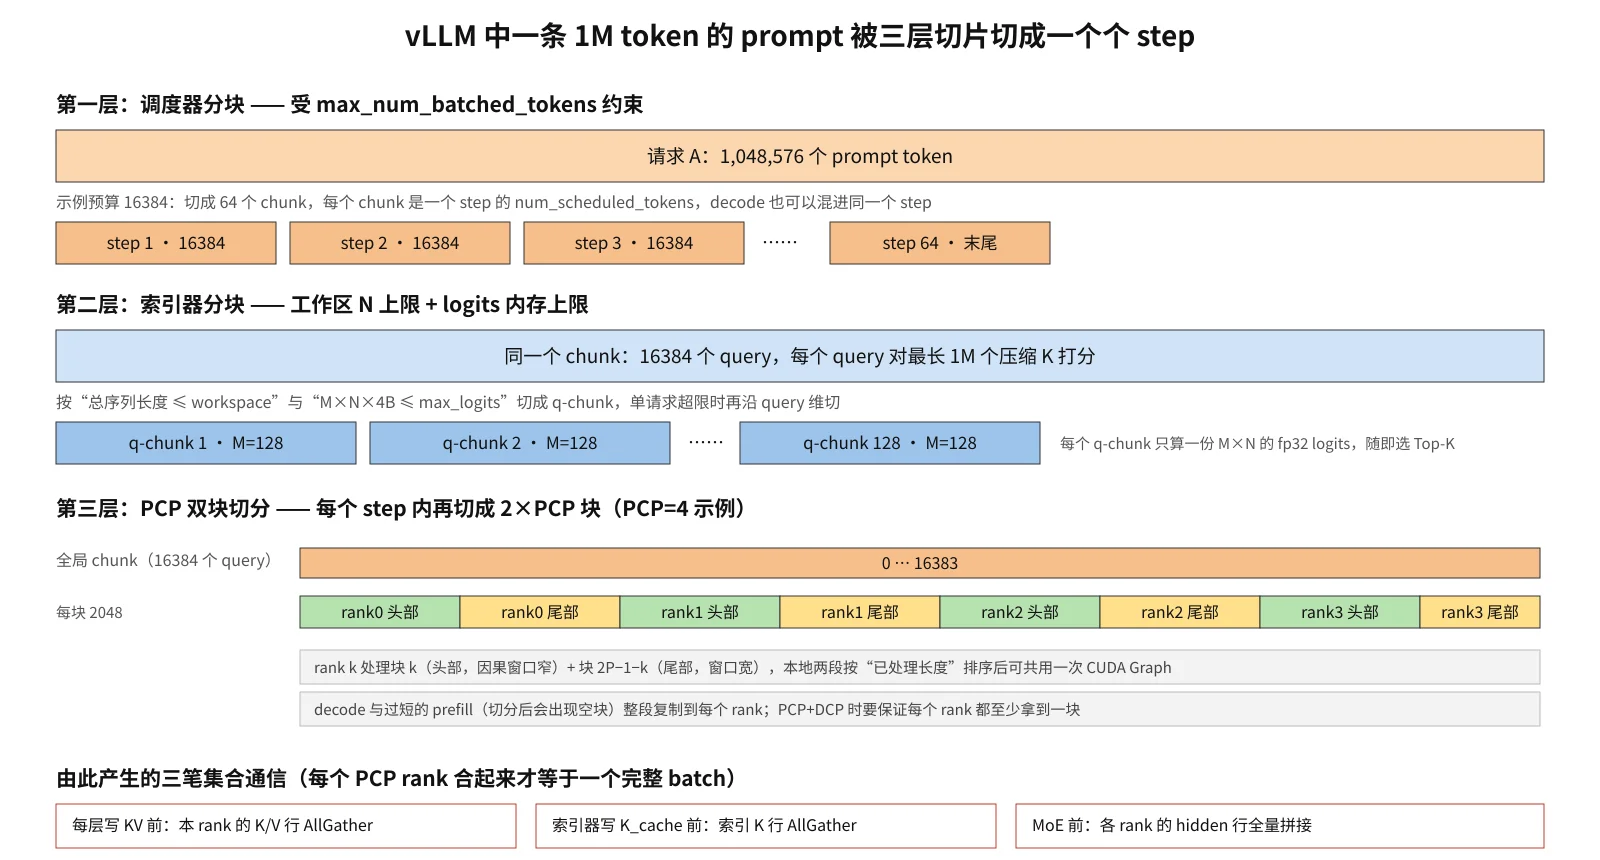
每个 step 要做的,就是给请求分配若干个新 token,让前者向后者“追”。一个全新的 1M 请求,num_computed_tokens=0,num_tokens_with_spec=1,048,576,第一轮分配 个 token;下一轮 num_computed_tokens 变成 ,再追 个……直到追平。所谓 chunked prefill,就是这条追平过程被拆成很多轮;前缀缓存命中,就是起点 num_computed_tokens 一开始就不是 0;投机解码,就是“追”的时候允许一次追过 1 个 token。
这种表示法的好处是统一:不需要“prefill 队列”和“decode 队列”两套逻辑,也不必在请求从 prefill 切到 decode 时做状态迁移。代价是调度器必须额外处理一些边界,比如一个请求只剩 1 个 prompt token 没算完时,它的下一轮其实是 decode 的形状——这就是后面 prefill_runs_as_decode 的来由。
两个预算
调度器有两条独立的预算:
token_budget:本 step 总共能调度多少个 token,默认等于max_num_batched_tokens;input_budget:本 step 能进入模型输入的 token 数,等于max_num_batched_tokens再减去给投机草稿预留的draft_slots。
大多数情况下两者相同,投机解码时后者略小。max_num_scheduled_tokens 才是 token_budget 的上限来源,它通常等于 max_num_batched_tokens,但可以设得更小,给模型内部“自己加 token”的机制(比如投机)留余量。
max_num_batched_tokens 的默认值不是常数,而是按 GPU 显存和设备名选出来的:
| 设备档位 | LLM 离线批处理 | OpenAI API 服务 |
|---|---|---|
| ≥ 160 GiB(B200/B300 一类) | 16384 | 16384 |
| ≥ 70 GiB 且不是 A100/GB10(H100/H200 一类) | 16384 | 8192 |
| 其它(A100、小卡、GB10) | 8192 | 2048 |
这组数字本身就说明了 vLLM 对 prefill 的策略:离线批处理追求吞吐,预算开大;在线服务给 prefill 一个相对保守的预算,让 decode 的 ITL 不被大 chunk 拖垮。后面所有的“一次 chunk 多少 token”都建立在这个值上。
先跑 RUNNING,再跑 WAITING
schedule 的顺序是固定的:
- 先遍历
running(已经在跑的请求),逐个分配新 token。对正在 prefill 的请求,分配量是num_tokens_with_spec + placeholders - num_computed_tokens,再被token_budget截断;对 decode 请求,分配量是 1(或投机时 ); - 再遍历
waiting(新到或抢占后重排的请求),如果预算还有剩余、running未达到max_num_active_reqs,就准入。准入时先做前缀缓存查找(本地 + 外部 KVConnector),命中长度从num_computed_tokens起点开始计; - 如果 KV 块不够分配,从
running尾部抢占最低优先级的请求,把它的 KV 释放、请求重新塞回waiting。
这个顺序意味着 prefill 永远排在 decode 之后:已经进入 RUNNING 的 decode 请求会先吃掉它们的 1 个 token,剩下的预算才给 prefill。这保证了在线服务里已有生成流的 ITL 不会因为新请求涌入而剧烈抖动。vLLM 文档里“chunked prefill 默认优先 decode”说的就是这件事。
long_prefill_token_threshold:别让一条长 prefill 饿死别人
1M 的请求如果每次都能拿满 16384,它会连续 64 个 step 独占输入预算,其他请求只能看着。vLLM 提供三个开关:
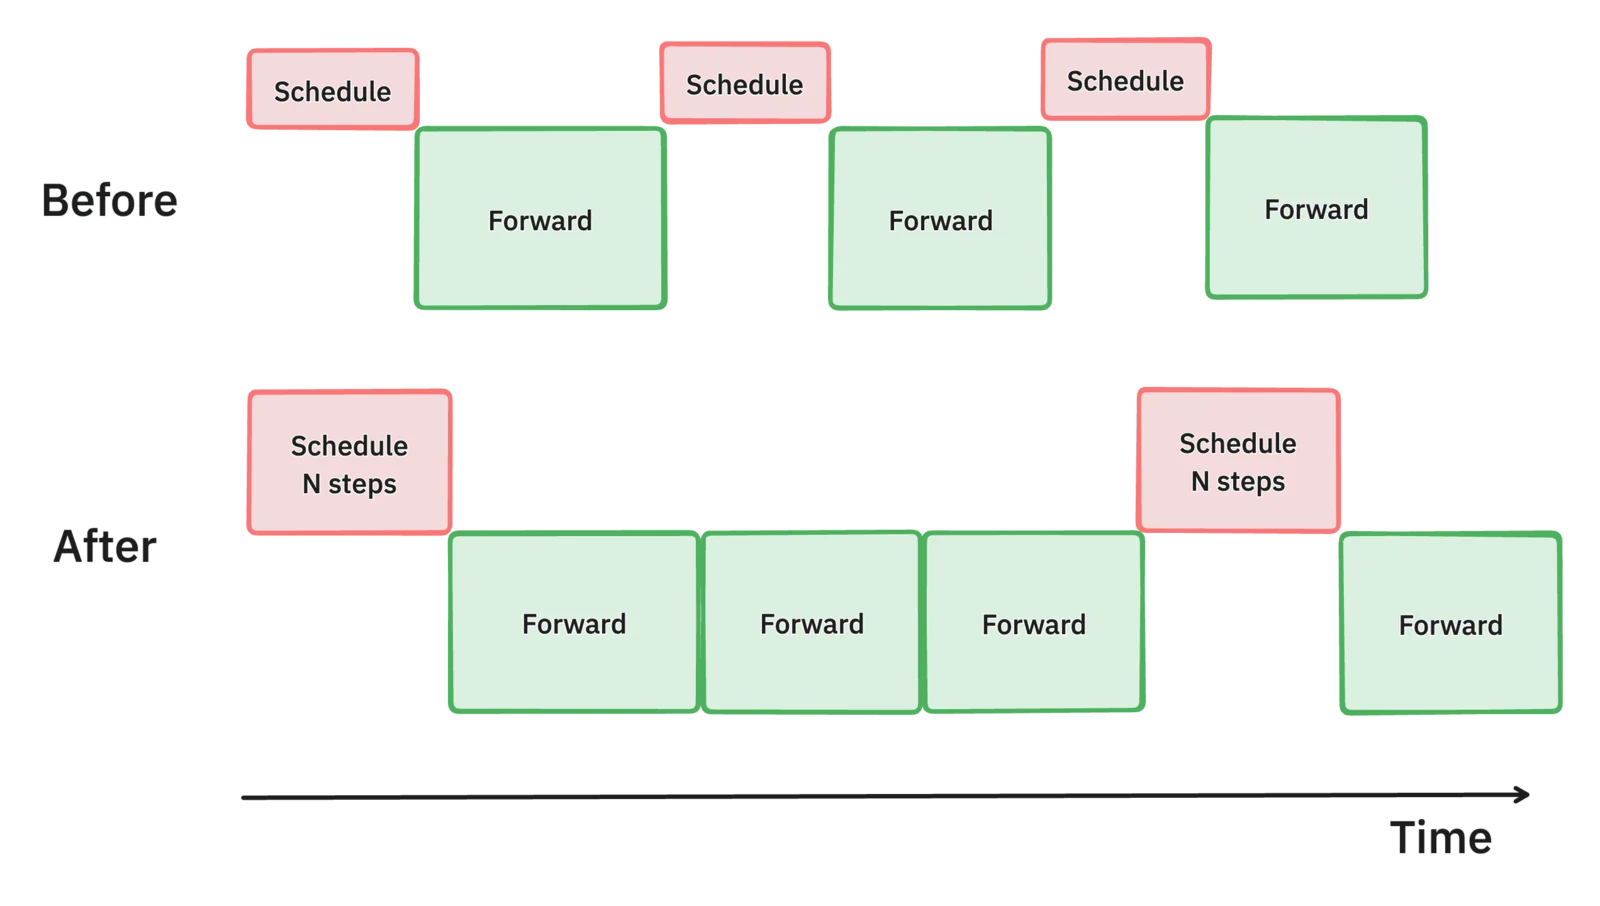
long_prefill_token_threshold:当一个请求的 prompt 比这个阈值长时,每轮最多只给它这么多 token;long_prefill_token_threshold_adaptive:把有效阈值托底到max_num_batched_tokens // 请求数,避免阈值设得太小让每条请求都被过度切割;prefill_schedule_interval:每隔若干个 step 才放一次 prefill,其余 step 纯跑 decode,用来让 decode 的 CUDA Graph 连续命中。
还有最后一个条件:如果 batch 里只有这一个请求,阈值直接设为 0,让它用满预算。调度器的注释写得很清楚——没有别人可以被饿死,切它没有意义。所以“离线跑一个 1M 长文本”与“在线服务 200 条请求里混进一条 1M”会走两条完全不同的切块路径:前者是 64 个满预算 chunk,后者可能被切成几千个小 chunk。
此外 prefill_schedule_interval(对应调度器里的 local_prefill_interval)还有一个“本地 prefill 节奏”机制:它可以让 prefill 只在每隔若干个 step 出现一次,中间几步纯跑 decode,这样 decode 的 CUDA Graph 能连续命中而不被 prefill 打断。这个机制只在未做 DP 协调的单实例上生效(DP 时由 engine core 统一驱动),默认值为 1 即不启用;但它同样说明一件事:prefill 与 decode 的“相位”在 vLLM 里是可调的工程参数,而不是硬编码的两阶段状态机。
一个 step 的输出长什么样
调度完成后,SchedulerOutput 里最关键的字段是:
num_scheduled_tokens: dict[req_id, int]:本 step 每个请求分配了多少 token;kv_cache_blocks:每个请求新分配的 KV 块;scheduled_spec_decode_tokens:本 step 的草稿 token。
在 GPU 侧,ModelRunner 会把 num_scheduled_tokens 按长度排序(decode 在前、prefill 在后),生成 InputBatch,再交给各层的注意力后端。后面所有“分块”“切片”“并行”都作用在这个 num_scheduled_tokens 的分配上,而不是再另起一套 prefill 数据结构。这也是 SGLang 与 vLLM 读代码时最容易混淆的地方:SGLang 有显式的 PrefillAdder 和 ForwardBatch.is_extend,vLLM 则只有一个“分配了多少 token”的字典。
一条 1M 请求的 64 个 step
把总账摊开看一遍。假设预算 16384、单请求、无前缀缓存、无投机:
| step | 进入时 num_computed_tokens | 本步分配 | 结束时 | 备注 |
|---|---|---|---|---|
| 1 | 0 | 16384 | 16384 | 第一块,索引器上下文从 0 开始 |
| 2 | 16384 | 16384 | 32768 | 索引器要给第二块每行打分, 已到 32768 |
| … | … | 16384 | … | … |
| 63 | 1,032,192 | 16384 | 1,048,576 | 最后一块恰好对齐 |
| 64 | 1,048,576 | 1(采样 token) | 1,048,577 | 转为 decode 形状 |
如果预算 8192,就是 128 个 step;如果开了 long_prefill_token_threshold=4096 且 batch 里还有别的请求,就是 256 个 step。注意 step 64 的“1 个 token”并不是 prefill:它只有 1 个 query、上下文 1M,会被 prefill_runs_as_decode 识别为“一次只有一个新 token 的 extend”,走 decode 路径(甚至能进 CUDA Graph)。这就是“没有相位”的好处:prefill 的最后一小步自然变成 decode,不需要额外的模式切换。
前缀缓存命中时,起点不是 0。假设命中 100K,第一个 step 的 num_computed_tokens=100000,只需要再算 948576 个 token;索引器的第一块从位置 100000 开始,打分范围是 ,而不是从 0 开始。前缀命中的 KV 仍然在页表里,索引器照样能读到;这也是为什么前缀缓存与 DSA 的索引器缓存必须同步(见第一篇的“细节二”)。
混合 batch 时,调度器先给 decode 请求各 1 个 token,剩下的预算才给 prefill。如果 decode 有 32 条、prefill 预算还剩 16384-32,那么这一 step 的 max_query_len 是 prefill 的 16352,decode 的 32 行会被排到 batch 前部,sort_batch_req_ids 按长度排序保证 decode 在前。但 max_query_len 一大,整批的 CUDA Graph 就用不了——这是“prefill 与 decode 混跑”必须付的图优化代价。
prefill_runs_as_decode:一个 token 的 extend
ModelRunner.gather_batch_req_state 里有一段判断:
if has_prefill and self.pcp_manager is None: one_token_ext = (num_new_tokens == 1) & (num_computed_prefill_tokens_np > 0) prefill_runs_as_decode_np = is_prefilling_np & one_token_ext decode_graph_eligible = bool( (prefill_runs_as_decode_np | ~is_prefilling_np).all() )它的含义是:如果某条请求还处在 prefill 状态,但本步只新增 1 个 token、且之前已经算过一些 token,那么它和 decode 没有区别——一个 query、上下文非空、KV 已存在。这样的行可以被当作 decode 处理,走 decode 的注意力后端与 CUDA Graph。这主要发生在三种情况:
- prompt 只剩最后 1 个 token 没算(常见于分块边界恰好切在倒数第二个 token);
- 投机解码的验证步(1 个目标 token + 若干草稿);
- prefix cache 命中后只剩 1 个 token 的补齐。
反过来,PCP 开启时这条不成立:PCP 把 prefill 的 query 行切开,即使只有 1 个 token,也可能被分到某个 rank 的“头段/尾段”,不能按 decode 处理。
索引器的二次方项:两个上限,两次切片
为什么索引器在 prefill 里是个特殊存在
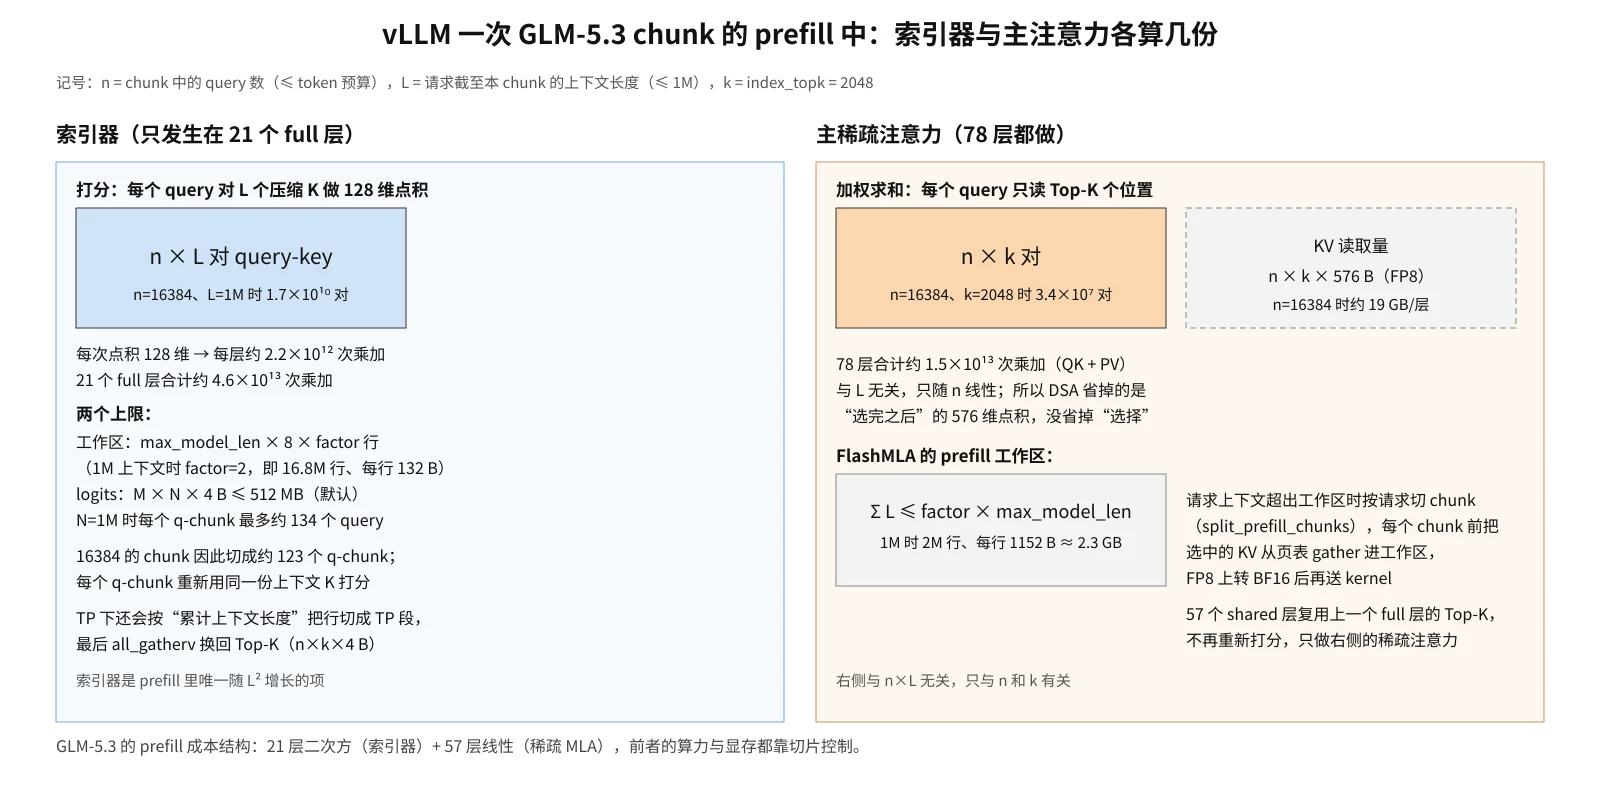
回顾一下 DSA 的索引器在做什么。GLM-5.3 的 78 层里,有 21 个“full 层”每层持有自己的索引器;另外 57 层共享上一层选出来的 Top-K。对一个 prefill chunk,每个 query token 都要对“上下文里截至它自己的位置”的所有压缩 key 打分,选出得分最高的 index_topk = 2048 个位置,再让主稀疏注意力只在这 2048 个位置上做 576 维的 MLA。
对一个 chunk 里的 16384 个 token,如果上下文长度是 ,索引器的打分矩阵尺寸就是 。 时是 个 fp32 元素,约 64 GB——一张 H200 的显存放不下,更别提还要同时跑别的层。即使放得下,一个 kernel 也不能就这么算:FlashMLA 之后的 sparse attention 需要的是 Top-K 下标,而这里 logits 只是中间结果。
vLLM 的做法是把这一步切成两种情况:
- decode:每个请求只有几个 query(MTP 下最多 6 个),logits 尺寸是 ,对 1M 上下文也只有 24 MB,可以一次算完,甚至能用
flattened布局把所有请求的 query 行摊平成一条; - prefill:query 有几千到几万,直接按上面的原则切块。
两个上限
DeepseekV32IndexerMetadataBuilder.build 在遇到 prefill 请求时,会调用 _split_indexer_prefill_chunks,传入两个限制:
max_logits_bytes = envs.VLLM_SPARSE_INDEXER_MAX_LOGITS_MB * 1024 * 1024chunk_specs = self._split_indexer_prefill_chunks( self._prefill_split_seq_lens(compressed_seq_lens_cpu[num_decodes:]), prefill_query_lens_cpu, self.max_prefill_buffer_size, max_logits_bytes, request_offset=num_decodes,)第一个限制是 workspace_size,即 max_prefill_buffer_size。它来自:
其中 576 是 MLA 潜向量的维度(FP8),132 是索引器每个 token 的缓存行字节数(128 字节 key + 4 字节 scale),factor 是 sparse_mla_prefill_workspace_factor,默认在 max_model_len \le 256K 时取 5、否则取 2。这个上限实际上是对“本 step 参与 prefill 的请求的上下文长度之和”的限制:
乘上 factor 之后的结果恰好等于主稀疏注意力 FlashMLA 工作区的行数(后面会讲),所以索引器和主注意力共用同一个显存预算:一个 step 里能 gather 多少 KV,就能同时容纳多少行的索引 K。
第二个限制是 logits 字节数:
是 chunk 内 query 总数, 是参与打分的上下文长度之和,4 是 fp32 的字节数。默认 512 MB,代入 VLLM_SPARSE_INDEXER_MAX_LOGITS_MB。这就是“fp32 logits 不能超过 512MB”的硬约束。
切片算法
_split_indexer_prefill_chunks 的逻辑分两层:
- 按请求装箱。从头遍历本 step 的 prefill 请求,逐个累加 和 ;只要 还在工作区以内、 还在 logits 预算以内,就继续加入同一个 chunk;否则结束本 chunk,开新的。
- 按 query 再切。如果某条请求自己就超过这两个上限(比如 已经大于 ),那就把这条请求单独装进一个 chunk,再沿 query 维切:每次最多 个 query。切出来的子块共享同一组
req_slice,只是query_slice不同。
返回值是一串 (req_slice, query_slice),用 request_offset=num_decodes 把 decode 行让开。这个“先按请求、再按 query”的次序是关键:同一请求的上下文在一次 gather 之后可以反复用,不必为每个 q-chunk 重新 gather。
代价与收益的数字
以第三篇的算例为准:1M 上下文、单请求 prefill。在 SGLang 的 32768 分块下,索引器一个 chunk 是 , 从 32768 一路涨到 1M,总 logits 元素约 ,总量与切法无关,但峰值每 chunk 是 个元素——显然放不下。vLLM 在 16384 的分块下同样不行: 个元素,64 GB。
vLLM 的 logits 上限把单次 logits 钉在 512 MB,也就是 个 fp32 元素;对应 时每个 q-chunk 只有 个 query。一个 16384 token 的 chunk 要切成 123 个 q-chunk。这看起来“切得很碎”,但实际上:
- 每个 q-chunk 的 logits 都是同一份上下文上的不同 query 行,gather 进工作区的索引 K 是同一份,切碎了不影响总计算量;
- 每个 q-chunk 内部的打分是 的矩阵乘,按 fp8 输入、fp32 输出,在 B200 上单卡大约 1.5–3 ms(按 30–60 TFLOPS 的打分吞吐),123 个 chunk 约 0.2–0.4 s;21 个 full 层合起来就是每层都要做这么多;
- 如果只按工作区( 行)切,一个 16384 的 chunk 可以一次装进 64 个请求左右的上下文,不需要沿 query 切;logits 上限是更紧的那一个。
这也解释了为什么要把 max_logits 设成可调的环境变量:默认 512 MB 是在小 GPU 和大 GPU 之间折中的值;在 192 GB 的 B200 上可以调大,让 chunk 更少、kernel 启动开销更小;在显存吃紧的部署里可以调小,避免 OOM。
分块之后的边界:因果窗口与 token→请求映射
一个索引器 prefill chunk 的元数据由 build_prefill_chunk_metadata 构造,它要输出三样东西:
token_to_seq:每个 query 行属于 chunk 内的哪条请求(长度 = );cu_seqlen_ks/cu_seqlen_ke:每个 query 行可以打分的 key 范围起点与终点(长度 = );block_table:chunk 内请求的页表切片。
第 1 项来自 q-chunk 的切法:同一个请求被沿 query 维切成多个子块时,token_start/token_end 只覆盖本子块的行,token_to_seq 与 cu_seqlen_ks/ke 也只用本子块的行长度分配。第 2 项是因果注意力的直接体现:第 行 query 的绝对位置是 ,它只能看到压缩后位置不超过 的 key。GLM-5.3 默认 compress_ratio = 1,所以范围就是 加上前缀偏移。
DCP 时这里还有一层:local_seq_lens = get_dcp_local_seq_lens(...) 先算出每个 rank 持有的 KV 行数,cu_seqlen_ks/ke 按 dcp_rank 映射到本 rank 的局部下标,kernel 的 cp_kv_cache_interleave_size 参数保证映射与 decode 路径一致。这样索引器的打分 kernel 不需要知道 DCP 的存在,只需要按 ks/ke 与 block_table 去读。
当一个请求被切成多个 q-chunk 时,第一个 q-chunk 的 skip_kv_gather = False,后续为 True:KV gather 只做一次,后面的 q-chunk 直接复用工作区。这是“先按请求、再按 query”的次序带来的直接收益——如果是按 query 切然后再按请求拼,每个 q-chunk 都要重新 gather 同一份上下文。
两个上限如何“接力”
对单请求 1M、16384 chunk 的情形,按当前默认参数算一遍 q-chunk 数。表里的 取 chunk 末尾 query 的上下文长度,compress_ratio=1 时它等于压缩后的 key 数;真实实现用各请求的压缩长度之和,数字会有几个百分点的出入:
- 工作区 行。第 个 chunk 的上下文长度(对 chunk 内最早的 query 而言)是 ,直到 1M 附近才逼近工作区。
- logits 限制: MB,即 。
- 因此每个 chunk 的 q-chunk 数是 , 随 增大而变小。
| chunk 序号 | 上下文 (末尾 query 的位置) | 允许的 | q-chunk 数 | 本 chunk 的 logits 峰值 |
|---|---|---|---|---|
| 1 | 16384 | 8192 | 2 | 512 MB |
| 2 | 32768 | 4096 | 4 | 512 MB |
| 4 | 65536 | 2048 | 8 | 512 MB |
| 8 | 131072 | 1024 | 16 | 512 MB |
| 16 | 262144 | 512 | 32 | 512 MB |
| 32 | 524288 | 256 | 64 | 512 MB |
| 64 | 1048576 | 128(精确值约 134) | 128(精确值约 123) | 512 MB |
整个请求的 q-chunk 总数(按表中近似值)约 个,21 个 full 层合计约 5400 次索引器打分 kernel 调用。每次的 logits 都是 512 MB,但只短暂存在——kernel 算完立即选 Top-K,logits 缓冲可以复用。这也是为什么 vLLM 选择“q-chunk + 立即选 Top-K”而不是“整个 chunk 算完所有 logits 再选”:后者需要一个随 增长的显存池,前者只需要一个固定的 512 MB。
第 64 个 chunk 时工作区(2.1M 行)远大于 ,所以工作区限制始终不起作用;真正让 chunk 切成 q-chunk 的只有 logits 限制。反过来说,如果 max_model_len 是 128K、factor=5,工作区只有 640K 行,一个 1M 请求(如果模型支持)就会被工作区切出多个请求级 chunk;而 128K 请求的上下文永远不会超过工作区,logits 限制仍然是主要约束。工作区限制是“跨请求”的(多个请求的上下文加起来);logits 限制是“单请求内”的(一条请求的 logits 行数)。 理解这一点,就能判断在某个长上下文场景下,是工作区还是 logits 先成为瓶颈。
与主注意力切块的耦合
索引器的 q-chunk 切法与主注意力的请求级 chunk 切法是两套独立的切法,但它们通过工作区耦合:
- 主注意力的
split_prefill_chunks只看“请求的上下文总长”和“工作区行数”,把 chunk 内的请求分成一组一组的“请求级 chunk”;每组在 gather 之后跑一次 FlashMLA 的 BF16 kernel; - 索引器的
_split_indexer_prefill_chunks在同一个 chunk 内再切 q-chunk,每个 q-chunk 有自己的cu_seqlen_ks/ke和block_table切片。
两者共享的只有“工作区行数”这个数字:索引器的 max_prefill_buffer_size 由同一 factor 决定,索引器的 skip_kv_gather 与主注意力的 gather 交错推进。实际执行顺序是:
- 模型层里先跑索引器(21 个 full 层之一):对每个 q-chunk,按
block_table读索引 K 缓存、算 logits、选 Top-K,写入topk_indices_buffer; - 再跑主注意力:
forward_mqa拿到 Top-K 下标,按请求级 chunk 逐组 gather 主 KV 进工作区,跑 FlashMLA kernel。
注意索引器的“gather 索引 K”与主注意力的“gather 主 KV”是两次独立的 gather:索引 K 缓存在 DeepseekV32IndexerCache 里,行宽 132 字节;主 KV 在 kv_c_and_k_pe_cache 里,行宽 576 字节。两者都按页表读,但缓存位置不同,不能在一次 gather 里合并(除非用 HiSparse 的 host cache 路径,把两者在主机内存里分别 staging)。第 57 个 shared 层不做索引器,所以它们只有主注意力的 gather。
这种“两次 gather、两次 kernel”的形态,是 DSA + 稀疏 MLA 在 vLLM 里的基本执行单元。SGLang 的选择略有不同:它在 prefill 时把索引器与主注意力按块交错执行,索引 K 与主 KV 的读取在块级别交替;vLLM 则是“先整层索引器、后整层主注意力”,因为它的索引器输出是整层的 Top-K 缓冲,主注意力直接消费。两种方式的带宽总量相同,差别在于中间结果的驻留位置与 kernel 调度的粒度。
索引器的 TP 行切分
还有一件与“二次方项”直接相关的事:balanced_prefill_row_shard。索引器的权重(wq_b、wk_weights_proj、k_norm)都是复制的——TP8 的每个 rank 都持有同一份索引器权重。如果不额外切分,8 张卡会同时做同一份 的打分,算力白白浪费 7/8。
vLLM 在满足一定条件时(CUDA、DCP=1、非 PCP、TP>1、非全图模式等),会把 prefill 的 query 行按“索引器工作量”切成 TP 段:
first_key = torch.repeat_interleave(seq_lens_cpu - query_lens + 1, query_lens)row_in_request = torch.arange(num_rows) - torch.repeat_interleave(...)cost = torch.cumsum((first_key + row_in_request) // compress_ratio, 0)targets = torch.arange(1, tp_size) * total // tp_sizebounds = [0, *torch.searchsorted(cost, targets).tolist(), num_rows]它给第 行算的“工作量”是这一行 query 要打分的 key 数,即该行的绝对位置;累加得到前缀和 cost,再在等分的目标值上二分,就得到每张卡负责的连续行区间。打分完成后,PrefillRowShard.exchange_topk 用 all_gatherv(变长 all-gather)把各 rank 的 Top-K 结果拼回全局行序:
topk_buffer[self.num_decode_tokens:end, :width] = get_tp_group().all_gatherv( local, dim=0, sizes=self.sizes)这步通信的大小是 字节(int32 下标)。16384 个 token 时是 134 MB,摊到 8 卡每次约 17 MB 的发送量,远小于索引器的计算量。
这里有一个细节值得注意:行切分是按“行”切,而同一请求的不同行工作量差异很大(越靠后的行要打分的 key 越多),所以二分时用的是累计工作量而不是行数。对一个 1M 的请求,工作量几乎全部集中在后半段,前段的行会大量分给同一张卡——这正是“按工作量切”而不是“按行数均分”的原因。
主稀疏注意力的工作区:先把 KV 搬进一块固定大小的显存
为什么不能直接读分页 KV
decode 时,稀疏 MLA 的每个 query 只读 Top-K 个位置,kernel 可以直接对每个请求维护一张 block table(页表),在 kernel 内部用下标在分页缓存里随机 gather。prefill 不行:一个 chunk 的每个 query 要读的 Top-K 位置各不相同,且一个请求的 Top-K 集合大小是 (16384 个 token 时约 3300 万个下标),如果 kernel 在每次点积前都按 block table 跑一次间接寻址,访存会碎成几百万次短读,带宽利用率极低。
第三篇里 SGLang 的处理方式是在 prefill 时按块做“两两块”计算,索引器和注意力都在块内/块间分别处理。vLLM 是另一个思路:把本 chunk 需要读的 KV 先整体 gather 进一块连续的工作区(workspace),FP8 上转 BF16,再让 FlashMLA 的 prefill kernel 在这个连续缓冲区上跑。
工作区大小的来由
get_prefill_workspace_size 只有一行:
def get_prefill_workspace_size(vllm_config: VllmConfig) -> int: # Memory usage: factor * max_model_len * 576 * 2 bytes factor = vllm_config.attention_config.sparse_mla_prefill_workspace_factor return vllm_config.model_config.max_model_len * factor返回的是“行数”而不是字节数,每行是一个 token 的 KV 潜向量(576 个 BF16,即 1152 字节)。factor 的默认值在 VllmConfig.__post_init__ 里确定:
self.attention_config.sparse_mla_prefill_workspace_factor = ( 5 if self.model_config.max_model_len <= 256 * 1024 else 2)也就是说,256K 以内的上下文,工作区最多容纳 5 倍于 max_model_len 的行;1M 上下文时只有 2 倍,即 2M 行、约 2.3 GB。为什么要随上下文缩短这个倍数?因为工作区是常驻显存:1M 上下文下 5 倍就是 5.76 GB,而 GLM-5.3 在 8 卡 H200 上的 KV 预算本来就很紧(第一篇算过,权重约占 870 GB,剩下 250 GB 左右给 KV 和缓存),5.76 GB 的工作区加上索引器缓存会让可同时容纳的请求数进一步下降。factor=2 时,一条 1M 请求的 KV 恰好能用自己的两倍行数装进工作区,留给其他并发 prefill 的空间是 1M 行。
注意工作区的行数是按“请求的上下文总长”计的,而不是按“本 chunk 的 query 数”计。一个 step 里如果有多条 prefill 请求,它们的上下文长度之和超过工作区,就要按 split_prefill_chunks 再切一层:
chunk_bounds = split_prefill_chunks(workspace_rows, max_prefill_buffer_size)这一步切的是“请求级”的 chunk:每个 chunk 里的所有请求一起 gather,一起跑 kernel;如果一条请求自己就超过工作区(例如 1M 上下文时 factor=2,单请求刚好等于工作区),那它自己就是一个 chunk。
gather 做了什么
在 FlashMLASparseImpl.forward_mqa 的 prefill 路径里,每个请求级 chunk 会先执行:
ops.cp_gather_and_upconvert_fp8_kv_cache( kv_c_and_k_pe_cache, chunk_workspace, chunk.block_table, chunk.workspace_starts, len(chunk.block_table),)输入是分页的 FP8 KV 缓存和张量(每行 576 字节,fp8_e4m3),输出是工作区里每行 1152 字节的 BF16。workspace_starts 是每个请求在工作区中的起始行号,block_table 是该 chunk 内所有请求的页表。这个 kernel 做的事可以分成两步:
- gather:对每个请求的每个页,把页中 64 个 token 的 576 字节读到工作区的连续区域;
- upconvert:FP8 → BF16。GLM-5.3 默认(SM10x 上)KV cache 是
fp8_e4m3,但 FlashMLA 的 prefill kernel 走的是 BF16 计算,所以必须转一次。
为什么先转再算,而不是在 kernel 里边读边转?因为 FlashMLA 的 prefill kernel 假设 Q 和 KV 的 head 维度与 cache 行宽一致(GLM-5.3 是 576 = 512 潜向量 + 64 RoPE),它可以按 q_head_size 读整行。把转换放在 gather kernel 里,可以让转换与主 kernel 完全解耦:主 kernel 只关心“工作区长这样、Top-K 下标长这样”,不关心 KV 缓存是 FP8 还是别的格式。
Top-K 下标也要换算
gather 完 KV 之后,Top-K 下标还是“逻辑位置”(在请求上下文中的第几个 token),而 kernel 需要“工作区中的物理行号”。triton_convert_req_index_to_global_index 做这个换算,对每条 query 的 2048 个下标逐一映射:
(实际实现还要处理分页、压缩比例与 DCP/PCP 的 rank 偏移,这里只写出单机单 rank 的情形。)换算后,kernel 就能在工作区里以连续的形式读 KV,访存效率接近常规的稠密 attention。
一次 prefill 的显存与带宽账
以 1M 上下文、16384 的 chunk 为例:
- 工作区 2M 行 × 1152 B ≈ 2.3 GB,常驻;
- 本次 chunk 需要的 KV:16384 个 query,各自读 2048 个位置,共约 3300 万次读取、每次 1152 B(BF16 后)≈ 38 GB 的读取流量——但实际是 gather 时从 FP8 缓存读 19 GB,再写 38 GB BF16 到工作区,之后 kernel 从工作区读;
- gather 的算力开销极小(FP8→BF16 转换),瓶颈在带宽:读 19 GB FP8 缓存 + 写 38 GB 工作区,按每卡 4.8 TB/s 计算,8 卡分摊后约 60 GB / 38 TB/s ≈ 1.6 ms 每层;78 层就是约 0.13 s。这个时间与主 kernel 的计算时间可以重叠吗?不能完全重叠,因为工作区是共享的:主 kernel 要读工作区,必须等 gather 完成。vLLM 的做法是“每个请求级 chunk 一次 gather + 一次 kernel”,chunk 之间是串行的;重叠只能发生在一个请求的 gather 与另一个请求的 kernel 之间(如果工作区足够大,多个请求可以分成多个 chunk,不同 chunk 的 gather 可以提前发起)。
这也是工作区大小与性能之间的直接权衡:工作区越大,能一次 gather 的上下文越多,chunk 越少,gather 与 kernel 的交替越少;但常驻显存也越多,KV 缓存能做多就少多少。factor=2 在 1M 上下文下就是一次只装一个满长请求,正好保证一条 1M 请求不会被切成多个请求级 chunk。
与索引器工作区的“共享预算”
前面提到,索引器的工作区 get_max_prefill_buffer_size 是按“每行 132 字节的索引 K”算的,但它刻意与 FlashMLA 工作区对齐:576 × 2 / 132 ≈ 8,所以一个 BF16 KV 行等于 8 个索引 K 行。factor 乘上去之后,索引器能容纳的 token 行数恰好在显存上“等于”FlashMLA 工作区。这不是巧合,而是设计者选择过的一个平衡点:两个工作区各占总显存的一个固定比例,不随上下文长度二次增长。
一个容易踩的坑:工作区与 prefix cache 的关系
工作区里的 KV 是从分页缓存 gather 来的临时副本,不是新的 KV 缓存。计算完成后,新的 KV 由每一层的 fused_norm_rope 写回分页缓存,工作区里那份就被下一次 gather 覆盖了。所以:
- 前缀缓存命中时,工作区只包含“前缀之后的 query 自己的 KV”,前缀的 KV 留在分页缓存里被 gather 时一并读入 Top-K 参考范围;
- 如果 Top-K 选中了前缀中的位置,gather 时也会把那些页的 KV 读进来;
split_prefill_chunks的seq_lens计的就是“上下文总长”,包括前缀。
PCP:把 prefill 的 query 行摊到更多卡上
PCP 解决的是哪一层并行度
在 8 卡 TP8 + EP 的部署里,prefill 的每个 GEMM 已经在 TP 组内按输出维切了 8 份,MoE 也按专家切了 8 份。但注意力与索引器的并行度并不是“TP=8”这么简单:
- 主注意力的 head 数是 64,TP8 下每卡 8 个头,GPU 内部还能再用 query 维和 KV 维切块;这部分并行度是够的;
- 索引器只有 32 个头,且权重复制,每个 rank 本来要算全部 32 个头;TP 行切分把 query 行切开之后,并行度才真正上来;
- 但更重要的是单卡的 KV 读带宽:prefill 每层要读 字节的 KV,1M 上下文、16384 chunk 时是 19 GB/层;这个量级下,单卡的 4.8 TB/s 需要约 4 ms,78 层就是 0.3 s。多卡 TP 已经把这个量按 head 切了 8 份,但如果你还想继续扩,TP 往 16 走会带来更细的 GEMM 与更多通信。
PCP 的思路不是继续切权重,而是把“一个 step 的 query 行”本身分给更多 rank。每个 PCP rank 都持有同一份 TP 权重切分、同一份 KV 缓存分片(PCP 不增加 KV 分片数,只增加副本),但它只负责一部分 query 行;算完后把各 rank 的 hidden / KV 合起来。ParallelConfig.prefill_context_parallel_size 的注释写得很准确:
Number of ranks that split prefill sequence computation. PCP expands the process world size but does not increase the KV-cache shard count.
命令行参数是 --prefill-context-parallel-size / -pcp,默认 1。开启后,进程总数变成 PP × TP × PCP × DP,但 KV 的切分数仍由 TP(和 DCP)决定。换句话说,PCP 是“用更多卡换更短的 prefill 墙钟时间”,而不是“用更多卡换更大的 KV 容量”。
双端切分:为什么是 2P 段而不是 P 段
最直观的切法是“把 query 均分成 P 段,每段一个 rank”。但因果注意力的成本随位置增长:第 0 段 query 的上下文只有 1 段长,最后一段 query 的上下文有 P 段长,最重的 rank 会拖慢整个 step。PCP 用的是“双端切分”:把一个 chunk 切成 段,rank 拿第 段和第 段。
num_chunks = 2 * self.pcp_world_sizechunk_size = (query_len + num_chunks - 1) // num_chunkschunk_indices = (rank, num_chunks - 1 - rank)以 PCP=4、chunk=16384 为例,每段 2048 个 token:
| rank | 段 A(位置) | 段 B(位置) | 两段的上下文长度之和 |
|---|---|---|---|
| 0 | 0–2047 | 14336–16383 | 0 + 14336 = 14336 |
| 1 | 2048–4095 | 12288–14335 | 2048 + 12288 = 14336 |
| 2 | 4096–6143 | 10240–12287 | 4096 + 10240 = 14336 |
| 3 | 6144–8191 | 8192–10239 | 6144 + 8192 = 14336 |
每一行的和都等于 ,与 rank 无关。这是双端切分最关键的性质:它把“因果注意力成本随位置线性增长”这件事,转成了“每个 rank 拿一段便宜的和一段贵的”,从而让负载均衡。如果只做 P 段均分,rank 0 的上下文几乎为 0,rank 3 的上下文是 3 倍段长,最慢的 rank 决定了整个 step 的时间,加速比会从 4 掉到 2 左右。
实现上还有两个细节:
chunk_size是向上取整,最后一段可能不足 2048;如果 段里出现空段(比如 query 只有 3 段长),replicated_requests会把这条请求标记为“整段复制到所有 rank”,而不是分片。判断条件是drops_a_chunk:当 时,某些 rank 会拿到空段,此时分片没有意义,不如整段复制;- decode 默认也是整段复制到每个 rank(
shard_decode_requests=False);如果开启pcp_shard_decode_requests,decode 会按请求轮流分配给不同 rank,再通过 KV 的 all-gather 让每个 rank 保持完整缓存。
batch 重排:从全局行到本地行
PCP 的第二个关键动作是重排 InputBatch。全局 batch 是按请求顺序排列的 token 行;PCP 要把每个 rank 负责的两段取出来,拼成“本 rank 的本地 batch”,同时记录三张映射表:
padded_gather_idx:全局行 → 本 rank 的“拼接后行号”(含各 rank 的 padding);hidden_restore_idx:本 rank 的拼接行 → 全局行;gathered_kv_write_mask:哪些行负责写 KV(复制的 decode 只让 rank 0 写,避免重复写)。
_build_batch_layout 的注释给了一个 PCP=2 的小例子:
global batch: [A B C D E F G]rank 0 / rank 1: [A B G] / [C D E F]padded gathered: [A B G _ | C D E F]hidden_restore_idx: [0, 1, 4, 5, 6, 7, 2]padded_gather_idx: [0, 1, 6, 0, 2, 3, 4, 5]全局有 7 个 token,rank 0 拿到第 0、1、6 个(头段 A、B 和尾段 G),rank 1 拿到第 2–5 个。拼接后的缓冲区是 8 行(两个 rank 各 4 行,rank 0 的最后一行是 padding)。hidden_restore_idx 把拼接行还原成全局顺序:[0,1,4,5,6,7,2] 表示全局第 0 行来自拼接第 0 行、全局第 1 行来自拼接第 1 行、全局第 2 行来自拼接第 6 行……;padded_gather_idx 则相反,把全局行映射到拼接行(padding 行映射到 0)。
partition_batch 用 torch.index_select 把 input_ids 和 positions 按 padded_gather_idx 拷到本地缓冲区,再重新计算本地的 query_start_loc、seq_lens、logits_indices。seq_lens 不是从全局表里取的,而是用本地最后一行 position + 1 回填——因为同一个请求在本地被切成两段后,两段的“上下文长度”不同,必须按本地行重新算。
三处集合通信
PCP 不是免费的。一个 step 里,它至少引入三类通信:
第一,KV 写入的 gather。 每个 rank 只算自己那段 query 的 K/V,但 KV 缓存要求每个 rank 都持有完整副本。所以写缓存前,要把本 rank 的 kv_c_normed、k_pe 以及对应 slot mapping 在 PCP 组内 all-gather:
(cache_kv_c, cache_k_pe_flat), cache_slot_mapping = _gather_prefill_cache_inputs( (kv_c_normed, k_pe_flat), slot_mapping, num_decode_tokens, pcp_shard_decode_requests,)注意 gather 的是“本 step 的新 token”,不是整个历史;所以通信量是 字节,16384 chunk、PCP4 时每 rank 约 4096 行、每层 2.3 MB,78 层约 180 MB,8 卡聚合带宽下约 20 μs。这个量不大,但它是每层都发生的。
第二,索引器 K 的 gather。 索引器的 K 缓存同样要求每个 rank 完整,maybe_gather_indexer_k 做同样的 gather;区别是只发生在 21 个 full 层,且每行是 132 字节的量化格式。21 层、每层 4096 行、每行 132 B,约 11 MB/rank。
第三,hidden / MoE 的 gather。 这一处取决于是否开 EP:
- 如果开了 expert parallel(
enable_expert_parallel=True),MoE 走 DeepEP 的 dispatch/combine,PCP 的 token 会在 dispatch 前被 all-to-all 重新分布,不需要额外的 all-gather;ParallelConfig.use_all2all在 EP 且 PCP>1 时强制为 true,正是这个原因; - 如果没开 EP(纯 TP 的 MoE),每张卡都有全部专家的权重,但只有本地 token;
PCPManager在 MoE 前把各 rank 的 tokenall_gather起来(moe_gathers_tokens=not enable_expert_parallel),算完再取回本地行。
此外,采样前还要把 hidden states 还原成全局顺序:
gathered = get_pcp_group().all_gather(hidden_states, dim=0)return gathered[self._hidden_restore_idx]这一步只在最后一个 transformer 层之后发生一次,通信量是 字节(16384 token 时 200 MB),8 卡聚合带宽下约 25 μs;与 78 层的 KV gather 相比可以忽略,但它必须等所有 rank 的前向都结束,是 PCP 的一个同步点。
PCP + DCP:decode 分片与 prefill gather 的配合
PCP 和 DCP(decode context parallel)可以同时开。DCP 的切法是把 KV 按 token 轮转分片到各 rank 上,分片粒度由 cp_kv_cache_interleave_size 控制。get_dcp_local_seq_lens 的计算很简洁:
rounds = seq_lens // (dcp_size * cp_interleave)remainder = seq_lens % (dcp_size * cp_interleave)remainder = clamp(remainder - dcp_rank * cp_interleave, 0, cp_interleave)local_seq_lens = rounds * cp_interleave + remainder即“先按整轮分,再按 rank 顺序分余数”。decode 时每个 rank 只读自己的那一段 KV,注意力输出用 LSE 合并;prefill 时则不同:prefill 的 query 要看到全部上下文,所以必须把各 rank 的 KV 分片合起来。
FlashMLASparseImpl._gather_prefill_chunk 就是为此存在的:
dist.all_gather_into_tensor(gathered_kv, shard, group=get_dcp_group().device_group)...topk_indices, topk_length = triton_convert_req_index_to_global_index( ..., prefill_workspace_rank_stride=shard_rows, dcp_size=self.dcp_world_size, dcp_rank=self.dcp_rank, ...)每个 rank 的 prefill 工作区只装“自己负责的 DCP 分片”,all-gather 后得到完整的上下文;Top-K 下标从“逻辑位置”映射到“rank-major 的拼接行号”,映射时按 shard_rows 做 stride。这个 kernel 的输入输出都是 BF16,通信量是 字节 × DCP 组大小,1M 上下文、DCP4 时约 4 × 288 MB ≈ 1.15 GB 每层——比 PCP 的 KV gather 大一个数量级,因为这里 gather 的是整个上下文,不是新 token。
这解释了为什么 PCP+DCP 组合的配置约束很严:validate_config 里明确要求,PCP+DCP 只支持 sparse MLA(hasattr(config, "index_topk")),因为只有稀疏 MLA 的分片行数有上界(每行只读 Top-K),dense MLA 的 gather 尺度会失控。
配置约束与图形模式
PCPManager.validate_config 列出的一串限制,基本就是“PCP 目前能用在哪些模型/模式上”的清单:
- 只支持 MLA 模型(
model_config.use_mla),不支持 encoder-decoder、多模态输入、LoRA; - 投机解码只支持 DSpark 或单模块 MTP;
- PCP+DCP 只支持 sparse MLA;
dcp_comm_backend必须是ag_rs(all-gather + reduce-scatter);- CUDA Graph:sparse MLA + PCP 且 DCP=1 时,只有 DeepSeek-V3.2 和 GLM-5.2/5.3 支持图形捕获;Full CUDA Graph 只能用于 decode-only 的 routine(
FULL_DECODE_ONLY),prefill 走 piecewise/eager。
最后一条尤其值得记住:PCP 的价值在 prefill,但 prefill 本身不能用整图 CUDA Graph 捕获。所以 PCP 带来的加速,是“kernel 变短 + 通信变多”的净效果,不能靠图优化再叠一层。第三篇里 SGLang 的 CP 也是类似处境:prefill 只能用 piecewise 图,真正的收益在计算与带宽的摊薄。
一个 PCP step 的完整生命周期
把上面的动作按时间排一遍:
- 调度器给出全局
num_scheduled_tokens; PCPManager.partition_batch按 2P 段切出本 rank 的本地行,生成padded_gather_idx/hidden_restore_idx;prepare_attn生成本地的 block table 与 slot mapping(复制的行只让 rank 0 写);- 每层前向:本地行做 A 投影、QKV、索引器(若 full 层);写 KV 前 all-gather 本层新 token 的 K/V 与索引 K;
- 稀疏 MLA 读本地已 gather 的工作区(含 PCP+DCP 的上下文 gather);
- MoE:EP 时走 all-to-all,非 EP 时先 all-gather 本地 token;
- 最后一层后:
restore_hidden_states把 hidden 还原成全局顺序,采样,输出。
这条路径与单卡 prefill 的差别,只在 2、4、5、6、7 步的“本地/全局”映射上;模型本身的算子没有变化。这也是 PCP 设计得比较“薄”的原因:它没有改模型,只改了 batch 的组织方式。
从调度计划到 GPU 张量:一个 chunk 的元数据
调度器只给出“每个请求多少 token”,真正把这些数字变成 GPU 张量的是 ModelRunner.prepare_inputs。对 prefill,最关键的几个字段是:
| 字段 | 形状/含义 | 在 prefill 里的作用 |
|---|---|---|
query_start_loc | [num_reqs + 1],第 个请求的起始行 | 定位每个请求在拼接 batch 中的 query 段 |
seq_lens | [num_reqs],每个请求的上下文长度 | 决定索引器与注意力要读多远 |
positions | [num_tokens],每个 token 的绝对位置 | RoPE;也用于重算本地的 seq_lens |
slot_mapping | [num_tokens],每个 token 写入 KV 页的槽位 | KV 写入与页表定位 |
block_table | [num_reqs, max_blocks] | gather 时按页读 KV |
prefill 的 positions 不是从 0 开始,而是从 num_computed_tokens 开始:前缀缓存命中时,第 100K 个 token 的 position 就是 100000,而不是 0。seq_lens 则等于 num_computed_tokens + num_scheduled_tokens,也就是“本 chunk 结束后这个请求的上下文长度”。这两个字段一起决定了索引器要打分的范围:第 个 query 只能看 positions[i] 之前的 key(因果),不能看 chunk 内它后面的 token。
另一个容易忽略的字段是 max_query_len。索引器与主注意力的 prefill 分支都按“本 batch 内最长的 query 长度”来切块;如果 batch 里混了一条 16384 的 prefill 和几条 decode,max_query_len 会是 16384,decode 的 CUDA Graph 就不能用,整个 batch 走 eager。这也是 vLLM 调度器把 decode 排在 prefill 前面、并尽量把 prefill 集中在少数 step 的原因之一:减少“decode 被 prefill 拖出图”的次数。
短 prefill 的“直接稠密”分支
有一个很实用的优化:当本 step 的 prefill 最长上下文不超过 index_topk(2048)时,vLLM 干脆不算索引器,直接用稠密 MHA:
def _use_dense_mha_prefill(vllm_config, prefill_max_seq_len, topk_tokens): return ( attention_config.hisparse_config is None and not attention_config.sparse_mla_force_mqa and prefill_max_seq_len <= topk_tokens )逻辑很直白:如果上下文本来就不超过 2048,Top-K 也只会选 2048 个位置,稀疏注意力等价于稠密注意力,那还算索引器干什么?直接让 FlashAttention 对所有 key 做因果注意力,省掉 21 层索引器的打分与切片。这个分支只在“上下文很短”的请求上触发,比如系统提示 + 几个来回的对话;它不改变长上下文的路径,但能显著降低短请求的 TTFT。
条件是 prefill_max_seq_len <= topk_tokens,即整个 batch 中最长的上下文不超过 2048;一旦混进一条 3000 token 的请求,整个 batch 都回到稀疏路径。这是“按 batch 决策”而不是“按请求决策”的一个典型代价。
一层 prefill 的算子与通信清单
下面以 GLM-5.3、单机 8×H200、TP8 + EP8、chunk token、DCP=1、PCP=1 为例,把 vLLM 一次 prefill 前向在一层里的算子按顺序列出。表中的“通信量”是每张卡的发/收量级(双向合计在括号里注出)。
| 步骤 | 算子 | 形状/说明 | 通信 |
|---|---|---|---|
| 1 | 层首 fused AllReduce + RMSNorm | hidden ,与 residual 相加 | TP AllReduce, MB/层(双向约 350 MB) |
| 2 | A 投影(q_a + kv_a 融合) | ,复制权重 | 无 |
| 3 | q/kv RMSNorm + RoPE + KV 写入(fused_norm_rope) | 融合 kernel,写 FP8 KV 页 + 索引 K | 无(PCP>1 时这里插一次 AllGather) |
| 4 | 索引器 Q 投影 + 打分 + Top-K | 21 个 full 层; 打分,按 q-chunk 切 | TP 行切分时 all_gatherv 交换 Top-K |
| 5 | Q 上投影(q_b) | (64 头 × 256) | 无(头维切分,复制 A 投影) |
| 6 | Q 吸收 bmm + 稀疏 MLA prefill | 每 query 读 2048 个 KV,工作区 gather | PCP 时 KV 写 AllGather;PCP+DCP 时上下文 gather |
| 7 | o_proj | ,reduce_results=False | ReduceScatter,约 175 MB/层 |
| 8 | post-attention RMSNorm + AllReduce | 与下一步 MoE 前的残差融合 | TP AllReduce,约 350 MB/层 |
| 9 | MoE 门控 + top-8 路由 | 专家打分 | 无 |
| 10 | EP dispatch | 每 token 发往 8 个专家所在 rank | all-to-all,约 B ≈ 805 MB/层 |
| 11 | 专家 GEMM(FP8) | 每专家约 token | 无 |
| 12 | combine + ReduceScatter | 专家输出归约 | all-to-all 回程 + RS |
| 13 | 共享专家 + routed scaling + 残差 | 标量乘加 | 无 |
几点说明:
- 第 1、8 步的 AllReduce 是融合的。GLM-5.3 的
o_proj与 MoE 输出都设了reduce_results=False,把归约推迟到下一个 RMSNorm,由flashinfer_allreduce_residual_rmsnorm把“通信 + 加残差 + 归一化”合成一个 kernel。prefill 的 hidden 是 201 MB/层,融合后省掉的是两次 201 MB 的显存读写,而不是通信量本身。 - 第 3 步写 KV 的量: 字节(FP8),16384 token 时 9.4 MB/层/batch;78 层合计约 736 MB(TP8 下每卡约 1/8)。这个量不大,但它是 prefill 的“必须落盘”成本,且要在注意力之前完成(同一层的 KV 要能被本层读到)。
- 第 6 步的 KV 读取:每个 query 读 2048 个位置、每个位置 576 字节 FP8, GB/层;78 层约 1.5 TB 的读流量。这是 prefill 最大的带宽项,也是 TP 按 head 切分、PCP 按 query 切分要解决的核心矛盾。
- 第 10 步的 MoE all-to-all 是 prefill 通信的第二大项。 个 (token, expert) 对,每对 6144 字节(FP8),805 MB/层(全部 rank 合计);75 个 MoE 层约 60 GB,与 TP AllReduce 的 27 GB/卡 处于同一量级,但它是 all-to-all,链路利用率通常低于 ring AllReduce。第三篇算过这笔账:单机 NVLink 下约 60–100 ms,跨节点 IB 会到秒级。
把这张表与第二篇的 decode 表对照,会发现一个明显的反转:decode 里 TP AllReduce 是“每层每步固定几百 KB、按 token 摊很贵”,prefill 里 TP AllReduce 是“每层几百 MB、摊到 16384 个 token 上很便宜”;decode 的 MoE all-to-all 只有 个 token,prefill 的 all-to-all 是 ,绝对量大但每个 token 的成本相同。所以:
- prefill 的优化重点是“把大矩阵乘与 KV 读摊到更多卡”,TP/PCP 越大越好,只要通信能重叠;
- decode 的优化重点是“减少每 token 的通信次数与同步点”,DP Attention、把 AllReduce 融进 RMSNorm、CUDA Graph 都是这个方向。
TTFT 的算术:一条 1M 请求在 vLLM 里要等多久
TTFT 由四段组成:
其中 是 chunk 数, 是第 个 chunk 的前向时间(含索引器、注意力、MoE 与通信)。 对 1M token 的 prompt 是几十毫秒到几百毫秒(取决于 tokenizer 与 CPU), 是一次 LM Head + 采样,几十毫秒。真正的大头是 。
把第三篇的算例搬到 vLLM 的切法上(16384 的预算、1M 上下文、PCP=1):
| 项目 | 计算量/通信量 | 估算时间 |
|---|---|---|
| 索引器(21 层) | 约 94 PFLOP,带宽受限,8 卡约 300 TFLOPS/卡 | 约 39 s |
| 主干(投影 + 稀疏 MLA + MoE) | 约 100 PFLOP,8 卡约 1.5 PFLOPS/卡 | 约 8 s |
| KV 读取 | 1.5 TB,8 卡合计约 38 TB/s | 约 40 ms(与主注意力计算重叠) |
| TP AllReduce | 约 27 GB/卡,NVLink 900 GB/s | 约 30 ms(与计算重叠) |
| MoE all-to-all | 约 60 GB(全部 rank 合计,dispatch + combine) | 约 20–100 ms(与计算部分重叠,取决于实现) |
| KV 写入 | 约 92 MB/卡(736 MB 分 8 卡) | 约 0.02 ms |
索引器是最大单项,39 s 量级;主注意力计算量约 22 PFLOP,按 8 卡 1.5 PFLOPS/卡估算约 2 s,KV 读取的 1.5 TB 虽然绝对量大,但 8 卡聚合带宽下只有几十毫秒,不是瓶颈。两项叠加,1M 单请求的 TTFT 在几十秒量级;这与第三篇的结论一致。
vLLM 的三层切片对这张表的影响:
- 调度分块不改变总量,只改变峰值显存与 ITL;16384 与 32768 的差别主要在“同时混入多少 decode”;
- 索引器切片把单次 logits 峰值压到 512 MB,代价是 kernel 启动次数增加(123 个 q-chunk × 1 层,全模型 21 个 full 层合计约 2583 次 kernel 调用),但每次 kernel 都是 的矩阵乘,启动开销占比很小;
- PCP 把每个 rank 的 query 行降到 ,索引器与主注意力的计算时间近似按 缩短;但每个 rank 仍要 gather 自己那部分 query 的 KV(),所以 KV 读取也按 缩短。通信只增加“新 token 的 KV AllGather”(每层几 MB),相对收益非常显著。按 PCP=4 估算,索引器从约 39 s 降到约 10 s、主干从约 8 s 降到约 2 s;TTFT 从几十秒降到十几秒量级。
这就是 PCP 的真正价值:它不是“让单卡算得更快”,而是“让一张卡只算四分之一的 query,同时不增加太多通信”。代价是进程数翻倍、每 rank 的 KV 副本翻倍(显存不变,因为 KV 分片数不变,但每个 PCP rank 都持有同一份分片),以及一堆配置限制。
工程上的几个坑
坑一:索引器的行切分与图模式互斥
tp_prefill_row_sharding_supported 的条件里有一条 cudagraph_mode.mixed_mode() != CUDAGraphMode.FULL。原因是行切分后每个 rank 处理的 query 行数不同,all_gatherv 的变长特性与全图捕获的“固定形状”假设冲突。所以如果你为了极低延迟把 --cudagraph-mode FULL 打开,索引器的 TP 行切分会自动关闭,8 张卡各自重算全部 32 个索引头,算力浪费会明显变大。这是一个“图模式”和“计算并行”之间的取舍,部署时要么接受行切分不开图,要么接受全图但索引器重复计算。
坑二:max_query_len 决定图能否复用
前面提到混合 batch 的 max_query_len 问题。更隐蔽的是“短 prefill 混入 decode”:一条请求还剩 3000 个 token,另一条 decode 请求新增 1 个 token,两者在同一个 step 里,max_query_len=3000,整批不能用 decode 的 CUDA Graph,decode 的每步开销从“几十微秒”变成“几百微秒”。vLLM 的 prefill_runs_as_decode 只能处理“1 个 token 的 extend”,处理不了 3000 个 token 的短 prefill。调度器层面的缓解是 prefill_schedule_interval——把 prefill 集中到少数 step,其余 step 纯 decode,但这会牺牲 prefill 的及时性。
坑三:工作区是共享的,多请求 prefill 会互相拖慢
工作区大小固定为 factor × max_model_len 行。如果两条 500K 的请求同时 prefill,它们占满工作区,split_prefill_chunks 会把它们放进同一个请求级 chunk(如果总长 ≤ 工作区),或者分成两个 chunk 串行处理。分块越多,gather 与 kernel 的交替次数越多,总时间变长。在生产部署里,长上下文请求最好不要同时到达:可以用准入控制(max_num_queued_reqs、按 context length 限流)把长请求排队,等前一条的 prefill 结束再放进来。这是 SGLang 与 vLLM 都绕不开的工程问题,第三篇在 SGLang 视角下也讨论过。
坑四:max_logits 设太大会 OOM,设太小会变慢
512 MB 的 logits 上限对应 时的 134 个 query;如果把 VLLM_SPARSE_INDEXER_MAX_LOGITS_MB 调到 2048,q-chunk 变成 536 个 query、总数降到 31 个,kernel 调用少 4 倍;但峰值显存多 1.5 GB,在多请求并发时可能刚好卡在 OOM 边缘。默认值是在“单请求单机”与“多请求并发”之间取的折中,部署时要按最坏并发场景评估。
坑五:索引器缓存与主 KV 的页对齐
DSA 的索引器 K 缓存每行 132 字节(128 字节 FP8 key + 4 字节 scale),主 KV 每行 576 字节(FP8)。两者按 page_size=64 分页,一个主 KV 页 36,864 字节、一个索引器页 8448 字节。前缀缓存 gather 时两者必须同时按页搬运,否则命中前缀的请求会因为索引器缓存没命中而重算索引器。第一篇已经讲过 SGLang 的 PageInterleaveDSATokenToKVPool 如何在页级把两者捆绑;vLLM 的 DeepseekV32IndexerCache 同样按 block_size 分配,并在 DeepseekV32Indexer 的 k_cache 里存量化后的 key。prefill 时两套页表必须一致,否则 indexer_slot_mapping 与 mla_slot_mapping 会错位——这是 fused_norm_rope 同时接收两套 slot mapping 的原因。
坑六:PCP 的进程世界变大,启动与显存都翻倍
PCP=4 时,进程总数是 PP × TP × PCP × DP,每张卡的权重与 KV 分片都不变(PCP 不增加分片),但每张卡都要加载一份权重(如果权重在 TP 内切分,每卡加载本 TP 分片,且各 PCP rank 持有相同分片),单卡显存占用不变。变的是进程数、启动时间、以及 NCCL 通信组的大小。如果节点内卡数不够,PCP 只能跨节点,那时的 KV AllGather 会走 IB,通信成本从微秒级变成毫秒级,PCP 的收益会被吃掉大半。所以 PCP 最适合“单机 8 卡、上下文长、单请求”的场景。
与 SGLang 的 prefill 路径对照
把第三篇的 SGLang 路径与这篇的 vLLM 路径放在一起:
| 维度 | SGLang(第三篇) | vLLM(本篇) |
|---|---|---|
| 调度表示 | 显式 PrefillAdder,ForwardBatch.is_extend 区分 extend/decode | 统一 num_computed_tokens 追 num_tokens_with_spec,无相位 |
| 分块预算 | max_prefill_tokens + chunked_prefill_size | max_num_batched_tokens + long_prefill_token_threshold |
| 长 prefill 保护 | 按 chunk 大小切 | 阈值 + 自适应下限;单请求时不切 |
| 索引器切块 | 按 32K 块做块内/块间两段算 | 按“工作区 N + logits 字节”切 q-chunk |
| 索引器并行 | TP 内复制,CP 切 query | TP 行切分 + all_gatherv 交换 Top-K |
| 主注意力 prefill | 分页 KV 直接读,块内/块间 | gather 进 FP8→BF16 工作区,连续读 |
| 上下文并行 | interleave CP,每 rank 两块交错 | PCP 双端切分,每 rank 头尾两段 |
| KV 分片 | CP 下按 token 交错分片 | PCP 不增加分片;DCP 按 cp_interleave 轮转 |
| 短 prefill | 无特殊分支 | ≤ 2048 上下文直接稠密 MHA |
| 图形模式 | CUDA Graph 桶 + MTP 6b | 仅 decode/短 extend 可入图,prefill 走 piecewise/eager |
这些差异背后是两套框架对“prefill 是什么”的不同理解:SGLang 把它当成一种显式的 forward 模式(extend),因此有专门的 PrefillAdder 和块级调度;vLLM 把它当成“追 token 总账”的一种自然结果,因此所有机制都围绕 num_scheduled_tokens 生长。两者没有绝对的优劣:SGLang 的块级控制在长上下文上更直接,vLLM 的统一表示在混合 batch 与投机解码上更简洁。
小结
把这篇的结论压成几句话:
- vLLM 的 prefill 没有独立的“阶段”,只有一条
num_computed_tokens追num_tokens_with_spec的总账;chunked prefill、前缀缓存、投机解码都是这条总账的不同起点与步长。 - 分块由
max_num_batched_tokens与long_prefill_token_threshold共同决定;单请求时阈值失效,长 prefill 可以吃满预算。 - 索引器是 prefill 里唯一的二次方项,vLLM 用“工作区 N 上限 + 512 MB logits 上限”把它切成 q-chunk;单请求超限时再沿 query 维切。这是 1M 上下文的 logits 峰值不会随上下文长度线性膨胀的前提。
- 主稀疏注意力把 KV gather 进一块常驻工作区(1M 上下文时约 2.3 GB),FP8 上转 BF16 后再算;工作区大小与索引器缓冲区共享同一笔显存预算。
- TP 组内还会按“累计上下文长度”切 prefill 的 query 行,把索引器的打分摊到多卡,最后用变长 all-gather 换回 Top-K。
- PCP 用“2P 段双端切分”把 query 行分给更多 rank,负载按上下文长度精确均衡;代价是三处集合通信与一组配置限制。
- prefill 的通信绝对量大但每 token 便宜,decode 的通信绝对量小但每 token 贵;这决定了两者的并行策略不同。
下一篇如果继续这个系列,可以往两个方向走:一是把 GLM-5.3 的 MoE 在 prefill 下的 DeepEP dispatch/combine 单独拆一篇(低延迟模式与高吞吐模式的选择、专家负载均衡、跨节点 IB 的账),二是把 vLLM 的前缀缓存与 KV 驱逐讲清楚(radix tree、copy-on-write、prefix cache 与 DSA 索引器缓存的同步)。这两块都是这条链路上还没有单独展开的部分。
参考资料
- vLLM 源码:V1 调度器(
vllm/v1/core/sched/scheduler.py) - vLLM 源码:PCP 管理器(
vllm/v1/worker/gpu/pcp_manager.py) - vLLM 源码:PCP 的 KV 与索引 K gather(
vllm/v1/attention/ops/pcp.py) - vLLM 源码:DSA 索引器元数据与分块(
vllm/v1/attention/backends/mla/indexer.py) - vLLM 源码:FlashMLA 稀疏 prefill 工作区(
vllm/v1/attention/backends/mla/flashmla_sparse.py) - vLLM 文档:Chunked Prefill 与
max_num_batched_tokens调优 - vLLM 官方博客:v0.6.0 的多步调度与性能更新
- DeepSeek-V3.2 技术报告(DSA 与稀疏 MLA 的原始设计,arXiv:2512.02556)
- FlashMLA:MLA 解码与稀疏注意力内核
- DeepEP:MoE dispatch/combine 通信库
- Sarathi-Serve:Chunked Prefill 与 Stall-Free Batching(arXiv:2403.02310)
- Ring Attention with Blockwise Transformers for Near-Infinite Context(上下文并行的经典实现,arXiv:2310.01889)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



