


GLM-5.3 推理全链路(十一):索引器缓存的跨层读写——21 层写入、57 层复用的带宽账
从一句话说起:省下的计算没省下带宽
前一篇账本里有一个看似矛盾的说法:GLM-5.3 的 78 个注意力层中,21 层是 full、57 层是 shared,共享层复用同一个索引组产出的 Top-K,索引器的打分计算量因此压掉了将近四分之三;但共享层仍然要为稀疏 MLA 读取自己的主 KV,而且索引器缓存的读取量按上下文长度线性增长,在 1M 上下文时达到每层 132MB 这个量级。
这句话把两件不同的事情放在了一起:省下的是计算(打分与 Top-K 选择),没省下的是带宽(读索引器 K、读主 KV)。很多关于跨层索引复用的讨论停在”计算量减少 75%“上,于是得出”长上下文 decode 只要打开共享层就能省时间”的结论。这条推理是错的,原因不在算力,而在缓存:索引器要读的那份 K 缓存本身并不是零成本的,它的写入与读取路径在推理框架里各自成账。
这一篇顺着这条追问往下拆:
- 索引器缓存到底是什么、为什么它和主 KV 缓存是两份独立的账;
- GLM-5.3 的
indexer_types如何决定哪些 layer 真正写缓存、哪些层拿到的是空壳; - 一次 decode step 里,索引器缓存被读了多少字节、拆在哪里;
- SGLang 为这条路径做了哪些优化——按页分块打分、跳过不必要的打分、复用 topk、跨层共享——各减掉了什么、没减掉什么;
- 最终给出一个可以直接套用的判断:什么时候该为索引器缓存单独扩容或优化。
先把系列前几篇的结论接上,方便对账:
- 第一篇给出 GLM-5.3 在 SGLang 里的一次请求经过的算子清单,其中”索引器”是单独一步,而不是稀疏 MLA 的内部细节;
- 第二篇在 vLLM 侧看到索引器跨层复用的具体形态;
- 第三、五篇的 prefill 分析指出索引器是二次方项,1M 请求的跨块项占了绝大部分耗时;
- 第四篇算过 PD 分离时索引器缓存跨节点传输的量级;
- 第八篇的账本把索引器读取列为 decode 阶段唯一随上下文增长的账,并留下了一句”索引器缓存的跨层读取带宽还没单独展开”。
本文就是那句追问的展开。站内关于 DSA 索引器算子本身的实现,可以参考 DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现,那里讲的是单个 kernel 里怎么算分;本文关心的是这份缓存被谁写、被谁读、读了多少。
索引器缓存是什么:与主 KV 缓存的两本账
主 KV 缓存里存的是什么
GLM-5.3 是 MLA 架构,每层每个 token 只存一份压缩后的潜在向量:512 维的 kv_lora_rank 加上 64 维的 qk_rope_head_dim,合计 576 维。按 FP8 存储再加每 128 维一个 4 字节的 ue8m0 缩放因子,就是第五、八篇里反复出现的 656 字节/token/层这个数。78 层合计约 50 KB/token,1M 上下文就是约 50GB 量级的主 KV。这份缓存的作用是:稀疏 MLA 在 Top-K 选出的 2048 个位置上,把每个位置的潜在向量直接乘进 W_UK / W_UV 的吸收矩阵,得到 K 和 V。
索引器缓存里存的是什么
索引器不读主 KV。它要判断”这个 key 和当前 query 有多相关”,用的是一份更小、更便宜的向量。GLM-5.3 的 glm_moe_dsa 配置里,索引器是 32 个头、每头 128 维(index_n_heads=32、index_head_dim=128),但所有头共享同一份 key:每个 token 在每层只存一个 128 维向量,外加按 128 维一块划分的 4 字节缩放因子。这个向量先经过 k_norm(LayerNorm)和只作用于前 64 维的 RoPE,再被量化成 FP8,落进索引器缓存。
于是索引器缓存的物理单元是 132 字节/token/层:128 字节的 FP8 向量加 4 字节 ue8m0 缩放。SGLang 的 DSATokenToKVPool 在构造时把这一点写死在一个断言里:
# num head == 1 and head dim == 128 for index_k in DSAassert index_head_dim == 128...self.buffer = [ torch.zeros( self._buffer_shape(self._layer_num_pages(i, num_pages)), dtype=pool.index_k_with_scale_buffer_dtype, # torch.uint8 ...而 _buffer_shape() 给出的每页宽度是:
pool.page_size // pool.index_kpool* (pool.index_head_dim + pool.index_head_dim // pool.quant_block_size * 4)quant_block_size 取 128,index_head_dim 取 128,所以括号里是 。这是一行字节级的账:每页每 token 132 字节,页大小 64(CUDA 路径下的断言是 page_size == 64),所以每页 64 × 132 = 8448 字节。
对比主 KV:每 token 每层 656 字节对索引器缓存的 132 字节,前者约是后者的五倍。这也解释了为什么直觉上”索引器缓存很小、不用管”——单看存储确实如此。但在 decode 的长上下文里,瓶颈往往不是”存了多少”,而是”每个新 token 要读多少”。
为什么两份缓存不能合并
最自然的省钱思路是:既然主 KV 也是 MLA 的潜在向量,索引器的 K 能不能直接从主 KV 里算出来?框架给出的答案是不行,原因有三条:
- 量化格式不同。 主 KV 的 656 字节口径包含 FP8 主体加上每块缩放,但索引器 K 的量化粒度、缩放格式和块划分都按它自己的 kernel 约定(
ue8m0、128 维块)。两个 kernel 期望的内存布局并不一致。 - 数值空间不同。 索引器 Q/K 在部分后端上会在进入 MQA logits 之前做 Hadamard 旋转(
rotate_activation),主 KV 的潜在向量不做。若从主 KV 现场转换,就得每层每 token 重算一遍归一化、RoPE 和量化——这正是索引器缓存的写入成本本身,省不掉。 - 共享层根本不需要它。 对 57 个
shared层来说,索引器缓存从来没被读过;从主 KV 推导只会平白多一份写入。SGLang 干脆让共享层的缓存分配成空。
第三条是本文的关键,值得单独展开。
谁来写这份缓存:GLM-5.3 的 indexer_types
配置里的 78 个字符
GLM-5.3 的 config.json 里有一条被很多人忽略的字段:
"indexer_types": ["full", "full", "full", "shared", "shared", "shared", "full", ...]它的长度正好等于 num_hidden_layers=78,前 14 项与后文的规律完全对得上:第 1、2、3 层是 full,第 4–6 层是 shared,第 7 层 full,第 8–10 层 shared……整个序列是”前 3 层全量,之后每 4 层里只让每 4 层的第一层做全量”。按这个规律数下去,78 层里 21 个 full、57 个 shared。
相邻的还有两个相关字段:index_topk=2048、index_topk_freq=4、index_skip_topk_offset=3。GLM-5.3 的 index_topk_pattern 是 null,所以如果只看 index_topk_freq 和 index_skip_topk_offset,得到的规律就是 max(layer_id - 3 + 1, 0) % 4 != 0,也就是从第 3 层起每 4 层跳 3 层。这跟 indexer_types 的序列是一致的:第 1、2 层不跳(因为 max(layer_id-2,0)=0),第 3 层起按频率分组。两套字段是同一规则的两种写法,前者是显式名单,后者是参数化的简写。 推理框架对这两套写法都做了兼容,SGLang 的 dsa_layer_skips_topk() 按优先级依次查:
indexer_types = getattr(config, "indexer_types", None)if indexer_types is not None: return 0 <= layer_id < len(indexer_types) and indexer_types[layer_id] == "shared"# LongCat computes fresh top-k indices every cli_factor layers.cli_factor = getattr(config, "cli_factor", 1)if cli_factor > 1: return layer_id % cli_factor != 0pattern = getattr(config, "index_topk_pattern", None)if pattern is not None: return layer_id < len(pattern) and pattern[layer_id] == "S"freq = getattr(config, "index_topk_freq", 1)...return max(layer_id - 1, 0) % freq != 0看这段代码要注意最后一行的 -1 对齐问题:在没有 index_skip_topk_offset 时,默认规则是 max(layer_id - 1, 0) % freq != 0,也就是从第 1 层开始数;对 GLM-5.3 来说真正生效的是 indexer_types 分支,所以这个偏移差异不会影响它,但对只带 index_topk_freq 的模型(比如某些 30B 级早期 DSA 模型)就会造成一层错位。vLLM 的实现则默认 index_skip_topk_offset = 2:
skip_topk = ( max(layer_id - index_skip_topk_offset + 1, 0) % index_topk_freq != 0)这个默认值意味着:第 0、1 层(max(layer_id-1, 0)=0)总是全量,第 2 层跳过,之后每 4 层跳 3 层。与 GLM-5.3 的显式名单相比,两者的边界并不一样:vLLM 这段默认值让第 0、1 层全量、第 2 层跳过,而 GLM-5.3 的 indexer_types 让第 0、1、2 层都是 full、第 3 层才开始跳。所以对只带 index_topk_freq 的模型,SGLang 与 vLLM 的默认对齐偏移(index_skip_topk_offset)必须显式写进 config,否则两个框架下发的 full/shared 名单会对不齐。 GLM-5.3 带全了显式名单与偏移,所以两边一致;但要注意 vLLM 的 DeepseekV32Attention 只读 index_topk_pattern,不读 indexer_types,而 GLM-5.3 的 index_topk_pattern 是 null——这意味着 vLLM 实际按的是参数化规则。对 GLM-5.3 的 profile 时,应在启动日志里核对每个 layer 的 skip_topk 判定,别默认两个框架名单相同。
这一节的关键结论是:哪些层写缓存、哪些层拿到空壳,完全由这个 78 字符的名单决定。
空壳:skip_topk_layers 与 0 行缓冲
SGLang 的 DSATokenToKVPool 在构造时接收 skip_topk_layers 列表,在分配 IndexKeyCache 时按层决定页数:
def _layer_num_pages(self, layer_idx: int, num_pages: int) -> int: # Layers that reuse the previous layer's top-k never write index-K, so # they get a 0-row placeholder that keeps ``buffer`` layer-aligned. return 0 if self.pool.skip_topk_layers[layer_idx] else num_pages注意它没有跳过这个列表元素,而是放了一个 torch.zeros((0, width))——零行张量。这样做的原因写在注释里:保持 buffer 列表与层号对齐。下游代码拿 buffer[layer_id] 取缓存时不需要判断列表元素是否存在,只要保证没人去读它即可。谁来保证?
写入侧有两道门:
def _fused_k_prepare_and_store(...): ... if hasattr(pool, "invalidate_index_buffer_for_layer"): pool.invalidate_index_buffer_for_layer(layer_id) if hasattr(pool, "_is_layer_owned") and not pool._is_layer_owned(layer_id): return_store_index_k_cache() 有同样的两道门。也就是说,full 层进来写,shared 层即使误入函数也会在第二行直接返回。第一道 invalidate_index_buffer_for_layer() 用来在写入前把这一层的缓存标记失效——在层分裂或 CP 场景下,旧数据可能不再是这个层该有的形状,需要先让读路径跳过它。
vLLM 侧写得更直接:shared 层根本不创建 indexer 对象。DeepseekV32Attention.__init__ 里:
indexer = Noneif not skip_topk or is_mtp_layer: indexer = type(self).indexer_cls(...)indexer 为 None 时,后续 if self.indexer is not None and not self.skip_topk: 的分支全部不进入,于是 shared 层的索引器缓存对象压根不存在。这也解释了为什么 vLLM 中的 GLM-5.3 能省下那 57 层 Indexer 的显存:虽然缓存本身只有 132 字节/token/层,但索引器 Q 投影(wq_b)、K 合并权重、归一化层和打分临时缓冲加起来在 744B 的模型规模上并非小数。
模型侧的另一道门:should_run_indexer
光在缓存分配上省还不够,前向路径里也得保证共享层不调用索引器。SGLang 的 forward_mla.py 里有一个显式函数:
def should_run_indexer(self, prev_topk_indices=None) -> bool: return not self.skip_topk or (self.is_nextn and prev_topk_indices is None)注释写得很清楚:skip_topk(共享)层不在 checkpoint 里带索引器权重,所以它们必须复用继承来的 topk,绝不运行自己的索引器。后面的 else 分支就是:
topk_indices = maybe_capture_indexer_topk(self.layer_id, prev_topk_indices)零拷贝:这里并没有把上一层的 topk 复制一份到本层的缓冲里,而是把这个张量送进本层对应的槽位。这个动作只对 maybe_capture_indexer_topk 有意义——它服务于 CUDA Graph 捕获期间按层登记 topk 的统计/调试用途。普通推理路径里,稀疏 MLA 直接从共享的 topk 张量读。
写一笔,读多少:一次 decode step 的细账
一次前向里 topk 只算一遍
模型层按层序执行:第 个 full 层计算一次 topk 并写进 IndexTopKShareState._topk_indices;紧接着的 个 shared 层通过 should_run_indexer() 返回 False,从 prev_topk_indices 拿到同一个张量。到下一个 full 层,update() 覆盖它,如此循环。
所以一次 decode step 里,索引器打分一共只算 21 次,topk 也一共只选 21 次。这一点与第八篇的”复用省掉了打分 GEMM 与 Top-K 选择”对得上,但要注意它的另一半:这 21 次打分每一次都要读完整段上下文的索引器 K。
读的字节数
设上下文长度为 。一次 full 层打分需要把它的索引器 K 缓存从第 0 个 token 读到第 个 token,每 token 132 字节,每层合计
21 个 full 层合计
一次 decode step 读一条请求,就是这么多。举几个具体数:
- (10 万 token):单层 13.2MB,21 层合计 277MB;换成 MiB 是单层 12.6MiB、合计 264MiB;
- (100 万 token):单层 132MB,21 层合计 2.77GB。
第八篇给的是”1M 上下文时每层约 132MB 的索引器缓存”,那是存储量;上面这笔是一次读的字节数。数字恰好相同只是因为 decode 时一条请求要把整段上下文读一遍。混淆这两个概念是讨论索引器缓存时最常见的错误:存储量决定它能装多少请求,读取量决定每条请求每步要花多少带宽。
读的带宽
以 H200 的单卡约 4.8 TB/s、H100 的约 3.35 TB/s 为例, 的那笔读取(按完整 21 层计)在单卡上理论耗时约 0.06ms(H200)和 0.08ms(H100)。比起第八篇里算出的每卡每步约 69GB 量级的权重读取,这笔开销确实不是瓶颈。
但当上下文变长、batch 被迫缩小时,账就变了。用第八篇的简化模型,设每步解码 条请求,每条上下文 :
把权重读取摊薄到不计(或者两者都在 HBM 上),两者的比值是
是每步要读的权重字节数。对 744B 的 GLM-5.3,在 TP8 + EP8 的部署下,每张卡只保留 的注意力层参数与 的专家参数,粗算每卡每步读权重在 字节量级——这里的分母是 8,不是“注意力层再按 TP 切、专家再按 EP 切”的 64。如果同时开启了注意力 DP(每卡只处理一部分请求),单卡的权重读取不会因此下降,只是被更少的请求分摊。、 时索引器读取是 8.7GB,占比约 12%; 被迫降到 4、 时读取是 11.1GB,占比升到约 16%。这个估算只算到量级:它忽略了 MLA 的 Top-K 主 KV 读取(也随 线性,但按选中的 2048 个位置而非 )、TP 通信、FP8 scale 的额外因子,因此不该被当作”索引器读取占比”的精确值。它能说明的是:索引器读取是 decode 账本里最容易被低估的一笔小账,在长上下文、小 batch 的极端场景下占比会明显上升。
IndexCache 论文在 30B DSA 模型上的实测数据可以当作这个趋势的侧面印证:200K 上下文时,DSA 的单请求 decode 58 tok/s,索引器复用 1/4 后到 86 tok/s,是 1.48×;而在 10K 上下文时只有 73.5 → 91 的 1.24×。长上下文下收益更大,恰恰说明索引器打分与索引器读取在长上下文时是同一块带宽上的两个消费者——复用削减的是 compute 侧,但每次 full 层的读取量并没有变,收益的上限就是”22 个 full 层降到 12 个 full 层”所带来的那部分。
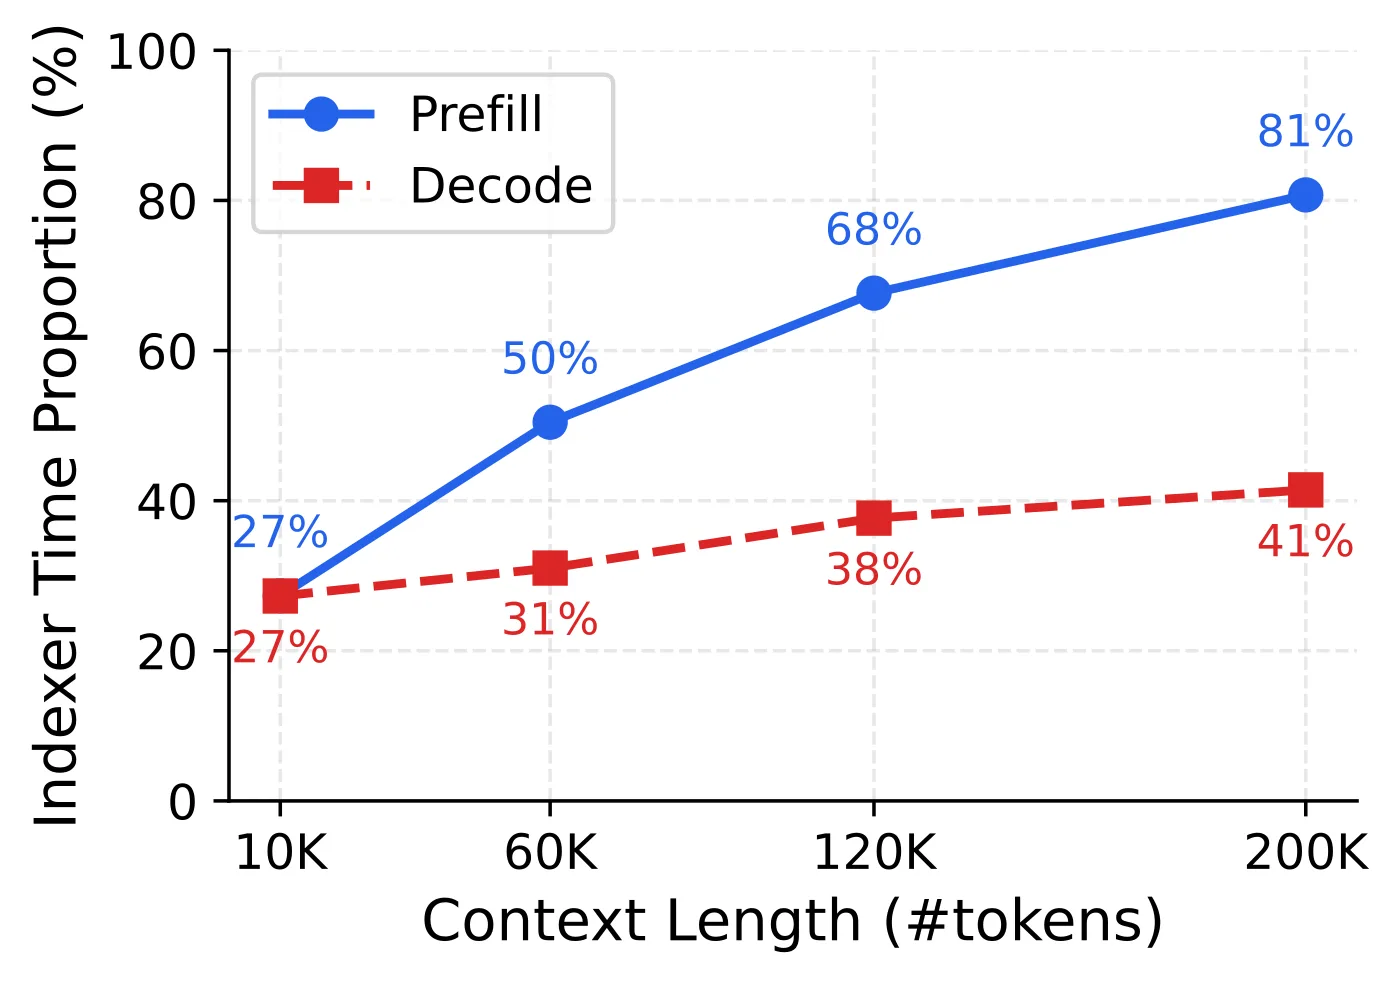
图源:IndexCache 论文(arXiv:2603.12201)
写一笔的字节数。一次 decode step,每个 full 层要为当前批里的每个新 token 写一份 K。一条请求每步只新增 1 个 token,所以一条请求每步写 字节,相当于读取量的 。这就是 decode 的特点:写便宜、读昂贵。prefill 则相反,一个 chunk 里的 个 token 全部要写:每层写 字节,21 层合计 ;这跟第八篇里”KV 写入随 chunk 长度线性增长”是同一个结构,只是把 656 字节换成了 132 字节。
临时缓冲:logits 矩阵
除了缓存本身,索引器还有一个常被忽略的分配:fp32 logits 矩阵。_get_topk_paged() 里,对每条请求的每个 query 行,score 要覆盖整段上下文,所以 logits 的形状是 [query 行数, max_seq_len],每个元素 4 字节。mqa_logits_utils.py 的第一段注释说得很直白:
The indexer scores every query row against every key column into one fp32 logits matrix that no pool sized by mem_fraction_static accounts for.
SGLang 为此设了三档预算:静态预算按显存总量 30% 上限封顶,并进一步按 1 - mem_fraction_static 后的可用显存乘一个比例(SGLANG_DSA_MQA_LOGITS_FREE_MEM_FRACTION)取更小者;实际运行时再按当前 mem_get_info() 的空闲显存封一次;元素数低于 8M 的矩阵不检查预算也不切块。超过预算时,按 query 行切块(mqa_logits_rows_per_chunk()):
def mqa_logits_rows_per_chunk(*, num_rows, row_bytes, budget_bytes): if num_rows * row_bytes <= budget_bytes: return None rows = max(budget_bytes // max(row_bytes, 1), 1) return int(rows) if rows < num_rows else Nonerow_bytes 按 256 列对齐(MQA_LOGITS_ROW_ALIGN_ELEMS = 256),因为 DeepGEMM 把 logits 的行跨度补齐到 1024 字节。这个对齐意味着: 和 的请求占用同样的 1024 字节/行; 时则是 8192 字节/行。 对长上下文,这一项是:
以 batch 32、 为例,约 12.8MB; 时约 128MB。它不是缓存的一部分,也不是每层独立的,而是每层计算时临时分配的。在 CUDA Graph 捕获路径下,它占用的字节数被固化在 mqa_logits_static_budget_bytes() 里,所以调小 mem_fraction_static 不一定会给 KV 池多出空间,反而可能让 logits 预算变小,进而让 kernel 切块、增加启动次数。 这是长上下文服务常见的隐性瓶颈。
SGLang 为这条路径做的四项优化
优化一:按页分块打分
索引器的 K 缓存是分页的。_get_topk_paged() 固定要求 CUDA 下 page_size == 64:
elif _is_xpu: assert page_size in (64, 128)else: assert page_size == 64, "only support page size 64"理由与主 KV 的页粒度来源不同:主 KV 的页大小是调度、前缀缓存、碎片之间的折中(参见站内 KV Cache 的页粒度:128 token 一块的账,以及五个推理框架为什么选了五个不同答案);索引器的页大小却由 kernel 决定——paged_mqa_logits 这类 FMHA 风格 kernel 期望 64 个 token 一块,块内一次读满 64 × 132 = 8448 字节。DSATokenToKVPool 为此专门加了断言:page_size % index_kpool == 0,并令 index_page_size = page_size // index_kpool。
按页分块读还有一个带宽上的好处:64 个 token 一块,连续访问的字节数是 8448,既满足 coalesced load 对 transaction 粒度(32/128 字节)的要求,又不会把页内数据切得过碎。如果按 token 单读,128 字节的 FP8 向量加 4 字节 scale,每次读就要拆出对齐缺口。
这一项优化的是读取的”形状”,而不是读取的”总量”。 它不减少字节数,只让相同字节数的读取更高效。这也是为什么”按页分块”不能回答本文开头那个问题:它不能让索引器读取的字节数随上下文变长而停止增长。
优化二:短上下文直接跳过打分
_should_skip_logits_computation() 是针对读取量的优化:
# topk_transform selects every valid page slot when kv_len <= index_topk;# logits are unnecessary in that case.当上下文不超过 index_topk=2048 时,Top-K 反正会选中全部有效位置,直接生成 [0, 1, ..., L-1, -1, ..., -1] 的索引就行,连 Q 投影、scores 都不需要算。注意它仍然要写 K:_forward_cuda_k_only() 的 assert 与注释写得很清楚——“Fast path: only compute and store k cache, skip all q and weights ops”。因为后续即使这一层不读,其他更长上下文的 full 层或 shared 层的索引器也可能读到它每个 full 层有自己独立的 K 缓存,所以在本层跳过打分不代表这层以后都不读:一旦上下文增长到超过 2048,它仍要拿出之前写入的 K 来打分。于是 K 必须照写,跳过打分省掉的是 Q 投影、weights 和 scores 矩阵这几块。实际实现里,decode 侧的 k-only 跳过注释写明”Eager k-only decode skip is validated on ROCm only”,CUDA 的 eager decode 路径不启用;prefill 路径(is_extend_without_speculative)则按 seq_lens_cpu.max() <= index_topk 判断,CUDA Graph 里用捕获时的 variant 决定。
这个优化把 时的索引器读取从”读 字节 + 算 个 score”压缩为”算 0 个 score”,但同时仍然写 K。对短请求它的收益最大;对长请求完全不起作用。
优化三:MTP 迭代内复用 topk
GLM-5.3 带一个 MTP 层,MTP 草稿在一步里要迭代多次(speculative-num-steps 等参数)。SGLang 的 IndexTopKShareState.mtp_iteration() 是一个上下文管理器:
@contextmanagerdef mtp_iteration(cls, forward_batch, enabled=True, keep_carry_seed=False): if not enabled: yield None return spec_info = forward_batch.spec_info forward_batch.reuse_dsa_topk_indices = True if not (keep_carry_seed and spec_info.dsa_topk_indices is not None): spec_info.dsa_topk_indices = None try: yield cls.from_mtp_carry(forward_batch) finally: spec_info.dsa_topk_indices = None forward_batch.reuse_dsa_topk_indices = False开启时(reuse_dsa_topk_indices=True),from_mtp_carry() 从 spec_info.dsa_topk_indices 拿到上一阶段的 seed,_should_skip_logits_computation() 之外的各 full 层索引器会检查 should_publish。topk == 1 时才能开启,因为 top-k 大于 1 时 select_top_k_tokens 会重排行、让索引对不上。index_share_for_mtp_iteration 在 GLM-5.3 配置里为 true。
MTP 复用的收益与上下文有关,但不要把它算到 21 个 full 层上:MTP 草稿只过一层 MTP 层(deepseek_nextn.py 里的 self.decoder),这一层有自己的索引器与自己的 132 字节/token 缓存,每个草稿步读 。复用后 5 个草稿步只有第一步读,节省 ;相对主模型每步 的读取,这只是约 19% 的增量。它对草稿阶段的耗时有明显帮助,对整步 decode 的总读取量影响有限。 真正会因为草稿步数放大索引器读取的,是“草稿模型本身有多层、每层都跑索引器”的方案(例如独立的 EAGLE draft 模型);那种情况下要按草稿模型的层数把 单独记一笔。
dsa_seed_topk_width 用的是 get_dsa_mtp_topk_width(),即 index_topk + index_kpool - 1。GLM-5.3 的 index_kpool=1,所以 seed 宽度就是 2048。多出来的 0 个 tail slot 是给 kpool 模式留的;这个设计在多 token 验证的场景里很重要(第一篇和第九篇的混批都涉及),但对读取字节数的账本影响很小。
优化四:PD 分离下的 seed 传输
第八篇算过 PD 分离时索引器缓存跨节点传输:78 层 × 132 字节 + 21 层 × 132 字节,1M 上下文约 53.7GB 主 KV 加约 2.9GB 索引器缓存。索引器缓存的传输量只是主 KV 的约 5%,看起来不起眼,但在 PD 分离里它有一个不显眼的作用:把 decode 侧本应重算的索引器 topk 传过去,让 decode 不必从零完整打分。
具体实现体现在两个地方:一是 get_dsa_mtp_topk_width() 在解耦配置里被用作 seed 元数据维度(disaggregation/utils.py 的 get_dsa_seed_metadata_dim());二是 write_mtp_seed() 把被选 topk 行拷进 MTP 的 seed 缓冲。注意这里是一次真正的 copy_,不涉及索引器缓存的字节,只是 2048 个 int32(8KB/请求)。它不省带宽,省的是 decode 首步的打分;而打分本身又要读一遍 全部缓存。
所以 PD 分离下真正对缓存读取有帮助的,不是那个 seed,而是:如果 decode 实例能把索引器 K 缓存与主 KV 一起迁过去,decode 首步的打分只读本地内存而不是远端——这正是第四篇里 NIXL/RDMA 传输存在的意义。
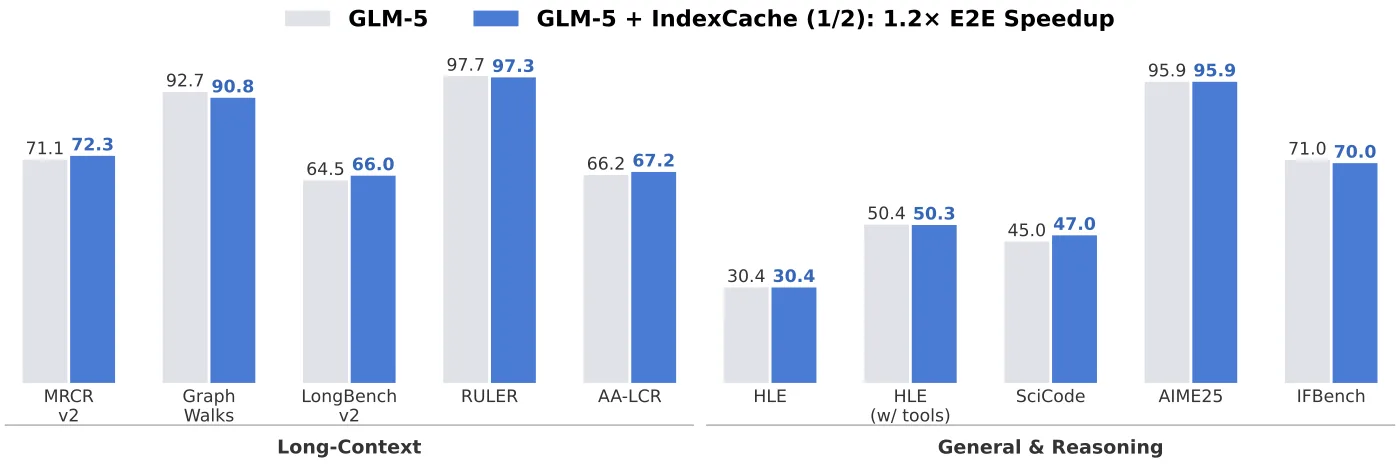
图源:IndexCache 论文(arXiv:2603.12201,Figure 1;GLM-5 即 GLM-5.3 同系列的 744B 生产级模型)
跨层共享为什么有效:从重叠率到缓存布局
相邻层的 topk 重叠率
IndexCache(arXiv:2603.12201,智谱与清华团队,2026 年 3 月)在 30B DSA 模型上测了 47 个层两两之间的 topk 重叠率:对每对层 计算 ,在 768 个 20 万 token 样本上取平均。结论是相邻层重叠 0.7–1.0,并且重叠随层距衰减的速度并不均匀——存在若干”块”,块内重叠高、块间突然下降;早期层与晚期层的重叠降到 0.4 以下。
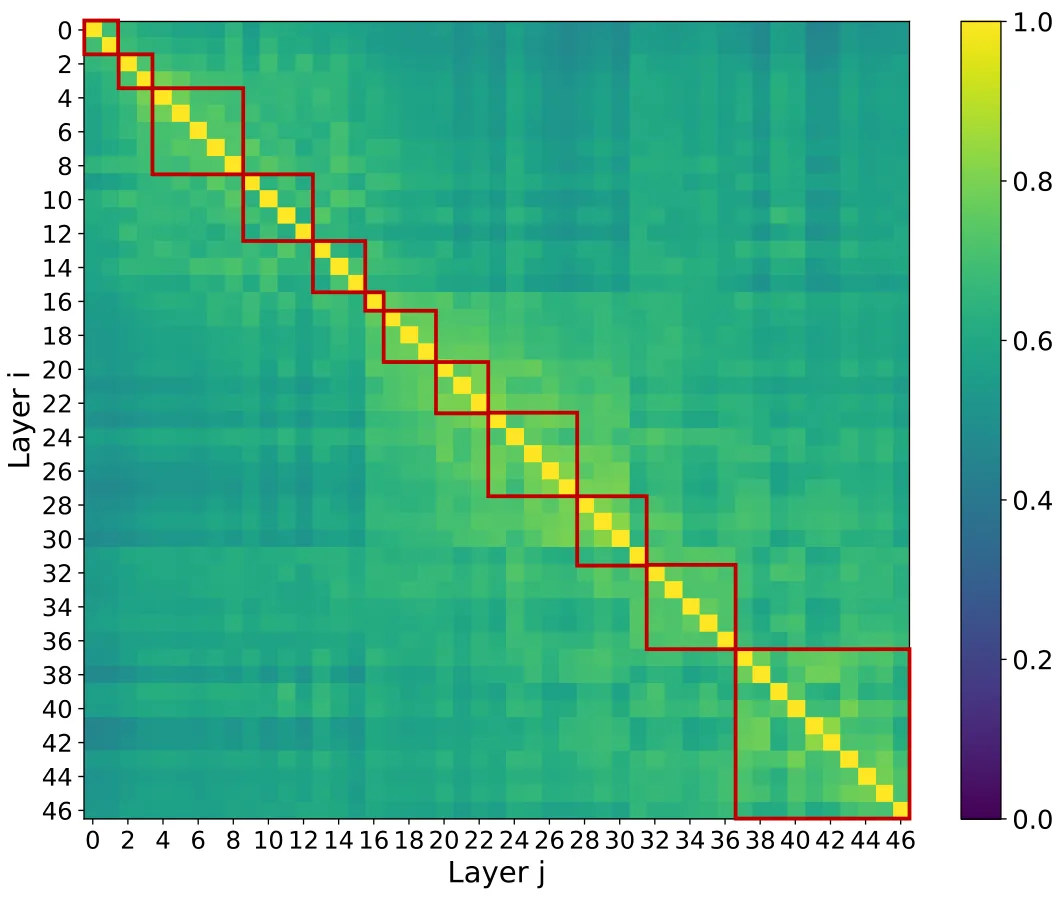
图源:IndexCache 论文(arXiv:2603.12201,Figure 4)
这张热图有两层含义:
- 重叠率解释了”为什么能共享”,但不能解释”怎么选共享块”。 论文在附录 A 和附录 C 里都承认了这一点:贪心搜索给出的共享块与视觉上明显的重叠簇并不重合,因为重叠率是聚合指标,它数”多少 token 相同”,不区分”哪些 token 不同”。被丢弃的那一小撮 token 一旦是关键的,hidden state 就会被扰动,并沿着最长的传播距离(早期层)放大。论文用相似度矩阵做最优布局的负结果(附录 C)进一步印证了这一点。
- 对缓存的直接含义。 共享层不写自己的缓存,但共享层的注意力仍然读主 KV。索引器缓存的省法止步于”哪些层不写”,而不触及”哪些层读什么”。所以缓存账里没有”跨层共享替下了读取”这一项——它替下的是 compute,以及 shared 层那个空壳缓存所省下的 132 字节/token/层的存储。
21 × 132 × L 的存储量与读量与模型规模无关吗
一个容易误读的地方:索引器缓存的写入量、读取量只与层数、上下文长度、单层 132 字节三个量有关,与模型参数量无关。GLM-5.3 是 744B,但它的索引器 K 仍然是每 token 132 字节——因为索引器每 token 每层只有一个 128 维向量,与 MLA 的 512+64 维潜在向量是两回事。这也是为什么 IndexCache 在 30B 上的字节账与在 744B 的 GLM-5 上完全同构:1/4 的复用率下,78 层(或不含 MTP 的 78 层)的读写字节公式不需要改任何一项。
真正随规模变化的是权重读取和主 KV。所以对小模型,索引器读取的占比更高、更显眼;对大模型,它在 decode 账本里相对被摊薄,但在 prefill 上它反而是主导项——第八篇与第三篇都给出了 1M prefill 里索引器读取约 47TB、打分约 94 PFLOP 的估算。这种”decode 占比小、prefill 占比大”的不对称是设计时要记住的:
- decode 优化索引器读取(MTP 复用、短上下文跳过)的收益与上下文、投机深度挂钩,但绝对值受权重账压制;
- prefill 优化索引器读取(跨层共享、分块预填)的收益与上下文长度平方挂钩,是 TTFT 曲线急剧上翘的主因。
一个反直觉的推论:改动 full 层名单会改变什么
这一节讨论一个缓存布局层面的可能性:indexer_types 的 78 字符名单可以被改。如果允许改变,会得到什么?
减少 full 层的数量,比如维持 1/8 复用(只保留 9–10 个 full 层),存储与读取都同比例下降;但 IndexCache 的实测说明这个代价在训练无关的场景里很明显:30B 模型 1/8 复用、未搜索模式时 Long Avg 从 50.2 掉到 35.3;使用贪心搜索模式后恢复到 46.1。所以”多砍几个 full 层”不免费。
增加 full 层的数量(全部 78 层都做全量),就是回到原始 DSA。存储 + 21 × 132L,读取 + 21 × 132L——但换来的是每层都能按自己的 query 精确选择。跨层共享是一种有信息损失的近似,与所有近似一样存在一个”什么时候不应近似”的边界。对短请求和小 batch(这时读取占比低),近似得不偿失;对长上下文、大 batch(读取占比高),共享的收益明显。
在 full 层之间重组(比如”每 4 层里保留第 4 层而不是第 1 层”)会改变读取的页数吗?不会。每个 full 层读整段 ,与它是序列里的第几层无关;_get_topk_paged() 传入的 block_tables 是本层的页表,不同 full 层各有一套。所以重排名单只影响质量与缓存总量,不影响单次读取的字节数。
把 full 层的结果共享到共享层,但不共享缓存本身。 IndexCache 被共享的是 topk 索引张量——每个 query 行 2048 个 int32,共 8KB——而不是 132 字节/token 的索引器 K 缓存。这一点必须说清楚,否则会误以为”共享之后 21 个 full 层可以合成一份缓存”。不行:每个 full 层的索引器 K 投影权重不同(wk_weights_proj 是独立参数),层 0 的 K 向量喂给层 6 的索引器,得到的是无意义的分数;只有”选哪些 token”这个离散结果可以跨层借用,因为它不再依赖某一层自己的 K。于是共享层不分配页、不写缓存、不读缓存,只拿 inherited 的 topk 去做自己的稀疏 MLA。
SGLang 的实现与 IndexCache 的思路同向:缓存分配用 skip 名单,读的是同一个物理池。_get_index_k_read_buffer(pool, layer_id) 只对 full 层有内容:
def _get_index_k_read_buffer(pool, layer_id): # Read path: prefer the owner-broadcast scratch buffer under DSA cache # layer split; fall back to the owned buffer for plain pools. Stores go # through get_index_k_with_scale_buffer() (owned buffer) instead. if hasattr(pool, "get_broadcastable_index_k_with_scale_buffer"): return pool.get_broadcastable_index_k_with_scale_buffer(layer_id) return pool.get_index_k_with_scale_buffer(layer_id=layer_id)读、写用两个不同的接口这一点很重要:写通过 owned buffer,读优先用 broadcastable buffer——这是 DSA cache layer split(缓存按层切到不同卡)场景下,一份缓存被多卡读取时的做法。这里”广播”不是每步真的拷一份,而是拿到一份只读视图。这是跨卡复用,不是跨层复用;但它也说明了一个工程趋势:共享层越多,缓存的”读-写分离”设计就越重要——写只在 21 个层发生,读可能跨 TP/DP 组发生。
还有一个不显眼的点:invalidate_index_buffer_for_layer(layer_id)。为什么要在写之前让缓存失效?在 CP/层分裂场景下,一个 full 层的缓存在某些 rank 上可能只被部分写入。失效标记让读路径(paged_mqa_logits 的 clean_logits、MTP seed 的 prepare_mtp_seed_indices)能识别”这次写入只覆盖了部分 slot”,从而走修补路径。这意味着:索引器缓存的写与读并非简单的”先写后读”,而是在层分裂和 CP 下带有正确性约束的读写协议。 对单个节点、单 TP 组,它不构成开销;对多卡、CP 和 PD 分离,它是必须显式处理的边界。
把账本用起来:四个可直接套用的判断
判断一:TTFT 随上下文上翘,先看是否 full 层过多
1M prefill 的索引器读取约 47TB、打分约 94 PFLOP(第八篇,按每层整段读取、每 token 每层 132 字节的简化口径估算)。若这份名单是 39 个 full 层而不是 21 个,两项都会接近翻倍。在排障 TTFT 之前,第一步应该打印 dsa_layer_skips_topk() 的判定结果,确认它真的走到了 indexer_types 分支——如果模型 config 里没有 indexer_types 字段,SGLang 会按 index_topk_freq 规则判断,默认 max(layer_id-1, 0) % freq != 0 会从第 1 层开始数,边界比显式名单偏移一层。这偏移一层的代价是少数几层的索引器多算/少算,对总账影响不大,但对前缀缓存命中或逐层对账时会出现”层号对不上”的困惑。
判断二:decode 单请求速度随上下文变长,先看索引器读取是否被 MTP 放大
关掉投机解码时,每条请求每步 21 次索引器读取。打开 EAGLE/MTP 后,每一步草稿(speculative-num-steps)都可能触发一次完整读取,除非开启了 index_share_for_mtp_iteration 且 topk == 1。若 GLM-5.3 部署中用 --speculative-eagle-topk 2 或更大,index_share_for_mtp_iteration 的共享会自动失效(eagle_worker_v2.py 里的 and self.topk == 1 门槛),于是索引器读取被乘以草稿步数。这时 decode 的瓶颈会从”权重读取”切换到”索引器读取”,表现为”与理论权重读取时间不相称的慢”。排查方式:在 SGLang 的 index_share_for_mtp_iteration 配置里核对 speculative_num_steps 与 topk 两个参数,并确认 eagle_worker_v2.py 中被置为 False 的路径。
判断三:显存不够用,先分清是 KV 池还是 logits 临时缓冲
mem_fraction_static 调低时,mqa_logits_static_budget_bytes() 按 (1 - mem_fraction_static) 计算可用显存再乘以默认比例(默认 0.2),所以调低它反而会让 logits 预算缩水(默认比例为 0.2,见 environ.py 里的 EnvFloat(0.2)),kernel 被迫按行切块。结果是显存看起来多了,但 prefill 的索引器 kernel 启动次数增加,TTFT 变差。正确的做法是把 SGLANG_DSA_MQA_LOGITS_FREE_MEM_FRACTION 单独调高,而不是改 mem_fraction_static。对 1M 上下文、batch 较大的 prefill,logits 矩阵本身(fp32,行对齐 256)就是百 MB 量级,不应被当成”零成本临时变量”。
判断四:索引器缓存的显存怎么估算
按当前名单和配置估算:
是 21(GLM-5.3), 是 KV 池总 token 容量。这个数与 无关——索引器缓存按 KV 池容量分配,不按单条请求上下文。所以按 KV 池容量算,1M 上下文能力(约 1M 个 token 槽位 × 每卡 的层分片,再乘上并发条数)对应的总量是几十 MB 到几百 MB 的规模,与权重和主 KV 相比不显眼。但如果把显存预算表里的索引器缓存漏算,在多卡分布式下每卡都漏算,PD 分离传 KV 的带宽预算也会算错——第八篇里 2.9GB 那个数就是按每条 1M 请求算的,而不是按 KV 池容量算的。
深入一层:读取量在哪些路径上被放大
前面四节的账在”单条请求、单步 decode、不投机”这个最简场景下成立。工程上真正决定索引器缓存开销的,是下面三条乘法关系。
乘法一:上下文长度 × full 层数
里, 是唯一随请求变化的项,也是唯一不受模型规模影响的项。这意味着同一个部署里,10K 的请求与 1M 的请求在做同一个 kernel、读同一份缓存,但字节数差 100 倍。因此索引器缓存的调优参数不应该按”平均上下文”来定,而应该按”最长的那一档”来定:页大小 64 是为了长上下文的读取效率,MTP 复用是为了长上下文的额外打分,索引器缓存的显存预算甚至要按 KV 池能装下的最长请求来估。
对多轮对话与 agent 工作流,这一点尤其要紧:一条请求的上下文每轮都在变长,索引器读取随轮数线性增长,而权重读取每步固定。第八篇里”decode 每 token 时间与上下文关系不大”的结论,在 DSA 模型上要加一句限定:主 KV 读取不随上下文增长(Top-2048),但索引器读取随上下文线性增长。两者叠加,长上下文的 DSA decode 曲线会比稠密 MLA 模型更”陡”。
乘法二:投机草稿步数 × full 层数
MTP 或 EAGLE 草稿阶段每一步都要跑完整模型。GLM-5.3 的第 79 层(MTP 层)在 SGLang 里是经 deepseek_nextn.py 的 self.decoder(...) 执行的,它同样接收 index_topk_share、同样会在自己的注意力层里决定是否跑索引器:
index_topk_share = IndexTopKShareState.from_mtp_carry(forward_batch)with get_global_expert_distribution_recorder().disable_this_region(): (hidden_states, topk_indices) = self.decoder( positions, hidden_states, forward_batch, zero_allocator, prev_topk_indices=index_topk_share.topk_indices, )...index_topk_share.update(topk_indices)index_topk_share.publish()MTP 层只有一层,它自己的索引器读一次整段上下文——开销比主模型 21 次小得多。真正放大读取量的是草稿迭代次数:speculative_num_steps=5 意味着这一步里 MTP 前向跑 5 次(外加目标验证一次),若每步都重新打分,读取量是 。主模型 decode 的 21 次不受草稿步数影响(目标模型每步只跑一次),但如果开的是 EAGLE 这类带独立 draft 模型的方案,草稿模型自身也有一套索引器缓存,那部分的开销要看草稿模型层数与上下文。
index_share_for_mtp_iteration 省掉的正是草稿迭代里的重复打分。它把第一步得到的 dsa_topk_indices 通过 spec_info 带进后续草稿步(IndexTopKShareState.mtp_iteration() 的 keep_carry_seed 分支就是为此设计的),使后续草稿步的 MTP 层不必再打自己的索引器。这也解释了 eagle_worker_v2.py 为何要求 topk == 1:topk 大于 1 时,select_top_k_tokens 会按 token 重排索引,跨步复用就对应不上位置了。
乘法三:层分片 × 卡数
TP8 部署里,每张卡只持有 的注意力层。索引器缓存的写入与读取都是按层分片的:卡 上的 start_layer..end_layer 范围内,full 层写自己的缓存、打自己的分,shared 层什么都不做。所以单卡每步的索引器读取量是
而不是 ( 是该卡上的 batch 大小)。这一条经常被忽略:估算单卡瓶颈时,分母里那个 TP 是真实存在的。 同样地,EP(专家并行)不切注意力层,所以它不改变索引器读取;DP Attention 会把不同请求分到不同 DP rank,每 rank 的 batch 变小,但每卡上的层数不变(若同时开了 TP)。
读取路径里的两条”非缓存”字节
索引器打分不只读缓存,还要读 Q、weights 和 block table:
- Q:每个 token 的行,形状
[tokens, 32, 128]的 FP8,外加每组 128 维度一个 ue8m0 缩放。一次 decode 每 token 为 KB——它是随 token 数而非上下文长度增长,对 时几乎可以忽略。 - Weights:
wq_b、wk_weights_proj(含 32 个 head gate)每步读取,与上下文无关。 - Block table:按页组织, 个 int32 项, 时约 6.4KB/请求。它在 metadata 的
get_page_table_64()里随 metadata 一起构造,通常进入 CUDA Graph 的捕获范围。
把这三项加上缓存读取:缓存读取是唯一随 线性增长的项,其余两项要么与 无关(weights、Q),要么增长极慢(block table)。这也是判断”是不是索引器缓存瓶颈”的信号:如果 decode 时间随 近似线性增长,而且斜率对得上 ,那瓶颈在索引器缓存读取;如果斜率明显偏大,就要查是否 MTP 复用没开、或是否因为页碎片导致读的页数多于 。
两个框架的对照:同一份缓存,不同的”空”与”镜像”
前面一直在 SGLang 侧看实现,这一节对照 vLLM,看同一个设计在另一套框架里是如何落成代码的。两边的共同点是:共享层不分配索引器缓存;差异在于”怎么表达这个不分配”。
| 维度 | SGLang | vLLM |
|---|---|---|
| 名单来源 | config.indexer_types → dsa_layer_skips_topk() 多级回退 | 直接判定 index_topk_freq/index_skip_topk_offset/index_topk_pattern(该版本 DeepseekV32Attention 不读 indexer_types) |
| 共享层的缓存 | IndexKeyCache 里分配 0 行的 torch.zeros((0, W)) 占位 | 不创建 indexer 对象,缓存对象不存在 |
| 共享层的前向 | 注意力层仍存在,should_run_indexer() 返回 False | 同样短路,但短路点是 indexer is None |
| topk 传递 | IndexTopKShareState(含 PP 跨 stage 传递) | 共享 topk_indices_buffer |
| MTP 复用 | index_share_for_mtp_iteration + mtp_iteration() 上下文管理器 | 走 sparse_attn_indexer 的 skip_k_cache_insert、skip_topk_buffer_clear 等参数 |
| 页大小 | CUDA 固定 64(ROCm 1 或 16 的倍数,XPU 64/128) | CUDA / ROCm 也是 64 或 1;Glm5NextIndexerBackend 放宽到基于 kv_cache_spec 判断 |
两个 SGLang 侧的细节值得记下,它们直接关系到调试:
- 0 行占位意味着
buffer[layer_id].shape == (0, 8448)。如果你在诊断脚本里遍历层时对每一层的缓存 tensor 做.max()或.numel(),共享层会返回 0 或报错。正确做法是先按skip_topk_layers过滤,或直接读_is_layer_owned()。 - PP 的跨 stage 约束:SGLang 的
deepseek_v2.py里有一个 assert,要求”PP stage 的起始层如果是 skip-topk 层,就必须从上一 stage 拿到 topk_indices”,否则报错。这条约束的原因很直白:流水并行把 78 层切到多个 stage,stage 边界正好落在 shared 层上时,那个 shared 层没有上一层的 topk 可用。所以切分时要保证每个 stage 的第一层是 full 层,否则框架会显式报错而不是静默给出错误结果。这是部署 GLM-5.3 用多机 PP 时最容易踩的坑之一——它通常表现在启动阶段而不是运行时,比较容易定位。
vLLM 侧也有一个类似但更细的点:sparse_attn_indexer 的 skip_k_cache_insert=not self.use_pcp。PCP(Prefill Context Parallel)打开时,K 缓存的写入由 gather 后的完整序列负责,因此各 rank 的索引器不写自己的缓存;没开 PCP 时则每 rank 各写自己那段。这意味着 PCP 与索引器缓存的写入量是耦合的:开 PCP 时写入集中在 gather 之后,读取则可能分布在各 rank。对长 prefill 的分块调度,这一条会影响写入带宽的峰值分布。
另外,vLLM 的 kv_cache_as_quant_view() 支持两种索引器缓存格式:FP8(head_dim 字节 + 4 字节 fp32 scale)与 MXFP4(head_dim/2 字节打包 + head_dim/block ue8m0 scale)。这意味着同一份索引器缓存可以有不同量化精度——MXFP4 把每 token 的字节数从 132 降到 128/2 + 128/32 = 68 字节。读取量随之减半。SGLang 的 DSATokenToKVPool 同样带 index_kpool_compress 选项(第 4620 行附近的 _init_kpool_compress_tail_buffers),但那是针对 index_kpool > 1 场景的页尾压缩,与 MXFP4 不是同一件事。两套框架都在探索”索引器缓存能不能再压”——但都绕不开一个前提:压缩会改变打分的数值,可能影响 Top-K 选择本身的正确性,而 Top-K 的微小扰动会经由稀疏 MLA 直接放大成输出差异。
一个具体的排障例:1M 上下文 decode 比预期慢
假设部署是 8×H200、TP8、EP8、DP Attention 8,--speculative-algorithm EAGLE、--speculative-num-steps 5、--speculative-eagle-topk 1,一条 1M 上下文请求 decode 实测 38 tok/s,而按权重读取估算的期望是 60 tok/s。按本文的账,可以从下面几处依次查:
第一步:算索引器读取的理论值。 单卡层分片后约 2.6 个 full 层,上下文 1M,索引器读取 ≈ MB/步。在 H200 的 4.8TB/s 下单卡约 0.07ms。与期望 decode 间隔(1/60s ≈ 16.7ms)相比,占不到 0.5%,不像是主因。再看验证前向:投机验证一次要对 个位置做 Top-K,索引器打分的 Q 行数放大 6 倍,但读的缓存字节数不变——同一个页只读一次。所以这一步本身只会让打分计算涨 6 倍,不会让读取涨 6 倍。如果斜率对不上这一条,就要去查第二、三步。
第二步:看 MTP 复用是否生效。 MTP 层不属于主模型 78 层,它只有一层,单步读 MB。若 index_share_for_mtp_iteration 生效,5 个草稿步合计只读约 132MB;若因 topk > 1 被关掉,则要读 5 次、约 660MB。两者都远小于主模型每步 343MB 的读取,所以这一步通常不会把 decode 拖慢一半;但它会把草稿阶段的打分计算放大 5 倍,对算力紧张的配置有影响。
第三步:看页碎片。 1M 上下文在 64 token 页下需要 16384 页。如果 KV 池碎片导致同一请求的页在物理上不连续,paged_mqa_logits 的读取会退化为按页随机访问——带宽利用率大幅下降。诊断方法是看 SGLang 的 KV 池利用率与 fragmentation 指标;若碎片率高,考虑用 HiCache 的多级方案或调整页大小。
第四步:看 logits 切块。 batch 32、 的 prefill 里,logits 矩阵是 = 128MB,在默认 0.2 比例下大概率超出预算,被按行切成数块。每一块都是一次独立的 kernel 启动,启动开销累加。这一项影响 TTFT 而非 decode TPOT,但在 decode 的验证步(target_verify)里,logits 同样要算:_get_topk_paged() 里 next_n >= 2 时会走 _chunked_fp8_paged_mqa_logits 或 native 路径,batch > SM 数时还会继续切块。
第五步:看 topk broadcast。 SGLANG_DSA_TOPK_BROADCAST 默认为 False。开启后,每次索引器出 topk 都做一次 P2P broadcast(_broadcast_indexer_topk_from_rank0_impl),目的写在代码注释里:只同步“最终确定”的索引器输出,因为各 rank 内部的 topk_transform 可能按不同的块切分,直接同步会让集合通信的调用序列在 rank 间错位。这本身不读缓存,但在 TP 下会引入同步点;对 decode 的尾延迟有影响。如果某卡因 batch 不足而 idle,broadcast 会把它的时间拉到最慢的 rank。
这五步的顺序很重要:从最大的一笔账开始查,而不是从”看起来最像缓存”的地方开始。索引器缓存读取在 1M decode 里往往只占 0.4%~1%,把它当成主因通常会白忙一场。
常见误解与纠正
误解一:共享层省掉了索引器缓存读取
纠正:共享层省掉的是它自己的写入与存储。它对索引器的读取需求本来就为零——共享层不需要 topk,因为它不用自己的索引器。所以”共享层不读索引器缓存”不是优化,是定义。真正读缓存的是 21 个 full 层,每一次读的都是整段上下文。
误解二:索引器缓存小,所以不用管
纠正:单看存储确实小(每 token 每层 132 字节,1M 上下文 21 层 2.77GB,仅占主 KV 的约 5%)。但在 prefill 里,它读的是同一块缓存 21 次;再加上打分本身的平方项,1M prefill 的索引器项占到了总耗时的一半以上(第三篇对 GLM-5.3 与第九篇对 SGLang PCP 的分析)。存储小、读取重是索引器缓存的典型特征。
误解三:翻倍 full 层数量就是翻倍开销
纠正:对读取,是的——每多一个 full 层,每步多读一整段上下文。对打分计算,也大致是线性的。但对质量,不是——跨层共享的质量损失不是线性增长的,IndexCache 的数据是”1/2 几乎无损、1/4 需搜索模式、1/8 明显退化”。所以”是否翻倍 full 层”不是带宽与质量的线性取舍,而是需要在质量允许的边界上找到最优比例。
误解四:MTP 复用在所有投机解码下都有效
纠正:只在 index_share_for_mtp_iteration=true 且 topk == 1 时有效。GLM-5.3 的默认 eagle-topk 是 1,但 --speculative-eagle-topk 5 这种”每步选 5 个候选”的配置会让复用失效。这也解释了为什么很多部署报告”索引器复用好像没起作用”:不是没作用,而是被配置悄悄关掉了。 日志里 index_share_for_mtp_iteration 不会被单独打出,需要配置核对或读源码。
局限与尚未解决的问题
- 跨层共享的质量边界在训练无关时很脆弱。 IndexCache 证明了搜索模式能在 30B 模型上把 1/8 的退化从 Long Avg 35.3 拉回 46.1,但这是”恢复了大部分”而不是”恢复了全部”。对 GLM-5.3 的 21/78 比例,质量损失是否在可接受区间,依赖模型本身的层间一致性——这是需要实际评测的,不能从计算账本推出来。
- 长上下文的页碎片与索引器读取的带宽关系缺乏定量研究。 本文给出了”页碎片会让读取退化”的定性判断,但碎片率与有效带宽之间的量化模型没有公开数据。
- 索引器缓存的量化与主 KV 量化的相互影响未完全展开。 若主 KV 走 FP8/NVFP4、索引器缓存走 FP8/MXFP4,两者的 scale 格式不同会影响 kernel 的读取效率;目前没有看到对这一组合的系统评测。
- 缓存压缩对 Top-K 正确性的影响,缺乏端到端评测。 68 字节对 132 字节的省法在单次 kernel 上成立,但 Top-K 选得对不对是另一回事。
小结
把这篇的结论按一条线串起来:
- 索引器缓存与主 KV 是两本账。 前者 132 字节/token/层,后者 656 字节/token/层;前者由 full 层写,后者所有层都读写。
- 写的人只有 21 个,读的人也主要只有 21 个。 78 层的
indexer_types名单里,21 个full层写缓存、也算 topk;57 个shared层拿到 0 行空壳,既不写也不读缓存,只复用 inherited topk 做稀疏 MLA。 - 省的是计算,不是这次读取的字节数。 共享层并不省”full 层对整段上下文的读取”,它省的是 shared 层原本要进行的打分与其自身的缓存存储。解码时,每步对每条请求的索引器读取量是 ( 是落在该卡上的 batch 大小) 字节,与共享与否无关。
- 优化的着力点按影响顺序排列: MTP 迭代内的 topk 复用(投机深度越大收益越大)> 短上下文跳过打分()> PD 分离的 seed 传输(省首步打分而非带宽)> 按页分块(提升读取效率、不减少总量)。
- logits 临时缓冲是长上下文 prefill 的隐性瓶颈。 它按 量级增长,按行切块会拉长 kernel 启动;调低
mem_fraction_static反而可能恶化它。
如果把这四本账(存储、单步读、单步写、临时缓冲)放进第八篇的时间线,decode 的索引器读取约占 10% 量级,prefill 的索引器读取约占索引器项的大头,PD 分离的迁移约占主 KV 传输量的 5%。这三个数都不大,但它们各自在不同的”边界条件”下会变大:长上下文 + 大 batch + 投机解码同时出现时,decode 账里索引器读取可以从 10% 跃升到 15% 以上;1M prefill 时索引器读取是 TTFT 曲线急剧上翘的主因;PD 分离把 KV 迁移做多卡时,5% 的传输量乘以 57GB 的主 KV 就不是小数。
下一层追问已经浮出:调度器在给定 KV 池容量下要同时给主 KV 和索引器缓存分页,这两份预算如何互不影响?RadixCache、HiCache 在不同推理框架里对索引器缓存采取了什么策略——它能不能参与前缀缓存命中,命中时如何跳过重算?以及当 indexer_types 从 1/4 再压缩(例如 GLM-5.3 这种 21/78 比例)时,IndexCache 论文在 GLM-5 上的贪心搜索名单和 SGLang 实际下发的名单是否一致。这些属于调度与缓存层的问题,可以留作后续单独的拆解。
参考资料
-
IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(arXiv:2603.12201)
-
DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(arXiv:2512.02556)
-
SGLang 源码:
python/sglang/srt/layers/attention/dsa/dsa_indexer.py -
SGLang 源码:
python/sglang/srt/layers/attention/index_topk_share.py -
SGLang 源码:
python/sglang/srt/layers/attention/mqa_logits_utils.py -
vLLM 源码:
vllm/models/deepseek_v32/attention.py补充几条定位到具体函数的源码入口,方便对照阅读: -
SGLang 源码:
python/sglang/srt/mem_cache/memory_pool.py(DSATokenToKVPool分配) -
SGLang 源码:
python/sglang/srt/models/deepseek_v2.py(index_topk_share的层间传递) -
SGLang 源码:
python/sglang/srt/configs/model_config.py(dsa_layer_skips_topk)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



