


GLM-5.3 推理全链路(六):token 跨卡的那一段——MoE dispatch/combine 的模式、缓冲与重叠
前五篇把账算清了,这一段还没打开
前五篇沿着一条请求的路径走完了入口、调度、prefill、PD 分离和 vLLM 的 prefill 切分。每一篇都会在某个位置写下一句相同的话:MoE 层要做一次 DeepEP 的 dispatch,专家算完再做一次 combine。账本也算过两遍——第二篇按 192 个验证行、8 个专家、75 个 MoE 层,得出一条 decode step 的 all-to-all 往返约 2.8GB;第三篇按 32K 的 prefill chunk 算出单层 1.6GB 的 dispatch。
但“dispatch 与 combine”一直被当成一个黑盒。它到底把哪些字节搬到哪里、为什么 decode 和 prefill 要用两套完全不同的模式、固定缓冲区的容量从哪来、超额了会怎样、以及框架到底用什么办法把这段通信藏进计算——这些问题不回答,“通信占 50%”就只是一个数字,没法指导部署参数。
这一篇专门打开这一段。对象仍然是 GLM-5.3:78 层、前 3 层稠密、后 75 层 MoE、每层 256 个路由专家加 1 个共享专家、每 token 选 8 个。部署形态取 SGLang cookbook 的单机吞吐配方:--tp 8 --ep-size 8 --attn-dp-size 8 --moe-a2a-backend deepep,也就是注意力按请求分片、专家按卡切分。代码以 SGLang 的 layers/moe/token_dispatcher/deepep.py、layers/moe/moe_runner/deep_gemm.py 与 batch_overlap/ 两条路径为准;DeepEP 本身则以它当前的 EPBuffer 接口和 legacy 接口为参照。
先把结论摆出来,后面逐条证明:
- 一次 MoE 前向的跨卡动作不是一次 all-to-all,而是四段:DP Attention 的 gather、专家 dispatch、专家 combine、DP Attention 的 reduce-scatter。前两段与后两段的方向相反,中间夹着两段 grouped GEMM;
- decode 与 prefill 用的是两套数据布局:decode 走固定容量的 masked 布局,prefill 走变长的 contiguous 布局。这不是实现口味,而是由“batch 大小是否可预知”和“能否进 CUDA Graph”决定的;
- 低延迟模式的代价是缓冲区容量:
num_max_dispatch_tokens_per_rank在启动时就要定死,超过它直接报错,不会自动扩容; - 重叠有三层:combine 与第二个 GEMM 用信号量重叠(SBO),两个子 batch 交替执行(TBO),以及 DP Attention 的 gather/scatter 与 MoE 通信在层间的自然交错。三层各有各的适用边界,TBO 在 decode batch 小于 64 时甚至会变慢。
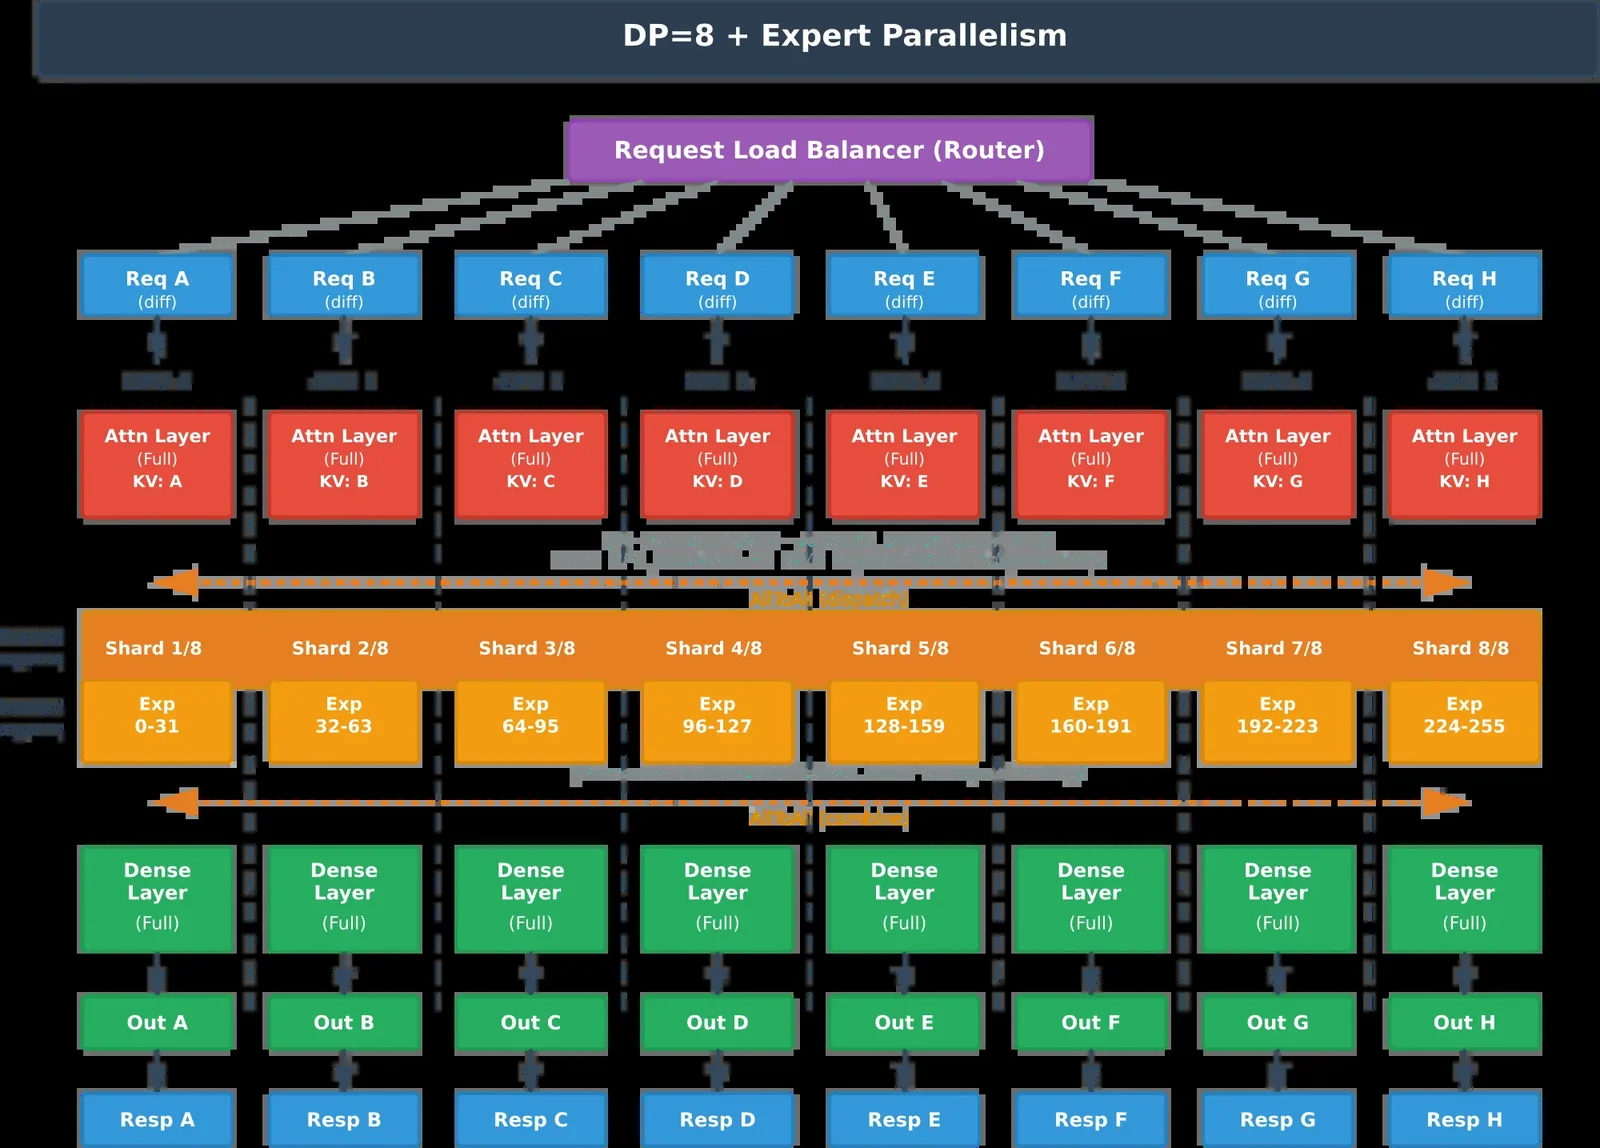
四段通信,不是一段
先把这个容易混淆的地方定下来。在 --attn-dp-size 8 且 attn_tp_size = 1 的配置里,一次 decode step 的跨卡顺序是:
- DP gather:每张卡只持有分给自己的请求的 KV 与 hidden,MoE 却要在全局 batch 上按专家路由,所以先把 8 张卡的 hidden 拼成一份全局 batch;
- dispatch:按路由结果,把全局 batch 里每个 token 复制 8 份,发到持有对应专家的 rank;
- combine:专家算完,把 8 份部分和按原路送回,并在发送端按路由权重求和;
- DP reduce-scatter:全局输出按请求归属散回各卡,同时完成跨 rank 的求和。
这四段里,只有第 2、3 段是“按专家”的 all-to-all;第 1、4 段是“按请求分片”的集合通信。把它们混成一句“MoE 要 all-to-all”,会导致一个常见的估算错误:把 DP gather 的字节也算进专家通信,或者忘了 combine 之后还有一次 reduce-scatter。
两条 gather 路径,取决于注意力有没有做 TP
layers/dp_attention.py 里的 _dp_gather_via_all_gather 把这件事写得很直白:
def _dp_gather_via_all_gather(global_tokens, local_tokens, forward_batch, is_partial): use_world = world_dp_gather_enabled()
if get_parallel().attn_tp_size == 1: if use_world: all_gather_single(global_tokens, local_tokens, group=torch.distributed.group.WORLD) else: get_parallel().tp_group.all_gather_into_tensor(global_tokens, local_tokens) return
if not is_partial: if get_parallel().attn_tp_rank != 0: local_tokens.fill_(0) scattered_local_tokens = local_tokens.tensor_split(get_parallel().attn_tp_size)[ get_parallel().attn_tp_rank ] get_parallel().attn_tp_group.reduce_scatter_tensor(scattered_local_tokens, local_tokens) ... get_parallel().tp_group.all_gather_into_tensor(global_tokens, scattered_local_tokens)分支的含义值得展开:
attn_tp_size == 1时,每张卡持有完整的注意力权重,同一批请求的 hidden 只在一张卡上,gather 就是一次纯AllGather,消息量等于全局 batch 的 hidden 字节数;attn_tp_size > 1时,同一批请求的 hidden 被切在注意力 TP 组的几张卡上,每张卡只有部分和。这时不能直接 gather,必须先ReduceScatter把部分和按行归约并散开,再做一次AllGather把完整的行拼起来。也就是说,同样的“拼全局 batch”,后者要多付一次归约。
这就是为什么 GLM-5.3 的吞吐配方更愿意用 --attn-dp-size 8 把 attn_tp_size 压到 1:注意力权重只有十几 B,复制 8 份不心疼;MoE 权重 724B,必须切开。让“轻”的注意力复制、让“重”的 MoE 切分,正好把两者的通信需求对齐——注意力不需要跨卡,MoE 才需要。
对 decode 来说,这条路径的字节数很小: 条请求、每条 6 个验证 token、hidden 6144、BF16,一次 gather 是 字节。 时约 2.36MB,scatter 同理。真正的量在专家那两段。
变长 gather 为什么进不了 decode
SGLANG_DP_USE_GATHERV 允许把各 rank 不等长的 token 直接按实际长度拼起来,省掉 pad 到最大长度的浪费。但代码里写死了它的适用条件:
def is_dp_gatherv_active() -> bool: return ( _USE_DP_GATHERV and not world_dp_gather_enabled() and get_parallel().attn_tp_size == 1 and get_parallel().tp_size == get_parallel().attn_dp_size and not _DpGatheredBufferWrapper.is_dp_max_padding() )注释里还有一句更关键:这条路径只在 SUM_LEN 的 padding 模式下成立,而“decode-only 的 step 与 CUDA Graph 捕获永远不会选择 SUM_LEN”。原因不难推:CUDA Graph 要求每次重放的形状固定,而 gatherv 的输出形状等于各 rank 实际 token 数之和,随 batch 变化。decode 的 batch 组成每一步都在变,只能用固定形状的 MAX_LEN 模式,把每个 rank pad 到相同的最大长度。padding 出来的零行必须在 MoE 里被屏蔽,否则会被路由到专家、既浪费带宽又改变负载分布——这就是后面 expected_m 与 masked_m 要处理的事。
路由结果如何变成一张发送清单
dispatch 不是“把 hidden 广播出去再让专家自己挑”。在真正搬字节之前,先要算出一张清单:每个 rank 会收到多少 token、每个专家会收到多少 token、某个 token 是否属于某个 rank。SGLang 的普通模式直接调用 DeepEP 的 get_dispatch_layout 完成这一步:
( num_tokens_per_rank, num_tokens_per_rdma_rank, num_tokens_per_expert, is_token_in_rank, previous_event,) = buffer.get_dispatch_layout( topk_ids, self.num_experts, previous_event=previous_event, async_finish=self.async_finish, allocate_on_comm_stream=previous_event is not None,)四个输出各有用途:
num_tokens_per_rank:每个目标 rank 应收到多少行,接收端据此分配输出缓冲;num_tokens_per_rdma_rank:跨节点时每个 RDMA rank 的量,用于决定 NVLink 段与 RDMA 段各发多少;num_tokens_per_expert:每个专家收到多少行,直接决定后面 grouped GEMM 的分组长度;is_token_in_rank:形状为 的布尔矩阵,标记某个 token 是否要发往某个 rank。
这张清单是后面所有账本的基础。它也解释了为什么 dispatch 之前要做一次全卡可见的路由:topk_ids 是每张卡对自己的 token 算出来的,但“某个 rank 要收多少”必须所有 rank 一致,否则接收缓冲会对不上。
紧接着的一个细节是量化。GLM-5.3 的专家权重是 FP8,DeepGEMM 路径要求激活也按 128 一组量化后再发:
if deep_gemm_wrapper.ENABLE_JIT_DEEPGEMM and self.use_fp8: hidden_states = sglang_per_token_group_quant_fp8( hidden_states, 128, column_major_scales=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_tma_aligned=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_ue8m0=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, )逐行看这段量化:
sglang_per_token_group_quant_fp8(hidden_states, 128, ...)把每一行按 128 个元素一组切成 48 组,每组独立求最大值并映射到 E4M3 的 [−448, 448] 区间,输出 6144 个 FP8 字节加上 48 个 scale。分组而不是逐行,是因为 LLM 的激活在 128 维的块内分布远比整行平稳,逐行量化一个离群值会拖垮整行的精度;column_major_scales=True让 scale 按列主序存放,形状是[scale 组数, 行数]而不是[行数, 组数]。DeepGEMM 的 grouped GEMM 在遍历专家时,同一个专家的行是连续的,但不同专家的 scale 需要按“组优先”读取,列主序正好让同一组的 48 个 scale 相邻,TMA 一次搬运就能取到一段;scale_tma_aligned与scale_ue8m0是 Blackwell 路径的开关:scale 的内存起始地址要按 TMA 的对齐要求补齐,scale 的数值要转成 UE8M0(只存 8 位指数、尾数固定为 1)。
为什么要三种标志一起开?因为它们服务于同一个目标:让 scale 也能被 TMA 直接搬运进 Tensor Core 的 MMA 指令。BF16 路径下,scale 要在 kernel 里逐元素乘回结果,这条路径只能走传统的逐元素指令;FP8 + UE8M0 + TMA 对齐时,scale 作为 MMA 描述符的一部分被硬件消费,反量化被并入矩阵乘本身。这正是 FP8 MoE 在 Blackwell 上比 Hopper 快出一截的原因——不只是 MMA 本身变快,而是反量化的开销从 kernel 里消失了。
对 dispatch 的字节账,这段量化有两层影响。第一层是负载减半:6144 维 BF16 的一行是 12KB,FP8 是 6KB。第二层是 scale 的额外开销,但它不是白发的——如果没有 scale,专家收到 FP8 的 hidden 就无法还原原始幅度,GEMM 的结果会整体偏小或偏大。48 个 FP32 scale 是 192 字节,占负载的 3%;如果按 UE8M0 以 8 位打包存储,48 个 scale 只要 48 字节,占比降到 0.8%。
把“先量化再发送”和“收到后再量化”放一起比较,差别不只是带宽:前者在发送端做一次,48 个 scale 随行发出;后者要在每个接收 rank 上对已经搬过来的 BF16 再做一次量化,不仅多一趟 2 倍字节的搬运,还会在每个 rank 上重复同样的量化计算。对 8 个 rank 的 EP 组,后者相当于把量化做了 8 遍。
清单与量化都准备好之后,才进入真正的 dispatch。而“真正搬”的方式,取决于选的是哪种模式。
两种模式:一张兼容性表背后的设计
DeepEP 提供两类内核,SGLang 用 DeepEPMode 枚举把它们暴露成三个选项:
class DeepEPMode(Enum): NORMAL = "normal" LOW_LATENCY = "low_latency" AUTO = "auto"
def enable_normal(self) -> bool: return self in [DeepEPMode.NORMAL, DeepEPMode.AUTO]
def enable_low_latency(self) -> bool: return self in [DeepEPMode.LOW_LATENCY, DeepEPMode.AUTO]
def resolve(self, is_extend_in_batch: bool) -> DeepEPMode: if self != DeepEPMode.AUTO: return self if is_extend_in_batch: return DeepEPMode.NORMAL else: return DeepEPMode.LOW_LATENCYAUTO 不是“自动调优”,而是一个按 forward 模式二选一的开关:这一步里有 prefill(is_extend_in_batch)就走普通模式,纯 decode 就走低延迟模式。它解决的正是同一个部署里 prefill 与 decode 对通信的需求完全相反的问题。
SGLang 团队在 2025 年 5 月那篇 96 卡部署 DeepSeek 的博客里给过一张兼容性表,把两类内核的边界列得很清楚:
| 模式 | 长输入(prefill) | 长输出(decode) | DP Attention | CUDA Graph |
|---|---|---|---|---|
| Normal | 支持 | 不支持 | 支持 | 不支持 |
| Low-Latency | 不支持 | 支持 | 支持 | 支持 |
| Auto | 支持 | 支持 | 不支持 | 支持 |
这张表要横着读:
- 普通模式适合 prefill。prefill 一次几千到几万个 token,每层的发送量是 MB 级,带宽是瓶颈;它用 SM 参与数据搬运,按专家连续布局输出,正好喂给 contiguous 的 grouped GEMM。但它的接收形状随 token 数变化,进不了 CUDA Graph,也不适合 decode 那种每步只有几百行的场景——延迟会被 kernel 启动和 CPU 同步吃掉;
- 低延迟模式适合 decode。它预分配固定大小的缓冲,用 NVSHMEM 做单边写,接收形状固定为
[本地专家数, 容量, hidden],可以进 CUDA Graph;代价是容量必须提前定死,且长输入会超出容量; - Auto 与 DP Attention 不兼容,原因不是软件 bug,而是同一个通信组不能在 prefill 与 decode 之间反复切换缓冲布局。切换时要
clean_low_latency_buffer,把整个低延迟缓冲清空重建,这在同一个 step 里同时有 prefill 和 decode 时无法安全完成。
PD 分离正好解开了这个死结:prefill 实例只跑普通模式,decode 实例只跑低延迟模式,两个实例各自有独立的通信组,不需要在同一个组里切换。这也是第四篇里 PD 分离对 GLM-5.3 的真正价值之一——不只是把两个阶段的 GPU 利用率分开,还让通信模式可以各自最优。
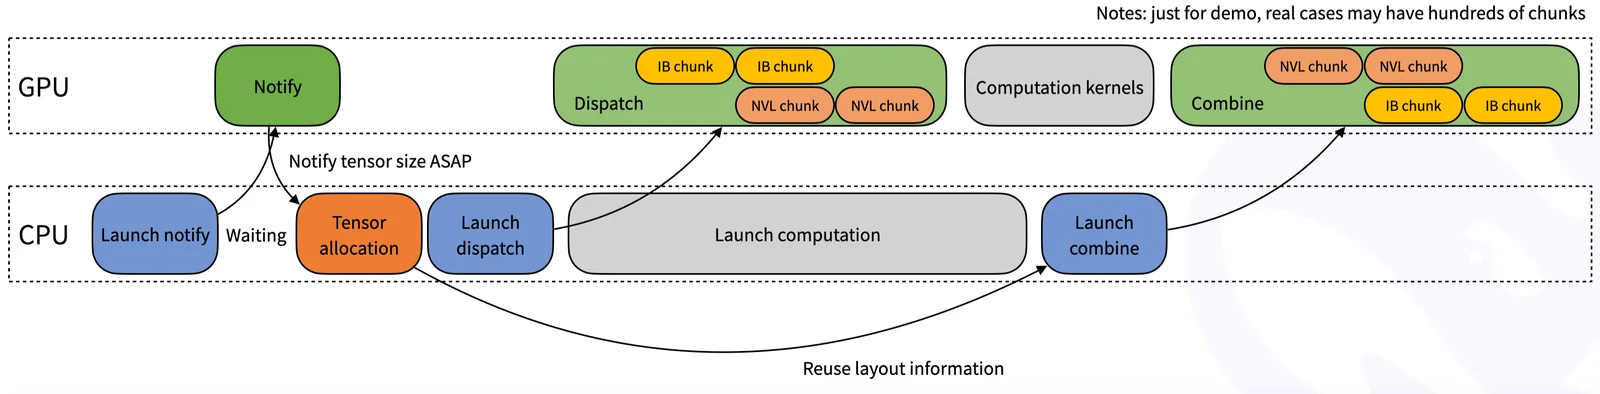
普通模式:按 SM 分片的高吞吐内核
普通模式的资源账在 DeepEPBuffer.get_deepep_buffer 里:
if deepep_mode.enable_normal(): hidden_bytes = hidden_size * param_bytes for config in ( DeepEPConfig.get_instance().normal_dispatch_config or Buffer.get_dispatch_config(group.size()), DeepEPConfig.get_instance().normal_combine_config or Buffer.get_combine_config(group.size()), ): num_nvl_bytes = max(config.get_nvl_buffer_size_hint(hidden_bytes, group.size()), num_nvl_bytes) num_rdma_bytes = max(config.get_rdma_buffer_size_hint(hidden_bytes, group.size()), num_rdma_bytes)几个常量值得注意:
param_bytes取 2,也就是按 BF16 估缓冲;即使 dispatch 实际发的是 FP8,缓冲仍按 BF16 留余量。这不是浪费,而是为了让同一个 buffer 在 FP8 与 BF16 两条路径下都能用;- 普通模式每个 rank 的 QP 数等于
num_sms,通信内核会按 SM 切分通道,每个 SM 负责一段 token 的转发; expert_alignment=128在 dispatch 调用里显式传入:DeepGEMM 的 contiguous grouped GEMM 要求每个专家的 token 段按 128 对齐,DeepEP 在接收端直接把每个专家的段补齐到 128 的倍数,省掉框架侧再做一次对齐拷贝。
代价是普通模式需要 CPU 同步来获得精确的接收形状。DeepEP 的 EPBuffer 文档里写得很明确:do_cpu_sync=True 用于训练和 prefill,能拿到精确的输出大小与 CPU 侧专家计数;decode 要设成 False,输出按配置容量分配,专家 GEMM 用 handle.psum_num_recv_tokens_per_expert 识别有效区间。GLM-5.3 的 prefill 走普通模式,正是前者。
contiguous 布局:prefill 为什么不需要 mask
普通模式接收端的布局与低延迟模式相反:不是“每个专家一段固定容量”,而是“按专家把 token 连续排成一条长行”。DeepEP 在接收时按目标专家排序,把所有属于专家 的 token 放在一起,再给出一张前缀和索引表 m_indices,标记每个专家在长行里的起始位置。
这种布局对 grouped GEMM 非常友好。GEMM 只需要读 m_indices 就知道第 组从哪一行开始、到哪一行结束,直接按组循环,不需要额外的 mask 张量,也不需要为无效行分配空间。prefill 的 token 多、每专家行数差异大,这种“按实际行数分配”的布局能把显存利用率拉满;而 decode 的 batch 小、形状每步变,长行的长度也跟着变,没法进 CUDA Graph——这正是普通模式不适合 decode 的根本原因。
代价是接收形状依赖 CPU 同步。get_dispatch_layout 算出每 rank、每专家的行数后,接收端才能分配输出;这一步需要把计数从 GPU 取回 CPU,再做一次分配。对 prefill 的 32K chunk,这个同步只发生一次,摊到几万个 token 上可以忽略;对 decode 的 192 行,同样的同步每层都要做一次,乘以 75 层就是不可接受的开销。普通模式与低延迟模式的分野,归根到底是“同步一次摊给多少 token”。
prefill 的字节账也因此不同。32K chunk、每 token 8 个专家、FP8 激活,每层的 dispatch 是 ,与第三篇的表一致;combine 是 BF16,翻倍到 3.2GB。这个量级下,dispatch 是纯带宽问题,SM 分片与 NVLink/RDMA 的通道数决定一切,延迟反而次要。
低延迟模式:固定容量、masked 布局
低延迟模式的缓冲计算完全是另一套:
if deepep_mode.enable_low_latency(): assert num_max_dispatch_tokens_per_rank != -1 assert num_experts != -1 and num_experts % group.size() == 0 if not _is_npu: _set_nvshmem_qp_depth(num_max_dispatch_tokens_per_rank) num_rdma_bytes = max( Buffer.get_low_latency_rdma_size_hint( num_max_dispatch_tokens_per_rank, hidden_size, group.size(), num_experts, ), num_rdma_bytes, )这段启动逻辑用两个 assert 与一次 QP 深度设置划出了适用边界:
- 容量必须给定,不能是 -1;
- 专家数必须能被 EP 组大小整除——每个 rank 的本地专家数相同,缓冲才能按
num_local_experts等分; - QP 深度随容量线性增长,
_set_nvshmem_qp_depth在启动时一次性设好。
QP 数的选择也不同。普通模式每 rank 的 QP 数等于 SM 数,低延迟模式则等于本地专家数:
if deepep_mode == DeepEPMode.NORMAL: num_qps_per_rank = DeepEPConfig.get_instance().num_smselif deepep_mode == DeepEPMode.LOW_LATENCY: num_qps_per_rank = num_experts // group.size()框架按本地专家数配置 QP,意图是让每个专家有独立的接收队列,收到即处理,不需要像普通模式那样按 SM 分片再聚合。对 GLM-5.3 的 EP8,本地专家 32 个,QP 就是 32;如果改成 EP16,本地专家 16 个,QP 也降到 16。但 QP 按“专家”配置并不等于流量按专家均分:一个热门专家会收到远多于平均的 token,它背后的那条 QP 就成了瓶颈。这是 EP 变大时更容易被放大的问题——本地专家越少,单个专家承担的流量份额越大。
还有一个容易被忽略的上限:
# DeepEP internode_ll dispatch uses FINISHED_SUM_TAG=1024# and the logic requires num-tokens-sent-from-one-rank-to-another-rank less than itassert self.num_max_dispatch_tokens_per_rank <= 1024这个 1024 不是随便定的,而是低延迟内核用一个固定的 sentinel tag 来判断“某个 rank 的 token 发完了”。如果单 rank 一次发的 token 超过 1024,计数会撞上 sentinel,接收端会提前认为发送结束。框架用 assert 把它挡在启动阶段,而不是等运行到一半出现数据错位。
对 GLM-5.3 来说,这条上限意味着 decode 的批不能无限加。每条请求 6 个验证 token,而一行 token 最多会被复制到 8 个专家所在的 rank;如果路由把多个专家集中到同一个远端 rank,单 rank 对单 rank 的发送量就是行数的数倍。1024 的容量按最坏情况折算,能容纳的请求远少于 170 条;DeepEP 文档给出的经验值是 decode 批不超过 256。要服务更大的并发放,只能加 DP rank 把请求摊开,或者降低投机验证的 token 数。
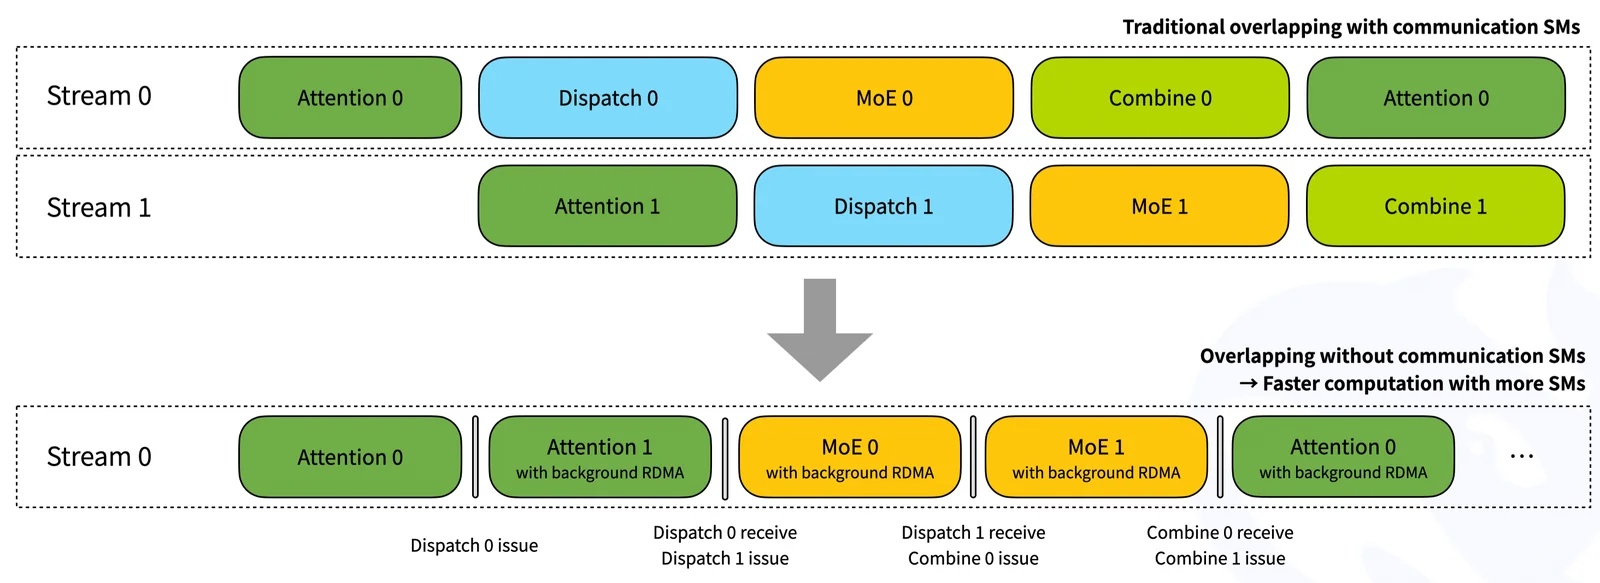
masked 布局:为什么 decode 的 GEMM 不是按行算的
低延迟模式的输出布局是理解 decode MoE 的关键。普通模式输出的是“按专家连续排列”的一维行集合,长度等于接收到的 token 总数,随 batch 变化;低延迟模式输出的是一个三维张量:
其中 num_max_tokens 就是 num_max_dispatch_tokens_per_rank。每个本地专家固定分到一段,段内前 masked_m[e] 行有效,其余是未定义数据。这样形状完全静态,CUDA Graph 才能捕获。
框架在 dispatch 之后拿到三个东西:hidden_states(三维)、masked_m(每个专家的有效行数)、expected_m(GEMM 的期望行数)。expected_m 的公式在 dispatch_a 里:
expected_m = ( hidden_states.shape[0] * buffer.group_size * topk_ids.shape[1] + self.num_experts) // self.num_experts把它写成数学形式。设本地行数为 (即全局 batch 的 token 数),EP 组大小为 ,每 token 选 个专家,全局专家数为 。分子是“所有 rank 一共会产生多少个 (token, expert) 对”,加上 是为了向上取整;分母 把它摊到每个专家上:
对 GLM-5.3、EP8、、、:
也就是平均每个专家 48 行;加 1 是为了在整除时也留出一行余量,结果 49。这个值不是精确的每专家行数,而是给 GEMM 选 tile 用的“期望 M”:DeepGEMM 的 masked grouped GEMM 会按 expected_m 选择 block 大小与并行粒度,再用 masked_m 逐专家屏蔽超出部分。真实分布由路由决定,热点专家可能收到 100 行,冷门专家 0 行;expected_m 只是一个平均基准,避免为最坏情况分配过大的 tile。
这也解释了 masked GEMM 的两个阶段。layers/moe/moe_runner/deep_gemm.py 的 _run_masked_gemm 里,第一段是 gate/up 投影:
num_groups, m, k = hidden_states.shapen = w13_weight.size(1)gateup_output = torch.empty((num_groups, m, n), device=hidden_states_device, dtype=torch.bfloat16)deep_gemm_wrapper.grouped_gemm_nt_f8f8bf16_masked( (hidden_states, hidden_states_scale), (w13_weight, w13_scale), gateup_output, masked_m, expected_m, recipe_a=recipe_a, recipe_b=recipe_b,)第二段在 SiLU 与乘 gate 之后,再对 down 投影做一次同样的 masked GEMM。注意中间激活函数也不是逐元素跑一遍:_varlen_deep_gemm_silu_mul_quant 在同一个 kernel 里完成 SiLU、逐元素乘、按 128 分组量化,输出直接是下一段 GEMM 要的 FP8 激活与 scale。三件事合成一个 kernel,省掉两次全量读写。
对 GLM-5.3 的单层 MoE,第二段 GEMM 的输出形状是 :32 个本地专家、每段最多 1024 行、输出 6144 维。即使实际只有 192 行有效,这个张量也要按满容量分配——固定布局的代价就是显存按最坏情况预留。1024 行的上限、6144 的宽度、BF16 输出,单个这样的张量是 32 × 1024 × 6144 × 2 = 402MB。SGLang 在分配失败时会打印一条很具体的错误:
Masked grouped-GEMM workspace allocation failed (num_groups=... m=... n=...).If this happens under saturated dp-attention prefill, try SGLANG_OPT_DG_MASKED_M_CAP=1.这条日志本身就是证据:masked 布局的显存开销与容量成正比,容量取大了,decode 还没开始就把显存吃光。num_max_dispatch_tokens_per_rank 因此不是“越大越安全”,而是要在并发、显存与 1024 上限之间取一个平衡。
combine 的语义:谁做加法,加法在哪做
dispatch 把 token 复制成 8 份,combine 要把 8 份部分和变回 1 份。这个“变回”包含两件事:按路由权重加权,以及跨 rank 求和。两件事发生在不同位置,混淆会导致对精度和带宽的误判。
在 SGLang 的路径里,加权发生在专家计算这一侧:每个专家算完自己的输出后,用该 token 对该专家的路由权重乘上去,再把结果交给 combine。combine 只负责把同一 token 的 8 份加权结果相加。DeepEP 的文档把这一点写得很清楚:combine 的输入必须是 BF16,recv_topk_weights 是展开成一维的、每行一个权重,专家计算在 combine 之前应用路由权重,combine 对供给的专家输出求和。
为什么加权要放在专家侧而不是 combine 侧?因为权重是 per-(token, expert) 的,而 combine 的接收端只看到“同一 token 的 8 份输出”,如果在那里加权,需要把 8 个权重也一起传回来——多一份 8 倍的小张量通信,还要在接收端做一次索引匹配。放在专家侧,权重在 dispatch 时已经随 token 一起发过去了,专家算完直接乘,combine 只做纯加法。
这也带来一个精度细节:combine 的输入是 BF16,8 份部分和相加。对 FP8 专家权重、BF16 激活的 GLM-5.3,单个专家的输出已经是 BF16,8 份相加的舍入误差在 量级,与注意力的 FP8 KV 误差同阶。如果再把 combine 也压到 FP8,误差会累加到 ,这也是为什么 combine 始终保持 BF16 而不跟着 dispatch 一起量化。
combine 之后为什么还有一次 reduce-scatter
combine 完成后,每个 rank 拿到的是“全局 batch 里属于自己专家的那部分 token 的输出”,但每个 token 的 8 份已经在 combine 里加过了,所以输出是按 token 的完整向量。问题在于:这些 token 属于哪些请求?在 DP Attention 下,token 的归属是分散的——每张卡只负责自己那批请求的注意力与 KV,combine 的输出却是全局 batch 的顺序。必须再做一次 reduce_scatter,把全局输出按请求归属散回各卡。
dp_reduce_scatter_tensor 的实现与 gather 对称:
if get_parallel().tp_size == get_parallel().attn_dp_size: get_parallel().tp_group.reduce_scatter_tensor(output, input)else: scattered_local_tokens = input.tensor_split(get_parallel().tp_size)[ get_parallel().tp_rank ] get_parallel().tp_group.reduce_scatter_tensor(scattered_local_tokens, input)第一分支对应 attn_tp_size == 1:直接对全局输出做 ReduceScatter,每张卡拿到自己那段。第二分支对应注意力也做了 TP:先把全局输出按 tp_rank 切出一段,再在注意力 TP 组内做 ReduceScatter,最后还要按 CP 组恢复。
这条路径的存在意味着:DP Attention 下的 MoE 层,跨卡字节数是 gather + dispatch + combine + reduce_scatter 四项之和,而不是两项。以 、6 个验证 token 为例:
| 阶段 | 每次字节(全部 rank 合计) | 说明 |
|---|---|---|
| DP gather | 2.36MB | 192 行 × 6144 × 2B |
| dispatch(FP8) | 9.44MB/层 | 192 × 8 份 × 6144B |
| combine(BF16) | 18.9MB/层 | 192 × 8 份 × 12288B |
| DP reduce-scatter | 2.36MB | 192 行 × 6144 × 2B |
dispatch 与 combine 要乘 75 层,gather/scatter 也要乘 78 层。按这个表,单步的 MoE 跨卡总量约 。
第二篇按 vLLM 的 TP+EP 拓扑(不开 DP Attention)算出 3.55GB,两者并不矛盾,逐项对账就能对上:把这里的 368MB gather/scatter 换成 644MB 的层首与注意力出口 AllReduce,加上 59.5MB 的 LM Head logits gather,再把 dispatch 从 FP8 的 0.71GB 换回 BF16 的 1.42GB,总数回到约 3.55GB。同一组模型常量、同一批 token,拓扑与精度口径一变,账本就会差出 1GB 量级——这也是为什么通信数字必须连同部署形态一起报。
重叠的第一层:让 combine 和第二个 GEMM 同时跑
账本只能说明“有多少字节”,说明不了“这些字节有没有被藏起来”。decode 的通信之所以能占到 50% 而不把延迟拖垮,靠的是重叠。SGLang 里最细的一层叫 SBO(single batch overlap),它把 combine 的发送与 down 投影的 GEMM 放在两个 stream 上同时执行。
batch_overlap/single_batch_overlap.py 里的参数结构是这一层的全部契约:
@dataclassclass CombineOverlapArgs: # this "overlap" flag means overlapping with down gemm, not the general two-stream overlap overlap: bool stream: torch.cuda.Stream wait_event: torch.cuda.Event num_sms: Optional[int] = None signal: Optional[torch.Tensor] = None block_m: Optional[int] = 64 threshold: Optional[int] = 0每个字段都有明确分工:
stream是 combine 通信所在的旁路 stream,wait_event让它在 down GEMM 开始后才启动;num_sms给通信内核留出的 SM 数。代码里默认值是 Hopper 3 个、Blackwell 32 个:communicate_num_sms = 32 if is_blackwell() else 3compute_num_sms = total_num_sms - communicate_num_smssignal是一块按“专家 × block”粒度分配的计数器,down GEMM 每完成一个 block 就把它对应的计数加一;block_m与threshold决定“GEMM 推进到什么程度才允许 combine 发下一段”:block_m是 signal 的计数粒度,Hopper 上不小于 64;threshold是开始发送的门槛。
通信之所以能等 GEMM,是因为 combine 的发送对象是“已经算完的专家输出”。down GEMM 按 block_m 分块产出,每产出一块,combine 就可以把这块对应的行发走,而不必等整个 GEMM 结束。Hopper 路径下 threshold 取计算 SM 数,表示当累计完成的 block 数达到计算 SM 数时开始发送——这是一个经验值,既保证发送不会早到没有数据,又保证通信不会晚到成为尾巴。
共享专家为什么值得单独一条 stream
GLM-5.3 每层有 1 个共享专家,它对所有 token 都激活,不参与路由。这意味着共享专家的 GEMM 可以在 dispatch 之前就开始算,或者在 combine 期间继续算——它不需要等任何跨卡结果。SGLang 把这件事拆成了三个互斥的开关(batch_overlap/single_batch_overlap.py):
@classmethoddef enable_combine_shared_two_stream_overlap(cls): return ( is_sbo_enabled() and not cls.enable_dispatch_shared_one_stream_overlap() and not envs.SGLANG_BLACKWELL_OVERLAP_SHARED_EXPERTS_OUTSIDE_SBO.get() )
@classmethoddef enable_dispatch_shared_one_stream_overlap(cls): return is_sbo_enabled() and not is_blackwell()
@classmethoddef fuse_shared_experts_inside_sbo(cls): return ( cls.enable_combine_shared_two_stream_overlap() or cls.enable_dispatch_shared_one_stream_overlap() )三条的分工是:
- Hopper 上走“共享专家与 dispatch 单 stream 重叠”:dispatch 把 token 发走的同时,共享专家在本卡上算。共享专家只读本卡权重与本地 hidden,不依赖任何跨卡结果,因此可以和 dispatch 的通信窗口安全重合;
- Blackwell 上走“共享专家与 combine 双 stream 重叠”:共享专家被放到 combine 所在的旁路 stream 上,与主 stream 的 reduce-scatter、下一层前准备同时推进;
- 如果部署者用
SGLANG_BLACKWELL_OVERLAP_SHARED_EXPERTS_OUTSIDE_SBO把共享专家移出 SBO,两条都不成立,共享专家退回串行执行。
fuse_shared_experts_inside_sbo 决定共享专家是否被融进 MoE 模块的调度里。GLM-5.3 的 GlmMoeDsaForCausalLM 把 fused_shared_experts_architecture 设成自己的类名,正是为了让共享专家走这条融合路径。对一个 75 层、每层共享专家 37.75M 参数的模型,共享专家的 GEMM 单层约 14.5 GFLOP(6144→2048→6144 的两段矩阵,按 192 行算),相比路由专家的 8 份计算量小一个量级,但它与 dispatch/combine 的时间窗高度重合;把它塞进同一条流水,省下的是每层几微秒的串行尾巴。
这套机制在 GLM-5.3 上的收益取决于 down GEMM 的长度。单层 down 投影在每张卡上是 个有效行( 个 token-expert 对摊到 8 个 rank),计算量约 GFLOP;按单卡 FP8 有效算力 500 TFLOPS 估,约 10 微秒。combine 每卡 2.36MB,NVLink 900GB/s 下带宽时间约 2.6 微秒,实际受延迟影响通常更长。两者量级相当,重叠能把这一层的尾延迟压掉几微秒——单看一层不多,乘 75 层就是几百微秒。
但 SBO 不是无条件的。SboFlags 里写了两条限制:
@classmethoddef enable_combine_down_gemm_two_stream_overlap(cls): return ( is_sbo_enabled() and ( get_moe_runner_backend().is_flashinfer_cutedsl() or (get_moe_runner_backend().is_deep_gemm() and not is_blackwell()) ) )也就是说,DeepGEMM 后端在 Blackwell 上默认关掉“combine 与 down GEMM 的重叠”,只有 FlashInfer 的 cutedsl 后端支持。SGLang 的 layers/moe/utils.py 里还有一条更直接的拦截:在 SM90 上启用 SBO 会直接抛错,提示当前 sgl-deep-gemm wheel 不支持。这类限制不是文档里的“建议”,而是启动即失败的硬约束——部署时看到 --enable-single-batch-overlap 起不来,先查 GPU 架构与 MoE 后端,而不是查模型。
重叠的第二层:两个子 batch 交替
SBO 重叠的是“同一层内 combine 与 down GEMM”。如果整层的通信量更大、单靠层内重叠盖不住,就需要 TBO(two batch overlap):把一个 batch 切成两个子 batch,让子 batch A 的注意力与子 batch B 的 MoE 通信同时进行,反之亦然。
实现上最直观的证据是 dispatcher 的数量:
class MaybeTboDeepEPDispatcher(BaseDispatcher): def __init__(self, runner_backend=None, **kwargs): super().__init__() num_inner_dispatchers = 2 if is_tbo_enabled() else 1 ... self._inners = [ DeepEPDispatcher(runner_backend=runner_backend, **kwargs) for _ in range(num_inner_dispatchers) ]
def _execute(self, name, tbo_subbatch_index: Optional[int] = None, **kwargs): return getattr(self._inners[tbo_subbatch_index or 0], name)(**kwargs)两个 DeepEPDispatcher 实例,各自持有一份 handle 与 src2dst。这不是为了并发调用同一个通信组,而是因为两个子 batch 的 dispatch 与 combine 必须能独立追踪:子 batch A 的 combine 还没结束时,子 batch B 的 dispatch 不能覆盖 A 的 handle。
切分点由 compute_split_seq_index 决定,_is_two_chunk_split_enabled 负责判断“这条 batch 值不值得切”:
vanilla_split_seq_index = _split_array_by_balanced_sum(extend_lens)left_sum = sum(extend_lens[:vanilla_split_seq_index])overall_sum = sum(extend_lens)threshold = get_tbo_token_distribution_threshold()assert threshold <= 0.5want_two_chunk = left_sum < overall_sum * threshold or left_sum > overall_sum * (1 - threshold)默认阈值是 0.48。它的含义是:如果按“尽量均分”切出来的左半部分 token 数落在总量的 48% 以外(即严重不均),就改用“按序列边界切”的方式,让两个子 batch 的 token 数接近一半。阈值取 0.48 而不是 0.5,是为了给边界情况留一点余量,避免恰好 50/50 时反复摇摆。
对 decode 来说,extend_lens 不是 token 数,而是每条请求的行数——每条请求 6 个验证 token,所以两个子 batch 各有 行左右。这带出一个重要约束:TBO 在 DP Attention 下需要所有 rank 一致。TboDPAttentionPreparer 用一次全局 all-gather 收集各 rank 的 can_run_tbo,再取最小值:
local_can_run_tbo_aggregated = min(partial_global_info_cpu[:, 0].tolist())只要有一个 rank 不能切(比如它这一步混入了 prefill),整个 DP 组就都不能切。原因很直接:TBO 改变了每一步前向的 token 顺序与 KV 槽位映射,如果某些 rank 按两个子 batch 跑、另一些按一个 batch 跑,DP gather 拼出来的全局 batch 顺序就对不上。
TBO 不是免费的:三个边界
SGLang 博客给出的实测数字,把 TBO 的适用边界画得很清楚:
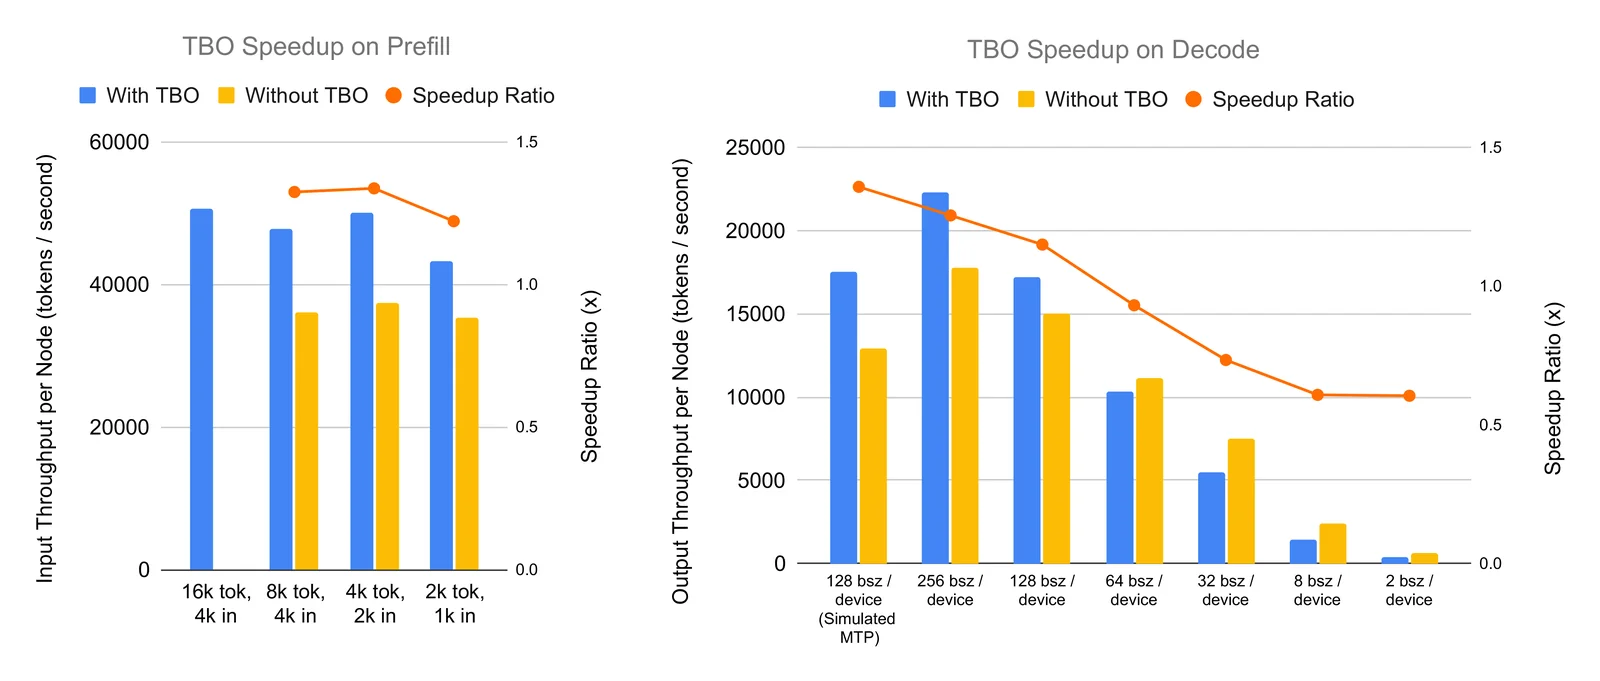
- prefill:同一 token 数下吞吐提升 27%–35%;开启 TBO 后单卡可处理 16K token 而不 OOM,相比最优的非 TBO 配置再提升 40.5%;
- decode:batch 小于 64 时收益很小甚至为负,32 token/device 时是 -27%;256 token/device 时提升 25.5%,吞吐达到 22,310 tok/s;
- 模拟 MTP:128 条请求、每条生成 256 个 token 的 decode step 下提升 35%,吞吐 17,552 tok/s 对 12,929 tok/s。
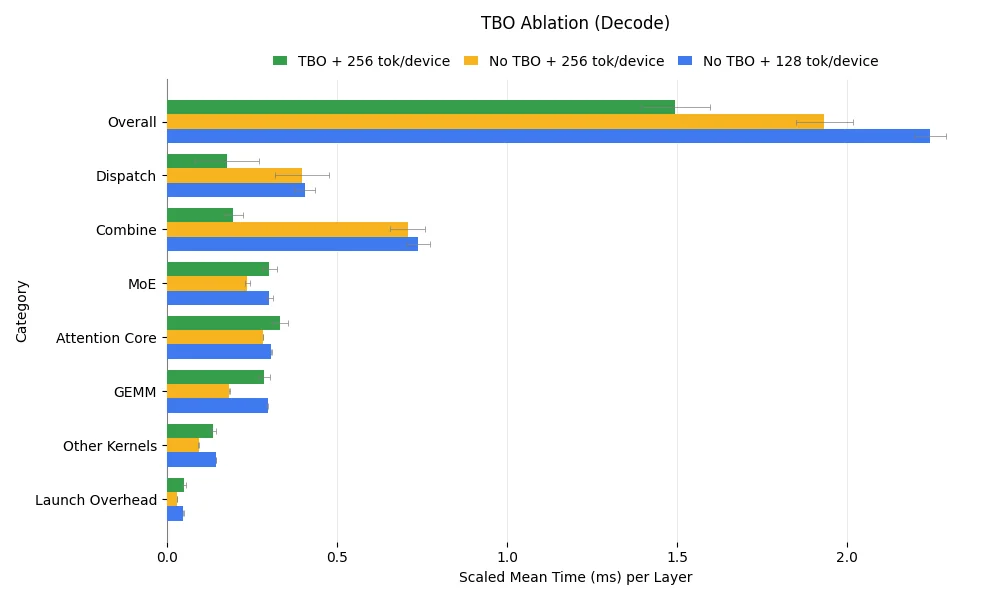
为什么 decode 小 batch 会变慢?因为 TBO 把一次前向拆成两次,每次的 batch 更小,GEMM 的 tile 利用率下降、kernel 启动次数翻倍;当每步的注意力时间很短时,通信本来就能被自然盖住,再拆一次只是增加开销。博客里的判断标准是“注意力处理时间是否足够长”——TBO 的收益来自“用 A 的注意力时间盖住 B 的通信”,注意力太短就没有东西可盖。
GLM-5.3 的 decode 恰好落在有利的一侧:每条请求 6 个验证 token,batch 的有效行数是请求数的 6 倍;DSA 的索引器还要对全部历史打分,长上下文下单步注意力时间远大于普通模型。最保守地算,按 8K 上下文、32 条请求,192 个验证行里每条 DP rank 分到 24 行,仍在门槛以下,单看 token 数 TBO 未必划算;但这些 24 行共享同一段历史 KV,索引器要扫的 key 数是上下文长度而不是行数。上下文到 100K 时,索引器读取是每卡 8.9GB/step,注意力时间以毫秒计,远远超过 MoE 通信的百微秒级,TBO 有充足的遮盖空间。判断 TBO 是否开启,应该看“单步注意力时间”,而不是“每 rank 多少行”。
反过来说,短上下文、低并发、纯 dense 模型的小 batch decode,开 TBO 很可能亏。这也是为什么它只能作为显式开关,而不是默认开启。
CUDA Graph 里的 TBO
TBO 与 CUDA Graph 的关系比 SBO 更紧。因为 TBO 改变了 token 顺序,图的捕获必须把切分点也固化进去。TboCudaGraphRunnerPlugin 的做法是在捕获时写入 tbo_split_seq_index,重放时按当前 batch 重新计算切分点,再把子 batch 的有效 token 数写进预分配的缓冲区:
def replay_prepare(self, batch, ...): tbo_split_seq_index, tbo_split_token_index = compute_split_indices_for_cuda_graph_replay(...) self._tbo_children_num_token_non_padded[...] = ( TboForwardBatchPreparer.compute_tbo_children_num_token_non_padded_raw( tbo_split_token_index=tbo_split_token_index, ... ) )注意 num_token_non_padded 这个字段:即使图是静态的,子 batch 里仍可能有 padding 行(DP 对齐、CP 切分留下的空行),MoE 必须知道哪些行是真实的。这个值在重放前用一次小的设备端计算更新,不改变图的形状,只改变 kernel 读取的元数据。
这也解释了为什么 TBO 在 DP Attention 下要求全局一致:图的切分点是按全局 batch 算的,如果某个 rank 的图按 3b 行切、另一个按 6b 行切,重放时的 kernel 参数会对不上。框架用 min(can_run_tbo) 把这种不一致挡在调度阶段,而不是让它进图。
重叠的第三层:DP gather 与 MoE 的自然交错
除了 SBO 与 TBO,还有一层不需要显式开关的重叠:层的流水。一层里,DP gather 在注意力之后、MoE 之前;reduce-scatter 在 MoE 之后、下一层注意力之前。gather 的 2.36MB 与 dispatch 的 9.44MB 是两个独立的集合通信,前者完成后后者才能开始(dispatch 需要全局 batch),所以它们之间没有重叠空间。
真正能交错的是相邻两层:第 层的 reduce-scatter 与第 层的 A 投影、Q/KV 上投影可以并行,因为后者只依赖本卡的 hidden。SGLang 的层边界抽象(attn_boundary/ffn_boundary)就是为这件事准备的:finish 里发起 reduce-scatter,prepare 里做下一层的 RMSNorm 与投影,中间用一个 stream 等待把依赖接上。
这一层的收益在 prefill 里更明显:一个 32K 的 chunk,reduce-scatter 是 MB 级,下一层的投影是几十毫秒的计算,重叠能盖住大部分通信。decode 里每层的计算只有几十微秒,reduce-scatter 也是微秒级,交错的空间有限,更多要靠 SBO 与 TBO。
把三种重叠放在一张表里
| 机制 | 重叠对象 | 开关 | 适用阶段 | 主要限制 |
|---|---|---|---|---|
| 层间流水 | 上一层 reduce-scatter 与下一层投影 | 默认开启 | prefill/decode | 只盖得住相邻层的独立计算 |
| SBO | combine 发送与 down GEMM | --enable-single-batch-overlap | decode | 后端与架构限制(Blackwell DeepGEMM 不支持) |
| TBO | 子 batch A 的注意力与 B 的 MoE 通信 | --enable-two-batch-overlap | prefill/decode | batch 小于 64 收益为负;DP 下需全局一致;需 CUDA Graph 配合 |
三者不是替代关系。SBO 解决“一层内 combine 发得比 GEMM 算得慢”,TBO 解决“整层通信量大于单层计算能盖住的量”,层间流水解决“相邻层的独立计算能不能填住通信尾巴”。一个部署可以同时开 SBO 与 TBO,但要注意 SM 的竞争:SBO 已经给 combine 留了 3 或 32 个 SM,TBO 又要求两个子 batch 的通信与计算同时进行,SM 总数不变的情况下,留给 GEMM 的 SM 会更少。这就是为什么博客里强调“TBO 的收益取决于注意力时间”——注意力是纯计算、不抢通信 SM,它越长,越能盖住被压缩的 GEMM 资源。
从字节到毫秒:两套硬件下的账
前面的字节账只能给出带宽下限。真实的 dispatch 时间由延迟主导,尤其是在跨节点时。SGLang 博客给过一个实测:96 张 H100、9 个节点部署 DeepSeek,decode 阶段单层 dispatch 约 0.17ms,而单元测试里 DeepEP 的潜力是 0.06ms;两者之间的差距来自“通信内核在忙等数据”——发送端把 token 发走后,接收端的 kernel 在自旋等待,SM 被占住但没有有效工作。博客还提到一个反直觉的实验:在 send 与 receive 之间插入慢速 dummy kernel,反而把 dispatch 时间降到 0.09ms,因为 dummy kernel 让发送与接收的时间窗错开,减少了无效自旋。
这个数字对 GLM-5.3 的部署有直接含义。按 75 个 MoE 层算,单层 0.17ms 就是每步 12.75ms 的 dispatch 时间;如果 combine 同量级,通信会占到 decode 单步的绝大部分。单机 8 卡 NVLink 的情况好得多:单层 dispatch 每 rank 只发约 192 行、1.18MB,900GB/s 下带宽时间约 1.3 微秒,真正花掉的是 kernel 启动、屏障与同步,量级估计在 20–40 微秒;75 层约 1.5–3ms,与权重读取的 0.85ms、KV 读取的 0.70ms 同量级。
所以同一套模型在不同拓扑下的瓶颈完全不同:
| 拓扑 | 单层 dispatch 主导因素 | 单步 75 层量级 | 优化重点 |
|---|---|---|---|
| 单机 8 卡 NVLink | 带宽 + kernel 启动 | 1.5–3ms | FP8 dispatch、减少层数上的固定开销 |
| 多节点 IB(EP16/EP32) | RDMA 延迟 + 忙等 | 10ms 以上 | TBO、低延迟模式、rail 优化、流量隔离 |
这张表解释了为什么 GLM-5.3 的单机配方与 DeepSeek 的跨机部署在调参上几乎没有共同语言:前者要压的是每层几十微秒的固定开销,后者要压的是每层几百微秒的往返延迟。
EP8、EP16、EP32 怎么选
GLM-5.3 有 256 个路由专家。EP 组大小直接决定每卡本地专家数、QP 数与单次发送的跨卡份额:
| EP | 本地专家 | 低延迟 QP/rank | 每 token 跨卡份数 | 适用 |
|---|---|---|---|---|
| 8 | 32 | 32 | 8(全在节点内) | 单机 8 卡,NVLink |
| 16 | 16 | 16 | 8(跨 2 节点) | 两机,IB |
| 32 | 8 | 8 | 8(跨 4 节点) | 四机以上,Wide-EP |
每 token 跨卡份数始终是 8,因为 top-k 是 8,与 EP 大小无关;EP 变大改变的是“这 8 份里有多少份要跨节点”。EP8 时 8 份都在同一节点,走 NVLink;EP16 时约一半跨 IB;EP32 时四分之三跨 IB。这就是 Wide-EP 的代价:专家切得越细,单卡权重越少、显存越省,但每 token 的跨节点份额越高。
反过来,EP 变大也有收益:每个 rank 的本地专家少,masked 缓冲的 num_local_experts 小,显存按比例下降;QP 数也下降,低延迟内核的队列开销变小。GLM-5.3 的 MoE 权重按 8 份切分后每卡约 90GB(FP8),加上复制的注意力、共享专家与稠密层约 109GB,已经接近 H200 的 141GB 上限;要留出 KV 空间,EP16 或 EP32 几乎是必然选择。这就是为什么 cookbook 把 EP8 作为单机起点,而生产部署往往用 PD 分离加更大的 EP。
流量隔离与自适应路由
DeepEP 的文档里有两段网络配置建议,对跨节点部署很实用:
- 流量隔离:用 InfiniBand 的 Virtual Lane 把专家并行的流量与其它流量分开,通过 buffer 的
sl_idx指定 RDMA service level,优先级是EP_OVERRIDE_RDMA_SL > sl_idx > EP_DEFAULT_RDMA_SL > NCCL 默认; - 自适应路由:建议在所有负载下开启,虽然会引入额外延迟,但能把流量均匀摊到多条路径上;
- 拥塞控制:最大带宽场景下建议在验证 fabric 配置后关闭,如果无法避免拥塞,就把这些负载放到低优先级 VL。
这三条的共同点是:MoE 的 all-to-all 是突发流量,单个 decode step 内连续 75 层反复打出 MB 级数据,层与层之间只有几十微秒的静默。按平均带宽做容量规划会低估瞬时拥塞,按峰值留带宽又会浪费。VL 隔离让它可以独占一条通道,不与 KV 传输、权重加载抢。
失败模式:启动阶段与运行阶段各自会踩的坑
这一段列出部署时最常遇到的错误,以及它们对应的代码位置。
缓冲区容量取小了
低延迟模式的缓冲在启动时按 num_max_dispatch_tokens_per_rank 分配。运行中如果某个 rank 单步要发的 token 超过容量,DeepEP 会直接报错,不会动态扩容。SGLang 的注释写得很明确:容量取大了显存占用大,取小了运行时报错,需要按实际 batch 调整。对 GLM-5.3,单 step 的行数是 (6 个验证 token),再按 DP 组大小摊到每个 rank;EP8 单机、8 个 DP rank、 时每 rank 约 24 行;但每个 token 还会按 8 个专家复制,最坏情况下同一个远端 rank 一次要收 8 倍的量,容量不能只按行数算。要把 --max-num-seqs 开到 256,每 rank 的行数涨到 192,再乘上专家复制的倍数,容量必须跟着涨。
模式混用
同一个通信组里同时跑普通模式与低延迟模式,需要 clean_low_latency_buffer 清空重建;如果 prefill 与 decode 在同一个 step 里混跑(--enable-mixed-chunk),这个切换无法安全完成。SGLang 的 set_dispatch_mode_as_low_latency 会在从普通模式切过来时清缓冲:
@classmethoddef set_dispatch_mode_as_low_latency(cls): state = cls._state() if state.dispatch_mode == DeepEPDispatchMode.NORMAL: cls.clean_buffer() state.dispatch_mode = DeepEPDispatchMode.LOW_LATENCY这就是“Auto 与 DP Attention 不兼容”的代码级原因,也是 PD 分离能解决问题的地方:两个实例各自固定一种模式,永远不切换。
num_max_dispatch_tokens_per_rank > 1024
前面提过,低延迟内核用一个 1024 的 sentinel tag 判断发送结束。超过这个值,接收端会提前认为数据到齐,后面出现静默的数据错位——不报错、不崩溃,只是输出变差。SGLang 用 assert 把它挡在启动阶段,这是少数“宁可起不来也不要跑错”的地方。
SM 被通信占满
普通模式的通信内核按 num_sms 分片,低延迟模式的 combine 也留了固定 SM。如果 num_sms 取成总 SM 数的一半以下,SGLang 会打印警告:
Only use N SMs for DeepEP communication. This may result in highly suboptimal performance.Consider using --deepep-config to change the behavior.这条警告的条件里还有一个 not is_tbo_enabled():开了 TBO 时不再警告,因为 TBO 本来就要把 SM 分给两个子 batch,通信占用是预期行为。反过来说,如果看到这条警告又没开 TBO,说明通信 SM 配少了,dispatch 会变成串行瓶颈。
专家分布不均
256 个专家、top-8 路由,热点专家可能收到几倍于平均的行数。expected_m 只是平均基准,真正的负载由 masked_m 决定;如果某几个专家持续过热,masked GEMM 的有效利用率会下降,combine 的等待也会变长。解法是 EPLB(专家并行负载均衡):复制热点专家、把副本放到不同 rank,再按负载重排。EPLB 的机制(冗余专家复制、贪心放置与在线重排)见 DeepInfer 源码拆解(四):MoE 专家并行与 EPLB,这里只强调一点:EPLB 改变的是 num_local_experts 的语义——物理专家数可能大于逻辑专家数,num_experts % group.size() 的整除约束仍然成立,但“每卡 32 个专家”不再是“每卡 32 个逻辑专家”。
与站内几篇的关系
这一段把这篇放回整个知识网络里,方便按需延伸:
- dispatch/combine 的内核实现、NVSHMEM 细节与 DeepEP 的两类 kernel 设计,见 DeepEP 完全拆解;
- DP Attention 与 EP 的并行拓扑、EPLB 的放置算法,见 SGLang 源码完全拆解(十七):DP Attention 与专家并行;
- 弹性 EP、故障恢复与专家布点重排,见 SGLang 源码完全拆解(十八):弹性 EP 与故障恢复;
- MoE 层的路由、分组 GEMM 与前向拼装,见 vLLM 源码完全拆解(八):MoE 层的前向执行 与 DeepInfer 源码拆解(三十五):MoE 层的 MLP;
- 本系列的前五篇:入口与 SGLang 全链路见 第一篇,vLLM 的算子融合见 第二篇,prefill 的分块与 CP 见 第三篇,PD 分离见 第四篇,vLLM 的 prefill 切分见 第五篇。
换一个拓扑重算账:PD 分离的 decode 实例
前面的账本都建立在“单机 8 卡、全部在一个节点”的前提上。GLM-5.3 的生产形态更可能是 PD 分离:prefill 实例与 decode 实例各占若干节点,KV 与索引器缓存跨节点交接(见第四篇)。这时 MoE 的账本要重算一次,因为 EP 组跨了节点。
设 decode 实例为 4 个节点 × 8 卡,EP32,注意力保持 DP Attention(attn_dp_size = 32,attn_tp_size = 1)。GLM-5.3 的 256 个专家被切成 32 份,每卡 8 个本地专家。对 条请求、每条 6 个验证行、全局 192 行:
- 每 token 的 8 份:8 个专家均匀落在 32 个 rank 上。某个专家落在本节点 8 个 rank 内的概率是 ,所以每 token 期望有 2 份走节点内 NVLink、6 份过 IB,跨节点份额 75%;
- 本地专家只有 8 个:每卡的 masked 缓冲是 ,BF16 下约 100MB,比 EP8 的 402MB 少了四分之三。这就是 Wide-EP 换来的显存;
- 低延迟 QP 数降到 8:队列变少,单队列的消息更密,对端处理压力集中。
跨节点的代价要直接算清楚。dispatch 每层每行有 6 份 × 6144 字节走 IB,192 行约 7.1MB;combine 是 BF16,同样 6 份但每份 12288 字节,约 14.2MB。两者相加,每层约 21.2MB 过 IB,75 层约 1.59GB。按每节点 8 张 IB 网卡、单卡 400Gb/s(50GB/s)估算,单节点出口带宽 400GB/s,一个节点分担的份额约 ,带宽时间约 1ms。但延迟才是主导:跨节点 RDMA 的往返是微秒级,单层 dispatch 在博客的实测里是 0.17ms,75 层就是 12.75ms。带宽账只有 1ms,延迟账却多出一个数量级——这正是 Wide-EP 部署必须靠 TBO 重叠的原因。
TBO 在这个形态下是否划算,取决于 decode 的注意力时间。8K 上下文时索引器读取每卡约 0.73GB,按 4.8TB/s 是 0.15ms;主注意力读取 3.35GB 约 0.70ms。一层注意力的 MoE 前计算约 0.85ms,而一层 MoE 通信约 0.17ms——注意力足够长,TBO 有遮盖空间。但如果 batch 很小(每条 DP rank 只有 4 条请求、24 行),注意力时间会缩到几十微秒,TBO 反而亏。这就是博客里“batch 小于 64 时 TBO 为负”的机制:不是 TBO 本身慢,而是没有足够长的注意力去盖住通信。
这也给出一个部署层面的结论:Wide-EP 与 TBO 应该成对出现。只扩大 EP 不开 TBO,跨节点份额增加但通信裸露,尾延迟会变差;只开 TBO 不扩大 EP,单节点内 EP8 本来就能靠 SBO 与层间流水盖住大部分,TBO 的额外切分收益有限。
索引器缓存也要跨节点
第四篇算过 GLM-5.3 的索引器缓存:每位置每层 132 字节,21 个索引器层合计 2772 字节/token,1M 上下文约 2.8GB。在 DP Attention 下,索引器 K 与主 KV 一样按请求分布在请求所属的 rank 上,不参与 MoE 的 dispatch/combine。这意味着索引器的读取仍在本地,只有 hidden 需要跨卡。
这一点很重要:如果把索引器 K 也按 EP 切分,那么每个 rank 都需要读取全部历史的索引 K,索引器通信会与 MoE 通信叠加。GLM-5.3 的设计让索引器跟随注意力、只跟随请求,正好与 MoE 的按专家切分错开,这也是 DSA 模型能在 Wide-EP 下维持可接受延迟的结构性原因。
精度口径:dispatch 用 FP8,combine 用 BF16
最后把量化口径单独说清楚,因为它直接改写上面的字节账。
SGLang 在普通模式的 dispatch_a 里对激活做 128 一组的 FP8 量化,低延迟模式则在 buffer.low_latency_dispatch 里传 use_fp8=self.use_fp8。两条路径的共同点是:发送的是 FP8,接收的是 FP8,量化发生在本地、反量化发生在专家 GEMM 内部。
DeepGEMM 的 FP8 grouped GEMM 接受 FP8 激活与 FP32/UE8M0 的 scale,在累加时统一按 FP32 处理,输出 BF16。也就是说,dispatch 环节的精度损失只有一次 128 组量化的舍入,误差量级约 (E4M3 的尾数位)。专家输出已经在 BF16 上,combine 再做 8 份求和,总误差与注意力 FP8 KV 的误差同阶,不会成为瓶颈。
如果要把 combine 也压到 FP8,需要额外传回每份输出的 scale,并接受 8 份求和时的二次舍入;DeepEP 目前的接口把 combine 输入固定为 BF16,正是为了避开这个问题。这条约束在调优时可以看作硬边界:dispatch 可以量化,combine 不可以。
对账单的影响:
| 精度口径 | dispatch 每层 | combine 每层 | 75 层合计 |
|---|---|---|---|
| 全部 BF16 | 18.9MB | 18.9MB | 2.83GB |
| dispatch FP8,combine BF16 | 9.44MB | 18.9MB | 2.13GB |
| 全部 FP8(DeepEP 不支持) | 9.44MB | 9.44MB | 1.42GB |
从 BF16 到 FP8 dispatch,省下的是 0.7GB/step;从 FP8 dispatch 到全 FP8,理论上还能再省 0.7GB,但当前接口不支持,而且精度收益不值得。这就是为什么各家推理框架的 MoE 通信优化都集中在 dispatch 侧:它是唯一可以安全量化的那一段。
和 DeepEP 的 EPBuffer 接口对齐:两代接口的语义映射
前面引用的代码主要来自 SGLang 的封装。DeepEP 本身正在从 legacy 的 Buffer 接口向 EPBuffer 统一,几个概念值得记下来,因为它们决定了框架层的抽象:
- 统一接口:高吞吐与低延迟的 EP 操作共用一个
EPBuffer,初始化时直接给 MoE 参数(num_max_tokens_per_rank、hidden、num_topk、num_experts),SM 与 QP 数由get_theoretical_num_sms(num_experts, num_topk)解析估算,也可以每次调用时用num_sms覆盖; - 延迟收尾:
defer_epilogue=True配合async_with_compute_stream=True时,调用直接返回EventOverlap,wait()时才在计算流上跑收尾并返回结果。SGLang 的dispatch_a/dispatch_b拆分,本质上是把这件事包得更显式; - 不需要 CPU 同步的 decode:
do_cpu_sync=False时输出按容量分配,用handle.psum_num_recv_tokens_per_expert识别有效区间,这正是masked_m的来源; - 对齐:
expert_alignment设成 grouped GEMM 的 token 对齐,DeepGEMM 用deep_gemm.get_mk_alignment_for_contiguous_layout()取值,SGLang 里写死 128,与前面代码一致。
这些概念在 legacy 与 EPBuffer 两套接口下名称不同,但语义一致。理解它们的对应关系,才能在看不同版本的 SGLang 或 DeepEP 代码时不迷路:dispatch_a/dispatch_b 对应 EPBuffer 的“发起 + 延迟收尾”,masked_m 对应 psum_num_recv_tokens_per_expert,expected_m 对应 GEMM 的 tile 选择参数。
小结
把这一篇压缩成几句话:
- 一次 MoE 前向有四段跨卡动作:DP gather、dispatch、combine、reduce-scatter。只算中间两段会低估 15%–20% 的通信量,漏掉 gather 还会算错 batch 形状;
- decode 与 prefill 必须用两套布局:低延迟模式的固定容量 masked 布局换来 CUDA Graph 与低延迟,普通模式的变长 contiguous 布局换来越长越省的带宽;Auto 模式在 DP Attention 下不能同时支持两者,PD 分离是解法;
- 容量是硬约束:
num_max_dispatch_tokens_per_rank决定缓冲、QP 深度与 masked GEMM 的显存,协议上限是 1024,框架用 assert 把超限挡在启动阶段; - 重叠分三层:SBO 把 combine 藏进 down GEMM,TBO 用两个子 batch 互相遮盖,层间流水填补相邻层的通信尾巴;TBO 在 decode batch 小于 64 时是负收益,判断是否开启要看单步注意力时间:长上下文下索引器扫描让注意力以毫秒计,TBO 才有东西可盖;
- 拓扑决定瓶颈:单机 NVLink 下 dispatch 是几十微秒的带宽与启动开销,跨节点 IB 下是百微秒级的延迟与忙等,调参重点完全不同。
下一篇会把这条链路里最后一个没打开的黑盒补上:采样之后,token 如何变成文本、stop string 与结构化输出如何截断流式响应,以及一次请求结束后 KV 页与前缀缓存如何回收。那一段决定的是“输出侧”的尾延迟,和这一篇的“输入侧通信”正好对称。
参考资料
- GLM-5 技术报告(GLM-5.3 的模型结构与 DSA 设计,arXiv:2602.15763)
- zai-org/GLM-5.3 模型卡(744B-A40B、FP8、78 层、256 专家)
- SGLang GLM-5.3 Cookbook(TP8/EP8、DP Attention、MTP 的启动参数)
- SGLang 官方博客:Deploying DeepSeek with PD Disaggregation and Large-Scale Expert Parallelism on 96 H100 GPUs(模式兼容性表、TBO 实测与 dispatch 0.17ms)
- DeepEP GitHub 仓库(EPBuffer、normal/low-latency 接口与网络配置建议)
- SGLang 源码:token_dispatcher/deepep.py(两种模式、缓冲计算与 overlap args)
- SGLang 源码:batch_overlap/single_batch_overlap.py(SBO 参数与共享专家重叠)
- SGLang 源码:batch_overlap/two_batch_overlap.py(TBO 切分、CUDA Graph 插件与双 dispatcher)
- SGLang 源码:moe_runner/deep_gemm.py(masked grouped GEMM 与 combine overlap)
- SGLang 源码:layers/dp_attention.py(DP gather/scatter 与 gatherv)
- DeepGEMM GitHub 仓库(FP8 grouped GEMM 与 masked/contiguous 两种布局)
- AMD ROCm《The vLLM MoE Playbook》(DP+EP 数据流图)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



