


vLLM 源码完全拆解(十六):把十五篇机制拼成一张可执行的源码阅读地图
从十五个局部机制回到一台完整引擎
前十五篇分别拆过请求生命周期、统一调度、KV Cache、输入拼批、注意力后端、PagedAttention Kernel、MoE、采样、投机解码、并行执行、编译、多模态、结构化输出与增量解码。局部机制已经足够多,新的困难反而变成:打开仓库时,怎样判断一个对象属于哪一层;从一个 API 请求出发,应沿哪些文件和数据结构一路追到 GPU,再从 token 回到用户;遇到错误或性能异常时,应该在哪个边界截断问题。
vLLM 项目于 2023 年由加州大学伯克利分校团队公开,核心工作 PagedAttention 同年发表于 SOSP。本文聚焦其在 2025 年发布、后来成为默认路径的 V1 架构。V1 保留模型实现、GPU Kernel 与大量工具,但重写了 API server、EngineCore、Scheduler、KV Cache Manager、Worker 和 Sampler 之间的边界。源码仍快速演进,因此本文以稳定的职责与数据流为坐标,不依赖容易变化的行号;文件路径以 2026 年 10 月官方 main 分支为准。
这一篇不是把十五篇摘要再排列一次,而是提供三种可执行的地图:
- 进程地图回答“代码在哪个进程运行,跨进程时传什么”;
- 状态地图回答“同一请求在前端、调度器和 Worker 各保存什么”;
- 热路径地图回答“一轮 step 依次经过哪些函数,哪里是 CPU 控制,哪里进入 GPU 数据面”。
读源码时最容易犯的错误,是只沿 Python 调用关系走。推理引擎同时存在三条关系:调用关系、状态所有权和异步时间关系。函数 A 调用函数 B,不代表 A 拥有 B 修改的状态;execute_model() 返回 Future,也不代表 GPU 已完成;同一个 request ID 在三个进程里出现,也不代表三份对象可以互相引用。后面的地图会始终把这三件事分开。
一张总图:控制面、数据面与输出面
先看入口。离线 LLM、异步 AsyncLLM 与 OpenAI 兼容 API 最终都要把外部请求规范化成引擎可理解的请求,但它们承担的并发模型不同:LLM 的调用者主动推动 step();在线服务由事件循环持续提交与消费;API server 还要完成协议校验、模板、分词以及流式响应封装。
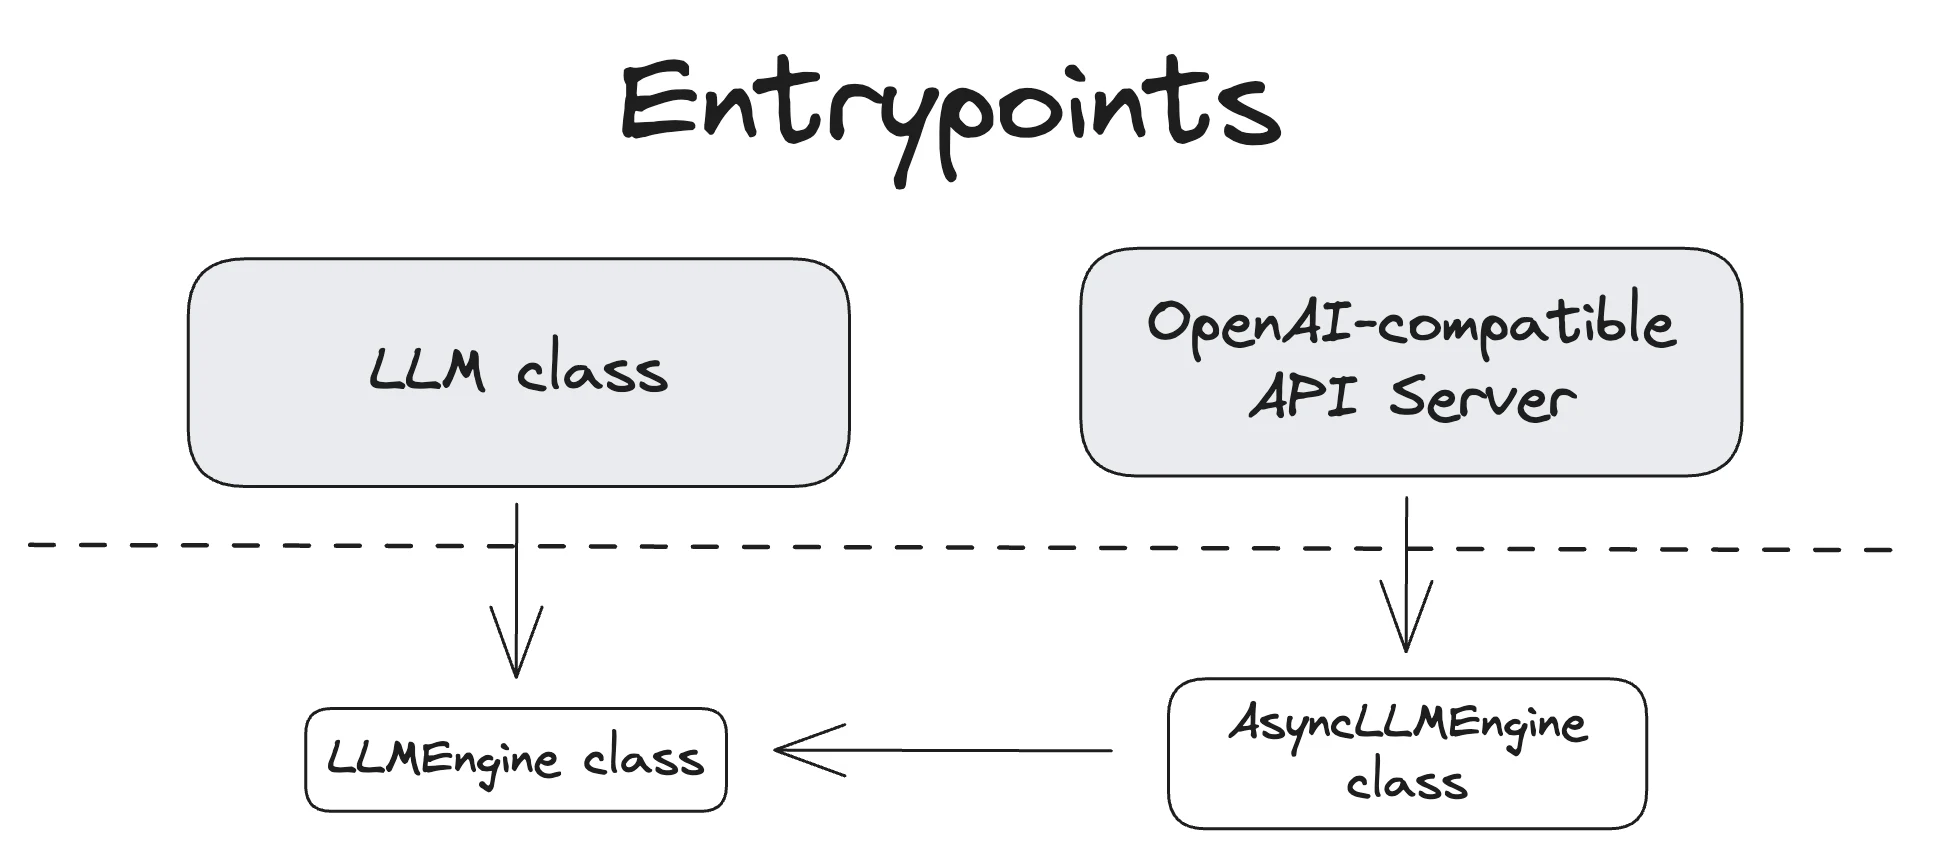
图源:vLLM 官方 Architecture Overview。图中入口虽然不同,真正需要守住的边界只有一个:前端负责面向用户的语义,EngineCore 负责设备无关的推理推进,Worker/ModelRunner 负责把计划变成设备执行。把 tokenizer、HTTP 流式连接塞进 EngineCore,会让核心循环被字符串和网络延迟污染;让 API server 直接管理 KV block,又会破坏内存状态的单一所有者。
V1 在线服务通常是多进程结构。以 4 张 GPU、张量并行度 4 为例,官方给出的拓扑包含 1 个 API server、1 个 EngineCore 和 4 个 GPU Worker,共 6 个进程。
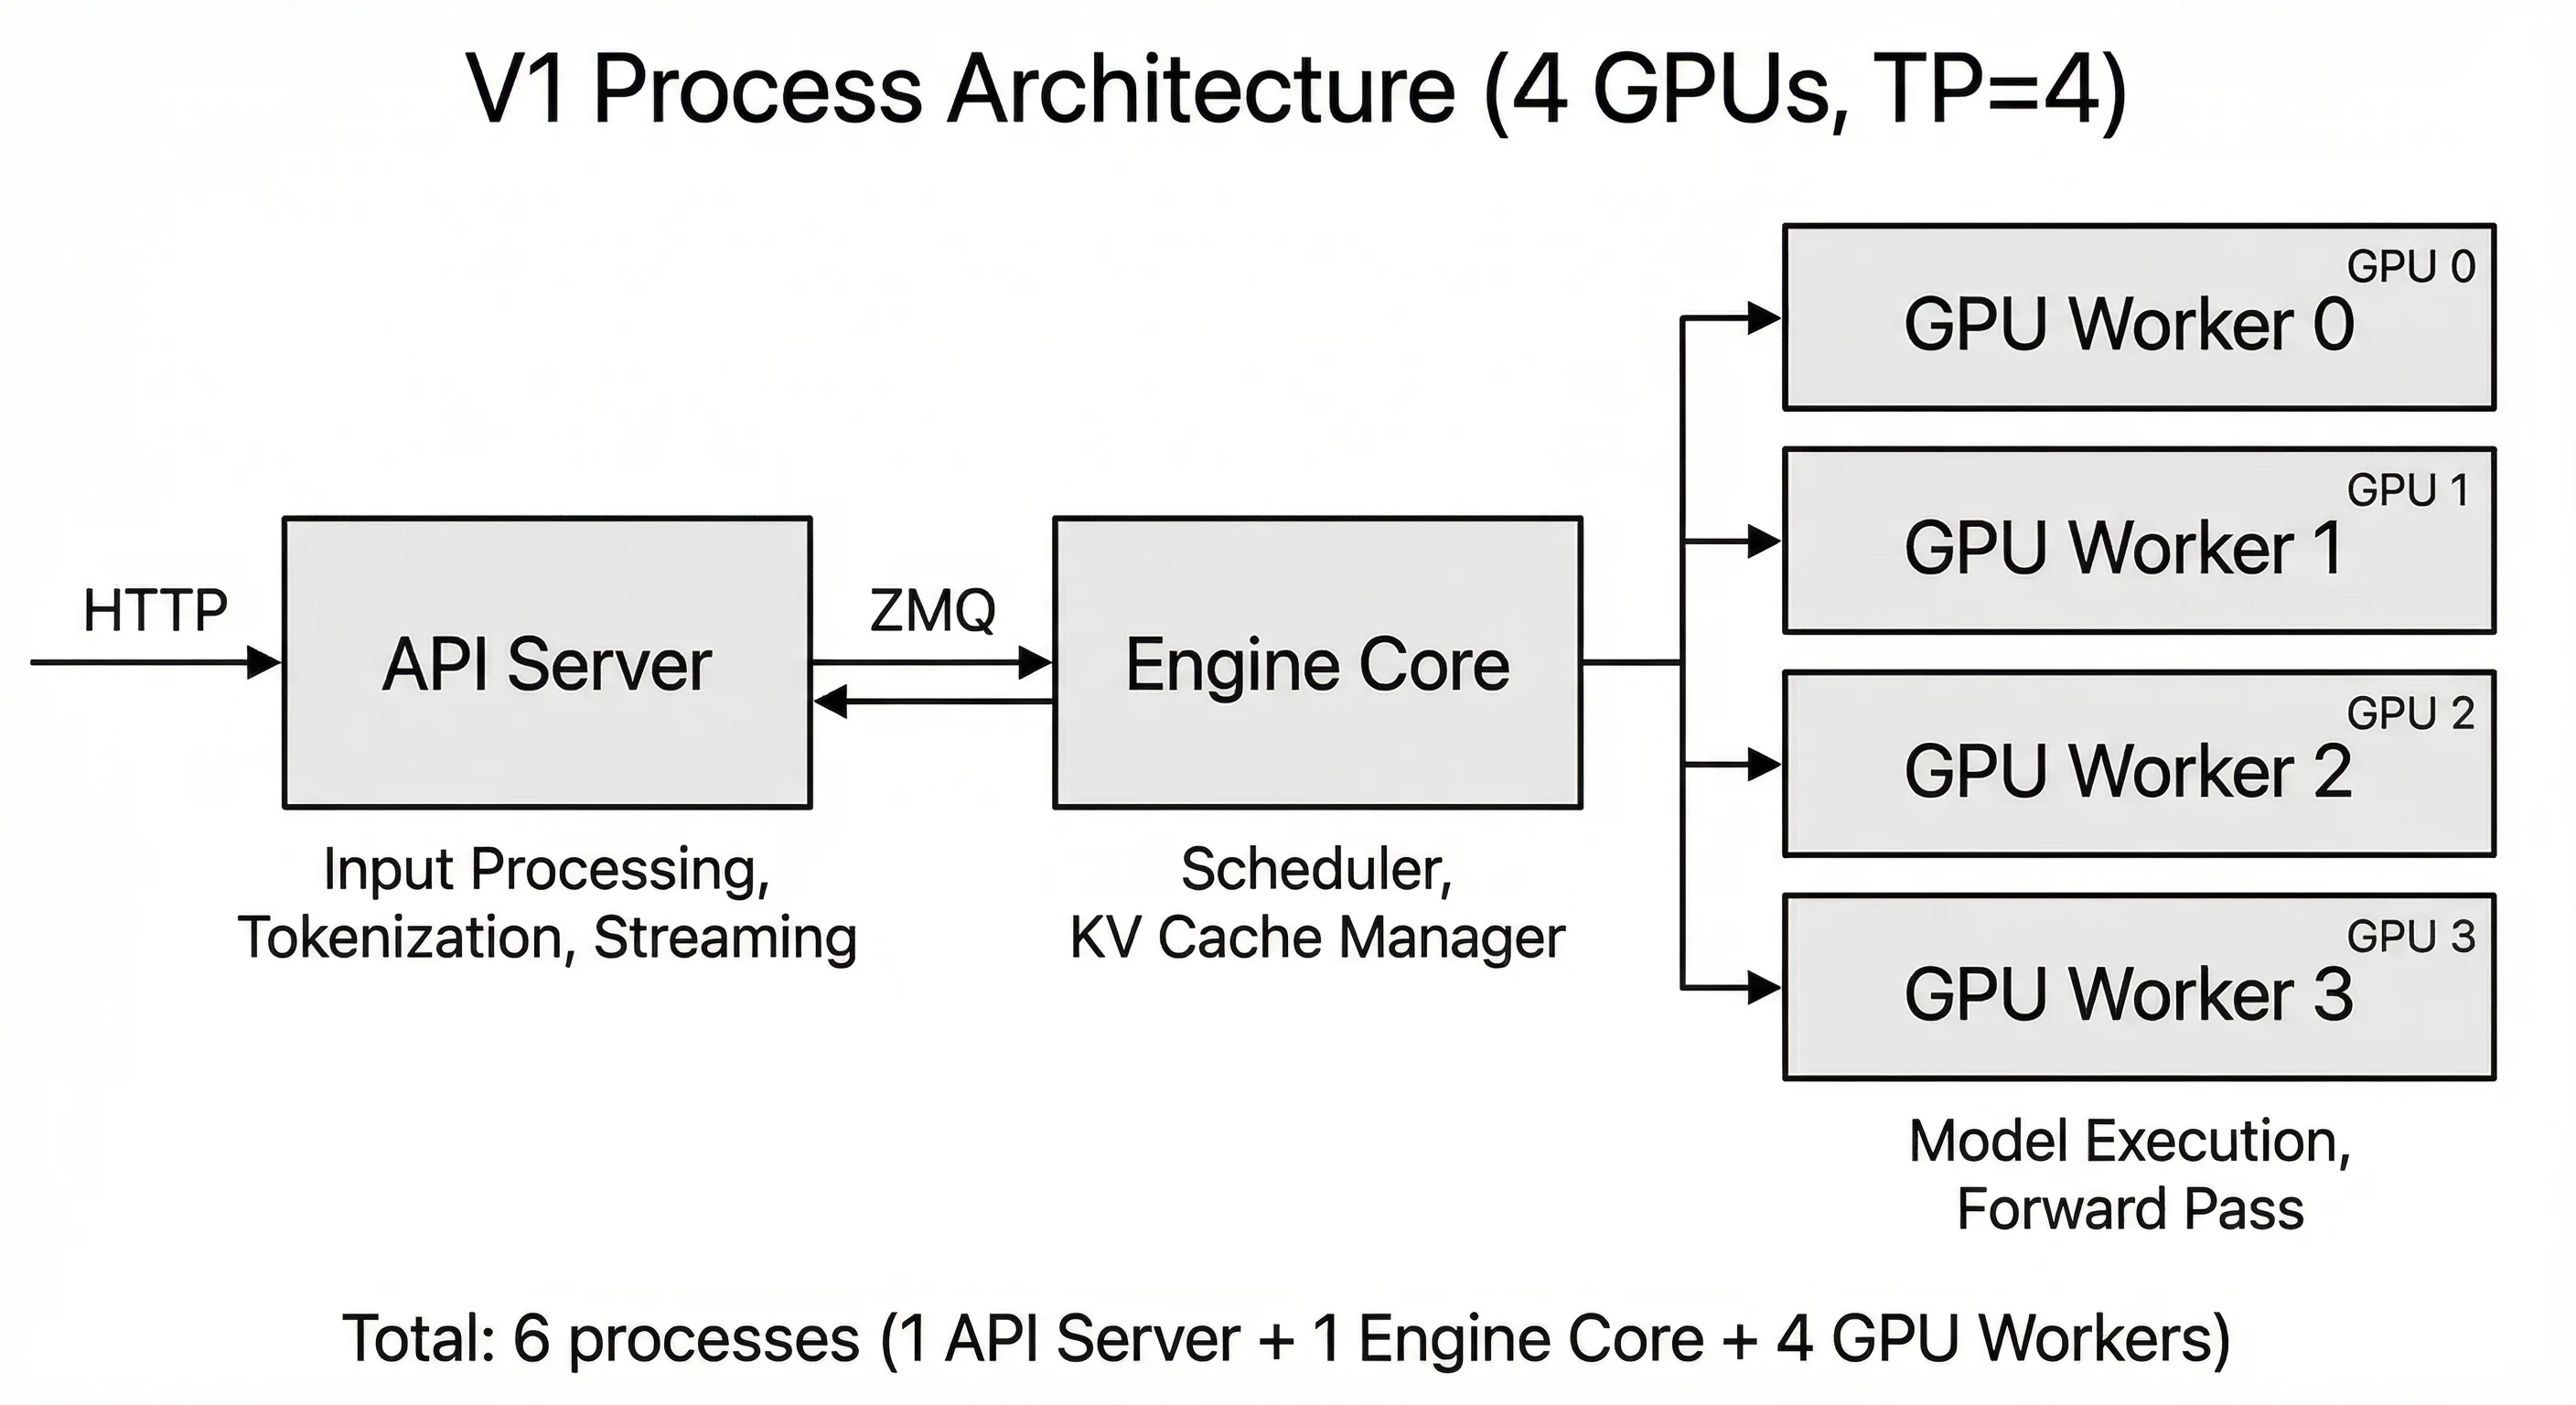
图源:vLLM 官方进程架构文档。图中三层可以进一步理解为:
| 层 | 主要对象 | 拥有的真值 | 不应承担的职责 |
|---|---|---|---|
| 接入与输出面 | API server、AsyncLLM、LLMEngine、OutputProcessor | 原始请求、tokenizer 状态、流式输出、用户可见 finish reason | 物理 KV 页分配、GPU 输入布局 |
| 控制面 | EngineCore、Scheduler、Request、KVCacheManager | 请求状态机、token 预算、逻辑 KV block、完成与抢占 | 模型 tensor 的具体布局、文本拼接 |
| 数据面 | Executor、Worker、GPUModelRunner、Attention Backend | 模型权重、物理 KV tensor、批次 tensor、CUDA Graph、Kernel 执行 | HTTP 协议、全局排队策略 |
“控制面”和“数据面”不是说 CPU 与 GPU 的简单二分。GPUModelRunner 会在 CPU 上维护 InputBatch 和请求状态镜像,Scheduler 也会触发结构化输出等异步工作。真正的分界是:控制面决定本轮算谁、算多少;数据面决定这些 token 如何组织成 tensor 并高效执行。
再看数据在一次迭代中的形态变化:
用户参数 -> EngineCoreRequest -> Request(调度状态) -> SchedulerOutput(本轮不可变计划) -> InputBatch + attention metadata(设备执行描述) -> ModelRunnerOutput(token / hidden state / logprob) -> EngineCoreOutput -> RequestOutput(文本 delta / finish reason)这里最重要的中间对象是 SchedulerOutput。它把“长期可变状态”编译成“本轮执行计划”,使 GPUModelRunner 不必读取 Scheduler 内部队列。反方向的 ModelRunnerOutput 只报告执行结果,不直接改 Scheduler 的 Request。两边通过窄对象交换事实,正是 V1 比巨型单进程引擎更容易扩展的根本原因。
第一条走读路径:请求怎样进入 EngineCore
在线路径可从 vllm/entrypoints/openai/api_server.py 开始,但第一次走读不应陷入 FastAPI 路由。更有效的起点是 vllm/v1/engine/async_llm.py 或 vllm/v1/engine/llm_engine.py:前者能看清异步服务如何提交请求,后者能看清同步离线循环如何推进。二者最终都要构造 EngineCoreRequest,再交给 EngineCoreClient。
跨进程边界值得单独停一下。Python 对象不能因为名字相同就跨进程共享;请求需要被序列化,经 IPC 送到 EngineCore 进程。Engine Core 侧把传输对象预处理成 vllm/v1/request.py 中的内部 Request。外部请求偏向协议表达,内部请求偏向状态机表达,后者至少要回答:已有多少 prompt token、已计算多少 token、已生成多少 token、当前状态是什么、采样约束是什么、是否携带 LoRA 或多模态输入。
主干可以压缩成下面的伪代码:
# 前端进程core_req = preprocess_and_build_request(user_request)engine_core_client.add_request(core_req)
# EngineCore 进程request = Request.from_engine_core_request(core_req)scheduler.add_request(request)
while scheduler.has_requests(): scheduler_output = scheduler.schedule() future = model_executor.execute_model( scheduler_output, non_block=True, ) model_output = future.result() outputs = scheduler.update_from_output( scheduler_output, model_output, )这段伪代码刻意省略 grammar、batch queue 和异步采样,但保留了 V1 主循环的五个阶段:接纳、调度、提交、等待、提交结果。官方当前 vllm/v1/engine/core.py 的 EngineCore.step() 仍遵守这个骨架。
请求为什么要在前端和 Scheduler 各存一份状态?因为两边关心的完成定义不同。Scheduler 看到 EOS、长度上限或 abort 后,可以释放 KV 资源并结束设备推进;前端还可能需要 detokenize、截断 stop string、聚合 n > 1 的子请求以及把最后一个流式片段发给客户端。若只保留一份对象,设备资源生命周期就会被慢客户端绑住。
建议在这条路径设置四个断点:
LLMEngine.add_request():确认外部请求怎样变成 Core 请求;EngineCore.add_request():确认进程边界之后保留下来的字段;Scheduler.add_request():观察状态进入 waiting 队列;EngineCore.step():观察一次长期请求怎样被多轮短计划推进。
前两篇已经分别拆过整体架构和一次请求穿过 V1 引擎的过程。此处应形成的整体认识是:add_request() 不是立即执行,step() 也不等于“一次生成恰好一个 token”;它们分别是状态登记与一次预算化推进。
第二条走读路径:Scheduler 怎样把请求编译成一轮计划
Scheduler 的入口位于 vllm/v1/core/sched/scheduler.py。不要从文件顶部一路顺读三千多行,先锁定三个方法:add_request()、schedule()、update_from_output()。它们恰好对应请求进入、计划生成、结果提交三次状态转换。
统一调度的关键抽象不是 prefill 队列和 decode 队列,而是每个请求的 token 欠账:
表示当前已知的 prompt 与输出 token 总数, 是投机草稿引入的待验证 token 数, 是已经写入有效计算状态的 token 数。Scheduler 在全局 token budget、KV 容量、模型长度、encoder budget 和功能约束下,为请求 选择本轮计算量 :
第二个约束中的 是本轮最大 batched token 数。只要 小于 prompt 剩余长度,同一机制自然得到 chunked prefill;当 且请求已完成 prefill,它就是常规 decode;当 且包含草稿 token,它又成为投机验证。统一的不是模型计算本身,而是“用 token 数描述本轮工作量”的调度接口。
调度循环通常先扫描 running 请求,再接纳 waiting 请求。对每个候选,它至少要执行以下检查:
计算可调度 token 数 -> 裁剪模型长度与本轮 token budget -> 处理 chunked prefill / spec token / encoder token -> 向 KVCacheManager 申请 slots -> 申请失败时决定抢占或暂缓 -> 写入 SchedulerOutputallocate_slots() 的成功是提交计划的前置条件。原因很直接:模型执行一旦开始,就必须有地方写每个新 token 的 K/V;先发 GPU、后找内存,会把可恢复的容量不足变成执行期错误。反过来,分配成功也不代表这些 block 已经含有有效 KV,只有模型输出正常提交后,请求的 num_computed_tokens 才能前进。
前缀缓存命中会改变 n_i^{\text{computed}} 的起点,但不会绕过 Scheduler。缓存键除 token block 外还必须覆盖父前缀、KV cache group 以及 LoRA、多模态等额外身份;相同文本不一定产生可共享的 K/V。物理块可以处于“引用计数为零但内容仍可命中”的状态,因此 free 表示可覆盖,而不是数据已清空。完整机制可参考 KVCacheManager 如何分配、复用与回收物理 Block。
update_from_output() 是读 Scheduler 时最容易漏掉的一半。它将采样出的 token 追加到请求,处理投机接受数,检查停止条件,把完成请求移出活动集合,并释放其 KV block。如果只读 schedule(),会知道计划从哪里来,却不知道 token 计数为什么在下一轮变了,也无法理解资源回收的时点。
第三条走读路径:KV 页表怎样变成 GPU 上的真实地址
Scheduler 管的是逻辑容量,GPUModelRunner 和 Attention Backend 最终需要的是物理地址。两者之间靠 block table 衔接。若 KV block 每块容纳 个 token,逻辑位置 先被拆成逻辑块号与块内偏移:
请求的 block table 给出物理块号 。对第 个请求,位置 的逻辑槽位可写为:
这个整数 slot 还不是字节地址。Kernel 再结合 KV tensor 的层、K/V、head、head dimension、dtype 和布局 stride,计算实际加载位置。分页的价值正在这里:序列的逻辑位置连续,但物理块不必连续;请求扩展时只需要追加页表项,不需要搬迁已经存在的 KV。
从源码对象看,这条链路分四步:
KVCacheManager为请求维护逻辑 block table,并处理命中、分配、回收;SchedulerOutput只携带本轮新增或变更的 block 信息;GPUModelRunner._update_states()将差量合并到 Worker 侧的请求镜像和InputBatch;_prepare_inputs()根据本轮 token 位置生成 slot mapping 与注意力公共元数据,具体 backend 再编译成 Kernel ABI。
差量传输很重要。假设一个长请求已有数千个 block,而本轮 decode 只新增一个 token,若每轮都跨进程传整张页表,CPU 序列化与 IPC 成本会随上下文长度增长。V1 让 Worker 保留持久状态,只传调度变化,使控制面消息更接近本轮工作量。
这里存在三种不能混用的地址:request ID 是跨层身份;InputBatch row 是本轮紧凑数组中的临时索引;物理 block ID 是 KV pool 的页号。删除请求后,Runner 可能把最后一行移动到空洞以保持 batch 紧凑,所以 row 会变;block table 也可能因追加与回收改变;只有 request ID 用于重新建立对应关系。许多“请求 A 输出混入请求 B”一类错误,本质是压紧时漏搬了某一列状态。
读这条路径可先关闭 prefix caching,只看纯分配;再打开缓存,比较命中请求的 num_computed_tokens 和 block table;最后构造显存紧张场景观察抢占与回收。一次加入 LoRA、多模态、混合 KV 和远程 connector,只会把多个独立变量叠在一起,难以判断是哪一层先偏离不变量。
进入 Kernel 后,应把地址翻译与注意力数学分开检查。对 decode query ,分页只改变 K/V 的取数方式,不改变注意力定义:
是 head dimension, 用来稳定 softmax。Kernel 必须沿 block table 遍历非连续页,同时维护全局等价的最大值和归一化和。V2 分区路径先在各 partition 得到局部 ,再按
合并分区,输出也用同样的指数比例缩放。页边界和分区边界都不能改变数学结果。线程组织、GQA head 映射与向量化加载已经在 PagedAttention Kernel 如何完成稳定 Softmax 中展开;在全景地图里,只需记住 Kernel 的输入契约来自上游 metadata,而不是自行推断请求语义。
第四条走读路径:GPUModelRunner 怎样组织一次模型执行
当前主路径位于 vllm/v1/worker/gpu/model_runner.py,兼容入口与平台实现也可能通过 gpu_model_runner.py 暴露。官方源码中 GPUModelRunner 组合了 LoRA、KV Connector、encoder cache、投机解码和平台相关能力,单个文件很长。阅读时不要按类的行号顺序,而应围绕 execute_model() 反向查四组依赖:状态更新、输入准备、模型前向和采样交接。
execute_model() 的稳定骨架可以概括为:
def execute_model(scheduler_output): self._update_states(scheduler_output) inputs = self._prepare_inputs(scheduler_output)
with set_forward_context(attn_metadata=inputs.attn_metadata): hidden_states = self.model( input_ids=inputs.input_ids, positions=inputs.positions, intermediate_tensors=inputs.intermediate_tensors, )
selected = select_required_states(hidden_states, inputs) logits = self.model.compute_logits(selected) return self.sampler(logits, inputs.sampling_metadata)真实代码会根据流水线并行、pooling model、async scheduling、spec decode、CUDA Graph 等分叉,但每个分支最终仍要回答四个问题:本轮有哪些请求;每个请求算哪些 token;注意力读写哪些 KV;哪些 hidden state 需要变成 logits。
变长请求不能直接堆成规则二维矩阵,否则 padding 会浪费计算。Runner 把本轮 token 压成一条连续流,并用前缀和描述边界。若请求 本轮计算 个 token,则:
query_start_loc=[q_0,q_1,\ldots] 让 attention backend 知道每段 query 的起止位置;seq_lens 则描述它可以读取到的完整上下文长度。前者回答“这轮新算多少”,后者回答“历史一共有多少”,两者混用会导致越界或错误 mask。
只计算需要的 logits 也是重要优化。长 prompt 的普通生成通常只需要最后一个位置的 logits;prompt logprobs、投机验证或特定任务才需要更多位置。Runner 因此维护 logits index,把大 [num_tokens, hidden_size] 中真正需要采样的行挑出后再乘词表矩阵,避免把所有 prompt token 投影到词表。
Attention Backend 是模型层与 Kernel 之间的编译接口。模型层调用统一 attention op;backend selector 根据设备、dtype、head 结构、KV layout 与功能约束选实现;metadata builder 把公共事实转成 FlashAttention 的 cu_seqlens、page table,或 FlashInfer 的 CSR 页表、workspace 和 plan。这样,Scheduler 不需要知道某个 Kernel 的参数表,模型实现也不用硬编码每个平台的地址格式。对应接口可参考 Attention Backend 如何统一 FlashAttention 与 FlashInfer。
CUDA Graph 又增加一层时间维度。eager 模式每轮由 CPU 逐个 launch Kernel;graph 模式先捕获稳定形状的执行图,之后把新数据复制到固定地址并重放。动态请求数量通常通过预设 capture size 向上取桶,空余行用 padding 占位。Graph 能消除 launch 开销,却要求地址与控制流稳定,所以不兼容的动态 op 会成为切图点。V1 的 piecewise compilation 让 Dynamo/Inductor 编译纯 tensor 片段,把自定义 attention op 留作边界,再对可捕获片段使用 CUDA Graph。完整机制可参考 piecewise compilation 与 CUDA Graph。
这一层的调试顺序应从形状开始,而不是从最终文本开始:
- 检查
num_scheduled_tokens与扁平input_ids长度是否相等; - 检查每个 request row 的 block table、采样参数和 token 历史是否同属一个 request ID;
- 检查
query_start_loc[-1]是否等于总 query token 数; - 检查 slot mapping 是否都落在已分配 KV 容量内;
- 最后才比较 eager、compile 与 graph 路径的数值输出。
如果 eager 正确而 graph 错,优先查静态 buffer、捕获尺寸和未更新的 metadata;如果单请求正确而混合批次错,优先查 row 压紧和边界数组;如果短上下文正确而跨 block 错,优先查页表与 slot mapping。
第五条走读路径:从 logits 到可流式交付的文本
模型输出 logits 后,链路并没有结束。Sampler 先应用温度、惩罚、top-k、top-p、min-p 和结构化输出 bitmask,再产生 token ID 与可选 logprobs。EngineCore 将模型结果交给 Scheduler.update_from_output(),后者更新请求状态、检查 token 级停止条件并生成 EngineCoreOutput。前端 OutputProcessor 再做增量 detokenize、stop string 截断、候选归并和流式模式转换。
顺序不能随意交换。结构化输出 bitmask 必须在采样前把非法 token 的 logits 置为负无穷;EOS 和最大 token 数属于 token 级停止,可在 Core 判断;stop string 是字符级条件,必须等 token 经过 tokenizer 的跨 token 合并之后判断。一个 stop string 可能横跨多个 token,一个 token 也可能只解出 UTF-8 字节序列的一部分,所以“采到 token 后立刻把它对应的字符串发出去”并不安全。
前端通常保留一段 hold-back 缓冲。如果 stop string 的最长长度为 ,当前尾部与某个停止串的前缀匹配,即使还没有完整命中,也不能把这段尾部立刻流给客户端;否则下一 token 补全停止串时,已经发送的数据无法撤回。增量解码同时要保存 tokenizer 的 decode state,保证合并 token、空格清理和非 UTF-8 中间态与整段解码等价。
| 模式 | 每次返回什么 | 前端需要保存什么 |
|---|---|---|
| DELTA | 自上次返回后的新增片段 | 已发送边界与 hold-back |
| CUMULATIVE | 当前完整生成文本 | 完整累计文本 |
| FINAL_ONLY | 完成时一次返回 | 全部结果与完成状态 |
abort 沿反方向传播:客户端断开或调用方取消后,前端把 request ID 送回 EngineCore,Scheduler 将请求标记为 aborted,移出队列并释放 KV block。取消不是仅仅“不再读取输出”;若设备侧仍继续生成,吞吐和显存都会被已经无人消费的请求占用。
这条路径建议串联三个目录与文件阅读:vllm/v1/sample/ 看 logits 到 token,vllm/v1/core/sched/scheduler.py 的 update_from_output() 看 Core 状态提交,vllm/v1/engine/output_processor.py 看 token 到用户输出。此前的 Sampler 采样管线、结构化输出和停止条件与增量解码分别对应这三段。
横切能力如何挂到主干而不改写主干
一台生产推理引擎不只有文本自回归。LoRA、多模态、投机解码、结构化输出、张量并行和远程 KV 都会改变执行,但 V1 没有为每种能力复制一套主循环。理解这些特性最有效的问题不是“它新增了多少文件”,而是“它在哪个既有边界增加约束或数据”。
| 横切能力 | 接入请求时 | Scheduler | ModelRunner / Worker | 输出侧 |
|---|---|---|---|---|
| LoRA | 请求携带 adapter 身份 | 限制同时活跃 adapter 数,缓存键区分 adapter | 激活权重槽并生成 LoRA mapping,融合低秩算子 | 无特殊语义 |
| 多模态 | 预处理媒体并生成 placeholder range | 分配 encoder budget,管理 encoder cache | 执行 encoder、回填 embedding、生成 M-RoPE 位置 | 通常复用文本输出 |
| 投机解码 | 携带草稿配置 | 为草稿与验证预留 token/KV | proposer 产草稿,目标模型批量验证 | 只提交接受 token |
| 结构化输出 | 提交 grammar/schema | 等待 grammar 编译,推进 FSM 状态 | 生成按请求对齐的 token bitmask | 输出仍需 stop 与解码 |
| KV Connector | 声明远程读写状态 | 请求可能等待远端 KV 就绪 | 搬运或发布物理 KV | 通常透明 |
| TP/PP/DP | 初始化时建立并行拓扑 | DP rank 拥有独立调度状态 | collective、stage send/recv、权重切分 | 汇总到对应前端 |
这张表揭示了一个重要设计规律:横切特性尽量以附加约束、metadata 或 hook 进入主干。LoRA 不应重写 Scheduler,只需让接纳逻辑知道本轮 adapter 集合是否超限;多模态不应建立第二个语言模型队列,只需让 encoder 工作拥有独立预算和缓存;投机解码不应破坏 token 欠账模型,只需让一轮可以验证多个位置。
LoRA:同一批次的权重身份
基础模型参数为 ,LoRA adapter 对线性层增加低秩更新:
、, 远小于原矩阵维度。在线服务的难点不是公式,而是同一批次中不同行可能选择不同的 。Runner 需要从 request row 建立 LoRA ID mapping,融合 Kernel 再按 token 找到对应 adapter。Scheduler 的 max_loras 是批次兼容约束,不是全局“只能加载几个文件”的同义词。
LoRA 还必须进入 prefix cache 的额外键。即使两个请求 token 完全相同,只要 不同,层输出和 K/V 就不同;误共享会产生静默错误,而不是明显崩溃。
多模态:同一 token 轴上的另一种来源
图片不会直接变成普通词表 token。预处理先在文本 token 流中放置 placeholder range,视觉 encoder 产生 embedding 后,Runner 按这些区间把视觉向量回填进 inputs_embeds。从 decoder attention 开始,视觉和文本位置都沿同一条序列进入分页 KV,因此后续调度与 PagedAttention 可以复用。
复用的代价是必须维护严格对齐:placeholder 长度、encoder 输出数、分块 prefill 本轮覆盖的子区间和位置编码必须一致。对应链路可参考 多模态输入如何从图像预处理走到 Placeholder Range。
投机解码与结构化输出:两个 token 集合的交集
投机解码给出目标模型可能接受的候选序列,结构化输出给出当前 FSM 状态允许的词表集合。两者同时启用时,候选并不会绕过 grammar:验证概率、接受路径和最终采样都必须尊重合法 token 集合。否则草稿模型可能让系统输出语法禁止的 token,破坏结构化输出的正确性承诺。
投机方法的算法与 vLLM 实现可参考 投机解码的草稿、批量验证与接受流水线。在源码地图中,它的关键落点只有三处:Scheduler 计算待验证 token,Runner 展开验证批次,update_from_output() 只提交实际接受的前缀。
多卡:复制控制面,切分数据面
张量并行把单层矩阵沿输出或输入维切到多卡,流水线并行把不同层放到不同 stage,数据并行则复制模型与 EngineCore,让不同副本服务不同请求。三者改变的轴完全不同。
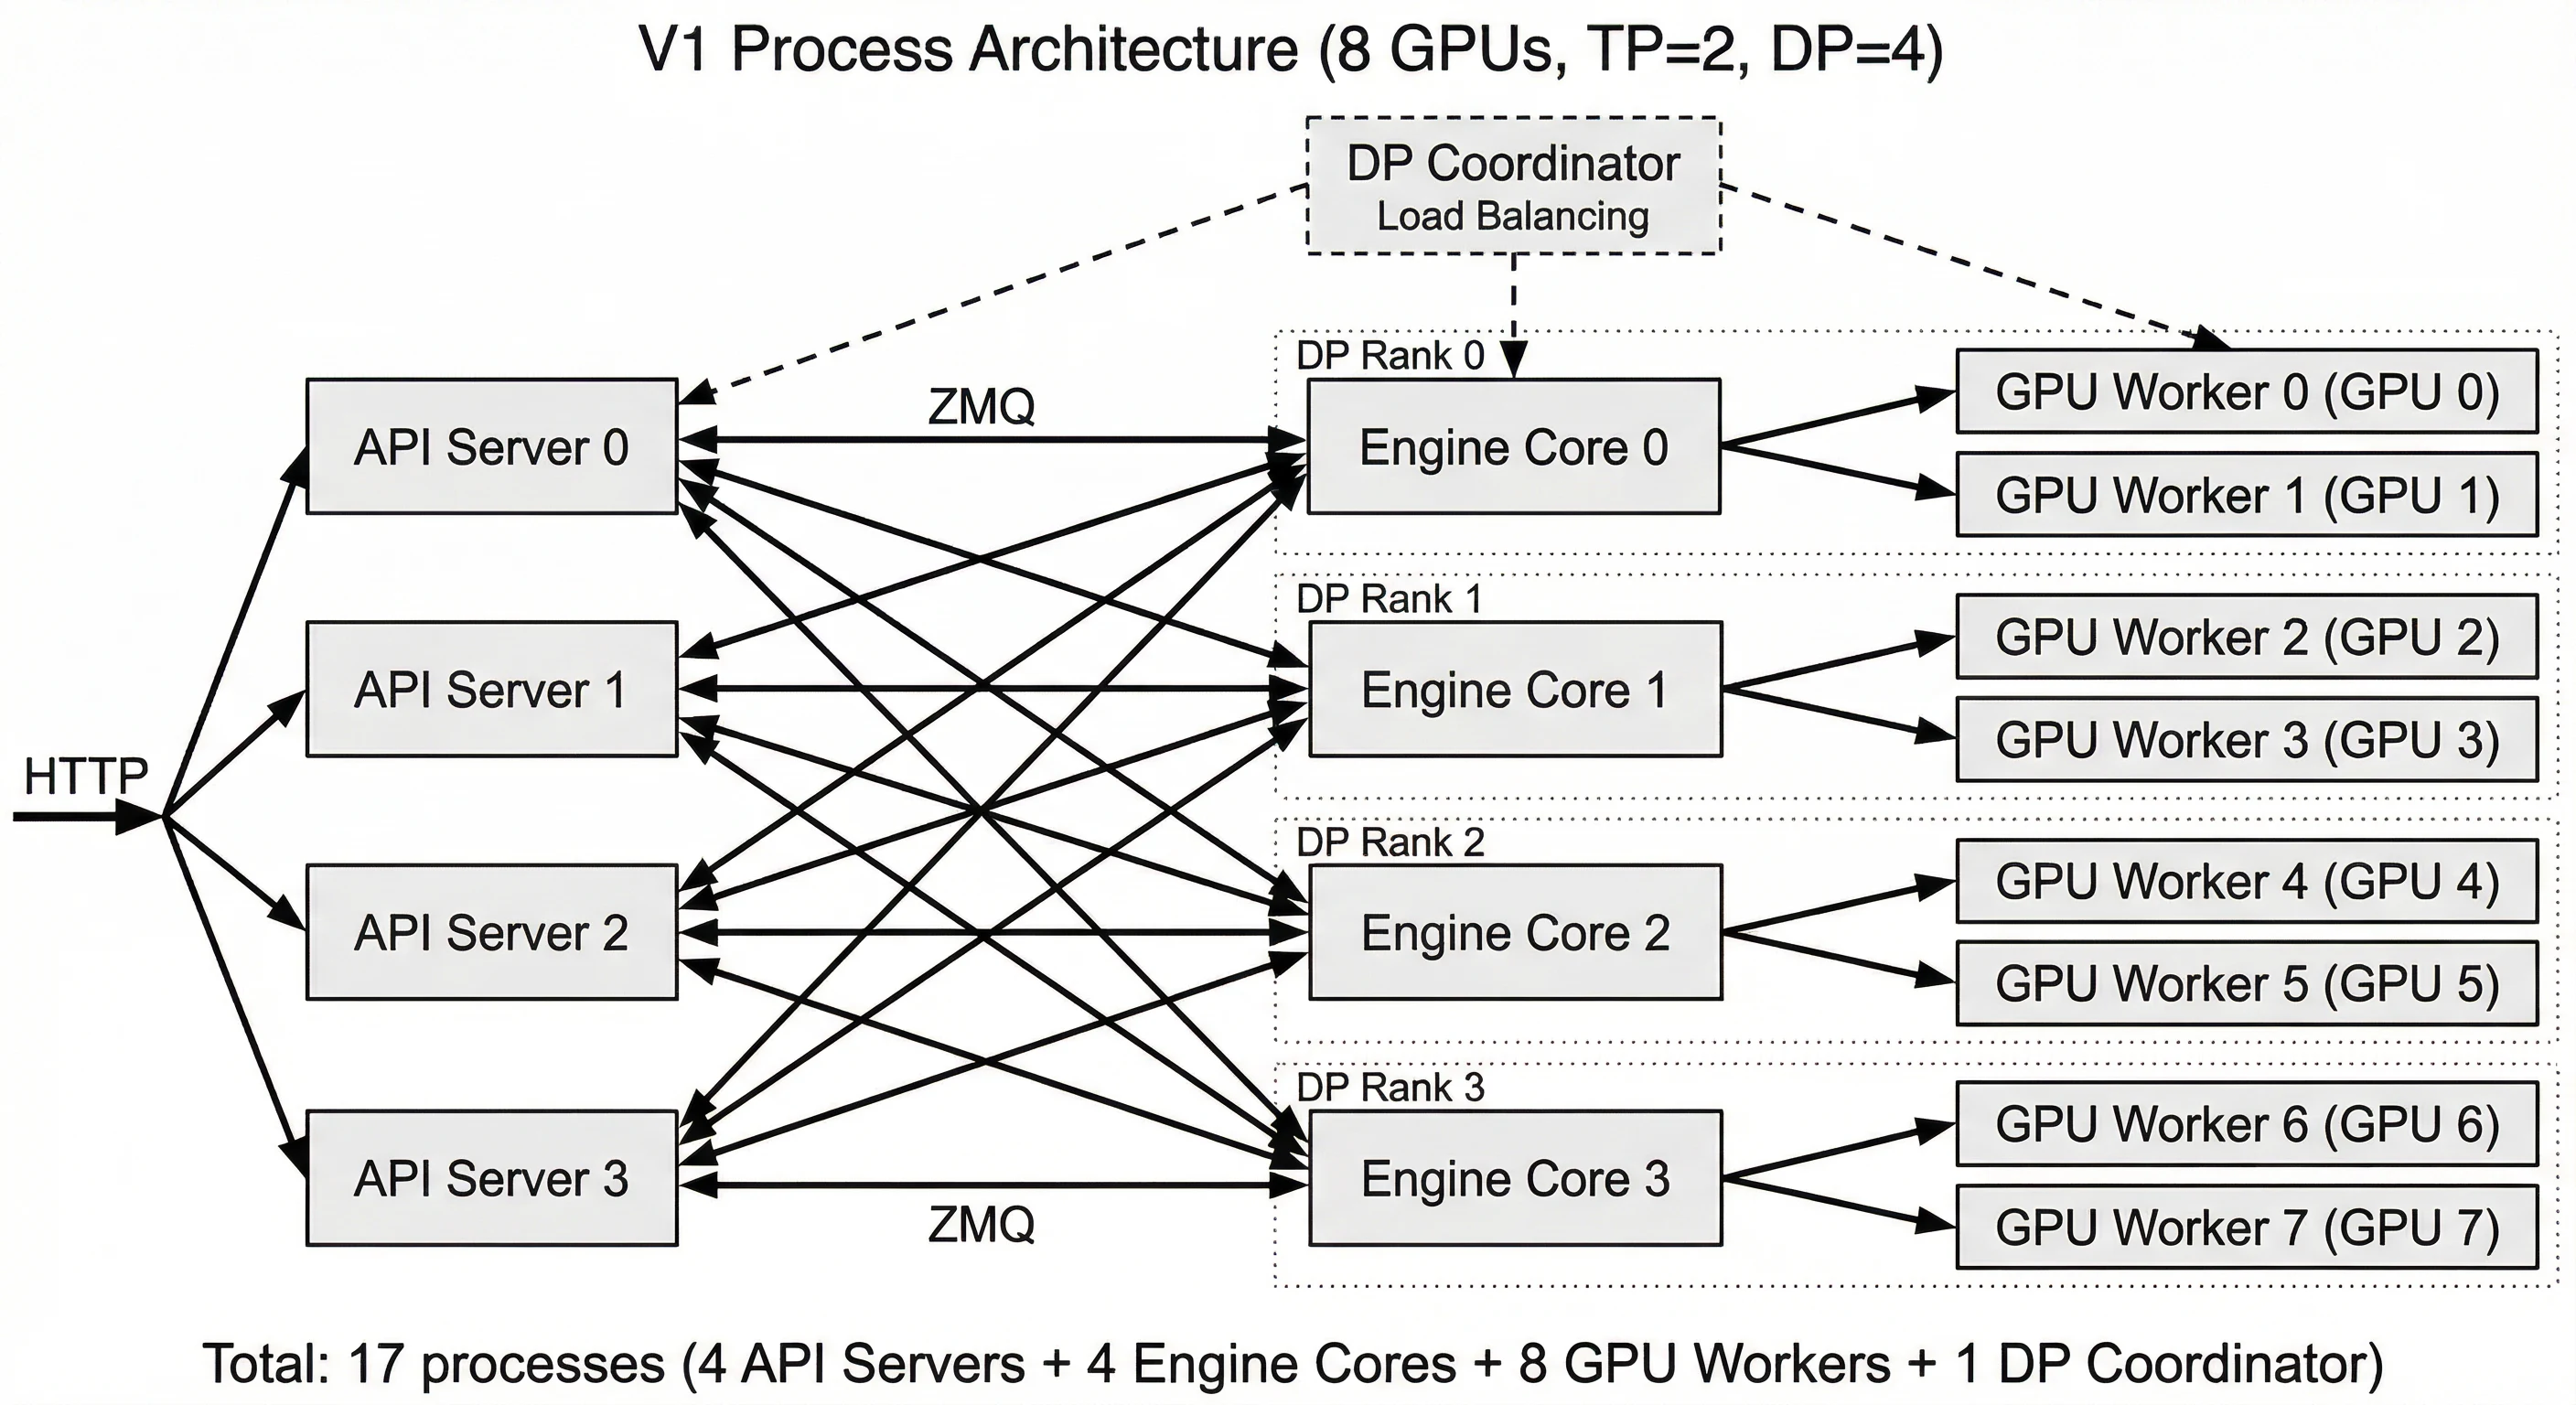
图源:vLLM 官方 Architecture Overview。图中 8 张 GPU 以 TP=2、DP=4 组织:每个 DP rank 有自己的 API server 与 EngineCore,两张 GPU 组成一个张量并行副本,另有 DP coordinator 做请求分发。由此可见,Scheduler 不是八卡共享的全局单例;每个 DP 副本分别维护排队与 KV 状态,协调层决定请求落到哪个副本。
张量并行层内的切分、all-reduce 与 Worker 执行已在 模型并行与 Worker 层 中展开。全景视角下要记住:控制消息必须在参与同一次 forward 的 rank 间一致,collective 调用顺序也必须一致;某个 rank 因条件分支少进一次 all-reduce,表现通常不是数值略偏,而是整个通信组挂起。
用一个混合批次贯穿完整调用链
构造三个同时存在的请求,才能看出各层接口为何这样设计:
- R0:已有 1024 个 KV token,常规 decode,本轮需要 1 个新 token;
- R1:2000-token prompt,前 512 token 命中前缀缓存,受 token budget 限制,本轮 prefill 256 token;
- R2:已有 600 个 KV token,携带 3 个投机草稿 token,本轮做批量验证。
假设本轮 token budget 为 260。Scheduler 可以给 R0 分配 1,给 R2 分配 3,剩余 256 给 R1。于是:
阶段一:计划生成
Scheduler 先为 R0 和 R2 的新增位置申请 KV slots,再为 R1 的 256 个 prefill 位置申请 slots。R1 已命中的 512 token 不重算,但相应 block 需要被 touch 并增加引用,避免仍在执行时被淘汰。若空间不够,Scheduler 必须在发出计划前缩减工作或抢占 victim。
SchedulerOutput 不需要携带完整 prompt 文本,而是携带 request ID、本轮 token 数、新增 block IDs、采样/投机/encoder 等变化。它是一份执行计划,不是 Scheduler 内存的序列化快照。
阶段二:Worker 合并状态
GPUModelRunner 收到计划后,将 R0/R1/R2 放入 InputBatch 的紧凑 row。它从本地 token 历史抽取本轮切片,拼出长度 260 的扁平输入,并生成:
query_start_loc = [0, 1, 257, 260]R0 的完整序列长度约为 1025,R1 本轮结束后的可见长度为 768,R2 的验证位置看到的上下文逐步增长。query_start_loc 只有本轮边界,不能替代这些完整 seq_lens。
随后 Runner 根据每个逻辑位置与 block table 生成 slot mapping。R0 和 R2 多半只触碰最后一个物理页;R1 可能跨越多个页。Attention metadata builder 再把这些公共事实转换成所选 backend 的计划。
阶段三:模型执行与 logits 选择
三个请求可在同一次模型前向中共享 GEMM 与 attention launch,但它们需要 logits 的位置不同。R0 只要一个决策位置;R1 如果只是未完成的 prompt chunk,通常不需要立刻采样;R2 需要多个验证位置。Runner 的 logits indices 从 260 个 hidden state 中选择必要行,避免无用词表投影。
如果命中 CUDA Graph 的 capture 桶,Runner 把 260 个有效 token 填入更大的静态 buffer,并用 metadata 屏蔽 padding;否则走 eager 或 piecewise compiled 路径。无论走哪条执行路径,返回的 token 与 request row 映射必须一致。
阶段四:结果提交
R0 的新 token 被追加,若未结束则下一轮仍是 running。R1 将 num_computed_tokens 从 512 推进到 768,但 prompt 尚未完成,不产生用户可见文本。R2 根据目标分布接受草稿前缀,可能接受 0 到 3 个草稿 token,并再采样一个修正 token;Scheduler 只按实际接受结果更新状态,不能把“验证过”误当成“全部接受”。
完成请求释放逻辑 KV 引用,未完成请求保留 block table。EngineCoreOutput 返回前端后,detokenizer 只处理新增输出 token;R1 本轮没有输出,不能伪造空字符串事件扰乱流式协议。至此,一轮从预算、地址、执行到输出闭环完成。
这个例子解释了为什么 vLLM 不能简单写成“把所有输入 pad 后调用模型”:请求在计算阶段、KV 历史、输出需求和附加约束上都不同,推理框架的工作就是把这些异构状态编译成一个可高效执行、又能准确还原身份的批次。
源码阅读的断点、日志与最小实验
源码阅读最好使用可复现的小模型与确定性采样。先固定 temperature=0,关闭投机、多模态、LoRA、结构化输出与远程 KV,只保留两个不同长度的文本请求。确认主干后,每次只打开一个特性。否则一次错误会同时穿过调度、metadata、Kernel 与输出四层。
先建立目录索引,再进入函数
仓库顶层的 vllm/ 不是按一条调用链排列的。模型定义、平台抽象、公共算子、V1 控制面和面向用户的入口会互相引用。第一次阅读可建立下面这份职责索引:
vllm/├── entrypoints/ # CLI、OpenAI API、离线入口├── engine/ # 部分公共引擎协议与兼容层├── v1/│ ├── engine/ # EngineCore、客户端、输出处理、IPC│ ├── core/sched/ # Scheduler、队列、SchedulerOutput│ ├── core/ # KV 管理、block pool、cache 工具│ ├── worker/ # Worker、GPUModelRunner、设备侧状态│ ├── attention/ # backend、metadata、注意力实现接口│ ├── sample/ # logits 处理、采样、logprobs│ ├── spec_decode/ # 草稿、验证与接受│ └── structured_output/ # grammar 编译与状态推进├── model_executor/│ ├── models/ # 模型结构与权重映射│ └── layers/ # 并行线性层、量化层、MoE 等└── distributed/ # 通信组与 collective目录只是导航,不是严格依赖层次。例如模型层会调用 V1 attention custom op,Runner 也会通过模型配置读取 model_executor 中的能力。判断一个类的职责时,应同时查看它的构造参数、持久字段和返回类型:构造参数说明它依赖谁,持久字段说明它拥有谁的状态,返回类型说明它向下游承诺什么。
对任何陌生子系统,都可以用“一个入口、一个状态、一个出口”的三点法快速定位。以 Scheduler 为例,入口是 schedule(),核心状态是 running/waiting 请求与 KV manager,出口是 SchedulerOutput;以 Runner 为例,入口是 execute_model(),核心状态是 Worker 侧请求镜像与静态 buffer,出口是 ModelRunnerOutput。先理解这三个点,再追辅助函数,会比从 import 列表开始逐行读更快。
阅读接口时记录所有权与生命周期
同名字段在不同对象中可能只是镜像。可以为关键数据做一张所有权表:
| 数据 | 权威所有者 | 镜像或消费者 | 生命周期终点 |
|---|---|---|---|
| 请求排队状态 | Scheduler | EngineCore 输出统计 | 请求完成或 abort |
| 逻辑 block table | KVCacheManager / Scheduler | GPUModelRunner | KV 引用释放 |
| 物理 KV tensor | Worker | Attention Kernel | Engine sleep、重配或进程退出 |
| InputBatch row | GPUModelRunner | metadata builder、sampler | row 删除或被压紧复用 |
| grammar 状态 | Scheduler / structured manager | sampler bitmask | 请求结束 |
| 增量文本状态 | OutputProcessor | 流式响应层 | 最终输出交付 |
所有权能解释更新方向。Runner 不应擅自决定请求 finished,因为它不知道 stop string;OutputProcessor 不应释放 KV,因为它不拥有物理资源;Scheduler 不应根据 detokenized 文本重新推断 token ID。若一段新代码跨过这些边界直接修改远端状态,即使暂时工作,也很可能在多进程、异步执行或 abort 路径下出错。
生命周期还解释了为什么缓存和请求状态不能一起清空。一个请求结束后,其引用计数归零,但完整 KV block 可以保留在 prefix cache 等待复用;物理内容的寿命可能长于生成它的请求。相反,InputBatch row 只是执行期槽位,它的寿命短于请求,同一请求在压紧后可能换 row。把两者都称为“请求缓存”会掩盖完全不同的回收规则。
用数据结构反推控制流
面对快速迭代的主分支,函数名称可能变化,数据契约更稳定。看到 SchedulerOutput,先列出哪些字段描述新请求、驻留请求、完成请求、scheduled token 和 block 更新;再搜索这些字段的写入与读取,就能同时找到 Scheduler 与 Runner 两端。看到 ModelRunnerOutput,同样搜索 token IDs、spec token、logprob 和 request index 的生产与消费,就能定位采样和状态提交。
这种“沿数据结构双向追踪”的方法还能发现异常旁路。如果一个特性只在 Runner 读取,却没有 Scheduler 侧对应写入,它可能依赖初始化配置而非逐请求状态;如果字段在计划中出现,却从未进入输出提交,它可能只影响执行而不改变请求状态。相比只看调用栈,这种方法更容易识别异步队列、IPC 和 callback 隔开的链路。
一套从外到内的断点顺序
| 顺序 | 断点 | 要验证的问题 |
|---|---|---|
| 1 | LLMEngine.add_request() | 参数和 token IDs 是否正确进入引擎 |
| 2 | EngineCore.add_request() | IPC 后请求身份与附加状态是否完整 |
| 3 | Scheduler.add_request() | 请求是否进入正确队列和初始状态 |
| 4 | Scheduler.schedule() | token budget、KV 分配和跳过原因是什么 |
| 5 | GPUModelRunner._update_states() | 差量是否合并到正确 request row |
| 6 | GPUModelRunner._prepare_inputs() | 输入、位置、边界与 slot 是否一致 |
| 7 | Attention metadata builder | 公共语义如何变成后端参数 |
| 8 | GPUModelRunner.execute_model() | eager/compile/graph 选择和 logits 行数 |
| 9 | Scheduler.update_from_output() | token、完成状态与 KV 释放是否提交 |
| 10 | OutputProcessor.process_outputs() | 文本 delta、stop 与 finish reason 是否正确 |
不要在高并发服务上打印完整 tensor 或完整 prompt。更有用的是记录小型结构化摘要:request ID、status、num_computed_tokens、本轮 scheduled token 数、block table 长度、batch row、query 区间、backend 名称、graph mode、输出 token 数和 finish reason。它们足够还原状态转换,又不会让日志 I/O 掩盖原始性能问题。
四组不变量比逐行单步更有效
状态不变量:waiting、running、finished 之间的迁移必须合法;完成请求不能再次调度;num_computed_tokens 不能超过当前已知 token 加待验证 token 的边界。
内存不变量:引用中的 KV block 不得出现在可覆盖集合;block table 中的页必须属于当前 cache group;slot mapping 不能越过物理池;释放只能发生在最后使用者离开之后。
批次不变量:所有以 row 为索引的列必须同步移动;query_start_loc 单调且末值等于扁平 token 数;logits index 必须落在 hidden state 范围内;输出 row 必须能映回原 request ID。
异步不变量:Future 完成前不能消费结果;grammar 未就绪时请求不能越过合法性门;abort 后迟到结果不能复活请求;跨 rank collective 的顺序必须一致。
从症状反推层级
| 症状 | 首查层级 | 常见原因 |
|---|---|---|
| 单请求正确,混合批次串输出 | InputBatch / metadata | row 压紧漏搬列,边界数组错位 |
| 短上下文正确,跨页后数值错 | KV / attention kernel | block table、slot、页布局或 mask 错 |
| eager 正确,CUDA Graph 错 | 编译与捕获 | 静态 buffer 未刷新,capture 桶 metadata 错 |
| 输出多出 stop string 前缀 | OutputProcessor | hold-back 长度或增量解码状态错误 |
| 前缀缓存命中后答案变化 | cache key / block 生命周期 | LoRA/MM 身份漏入哈希,块被提前覆盖 |
| 多卡挂起而 GPU 利用率为零 | Executor / collective | rank 分支不一致,collective 次序不同 |
| TTFT 突然升高但 decode 正常 | Scheduler / prefill | 大 prefill 未分块,encoder 或 grammar 阻塞 |
性能分析也应分层。API 排队时间、Scheduler CPU 时间、H2D metadata 拷贝、模型 forward、采样 D2H 和 detokenize 是不同账本。只看端到端延迟无法判断优化对象;只看 GPU Kernel 又可能忽略 CPU 无法及时发射下一轮。可以结合 GPU 推理性能分析完全指南中的 torch.profiler、Nsight Systems 与 Nsight Compute 路线,先用系统时间线找空洞,再进入具体 Kernel。
vLLM 部分的路线收束与下一站
十五篇机制现在可以压成一条稳定主线:前端把用户语义收敛为 Core 请求;Scheduler 把长期状态编译成短期 SchedulerOutput;KVCacheManager 在执行前兑现内存;GPUModelRunner 把异构请求压成紧凑 tensor 与 metadata;Attention Backend 把公共语义翻译成 Kernel ABI;Sampler 和 update_from_output() 提交 token;OutputProcessor 最终履行流式文本与停止语义。
读懂 vLLM 不等于记住某个版本的类名和行号。真正可迁移的知识是边界:计划和状态分离、逻辑页和物理 tensor 分离、请求身份和 batch row 分离、token 停止与字符串停止分离、控制面和设备数据面分离。源码重构会移动函数,却很难取消这些约束。
至此,vLLM V1 的核心请求主干已经闭环。LoRA、KV Connector、平台插件、池化模型等专用分支仍可各自深入,但不再阻碍沿完整链路定位代码。下一篇进入 SGLang 前,会先发布框架总览:画清 Runtime、TokenizerManager、Scheduler、ModelWorker、RadixAttention 与前端 DSL 的职责边界,再以 vLLM 这张地图为基线比较两套系统在哪里采用了相同抽象,在哪里选择了不同的缓存与调度语义。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


