


vLLM 源码完全拆解(九):Sampler——从 Logits 到 Token 的采样管线与输出回传
背景:模型 forward 结束了,然后呢?
vLLM 源码完全拆解(五):GPUModelRunner 曾经给出过 execute_model() 的主干骨架:构造 InputBatch → 准备 attention metadata → model forward → compute_logits()。第八篇走完了 MoE 层在 forward 中的完整路径。如果模型是 Dense Transformer,在最后一层 Transformer Block 之后会直接产出 hidden states;如果是 MoE 模型,hidden states 穿过共享专家和路由专家后才出来。
无论哪种变体,GPUModelRunner.execute_model() 的下一步都是同一件事:把 hidden states 的最后一个位置(decode)或每个有意义的 token 位置(prefill)对应的 hidden state 取出来,经过 lm_head(或者 compute_logits)投影到词表维度,得到一个形状为 [num_tokens, vocab_size] 的 logits 张量。
然后呢?logits 是一个稠密向量——每个位置上有 vocab_size(典型 32000 到 152064)个浮点数。引擎最终需要的是一个整数 Token ID(如 2947),以及可选的对该 token 的 log 概率。把 [num_tokens, vocab_size] 的浮点矩阵变成 num_tokens 个整数,这个步骤就叫 Sampler。
听起来简单(取 argmax 不就行了),但实际生产级 Sampler 要同时处理:
- 多请求异构参数:同一个 batch 里请求 A 用 temperature=0.7 做随机采样,请求 B 用 temperature=0 做 greedy,请求 C 要求 top_k=40 + top_p=0.95,请求 D 可能还配置了频率惩罚和结构化输出约束
- logprobs 计算:不仅返回采样的 token,还要返回该 token 的 log 概率,以及可选地返回前 K 个 token 的 log 概率(prompt logprobs 或 generated logprobs)
- GPU 端执行:在 GPU 上直接完成所有处理,避免把
vocab_size × num_tokens的 logits 回传 CPU——这个体积对 128K 词表来说太大了 - CUDA Graph 兼容:采样结果的位置和形状必须固定,不能因为不同 step 采出不同数量的 token 而改变 tensor shape
本文聚焦 vLLM V1 的 Sampler 实现,沿 vllm/v1/sample/ 下的源码路径,拆解从 logits 到 token 的完整管线。阅读基线同样固定在前几篇使用的 vLLM main 分支提交 3b4566c5。
Sampler 在 vLLM V1 架构中的位置
回顾第二篇到第八篇已经走通的链路:
EngineCore.step() → Scheduler.schedule() # 决定本轮哪些请求跑、每个跑几个 token → Scheduler.update_from_output() # 用上一轮的 sampler 输出更新请求状态 → GPUModelRunner.execute_model() → _update_states() # 把调度输出合并到 InputBatch → _prepare_inputs() # 构造 input_ids、positions、attention metadata → self.model.forward() # Transformer forward(含 Attention + MoE) → self.model.compute_logits() # hidden states → logits → self.sampler.sample() # ★ logits → tokens最后一步 self.sampler.sample() 返回的 SamplerOutput 会被 execute_model() 带回 EngineCore,在下一轮 step() 开头通过 update_from_output() 注入调度器。整个引擎的控制环才算闭合。
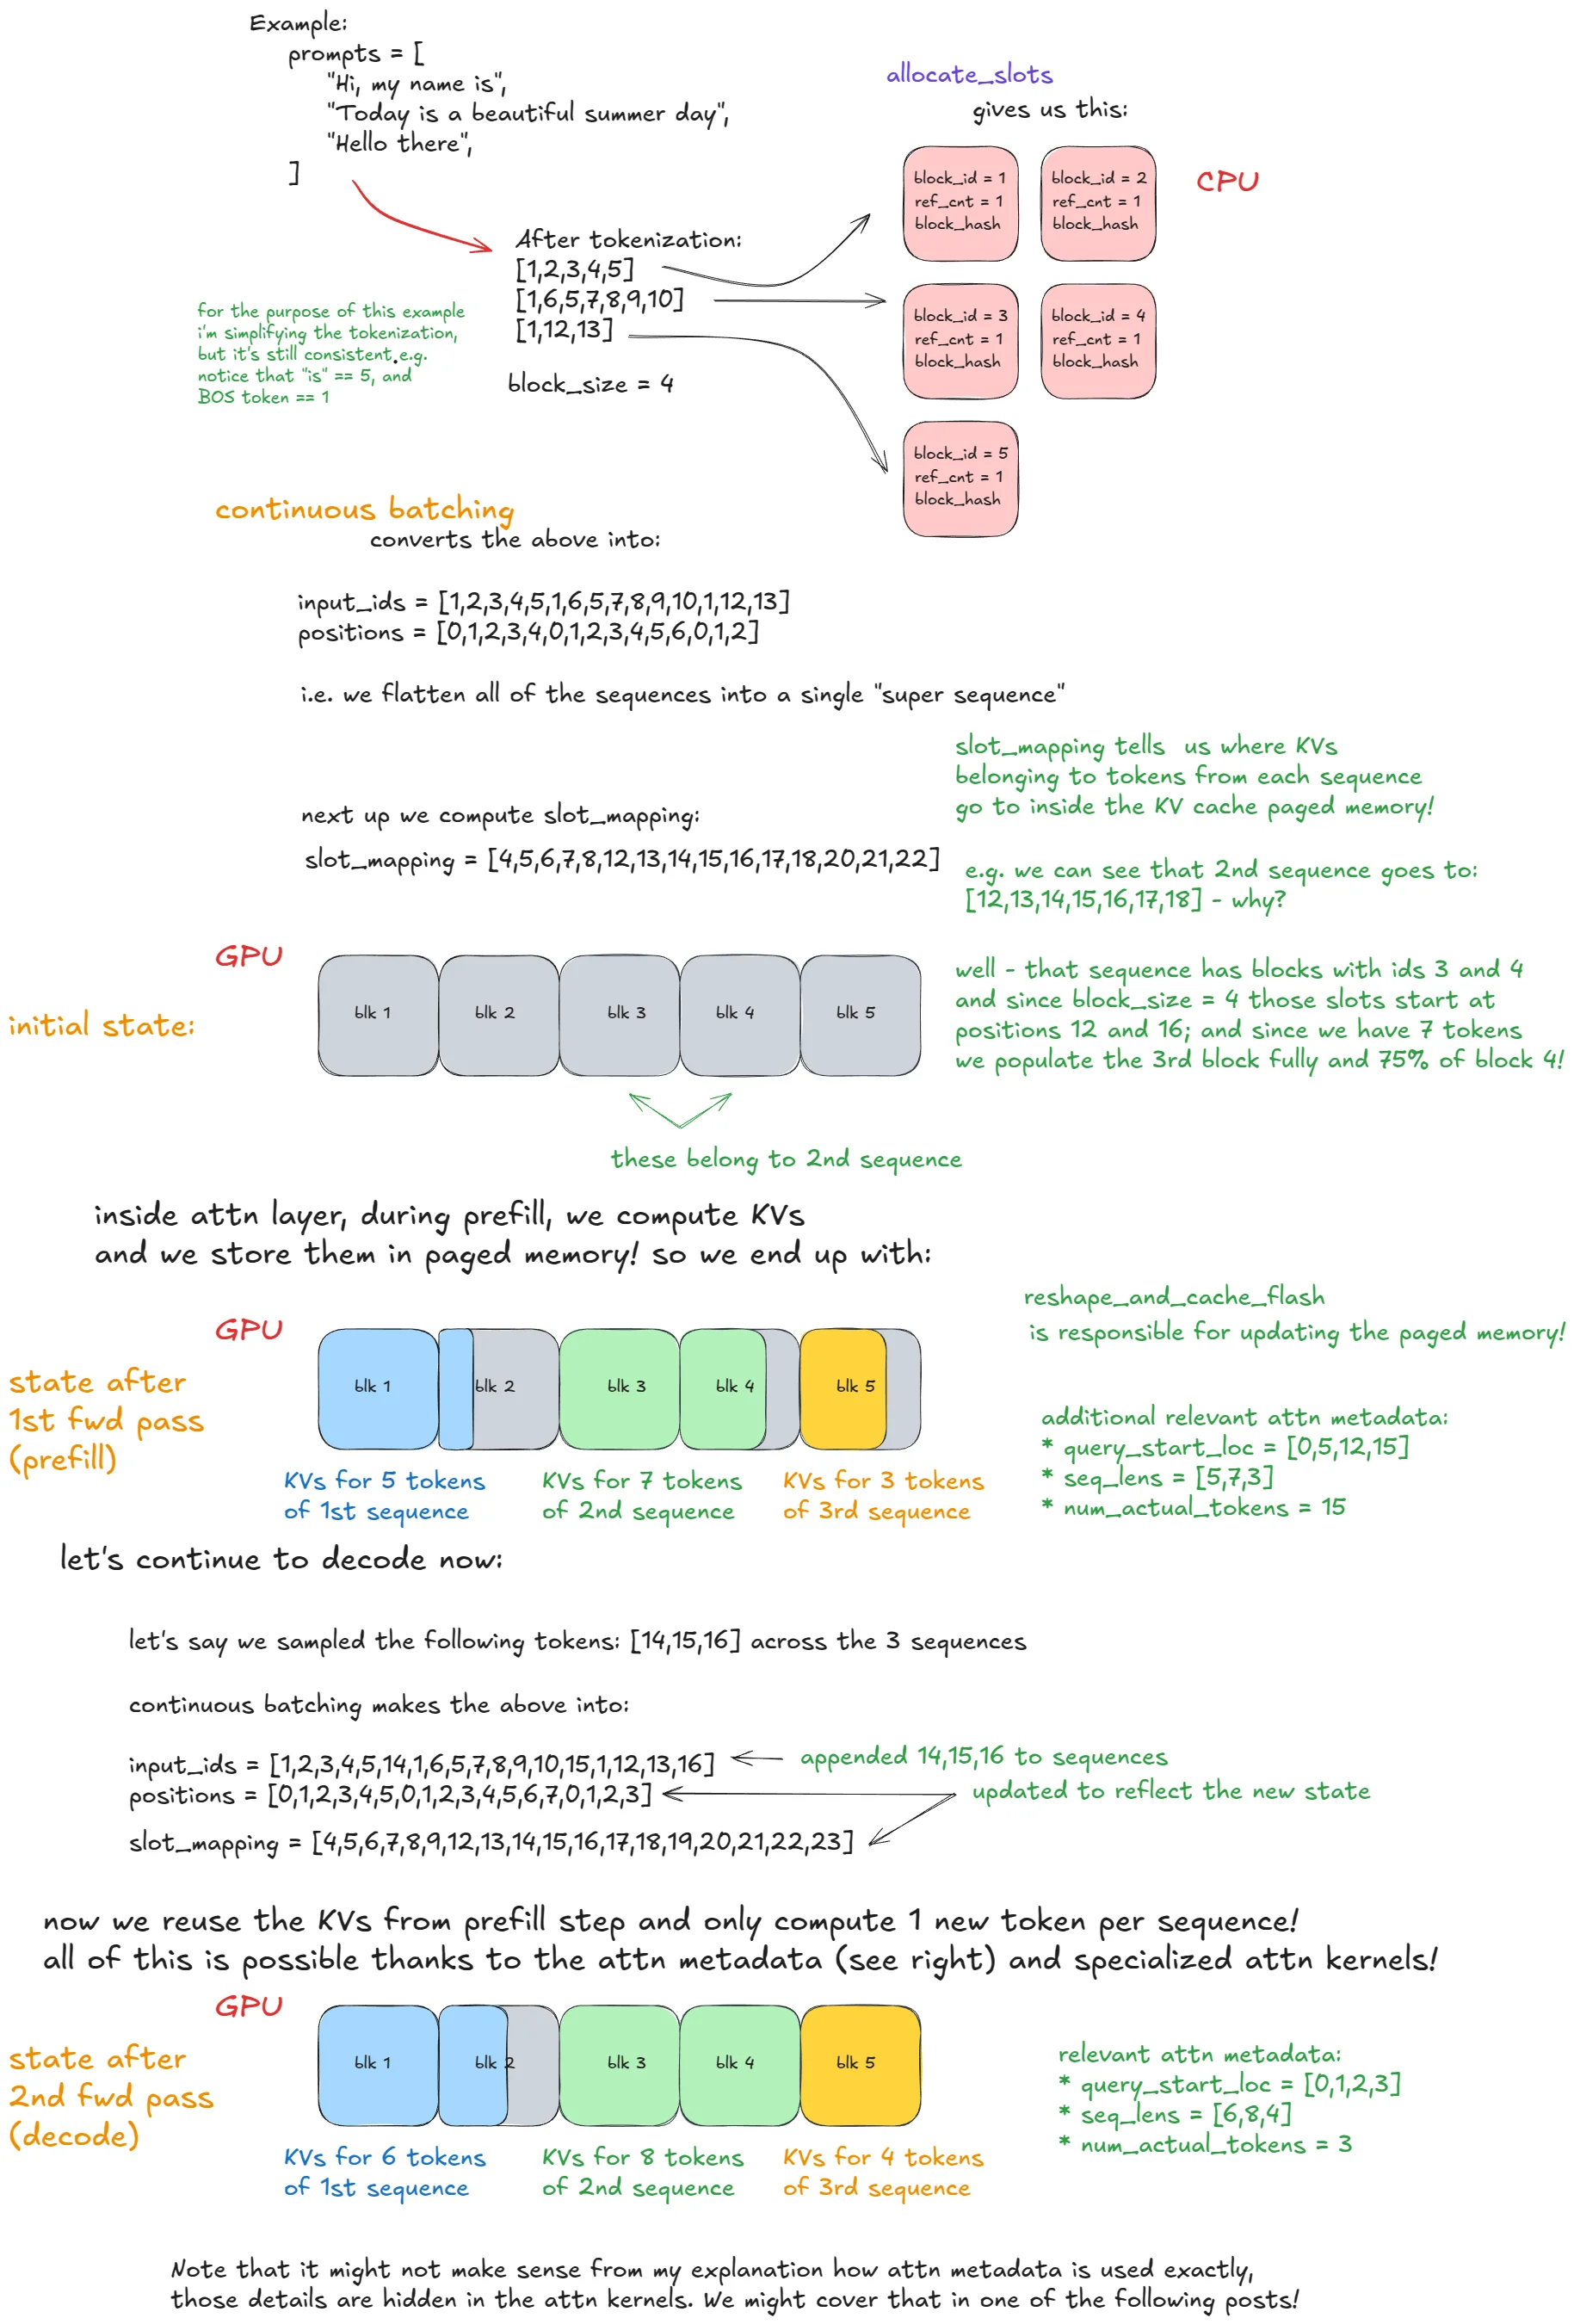
vLLM V1 的 forward pass 流程(来源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System)。橘色虚线框标注了本文聚焦的采样管线:模型 forward 产出 logits 后,Sampler 通过 LogitsProcessor 管线(温度、Top-K、Top-P、Min-P、惩罚项)处理,最终将采样结果送给 Scheduler 闭环。理解这张图的关键是注意到 logits 从 compute_logits() 出来时形状仍是 [num_tokens, vocab_size],整个 Processor 管线在 GPU 端原地完成,只有精简后的 token ID 和 logprobs 通过异步 D2H 传回 CPU。
Sampler 不是一个孤立的函数调用。在 V1 源码中,vllm/v1/sample/ 是一个独立目录,包含:
| 文件 | 职责 |
|---|---|
sampler.py | Sampler 主类,持有 LogitsProcessor 列表并执行采样 |
logits_processor/ | 各种 logits 处理器(temperature、top-k、top-p、min-p、penalties 等) |
metadata.py | SamplingMetadata:把请求级 SamplingParams 打包成 GPU 能消费的张量 |
rejection_sampler.py | 投机解码的拒绝采样路径(本篇不展开,留到投机解码专项) |
structured_output/ | 结构化输出约束(grammar、JSON schema 等) |
GPUModelRunner 在构造时持有 Sampler 实例:
# 伪代码:GPUModelRunner 初始化self.sampler = Sampler( logits_processors=create_logits_processors(...), sampler_output_copy_stream=Stream(), # 用于异步 D2H 传输 logprobs ...)每次 execute_model() 末尾,Sampler.sample() 被调用:
# 伪代码:execute_model 末尾logits = self.model.compute_logits(hidden_states[logits_indices])sampled_tokens = self.sampler.sample( logits=logits, sampling_metadata=self.input_batch.sampling_metadata, top_m_logprobs=self.input_batch.top_m_logprobs,)返回的 sampled_tokens 是 SamplerOutput 类型,包含:
class SamplerOutput: sampled_token_ids: torch.Tensor # [num_tokens] 每个 token 位置的采样结果 logprobs_tensors: LogprobsTensors | None # 可选的 log 概率 kv_connector_output: dict | None # KV Connector 的输出(跨实例 KV 传输路径)下面分五步拆解这个管线的每一层。
第一步:SamplingMetadata——把异构请求参数打包成 GPU 张量
为什么需要 SamplingMetadata
在 vLLM 的一轮 step 中,batch 里可能同时存在十几个甚至几十个请求。每个请求有自己的 SamplingParams,包括:
class SamplingParams: temperature: float = 1.0 # 温度参数(0 表示 greedy) top_k: int = -1 # Top-K 过滤(-1 表示禁用) top_p: float = 1.0 # Top-P 过滤(1.0 表示禁用) min_p: float = 0.0 # Min-P 过滤 frequency_penalty: float = 0.0 # 频率惩罚 presence_penalty: float = 0.0 # 存在惩罚 repetition_penalty: float = 1.0 # 重复惩罚 seed: int | None = None # 随机种子 max_tokens: int = 16 # 最大生成 token 数 stop: str | list[str] | None # stop strings stop_token_ids: list[int] | None logprobs: int | None = None # 返回多少个 logprobs ...不同请求的这些参数几乎不可能完全一致。设想一个场景:请求 A(聊天补全,temperature=0.7,top_p=0.9),请求 B(代码补全,temperature=0,greedy),请求 C(创意写作,temperature=1.2,top_k=50)。Sampler 需要在 GPU 上一次性执行所有三个请求的采样,但每个请求又需要不同的 logits 处理方式。
直接把每一份 SamplingParams 传给 GPU Kernel 是不可行的——Kernel 无法接受 Python 对象的动态列表。vLLM 的解决方案是 SamplingMetadata:把所有请求的采样参数打包成一组等长张量(每请求一个标量,[batch_size] 形状),让 GPU Kernel 按索引读取对应请求的参数。
SamplingMetadata 的结构
在 V1 中,SamplingMetadata(位于 vllm/v1/sample/metadata.py)的核心字段如下:
@dataclassclass SamplingMetadata: temperature: torch.Tensor # [batch_size] float32 top_k: torch.Tensor # [batch_size] int32 top_p: torch.Tensor # [batch_size] float32 min_p: torch.Tensor # [batch_size] float32
frequency_penalty: torch.Tensor # [batch_size] float32 presence_penalty: torch.Tensor # [batch_size] float32 repetition_penalty: torch.Tensor # [batch_size] float32
seed: torch.Tensor # [batch_size] int64 max_tokens: torch.Tensor # [batch_size] int32
all_greedy: bool # 是否所有请求都是 greedy no_penalties: bool # 是否所有请求都没有惩罚项
# 输出规格 output_token_ids: list[list[int]] # 每个请求已经生成的 token ID(用于重复惩罚计算)
# 惩罚相关的 bookkeeping prompt_token_ids: torch.Tensor | None # prompt 的 token ID(已扁平化) num_prompt_tokens: torch.Tensor | None # 每个请求的 prompt token 数注意 all_greedy 和 no_penalties 两个标志——它们是 vLLM 的快速路径优化。如果所有请求都是 temperature=0(greedy),Sampler 可以直接走 argmax,跳过随机数生成、top-k/top-p 排序等昂贵操作。如果没有任何惩罚项,就跳过频率/存在/重复惩罚的 logits 修正——在典型的生产场景中这非常常见。
如果所有请求的 temperature 为 0 且没有惩罚项,Sampler 可以只用一次高效的 argmax Kernel 完成全部采样。
SamplingMetadata 从哪来
SamplingMetadata 的构造发生在 GPUModelRunner 的输入准备阶段。每次有新的调度输出时,InputBatch 中增删请求,SamplingMetadata 被更新为当前活跃请求的参数打包:
# 伪代码:SamplingMetadata 的更新逻辑def _update_sampling_metadata(self, input_batch): req_ids = input_batch.req_ids # 当前活跃的请求 ID 列表 sampling_params = [self.requests[r].sampling_params for r in req_ids]
self.sampling_metadata.temperature = tensor([ sp.temperature for sp in sampling_params ]) self.sampling_metadata.top_k = tensor([ sp.top_k for sp in sampling_params ]) self.sampling_metadata.all_greedy = all( sp.temperature == 0 for sp in sampling_params ) # ... 其他字段类似all_greedy 是引擎快速判断时常用的优化位。在生产中,大量请求(特别是代码补全、指令遵循)使用 temperature=0,这使得 argmax 路径成为默认热路径。
第二步:LogitsProcessor——管线式处理与五种关键变换
logits 刚从 compute_logits() 出来时,是未经处理的原始分数(raw scores)。Sampler 把它们按顺序喂给一组 LogitsProcessor。每个 Processor 接收 (logits, sampling_metadata),原地修改 logits 张量(或返回修改后的拷贝),然后将结果交给下一个 Processor。
这条管线的设计遵循一个原则:所有操作都在 GPU 上原地完成。任何一步把数据搬回 CPU 都会破坏 CUDA Graph 的捕获能力、引入同步点。logits 的形状在整个管线中保持不变([num_tokens, vocab_size]),只有数值被逐层变换。
管线架构
在 vllm/v1/sample/logits_processor/ 下,每种变换被实现为一个独立的类,都遵循统一的接口:
class LogitsProcessor(ABC): @abstractmethod def apply(self, logits: torch.Tensor, sampling_metadata: SamplingMetadata) -> torch.Tensor: ...Sampler 内部维护一个有序的 Processor 列表,采样时按序调用:
# Sampler.sample() 中 LogitsProcessor 管线的调用def _apply_logits_processors(self, logits, sampling_metadata): for processor in self.logits_processors: logits = processor.apply(logits, sampling_metadata) return logits处理顺序经过精心选择,以保证数学正确性和数值稳定性。接下来逐个拆解每种核心变换。
2.1 Temperature(温度缩放)
作用:把所有 logits 除以 temperature,控制 softmax 后分布的尖锐程度。
给定 temperature 和原始 logits ( 为词表大小),
当 时,最大的 logit 被无穷放大——等效于 argmax(greedy decoding)。当 时,保持原始 logits。当 时(如 ),logits 之间的差异被压缩,softmax 后的分布更平滑,采样更多样。
实现细节:temperature 缩放是最简单的变换,只是一个逐元素除法。但在批量异构场景中,不同请求需要不同的 temperature,而 logits 是 [num_tokens, vocab_size] 的连续张量——不能简单的一个 batch 一个除法。
vLLM 的解决方式是把每个请求的 temperature 广播到它在本轮中占用的 token 数:
# 伪代码:Temperature 的批量应用def apply_temperature(logits, sampling_metadata): # temperatures_per_token: 从 sampling_metadata.temperature # 按 query_start_loc 扩展到每个 token temps = temperatures_per_token # [num_tokens] logits.div_(temps.unsqueeze(-1)) # 广播到 vocab_size 维度 return logits当 sampling_metadata.all_greedy 为 True(所有 temperature=0)时,这一步骤被跳过——不是因为”等于 1”,而是因为 greedy 路径根本不需要经过 processor 管线,直接走 argmax。
为什么 不能直接除:除零显然无效。vLLM 对 temperature=0 的处理是进入独立的 greedy 路径,完全不经过 temperature processor。
2.2 Top-K 过滤
作用:只保留 logits 中最大的 K 个值,其余设为 (在 softmax 中等效于概率为 0)。
算法(对每个 token 位置独立执行):
- 找到 logits 中第 K 大的值(通过
torch.topk(logits, k).values[:, -1:]) - 构造 mask:
logits < threshold logits[mask] = -inf
为什么是 而不是 0:直接设 0 在 softmax 后仍然会获得非零概率——,在所有 的和中占据一定份额。只有 能让 ,彻底排除该 token。
批量异构 Top-K:不同请求有不同的 K 值。vLLM 需要为每个 token 位置取对应的 K,计算各自的阈值,然后单独 mask:
# 伪代码:批量异构 Top-Kdef apply_top_k(logits, sampling_metadata): k_per_token = sampling_metadata.top_k_per_token() # [num_tokens] # 在 CUDA/Triton kernel 中为每个 token 找它的第 K 大值 thresholds = compute_per_token_topk_threshold(logits, k_per_token) mask = logits < thresholds.unsqueeze(-1) logits.masked_fill_(mask, float("-inf")) return logits当某请求的 top_k <= 0 时,该 token 位置跳过 Top-K 过滤。
2.3 Top-P(Nucleus Sampling)
作用:从概率最高的 token 开始累加,保留直到累积概率达到 p 的最小集合。由 Holtzman 等人于 2020 年在 ICLR 论文中提出。
算法(对每个 token 位置独立执行):
- 对 logits 做 softmax 得到概率分布
- 按概率降序排列
- 计算累积概率:
- 保留满足 的最小的 个 token
- 其余 token 的 logits 设为
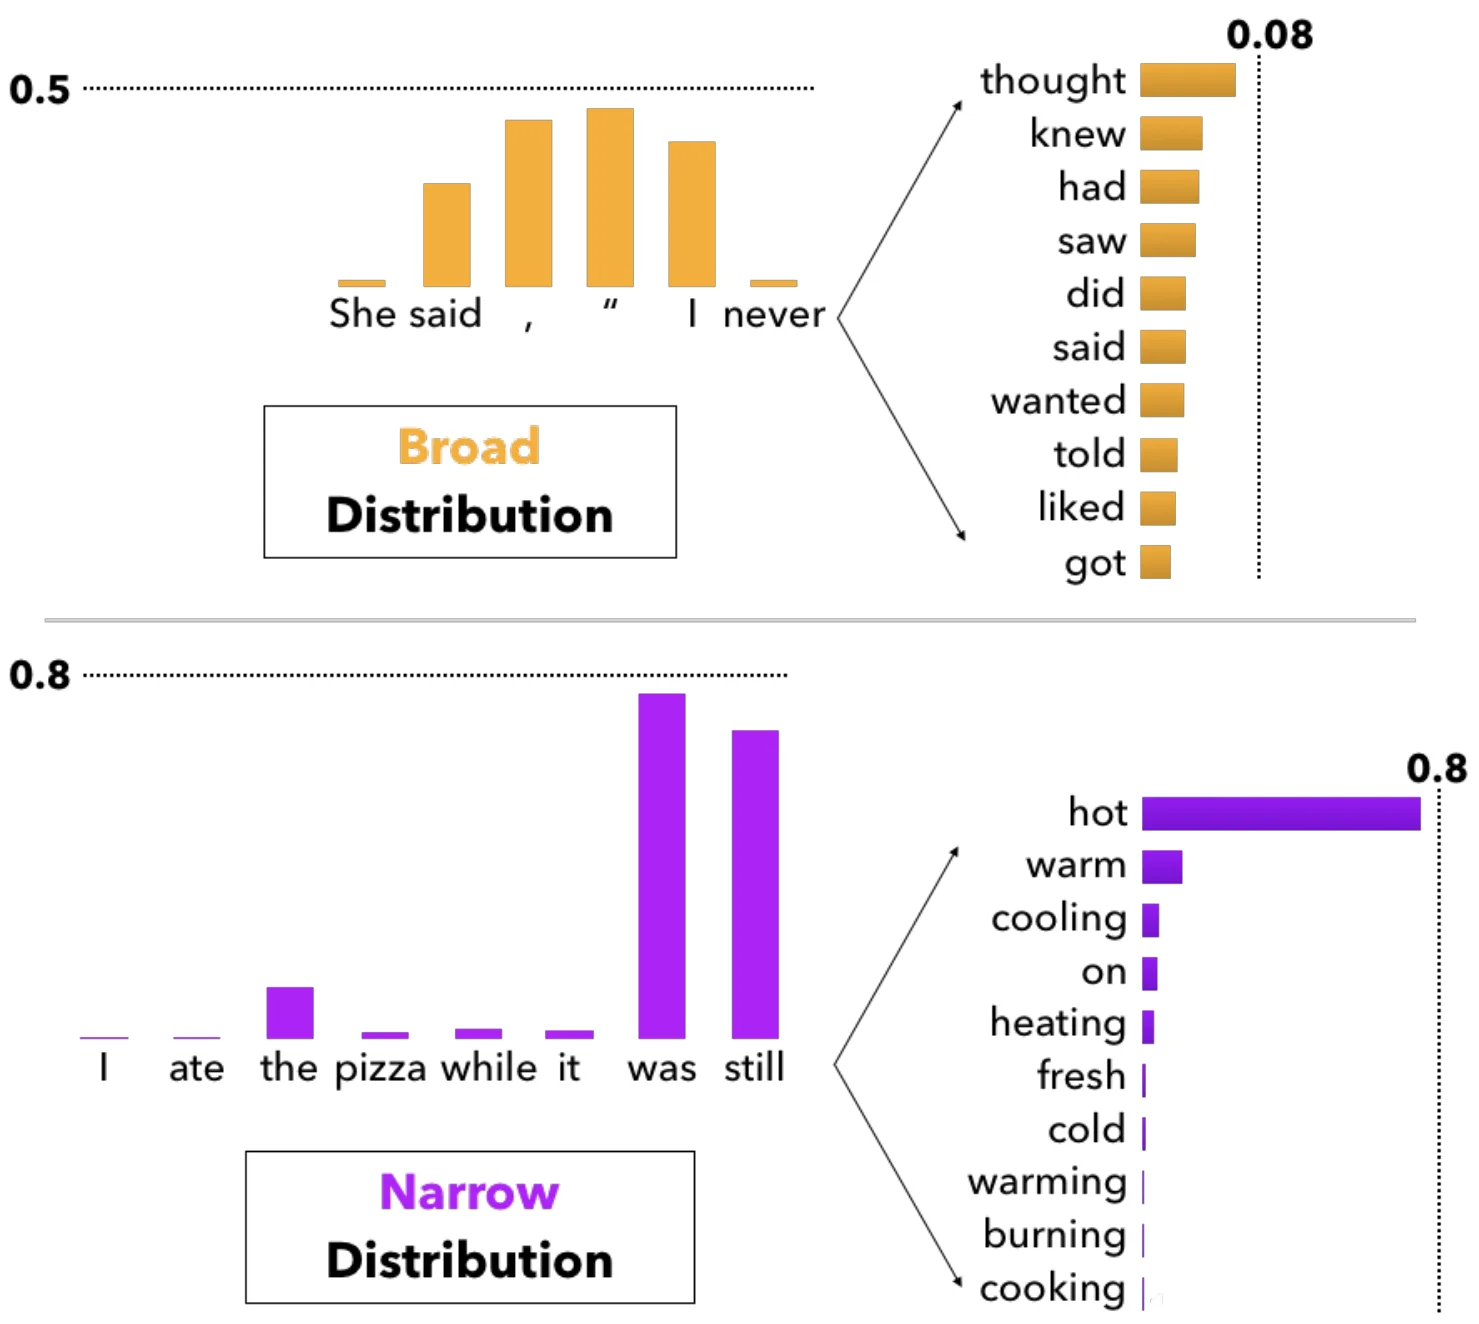
与 Top-K 的关键区别:Top-K 是固定绝对数量的硬截断——无论分布是陡峭还是平坦,都只留 K 个。Top-P 是动态的自适应截断——如果头部 token 概率集中(如第一个 token 就占 0.85),可能只留 1-2 个;如果分布平坦,可能需要留几十个才能凑够 p=0.95。这使 Top-P 比 Top-K 更适应不同的采样场景。
Top-P 核采样概念图(来源:The Curious Case of Neural Text Degeneration,ICLR 2020)。不同上下文中的 softmax 概率分布差异巨大——左侧上下文中模型高度确定(前两个 token 就占绝大多数概率,Top-P 只需小核),右侧上下文则高度不确定(概率分布平坦,Top-P 需要大核才能覆盖相同累积概率)。这正是 Top-P 相比 Top-K 的优势:Top-P 的自适应核大小可以匹配上下文的不确定性程度,而不像 Top-K 一刀切地保留固定数量。
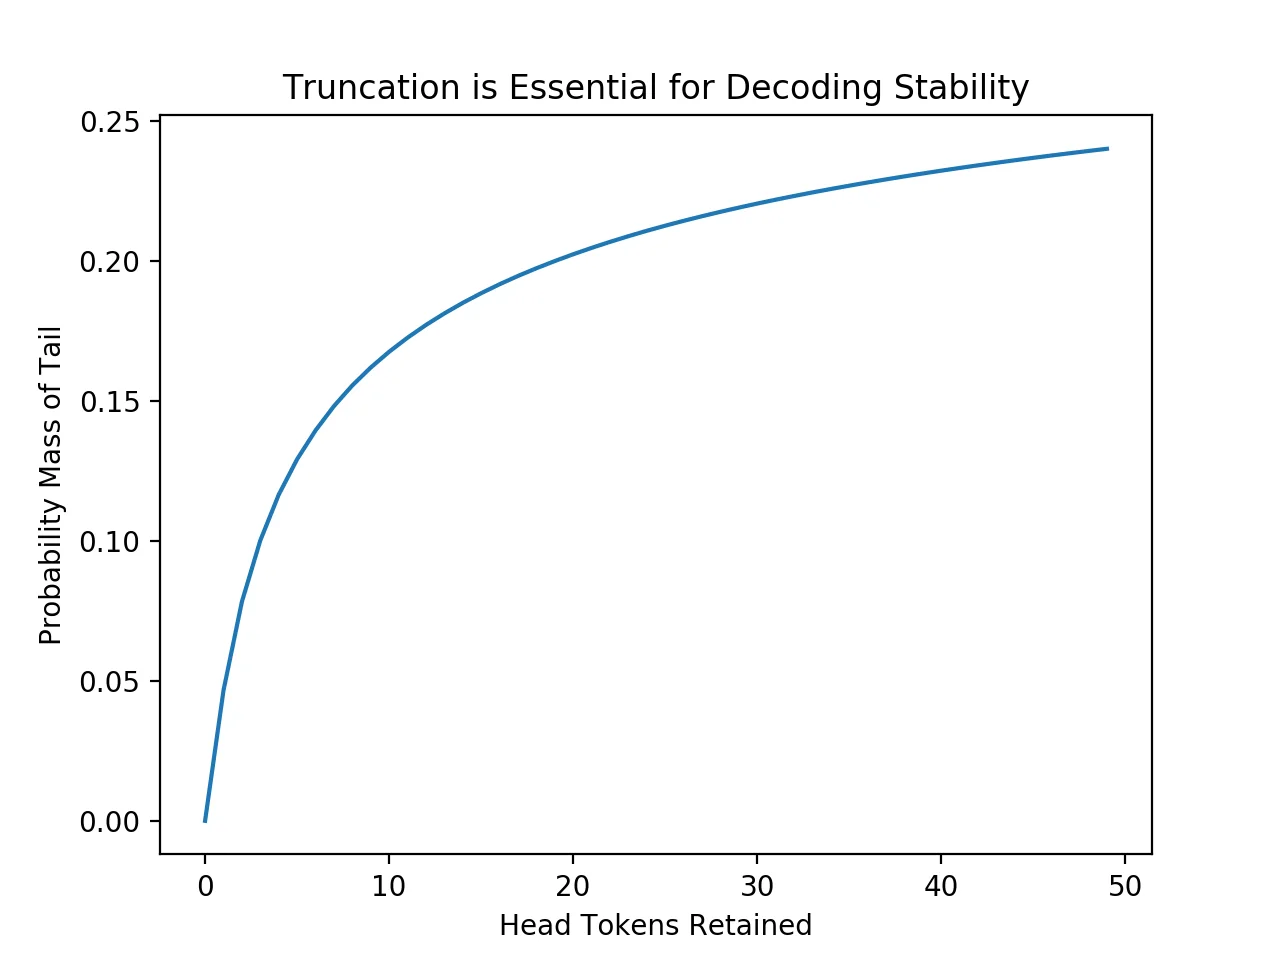
Tail Mass 示意图(来源:The Curious Case of Neural Text Degeneration)。绿色曲线标注 Top-K=50 时保留的概率质量分布,红色曲线标注被 Top-K 截掉的尾部分布(Tail Mass)。当模型的输出分布非常平坦时(红色面积很大),Top-K 的恒定截断会丢掉大量合理的候选 token——这些 token 本该有被采样到的机会。这就是 Top-P 用累积概率而非绝对排序数来决定截断边界的根本动机。
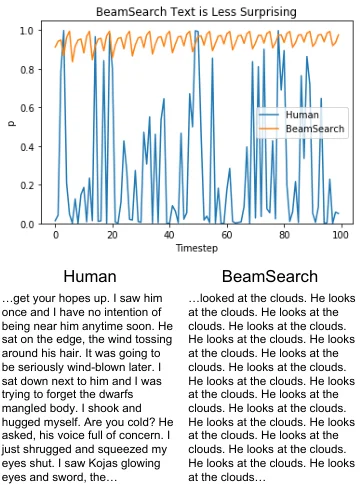
Top-P 在自然语言生成中的效果(来源:The Curious Case of Neural Text Degeneration)。当模型在若干候选 token 间存在不确定性时(如图中紫色节点所示),Top-P 保留足够多的分支让采样可以自然选择,而贪婪解码或低 Top-K 会过早确定路径,导致生成的文本陷入「重复-无意义」的模式。这张图直观解释了为什么 Top-P 核采样能产生比贪婪解码更自然、更多样的文本。
批量实现:GPU 上的高效实现需要 batch-level 排序——将所有 [num_tokens, vocab_size] 的 logits 降序排列,然后在最后一个维度上累积 softmax 概率,找每个位置的截止点。
2.4 Min-P
作用:只保留概率不低于”最大概率的 p 倍”的 token。即,如果最高概率是 ,则保留所有 的 token。
算法:
- 对 logits 做 softmax 得到概率分布
- 找到最大概率
- 构造 mask:
logits[mask] = -inf
为什么需要 Min-P:Top-K 和 Top-P 有各自的盲区。Top-K 在分布极陡时割掉可能有用的 token,在分布极平时保留太多噪声。Top-P 解决了”分布平坦”的问题,但有另一个问题:如果前 10 个 token 的概率加到一起都不够 p,Top-P 不得不保留大量极低概率的噪声 token。Min-P 的思路完全不同——不是从高往低累加,而是用最高概率做标杆,相对太低的全部砍掉。
当某请求的 min_p <= 0 时,该 token 位置跳过 Min-P。
2.5 惩罚项:频率惩罚、存在惩罚与重复惩罚
这三项操作的目标都是抑制重复生成。模型在生成长文本时有一种倾向——在某些位置反复输出同样的词或短语。惩罚项通过修改 logits 来让已经出现过的 token 更难被再次选中。
频率惩罚(Frequency Penalty):
其中 是 token 在已经生成的 token 中出现的次数, 是频率惩罚系数。出现次数越多,惩罚越重。
存在惩罚(Presence Penalty):
只要 token 至少出现过一次,就扣除固定惩罚值 。不同于频率惩罚的是,出现 100 次和出现 1 次的惩罚量相同。
重复惩罚(Repetition Penalty):
与存在惩罚不同,重复惩罚是乘法而非减法——已出现 token 的 logits 被除以 ( 时降低概率)。这导致惩罚量的语义是”概率缩小多少倍”而非”扣除多少分”,对大 logit token 和小 logit token 的惩罚更均匀。
批量实现中的 bookkeeping:计算每个 token 的出现次数需要在 GPU 上维护一个计数表。SamplingMetadata 中的 output_token_ids(每个请求已生成的 token 列表)是这项计算的数据源。vLLM 会将每个请求的已生成 token 做 bincount 得到出现次数,然后根据每个 token 位置上对应请求的计数表来修改对应行的 logits。
当 sampling_metadata.no_penalties 为 True 时,整个惩罚计算链被跳过。
处理器顺序与设计动机
vLLM 的 LogitsProcessor 管线按以下顺序执行:
- Penalties(频率/存在/重复惩罚)——在对数空间做加减/缩放,数值安全
- Temperature——缩放整个 logits 向量的幅度
- Min-P——需要先有 softmax 才知道 ,但 Min-P 后仍可应用 Top-K/Top-P
- Top-K——绝对值截断,不影响 softmax 的计算
- Top-P——最后一步累积概率过滤
这个顺序的关键考量:惩罚项必须在 temperature 之前——如果先做 temperature 再做 penalty, 已经把 logits 推向 和 两极了,penalty 失去意义。Top-K 和 Top-P 放在最后是因为它们本质上是”softmax 后再过滤”——先让所有数值处理完成,再做最终的概率取舍。
第三步:采样——greedy 快速路径与随机采样
经过 LogitsProcessor 管线后,logits 已经变成了”可采样分布”。接下来要实际从这些分布中抽取 token。
3.1 Greedy(Temperature=0)路径
当 sampling_metadata.all_greedy 为 True 时,所有请求都使用 temperature=0。此时不需要做 softmax——直接找 logits 中最大值的索引即可:
# 伪代码:Greedy 采样if sampling_metadata.all_greedy: sampled = torch.argmax(logits, dim=-1) # [num_tokens]argmax 在 GPU 上是一个归约操作——每个 thread block 处理词表的一段,用共享内存做局部最大值比较,最后跨 block 汇总。
为什么 Greedy 不需要 softmax:softmax 是单调变换——不会改变最大值元素的位置。。跳过 softmax 省掉了 次 、 次加法、 次除法——对 128K 词表来说这是一笔可观的开销。
3.2 随机采样(Temperature > 0)路径
当至少有一个请求的 temperature > 0 时,需要走随机采样路径。步骤:
- Softmax:
- 从多项分布采样:PyTorch 的
multinomial或自定义 CUDA Kernel
批量异构采样:经过 temperature processor 后,logits 已经被各请求对应的 temperature 缩放。同一个 batch 中 temperature=0.7 的请求和 temperature=1.0 的请求的 logits 已经各自由不同的 scale 处理过。所以采样阶段不需要再区分请求——直接对整个 [num_tokens, vocab_size] logits 做统一的 softmax + multinomial 即可。
vLLM 使用 torch.multinomial 作为主要的多项分布采样实现(在 PyTorch 中已高度优化),同时在部分专用后端(如 ROCm)中有自研 CUDA kernel 替代。
3.3 混合 batch 的处理
当 all_greedy 为 False 但不是所有请求都需要随机采样时(部分 greedy + 部分随机),vLLM 的做法是将 batch 拆成两个子集分别处理:
# 伪代码:混合 batch 的采样greedy_indices = sampling_metadata.greedy_indices # temperature==0 的位置random_indices = sampling_metadata.random_indices # temperature>0 的位置
sampled = torch.empty(num_tokens, dtype=torch.int32, device=logits.device)if len(greedy_indices) > 0: sampled[greedy_indices] = torch.argmax(logits[greedy_indices], dim=-1)if len(random_indices) > 0: probs = torch.softmax(logits[random_indices], dim=-1) sampled[random_indices] = torch.multinomial(probs, num_samples=1).squeeze(-1)第四步:Logprobs 计算——采样附带的不只是 Token ID
除了采样得到的 token ID,vLLM 的 Sampler 还负责计算并返回 logprobs(log 概率)。这是 OpenAI API 兼容性的要求——调用者可以通过 logprobs 参数请求返回采样 token 的 log 概率以及前 K 个备选 token 的 log 概率。
请求级规格
SamplingParams 中的 logprobs 字段有三种取值:
None:不返回任何 logprobs(省计算)0:只返回采样 token 的 log 概率k > 0:返回采样 token 的 log 概率 + 概率最高的 k 个备选 token 及各自的 log 概率和 token ID
计算方式
采样完成后,logits 经过 softmax 再取 log:
# 伪代码:Logprobs 计算logprobs = torch.log_softmax(logits, dim=-1) # [num_tokens, vocab_size]然后根据每个请求的需求提取不同级别的 logprobs:
# 每个 token 位置的采样 token 的 log 概率sampled_logprobs = logprobs[range(num_tokens), sampled_token_ids] # [num_tokens]
# 对需要 top-k logprobs 的 token 位置topk_logprobs, topk_indices = torch.topk(logprobs, k=top_m, dim=-1)工程考量:logprobs 的体积问题
logprobs 的完整形状是 [num_tokens, vocab_size],如果词表为 128K,FP32 下 256 个 token 就是 128 MB。大部分请求不要求返回全部 logprobs(甚至不要求返回任何 logprobs)。vLLM 的策略是分档处理:
- 如果没有任何请求需要 logprobs,完全跳过 softmax + log(greedy 路径)
- 如果有请求需要 logprobs,只计算需要的部分,并只提取需要的级别(采样 token 的 logprob 或 top-k logprobs)
异步 D2H 传输
logprobs 的数据量不容忽视。对于 batch_size=64, top_m=20 的场景,每个 step 有 64×20×2(logprob+token_id)= 2560 个 32-bit 值 ≈ 10 KB——量不大,但如果每个 step 都同步 D2H 复制,会打乱 GPU 的流水线。
vLLM 使用异步 Stream 做 D2H 传输:
# 伪代码:异步 logprobs 回传with torch.cuda.stream(self.sampler_output_copy_stream): sampled_token_ids_cpu = sampled_token_ids.to("cpu", non_blocking=True) if logprobs_tensors is not None: logprobs_cpu = logprobs_tensors.to("cpu", non_blocking=True)non_blocking=True 保证 CPU 端在 GPU 传输完成前不等待,GPU 可以继续执行下一个 step。但这也意味着 EngineCore 在消费采样结果时需要确保传输已完成——通过 event 同步或 next step 的隐式 barrier 来保证。
第五步:输出回传——SamplerOutput 如何闭合引擎控制环
Sampler.sample() 返回 SamplerOutput 后,GPUModelRunner.execute_model() 将其作为返回值的一部分带回 Worker,Worker 通过输出队列提交给 EngineCore。
在 EngineCore 中的消费
在 EngineCore.step() 的主循环中,输出的消费发生在每步的开头:
# 伪代码:EngineCore.step() 的输出消费def step(self): # 0. 处理上一步的输出(闭环关键步骤) self.scheduler.update_from_output( scheduler_output=self.last_scheduler_output, sampler_output=self.last_sampler_output, )
# 1. 新一轮调度 scheduler_output = self.scheduler.schedule()
# 2. 执行模型 model_output = self.model_executor.execute_model( scheduler_output, ) self.last_sampler_output = model_output.sampler_output
# ... 返回结果给前端update_from_output() 做的事情:
- 把采样的 token 写入请求的状态:
request.output_tokens.append(sampled_token_id) - 检查 stop 条件:新 token 是否命中
stop_token_ids或stop_strs - 更新请求的完成状态:如果到达
max_tokens或命中 stop,标记请求为已完成 - 更新 KV Cache Manager 的请求状态:如果请求完成,释放其物理 KV blocks
这一步完成后,调度器就知道了:“上一步有哪些请求产生了哪些 token、哪些请求已经跑完了”。这直接影响下一轮调度时哪些请求继续被选择,哪些新请求可以被加入 batch。
请求完成时的收尾
当一个请求生成了 max_tokens 个 token 或命中了 stop token/string,update_from_output() 将其标记为完成。完成的请求在下一轮 schedule() 中不会被分配新的 token 预算,其 KV blocks 被 free() 后重新加入空闲池,可供新请求分配。
这就是整个引擎控制环的闭合点——从采样结果的注入开始,到 KV 内存的回收结束,一整个 step 的状态迁移完成。
小结
vLLM V1 Sampler 的设计可以用三个核心设计原则概括:
-
GPU 端全流程处理:从 logits 到 token ID 到 logprobs,所有计算都在 GPU 上完成。logits 的
[num_tokens, vocab_size]体积决定了它不适合回传 CPU。异步 D2H 只在最后传输精简后的采样结果(token ID + 有限的 logprobs)。 -
批量异构通过张量化参数:
SamplingMetadata把每个请求不同的采样参数打包成等长张量,让 GPU Kernel 可以通过索引读取对应请求的配置。这使得同一个 batch 里的 32 个请求可以各自使用不同的 temperature、top-k、top-p 而无冲突。 -
快速路径优化:
all_greedy(全部 temperature=0 时跳过随机采样和 softmax)和no_penalties(无惩罚项时跳过计数和惩罚计算)是两个关键标志位,让最常见的生产场景(greedy + 无惩罚)能以最小开销完成采样。
从架构角度看,Sampler 是整个引擎控制环的”最后一公里”——它接收模型 forward 的稠密 logits 输出,产生稀疏的 token ID 决策,然后通过 update_from_output() 把决策结果注入调度器,为下一轮 step 的”谁跑、跑多少”提供信息。没有这个环节,调度器不知道请求是否该继续,KV Cache 不知道哪些 block 可以回收——整条流水线断在终点前。
下一篇将回到 MoE 路线,拆解 vLLM 的 fused_moe Triton/CUDA Kernel 如何实现 batched GEMM、FP8 量化推理,以及 MoE Kernel 的模块化插件架构。
参考资料
- vLLM Official Documentation
- vLLM GitHub Repository
- Inside vLLM: Anatomy of a High-Throughput LLM Inference System
- OpenAI API Reference: Chat Completions
- The Curious Case of Neural Text Degeneration (Top-P/Nucleus Sampling)
- vLLM 源码完全拆解(五):GPUModelRunner 如何把动态请求拼成一次 GPU 前向
- vLLM 源码完全拆解(二):从 add_request 到 EngineCore.step
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


