


vLLM 源码完全拆解(七):PagedAttention Kernel 如何遍历分页 KV 并完成稳定 Softmax
从 Backend 接口继续进入 CUDA Kernel
前六篇已经把一条请求从 API 入口送到了 Attention Backend:Scheduler.schedule() 决定本轮计算多少 token,KVCacheManager 分配物理 Block,GPUModelRunner 把不同请求压成连续输入,最后由 Attention Backend 把公共元数据翻译成具体实现需要的参数。现在只剩一个关键问题没有打开:Kernel 拿到 query、block_tables、seq_lens 与分页 KV tensor 后,怎样在 GPU 上算出与连续注意力相同的结果?
PagedAttention 由 UC Berkeley 团队在 2023 年提出,并发表于 SOSP 2023。论文的系统贡献是把操作系统分页思想引入 KV Cache 管理;本文聚焦其更底层的一面,即 vLLM 经典 CUDA 实现中的 decode Kernel。源码基线固定为 vLLM v0.6.0 的 csrc/attention/attention_kernels.cu 与 vllm/attention/ops/paged_attn.py。固定版本很重要:现代 vLLM V1 可以通过 Backend 选择 FlashAttention、FlashInfer、Triton 等实现,不能把某个历史 CUDA Kernel 当成所有当前配置的唯一执行路径;但它把分页寻址、线程协作、稳定 softmax 和长上下文分区写得最直接,仍是理解各类分页注意力实现的最佳坐标系之一。
还要先消除一个命名冲突:本文的 PagedAttention V1/V2 是同一经典 CUDA 算子的两个 Kernel 版本,不是 vLLM 的 V0/V1 引擎架构。前者讨论是否按 512-token partition 拆分一个 attention head,后者讨论引擎控制面重构,二者没有版本继承关系。
本文沿一次单 token decode 的数据路径展开。多 token prefill 更适合 FlashAttention 风格的分块矩阵乘;经典 paged_attention_v1/v2 的输入 query 形状是 [num_seqs, num_heads, head_size],即每条序列、每个 query head 只有一个当前 query。理解这一边界可以避免把 decode Kernel 的线程网格误套到 chunked prefill。
先明确问题:分页之后,注意力怎样计算
对序列 的 query head ,普通 decode attention 是:
是 head size, 是当前完整上下文长度, 用于数值稳定, 是这个 query head 对应的 KV head。MHA 中 ;GQA/MQA 中多个 query head 共享一个 KV head。
连续实现可以把 看成两块规则矩阵。分页以后,逻辑 token 的地址要先经过两级翻译。设每个物理 KV Block 容纳 个 token,则:
是请求内部的逻辑块号, 是块内 token 偏移,block_table 给出实际物理块号。真正读取地址还要加上 KV head、head 维度与 tensor stride。分页只改变地址计算,不改变上面的注意力公式;Kernel 的正确性目标就是让任意物理排列都产生与逻辑连续序列完全相同的 。
这带来三类代价。
第一,读取每个逻辑块前多一次 block-table 间接寻址,物理块之间也不保证相邻。第二,decode 只有一个 query,无法像大矩阵 GEMM 那样提供大量并行工作。第三,长上下文会让单个 (sequence, head) thread block 循环太久,并需要与上下文长度近似成正比的 logits 临时空间。经典 Kernel 的所有设计,都围绕这三项代价展开。
分页的收益则发生在系统层:物理块可以按需分配、共享和回收,序列无需预留最大长度的连续显存。vLLM 论文报告传统服务系统可能因碎片和过度预留浪费 60%–80% 的 KV 空间,而分页把浪费限制在每条序列最后一个未填满块;官方早期博客给出的实际浪费低于 4%。这不是 Kernel 自身的算力加速,而是通过容纳更大 batch 间接提高整体吞吐。
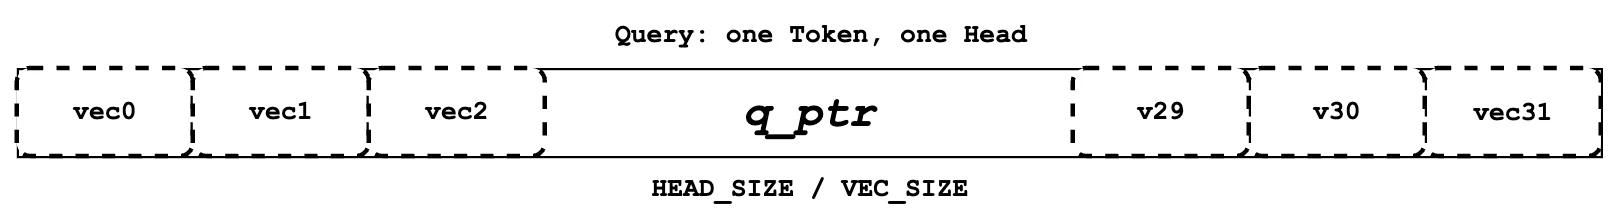
图源:vLLM Paged Attention Kernel 官方文档。图中一行是一个 query head;彩色小格表示向量化加载单元。后文会看到,Kernel 不是让一个线程独占整个 head,而是让一个 thread group 共同保存并复用这条 query。
源码地图与两条 Kernel 路径
经典实现只有两个真正需要追踪的文件:Python 包装层负责布局、临时 tensor 与 V1/V2 选择,CUDA 文件负责计算。主调用链可以压缩成:
PagedAttention.forward_decode() ├─ split_kv_cache(): 把统一 KV storage 解释成 K/V 两种视图 ├─ 判断 use_v1 ├─ ops.paged_attention_v1(...) │ └─ paged_attention_v1_kernel │ └─ paged_attention_kernel<PARTITION_SIZE=0> └─ ops.paged_attention_v2(...) ├─ paged_attention_v2_kernel │ └─ paged_attention_kernel<PARTITION_SIZE=512> └─ paged_attention_v2_reduce_kernelV1 与 V2 复用同一个 paged_attention_kernel device 函数。模板参数 PARTITION_SIZE=0 表示不分区,一个 CUDA thread block 负责一个序列的一个 query head;PARTITION_SIZE=512 表示每 512 个上下文 token 建一个独立工作单元,先得到局部 attention 输出,再由第二个 Kernel 合并。
两条路径的 launch grid 分别是:
// V1: 一个 block 处理完整 (head, sequence)dim3 grid(num_heads, num_seqs, 1);
// V2: z 维把同一个 head 的上下文切成多个 partitiondim3 grid(num_heads, num_seqs, max_num_partitions);dim3 reduce_grid(num_heads, num_seqs);v0.6.0 的启发式为:max_seq_len <= 8192,且只有一个 partition 或 num_seqs * num_heads > 512 时使用 V1;否则使用 V2。它表达的是并行度与额外归约之间的权衡,而不是“V2 永远更快”:
- batch 与 head 已经产生很多 thread block 时,V1 的 GPU 并行度足够,避免第二次 launch 和临时输出读写更划算;
- batch 很小、上下文很长时,V1 只有少量长时间运行的 block,很多 SM 闲置,V2 用 partition 维补出并行度;
- 超过 8192 token 时,V1 的共享内存 logits 继续线性增长,V2 把每块的 logits 空间固定在 512 个 FP32 数。
这个阈值属于 v0.6.0 的实现启发式,不是 PagedAttention 算法定律。硬件代际、后端、block size 和 Kernel 重写都会改变最优分界。
参数与内存布局:Kernel 到底拿到了什么
核心 device 函数的模板参数与运行时参数承担不同职责。前者在编译期固定循环边界和向量宽度,后者描述本轮动态批次:
template <typename scalar_t, typename cache_t, int HEAD_SIZE, int BLOCK_SIZE, int NUM_THREADS, Fp8KVCacheDataType KV_DTYPE, bool IS_BLOCK_SPARSE, int PARTITION_SIZE = 0>__device__ void paged_attention_kernel( float* exp_sums, float* max_logits, scalar_t* out, const scalar_t* q, const cache_t* k_cache, const cache_t* v_cache, int num_kv_heads, float scale, const int* block_tables, const int* seq_lens, int max_num_blocks_per_seq, ...);scalar_t 是 query 与输出的数据类型,通常为 FP16 或 BF16;cache_t 可以与它相同,也可以是 FP8 存储类型。二者分开后,Kernel 能在加载时用 k_scale、v_scale 把量化缓存转换到计算向量。HEAD_SIZE、BLOCK_SIZE 与 NUM_THREADS 编译期常量化,使编译器可以展开循环并把小数组放进寄存器;代价是二进制要为常见 head size 和 block size 预实例化多个版本。
输入张量的关键形状是:
| 张量 | 逻辑形状 | 作用 |
|---|---|---|
q | [num_seqs, num_heads, head_size] | 每条序列本轮的单个 query |
block_tables | [num_seqs, max_blocks_per_seq] | 逻辑块号到物理块号的映射 |
seq_lens | [num_seqs] | 每条序列真实上下文长度 |
k_cache | [num_blocks, num_kv_heads, head_size/x, block_size, x] | 为 QK 点积优化的 K 视图 |
v_cache | [num_blocks, num_kv_heads, head_size, block_size] | 为按 token 加权累加优化的 V 视图 |
这里 。若缓存为 FP16,则 ;一个向量化事务恰好搬 16 字节。K 与 V 的逻辑内容都是 [block, kv_head, token, head_dim],却故意采用不同物理排列,因为两个阶段的内层访问方向不同:QK 阶段固定 token、沿 head dimension 做点积;PV 阶段固定 head-dimension row、沿 token 维取一段 value 与概率相乘。单一布局难以让两种访问都规整。
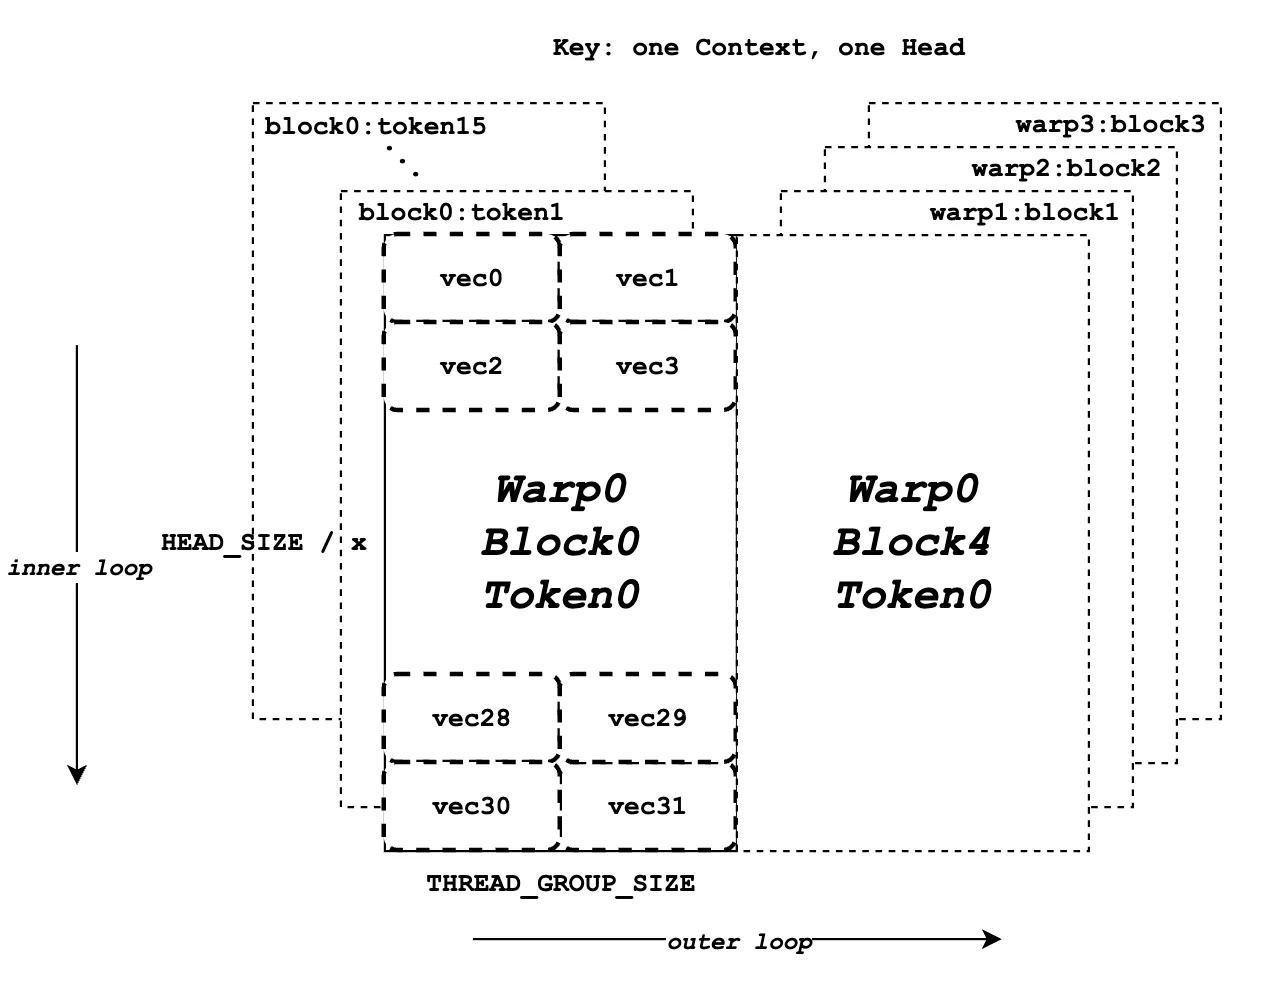
图源:vLLM Paged Attention Kernel 官方文档。横向小块对应连续的向量元素,虚线框展示一个 thread group 如何协作取得某个 token 的 Key。K 的末维 x 让一组线程合计完成 16 字节对齐访问。
block_tables 的行尾可能为了 CUDA Graph 固定形状而 padding。Kernel 不读取整行,而是先用 seq_len 算:
只遍历前 个逻辑块。因此 block-table tensor 的物理宽度不是有效页数;调试时若把 padding block ID 当成真实映射,会误判越界来源。
K/V 的物理地址由三个 stride 组成。对逻辑块 block_idx,先做:
int64_t physical_block_number = block_table[block_idx];const cache_t* base = cache + physical_block_number * kv_block_stride + kv_head_idx * kv_head_stride;随后才叠加 head-dimension 与块内 token 偏移。物理块号先转成 int64_t,是因为它还要乘可能很大的 stride;若保留 int32,大型缓存上的中间乘法可能溢出,即使 block_table 中的 ID 本身完全合法。
线程组织:一个 Query Head 怎样分给 Thread Group
经典 Kernel 默认每个 CUDA thread block 使用 128 个线程,即 4 个 warp。grid 的 x 维是 query head,y 维是 sequence,V2 再用 z 维表示 partition。于是一个 thread block 始终只写一个 (sequence, query_head, partition) 的结果,不需要跨 block 同步。
warp 内部再切成 thread group:
constexpr int THREAD_GROUP_SIZE = max(WARP_SIZE / BLOCK_SIZE, 1);constexpr int NUM_THREAD_GROUPS = NUM_THREADS / THREAD_GROUP_SIZE;当 BLOCK_SIZE=16、warp size 为 32 时,THREAD_GROUP_SIZE=2。一个 warp 被切成 16 个二线程小组,正好让 16 组分别处理 KV Block 中的 16 个 token。若 BLOCK_SIZE=8,每组 4 线程;若 BLOCK_SIZE=32,每组 1 线程。这个公式的目的不是让组大小随意变化,而是让一个 warp 在一次内层迭代中覆盖完整 KV Block。
每个小组协作完成一个长度为 的 QK 点积。设组大小为 ,每线程承担 个 head 元素;向量宽度取:
这样整个 thread group 每次合计搬运约 16 字节。以 FP16、 为例,VEC_SIZE=4:每线程一次读 4 个 FP16,两线程合计 8 个 FP16,正好 16 字节。若 head size 为 128,每线程最终持有 64 个元素,也就是 16 个这样的向量。
Query 只加载一次。各 thread group 原本会反复使用同一条 ,如果每组都从全局显存重读,Q 流量会被上下文 token 数放大。实现先让 block 内线程分工把 query 搬进:
__shared__ Q_vec q_vecs[THREAD_GROUP_SIZE][NUM_VECS_PER_THREAD];然后所有组从共享内存取自己负责的片段。这里共享数组第一维不是 thread-group 编号,而是组内 offset;相同 offset 的线程读取相同 query 分片。一次同步后,4 个 warp 都能复用这条 query。
GQA 的映射更直接。若 query head 数为 、KV head 数为 ,代码计算:
例如 ,query heads 0–3 读取 KV head 0,4–7 读取 KV head 1。经典 grid 仍按 query head 发 block,所以共享同一 KV head 的四个 CUDA block 可能重复读取相同 K/V;这让实现简单,也解释了为什么面向 GQA 的新 Kernel 会尝试把多个 query head 放进同一工作单元以复用 KV。
第一步:QK 点积如何跨非连续 KV Block
外层循环以逻辑块为单位,4 个 warp 交错领取:
for (int block_idx = start_block_idx + warp_idx; block_idx < end_block_idx; block_idx += NUM_WARPS) { int64_t physical = block_table[block_idx]; // 当前 warp 处理这个物理 KV Block}假设逻辑 block table 为 [7, 2, 9, 4]。warp 0 首轮读物理块 7,warp 1 读 2,warp 2 读 9,warp 3 读 4。物理编号无序只改变每个 warp 的基地址,不改变 token 的逻辑次序;logit 写入位置仍由 token_idx = block_idx * BLOCK_SIZE + offset 决定。
对块内某个 token,thread group 的各线程加载不同 K 分片,各自做局部乘加,再由 Qk_dot<..., THREAD_GROUP_SIZE>::dot() 在组内归约:
是组内第 个线程负责的 head-dimension 索引集合,scale 通常为 。若模型使用 ALiBi,Kernel 再加:
是当前 head 的 slope。当前位置 的偏置为 0,更早 token 得到负距离乘 slope。偏置在 softmax 前加入,因此与分页地址无关。
每个有效 logit 以 FP32 写入动态共享内存 logits[token_idx - start_token_idx]。这解释了 V1 的共享内存为什么随最长序列增长:仅 logits 就需要约 字节。V2 每个 partition 最多 512 token,把这部分固定为 2048 字节。
最后一页通常没有填满。QK 阶段对 token_idx >= seq_len 的位置做 mask,不让它们更新最大值。更重要的是后续 softmax 循环只遍历 num_tokens 个真实位置,padding 不进入分母。仅仅把无效 logit 写成 0 而又参与 softmax 是错误的,因为 仍会贡献概率质量。
第二步:稳定 Softmax 与跨分区归约
经典 CUDA Kernel 在一个 partition 内使用的是“两遍稳定 softmax”,不是 FlashAttention 那种边读 tile 边持续更新输出的单遍 online softmax。第一遍已经把所有 写入共享内存,随后分两级求最大值。
每个 thread group 的 leader 先保存自己处理 token 的局部最大值;warp shuffle 把这些值归约成 warp 最大值,lane 0 写入 red_smem[warp_idx];第一次 __syncthreads() 后,第一个 warp 再把 4 个 warp 最大值归约成整个 CUDA block 的 ,并广播给所有线程:
然后 128 个线程跨步处理共享内存中的 logits:
减去 后,所有指数的输入不大于 0,避免较大正 logit 导致 FP32 exp 上溢。S 也通过先 warp 内、再跨 warp 的 block_sum() 得到。实现把概率继续放回原来的 logits 共享内存,随后 PV 阶段直接复用;不需要额外概率 tensor。
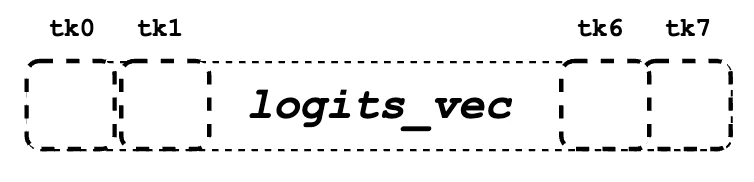
图源:vLLM Paged Attention Kernel 官方文档。每个线程在 PV 阶段读取一段连续概率,使它与同一批 token 的 Value 向量一一对齐。
10^{-6} 是防御性分母项。正常有效序列至少有一个 logit,减最大值后至少有一个 ,理论上 ;但显式小常数可以避免异常输入或极端 mask 路径产生除零。它会使概率和略小于 1,误差数量级相对 FP16/BF16 输出通常可以忽略。若调试时发现 S 接近 0 或出现 NaN,不应把它归因于正常数值舍入,而应优先检查长度、mask、量化 scale 与上游 Q/K。
V2 怎样精确合并多个 partition
V2 的每个 partition 独立得到三个量:局部最大值 、局部指数和 、局部归一化输出 :
不能直接平均 。不同 partition 的 logit 尺度和概率质量都可能不同。reduce Kernel 先求全局最大值:
再把每个局部指数和换算到共同基准:
最终输出为:
把 与 展开,就会恢复对所有 token 的一次全局 softmax,因此这个合并是数学精确的分块重组,不是近似。V2 的代价是写出 tmp_out、max_logits、exp_sums,再启动 paged_attention_v2_reduce_kernel 读回来;收益是把一个长串行遍历拆给更多 SM,并固定单 block 的共享内存需求。
第三步:概率与 V 相乘并写回输出
得到共享内存中的 后,Kernel 计算每个输出维度:
这次内层方向从 head dimension 转成 token。实现选择:
constexpr int V_VEC_SIZE = min(16 / sizeof(scalar_t), BLOCK_SIZE);constexpr int NUM_V_VECS_PER_ROW = BLOCK_SIZE / V_VEC_SIZE;FP16/BF16 且 BLOCK_SIZE=16 时,V_VEC_SIZE=8。一个线程读取固定输出维度上的 8 个连续 token value,同时读取相同 8 个概率,完成一个长度 8 的点积;同一 warp 的另一个线程处理该 KV Block 剩余 8 个 token。这样每线程的 V 访问仍是 16 字节向量事务。
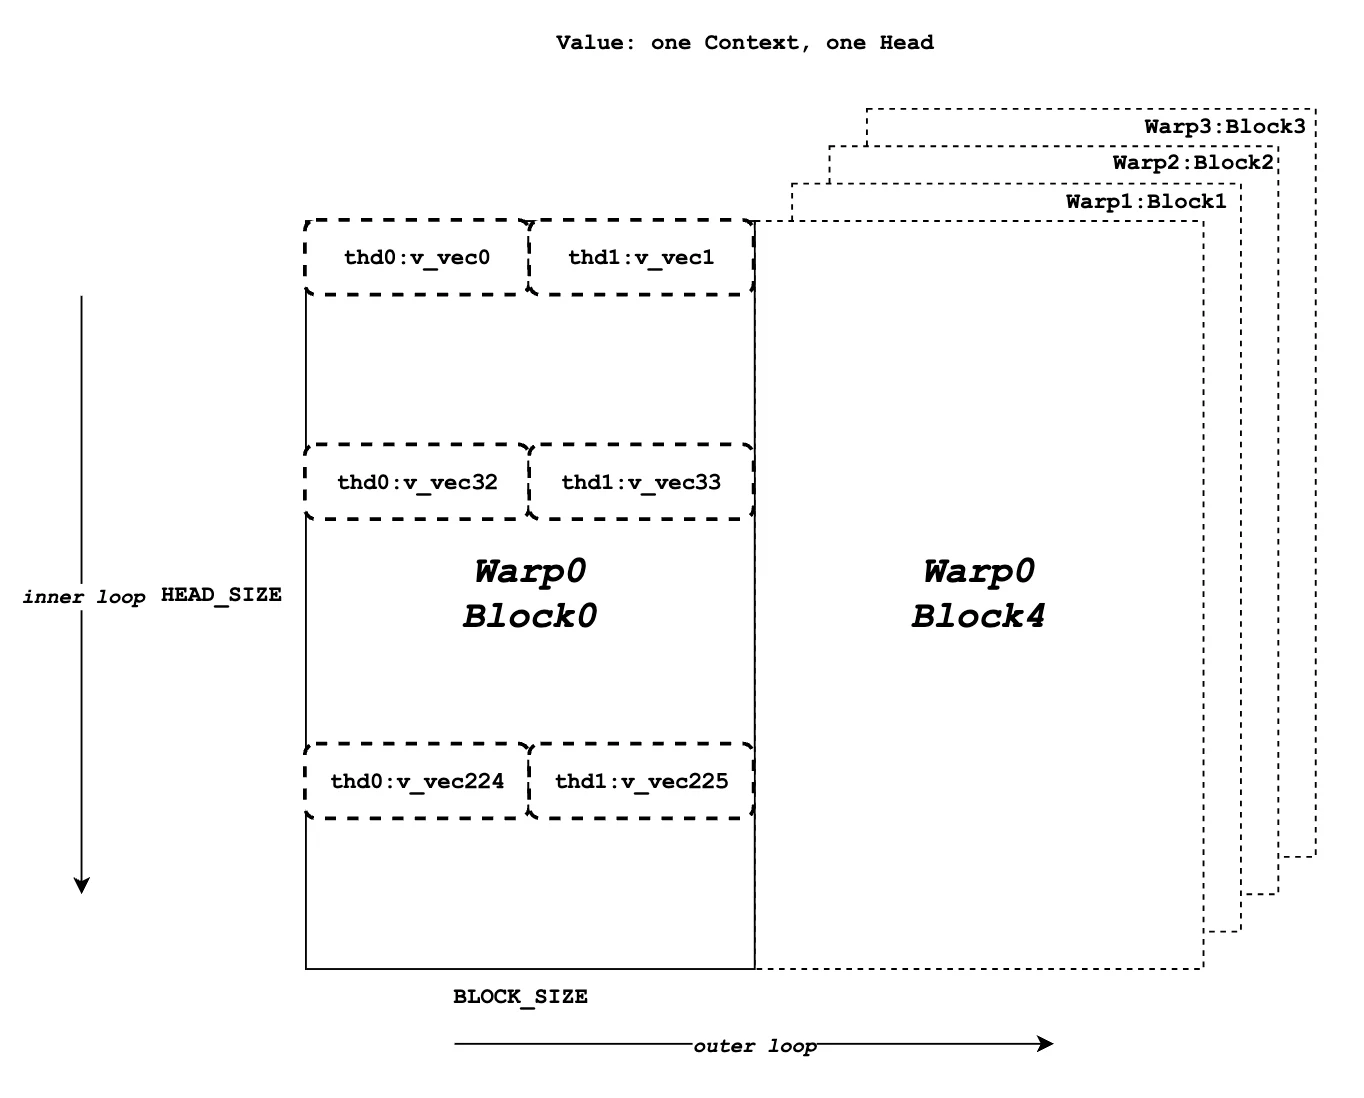
图源:vLLM Paged Attention Kernel 官方文档。纵向是 head dimension,横向是 block 内 token。它与 K Cache 的布局不同:K 为单 token 的 head 向量点积服务,V 为固定输出维度上的 token 归约服务。
每个线程为自己负责的若干输出 row 保留 FP32 accs[]。遍历完所有物理块后,归约也分两层:
- warp shuffle 合并同一 row 在不同 token 片段上的局部和;
- 各 warp 把相同 row 的结果通过共享内存做树形合并;
- warp 0 把 FP32 累加值转换回
scalar_t并写入输出。
这里有一个容易忽略的边界处理。最后一个物理页未使用位置的 V 可能保留旧值,甚至包含 NaN。即使对应概率理论上为 0,浮点运算中的 仍是 NaN,最终会污染整个输出。因此源码在最后一页加载 V 向量后,显式把 token_idx + j >= seq_len 的元素改成零。这不是冗余 mask,而是阻断 NaN 传播所必需的数值防线。
QK 阶段使用过的动态共享内存 logits 随后被解释为 out_smem,供跨 warp 合并输出。复用能降低每个 block 的共享内存总量,但必须在改变用途前执行 __syncthreads();否则仍在读取概率的线程可能与已经写部分输出的线程发生读写竞争。
GQA、向量化加载与 Block Size 的联动
BLOCK_SIZE 不只是缓存管理参数,它同时改变内存碎片、block-table 长度和 Kernel 线程组织。三类影响可以放在一张表里:
| Block size | 系统层影响 | Kernel 层影响 |
|---|---|---|
| 较小 | 最后一页平均浪费更少,前缀共享粒度更细;页表更长 | 间接寻址次数更多,thread group 更大 |
| 较大 | 页表更短、每页摊薄元数据;尾页浪费和写时复制粒度更大 | thread group 更小,一个 warp 一次覆盖更多 token |
若序列尾长在页内近似均匀分布,单序列平均内部碎片约为 个 token。把 从 16 增到 32,页表项大约减半,但平均尾部浪费也接近翻倍。实际系统还要考虑 prefix cache:较小页允许在更细边界命中共享前缀,较大页则减少哈希与 block 元数据。
向量宽度又受 dtype 影响。缓存从 FP16 改成 FP8 后,同一 16 字节事务可以装入两倍元素,但 Kernel 还要加载 scale 并转换为计算类型。因而“KV 字节减半”不等于 attention 时间严格减半:block-table 读取、指数、归约、地址计算和反量化开销没有同比减少。不过长 decode 通常高度受 K/V 带宽限制,压缩缓存仍可能带来显著收益。
GQA 进一步改变瓶颈。经典实现用:
int num_queries_per_kv = num_heads / num_kv_heads;int kv_head_idx = head_idx / num_queries_per_kv;保证数学映射正确,却没有跨 query-head CUDA block 主动共享 KV。若 8 个 query head 对应 1 个 KV head,最坏情况下相同 K/V 会由 8 个独立 block 请求。L2 cache 可能吸收部分重复流量,但不能保证这些 block 同时落在能共享 L1 的同一 SM。面向现代 GQA 的 kernel 常把 grid 改成按 KV head 组织,并在一个 program 中同时处理关联的 query heads,本质上是用更多寄存器与更复杂的 tile 换 KV 复用。
因此调优不能孤立选择 BLOCK_SIZE、KV dtype 或 GQA tile。它们共同决定 thread-group 大小、每次事务的元素数、寄存器数组规模、L1/L2 复用和 block-table 访问频率。一个在 MHA+FP16 上合理的配置,迁移到高分组比 GQA+FP8 后可能完全不是最优点。
V1 与 V2:为什么长上下文需要分区
设 batch 有 条序列、 个 query head。V1 的 CUDA block 数近似为 ,每个 block 扫完整上下文;V2 则近似为:
小 batch decode 时,例如 ,V1 只有 32 个长任务,可能不足以占满高端 GPU 的全部 SM;V2 产生 个 partition 任务,能把上下文维度也变成并行维。代价是 32 个 reduce blocks、临时输出,以及 partition 间重标定 softmax。
分区还解决共享内存上界。V1 的动态共享内存至少要容纳按最长序列 padding 后的 FP32 logits:
时约为 32 KiB,尚未计入跨 warp 输出归约需要的空间;上下文继续增长会压低 occupancy,甚至超过单 block 可配置共享内存。V2 的这部分固定为 KiB,并把增长转移到全局临时 tensor。
但序列很短或 batch 已很大时,V2 可能更慢。partition 数为 1 时,它做的主体工作与 V1 相同,却仍需要临时 tensor 和 reduce 路径;即使 partition 多于 1,若 已经提供数千个 block,继续拆分不会显著增加有效并行度,只会放大 launch、写回与归约流量。v0.6.0 的 num_seqs * num_heads > 512 条件正是在粗略识别这种场景。
选择还使用 batch 的 max_seq_len,而实际每条请求由 seq_lens[seq_idx] 决定有效 partition 数。V2 grid 按最大值统一发射,短序列对应的多余 z block 一进入 Kernel就检查 partition_idx * 512 >= seq_len 并退出。这保持了规则 grid 和 CUDA Graph 友好性,却意味着长度差异很大的 batch 会发射一些空 block。
用一个跨页 Decode 请求走完整条路径
设一次普通 decode 具有如下配置:
block_size = 16head_size = 128num_query_heads = 8num_kv_heads = 2seq_len = 35block_table = [7, 2, 9]当前 query_head = 5先做 head 映射。每个 KV head 服务 个 query heads,因此 query head 5 对应:
CUDA grid 中 (blockIdx.x, blockIdx.y, blockIdx.z) 为 (5, seq_idx, 0) 的 thread block 负责这个输出 head。由于上下文只有 35 token,包装层选择 V1;128 个线程组成 4 个 warp,THREAD_GROUP_SIZE=32/16=2。
地址翻译
35 个 token 需要三个逻辑块。4 个 warp 第一轮分别领取逻辑块 0、1、2、3:
| Warp | 逻辑块 | 物理块 | 逻辑 token | 实际工作 |
|---|---|---|---|---|
| 0 | 0 | 7 | 0–15 | 16 个有效 token |
| 1 | 1 | 2 | 16–31 | 16 个有效 token |
| 2 | 2 | 9 | 32–47 | 仅 32–34 有效 |
| 3 | 3 | 不存在 | — | 不进入循环 |
token 34 的逻辑块号为 ,块内偏移为 2,所以它从物理块 9 的 KV head 1、offset 2 处读取。注意它在 logits 共享内存中的位置仍是 34;物理块 9 不意味着逻辑位置 9。block table 只参与地址翻译,不能改变 softmax 的逻辑次序。
QK 与 mask
每个二线程 group 协作处理一个 token 的 128 维点积。warp 0 的 16 个 group 对应 token 0–15,warp 1 对应 16–31,warp 2 对应 32–47。warp 2 中只有前三个 group 的结果有效,其余 group 不更新 qk_max,也不会进入 num_tokens=35 的指数循环。
四个 warp 的局部最大值经过共享内存合并为全局 ,35 个 logit 变成概率 。整个过程没有把物理块 7、2、9 拼成新的连续 K tensor;连续性只存在于共享内存中的逻辑 logits。
PV 与输出
warp 再按同样的 block-table 顺序读 V。FP16 下每线程一次读取 8 个 token 的 value,因此每个 KV Block 的一行由两个线程覆盖。物理块 9 的 token offset 3–15 被显式清零,防止尾页旧值或 NaN 污染。最终所有 warp 对 128 个输出维度的局部和完成归约,warp 0 写出 out[seq_idx, 5, :]。
若把 seq_len 改为 1100,block size 仍为 16,则共有 69 个逻辑块。V2 会形成三个 partition:
partition 0: token 0 ... 511 -> 32 个完整逻辑块partition 1: token 512 ... 1023 -> 32 个完整逻辑块partition 2: token 1024 ... 1099 -> 5 个逻辑块,最后一块部分有效512 能被 16 整除,因此 partition 边界不会劈开一个 KV Block。三个 CUDA block 分别生成 ,reduce Kernel 再按前文公式得到一个 head 输出。若 PARTITION_SIZE 不能被 BLOCK_SIZE 整除,start_block_idx 无法准确表达 partition 起点,源码包装层因此显式断言二者整除。
性能模型:何时受带宽、占用率或归约限制
单 token decode 的算术强度很低。忽略 block table、scale 和输出,对一个 query head,QK 与 PV 总计算量约为:
读取 K/V 的最低数据量约为:
是每个缓存元素的字节数,因此理想算术强度为:
FP16/BF16 KV 约为 1 FLOP/byte,FP8 KV 约为 2 FLOP/byte,远低于现代 GPU 充分喂饱 Tensor Core 所需的强度。decode attention 通常首先受显存带宽与有效访存效率限制,而不是峰值矩阵算力。
“分页”不等于每个标量都随机读取。block table 的确让物理块之间不连续,但进入一个物理块后,warp 仍对 K/V 的连续向量执行合并访问。真正的性能损失来自:每页一次额外索引、跨页空间局部性下降、同一 GQA KV head 的重复读取,以及小 batch 时 block 数不足。
可以按症状拆成四类瓶颈:
| 症状 | 主要限制 | 需要观察的量 |
|---|---|---|
| 长上下文下时间近似线性增长 | K/V 带宽 | DRAM throughput、L2 hit rate、每 token 字节数 |
| 小 batch GPU 利用率低 | grid 并行度不足 | active SM、waves per SM、V1/V2 block 数 |
| 增大 head size 后占用率下降 | 寄存器或共享内存压力 | registers/thread、shared memory/block、occupancy |
| V2 比 V1 更慢 | 临时写回与第二次归约开销 | kernel launch 数、tmp_out 流量、partition 数 |
V1 的共享内存取 max(logits_size, outputs_size),因为同一空间分时复用,而不是把二者相加。即便如此,最长序列仍可能使每 block 的共享内存上升、单 SM 同驻 block 数下降。V2 把 logits 空间上界固定,却多出全局临时输出;它是用更多全局流量换并行度和 occupancy。
寄存器也可能成为限制。每线程既要保存多个 q_vecs/k_vecs 片段,又要保存 accs[NUM_ROWS_PER_THREAD]。head size 增大时,编译期数组展开会提高寄存器需求;若发生 spill,所谓“寄存器累加”会退化为 local memory 流量。判断时应查看实际编译结果和 Nsight Compute,而不是只依据源码变量名。
性能实验至少应固定 GPU、dtype、head size、Q/KV head 数、block size、batch size、上下文长度分布和 Kernel 路径。只报告“PagedAttention V2 快于 V1”没有意义:V2 的优势主要出现在 较小而 较大的区域。若负载已提供足够多 (sequence, head) 工作单元,第二级分区常只增加开销。
现代 Backend 还可能完全不走这份经典 Kernel。分析线上 trace 时,应先确认实际后端和 Kernel 名称,再把本文的地址与归约模型映射过去。Backend 选择方法可参考系列第六篇,底层 profiling 方法可参考 GPU 推理性能分析完全指南。
正确性不变量与调试方法
分页注意力最危险的错误往往保持形状合法:错误物理块号仍是一个整数,错误请求行也可能指向已分配显存,Kernel 不一定立即崩溃,却会静默读取别人的 KV。调试应从不变量开始。
十条必须成立的不变量
block_tables[seq_idx]的前 项都必须是当前请求有权读取的物理块。- 逻辑块次序必须保持 token 次序;物理 ID 可以无序,但不能排序后再传给 Kernel。
seq_lens[seq_idx]不能超过该行有效 block 数乘BLOCK_SIZE。- query head 到 KV head 的映射必须满足
num_heads % num_kv_heads == 0。 - K/V tensor view 的
kv_block_stride、kv_head_stride与实际缓存布局必须一致。 HEAD_SIZE必须匹配模型层,并能被THREAD_GROUP_SIZE整除。- V2 的
PARTITION_SIZE必须能被BLOCK_SIZE整除。 - 所有 padding token 都不能进入 softmax 分母,尾页无效 V 必须对 NaN 传播安全。
- FP8 K/V 的 dtype、
k_scale与v_scale必须和写缓存时的量化约定相同。 - V2 reduce 必须使用与第一阶段相同的有效 partition 数,不能把未写临时槽位参与合并。
最小调试顺序
先关闭 FP8 KV、ALiBi、block-sparse、prefix sharing 和 CUDA Graph,使用一个序列、一个短上下文、确定性输入。选 BLOCK_SIZE=16、seq_len=17,故意跨一个页边界;把 K/V 填成可手算的小值,用 PyTorch 连续 attention 作为 reference。
第一轮只核对地址:
seq=0 head=0 kv_head=0 seq_len=17block_table=[7,2]logical_token=16 -> logical_block=1, offset=0, physical_block=2第二轮核对中间统计:每个 head 的 qk_max、exp_sum 与 reference 是否一致。若最大值就错,问题在 Q/K、head 映射、地址或 scale;最大值正确而指数和错,优先检查 mask 与长度;两者正确但输出错,问题集中在 V 布局、尾页清零和 PV 归约。
第三轮把长度提高到 513,强制产生两个 V2 partition,并核对:
若两个局部输出都正确而最终输出错,问题只可能位于重标定权重、临时输出步长或有效 partition 数。把验证边界设计在 512/513,比直接用随机 32K 上下文更容易定位 off-by-one。
最后逐项恢复 GQA、FP8、CUDA Graph 与多请求批次。一次只增加一个维度,并保留以下对照:
- 连续 reference 与分页输出的最大绝对/相对误差;
- 逻辑 token 到
(physical_block, offset)的抽样映射; - 实际 Kernel 是 V1、V2 还是其他 Backend 实现;
seq_len、有效 block 数与 partition 数;- 是否只在最后一页、page 边界或某个 GQA head 组出错。
源码阅读时常见的四个误区
第一,PagedAttention 不是“把注意力近似成分块结果”。分页只改变 KV 存储地址,V1 与 V2 都应给出完整精确 attention;V2 的局部输出按 softmax 质量精确合并。
第二,KV Block 与 CUDA thread block 不是同一概念。前者是若干 token 的缓存页,后者是协作执行的一组 GPU 线程;一个 thread block 会循环读取多个 KV Blocks。
第三,V2 不是 vLLM V1 引擎。看到 paged_attention_v2_kernel 时,应把它理解为分区 Kernel,不要联想到 Engine Core、V1 Scheduler 等控制面对象。
第四,经典 Kernel 的 softmax 不是单遍 online softmax。它先把 logits 存进共享内存,再求最大值、指数和与概率;partition reduce 使用了可组合的稳定 softmax 统计,但这不改变 partition 内的两遍实现。
系列进度与下一站
至此,vLLM 系列已经从请求控制面进入了第一个具体 GPU Kernel:
| 篇次 | 已完成主题 | 关键源码坐标 |
|---|---|---|
| 一 | 整体架构与模块全景 | Entrypoint、Engine、Worker、Kernel |
| 二 | 请求穿过 V1 引擎 | add_request()、EngineCore.step()、输出提交 |
| 三 | Scheduler 的批次决策 | token budget、waiting/running、抢占 |
| 四 | KV Cache Manager | prefix lookup、block pool、分配与回收 |
| 五 | GPUModelRunner 与 InputBatch | 扁平 token、block table、slot mapping |
| 六 | Attention Backend | selector、AttentionGroup、builder 与 Impl |
| 七 | PagedAttention Kernel | 分页寻址、线程组、稳定 softmax、V1/V2 分区 |
本篇最重要的源码关系可以归纳为七条:
- block table 把逻辑 KV 块翻译成物理块,softmax 的逻辑 token 次序不随物理排列改变。
- 一个 CUDA thread block 负责一个
(sequence, query_head, partition),warp 轮流遍历 KV Blocks。 - thread group 共同完成一个 token 的 QK 点积,组大小由 warp size 与 KV block size 联动决定。
- K 与 V 使用不同物理视图,分别适配沿 head dimension 的点积和沿 token dimension 的加权归约。
- partition 内使用共享内存保存 FP32 logits 并做两遍稳定 softmax,尾页 V 还需显式清零以阻断 NaN。
- V1 用一个 block 扫完整 head;V2 把长上下文按 512 token 并行切分,再用局部最大值与指数和精确合并。
- 经典 Kernel 是理解分页注意力的基线,不代表现代 vLLM 每个 Backend 都沿用相同代码和启发式。
下一篇回到 GPUModelRunner.execute_model() 的主执行路径,拆解输入准备完成后如何选择 eager 或 CUDA Graph,怎样建立 forward context、调用模型、抽取需要计算 logits 的 hidden states,并把结果交给 sampler。采样算法本身会继续单独成篇,避免把模型执行边界与 top-k/top-p 等策略混在一起。
参考资料
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- SOSP 2023 论文正式出版页
- vLLM 官方博客:Easy, Fast, and Cheap LLM Serving with PagedAttention
- vLLM Paged Attention Kernel 官方文档
- vLLM v0.6.0 经典 CUDA Attention Kernel 源码
- vLLM v0.6.0 PagedAttention Python 包装与 V1/V2 选择
- vLLM 当前 PagedAttention 缓存视图与写入接口
- vLLM Attention Backend Feature Support
- vLLM Triton Attention Backend Deep Dive
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


