


vLLM 源码完全拆解(十五):停止条件与增量解码——stop string、detokenizer 流水线与输出回传
上一篇拆解了结构化输出:语法约束如何在进入采样前把 logits 压成合法子集。链条至此只剩最后一环没拆——token 离开引擎之后、变回用户可读文本之前的那段路:增量解码(incremental detokenization)、stop string 的检测与截断、流式输出的切分,以及”前端发现 stop 条件后如何反向通知 EngineCore 停止调度”。本篇的主角是 vllm/v1/engine/detokenizer.py 与 output_processor.py,加上 stop_checker.py 里一段看似简单、实则边界密集的字符串搜索。
这一环容易被认为是”胶水代码”而不值得拆,实际它有三个非平凡点。其一,stop string 是跨 token 边界匹配的——用户给 "USER:",token 里没有哪个完整包含它,匹配必须发生在”增量解码出的文本流”上;而为了不让还没匹配完的字符串提前漏给用户,vLLM 引入了一个字符级的 hold-back 缓冲,这段逻辑是流式输出正确性的关键。其二,解码本身有状态——tokenizers 库的 DecodeStream 让”只解码新 token”成为可能,但 UTF-8 多字节字符横跨 token、特殊 token 的空格语义等角落,让快慢两条解码路径各有各的坑。其三,检测 stop 的进程与执行生成的进程不同——detokenizer 住在前端进程,EngineCore 不知道请求已经”该停了”,需要一条 abort 回传链路把消息带回调度器。
系列进度与本篇位置
本系列 vLLM 部分已至第十五篇:整体架构(一)→ 请求生命周期(二)→ 调度器(三)→ KVCacheManager(四)→ GPUModelRunner 拼批(五)→ Attention Backend(六)→ PagedAttention Kernel(七)→ MoE 执行(八)→ Sampler(九)→ 投机解码(十)→ 张量并行(十一)→ 编译子系统(十二)→ 多模态输入(十三)→ 结构化输出(十四)。请求从进入到离开的完整旅程,前十四篇覆盖了”进”(输入处理、调度)、“中”(前向、采样),“出”侧只顺带讲过 finish_reason 的判定;本篇把”出”侧补完,至此 V1 引擎一条请求的主干闭环就完整了。
把这一环放进系列的语境:到这里,vLLM 部分还剩最后一篇收官——把 15 篇的机制拼成全景地图。本篇之后建议暂停一次,自己沿”一条带 stop string 的流式请求”把 1→15 篇的机制链独立走一遍;能走通,就达到”能读懂、能讲清楚”的系列目标了。
全景
先把”出”侧的架构图摆出来。V1 把”停止判定”这个职责显式一分为二
[EngineCore P1] 每个 step update_from_output(): ├─ append_output_token_ids(token) ├─ check_stop(): stop token id? 超过 max_tokens? │ 是 → finish_reason=STOP/LENGTH,本请求出队 └─ 打包 EngineCoreOutput{new_token_ids, finish_reason, stop_reason} │ ZMQ ▼[前端 OutputProcessor.process_outputs()] # 每步"唯一应该循环批的函数" for engine_core_output in outputs: 1) 更新统计 _update_stats_from_output 2) detokenizer.update(new_token_ids, stop_terminated) ├─ 逐 token 增量解码 → 追加 output_text ├─ StopChecker.check_stop_strings() 在文本流上找 stop string │ 命中 → 返回 stop_string,可能截断 output_text └─ 返回 stop_string 3) logprobs_processor.update_from_output() # 若请求要求 4) make_request_output() ├─ DONE 方式决定 DELTA/CUMULATIVE/FINAL_ONLY 的形状 └─ 塞进 RequestOutputCollector(异步流)或列表(同步) 5) finish_reason 就绪? └─ 是,且 EngineCore 侧还未标记结束 → reqs_to_abort.append │ ▼ abort 回传 async_llm.generate() 收到 reqs_to_abort → engine_core.abort_requests_async()几个角色名词先固定下来(术语约定)——在此之前,先看官方博客的引擎循环图,注意本篇的位置:前十四篇覆盖了图里 EngineCore 循环的左侧与中部(scheduler、model runner),本篇覆盖右侧输出流出 EngineCore 之后的那段:
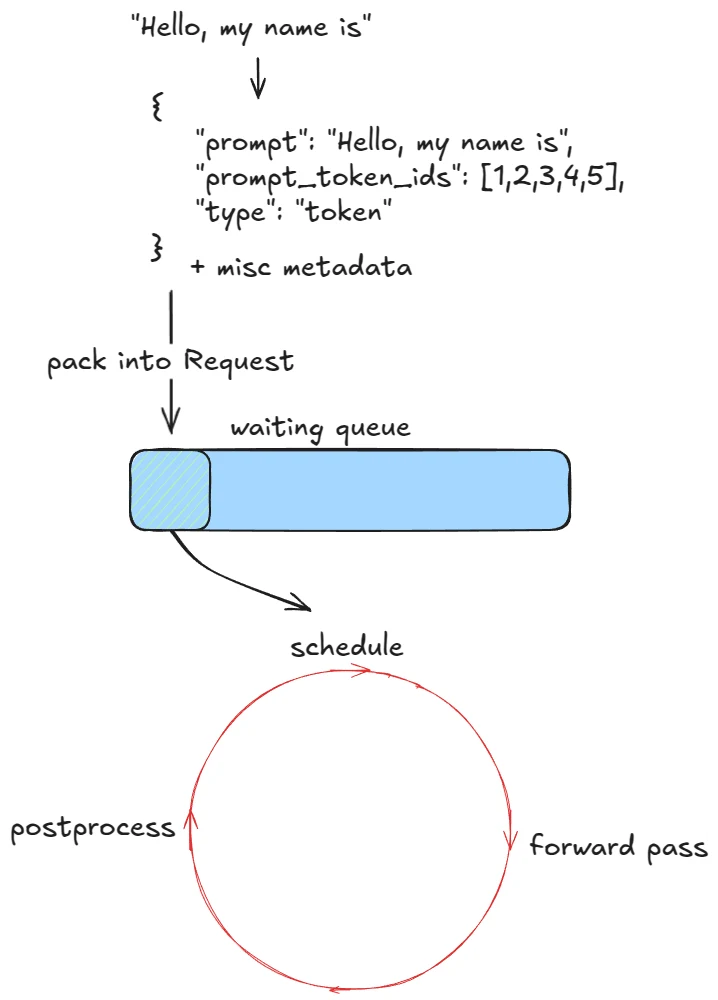
- stop_token_id:单个 token 的停止条件(如 EOS)。模型词汇表的
eos_token_id会被SamplingParams.update_from_generation_config自动合并进来,用户通常不用手填。 - stop string:任意字符串列表(
SamplingParams.stop),如"USER:"、"”`,在解码后的文本上匹配,匹配后还要决定”停在哪、截不截、包不包含”。 - finish_reason / stop_reason:前者是枚举(STOP/LENGTH/ABORT),后者携带细节——stop string 模式下是被命中的字符串本身,token 级停止下是 token id。
- delta vs cumulative:流式接口给用户的两种文本口径,
get_next_output_text的delta参数控制;详见后文。
stop string:一段被低估复杂度的字符串搜索
StopChecker.check_stop_strings(vllm/engine/output_processor/stop_checker.py:95)的全部逻辑不到 25 行,但每一行都在处理边界。签名先看清:
@staticmethoddef check_stop_strings( output_text: str, # 到目前为止解码出的全部文本 new_char_count: int, # 本次 update() 新增的字符数 stop: List[str], # 用户给的停止串列表 include_in_output: bool, # 命中的 stop string 是否包含在输出里) -> Optional[Tuple[str, int]]: # (命中的串, 截断位置 or -1)为什么需要 new_char_count
朴素做法是每个 step 都对 output_text 全文执行 find(stop_str)——正确但浪费:文本到几千字符时,每 token 扫一遍全文,O(T²) 的总开销。优化思路是只搜可能的新匹配find 的起始下标写成 1 - new_char_count - stop_string_len,负数下标从尾部数起,正好落在”上一次搜索已保证无匹配的区域”之外。这一个哨兵值同时做了两件事:窗口刚够覆盖”新字符里藏着的完整匹配”和”跨新旧边界的部分匹配”,又不重扫旧文本。跨步增量搜索 + 长度参数圈定窗口,是这段代码的核心技巧;也解释了 detokenizer 为什么把 new_char_count 一并传进来(len(self.output_text) - offset_before)。
截断位置的两分支
命中后返回什么取决于 include_in_output:
if include_in_output: stop_index += stop_string_len # 截到 stop string 的"末尾之后" if stop_index >= len(output_text): return stop_str, -1 # stop string 恰好在末尾,无需截断return stop_str, stop_index # 截到 stop string 的开头三个出口对应三种语义:(str, -1) 是”包含且正好结束,无需动作”;(str, idx) 是”把输出截断到 idx”(不含模式,或含模式但后面还有残留);None 是没命中。截断发生在文本层,token 层的 token_ids 不回退——这点跟 KV cache 的处理呼应
hold-back 缓冲:流式场景下的”先别发”
一个独立于检测的流式正确性问题:用户设置 stop=["USER:"],当前已解码出完整文本 "你好,USER:"——匹配刚刚在这一步才完成的;若前端每个 step 都把 output_text 全文增量推给用户(delta 模式),那么 "USER:" 的前三个字符 USE 可能在上一步就已经被当成”普通文本”流给出去了,等 stop 判定完成再想回收,已经晚了。vLLM 的对策是 BaseIncrementalDetokenizer 的 stop_buffer_length:
if stop and not self.include_stop_str_in_output: self.stop_buffer_length = max(len(s) for s in stop) - 1else: self.stop_buffer_length = 0get_next_output_text(detokenizer.py:146)在计算”本次给用户的文本”时,把窗口右端刻意向左收 buffer_length 个字符:未结束时只放出”确定不会被后续 stop 匹配改变”的部分——任何比最长 stop string 短 1 的尾巴都先扣住;结束时(finished=True)buffer_length 归零,全文放行。这是”以延迟换流式正确性”的标准权衡,参数大小(stop 最长串长度-1)就是扣住的时间量级——stop string 越长,流式收尾的延迟越高,但不会漏泄违规前缀。
把 hold-back 与截断放在一起看,两个机制分别堵住两条泄漏路径:截断堵”已经发出的文本包含违规内容”(靠文本层回退),hold-back 堵”尚未判定的文本被提前发出”(靠右端收口)。二者共同确保:流式与非流式两种模式下,用户最终看到的文本都满足”不含(或按配置包含)stop string”的承诺——这也是为什么 include_stop_str_in_output=True 时 buffer_length 严格为 0:模式串本身是要发给用户的,不存在”提前漏出”的问题。
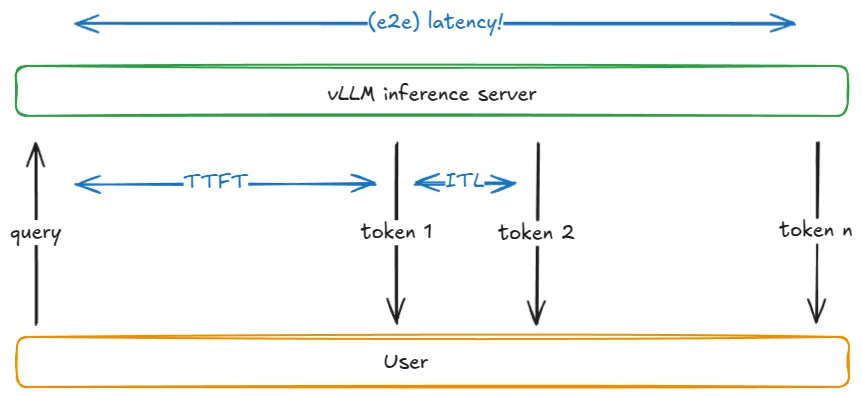
hold-back 的引入让”流式逐帧延迟”有了一个可量化的画像——官方博客的延迟分解图正好给出这个视角(输出侧的每一步都在延迟预算内排队):
停止条件的全景分类
把 vLLM 支持的全部停止条件按”在哪一层判定、消耗什么”归纳成一张表,排查时可以按图索骥:
| 条件 | 判定层 | 依据 | 对应 finish_reason | 截断行为 |
|---|---|---|---|---|
| EOS / stop_token_ids | EngineCore | token id 命中 | STOP | token 计入输出(可配 skip_special_tokens 不显示) |
| max_tokens | EngineCore | 已生成数达到上限 | LENGTH | 完整保留已生成内容 |
| stop string | 前端 detokenizer | 解码文本命中 | STOP | 按 include_stop_str_in_output 截断 |
| 请求取消 / 客户端断开 | 前端 → abort | 用户主动 abort | ABORT | 输出到断点为止 |
四类条件的判定时机依次错开:前两类在 EngineCore 的 update_from_output(第三篇拆过的调度闭环里的 check_stop),零浪费;第三类在前端,一 step 浪费;第四类甚至可能发生在请求还在 waiting 队列里、从未开始生成时——abort 会把 waiting 状态的请求一并清除。同一个”停”字,四种语义,三个执行位置——这是把”停止条件”从直觉拆成机制的代价,也是排查”为什么我的输出停在奇怪的地方”的第一张地图。
与投机解码的交互也在这张表的范围里:投机路径上,EngineCore 判停的对象是被接受的 token 序列——草稿 token 被拒绝的部分不参与 stop 判定(update_from_output 只对 new_token_ids 里被接受的 token 追加与检查);所以投机解码不会”跳过 stop token”——被拒绝的草稿即使恰好是 stop token,也不算数。这是第十篇”token 接受流水线”在停止维度的自然延伸:一切输出语义都以净接受的 token 为准。
增量解码:两条实现路径
IncrementalDetokenizer.from_new_request(detokenizer.py:47)按 tokenizer 类型分派:
if tokenizer is None: # detokenize=False 或纯 token 模式 return IncrementalDetokenizer() # 空实现:只存 id,不解码if USE_FAST_DETOKENIZER and isinstance(tokenizer, PreTrainedTokenizerFast): return FastIncrementalDetokenizer(tokenizer, request) # tokenizers 库 DecodeStreamreturn SlowIncrementalDetokenizer(tokenizer, request) # HuggingFace Python 路径为什么不能”每个 token 各自解码”
词表里的 token 是子词片段,解码器还可能做 BPE 后处理(如 Byte-Level 清理、空格规范化)。同一 token 前面接不同的上下文,解码出的字符串可能不同——因此单个 token 的”文字值”不独立存在,必须带上下文解码。SlowIncrementalDetokenizer 用”prefix_offset/read_offset 双指针”控制上下文窗口(detokenizer_utils.py:100 的 detokenize_incrementally):每次取 output_tokens[prefix_offset:] 重新解码成 new_text,与上次的 prefix_text 相减,得到新增部分;双指针前移的量由本次新增 token 数决定。INITIAL_INCREMENTAL_DETOKENIZATION_OFFSET(默认 32)是启动时的上下文预热长度——只把 prompt 末尾一小段转成 token 缓存,注释点名了两个限制:太短会出 vocab 越界,特殊 token 需要多留两格。
Faster 路径
tokenizers 库的 DecodeStream 把这层簿记内化到 Rust 侧:stream.step(tokenizer, tid) 内部维护同样的前缀上下文,单次调用等价于 Python 版的 subtract 双指针。vLLM 的 FastIncrementalDetokenizer 在此之上还处理了特殊 token 空格语义(spaces_between_special_tokens=False 时,连续特殊 token 之间不加空格——需要自己用 added_token_ids 记录上一个 token 是否特殊,detokenizer.py:218-224)——注释里”Store dict of added token ids so that we can suppress the spaces between them”就是指这件事,词表预处理的产物被缓存在 tokenizer 对象本身(跨请求复用)。
DecodeStream 的”启动预热”(detokenizer.py:179-191)是另一处隐蔽设计。流式解码有状态,但它不知道本请求的 prompt 结尾——直接用空状态解码新 token,前几个 token 的上下文是错的(比如一个以未完全 UTF-8 字节结尾的中文 prompt,新 token 的合并行为会不同)。预热方案很有分寸感:取 prompt 末尾最多 23 个 token 从头试到尾,选一个解码结果不含 � 的后缀做预热(用更短后缀解码时可能出错——多字节字符被腰斩),把这几步”先走一遍”但不把结果算进输出文本:
prompt_suffix = request.prompt_token_idsprompt_len = len(prompt_suffix)if prompt_len > 4: for i in range(4, min(prompt_len + 1, 24)): suffix = request.prompt_token_ids[-i:] if '�' not in self.tokenizer.decode(suffix): prompt_suffix = suffix break
# Prime the stream.for tid in prompt_suffix: self._protected_step(tid)读者值得在这段 13 行的代码上多停留一会儿,它浓缩了三个工程判断。循环从 4 起步:一个 UTF-8 字符最多 4 字节,3 个 token 以内的后缀无论如何试都不能代表”安全截断点”——从 4 开始是下界的直接表达。循环到 24 封顶:若末尾 23 个 token 全都解不出干净文本,说明这里横着一个超长多字节序列(或 tokenizer 本身有坏数据),继续加深预热的边际收益是零,选择”接受一个可能有小瑕疵的预热”比无限加深更好——prompt_suffix 此时保持为完整 prompt,预热步数等于 prompt 长度,这个最坏情况在正常 tokenizer 语境下不会触发,但代码没有断言保护它,属于”信任上游 + 最坏代价可承受”的写法。预热结果不进输出:_protected_step 的返回值被刻意丢弃,DecodeStream 的状态前进了,但 output_text 没有增长——预热是”给解码器看上下文”,不是”替用户读内容”。这三条合起来的效果是:任何 prompt 结尾(包括切在汉字中间、切在特殊 token 上)都不会让第一个生成 token 的文本出错,而预热代价被压到常数级。
慢路径的适用边界
慢路径(SlowIncrementalDetokenizer)不是”旧版残留”,它有真实的适用面:非 fast 的 tokenizer(如某些 SentencePiece 封装)、以及带 added_vocab 且 is_fast 为 False 的混合封装。detokenize_incrementally 内部根据 tokenizer.is_fast or not tokenizer.get_added_vocab() 分两条字符串化路径(detokenizer_utils.py:162):前者直接 convert_tokens_to_string,后者要过 _convert_tokens_to_string_with_added_encoders——因为 added token(如聊天模板的特殊标记)可能被 decode 的清理算法改写,需要显式的空格控制。“快慢”的分水岭不是性能刻意的产物,而是 tokenizer 库两代 API 的现实tokenizer.is_fast 即可;LLaMA/Qwen 系默认 fast,自己微调后保存的 tokenizer 若用了旧的 slow 保存方式,会静默掉进慢路径(症状:流式输出的 CPU 开销明显变大,GPU 利用率反而高)。
非 UTF-8 中断的恢复
_protected_step(detokenizer.py:228)给 stream.step 包了一层防御:若 tokenizers 抛出 INVALID_PREFIX_ERR_MSG(“Invalid prefix encountered”),新建一个空 DecodeStream 重置状态后重试,而不是让请求崩掉。触发条件是模型的输出”非单调、产生非法 UTF-8”(issue #17448 记录了现场:某些模型在采样异常时会产生字节级非法序列,让 DecodeStream 的内部状态进不去)。重置状态意味着丢弃上下文,后续 token 的解码质量会降,但这只发生在”模型本来就在产生垃圾”的场景——相比整个请求 500,降级是更好的错误语义。
多字节中段的 hold
在讲停止条件之前,值得先把”为什么慢路径要留双指针、快路径要预热”这个共同背景交代清楚:解码器的输入是 token 序列,输出是”从某个前缀开始的字符串”,而”新增文本”这个词没有天然定义——它取决于你怎么看上下文。两条路径处理同一问题的不同机制,共同点是都让”上下文充分的解码 + 只取新增部分”可以独立重复进行。
detokenize_incrementally 的最后几行(detokenizer_utils.py:181-186)有对”未完成字节序列”的显式处理:
if len(new_text) <= len(prefix_text) or new_text.endswith("�"): # utf-8 char at the end means it's a potential unfinished byte sequence # from byte fallback tokenization. return new_tokens, "", prefix_offset, read_offset # 本步不产出文本一个中文字符往往占 2~3 字节、横跨多个 BPE token;中间态的解码结果要么变短(字节还没拼齐),要么以 � 结尾(字节半阙)。此时本步返回空串、双指针不前移,等下一个 token 把字节拼完整再一次性吐出。这让”字数 ≈ token 数”的直觉在流式里不成立,但对 stop string 检测是对的语义——匹配发生在”已确认完整”的文本上。若在中间态文本上做 stop 匹配,会出现”模式串的第 2 个字节恰好是多字节字符的上半部分”这类伪命中。
输出侧的流式切分
RequestOutputKind 决定 make_request_output 产出的形状。三种模式不是三种”渲染方式”,而是三种数据流契约:
- CUMULATIVE(同步默认):每次
RequestOutput带从开头到现在的完整output_text。前端每步都是”最新全文”,实现最简单,但大输出时每步传输 O(T) 字符,总开销 O(T²)。 - DELTA(流式):每帧只带自上一步以来的新增文本。
RequestOutputCollector.put看到 DELTA 时,把”尚未被消费的旧 delta”与”新 delta”合并(aggregate=True分支)——消费速度跟不上生产速度时,中间帧不丢、只是合并成一帧更大的 delta。 - FINAL_ONLY:中间步直接返回 None(
output_processor.py:176),只有结束那一帧带完整文本;批处理客户端用这个模式最省。
DELTA 与 hold-back 的合作在 get_next_output_text(detokenizer.py:146)里有一处精确的咬合:
buffer_length = 0 if finished else self.stop_buffer_lengthif not delta: return self.output_text[:-buffer_length] if buffer_length else self.output_textlength = len(self.output_text) - buffer_lengthlast_offset = self._last_output_text_offsetif last_offset < length: self._last_output_text_offset = length return self.output_text[last_offset:length]return ""两件事同时发生:右端收敛(减掉 buffer_length)与左端推进(_last_output_text_offset 记住上次发到哪)。delta 的切口是同一条物理文本上两个偏移的差——hold-back 让右端左移时,本帧 delta 比”这步新增的全部字符”短,被扣住的部分等 stop 判定落定、buffer_length 归零后,在后面某帧里自然补齐(左偏移停在旧位置,新右端覆盖了之前扣住的字符)。这是”不丢失、不重复、不提前”三个流式约束在同一对偏移量上的统一实现。
还有一个容易忽略的顺序语义:截断发生在 detokenizer 的 output_text(detokenizer.update 内),切分发生在其后的 make_request_output——先截断、后切分。所以 DELTA 流里不会出现”已被截断的内容还在后续帧中”的鬼影:截断掉的右端从未进入过任何一帧的窗口。
RequestOutputCollector:消费侧的合流阀
流式消费模型里,RequestOutputCollector(output_processor.py:24)是连接”生产(每 step 的输出)“与”消费(用户侧的 async for 循环)“的缓冲。设计目标是:消费慢时丢帧不丢内容。三个成员:
def put(self, output): if not self.aggregate: wait self.output ... # 非 DELTA:简单覆盖/等待 if self.output is None: self.output = output # 空则直接占位 else: # DELTA 且已有未消费的输出:合并(append token ids / 连接文本) ...put_nowait / event.set()...DELTA 模式下连续两个未消费的输出合并成一帧——token id 列表拼接、文本 delta 直接连接(logprobs 亦按同规则合并);消费侧醒来看到的是”一段时间内的净变化”,与逐帧消费在最终文本语义上等价。CUMULATIVE/FINAL_ONLY 模式下不合并(新输出直接覆盖旧的:反正每帧都是全文快照或只有最终帧)。
这个合流阀回答了一个流式服务的经典难题:“async for 消费者的处理耗时不可控,输出怎么办?”——背压无法向上游传递(GPU 不等人),那就把”不可控的消费延迟”隔离在前端队列里CompletionOutput 的 text 拼接、token_ids 延长、logprobs 延长,字段级的增量合并逻辑集中在 collector 里,这让”DELTA 契约”从 detokenizer 一路到用户回调保持同一条语义线。若做下游二次分发(如 WebSocket 网关),建议在自己的层里也复用”合并未消费帧”的模式,而不是指望 TCP 缓冲。
把输出侧与调度侧的时间尺度放在一起,能看清前端在流式服务里的真实定位
一道走查题:三个 stop 条件一起上场
把所有机制放到一个具体例子里走一遍,设定
SamplingParams( max_tokens=512, stop=["\nUser:", "END"], include_stop_str_in_output=False,)Step 1(请求创建):前端 OutputProcessor 为请求建 RequestState;detokenizer 按类型选中 Fast 路径,DecodeStream 用 prompt 末尾的”干净后缀”预热(若末尾是”例:“且无坏字节,后缀可能只有 1 个 token 也够——预热循环从最短试起);stop_buffer_length = max(6, 3) - 1 = 5(两个 stop 串取最长 \nUser: 减 1)。EngineCore 侧 status 是 WAITING,sampling_params.update_from_generation_config 已把模型的 EOS 合并进 stop_token_ids。
Step 2-3(prefill 中):调度器分块推进 prompt,每步 EngineCoreOutput 的 new_token_ids 为空(prompt 部分不算输出)。detokenizer 的 update 直接短路返回(if not new_token_ids: return None),stop 检查不发生;流式消费者拿到空 delta(DELTA 模式下 collector 合并,等价于这一帧不存在)。
Step 4(prefill 完成,产出第一个 token)"Here is the translation: "。stop 检查"Here is the tran",末尾的 ion: 还押着。
Step 5-9(逐 token 流式):每当解码文本累计长度超过 buffer_length,新增的”安全区”文本逐帧放出。某步解码出 "...\"value\". If you have any questions,"——注意 If you 里的 If 不匹配任何 stop 串(它们是 \nUser: 与 END),文本照常;若模型输出的是 "The END" 呢?END 在这一步的解码文本里命中,check_stop_strings 返回 ("END", 截断到该位置),output_text 截断,finish_reason=STOP、stop_reason=“END”;该步的 EngineCoreOutput 未带 finished(EngineCore 还不知道),req_state 收进 reqs_to_abort,回传给 EngineCore;下一 step 调度器里这条请求消失,KV block 释放。若此时还有同批请求,它们的调度不受影响——批循环里 abort 只改变这一条的状态。
若走到的不是 stop 串而是 max_tokens=512get_next_output_text(finished=True) 的 buffer_length 取 0,hold 押住的尾巴一次性放完,最后一帧比前面的帧长几个字符。
若 EOS 在某步被采样出skipped_stop_token_id 的 append/decode 跳过逻辑就是干这事的,输出文本在 EOS 处自然收束。
这三种结局覆盖了上表的前三行;走查一遍会发现,每个机制的”存在感”都只在它该出现的分支上——正常路径里 hold-back 与 delta 稳态运转,EOS 路径里 skipped_stop_token_id 生效、stop string 检查被短路(return None 注释
用走查里的数字再算一笔 hold-back 的账,把”延迟换正确”的权衡具体化。stop 串取 \nUser:(6 字符,buffer 5 字符),按 GPT 系 tokenizer 平均每 token 4 字符算:5 字符的 hold-back 意味着约 1.25 个 token 的文本被押后发布;换算成时间,等于把流式的最后一帧延迟了 1-2 个 step——在每 step 数十毫秒的语境下,这是几十毫秒量级的收尾延迟,远小于模型一遍前向;而它换来的是”违规前缀零泄露”的硬保证。把同样的账放到更极端的配置:若用户给了 10 条 stop 串、最长 50 个字符,buffer 是 49 字符 ≈ 12 个 token ≈ 数百毫秒的收尾延迟——此时正确的工程动作不是抱怨机制,而是合并/缩短 stop 串,或在业务层接受”最后一段文本一次性到达”的形态。参数先行的延迟责任,在这里是字面意义上的。
顺带补一个与”停止条件分层”相关的架构对照。Token 级停止由 EngineCore 闭环还有一个隐藏收益:它发生在抢占路径之外。请求因 LENGTH 或 EOS 结束时,它的 KV block 走主动释放路径(优雅出队,块立刻回池);而 stop string 的 abort 路径在语义上更接近”客户端取消”——两者殊途同归到同一个块回收代码,但前者省了一次调度循环的出入队、一次请求对象的状态翻转。生产里若能预知”输出会以固定前缀结束”(如 JSON 的结尾括号),把”等文本层 stop”优化成”把该终点教会模型(如用 structural_tag 的 end 标记)“,停止就整体上移到 token 层,这个优化值一个数量级——这也是上一篇的 structural_tag 在工程上的真实动机之一。
停止后的回传
stop string 命中有个结构性的尴尬:它发生在前端进程,而生成在 EngineCore 还在继续——调度器还在为这条请求排 KV block、跑前向,直到 token 层的停止条件(若有)触发。若不处理,用户的输出已定格,引擎却在为一条”头脑里已经结束”的请求继续付费。
vLLM 的对策在 output_processor.py:420-431:
# Free completed requests.if finish_reason is not None: self.request_states.pop(req_id) ... if not engine_core_output.finished: # If req not finished in EngineCore, but Detokenizer # detected stop string, abort needed in EngineCore. reqs_to_abort.append(req_id)判定条件 not engine_core_output.finished 精确区分两种结束reqs_to_abort 收集的就是后者。process_outputs 把列表返回给 async_llm.generate 的循环(async_llm.py:406-408),调用 engine_core.abort_requests_async(reqs_to_abort);abort 是 P0→P1 的控制消息,让调度器把请求出队、释放 KV block(已生成的 token 不浪费——它们已经流给用户了)。
对比 token 级停止:check_stop 在 update_from_output 里同步发生,下一 step 的调度列表里请求已不存在——token 级停止零浪费,文本级停止最多浪费一个 step 的调度与前向。为什么 vLLM 不把 stop string 检测下沉到 EngineCore?把文本比对搬过进程边界,要么把每步解码文本回传(而文本只在请求的 detokenizer 里增量存在),要么让 EngineCore 也持解码器(重复解码成本);一个 step 的浪费换来职责的干净分离,是亏得起的买卖。谁拥有状态,谁做判定——stop string 的状态(文本流)在前端,判定就在前端,代价用一条 abort 消息结清。
detokenize=False 与 logprobs 侧的输出
detokenize=False(或 skip_tokenizer_init=True)时,输出侧退化成”纯 token 流”output_processor.py:126-142 的分派只对带 SamplingParams 的生成请求生效),make_request_output 产出的 CompletionOutput 只有 token_ids、没有 text。这个模式不是边角料——RLHF/评估流水线里常见的”引擎只出 token id、打分器自己解码”用法就靠它;它的代价(前文坑 4)是 stop string 失效,收益是前端每步的 CPU 开销归零(解码、stop 搜索、文本构造全部跳过),批处理吞吐因此更接近纯 EngineCore 的上限。
logprobs_processor(vllm/v1/engine/logprobs.py)与 detokenizer 是同一循环里的左右手pop_prompt_logprobs(output_processor.py:218-222)把 prompt 部分的 logprobs 只在第一帧给出、之后弹空——这对应 OpenAI API 的 first-chunk 特例(第一帧的 choices 里带 prompt_logprobs 字段)。与 detokenizer 一样,它的工作量与”是否请求该功能”强相关:logprobs=None 的请求这条链完全空转,这正是第九篇说过”logprobs 是按需付费的功能”在输出侧的另一半。
两个输出组件的分工划清了一个测试边界
多候选的输出归并
n>1 的请求(一个 prompt 生成 N 个候选)在 V1 里拆成 N 个子请求,各自独立调度与解码;ParentRequest(vllm/v1/engine/parallel_sampling.py:12)在输出侧把它们重新归并:每个子请求产出自己的 CompletionOutput,get_outputs 把完成候选的列表聚进同一个 RequestOutput(output_processor.py:189-195);父请求的 finished 等所有子请求结束才置 True,最后一个结束的子请求还负责触发父请求的统计收尾(observe_finished_request)。注意每个子请求独立持有 detokenizer 与 stop 检查——N 个候选里第 3 个先命中 stop string,先结束、先回传,不影响兄弟候选。这套”独立调度+归并输出”把分支采样的复杂度限制在输出侧,调度器看到的永远是普通请求;n>1 与流式 DELTA 组合时的合并语义也由 collector 统一处理,不给调度器加任何分支逻辑。output_processor.py 的开发者注释再次得到印证
性能与常见坑
开销画像
输出侧每步的固定成本process_outputs 的注释已经点明它是批循环唯一入口——所有对每请求的处理必须在这个循环体里做,前端每步的 Python 开销才能与批大小保持线性、常数可控。
会放大输出侧成本的三个配置:要求 logprobs/prompt_logprobs(第九篇拆过,构造与序列化在 logprobs_processor);DELTA 流式下游消费慢(collector 合并窗口越聚越大,前端内存涨);超长 stop 串列表(hold-back 由最长串决定,流式收尾延迟被最长的那个拉高)。
常见坑排查
- “stop string 有时截不干净”。先核对 include_stop_str_in_output 与截断语义的组合预期:默认截到串开头,包含要显式开 true。再查 stop 串是否横跨多 token(带前后空格最容易),这类必须走文本层;若又给了很小的 max_tokens,“停在半句”其实已到长度上限。
- 流式输出的中文字符”卡顿一拍”。多字节字符拼齐机制,非阻塞:一帧无新文本,下一帧一次蹦出一个字。想摊平可换用聚合帧或上游消费更快的客户端。
- stop 命中后请求还在烧算力。这是 abort 回传问题:确认 EngineCore 日志中该请求是否在下一 step 前出队,
reqs_to_abort经 async_llm 循环是否被异常吞掉。 - detokenize=False 的静默降级。此时 detokenizer 为空实现、stop string 完全失效(没有文本可匹配),只有 token 级条件生效——纯 token 模式下要自己维护停止判定。这与结构化输出篇”skip_tokenizer_init 时约束失效”是孪生场景:输出侧的多数功能以”存在解码文本”为前提。
- 多 stop 串的命中顺序。check_stop_strings 按列表顺序遍历、命中即返回——列表顺序就是优先级,若多个串可同时命中(如
"AB"与"A"),先出现的先定截断点;需要”最长命中”语义时自己排好序传入。
与站内其他机制的关系
与 Sampler(第九篇):第九篇收尾在”输出回传到调度器闭环”,本篇从闭环下一站接棒——Sampler 决定”采出什么 token”,本篇处理”token 变什么文本、何时停”。两个 stop 层次(EngineCore 的 token 级、前端的文本级)对应两条独立代码路径,finish_reason/stop_reason 是它们的汇合点。
与调度器(第三/四篇)
与结构化输出(上一篇):交叉点在 max_tokens 与约束终止的竞争——上篇说过”stop 条件胜出,输出于是不完整”;本篇补全 stop 一侧的实现细节后,那个语义边界有了完整的机制解释。
与 P/D 分离(DistServe 篇的延伸)
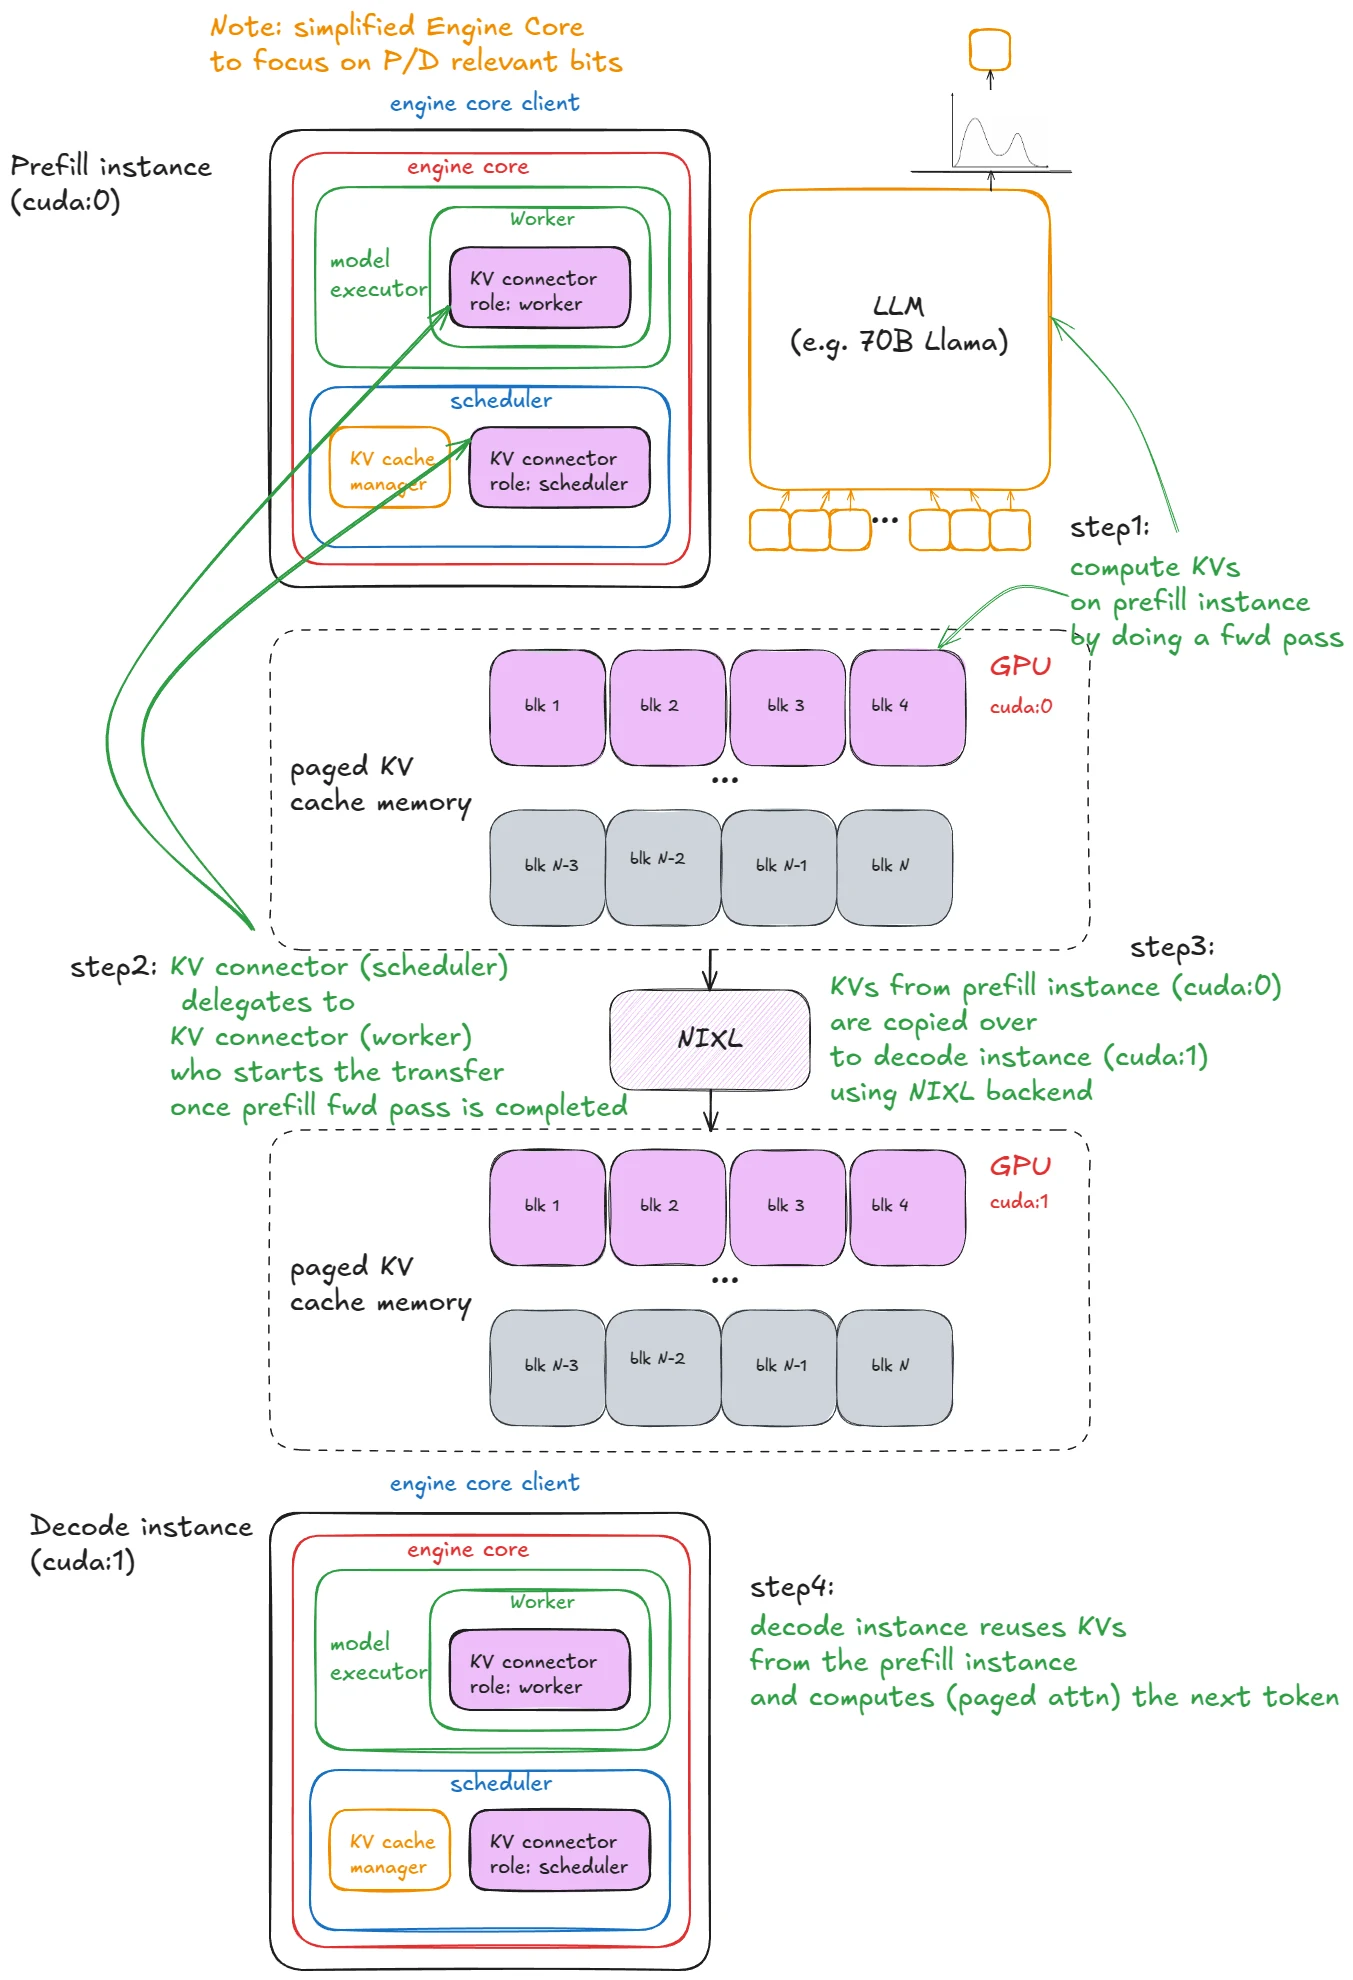
这个”输出侧零改动”不是巧合,而是分层红利:输出处理只依赖 EngineCoreOutput 抽象,不关心它在哪个进程、哪张卡上生成。对比输入侧——多模态让预处理大改、结构化输出让调度加状态——输出侧是 V1 各子系统里受架构演进冲击最小的一层,原因是它处理的抽象(token id 流)自始至终稳定。读框架源码时,这种”几乎不动的层”是理解系统不变量的最佳锚点:EngineCoreOutput 的字段就是 V1 一年演进的沉淀,每个字段背后都有一次真实的架构变动。
三个设计决策的复盘
把这一环里最值得争论的三个选择单独拿出来,每个都给出”当时可能的另一条路”与选这条的理由——这是系列里反复用的收束法,对”改框架的人”比对”用框架的人”更值钱。
决策一
决策二
决策三:增量解码为什么分快慢两条路径,而不是把慢路径砍掉、只支持 fast tokenizer?生态现实:不少开源模型的 tokenizer 仍是 slow 封装,或者 community 改写版保存后 is_fast 丢失;推理框架”只支持 fast”的代价是这些模型直接不可用。慢路径保有正确语义(双指针增量),让它成为兜底而不是障碍——而且它的存在反而让 fast 路径的边界被测得更清(两路径跑同一测试集、结果必须一致,vLLM 的多路径测试就是这么组织的)。兼容性兜底代码的价值不在性能,而在”什么模型都能跑”——llama.cpp 系与 TensorRT-LLM 在 tokenizer 支持面上的差异,很大程度上就是这条哲学的分野。
三个决策连起来读,输出侧的设计观浮现出来:它的复杂度不在算法,而在边界——进程边界(stop/abort)、时间边界(hold-back)、生态边界(fast/slow)。每一处边界都被处理过,所以才”看起来只是胶水”。
与站内已有文章的关联再补一条线:流式输出的消费者们。本篇拆的 DELTA/hold-back 机制,与实时场景的关系最近——语音助手逐句播报、Agentic 工作流对首轮 token 的等待,都是这套机制的直接受益方;站内的StreamingLLM 拆解讲的是”无限流式输入”的注意力机制,与本篇的”流式输出”是流的两端,互为对照:一端在解决”KV 缓存放不下长流”的问题,另一端在解决”长流如何体面地送到用户眼前”。合起来看,一个流式 LLM 服务的完整性,恰好由这两块拼出。
V1 输出侧的机制压成三条线索:
- 停止条件分两层
级在 EngineCore(零浪费),文本级在前端(一 step 浪费加 abort 回传);分层的依据是”状态在哪层,判定就在哪层”。 - 停止串匹配是增量算法
圈定搜索窗口避免全文重扫;hold-back 缓冲保证流式不泄露未判定文本;截断只动文本层、不动 token 层。 - 解码是有状态流
的末尾 23 token 预热、多字节中间态 hold、Invalid prefix 异常重置——每处防御对应一类真实故障;DELTA/CUMULATIVE/FINAL_ONLY 三种契约与 collector 的合并窗口共同守住”不丢、不重、不提前”。
至此,一条请求”从 logits 到用户屏幕”的机制全部拆完;V1 引擎主干——输入、调度、执行、采样、约束、输出——在本系列全线闭环。输出侧给整条链路的收束语是:引擎对用户的全部承诺(不丢字、不提前、该停就停、合法就合法),都由倒数第二环的 bitmask 与本篇的 stop 机制背书——前面十三篇的极致性能,最后都要过这两个”守门员”。下一篇收官:把 15 篇的机制拼成一张 vLLM 全景地图,标注每条链路的源码入口与关键数据结构,作为本框架部分的总结,也作为后续 SGLang、llama.cpp、TensorRT-LLM 横向对比的基线。
参考资料
- vLLM 源码 v0.9.2
/engine/detokenizer.py(增量解码器与 hold-back) - vLLM 源码 v0.9.2
/engine/output_processor.py(RequestState 与 process_outputs) - vLLM 源码 v0.9.2
/engine/output_processor/stop_checker.py(停止串搜索算法) - vLLM 源码 v0.9.2
/transformers_utils/detokenizer_utils.py(双指针增量解码) - vLLM 源码 v0.9.2
/engine/async_llm.py(abort 回传与流式消费) - tokenizers 库 DecodeStream(流式解码原语)
- vLLM issue #17448:非法 UTF-8 导致 DecodeStream 状态损坏的现场
- vLLM 官方博客
引擎架构剖析(本文配图来源)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


