


vLLM 源码完全拆解(一):整体架构与模块全景
系列引言:为什么要系统读推理框架源码
大模型推理框架是连接模型权重与用户请求的关键基础设施。无论是 vLLM、SGLang、llama.cpp 还是 TensorRT-LLM,每个框架都有几十万行代码,背后沉淀了大量工程智慧——从 KV Cache 的内存管理到 GPU kernel 的调度策略,从连续批处理的调度算法到分布式推理的通信模式。
这个系列的目标是把四个主流推理框架的源码讲透。每一篇只深入一个模块或一个知识点,从整体架构出发,逐层拆解到关键代码。原则很明确:先讲清楚这个模块解决什么问题,再用伪代码梳理核心逻辑,最后才摘少量真实代码印证——目标是让读者读完能自己去看源码,而不是被几十万行代码吓退。
从 vLLM 起步是最自然的选择。vLLM 是目前社区生态最活跃、文档最完善的推理框架,它的 PagedAttention 已经成为推理服务的事实标准,它的架构设计深刻影响了后续的 SGLang、lmdeploy 等框架。读懂 vLLM,相当于掌握了推理框架领域的”通用语言”。本站在此之前已经覆盖了 vLLM 的几个核心技术——PagedAttention、连续批处理和 RadixAttention(前缀缓存),读者可以先参考这几篇建立基础概念:
- PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率
- 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理
- RadixAttention 完全拆解:用前缀树自动复用 KV Cache
本篇是 vLLM 子系列的第一篇:先不深入任何一行代码,而是把整个架构的全景图画出来——vLLM 分了哪几层、每层有哪些核心模块、数据如何在模块之间流动。读完这篇,读者应该能说出 vLLM 的完整模块地图,知道从哪里入手阅读源码。
vLLM 的历史与定位
vLLM 源自 UC Berkeley Sky Computing Lab,由 Woosuk Kwon 和 Zhuohan Li 等人于 2023 年发表在操作系统顶会 SOSP 上。论文标题是 Efficient Memory Management for Large Language Model Serving with PagedAttention,核心贡献是把操作系统中的虚拟内存与分页思想引入 LLM 的 KV Cache 管理,提出了 PagedAttention 算法和基于它的 vLLM 推理引擎。
在 vLLM 出现之前,LLM 推理服务面临一个核心困境:KV Cache 的内存浪费严重。传统的推理系统(如 FasterTransformer、Orca)为每个请求预分配一整块连续内存来存放 KV Cache,最大长度按 2048 token 来预留。但实际请求的长度远短于此,导致内部碎片严重——论文实测数据显示,传统系统中有效利用的 KV Cache 内存仅占 20.4% 到 38.2%。
vLLM 的解决方案简洁而深刻:把 KV Cache 切成固定大小的”块”(block),就像操作系统把内存切成页(page)。每个请求的 KV Cache 不再需要一块连续内存,而是由多个不连续的小块组成,通过一张”块表”来维护逻辑块到物理块的映射。这套机制把 KV Cache 的利用率从 20% 推到了接近 100%,同等延迟下吞吐最高提升了 2-4 倍。
论文发表后,vLLM 迅速成为 LLM 推理的事实标准。截至 2026 年,GitHub 上已有超过 40k stars,被 OpenAI、Anthropic、DeepSeek 等主流 AI 公司广泛采用。它的设计理念(分块 KV Cache、连续批处理、集中式调度)深刻影响了后续几乎所有推理框架。
vLLM 整体架构:四层结构
如果把 vLLM 的代码按职责边界来划分,可以清晰地分为四个层次。从用户请求进入到 GPU 执行完成,数据依次流经:
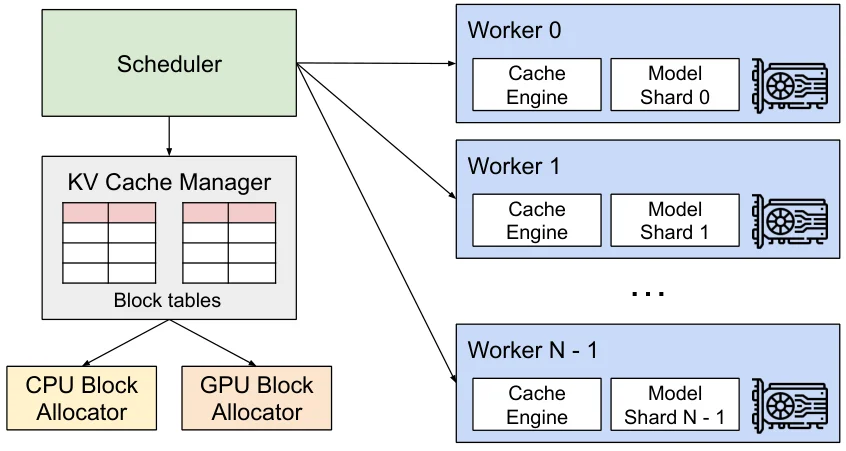
上图来自 vLLM 论文(SOSP 2023)Figure 4,展示了 vLLM 的集中式调度器与分布式 GPU Worker 的协作关系。中央调度器负责协调 KV Cache 管理器和 GPU Worker 的执行。
第一层:入口层(Entrypoints)。这一层直接面向用户,提供了三种交互方式:Python API(LLM 类用于离线批量推理)、异步服务端(AsyncLLM 类用于在线服务)、以及 OpenAI 兼容的 REST API 服务端。入口层的职责很纯粹——接收用户请求、校验参数、将其转发给引擎层。
第二层:引擎层(Engine)。这是 vLLM 的大脑。LLMEngine(以及异步版本 AsyncLLMEngine)负责整个推理生命周期的编排:接收新请求、管理每个请求的状态(Sequence 和 SequenceGroup)、在每个迭代步中决策哪些请求参与本轮计算(调度)、管理 KV Cache 的分配与回收(块管理)、以及将准备好的输入分发给执行层。引擎层还负责处理抢占(当 GPU 内存不足时,将部分请求的 KV Cache 换出到 CPU 内存或直接丢弃并重新计算)。
第三层:执行层(Executor/Worker)。这一层是真正运行模型的地方。GPUWorker 负责管理单个 GPU 上的模型权重、KV Cache 显存和执行模型前向计算。在单 GPU 场景下,只启动一个 Worker;在多 GPU 场景下,按张量并行(tensor parallelism)或流水线并行(pipeline parallelism)的方式启动多个 Worker,每个 Worker 持有模型的一个分片。ModelRunner 是 Worker 内部的核心组件,封装了模型的实际执行逻辑——加载模型权重、准备输入张量、调用各层的 forward 函数。
第四层:Kernel 层。模型执行中最关键的几个算子(PagedAttention、融合的 KV Cache 写入、块拷贝等)由自定义 CUDA kernel 实现,不依赖 PyTorch 的默认实现。这是 vLLM 能实现高性能的基础。
这四层之间通过清晰的接口通信。入口层调用引擎层的 add_request() 和 step();引擎层在每个 step 中产出调度结果,通过控制消息发送给所有 Worker;Worker 完成模型前向计算后,将采样出的新 token 返回给引擎层;引擎层再将这些 token 追加到对应请求的 Sequence 对象中,开始下一轮循环。
入口层:三种姿态接入用户请求
vLLM 提供了三种不同姿态的入口,对应不同的使用场景。
LLM 类:离线批量推理
from vllm import LLM, SamplingParams
llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct")outputs = llm.generate(prompts, sampling_params)LLM 类封装了一个简化的同步推理接口。它的核心实现非常直觉:内部持有一个 LLMEngine 实例,调用 llm.generate() 时,它把所有 prompt 作为请求添加到引擎中,然后循环调用 engine.step() 直到所有请求都生成完毕。这是最方便测试和离线批量处理的入口,但不适用于在线服务场景——它是同步阻塞的。
AsyncLLM:异步在线推理引擎
async_llm = AsyncLLM(model="meta-llama/Llama-3.1-8B-Instruct")async for output in async_llm.generate(prompt, sampling_params, request_id): ...AsyncLLM 是对 AsyncLLMEngine 的轻量封装,提供了异步生成器接口。它内部的引擎运行在后台事件循环中,每个 step 的调度和 GPU 执行与请求的到达是异步并行的——新请求可以随时加入,完成的请求自动返回结果。这是构建在线服务的基础。
OpenAI 兼容 API Server
vLLM 的 API Server 实现了 OpenAI /v1/completions 和 /v1/chat/completions 接口。它在 AsyncLLMEngine 之上挂载了一个 FastAPI 应用,负责 HTTP 请求解析、参数校验、流式输出(Server-Sent Events)和 token 计数。用户可以像调用 OpenAI API 一样调用 vLLM 服务:
curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{"model": "meta-llama/Llama-3.1-8B-Instruct", "messages": [...]}'入口层的设计哲学是”分层独立”:API Server 不需要了解引擎内部的工作机制,它只需要把请求翻译为引擎能理解的格式;引擎也不需要关心 HTTP 协议的细节。这种分层让 vLLM 既可以作为 Python 库嵌入其他应用,也可以作为独立服务部署。
引擎核心:LLMEngine 的调度循环
LLMEngine 是整个 vLLM 的绝对核心。如果只允许读一个文件来理解 vLLM,那就读 llm_engine.py。下面是引擎在每个 step 中所做的事情,用伪代码描述:
def step(): # 1. 调度:从等待队列中选择一批请求 scheduler_output = scheduler.schedule()
# 2. 准备输入:根据调度结果构建输入张量 # - 拼接所有选中请求的输入 token # - 为每个请求准备 block table(逻辑块 → 物理块映射) model_input = prepare_model_input(scheduler_output)
# 3. 执行:调用 GPU Worker 做模型前向 output = executor.execute_model(model_input)
# 4. 采样:对每个请求的输出 logits 采样新 token sampled_tokens = sample(output.logits, sampling_params)
# 5. 更新状态:将新 token 追加到对应 Sequence # - 新 token 写入 KV Cache(通过 PagedAttention kernel) # - 检查是否遇到 eos 或达到 max_tokens # - 完成或超限的请求移出活跃队列 update_sequences(sampled_tokens)这个循环的每一步都值得单独深入讲解——调度器的决策策略、KV Cache 的块分配与回收、模型输入的数据准备方式——后续文章会逐一拆解。本篇先聚焦于架构全景,理解”谁在什么时候做什么”。
Sequence 与 SequenceGroup
引擎用两个核心数据结构追踪每个请求的状态:
Sequence 代表一个序列。它记录了 token 列表、当前状态(WAITING / RUNNING / FINISHED)、逻辑块 ID 列表、以及最后一个物理块的未填充位置。一个 Sequence 对应一个完整的生成过程。
SequenceGroup 是一组相关联的 Sequence。在基础采样(一个 prompt 生成一个回答)的场景下,一个 SequenceGroup 只包含一个 Sequence。但在并行采样(一个 prompt 生成多个候选回答)或 beam search 时,一个 SequenceGroup 包含多个共享相同 prompt 的 Sequence。SequenceGroup 的语义是:同一组内的序列共享 prompt 的 KV Cache,在调度时作为一个整体被选取或抢占。
引擎维护了几个队列来管理 SequenceGroup 的生命周期:waiting(新到达、尚未开始 prefilling 的请求)、running(正在生成 token 的活跃请求)、swapped(被抢占、KV Cache 已换出到 CPU 内存的请求)。调度器在每个 step 中根据这些队列的状态做出决策。
调度器:连续批处理与抢占
vLLM 的调度器实现了迭代级连续批处理(iteration-level continuous batching)。这一机制本站已有专文详解(连续批处理完全拆解),这里从源码架构的角度概括其要点。
传统请求级批处理的问题在于:一批请求必须等所有请求都完成才能开始处理下一批,导致先完成的请求占着内存空等,后来的请求排队干等。连续批处理的解决方案是:在每个迭代步结束时,已完成(遇到 eos 或达到 max_tokens)的请求立即移出 batch,新到达的请求立即加入。batch 的成员”随来随走”,GPU 的利用率始终维持在高位。
在 vLLM 的代码中,这一步对应 Scheduler.schedule() 方法。它按 FCFS(先到先服务)的顺序从 waiting 队列中取出请求,尝试为每个新请求分配一个物理 KV block(用于 prefilling 阶段)。如果有空闲 block 就接纳新请求,没有就拒绝或触发抢占。
抢占是调度器最复杂的部分。当 GPU 的物理 block 全部用尽而又有新请求需要 KV 存储空间时,vLLM 面临两个选择:
Swap(换出):将某个低优先级请求的全部 KV block 拷贝到 CPU 内存,释放 GPU block 给新请求。被换出的请求暂停生成,等待 GPU 有空闲 block 后再换入继续。vLLM 实现了一个与 GPU block allocator 对称的 CPU block allocator,swap 操作的带宽受限于 PCIe/NVLink。
Recompute(重计算):直接丢弃被抢占请求的 KV Cache,等 GPU 有空闲时将该请求的 prompt 与已生成的 token 拼接在一起,重新跑一次 prefill 来重建 KV Cache。这比原始 prefill 更快,因为可以把已生成的 token 与新 prompt 一起做并行计算。
调度器根据 “swap 速度 vs 重计算速度” 的比较来选择合适的抢占策略——论文的消融实验表明,当模型较小、GPU 计算能力强时,recompute 往往更划算;当模型较大、PCIe 带宽充裕时,swap 更合适。
KV Cache 管理:PagedAttention 与块管理器
这是 vLLM 最核心的创新。本站已有 PagedAttention 完全拆解 一文详细讲解了算法原理,本篇从架构层面补充块管理器在整个引擎中的角色。
块管理器的数据结构
块管理器维护了两层映射,与操作系统的虚拟内存几乎同构:
逻辑块(Logical Block):每个 Sequence 看到的 KV Cache 地址空间。逻辑块按位置从 0 开始编号,第 j 个逻辑块存储 token 位置 (j-1)B+1 到 jB 的 KV 向量(B 是块大小,通常为 16)。
物理块(Physical Block):GPU 显存中的实际存储位置。GPU 启动时,块引擎(block engine)在显存中预分配一大块连续空间,将其均匀划分为固定大小的物理块,编号 0, 1, 2, …。
块表(Block Table):每个 Sequence 维护一个映射表 block_table[i] = physical_block_id,表示该 Sequence 的第 i 个逻辑块存储在哪个物理块中。块表的条目还记录了该逻辑块中已填充的 token 数量。
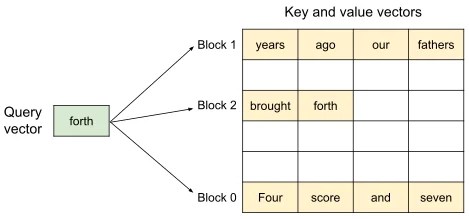
图来自 vLLM 论文 Figure 5:PagedAttention 中 Query 向量依次与三个非连续物理块中的 Key 向量做内积,再与 Value 向量加权求和。
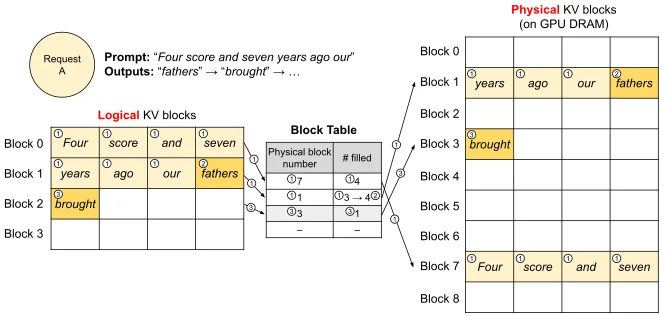
图来自 vLLM 论文 Figure 6:三步解码过程中的块表翻译。第一步 prefill 时分配物理块 7 和 1;第二步逻辑块 1 的最后一个空位被填入新 token 的 KV;第三步逻辑块 1 满后分配新的物理块 3。
块分配与回收
当引擎添加新请求时,块管理器首先为 prompt 的 KV Cache 分配物理块:prompt 有 len(prompt) 个 token,需要 ceil(len(prompt) / B) 个逻辑块。块管理器从空闲物理块池中取出对应数量的物理块,填入该 Sequence 的 block table。
在解码阶段,每个新生成的 token 需要写入 KV Cache。如果当前最后一个逻辑块还有空位,就填入该空位;如果已满,就分配一个新的物理块。块管理器保证”除最后一个块外,所有块都是满的”,这使得内存浪费被严格限制在一个块之内。
请求完成后(或 Sequence 被删除时),它占用的所有物理块归还到空闲池中。如果有其他 Sequence 共享了这些块(通过 copy-on-write 或显式共享),块管理器先检查引用计数:只有当引用计数降为 0 时才真正回收物理块。
写时复制与内存共享
vLLM 的 KV Cache 共享机制直接受益于块这一抽象。在并行采样场景中,多个输出 Sequence 共享同一个 prompt,它们的 prompt 部分的逻辑块可以映射到相同的物理块:
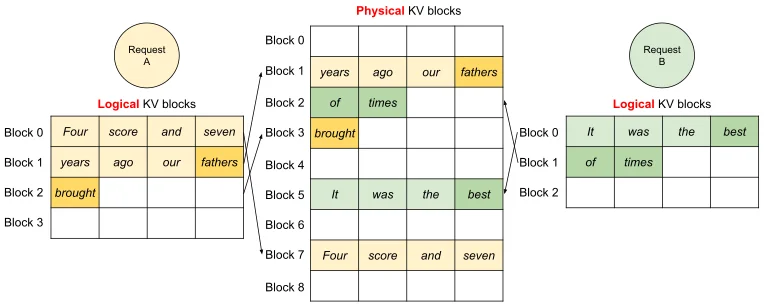
图来自 vLLM 论文 Figure 7:两个请求的 KV Cache 共享同一片物理块空间,逻辑块不连续排列但物理块被高效利用。
当两个共享者中有一个需要修改共享块的内容时(比如在并行采样中,两个序列的不同输出 token 要写入同一个逻辑块的最后几个空位),vLLM 采用写时复制(copy-on-write):先将该物理块的内容拷贝到一个新分配的物理块,将修改者的 block table 指向新块,然后在新块上修改。这个过程在块级进行——一次最多拷贝一个块的数据(通常只有几十 KB),开销远小于拷贝整个序列的 KV Cache。
前缀缓存
共享 prompt 前缀的场景更加自然。如果多个用户请求以相同的系统提示词开头,块管理器可以预先缓存这些共享前缀的 KV block,让新请求的 prompt 部分逻辑块直接映射到这些已缓存的物理块上,跳过重复的 prefill 计算。本站的 RadixAttention 完全拆解 讲的是 SGLang 如何用前缀树实现更通用的前缀缓存,原理上与本机制一脉相承。
模型执行层:Worker 与 ModelRunner
当引擎层完成了调度、准备好了输入数据(token IDs 和 block table),下一步就是真正让模型跑起来。这一步由执行层完成。
GPUWorker
Worker(在单 GPU 部署中通常是 GPUWorker)是执行层的最小单元。每个 Worker 绑定一个 GPU,持有该 GPU 上的模型权重副本(在张量并行时是模型的部分分片)。Worker 的核心职责是:
- 加载模型:在初始化时从 Hugging Face 或本地路径加载模型权重到 GPU 显存。
- 管理 KV Cache:在 GPU 显存中分配物理 block 空间,维护 block table。
- 执行模型:接收引擎发来的输入(token IDs、positions、block table),执行模型的
forward()调用,返回 logits。 - 采样:对 logits 应用采样参数(temperature、top-p、top-k),选出下一个 token。
ModelRunner
ModelRunner 是 Worker 内部驱动模型执行的组件。它负责:
- 构建输入张量:将不同长度的请求序列拼接成一个 batch。这一步需要对齐 token 位置、生成 attention mask、合并 block table。
- 管理 KV 读写:在注意力层执行前,将 block table 传给 PagedAttention kernel,kernel 根据 block table 从非连续的物理块中读取所需的 Key 和 Value;执行后将新生成的 Key 和 Value 写入 block table 指定的物理块位置。
- 调用模型 forward:按照 Transformer 的层顺序,依次调用各个子模块(attention、MLP、layer norm 等)。在张量并行模式下,各 GPU Worker 的 attention head 分片和 MLP 列分片由 NCCL all-reduce 来同步。
vLLM 支持丰富的模型架构——从传统的 Llama、Mistral 到 MoE 架构的 Mixtral、DeepSeek-V3,再到多模态模型——通过模型注册机制来实现。每个支持的模型类实现自己的 forward() 或 compute_logits(),而 ModelRunner 提供了统一的执行框架。
关键 CUDA Kernel
vLLM 的性能优势很大程度上来自自研的 CUDA kernel:
- PagedAttention kernel:这是最核心的 kernel。它接收 block table 作为输入,在扫描 KV block 时按 table 跳转,实现了对非连续物理块的透明访问。为了避免随机内存访问带来的延迟惩罚,kernel 以 warp 为单位处理每个 block,确保同一 warp 内的线程访问同一 block 的连续地址,从而利用合并内存访问(coalesced memory access)。
- 融合 reshape 与写入 kernel:将新生成的 KV cache 按 block table 指定的位置写入物理块,融合了 reshape 操作(将 token 维度的 K/V 向量组织成按 block 存储的格式)和实际的显存写操作,减少了 kernel launch 开销。
- 融合块拷贝 kernel:在 copy-on-write 触发时,需要在物理块之间拷贝数据。单独调用
cudaMemcpyAsync会产生大量小数据传输的 kernel launch 开销。vLLM 将同一批请求的多个块拷贝操作合并成一个 kernel launch,显著降低了延迟。
分布式执行
当模型参数超过单 GPU 显存容量时,vLLM 通过张量模型并行将模型分片到多张 GPU 上。具体策略沿用了 Megatron-LM 的 SPMD(Single Program Multiple Data)范式:
- 每个 GPU Worker 持有模型的一个分片(例如按 attention head 切割,GPU 0 持有 head 0-7,GPU 1 持有 head 8-15)。
- 所有 GPU Worker 处理相同的输入 token,各自执行自己分片上的计算。
- 在 attention 层结束后、MLP 层开始前,各 GPU 通过 NCCL all-reduce 同步中间结果。
值得注意的是,即使模型参数被分片到多张 GPU 上,每个 GPU 仍然需要存储完整序列的 KV Cache(只是存储自己负责的那部分 attention head 的 K/V)。因此,块管理器对物理块的管理是跨 GPU 一致的:引擎中的中央调度器维护一份统一的 block table,所有 GPU Worker 共享同一套逻辑块到物理块的映射。
在分布式执行的每个 step 中,中央调度器将包含(token IDs + block table)的控制消息广播给所有 GPU Worker。各 Worker 在自己的物理块副本上执行相同的 PagedAttention 操作。Worker 之间不需要就内存管理进行任何同步——它们从调度器那里一次性获得所有需要的信息——这极大地简化了分布式场景下的 KV Cache 管理。
vLLM v1:2025 年的架构重构
vLLM 在 2025 年发布了一次重大架构重构,称为 “vLLM v1”(代码位于 vllm/v1/ 目录)。v1 保留 v0 的核心思想(PagedAttention、连续批处理、块管理),但在几个关键维度上做了根本性的重新设计。
v1 架构的第一个核心变化是结构化输出接口。v0 中引擎层与执行层之间的通信依赖大量隐式的状态共享(Worker 直接访问引擎的某些数据结构),导致代码耦合度高、并行扩展困难。v1 引入了严格的结构化输出对象——引擎核心(EngineCore)产出的调度结果是一个明确的数据类,Worker 接收这个对象来驱动执行,Worker 返回的模型输出也是一个明确的数据类——通信协议完全由这些数据类的字段定义。
第二个核心变化是引擎核心的重构。v0 的 LLMEngine 混合了调度、状态管理和 I/O 处理。v1 将这些职责拆分为独立的模块:EngineCore 只负责调度与 KV Cache 管理,输入/输出处理由 Processor 负责,两者之间通过结构化的队列通信。具体来说:
EngineCore:处理调度、块分配、模型执行。它的输出是一组EngineCoreOutput,包含新生成的 token 及其元数据。Processor:处理输入 tokenization、输出 detokenization、流式响应组装。它将外部世界的”字符串请求”翻译为核心能理解的”token 请求”,反之亦然。KVCacheManager(v1 版本的块管理器):提供了更精细的 KV Cache 管理接口,支持 prefix caching 的自动协商(不再需要外部手动指定前缀映射)。Scheduler(v1 版本):优化了调度策略,更精细地权衡 prefill 请求(计算密集)和 decode 请求(内存密集)的混合比例,提升 GPU 利用率。
v1 的第三个核心变化是异步流水线化。v0 中引擎的 step 是串行的——调度、输入准备、模型执行、采样按顺序执行。v1 允许下一轮的调度与当前轮的模型执行重叠进行(在 AsyncLLM 的事件循环中),减少了 CPU 端的空闲等待。
要理解 vLLM 的当前状态和发展方向,v0 和 v1 都需要读。v0 的代码经过两年多的打磨,逻辑清晰、社区资料丰富,适合入门学习;v1 则是 vLLM 的未来方向,代表了更高性能、更可扩展的架构设计。本系列后续在讲具体模块时,会同时覆盖 v0 和 v1 两套实现,并在关键设计决策处做横向对比。
源码阅读路线图
基于以上架构全景,推荐以下渐进式阅读路径:
第一步:理解数据结构
从 Sequence 和 SequenceGroup 开始。它们是引擎中一切操作的对象,理解它们的状态转换是理解引擎的前提。同时读 SamplingParams 了解用户可配置的采样参数。
第二步:阅读引擎核心
LLMEngine.step() 方法(约 200 行)是整个引擎的缩影。从它出发,逐步深入 Scheduler.schedule()(调度逻辑)、_prepare_model_input()(数据准备)、_process_model_outputs()(结果处理)。建议逐行读,不跳过任何一行。
第三步:深入块管理器
BlockSpaceManager 或 v1 中的 KVCacheManager。理解物理块的分配/释放/引用计数机制,以及 block_table 如何被填入并被 PagedAttention kernel 消费。本站的 PagedAttention 完全拆解 可作为同步参考。
第四步:模型执行
Worker.execute_model() → ModelRunner.execute_model()。这一层包含模型加载、输入准备(prepare_input)、注意力 forward(含 PagedAttention kernel 调用)、和采样逻辑。建议选一个熟悉的模型架构(如 Llama)来追踪完整的 forward 过程。
第五步(进阶):vLLM v1
在理解 v0 的基础上,对比阅读 vllm/v1/engine/core.py、vllm/v1/core/scheduler.py、vllm/v1/worker/gpu_model_runner.py。重点关注结构化输出接口如何解耦模块、调度器如何优化 prefill/decode 混合。
关键源码文件索引(v0)
| 模块 | 关键文件 | 核心职责 |
|---|---|---|
| 入口层 | entrypoints/llm.py | 离线推理 LLM 类 |
| 入口层 | entrypoints/openai/api_server.py | OpenAI 兼容 API 服务 |
| 引擎 | engine/llm_engine.py | 核心引擎,step 循环 |
| 引擎 | engine/async_llm_engine.py | 异步引擎封装 |
| 引擎 | engine/scheduler.py | 调度器 |
| 引擎 | engine/block_manager.py 或类似 | 块管理器(版本间有差异) |
| 引擎 | engine/sequence.py | Sequence / SequenceGroup |
| 执行层 | worker/worker.py | GPUWorker |
| 执行层 | worker/model_runner.py | ModelRunner,模型执行驱动 |
| Kernel | attention/ops/paged_attn.py 或 CUDA 文件 | PagedAttention kernel 入口 |
小结
vLLM 的架构之所以能在短短两年内成为推理框架的事实标准,关键在于它找到了正确的抽象层级。把 KV Cache 抽象为”块”——这个看似简单的决定,释放出了巨大的设计空间:内存利用率接近 100%、写时复制共享、前缀缓存、抢占换出——所有这些高级特性都自然而然地”长”在了块这个抽象之上,不需要额外的框架级补丁。
本文建立了 vLLM 的四层架构全景图:入口层做请求适配,引擎层做调度编排,执行层做模型计算,Kernel 层做极致优化。每一层都有清晰的职责边界和标准化的通信接口,这种分层不是说出来的,是真正写进代码里的。
下一篇将深入 LLMEngine.step() 的核心循环,逐行解读引擎在每个迭代步中做了什么决策、如何准备数据、如何消费模型输出——从”架构是什么”进入”代码怎么写”。
参考资料
- vLLM 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention — Woosuk Kwon et al., SOSP 2023
- vLLM GitHub 仓库
- vLLM 官方文档
- PagedAttention 完全拆解(本站)
- 连续批处理完全拆解(本站)
- RadixAttention 完全拆解(本站)
- Megatron-LM:Training Multi-Billion Parameter Language Models Using Model Parallelism — Shoeybi et al., 2019
- Orca: A Distributed Serving System for Transformer-Based Generative Models — Yu et al., OSDI 2022
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness — Dao et al., NeurIPS 2022
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


