


vLLM 源码完全拆解(二):从 add_request 到 EngineCore.step,一次请求如何穿过 V1 引擎
从“模块地图”走进一次真实请求
上一篇 vLLM 源码完全拆解(一):整体架构与模块全景 建立了入口层、引擎层、执行层和 Kernel 层的地图,并把下一站定在引擎的核心循环。现在沿着一个最普通的离线生成请求向下追踪:它从 LLM.generate() 出发,怎样变成引擎内部的数据结构,怎样进入调度器,怎样触发一次 GPU 前向,又怎样变回用户看到的文字。
本文以 2026 年 9 月 26 日访问到的 vLLM main 分支 V1 源码为基线。vLLM 的内部接口迭代很快,因此学习时应抓住稳定的职责边界,而不是死记行号。源码里还有一个尤其容易误读的点:当前 V1 同时存在前端的 LLMEngine.step() 和核心进程里的 EngineCore.step()。前者主要接收并加工结果,后者才执行“调度—模型执行—状态更新”事务。把两者混成一个函数,会从一开始就看错控制流。
vLLM 源于 UC Berkeley 团队 2023 年发表在 SOSP 的 PagedAttention 工作。V1 架构的公开设计在 2024 年启动,目标是在保留模型实现与高性能 Kernel 的同时,重构调度器、KV Cache 管理、Worker、采样器和服务端之间的边界。本文不讨论某一个注意力 Kernel,而是回答更基础的问题:一轮引擎迭代到底是什么。
先看全路径:三个循环,而不是一个循环
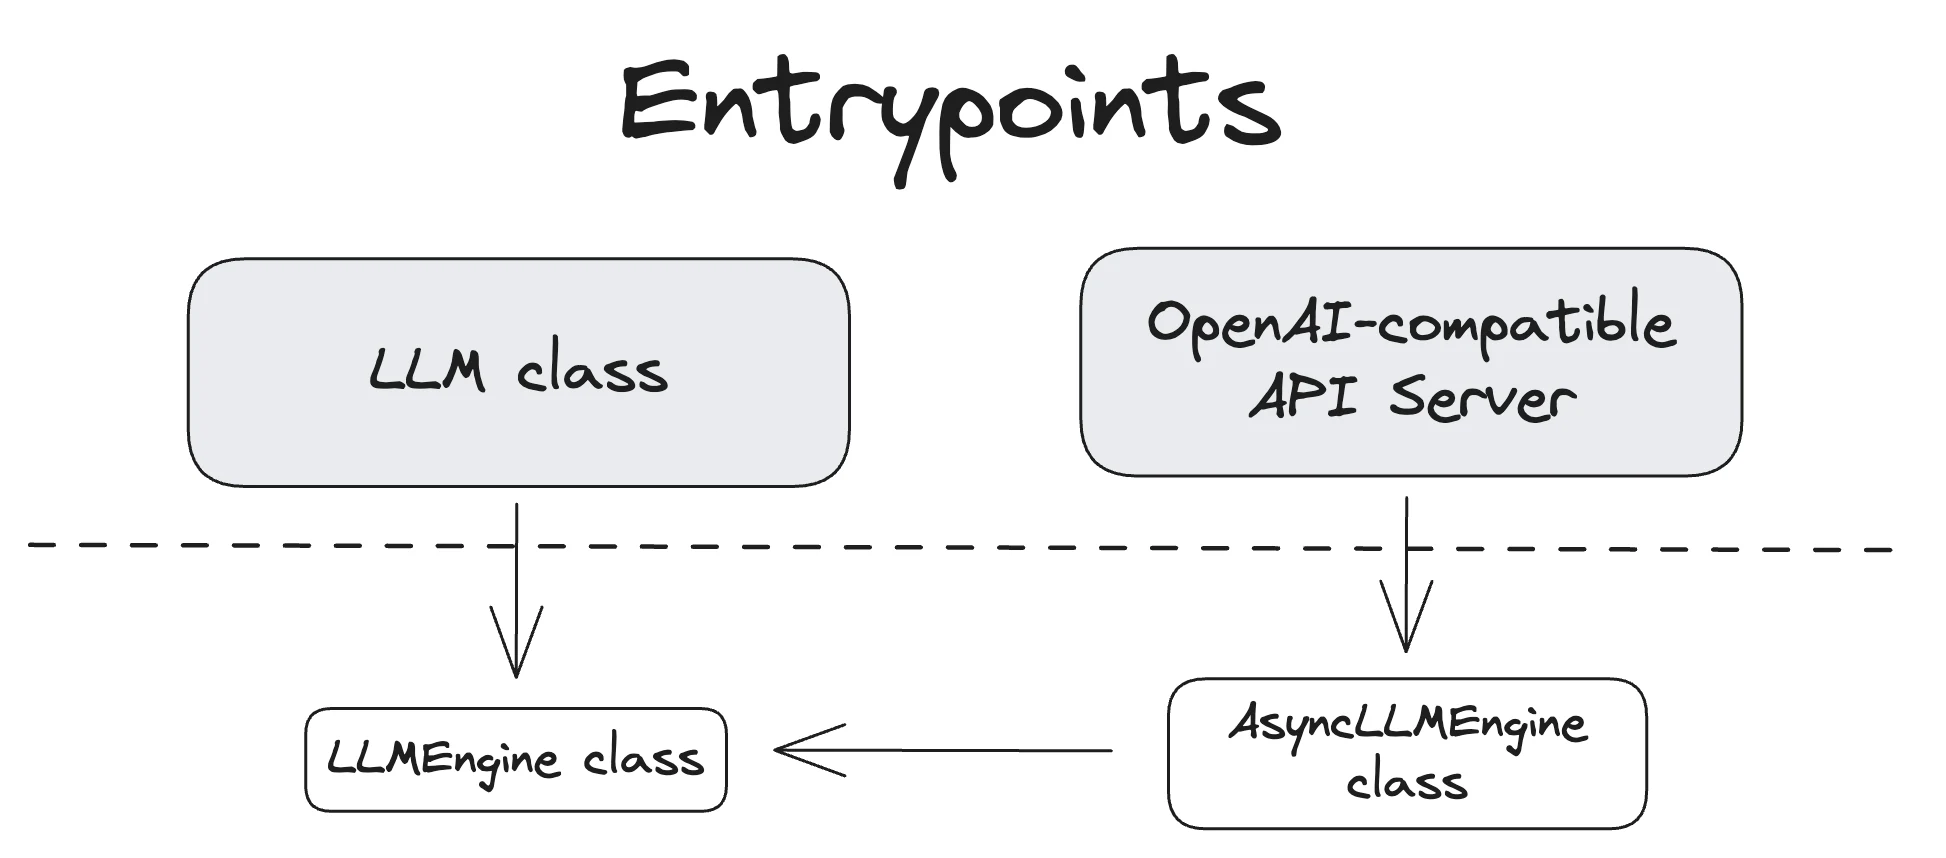
图源:vLLM 官方架构文档 entrypoints.excalidraw.png。图中离线 LLM 和在线 OpenAI 兼容 API 最终都会进入引擎,但在线路径多了一层异步服务封装。
从用户代码到 GPU,至少要区分三个循环:
- 离线排空循环:
OfflineInferenceMixin._run_engine()反复调用前端LLMEngine.step(),直到没有未完成请求。 - 核心忙循环:多进程部署下,
EngineCoreProc.run_busy_loop()持续接收入站消息并推进引擎。 - 单步事务:
EngineCore.step()在一轮中完成调度、执行和状态提交。
它们对应三种不同的“持续运行”:第一个回答“何时把整批离线任务跑完”,第二个回答“服务进程如何一直活着”,第三个回答“一个迭代步具体做什么”。后文会反复用到这个区分。
一条简化后的调用链如下:
LLM.generate() -> OfflineInferenceMixin._run_completion() -> _add_completion_requests() -> LLMEngine.add_request() -> InputProcessor.process_inputs() -> OutputProcessor.add_request() -> EngineCoreClient.add_request() -> EngineCore.add_request() -> Scheduler.add_request()
-> OfflineInferenceMixin._run_engine() -> LLMEngine.step() -> EngineCoreClient.get_output() -> EngineCore.step() -> Scheduler.schedule() -> Executor.execute_model() -> Scheduler.update_from_output() -> OutputProcessor.process_outputs() -> RequestOutput这条链里有两条方向相反的数据流。请求向下时,文本逐步变成 token、参数对象、核心请求和调度状态;结果向上时,采样 token 逐步变成核心输出、增量文本和用户级 RequestOutput。V1 的关键设计不是把所有事情塞进一个“大引擎类”,而是让输入处理、核心调度和输出处理拥有各自的数据模型。
第一道边界:LLM.generate() 不负责生成 token
对离线 API 而言,入口通常只有几行:
from vllm import LLM, SamplingParams
llm = LLM(model="Qwen/Qwen3-8B")outputs = llm.generate( ["PagedAttention 的核心思想是"], SamplingParams(max_tokens=64, temperature=0.0),)直觉上,generate() 似乎应该包含生成循环。实际源码中,它先检查当前 runner 是否支持生成任务,补齐默认采样参数,然后转入 _run_completion()。后者只做两件事:先把所有 prompt 加入引擎,再调用 _run_engine() 排空请求。
核心伪代码可以压缩为:
def run_completion(prompts, params): add_completion_requests(prompts, params) return run_engine()
def run_engine(): outputs = [] while llm_engine.has_unfinished_requests(): for output in llm_engine.step(): if output.finished: outputs.append(output) return sort_by_request_id(outputs)这里有三个值得注意的设计。
第一,离线接口也经过统一引擎,而不是另写一套静态批处理实现。所谓“自动批处理”来自调度器每一步重新选择请求,并不来自 generate() 预先把输入拼成一个固定 batch。
第二,完成顺序与提交顺序可以不同。短请求可能先结束,长请求后结束,所以 _run_engine() 最后按 request ID 排序,恢复离线 API 承诺的输入顺序。在线流式服务则不需要等待全体结束,应尽快把每个请求的增量输出发回客户端。
第三,当前离线路径会把 SamplingParams.output_kind 设成 FINAL_ONLY。内部每一步仍然产生 token,但离线调用者只收集最终结果。是否流式输出是前端策略,不改变核心调度器按迭代推进请求的事实。
请求入队:同一个请求为什么要保存两份状态
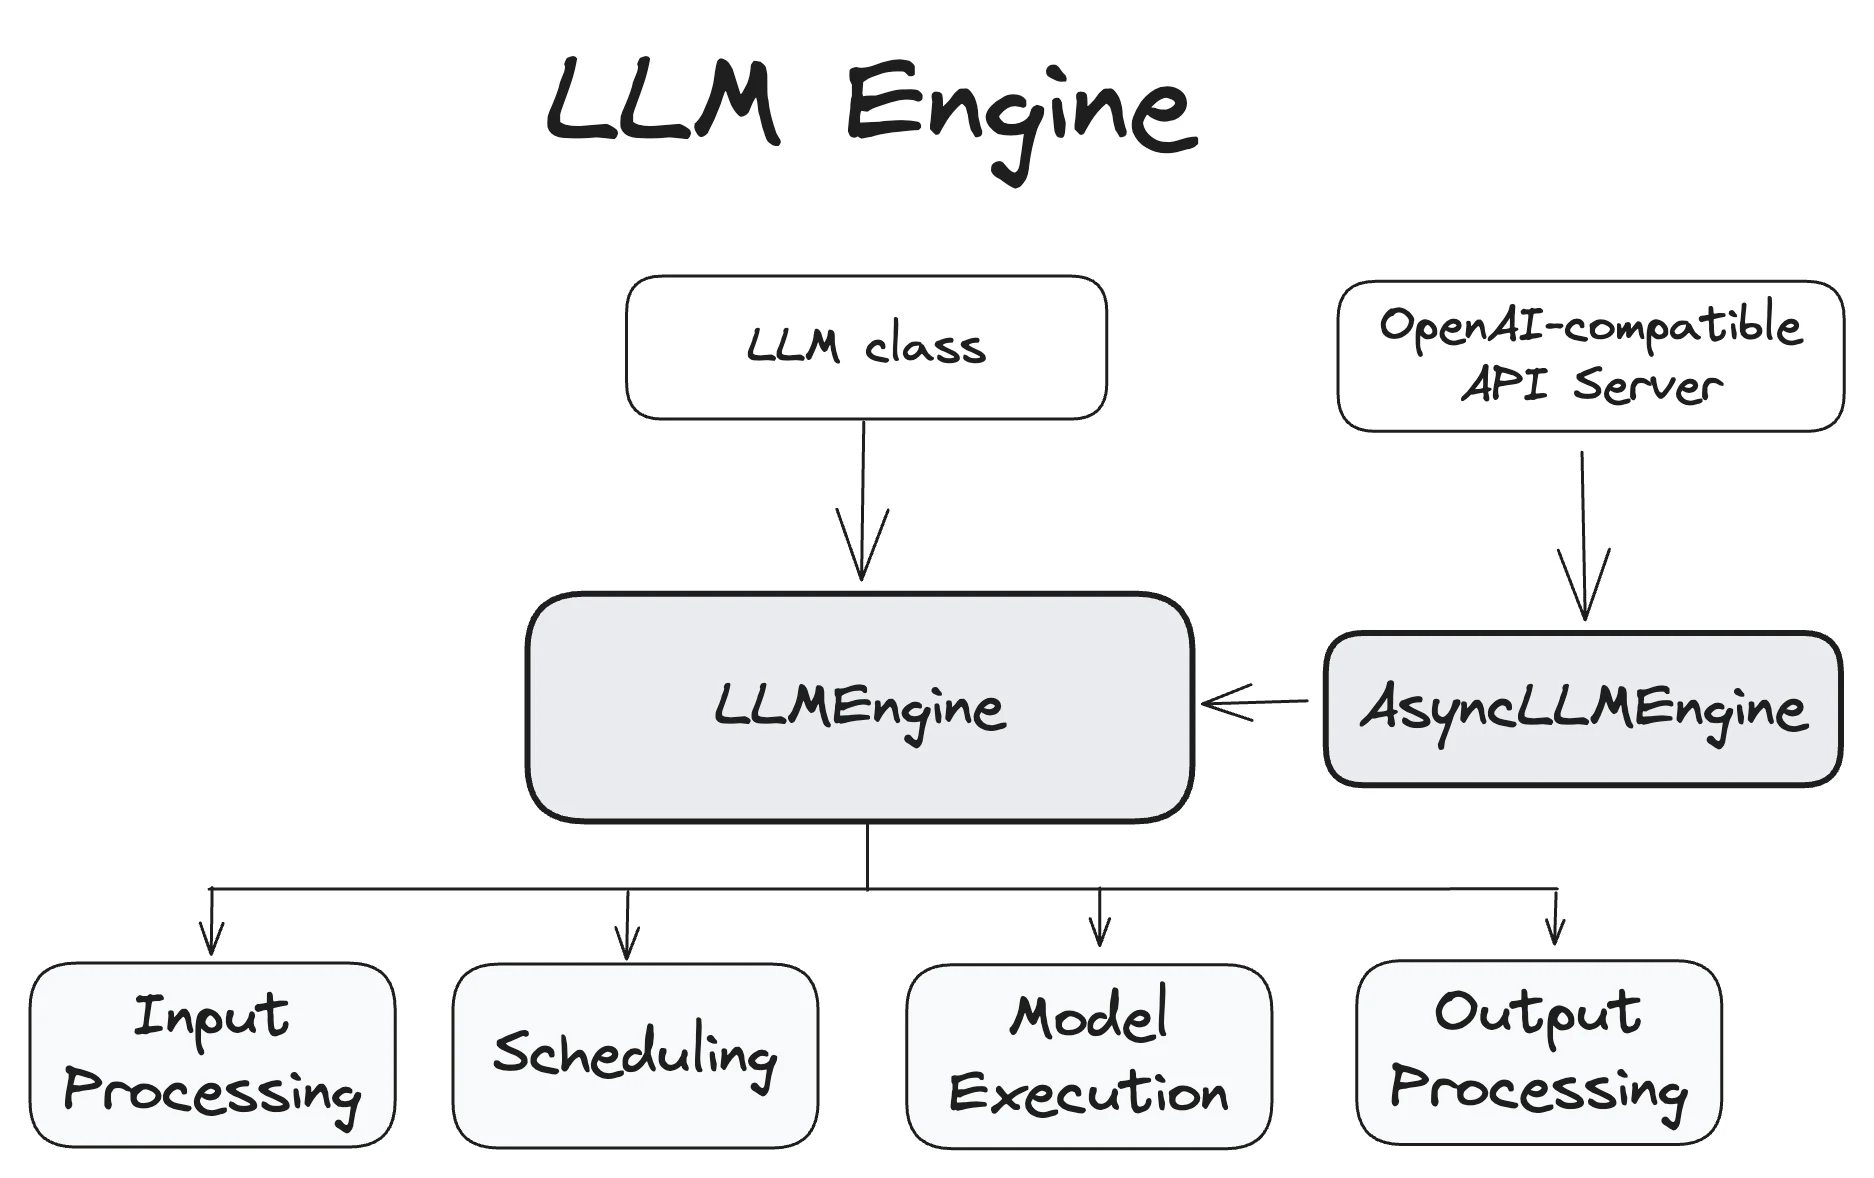
图源:vLLM 官方架构文档 llm_engine.excalidraw.png。这张图适合建立职责地图,但阅读 V1 源码时还要进一步把前端处理与 Engine Core 分开。
LLMEngine.add_request() 是第一个真正重要的入口。它接收 prompt、采样参数、优先级、LoRA 请求和到达时间等外部信息,然后建立两份状态:
OutputProcessor中的RequestState:面向用户输出,保存 detokenizer、logprobs 处理器、原始 prompt、流式队列以及父子请求关系。EngineCore中的Request:面向调度与执行,保存 token、已计算位置、输出 token、KV Cache 相关状态、优先级、到达时间和运行状态。
这不是无意义的重复。两份状态服务于不同一致性域。前端关心字符串停止条件、流式片段怎样拼接、输出是否包含 prompt;核心关心还欠多少 token 计算、占了哪些 KV block、能否被抢占。在线多进程模式下,两份状态本来就位于不同进程,试图让它们共享一个可变对象,反而会造成锁、序列化和故障隔离问题。
从 prompt 到 EngineCoreRequest
输入首先经过 InputProcessor.process_inputs()。它把原始字符串或已分词输入统一为 EngineCoreRequest。这个跨边界对象包含的关键字段包括:
| 字段 | 用途 |
|---|---|
request_id | 核心内部唯一标识,关联输入、调度与输出 |
prompt_token_ids | 语言模型实际消费的 token 序列 |
sampling_params | 温度、top-p、最大生成长度、停止 token 等 |
arrival_time | FCFS 与延迟统计的时间基准 |
priority | 启用优先级策略时参与排序 |
client_index | 多前端场景中把输出路由回正确客户端 |
mm_features | 图像、视频等多模态特征描述 |
lora_request | 本请求需要加载或选择的 LoRA 适配器 |
cache_salt | 前缀缓存隔离相关信息 |
V1 使用 msgspec.Struct 定义 EngineCoreRequest,并启用紧凑的数组式序列化。这是一个很典型的系统取舍:跨进程热路径中的对象需要明确 schema 和较低编码开销,而不适合随意传递层层嵌套的 Python 字典。
n > 1 为什么在前端展开
当采样参数要求一个 prompt 生成 n 个候选时,LLMEngine.add_request() 会建立一个 ParentRequest,再派生出多个子请求。每个子请求有独立 request ID 和采样状态,OutputProcessor 负责把结果重新聚合到父请求。
这样做的好处是核心调度器仍然只处理统一的 Request,不需要到处判断“这是普通请求还是并行采样的第几个分支”。共享 prompt 所需的 KV Cache 复用由缓存层解决,用户级的候选聚合由前端解决,调度器不承担展示语义。
入队只改变状态,不立即运行模型
核心侧的 Scheduler.add_request() 最终把新请求放入 waiting 队列,并在请求表中登记。新建 Request 的初始状态通常是 WAITING;如果启用了结构化输出而 grammar 尚未准备好,它也可能先处于等待 grammar 的状态。
这一步不会偷偷执行 prefill。入队与执行严格分离,调度器才能同时观察多个请求,再根据 token 预算、KV 空间、优先级和当前 running 集合组成下一轮 batch。连续批处理的基础正是这种分离。相关调度背景可参考 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理。
第二道边界:EngineCoreClient 隔离进程拓扑
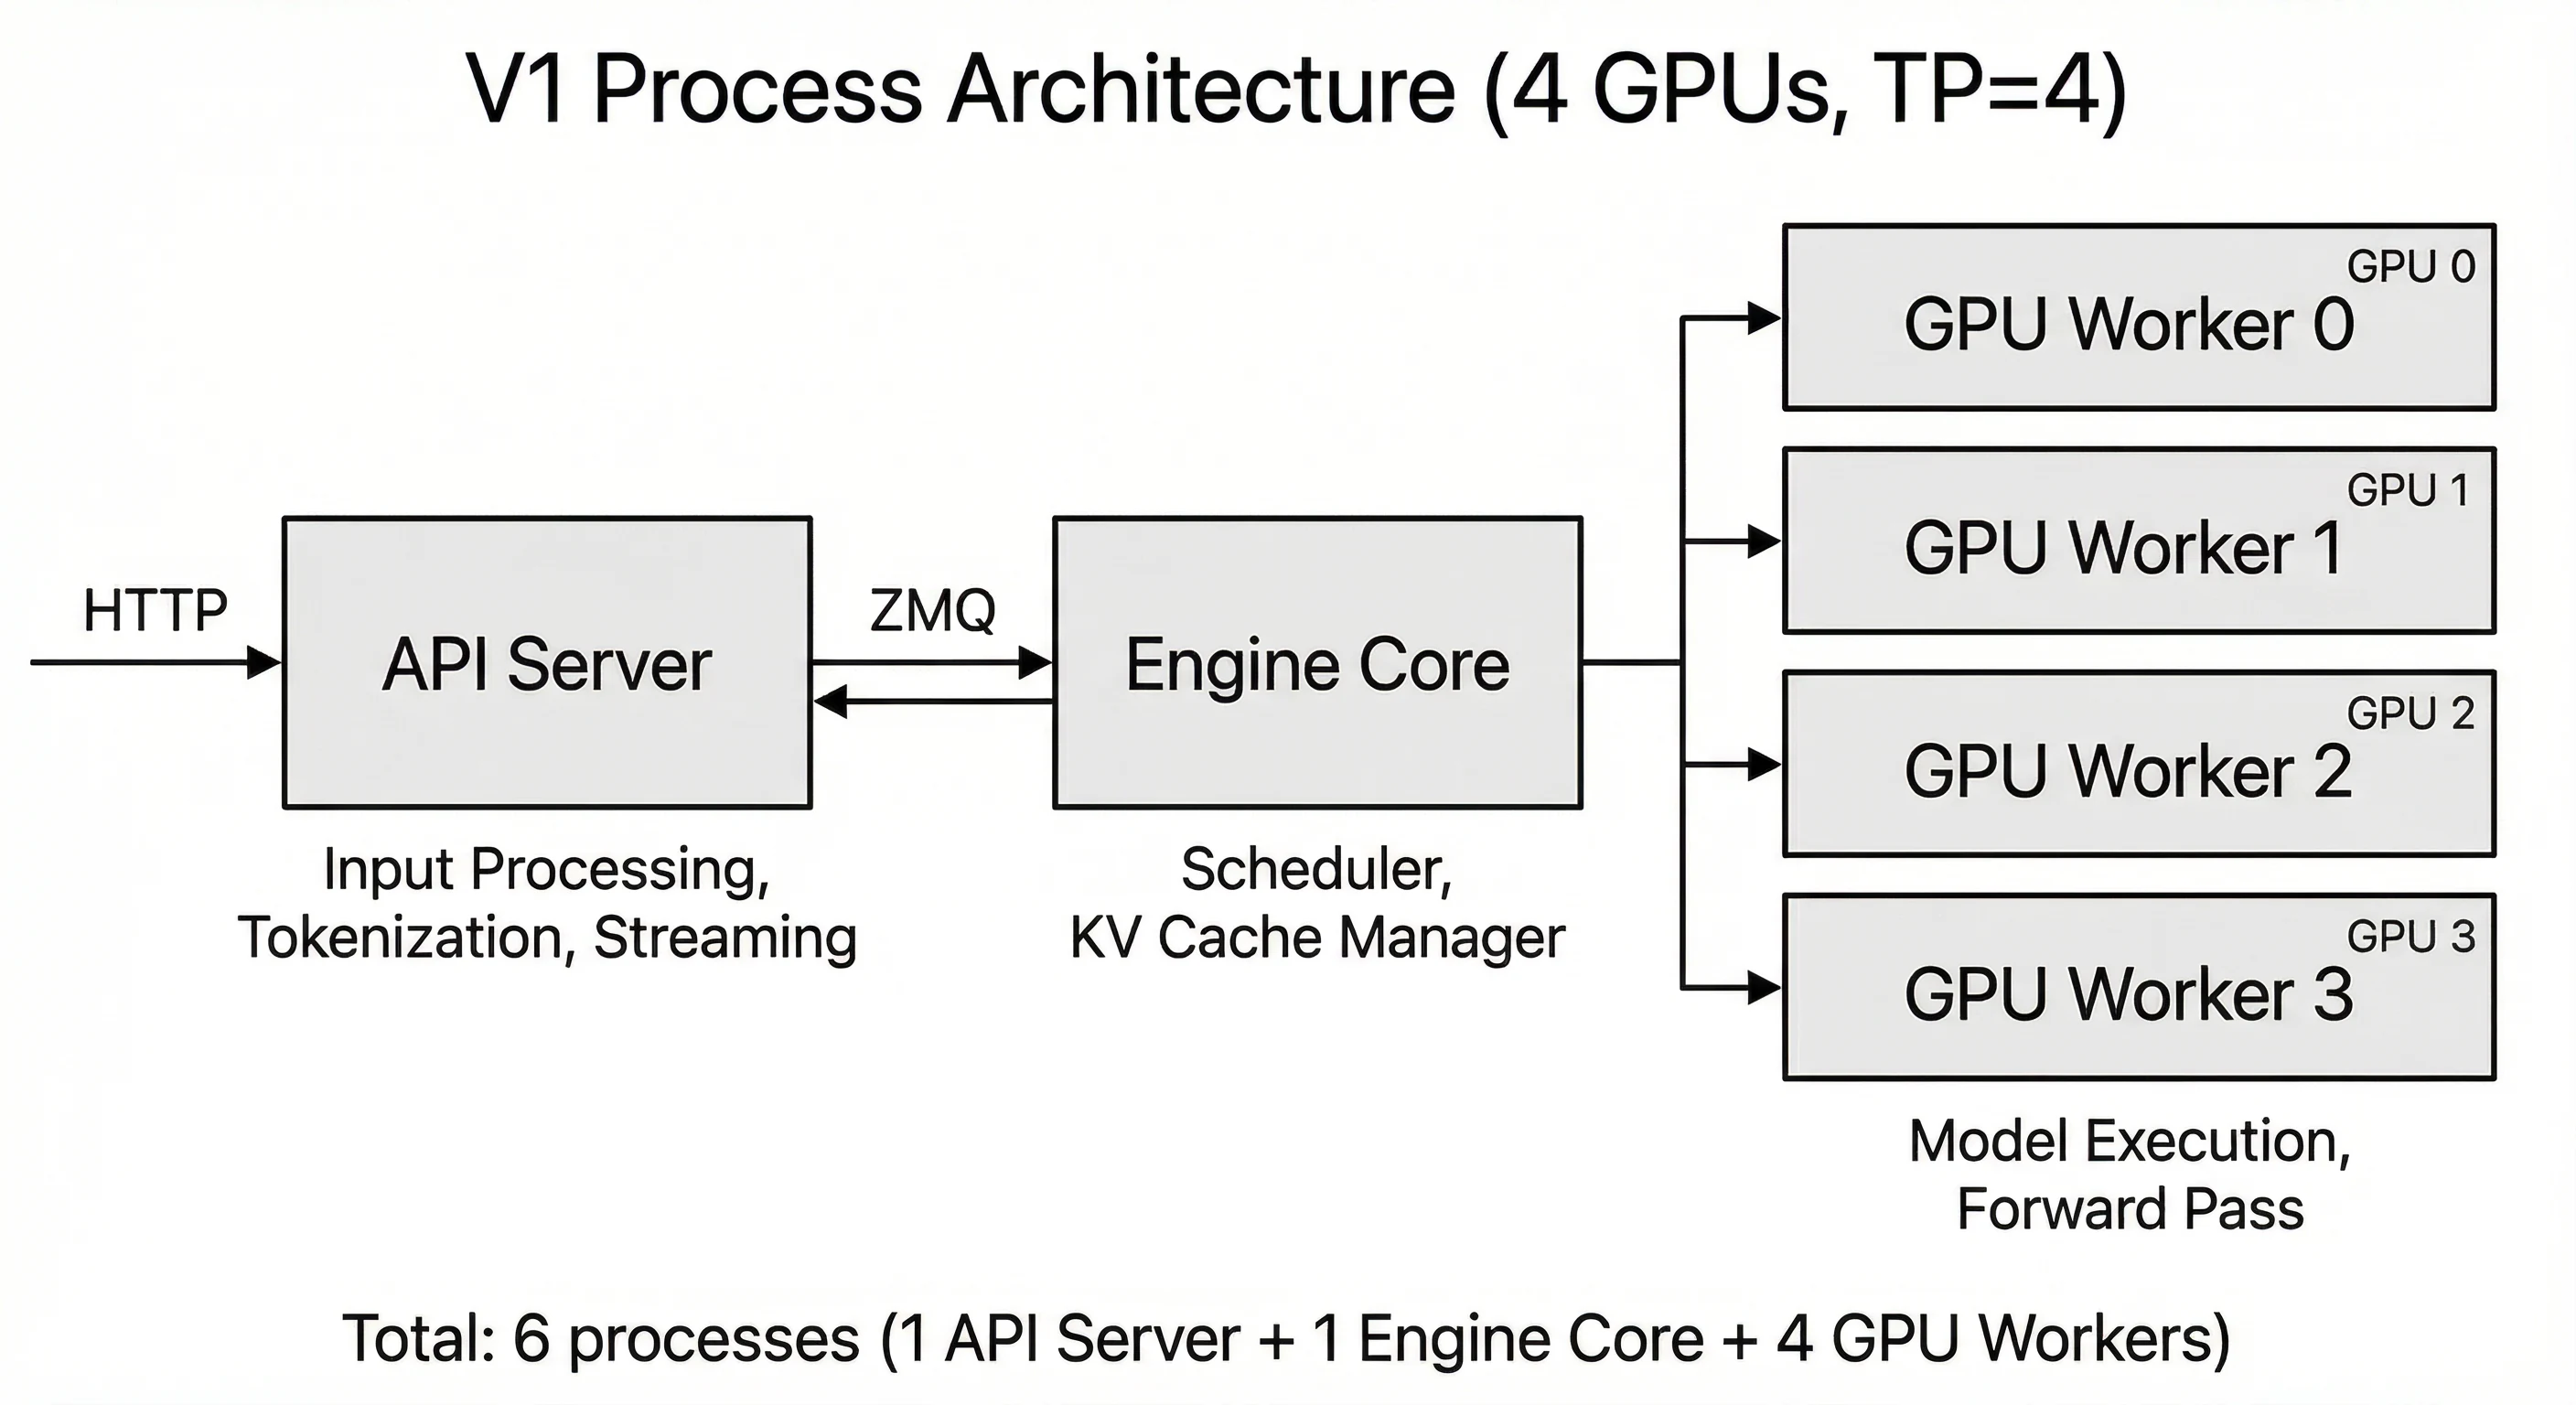
图源:vLLM 官方架构文档 v1_process_architecture_tp4.png。在四卡张量并行示例中,API Server、Engine Core 与四个 GPU Worker 一共是六个进程;API Server 和 Engine Core 通过 ZMQ 交换请求与结果。
LLMEngine 不直接调用一个固定的 EngineCore 实例,而是持有 EngineCoreClient。这层抽象把“我要提交请求、拿回结果”与“核心究竟在本进程还是另一个进程”分开。
InprocClient:适合看清控制流
进程内客户端的逻辑最直接:
def add_request(request): req, request_wave = engine_core.preprocess_add_request(request) engine_core.add_request(req, request_wave)
def get_output(): outputs, model_executed = engine_core.step_fn() engine_core.post_step(model_executed) return outputs.get(0, EngineCoreOutputs())阅读源码时可以先沿这条路径走,因为函数调用关系没有 IPC 噪声。它清楚说明:前端 get_output() 会主动推进一次核心 step。
多进程客户端:提交与执行解耦
多进程客户端的 add_request() 把消息编码后写入 ZMQ socket;get_output() 则从本地输出队列取结果。另一个线程负责从 Engine Core 的输出 socket 接收消息并填充队列。此时前端 LLMEngine.step() 本身不运行调度器,它只是在等待或消费核心进程已经推进出来的结果。
这一区别解释了为什么只看 LLMEngine.step() 会误以为 vLLM 没有模型执行:在生产服务拓扑中,执行发生在另一个进程的忙循环里。EngineCoreClient 的价值就是让上层不必为两种拓扑维护两套 API。
为什么 V1 要专门拆出 Engine Core 进程
官方架构把 API Server 的输入处理、tokenization 和 streaming 与 Engine Core 的调度、KV Cache 管理分开。原因不只是代码整洁:
- tokenizer、JSON 解析和网络回压不应阻塞两次 GPU forward 之间的关键 CPU 路径;
- Engine Core 可以维持更小、更稳定的工作集,降低 Python GC 和偶发 I/O 抖动;
- 多个 API Server 可以连接一个或多个 Engine Core,前端扩缩容不必改变 GPU Worker 的执行逻辑;
- 核心进程崩溃与客户端断开有清晰的错误传播边界。
这也是读 V1 与读旧版 V0 最大的思维变化:LLMEngine 仍保留兼容名称,但源码注释已明确把它称为兼容性前端;真正的内层循环位于 EngineCore。
核心忙循环:服务为什么不会空转烧满一个 CPU 核
多进程模式下,EngineCoreProc.run_busy_loop() 的结构非常短:
while engine_is_running: process_input_queue() publish_request_counts_if_needed() process_engine_step() publish_request_counts_if_needed()当核心没有工作时,_process_input_queue() 可以阻塞等待输入消息;有请求、待完成 batch 或数据并行 wave 时,循环才继续推进。一次核心 step 没有执行模型但仍有等待状态时,例如正在等远端 KV 到达,代码会短暂让出执行权,让后台传输线程获得进展机会。
这个细节揭示了 busy loop 的准确含义:它是常驻事件循环,不等于无条件自旋。系统既要尽快发起下一次 GPU 工作,又不能在没有请求时白白占满 CPU。
输入队列还承载 ADD、ABORT、UTILITY、WAKEUP 等控制消息。也就是说,请求到达、客户端取消、缓存重置等操作会在核心进程的控制平面汇合。核心在模型执行完成后、提交输出前还会再处理 abort 队列,避免已经取消的请求因为并发时序又被错误提交一个 token。
EngineCore.step():一次迭代只有三项主任务
当前源码中的核心函数可以摘成下面这段。省略了统计与错误记录,但保留了控制流:
def step(self): if not self.scheduler.has_requests(): return {}, False
scheduler_output = self.scheduler.schedule( self._should_throttle_prefills() ) future = self.model_executor.execute_model( scheduler_output, non_block=True, ) grammar_output = self.scheduler.get_grammar_bitmask( scheduler_output )
model_output = future.result() if model_output is None: model_output = self.model_executor.sample_tokens(grammar_output)
self._process_aborts_queue() outputs = self.scheduler.update_from_output( scheduler_output, model_output, ) return outputs, scheduler_output.total_num_scheduled_tokens > 0它的主干只有三步:
schedule():决定本轮哪些请求计算多少 token,并准备 KV block 等执行元数据。execute_model():让 Executor 和 Worker 执行模型,返回采样 token、logprobs、连接器结果等。update_from_output():把执行结果提交回请求状态,判断完成条件,释放资源并生成核心输出。
这个函数短,并不意味着系统简单。恰恰相反,V1 把复杂度推到三个边界清晰的组件里,让 step() 成为可检查的事务骨架。读源码时应先证明自己能解释这三步的输入与输出,再进入任意一个组件的细节。
调度器不再硬分 prefill 队列与 decode 队列
理解 Scheduler.schedule() 的钥匙,是源码中的一句注释:调度器没有独立的“prefill phase”和“decode phase”。每个请求只记录已经计算的 token 数与当前应覆盖的 token 数,然后尝试让前者追上后者。
可把本轮欠账写成:
待计算 token 数= prompt token 数 + 已生成但尚待计算的 token 数 + speculative token 数 + 异步流水中的占位 token 数 - 已计算 token 数普通 prefill 请求刚入队时,已计算数为 0,欠账接近 prompt 长度;普通 decode 请求每轮通常只多欠 1 个 token;chunked prefill 会把长 prompt 的欠账分多轮偿还;投机解码则一次加入多个 draft token。统一的 token 欠账模型避免为每项特性复制一套调度分支。
先 running,后 waiting
一次 schedule() 通常先遍历 running 请求,再考虑 waiting 请求。running 请求已经拥有部分 KV 状态,继续推进它们有利于减少中断和重复工作;waiting 请求则需要做前缀缓存查询、首次 KV block 分配、LoRA 限制检查和多模态 encoder 预算检查。
“先 running”不等于 waiting 永远饿死。调度器受统一 token budget 约束,长 prefill 还可以被阈值切块,让 decode 和其他 prefill 共享一轮计算。启用优先级策略后,排序与抢占规则也会改变。
token budget 与 KV budget 是两种不同约束
调度器至少同时面对两类资源:
- token budget 限制一轮模型前向最多处理多少 token,直接影响计算量与 batch 形状;
- KV Cache 可用 block 限制请求能否保存新位置的 K/V,直接影响可驻留序列数。
有 token budget 不代表一定能调度。如果 KVCacheManager.allocate_slots() 无法分配新槽位,调度器会尝试抢占较低优先级或队尾请求;如果可释放的 block 仍不足,本轮就不能继续接纳更多工作。PagedAttention 让显存分配粒度从整条序列变为 block,但并没有消除容量上限。块管理的原理可参考 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率。
SchedulerOutput 是本轮执行计划
调度器的产物不是用户 token,而是一份计划。它至少要告诉执行器:
- 每个 request ID 本轮计算多少 token;
- 哪些是新请求、继续运行请求和恢复请求;
- 为请求新分配了哪些 KV block;
- 哪些 speculative token 参与本轮验证;
- 哪些 encoder 输入或外部 KV 需要调度;
- 本轮总共调度多少 token。
Worker 不需要重新运行调度算法,只需按计划增量更新自己的批状态并执行。V1 设计文档把这种通信称作发送状态差量:核心掌握全局调度,Worker 保留执行所需的持久状态,每一轮只传变化部分。这样可以减轻 CPU 序列化开销,也避免重复传送完整请求历史。
执行阶段:为什么先拿 Future,再准备 grammar
EngineCore.step() 调用 execute_model(..., non_block=True) 得到 Future,随后才从调度器获取结构化输出 grammar bitmask,最后等待 future.result()。这段顺序不是随意排列。
模型执行包含 Worker 调度、输入张量准备、GPU forward 等工作。非阻塞提交后,核心 CPU 可以并行准备采样约束,减少 GPU 工作前后的串行空洞。如果执行后端直接返回已经采样的结果,future.result() 给出完整 ModelRunnerOutput;在某些异步调度路径中,forward 与采样可能被拆开,返回 None 后再用 grammar mask 调用 sample_tokens()。
从接口角度看,ModelRunnerOutput 不是单个 logits 张量。它可以包含:
- request ID 到 batch 行的映射;
- 每个请求采样得到的 token IDs;
- logprobs 与 prompt logprobs;
- pooling 模型输出;
- KV Connector 与 Encoder Cache Connector 的执行结果;
- 投机解码草稿及其接受信息;
- CUDA Graph 等执行统计。
调度器需要的不是“神经网络算完了”这一布尔事件,而是足以完成状态提交的结构化结果。Executor 屏蔽单卡、多进程张量并行和其他执行后端的差异,使 EngineCore.step() 不必知道每个 GPU Worker 如何通信。
update_from_output():token 生成之后,事务还没有结束
GPU 得到 token 并不等于本轮结束。Scheduler.update_from_output() 必须把乐观执行计划变成已提交状态。这是理解请求生命周期最容易漏掉的一半。
先处理并发与失效结果
模型执行期间,请求可能被客户端取消,也可能因为异步调度发生抢占。更新函数会检查请求是否仍存在、是否已经结束、返回结果是否属于 stale output。无效结果不能再修改正常请求状态,否则会出现重复 token、计算计数倒退或已释放 KV block 被再次引用。
投机解码还需要把被拒绝的 draft token 从乐观计数中回滚。异步调度为了让流水线向前跑,会提前增加部分占位计数;验证结果回来后,接受多少、拒绝多少,都必须精确校正。这说明 num_computed_tokens 不是一个随手累加的统计量,而是调度正确性的核心状态。
再更新 token 与结束条件
对普通生成请求,更新函数把新 token 追加到内部 token 列表,推进已计算位置,并检查以下结束条件:
- 生成到 EOS 或用户配置的 stop token;
- 达到
max_tokens; - 达到模型最大上下文长度;
- 结构化输出 grammar 拒绝了不应出现的 token;
- 执行或连接器返回错误。
注意字符串 stop 条件通常不在核心侧完成,因为核心只拥有 token 语义,完整字符串匹配属于 detokenization 之后的前端语义。因此核心可能先返回 token,前端识别到 stop string 后再发 abort,把请求从核心调度器中清理掉。
最后释放资源并构造 EngineCoreOutput
请求完成时,调度器需要释放 KV block、清理 encoder cache、更新前缀缓存引用,并从活跃结构中移除请求。然后为每个客户端构造 EngineCoreOutputs,其中包含若干 EngineCoreOutput。单个请求的核心输出主要带有:
request_id;- 本轮新增 token IDs;
- logprobs;
- finish reason 与 stop reason;
- prefill 统计、连接器参数和可观测性事件。
输出按 client_index 分组,使多个前端共享核心时仍能收到属于自己的结果。这个字段看似只是路由元数据,却是 API Server 横向扩展的基础之一。
前端 LLMEngine.step():它做的是输出语义收尾
现在回到另一个同名函数。当前 V1 的 LLMEngine.step() 主干如下:
def step(self): outputs = self.engine_core.get_output() processed = self.output_processor.process_outputs( outputs.outputs, engine_core_timestamp=outputs.timestamp, ) self.engine_core.abort_requests(processed.reqs_to_abort) record_stats_if_needed() return processed.request_outputs它没有再执行一次模型,而是做四件事:拿核心输出、转成用户输出、回传需要终止的请求、记录统计。OutputProcessor.process_outputs() 被设计成整批输出唯一的一次 Python 全量遍历,目的是控制 CPU 开销。
token ID 如何变成字符串
每个前端 RequestState 都持有 detokenizer。新 token 到达后,detokenizer 增量更新文本,而不是每次对完整 token 序列重新解码。增量解码既减少重复计算,也解决字节级 tokenizer 中“一个 Unicode 字符跨多个 token”的边界问题。
随后输出处理器检查 stop string。假设用户要求遇到 "END" 停止,这三个字符可能跨越多个 token;核心调度器只看到 token ID,不适合负责字符串拼接。前端确认 stop string 后,把 finish reason 改成 STOP,并将 request ID 放入 reqs_to_abort,由 LLMEngine.step() 通知核心释放剩余状态。
为什么结果处理也要关心父子请求
并行采样的多个子请求可能在不同迭代完成。OutputProcessor 需要把它们重新组合成父请求下的多个候选,并遵守流式或最终输出模式。这个过程与 GPU 调度没有关系,却与 API 契约直接相关,所以它被留在前端。
至此,一次 token 的往返才完整结束:调度器提交执行计划,Worker 产生 token,核心提交状态,前端把 token 解释为字符串。如果请求尚未结束,下一轮再次从 schedule() 开始。
用一个 6-token prompt 走两轮
假设只有一个请求,prompt 长 6 个 token,max_tokens=2,未命中前缀缓存,当前 token budget 足够。忽略 block size 和特殊 token 后,可以把状态变化写成下表:
| 时刻 | 核心状态 | num_computed_tokens | 调度结果 | 用户可见输出 |
|---|---|---|---|---|
| 入队后 | WAITING | 0 | 尚未调度 | 无 |
| 第 1 轮 schedule | 转为 RUNNING | 0 | 计算 6 个 prompt token | 无 |
| 第 1 轮 update | RUNNING | 6 | 采样出第 1 个输出 token | 第 1 个 token 对应文本 |
| 第 2 轮 schedule | RUNNING | 6 | 计算上轮新 token 对应位置 | 暂无新增 |
| 第 2 轮 update | FINISHED | 7 | 采样出第 2 个 token,达到上限 | 第 2 个 token 对应文本与完成标记 |
这里最反直觉的是 num_computed_tokens 与已生成 token 数不是同一个概念。第 1 轮结束时已经采样出一个新 token,但这个 token 作为下一位置的输入,要到第 2 轮 forward 才真正进入模型并产生后继 token。调度器通过“当前 token 总数减已计算 token 数”自然得到下一轮欠账为 1。
若 prompt 长度超过本轮 token budget,第 1 轮只处理其中一个 chunk,不一定采样输出 token;若命中前缀缓存,num_computed_tokens 会从缓存命中位置起步;若启用投机解码,一轮可能验证多个 draft token。场景不同,但欠账模型不变。
四个必须守住的正确性不变量
读引擎源码时,与其记住每个分支,不如持续检查四个不变量。
请求状态只能沿合法路径迁移
典型路径是 WAITING 到 RUNNING,再到某一种 FINISHED 状态;抢占会让运行请求回到等待或特殊等待状态。已经结束的请求不能再次被调度,已取消请求的迟到输出不能复活它。
计算位置与 KV 状态必须一致
调度器声称某请求已计算到位置 p,对应层的 KV Cache 就必须对这些位置有效。抢占、外部 KV 加载、投机回滚和前缀缓存命中都不能只改计数不改 block 状态。许多看似偶发的错误,根因都是这两个世界失去同步。
一个 block 只有在最后使用者离开后才能回收
前缀缓存、并行采样和写时复制会让多个逻辑请求引用同一物理 block。请求完成不等于它引用的所有 block 都能立刻归还空闲池;缓存引用、异步 GPU 工作和延迟释放都必须纳入生命周期。
每个核心输出必须回到正确前端
request_id 关联请求本身,client_index 关联提交请求的前端。多 API Server、多数据并行 rank 或请求取消重试时,这两个维度不能混淆。否则最危险的结果不是“少返回一个 token”,而是把一个用户的结果发给另一个用户。
源码调试:从哪里打断点最有效
第一次跟踪不应在完整在线服务和多卡环境里开始。先用单卡离线请求、确定性采样和很短的输出,把进程拓扑压到最简单,然后观察以下位置:
sampling_params = SamplingParams( temperature=0.0, max_tokens=2,)推荐的断点顺序是:
LLMEngine.add_request():确认外部输入何时变为EngineCoreRequest。Scheduler.add_request():查看请求初始状态、prompt token 数与 waiting 队列。EngineCore.step():记录每轮SchedulerOutput.total_num_scheduled_tokens。Scheduler.schedule():比较num_computed_tokens与num_tokens_with_spec。Scheduler.update_from_output():观察新 token、状态迁移和完成条件。OutputProcessor.process_outputs():确认 token 如何增量解码、何时触发 stop string。
每轮建议只记一行状态:
step=3 req=0 status=RUNNINGcomputed=10 total=11 scheduled=1new_tokens=[1234] finished=False如果进入多进程模式后断点像“失效”一样,先检查函数运行在哪个进程。前端断点抓不到核心进程中的 EngineCore.step() 是正常现象。可以临时使用进程内客户端理解逻辑,再切回多进程验证 IPC;也可以给日志加 PID、request ID 与 step 序号,重建跨进程时间线。
性能分析时还要避免在热循环里打印完整 block table 或全部 token。日志序列化本身就可能扩大迭代间隙,制造并不存在于正常运行中的 CPU 瓶颈。更可靠的办法是记录计数、时间戳和少量 request ID,在异常步骤再有条件地导出详细状态。
常见误读与源码中的真实答案
误读一:一次 step() 就生成一个 token
对普通 decode 请求通常接近如此,但不是接口保证。chunked prefill 可能只计算 prompt,不产生可见输出;投机解码可能一次接受多个 token;pooling 任务也不是自回归生成。step 的本质是一轮调度与执行事务,而不是“一 token API”。
误读二:prefill 和 decode 必须由两套调度器处理
V1 的统一 token 欠账模型可以在同一轮混合 prefill 与 decode。两者计算特征不同,调度策略可能对长 prefill 限流,但内部不必先给请求贴上永不变化的阶段标签。
误读三:前端 LLMEngine 就是全部引擎
在当前 V1 中,前端类负责输入与输出语义,并通过 EngineCoreClient 接入核心。多进程部署的真正调度循环位于 Engine Core 进程。名称兼容性会误导阅读,调用关系比类名更可信。
误读四:模型返回 token 后可以立刻释放请求资源
结束判断、字符串 stop、迟到输出、异步 GPU 工作、缓存引用都可能推迟清理。正确实现必须先提交状态,再按所有权规则释放资源。
误读五:多进程只是把同一段代码搬到另一个进程
进程边界会改变控制流。进程内模式由 get_output() 主动调用核心 step;多进程模式由核心 busy loop 自主推进,前端只收消息。调试、背压、异常传播和性能归因都因此不同。
这一篇之后,应该能读懂什么
一次 vLLM V1 请求可以概括为两次翻译和一次核心事务:
- 输入翻译:prompt 与采样配置变成
EngineCoreRequest,前端和核心分别建立自己的请求状态; - 核心事务:
schedule()生成执行计划,Executor 执行,update_from_output()提交状态; - 输出翻译:
EngineCoreOutput经增量解码、stop 检查和父子聚合,变成RequestOutput。
最重要的源码认识有三点。第一,LLMEngine.step() 与 EngineCore.step() 不在同一层;第二,调度器用 token 欠账统一描述 prefill、decode、chunked prefill 和投机 token;第三,GPU forward 只处于事务中间,状态提交与资源回收同样决定系统正确性。
下一篇将继续深入 Scheduler.schedule(),专门拆解 running 与 waiting 队列、token budget、chunked prefill、前缀缓存命中、KV block 分配和抢占。到那时,本文的调用链会成为定位每个调度分支的坐标系。
参考资料
- vLLM 官方架构总览
- vLLM V1 用户指南
- vLLM V1 Engine Architecture 设计讨论
- EngineCore 源码:vllm/v1/engine/core.py
- 前端 LLMEngine 源码:vllm/v1/engine/llm_engine.py
- EngineCoreClient 源码:vllm/v1/engine/core_client.py
- V1 Scheduler 源码:vllm/v1/core/sched/scheduler.py
- V1 Request 数据结构:vllm/v1/request.py
- V1 OutputProcessor 源码:vllm/v1/engine/output_processor.py
- PagedAttention 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


