


vLLM 源码完全拆解(十四):结构化输出——FSM 编译、语法 bitmask 与受限采样
上一篇拆解了 V1 引擎的多模态输入链路,看到”一张图”如何被拆成 token 流、镜像缓存与编码器输出三种形态、最后在 get_input_embeddings 处汇合。本篇转向 V1 另一块从未触及的生产级模块:结构化输出(structured output,也常叫 guided decoding)——让模型的输出严格符合 JSON Schema、正则表达式或某种上下文无关文法。这个功能的实现横跨引擎三层:请求进入时要编译语法(可能很慢,需要异步)、调度时要跟踪编译状态(没编译完的请求不能进批)、采样时要屏蔽非法 token(一个 bitmask 叠加在 logits 上)。它与第九篇拆过的 Sampler 在 apply_grammar_bitmask 这一点上精确对接,与调度器的 WAITING_FOR_FSM 状态机直接耦合,是继连续批处理、KV Cache 管理之后,理解”生产可用”的第三块地基。
先看用户侧的接口。vLLM 的 SamplingParams 支持以 guided_decoding 字段携带约束:
from vllm.sampling_params import GuidedDecodingParams
params = SamplingParams( temperature=0.8, guided_decoding=GuidedDecodingParams(json=schema), # JsonSchema/regex/grammar/choice)llm.generate(["给我一个北京今天的天气 JSON"], params)GuidedDecodingParams 支持的约束类型:json(JSON Schema)、regex(正则)、grammar(EBNF 文法)、choice(固定选项)、structural_tag 等。注意一个反直觉之处:这个功能不需要重新训练模型,也不需要在 prompt 里写”请输出合法 JSON”——vLLM 在每个生成步,把”接在这个位置会违反约束”的所有 token 的 logits 压到负无穷,让采样永远只会选出合法 token。语法约束变成了一个每步重算的采样问题。约束的效果立竿见影,官方博客给过一个最直观的对比:
系列进度与本篇位置
本系列 vLLM 部分已拆到第十四篇,路线是:整体架构(一)→ 请求生命周期(二)→ 调度器(三)→ KVCacheManager(四)→ GPUModelRunner 输入拼批(五)→ Attention Backend(六)→ PagedAttention Kernel(七)→ MoE 执行(八)→ Sampler(九)→ 投机解码(十)→ 张量并行(十一)→ 编译子系统(十二)→ 多模态输入(十三)。这些篇目里,有一条隐含的主线是 batch 的每一维度都在被压缩
五种约束类型各自走什么路径,在 get_structured_output_key(structured_output/request.py:61)里一眼可见——它把 GuidedDecodingParams 归一成 (类型, 规格串) 的二元组:
jsonSchema(int 或 str 统一 json.dumps 成 str)。编译走 compile_json_schema(any_whitespace=...),{"type": "object"}的裸 object(即json_object)共享同一条编译路径。regex:正则转文法编译。入口验证只做Grammar.from_regex的解析尝试。grammar或(转换后的)Lark 文法,xgrammar 只吃 EBNF。 choice:入口即改写成 EBNF 文法,内部无独立路径。structural_tag:对思维链模型友好的结构化标签——触发词之后才按 schema 约束、结束标记之后放开,compile_structural_tag一并编译。它解决的是”响应的一部分要结构化、一部分要自由文本”的复合场景,本质是把”在哪个 token 区间应用哪段文法”也编码进了约束本身。
这套键值会被放进 structured_output_key(functools.cached_property,一次计算终身缓存),它是编译缓存与请求配对的主键——backend 磁盘 LRU 里 key 就是这个二元组的序列化。同 schema 的请求天然同 key,这也是前文”同 schema 第二请求零编译”的机制根源。
接口还有一个与第九篇 Sampler 相呼应的细节:guided_decoding 挂在 SamplingParams 下而非请求级独立字段,意味着同一请求的采样配置与约束是原子整体——params.clone() 时约束跟着走,第九篇拆过的”采样参数在 multiproc 场景下的克隆”逻辑对约束同样生效。
结构概览:三层职责划分
先给全景。V1 的结构化输出代码集中在 vllm/v1/structured_output/(四个文件,合计千行级)加上散布在调度器、Sampler 与 model runner 里的几个挂钩点。按”哪个进程、哪个时机”划分,一共三层:
[请求进入时 | P0/验证层 processor.py] validate_xgrammar_grammar() / validate_guidance_grammar() ── 语法能不能表达?立即抛 ValueError 给客户 ── choice →grammar 的降级改写在validation 里完成
[请求入队后 | P1/编译层 structured_output/] EngineCore.add_request() → grammar_init() ── 首次用到才初始化 Backend(懒加载 xgrammar/guidance) ── executor.submit(异步编译) → Future 存进 StructuredOutputRequest Request.status = WAITING_FOR_FSM 编译没完成就不能进批
[每个调度步 | P1/屏蔽层 scheduler + gpu_model_runner + sampler] scheduler.schedule() 尾部: structured_output_manager.grammar_bitmask(...) → np.ndarray gpu runner execute_model(): compute_logits() → apply_grammar_bitmask(logits) 就地压 -inf sampler() 采样(对 bitmask 无感知) scheduler.update_from_output(): grammar.accept_tokens() 把采样结果喂回 FSM 推进状态三层的职责边界切得非常清楚:验证层只回答”这个约束我们接不接”,编译层只回答”FSM 造好了没有”,屏蔽层只回答”这一步哪些 token 禁选”。彼此之间没有函数调用耦合——靠 Request.status(WAITING_FOR_FSM → WAITING)、StructuredOutputRequest._grammar(Future 或成品)、SchedulerOutput.grammar_bitmask(NumPy 数组)三个”信物”传递状态。这也让第九篇拆过的 Sampler 完全不用改
这个分层还决定了失败模式的位置:验证失败在 P0(立刻抛给用户)、编译失败在后台(Future 里,最坏表现为请求卡 WAITING_FOR_FSM)、屏蔽失败在 GPU(掩码错位,输出违反约束但不报错)。三种失败的可观测性依次变差,所以源码把最多人踩的前两类失败都前置了
还有一条值得注意的架构决策,源码注释写得很直白(structured_output/__init__.py 的 grammar_init):
# NOTE: We only support a single backend. We do NOT support different# backends on a per-request basis in V1 (for now, anyway...).整个引擎只有一个全局 backend(默认 xgrammar,可切 guidance),第一个带约束的请求到来时才初始化。请求级的 backend 混用被有意排除了——因为 bitmask 是按批生成、按批传输的,批里一半请求用 xgrammar 一半用 guidance 意味着两套 mask 通道,复杂度翻倍而收益存疑。这个”一刀切”在 V1 里随处可见(比如 CUDA Graph 档位全员一致),是同一条设计哲学:批处理引擎的约束应该收敛在最小集合上。
第二层:语法编译为什么必须异步
编译有多慢
GrammarCompiler.compile_json_schema 把一份 JSON Schema 编译成 xgrammar 的自适应 token 掩码数据结构。这个过程是纯 CPU 的:遍历 schema → 转成等价的 EBNF 文法 → 构建 token 树掩码。对简单的 {"type": "object", "properties": {...}} 毫秒级;但对带深层嵌套、oneOf 组合、多维数组的真实业务 schema,编译可能要秒到分钟级——xgrammar 论文里报告的最大用例(全量 MySQL schema 的 JSON)编译时间以分钟计。
问题在于这不能发生在调度热路径上。调度器每个 step 都在毫秒级预算里跑完,一条请求卡住整个引擎 30 秒不可接受;但请求也不能被丢弃——语法是用户明确要的,vLLM 既不能静默去掉约束(那是错误的输出),也不能立刻 503(那是不必要的拒绝)。
Future + 状态机:两段式等待
解法是把”编译”变成一个可以轮询的后台任务。grammar_init(structured_output/__init__.py:63)做三件事:
def grammar_init(self, request: Request) -> None: ... if self.backend is None: # ① 懒初始化全局 backend self.backend = XgrammarBackend(...) grammar = self.executor.submit(self._async_create_grammar, request) # ② request.structured_output_request.grammar = grammar # ③ # 此刻 request.structured_output_request.grammar 是一个 Future① 全局 backend 只建一次,持有一个带缓存的 GrammarCompiler(编译结果磁盘 LRU,容量 VLLM_XGRAMMAR_CACHE_MB,默认 512MB——同样的 schema 第二次请求直达);② 编译任务提交到线程池,线程数是CPU 核数的一半(注释:默认 cpu*5 是给 I/O 任务的,CPU 密集的语法编译不该占满核;顶多耗一半,给调度器留算力);③ Future 挂到请求上,Request.__init__ 已经把状态设为 WAITING_FOR_FSM(vllm/v1/request.py:54)。
等待端在调度器(vllm/v1/core/sched/scheduler.py:354):
if request.status == RequestStatus.WAITING_FOR_FSM: structured_output_req = request.structured_output_request if structured_output_req and structured_output_req.grammar: request.status = RequestStatus.WAITING # 编译完成,进入正常调度 else: self.waiting.pop_request() skipped_waiting_requests.prepend_request(request) # 没好,放回队头 continueGrammar 属性自带完成探测(structured_output/request.py:26):
def _check_grammar_completion(self) -> bool: if isinstance(self._grammar, Future): try: self._grammar = self._grammar.result(timeout=0.0001) # 100 微秒 self.status = RequestStatus.WAITING except TimeoutError: return False return True100 微秒的非阻塞轮询是这段设计的精髓:不是轮询间隔(轮询发生在每个调度步,天然节流),而是”探测成本”。Future.result(timeout=...) 底层是条件变量的带超时等待,100μs 的口径让一次探测最坏只吃掉调度步预算的百分之一;编译好了 Future 就变成了真正的 StructuredOutputGrammar,此后 grammar 属性每次访问都立即返回。请求在 WAITING_FOR_FSM 状态里不占调度预算、不占 KV block、不占 running 槽位,只是安静地排在 waiting 队列——编译慢的全部代价就是”这个请求晚几分钟开始生成”,而不是”整个引擎停摆”。
一个容易被忽略的次序细节:探测发生在每个调度 step 的 waiting 队列扫描里,而扫描是从队头来的。如果队头三条请求的 FSM 都没编译好,它们会被 prepend_request 依次放回队头,同批更靠后的纯文本请求不会被它们挡住——skipped_waiting_requests 这个专用队列的意义就在这里:跳过的请求集合与”被选中继续调度”的集合分开收集,循环结束后统一 prepend,避免跳过请求打断本轮已建立的队序。
验证层:把编译失败挡在 P0
编译还可能失败——schema 里有 xgrammar 不支持的 JSON 关键字、正则无法转成文法、Lark 语法转 EBNF 失败。这些都发生在 P1 的编译线程里,但抛给用户的时机在 P0:process_inputs 的 _validate_structured_output(processor.py:187)在请求进入引擎之前就调用 validate_xgrammar_grammar(backend_xgrammar.py:241),做一轮”只解析、不编译”的预检:
if gd_params.json: ... try: xgr.Grammar.from_json_schema(schema) # 只解析 schema,不构建掩码 except Exception as err: raise ValueError("Failed to transform json schema into a grammar: ...") if has_xgrammar_unsupported_json_features(schema): raise ValueError("The provided JSON schema contains features not " "supported by xgrammar.")has_xgrammar_unsupported_json_features 递归扫 schema,列出已知不支持的特性:multipleOf(数字倍数)、uniqueItems/minContains/maxContains(数组约束)、format(字符串格式)、minProperties/patternProperties 等。为什么不直接编译来发现不支持?因为那要把失败信号从 P1 的线程穿透回 P0 的 HTTP 响应,而编译是在异步线程里跑的——显式列出已知不支持清单,把错误前置到立刻抛出,比事后从异常链里捞要可靠。代价是清单会过时(xgrammar 支持面在扩大),源码用 TODO 注释承认了这一点。
choice 类型还有一处改写式降级:["北京","上海","广州"] 被转换成 root ::= "北京" | "上海" | "广州" 的 EBNF 文法再统一走 grammar 通道(validate_xgrammar_grammar 中 gd_params.choice = None; gd_params.grammar = choice_grammar)。choice 在引擎内部根本不是独立类型——它的 bitmask 语法与 regex/JSON 完全共享,只是入口接口给了用户一个更顺手的形状。同类改写还有 Lark→EBNF 的自动化转换(structured_output/utils.py:41,逐行把 rule: 头转成 rule ::=、单引号字面量转双引号、补 root ::= first_rule)。
改写发生在验证层,带来一个值得单独说明的好处:改写失败(引号不配对、引用了未定义规则)在 P0 就抛 ValueError,用户拿到的是”你的 grammar 第 3 行引用了未定义的 rule”这样精确的错误;若改写发生在 P1 的异步编译里,同样的错误要经过 Future 的异常通道、可能被 _check_grammar_completion 的轮询掩盖,用户只会看到”请求一直在排队”。这也是验证层存在的深层理由——编译的失败要尽量前移到同步路径,异步段的错误越少,状态机的处理越简单。
guidance 后端与 xgrammar 的接口对照
GuidanceBackend(backend_guidance.py)内部的 GuidanceGrammar 用 llguidance 的 LLMatcher 实现同一组动词,对照读可以看清抽象接口的边界到底裁在哪里。三处语义差异值得标记:
终止判定的来源不同。xgrammar 的 is_terminated() 直接问 matcher 内部状态;guidance 用一个自己维护的布尔self.terminated = True,matcher 停止后 accept_tokens 变成无条件返回 True。两种实现对外行为一致(到终止态后不再消耗输入),但guidance 的终止要靠”EOS 出现在采样结果里”这个事件驱动,xgrammar 是状态驱动——语义等价,机制 different,混用两者的心智模型时需要注意。
错误处理的可见性不同。guidance 的 matcher 有错误态,check_error() 用一个一次性标志(printed_error=False 起步)保证同一错误只打印一次;xgrammar 的 accept_tokens 失败直接 logger.error 加”Please file an issue”——后端的错误路径设计按各自上游库的风格收敛,但都遵守”错误不中断批处理”的共识:一个请求的 FSM 出错不连带其他请求,最坏情形是该请求的约束失效或提前终止,由日志暴露。
fast-forward 的支持度不同。guidance 侧留了一段 TODO:compute_ff_bytes/compute_ff_tokens(jump-forward decoding——文法状态如果只差一个”固定后缀”就能到下一歧路口,直接把这段固定 token 跳过不采样),xgrammar 侧 find_jump_forward_string 已经在 API 里(见 backend 源码引用的文档链接)。跳过确定性后缀是受限采样独有的免费午餐:文法在”必须有右括号”的状态下,输出没有选择自由,直接填串比生成掩码更省 GPU 跳。0.9.2 的 vLLM 接口还没把 fast-forward 接进调度循环(那需要”一个 step 填多个 token”的能力与 KV 缓存的配合),但接口的动词集已经为它留了位置。
FSM 内部:自适应 token 掩码与两个后端的对照
把视角拉到 xgrammar 内部。编译产物 CompiledGrammar 是一个下推自动机(pushdown automaton——带栈的状态机,栈用来处理递归嵌套):文法的每个非终结符展开路径对应状态的转移,oneOf 对应分支,递归类型(如任意深度的嵌套 JSON)对应压栈/弹栈。“下一步能接哪些 token”在这个自动机上看就是”从当前状态出发,经一步转移能到达的状态的集合对应的 token 集”。
朴素实现是每个状态都存一张 vocab_size 比特的完整掩码:状态数可能上千,每个掩码 128KB(vocab 15 万级别算,vocab/8 字节),内存与编译时间都会爆炸。xgrammar 论文的核心设计是自适应 token 掩码(adaptive token mask):首先,不是每个状态都要完整掩码——很多文法状态下,可达 token 很少,只存它们的稀疏下标比存位图省得多;其次,对”必须完整枚举”的状态,利用 token 树(token mask tree,按词表前缀关系分层的树)把”前缀相同的 token 组”的合法性判定下推到组级——比如”所有以 {"type": " 开头的 token 在此状态下都合法”,判定一次就覆盖上千个词表项。这两层把”每状态全词表扫描”变成”增量推理 + 组级捷径”,是 JSON 生成近零开销的算法基础。
vLLM 侧对这一切不感知compile_grammar / fill_bitmask / accept_tokens / rollback 四个动词,XgrammarGrammar(backend_xgrammar.py:136)是这套动词在 vLLM 里的薄封装。guidance 后端(backend_guidance.py)实现同一组接口、内部是 Il Guidance 的引擎——backend_types.py 里 StructuredOutputBackend/StructuredOutputGrammar 两个抽象类就是两者的公约数。换 backend 不动引擎是这条抽象线的价值;0.9.2 里 xgrammar 的 any_whitespace 变体参数从 vLLM 配置穿透到 compile_json_schema 的调用参数,是”引擎细节通过 backend 接口逃逸”的少数几处——因为 JSON 的空白容忍度直接改变编译产物,躲不开。
第三层
FSM 是什么,bitmask 从哪来
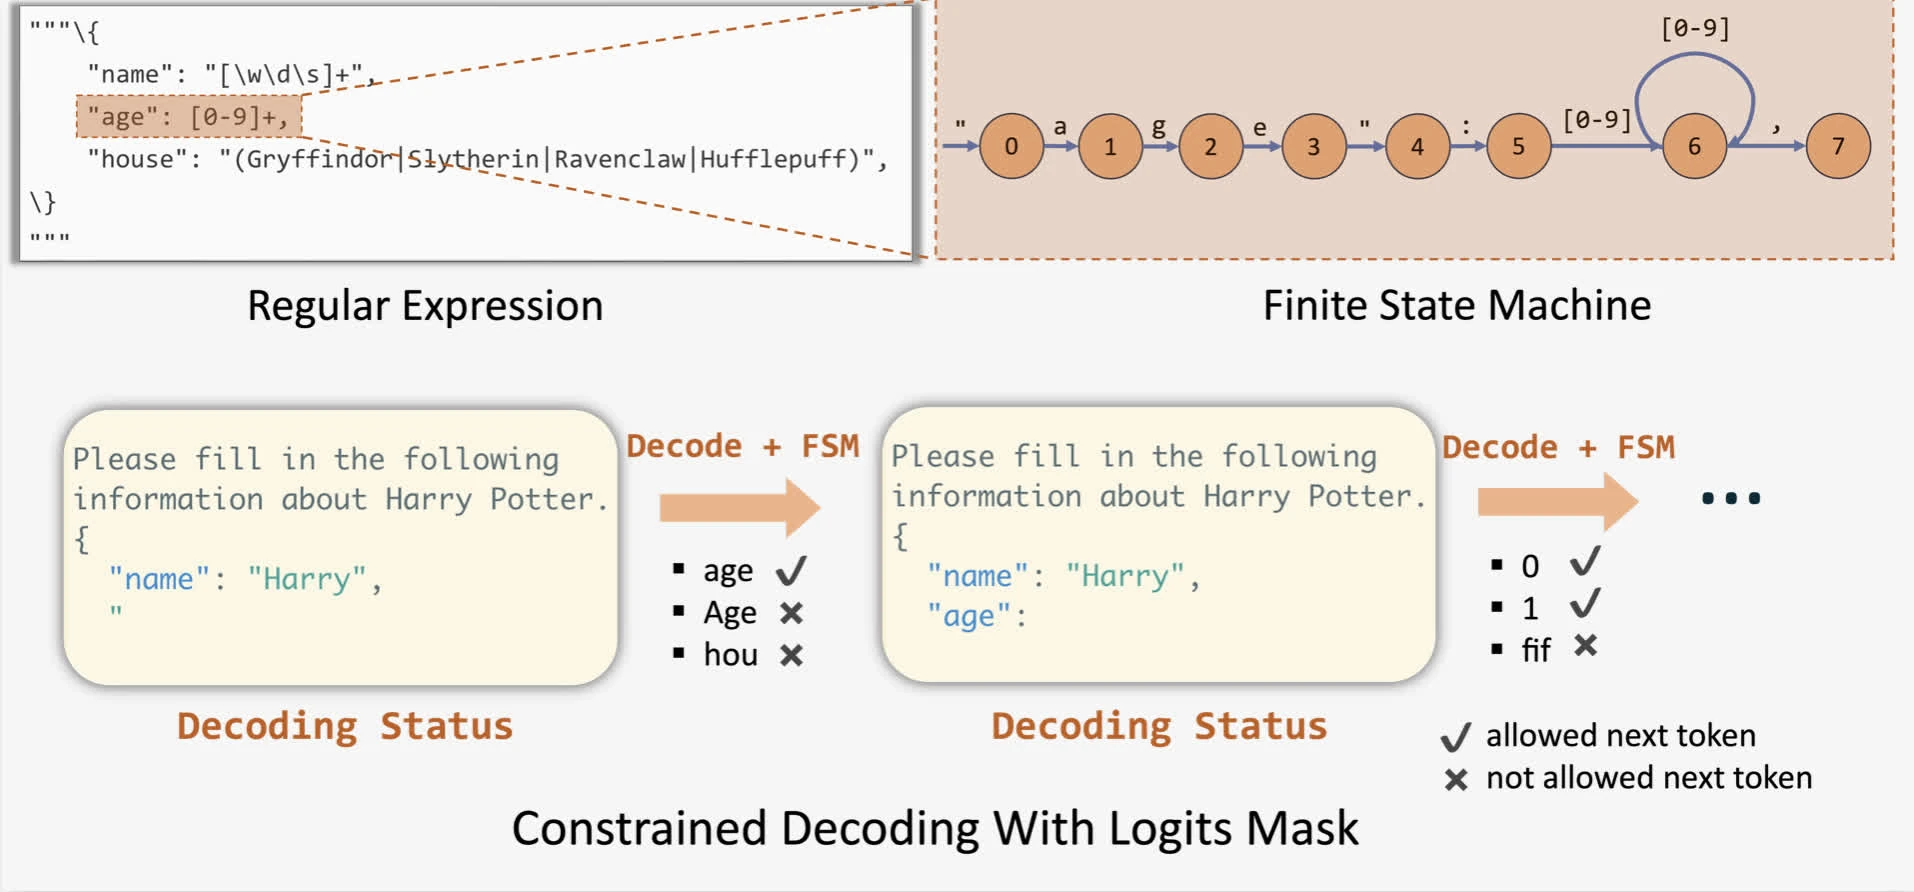
xgrammar 的 GrammarMatcher 内部对编译好的文法维护着当前状态:已消费哪些 token、下一步能接哪些。fill_next_token_bitmask(bitmask, idx) 把”从当前状态出发,接受哪些 token 不会违反文法”写成一张位图——vocab_size 个比特,int32 每 32 位一个字,合法 token 的比特为 1,非法为 0。vLLM 拿到这张位图后,对 logits 做就地掩码
先看位图缓存的数据结构与生命周期要点:
- 分配:首次需要时
backend.allocate_token_bitmask(max_batch_size * (1 + max_spec_tokens)),即每个请求一张,若开投机解码,每个投机槽位再各一张。一次分配终身复用,每个调度步开头重置。 - 重置:
bitmask_tensor[...].fill_(-1)——_full_mask = torch.tensor(-1)是 int32 的全 1,即”默认全禁”,随后每个被调度的请求把自己的合法位写出来。默认态选”全禁”而不是”全允许”是纵深防御:某个路径漏写请求的 mask 时,表现为该请求永远采不出 token(超时/卡死),而不是”约束被静默忽略、输出又飘了”。 - 传输
→ numpy( structured_output/__init__.py:196;注释解释:NumPy 的序列化比 torch 快得多,这是 P1→GPU worker 的跨进程序列化路径,第九篇 Sampler 的 logprobs 也走同一条)。 - 生效
worker 收到后转回 tensor, apply_token_bitmask_inplace的 torch.compile 实现(gpu_model_runner.py:1149)对 logits 的对应行做logits[bit=0] = -inf。
生成端
StructuredOutputManager.grammar_bitmask(structured_output/__init__.py:114)每个调度步末尾运行,遍历本步真的被调度的结构化输出请求,逐个填位图:
for req_id, _ in ordered_seq: # 按批内下标排序 ... apply_bitmask = True if self.reasoner is not None: if structured_output_request.reasoning_ended is None: structured_output_request.reasoning_ended = \ self.reasoner.is_reasoning_end(request.prompt_token_ids) apply_bitmask = structured_output_request.reasoning_ended state_advancements = 0 req_tokens = scheduled_spec_decode_tokens.get(req_id, []) + [None] for i, token in enumerate(req_tokens): # 每个投机槽位 + 1 个本位 if apply_bitmask and not grammar.is_terminated(): grammar.fill_bitmask(bitmask_tensor, cumulative_index) if token is not None: grammar.accept_tokens(req_id, [token]) # 前瞻:假想接受 state_advancements += 1 cumulative_index += 1 if state_advancements > 0: grammar.rollback(state_advancements) # 回滚,恢复真状态主循环只填一张”本位”的 mask(没有投机解码时这是唯一一张);若调度里有投机 token,对每个投机槽位额外填一张——填第 i+1 张前,把第 i 个投机 token “假想接受”进 FSM 推进状态,这样第 i 个槽位的 mask 反映的是”若前面全被接受,后面的合法选择是什么”。所有槽位填完统一 rollback。这是在用”前进再倒档”换算多步状态,而不是为每个假设状态保留独立副本——FSM 状态推进是 O(1) 的指针操作,回滚也一样便宜,远比维护多副本状态省内存,这个模式在投机解码与受限采样交叉的场景里是标准解法(第十二篇 CUDAGraphDispatcher 的 BatchDescriptor、本篇 accepted_token 前瞻,都是同型思路)。
apply_bitmask 的分支是为推理解耦/reasoning 交互:若模型是思维链型(如 DeepSeek-R1 的 <think>...</think> 结构),约束不该从第 0 个 token 就生效——推理阶段的自然语言会被 JSON 的位图活活绞死。vLLM 用 ReasoningParser 判断”思维结束了吗”,没结束的请求本步不填 mask、也不推进 FSM,等 </think> 之后才开始受限采样。should_advance(structured_output/__init__.py:198)在输出端配对:reasoner.is_reasoning_end(request.all_token_ids) 检测到思维结束的当下返回 False(本步的 token 还在思维里),下一个 pass 才开始推进 FSM——一句注释就说明白了这种 off-by-one 的处理:“Reasoning just ended, so we shouldn’t advanced til next pass”。
生效端:三把尺子对齐同一批请求
apply_grammar_bitmask(gpu_model_runner.py:1093)是屏蔽层在 GPU 侧的最后一跳。它会遇到一个排序错位问题:调度器把 bitmask 按”结构化输出批内序”打包(紧致排列,没有约束的请求不占位),而 logits 的行序是”GPU 批内下标”(每个请求占一行,包括没有约束的)。两个序必须精确对齐,mask 才会落在请求自己的行上:
for req_id, batch_index in seq: # ① GPU 批内序 logit_index = batch_index + cumulative_offset cumulative_offset += len(scheduled_spec_decode_tokens.get(req_id, [])) if req_id in structured_output_request_ids: struct_out_req_batch_indices[req_id] = logit_index
for req_id, _ in seq: # ② 结构化批内序 logit_index = struct_out_req_batch_indices[req_id] num_spec_tokens = len(scheduled_spec_decode_tokens.get(req_id, [])) for i in range(1 + num_spec_tokens): sorted_bitmask[logit_index + i] = grammar_bitmask[cumulative_index + i] out_indices.append(logit_index + i) cumulative_index += 1 + num_spec_tokens两把尺子的换算都在这段里:① 建立”请求 → 它的 logits 行号”映射,偏移量 cumulative_offset 加的是其他请求的投机 token 数——投机解码里每个请求占的 logit 行数 = 1 + 自身投机数,批内行号是逐请求累加的,不是 batch_index 直接可索引(第九篇 Sampler 的 bonus_logits_indices 处理的是同一套行号语义);② 沿结构化请求序把各自紧凑打包的 mask 行拷到 logits 行号对应的位置,投机请求的 1+num_spec_tokens 张连成一段。没有约束的请求在 sorted_bitmask 里保持全 0 初始化——np.zeros_like 保证了这一点,它们不会碰 mask(全 0 的 int32 字不是 -1,后续 kernel 对”未列出的行”跳过)。
out_indices 把”实际写了 mask 的 logits 行号”收集成一个整数列表传给 kernel,kernel 只对这些行做掩码,别的行原样不动。mask 的行数、logits 的行数、结构化请求的行数三个数互不相等,全靠显式索引对齐——这里没有 batch 维度广播的巧合,只有排序与索引的算术。
与 Sampler 的衔接:一次受限采样的完整时间线
先去掉投机解码的干扰,给一个纯 prefill + decode 的最小时间线,把接口层的五个约束类型、编译层的 Future、调度层的 bitmask、执行层的 logits、输出层的 FSM 推进串到一条请求上。设批里 4 条请求,其中请求 B 带 JSON 约束,调度步 3 时刻 B 已完成编译、正在 prefill 的第 128 个 token:
把各环节接到一个具体请求上。设批里有 4 条请求,其中请求 B 带 JSON 约束,调度步 3 时刻 B 已完成编译、正在 prefill 的第 128 个 token:
[schedule 尾部] Scheduler structured_output_request_ids = {"B": 1} # B 在批内下标 1 grammar_bitmask(requests, ids, spec_tokens) → 请求 B 的 FSM fill_next_token_bitmask → np.ndarray shape ≈ (1, ceil(vocab/32)) # 只含 B,紧凑排列[SchedulerOutput.grammar_bitmask] → ZMQ → GPU worker
[execute_model] logits = model.compute_logits(hidden_states[logits_indices]) # (4, vocab) if scheduler_output.grammar_bitmask is not None: apply_grammar_bitmask(scheduler_output, logits) → 排序对齐: B 的 mask 行 → logits 行 1 → apply_token_bitmask_inplace: logits[1][bit=0] = -inf sampler(logits, sampling_metadata) # 第九篇的采样管线 → 对请求 B: temperature/top-k/top-p 都在 -inf 之后的可行集上工作 → 采样出 token t
[update_from_output] Scheduler should_advance(B) → True grammar.accept_tokens("B", [t]) # FSM 前进一格 若 t 是投机路径的 token → validate_tokens 验证分支,拒绝则 rollback三个值得注意的边界:
bitmask 与 Sampler 的能力正交。温度缩放只是 logits / T,-inf 除以任何正数仍是 -inf;top-k/top-p 在可行性集合内截断;logit_bias/stop token 在 Sampler 层另行叠加(若 bias 里的 token 恰好被 bitmask 禁掉,表现为该永远不会被采出,不报错)。约束的可满足性问题在填充位图的时刻就定下了——若文法在某状态下要求”必须有 token 可选而位图全 0”,这是文法与词表失配的编译期错误,会在首个 mask 应用时立刻暴露为采样超时,而不是静默错输出。
FSM 的推进以”采样结果”为准,以”调度时序”为界。update_from_output 里 if new_token_ids and structured_output_manager.should_advance(...)(scheduler.py:824)——只有本步真的为这条请求采样出了 token(分块 prefill 的中间步没有 token),FSM 才推进。这保证了 FSM 状态与”请求实际生成到的位置”严格同步,哪怕分块调度把一条请求的 prefill 拆成 5 个 step。
投机解码路径用 validate_tokens 而非 accept_tokens(scheduler.py:838-841):草稿给出 spec_token_ids,先整段验证(validate_tokens 内部”接受到第一个失败 token 就停,然后 rollback 到起点”,backend_xgrammar.py:167),把验证通过的 prefix 作为 FSM 的净推进量——拒绝的是失败 token 之后的部分,已接受的前缀不需要”重来一遍”,这是第九篇投机解码”批量验证”在约束维度的对应实现。max_rollback_tokens=num_speculative_tokens 在 backend 构造时被显式设进 GrammarMatcher(backend_xgrammar.py:122),给”整段草稿被拒”的回滚路径留出精确的回退深度。
性能与常见坑
开销集中在哪
结构化输出的运行期开销有三个来源,量级差得很远:
- 语法编译(一次性):简单 schema 毫秒级,复杂 schema 秒到分钟级。xgrammar 论文的核心贡献就是把这个数字从分钟压到亚秒——用自适应 token 掩码(token mask tree)加缓存已见状态的掩码增量,而不是每个状态都现算全量掩码。vLLM 侧的对策是异步编译加编译结果 LRU 磁盘缓存(
VLLM_XGRAMMAR_CACHE_MB),同 schema 的第二个请求零编译。 - 每步 bitmask 填充(每跳每请求):
fill_next_token_bitmask从缓存状态增量生成,CPU 上微秒级;但它跑在 P1 的调度线程上(grammar_bitmask在 schedule 尾部同步调用),大 batch 全是结构化输出请求时,这个逐请求串行循环本身是 O(batch × FSM 常数) 的纯 CPU 段。源码留了注释承认这里有优化空间(# NOTE: This outer loop can likely be parallelized...),当前版本没做。 - GPU 掩码应用(每跳一次):
apply_token_bitmask_inplace是一个对(num_reqs, vocab)的位运算广播,微秒级开销,不构成瓶颈。值得注意 0.9.2 刻意选了 torch.compile 实现而非 Triton kernel(gpu_model_runner.py:1146-1149),注释指向 PR #19565 与 issue #19493/#18376版在并发结构化输出场景有正确性问题,torch.compile 版虽慢一点但错不了——用微量性能换确定性的取舍,与上一章的默认全禁 mask 是同一种防御意识。
官方博客给的实测位
vLLM 官方的结构化输出解读文章给了一组 LLaMA-3B、单卡 A6000 的对比数字(见下图):旧 V0 的 GuidedDecoding 路径(outlines/local 两种)每 token 额外开销都在数百微秒到毫秒级,换 xgrammar 的 V1 路径后,decode 每 token 的额外开销被压到 50μs 附近——几乎接近无约束基线。原理不神秘
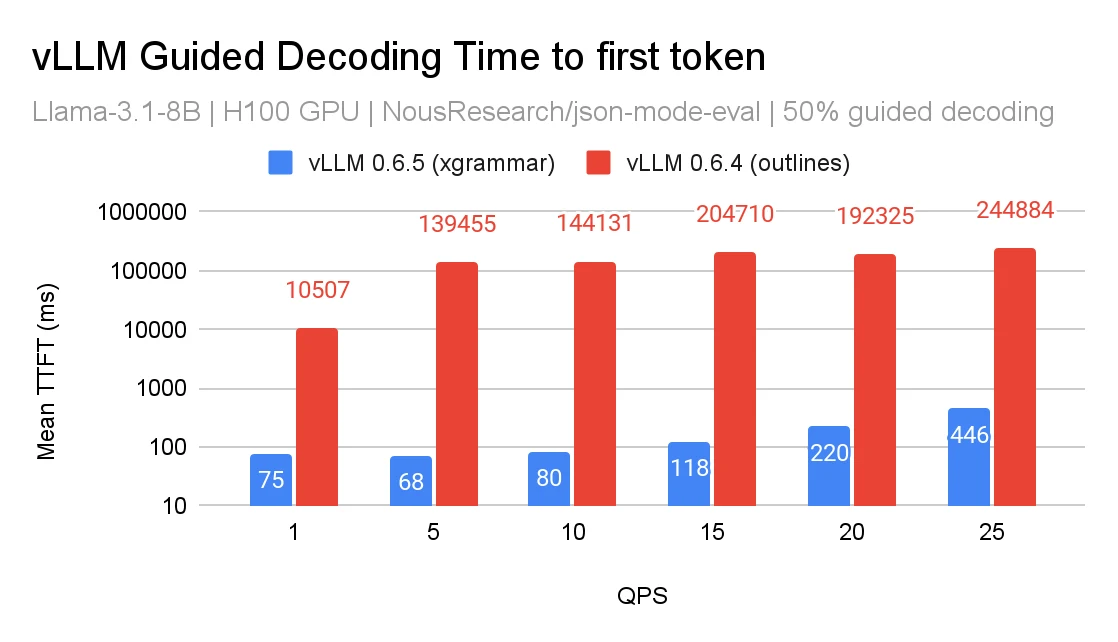
另外两个来自同一份实测的观察对容量规划有用:约束对批处理吞吐的稀释远小于对单请求延迟的影响(大 batch 下,掩码应用的固定开销被摊薄);带 any_whitespace 变体时编译产物不同(xgrammar 对”JSON 里允不允许任意空白”编译出不同 FSM),用 --structured-outputs-config '{"disable_any_whitespace": true}' 关掉可以缩小可行集、提高输出贴近 schema 的程度,但代价是输出格式更死板(没有缩进换行)。
常见坑排查手册
- “请求一直排队不开始生成”先查 FSM 编译。调度器日志里请求进进出出 WAITING_FOR_FSM,QPS 明明很低。三个排查方向
是不是第一次出现的复杂 schema(看 VLLM_XGRAMMAR_CACHE_MB命中率,或看编译线程是不是在干活)、--structured-outputs-config的 backend 是不是意外切到了 guidance(guidance 对某些文法的编译比 xgrammar 慢)、tokenier 是不是skip_tokenizer_init——注释里明确写了skip_tokenizer_init的部署(纯 token id 输入)没有 StructuredOutputManager,约束会被静默忽略。 WAITING_FOR_FSM的请求也占 waiting 队列的位置。前文说了它们不占算力,但队头堵一堆长编译请求时,调度循环每个 step 都要探测一遍(每条 100μs)。若一批涌入 50 条同 schema 请求,它们共享同一个编译任务吗?不——vLLM 的编译缓存(backend 的GrammarCompiler磁盘 LRU)在编译完成后才可能命中,提交时刻 50 条 Future 就是 50 个任务,靠cache_enabled=True的编译器内部去重并发。上游讨论里有 schema 加载去重的工作,0.9.2 还是靠编译器自身的缓存语义兑现。- 结构化输出 + prefix caching 的交集要看 FSM 状态对齐。两条请求共享前缀、但 schema 不同时,bitmask 各填各的(vLLM 按 schema 内容的 hash 是否一致来共享编译产物,而不是”同前缀就同 FSM”);同 schema 时 FSM 从 0 状态同构推进,没有 state 跨请求复用问题。自定义后端集成时要保证
StructuredOutputGrammar的状态不逃逸出单请求。 - reasoning 交互开启时约束生效点后移。带
<think>的请求,JSON 约束从思维结束后才开始;若ReasoningParser配置的结束标记与模型实际输出不一致(或模型永远不输出</think>),约束永远不生效,表现为”structure output 不起作用”。reasoning_ended的初始化是惰性的(reasoning_ended is None时才扫 prompt),已判 False 的请求不会重扫 prompt,靠每步的all_token_ids检查翻转——输出里搜结束标记失败的话,整个请求的自由文本一路采到底。 - Mistral/tekken 词表要走专门路径。backend 构造里对
MistralTokenizer单列了一支(逐 token 排序重构词表、按 tekken 与否选 RAW/BYTE_FALLBACK 词表类型,backend_xgrammar.py:39-71)。用 Mistral 模型做结构化输出看到掩码异常时,先确认这段构造走的分支是否正确。
受限采样的正确性论证:为什么”屏蔽”就够了
一个值得停下来想的问题:只在采样时屏蔽 token,凭什么保证输出完整满足约束?屏蔽只约束了”这一步能选什么”,没有约束”选了之后能否走完”。
答案来自 FSM 的活性(liveness)与约束的可满足性两层。活性max_tokens 的截断会让它停在半路——此时输出不合法,但这是长度预算的失败,不是屏蔽机制的失败。
这层区分在工程上有真实含义:遇到”加了约束之后偶尔输出不完整 JSON”的报告,先检查是不是 max_tokens 给小了(递归 schema 的路径长度下界可能远超用户直觉),再查 FSM 终止判定(is_terminated)与 stop 条件的交互——约束模式下,stop string 检测的语义变成”输出到约束允许的终止态”与”输出到 stop 条件”两条规则的竞争,前者由 FSM 保证、后者由用户决定,二者的冲突(用户要求在任何前缀上停、约束说不合法)按”stop 条件胜出”处理,输出于是不完整。这不是 bug 而是语义边界,生产里要用 max_tokens 与 schema 复杂度的匹配来规避。
与站内其他机制的关系
结构化输出与前面几篇拆过的机制有四处精确的耦合,单独列出可以当本篇的”接口索引”:
与 Sampler(第九篇)compute_logits 之后、sampler(...) 之前(gpu_model_runner.py:1423-1425)。第九篇拆过的采样管线——温度缩放、top-k/top-p、logprobs——全部在可行子集上运行,一行都没改。logprobs 有个细节因此值得复读:被 -inf 的 token 如果出现在 top-k 名单里,其 logprob 是 -inf,sample_logprobs 里就会如实显示——用户看到 -inf 的 logprob 不是 bug,是约束在说”这个不可选”。
与调度器(第三/四篇):WAITING_FOR_FSM 是调度状态机的一个等待态;编译完成前的请求不占 KV block、不占 batch 槽位,调度循环每步探测一次。这与第四篇 KVCacheManager 的”分配即承诺”哲学一致——不准备好执行条件的请求,不进入任何资源池,等待编译的请求与等待 KV 空间的请求共用同一套 skip-and-prepend 队列机制,彼此不阻塞。
与投机解码(第十篇):草稿-验证协议在约束下多了一层语义——验证不只看目标模型对草稿 token 的接受度,还要看 FSM 对它们的接受度(validate_tokens 的 prefix 语义),两者取交集。草稿模型不知道约束,会持续给出”目标模型可能接受但 FSM 拒绝”的草稿,接受率因此下降——这是约束模式下投机收益打折的机制根源,也是为什么 max_rollback_tokens 要按投机深度初始化。两个功能的收益在有约束负载上部分相互抵消,容量规划时不能简单地相乘。
屏蔽 vs 重排序(re-rank)是另一条设计岔路:也有框架不在 logits 上屏蔽,而是对采样分布按合法集重新归一(re-normalize)。屏蔽在数学上等价于把非法 token 的概率质量归零后自然归一——两者对采样的效果一致;差在工程面:屏蔽让 -inf 之后的分布自带可行性质,top-k/top-p/temperature 全部自动只看可行集,不需要在每个后处理阶段重新判定合法性;re-rank 则要在每次采样时携带合法集。这就是为什么几乎所有推理框架都选屏蔽而不是重排——V0 的 logits processor 与 V1 的 bitmask 是屏蔽的两种实现位置,不是两种机制。
投机解码分叉:约束语义在三处与草稿机制交叉
投机解码(request 用草稿模型先猜 N 个 token,目标模型并行验证)与结构化输出的组合是这条链上最精细的部分,把三个交叉点单独拎出来:
交叉一:验证阶段的合法集判定。草稿给出 spec_token_ids = [t1, t2, t3],目标模型本步调度了这 3 个投机 token。grammar_bitmask 里对每个投机槽位 i:先填第 i 状态的 mask,再把 ti 假想接受进 FSM(推进),循环三次、回滚三次。这张 3 张 mask 的表随 SchedulerOutput 上 GPU,验证采样的目标模型自身也受 mask 约束(验证时目标模型对每个位置做 teacher-forced 前向,采样的是”接受/拒绝”判定所需的 token 分布)。
交叉二[t1, t2](t3 被拒),此时调度器 update_from_output 调 validate_tokens([t1,t2,t3]) 返回 [t1,t2] 并 rollback;FSM 的推进量以接受前缀为准(scheduler.py:841 直接把 validate 的返回写回 request.spec_token_ids),被拒绝的 token 从未”真正”进入 FSM 的时间线。max_rollback_tokens 的构造参数(backend_xgrammar.py:122)由此而来:回滚深度只需要覆盖”本步全部投机 token 数”这个上界。
交叉三(sum(1+spec_i), vocab)——每个请求占 1+自身投机数 行(第九篇的 bonus_logits_indices 处理的就是这套行号)。apply_grammar_bitmask 里 cumulative_offset 累加的就是其他请求的投机 token 行数,把紧凑打包的 mask 行精确铺到目标行的 logit_index + i 位置上。三个交叉点合起来看
从 V0 的 logits processor 到 V1 的调度步 bitmask
结构化输出在 V0(vllm/model_executor/guided_decoding/)与 V1 的实现路径差异,是理解 0.9.2 引擎设计的一个好样本。V0 把约束作为 logits processor:采样时逐请求现算掩码,XGrammarLogitsProcessor 持有 matcher,每个 batch 采样前在 CPU 上逐请求 fill、再由框架把掩码应用到 logits。这个模型直观、与 HF transformers 的自定义 logits processor 生态兼容,但有两个执行层的问题:一是掩码生成串在采样关键路径上——batch 越大、约束越复杂,采样前的 CPU 段越长,GPU 空等;二是batch 无感知——每个请求独立填掩码、独立应用,连”同 schema 的请求可以共享编译产物”都要靠 processor 外面的缓存字典手工对齐。
V1 的改造不是换掉 xgrammar,而是把三段成本重新分配(见”性能”一章):编译进后台线程池、掩码生成进调度步(与 GPU 执行重叠)、掩码应用进 GPU kernel(与 sampler 重叠)。grammar_bitmask 的返回值是 NumPy 数组这个”看似随意”的选择,正是为跨进程传输优化的注脚——ZMQ 消息里的 payload 是纯字节数组,GPU worker 收到后一次 torch.from_numpy 进内存、一次 .to(device) 上卡,全程没有 Protobuf/JSON 的对象化开销。V0 路径在 0.9.2 里仍在但已标记 legacy,官方博客的结构化输出文章里那张对比图(见”性能”一章)对应的就是这次切换。
有一个 V1 特有的工程细节,体现这套改造的彻底性:StructuredOutputManager 整个住在 EngineCore 进程里,而编译线程也在这个进程里。编译是 CPU 密集的,与调度循环共用人核——线程池上限取一半 CPU 就是给调度主循环留的份额。设计上更激进的做法是把编译挪到 P0(前端进程)甚至独立进程,但那要求把”编译产物”跨进程序列化传输,而 CompiledGrammar 是原生对象(带 C++ 扩展的 matcher 状态),不能过 ZMQ——所以编译必须住在产物被消费的进程里,这是”数据在哪,计算就在哪”约束下的次优选择,而不是没想过。相关讨论在上游 issue 里出现过多次,拆成”编译服务 + matcher 状态同步”的方案复杂度高,0.9.2 的选择是让编译在 P1 内部并发,靠磁盘缓存兜住冷启动。
V1 的结构化输出可以压成一条四段流水线:
- 入口验证(P0)
能否表达、支持的特性清单显式核对、choice/Lark 的入口改写,失败立刻 4xx 而不是进入引擎后再死。 - 异步编译(P1):线程池加 Future,状态机
WAITING_FOR_FSM隔离编译慢;编译结果磁盘 LRU,同 schema 第二次直达;编译线程只分 half CPU,把核留给调度。 - 批量掩码(每步):按批内序紧凑填表,投机解码用”前进再倒档”换算前瞻状态,reasoning 检测决定约束从哪一跳开始生效,默认全禁 mask 提供漏填时的纵深防御。
- 就地生效(GPU):两把尺子(批内序、logits 行号)的重排对齐,
apply_token_bitmask_inplace的 torch.compile 实现把 -inf 就地压进 logits,Sampler 全程无感知。
机制之外,这套设计最有味道的是成本搬家:编译的成本被搬到后台、掩码生成的成本被搬到调度步、掩码应用的成本被搬到 GPU 内核——每一段都问”这个开销放在哪才能不挡住关键路径”,而不是”这个开销能不能零”。这条思路与 V1 的其他改造(进程分离、连续批处理、piecewise CUDA Graph)一脉相承,也给了阅读其他推理框架(SGLang 的 constrained_json_gen、TensorRT-LLM 的 logits processor 约束)一个固定的分析框架:遇到受限解码,先问四个位置——约束在哪个进程验证、在哪编译、在哪生成掩码、在哪应用。
下一篇继续 V1 的采样侧:第九篇拆过的 Sampler 是”单跳视角”,还有一条它完全没覆盖的生产路径——stop string 的检测与截断、detokenizer 的增量解码流水线,以及它们与结构化输出的相互影响。
参考资料
- vLLM 源码 v0.9.2
/structured_output/init.py(StructuredOutputManager 与 bitmask 生成) - vLLM 源码 v0.9.2
/structured_output/backend_xgrammar.py(XgrammarBackend、GrammarMatcher 封装与入口验证) - vLLM 源码 v0.9.2
/structured_output/request.py(StructuredOutputRequest 与编译 Future) - vLLM 源码 v0.9.2
/core/sched/scheduler.py(WAITING_FOR_FSM 与 FSM 推进挂钩) - vLLM 源码 v0.9.2
/worker/gpu_model_runner.py(apply_grammar_bitmask 与 logits 掩码应用) - xgrammar 项目官方仓库(mlc-ai/xgrammar,自适应 token 掩码)
- vLLM 官方博客:结构化输出与 xgrammar 集成(本文配图来源)
- vLLM 官方文档:结构化输出
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


