


Marlin 完全拆解:4-bit 权重如何喂满 GPU Tensor Core
从 4-bit 模型到 4-bit 加速,中间差一个 Kernel
4-bit 权重量化经常被概括成一句话:权重体积缩小到 FP16 的四分之一,因此推理也能快接近四倍。前半句是存储格式的事实,后半句却只有在 Kernel 足够好时才成立。
以线性层 为例,激活 仍是 FP16,权重 以 INT4 形式从 HBM 读取。NVIDIA Ampere 并没有直接执行 FP16 激活乘 INT4 权重的 Tensor Core 指令,因此 Kernel 必须在片上完成三件额外工作:解包 4-bit nibble、还原符号并乘量化尺度,再把得到的 FP16 权重片段送进 mma.sync。如果把整张权重先反量化到显存,再调用普通 GEMM,读取量会重新变成 16 bit,压缩带来的带宽收益也随之消失;如果在融合 Kernel 中解包,却没有把访存、反量化和 MMA 重叠起来,Tensor Core 又会等待整数指令或内存。
Marlin 的价值正在这道缝里。Elias Frantar 等人于 2024 年公开预印本,并在 PPoPP 2025 发表 MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models。它不是一种新的权重量化误差优化算法,而是一族面向自动回归推理的混合精度线性层 Kernel:输入和输出保持 FP16,权重用分组 INT4 保存,运行时在寄存器中反量化,然后调用 FP16 Tensor Core。设计目标也不只是一条请求的 batch 1,而是让 batch 16 到 32 的服务负载仍接近理论带宽收益。
这一区分很重要:GPTQ回答“怎样选择 4-bit 码值,尽量不损伤模型”;AWQ回答“怎样依据激活保护显著权重”;Marlin 回答“这些码值落到 GPU 上,怎样真正比 FP16 GEMM 快”。量化算法决定近似误差,Kernel 决定延迟和吞吐,两者通过权重打包格式、分组大小和尺度布局衔接。
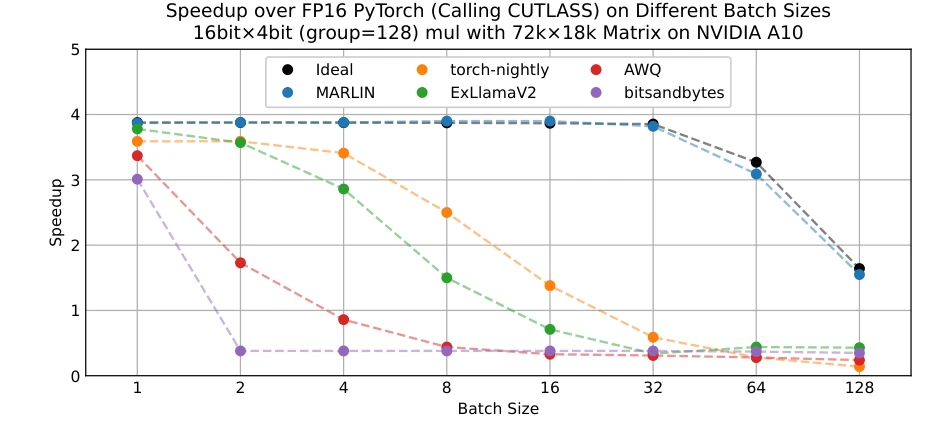
图源:Marlin 论文 Figure 1。实验使用 NVIDIA A10、 权重矩阵和 group size 128。虚线“ideal”并不是任意画出的四倍线:每 128 个 4-bit 权重还要保存一个 FP16 scale,平均每个权重实际占 bit,所以相对 16-bit 权重的带宽上限是 倍。Marlin 在 batch 16 到 32 之前仍贴近这条上限;当 batch 继续增加,矩阵乘的算术强度升高,瓶颈自然从 HBM 带宽转向 Tensor Core 算力,加速比才逐渐下降。
本文聚焦密集版 W4A16 Marlin。论文还给出叠加 NVIDIA 2:4 结构化稀疏的 Sparse-Marlin,但那需要 mma.sp、非零值布局和稀疏元数据三套额外约束,适合单独展开。这里要解决的是更基础也更普遍的问题:不依赖原生 INT4×FP16 Tensor Core,如何把低比特权重“喂”给 FP16 Tensor Core,而且不让任何中间步骤成为新瓶颈。
Marlin 要解决的精确问题
设一层线性变换为
是本次 Kernel 处理的 token 数;在解码阶段,它可以理解为连续批处理中同时前进一步的序列数。 是输入特征维度, 是输出特征维度。 和 使用 FP16, 使用对称 INT4 分组量化。对第 个量化组,概念上的反量化是
是 4-bit 码值, 是 FP16 scale, 是零点。原始 Marlin 主路径采用对称量化,可以把偏置约定吸收到编码和快速解包中;工程实现后来也扩展出不同的量化类型。公式写成一般的仿射形式,是为了明确:反量化不是一次免费的类型转换,而是码值提取、符号或零点处理、尺度乘法组成的片上工作。
一个可用的 Kernel 必须同时满足五个条件:
- 权重跨 HBM 时始终保持 4 bit,不能生成落在全局显存中的 FP16 权重副本。
- 反量化必须与 GEMM 融合,并尽量发生在寄存器中,否则共享内存容量和带宽会被膨胀后的权重占满。
- FP16 激活要被多个输出列复用。如果切块太窄,重复读取激活的流量会取代权重流量,Kernel 就不再由压缩权重加载主导。
- 打包布局既要支持 128-bit 合并加载,又要满足
ldmatrix和mma.sync对 warp 内寄存器 fragment 的固定映射。 - 很小时输出 tile 数量有限,仍要给所有 SM 分到足够均匀的工作,同时控制 Split-K 部分和的归约成本。
这些条件彼此牵制。增加一个线程块负责的 tile 宽度,可以提高激活复用并减少重复加载,却会减少网格里的线程块数,导致部分 SM 空闲;沿 维增加切分可以补回并行度,却会产生多个部分和与全局归约;更深的流水能隐藏 HBM 延迟,却需要更多共享内存,可能降低 occupancy。Marlin 并不存在一个孤立的“神奇位运算”,它的性能来自布局、流水与调度共同维持同一个不变量:在内存受限区间,关键路径应尽可能只剩下一次 INT4 权重流。
从硬件路径看,一块权重经历如下过程:
HBM 中已重排的 INT4 -> 128-bit cp.async共享内存中的打包权重 tile -> 每线程取到 32-bit 寄存器lop3 / 位掩码 + FP16 packed arithmetic -> 符合 MMA fragment 布局的 FP16x2 寄存器mma.sync.aligned.m16n8k16 -> 寄存器中的累加器 fragment共享内存或 L2 中完成必要归约 -> FP16 输出 C关键点是不存在“完整反量化矩阵”这个中间对象。反量化只在当前 MMA 所需的几个寄存器值上短暂发生,随后立刻被消费。
性能上限:先用 Roofline 算清楚什么值得优化
Marlin 的优化方向可以直接从字节数推出。忽略 scale、缓存行取整和重复加载时,计算 至少需要访问:FP16 激活 的 字节、INT4 权重 的 字节,以及 FP16 输出 的 字节。浮点工作量为 FLOP,于是算术强度为
当 都很大而 较小时,权重项 占主导,便有
同样条件下,FP16 GEMM 的权重流量约为 字节,所以 。量化没有减少乘加次数,却把每次从 HBM 取出的权重字节降为四分之一,因此同一个 batch 的算术强度提高约四倍。它不是永远更快:Roofline 模型给出的延迟下界是
其中 是必须传输的字节, 是 FLOP 数, 是可持续显存带宽, 是可持续 Tensor Core 吞吐。量化主要缩短第一项,对第二项几乎没有帮助,还额外加入了解包和缩放。只要第一项较大,少读权重就能换来加速;一旦第二项占主导,理论加速会收敛到 1,甚至可能因反量化开销而落后。
论文以 A10 约 200 FLOP/Byte 的 FP16 算力带宽比估算交叉点。令 ,得到 。这解释了为什么 W4A16 的甜点区并不局限于 batch 1:直到几十个 token 并行,理想实现仍可由权重带宽限制。与此同时,这也把优化目标说得很具体——Marlin 不需要让反量化“没有成本”,而要把它藏进原本等待 HBM 的时间窗口中。
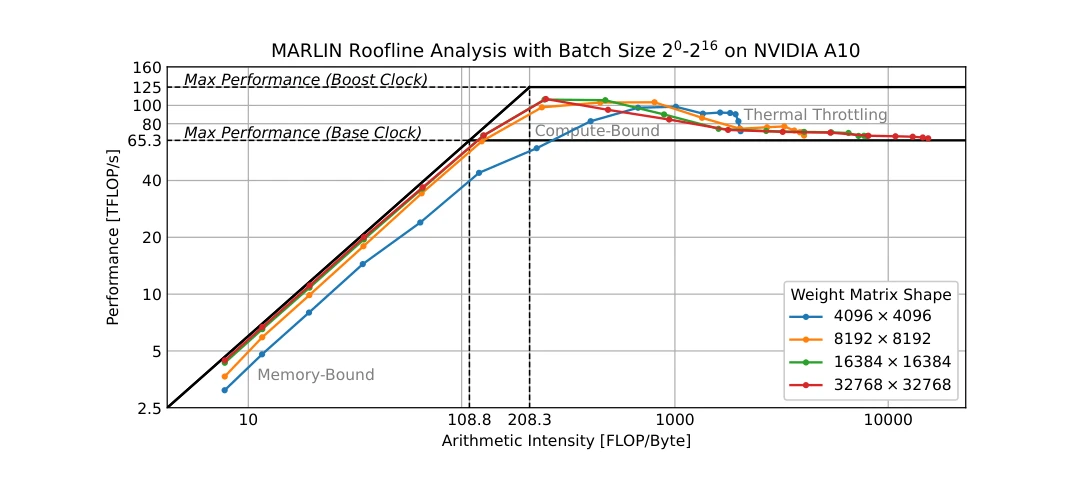
图源:Marlin 论文 Figure 11。横轴是实际算术强度,纵轴是实测 TFLOP/s;斜线对应带宽屋顶,水平线对应不同频率下的算力屋顶。不同矩阵尺寸的点随 batch 增大先沿斜线爬升,约在 batch 64 之后进入计算受限区。大矩阵、高 batch 的点还出现热降频,说明“峰值 FLOPS”本身也不是恒定不变的水平线。
这个模型还能解释三个常见误区。
- “权重小四倍,所以所有阶段快四倍”不成立。Prefill 的 往往是数百到数千,通常已经计算受限;W4A16 主要节省显存容量,对速度的收益有限。
- “INT4 Tensor Core 才能获得 INT4 加速”不成立。W4A16 的核心收益来自少读 HBM;计算仍可以使用 FP16 Tensor Core,只要反量化被融合和隐藏。
- “batch 越小越容易达到四倍”也不完整。当矩阵形状太小或网格并行度不足时,硬件可能连 HBM 都喂不满。此时需要工作划分来增加并行度,而不只是继续压缩数据。
量化数据如何进入 Tensor Core
INT4 只是存储类型,不是这条路径的计算类型
原始 Kernel 最核心的 MMA 指令是:
mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32m16n8k16 表示一个 warp 协作完成 与 的小矩阵乘,结果覆盖 ;两个输入 fragment 都是 FP16,累加器是 FP32。也就是说,Marlin 在数学上做的是
并不是让 Tensor Core 原生消费 INT4。INT4 的职责是缩小 HBM 到片上存储之间的运输体积。只要权重在到达寄存器前保持压缩、解包结果不回写显存,这个策略就能获得内存侧收益。
一个 32-bit 寄存器可以装 8 个 INT4 权重。朴素做法是逐个右移、与 0xF 做 AND、转成整数,再转成 FP16;这样会制造一长串串行依赖和类型转换。Marlin 使用一种“构造 FP16 位模式再减常数”的办法,并显式发出 lop3.b32。lop3 可以按一个 8-bit 真值表在三路 32-bit 输入上完成任意逐位逻辑,因此一次指令可融合掩码与 OR。
以低位上的两个 nibble 为例,Kernel 使用掩码 0x000f000f 提取它们,再 OR 入 0x64006400。0x6400 是一个指数已经就位的 FP16 基值,四个目标位被放进尾数低位;把这个 uint32 重新解释成 half2 并减去对应基值,就同时得到两个 FP16 数。对另一组位使用 0x00f000f0,再配合 packed FP16 FMA 校正位权。对称 INT4 的零点 8 直接融合进减法和加法常量,最终得到 。原始实现的核心可概括为:
int lo = lop3(q, 0x000f000f, 0x64006400);int hi = lop3(q, 0x00f000f0, 0x64006400);half2 w01 = reinterpret_as_half2(lo) - half2_base_with_zero_point;half2 w23 = fma(reinterpret_as_half2(hi), half2_bit_scale, half2_bias);这段伪代码刻意省略常量细节,保留了真实依赖关系:一条逻辑指令构造两个 FP16 位模式,随后用 half2 一次处理两个权重。它比逐元素 cast 快的原因不是 FP16 转换本身神秘消失,而是把四个标量转换改写成少数 packed 指令,并减少了依赖链。
scale 为什么有时在内环乘,有时在末尾乘
若一整列共享一个 scale,则有
可以先用整数码值对应的 FP16 数完成整个 维累加,在写出 之前只缩放一次。这把 scale 乘法从“每个权重一次”降为“每个输出一次”。
group size 128 时,同一输出列沿 维有多组 scale,不能把不同组的部分和统一乘一个尺度。此时必须对当前组的反量化权重先乘 ,再进入 MMA:
内层循环因此同时维护打包权重、对应 scale 和 FP32 累加器。为了让一条 half2 乘法处理两个权重,scale 本身也要离线重排,使同一类线程需要的尺度连续地到达寄存器。这说明量化格式不只是“每 128 个值附一个 scale”;在高性能 Kernel 中,scale 的物理次序也是 ABI 的一部分。
直接生成 MMA 所需的寄存器 fragment
mma.sync 不把操作数看成普通的二维数组。一个 权重块会按硬件规定的非直观方式分散到 warp 的 32 个线程,每个线程只持有 fragment 的若干元素。如果先按自然行列顺序解包,再在运行时用 shuffle 或额外访存整理 fragment,反量化省下的 HBM 时间很可能被重排吃掉。
Marlin 反过来做:模型加载或量化导出时就按照目标线程与目标 MMA 的消费顺序重排权重。论文描述每个线程读到的 16-byte 向量,恰好包含来自四个 Tensor Core block 的 8 个所需量化权重;一个 INT32 内还按特定交错顺序安排 nibble,以便前述两路并行解包。于是运行时的 dequant() 返回值已经是 FragB,可以直接作为 MMA 的 B 操作数。
这是一项典型的静态换动态:权重在模型生命周期中保持不变,离线重排只付一次代价,内层循环却会执行成千上万次。代价是格式不再通用——一个普通 GPTQ/AWQ checkpoint 的 packed tensor 不能不经转换直接传给 Marlin。vLLM 因此有 gptq_marlin_repack 和 awq_marlin_repack 路径,在权重加载阶段把来源格式转换成 Kernel 所需布局。
全局内存布局:为什么权重必须离线重排
布局设计要同时服务三层接口:HBM 的合并访问、共享内存的 bank 访问,以及 MMA 的线程内 fragment。只满足其中一层通常不够。
HBM:每线程 128 bit,每组线程覆盖完整 cache line
Ampere 上 Marlin 让每次 cp.async 搬 16 byte,也就是每线程 128 bit。一个 warp 的 32 个线程合计可以在一条加载路径中搬入 512 byte,相当于 1024 个 INT4 权重。论文进一步要求每 8 个线程覆盖一个对齐的 128-byte 连续区间,这样内存事务恰好匹配 cache line,不因离散地址产生额外 transaction。
自然行主序的 权重并不一定让“同一时刻参与同一组 MMA 的线程”读到连续地址。Marlin 在离线 pack() 中先把矩阵切成 小块,再以更大的调度单元重排,最后每 8 个 4-bit 值打进一个 uint32。论文从加载视角把它描述为重排 tile;参考实现中的 _perm 则把 warp、block、行列映射完全展开为一张固定置换表。
重排之后,热路径不再计算复杂二维索引,也不需要从一个 word 中挑出与当前线程无关的值。全局地址用于大粒度连续搬运,word 内 nibble 顺序用于寄存器解包,两层排列各自消除一种运行时开销。
L2:保住会复用的激活,尽快淘汰一次性权重
权重 在一次线性层调用中通常只流过一次,而激活 会被不同输出列 tile 重复使用。两者若采用相同缓存策略,大体积权重流会占据 L2,把仍要复用的激活逐出。Marlin 对权重的 cp.async 附加 evict_first cache hint,告诉硬件优先淘汰这些一次性 cache line;激活则留在 L2,由处理不同 tile 的线程块重复读取。
这个策略也解释了为什么 Kernel 选择较大的 覆盖范围和至少 64 的 tile:激活在一个线程块内、跨输出 tile 和跨缓存层都有复用机会。只盯着“INT4 权重读得少”会遗漏另一半条件——FP16 激活绝不能因为切分不当被反复从 HBM 取回。
共享内存:连续写入不等于无 bank conflict 读取
权重已经离线排好,可以从全局内存连续复制进共享内存,再按固定偏移取出。激活不能离线重排,因为每次请求都不同。更麻烦的是,ldmatrix.sync.aligned.m8n8.x4.shared.b16 会让整个 warp 按硬件规定的模式,从共享内存装载一个 FP16 fragment;若多个地址落到同一个 bank,同一条逻辑加载会被拆成多次访问。
Marlin 对激活的 16-byte 向量使用 XOR swizzle。若 表示行索引, 表示向量列索引,则逻辑位置 写到近似如下的位置:
是按位异或。这个变换保持每一行是列索引的置换,不丢数据;同时让 ldmatrix 并行触及的地址分散到不同 bank。由于 tile 尺寸固定,参考实现把所有变换后的读写偏移预先算进寄存器数组,并展开主循环,避免在热路径反复执行 XOR 与整数地址计算。
论文消融显示,取消 XOR、缩短流水深度和移除 L2 淘汰提示这些看似“小”的变化叠加后,会让加速比最多损失约 1 倍。高性能 GEMM 的差距往往不来自矩阵乘公式,而来自 cache line、bank、指令排序这些边界条件是否同时满足。
软件流水线:让加载、解包与矩阵乘重叠
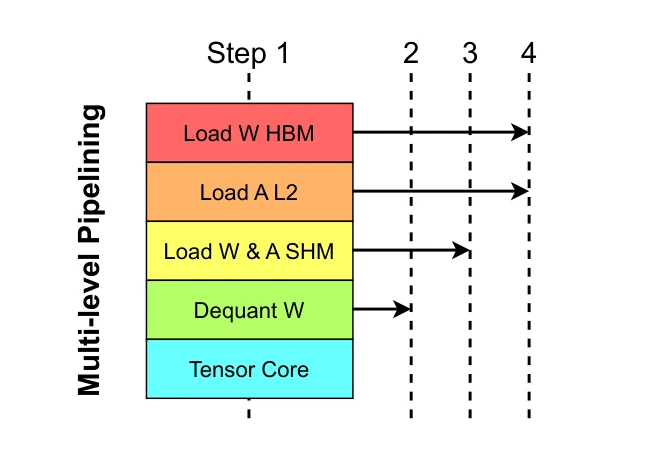
图源:Marlin 论文 Figure 3。图中的五行不是顺序执行的五个阶段,而是跨不同 tile 交错:当前 tile 在 Tensor Core 上计算时,下一个 tile 在寄存器中反量化,更远的 tile 从共享内存进入寄存器,再远的权重和激活已分别从 HBM、L2 发往共享内存。
第一层:四级 global-to-shared 环形流水
Ampere 的 cp.async 能把全局内存数据直接写入共享内存,不经过通用寄存器中转。Marlin 分配四份 stage buffer,流水深度 。在处理第 个 tile 时,Kernel 会预取约 步之后使用的激活、权重与必要的 scale,并用 cp.async.commit_group 和 cp.async.wait_group 控制依赖。
选择四级不是越深越好的经验拍脑袋。它有三重约束:
- 深度必须足以覆盖 HBM 延迟;论文实验中四级已经能隐藏加载。
- 每增加一级,都要再保存一份 、 与部分 scale tile;原始实现把动态共享内存设为 96 KiB,继续加深会挤压可用 tile 或 occupancy。
- 寄存器双缓冲的周期是 2, 恰好能在完整展开后让共享 stage 索引和寄存器 buffer 索引同时回到 0,编译器可以看到静态偏移。
启动阶段先发出三组异步加载,等待最早一组到达,再进入稳态循环;结束阶段停止发新请求并排空在途 stage。这与 CPU 流水线一样存在 prologue 和 epilogue,因此很小的矩阵更容易暴露启动开销。
第二层:shared-to-register 双缓冲
共享内存中的当前 tile 还不能直接参与 MMA。激活要经 ldmatrix 装成 FragA,权重 word 要装入寄存器并反量化成 FragB。Marlin 为这些 fragment 准备两套寄存器缓冲:计算 buffer 0 时预取 buffer 1,下一轮交换角色。
伪代码可以写成:
prefetch_global_to_shared(stage[0..2]);wait(stage[0]);load_shared_to_register(reg[0], stage[0]);
for (tile : k_tiles) { load_shared_to_register(reg[next], stage[current]); if (shared_stage_about_to_be_reused) { prefetch_global_to_shared(stage[future]); wait(stage[next]); } dequant_and_mma(reg[current]); swap(current, next);}真实实现比伪代码更刻意:两层循环都用 #pragma unroll 完全展开,共享内存偏移尽量成为编译期常量。作者在 README 中明确指出,源码里存在看似冗余或不够优雅的写法,因为它们生成的 PTX 更快。对这种指令级交叠 Kernel,源代码的抽象整洁度不等于生成指令的调度质量,最终必须以 SASS/PTX 和 Nsight Compute 时间线为准。
第三层:把反量化插进相邻 MMA 之间
内层按输出列方向发出多个 MMA。Marlin 在计算当前列时准备下一列的 FragB:读取一个量化 word、对低半和移位后的高半分别调用 dequant(),按需乘 group scale,再让所有 子块消费这份权重 fragment。这样同一个反量化结果被多个激活行 tile 复用,整数/FP16 packed 指令也有机会与 Tensor Core 指令并行发射。
循环顺序因此不是随便互换的。若最内层先遍历权重反量化,再长时间连续发 MMA,前半段会压满普通执行管线、后半段才压 Tensor Core;交错次序则让两类管线同时有独立工作。Marlin 所说的“保持 Kernel 由权重加载主导”,实际意味着 HBM、L2、共享内存、整数逻辑、FP16 packed 运算和 Tensor Core 六类资源都不能先于 HBM 堵住。
为什么 scale 宁可多读几次
group size 128、某些 tile 配置下,一个 scale 理论上可跨多个子 tile 复用。直觉会建议把它长期留在寄存器里,只在跨组时更新。论文和源码却记录了一个反常选择:每个子 tile 都从共享内存重新装 scale。原因是条件化、不规则的 scale 更新让编译器排出更差的指令顺序,在部分 shape 上造成 10% 到 20% 的整体下降;共享内存带宽尚有余量,规则地重复加载反而更快。
这不是“冗余访问有益”的一般规律,而是资源余量换调度确定性的局部决策。优化时必须看真正紧张的资源:当共享内存带宽不是瓶颈时,少几条加载不如稳定的双管线交叠重要。
并行划分:线程块如何覆盖 M、N、K
从层级 GEMM 到 Marlin 的特殊约束
普通高性能 GEMM 通常按三层切分:线程块拥有一个输出 tile,warp 拥有其中更小的输出 tile,mma.sync 再把 warp tile 分成硬件 fragment。沿 维依次累加,输出一直留在寄存器里。理想情况下,不同线程块写不同的 tile,无需彼此通信。
W4A16 的困难是 小。若每个 warp 只负责一个很窄的输出区域,独立输出 tile 数量可能不足,SM 吃不满;若盲目扩大 tile 来容纳更多 warp,一个线程块消耗的寄存器和共享内存增加,而且真实模型的 不一定能均匀除尽,最后一波只剩少数线程块运行,这就是 wave quantization。
Marlin 在原始实现中固定使用 256 threads,也就是 8 个 warp。Ampere 每个 SM 有 4 个 warp scheduler,8 个 warp 让每个 scheduler 至少有两条可切换的 warp,在一条 warp 等待依赖时仍有另一条可发射。与此同时,warp 的 方向宽度固定为 64,避免输出 fragment 太窄导致连续 MMA 反复依赖同一组累加器。
自动配置按 选择两种主要线程块形状:
| 条件 | 参数与设计倾向 |
|---|---|
thread_k=128,thread_n=128。增加可划分任务,优先让更多 SM 有活干 | |
thread_k=64,thread_n=256。增大输出宽度和计算复用,优先提高 Tensor Core 利用率 |
这里 thread_k 是线程块一次处理的归约深度,thread_n 是输出列宽。 以 16 为基本块,单次实例通常覆盖到 64 行;更大的 会拆成多个 64 行问题并行运行。两套配置都不是普适常数,而是原始 Ampere Kernel 在并行度、寄存器、共享内存与实际模型 shape 间选出的工作点。
让多个 warp 计算同一个输出 tile 的部分和
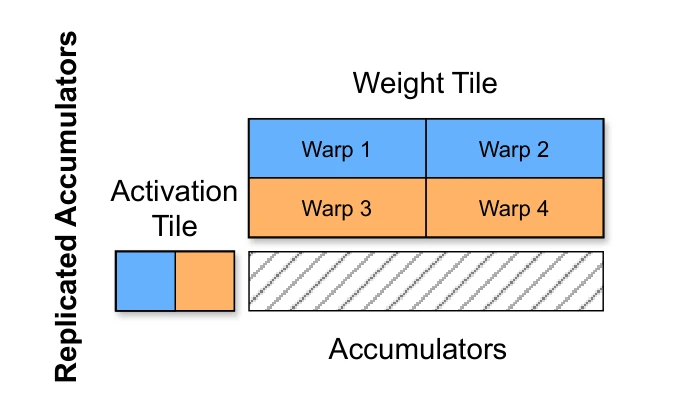
图源:Marlin 论文 Figure 4。图中 Warp 1 与 Warp 3 使用权重 tile 在 维的不同部分,却累加同一段输出列;Warp 2 与 Warp 4 同理。斜线区域表示不同 warp 的部分和最终要归约成一份输出。
传统做法会让更多 warp 沿 方向各算不同输出。Marlin 则把部分 warp 放到 方向,让它们计算相同 tile 的不同归约区间。这带来两点收益:一是无需无限增大输出 tile,就能维持 8 个活跃 warp;二是每个 warp 仍拥有 64 列的宽 tile,可以发出足够多彼此独立的 MMA,隐藏指令延迟。
代价是部分和。线程块内部先在共享内存中做对数级归约:成对 warp 写出和读取 fragment,归约轮数随参与 warp 数按 增长。FP32 累加器只在最终写出时转换为 FP16。这个开销之所以可接受,是因为 较小,输出元素量远少于 权重量;用少量输出归约换取整段权重流期间的高并行度,整体上划算。
可以把这个决策写成一个粗略比值。若沿 切成 份,需要额外处理约 个部分和,而主乘法仍有 个乘加。当 是数千、 只是少数几份时,额外工作与主工作量之比约为
算术量很小。真正需要控制的不是加法次数,而是跨线程块同步和全局内存往返,因此 Marlin 尽量在线程块内部完成归约,并让跨线程块归约的次数最少。
Split-K 与全局归约:小批量为什么仍能占满 GPU
为什么规则二维网格会浪费最后一波 SM
假设某层沿 方向只能切出 80 个输出 tile,而 GPU 有 72 个 SM。规则调度会产生两波:第一波 72 个线程块,第二波只有 8 个,第二波期间大部分 SM 空闲。沿 平均切成两份会变成 160 个线程块,波数更满,却让每个输出 tile 都产生两个部分和,必须全部做全局归约。
Marlin 使用接近 Stream-K 思路的 striped partitioning。先把权重视为按 行、 列排列的 tile 网格,计算每个 SM 应处理的 tile 数
然后从左上角按列分配连续的 个 tile。若一个 SM 在某列走到底仍没拿满 个任务,它继续领取下一列顶端的 tile。这样每个 SM 的工作量相差至多很小,只有跨越列边界的 stripe 才会使同一输出列被多个线程块部分覆盖,触发全局归约。
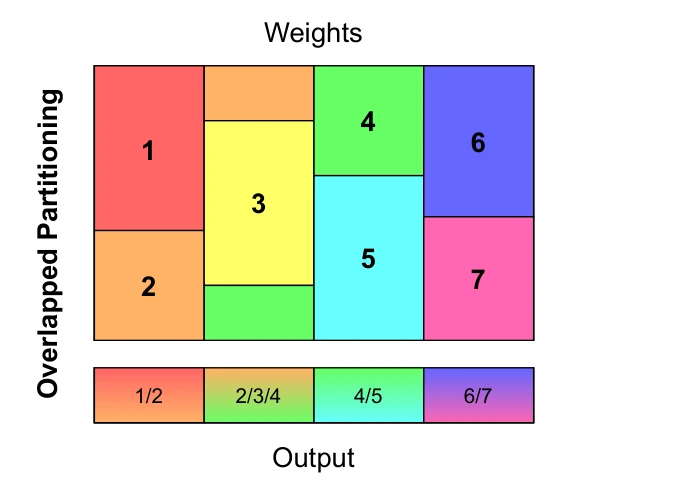
图源:Marlin 论文 Figure 5。彩色大块是 7 条 stripe;下方输出中的 1/2、2/3/4 表示这些输出列包含多个 stripe 的部分和。与对所有列统一 Split-K 相比,它只在边界处引入归约。
为什么归约串行,却不一定慢
同一输出列上的多个 stripe 按从底到顶的顺序串行合并。这个顺序利用了任务分配造成的完成时间差:底部 stripe 通常更早完成,顶部跨列的 stripe 更晚完成。线程块通过一个很小的 lock workspace 获取顺序,直接在输出 buffer 上以 FP16 暂存部分和,并用 FP32 做合并计算。
“串行”听起来危险,但需要比较数据规模。每条 stripe 的主体是读取大块 权重并完成 乘加,归约只触及 输出;而条带方案又把需要归约的列边界压到很少。输出 buffer 刚被前一个线程块写过,通常仍在 L2 中,所以全局地址并不等于每次都落到 HBM。原始实现还只用 lock 数组保存访问次序,不为所有部分和分配一张庞大临时矩阵。
这个设计也带来数值与可复现性权衡。线程块内使用 FP32 累加,但原始全局归约为了原位和 L2 命中,会把中间结果暂存为 FP16;浮点加法顺序也随 stripe 分解而变。因此它不承诺与单一 FP16 GEMM 逐 bit 相同。现代 vLLM 的 Marlin 路径已包含临时输出、FP32 reduction 与 atomic-add 等更多选择,说明生产实现会根据 shape、精度要求和硬件继续扩展归约策略。
大 时虚拟复制权重网格
当 ,Kernel 把输入按 64 行切成多个子问题并行处理。调度计算中可以把权重 tile 网格“虚拟复制”多份,让每个子问题参与条带分配;真正访问权重时再用模运算映射回同一张 。这样不复制物理权重,却增大了可调度任务集合,减少 Prefill 大输入下的跨块归约。
这也说明 Marlin 的并行策略不是简单的 batch 维、输出维或 Split-K 三选一,而是分层组合: 大时拆 64 行子问题, 方向提供独立输出列,线程块内让 warp 分摊 ,线程块间只在条带边界做有限的 切分。每一层都在用尽量局部的归约换更均匀的 SM 利用率。
可复现的调用链与实现伪代码
理解 Marlin 最容易混淆的是“量化”“重排”“执行”三个阶段。完整调用链如下:
FP16/BF16 权重 -> GPTQ、AWQ 或其他方法确定 4-bit 码值与 group scale -> checkpoint 保存为某种量化格式 -> 模型加载时检查 group size、zero point、K/N 对齐和 GPU 能力 -> repack 为 Marlin 的权重与 scale 排列 -> 为跨 CTA 归约分配并清零 workspace -> 每次前向把激活展平成 [M, K] -> 选择 tile 配置并启动 Marlin GEMM -> 输出恢复成 [..., N]原始作者仓库的 Layer.pack() 清楚展示了离线格式形成过程:权重除以 scale 后舍入,偏移 8 并截断到 ;随后按 tile 重排,应用固定 _perm,最后把 8 个 nibble 打进一个 uint32。scale 也使用独立的 scale_perm。前向阶段只分配输出并调用 marlin_cuda.mul(),不再重复这些置换。
Kernel 主体可压缩成下面的结构:
configure_tiles(M); // 小 M: K128 x N128;较大 M: K64 x N256assign_stripe(blockIdx, num_sms); // 跨 N 列连续分配 K tilesprecompute_smem_offsets(); // XOR swizzle 后的静态地址
issue_first_three_cp_async_stages();load_first_register_fragment();
for (each tile in my_stripe) { for (each K subtile, fully unrolled) { prefetch_next_fragments_from_smem(); refill_future_cp_async_stage_if_needed();
FragB w0 = dequant(packed_low); FragB w1 = dequant(packed_high); if (grouped) { w0 *= scale0; w1 *= scale1; } mma(a_frag, w0, accum0); mma(a_frag, w1, accum1); }}
reduce_partial_warps_in_smem();reduce_boundary_stripes_through_L2();write_fp16_output();复现实验时,至少要分开记录四类量:权重实际格式与 group size、矩阵 、GPU 型号和时钟状态、比较基线所调用的 Kernel。只写“INT4 比 FP16 快 3 倍”没有可迁移性。论文特别锁定 base clock 做持续性能实验,因为短测时 boost clock 与热降频会改变算力屋顶;A10 若开启 ECC,校验流量还会使可用带宽比规格低约 10% 到 15%。
原始仓库要求 CUDA 11.8 以上、compute capability 8.0 以上,并说明它主要为 Ampere/Ada 优化。今天使用 vLLM 时不应把旧仓库的支持矩阵当成现状:当前 vLLM 量化兼容表列出了 GPTQ/AWQ/FP8/FP4 等 Marlin 路径及各代硬件支持,加载器还会根据 checkpoint 格式和平台自动选择或回退后端。机制可以沿用,具体可用格式必须以所安装版本的文档和日志为准。
性能结果应该怎样读
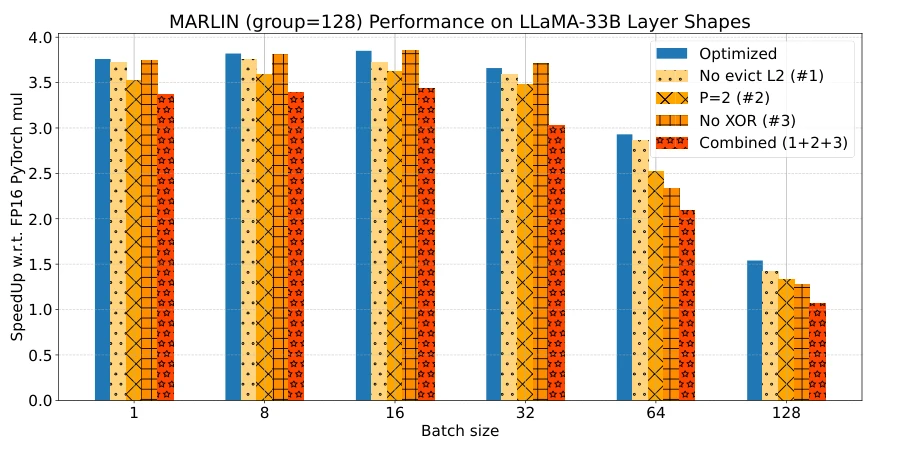
图源:Marlin 论文 Figure 12。蓝柱是完整实现;三种单独改动分别移除权重的 evict_first、把流水深度从 4 降到 2、取消激活共享内存 XOR 布局;橙色交叉柱叠加三种退化。小 batch 时权重带宽绝对主导,差距相对有限;进入中等和较大 batch 后,缓存污染、bank conflict 与不足的重叠更容易暴露,组合退化最多损失约 1 倍加速比。
论文的结果应分三层读。
第一层是理想大矩阵 Kernel 上限。在 A10 的 权重、group 128 实验中,Marlin 在 batch 1 到 16/32 基本维持 3.87 倍上限,batch 128 降到约 1.5 倍。这个实验主要证明流水线能把反量化和计算藏在带宽后面,不代表每个模型层都能得到相同数字。
第二层是真实层 shape。论文在 batch 16 汇总 Llama-7B/13B/33B/65B 与 Falcon-180B 的线性层,A10、RTX 3090、RTX A6000 上总体更接近四倍,A100 相对较低。原因不是 A100 更弱,而是它的绝对带宽和算力更高,固定的启动、重排与不完美切分开销占比更大;小矩阵也更难形成足够长的稳态流水。加速比必须和绝对性能一起看,不能把“更便宜的卡加速倍数更高”误解为它跑得更快。
第三层是端到端生成。论文用 vLLM、每序列 64 个输入 token 和 64 个输出 token 测试,表中有几个代表点:
| 模型与 GPU | batch | 加速比 |
|---|---|---|
| Llama-2-7B,1×A10 | 1 | 2.93× |
| Llama-2-7B,1×A10 | 16 | 2.74× |
| Llama-2-7B,1×A10 | 128 | 1.20× |
| Llama-2-13B,1×A6000 | 1 | 3.17× |
| Llama-2-13B,1×A6000 | 16 | 2.77× |
| Llama-2-13B,1×A6000 | 128 | 1.23× |
| Yi-34B,1×A100 | 1 | 2.90× |
| Yi-34B,1×A100 | 16 | 2.69× |
| Yi-34B,1×A100 | 128 | 1.18× |
端到端低于单层 3.87 倍很正常,因为注意力、归一化、采样、KV Cache 管理和调度没有被这一个线性层 Kernel 同比例加速。对一个应用 Amdahl 定律,若可被 Marlin 加速的线性层占原延迟比例为 ,单层加速为 ,端到端上限是
即使 ,只要其他路径占 20%,端到端上限也只有约 2.47 倍。论文报告的具体结果还混合了模型、batch、张量并行和硬件差异,不能脱离条件横向拼表。
多 GPU 场景尤其能体现这一点。增加张量并行度后,每张卡上的权重子矩阵变小,Marlin 稳态工作缩短;通信与框架固定开销占比上升。论文中 Llama-2-70B 在 A100 上从 2 卡增至 8 卡时,batch 16 的相对加速从 2.42 倍降到 1.44 倍。量化依然减少每卡容量,但“能放下”和“端到端更快”是两个不同指标。
最后,精度表也必须正确归因。Kernel 只是按给定的码值和 scale 执行近似矩阵乘,精度差主要来自 GPTQ/AWQ 等量化步骤和分组方案,而不是 cp.async 或 striped scheduling。论文 Llama-2-7B 的 GPTQ INT4 在三项任务均值上由 56.96 降到 53.63,说明这组具体 checkpoint 并非无损;这不能用 Kernel 加速曲线掩盖,也不能反过来归咎于调度策略。
与 GPTQ、AWQ、CUTLASS 和后续 Marlin 路线的关系
GPTQ/AWQ 解决误差,Marlin 解决执行
GPTQ 用近似二阶信息决定逐列量化与误差补偿;AWQ 根据激活统计寻找显著权重,并通过按通道缩放减轻这些权重的量化误差。两者都可以产生 4-bit 权重、group scale 与可选 zero point,但 checkpoint 的打包次序和量化语义并不必然相同。
Marlin 对量化算法本身没有强依赖,却对运行时格式有强依赖。要把一个 checkpoint 交给 Marlin,需要确认:码值是否为支持的对称或非对称类型、group size 是否有对应 Kernel、scale 与 zero point 的数据类型、权重能否重排到要求的 tile 对齐。当前 vLLM 会在加载阶段完成 GPTQ/AWQ 到 Marlin 布局的 repack;这一步不重新决定量化码值,只改变物理排列。
因此“GPTQ 模型”和“Marlin 模型”不是互斥的两个精度算法标签。前者可以描述码值如何得到,后者可以描述码值由哪个 Kernel 和哪种布局执行。部署排障时应把三层信息写全:量化方法、序列化格式、运行后端。
CUTLASS 是设计参照与 FP16 基线
Marlin 沿用了 CUTLASS 的层级 GEMM 思路:线程块、warp、Tensor Core fragment 三级切分,寄存器累加,shared-memory staging 和双缓冲。区别在于 CUTLASS 的常规同精度 GEMM 不必处理 INT4 解包、scale、格式重排和小 的条带归约。Marlin 可以理解为针对 W4A16 自动回归 shape 重新联合优化了一遍 CUTLASS 式层级结构。
论文性能图中的 FP16 PyTorch 基线调用 CUTLASS。这个口径很关键:Marlin 不是与一个朴素 CUDA 矩阵乘比较,而是与成熟的 FP16 Tensor Core GEMM 比较。3.87 倍代表在内存受限区间少搬权重带来的接近理论收益,不是因为 INT4 路径拥有四倍的 FP16 Tensor Core 峰值。
Sparse-Marlin 再叠加 2:4 结构化稀疏
Sparse-Marlin 在 INT4 基础上进一步对每 4 个权重保留 2 个非零值,并使用 Ampere Sparse Tensor Core 的 mma.sp。非零值本身仍以 4 bit 保存,因此权重值流量相对密集 FP16 可降到约八分之一;同时还要携带每组非零位置的 2-bit metadata。
硬件要求稀疏矩阵出现在 MMA 的指定操作数位置,所以实现把 改写为 ,并为非零值与 metadata 各设计一套离线布局。论文在密集 Marlin 之上测得最高约 65% 的额外 Kernel 加速,端到端也有收益。但稀疏化会再引入模型质量问题,并不是把任意 W4A16 checkpoint 加一个开关就能免费翻倍。
Marlin 已从一个 Kernel 变成一族实现
原始仓库的主路径很窄:FP16×INT4、对称量化、group size 128 或整列 scale,重点优化 Ampere/Ada。生产框架中的 Marlin 已继续演化。当前 vLLM 源码包含 GPTQ/AWQ repack、不同 scalar type、zero point、bias、FP32 reduction、FP8/FP4 权重路径和更多架构模板。这里的共同内核思想仍然是:权重以紧凑格式跨内存层次,在寄存器中转换成硬件可计算类型,以多级流水和 shape-aware 调度隐藏转换。
但“同名”不保证性能相同。某个新格式可能借用 Marlin 调度框架,却有不同反量化成本;某代 GPU 可能已经提供更合适的原生低精度 Tensor Core,CUTLASS、FlashInfer 或专用 Kernel 会胜出。框架的自动后端选择是起点,针对真实 做基准才是结论。
适用边界与工程陷阱
1. W4A16 最适合权重带宽受限的 decode
小到中等 是 Marlin 的主场:普通 decode、连续批处理中几十条序列并行、以及一次验证多个候选 token 的投机解码,都可能落在甜点区。长 prompt Prefill 的 很大,GEMM 已经计算受限,W4A16 仍能节省模型显存,却不应期待接近四倍速度。论文在 A100 上观察到 batch 1024 以内与未压缩计算受限 GEMM接近,继续增大输入时约慢 10%,正体现了反量化在计算受限区不再“免费”。
判断方法不是看请求数,而是看一次线性层实际展平后的 。调度器可能把多个请求的 Prefill chunk、decode token、投机分支合在同一批中;MoE 层还会把 token 按专家重新分组,使每个专家 GEMM 的 与全局 batch 不同。性能分析必须抓到 Kernel 的真实 shape。
2. shape 对齐和小矩阵会改变结论
原始 Layer 要求 能被 128 整除、 能被 256 整除,只支持 group size 128 或整列 scale。这些限制来自已编译 tile 组合,不是线性代数本身。现代框架会支持更多形状,或在加载时 padding 到可执行尺寸;padding 仍会产生真实计算和内存访问,极端不对齐时可能明显降低有效利用率。
张量并行也会改变 shape。列并行把 除以 TP 数,行并行把 除开;分片越多,单卡矩阵越小,条带调度越难形成长稳态,collective 占比也越大。部署前应按每个 rank 的局部矩阵做 sweep,而不是拿未分片模型的单卡微基准推断。
3. checkpoint 格式不是可互换的字节数组
同样标注 “INT4、group 128” 的 GPTQ、AWQ 与 Marlin tensor,nibble 顺序、scale 排列、zero point 语义都可能不同。错把一种 packed tensor 传给另一种 Kernel,轻则触发 shape 检查,重则产生数值看似正常却完全错误的输出。正确路径是让框架识别 quantization_config 并调用对应 repack,不要仅通过改配置名称强制加载。
模型启动时间和显存峰值也会受 repack 影响。若框架先保留来源格式,再生成 Marlin 副本,加载阶段可能短暂持有两份权重;若每次启动都动态转换,还会增加冷启动延迟。面向固定部署可以预先保存兼容格式,但要绑定清楚框架版本、量化元数据和目标硬件。
4. “Kernel 支持”不等于“模型所有层都走它”
词嵌入、归一化、注意力、采样显然不属于 Marlin GEMM;某些线性层还可能因尺寸、bias、并行切分、输出头精度策略而回退到其他实现。MoE 的 grouped GEMM 与稠密线性层也有不同调度问题。端到端优化要从 profiler 验证各层实际后端,不能只凭启动参数。
可以用四个层次逐步验证:
- 数值:对小矩阵比较反量化参考实现与 Kernel 输出,分别统计最大绝对误差和相对误差。
- 布局:验证 repack 后再 unpack 能恢复相同码值、scale 与 zero point。
- Kernel:对真实层 shape 扫 ,同时记录时间、有效 HBM 带宽、Tensor Core 利用率和 shared-memory bank conflict。
- 服务:在相同请求分布与 SLO 下比较 TTFT、TPOT、吞吐、显存占用和尾延迟。
若微基准快而服务不快,问题通常在 Amdahl 比例、层回退、通信或调度;若 batch 1 快而 batch 16 坍塌,则优先检查反量化/MMA 交叠、激活重复加载和 tile 划分;若理论带宽高但实测低,则检查对齐、cache hint、ECC、频率以及事务合并。
5. 数值等价、确定性和量化精度是三件事
量化精度描述 与 的差异;Kernel 数值误差还包含 FP16 scale、FP32 累加以及部分和降精度;确定性则取决于归约顺序是否固定。一个 Kernel 可以正确实现给定量化公式,却不与另一后端逐 bit 相同。验证阈值应依据误差模型制定,而不是把 bitwise equality 当作唯一标准。
此外,Marlin 只改变线性层权重路径,不量化 KV Cache。模型权重省出的显存可以间接容纳更多 KV block、提高并发,但那是容量再分配带来的系统收益,不是 Marlin 直接压缩了 KV。KV 内存的分页、复用与回收机制可结合 PagedAttention 完全拆解继续理解。
小结
Marlin 把“4-bit 权重少搬四倍数据”兑现成真实速度,靠的不是单点技巧,而是一组互相咬合的约束:离线重排让 128-bit 合并加载直接生成目标线程所需 nibble;lop3 与 half2 把 INT4 快速构造成 FP16 fragment;四级 cp.async、寄存器双缓冲和列向 MMA 顺序把 HBM、共享内存、反量化与 Tensor Core 交叠;warp 内 Split-K 和跨线程块条带划分则在小 下维持足够并行度,同时压低归约次数。
Roofline 给出了这套设计的边界。W4A16 对权重主导的大矩阵有约 的算术强度,因而在 A10 一类 GPU 上直到几十个 token 并行仍可能由显存带宽限制;超过交叉点后,计算成为屋顶,量化加速自然回落。由此也能得到部署上的核心判断:先确认真实线性层 shape 是否在带宽受限区,再讨论量化格式和 Kernel;先验证实际后端与硬件利用率,再用端到端服务指标下结论。
Marlin 最值得复用的思想并不限于 INT4。任何“压缩存储、片上展开、原生计算”的混合精度路径,都要回答相同问题:压缩节省的字节能否覆盖展开代价,展开后的数据是否直接进入硬件 fragment,流水是否能让转换与计算并行,任务划分是否能在真实 shape 上填满机器。把这四个问题答清楚,才算从模型文件里的低比特走到了 GPU 上的低延迟。
参考资料
- MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models(PPoPP 2025)
- MARLIN arXiv 预印本与论文页面
- IST-DASLab Marlin 官方源码仓库
- Marlin PPoPP 2025 Artifact
- vLLM 量化方法与硬件兼容表
- vLLM Marlin 量化工具源码
- NVIDIA PTX ISA:Warp-level Matrix Instructions
- NVIDIA CUTLASS:Efficient GEMM in CUDA
- Stream-K: Work-centric Parallel Decomposition for Dense Matrix-Matrix Multiplication
- How Marlin pushes the boundaries of mixed-precision LLM inference
- Marlin 代码解读
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


