


vLLM 源码完全拆解(十一):模型并行与 Worker 层——Tensor Parallel 如何切分权重并在多卡间同步
背景:为什么一个模型要塞进多张 GPU
前 10 篇把 vLLM 的一条请求从入队、调度、拼 batch、KV Cache 管理、PagedAttention kernel、MoE 执行、采样到最后回传的全链路都走通了。这一路我们其实悄悄做过一个假设:模型能够完全放进一张 GPU 的显存。这在跑 7B、13B 级别的小模型时成立,但一旦模型变大就不成立了。
以常见的 Llama-3-70B 为例,参数是 70B 个,每个参数用 bfloat16 存 2 字节,那么光是权重就需要:
即便是一张 80GB 的 H100、A100,也装不下;更不用说 671B 的 DeepSeek-V3 这类模型。于是产生了「模型并行」(Model Parallelism)这个大类技术:把一个大模型按某种维度切开,分摊到多张 GPU,每张卡只负责其中一块,多卡协作完成一次前向。
但”切开”有几个完全不同的方法,它们切的方向、通信的方式、对硬件的要求都截然不同。这一篇我们聚焦 vLLM 里最常用、也最容易理解的一种——张量并行(Tensor Parallelism,TP),并连带讲清楚承载它的Worker 层:Executor 怎么把一次前向”广播”给多张卡、每张卡上的 Worker 进程如何跑出各自的分片结果、最后又怎么把结果汇总回来。
顺着 vLLM 源码往下走,你会看到一条非常清晰的职责链:
- 配置层:
ModelParallelConfig记录 tp_size、pp_size、rank 等; - 通信层:
GroupCoordinator封装”哪些 rank 属于同一组、用什么后端通信”,提供all_reduce/all_gather等原语; - 模型层:
ColumnParallelLinear/RowParallelLinear/QkvParallelLinear这些线性层决定权重怎么切、前后怎么同步; - Worker 层:
MultiprocExecutor创建 N 个 Worker 进程,往每个进程发同一个execute_model广播,让它们各自跑前向。 - 执行层:
GPUModelRunner实际调用模型前向,中间穿插 TP 组的 all-reduce。
这一篇我们按”切分(模型层) → 同步(通信层 → 模型层) → 编排(Worker 层)“的顺序,自顶向下把这条链彻底走通。
张量并行:把一次矩阵乘法拆成多份
一个矩阵乘法如何被切开
张量并行的思想很简单,但要讲清楚它为什么省显存、为什么需要通信,得从一次最简单的线性层说起。
一个线性层(dense 层)做的计算是:
其中 是输入(形状 , 是 batch 里的 token 数, 是输入维度), 是权重(形状 , 是输出维度), 是偏置(形状 ), 是输出(形状 )。
现在有 张卡(vLLM 里叫 tensor_parallel_size)。张量并行要对上面这次 GEMM 做拆分,有两种基本切法,分别对应两种”并行线性层”,这正是 vLLM 源码里 ColumnParallelLinear 和 RowParallelLinear 两个类的来历。
Column(列)切法——按输出维度 切权重。把 沿最后一维(列方向)切成 块,每卡拿 。因为:
所以每张卡用相同的完整输入 和自己的那列权重 算出一块输出 。所有卡算完,各占 的 列。也就是说,权重被水平切开,输入是全量复制给每张卡,输出按列分摊。
Row(行)切法——按输入维度 切权重。把 沿第一维(行方向)切成 块,每卡拿 。把输入 也沿列(最后一维)切成 份 ,有:
每张卡用 和 算出一个部分和,最后要把 张卡的部分和加起来才是完整输出。这意味着 Row 切法天然需要一次求和通信(reduce)。
这两种切法,一个”输出分摊、无需直接求和(因为每块列结果独立)“,一个”需要累加部分和”。它们一个像”分头写文章的各章节”,一个像”各自算一遍再合并结果”。
为什么需要 all-reduce 而不是简单地各自算完
回到上面的分析:Column 切法看起来每张卡算完自己的列就完事了,不需要通信。但在 Transformer 里事情没这么简单——因为下一层往往需要完整的输出。
考虑一个具体的 Transformer 结构:self-attention 的 qkv_proj 之后,下一层是注意力计算,然后接 o_proj。如果你用 Column 切 qkv_proj,那么每个 head 的 Q/K/V 分片在各自的卡上齐了(因为注意力是按 head 分的,head 恰好就被 Column 切分到各卡),可以直接在本卡做注意力。但注意力算完的 attn_output 是一个完整向量,o_proj 的输入需要完整 hidden state。
于是 vLLM 的典型做法是”列行交替”:qkv_proj 用 Column(列)切,o_proj 用 Row(行)切。o_proj 的 Row 切需要把输入(即上一层的注意力输出)按列切给各卡、然后再 all-reduce。这样在 qkv/o 之间插一次 all-reduce,attn 的输出被拼回完整的 hidden state 喂给下一层。
同样,FFN 里 gate_up_proj 用 Column(列)切、down_proj 用 Row(行)切,down_proj 之后做一次 all-reduce。这就是经典的”MLP 中间 all-reduce + attention 输出 all-reduce”,也就是 Megatron-LM 那套”f-g 交替(f forward / g backward)“模式的推理侧版本。
所以结论是:张量并行的”切”本身不产生通信,但为了把结果拼回完整维度喂给下一层,每一对 Column–Row 之间必须有一次 all-reduce。通信的代价就藏在这一次次 all-reduce 里。
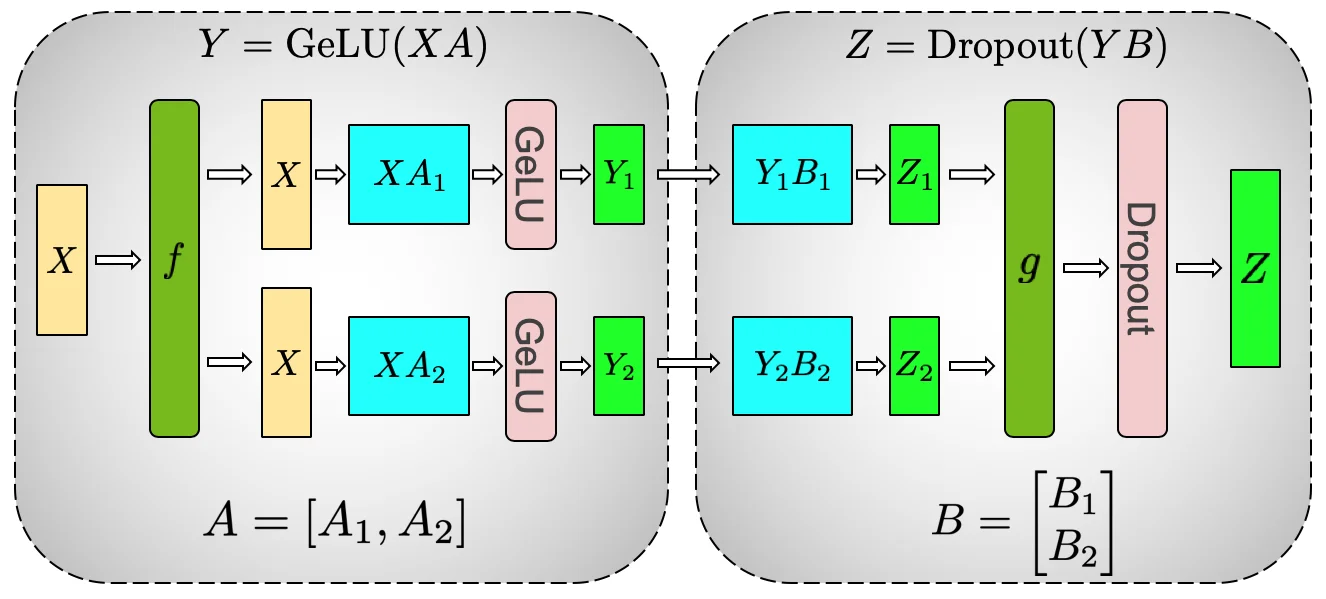
MLP 的张量并行切分方式(来源:Megatron-LM 论文 Fig.3)。左侧 Column 切 gate_up(f 阶段),右侧 Row 切 down(g 阶段),中间用 all-reduce(论文里标为 f / g 的通信)把部分和叠加成完整输出。vLLM 的 MergedColumnParallelLinear + RowParallelLinear 组合正是这套结构的推理侧实现。
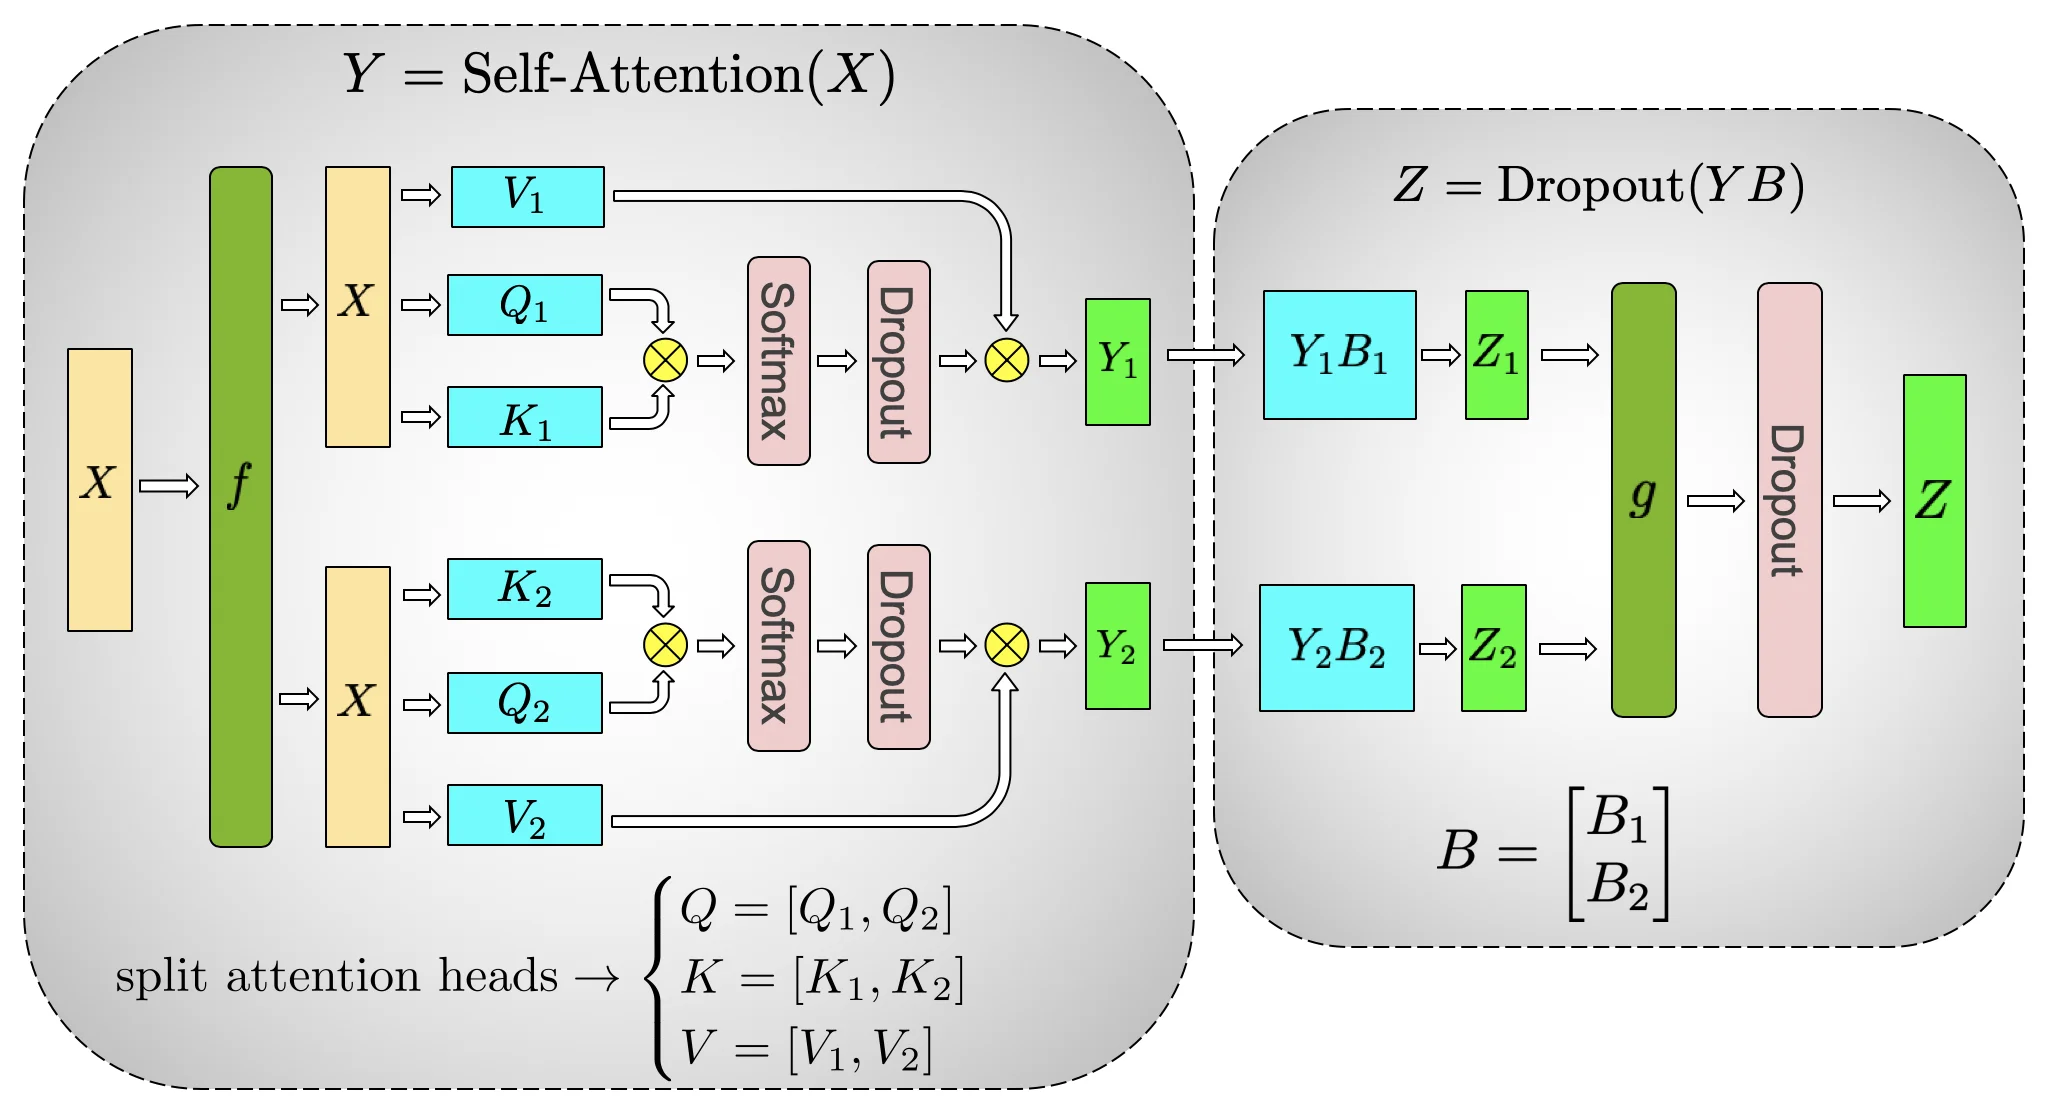
Self-Attention 的张量并行切分(来源:Megatron-LM 论文 Fig.5)。QKV 投影沿 head 维度切(Column),注意力输出投影(o_proj)做 all-reduce(Row)。vLLM 的 QkvParallelLinear(Column)+ o_proj(Row)严格对应此结构。
现在你理解了张量并行的宏观思路。接下来深入到 vLLM 源码,看这些线性层到底怎么在构造时算”每卡拿哪一块”,又怎么在 load_weights 阶段只把自己那块切片填进来。
模型层:线性层如何切分权重
GroupCoordinator:通信的本体
在讲线性层之前,必须先认识 vLLM 所有通信的载体——GroupCoordinator(vllm/distributed/parallel_state.py)。它是一个对 PyTorch ProcessGroup 的封装,统一管一组进程之间的通信。
它的构造函数接收 group_ranks: list[list[int]],也就是”把哪些全局 rank 划成一组”。它对每组新建两个通信组(第 223-234 行):
for ranks in group_ranks: device_group = torch.distributed.new_group( ranks, backend=torch_distributed_backend) # 设备通信组,GPU 上用 NCCL cpu_group = torch.distributed.new_group(ranks, backend="gloo") # CPU 通信组这里的关键设计:同一个进程组,同时维护两个后端通信。device_group 用 NCCL(GPU 之间高速通信,走 NVLink/IB),cpu_group 用 Gloo(CPU 之间同步、广播元数据)。为什么要有 CPU 组?因为有些信息(比如 broadcast 一个 dict、同步一个标志位)不需要 GPU 显存里的张量参与,用 CPU 组更轻量、也更不容易和计算流冲突。
GroupCoordinator 对外暴露的核心 API 就是那几个通信原语,比如 all_reduce(第 336 行):
def all_reduce(self, input_: torch.Tensor) -> torch.Tensor: if self.world_size == 1: return input_ # 单卡直接返回,省一次通信 if self.use_custom_op_call: return torch.ops.vllm.all_reduce(input_, group_name=self.unique_name) else: return self._all_reduce_out_place(input_)以及 all_gather、reduce_scatter、broadcast、send、recv 等。注意这里有个细节:vLLM 用 torch.ops.vllm.all_reduce 这个自定义 op,传入的是 group_name(字符串)而不是 group 对象。原因是这套代码要能被 torch.compile/Dynamo 用,而 Dynamo 不支持把任意对象(self)传给自定义 op,所以用一个字符串名字做间接寻址。
Tensor 并行组(TP group)怎么生成
光有 GroupCoordinator 还不够,还得知道哪些 rank 组成”张量并行组”。这是 initialize_model_parallel 干的事(parallel_state.py 第 977 行起)。它的核心是把 world 里所有 rank 排成一个 4 维矩阵,然后按不同维度切片得到不同的组:
# 布局顺序: ExternalDP x DP x PP x TPall_ranks = torch.arange(world_size).reshape( -1, data_parallel_size, pipeline_model_parallel_size, tensor_model_parallel_size)
# 张量并行组: 按最后一维(TP)切group_ranks = all_ranks.view(-1, tensor_model_parallel_size).unbind(0)_TP = init_model_parallel_group(group_ranks, ...)
# 流水线并行组: 转置后按 PP 维切group_ranks = all_ranks.transpose(2, 3).reshape( -1, pipeline_model_parallel_size).unbind(0)_PP = init_model_parallel_group(group_ranks, ...)文档里给了一个 8 卡、TP=2、PP=4 的例子(第 991-998 行):会生成 4 个 TP 组 [g0,g1], [g2,g3], [g4,g5], [g6,g7] 和 2 个 PP 组 [g0,g2,g4,g6], [g1,g3,g5,g7]。
一个很关键的约定是:TP 组的成员在 rank 上是连续的。[0,1]、[2,3]… 之所以这样分,是为了让同组落在同一台机器(同一个 NVLink 域)上,通信走得快。这是初始化时给用户的提示:相邻 rank 应尽量放在同一台 DGX 上。
initialize_model_parallel 结束后,全局就有几个单例组:_TP、_PP、_DP、_EP,分别通过 get_tp_group()、get_pp_group() 等拿到。模型的 o_proj、down_proj 里的 all-reduce,用的就是 get_tp_group() 这个组。
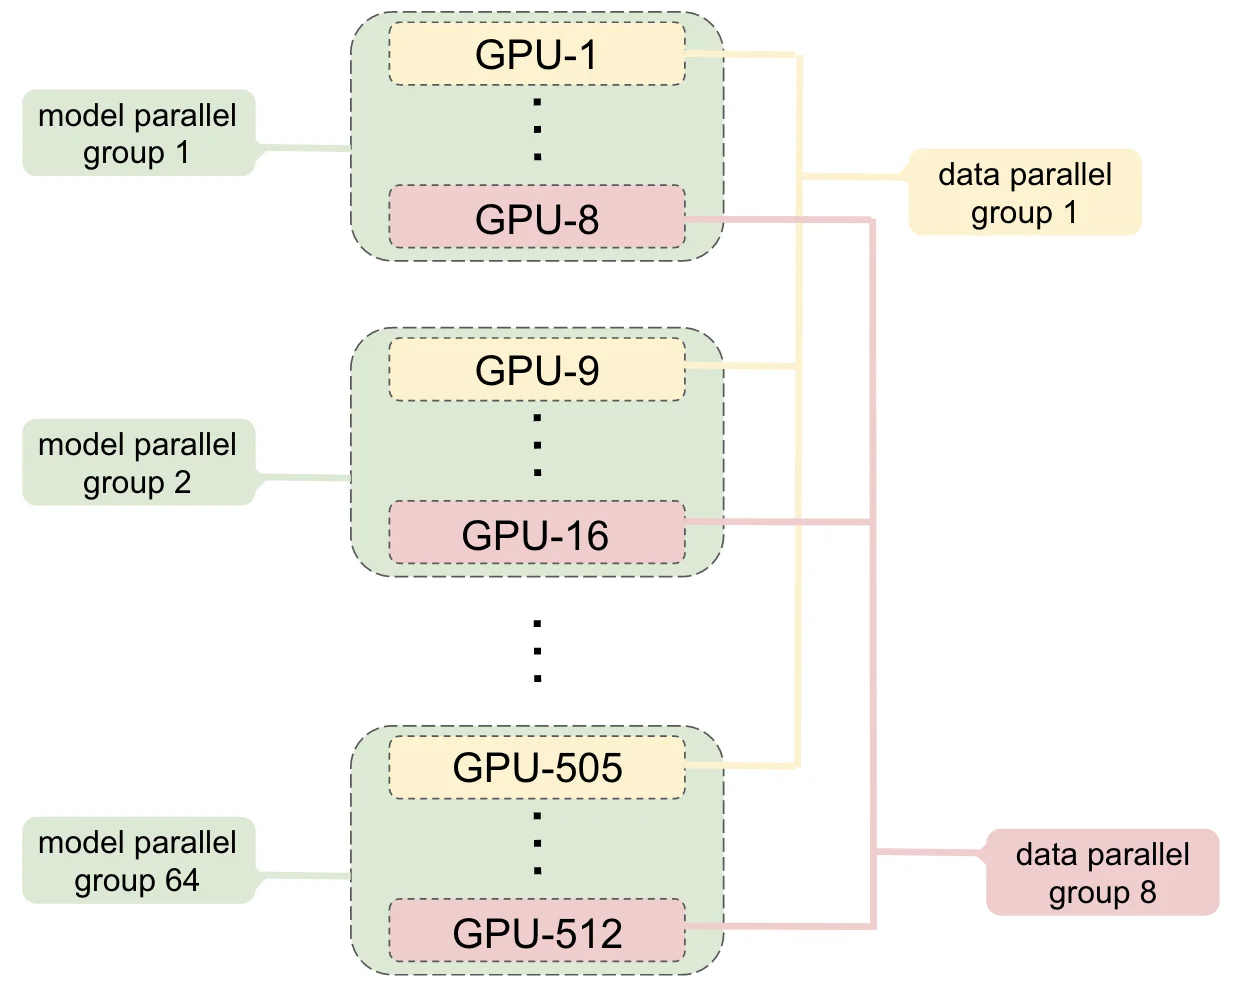
张量并行与数据并行混合的划分示意(来源:Megatron-LM 论文 Fig.8,示意了 TP 组沿模型层内部切、DP 组沿 batch 维切)。vLLM 的 initialize_model_parallel 用同样的方式,把 rank 排成矩阵后按不同维切片,分别得到 TP 组和 PP 组。
ColumnParallelLinear:沿输出维切权重
现在进入正题。ColumnParallelLinear(vllm/model_executor/layers/linear.py 第 370 行)是张量并行的第一个主角。它在构造时就算好”本卡拿多少列”:
# 沿最后一维(输出维)切分权重self.tp_size = get_tensor_model_parallel_world_size()self.input_size_per_partition = input_sizeself.output_size_per_partition = divide(output_size, self.tp_size)divide 就是 output_size // tp_size,并且断言能整除。也就是说,整张权重矩阵的宽度 被等分到 张卡,本卡只持有 这一块。这直接解释了显存怎么省:每张卡只存 1/t 的权重。
权重加载时(weight_loader,第 455 行),它要知道”从完整权重里切哪一段给我”。切的位置由 tp_rank(本卡在 TP 组里的序号)决定:
def weight_loader(self, param, loaded_weight): tp_rank = get_tensor_model_parallel_rank() output_dim = getattr(param, "output_dim", None) ... if output_dim is not None and not is_sharded_weight: shard_size = param_data.shape[output_dim] # 本卡拿多少 start_idx = tp_rank * shard_size # 从完整权重的哪一格开始 loaded_weight = loaded_weight.narrow(output_dim, start_idx, shard_size) ... param_data.copy_(loaded_weight) # 只把这一块填进本卡参数param.output_dim 是一个元数据,指示这个参数沿哪个维度切分(对权重矩阵是最后一维 -1)。narrow 就是 Python 端的张量切片。于是每次加载权重时,vLLM 从 huggingface 的完整 checkpoint 里 narrow 出 [start_idx : start_idx+shard_size] 这一段,填进本卡的参数。这就是”切分权重”最直接的一步代码。
ColumnParallelLinear.forward(第 503 行):
def forward(self, input_): output_parallel = self.quant_method.apply(self, input_, bias) if self.gather_output: output = tensor_model_parallel_all_gather(output_parallel) else: output = output_parallel return output这里有两个分支。gather_output=False(默认)时,本卡的输出就是自己的那 列,不立即通信;这个输出通常被交给下一个 Row 层直接消费。gather_output=True 时,才用 all-gather 把各卡的列拼成完整的 维。在标准 Transformer 里,qkv_proj 用 gather_output=False,因为注意力的 head 本来就是按卡切好的,不需要拼回全部 head。
注意 apply 是 self.quant_method 提供的——它统一了”是否量化、用哪个 kernel”这些细节。这让我们看到 vLLM 的一个干净设计:切分逻辑(线性层的 shape 计算、narrow、通信时机)和计算逻辑(quant_method)解耦。
MergedColumnParallelLinear / QkvParallelLinear:几个层拼成一个
Transformer 里有两类”一个模块拆成几个投影”的层,vLLM 用两个子类优化它们。
MergedColumnParallelLinear(第 530 行):适用于 FFN 的 gate_up_proj——把 gate 和 up 两个线性层沿输出维拼成一个长权重,构造时传 output_sizes=[intermediate, intermediate]。这样一次 GEMM 同时算 gate 和 up 的输出,省一次 kernel launch。
QkvParallelLinear(第 663 行左右):作用于 self-attention 的 q/k/v 投影。它和 MergedColumn 不同,因为它要处理一个非常特殊的切分问题——多头注意力(MHA)里的 head 在 TP 下怎么分。
看它的构造逻辑(关键在 num_heads 和 num_kv_heads 的计算):
tp_size = get_tensor_model_parallel_world_size()self.num_heads = divide(self.total_num_heads, tp_size) # Q 头按卡平分if tp_size >= self.total_num_kv_heads: self.num_kv_heads = 1 self.num_kv_head_replicas = divide(tp_size, self.total_num_kv_heads)else: self.num_kv_heads = divide(self.total_num_kv_heads, tp_size) self.num_kv_head_replicas = 1这里体现的是 GQA(Grouped Query Attention)在 TP 下的切分。标准 MHA 里 total_num_kv_heads == total_num_heads,Q/K/V 都按卡平分。但如果是 GQA(比如 KV 头只有 8 个),且 tp_size >= num_kv_heads,那么 K/V 头不够分,于是每个 KV 头要在多张卡上复制(num_kv_head_replicas > 1)。这带来两个后果:
- 显存不对称:Q 头被切开(每卡 1/t),但 KV 头被复制(每卡都存一份)。K/V 投影的显存没有被切省,这正对着 GQA 的”KV 缓存小”特性——KV 本来就不大,复制的代价可以接受。
- 前向需要把 Q 头拼回完整来对齐:由于 KV 头复制在每张卡上而 Q 头只占 1/t,注意力计算时本卡的 Q 只能看到本卡的 KV,但某些 query 要 attend 的 key 在别的卡上…… 这个我们在讲 Attention 的篇章里处理,这里只需记住:GQA + TP 的关键是 KV 头按 “复制还是切分” 二选一划分,这就是
num_kv_head_replicas的分支。
本站已有 GQA 完全拆解 专门讲 GQA 的动机,可以配合阅读。
RowParallelLinear:沿输入维切权重 + all-reduce
RowParallelLinear(第 626 行左右)是张量并行的第二个主角,负责”切输入 + 累加部分和”。
构造时沿第一维切(第 656 行附近):
self.tp_rank = get_tensor_model_parallel_rank()self.input_size_per_partition = divide(input_size, self.tp_size) # 输入维切self.output_size_per_partition = output_size # 输出不切forward(input_is_parallel 参数很关键):
def forward(self, input_): if self.input_is_parallel: input_parallel = input_ # 输入已经按卡切好,直接用 else: # 输入还是完整的,在 forward 里切 splitted_input = split_tensor_along_last_dim(input_, num_partitions=self.tp_size) input_parallel = splitted_input[self.tp_rank].contiguous()
output_parallel = self.quant_method.apply(self, input_parallel, bias=bias_) if self.reduce_results and self.tp_size > 1: output = tensor_model_parallel_all_reduce(output_parallel) # All-reduce! else: output = output_parallel return outputinput_is_parallel=True 表示”上一层的输出已经按列切好给我的卡了,不用再切”。在标准的 qkv→o 链路里,o_proj 的输入是 attention 的输出,它按 head 切在每张卡上,所以 input_is_parallel=True;而最外层的某些层(比如第一个线性层的输入是完整 embedding),需要 input_is_parallel=False 并在 forward 里先 split_tensor_along_last_dim。
最核心的一行是 tensor_model_parallel_all_reduce(output_parallel)。它调用:
def tensor_model_parallel_all_reduce(input_: torch.Tensor) -> torch.Tensor: """All-reduce the input tensor across model parallel group.""" return get_tp_group().all_reduce(input_)也就是在 TP 组内做一次 all-reduce,把所有卡算的部分和累加,得到完整输出。这一下就闭环了我们前面”为什么需要 all-reduce”的解释:Row 层的每张卡算的是部分和,必须 all-reduce 才能喂给下一层。
一个典型 block 的”列行交替”拼装
把以上拼起来,看 Llama 模型里一个 Transformer Block 的 MLP 部分(llama.py):
self.gate_up_proj = MergedColumnParallelLinear( # Column: 沿输出维切 hidden_size, 2 * intermediate_size, ...)self.down_proj = RowParallelLinear( # Row: 沿输入维切 + all-reduce intermediate_size, hidden_size, ...)自注意力部分:
self.qkv_proj = QkvParallelLinear( # Column: 沿 head 维切 hidden_size, head_size, num_heads, num_kv_heads, ...)self.o_proj = RowParallelLinear( # Row: all-reduce 拼回完整 hidden hidden_size, hidden_size, ...)这就是一个完整的张量并行单元:Column 进 → Row 出,Row 结束做 all-reduce。每层 block 都这样交替,模型的显存被均匀切到 张卡,代价是每层多一次 all-reduce。这也解释了为什么 TP 在单机、NVLink 高带宽环境下划算——通信快,摊薄了切分带来的好处;而跨机 TP 会因 IB 带宽受限。这也是为何大模型跨机部署更倾向用「流水线并行」或「专家并行」,我们在 Worker 层和 MoE 篇里分别涉及。
通信层:all-reduce / all-gather 与 custom all-reduce
通信的两种底层实现
上面讲到 get_tp_group().all_reduce() 是 GroupCoordinator.all_reduce。它内部走 torch.ops.vllm.all_reduce(...)。为什么不用 torch.distributed.all_reduce 直接做?vLLM 自己实现了一个 Custom AllReduce(vllm/distributed/device_communicators/custom_all_reduce.py),默认开启(set_custom_all_reduce(not parallel_config.disable_custom_all_reduce),见 gpu_worker.py)。
Custom AllReduce 的思路是:把 NCCL all-reduce 的下半场(broadcast-reduce)用共享内存 + 一个额外 buffer 优化掉。简单说,它在 TP 组内选一个”主卡”,其它卡先把各自的分片结果通过 PCIe/NVLink 写到一个预先分配的 buffer,主卡聚合后再广播回去。相比每个 step 都做完整 NCCL all-reduce,它省掉了握手同步的固定开销,在小规模(单机、TP 卡数不多)、小数据量下收益明显。这也是 vLLM 官方 benchmark 里 TP 场景能跑出低延迟的原因之一。
不过 Custom All-Reduce 有前提:它假设同组卡在同一台机器、共享内存(多节点下无法用共享内存做聚合)。所以跨机场景会回退到标准 NCCL。这也是 disable_custom_all_reduce 这个开关存在的原因——某些环境(比如和某些通信库冲突)需要关掉。
all-gather:把分片拼回完整
除了 all-reduce,张量并行还常用 all_gather——在 gather_output=True 的 Column 层或某些场景下,把各卡持有的分片按维度拼回完整张量。GroupCoordinator.all_gather:
def all_gather(self, input_: torch.Tensor, dim: int = -1) -> torch.Tensor: world_size = self.world_size if world_size == 1: return input_ return torch.ops.vllm.all_gather(input_, dim, world_size, group_name=self.unique_name)all-gather 的语义是:组内每张卡各持有 的一部分,交换后每张卡都拿到完整的 。它和 all-reduce 的区别是:all-reduce 是”各卡的部分和 → 每卡都拿到总和”,all-gather 是”各卡的分片 → 每卡都拿到完整拼接”,后者不做数值累加。
至此,“模型怎么切、通信怎么走”已经清楚。但还有一个问题没解决:这些 rank 进程是怎么被创建、怎么被指派角色、如何同时收到同一个执行指令的?这就进入第三部分——Worker 层。
Worker 层:Executor 如何把一次前向广播给多卡
一次前向的”总-分-总”三阶段
在 vLLM V1 里,Executor.execute_model 是入口。回顾 第一篇整体架构 讲过的分层:EngineCore 持有 Executor,Executor 持有若干 Worker,每个 Worker 进程持有一个 GPUModelRunner。一次 GPU 前向是三阶段:
- 总(广播):Executor 把
SchedulerOutput(本次要执行的 batch 的调度结果)通过广播消息队列发给所有 Worker。 - 分(并行执行):每个 Worker 的
GPUModelRunner在自己的 GPU 上执行模型前向,期间通过 TP 组 all-reduce 等在卡间同步。TP=1 时各卡独立;TP>1 时同 PP stage 内的卡协作。 - 总(回收):只有指定的”输出 rank”(通常是 TP 组 rank 0 和最后一个 PP stage 的 rank 0)把
ModelRunnerOutput通过响应消息队列发回 Executor,其余 Worker 返回 None。
这个”广播-并行-回收”结构是理解 Worker 层的钥匙。
MultiprocExecutor:单机多进程的执行器
vLLM V1 默认的多卡执行器是 MultiprocExecutor(vllm/v1/executor/multiproc_executor.py)。它用一个消息队列广播 SchedulerOutput,为每个 rank 创建一个 Worker 子进程,然后每个进程跑 worker_busy_loop 循环。注意 Executor.get_class(abstract.py)根据 distributed_executor_backend 选择实现:"mp" → MultiprocExecutor、"ray" → RayDistributedExecutor、"uni" → 单进程 UniProcExecutor。
_init_executor(第 43 行)的建进程部分:
for rank in range(self.world_size): unready_workers.append( WorkerProc.make_worker_process( vllm_config=self.vllm_config, local_rank=rank, rank=rank, distributed_init_method=distributed_init_method, input_shm_handle=scheduler_output_handle, ))self.workers = WorkerProc.wait_for_ready(unready_workers)world_size = tensor_parallel_size * pipeline_parallel_size。每个 rank 一个进程,local_rank=rank(单机场景 local_rank 等于全局 rank),这就把每张卡绑定到一个 Worker 进程。
collective_rpc(第 166 行)是广播的核心:
def collective_rpc(self, method, timeout=None, args=(), kwargs=None, non_block=False, unique_reply_rank=None): self.rpc_broadcast_mq.enqueue((send_method, args, kwargs, unique_reply_rank)) workers = (self.workers[unique_reply_rank],) if unique_reply_rank is not None \ else self.workers responses = [] for w in workers: result = get_response(w, dequeue_timeout) if not non_block \ else self.io_thread_pool.submit(get_response, w, dequeue_timeout, self.shutdown_event) responses.append(result) return responses要点:
- 广播:
rpc_broadcast_mq.enqueue(...)把一个(method, args, kwargs, unique_reply_rank)元组广播给所有 Worker(共享内存环形消息队列,见shm_broadcast.py)。 - 选择性回传:
unique_reply_rank指定”只要哪个 rank 回结果”。比如execute_model只想要最后一个 PP stage 的 TP rank 0 回ModelRunnerOutput,于是unique_reply_rank = self._get_output_rank():这个例子是文档注释里给的:TP=8、PP=4 → world_size=32,def _get_output_rank(self):return self.world_size - self.parallel_config.tensor_parallel_sizeworld_size - tp_size = 32 - 8 = 24,正好是 PP rank=3(最后一 stage)且 TP rank=0 的那张卡。
execute_model(第 154 行):
def execute_model(self, scheduler_output): (output, ) = self.collective_rpc( "execute_model", args=(scheduler_output, ), unique_reply_rank=self.output_rank, non_block=self.max_concurrent_batches > 1, timeout=envs.VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS) return outputnon_block 是流水线并行(PP>1)时需要的:PP 有多个 stage,可以异步把 batch 交出去,用 io_thread_pool(单线程)去异步取结果。这也对应 max_concurrent_batches = pipeline_parallel_size(第 273 行)——PP 下允许多个 batch 同时在流水线里。
WorkerProc 与 worker_busy_loop:Worker 进程的主循环
每个 Worker 进程的入口是 WorkerProc.worker_main → 构造 WorkerProc → 调用 worker.worker_busy_loop()。WorkerProc.__init__ 里做的是”初始化这个进程对应的 worker 并加载模型”:
wrapper = WorkerWrapperBase(vllm_config=vllm_config, rpc_rank=rank)wrapper.init_worker(all_kwargs) # 创建 Worker(按 rank 区分 driver/non-driver)...self.worker.init_device() # 初始化 CUDA 设备 + 分布式环境self.worker.load_model() # 构造 GPUModelRunner 并加载权重然后主循环 worker_busy_loop(第 507 行):
def worker_busy_loop(self): while True: method, args, kwargs, output_rank = self.rpc_broadcast_mq.dequeue() try: if isinstance(method, str): func = getattr(self.worker, method) # 按名字调用 worker 的方法 elif isinstance(method, bytes): func = partial(cloudpickle.loads(method), self.worker) # 任意 callable output = func(*args, **kwargs) except Exception as e: ... if output_rank is None or self.rank == output_rank: self.worker_response_mq.enqueue((ResponseStatus.FAILURE, str(e))) continue if output_rank is None or self.rank == output_rank: self.worker_response_mq.enqueue((ResponseStatus.SUCCESS, output))这就是”广播的执行体”:每个 Worker 从广播队列取到同一个 ("execute_model", (scheduler_output,), {}, rank24),调用 self.worker.execute_model(scheduler_output),只有 self.rank == output_rank(即 rank 24)的进程把结果写回响应队列,其余进程算完就丢弃。每个进程执行的是同一个方法、同一批调度数据,但各自只在自己的 GPU 上跑自己的模型分片——这就是张量并行”同时执行、各算各的、通信同步”的落点。
另外 WorkerProc 有一个 is_driver_worker 的概念(第 333 行):
is_driver_worker = (rank % vllm_config.parallel_config.tensor_parallel_size == 0)每个 TP 组的第一个 rank(rank % tp_size == 0)是 driver worker。driver worker 负责一些”只需一份”的工作(比如采样结果的收集)。这与我们前面”最终只回传输出 rank”的设计呼应——同 TP 组内,通常只让 driver 回传结果。
Worker / GPUWorker:单卡上干了什么
每个 Worker 进程里跑的是 GPUWorker(vllm/v1/worker/gpu_worker.py)。它的 init_device(第 120 行)在每张卡上做三件事:
- 绑定设备:
self.device = torch.device(f"cuda:{self.local_rank}"),torch.cuda.set_device(self.device)——把当前进程绑定到local_rank这张卡。 - 初始化分布式环境:
init_worker_distributed_environment(...),内部调用init_distributed_environment(world_size, rank, distributed_init_method, local_rank, backend),然后ensure_model_parallel_initialized(tp_size, pp_size)确保 TP/PP 组建好。 - 构造 GPUModelRunner:
self.model_runner = GPUModelRunner(self.vllm_config, self.device)。
execute_model(第 298 行)展示了 PP 下 stage 之间的 send/recv:
def execute_model(self, scheduler_output): intermediate_tensors = None if not get_pp_group().is_first_rank: # 非第一个 PP stage intermediate_tensors = IntermediateTensors( get_pp_group().recv_tensor_dict(all_gather_group=get_tp_group())) output = self.model_runner.execute_model(scheduler_output, intermediate_tensors) if parallel_config.distributed_executor_backend != "external_launcher" \ and not get_pp_group().is_last_rank: # 非最后一个 PP stage get_pp_group().send_tensor_dict(output.tensors, all_gather_group=get_tp_group()) return None return output if self.is_driver_worker else None这里体现了两件事:
- PP 的 stage 间传递:
get_pp_group().recv_tensor_dict(...)从上一个 PP stage 接收中间张量,算完后send_tensor_dict(...)发给下一个 stage,最后一个 stage 才产生ModelRunnerOutput。这和 TP 的 all-reduce 不同,属于流水线并行(PP)特有的点对点传输。本文主角是 TP,PP 在这里只需理解”每个 PP stage 是一整层模型的子序列,stage 之间用 send/recv 串成流水线”。 - TP 内 only driver 回传:
return output if self.is_driver_worker else None——同 TP 组里只有 driver worker 返回结果,其它返回 None。这样 Executor 拿到的输出是唯一的。
注意 recv/send_tensor_dict 传了 all_gather_group=get_tp_group(),表示在 PP 的 send/recv 前可能需要先在 TP 组内 all-gather,因为 stage 的输入可能是 TP 分片。这些细节在 vLLM 的 PP 实现里有一套完整的 schedule 机制,属于更深的范畴,本篇点到为止。
为什么 Worker 层和模型层是解耦的
看到这里你会发现 vLLM 的结构非常”正交”:
- 模型层(linear.py)负责”怎么切、怎么同步”,它只关心 TP 组的通信原语,不关心进程怎么起。
- Worker 层(worker/)负责”每张卡一个进程、进程里跑什么”,它只关心分发执行,不关心模型内部怎么切。
两者的接口是 GPUModelRunner.execute_model。Executor 说”这个 batch 你跑一下”,Worker 说”我把权重切好、把 TP 组建好、在自己的卡上跑,然后 all-reduce”。这种解耦让 vLLM 能轻松切换执行后端(mp / ray / uni)、切换设备(GPU/TPU/XPU,各有自己的 model_runner),而模型层的切分逻辑完全复用。
显存账:TP 到底省了什么、花了什么
把以上机制落到数字,能更直观地看到 TP 的收益与代价。
省下的显存:所有权重沿切分维度等分。Llama-70B 用 TP=8,每张卡只拿 140/8 = 17.5 GiB 权重。但注意:偏置(bias)通常不切(RowParallelLinear 的 bias 是完整副本,只在 TP rank 0 加,第 668 行 bias_ = None if (self.tp_rank > 0 ...) else self.bias),KV 头在 GQA 场景可能复制而非切。这些”没被切的部分”会让每卡实际占用略高于 总显存/t。
花的通信:每层 1-2 次 all-reduce(attention 的 o_proj 一次、MLP 的 down_proj 一次;若某层有 gather 则多一次 all-gather)。一次 all-reduce 的通信量约等于 hidden size × batch。在 NVLink 域内(单机 8 卡、~900GB/s)这部分可被并行计算隐藏;跨机则成为瓶颈。
什么时候该用 TP:单机卡够、模型能摊开、需要低延迟(TP 不增加 batch 粒度,比 PP 更”细粒度”地拆分单卡执行)。什么时候不该:跨机(IB 带宽不够 hidden×batch 的 all-reduce)、模型极大靠 TP 摊不够(要叠 PP/EP)。
小结
这一篇把 vLLM 的两条线打通了:
- 模型怎么切(模型层):张量并行按”列–行”二元切法。Column 切(
ColumnParallelLinear/QkvParallelLinear)沿输出维等分,Row 切(RowParallelLinear)沿输入维等分并在结尾 all-reduce。权重在load_weights时用narrow只取本卡那一块;GroupCoordinator封装了 TP 组和 all_reduce/all_gather 原语。 - 怎么同时执行(Worker 层):
MultiprocExecutor广播SchedulerOutput给所有 Worker 进程,每个WorkerProc在worker_busy_loop里调用worker.execute_model,自己的 GPU 上跑自己的分片,GPUWorker.execute_model内部完成 TP all-reduce(以及可选的 PP send/recv),最后只有 driver + 末 PP stage 的 rank 回收ModelRunnerOutput。
理解张量并行后,vLLM 的”单卡前向”就升级成了”多卡协作前向”。下一篇我们顺着这条协作线继续深入:GPUModelRunner 在 TP/PP 组里如何做模型初始化时的通信 buffer 准备(prepare_communication_buffer_for_model)、如何把一次 step 的输入在 TP 组内做 all-gather(序列并行)、以及 PP 的 schedule 与 send/recv 流水线如何真正衔接多个 stage,把”多卡协作”的执行细节彻底收尾。
参考资料
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- vLLM v1 Executor 抽象(abstract.py)
- vLLM Multiprocess Executor 源码(multiproc_executor.py)
- vLLM GPU Worker 源码(gpu_worker.py)
- vLLM Parallel State 与 GroupCoordinator 源码(parallel_state.py)
- vLLM 并行线性层源码(linear.py)
- vLLM 官方文档:分布式推理设计
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
音乐
暂未播放


