


GPU 推理性能分析完全指南:用 torch.profiler、Nsight Systems 与 Nsight Compute 逐层定位瓶颈
为什么需要三把尺子
一段 PyTorch 推理代码“很慢”,可能是完全不同的三类问题:Python 在逐个发射大量小算子,GPU 一直吃不饱;某个 CUDA Kernel 已经占满时间,但它受显存带宽限制;或者主机在 .item()、数据拷贝、锁和线程调度上等待,GPU 反而时忙时闲。只看一次端到端计时,这三种情况得到的只有同一个结论——慢,却没有下一步行动。
性能分析工具因此不是越底层越好,而是要按问题的空间尺度分层:
| 工具 | 观察尺度 | 最擅长回答的问题 | 不擅长回答的问题 |
|---|---|---|---|
torch.profiler | PyTorch 算子、Python 调用栈、CUDA Kernel 关联 | 哪个 aten 算子最贵?来自哪段模型代码?输入形状和显存分配是什么? | 一个 Kernel 为什么只达到 30% 带宽?CPU 线程为何被系统调度出去? |
Nsight Systems(nsys) | 进程、线程、CUDA API、Stream、Kernel、内存拷贝的全局时间线 | GPU 空洞从哪里来?是否频繁同步?H2D 能否与计算重叠?多 Stream/多进程是否并发? | 单个 Kernel 内部是哪条流水线、哪级缓存或哪类 stall 限制性能? |
Nsight Compute(ncu) | 单个 CUDA Kernel 的硬件计数器、SASS/源码关联 | Kernel 是计算受限还是带宽受限?占用率、缓存命中、访存合并和 warp stall 如何? | 整个请求为何有排队、CPU 间隙或跨 Kernel 的调度问题? |
三者正确的使用顺序是从宽到窄:先用 torch.profiler 把模型语义映射到算子与 Kernel,再用 Nsight Systems 判断全局时间究竟消失在 CPU、拷贝、同步还是 GPU,最后只把少数主导 Kernel 交给 Nsight Compute。直接对完整推理程序执行 ncu --set full,常常会因为采集硬件计数器而重放成百上千个 Kernel,等待很久后得到一堆无从下手的报告。
这套工具链有清晰的历史脉络。PyTorch 团队与微软、Facebook 在 PyTorch 1.8.1 发布时,于 2021 年 3 月正式介绍新版 PyTorch Profiler;其目标是在框架算子语义与 GPU 活动之间建立关联。NVIDIA 于 2018 年推出 Nsight Systems,统一展示 CPU 与 GPU 的系统级行为;Nsight Compute 1.0 同年随 CUDA 10.0 发布,接替 nvprof/Visual Profiler 中面向 Kernel 的深度指标分析。它们不是互相替代,而是把同一条性能因果链从上到下接起来。
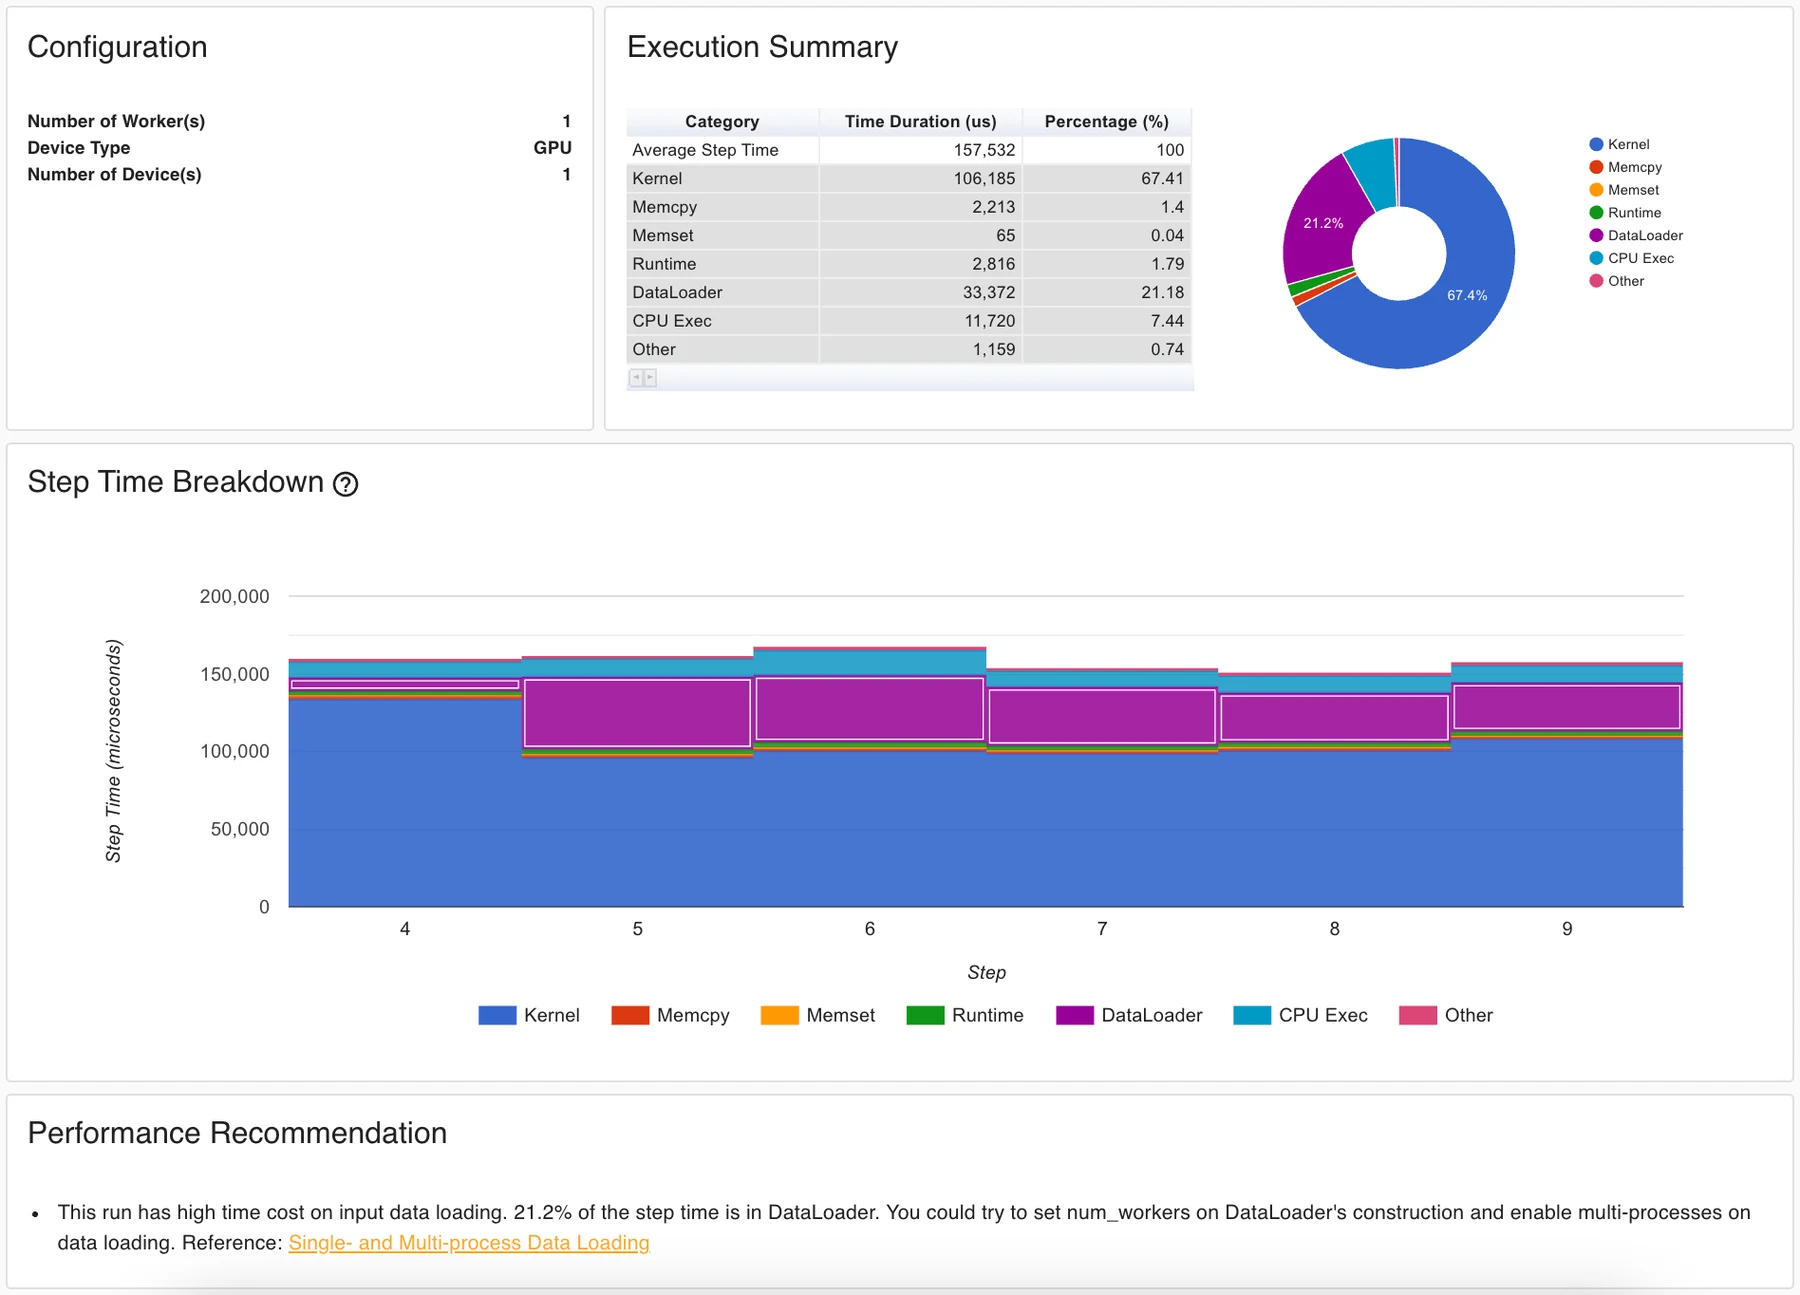
图源:PyTorch 官方 Profiler 介绍。图中的算子统计负责找“谁最贵”,时间线负责看“它何时发生、发射了哪些 Kernel”;这正是进入系统级分析前需要保留的框架语义。
先区分 profiling 与 benchmarking
Benchmarking 要回答“优化前后快了多少”,要求低扰动、足够预热、重复采样和统计分布;profiling 要回答“时间为什么花在这里”,必须采集额外事件或硬件计数器,因而会改变程序本身。Profiler 结果中的绝对总时长通常不能直接当成线上延迟,更不能把 ncu 重放期间的墙钟时间当成 Kernel 的真实耗时。
一条可靠的工作纪律是:
- 先在无 profiler 的条件下建立端到端基线,记录软件版本、输入形状、批大小、数据类型、GPU 型号、功耗/时钟状态和分位数。
- 开启 profiler 找因果关系,只比较同一种采集配置下的相对构成。
- 修改代码后关闭 profiler,用与第一步相同的基准重新验证。
对于大模型推理,还要把 Prefill 与 Decode 分开。Prefill 通常包含大矩阵乘,算术强度较高;单 token Decode 的矩阵形状更“瘦”,并且每步都要读取权重与 KV Cache,更容易表现为带宽受限或 launch bound。把二者平均到一个数字里,会把真正的限制因素冲淡。若需要先统一 TTFT、TPOT、吞吐和并发的口径,可参考 LLM 推理 Benchmark 完全指南。
开始之前:先建立正确的时间观
CUDA 默认是异步的
Python 执行 y = torch.mm(a, b) 时,CPU 通常只是向某条 CUDA Stream 提交工作,然后继续向下执行;Kernel 稍后才在 GPU 上完成。于是下面的写法只量到了主机提交开销,而没有量完整的 GPU 工作:
import time
t0 = time.perf_counter()y = torch.mm(a, b)elapsed = time.perf_counter() - t0 # 错误:此时 y 可能尚未算完若测端到端墙钟延迟,要在计时边界同步:
torch.cuda.synchronize()t0 = time.perf_counter()y = torch.mm(a, b)torch.cuda.synchronize()elapsed = time.perf_counter() - t0若只测同一 GPU Stream 上一段设备执行时间,CUDA Event 更合适:
start = torch.cuda.Event(enable_timing=True)end = torch.cuda.Event(enable_timing=True)
start.record()y = torch.mm(a, b)end.record()end.synchronize()elapsed_ms = start.elapsed_time(end)Event 被依次放进 Stream,elapsed_time 读取两者在 GPU 时间轴上的间隔。它避开了 Python 计时器精度和大部分主机调度噪声,但它回答的是设备区间时间,不包括请求排队、数据准备等端到端成本。反过来,墙钟时间包含这些成本,却必须正确同步才能封住异步执行边界。
五种时间不能混为一谈
- CPU total:某个 PyTorch 算子在 CPU 侧事件的总时间,包含它调用的子算子。
- Self CPU:扣除子事件后,该事件自己消耗的 CPU 时间。它有助于发现 Python/dispatcher/同步开销,但不等于 GPU Kernel 时间。
- CUDA 或 Device total:与算子相关联的设备活动总时间。一个算子可能发射多个 Kernel,多个算子也可能因异步和并发而在时间线上重叠。
- Kernel duration:某个 Kernel 从 GPU 开始到结束的持续时间。不同 Stream 的 Kernel 可以重叠,因此不能无条件把所有 Kernel duration 相加后称作请求延迟。
- Wall-clock latency:从请求进入到结果可用的真实时间,包含 CPU、GPU、拷贝、排队和同步。
若同一窗口内两个 Stream 分别执行时长为 和 的工作,它们有 的重叠,设备区间的并集时间是:
这解释了为什么表格中按 Kernel 聚合的 CUDA 总时间可能大于墙钟时间。聚合表负责回答“总工作量由谁贡献”,时间线负责回答“这些工作是否串行、并行或被空洞隔开”,两者不能互相替代。
预热不是可选项
第一次执行常常混入 CUDA Context 初始化、动态库加载、cuBLAS/cuDNN 算法选择、内存池扩容、JIT 编译、torch.compile 图编译与 GPU 升频。把第一次迭代纳入结论,相当于把部署冷启动与稳态推理混在一起。一个稳妥的最小协议是:
- 固定输入形状、dtype、batch 与随机种子;
- 先运行若干次不记录的 warmup,直到形状特化与编译完成;
- 再记录短而有代表性的窗口;
- 重复基准并报告中位数及 P90/P99,而不是只挑最快一次;
- 分析前确认没有别的进程占用 GPU,且没有热降频或功耗限制。
CUDA_LAUNCH_BLOCKING=1 会把 CUDA 调用强制同步,适合定位报错对应的 Python 行,却会摧毁原有并发与流水,不能用于正常性能结论。类似地,随意在循环中插入 torch.cuda.synchronize() 会把潜在重叠全部串行化;同步应只放在基准边界,或作为“验证是否存在异步归因问题”的诊断实验。
可运行实验:故意制造三类瓶颈
下面的脚本只依赖 PyTorch,目的是制造四种可辨认的现象,而不是模拟完整模型:gemm 提供较重的矩阵乘;memory 对大向量做低算术强度逐元素操作;launch 从 Python 连续发射许多极短 Kernel;sync 用 .item() 在循环内强迫 CPU 等待 GPU。保存为 profile_demo.py。
import argparsefrom pathlib import Path
import torchfrom torch.profiler import ProfilerActivity, profile, record_function
def parse_args(): parser = argparse.ArgumentParser() parser.add_argument( "--case", choices=["all", "gemm", "memory", "launch", "sync"], default="all", ) parser.add_argument("--steps", type=int, default=5) parser.add_argument("--warmup", type=int, default=5) parser.add_argument("--torch-profiler", action="store_true") parser.add_argument("--with-stack", action="store_true") parser.add_argument("--trace-dir", default="traces") return parser.parse_args()
@torch.inference_mode()def main(): args = parse_args() if not torch.cuda.is_available(): raise RuntimeError("这个实验需要 NVIDIA GPU 和可用的 CUDA PyTorch")
torch.manual_seed(0) device = "cuda"
# 2048 x 2048 FP16 GEMM;显存较小可改成 1024。 a = torch.randn(2048, 2048, device=device, dtype=torch.float16) b = torch.randn(2048, 2048, device=device, dtype=torch.float16)
# 2^24 个 FP32 元素约为 64 MiB。 vector = torch.randn(1 << 24, device=device) tiny = torch.randn(1024, device=device)
selected = ( ["gemm", "memory", "launch", "sync"] if args.case == "all" else [args.case] )
def run_case(name, prefix): label = f"{prefix}_{name}" # record_function 给 torch.profiler 标注;NVTX 给 Nsight 标注。 with record_function(label), torch.cuda.nvtx.range(label): if name == "gemm": return a @ b if name == "memory": y = vector * 1.0001 return y + 0.0001 if name == "launch": y = tiny for _ in range(200): y = torch.sin(y) return y if name == "sync": value = 0.0 for _ in range(20): # float(CUDA tensor) 内部需要把标量搬回 CPU。 value += float(tiny.mean()) return value raise ValueError(name)
# 预热使用不同的 NVTX 名称,便于 ncu 精确排除。 for _ in range(args.warmup): outputs = [run_case(name, "warmup") for name in selected] torch.cuda.synchronize()
def one_step(): return [run_case(name, "profile") for name in selected]
if not args.torch_profiler: start = torch.cuda.Event(enable_timing=True) end = torch.cuda.Event(enable_timing=True) start.record() for _ in range(args.steps): outputs = one_step() end.record() end.synchronize() print( f"{args.case}: " f"{start.elapsed_time(end) / args.steps:.3f} ms/step" ) return
trace_dir = Path(args.trace_dir) trace_dir.mkdir(parents=True, exist_ok=True)
def save_trace(prof): sort_key = "self_cuda_time_total" print( prof.key_averages(group_by_input_shape=True).table( sort_by=sort_key, row_limit=25, ) ) prof.export_chrome_trace( str(trace_dir / f"trace-step-{prof.step_num}.json") )
# 共 5 步:1 步 wait、1 步 warmup、3 步 active。 schedule = torch.profiler.schedule( wait=1, warmup=1, active=3, repeat=1, ) activities = [ProfilerActivity.CPU, ProfilerActivity.CUDA]
with profile( activities=activities, schedule=schedule, on_trace_ready=save_trace, record_shapes=True, profile_memory=True, with_stack=args.with_stack, ) as prof: for _ in range(5): outputs = one_step() prof.step()
if __name__ == "__main__": main()先检查环境:
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"nvidia-sminsys --versionncu --versionPyTorch 应按 官方安装选择器 安装与驱动匹配的版本。Nsight Compute 通常随 CUDA Toolkit 提供,Nsight Systems 也可以从 NVIDIA 官方软件包单独安装。容器中能运行 CUDA 并不保证能读取性能计数器:若 ncu 报 ERR_NVGPUCTRPERM,应按 NVIDIA 的性能计数器权限说明由管理员开放非管理员访问,或在受控环境中以具有相应权限的方式运行;不要把权限错误误判成代码问题。
这个脚本刻意保留了“坏写法”。生产优化并不是看到 memory 就删除逐元素运算,也不是看到 launch 就盲目 torch.compile;要先让三个 profiler 分别提供证据,再选择融合、批处理、异步流水或 Kernel 优化。
第一层:用 torch.profiler 找到昂贵算子
执行:
python profile_demo.py --case all --torch-profiler脚本会打印按 self_cuda_time_total 排序的聚合表,并在 traces/ 下写出 Chrome Trace JSON。可以在浏览器的 trace viewer 或 Perfetto UI 中打开该文件。表格适合排行,时间线适合因果分析;一开始就盯着时间线上成千上万条细线,很容易迷失。
profile() 到底记录了什么
activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA] 同时请求 CPU 算子事件与 CUDA 设备活动。CPU 侧可以看到 aten::mm、aten::add 以及自定义的 profile_gemm;GPU 侧可以看到它们发射的 cuBLAS 或 ATen CUDA Kernel。Profiler 借助相关 ID 把两侧事件连接起来,所以能从一个高层算子追到设备工作。
几个选项应按问题逐步开启:
record_shapes=True记录输入形状。相同的aten::mm可能有完全不同的 ,不按形状分组会把 Prefill 与 Decode 的调用平均在一起。profile_memory=True记录张量分配与释放事件。它能指出哪个算子触发了显存变化,但不是 CUDA caching allocator 的完整快照;“已分配”“已保留”和进程在nvidia-smi中显示的占用不是同一个口径。with_stack=True记录 Python 调用栈,可用group_by_stack_n找到调用点,但开销明显更高。第一次轻量采集先关闭,只有同名算子无法定位源码时再打开。with_flops=True可为矩阵乘与卷积估算 FLOP,但覆盖范围有限,不能把缺失值理解为算子没有计算。
采集选项越多,扰动越大。正确策略是先用最少信息圈定区域,再为短窗口增加 shape、memory 或 stack,而不是全程打开所有选项。
schedule 为什么分成 wait、warmup 与 active
长时间推理不能全量记录。脚本的调度是 wait=1, warmup=1, active=3, repeat=1:第一步不采集;第二步启动采集但丢弃结果,用来吸收 profiler 自身刚开启时的额外开销;后三步正式写入 trace。每个逻辑迭代末尾必须调用 prof.step(),否则调度器不知道何时进入下一阶段。
外层 args.warmup 与 profiler 内的 warmup 解决不同问题:前者让模型、库和 GPU 进入稳态,后者让采集机制本身稳定。二者不能互相替代。在线服务中可把请求或 decode iteration 定义为 step,并用 on_trace_ready 周期性导出短 trace;但导出 JSON 会产生 I/O,不能在热路径上无限重复。
聚合表怎么读
假设某行名为 aten::mm:
Self CPU是该事件自身在主机侧的时间,不包含嵌套子事件;CPU total包含子事件。CPU time avg是聚合总时间除以调用次数,不是 P50 延迟。Self CUDA是直接归属于该事件的设备时间;CUDA total还包括子事件关联的设备工作。# of Calls极其关键。一个 4 微秒 Kernel 调用 10 万次,优化优先级可能高于一个偶尔出现的 1 毫秒 Kernel。- CPU/CUDA memory 列是事件期间的分配变化;负值通常表示释放,不代表显存测量失败。
self 与 total 的关系可以写成:
其中 是当前事件, 是它的直接子事件。若 profile_launch 的 CPU total 很大而 self 较小,成本主要在内部 200 次 aten::sin;若 self 本身很大,则可能有 Python、dispatcher 或同步逻辑留在这个范围上。并发事件并不总能用简单减法完美解释,所以最终仍需回到时间线核对。
对示例脚本,合理的观察不是背诵某组毫秒数,而是辨认模式:
| 区间 | 聚合表中的典型信号 | 初步假设 |
|---|---|---|
profile_gemm | aten::mm 的 CUDA 时间集中,调用次数少 | 单个重 Kernel,值得检查 Tensor Core、矩阵形状和计算吞吐 |
profile_memory | aten::mul/aten::add 有大张量 shape 与显存分配 | 逐元素低算术强度,可能适合融合以减少中间张量与显存往返 |
profile_launch | aten::sin 调用数极高,单次很短,CPU 发射成本显眼 | launch bound,考虑融合、CUDA Graph 或增大工作粒度 |
profile_sync | aten::item、aten::_local_scalar_dense 及同步相关事件反复出现 | 主机每轮等设备,需把标量判断留在设备侧或降低同步频率 |
这只是候选解释。aten::mm 时间长不等于矩阵乘实现差:它可能已经接近硬件峰值,只是业务本来就有这么多计算;逐元素 Kernel 时间长也不自动等于“显存带宽已跑满”。是否接近硬件上限,需要 Nsight Compute 的计数器证明。
时间线看四条关系
在 trace viewer 中按下面顺序检查:
- 找到自定义
profile_*范围,先确认采集窗口确实覆盖稳态步骤。 - 展开 CPU thread,观察 PyTorch 算子与 CUDA Runtime 调用;
cudaLaunchKernel只表示提交,不是 Kernel 已经完成。 - 展开 GPU stream,沿相关连线从
aten算子追到 Kernel,检查提交与执行之间是否有长队列。 - 放大 GPU 空白区,向上寻找对应 CPU 活动:CPU 是否在计算、睡眠、被调度出去、做同步或执行 H2D/D2H。
时间线中的空白不是一种瓶颈名称。GPU 空白可能是输入没准备好、CPU launch 太慢、显式同步、跨进程排队,也可能只是这段业务本来就不需要 GPU。PyTorch trace 能提供框架上下文,但对 OS 调度、其他进程、CPU 采样和跨库全局关系的观察有限;这正是下一层交给 Nsight Systems 的原因。
第二层:用 Nsight Systems 看清 CPU、CUDA 与 GPU 的协作
不要在同一次进程里同时开启 torch.profiler 和 Nsight 的深度采集。它们都可能使用 CUPTI,不仅扰动叠加,还可能争用采集能力。关闭脚本中的 --torch-profiler,先做一份轻量系统时间线:
nsys profile \ --trace=cuda,nvtx,osrt,cublas \ --sample=none \ --cpuctxsw=none \ --force-overwrite=true \ -o nsys-all \ python profile_demo.py --case all --steps 5输出的 nsys-all.nsys-rep 可用 Nsight Systems GUI 打开。没有 GUI 的服务器可以先看汇总:
nsys stats nsys-all.nsys-repnsys stats --help-reportsnsys stats --report cuda_gpu_kern_sum,cuda_api_sum,nvtx_sum \ nsys-all.nsys-rep报告名会随版本演进,因而先用 --help-reports 查看当前版本支持的名字,比从旧文章复制命令更稳妥。--sample=none --cpuctxsw=none 降低了 CPU 采样扰动;若时间线显示 GPU 长时间饥饿,而且需要判断 CPU 线程是在运行、睡眠还是被调度出去,再单独采一份带 CPU sampling/context switch 的短报告。
从上到下读时间线
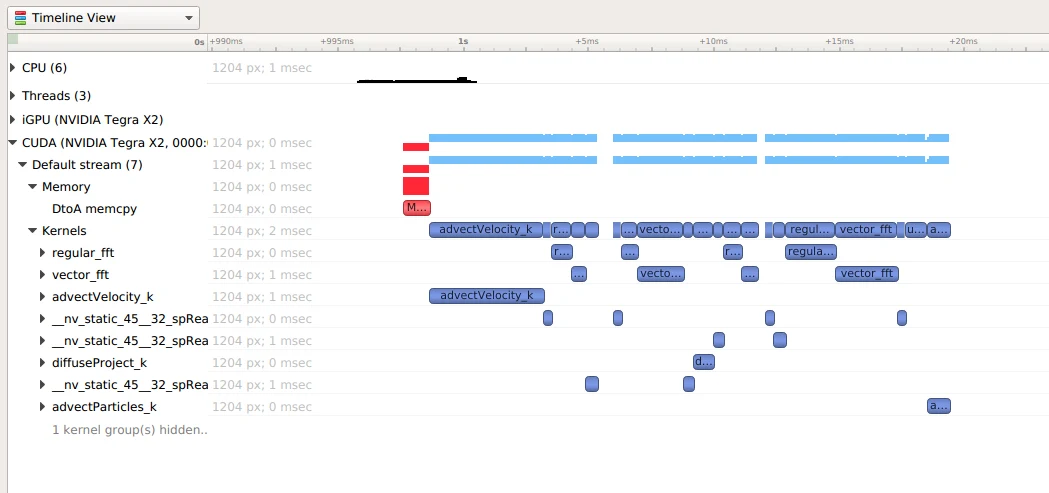
图源:NVIDIA Nsight Systems User Guide 的 CUDA Trace 章节。官方图把 CUDA Context 下的 Stream、Kernel 和内存传输分行展开;蓝色块表示 Kernel,红色块表示内存操作。颜色会因版本和主题变化,分析时以事件类型和名称为准。
一份 PyTorch CUDA 报告通常至少有四组轨道:
- Python 主线程与其他 CPU 线程。这里能看到 NVTX 范围、OS Runtime 调用与 CPU sampling 结果。
- CUDA API 轨道。
cudaLaunchKernel、cudaMemcpyAsync、cudaStreamSynchronize等发生在主机端。 - GPU Context/Stream 轨道。真正执行的 Kernel 与 Memcpy 在这里;同一 Stream 内有序,不同 Stream 才有重叠机会。
- 可选的 GPU Metrics、cuBLAS/cuDNN、NCCL、网络与存储轨道。它们用于回答更特定的问题,不应默认全部开启。
点击某个 cudaLaunchKernel,界面中的 correlation 通常可定位到对应 GPU Kernel。二者之间的距离不能简单称作“CUDA launch overhead”:Kernel 可能在 Stream 队列里等待前序工作,也可能受上下文切换或设备调度影响。真正的主机发射成本主要体现在 API 调用本身和连续调用之间的 CPU 间隙;提交到开始执行的延迟还包含设备排队。
NVTX 是跨工具的语义桥
裸 CUDA Kernel 名经常很长,而且 void at::native::... 并不能直接说明它属于 Prefill、Decode、采样还是 KV Cache 更新。示例中的 torch.cuda.nvtx.range("profile_gemm") 把业务语义附着到时间线;NVIDIA 工具还能把 CPU 上的 NVTX 范围投影到它内部发射的 GPU 工作。
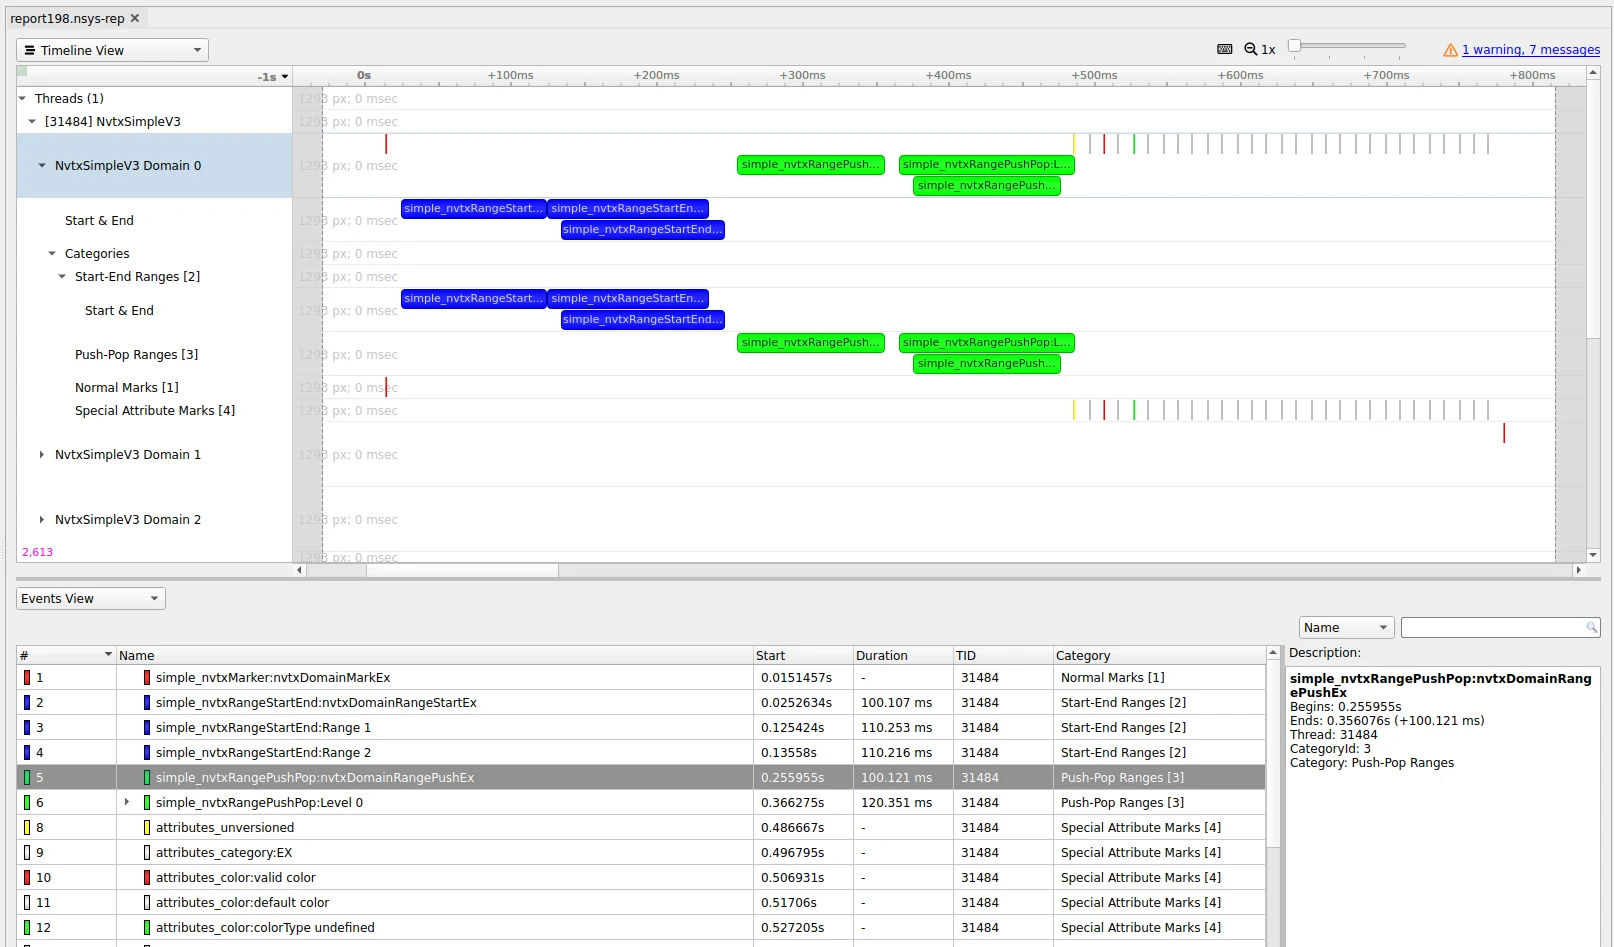
图源:NVIDIA Nsight Systems User Guide 的 NVTX Trace 章节。图中不同颜色和层级不是装饰:domain 可以隔离不同库,category 可以区分工作类型,嵌套 range 可以表达“请求 → Decode step → attention → GEMM”的层次。大型推理服务若没有稳定的 NVTX 命名,分析者只能在实现细节名称中猜业务阶段。
PyTorch 的 record_function 与 NVTX 用途相近但消费者不同:前者首先服务于 PyTorch Profiler;后者是 Nsight Systems/Compute 原生理解的跨语言标记。示例同时写两种标记,是为了让三份报告使用同一组名称,并不意味着必须在所有生产路径长期保留最细粒度标记。
四类典型时间线
GPU 饥饿或 launch bound。 profile_launch 内是一串很短的 Kernel,Kernel 之间存在细小空洞;CPU 线程持续调用 cudaLaunchKernel,GPU 没有足够大的工作覆盖发射间隔。可尝试算子融合、torch.compile、CUDA Graph、批处理或把循环搬进单个 Kernel。增加占用率并不能修复 GPU 根本拿不到工作的情况。
强制同步。 profile_sync 中 CPU 反复进入 cudaStreamSynchronize、cudaEventSynchronize 或同步内存拷贝,后续发射必须等 GPU 返回。.item()、把 CUDA Tensor 转成 Python 标量、打印 Tensor、某些 .cpu()/.numpy() 路径都可能形成同步点。修复方向是让判断与归约留在设备侧、合并读取,或把确有必要的同步移出逐 token 热循环。
拷贝没有重叠。 H2D、D2H 和 Kernel 全在同一 Stream 上首尾相接,或者页锁定内存与 non_blocking 条件不满足。只有硬件支持复制引擎、主机缓冲区可异步 DMA、工作位于可并发的 Stream 且依赖关系正确时,拷贝才可能与计算重叠。看到 cudaMemcpyAsync 的函数名不等于时间线上必然并发。
GPU 很忙但请求仍慢。 GPU 时间线连续不空,并不能证明效率高。一个低效 Kernel 同样能让 GPU 100% busy;多请求排队也能填满设备,却恶化单请求尾延迟。此时先用 NVTX 分开单个请求/阶段,确认关键路径,再把主导 Kernel 交给 ncu。
可用 GPU 覆盖率描述选定窗口内设备是否有工作:
分子是所有 GPU 活动区间的并集长度,不能直接累加重叠 Kernel 的 duration; 是所选分析窗口。这个指标只描述“忙不忙”,不描述“忙得是否有效”。
什么时候增加采集项
- 怀疑 CPU 调度或锁:增加 CPU sampling、thread scheduling/context switch,缩短采集窗口控制数据量。
- 怀疑显存申请:增加
--cuda-memory-usage=true,但官方文档明确提示它可能带来显著开销。 - 多 GPU 通信:增加 NCCL trace,观察 collective API、GPU Kernel 与网络活动是否串联或重叠。
- 怀疑整卡利用率波动:可采 GPU Metrics,但它需要受支持的 GPU与相应权限;它仍是采样信号,不替代单 Kernel 计数器。
先提出问题,再增加对应数据源。一次捕获所有 OS、网络、GPU、Python backtrace 与库事件,通常只会制造巨大的报告和更高扰动。
第三层:用 Nsight Compute 解剖单个 Kernel
Nsight Systems 已经回答“哪个 Kernel 值得看”之后,才轮到 Nsight Compute。先只采 profile_gemm NVTX push/pop 范围中的第一个 Kernel:
ncu \ --target-processes all \ --nvtx \ --nvtx-include "profile_gemm/" \ --section LaunchStats \ --section Occupancy \ --section SpeedOfLight \ --launch-count 1 \ --force-overwrite \ -o ncu-gemm-basic \ python profile_demo.py --case gemm --steps 1末尾的 / 很重要:NVIDIA 的 CLI 语法用它表示 NVTX push/pop range。示例预热阶段叫 warmup_gemm,正式阶段才叫 profile_gemm,所以过滤条件不会把预热 Kernel 也采进去。打开报告:
ncu-ui ncu-gemm-basic.ncu-rep如果第一条并非期望的主 GEMM,可先去掉 --launch-count 1 做一次轻量发现,查看完整 Kernel 名,再用名称过滤:
ncu \ --kernel-name-base function \ --kernel-name 'regex:.*gemm.*' \ --launch-count 1 \ -o ncu-gemm \ python profile_demo.py --case gemm --steps 1Kernel 名随 GPU 架构、PyTorch、cuBLAS 与算法选择变化,不应照抄某台机器的精确名字。NVTX 先圈业务区间、名称再选 Kernel,比只依赖容易变化的模板化 C++ 名称更稳。
为什么 ncu 特别慢
硬件性能计数器数量多,但 GPU 一次可同时采集的计数器有限。Nsight Compute 会把请求的 metrics 分成若干 pass,并通过 Kernel Replay、Application Replay 或 Range Replay 重放工作。重放时还可能保存与恢复 Kernel 使用的显存,以尽量维持正确性。
因此 ncu --set full python server.py 可能让本来几秒的程序运行很久,也可能破坏原有并发。报告中被测 Kernel 的 duration 才是关注对象;整个 profiler 命令的墙钟时间没有业务性能含义。若 Kernel 依赖并发执行或与主机交互,默认 Kernel Replay 还可能不合适,应根据官方 Profiling Guide 评估 Application/Range Replay。
建议分两轮:
# 第一轮:低成本分诊ncu \ --nvtx --nvtx-include "profile_memory/" \ --section LaunchStats \ --section Occupancy \ --section SpeedOfLight \ --launch-count 1 \ -o ncu-memory-triage \ python profile_demo.py --case memory --steps 1
# 第二轮:确认需要后再采完整 section setncu \ --nvtx --nvtx-include "profile_memory/" \ --set full \ --launch-count 1 \ -o ncu-memory-full \ python profile_demo.py --case memory --steps 1若只需某组信息,用 --section MemoryWorkloadAnalysis 等定向采集通常比 --set full 更快。可通过 ncu --list-sections 查看本机版本提供的 section;metrics 名与可用性依 GPU 架构变化,遇到 n/a 应先用 ncu --query-metrics 核对,而不是把 n/a 当作 0。
报告首页按什么顺序读
GPU Speed of Light Throughput。 先看 duration、Compute Throughput 和 Memory Throughput。两者之一接近峰值时,通常指向相应资源上限;两者都低时,不等于“还有大量免费性能”,更常见的是工作网格太小、依赖延迟、同步、分支发散或指令发射受阻。
Launch Statistics。 看 grid/block 维度、每 block 线程数、寄存器/线程、静态与动态共享内存、waves per SM。若 grid 只有少量 block,大 GPU 根本没有足够并行工作;若每线程寄存器或每 block 共享内存过高,同驻留 block 数会下降。
Occupancy。 Theoretical Occupancy 由 block 大小、寄存器、共享内存和硬件上限推导;Achieved Occupancy 是执行期间实际活跃 warp 相对最大值的观测。理论高而实际低常提示负载不均或尾部效应;理论本身低则应查看是 registers、shared memory 还是 blocks 限制。
Compute Workload Analysis。 它把指令压力拆到 FP32、FP64、Tensor、整数、Load/Store 等流水线。对于 FP16/BF16 GEMM,要确认 Tensor Core 相关管线确实有工作;只看泛化的 SM busy 无法证明使用了 Tensor Core。
Memory Workload Analysis。 从 DRAM 向上追到 L2、L1/TEX、Shared,观察吞吐、bytes、hit rate、requests/sectors 和 shared-memory bank conflict。高 DRAM throughput 可能表示有效地跑满带宽,也可能表示本可复用的数据反复穿过 DRAM;必须结合算法预期的数据流判断。
Scheduler Statistics 与 Warp State Statistics。 前者说明每个 scheduler 有多少 active/eligible warps、多少周期能发射指令;后者说明 warp 为什么没有发射。stall reason 是诊断线索,不是优化排行榜。比如 long scoreboard 常与等待远端内存依赖有关,但修复点可能是改善合并访问、提高复用或增加可隐藏延迟的独立工作,而不是“消灭这个指标”。
Source。 若目标是自编译 CUDA/Triton Kernel,并保留 line info,可把热点 SASS、源代码行与采样/指标关联。预编译 PyTorch/cuBLAS 库不一定提供完整源码映射,此时仍可读 SASS 与函数级信息,但不应期待跳回自己的 Python 行;Python 归因应由 torch.profiler 与 NVTX 完成。
Occupancy 不是越高越快
Occupancy 定义为 SM 上活跃 warp 数与硬件允许最大活跃 warp 数之比:
更多活跃 warp 可以在某个 warp 等待数据时让 scheduler 切换到其他 warp,从而隐藏延迟;但只要已有足够并行性覆盖延迟,继续提高 occupancy 不一定增加吞吐。为追求 100% occupancy 而减少寄存器,可能导致 register spilling,把数据溢出到 local memory,反而更慢。判断顺序应是:先看 duration 是否改善,再看吞吐与 stall 如何变化,occupancy 只是解释变量。
从指标到结论:计算、带宽、延迟与占用率
Roofline 把计算量与数据搬运放到同一张图
算术强度定义为完成的工作量与数据流量之比:
是浮点操作数, 是从所讨论存储层搬运的字节数,单位为 FLOP/byte。给定峰值计算吞吐 和峰值内存带宽 ,一个简化上界是:
当 很小, 更低,Kernel 落在斜屋顶下,属于带宽侧;当 越过 ridge point,计算峰值成为平屋顶。交点的算术强度是:
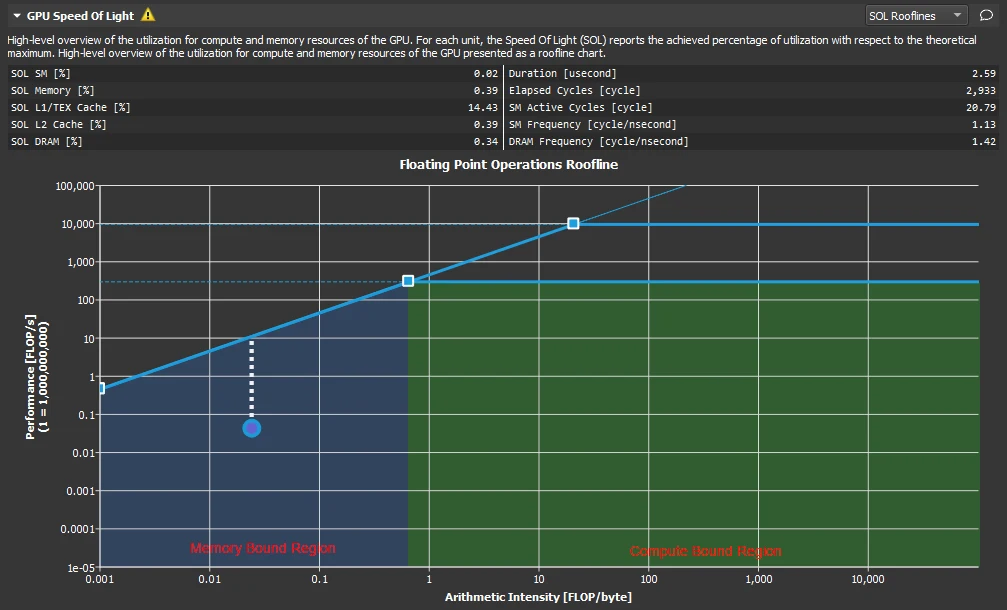
图源:NVIDIA Nsight Compute Profiling Guide 的 Roofline Analysis。蓝色区域受斜向内存带宽屋顶限制,绿色区域受水平计算屋顶限制;实测点到对应屋顶的距离表示仍未利用的机会。这里的“受限”不是说另一种资源完全没工作,而是继续提升性能时首先撞到哪条上界。
以 与 的矩阵乘为例,乘加约有 FLOP。若只按读入两个矩阵、写出一个矩阵的理论最低 DRAM 流量估算,元素宽度为 字节,则:
方阵边长增加时,计算量按立方增长,最低数据量按平方增长,因此 GEMM 有机会成为计算受限。真实实现还会受 cache reuse、tile、输出读改写、布局和算法选择影响,Nsight Compute 报告中的实测 DRAM bytes 才能检验这个理论数据流是否实现。
示例中的 memory 做两个独立 FP32 逐元素算子。忽略缓存后,每个算子至少读写一次 个元素,两次算子约搬运 字节而只做 次操作:
若融合成一个 y = x * alpha + beta Kernel,中间张量不落回显存,最低流量变成一次读、一次写:
融合没有减少这两个数学操作,却把最低显存流量减半、算术强度翻倍,同时少一次 Kernel launch。这正是 torch.compile 或手写融合 Kernel 可能同时改善 memory bound 与 launch bound 的原因。
Memory Chart 追踪字节到底走过哪一级
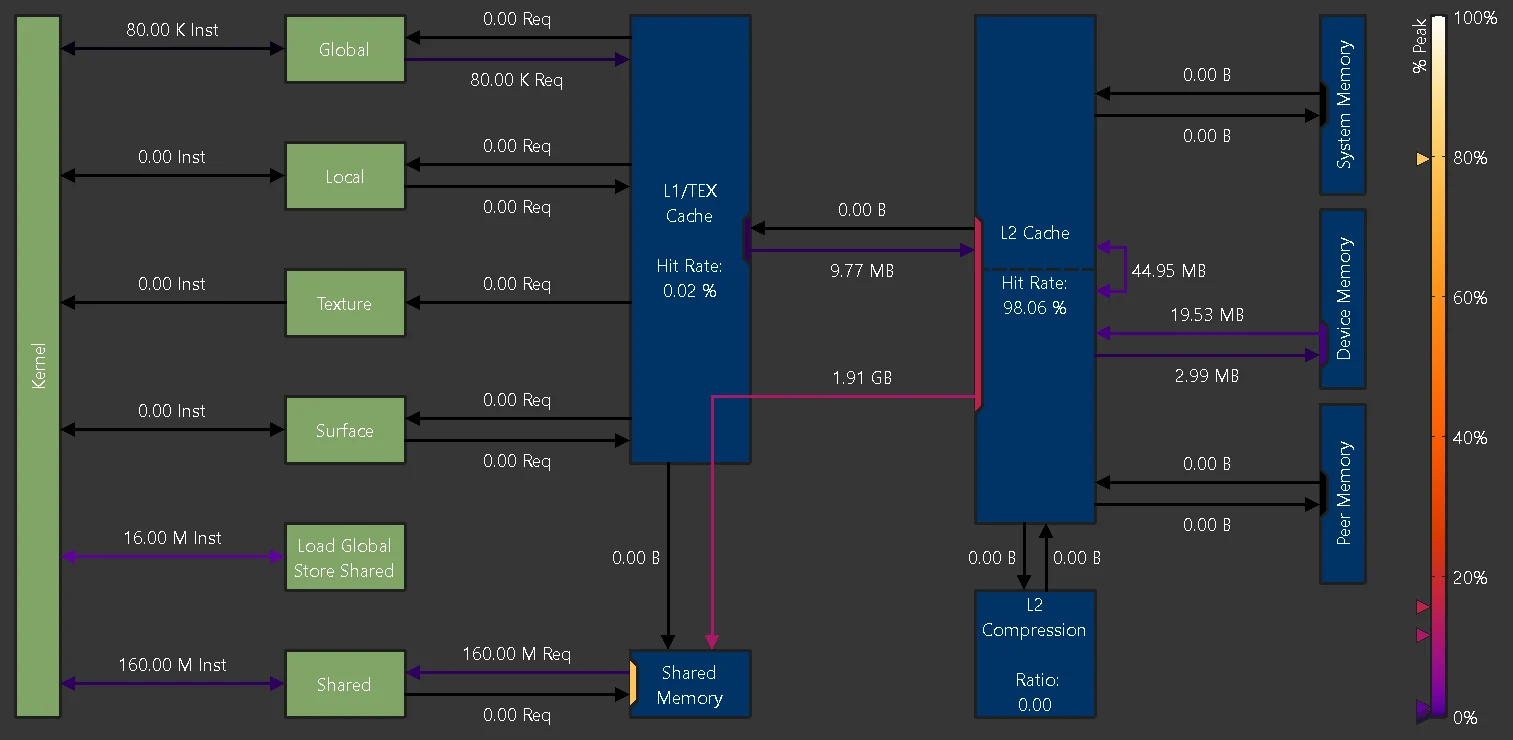
图源:NVIDIA Nsight Compute Profiling Guide 的 Memory Chart。绿色框表示 Kernel 看到的逻辑内存空间,蓝色框表示 L1/TEX、L2、DRAM 等物理单元,连线给出 requests/bytes 与链路利用率。图中某条链路接近峰值,只能说明该路径繁忙;还需检查 sector 数、命中率与算法预期,判断这些流量是否必要。
几个常见的证据组合如下:
| 结论候选 | 需要同时看到的证据 | 更可能有效的优化 | 容易误用的动作 |
|---|---|---|---|
| 计算吞吐受限 | Roofline 靠近平屋顶;目标计算管线利用率高;内存不是主导 | 更低精度/Tensor Core、减少 FLOP、改进指令混合、使用更优库算法 | 只提高 occupancy,或为缓存优化增加额外计算 |
| DRAM 带宽受限 | 靠近斜屋顶;DRAM throughput 高;bytes 与理论数据流相符或偏高 | 融合、量化、提高复用、改善布局、减少中间张量 | 盲目增加 block/warp,或只减少算术指令 |
| 缓存/访存效率问题 | DRAM/L2 流量异常、sector/request 比差、命中率低或 shared bank conflict 高 | 合并访问、对齐、tile、重排数据、消除 bank conflict | 仅凭低 hit rate 下结论;流式访问本就可能不需要高命中率 |
| 设备延迟受限 | Compute 与 Memory throughput 都低;eligible warp 少;某类依赖 stall 主导 | 增加独立工作、软件流水、减少依赖链、合理提高 occupancy | 把“二者都低”解释成资源充足,可以随便加计算 |
| 网格/尾部太小 | waves per SM 很低;只有少数 SM 有工作;最后一波拖尾明显 | 合并请求/批次、持久化 Kernel、改变工作划分 | 优化单线程指令,却不增加并行工作量 |
| 主机发射受限 | Nsight Systems 中短 Kernel 间有空洞,CPU launch 连续;单 Kernel 指标未必差 | 融合、CUDA Graph、批处理、减少 Python 循环 | 用 ncu 深挖每个小 Kernel;问题在 Kernel 外部 |
“利用率高”仍需问两个问题
第一,分母是什么。Nsight Compute 的 % of peak sustained 以工具数据库中的持续峰值为参照;nvidia-smi 的 GPU-Util 则是采样窗口内是否有 Kernel 活跃的粗粒度指标。二者不是同一个利用率。
第二,工作是否有价值。一个 Kernel 可以用大量冗余加载把 DRAM 跑满,也可以用无用计算把 Tensor Core 跑满。优化必须同时验证 duration、输出正确性与总工作量;官方 Profiling Guide 也强调,优化前后应以绝对 workload duration 为最终性能依据,因为利用率百分比会随工作量变化而升降。
对于 GPU GEMM 优化系列,共享内存分块、寄存器分块、向量化访存和异步流水线分别会改变 DRAM 流量、occupancy、指令发射与计算管线利用率。Nsight Compute 的作用不是给这些技术打一个总分,而是验证某次实现是否真的改变了预期的硬件路径。
完整实战:把三个工具串成一次性能调查
第 0 步:先取得没有 profiler 的基线
分别运行四种负载,记录脚本输出的 ms/step。增加 --steps 可以减小短任务的测量噪声:
python profile_demo.py --case gemm --steps 20python profile_demo.py --case memory --steps 20python profile_demo.py --case launch --steps 20python profile_demo.py --case sync --steps 20不要比较不同机器上得到的绝对数字。即使 GPU 型号相同,PyTorch/cuBLAS 版本、驱动、时钟、MIG 配置、后台负载和输入 shape 都会改变结果。这个基线的用途是验证同一环境里的定向修改。
第 1 步:框架层找候选热点
python profile_demo.py --case all --torch-profiler聚合表会把四类工作映射到 aten::mm、逐元素算子、反复的 aten::sin 与标量读取相关算子。此时建立的是候选假设:GEMM 可能计算重,pointwise 可能带宽重,sin 链可能发射重,.item() 可能同步重。不能在这一步就宣布根因。
若真实模型中同名算子很多,先用 group_by_input_shape=True 区分形状;仍无法区分时,给模型阶段加 record_function,或只在第二轮打开 --with-stack。不要一开始就为整个服务采 Python stack。
第 2 步:系统层验证关键路径
nsys profile \ --trace=cuda,nvtx,osrt,cublas \ --sample=none --cpuctxsw=none \ -o nsys-demo \ python profile_demo.py --case all --steps 5在 GUI 里只选正式的 profile_* 范围:
- 若
profile_launch的 200 个短 Kernel 之间有空洞,CPU 提交节奏限制了设备,继续分析每个sinKernel 的 L2 命中率意义很小。 - 若
profile_sync每次mean后都出现主机等待,.item()假设得到证实。 - 若
profile_memory内 GPU 连续忙、两个逐元素 Kernel 首尾相接,瓶颈已经收窄到 Kernel 与中间张量流量。 - 若
profile_gemm是连续的长 Kernel,系统调度不是首要问题,可以进入硬件计数器层。
第 3 步:只深挖值得优化的 Kernel
对 profile_memory 与 profile_gemm 分别采一条主导 Kernel,而不是把四类负载都交给 --set full。重点核对:
- GEMM 是否使用预期的 Tensor Core 数据路径,是否靠近计算屋顶,矩阵形状是否导致网格或 tile 尾部浪费;
- pointwise Kernel 的 DRAM bytes 与吞吐是否支撑带宽受限判断,两个 Kernel 是否确实把中间张量写回并重新读入;
- duration 是否与 Nsight Systems 中同一 Kernel 大致一致。若差异很大,先检查 replay、cache control、clock control 和被测 invocation 是否一致。
第 4 步:做一次只针对根因的改动
同步问题可以把 20 次主机读取收敛成一次:
# 修改前:每轮都把 CUDA 标量读回主机,产生 20 次同步。value = 0.0for _ in range(20): value += float(tiny.mean())
# 修改后:累加保持为 CUDA Tensor,循环结束后只读回一次。value_on_gpu = torch.zeros((), device=tiny.device)for _ in range(20): value_on_gpu += tiny.mean()value = float(value_on_gpu)pointwise 与 launch 问题可以先验证编译融合:
def memory_chain(x): return x * 1.0001 + 0.0001
def launch_chain(x): for _ in range(200): x = torch.sin(x) return x
compiled_memory_chain = torch.compile(memory_chain, fullgraph=True)compiled_launch_chain = torch.compile(launch_chain, fullgraph=True)编译发生在首次调用,必须在计时前执行足够 warmup。还要通过 profiler 验证图没有意外 graph break、Kernel 数确实下降;某些后端或动态 shape 下不一定能得到理想融合。对生产路径,200 层 sin 这种人为算例不是合理算法,真正的优化可能是消除循环本身,而不是只依靠编译器包装。
GEMM 若已经接近适用精度的硬件屋顶,手写 Kernel 往往不是优先项。更有效的动作可能是选择能走 Tensor Core 的 dtype/布局、调整 batch 或把上游多个小 GEMM 合并;这些变更都可能影响数值精度、内存与请求延迟,需要端到端验证。
第 5 步:关闭 profiler 回到原基准
用第 0 步完全相同的输入、软件和硬件条件重新测量。一次完整记录至少包含:
| 字段 | 示例内容 |
|---|---|
| 变更 | 把逐 token 的 .item() 移到循环外 |
| 基线 | 固定 batch/shape 下的 median、P90、P99 |
| 证据 | aten::item 调用数;Nsight Systems 同步点数量 |
| 修改后 | 相同统计量与正确性结果 |
| 副作用 | 显存变化、首轮编译、动态 shape、数值差异 |
| 环境 | GPU、驱动、CUDA、PyTorch、时钟/功耗设置 |
只有“基线变快 + 正确性不变 + profiler 中预期机制确实改变”三者同时成立,优化闭环才算完成。否则可能只是运行间噪声,或改动通过减少工作量获得了错误的速度。
常见误判与排查清单
误判一:某算子 CUDA 时间最高,所以它实现得最差
热点只说明它贡献了最多时间。矩阵乘可能占 70% 时间,同时已达到 90% 可达峰值;另一个只占 15% 的碎片化小算子链反而有数倍优化空间。先用占比决定优先级,再用硬件上界决定可优化空间。
误判二:GPU-Util 接近 100%,所以 GPU 已经高效
nvidia-smi 的利用率是采样窗口内是否有 Kernel 执行的粗粒度信号。低效 Kernel、冗余计算和排队请求都能把它推高。效率判断至少需要时间线关键路径、单位请求工作量和 Kernel 级吞吐共同支撑。
误判三:CPU 时间与 CUDA 时间相加就是端到端延迟
CPU 提交与 GPU 执行是流水并发的,多个 Stream 也可重叠。简单相加会重复计算重叠区间。端到端延迟用正确同步的墙钟基准测;CPU/CUDA 聚合时间用来解释构成。
误判四:最大的 warp stall 就是根因
warp 几乎总有“不发射”的分类原因。只有在 issue activity 低、Kernel 确实 latency bound 时,stall 分解才直接指向机会;若 Tensor pipeline 已饱和,warp 等待该 pipeline 是结果而非独立问题。先做 SOL/吞吐分类,再读 stall。
误判五:Occupancy 没到 100%,应该减少寄存器
Occupancy 是隐藏延迟的手段,不是最终 KPI。强行压寄存器可能触发 local-memory spill;此时 occupancy 上升,duration 却更差。比较前后寄存器、local load/store、issue activity 与 duration,才能判断权衡。
误判六:一次 --set full 可以永久解释所有版本
Kernel 选择随 shape、dtype、GPU 架构和库版本变化;量化、CUDA Graph、编译器融合也会彻底改变时间线。优化后要重新从上层定位,不能默认旧热点仍是热点。迁移到新 GPU 时,计算峰值、带宽、缓存和寄存器容量的相对比例变化,也可能让同一 Kernel 从 compute bound 变成其他类型。
常见故障
| 现象 | 常见原因 | 排查动作 |
|---|---|---|
torch.profiler 没导出 trace | 循环没有走完 active 阶段,或忘记 prof.step() | 打印 prof.step_num;让逻辑 step 数覆盖 wait + warmup + active |
| 表里只有 CPU,没有 CUDA | PyTorch 不是 CUDA 构建、CUDA 不可用、漏写 ProfilerActivity.CUDA | 检查 torch.__version__、torch.cuda.is_available() 与 activities |
| trace 巨大、程序明显变慢 | 采集窗口过长,同时开启 stack/shape/memory | 缩短 active,分轮开启选项,只标记关键阶段 |
| Nsight Systems 看不到 NVTX | --trace 未含 nvtx,标记发生在捕获窗口外,或分析了错误进程 | 先用短脚本全程采集;检查 process tree 和 NVTX 名称 |
| Nsight Systems 只有主进程,工作在 worker | 子进程不在默认捕获范围或启动方式特殊 | 检查当前版本的 process-tree/child-process 选项与容器注入限制 |
ncu 显示 No kernels were profiled | NVTX range 写法不匹配、尾部 / 缺失、Kernel 名过滤过严 | 先去掉名称过滤;用轻量 section 列出范围内 Kernel,再逐步加过滤 |
ERR_NVGPUCTRPERM | 驱动限制非管理员访问性能计数器 | 按 NVIDIA 官方权限指南配置;共享机器上联系管理员 |
ncu 运行极慢 | 选中太多 Kernel/metrics,发生多 pass replay | --launch-count 1;用 NVTX 精确圈定;先少量 section,再 --set full |
ncu duration 与 nsys 差距很大 | 选错 invocation、replay/cache/clock 控制改变执行条件 | 比对 Kernel 名和形状;查看 Session 设置;换 replay 模式并缩小工作负载 |
| CUDA Graph 只显示一个整体节点 | 工具按 graph 粒度跟踪以降低开销 | 需要时改用 node 粒度;接受更高采集开销并仅截取短窗口 |
在多进程推理服务中,先确认模型到底运行在哪个 PID/rank。--target-processes all 可以帮助 ncu 捕获子进程,但会扩大范围,必须和 NVTX、Kernel filter 配合。MIG、MPS、虚拟机、容器和安全策略也会改变 tracing 或计数器可用性;工具报告的 Diagnostics/Session 页面应当先于指标解读。
一套可复用的分析流程
把整个方法压缩成一条因果链:
定义业务指标与代表性输入 ↓无 profiler 基线:warmup + 同步边界 + 重复统计 ↓torch.profiler:模型阶段 → PyTorch 算子 → CUDA Kernel 候选 ↓Nsight Systems:CPU / API / Copy / Stream / Kernel 的关键路径 ↓问题在 Kernel 内部吗? ├─ 否:处理发射、同步、调度、拷贝、并发或排队 └─ 是:Nsight Compute 过滤一条主导 Kernel ↓ 网格大小 → SOL → Compute/Memory → Scheduler/Stall → Source ↓只做一个可验证的修改 ↓关闭 profiler,回到同口径基线验证;热点变化则重新循环落到真实推理系统,可按以下顺序执行:
- 定义目标。 是降低 TTFT、TPOT、P99,还是提高固定 SLO 下吞吐?目标不同,关键路径不同。
- 冻结变量。 固定模型、权重精度、batch、序列长度、并发、采样参数、硬件与软件版本。
- 分阶段标记。 至少用 NVTX 区分输入准备、Prefill、逐 token Decode、采样、KV Cache 操作与通信。
- 框架分诊。 用短
torch.profiler窗口找算子、shape、调用次数和内存事件。 - 系统验证。 用
nsys判断空洞、同步、排队、复制/计算重叠与多 Stream/多卡关系。 - Kernel 分诊。 只有主导 Kernel 才进入
ncu;先少量 section,再根据证据加 Memory、Scheduler、Warp State 或 Source。 - 建立假设。 用一句可证伪的话描述:“两个 pointwise Kernel 中间张量写回 DRAM,因此融合应减少一次读写和一次 launch”。
- 单变量修改。 避免同时改 batch、dtype、编译模式和 Kernel,否则无法归因。
- 三重验证。 检查正确性、无 profiler 性能与 profiler 机制变化。
- 记录边界。 写清优化只在什么 shape、GPU、并发和软件版本下成立。
这条流程也能防止“指标驱动编程”:不是看到低 occupancy 就改 block,不是看到 long scoreboard 就加 prefetch,而是先确认它位于业务关键路径、确实限制 issue,并且改动能缩短绝对 duration。
小结
torch.profiler、Nsight Systems 与 Nsight Compute 分别回答三个层次的问题:模型语义里的时间花在哪里,CPU 与 GPU 如何协作,以及单个 Kernel 为什么没有更快。它们的边界比功能列表更重要:算子表不能证明带宽饱和,系统时间线不能解释某条 SASS 的 stall,Kernel 计数器也不能发现请求排队与 Python 发射空洞。
一套可靠实践包含四个不变原则:先基准后 profiling;从全局到局部逐层收窄;任何指标都要与 duration 和关键路径交叉验证;修改后关闭 profiler 回到原始业务口径。掌握这条证据链之后,性能优化不再是凭经验猜参数,而是从可复现现象走到可证伪假设,再走到可验证结果。
参考资料
- PyTorch 2.14:torch.profiler 官方 API
- PyTorch 2.14:Profiler Recipe
- PyTorch 2.14:CUDA semantics 与异步执行
- PyTorch 官方博客:Introducing PyTorch Profiler
- NVIDIA Nsight Systems User Guide
- NVIDIA Nsight Systems Post-Collection Analysis Guide
- NVIDIA Technical Blog:Nsight Systems Exposes New GPU Optimization Opportunities
- NVIDIA Nsight Compute Profiling Guide
- NVIDIA Nsight Compute CLI Manual
- NVIDIA Nsight Compute Triage Guide
- NVIDIA Nsight Compute Release History
- NVIDIA Tools Extension(NVTX)官方文档
- NVIDIA CUDA C++ Best Practices Guide
- NVIDIA:ERR_NVGPUCTRPERM 性能计数器权限说明
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


