


vLLM 源码完全拆解(十):投机解码——草稿模型、批量验证与 token 接受流水线
系列回顾与本篇定位
前面的九篇文章把 vLLM V1 引擎从整体架构一路拆到了最细的算子:第一篇(架构总览)里画出了 LLMEngine → 调度器 → 块管理器 → 模型执行器 的四层结构;第二篇沿着 add_request 走通了 EngineCore.step 的一次完整迭代;第三篇拆了 Scheduler.schedule 如何分配 token 预算与 KV Block;第四到第九篇则一头扎进 GPUModelRunner 里,逐层拆解了 KV Cache 分配(KVCacheManager)、动态请求如何拼进一次 GPU 前向(InputBatch/GPUModelRunner)、注意力后端如何统一 FlashAttention 与 FlashInfer,最后落到 PagedAttention Kernel 与 MoE、Sampler。
但到目前为止,我们默认每一轮 EngineCore.step 只让目标模型自回归地生成一个 token——也就是「每步串行、模型越大越慢」的朴素解码。本篇就来补上这个框架层最特殊、也最能体现「调度与执行分离」的分支:投机解码(speculative decoding)。它不像前面那些「把单 token 生成打磨到极致」的技术,而是用额外的草稿模型去猜测多个 token,再由目标模型的一次前向并行验证,从而在数学意义上是完全无损的前提下,把解码速度提升一个台阶。
本篇要讲透的不是投机解码算法本身(站内已有 EAGLE、MTP、DSpark、DFlash 等多篇文章深入讲过各种草稿模型),而是 vLLM 如何把「草稿—验证—接受」这条流水线嵌进它自己的 Worker / ModelRunner / Scheduler 框架。读完你会得到一张地图:投机解码在 vLLM 里到底是谁在调谁、每类草稿模型对应什么类、验证用的拒绝采样是怎么做的、多步执行和 CUDA Graph 又怎么在这里相遇,以及它有哪些绕不开的限制。要理解算法原版,可参考站内 投机解码基础与 EAGLE 特征级草稿 和 DeepSeek 的 MTP 自带草稿。
一个重要的版本说明:本篇基于 vLLM 主分支的 V1 引擎(也就是你 pip install vllm 拿到的现代版本)来写。V0 时代 vllm/spec_decode/ 下的 SpecDecodeWorker、NgramWorker、EagleWorker、DraftModelWorker、MLPSpeculatorWorker 等类,在 V1 里被彻底重构,统一进了 vllm/v1/spec_decode/ 目录,以 SpecDecodeBaseProposer 为核心。后面所有路径都以 V1 为准。
背景:算法简单,框架难做
先花一小节把「为什么要实现它」和「实现它有多麻烦」讲清楚。
从「每一步一个 token」到「一个 batch 的草稿」
标准自回归解码是这样的:给定已生成的序列,模型前向一次,输出下一个 token 的概率分布,采样出 ,把它接到序列末尾,再前向一次…如此串行往复。每步之间严格依赖,无法并行。对 Transformer 而言,生成第 个 token 要重新算一遍整条序列的自注意力,计算量主要花在已经算过的 token 上——这就是解码阶段的算术强度(每 token 浮点 / 每 token 访存)很低、高度受限于 KV Cache 内存带宽的原因。
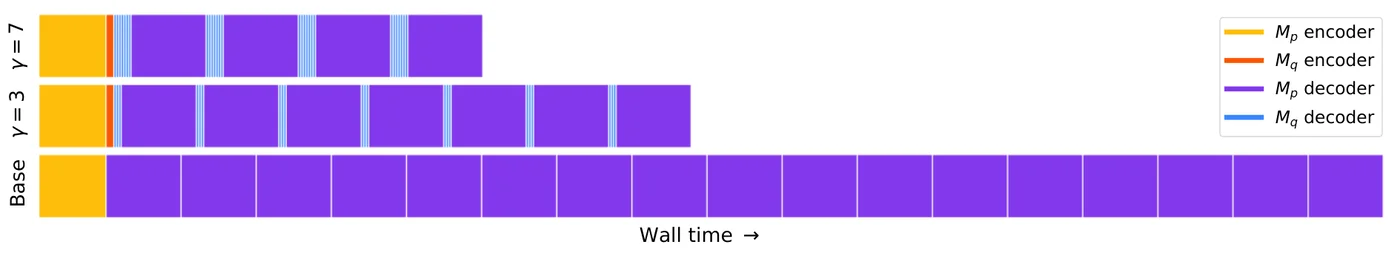
投机解码的思路(DeepMind 2022 那篇把它形式化)很反直觉:先让一个小得多的草稿模型(draft model)快速自回归地猜 个 token,组成一个长度为 的草稿序列;然后把这个草稿塞给目标模型,让目标模型一次前向,给出这 个位置各自的预测分布;最后从后往前逐 token 检查,能接受的保留、不能接受的从那个位置重新采样。 如图:
图里左上是一个小目标模型循环生成草稿 token,右侧是大目标模型对整条草稿做一次并行前向,下面是从后往前做「接受 / 拒绝」的验证。这张图来自 DeepMind 的那篇原始论文 Fast Inference from Transformers via Speculative Decoding。
为什么它能「无损」加速
关键在于接受准则。设草稿模型在某个位置给 token 的概率是 ,目标模型给的概率是 。我们抛一个均匀随机数 ,满足
就接受这个草稿 token;否则拒绝,并从调整后的分布
中重新采样一个 token 作为真正的输出。这个 就是「目标分布减去草稿分布在 处的那部分质量,再重新归一化」——直观上,如果草稿模型对某个 token 太有信心( 大),但目标模型并没那么认可( 小),那么这个 token 被接受的概率 就低;被拒绝后,我们把它「按草稿的过分自信量」剔除,再从剩余质量里采样,从而保证重采样后的边际分布恰恰等于目标分布 。这就是「无偏」(unbiased)的来源:只要草稿分布 与目标分布 一致或更激进,接受后得到的 token 分布与直接采样目标模型完全等价,代价只是多算了草稿的那几次便宜前向。
vLLM 在文档里给过一个形象的比喻:目标模型像一位严谨的教授,草稿模型像一个抢答的学生。学生先小声报一串答案,教授听一遍,认可的就点接受、不认可的当场指出并给出正确答案。因为大多数 token 其实很容易猜(“the”、“of” 这类高频词),教授一次前向就能「盖章」通过好几个 token——省下了原本要串行做的几次昂贵前向。
算法一页纸,工程十层楼
算法本身只有一张图(上面那张),但它在真实推理框架里落地时,几乎每一层都会遇到新问题:
- 草稿模型要能随时接入:vLLM 得支持 EAGLE(依赖目标模型的特征/hidden states)、独立的 draft LLM(有自己独立的 tokenizer 甚至词表)、Medusa 这种挂在目标模型边上的 MLP 头、以及 ngram 这种根本不加载模型的「伪草稿」。四种方式输入输出都不一样。
- 草稿 token 怎么进目标模型:草稿序列的 token 不能和普通请求一样处理,它要作为「待验证的候选」塞进目标模型的前向,得为它构造出并行验证所需的批展开(batch expansion)和注意力元数据。
- 验证怎么保证无偏:拒绝采样需要
draft_probs和target_logits两套分布,还要处理 greedy/随机采样、temperature/top-k/top-p 这些采样参数,外加一个「bonus token」的收尾处理。 - 多步草稿怎么和 CUDA Graph 合作:草稿模型通常要一次生成 个 token,这意味着它自己要多步自回归;而 CUDA Graph 要求固定的 batch shape,两者必须协同。
- KV Cache 和调度器怎么办:草稿 token 临时占用 KV 块,接受/拒绝后要回收;调度器要能感知「这批请求处于投机解码模式」。
- 限制:不是所有模型/并行配置都能投机解码,比如张量并行度、流水线并行、词表异构等,各有约束。
这就是本篇正文的主体。下面我们从「谁在调谁」的总架构开始,层层往下拆。
整体架构:SpecDecodeBaseProposer 与双角色
在 V1 里,投机解码不再是一个独立的 Worker,而是挂进 GPUModelRunner 主循环中的一个「提议者(Proposer)」对象。理解这一点最关键:目标模型的主循环(prefill/decode → 采样)是原有的,投机解码只是在它后面追加了一段「让草稿模型跑起来、再让目标模型验证」的逻辑。
主循环里插进来的一段
GPUModelRunner._execute_model_step() 的伪代码骨架大致是:
1. 目标模型 prefill / decode 前向一次 → target_logits2. 目标模型先做一次"第 0 个 token"的采样 (本来的自回归采样)3. if spec_config is set: a. 提取 target_hidden_states(EAGLE 要用的特征) b. proposer.prepare_next_token_ids_padded(...) # 准备草稿输入 c. proposer.propose(...) # 草稿模型生成 K 个候选 token d. proposer.prepare_next_token_ids_cpu(...) e. rejection_sampler(...) # 目标 logits 验证草稿4. 处理输出,更新请求状态注意第 2 步:目标模型本身仍然先生成一个 token。这个 token 是这条序列真正的、由 target logits 决定的输出(也是投机解码里「第 0 个接受 token」的基础),它同时作为草稿模型生成后续 个 token 的「上下文起点」(EAGLE 里更是直接把它的 hidden state 喂给草稿层)。可以认为:投机解码不是「跳过目标模型」,而是「目标模型每跑一次,顺带验证 个便宜草稿」。
Proposer:统一所有草稿方法的基类
V1 用 SpecDecodeBaseProposer(vllm/v1/spec_decode/llm_base_proposer.py,约 1900 行)这一个类统一了口径。它的 method 字段决定了具体走哪条草稿路,代码里通过 isinstance(model, (...)) 或 model_type 分派。它的职责很重:持有一个草稿模型(或者根本不持有模型,如 ngram)、负责多步自回归生成草稿、构建草稿的注意力元数据、对接 CUDA Graph。
几个关键字段(都来自 SpecDecodeBaseProposer.__init__):
| 字段 | 含义 |
|---|---|
self.method | "eagle" "eagle3" "mtp" "draft_model" "medusa" "ngram" "dflash" "dspark" 等,由 SpeculativeConfig 解析 |
self.num_speculative_tokens | 每次生成的草稿 token 数(,配置名 --num-speculative-tokens 或 num_speculative_tokens) |
self.pass_hidden_states_to_model | 是否把目标模型的 hidden states 传给草稿模型(EAGLE/MTP 为 True) |
self.parallel_drafting | 是否「一次前向并行生成全部草稿 token」(DFlash/DSpark) |
self.extra_slots_per_request | 每请求额外扩张的 padding slot 数(padded drafter batch 用) |
self.needs_extra_input_slots | 是否需要 pad 输入来满足 CUDA Graph 固定形状 |
self.cudagraph_dispatcher | CUDA Graph 分派器,根据 batch size 选图 |
self.draft_attn_groups | 草稿专用的注意力组(draft 有自己的 KV / attention 后端) |
不同草稿方法在 vLLM V1 里对应这些 Proposer(都在 vllm/v1/spec_decode/ 下):
| Proposer 类 | 文件 | 草稿来源 | 特点 |
|---|---|---|---|
EagleProposer | eagle.py | EAGLE / EAGLE3 特征层 | pass_hidden_states_to_model=True,依赖目标 hidden states |
DraftModelProposer | draft_model.py | 独立的小 LLM | 可启用异构词表映射 use_heterogeneous_vocab |
MedusaProposer | medusa.py | 目标模型边上的多个 MLP 头 | 每个 head 从一个 hidden state 预测一个后续 token,天然单次前向得到 个草稿 |
NgramProposer | ngram_proposer.py | 纯 CPU n-gram 匹配 | 不加载任何模型,用 KMP 变体找「历史里出现过的后缀」 |
SuffixDecodingProposer | suffix_decoding.py | 后缀解码 | 基于 prompt / KV 内容检索 |
ExtractHiddenStatesProposer | extract_hidden_states.py | KV/hidden 转移 | 跨模型复用特征 |
custom_class_proposer.py 的 create_custom_proposer() | — | 用户自定义 | 动态加载用户注册的 proposer 类 |
调度器与 KV:投机解码怎么融入既有框架
前面第三、四篇讲过的 Scheduler 和 KVCacheManager 在这里并没有被推翻,只是多了一层标记。InputBatch / SamplingMetadata 里会带上投机相关的字段(如 num_speculative_tokens、spec_decode_meta),调度器给投机请求正常分配 KV 块,只是 draft token 会被作为「临时占用」对待:如果这轮草稿 token 被拒绝,它的 KV 位置(spec_decode_meta 里的 slot mapping)会被标记成 PADDING_SLOT_ID(值 -1),下一轮就不会再读它。这正好呼应我们对 KV Cache「有借有还」的理解——草稿的 KV 是可以作废的临时空间。
我们把「谁调谁」串成一张总图(基于前面九篇的框架):
Scheduler.schedule ──> 产出本轮要执行的请求 + 分配 KV block │ ▼GPUModelRunner._execute_model_step │ ├─ (1) 目标模型前向 + 第 0 个 token 采样 │ ├─ 若启用了投机 ◄──── spec_config 存在 │ ├─ 提取 target hidden states (EAGLE/MTP) │ ├─ proposer.prepare_next_token_ids_padded(...) │ ├─ proposer.propose(...) ──> 草稿模型多步生成 K 个 token │ │ │ │ │ └─ 内部: CUDA Graph 分派 + set_forward_context + 多步循环 │ ├─ proposer.prepare_next_token_ids_cpu(...) │ └─ rejection_sampler(...) ──> 用 target logits 验证草稿 │ └─ 输出 accepted tokens,更新请求与 KV下面我们按这三段展开:草稿模型体系(propose 里到底谁在生成草稿)、验证与接受(rejection sampler 怎么做)、多步执行与 CUDA Graph(proposer 怎么把 K>1 跑起来)。
草稿模型体系:五种草稿怎么被统一
这一节回答「草稿从哪来」。我们重点讲三类:ngram(最简单、不加载模型)、draft_model(独立小模型)、EAGLE/MTP(依赖特征、最常用),以及简略提一下 Medusa。它们最终都收敛到同一个 propose() 入口。
NgramProposer:不加载任何模型
NgramProposer(vllm/v1/spec_decode/ngram_proposer.py)是投机解码里最「轻」的实现——它根本不加载草稿模型,而是在已生成的 token 串里找「历史中出现过的相同后缀」,把后缀后面紧跟的那段 token 当作草稿。思路与 prompt 缓存有相似之处:语言里很多片段会重复出现。
它的核心算法 _find_longest_matched_ngram_and_propose_tokens 是 KMP(Knuth-Morris-Pratt)字符串匹配算法的一个变体:
def _find_longest_matched_ngram_and_propose_tokens( origin_tokens, # 已生成的 token 序列 min_ngram, max_ngram, # 匹配的 n-gram 长度上下界,默认都是 5 max_model_len, k, # k = 要提议的 token 数) -> np.ndarray: # 1. 翻转 token 序列:tokens = origin_tokens[::-1] # 这样做的原因是我们要从"当前结尾"往前找共同后缀 # 2. 构造 lps(Longest Proper Prefix-Suffix)数组,长度上限 max_ngram # ——因为匹配段被 max_ngram 限制,只需要存前缀长度不超过 max_ngram 的 lps # 3. 在翻转后的序列里,找到长度落在 [min_ngram, max_ngram] 区间内的最长匹配后缀 # 4. 返回"匹配段之后"接下来 k 个 token 作为草稿为什么用翻转 + KMP?因为我们要找的是「当前序列的尾部后缀,在更早的历史里有没有出现过相同的」。把序列倒过来,就成了「当前序列头部的前缀」匹配问题,正好能套 KMP 的 lps 数组。匹配长度被 max_ngram 截断是为了省内存——lps 数组只需 max_ngram 长。
它从 SpeculativeConfig 读两个参数:
| 配置字段 | 命令行 | 默认 | 含义 |
|---|---|---|---|
prompt_lookup_min | --ngram-prompt-lookup-min | 5 | 接受为匹配的最小 n-gram 长度 |
prompt_lookup_max | --ngram-prompt-lookup-max | 5 | 匹配段的最大长度上限 |
num_speculative_tokens | --num-speculative-tokens | 必填 | 匹配成功后提议多少个 token() |
ngram 草稿有个明显的好处:为零成本,草稿前向的开销几乎可以忽略(纯 CPU 字符串查找,还能用 numba JIT 并行批量做)。但它只对「大量重复文本」(比如代码、格式化输出、对话模板)有效,对自由文本效果很差,所以实际生产用得多的还是模型类草稿。
DraftModelProposer:独立的草稿 LLM
DraftModelProposer(vllm/v1/spec_decode/draft_model.py)对应用一个小得多的、独立的 LLM 当草稿模型的场景。这是最直观的投机解码形态:小模型算得快,猜 个 token,大模型验证。
它有两个值得一提的点:
第一,草稿模型的 token 不共享目标模型的注意力/词表。 小模型和大模型往往是两个不同的 tokenizer。于是 DraftModelProposer 支持异构词表(heterogeneous vocab):当 use_heterogeneous_vocab=True 时,会构建一个 VocabMapping(vllm/v1/spec_decode/vocab_mapping.py),在两个 tokenizer 的 token id 之间做双向映射。vLLM 用了一个叫 TLI(Token-Level Intersection) 的思路:只让草稿 logits 在「两个词表都共享的 token」上计算,避免把「草稿词表里的 token id」直接当成「目标词表里的 token id」用导致错位。
第二,张量并行度有硬约束。 代码里有 _raise_if_draft_tp_mismatch():
def _raise_if_draft_tp_mismatch(self, draft_tp_size: int) -> None: target_tp_size = self.vllm_config.parallel_config.tensor_parallel_size if draft_tp_size != target_tp_size: raise ValueError( "draft_tensor_parallel_size ... 必须与目标模型的 " "tensor_parallel_size 一致 ..." )原因与 torch.compile 缓存、以及验证阶段要把草稿 logits 和 target logits 对齐有关——TP 不一致会让通信分片对不上。这是我们后面「局限」一节的重要一条。
EagleProposer:依赖目标模型特征的草稿
EagleProposer(vllm/v1/spec_decode/eagle.py)是社区里最常用的草稿方法,对应 EAGLE/EAGLE3(以及 DeepSeek 系的 MTP)。它和前面的最大区别是 pass_hidden_states_to_model=True:
class EagleProposer(SpecDecodeBaseProposer): def __init__(self, vllm_config, device, runner=None): super().__init__( vllm_config, device, pass_hidden_states_to_model=True, runner=runner, )EAGLE 的核心洞察是:与其用一个小模型去猜「下一个 token 是什么」,不如把目标模型已经算好的 last hidden state 也喂给草稿层,让草稿层去学习「给定特征,下一步最可能是谁」。这样草稿模型只需做一次额外的低维映射,质量远高于从零猜。所以 EAGLE 需要一个「特征注入」的通道——target_hidden_states 必须从目标模型最后一层提取出来传给草稿模型。这一点直接体现在 propose() 里:
if self.method in ("eagle3", "dflash"): model = ... # 解包 BreakableCUDAGraphWrapper assert isinstance(model, (Eagle3LlamaForCausalLM, ...)) target_hidden_states = self.model.combine_hidden_states(target_hidden_states) assert target_hidden_states.shape[-1] == self.hidden_sizeEAGLE3 更进一步,支持 use_aux_hidden_state:不只从最后一层,还能从中间若干层提取特征(eagle_aux_hidden_state_layer_ids 配置)。站内的 EAGLE 系列文章 把特征级草稿、树验证、EAGLE-2/3 演进讲得很透了,这里我们只关注 vLLM 怎么把它装进去:核心就是「提取目标 hidden state → 拼进草稿输入 → 草稿模型前向」。
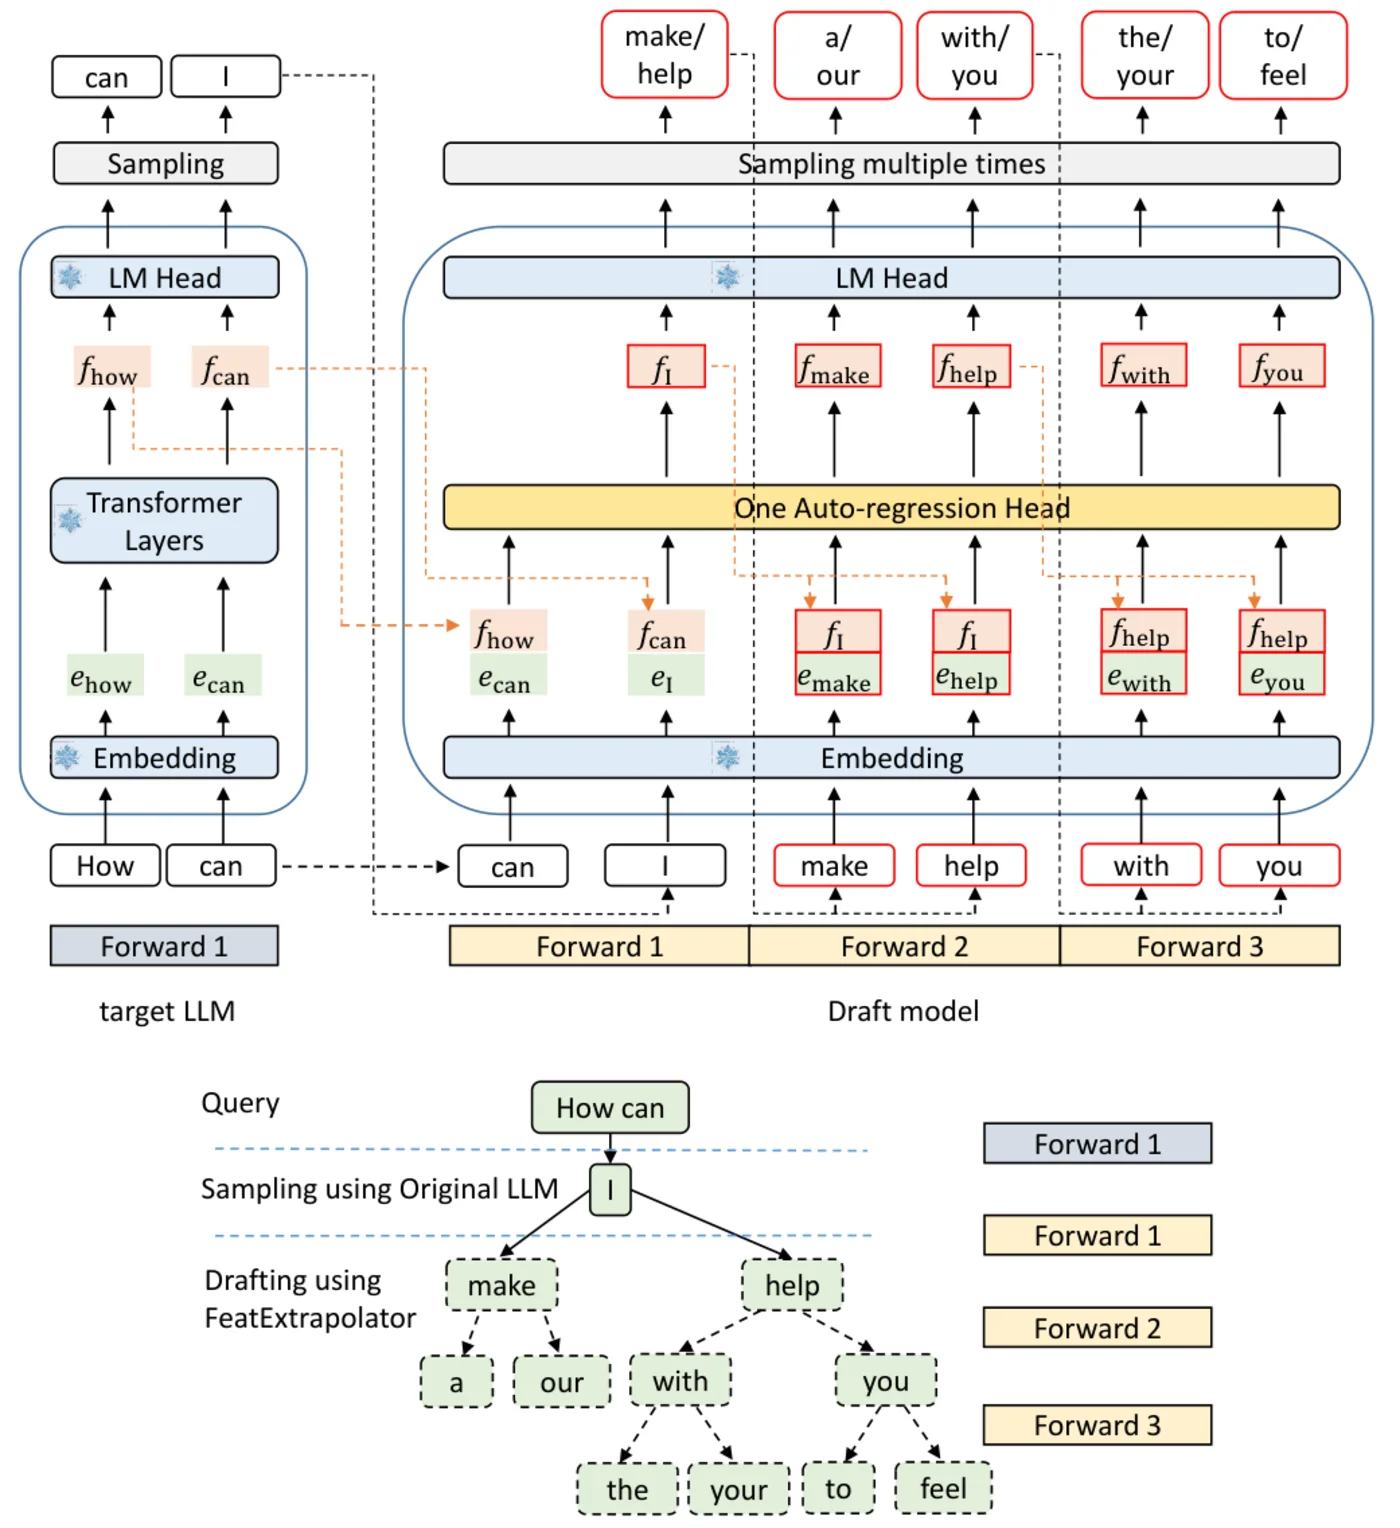
这张图来自 EAGLE 原始论文,展示了「草稿层(draft layer)」如何叠在目标模型最后一层隐藏状态之上做低维映射来预测下一 token:训练时(上图)草稿层用目标模型的特征做监督学习,解码时(下图)把上一轮已接受 token 的特征继续喂给草稿层,让它多步生成草稿序列。vLLM 的 EagleProposer 正是把「提取最后一层 hidden state」这一环接进了主循环。
MTP(Multi-Token Prediction)在 vLLM 里也走 EAGLE 这条路:DeepSeek-V3/V4 等模型的 model_type 落在 MTPModelTypes 这个 Literal 里(deepseek_mtp、qwen3_5_mtp、minimax_m3_mtp、glm4_moe_mtp、pangu_ultra_moe_mtp 等 20 多种),SpeculativeConfig.__post_init__ 会自动把 method 识别为 "mtp",然后用 EAGLE 风格的 EagleProposer(实际上是同一套 Proposer 逻辑)加载这些预训练好的 MTP 头。
MedusaProposer:并行的多个头部
MedusaProposer(vllm/v1/spec_decode/medusa.py)对应 Medusa 那类方法:不用额外的 LLM,而是在目标模型最后一层 hidden state 上挂多个小 MLP 头,每个头负责预测「往后第 个 token」,所以一次前向就能给出全部 个草稿 token:
class MedusaProposer: def propose(self, num_speculative_tokens, target_hidden_states, ...): blocks = self.model(target_hidden_states) # 多个 MLP head 并行 logits = self.model.compute_logits(blocks) draft_tokens = torch.stack( [logit.argmax(dim=-1) for logit in logits], dim=1 ) return draft_tokens # [batch_size, num_heads]它有个限制:如果目标是 MoE 模型且开启了 EPLB(Expert Parallel Load Balancing),Medusa 不被支持(medusa.py 里有对应的断言)。这属于「草稿方法 × 调度特性」的组合限制。
方法自动检测:你只需给个模型名
用户层面,vLLM 让这一切尽量「零配置」。SpeculativeConfig.__post_init__(vllm/config/speculative.py)会根据草稿模型的名字 / HF config 的 model_type自动推断 method,判断顺序大致是:
模型名/type 含 "eagle3" → method = "eagle3"模型名含 "dflash" / "dspark" → method = "dflash" / "dspark"hf_config.model_type == "medusa" → method = "medusa"model_type ∈ MTPModelTypes → method = "mtp" (deepseek_mtp, qwen3_5_mtp ...)model_type == "mlp_speculator" → method = "mlp_speculator"其他(例如单独给一个小模型路径) → method = "draft_model"(或 "ngram",当指定 `--speculative-method ngram` 时)所以典型用法是:vllm serve <target_model> --draft-model <draft_model_or_eagle_ckpt> --num-speculative-tokens 5,框架自行判断该用 EAGLE 还是独立草稿模型。ngram 则是 --speculative-method ngram --num-speculative-tokens 5,不需要 --draft-model。
我们把「草稿从哪来」这五种方式总结成下表:
| 方法 | 草稿模型形态 | 特征注入 | 一次前向产出 K 个? | 典型场景 |
|---|---|---|---|---|
| ngram | 无(CPU 查找) | 否 | 否(查找) | 重复文本、零成本 |
| draft_model | 独立小 LLM | 否 | 否(多步) | 通用、可异构词表 |
| EAGLE/EAGLE3 | 特征层 | 是 | 否(多步) | 社区最常用 |
| MTP | 目标模型自带头 | 是 | 否(多步) | DeepSeek-V3/V4、Qwen3.5 等 |
| Medusa | 目标模型旁 MLP 头 | 是(hidden state) | 是 | 免加载草稿模型 |
验证:批量展开、注意力元数据与拒绝采样
草稿生成好了,接下来是整条流水线最精密的一段:把草稿 token 组织成目标模型能并行验证的输入。这节分三步讲:批展开(batch expansion)、注意力元数据(attention metadata / slot mapping)、以及拒绝采样(rejection sampling)本身。
Batch Expansion:从「序列」到「并行验证的批」
草稿模型提议的是每个请求一条长度为 的候选序列。要让目标模型一次性验证这 个位置,vLLM 必须把这些候选 token「摊平」成一个更大的 token 批,让目标模型对所有请求 × 所有草稿位置做一次前向。
关键方法在 llm_base_proposer.py:
set_inputs_first_pass(...):构造第一次草稿前向的输入。对needs_extra_input_slots=False的方法(主要是 EAGLE,因为它不额外 pad,直接 shift input_ids + 插入 next token),输入相对规整;对needs_extra_input_slots=True的方法(draft_model、并行 drafting),需要调用 Triton kernel_copy_and_expand_eagle_inputs()做输入展开,并给每个 request 补extra_slots_per_request个 padding slot。prepare_inputs_padded(...)/prepare_next_token_ids_padded(...):把「下一步的 token id」预展开成 padding 的形状。
所谓 padded drafter batch,是 V1 为了驯服 CUDA Graph 做的选择:把每个 request 的草稿输入都 pad 到相同长度,这样每次前向的输入形状固定,能被 CUDA Graph 捕获。代价是多算一些 padding slot——在 compute_new_slot_mapping 里,被拒绝的 token 位置会被置为 PADDING_SLOT_ID(-1),表示「这个 KV slot 不用再读了」。
展开时对 padding slot 的处理很关键:is_rejected_token_mask 和 is_masked_token_mask 两个 mask 跟踪哪些位置是真实草稿、哪些是 padding。被 mask 掉的位置不会贡献最终 logits(我们后面会看到 SpecDecodeMetadata 专门记录哪些 logits 是「要采样的 target 位置」)。
SpecDecodeMetadata:验证阶段的「索引地图」
验证阶段需要的所有对齐信息,都打包在一个 SpecDecodeMetadata dataclass(vllm/v1/spec_decode/metadata.py)里:
@dataclassclass SpecDecodeMetadata: draft_token_ids: torch.Tensor # [num_tokens] 所有摊平的 draft token num_draft_tokens: list[int] # [batch] 每个 request 的草稿 token 数(K_i) cu_num_draft_tokens: torch.Tensor # [batch] 草稿数量的前缀和 cu_num_sampled_tokens: torch.Tensor # [batch] 前缀和(含 bonus 数) target_logits_indices: torch.Tensor # [num_tokens] target logits 的取址索引 bonus_logits_indices: torch.Tensor # [batch] bonus token 的 logits 索引 logits_indices: torch.Tensor # [num_tokens + batch] 合并索引 max_spec_len: int # max(num_draft_tokens)cu_num_draft_tokens 这个前缀和数组是整段的枢纽:它像一个「分组指针」,让我们能在摊平的 token 串 [req0_tok0, req0_tok1, ..., req1_tok0, ...] 里,高效地知道每个 request 的草稿 token 落在哪个区间。V0 时代用 Trie 树来组织树形注意力的父子关系;V1 的 padded drafter batch 则直接用这个前缀和来索引,不再需要 Trie。
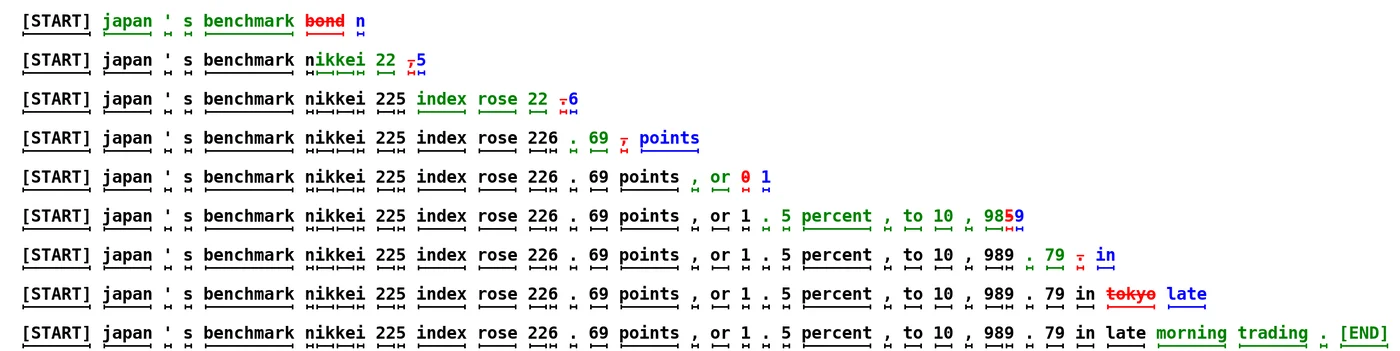
上面这张 trace 图同样来自 DeepMind 那篇原始论文:它以一条真实草稿序列为例,从左到右画出「草稿模型提议 → 目标模型验证 → 逐位置 accept / reject → 拒绝处 recovered」的完整时间线。最上面是草稿 token,中间是目标模型对每个位置的检查,下面标出最终保留下来的接受序列——能直观对应后面要讲的拒绝采样器逻辑。
拒绝采样:RejectionSampler 的两个分支
验证真正发生的地方是 RejectionSampler(vllm/v1/sample/rejection_sampler.py)。它是个 nn.Module,forward 大体分四步:
-
Bonus token:从 target logits 的「序列最后位置」再采一个额外 token(
bonus_logits_indices对应)。为什么需要 bonus? 因为我们一共提议了 个草稿,理论上可能全部被接受——那样这轮就只「消费」了 个草稿 token 而没有真正产出目标模型的 token。为了补齐这一格(让每轮至少前进一步、避免死锁),在全部接受时追加一个由目标模型亲自采样的 token。这就是 bonus 的由来。 -
Target logits 提取与预处理:用
target_logits_indices从目标模型整块 logits 里把「每两个相邻草稿之间该验证的那个位置」的 logits 抠出来,然后施加采样约束(temperature、top-k、top-p),再应用 logits processor(penalty 等)。注意这里要处理num_draft_tokens的重复展开——比如一个 request 有 个草稿,那么它的温度/penalty 参数也要重复 次(expand_batch_to_tokens)。 -
拒绝采样主体(
rejection_sample)分两套 kernel:- greedy 路径(
rejection_greedy_sample_kernel):对所有「贪婪采样」的请求,直接比较draft_token_id == target_argmax_id。相同就接受,不同就拒绝并记下那个位置。不需要算概率。 - 随机路径(
rejection_random_sample_kernel):对做随机采样的请求,按论文的无偏准则,逐位置比较target_probs / draft_probs >= uniform,被拒绝的位置用一个「重采样 token(recovered token)」顶上。
- greedy 路径(
-
parse_output:把
output_token_ids(初始填PLACEHOLDER_TOKEN_ID即-1)里真正有效的 token 过滤出来,转成list[list[int]]返回。
我读源码时截取到的主流程伪代码,正好能对应上面四步:
def rejection_sample(draft_token_ids, num_draft_tokens, max_spec_len, cu_num_draft_tokens, draft_probs, target_logits, bonus_token_ids, sampling_metadata, ...): # 输出 buffer: [batch, max_spec_len + 1](+1 留给 bonus),用 -1 占位 output_token_ids = torch.full((batch_size, max_spec_len + 1), PLACEHOLDER_TOKEN_ID)
# A. 需要 uniform 随机数(synthetic 模式 / 非全 greedy 时) uniform_probs = generate_uniform_probs(...)
# B. greedy 请求:直接比 argmax if not sampling_metadata.all_random: target_argmax = target_logits.argmax(dim=-1) _rejection_greedy_sample(output_token_ids, ...)
# C. 随机请求:先算 target 概率分布,采样 recovered tokens target_probs = target_logits.softmax(dim=-1, dtype=torch.float32) recovered_token_ids = sample_recovered_tokens(...)
# D. 随机拒绝采样 kernel,把 accepted/recovered/bonus 装配进输出 _rejection_random_sample(output_token_ids, ...)Greedy kernel:逐 token 比较
greedy 版本对应 rejection_greedy_sample_kernel 这个 Triton kernel,对每个 request(一个 program),从 cu_num_draft_tokens 推出 start_idx / end_idx,然后在这段里逐 position 比较:
@triton.jitdef rejection_greedy_sample_kernel(...): req_idx = tl.program_id(0) start_idx, end_idx = ... # 从 cu_num_draft_tokens[req_idx] 算 num_draft_tokens = end_idx - start_idx rejected = False for pos in range(num_draft_tokens): if not rejected: draft_id = tl.load(draft_token_ids_ptr + start_idx + pos) target_id = tl.load(target_argmax_ptr + start_idx + pos) rejected = (draft_id != target_id) # 一看到不一致就停 tl.store(output_token_ids_ptr + ..., target_id) # 若全部接受(没 rejected),追加 bonus token if not rejected: bonus = tl.load(bonus_token_ids_ptr + req_idx) tl.store(output_token_ids_ptr + ..., bonus)注意那个 rejected 标志:一旦遇到第一个不一致的 token,后面的草稿全部作废(这是投机解码的正确性要求——如果第 3 个 token 被拒绝,第 4 个 token 本身也是基于错误的上下文猜的,不能再用)。但 greedy 路径里,被接受的那些位置输出的是 target_argmax(而不是草稿 token),因为 target argmax 才真正代表「目标模型的决策」。只有全部接受时才需要 bonus token 来「补一格」。
Random kernel:无偏接受 + 重采样
随机路径对应 rejection_random_sample_kernel,它实现的就是我们背景小节里那两个公式:
- 接受:
uniform < target_prob / draft_prob; - 拒绝:从调整后的分布重采样一个
recovered_token_id。
sample_recovered_tokens 用到一个技巧:标准的多项式采样可以用「指数分布随机数求 argmax」来实现(Gumbel 思想的变体)。它给每个位置生成独立的指数随机数 ,对每个候选 token 算 adjusted_prob * (1/q),取 argmax 就等价于「从 adjusted 分布采样」。adjusted prob 的分量是:
也就是把目标分布里「草稿 token 那一格」的质量整个剔除(因为那个 token 已经在这轮被判断为不接受了),再归一化。这保证了重采样不会又采回那个被拒的草稿 token,且最终分布无偏。
关于 synthetic / block 验证模式
rejection_sample_method 除了默认的 standard,还有两档:
synthetic:给每个位置预设一个「合成接受率」synthetic_acceptance_rates(必须单调非增),直接用uniform < rate接受草稿,不依赖真实的 target probs。它用于在还没有真实草稿模型时模拟评估(比如做实验/基准测算),不是生产用法。block:块验证(Block verification),按 Sun 等人的 Block Verification Accelerates Speculative Decoding,一次性联合验证整段草稿块而不是逐 token,可以省掉部分概率比较。
多步执行与 CUDA Graph
前面提到 num_speculative_tokens > 1 时,除了 Medusa/DFlash 这类「单次前向出 K 个」的方法,EAGLE 等需要草稿模型自己多步自回归:第 1 个草稿 token 定了,才能基于它推第 2 个。这就引出了「proposer 内部的多步循环」。
propose() 的多步循环
SpecDecodeBaseProposer.propose() 的骨架(我在源码里核对过)大致是:
def propose(self, num_speculative_tokens, target_token_ids, target_positions, target_hidden_states, next_token_ids, ...): # —— Step 0:第一次前向 —— num_tokens, token_indices_to_sample, common_attn_metadata = ( self.set_inputs_first_pass(target_token_ids=target_token_ids, next_token_ids=next_token_ids, ...)) per_layer_attn_metadata = self.build_per_group_and_layer_attn_metadata(...) cudagraph_runtime_mode, ... = self._determine_batch_execution_and_padding(num_tokens)
with set_forward_context(per_layer_attn_metadata, self.vllm_config, cudagraph_runtime_mode=...): last_hidden_states, hidden_states = self.model(**model_kwargs) # 草稿第 1 步
# K==1 或并行 drafting:一次前向即可,直接采样后返回 if self.num_speculative_tokens == 1 or self.parallel_drafting: draft_token_ids, draft_probs = self._sample_draft_tokens( last_hidden_states[token_indices_to_sample], sampling_metadata) return draft_token_ids.view(-1, K)
# —— Step 1..K-1:逐步自回归 —— draft_token_ids_list = [] for token_index in range(self.num_speculative_tokens - 1): positions = self._update_positions_dependent_metadata(...) # 更新位置 # 用 draft_index 感知重建注意力元数据(每个 step 位置不同) _, per_layer_attn_metadata = self.build_per_group_and_layer_attn_metadata( common_attn_metadata, draft_index=token_index + 1) # 把上一步的 input_ids / hidden_states 拷进 CUDA Graph buffer self.input_ids[:batch_size] = input_ids self.hidden_states[:batch_size] = hidden_states with set_forward_context(...): ret_hidden_states = self.model(**model_kwargs) # 草稿第 N 步 draft_token_ids, draft_probs = self._sample_draft_tokens( last_hidden_states[:batch_size], sampling_metadata) draft_token_ids_list.append(draft_token_ids) return torch.stack(draft_token_ids_list, dim=1) # [batch, K]几个要点:
draft_index:每一步的位置/attention 元数据都不同(第 步的草稿 token 只 attend 到它前面的 token),所以多步循环里要按draft_index重建 attention metadata,而不是复用第 0 步的。- 中间状态存哪:V1 把多步所需的中间
hidden_states、input_ids、positions、两个 mask 都作为SpecDecodeBaseProposer的预分配 buffer 持久保存(__init__里按max_num_tokens分配),循环里就地更新,而不是每次新建张量——这是为了减少分配、贴合 CUDA Graph 的固定地址要求。 _sample_draft_tokens:每步从前一步的 hidden state 采样出下一个草稿 token,draft_sample_method控制是greedy(始终 argmax,速度最快)还是probabilistic(从分布随机采样,能拿到完整的draft_probs供随机拒绝采样做概率比)。
CUDA Graph 在投机解码里怎么工作
前面第七、九篇讲过 CUDAGraph 需要固定的 batch shape。草稿模型的多步前向天然和这个冲突:每一步的输入长度都在变。vLLM 的处理是靠两个动作:
_determine_batch_execution_and_padding:在每次草稿前向之前,根据当前num_tokens算出该用哪个 CUDA Graph(cudagraph_runtime_mode可以是PIECEWISE等),并把 batch pad 到图要求的形状。这就是 padded drafter batch 的用武之地。CudagraphDispatcher/initialize_cudagraph_keys/dummy_run:捕获阶段跑一次空转(dummy_run)来把形状固定下来;CudagraphDispatcher根据 batch size 分派到正确的图。
有意思的是,多步循环里对 is_graph_capturing or self.parallel_drafting 走的是「只 forward 一次」的简化路径——因为捕获阶段只需要一步的形状;正常执行时才循环 K-1 次。这避免了在捕获阶段重复展开。
KV Cache 与位置在每一步的更新
多步草稿的 KV Cache 管理是另一个重点。每生成一个草稿 token,都会给它分配一个 KV slot;但如果这个 token 后面被拒绝,它的 KV 就浪费了。vLLM 用 _update_positions_dependent_metadata 和 compute_new_slot_mapping 这两个工具函数来动态更新 slot mapping:被拒绝的草稿位置 → PADDING_SLOT_ID(-1),不会再分配/读取。这样草稿 KV 是一个「可回滚的临时区」。
调度与配置:怎么打开、怎么选参
前面拆了实现,这节落到用户视角:你从命令行怎么开启、各参数选什么。
最小启用法
用独立草稿模型:
vllm serve meta-llama/Meta-Llama-3-8B-Instruct \ --draft-model JackFram/llama-68m \ --num-speculative-tokens 5用 EAGLE 草稿(需要一个带 EAGLE 权重/映射的 checkpoint):
vllm serve meta-llama/Meta-Llama-3-8B-Instruct \ --draft-model Yuhuili/EAGLE-LLaMA3-Instruct-8B \ --num-speculative-tokens 5用 ngram(不加载草稿模型):
vllm serve meta-llama/Meta-Llama-3-8B-Instruct \ --speculative-method ngram \ --num-speculative-tokens 5 \ --ngram-prompt-lookup-max 5关键参数(对应 SpeculativeConfig 字段):
| 配置字段 | 命令行 | 含义 |
|---|---|---|
method | --speculative-method | ngram / draft_model /(EAGLE 等由模型名自动推断) |
model(draft 模型路径) | --draft-model | 草稿模型或 EAGLE checkpoint |
num_speculative_tokens | --num-speculative-tokens | 每次提议的草稿 token 数 |
prompt_lookup_min/max | --ngram-prompt-lookup-min/max | ngram 匹配长度(默认 5) |
draft_tensor_parallel_size | --draft-tensor-parallel-size | 草稿模型的 TP 度(必须等于目标 TP) |
rejection_sample_method | --rejection-sample-method | standard / synthetic / block |
draft_sample_method | --draft-sample-method | greedy / probabilistic |
use_heterogeneous_vocab | --use-heterogeneous-vocab | 异构词表映射(draft_model) |
num_speculative_tokens_per_batch_size | — | 按 batch size 动态调整 (dynamic SD) |
Dynamic SD:按 batch size 调 K
SpeculativeConfig 里有个 num_speculative_tokens_per_batch_size(格式 [(range_start, range_end, K), ...]),对应 dynamic speculative decoding:batch 很大时,模型利用率已经很高,再投机收益不大,可以调小 甚至到 0;batch 小时,decode 是内存瓶颈,投机收益大,调大 。vllm/v1/spec_decode/dynamic/utils.py 里的 build_dynamic_sd_schedule_lookup 会把这组区间编译成一个 O(1) 的 dense_schedule[batch_size] → K 查表。
配置校验与常见报错
_verify_args() 做了不少约束检查,常见的:
synthetic_acceptance_rates与synthetic_acceptance_length互斥,且 rates 必须单调非增。use_heterogeneous_vocab=True时,draft_sample_method必须为greedy,且只对method="draft_model"有效。draft_tensor_parallel_size必须等于目标tensor_parallel_size。- DeepSeek-V4.1 的 checkpoint 不含经典 MTP 权重,必须用
dspark而不是mtp(这是模型侧的特殊情况)。
局限与权衡
投机解码在 vLLM 里功能齐全,但有几条硬性限制值得记住(也是框架设计取舍的体现):
| 限制 | 说明 | 原因 |
|---|---|---|
| 流水线并行(PP)不支持 | 代码多处 get_pp_group() 检查 | 投机解码的多步草稿 + 验证与 PP 的流水阶段错位复杂 |
| 张量并行度必须一致 | draft_tensor_parallel_size == tensor_parallel_size | 草稿 logits 与 target logits 要对齐分片 |
| 异构词表仅 greedy + draft_model | use_heterogeneous_vocab 组合约束 | 概率模式跨词表映射的 probs 还没实现(有 TODO) |
| M-RoPE 不支持 padded batch | _raise_if_mrope 在 needs_extra_input_slots 时抛 NotImplementedError | 多维位置编码与扩展输入的复杂交互 |
| 多模态支持有限 | _warn_if_multimodal 只是警告,主要面向 text-only SD | 视觉编码部分未与草稿流水线耦合 |
| EPLB 不支持 Medusa | is_mixture_of_experts and enable_eplb → 报错 | MoE 负载均衡与 Medusa 头的交互未实现 |
| 概率化草稿采样尚未完全启用 | _enable_probabilistic_draft_probs 需要 standard + probabilistic,但 draft_probs 内存管理有未完成处 | 社区仍在演进 |
另外几点权衡,不是「限制」但选了就要明白代价:
- K 太小没收益,太大浪费。 的收益曲线不是单调的——草稿 越大,验证成本越高,一旦接受率不高反而拖慢。所以有 dynamic SD 去自适应。
- 草稿模型本身占显存。EAGLE 特征层很轻,但一个独立 draft LLM 会显著增加显存占用和加载开销;这也是为什么 ngram(零显存)和 Medusa(共用目标模型参数)有它们的生存空间。
- bonus token 与拒绝位置的衔接:投机解码能「无损」的前提是草稿分布 与目标分布 关系合理;如果草稿太激进、接受率极低,那额外多算的草稿前向和验证前向就都是浪费——速度甚至更慢。vLLM 会把投机解码的接受率等指标通过 Prometheus 暴露出来(对应
vllm/v1/spec_decode/metrics.py里的SpecDecodingProm),生产环境可以据此观测草稿质量,而不必手工猜 K 是否合适。
与站内其他文章的衔接
投机解码是站内覆盖面很广的话题,这里帮你把「算法」和「框架」两套知识接起来:
- 算法基础与 EAGLE:想知道 EAGLE 特征级草稿为什么效果好、树验证怎么加速接受,读 EAGLE 完全拆解,以及 EAGLE-2 动态草稿树 和 EAGLE-3。
- DeepSeek 的自带草稿:vLLM 支持的 MTP 方法,对应 DeepSeek-V3 的共享主干多头预测,详见 MTP 完全拆解;它对 KV Cache 的极致压缩背景见 V4.1-Flash 的 KV 压缩。
- 投机解码与内存/带宽:投机解码本质是「用计算换内存带宽」,这个视角在 信息论与熵 里有讲(投机解码如何用熵度量草稿收益)。
- 框架里的相邻模块:本篇是 vLLM 系列的第十篇。投机解码要依赖你在前几篇已经掌握的 调度器、KVCacheManager、GPUModelRunner 输入构造、PagedAttention Kernel 这些知识。下一层你可以继续深入 vLLM 的「多模态输入」「前缀缓存命中」等,它们与投机解码共同构成 V1 引擎的完整拼图。
小结
投机解码在 vLLM V1 里不是一个新的独立 Worker,而是挂在 GPUModelRunner 主循环后面的一段 Proposer + RejectionSampler 流水线。本文的核心结论可以浓缩成几点:
- 统一抽象是
SpecDecodeBaseProposer:它用一个基类 +method字段,把 ngram(零模型)、draft_model(独立小模型)、EAGLE/MTP(依赖特征)、Medusa(并行多头)这几种形态完全不同的草稿统一进同一个propose()入口。 - 目标模型仍然每轮前向一次:投机解码是「目标模型验证草稿」,而不是「跳过目标模型」。目标模型先给自己采第 0 个 token,再用同一块 logits 验证草稿。
- 验证靠
RejectionSampler:greedy 直接比 argmax,随机路径按target/draft >= uniform无偏接受、拒绝处用调整分布重采样,全接受时补一个 bonus token 避免死锁。 - 多步草稿 + CUDA Graph 靠 padded drafter batch 协同:把每个 request 的草稿输入 pad 到固定形状,用
SpecDecodeMetadata的前缀和索引对齐,被拒绝位置的 KV 标成PADDING_SLOT_ID回收。 - 限制主要在与并行/特性组合:PP 不支持、TP 必须一致、异构词表仅 greedy、M-RoPE/multimodal/EPLB 各有约束。
弄懂这条流水线,你就理解了一个大型推理框架为「一个在数学上无偏、但工程上充满中间状态」的加速技巧做了多少抽象工作。这也是 vLLM 这类框架的价值所在:让用户只需要 --draft-model X --num-speculative-tokens 5,剩下的批展开、元数据、CUDA Graph、KV 回滚全部由框架替你搞定。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


