


DeepSeek-V4.1-Flash 推理侧完全拆解:890 字节/token 的 KV Cache 是怎么压出来的
一个被 Agent 改变的账单结构
2026 年 9 月 10 日,DeepSeek-AI 发布了 DeepSeek-V4.1-Flash,同时公开了 51 页的技术报告《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》。报告的标题就把主题写死了:推 KV Cache 压缩的极限。这不是一次常规的模型迭代——552B 骨干参数的 MoE 模型,1M token 上下文,但真正的主角是那个副标题。
先把基本盘放在这里:40 层语言骨干、552B 骨干参数(相比 V4-Flash 的 284B 几乎翻倍),另有 196B 的 Engram 条件记忆参数,官方模型卡给出的含视觉编码器的总规模约 763B;原生 1M token(1,048,576 位置)上下文、最高 384K 输出;权重以 MIT 许可、免申请(ungated)的方式公开。放在 DeepSeek 自己的演进线上看,这是一次典型的「同代重构」——参数涨了,推理侧的存储与带宽反而全面下降(三年脉络见本站 DeepSeek 技术全景)。
也先交代本文的取材边界:压缩比与效率数字来自技术报告与官方模型卡,定价、实测与生态信息来自发布之后的社区与媒体报道,两类来源的可信度不同,文中会逐处标注。报告本身的论证已经足够精彩,但只读报告,会漏掉这套压缩真正落到账单上时发生的另一半故事——那部分在第九节。
要理解 DeepSeek 为什么把整个架构围绕 KV Cache 重做一遍,得先看工作负载发生了什么变化。
长时程智能体(long-horizon agent)把推理负载从「输出重」改成了「输入重」。一个典型的编码 agent 会话是这样的:读进一个几万 token 的代码仓库前缀、若干次工具调用的返回值、上一轮的完整对话历史;然后模型只吐几十到几百个 token 的补丁或命令。下一轮,前缀变长了一点,整个流程重来一遍。
这个模式对推理系统提出了两个与以往截然不同的要求:
- Prefill 反复发生。每一轮工具调用都可能打破前缀缓存(prefix cache),迫使引擎重新计算整段上下文。在传统的「输入短、输出长」负载里,prefill 成本可以被摊薄;在 agent 负载里它变成了主导项。
- KV Cache 必须被持久化、复用和搬运。前缀缓存要跨会话保存,要在节点间迁移,要在 SSD 和主机内存之间换入换出。KV 不再只是「显存里的一块临时缓冲」,而是一份需要长期驻留、持续占用容量和带宽的一等数据资产。
报告把这个转变的后果总结得很直接:稀疏注意力等此前的进展已经把长序列的计算成本压下去了,于是持久存储与数据搬运顺理成章地浮上来,成为新的主导瓶颈。换句话说,算力已经不是最贵的那一项了。
而 KV Cache 的体量有多大?报告给出的代际对比数字值得单独看一眼。
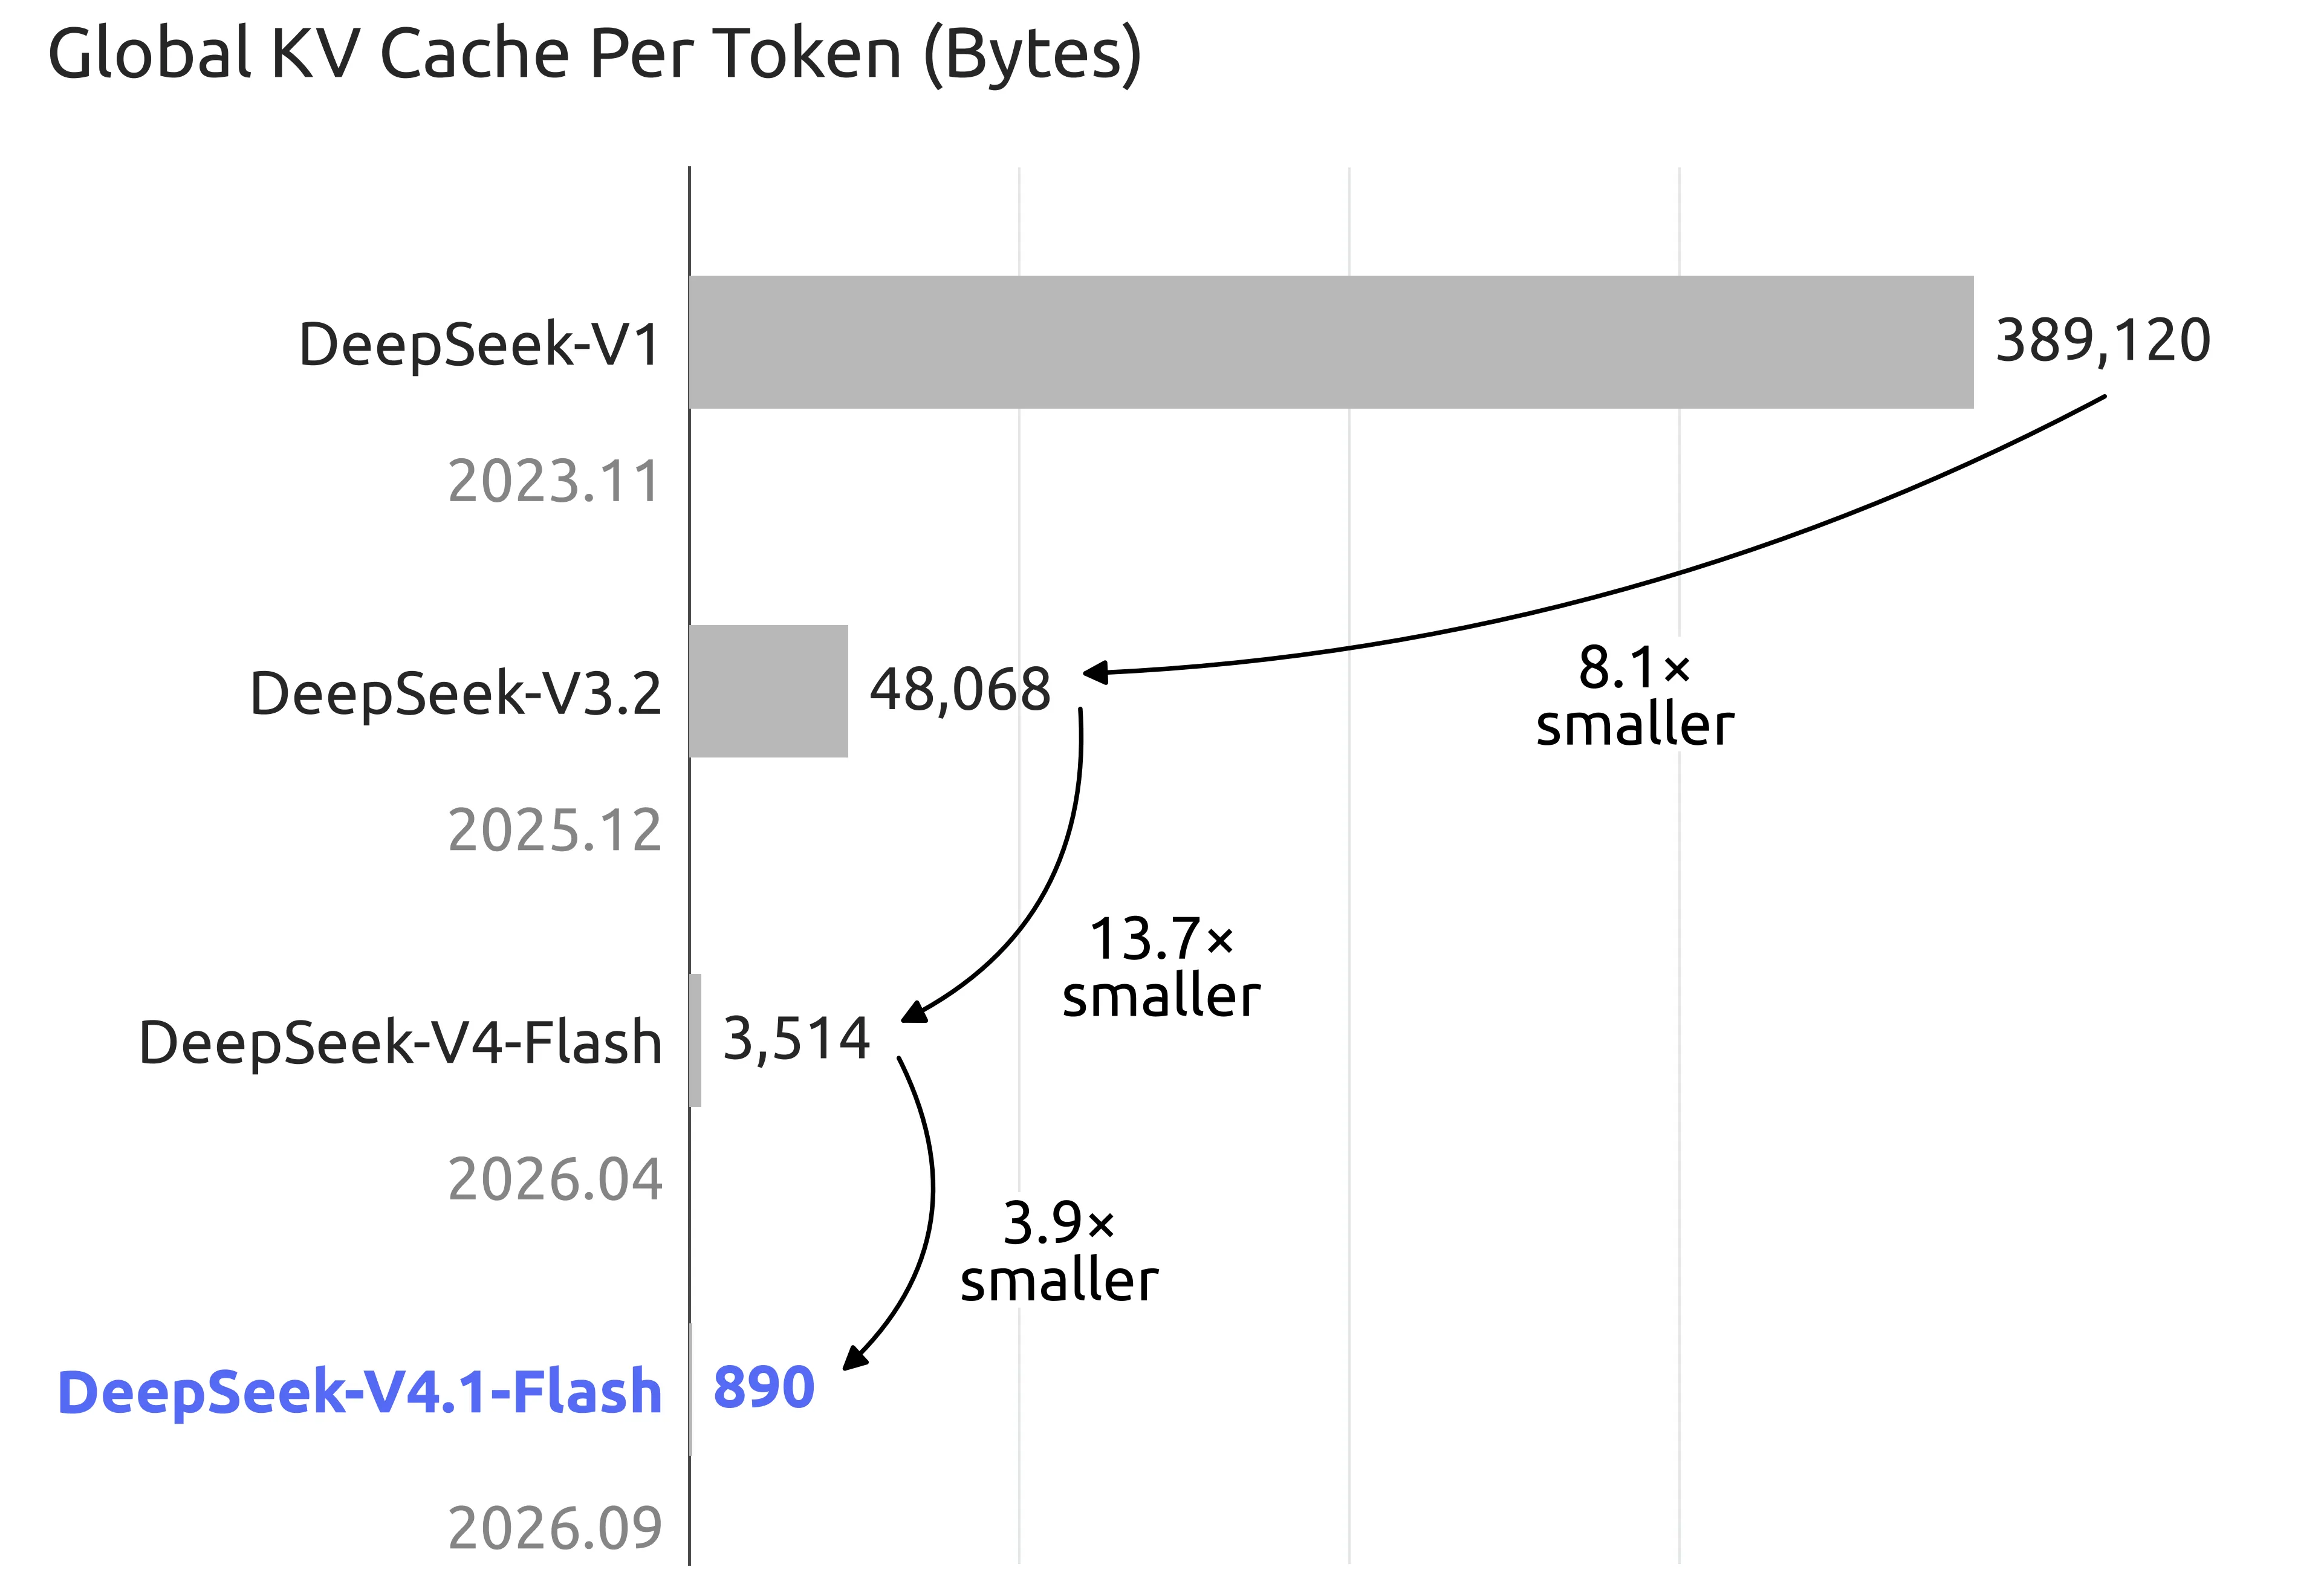
这张图(报告图 1(b))的纵轴是对数刻度,四个数字分别是:
| 模型 | 发布时间 | 每 token 全局 KV Cache |
|---|---|---|
| DeepSeek-V1 | 2023.11 | 389,120 字节(约 380 KB) |
| DeepSeek-V3.2 | 2025.12 | 48,068 字节(约 47 KB) |
| DeepSeek-V4-Flash | 2026.04 | 3,514 字节(约 3.4 KB) |
| DeepSeek-V4.1-Flash | 2026.09 | 890 字节 |
三代之间分别缩小 8.1 倍、13.7 倍、3.9 倍,累计约 437 倍。890 字节/token 意味着什么?1M token 的上下文,全部层加起来的全局 KV 只有大约 890 MB。这个数量级已经可以完整装进单张加速卡的高带宽显存里,而不是像过去那样必须拆散到多卡、甚至下推到主机内存。
更有意思的是,这个压缩不是在缩小模型的前提下换来的。DeepSeek-V4.1-Flash 的骨干参数从 V4-Flash 的规模涨到了 552B(另有 196B 的 Engram 条件记忆参数),能力反而更强。报告的说法是「尽管 KV Cache 占用小得多,模型性能显著优于基线」。
这篇文章聚焦推理侧:这 4 倍的全局 KV 压缩、8 倍的持久缓存压缩是怎么做出来的,每一层设计的动机是什么,代价又落在哪里。训练侧的细节(数据配比、RL 流程)只在必要处一笔带过。
一、先把两笔账分开:runtime KV 与 persistent KV
在拆解具体技术之前,必须先建立一个概念区分。报告反复使用两个不同的 KV 口径,混在一起看会完全读不懂它在优化什么。
从 DeepSeek-V4 开始,模型的每一层同时挂了两条注意力分支:
- 全局注意力分支(global attention)覆盖完整的因果可见范围。它维护的 KV 叫 global KV,由两部分组成:main KV(压缩后的主键值缓存)和 indexer K(稀疏索引器用来打分选 Top-K 的键)。这部分数据在解码过程中始终驻留 HBM,因为每一步都要读它。
- 滑窗注意力分支(Sliding-Window Attention, SWA),窗口大小固定为 128(记为 )。它维护 SWA KV,用于捕捉最近邻的局部依赖。
这两者的存储特性完全不同:SWA KV 的体量与序列长度无关(窗口固定,永远只保留最近 128 个位置的 KV),而 global KV 随序列长度线性增长。序列足够长时,global KV 必然主导运行时占用。
于是就有了两个受不同物理资源约束的口径:
| 口径 | 存放位置 | 约束资源 | V4.1-Flash 相对 V4-Flash |
|---|---|---|---|
| Runtime KV(HBM 常驻) | 加速卡显存 | HBM 容量 | 压到约 1/4(890 B/token) |
| Persistent KV(前缀缓存) | SSD / 主机内存 | SSD 容量 + I/O 带宽 | 压到约 1/8 |
这两个数字的工程后果是直接的:官方公告把并发请求上限提到了 2,500,并把缓存命中的输入价格下调到 0.02 元/百万 token(降幅 60%)。前者是 runtime KV 压到 1/4 之后、显存能同时装下更多活动会话的直接结果;后者是 persistent KV 压到 1/8 之后,缓存集群用同样的容量服务更多请求的容量红利。KV Cache 的账,最后都会以并发数和单价的形式出现在账单上——这也是本文值得逐节拆开的原因。
这两笔账在推理框架里对应两套完全不同的机制:runtime KV 的管理是块表与写时复制那一套(本站 PagedAttention 完全拆解),persistent KV 的跨请求复用靠前缀树(本站 RadixAttention 完全拆解)。V4/V4.1 的异构缓存——压缩条目、滑窗 KV、未压缩尾部共存——打破的恰恰是这两篇文章里「一个逻辑前缀对应一份连续 KV 缓冲」的默认前提,V4 那篇拆解里画过完整的布局图,本文不再重复。
Runtime KV 决定的是「一张卡能同时服务多长的上下文、多大的并发」;persistent KV 决定的是「缓存集群要多大、命中时要把多少数据搬回来」。DeepSeek 把这两个数分别压了 4 倍和 8 倍,用的是同一套架构改动的不同侧面——这正是 V4.1 设计上最精巧的地方。
还有一个必须提的历史包袱:在 V4 的部署里,SWA KV 占据了持久 KV 缓存的近一半容量。这一点在第六节会展开,它是 V4.1 一个关键改动的直接导火索。
二、压缩的三个乘法维度
搞清楚优化对象之后,接下来的问题是:KV Cache 能从哪些方向压?
报告给出了一个非常清晰的分解框架——KV Cache 的体积可以沿三个乘性叠加的维度缩减:
维度一:entry size(每个 KV 条目多大)
同一层的不同注意力头之间共享信息。GQA(Grouped-Query Attention)让若干 query 头共用一组 KV 头,直接把 KV 头数除以分组数;MLA(Multi-Head Latent Attention)更激进,把所有头共享成一个低秩潜向量。这两条路线本站都拆过(GQA 完全拆解、MLA 完全拆解),核心是把「头」这个维度上的冗余挤掉。这也是 DeepSeek 从 V2 起就在吃的红利——V4.1 的 FP4 主缓存,量化对象正是 MLA 那条低秩潜空间(第五节的 512 通道就是它)。
维度二:sequence(序列方向多少 token 合成一个条目)
每 个相邻 token 压缩成一个 KV 条目,读取时在大大缩短的序列上做注意力。DeepSeek-V4 里的 CSA(Compressed Sparse Attention)和 HCA(Heavily Compressed Attention)都走这条路, 就是压缩比。两种压缩率的分工、闪电索引器与统一块大小的设计,本站 DeepSeek-V4 混合注意力完全拆解 有完整推导——本文只把它当作 CSA2 的前置背景,不再重复公式。
维度三:layer(层与层之间能否复用)
Transformer 相邻层的 KV 高度相似,于是就有一个自然的想法:某些层干脆不算自己的 KV,直接复用别的层的。这条路上此前已有不少工作:
- Cross-layer attention(Brandon et al., NeurIPS 2024)首先提出让上层复用下层 KV 来缩减缓存,是这条线的源头之一;
- IndexCache 复用 Top-K 索引以削减索引器的计算量;
- YOIO 把稀疏路由算一次、全层共享;
- HySparse 让稀疏层复用稠密层的 KV 缓存。
报告对这条路的现状有一个很准的判断:已有的层维复用方法没有一个同时覆盖三个维度。具体来说——
只复用索引(IndexCache、YOIO)省不下 main KV 的存储; 全网共享路由会限制模型性能; 混合式设计(如 V4 的 CSA+HCA)仍然保留了完整的全注意力层。
这就是 CSA2 的切入点:把三个维度联合起来用,同时把「缓存共享」和「索引复用」这两件事解耦——这是一个关键的设计选择,下面会看到它为什么重要。
值得先指出的是,第三条路(层维复用)在同期还有别的解法,本站都拆过:美团的 LSA 用跨层索引 + 层级索引把 DSA 的索引开销按组摊销、把 top-k 的候选空间打薄;CLAA 则在长上下文 prefill 场景做跨层注意力聚合。它们和 CSA2 属于同一条大思路的不同切面——层间冗余是稀疏化与压缩之外,第三个可以被系统性利用的维度。第四节末尾会把 CSA2 和 LSA 摆在一起做一次正面对照。
顺带说清楚 890 字节的账是怎么分的。报告在结论部分明确写:890 字节/token 来自 CSA2 的跨层 KV 复用 与 FP4 KV 缓存 两者的联合作用,合计约为 V4-Flash 的 1/4。这两个因素大致是各贡献一半:
- FP4 把每个条目的位宽从 FP8 的 8 bit 降到约 4.5 bit(E2M1 的 4 bit 加每 16 通道一个 8 bit 的 scale),条目体积近乎减半——报告原文用的词就是 “nearly halves”;
- 剩下的约 2 倍来自架构侧,即跨层共享与压缩带来的条目数量下降。
需要说明的是,报告没有给出逐项的字节级归因表,上面这个对半拆分是从「FP4 nearly halves」和「总计约 1/4」两个已知量推出来的。相比之下,持久缓存的 1/8 在报告 3.2.1 节里有明确的乘法分解(1/2 × 1/4),这部分是原文给出的,可信度更高。
三、CED:让 prompt token 止步于第 20 层
第一个大的架构改动针对的是 prefill 的计算成本。
3.1 YoCo 的思想与它的不足
CED 的全称是 Causal Encoder-Decoder(因果编码器-解码器),灵感来自 2024 年微软的 YOCO 论文(arXiv:2405.05254)。YOCO 的核心观察是:既然 Transformer 上层的 KV 可以从下层推导,那为什么不让上层的所有层直接共享下层生成的 KV 缓存?
这样一来,一段输入序列只需要走完下半部分的层来生成 KV,上半部分就可以直接拿来用了——prefill 的计算量几乎减半。
但 YOCO 的做法过于粗暴。报告指出 CED 相对它在两方面做了结构性改进:整体 KV 缓存容量和 KV 生成的计算深度。
3.2 CED 的具体做法
V4.1-Flash 的语言骨干一共 40 层,被切成 20 层的因果编码器 + 20 层的解码器。
对于全局注意力,下半部分()正常计算,作为因果编码器。而上半部分(解码器,)的 KV 不再从各自的隐藏状态 推导,而是统一从第 层(即编码器最后一层)的隐藏状态 投影出来:
其中:
- 是编码器最后一层输出的隐藏状态, 是序列长度, 是隐藏维度;
- 是第 层的 KV 投影权重, 是投影出的 KV 条目;
- 是同一层的压缩权重, 是配套的压缩分量——它是 CSA2 压缩路径的一部分(第四节会看到,在 CSA2 里 KV 条目还要经过压缩/量化才能入缓存)。
为什么每层要用不同的投影权重? 这是 CED 相对 YOCO 的关键改进。如果所有解码器层共用同一份投影,那第 21 层到第 40 层看到的全局 KV 就是完全一样的,模型的表达深度被严重削弱。给每层各自一套 和 ,等价于让所有解码器层「共享同一个信息来源,但各自解释它」——来源的存储只有一份,表达的自由度却保住了。
投影的代价有多大?一次 到 的矩阵乘是 ,而完整跑一层 Transformer(含 Attention、MoE)的代价远高于此。所以这个替换是划算的。
3.3 为什么 SWA 不能一起省,以及怎么绕过去
如果 CED 到此为止,那就会出现一个问题:SWA KV 怎么办?
全局分支可以靠投影跳过,滑窗分支不行。SWA 的局部键值必须逐层从当前层自己的隐藏状态 推导——这样才能「有效增加局部 KV 生成的计算深度」(报告的措辞)。如果解码器的 SWA KV 也从编码器投影,那这 20 层的局部特征就全退化了。
但保留逐层计算的代价是:解码器要为最后 个 token 走一遍 SWA 计算。对多轮交互、每轮 prompt 都很短的场景,这个开销不容忽视。
这里的转折点是一个来自既有工作的经验观察(Chen et al., 2025 的 PowerAttention):SWA 的实际有效感受野远小于理论上的 。既然理论上需要的那么长的重放区间在实践中并不真的被用到,那就没必要为它付钱。
这条经验观察在本站拆过的其他方向上反复出现:Prefix Sliding 发现推理轨迹中段的 token 既拿不到注意力、也基本不再被后续步骤使用,于是干脆把中间整段从缓存里删掉,只留前缀与滑窗;SWA 滑窗注意力完全拆解 那一篇则解释了为什么滑窗分支只要搭配极少数 attention sink 就能工作。V4.1 的 Bounded Replay 与它们同源——先承认「理论上该看的东西实际大都没被看」,再据此把不必付的成本退回去。这类改动的共同点是:它们不改变模型看到了什么,只改变系统为「万一要用」预留了多少。
于是有了 Decoder SWA Bounded Replay:prefill 时只对 prompt 的最后 个 token 跑 SWA 计算。这一步的收益直接把 prefill 复杂度改写了:
因为 , 这一项可以忽略,prefill 计算量整体减半。这个结论在报告的图 2 里有直接体现。
3.4 非对称激活:prefill 8B / decode 16B
CED 带来的另一个结果,是输入输出两侧的激活参数量不再对称:
| 阶段 | 每 token 激活参数 |
|---|---|
| Prefill(输入侧) | 约 8B |
| Decode(输出侧) | 约 16B |
为什么差一倍?直觉很简单:prefill 只需要跑完 20 层因果编码器就能拿到全局 KV,而 decode 每一步都要走完整 40 层。对输入重、输出轻的 agent 负载来说,这个非对称正好把成本压在了便宜的那一侧——官方公告里把这个结构称为「非对称模型结构,小成本大智能」。
代价也很明确:decode 侧的 16B 激活比普通的同尺寸模型更重,只有在「输入远长于输出」的场景下才划算。如果负载是相反的形状(短输入、长生成),CED 的收益会被稀释。
CED、CSA2 这些改动叠加起来的总效果,可以看报告图 2 这张单 token 解码 FLOPs 随上下文长度的变化曲线。
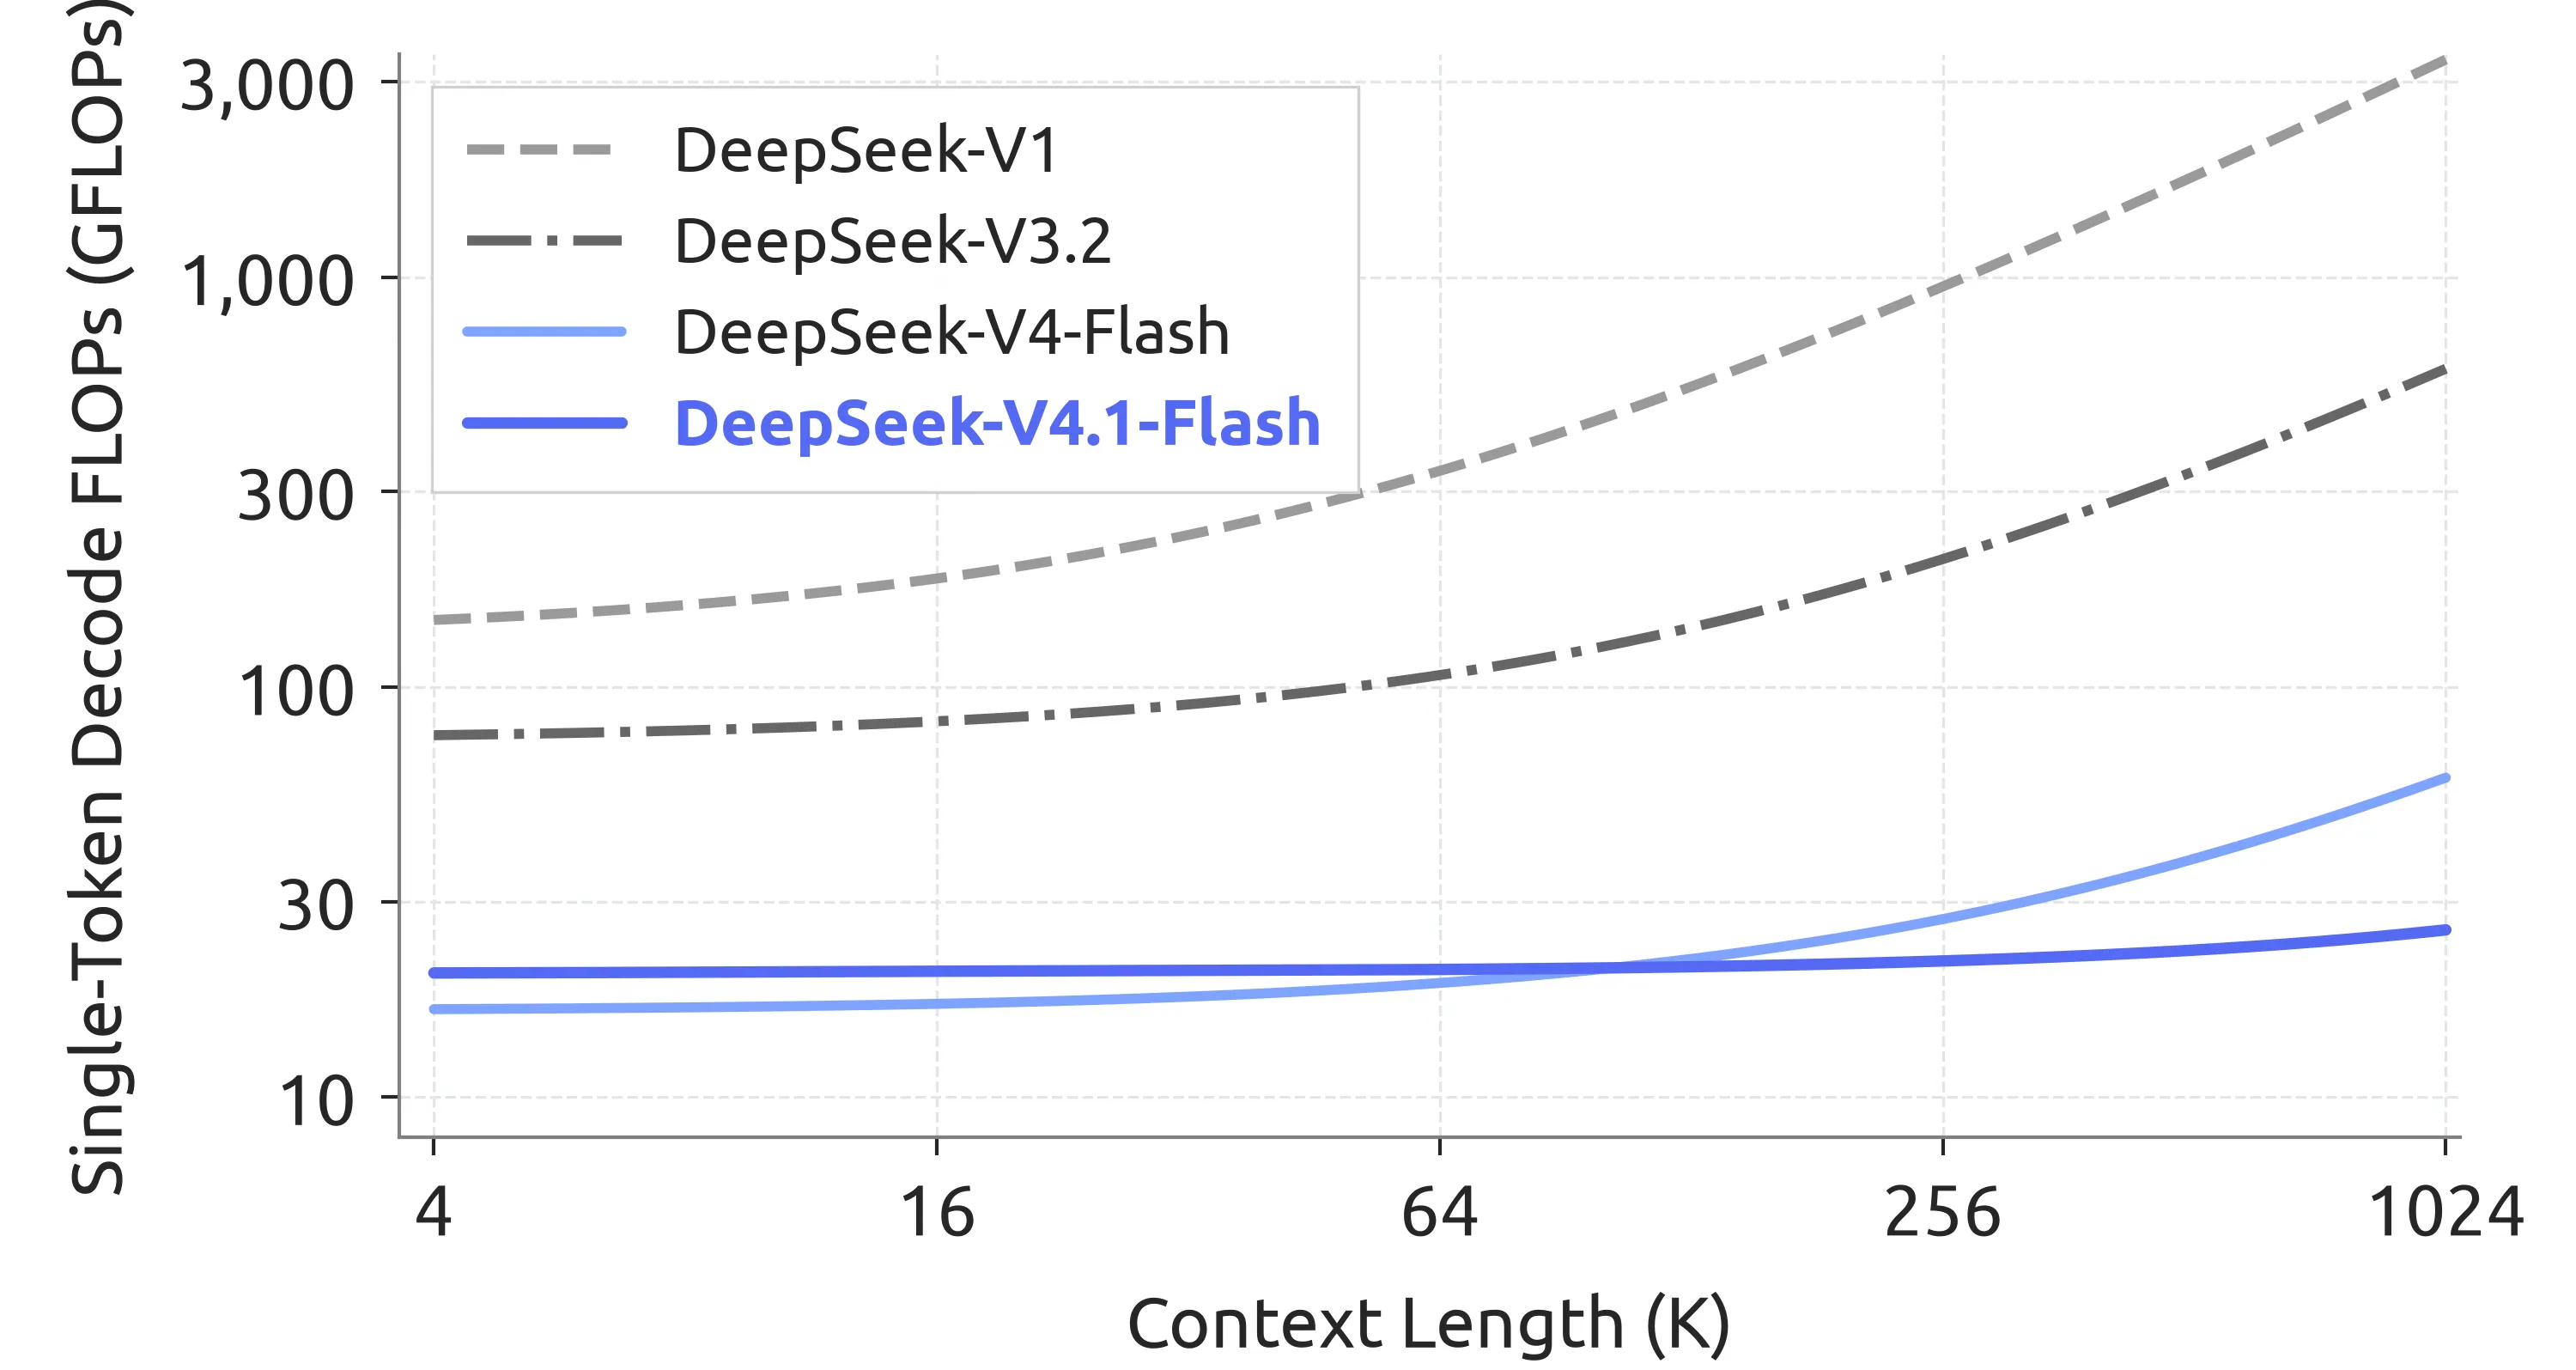
这张图的纵轴是对数坐标,而且计算时按精度做了加权——BF16、FP8、FP4 的运算分别按 1、0.5、0.25 计权(低精度算子算力更高,权重更低):
- DeepSeek-V1(灰虚线)从 4K 时的约 180 GFLOPs 一路涨到 1M 时的 3000+ GFLOPs,翻了十几倍——这是标准全注意力的平方级增长。
- DeepSeek-V3.2(灰点划线)起点更低(约 75),但斜率依旧明显,1M 时约 700。
- DeepSeek-V4-Flash(浅蓝)在 64K 之前和 V4.1-Flash 几乎重合,但之后开始明显上翘,1M 时约 75。
- DeepSeek-V4.1-Flash(深蓝)几乎是一条平线:从 4K 到 1M,上下文长度扩展了 256 倍,单 token 解码 FLOPs 只增加了约 1/4。
「几乎恒定」这个性质对推理系统意味着什么?它意味着解码的每步延迟不再随上下文长度膨胀。传统模型跑到 128K 上下文时,每一步解码都要扫过全部历史 KV,延迟被线性拉长;用户会直观感受到「聊得越久,吐字越慢」。而解码 FLOPs 恒定的模型,在 4K 和 1M 上下文下的吐字速度基本一致——这对 agent 场景是决定性的,因为 agent 恰恰是「上下文极长、单轮输出极短」的负载形状。
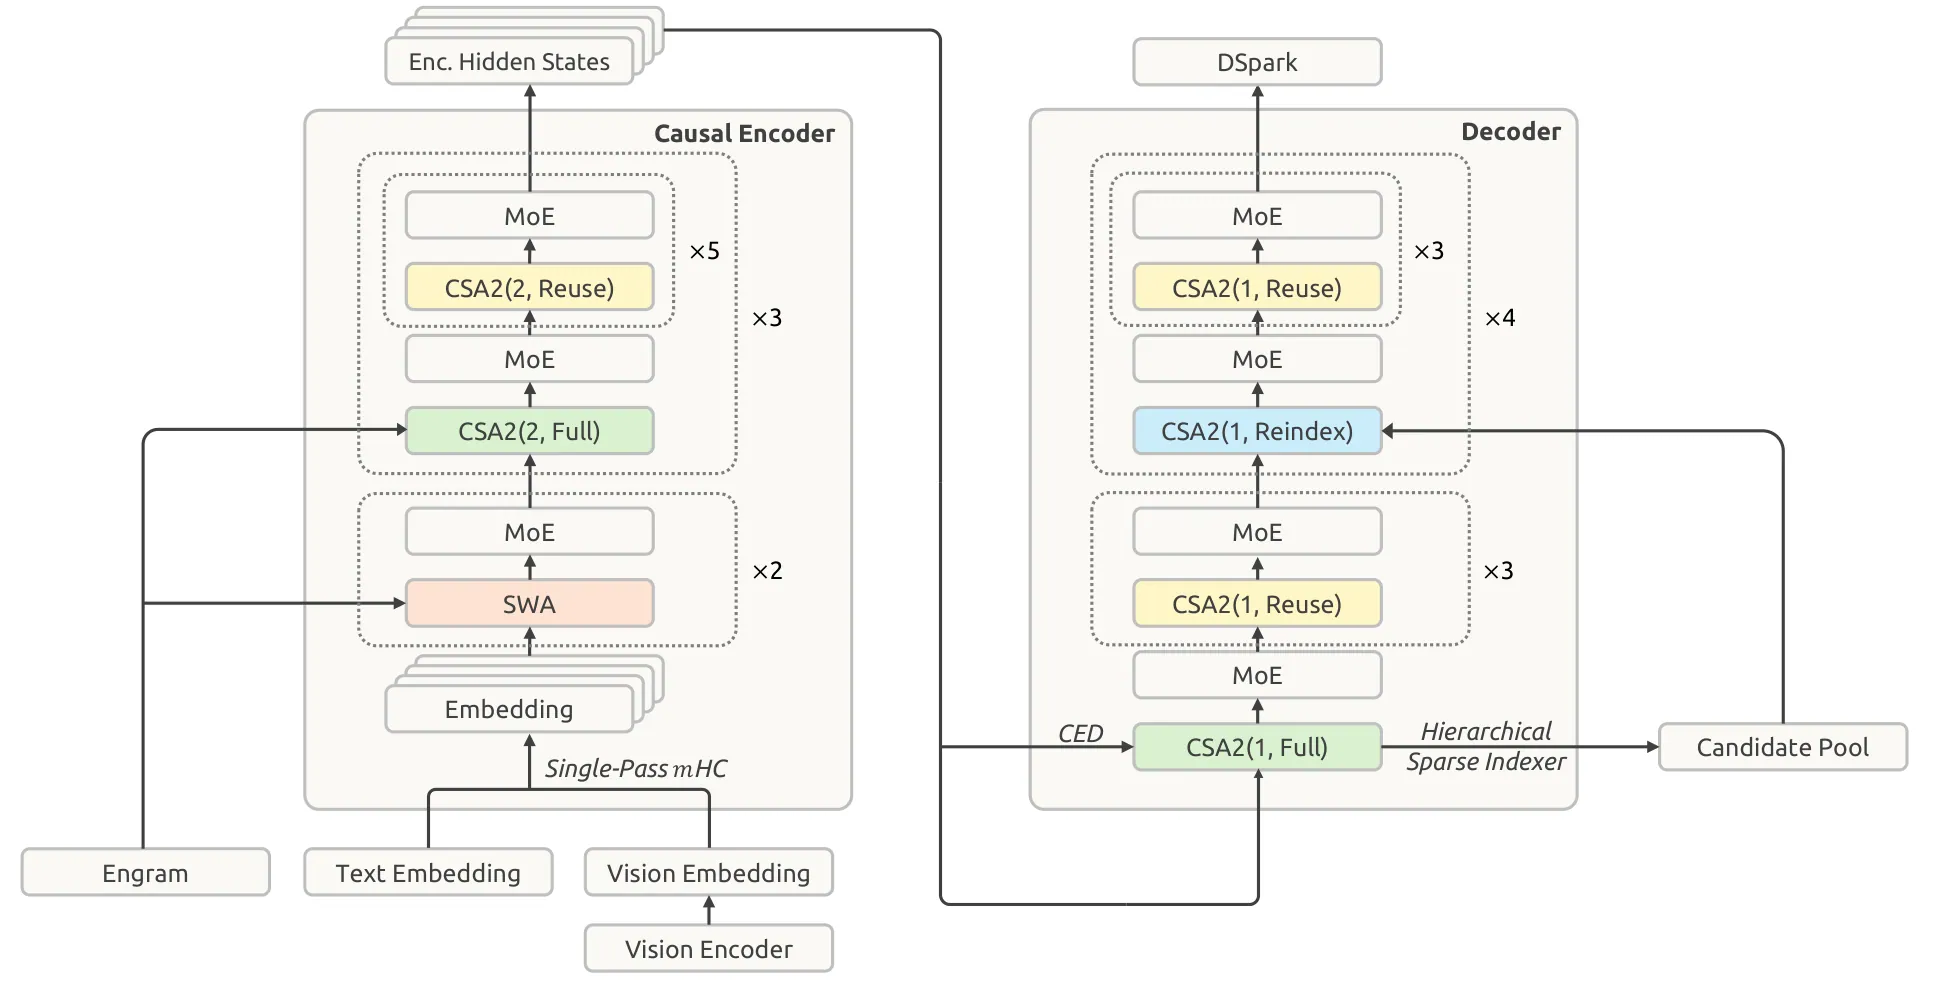
这张架构图(报告图 3)把整个模型的组织方式画清楚了,值得逐块看:
- 左侧的 Causal Encoder 底部是 Embedding 层(文本、视觉、还有连接 Engram 的分支)。往上先是 ×2 的 SWA 层(橙色)——注意,编码器的前两层用的是纯滑窗注意力,没有全局分支,这是全模型仅有的两个非 CSA2 层。再往上是 ×3 的三组结构,每组形式为
MoE → CSA2(2, Full) → MoE → CSA2(2, Reuse) ×5,即每组 6 层里只有第一层是 Full 模式,其余五层全是 Reuse。 - 编码器顶部输出的 Enc. Hidden States 就是 CED 的枢纽:它既是编码器的输出,也是解码器所有全局 KV 的唯一来源。图中那条从 Enc. Hidden States 引出、绕过整个 Decoder 再插回 CSA2(1, Full) 的箭头,画的就是这个投影关系。旁边的 CED 标注明确指了这条通路。
- 右侧的 Decoder 同样是 ×4 的五组结构,但模式分配不同:第一组是
Full + Reuse ×3,后四组是Reindex + Reuse ×3。注意解码器的压缩比是 而不是编码器的 ——解码器不做序列压缩。 - 解码器第一个 Full 层右侧引出的 Hierarchical Sparse Indexer 箭头指向 Candidate Pool,然后这条线又绕回来接进 Reindex 层——这就是第四节的候选池机制。
- 顶部的 DSpark 是投机解码模块,Single-Pass mHC 标注在 Embedding 附近,说明残差流的融合发生在每个 block 的边界上。
图里一个容易看漏的细节:虽然 CSA2 层被分组并大量使用 Reuse 模式,但每个层都保留了自己的 main Q 和 SWA KV。复用的只是 global KV 和索引,不是全部。
四、CSA2:把缓存共享与索引复用解耦
CED 解决的是「算得少」,CSA2 解决的是「存得少」。这是全文最核心的一节。
4.1 CSA2 相对 CSA 做了哪些简化
在动手压缩之前,CSA2 先把上一代的 CSA 做了减法。报告明确列了两处:
简化一:去掉重叠与绝对位置编码。 CSA 在压缩比 下,每个压缩后的 main KV 条目由 个原始 KV 条目产生,而且相邻压缩条目之间有重叠(overlap)。此外 CSA 还带了一个绝对位置编码,用来在压缩时记录这 个条目的位置信息。CSA2 把重叠和绝对位置编码都删掉了。
这不是纯粹的简化——删掉绝对位置编码意味着位置的表达必须完全交给 RoPE 承担,而重叠的取消意味着压缩边界处的信息会比原来更硬。报告的说法是这两处改动「简化了实现并提升了训练效率」,代价则是压缩器的表达能力有所下降,需要用别的方式来补(比如下面要讲的索引器)。
简化二:indexer K 改为从 main KV 投影。 在 CSA 里,索引器的键 有一条独立的压缩路径,直接从隐藏状态算出来。CSA2 改为:索引器 K 由 main KV 条目投影得到。
这一改动的影响比看起来大。索引器 K 不再是一份独立的数据,而是 main KV 的派生物——只要 main KV 被跨层复用了,索引器 K 就自动跟着复用,不需要额外的共享机制,也不会有两份数据不同步的风险。这是 CSA2 能干净地实现「跨层共享」的前提。
顺带把索引器这条线的来历接上:它是 DeepSeek-V3.2 的 DSA(闪电索引器)的后代,本站 NSA 系列第二篇 拆过 DSA 的工程落地,LSA 完全拆解 则对「索引器到底贵在哪」做了目前最细的量化——结论是长上下文下真正的大头不是打分,而是 top-k 选择本身。CSA2 的两处设计(索引器 K 派生自 main KV、分层候选池)正是在这个认识上往前走的。
另外报告特别提了一句:压缩比 时,CSA2 就退化成不压缩的 main KV 这一特例。解码器用的正是 。
4.2 三种模式的精确语义
CSA2 的每个层被静态分配三种模式之一:Full、Reindex、Reuse。三者的共同点是:都自己计算 main Q 和 SWA KV,并用它们加上选中的 main KV 条目产生注意力输出。区别在于 main KV、索引器 K、Top-K 索引这三样东西各自从哪来。
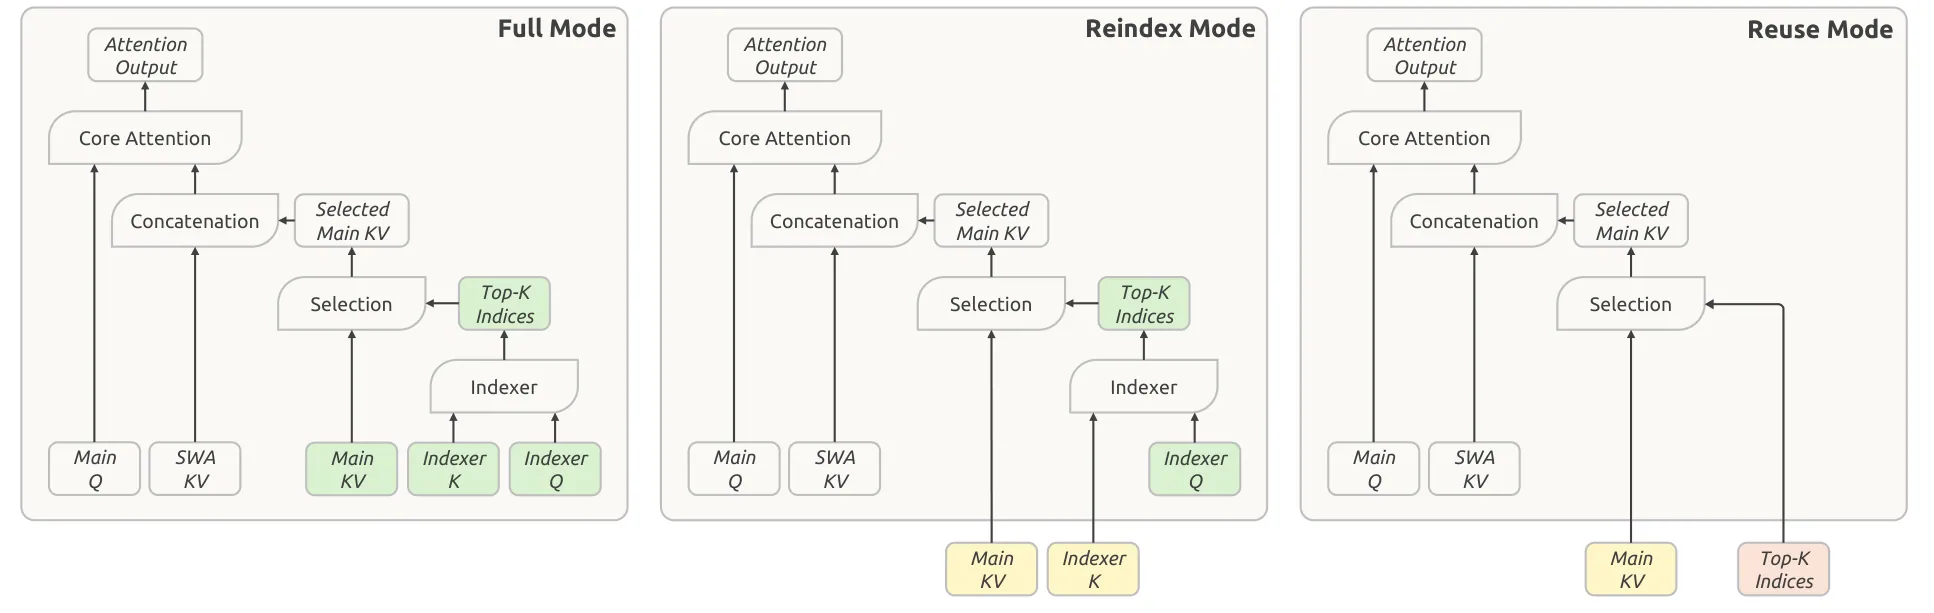
这张图(报告图 4)的配色规则是理解全部机制的关键,先记住它:绿色 = 当前层自己算的;黄色 = 从最近的 Full 模式层复用来的 main KV 和索引器 K;红色 = 从最近的索引产出层(Full 或 Reindex)复用来的 Top-K 索引。
Full 模式(最左):完整执行 CSA2 的全部路径。自己算 main KV → 从中投影出 indexer K → 自己算 indexer Q → 跑索引器打分 → 选出全新的 Top-K 索引。图里这一列所有的方块都是绿色的,包括左下角的 Main KV、Indexer K、Indexer Q 和右侧的 Top-K Indices。它的组件职责与 DeepSeek-V4 里一个完整的 CSA 层完全一致。
Reindex 模式(中间):main KV 和 indexer K 是黄色(复用自前面某个 Full 层),但右下角的 Indexer Q 是绿色(自己算),Top-K Indices 也是绿色(自己重新选)。也就是说:它用自己的查询去重新打分那些复用来的键,从而产出一套新的 Top-K 索引。图里 Selection 模块的输入箭头正是从黄色的 Main KV / Indexer K 和绿色的 Indexer Q 汇合而来的。
这个模式存在的意义是解决一个矛盾:如果所有层都用同一套 Top-K 索引,那稀疏选择就被「焊死」在全网同一组位置上,模型失去了逐层调整关注点的能力。Reindex 用极小的代价(只多算一个 indexer Q 和一次打分)换回了这个自由度——缓存共享保住了,选择却可以逐层变化。
Reuse 模式(最右):main KV 是黄色、Top-K Indices 是红色,而 Indexer Q 整个消失了。它不做任何索引计算,直接拿现成的选择去读现成的 KV。注意图中右侧那条从外部绕进来接到 Selection 的箭头——索引是从”最近的索引产出层”传过来的。
回到第三节架构图里的层分配,现在可以算清楚实际的缓存开销了:
| 部分 | 层数 | 压缩比 | 分组方式 | 实际产生 main KV 的层数 |
|---|---|---|---|---|
| 编码器前 2 层 | 2 | —(纯 SWA) | — | 0 |
| 编码器 CSA2 层 | 18 | 2 | 3 组 × 6 层(1 Full + 5 Reuse) | 3 |
| 解码器 CSA2 层 | 20 | 1 | 5 组 × 4 层(首组 1 Full + 3 Reuse;其余 4 组 1 Reindex + 3 Reuse) | 5 |
40 层里,真正独立产生 main KV 的只有 8 层。而且编码器那 3 层的压缩比是 2,等于每个条目还代表了两个 token。这就是「层维复用」带来的存储收益——它不是让每个条目变小,而是让条目的份数变少。
还有一个要澄清的点:Reuse 模式复用 Top-K 索引时,复用的是「针对它所复用的那份 main KV 算出来的最新索引」。这一点必须成立,否则索引指向的位置和实际读取的 KV 会对不上。报告在定义 Reuse 模式时特意强调了这层绑定关系。
三种模式的逻辑差异,用一段伪代码可以精确表达出来。注意共享状态用 # 标记来源,last_* 表示「最近一次产生该状态的层」:
# 跨层共享的状态(每个 CSA2 层都在读写)main_kv_shared = None # 最近一次 Full 层产生的 main KVindexer_k_shared = None # 与之绑定的 indexer Ktopk_shared = None # 最近一次索引产出层(Full/Reindex)选的 Top-Kcandidate_pool = None # 仅解码器:分层稀疏索引器的候选池
def csa2_layer(hidden, mode, is_decoder, layer_local_swa_kv): main_q = W_q(hidden) # 三种模式都自己算
if mode == "Full": main_kv = compress(hidden @ W_kv) # 自己产生 indexer_k_shared = project(main_kv) # 从 main KV 投影 indexer_q = W_iq(hidden) topk_shared = topk(indexer_q @ indexer_k_shared, k=512) main_kv_shared = main_kv if is_decoder: # 建候选池供后续层使用 candidate_pool = blocks_to_positions( top_blocks(indexer_q @ indexer_k_shared, n_blocks=2048, per_block=8))
elif mode == "Reindex": indexer_q = W_iq(hidden) # 自己算 query score_domain = candidate_pool if is_decoder else ALL_VISIBLE topk_shared = topk(indexer_q @ indexer_k_shared, k=512, domain=score_domain)
elif mode == "Reuse": pass # 完全不碰索引器
selected = gather(main_kv_shared, topk_shared) # 三种模式统一从共享态取 return core_attention(main_q, selected, layer_local_swa_kv)这段伪代码里有三处细节值得对照报告确认:
main_q和layer_local_swa_kv永远来自本层,不在共享范围内。共享的是「被查的东西」,不是「查询本身」。indexer_k_shared由main_kv_shared投影而来,所以它跟着 main KV 一起被复用,不需要独立的共享逻辑。topk_shared在 Reindex 模式里被刷新,在 Reuse 模式里被沿用。这个状态更新的不对称,正是「缓存共享」与「索引复用」解耦的落点——两者可以分别决定要不要复用。
4.3 分层稀疏索引器:把深度索引器的代价变成常数
跨层复用把索引器的调用次数降下来了——Reuse 层完全不跑索引器。但报告紧接着指出一个更容易被忽略的问题:
剩下的索引器仍然要对完整的因果可见上下文打分。对极长上下文来说,这个成本依然是主要的计算瓶颈。
数一下:编码器 3 个 Full + 解码器 1 个 Full + 4 个 Reindex = 8 个索引器要为每个 query 扫描整个可见范围。在 1M 上下文下,这 8 次全量扫描本身就不可忽略。
已有工作(Xu et al., 2026b)的思路是先对池化后的块表示打分并剪枝,再做 token 级索引。而 CSA2 的发现更巧妙:解码器里,浅层索引器的信息可以自然地用来限制深层索引器的候选范围,而且不需要引入任何额外状态。
这就是 Hierarchical Sparse Indexer(分层稀疏索引器),它只在 CED 的解码器中启用。
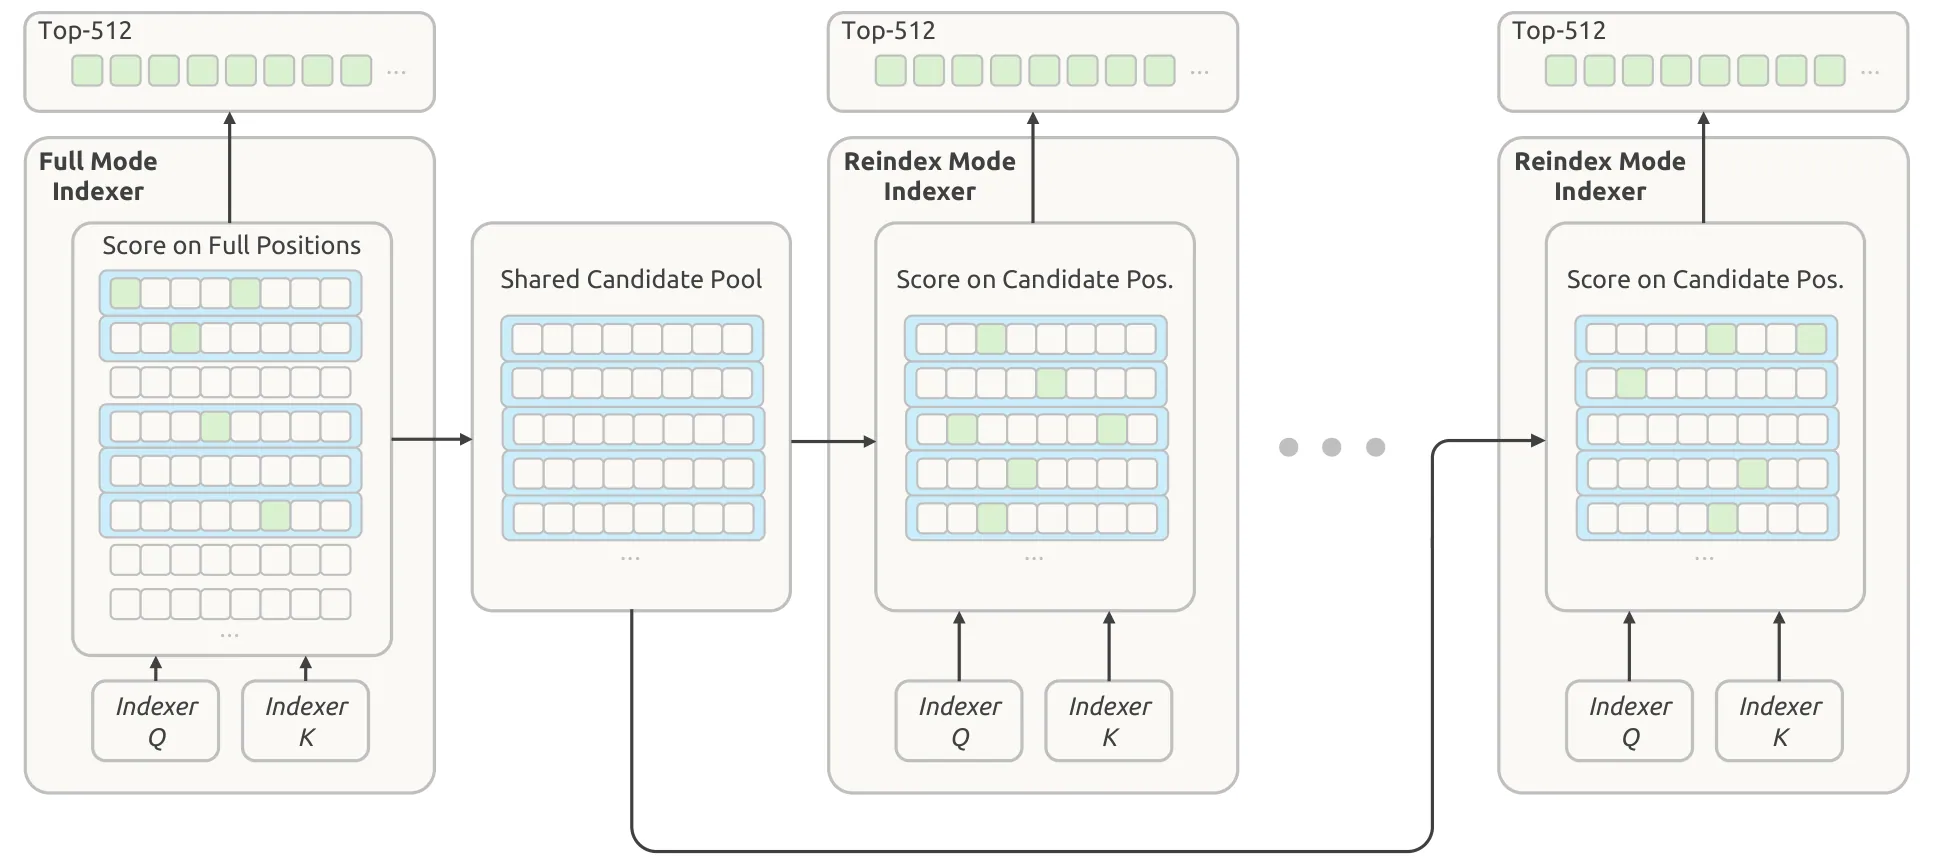
看这张图(报告图 5)的流程。绿方块代表被选中的位置,蓝框代表按分数选出的块:
- 最左边的 Full Mode Indexer:它做两件事。第一,对全部因果可见的 main KV 位置打分(图中 “Score on Full Positions”,可以看到整片方块都被扫描了),选出自己的 Top-512。第二,块级候选选择——每个块取其内部位置的最大索引分数作为该块的分数,然后选出分数最高的若干块。
- 中间的 Shared Candidate Pool:被选中块覆盖的所有位置被收集起来,形成一个比最终 Top-K 集合更大的候选池。报告的配置是:2048 个块 × 每块 8 个位置 = 最多 16,384 个候选位置。
- 右边的 Reindex Mode Indexer:它只对候选位置打分(“Score on Candidate Pos.”),在池内选出自己的 Top-512。注意图中它扫描的方块数量明显少于 Full 层。
结果就是报告给出的那个关键结论:对固定的候选池大小,后续每个索引器为每个 query 打分的位置数与上下文长度无关。1M 上下文和 100K 上下文,Reindex 层的索引代价是一样的。
代价是什么?第一个 Full 模式层仍然要扫描完整的因果可见范围——这个成本没有被消除,只是被限制在一层之内。报告对此的表述很坦诚:「分层索引降低了后续索引器评估的成本,同时保留了初始的全范围扫描。」
还有一个工程上很关键的细节:这个机制是训练感知的(training-aware)。候选限制在训练和推理时以完全相同的方式施加,因此深层索引器是在它推理时真正会面对的搜索域上被优化的,而不是在训练时看全量、推理时看子集,导致分布错配。报告的说明是,该机制「在后训练阶段引入」。
4.4 与 LSA 的正面对照:同一目标,两种解法
跨层复用不是 CSA2 独有的想法。本站拆过的美团 LSA(2026 年 8 月,比 V4.1-Flash 早一个月)走的是同一条路的另一个方向,把两者摆在表格里对照,能看清各自让步的地方:
| 维度 | LSA(跨层索引 CLI + 层级索引 HI) | CSA2(本文) |
|---|---|---|
| 复用的组织形式 | 连续 层一组,owner 层算一次索引,其余层广播式共用同一次打分 | Full / Reindex / Reuse 静态分配,Reindex 用新 query 重打分,只有 Reuse 完全沿用 |
| 让复用成立的手段 | 跨层蒸馏:owner 层索引器要对组内全部层的注意力分布负责(不做蒸馏时,朴素复用让 128K 大海捞针从 96% 掉到 70%) | 不做蒸馏,而是把索引从 KV 上解耦 + 候选池限制在训练与推理时同样施加 |
| 候选缩减 | 页级粗召回 + token 级精选,top-k 复杂度从 降到 ,≥256K 才划算 | Full 层建共享候选池,后续索引器只在池内打分,代价与上下文长度无关 |
| 已知代价 | 层距超过 4 覆盖率明显下降,因此保守取 ;HI 在 agentic 任务上掉 1.5–3.3 分 | 每层仍保留自己的 main Q 与 SWA KV,首个 Full 层仍需全范围扫描 |
分歧点可以归结为一个很本质的问题:复用的对象到底是什么。 LSA 复用「选择的结果」,因此必须让这份结果对别的层也可信——代价放在训练期的跨层蒸馏上;CSA2 复用「被打分的数据」(main KV 与派生的 indexer K),逐层的选择自由用一层索引器的算力买回来——代价留在推理期。两者的另一个共同点是都承认近似与妥协是明写在设计里的,而不是靠测试集掩盖:LSA 承认 HI 在 agentic 任务上掉点,CSA2 承认首个 Full 层的全范围扫描没有被消除。读到这类论文时,先找它们承认了什么,往往比先看它们宣称了什么更有信息量。
五、FP4 主 KV Cache:为什么敢砍掉第二级 scale
架构侧压完了份数,精度侧接着压体积。
5.1 一个和通常直觉相反的设计
DeepSeek-V4 已经对索引器的 Q 和 K 做了 FP4 的量化感知训练(QAT),目的是加速索引计算并缩小索引器缓存。V4.1 把 QAT 扩展到了 main KV cache 上。
这里有一个必须点破的区别:这次量化不是为了加速矩阵乘,而是为了省存储。
普通的 FP4 权重/激活量化,收益来自 Tensor Core 能直接吃低精度输入、吞吐翻倍。但 KV Cache 量化的收益完全是另一回事——它省的是容量和带宽。而省带宽这件事有个前提:写进去的时候要真的更小,读出来的时候要真的少搬。
报告在这里做了一个非常务实的工程决定:反量化之后再送入注意力计算。
在注意力之前反量化缓存的值,可以让模型使用一个更精确的格式,而不需要该格式具备原生的矩阵乘支持,从而保持了跨硬件平台的兼容性。
这个决定的效果是解耦:KV Cache 的存储格式不再受限于硬件的矩阵乘能力。哪怕某张卡完全不支持 FP4 的 Tensor Core 指令,只要它能做整数/查表解包,就能享受 FP4 KV Cache 的存储收益。对一个需要在多种加速卡上部署的开源模型来说,这个兼容性价值很高。
5.2 格式选型:E2M1 + 每 16 通道一个 E4M3 scale
报告评估了大约四种四位格式,最终选定的是:
- 数据格式 E2M1:1 位符号、2 位指数、1 位尾数,可表示的幅值上限是 ;
- 缩放格式 E4M3:每个 16 通道共享一个 E4M3 的 scale,即 OCP 标准的 MXFP4(Rouhani et al., 2023);
- 一个刻意的省略:遵循 NVFP4 的通道级 scale 设计,但去掉了它的第二级全局 scale。
统一的格式(OCP MXFP4)而不是实验里精度更高的替代格式,理由写得很直白:「以支持尽可能多的硬件平台」。这是典型的部署优先思维。
E2M1 与 E4M3 的位布局(1+2+1 与 1+4+3 的符号/指数/尾数分配)、各自的动态范围与 subnormal 行为,本站浮点数专文有逐位拆解;而「MXFP4 为什么能不掉精度」这个问题,本站也单独答过(面试疑难(三))——结论与下一节的论证同构:真正决定精度的是数据分布的先验,而不是格式本身多一位少一位。
5.3 省略全局 scale 为什么安全:一次定量的动态范围论证
去掉第二级 scale 是这段设计里最容易被质疑的一步——少一层缩放,动态范围不就塌了吗?报告用一串不等式把这件事算清楚了,这个推导值得完整走一遍,因为它示范了「量化格式选型」应该怎么做。
推理链是这样的:
第一步:RMSNorm 的权重幅度有上界。 V4.1-Flash 训练后,RMSNorm 权重的最大幅度约为 1。归一化层的输出是「归一化后的输入」乘以这个权重,所以权重不超过 1 意味着 RMSNorm 不会放大信号的幅度。
第二步:归一化后 KV latent 的 L2 范数有上界。 经过 RMS 归一化后,一个 维向量的均方根为 1,因此它的 L2 范数至多是 。报告里这个 就是 KV latent 的通道数 512,所以
第三步:RoPE 保范数。 RoPE 是旋转操作——它把向量按维度两两配对,在二维平面里做旋转。旋转不改变任何一对分量的平方和,因此整个向量的 L2 范数在 RoPE 前后完全不变。所以旋转之后,单通道绝对值的上界依然是
(单通道绝对值不超过整体 L2 范数,因为 L2 范数是各分量平方和的开方。)
第四步:训练中实际观测到的极值更小。 报告给出的实测数字是——训练中观察到的最大幅度约为 10。它比理论界 22.6 还低一半以上,说明理论界是宽松的。
第五步:反推格式的动态范围够不够。 E2M1 能表示的最大值是 6。配上 E4M3 的 scale(E4M3 的最大值是 448),整体可表示的幅值上限是
而实际需要覆盖的最大幅度只有约 10(理论界 22.6)。2688 比 22.6 还高出两个数量级——报告的结论是「远高于缓存的幅值上界」,因此省略全局 scale 不会造成可测量的精度下降,同时简化了缓存的布局。
这个论证的一般形式值得记住:当你对一个已知范数上界的向量做分块量化时,只要「分块 scale 的最大值 × 数据格式的最大值」能覆盖范数上界,就不需要全局 scale。 全局 scale 的作用是处理跨块幅度差异巨大的情况;而 KV latent 经过 RMSNorm 之后,各块的幅度被归一化压在了同一个量级,跨块差异本来就不大——这才是敢省略的底气。
5.4 量化时机:为什么在 RoPE 之后
KV 量化的谱系本站覆盖得比较全:按通道/按 token 的非对称量化(KIVI)、旋转式离群值治理(QuaRot)、逐通道预旋转与稀疏离群值隔离(KVQuant)。V4.1 在这条线上的位置很特别——它不是给现成的 FP8/BF16 缓存打的一层量化补丁,而是把 4 位格式写进了训练流程(QAT),因此敢直接作用在整条 KV latent 上。
KVQuant(NeurIPS 2024)等经典工作反复强调过一件事:Key 的量化必须在 RoPE 之前做,因为 RoPE 旋转会把低频通道的能量「抹」到高频通道上,放大逐通道的分布差异,让量化更难。
V4.1-Flash 的做法相反——在 RoPE 之后量化。报告给出的理由是:「在我们的实验中,RoPE 之前量化只能带来边际的精度提升,却会在解码期间引入额外开销。」
这个权衡的算术很清楚:RoPE 前量化意味着缓存里存的是旋转前的向量,那么每次解码读取 KV 时都得现场做一次 RoPE 旋转——这是每步、每层、每个 token 都要付的代价。而收益只是「边际的精度提升」。在 890 字节/token 这个压缩目标下,省下这一步的解码开销比那点精度更值钱。
另外两个细节:
- 非 RoPE 分量和 RoPE 分量使用相同的量化格式。MLA 类架构里 KV latent 通常会被拆成「承载内容的非 RoPE 部分」和「承载位置的 RoPE 部分」,V4.1 没有对它们区别对待,统一按一套格式处理,简化了缓存的布局。
- SWA KV 保持 FP8。理由是对量化敏感。这是一个有意思的不对称:占大头的 global KV 用 FP4,只在最近 128 个位置上生效的 SWA KV 反而用更宽的 FP8。合理的解释是 SWA 承担的是局部精确依赖(相邻 token 的语法、指代),这部分对数值误差的容忍度远低于全局的粗粒度语义检索。
收益:相比 V4 的 FP8 main KV cache,FP4 近乎减半存储占用,而且在 HBM 和卸载到 SSD 时都成立——也就是说这个减半会同时体现在 runtime KV 和 persistent KV 两个口径上。
六、部署侧:SWA Bounded Replay 与持久缓存分层
前面三节都是模型架构的改动,这一节是纯粹的部署策略——也是 persistent KV 从 1/4 进一步压到 1/8 的地方。
6.1 问题:存了也白存的 SWA KV
回到 V4 的持久 KV 缓存设计。在 V4 的部署里,global KV 和 SWA KV 被独立管理,都遵循 LRU 淘汰策略,但缓存策略完全不同:
- Global KV 全量存储。命中时,整个前缀可以直接复用。
- SWA KV 只在两个特定点缓存——prompt 的末尾和输出的末尾,用于支持重新生成和多轮会话。命中时可以从那个缓存位置继续算。
由于 SWA KV 只保留 个条目,单看一份并不大。但报告指出:即使只保留指定位置上的 个 KV 条目,未压缩的 SWA KV 缓存仍然带来可观的存储开销,在多轮短对话场景下尤为明显。
问题出在访问模式与保留策略的错配。报告的分析很精准:
Global KV 表现出长尾复用——很久以前的上下文仍然可能被后续会话用到,所以长保留期是有意义的。而 SWA KV 只在活动会话内部一个狭窄的、分钟级的窗口里被复用,会话一结束或者下一轮一开始,它就成了死数据。
可是 V4 给持久缓存配置的保留期是——「在典型负载下,两类 KV 都能驻留 72 小时以上」。用一个 72 小时的策略去保存寿命只有几分钟的数据,命中率再高也是浪费。
V4 技术报告其实已经提出了一个方案,叫 Zero SWA Caching:干脆不存,用的时候重算。但这个方案在生产部署中被证明不可行,原因是重算的代价——精确恢复需要对 个 token 做一次完整的前向。
算一下这个数字有多离谱:,,。看起来只有 5120 个 token,好像不多?但这是一个完整的前向——40 层 Transformer、每层带一个 384 专家的 MoE。用 5120 个 token 跑一次全模型前向,和用 5120 个 token 做一次正常 prefill 的代价是一样的。而它的作用仅仅是恢复一份本该在几分钟后就失效的局部缓存。报告的原话是这笔开销「在生产部署中被证明是过高的」。
6.2 V4.1 的修正:三条改动
报告给了两条明确的改动加上一条保留项:
改动一:SWA KV 不再进入持久 KV 缓存,改为存放在从每台机器主机 DRAM 的 10% 划出的分布式内存池里。
这个池子的总容量比 SSD 小得多,但它的 TTL 只有分钟级——过期的条目可以立刻回收给新会话。报告的判断是:在真实负载下,这个高周转率足以服务绝大多数并发活动会话。
注意这里的逻辑:不是「用更小的存储装下同样的东西」,而是把保留期从 72 小时砍到几分钟,于是同样的物理容量能服务的会话数大幅上升。这是一个用调度策略换容量的经典手法。
把池子放在主机 DRAM 上、用 TTL 换周转率,这条思路在存储分层里并不新鲜——本站拆过的 H³ 就是在 HBM 与高带宽闪存之间做混合、再用延迟隐藏缓冲顶住换入延迟的硬件版。V4.1 的分布式内存池是同一个问题的软件版:既然这份数据的寿命只有分钟级,就不该给它按小时计费的存储。区别只在于,H³ 靠硬件缓冲藏住 20 μs 的换入延迟,而 V4.1 靠重放把「取不回来」这件事本身变得不再致命。
改动二:接受未命中,用 Encoder SWA Bounded Replay 兜底。
淘汰 SWA KV 必然带来未命中。这些未命中的请求会「命中 global KV 但错过 SWA KV」——按 V4 的老办法就得做 5120 token 的全量前向。
V4.1 的兜底方案是 Encoder SWA Bounded Replay:只重算 个 token(128 个),而不是 个(5120 个)。
报告对这一步的评价很高,称它是「整个设计的基石」:
这个有界重放把一次灾难性的未命中变成了一次优雅而廉价的降级,从而为「把 SWA KV 从持久缓存中移除」这个决定提供了正当性。
保留项:global KV 继续留在持久缓存里,保证生命周期至少 72 小时。 因为它的复用模式确实是长尾的。
6.3 有界重放的两种形态
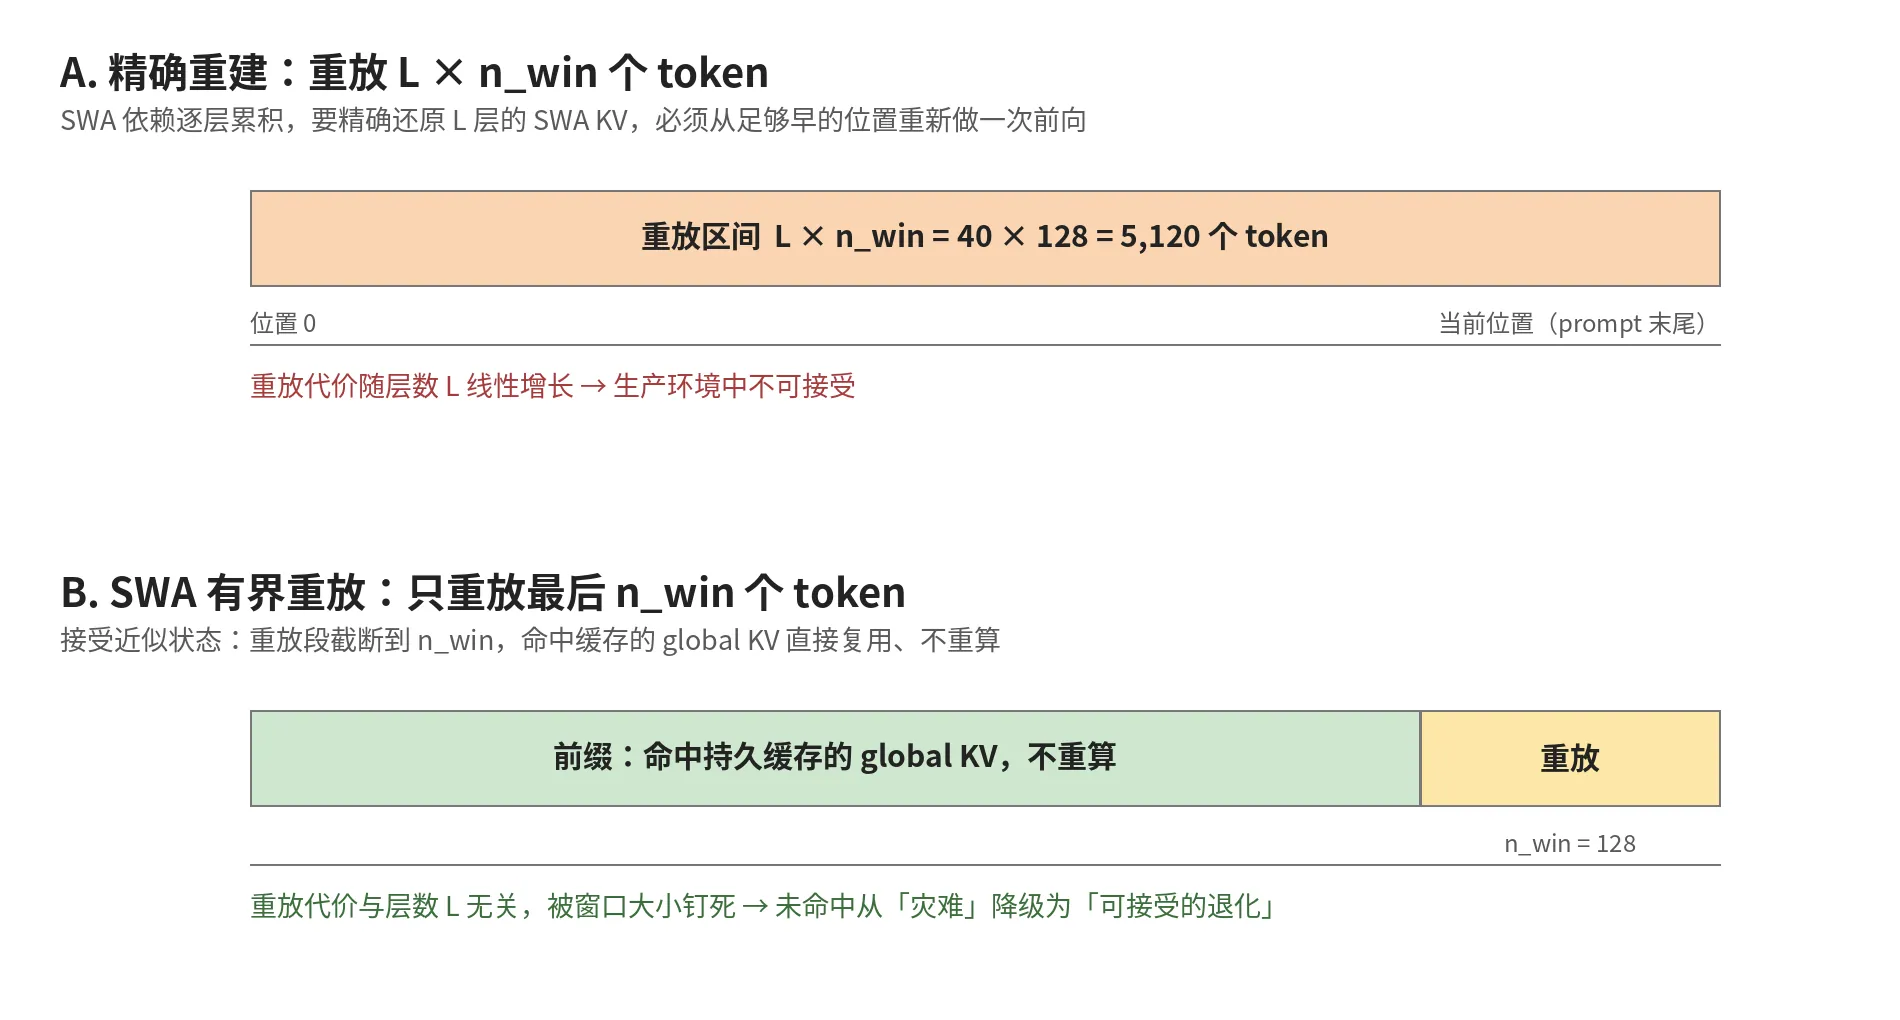
上图对比了两种策略的差别(此图根据报告 3.2.2 节描述绘制)。有界重放的核心近似是这样定义的:重放从位置 开始时,位置 的 query 只能看到
范围内的 SWA 键,其中 是窗口大小。也就是说,跨过重放起点的那些更早的 SWA 依赖被直接截断了。
Encoder SWA Bounded Replay 的目标是让前缀缓存只依赖 global KV,从而把 SWA KV 彻底移出持久缓存。流程是:
- 编码器 SWA KV 缺失时,重放缓存前缀的最后 个 token;
- 把这些重放的 token 与未缓存的后缀放在一起处理;
- 重放段只重建 SWA KV,global KV 直接复用缓存里的、既不重算也不覆盖;
- 未缓存的后缀则正常产生 global KV 和 SWA KV。
第 3 点是设计的关键——重放段不覆盖已缓存的 global KV,否则缓存的内容会随着「什么时候发生未命中」而漂移,同一个前缀在不同时刻读到的缓存就不一致了。
顺带把「前缀缓存」在 DeepSeek 服务栈里的位置说清楚:从 V3 推理系统开始,官方就用磁盘 KV Cache 消除共享前缀的重复 prefill(机制见本站 DeepSeek-V3/R1 推理系统完全拆解),而跨请求前缀复用在框架侧的标准形态是前缀树(RadixAttention);在 agent 场景里,这类缓存正是「540 GB 共享预计算 KV」那类大账的来源(本站 答疑特辑(四) 里算过一遍)。V4.1 做的事情不是发明新的复用机制,而是把不该进这份缓存的数据请出去——这也正是 1/8 里那「1/2」的来源。
Decoder SWA Bounded Replay 解决的是另一个问题:CED 下 prefill 为什么不能干脆在编码器就结束?
答案很明确——唯一的障碍就是解码器的 SWA KV。全局 KV 已经由编码器投影得到了,但解码器各层的 SWA KV 是从各层自己的隐藏状态生成的,而最初的几个解码步需要它。
精确重建这份 SWA KV,需要把 个解码器层跑在最后 个 prompt token 上。当「一个很长的已缓存前缀 + 一个很短的未缓存后缀」出现时,这个开销非常昂贵。所以同样的有界重放策略被应用过来:每次 prefill 只重放 prompt 的最后 个 token,把它们的编码器输出送进解码器层(施加同样的 SWA 截断),得到的解码器 SWA KV 只用于解码,不用于前缀缓存。
6.4 近似的代价与报告的坦诚
有界重放是一个近似,报告没有回避这一点,反而写得相当直白:
按设计,重放出的前缀状态是近似的,因此为未缓存后缀计算的 global KV 和 SWA KV 依赖于缓存命中位置,在不同位置之间不是数学上完全相同的。
这句话的含义值得展开:由于重放起点 取决于「缓存命中了多少」,同一段后缀在两次不同的请求里可能落在不同的 上,从而得到略有差异的 KV。这在确定性上有代价——理论上同一个前缀不一定产生同一个输出。
报告对两个机制的近似性分别做了说明,并且都强调「实验证明对响应质量的影响可以忽略」:
- Encoder 版:「令人鼓舞的是,我们的实验证据证实这个有界重放策略几乎没有损害响应质量。」
- Decoder 版:「我们也发现这个策略对响应质量的影响可以忽略。为了额外的安全性,我们在后训练期间额外模拟了相同的重放,以实现训练感知的适配。」
最后那句特别重要——在后训练阶段把重放过程模拟一遍,让模型在训练时就见到推理时会遇到的近似状态。这和分层稀疏索引器的「训练感知」是一脉相承的思路:凡是推理期引入的近似,就把它搬进训练期,让模型自己适配,而不是指望近似不造成伤害。
6.5 合成:1/8 的账
现在可以把持久缓存的压缩账算完整了。报告 3.2.1 节明确给出了两个乘法因子:
| 因子 | 贡献 | 来源 |
|---|---|---|
| 持久缓存不再保存 SWA KV | 约 1/2 | 第六节的部署改动 |
| 其中的 global KV 进一步压到 V4 的 1/4 | 约 1/4 | 第四节的 CSA2 + 第五节的 FP4 |
| 合计 | 约 1/8 |
这也解释了为什么 SWA KV 在 V4 里占了持久缓存的「近一半」——因为 global KV 那一半在 V4.1 里已经被压掉 4 倍了,如果不处理 SWA 这一半,整体的压缩比就会被它卡在 2 倍左右。一个系统里最慢的那个环节决定整体收益,这条规律在缓存优化里反复出现。
七、工程侧:15 个 kernel 的推理路径
架构越做越复杂,但推理系统的复杂度必须反向压下来,否则再好的理论压缩也落不了地。报告用一句话概括了 V4.1 的落地原则:
尽管架构在概念上很复杂,但由此产生的推理 kernel 流程却相当简洁。
具体做法是通过合理的 kernel 融合,把复杂的操作封装在少数几个融合 kernel 内部,让硬件资源在内部保持满流水。报告点名了几个关键组件:
- FlashMLA 里的 fused-RoPE-attention-RoPE-cast kernel——注意这个名字里 RoPE 出现了两次,说明整个「读缓存 → 反 RoPE/再旋转 → 注意力 → 写回」的过程被压进了一个 kernel,中间不落显存;
- DeepGEMM 里的 Mega-Gate、Mega-mHC、Mega-MoE 三个融合 kernel;
- TileKernels 中的一组 kernel;
- DeepSelect 里的 TopK kernel(稀疏索引器选 Top-512 用)。
这些组件本站大多拆过:DeepGEMM(FP8 GEMM 与两级累加)、MLA 完全拆解(FlashMLA 的矩阵吸收与 kernel 设计)、DeepEP(MoE 的 dispatch/combine 通信内核)。这里只关注它们的协同结果:绝大多数 Transformer 层——准确地说是 CSA2 工作在 Reuse 模式的那些层——prefill 只需要 15 个 kernel,decode 只需要 11 个。
为什么 Reuse 模式能这么省?回看第四节的图 4 就明白了:Reuse 层不需要 indexer Q、不需要打分、不需要选 Top-K,它只做「读选中的 main KV + 拼上自己的 SWA KV + 做核心注意力」。索引器的整条路径被完全跳过,所以 kernel 数能压到十几个。
整个推理系统还采用了 Encoder–Prefill–Decode(EPD)解耦的部署形态,让视觉编码、prefill、解码三个阶段独立扩缩容并重叠执行(EPD 的来历与 V3 推理系统的专家并行、双批重叠一脉相承,见本站 DeepSeek-V3/R1 推理系统完全拆解)。
一个附带亮点:Single-Pass mHC 的访存账
V4 引入的 mHC 在相邻 Transformer block 之间维护 条残差流。对每个 token,记这些流为 ,更新规则是
其中 、、 是逐 token 从 预测出来的系数, 是包含归一化和投影的系数预测器, 是 block 本身(注意力或 MoE)。
理想的实现应该是一次映射:把 一次读入、一次写出得到 ,其中 是当前 block 的输入。这需要读取和写入各 个值,因此激活访存量的下界是 。
但 V4 的实现是三个串行 kernel,因为存在数据依赖:
三个 kernel 分别读 、、 个值,共写 。算上 里的 pre-norm,总访存量是 ——正好是下界的两倍。
能不能融合?报告的分析是:把归一化权重离线折进投影权重、RMS 除法放在投影之后,那么残差更新和系数预测可以共用一次遍历——因为残差更新不需要在隐藏维上做归约,所以 的每个 tile 算完就能立刻用来累加投影输出和 RMS 所需的平方和。
但输入混合融不进去: 要等所有隐藏维 tile 的归约全部完成才可用。于是至少需要第二遍读 ,总访存降到 。
真正的解法是 Single-Pass mHC——把输入混合的系数挪一个 block:
输入混合改用 而不是 ,于是它不再依赖从 算出的系数。每个 tile 都能立刻同时用于输入混合和系数预测,不必等待完整归约。报告说这个位移带来的性能损失可以忽略。
部署时对应的 kernel 是 Mega-mHC,它把残差更新、输入混合、系数预测融成一个 kernel,还顺带融合了输入 pre-norm 和 FP8 转换。结果是残差只读一次、只写一次,达到理想映射的 读 + 写,激活访存量减半。
顺带一提,训练时仍保留多 kernel 实现——因为系数位移只改变每个 block 用哪一组混合系数,对训练流程本身没有影响。
其他配套改动
mHC 之外,V4.1-Flash 里还有两块与推理直接相关的拼图——Engram 条件记忆与 DSpark 投机解码。它们不属于「KV 压缩」,但决定了这套压缩在真实负载下的实际表现,下一节单独展开。
八、另外三块拼图:Engram、DSpark 与 MoE
前面七节都在讲「缓存怎么变小」。但 V4.1-Flash 里还有几块与推理直接相关的拼图,缺了它们,890 字节的账会看不懂——因为它们解释的是同一件事的另一面:哪些东西根本不必算、不必放进 KV,甚至不必放进显存。
8.1 Engram 条件记忆:把「记住」和「算」分开
196B 的 Engram 参数在这个模型里占了四分之一还多,但它做的事情和 Transformer 层完全不同:它不是更多的计算,而是一套可检索的条件记忆(conditional memory)。
机制上是 N-gram 查表:把输入序列切成 2-gram、3-gram、4-gram 单元,用 8 个哈希头把每个单元映射到各自的记忆表(每个头约 1600 万条目),命中即取回对应的 embedding,再经过条件门控决定以多大强度注入当前 token 的表示;表本身以 FP8 存储。有几件事值得单独拎出来:
- 它把「记忆」从「参数」里拆了出来。 稠密模型和 MoE 都必须把知识编码进矩阵乘的权重里——想知道什么,就得花算力算一遍。Engram 走的是检索:命中即拿到,开销是访存而不是矩阵乘。这和 MoE 正好互补——MoE 决定算多少,Engram 决定记在哪。
- 寻址是确定性的,因此推理时可以把 embedding 从主机内存通过后台 RDMA 预取——第一个 Engram 模块的预取与第一个 Transformer block 的计算重叠。注意这与第六节的 SWA 内存池是同一套思路:KV 是算出来的、必须常驻显存;记忆是查出来的、可以放在主机内存甚至更远的地方。每个 token 实际只读取几十行数据,正是这一点让「大词典放慢速存储」在工程上成立。
- 放置位置是有讲究的:196B 平均分给两个模块,分别放在第 1 层与第 14 层(0 起始),目的是平衡各训练流水阶段的显存占用。推理侧的容量分配问题,在训练期就已经被考虑过一遍了。
8.2 DSpark:投机解码从「自投机」换成「外挂草稿」
V4 还在用 MTP(多 token 预测)模块做自投机解码(本站 MTP 完全拆解 讲过机制与约 1.8 倍的收益),到 V4.1-Flash 则换成了独立训练的 DSpark——本站此前对它有完整拆解(DSpark:半自回归生成与置信度调度的投机解码),这里只列它在 V4.1-Flash 里的具体形态:
- 草稿器是 3 个 Transformer block,滑窗 128;一次前向并行算出 5 个草稿位置的基础 logits;
- 一个轻量 Markov 头建模草稿 token 之间的依赖,解决并行草稿固有的「接受率衰减」问题;一个置信度头预测逐位置的条件接受概率;
- 调度器结合引擎的吞吐曲线,动态决定每个请求验证多少个草稿 token——在高并发下把「注定被拒绝的验证」省下来,把验证 batch 的容量让给别的请求。
训练安排值得单独记一笔:DSpark 在预训练之后单独训练(主干冻结),后训练阶段与主干一起训练,但不把 DSpark 的梯度回传到主干。对照来看 MTP 是与主干联合训练的——把投机解码做成一个可插拔的外挂件,而不是长在主干上的器官,这是工程可控性上的一次明确取舍:草稿模型可以独立迭代、独立回滚,代价是要为它单独准备一份权重与显存。
把这段与前面几节串起来,解码路径上的三个乘数就清楚了:CED 让每一步便宜(8B/16B 的非对称激活),DSpark 让一步能吐出多个 token,CSA2 与 FP4 让每一步要读的 KV 更小。三者优化的是三个不同的因子,缺一不可。
8.3 MoE:384 个专家的老配方
语言骨干的每个 MoE 层仍是细粒度专家加共享专家那一套(原始设计见本站 DeepSeekMoE 完全拆解),前几层继续沿用哈希路由(按 token id 的哈希决定专家,零路由开销)。
这里没有新故事,但这本身就是一条值得注意的信息:V4.1 的架构改动几乎全部发生在注意力与 KV 上,前馈网络部分基本不动。看一家公司认为瓶颈在哪,最直接的方法就是看它改了什么、没改什么。
九、发布之后:定价、实测与争议
技术报告回答的是「架构能把成本压到多低」,而模型上线之后,社区、媒体与开发者补上的是另一半:这些压缩怎么变成账单上的数字,边界又在哪里。 这一节把发布后两周里的解读收拢一遍,并标清每一类数字的来源。
9.1 官方口径:降价、并发与基准
发布同时官方宣布了三件事:
- 价格:缓存命中的输入降到 0.02 元/百万 token(降幅 60%),未命中输入降到 1 元/百万(降 33%),输出降到 4 元/百万(降 11%);高峰时段(工作日 9:00–12:00 与 14:00–18:00)价格为空闲时段的两倍。按一个固定工作量的测算(100 万缓存命中 + 10 万未命中 + 1 万输出 token),闲时账单从 0.245 元降到 0.16 元,降幅约 34.7%。
- 并发:正式版的请求并发上限提到 2,500(内测版本的限额只有 20,被评测者吐槽「这个速度优势在高并发下能不能保持,内测数据回答不了」)。按 890 字节/token 的口径,1M 上下文的一份完整 runtime KV 不到 1 GB——2,500 路并发在 KV 侧的总占用,大致相当于过去几百路全注意力会话的量级。
- 基准(均为厂商自报,尚无独立复现):Terminal-Bench 2.1 得 90.6(V4-Pro 为 87.9)、DeepSWE v1.1 得 74.2、CyberGym 得 88.1(V4-Pro 为 83.3)、Codeforces 3471;GPQA Diamond 90.9,仍落后于 Opus 的 93.4 与 GPT-5.6 Sol 的 94.1。这组数字里,强项主要在 agentic 与代码类任务上,纯知识问答仍是短板。
9.2 第三方实测与质疑:单价降了,账单不一定降
实测给出的图景比公告复杂,而且矛盾点恰好落在本文的主题上:
- 同一批任务的账单反而更高。 有第三方用 14 组任务做对照实测:V4.1-Flash 累计花费 61.96 元,前代 V4-Flash 为 45.47 元,高出 36%。多出来的钱主要不在单价而在行为——V4.1 更爱拆任务、开子 Agent,两个大任务派出了 37 个子 Agent,子任务累计消耗超过 1 亿 token,交接与返工也都被计费。
- 速度提升要看口径。 官方口径下峰值 507 token/s、稳定 300+ token/s(旧版约 97 token/s);也有海外独立端点的实测只有约 108 token/s,与旧版基本持平。这里有两层要分开:一是 300+ token/s 是单用户低并发下的数字,高并发下要另算;二是 token/s 与账单是两件事——按 token 计费时,吐得越快往往意味着同一段时间里消耗的 token 越多。
- 长上下文质量存在分歧。 十万字量级的长文实测里出现过前后记录矛盾、长文一致性不如前代;也有开发者报告缓存命中率约 98%、长上下文的工程开发「极度省钱」。这类分歧在 agent 负载上很典型:命中率高时这套压缩便宜得惊人,命中率掉下来时未命中输入仍是 1 元/百万——persistent KV 压到 1/8 改变的是缓存集群的成本,不改变未命中的单价。
- 模型路由引发争议。 官方宣布自 9 月 14 日起,发往 V4-Pro 的请求将自动路由到 V4.1-Flash(按 Flash 单价计费),直到 V4.1-Pro 发布。支持者认为这是省钱的好事,批评者担心它会悄悄改变已经调校好的生产工作流、影响评测与安全审查的可复现性。这类「用性价比换可控性」的取舍,与第六节里把 72 小时改成分钟级 TTL 是同一种思维的两次现身:都是拿不再重要的东西,去换更重要的东西。
9.3 怎么读这些数字:三条口径纪律
把上面几组数字放在一起,能得到一条比任何单个 benchmark 都更有用的方法论:
- 区分服务成本与开发者账单。890 字节/token、1/4 与 1/8 描述的是服务的单位成本——同样的卡能服务多长的上下文、多少路并发。它是否变成开发者账单的下降,取决于两件事:缓存命中率有多高(命中与未命中的价差是 50 倍),以及模型会不会用更多 token 完成任务。压缩的是分母,agent 的行为决定的是分子。
- 区分模型卡数字与报告数字。890 字节/token 来自模型卡,1/437 是厂商基于不同代际基线做的算术;报告里给出完整乘法分解的只有持久缓存的 1/8(1/2 × 1/4),全局 KV 的 1/4 并没有逐项归因表(本文第二节那个「对半拆分」也是从两个已知量推出来的)。凡是厂商口径,都值得先标注来源再引用——社区里已经有解读明确提醒了这一点。
- 区分单流速度与高并发吞吐。DSpark 的置信度调度在单流下收益有限、在高并发下才放大(本站 DSpark 拆解 里有清晰的消融:仅半自回归生成提升 8–12%,仅置信度调度提升 15–20%,两者叠加在高并发下最高到 661%)。单用户的速度与集群的吞吐是两条不同的曲线,实测里只看前者,很容易得出与后者相反的结论。
十、开源与生态:这套架构改动怎么落地
10.1 权重、许可与量化格式
V4.1-Flash 的权重以 MIT 许可、免申请(ungated)的方式公开,架构标识符为 DeepseekV41ForCausalLM。一个值得注意的细节是量化格式在模型里的分层:MoE 的路由专家权重在 FP8 配置下以 FP4 存储(非专家部分保持 FP8),而 KV 走的是第五节的方案——FP4 主缓存加 FP8 滑窗缓存。
也就是说,「FP4」在这代模型里出现在三个不同的位置:专家权重、索引器 Q/K、主 KV。三处省的东西完全不同——权重驻留、索引计算、缓存容量与带宽——不能把它们当成同一件事去算收益。第五节里 FP4 让条目「近乎减半」、第二节里那「8 倍中的 2 倍」,说的都只是主 KV 这一处。
10.2 推理引擎与硬件适配
生态侧的推进速度,可以反推出这套架构的迁移成本:
- vLLM 的 Ascend 后端在发布当天给出了实验性支持,已验证的配置是 W8A8 权重、INT8 存储的 Engram、TP8 / DP4 / EP32 并行、启用 DSpark、目标模型跑 FULL_DECODE_ONLY 的 ACL Graph,并支持自动前缀缓存;暂不支持 prefill-decode 分离、流水线并行与新一代 model runner。两个细节值得记:一是 Engram 表可以用 INT8 而不是 FP8 存(表是查出来的,精度要求比计算路径宽松);二是论文里讲的 EPD 解耦,在这条硬件栈上还没有对应实现——架构能力与某条具体软件栈的支持矩阵,从来不是同一件事。
- 硬件厂商 Day-0 适配:有厂商公开了用 5 层主干 block 加 1 层 DSpark block 的真实量化权重切片,验证 prefill、连续 decode 与投机解码的完整流程,并指出 V4.1 在 mHC 残差混合上的语义变化主要涉及 Sinkhorn 初始化与 pre 系数处理(正是第七节 Single-Pass mHC 的落点),系数投影与残差合并的主体可以复用。改一个 block 的系数来源这种看似微小的改动,跨平台迁移时也需要逐个对齐语义——这是把复杂度从运行时推到编译期与训练期之后,必然要付的一次性成本。
10.3 本地部署的账:KV 不再是瓶颈,权重才是
把 890 字节/token 代进本地部署的算式,结论有点反直觉:1M 上下文的会话,KV Cache 总共不到 1 GB——缓存已经从「决定能不能跑」的问题,变成了可以忽略的零头。真正压不住的仍然是权重:552B 骨干按 8 bit 约 552 GB、按 4 bit 约 280 GB,还要再加 196B 的 Engram 参数。MoE 的 8B/16B 激活省的是算力与带宽,不减少驻留容量——这两个数字经常在讨论里被混为一谈。
社区里「四台 DGX Spark 能不能跑 500 GB 权重」这类讨论之所以成立,靠的正是 Engram 的确定性寻址(把记忆放在慢速存储上、只预取命中的行)与 MoE 的稀疏激活,而不是 KV 压缩本身。这也从反面说明了本文的定位:V4.1-Flash 解决的从来不是单机能跑多大的模型,而是同样一批卡能同时服务多少路、多长的上下文。
十一、代价、边界与还没解决的问题
一项把缓存压到 1/4、持久缓存压到 1/8 的技术,代价必然存在。报告在结论的 “Limitations” 部分主动列了几条,这些比成绩更值得读。
近似带来的鲁棒性边界尚未完全刻画。 报告承认:「新引入的架构改动也带来了尚未被完全刻画的鲁棒性边界」。具体点名了两处:
- CSA2 的选择错误——稀疏索引器选错了 Top-K,就等于注意力根本没有看到本该看到的位置;
- SWA Bounded Replay 的近似状态重建——重放起点的截断会让状态与精确值有偏差。
报告说内部评估覆盖了多种测试用例和边界条件,没有观察到系统性的能力退化,但也明确表示「没有哪个有限的测试集能覆盖所有极端输入和部署条件」。后续方向是继续扩大压力测试栈,特别关注长上下文下的稀疏检索和缓存恢复边界处的 SWA 状态重建。
这是两处「静默失败」的风险点——它们不会报错、不会崩溃,只会在某个没测到的输入上给出质量下降的结果。对做部署的人来说,这类风险比性能数字更需要被监控。
激活参数的权衡。 decode 侧 16B 的激活量比同尺寸模型更重。CED 的非对称设计只在输入重的负载下划算;负载形状相反时收益会被稀释。8B/16B 的拆分与缓存命中行为的实际收益,也需要独立的端到端吞吐和账单数据来验证。
工程复杂度没有消失,只是被藏起来了。 CSA2 的三种模式、静态层分配、分层索引器的候选池、训练感知的候选限制、影子索引器(shadow indexers,用于在流水线并行下支持跨阶段共享参数的轻量副本)、micro-batch 级的共享状态生命周期管理……这套机制对训练和推理基础设施的要求相当高。报告在 3.1.2 节专门讲了「支持 CSA2 的注意力共享训练」,因为共享组件的层可能被放在不同的流水线阶段上,直接的模块复用与传统的阶段本地执行不兼容。把复杂度从运行时推到了编译期和训练期,这是这类设计的典型代价形态。
厂商口径是这套数字的边界。 本文引用的效率数字——890 字节/token、1/4、1/8、以及三代 437 倍的代际差——全部来自 DeepSeek 自家的模型卡、技术报告与官方服务栈。报告没有给出全局 KV 那 4 倍压缩的逐项字节归因,也没有给出跨硬件的可复现实验;社区侧对「1/437」这类跨代算术的提醒是合理的。对做部署决策的人来说,这些数字更适合用来判断架构方向对不对,而不是直接拿来做容量规划——后者需要的是在自家负载上跑出来的缓存命中率、TTFT 与 TPOT(口径参见本站 LLM 推理 Benchmark 完全指南)。
压缩的收益会被工作负载的行为吃掉一部分。 第九节的实测给出了一个反例:KV 与单价都压下去了,但模型更爱开子 Agent、单任务消耗的 token 更多,账单反而涨了三成。这不是压缩做错了,而是成本优化从来是「单位成本 × 用量」两个变量的乘法——架构能改的是前者,后者由模型的行为策略决定。agent 负载尤其如此:一次工具调用循环里的每一轮都可能打破前缀缓存,命中率是这套压缩能否兑现的最关键变量。
小结
把 V4.1-Flash 的推理侧设计按「压缩了什么、怎么压的、代价在哪」重新梳理一遍:
| 技术 | 压缩对象 | 手段 | 收益 | 代价 |
|---|---|---|---|---|
| CED | prefill 计算量 | decoder 的 global KV 由第 20 层隐藏态投影 | prefill 计算量近乎减半,激活 8B | 仅利于输入重负载;decoder SWA 需重放 |
| CSA2 跨层复用 | global KV 条目份数 | 40 层只有 8 层独立产生 main KV | 层维上大幅减少条目 | 层间表达自由度下降,用 Reindex 部分找回 |
| 分层稀疏索引器 | indexer 打分成本 | Full 层建候选池,Reindex 层只在池内打分 | 深层索引器代价与上下文长度无关 | 首个 Full 层仍需全范围扫描 |
| FP4 main KV | 每条目位宽 | E2M1 + 每 16 通道 E4M3 scale,RoPE 后 QAT | 存储近乎减半,HBM/SSD 双受益 | 需要反量化,量化时机做了取舍 |
| SWA Bounded Replay | persistent KV | SWA KV 移出持久缓存,未命中只重放 128 token | persistent 再降一半 | 状态是近似的,与命中位置相关 |
三句话概括这套设计的思想:
-
KV Cache 的压缩是乘法关系,不是加法关系。 条目大小 × 序列压缩比 × 层维复用,三个维度乘起来才有 4 倍。只优化其中一维会被其他维度卡住——这正是 V4.1 把 SWA KV 也处理掉的原因:留着它,整体压缩比就上不去。
-
凡是推理期的近似,都搬进训练期。 分层稀疏索引器的候选限制在训练和推理时同样施加;SWA 有界重放在后训练中被模拟。不是指望近似无害,而是让模型在训练时就学会在近似状态下工作。
-
省存储和加速计算是两件事,要分开设计。 FP4 KV 的收益纯粹来自容量和带宽,所以「反量化后再算」这个决定才能成立——它把存储格式与硬件矩阵乘能力解耦了。同样,SWA Bounded Replay 省的不是算力而是 SSD 容量,所以它才愿意付出一点重算代价。
另外两句话,留给「压缩之外」的部分:
- 记忆、计算、缓存是三笔分开的账。Engram 把「记住」变成检索(用访存换矩阵乘),MoE 把「算」变成按需激活,CED、CSA2 与 FP4 把「存」压到极限——V4.1-Flash 的每个部件都在优化这三笔账中的一笔,混着看就会得出「参数涨了为什么反而更省」这种看似矛盾的结论。
- 发布之后的故事同样是技术的一部分。单价降 60%、并发提到 2,500 是压缩的直接兑现;但第三方实测里账单反而涨三成、长文质量存在分歧、以及厂商口径与实测口径的差距,共同说明架构决定成本的下限,行为与命中率决定成本的实际值。
从 389,120 字节到 890 字节,三代 437 倍。这条曲线的斜率背后,是「算力已经不再是唯一稀缺资源」这个判断在架构层面的具体落地。而围绕它的解读与实测,才刚刚开始——这可能是第一份把缓存效率当作模型核心卖点的技术报告,但不会是最后一份。
本站相关拆解
本文涉及的技术,本站大多有专文展开,按阅读顺序排:
- DeepSeek 技术全景:从 67B 稠密模型到 1.6T 稀疏模型的三年演进——把本文放回时间线
- MLA 完全拆解——低秩 KV 压缩与 FlashMLA kernel,本文 FP4 主缓存量化的对象就是它的潜空间
- GQA 完全拆解——第二节「维度一」的另一条路线
- DeepSeek-V4 混合注意力完全拆解——CSA/HCA、闪电索引器与异构 KV Cache,CSA2 的直接前身
- NSA 原生稀疏注意力(一) / (二)——压缩-选择-滑窗三分支,以及 DSA 的工程落地
- LSA(LongCat Sparse Attention)完全拆解——跨层索引与层级索引,与 CSA2 最值得对照的另一条路线
- SWA 滑窗注意力完全拆解 / Prefix Sliding 完全拆解——滑窗分支的机制,以及「窗口外的信息到底有多少真被用到」
- KVQuant 完全拆解 / KIVI 完全拆解 / QuaRot 完全拆解——KV 量化的三条经典路线
- 浮点数与数值稳定性 / 面试疑难(三)——E2M1、E4M3 的位布局,与 MXFP4 为什么能不掉精度
- DeepGEMM 完全拆解 / DeepEP 完全拆解——第七节的融合 kernel 与通信库
- DeepSeek-V3/R1 推理系统完全拆解——专家并行、双批重叠与 EPD 解耦的来历
- DSpark 完全拆解 / MTP 完全拆解——两代投机解码方案的交棒
- PagedAttention 完全拆解 / RadixAttention 完全拆解——runtime KV 与 persistent KV 各自的框架侧机制
- H³ 完全拆解——HBM 与高带宽闪存的分层混合,第六节内存池的硬件版
- DeepSeekMoE 完全拆解——第八节 MoE 部分的原始设计
参考资料
- DeepSeek-V4.1-Flash 技术报告(DeepSeek_V41_Tech_Report.pdf)
- DeepSeek-V4.1-Flash 模型仓库
- DeepSeek V4.1 Flash:更强、更快、更普惠(官方发布公告)
- YOCO: You Only Cache Once: Decoder-Decoder Architectures for Language Models
- Microscaling Data Formats for Deep Learning(OCP MXFP4 格式来源)
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Introducing NVFP4 for Efficient and Accurate Low-Precision Inference(NVIDIA 官方博客)
- DeepSeek AI Released DeepSeek-V4.1-Flash with 1M Context, FP4 KV Cache, and Cross-Layer Attention Reuse(MarkTechPost 解读)
- 参数几乎翻倍,推理反而更省:DeepSeek V4.1-Flash 重构 KV Cache(InfoQ 解读)
- DeepSeek V4.1 Flash explained: how it cuts AI memory 8x(The Neuron 解读)
- vLLM-Ascend:DeepSeek-V4.1-Flash 部署指南(实验性支持与已验证配置)
- DeepSeek V4.1 Flash 实测复盘:性能表现、Pro 全量路由机制与调用避坑指南
- DeepSeek V4.1 Flash 正式上线:降价生效了,但有人反而多花了钱(腾讯云开发者社区实测)
- DeepSeek cuts cache-hit prices 60% as V4.1 Flash claims 4x memory saving(Edgen 报道)
- DeepSeek V4.1 Flash: New Base Model, Not a Point Release(OrcaRouter 解读,含对厂商口径的提醒)
- DeepSeek’s ‘Cheaper’ V4.1 Flash May Actually Cost Developers More Per Task(AInvest 质疑)
- 云天励飞 IFWA 软件栈 Day 0 适配 DeepSeek-V4.1-Flash(mHC 语义变化与适配细节)
- Engram: 条件记忆模块(arXiv:2601.07372)
- mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880)
配图说明:图 1(b)、图 2、图 3、图 4、图 5 取自 DeepSeek-V4.1-Flash 技术报告;SWA 有界重放示意图根据报告 3.2.2 节描述绘制。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


