


RadixAttention 完全拆解:用前缀树自动复用 KV Cache,让共享前缀只计算一次
背景:LLM 程序里无处不在的共享前缀
先回顾一个已经被反复强调过的事实:Transformer 的自回归推理分成 prefill(预填充)和 decode(解码)两个阶段。prefill 阶段把整段 prompt 并行过一遍前向计算,同时算出每一层注意力需要的 K 矩阵和 V 矩阵,合起来就是 KV Cache(名字就来自注意力里的 key-value 对);decode 阶段每生成一个 token,都要带着前面全部 token 的 KV Cache 再做一次注意力。KV Cache 的计算只依赖「当前 token 之前的所有 token」,这是一个关键性质:相同的前缀,必然产生相同的 KV Cache(在权重和采样配置不变的前提下)。既然如此,两个请求共享的那段前缀,KV Cache 只需要计算一次,第二个请求直接拿来用就行——这就是「KV Cache 复用」的全部出发点。
从公式上可以看清「前缀决定一切」的数学本质。设第 个 token 的 query 为 ,它的注意力输出是:
其中 、 是第 1 到第 个 token 的 key/value 矩阵, 是注意力头维度。第 个位置只与「它自己和它之前的 token」做注意力,所以当两个请求在第 个 token 之前完全相同时,前 个位置的 K/V 张量逐位相同。这是 RadixAttention 能安全复用的理论前提——不存在近似、不需要校验:相同的输入经过相同的权重,输出确定(推理时 dropout 关闭、权重冻结),命中就是精确命中。
KV Cache 本身的体量也值得记住:以 LLaMA-7B 为例,32 层、每层 32 个注意力头、头维度 128,一个 token 的 K/V 张量大小为 ,8K 上下文就是约 4GB 的显存。这些张量算出来之后如果随请求丢弃,下一轮请求又要花同样的算力和内存重新生成——缓存它们,就是在缓存真金白银。
再算一笔「重复 prefill」的账,感受浪费的量级。prefill 阶段的计算量粗略估计为:
其中 是模型参数量, 是输入长度(Transformer 前向总计算量 的简化形式)。一个 7B 模型处理 8K token 的 system prompt,需要 次浮点运算;而 A10G 的 FP16 峰值算力约 125 TFLOPS——也就是说,仅仅这一条 system prompt 的 prefill,就要烧掉接近一秒的纯计算时间。10 个并发请求共享同一个 8K system prompt,就是 10 遍完全相同的计算:约 9 秒的 GPU 算力被浪费,还要叠加到用户的等待时间上。
实际生产环境中,共享前缀无处不在,而且远比想象的多:
- 系统提示词(System Prompt):几乎所有服务都会在每轮请求里携带同一段角色设定和工具说明,几百到几千 token 全是重复计算;
- Few-shot 示例:MMLU 这类评测把 5 个示例拼在每个问题前面,问题各不相同,但示例部分完全共享;
- 多轮对话历史:同一会话的第 轮请求,输入里包含前 轮的完整对话,逐轮递增;
- Agent 的工具与模板:ReAct、function calling 这类工作流的工具描述和思考模板每次调用都带上;
- RAG 上下文:同一批检索到的文档片段会被多个问题引用;
- 并行采样与树搜索:self-consistency(自洽性采样)、tree-of-thought(思维树)从同一个 prompt 分叉出多个生成,前缀完全相同。
论文里用一张图总结了四种最典型的共享模式:few-shot 示例共享、self-consistency 中同一问题的多次采样、多轮对话的聊天历史、以及思维树的搜索历史。
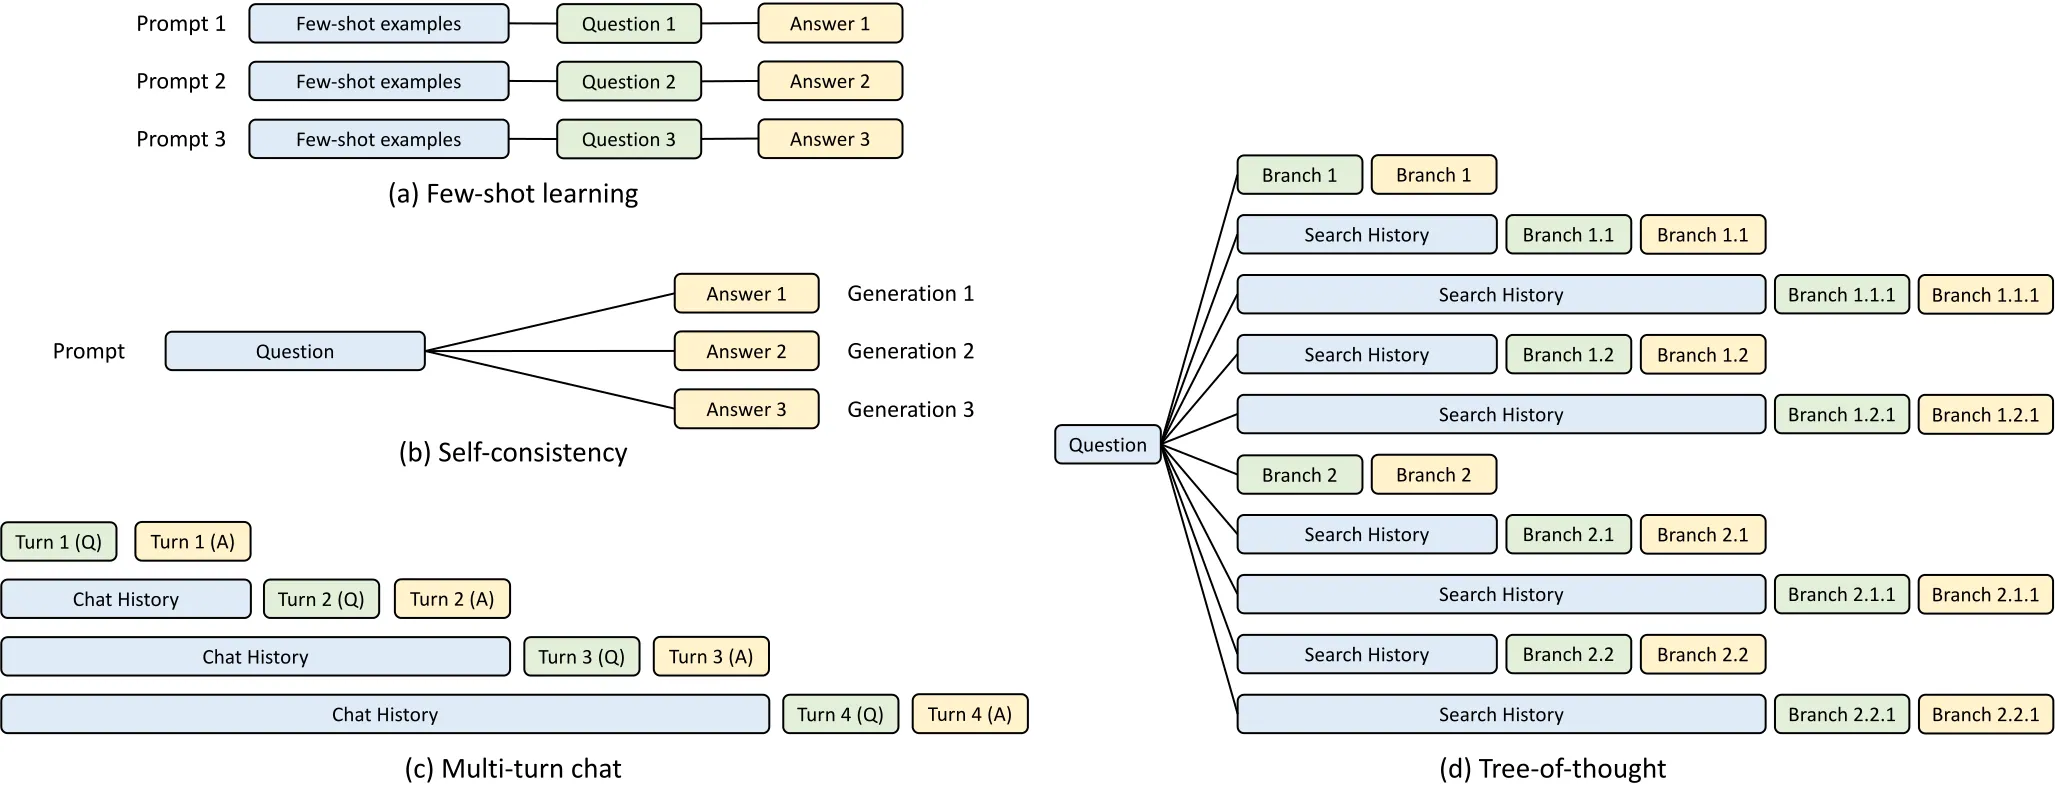
(图片来源:SGLang 论文 Figure 9。蓝框代表可共享的 prompt 片段,绿框是不可共享的输入,黄框是模型输出。)
这张图想传达的重点是:共享不一定发生在「完整请求」层面,而是发生在任意长度的前缀层面。两个请求可以只在开头共享 2K token,后面完全分叉;也可以共享好几层(few-shot 示例之下再共享公共问题前缀,形成两级共享)。问题在于,当时所有主流推理引擎(vLLM 早期版本、HuggingFace TGI、llama.cpp)处理完一个请求就把 KV Cache 直接丢弃——以上所有共享前缀,每来一个请求都要从头重新算一遍。
重复 prefill 的代价比很多人直觉的更大。prefill 是计算密集的:输入多长,就要对多长的序列做完整的注意力计算,GPU 浮点算力全部烧在这里;而 decode 每步只算一个 token,瓶颈在内存带宽。一个 8K token 的 system prompt,10 个并发请求就是 10 遍重复 prefill,吞吐被直接打穿,首 token 延迟(TTFT)也被拖高——用户的第一感觉就是「转圈转得久」。
2023 年 12 月,斯坦福与 UC Berkeley 的 LMSYS 团队(Lianmin Zheng 等人)在 arXiv 发布了 SGLang 论文《SGLang: Efficient Execution of Structured Language Model Programs》(arXiv 2312.07104,后被 ICML 2024 接收),其中的核心创新 RadixAttention(基数树注意力)就是来解决这个问题的。这篇拆解就围绕 RadixAttention 展开。
为什么简单的「请求级缓存」不够
先想想最直觉的方案:把整个请求的 KV Cache 按输入文本哈希后缓存起来,下次遇到完全相同的输入直接命中。这种「请求级缓存」只能覆盖整段 prompt 完全相同的场景,而且仔细一想,连多轮对话都覆盖不了:第二轮请求的输入 = 第一轮输入 + 第一轮输出 + 新消息,和第一轮请求的输入并不相等,哈希对不上,只能整个重算。两个用户共享 system prompt 但问题不同,同样整个重算。
要利用部分共享,需要的不是「整串匹配」,而是任意长度的前缀匹配(Longest Prefix Match)。进一步观察会发现,多个请求之间的共享关系天然构成一棵树:两个会话在根上共享 system prompt,各自的分叉再产生子共享……这种多级树形共享,用一张「共享 system prompt 表」也覆盖不了——表只支持一层,树的每一层都需要一层匹配结构。
SGLang 论文的 Related Work 部分逐一点了当时各路方案的局限:
- vLLM 早期版本只探索了一些简单复用场景(如 system prompt 共享),不支持多级树形共享,也没有 LRU 缓存的概念(论文对比时特意用了未集成前缀缓存的旧版 vLLM;后来 vLLM 才把 RadixAttention 作为可选实验特性部分集成进来);
- PromptCache(arXiv 2311.04934)提出前缀之外的模块化 KV 复用,但这类「非前缀」的近似复用可能带来最高 43% 的精度下降;
- HydraGen、FlashInfer、ChunkedAttention 专注 CUDA kernel 层优化(共享前缀的注意力计算),但都没有「把缓存管起来」的 LRU 概念;
- APIServe、LLM-SQL 只针对特定应用场景做 KV 复用。
结论很明确:需要一种把「任意前缀」当作缓存单元、天然支持树形共享、并且能自动淘汰的运行时级方案。这正是 RadixAttention 做的事情。
核心思想:把 KV Cache 当成操作系统的页缓存来管
RadixAttention 的核心思想可以用一句话概括:把计算过的 KV Cache 全部保留下来,组织成一棵前缀树,每个新请求自动做最长前缀匹配,命中的部分直接复用,只计算没命中的尾巴;树按照 LRU 策略自动淘汰。
这本质上就是把 KV Cache 当成操作系统的页缓存(page cache)来管理:页缓存里存的是磁盘块,按页组织、按 LRU 淘汰、被进程共享;RadixAttention 里存的是 token 序列的 KV 张量,按前缀组织、按 LRU 淘汰、被请求共享。区别只是「块」换成了「前缀」。
为什么要用前缀树(Radix Tree),而不是哈希表或普通字典树(Trie)?对比一下:
- 哈希表:查找 O(1),但不支持前缀匹配——只能问「这个完整序列在不在」,不能问「这个序列的前 2000 个 token 在不在」;
- 普通字典树:支持前缀匹配,但每条边只带一个 token,「You are a helpful assistant」要拆成 7 个节点,空间浪费严重;
- 基数树:边的标签可以是任意长度的 token 序列,空间上与 trie 相比省掉一个数量级,同时保留前缀匹配能力,匹配复杂度 ( 为匹配到的前缀长度)。
用一个具体例子感受树的形状。假设依次来了三个请求:
- “What is the capital of France?”
- “What is the capital of Germany?”
- “What is the weather today?”
它们会形成一棵这样的树:
root│[What is the] ├─ [capital of] │ ├─ [France?] │ └─ [Germany?] └─ [weather today]「What is the」只在树里出现一次,「capital of」也只出现一次。普通 trie 会把每个 token 拆成独立节点(更极端地逐字符展开),节点数与总 token 数同阶;基数树把「不会分叉的整段序列」合并为一条边,节点数只与实际分叉点的数目成正比。三个请求总共 15 个 token,树里只需要存 9 个(公共前缀只占一份)——这就是「空间高效」的直观含义。
SGLang 的系统架构如图:

(图片来源:SGLang 论文 Figure 1。前端是一个嵌入 Python 的 DSL,把完整 prompt 发给运行时;运行时内维护前缀树与 KV 缓存池,自动完成匹配、复用与缓存。)
树里每个节点携带两样东西:一段 token 序列(作为 key),以及这段序列对应的 KV Cache 物理页索引(作为 value)。KV Cache 本体存放在 GPU 上非连续的分页内存池里(论文里每页大小相当于一个 token 的 KV;现代实现中可配置为 16 token 一页),树本身只是「token 序列 → 物理页位置」的映射元数据,存在 CPU 上——这也是它维护开销极小的原因之一。
论文用一张九步演化图展示了 RadixAttention 的全部核心操作,下面逐步讲解:
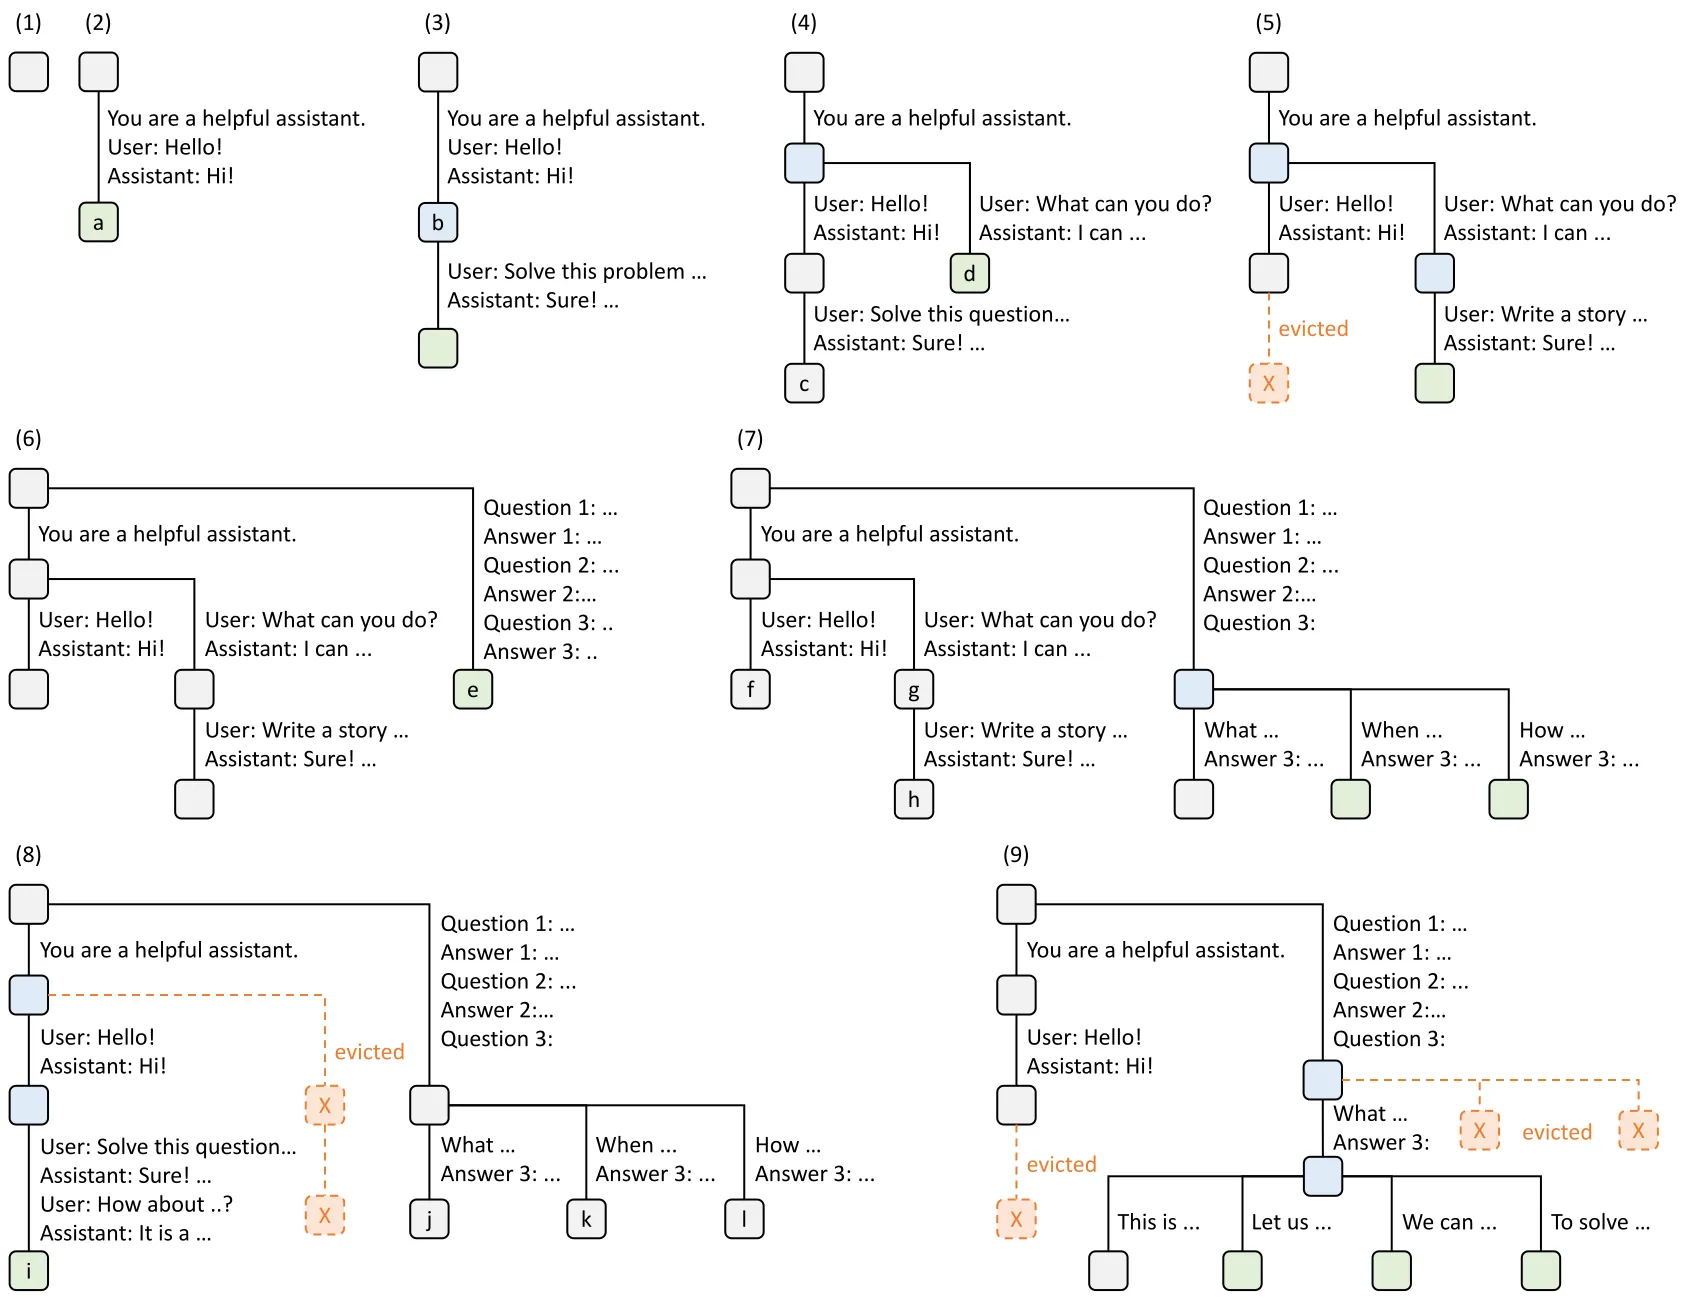
(图片来源:SGLang 论文 Figure 3,含 LRU 驱逐策略下前缀树的动态演化,覆盖两个聊天会话、一批 few-shot 查询和一次 self-consistency 采样。)
- (1) 树初始为空;
- (2) 第一个请求到达:system prompt + “Hello!” + 模型回复 “Hi!”,整条序列作为一个节点挂到根上——注意这里把「输入 + 输出」一起存进去了,因为输出也会成为后续请求的前缀;
- (3) 同一会话的第二轮请求到达:命中(2)里存的整条前缀,复用 KV Cache,新轮次追加为新节点;
- (4) 新的聊天会话开始:节点 b 发生分裂(split),让两个会话各自拥有自己的分支,同时共享 system prompt 这一段;
- (5) 第二个会话继续对话,但显存不够了,节点 c 被 LRU 驱逐(evict),新轮次挂在节点 d 后面;
- (6) 一个 few-shot 查询到达:与现有节点完全没有共享前缀,根节点分裂,新序列独占一条新边;
- (7) 一批 few-shot 查询到达:它们共享同一组示例,节点 e 再次分裂,让共享示例成为公共前缀;
- (8) 第一个会话来了新消息:第二个会话的节点 g、h 因为最久未用被全部驱逐,为新请求腾出空间;
- (9) 对节点 j 里的问题做 self-consistency 采样:驱逐 i、k、l 腾出空间,生成多个答案分支。
九个步骤浓缩了 RadixAttention 的全部机制:匹配(步骤 3、5、8)、插入(步骤 2、5、6)、分裂(步骤 4、6、7)、驱逐(步骤 5、8、9),以及最重要的——树形共享(步骤 4、7 中共享前缀只存一份)。
顺带澄清一个命名问题:RadixAttention 里的 Attention 不是指它自己实现了注意力计算。论文的实现里,实际的注意力矩阵计算由 FlashInfer、Triton 等底层 kernel 库完成(SGLang 基于 PyTorch 和自定义 CUDA kernel 构建);RadixAttention 的职责是决定注意力从哪些物理页取 K/V——它把「token 前缀 → KV 页位置」的映射管好,kernel 按这份映射执行注意力。名字里的 Attention 指的是它服务的对象:注意力机制的 KV 缓存。
原理详解:前缀树的四个基本操作
1. 最长前缀匹配
新请求到达时,运行时把完整 prompt 交给树,从根节点出发逐边比对 token 序列,找到最长的缓存前缀。因为基数树的边是「最长不共享段」,匹配要么整条边命中,要么在边的中间终止(这时就需要分裂,见下节)。
匹配返回两个东西:命中的 KV Cache 物理页索引列表(device_indices),以及终止节点。运行时只需要为「没命中的尾巴」分配新页并计算。
现代 SGLang 里当 page_size > 1(如 16)时,匹配按页粒度对齐:不足一页的尾部 token 不参与匹配。原因很工程化:KV Cache 存放在分页内存池里,按页对齐后,每页要么整体命中、要么整体不命中,页表记账和后续 kernel 的处理都简单得多;按 token 粒度共享,一页里只有部分 token 有效,反而浪费。
radix_cache.py 里的匹配逻辑(简化版):
def match_prefix(self, key): """在树中寻找 key 的最长缓存前缀,返回 KV 位置与终止节点""" value, last_node = self._match_prefix_helper(self.root_node, key) if value: value = torch.cat(value) # 拼接各节点的物理页索引 else: value = torch.empty((0,), dtype=torch.int64, device=self.device) return MatchResult(device_indices=value, last_device_node=last_node)2. 插入与节点分裂
请求跑完后,运行时把「输入 + 输出」的完整序列和它的 KV 位置插回树里,让未来的请求可以复用。插入从匹配到的终止节点出发:如果新序列是已有边的直接扩展,挂一个新节点即可;如果新序列与已有序列在某个节点中间分叉,就需要分裂(_split_node)。
分裂操作把节点 child[0:N] 在 split_len 处一分为二:
Before: parent -> child[0:N]After: parent -> new_node[0:split_len] -> child[split_len:N]为什么一定要分裂?因为树里的共享边界必须精确。设想两个会话共享 system prompt:如果 (4) 步不把节点 b 分裂,那么第二个会话的插入就只能挂在 b 的末端,「共享 system prompt」这一事实就无法表达,之后的匹配也就找不回这段公共前缀。分裂的代价是 O(1):new_node 的 children 指向 child,parent 指向 child 的 parent,只是几个指针操作,不拷贝 token 序列。
分裂还有一个附带好处:它天然让树收敛成「每条边的端点都是实际分叉点」,未来的请求无论从哪个位置分叉,都能找到精确的匹配边界,命中率不会因为边界粗糙而损失。
3. 引用计数:缓存与运行请求共存
连续批处理(Continuous Batching)下,一批请求正在 GPU 上跑,它们正在使用的前缀节点绝不能被驱逐。每个节点维护一个引用计数(lock_ref,论文里叫 reference counter):请求被调度进 batch 时 increase_ref_counter,跑完离开时 decrease_ref_counter,计数大于 0 的节点不可驱逐。
这里有一个很容易被忽略、但非常关键的设计决策:SGLang 不预分配固定大小的缓存池。缓存和正在运行的请求共用同一块显存池,系统动态地在两者之间分配:
- 等待队列里请求多、需要大 batch 时,把缓存全部驱逐,腾出显存换吞吐;
- 请求少时,缓存尽量保留,命中率最大化。
这与操作系统页缓存的理念完全一致——页缓存占用的也是进程的内存,内存压力大时内核回收缓存,压力小时缓存自动膨胀。缓存是内存的牺牲品,也是内存的加速器。
这里还有一个容易被忽视的协同设计:前端提示(Frontend Hint)。SGLang 的前端解释器在执行 fork 原语(从一个 prompt 并行复制出多个副本)时,会先把共享前缀作为提示发送给运行时,确保前缀先被正确插入树中,再发送剩余部分。为什么要这样做?因为前端知道程序的结构——「哪里会分叉」是程序语义的一部分,后端靠猜也能工作,但前端直接告诉它,匹配和调度的开销进一步下降,也避免了分叉瞬间的缓存错位。论文的消融实验里,关掉 Frontend Hint 后性能明显回退,说明这个「前端语言与运行时协同设计」不是可有可无的。
4. 叶子优先的 LRU 驱逐
显存有限,驱逐不可避免。RadixAttention 的驱逐策略是 LRU + 叶子优先递归驱逐:
- 每个节点记录
last_access_time,被命中时更新; - 需要腾空间时,选择最久未使用的叶子节点(没有子节点的节点)优先驱逐;
- 叶子驱逐后,如果它的父节点失去所有子节点变成叶子,才继续被驱逐,逐层向上递归。
为什么叶子优先?看九步图的 (8):驱逐叶子 g、h 只损失第二个会话自己的分支,而它们的公共祖先 d(第一个会话的历史 + 系统提示)被完整保留。如果先驱逐内部节点,等于同时毁掉它下面所有分支的复用机会。论文原文的说法是:先驱逐叶子,让公共祖先持续可复用,直到祖先自己也变成叶子才被驱逐。
驱逐还有一层策略含义:它不总是「迫不得已」。论文明确写到,当等待队列里攒够了请求、需要更大 batch 时,系统会主动驱逐全部缓存,把显存让给批处理——因为大 batch 带来的吞吐收益此时大于缓存命中带来的收益。缓存是「软」的:它存在的唯一理由是省算力,当算力本身供不应求时,缓存就该让位。这个权衡在调度算法的容量预算里自然表达(见下一节的 available = evictable_size() + pool.available_size()):可驱逐的缓存被算作可用容量的一部分,驱逐与批处理共享同一本账。
现代 SGLang 的 TreeNode 结构(docs 中的代码片段,实际位于 python/sglang/srt/mem_cache/radix_cache.py):
class TreeNode: def __init__(self): self.children = defaultdict(TreeNode) self.parent = None self.key = None # 一段 token 序列(RadixKey) self.value = None # 对应 KV cache 的物理页索引 self.lock_ref = 0 # 引用计数,>0 不可驱逐 self.last_access_time = 0 # LRU 时间戳缓存感知调度:调度顺序就是命中率
前缀树解决了「怎么存、怎么找」的问题,但还有一个决定命中率的因素藏在细节里:请求的执行顺序。
想象等待队列里同时排着 10 个请求:3 个是同一个多轮会话的后续轮次(共享 5K 前缀),7 个是完全不相关的随机查询。如果调度器按先来先服务(FCFS)顺序执行,3 个会话请求被 7 个无关请求隔开,每个会话请求执行时,它要复用的前缀可能早就被无关请求的 prefill 挤出了缓存——缓存被反复装进又踢出,这就是缓存颠簸(cache thrashing),命中率暴跌。
RadixAttention 配套的缓存感知调度(Cache-Aware Scheduling)思路极简:对等待队列按「匹配到的前缀长度」降序排序,最长共享前缀优先(longest-shared-prefix-first),让共享前缀长的请求尽量进入同一批,公共缓存被连续命中。论文 Algorithm 1 给出了与连续批处理结合的完整流程,整理成可读形式:
def schedule(radix_tree, memory_pool, running_batch, waiting_queue): # 1. 对全部等待请求做最长前缀匹配 for req in waiting_queue.get_all_requests(): req.prefix_node, req.prefix_len = radix_tree.match_prefix(req.input_tokens)
# 2. 按匹配长度降序排序(longest-shared-prefix-first) waiting_queue.sort(key=lambda r: r.prefix_len, reverse=True)
# 3. 挑下一批:可用容量 = 可驱逐的缓存 + 内存池剩余 available = radix_tree.evictable_size() + memory_pool.available_size() new_batch = [] for req in waiting_queue: if req.size() + current_size < available: new_batch.append(req) delta = radix_tree.increase_ref_counter(req.prefix_node) available += delta # 引用的前缀不可驱逐,预算相应减少
# 4. 需要时驱逐缓存、分配显存、运行 needed = running_batch.merge(new_batch).needed_size() ok, buffer = memory_pool.alloc(needed) if not ok: radix_tree.evict(needed) # 优先驱逐缓存换空间 ok, buffer = memory_pool.alloc(needed) running_batch.run(buffer)
# 5. 请求结束:释放引用,把序列与 KV 插回树 for req in running_batch.drop_finished_requests(): radix_tree.decrease_ref_counter(req.prefix_node) radix_tree.insert(req)第 3 步里 available += delta 是一个容易看漏的细节:请求被选中进入 batch 后,它引用的前缀被锁住、不可驱逐,所以「可用容量」的预算要相应扣减——这正是引用计数与调度协同的方式。
离线场景下,论文证明了这种调度是最优的(Theorem 3.1):
给定一批请求,若缓存容量 ≥ 最长请求长度,按请求所构成的前缀树做深度优先(DFS)遍历执行,可达到最优命中率;而最长共享前缀优先的排序等价于 DFS 序。
证明的思路值得展开,因为它把「缓存命中」归结为一个组合下界问题。设 为这批请求构成的前缀树, 为边 上 KV Cache 的大小。每条边对应的 KV 至少要计算一次,所以总计算量满足:
再看 DFS 序:首次访问边 时,会接着把 的整个子树算完;子树计算期间 持续被命中,不会被驱逐(缓存容量 ≥ 最长路径保证);子树算完后 不再被访问。于是每条边恰好被计算一次,,达到下界。命中率定义为:
(分子分母分别对所有请求求和。)
它等于 ,因此 DFS 序把命中率推到上界。等价性的归纳证明也顺理成章:已访问节点形成的路径 必然被缓存,未访问节点中与 共享前缀最长者,正是 DFS 下一步要访问的节点——而最长共享前缀优先恰好每次都选中它。
在线场景下新请求随时到达,DFS 序会被打乱,但最长共享前缀优先调度在「已缓存部分的增广树」上仍然近似 DFS 行为(论文附录 A.3 给出了详细论证,思路是把新到达的请求视为对已有树的增广,逐棵子树做近似 DFS),实验里它的命中率平均达到离线最优的 96%。
另外要看清定理与实际的差距。论文在定理之后专门加了一个注记:实际执行并不完全等同于证明中的描述,因为输出 token 数量不可预测——树里缓存的前缀由「输入 + 上一轮输出」组成,而输出是什么只有生成完才知道,这会导致某些 KV 重算,破坏最优性。所以定理给出的是理想离线批处理下的上界,在线场景靠近似 DFS 逼近,96% 的平均值就是实证结果。
调度层面还留了一个公开问题:贪心的缓存感知调度可能让共享前缀短的请求无限期被排后,即饥饿(starvation)问题,论文把它与公平调度结合的研究列为 future work。
实验:命中率、加速比与开销
实验环境:Llama-7B 跑在单张 A10G(24GB),Mixtral-8x7B 跑在 8 张 A10G 上(张量并行),Llama-70B 跑在 4 张 A100(80GB)上;基线是 vLLM v0.2.5、Guidance 0.1.8 与 LMQL 0.7.3,全部 FP16。
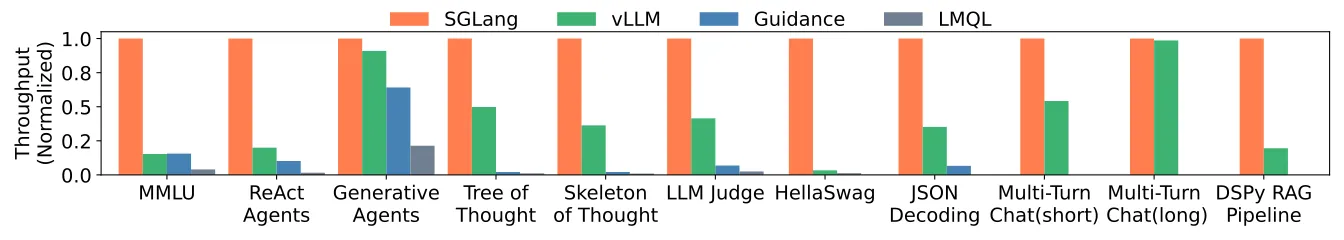
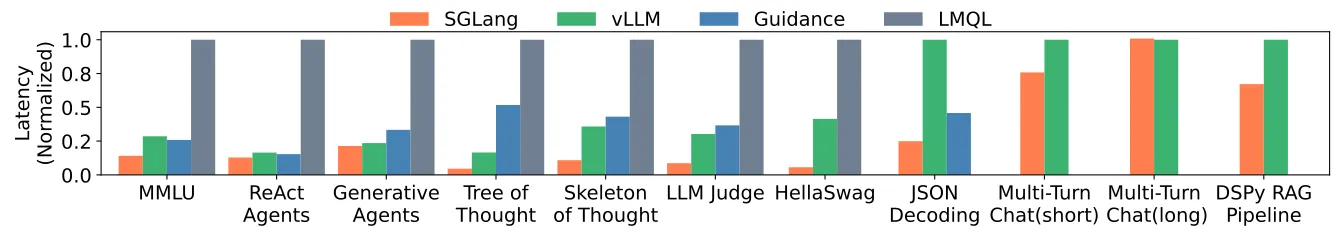
(图片来源:SGLang 论文 Figure 5/6。基准涵盖 MMLU、HellaSwag、ReAct agent、思维树、JSON 解码、多轮对话、DSPy RAG 等工作负载。)
端到端结果:吞吐最高提升 6.4 倍,延迟最高降低 3.7 倍(博客版的数字是 5 倍吞吐,论文最终版为 6.4 倍)。更大模型的趋势一致:Mixtral-8x7B(8 张 A10G 张量并行)与 Llama-70B(4 张 A100)上的加速与 7B 同向,说明收益来自「共享前缀的多少」而非模型大小——模型越大,每 token 的 KV 越贵(层数、头数更多),省下的绝对算力与显存反而更多。逐 benchmark 看加速来源,能更精确地理解 RadixAttention 在什么场景下最值钱:
- MMLU(5-shot):复用 5 个示例的 KV Cache,收益是双份的——共享 KV 降低显存占用,同一块显存能装下更大的 batch,吞吐变高;prefill 计算变少,首 token 延迟变低;
- HellaSwag(20-shot):复用 few-shot 示例 + 多个选项之间的公共问题前缀,形成两级共享——这正是请求级缓存做不到、只有树形结构能表达的模式;
- ReAct / 生成式 agent:复用 agent 模板与之前调用的 KV;
- 思维树 / Skeleton-of-thought:程序内的并行分叉 + 前缀复用协同;
- JSON 解码:主要靠另一项优化(压缩有限状态机)而非 RadixAttention;
- 多轮对话:复用聊天历史。注意输出短时(4-8 token)加速明显,输出长时(256-512 token)几乎无加速——因为输出长时 decode 占主导,且不同会话之间没有可共享内容,RadixAttention 帮不上忙。这个对比是理解「前缀缓存的价值上限」的好样本:它加速的是 prefill 部分,decode 部分它管不着;
- DSPy RAG:复用公共上下文示例。
这些 benchmark 的命中率在 50% 到 99% 之间,缓存感知调度平均达到最优命中率的 96%。
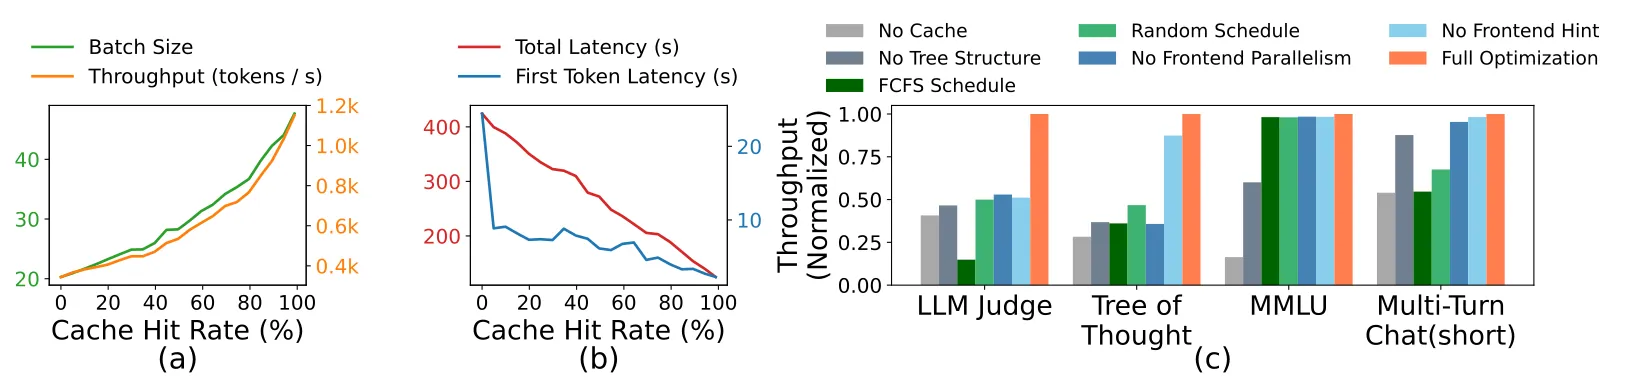
(图片来源:SGLang 论文 Figure 8。(a)(b) 展示命中率与首 token 延迟、总延迟、batch 大小、吞吐的关系;(c) 是组件消融。)
消融实验(Figure 8(c))把 RadixAttention 逐组件拆掉验证必要性:关掉缓存(No Cache)性能大幅回退;把树换成简单表缓存(No Tree-Structure)也明显变差——树结构本身就有价值,不只是工程实现细节;FCFS 调度与随机调度都比缓存感知调度差,说明调度确实直接影响命中率;前端并行与 fork 提示(Frontend Hint)关掉同样有损,证明前端语言与运行时协同设计不是锦上添花。
开销:在完全没有共享机会的 ShareGPT 数据集上跑 100 个请求,总耗时 74.3 秒,其中 RadixAttention 数据结构管理只占 0.2 秒,不到 0.3%。树操作是线性复杂度,维护成本可忽略,所以 RadixAttention 默认开启。
生产验证:SGLang 部署在 Chatbot Arena 上服务开源模型,一个月的观测中,LLaVA-Next-34B 的命中率达到 52.4%,Vicuna-33B 达到 74.1%;命中来源包括公共系统消息、被反复使用的示例图片、以及多轮对话历史;Vicuna-33B 的首 token 延迟平均降低 1.7 倍。
另外两个工程细节值得记一笔:
- 多模态:对图片 token 的 KV Cache,SGLang 计算输入图片的哈希作为树的 key——同一张图被多次提问时,图片部分的 KV 只算一次。这正是 Chatbot Arena 里 LLaVA 命中率的重要来源。多模态的收益数字也很有说服力:LLaVA-v1.5-7B 在 llava-bench-in-the-wild 上,相比作者原实现(HuggingFace Transformers)的 0.18 image/s 提升到 1.15 image/s(约 6 倍);LLaVA-NeXT-34B 的视频推理从 0.02 frame/s 提升到 0.10 frame/s——benchmark 里同一张图/同一段视频被多个问题反复引用,RadixAttention 把「反复引用」全部变成了命中;
- 分布式:张量并行下每张卡各自维护分片的 KV Cache,树操作完全相同,不需要额外同步;数据并行下每个 worker 维护自己的子树,路由器维护一棵 meta-tree(元树),按请求与各 worker 的共享前缀长度做亲和性派发,论文用 4 个 worker 跑 MMLU 验证了线性扩展与接近最优的命中率。
工程落地与后续演进
RadixAttention 如今已经是 SGLang 的默认基础设施,实现位于 python/sglang/srt/mem_cache/radix_cache.py,上文已经展示过 TreeNode 结构与 match_prefix/insert/_split_node/evict 全套操作。它也与 vLLM 的自动前缀缓存、各种网关的 prompt cache 一起,构成了「前缀缓存」这个方向的事实标准。
与 vLLM 前缀缓存的粒度对比值得一提:vLLM 的自动前缀缓存(prefix caching)以 KV block 为粒度做匹配——对每个 block 的 token 序列计算哈希,LRU 管理 block 缓存,实现简单、与 PagedAttention 天然契合,但共享边界受 block 大小约束,分叉点不在 block 边界时无法精确共享;RadixAttention 的树支持任意长度的前缀匹配,加上节点分裂,分叉边界始终精确。工程上是「块级近似」与「树级精确」的取舍:vLLM 的实现在 block 粒度上已经足够好且更简单,SGLang 则把精确性推到极致。
SGLang 团队后来把它往两个方向演进:
- HiCache(三级缓存):把 RadixAttention 从「只有 GPU 显存」扩展成三级层次——GPU 显存作为 L1,主机内存作为 L2,分布式存储作为 L3(可对接 Mooncake、3FS 等)。HiRadixTree 在元数据里记录 KV 在每一层的存储位置,工作流围绕三个关键操作展开:本地匹配(在 L1/L2 里找最长前缀)、L3 预取(未命中时从分布式存储拉取)、写回(新计算的 KV 逐层回写)。配套优化包括零拷贝传输、page-first 数据布局、计算与传输重叠、GPU 辅助 I/O kernel(最高 3 倍传输提速)、多 rank 同步(all_reduce 保持各 rank 的树一致),并可与 prefill-decode 分离部署(PD 分离)集成。这正好回应了论文 future work 里「把 RadixAttention 扩展到 DRAM、Disk 等更多内存层级」的设想,让缓存容量从几十 GB 的显存扩到 TB 级;
- Unified Radix Cache(LMSYS 2026 年 8 月的博客):解决另一类问题——混合注意力模型(FULL 稠密注意力 / SWA 滑窗注意力 / Mamba 线性注意力)的 KV 结构各不相同,以往每种注意力类型要维护各自的缓存,互相之间无法共享。统一基数缓存让它们共用一棵前缀树,并引入会话感知的驱逐策略,在 SWE-bench 这类 agent 负载上显著提升命中率、降低 TTFT。
局限与未解决的问题
- 只能精确匹配:RadixAttention 做的是 token 级精确前缀匹配,不支持模糊/语义匹配——prompt 措辞改一个字,后面全部 miss。论文把「RadixAttention 内的模糊语义匹配」列为 future work;
- 命中率依赖流量模式:长尾请求多、几乎没有共享的负载下,前缀缓存贡献有限(虽然管理开销只有 0.3%,不至于亏本);
- 生成内容不可预知:论文 Theorem 3.1 的证明假设了理想的离线批处理,实际中输出 token 数量不可预测,可能导致 KV Cache 重算,破坏最优性;
- 调度饥饿:缓存感知调度可能牺牲共享前缀短的请求的公平性,与公平调度的结合仍是开放问题;
- 与 KV 量化的组合:缓存命中减少的是算力和显存,显存压力大时命中率本身会下降——与 KIVI、GEAR 这类 KV Cache 量化/压缩技术正交,可以叠加但需要额外的工程整合;
- 缓存容量没有免费午餐:前缀缓存占用的显存越多,留给批处理的就越少,显存紧张的部署里需要显式配置缓存容量上限,把「省 prefill」与「大 batch」的权衡交给部署者——这正是 HiCache 用「把缓存挪到更便宜的层次」来绕开的问题。
小结
RadixAttention 的贡献可以浓缩为一句话:首次把 KV Cache 当作操作系统页缓存来管理——基数树提供任意前缀的 O(L) 匹配与树形共享,叶子优先的 LRU 驱逐保证公共前缀长寿,缓存感知调度把命中率推到接近离线最优。它让「共享前缀只计算一次」从手工配置变成了运行时自动行为,是 SGLang 得以成为主流推理框架的基石之一。
如果把这系列讲过的推理服务技术放在一起看,会得到一张完整的拼图:PagedAttention 管内存布局(分页解决碎片化),连续批处理管批处理调度(迭代级调度消灭 padding 浪费),RadixAttention 管跨请求复用(前缀树消灭重复 prefill)。三者正交、互相叠加,共同决定了现代 LLM 推理服务的吞吐与延迟——而 RadixAttention 是其中最后一个拼上的、也是影响面最广的一块。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs(论文,arXiv 2312.07104)
- LMSYS 官方博客:Fast and Expressive LLM Inference with RadixAttention and SGLang
- SGLang GitHub 仓库
- SGLang 文档:RadixAttention 核心概念
- SGLang 文档:HiCache 系统设计与优化
- LMSYS 博客:Unified Radix Cache: One Tree for Hybrid Model Prefix Caching
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM 论文)
- 站内文章:连续批处理完全拆解:Orca 的迭代级调度与选择性批处理
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


