


QuaRot 完全拆解:旋转坐标系根除激活离群值,LLM 端到端 W4A4KV4 推理的数学魔法
背景:量化之路走到 W4A4 门口
过去一年多的低比特量化路线图可以这样概括:权重是最早被量化的部分,GPTQ、AWQ 都能做到 4-bit 几乎无损;激活(activation)在 8-bit 也基本被征服(SmoothQuant 的 W8A8 已大规模落地);KV 缓存在 2–4-bit 也有了不少尝试(KIVI、KVQuant 等)。剩下的硬骨头是:权重、激活、KV 三者同时量到 4-bit,也就是常说的 W4A4KV4 端到端 4-bit 推理。前面三篇拆解分别讲过 GPTQ 的权重量化、SmoothQuant 的 W8A8 和 KIVI 的 KV 量化,本篇文章的主角 QuaRot(Quantization based on Rotations,基于旋转的量化)要回答的,正是这条路上最后、也最麻烦的一段。
先复习一下 W4A4 为什么诱人。解码(decode)阶段是显存带宽受限的,权重位数每降一半,单 token 生成所需的字节读取就降一半;KV 缓存同理,4-bit 缓存比 FP16 缓存省 4 倍内存,意味着同样显存能支撑 4 倍的并发序列。prefill 阶段是算力受限的,如果只有权重降位而激活仍以 FP16 参与计算,省下的带宽并不能直接变现成吞吐;只有权重与激活都降到 4-bit、矩阵乘全程跑在 INT4 MMA(matrix multiply-accumulate,矩阵乘累加)上,算力红利才会兑现——论文附录里单层线性层的实测是 3.2 到 4.3 倍加速(详见后文实验部分)。
问题出在激活离群值(activation outlier)。LLM.int8() 在 2022 年就发现:大模型的隐藏状态里,有极少数特征通道的幅值比普通通道大一个量级以上,且这些通道是系统性的——跨 token、跨层稳定出现。我们在 LLM.int8() 拆解里讲过它的应对:把这些通道单独拎出来用 FP16 算。到 8-bit 激活量化时代,SmoothQuant 用按通道缩放把激活的量化难度数学等价地迁移到权重上,把激活压回 8-bit;可一旦把目标从 8-bit 提到 4-bit,缩放这条路就走不通了——4-bit 只有 16 个取值,即使做了平滑,残留下来的动态范围仍然超出 16 个格子能表达的范围,量化误差会把模型直接摧毁。
把时间拨回 2024 年 4 月,学界对 W4A4 的尝试都还停留在“绕开离群值”:
- Atom 专门为离群通道写了混合精度矩阵乘内核,复杂且移植困难;
- QUIK 把离群值相关的下投影层(down-projection)整个保留在 8-bit;
- OmniQuant 用可学习的量化参数逼近全精度模型,本质是轻量重训练,需要额外数据与训练流程;
- SmoothQuant 的直接外推(表 1 里 RTN 权重的 W4A4 配置)在 LLaMA2-7B 上困惑度直接从 5.47 崩到 83.12,完全不可用。
QuaRot 由 ETH Zürich SPCL 团队的 Saleh Ashkboos 与微软、ISTA 等机构的研究者合作提出,2024 年 4 月发布在 arXiv,被 NeurIPS 2024 接收,代码开源在 spcl/QuaRot。它换了一个完全不同的思路:不修补离群值,而是旋转坐标系让离群值“不存在”。在 LLaMA2-70B 上,它把权重、激活、KV 缓存全部量到 4-bit,困惑度只损失 0.47,零样本任务精度保留 99%,并且做到没有任何通道需要以更高精度保留——论文称这在其所知范围内是端到端 4-bit 推理的首次。
核心思想:与其压平离群值,不如换一套坐标系
先看离群值问题的本质。给定一个待量化的激活向量 ,per-token 对称量化用一个缩放因子 (INT4 最大可表示值)把 压到 的整数网格。量化误差的绝对大小由离群通道的幅值决定:如果 4096 维里有一两个通道是 25,其余都是 0.5,那么 被拉到 25/7 ≈ 3.57,普通通道 0.5 的幅值只占 0.14 个格子,四舍五入后几乎全被抹成 0——这正是 SmoothQuant 论文里展示过的“大象在房间里”效应:一格之差的相对精度完全被极端值吃掉。
QuaRot 的观察是:把向量旋转一下再量化,量化误差并不会变大。对任意正交矩阵 (满足 ),旋转不改变向量的长度。量化可以看作先加一个与数据分布有关的误差向量 ,旋转后做量化再旋转回去,误差仍然是 量级;但误差的结构变了:原来集中在少数坐标轴上的大误差,被摊到了所有坐标轴上,变成均匀的小误差。而矩阵乘、注意力这类计算对“均匀小幅误差”的容忍度远高于“少数通道大幅误差”——因为点积误差正比于各分量误差平方和的平方根,能量守恒下,摊匀的误差总和反而更小。
更重要的是,Transformer 的结构给了旋转完全免费的通行证。神经网络的每一层里,有两类运算对正交旋转天然不变:
第一类:RMSNorm。 RMSNorm 把每个 token 向量除以自己的 RMS 范数(再乘可学习的缩放参数 ),只关心“方向”不关心“坐标”:
第二个式子两边是严格相等的(范数对旋转不变,)。这意味着:在 RMSNorm 前面给残差流乘一个正交矩阵 ,等价于在 RMSNorm 后面给输出乘同一个 ——旋转可以“穿过”归一化层。
第二类:softmax 注意力里的点积。 如果查询和键被同一个正交矩阵 旋转,点积不变:
所以注意力分数、进而 softmax 的权重,在共同旋转下完全不变。
有了这两把钥匙,就可以构造一个“计算不变”的模型变换:在相邻两个 Transformer 块之间插入旋转 ,让块间的残差流从 变成 ,同时把 (或 )融合(fuse)进相邻的权重矩阵,使得整个模型在数学上输出分毫不差。但插入点两侧的权重吸收方向不同——出现在块输入侧的权重(、、、、)左乘 把旋转“撤销”回原坐标系,出现在块输出侧的权重(、)右乘 把结果旋转进新坐标系。旋转过的块间激活不再有离群值,而块内部因为坐标被“撤回去”,GELU、SiLU 这类逐元素非线性函数的行为完全不受影响。逐块做下去,整个模型的隐藏状态流就全被“洗”过一遍,激活变得极其容易量化。
这个技巧不是 QuaRot 首创——它直接借用自 SliceGPT(同一批作者 2024 年 1 月的工作,原用途是结构化剪枝)提出的计算不变性(computational invariance)。QuIP/QuIP# 也在权重量化里用过左右乘旋转矩阵的“非相干化”(incoherence processing)。QuaRot 的贡献在于把它从“纯权重量化”推广到端到端:不仅洗残差流,还把手伸进了 FFN 内部激活、注意力内部和 KV 缓存——后面三者是 QuIP# 没有覆盖的,也是 W4A4KV4 之所以难的原因。
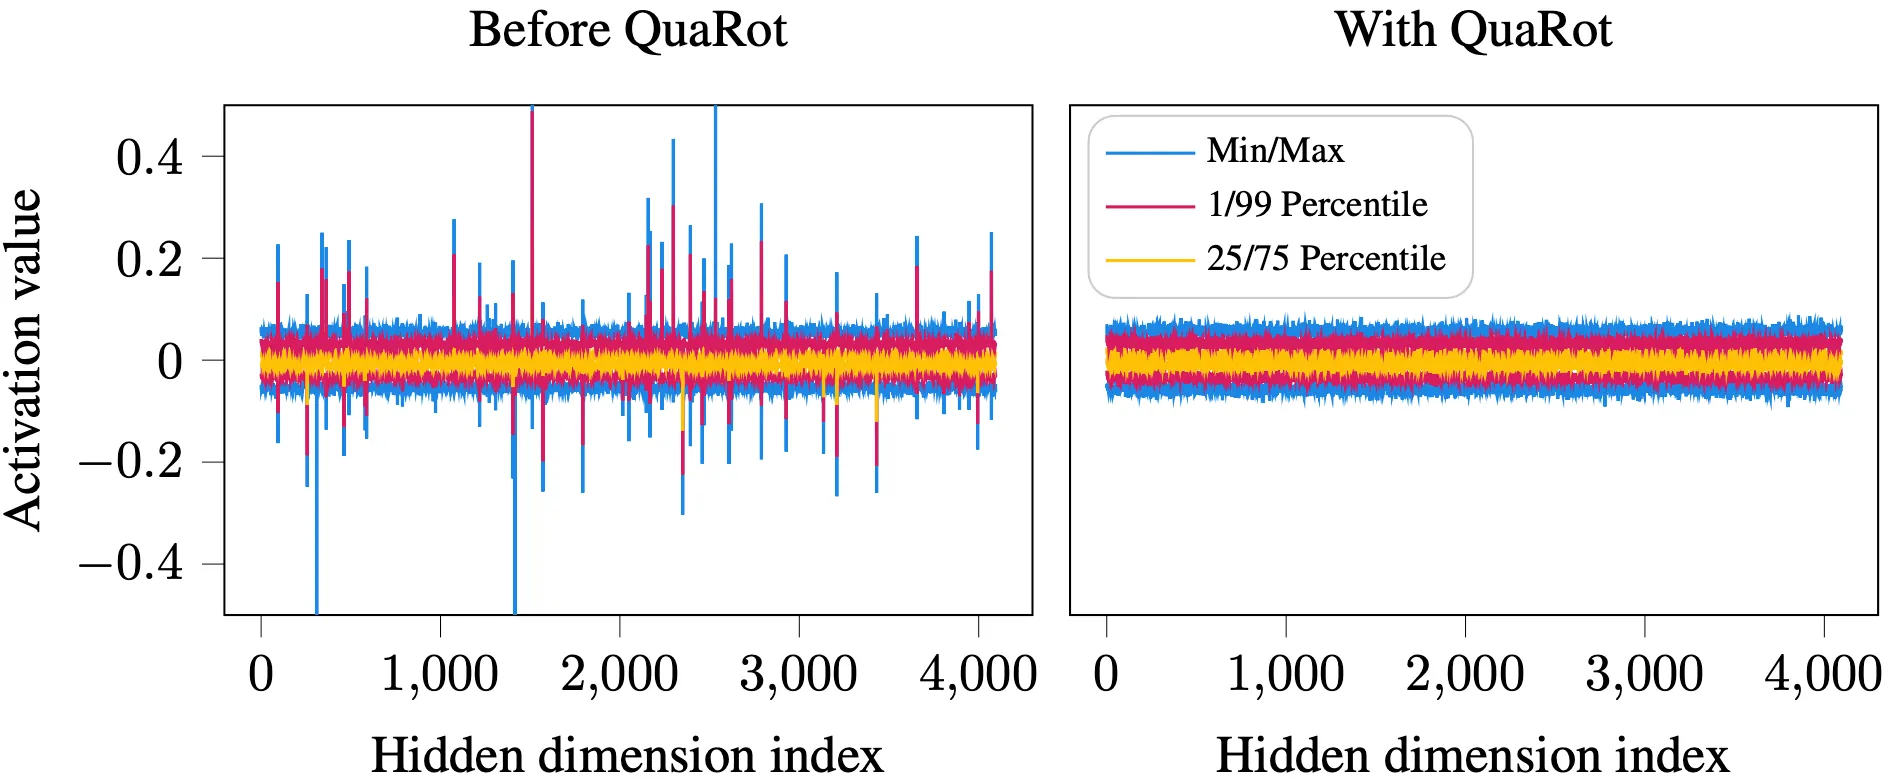
上图是论文的 Figure 1,展示 LLaMA2-7B 第 10 层 FFN 输入激活旋转前后的分布。左图里存在幅值明显凸出的通道,这些通道让 per-channel 之外的任何细粒度量化方案都很难办;右图经过随机 Hadamard 旋转后,能量被摊到所有维度上,分布均匀平滑,普通 4-bit 均匀量化就能安全表达。注意两边的信息量并没有损失——旋转是正交变换,是可逆的,变的只是坐标系。
为什么旋转后量化真的变好了:非相干性
给“摊匀”一个精确的度量。一个权重或激活矩阵 (每行一个样本)被称为 -非相干的(-incoherent),如果它的最大元素幅值被矩阵整体能量约束住:
其中 是矩阵形状, 是 Frobenius 范数。直觉上: 越小,说明没有单个元素“鹤立鸡群”,矩阵越容易量化。旋转不改变 (能量守恒),但可以把集中在个别坐标上的能量分散,把 从几十压到接近 1。用一个小例子感受:向量 的最大元素是普通元素的 100 倍;左乘 4 阶 Hadamard 矩阵后得到
( 未归一化时 ,所以前面要补 才是正交矩阵。)原来的 100 倍悬殊被压成了 1.04 倍,这就是“旋转根除离群值”的全部秘密:把能量从少数坐标轴搬到所有坐标轴。而 LLM 的离群值恰好在标准坐标系里“抱团”,旋转坐标系后它们被彻底打散。论文 Figure 1 的实测中,LLaMA2-7B 激活的最大幅值约为普通通道的 50 倍,旋转后降到约 7.5 倍——per-channel 量化(每组一个缩放因子)此时已经足够。
数学工具:Hadamard 矩阵为什么是旋转的不二之选
旋转矩阵的选择有讲究。QuaRot 用了随机化 Hadamard 矩阵(randomized Hadamard matrix)。Hadamard 矩阵是元素只取 的正交矩阵(归一化后),Walsh-Hadamard 矩阵按 Kronecker 积递归构造:
三个性质让它几乎是为这个场景量身定做的:
其一,变换快。 可以在 次加减运算内完成(Walsh-Hadamard 变换,只需加减、不需要乘法,也不需要显式存储矩阵)。旋转本身如果太贵,融入前向的在线 Hadamard 变换就没有意义了——论文实测在线变换最多只给前向增加 7% 的耗时。作为对比,一张通用稠密旋转矩阵的矩阵向量乘是 ,在 4096 维上比 慢三个数量级。
其二,非相干性最优。 归一化 Hadamard 的每个元素幅值都是 ,是所有正交矩阵里能达到的“最不集中”的水平, 理论上可以压到接近 1。
其三,自逆且对称。 归一化 Walsh-Hadamard 满足 且 ,即 。这意味着同一个矩阵既能当旋转、又能当“反旋转”用,融合进两侧权重时不需要区分正向和逆向——这对下文注意力模块里的成对抵消至关重要。真实模型隐藏维不一定恰好是 2 的幂(比如某些模型是 5500 之类),此时可以把 分解成 ,其中 是某个已知存在 Hadamard 矩阵的阶数(Sloane 维护了各阶 Hadamard 矩阵目录),用 的 Kronecker 构造拼出来, 的代价是 。
还有一层“随机化”:取一个元素随机取 的对角矩阵 ,令 。 只是给每列乘了个符号, 仍然是正交矩阵,但打破了 Hadamard 的规则结构。论文做了一组对照实验(附录 A.5):把 Hadamard 换成由随机矩阵 QR 分解得到的普通随机正交矩阵,同样只融合进权重,4-bit 下 LLaMA2-7B 的困惑度是 7.45,比 Hadamard 的 6.10 差 1.35;模型越大差距越小(70B 上只差 0.28)。这说明旋转的“摊匀”效果与矩阵的具体结构有关,Hadamard 的均匀 结构在有限维上恰好比“真随机”旋转更彻底,论文没有给出更深层的解释,但实验结论明确:既快又好的那个,就是 Hadamard。
原理详解:四步改造一个 Transformer
QuaRot 的完整流程分两个阶段:第一阶段(Stage 1a–1d)在全精度下改造模型权重并向前向里插入少量 Hadamard 运算;第二阶段(Stage 2a–2c)用现成的量化方法量化权重,并给激活和缓存加上在线量化。权重改造的每一步都保证数学等价,改完的模型输出与原来逐位一致(在足够精度下)。
Stage 1a:残差流旋转与权重融合
先做准备工作:把 RMSNorm 的线性缩放部分(diag(),即逐元素乘上可学习参数 )吸收进相邻权重矩阵——这一步只是把两次线性运算合并成一次,不改变任何数值。然后给每个 Transformer 块选一个与隐藏维等大的随机化 Hadamard 矩阵 ,按“输入侧权重左乘 、输出侧权重右乘 ”的规则改造。以注意力里的键投影为例:
对 、、、 做同样处理。直觉上,块间残差流 变成 之后,RMSNorm 把它“旋转地”传下去(),投影层权重左乘的 恰好把这层旋转抵消,于是投影层输出仍是原坐标系里的干净结果,后续 GELU 之类逐元素运算一切照旧;而块输出侧的 、 右乘 ,把块的输出旋进残差流的旋转坐标系,残差相加才保持一致。逐块串联,全模型的层间激活就都变成“旋转后无离群”的状态。首尾边界上,词嵌入矩阵右乘 (让第一层的输入就是旋转坐标),语言模型头左乘 (把最后的 logits 旋回原坐标),这样输入输出都不受影响。
这一步有个额外红利:被 左乘过的权重矩阵本身也被“洗”了一遍,权重侧的离群元素(AWQ 讲过的 1% 显著权重)同样被摊匀,权重量化因此也变容易。论文在附录 A.4 里单独验证了这一点:仅做权重改造(激活仍 FP16)时,4-bit GPTQ 的困惑度损失最多能再降低 2.65。
Stage 1b:FFN 下投影前的在线旋转
残差流洗过之后,FFN 内部还有一处离群值重灾区:下投影()的输入,也就是 、 两个投影经 SiLU 门控逐元素相乘后的结果。它不在任何归一化层之后(门控乘法的输出没有 norm),旋转无法“穿过”上一层的权重免费完成——但可以在前向里实时插入一次 Hadamard 变换,再把它的逆融合进 。因为归一化 Hadamard 自逆(),融合与实时变换用的是同一个 :
前向计算变成:门控输出 先在线乘 (摊匀离群值)→ 量化成 INT4 → 与 做 INT4 矩阵乘 → 结果里的 与在线那次的 相乘抵消(),剩下的右乘 恰好把输出旋进残差流的旋转坐标系。论文 Figure 3 把这一串画得很清楚:
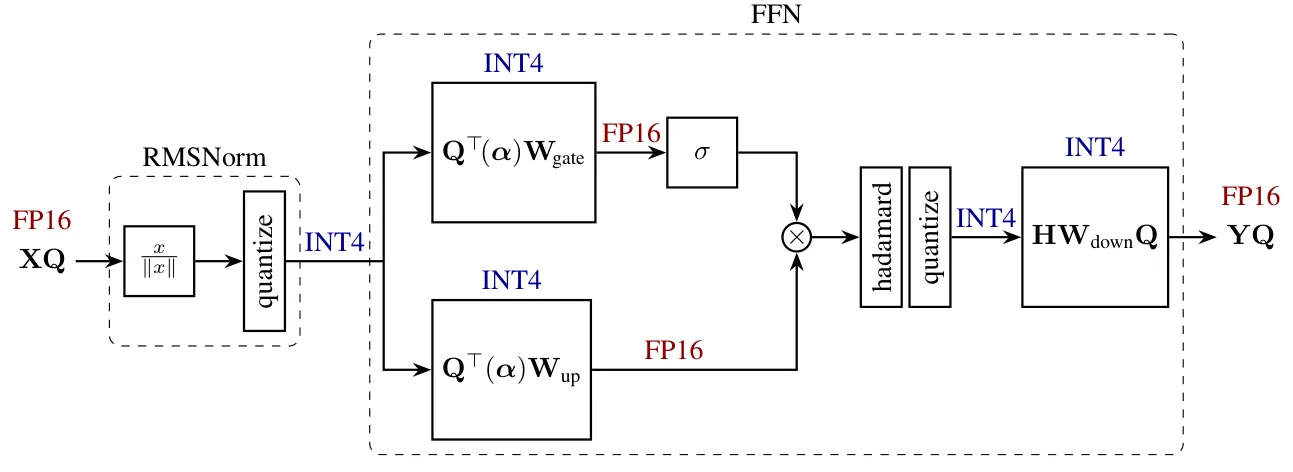
读图顺序(从左到右):输入 (FP16,旋转坐标)进入 RMSNorm(只剩除以范数、不再乘 )→ 分两路进 与 (INT4 权重)→ 门控路径过 SiLU(图中 )→ 两路逐元素相乘 → 在线 hadamard 变换 → 量化(INT4)→ 与 (INT4)矩阵乘 → 输出 (FP16,仍是旋转坐标,直接加入残差流)。图中每个矩阵乘的输入输出都标了位宽:所有参与矩阵乘的张量都是 INT4,只有残差流本体保持 FP16。矩阵乘的 INT32 累加结果立即转回 FP16 并乘上缩放因子,保证后续在线变换在 FP16 里做。
Stage 1c:注意力里的 Value 与输出投影——成对抵消的头维旋转
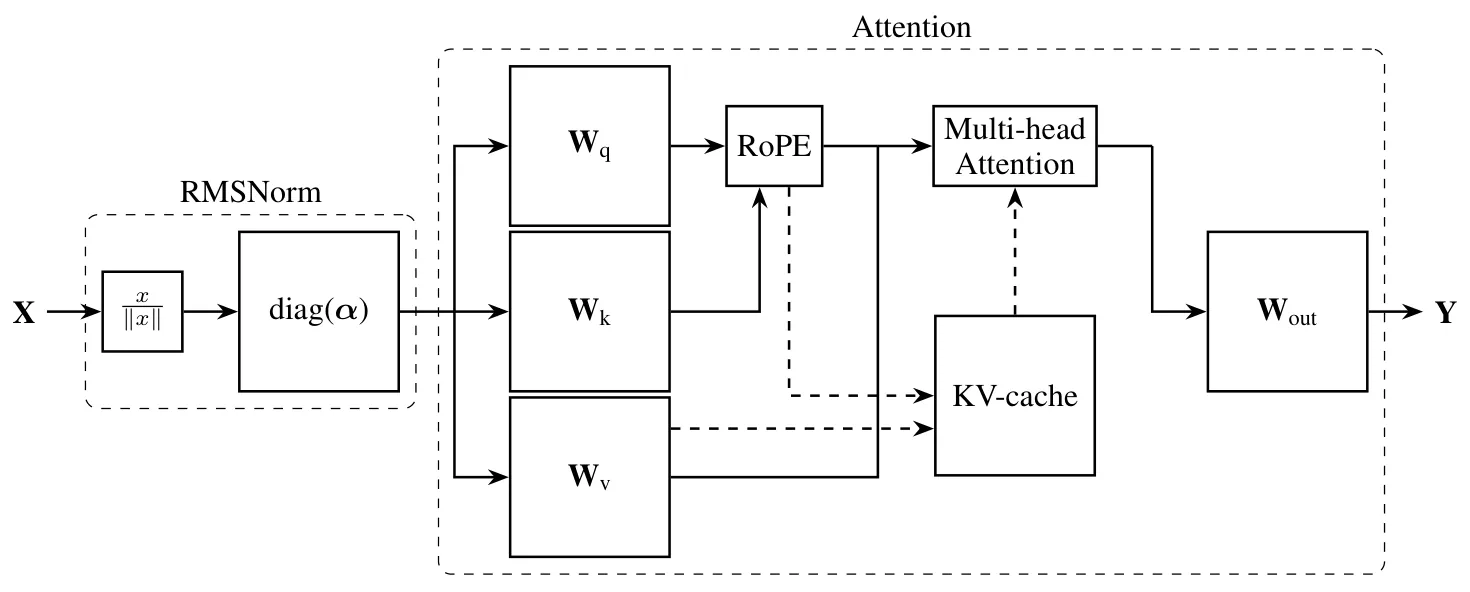
先看未改造的原始注意力模块(论文 Figure 5):残差流 经 RMSNorm(乘上 缩放)后由 、、 三个投影线性变换,RoPE 注入位置信息,多头注意力读出 KV 缓存(FP16,虚线路径)算出逐头的 ,拼接后经 输出 加回残差流。离群值在这条路径上有三个落脚点:、 投影的输出(key 还要写进缓存供后续所有 token 复用)、value 矩阵(同样要缓存),以及更深处 FFN 的门控乘积。注意 key 与 value 一旦写入缓存,就要被序列中之后的所有查询反复读取——缓存里的离群值会被放大成持续的内存与精度负担,这正是 KV 量化比激活量化更棘手的原因。
注意力模块比 FFN 麻烦,因为 和 在计算上“隔着”一个 softmax,不能简单当相邻权重处理。先把多头注意力的输出写成逐头形式,看出其中的结构:
其中 是第 个头(head)的 value 矩阵, 是 softmax 后的注意力权重矩阵(序列长度平方大小), 是头数。每个头的 是 行的凸组合,而 是线性投影——所以对每个头来说, 的输出坐标和 的输入坐标是对齐的,中间夹的“按 softmax 权重取行组合”是一个线性运算,不破坏坐标对齐。于是可以对每个头单独做旋转:给 右乘一个大小为头维 的 Hadamard (把 value 向量旋进头内坐标系),再给 左乘同一个 (把凸组合结果旋回来):
代入上式,每个头的计算变成 ——中间多出的 恰好抵消,数学上输出不变,但 输出的 value 向量已经是在旋转坐标里,旋转后的 value 不再有离群值,KV 缓存里存的 value 就可以安全量化了。由于各头权重是拼接存放的,逐头乘 等价于对整个矩阵做一次 Kronecker 结构乘法 —— 是一个块对角矩阵,每块正好是 ,实现上就是按头 reshape 后批量做小 Hadamard 变换。
但这只在头内( 维)旋转了 value。要想让 value 的旋转同时覆盖整个隐藏维(4096 维的“完整”旋转),还要利用 Kronecker 积的分解恒等式(当 和 都是 2 的幂时成立):
这部分没法融进 ( 的输出只有 维自由),QuaRot 的做法是把它作为在线块插在注意力输出与 之间,做 ,并把这部分同样左乘进 完成抵消——这就是论文 Figure 6 里标注的“hadamard heads”块。因为 只是“按头打乱组合”的置换式结构,实现上用一个 reshape 加一次快速 Walsh-Hadamard 变换就能算完。
这里有一个被后续工作盯上的工程细节: 要求 是 2 的幂,一旦模型被张量并行切分(每张卡分到 个头),需要 仍是 2 的幂才能保持 Kronecker 结构——SpinQuant(下文会讲)专门指出这是 QuaRot 在分布式推理下的一个痛点。
Stage 1d:Key 与 Query 的在线旋转——RoPE 挡路后的选择
value 解决后还剩 key。KV 缓存量化文献(KVQuant、KIVI)早就发现 key 里的离群值比 value 更严重:key 离群值出现在固定的少数通道上(对应位置编码的某些频率分量),按通道(per-channel)量化才能压住;KIVI 那篇文章里我们已经看到 K/V 分布的不对称性。QuaRot 想用同样的头维旋转把 key 洗一遍,但这里撞上一个障碍——RoPE。
现代模型(LLaMA 家族)在 、 投影之后、注意力之前插入旋转位置编码 。位置编码是逐位置的旋转,不能融进 ( 对所有位置共用,RoPE 的旋转角度却随位置变化)。因此 、 两个矩阵只能在投影和 RoPE 之后在线各乘一次 :
因为查询和键被同一个正交矩阵旋转,点积不变,softmax 分数与原来完全一致(前面第二把钥匙),所以不需要改动注意力分数的计算逻辑。每头每 token 一次 维的小 Hadamard 变换,开销极小。
在线旋转引出一个缓存策略的取舍,论文对比了两条路:
- Pre-RoPE 缓存(KVQuant 的做法):缓存未旋转、未加位置编码的 key,等查询来了再在线补 RoPE 和旋转——每次查询都要重新旋转全部历史 key,解码阶段查询向量只有一个而 key 有几千个,代价随序列长度线性增长;
- Post-RoPE 缓存(QuaRot 的选择):key 在写缓存前就完成旋转,缓存里存的就是旋转后的 key,新查询只需要在线旋转自己这一个向量。
解码时每次只产生一个 token,Post-RoPE 把每步的旋转开销从随序列长度线性增长变成与序列长度无关的常数,QuaRot 因此选择它:KV 缓存中存储的 key/value 都已经是“洗过”的,直接量化存储即可。
把各部件拼起来,改造后的注意力模块整体就是论文的 Figure 6:
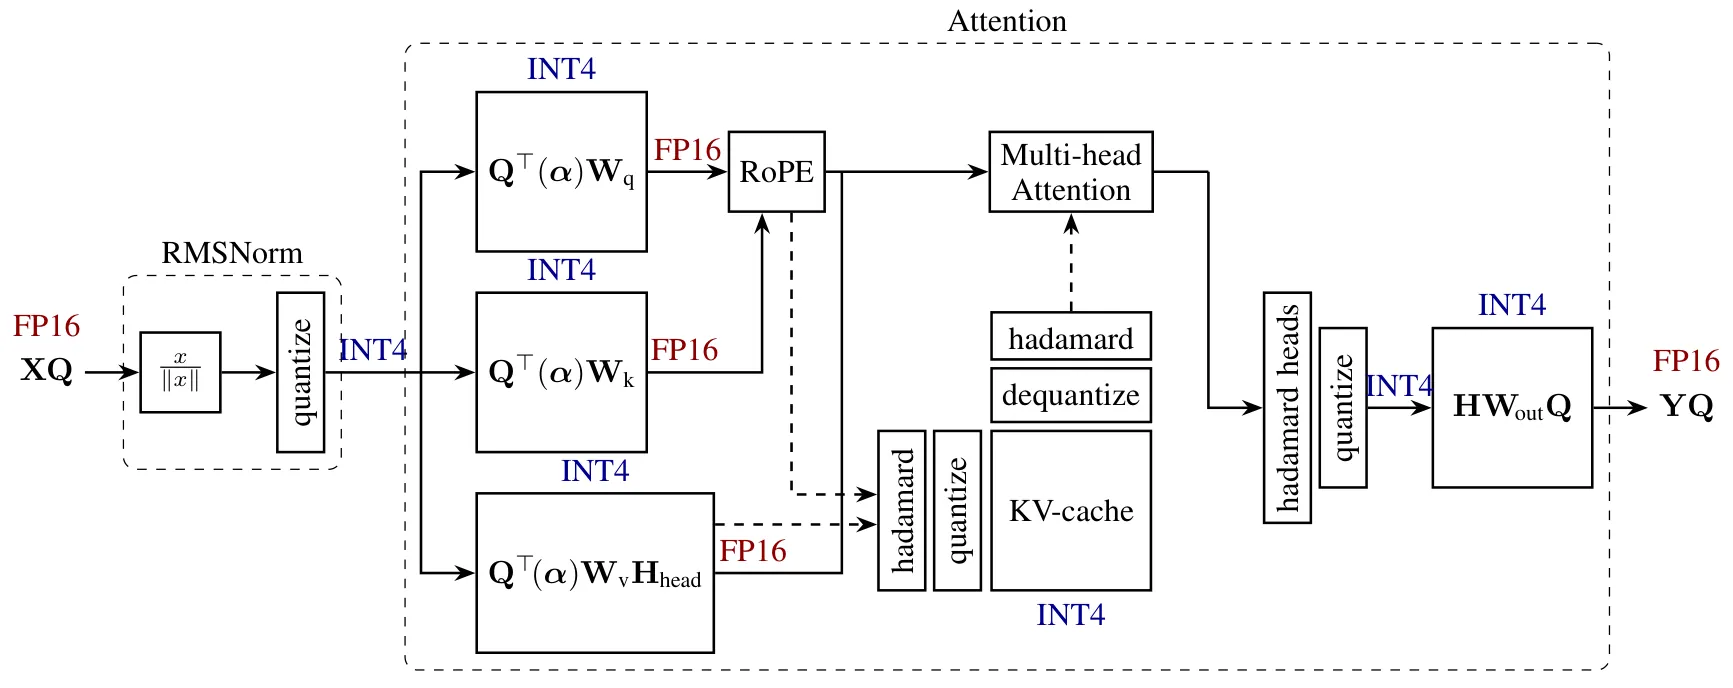
与原始结构逐处对照,每个新增块都是“旋转—抵消”的一对: 与 左乘的 撤销残差流旋转,RoPE 后的在线 hadamard 负责洗 query/key; 右乘的头维 洗 value,输出侧 hadamard heads 块与 里的 成对抵消,右乘的 把注意力输出旋回残差坐标系。注意图中 KV 缓存(虚线框)两侧的位宽标注:写入的是 INT4,读出后先反量化(dequantize)再参与 FP16 的注意力计算——论文在注意力内部保留了 FP16 的在线 softmax 计算(类似 FlashAttention 的逐段加载),只有缓存是 4-bit。
到这里,“四个旋转插入点”全部就位:残差流全局旋转(融合)、FFN 下投影前在线旋转、注意力 value/输出投影的头维旋转(融合为主)、query/key 的在线头维旋转(服务 KV 缓存)。论文的说法是:相比 QuIP# 每个权重矩阵都要在运行时撤销两次变换,QuaRot 每层只需要 1.5 次在线 Hadamard 变换(FFN 下投影前一次,注意力头维加 query/key 共享约半次),其余全部提前融合进权重。
Stage 2:量化设置与 kernel 实现
权重改造完毕,模型输出与原来一致(足够精度下),接下来才是真正的量化:
- 权重:默认用 GPTQ,per-column(即 per-channel)对称量化,裁剪比例(clipping ratio)通过对平方误差线性搜索确定;也可以退化成纯 round-to-nearest(RTN),无需任何校准数据(代价是精度,后文有数据);
- 激活:所有线性层输入用 per-token 对称量化——每个 token 一行、一个缩放因子,,除完后四舍五入;裁剪比例取常数 0.9(附录 A.2 的网格搜索显示输入量化在 0.9 附近最优,困惑度 5.828 vs 裁剪 1.0 时的 5.938);
- KV 缓存:非对称量化(KIVI 那篇讲过的原因:value 非负、分布不对称),group size 128,正好等于 LLaMA2 的头维;裁剪比例 0.95;
- RMSNorm(去掉缩放后只剩除法)留在 FP32;矩阵乘的 INT32 累加结果转 FP16 时乘上输入行缩放与权重列缩放的乘积完成反量化。
权重改造与量化各需要多久?论文给出一个很实用的工程数据:在单张 A100 上,把 LLaMA2-70B 做完 QuaRot 权重改造只要 5 分钟,再用 GPTQ 量化花 2 小时。
kernel 方面,QuaRot 基于 CUTLASS 实现了 INT4 矩阵乘(TensorCore MMA,INT32 累加),KV 缓存量化复用 FlashInfer 库,性能实验全部跑在消费级 RTX 3090 上。
实验:精度与性能
精度:端到端 4-bit 终于“站住了”
先看最核心的结果——WikiText-2 困惑度(越低越好,序列长度 2048,权重用 GPTQ,激活与 KV 均 4-bit):
| 方法 | 权重量化 | 保留高精度通道数 | LLaMA2-7B | LLaMA2-13B | LLaMA2-70B |
|---|---|---|---|---|---|
| FP16 基线 | — | — | 5.47 | 4.88 | 3.32 |
| SmoothQuant(4-bit 外推) | RTN | 0 | 83.12 | 35.88 | — |
| OmniQuant | RTN | 0 | 14.26 | 12.30 | — |
| QUIK-4B | GPTQ | 256 | 8.87 | 7.78 | 6.91 |
| QuaRot | GPTQ | 0 | 6.10 | 5.40 | 3.79 |
| Atom(group 128) | GPTQ-128G | 128 | 6.03 | 5.26 | — |
| QuaRot(group 128) | GPTQ-128G | 0 | 5.93 | 5.26 | 3.61 |
(数据取自论文 Table 1;表中 128G 表示权重与激活的 group size 为 128。)三行关键对比:
- SmoothQuant 的 W4A4 外推直接崩盘(7B 上 83.12),说明缩放迁移这条路在 4-bit 确实到头了;
- QUIK 保留 256 个高精度通道仍比 QuaRot 差 2 个多点——“绕开离群值”不如“消灭离群值”;
- 与同样细粒度(group 128)的 Atom 相比,QuaRot 在 7B 上反超 0.1(5.93 vs 6.03),在 13B 上打平(5.26),且不需要 Atom 那套复杂的混合精度内核与通道重排——论文声称这是首次在零高精度通道的前提下把 W4A4KV4 做到这个精度水平。
零样本任务(PIQA、WinoGrande、HellaSwag、Arc-Easy、Arc-Challenge、LAMBADA 六项平均)同样站得住:LLaMA2-70B 平均分从 77.07 只掉到 75.98(-1.09),保留了 FP16 的约 99%;7B 上掉得多些(-4.18),模型越小对低比特越敏感,这是量化文献里的普遍规律。
还有两个细节值得单独说明。其一,RTN vs GPTQ:纯 RTN 在 4-bit 下 7B 困惑度 8.37(比 GPTQ 的 6.10 差 2.27),但 70B 上差距缩到约 0.35(4.14 vs 3.79)——模型越大、权重越“好量化”,校准数据的重要性越低;而 RTN 在 8-bit 下完全无损(7B:5.50 vs 5.47;70B:3.33 vs 3.32),6-bit 同样无损——不需要任何校准集和超参数,这是 QuaRot 旋转洗过权重后白送的福利。其二,group size 的取舍:group 越小精度越好(64G 时 7B 到 5.88),但缩放因子数量变多、kernel 复杂度上升,需要显存换精度还是精度换显存由部署场景决定。
KV 缓存位宽消融:Key 比 Value 更娇气
KV 部分单独做位宽消融(论文 Table 6,其余部分保持全精度)很有信息量:
| K 位宽 | V 位宽 | LLaMA2-7B | LLaMA2-13B | LLaMA2-70B |
|---|---|---|---|---|
| 16 | 16 | 5.47 | 4.88 | 3.32 |
| 4 | 4 | 5.51 | 4.91 | 3.33 |
| 4 | 3 | 5.54 | 4.93 | 3.35 |
| 3 | 4 | 5.65 | 5.01 | 3.38 |
| 3 | 3 | 5.68 | 5.02 | 3.39 |
| 2 | 4 | 8.06 | 6.42 | 3.89 |
| 2 | 2 | 9.23 | 7.07 | 4.13 |
三个结论:4-bit KV 几乎白送(70B 上 3.33 vs 3.32,7B 上 5.51 vs 5.47);key 比 value 敏感(K4V3 是 5.54,K3V4 是 5.65——同样的平均位宽,砍 key 的损失更大),与 KIVI、KVQuant 的观察一致;2-bit key 是悬崖(7B 上 8.06 起跳),旋转也救不了 2-bit key。这也解释了为什么 QuaRot 要把旋转的重点放在 key 上:洗掉 key 的固定通道离群值之后,per-group 均匀量化才敢用 4-bit。70B 模型对 KV 位宽尤其钝感(K2V2 也才 4.13),与 GQA 分组注意力天然摊薄了 KV 敏感度有关。
性能:prefill 加速与解码内存
性能实验用论文自己的 CUTLASS INT4 kernel 在 RTX 3090 上测单个 transformer 块(整模型太大放不进测试集群的大 batch)。论文 Figure 4 给出两个关键结果:
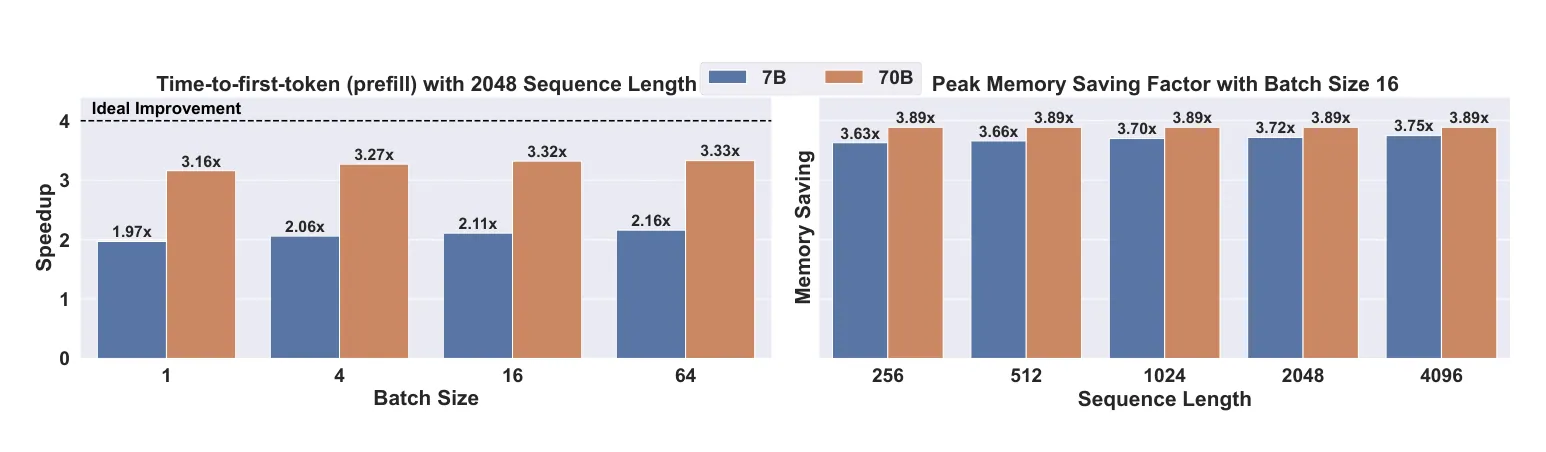
左图 prefill(计算受限):7B 模型拿到 1.97 到 2.16 倍加速,70B 模型最高 3.33 倍,且加速比随 batch 增大而增大——batch 越大计算越饱和,INT4 张量核的优势越能兑现。右图解码峰值内存:7B 至少 3.63 倍、最长序列下 3.75 倍,70B 稳定在 3.89 倍。没到理论上的 4 倍,是因为块内还有激活与中间缓冲等常数项没有被压缩,摊薄了节省倍数;序列越长 KV 占比越高、节省越接近极限,论文预计整模型上的比例还会更高——KV 4-bit 化的内存收益是实打实的。
论文附录里还有一组更细的 kernel 数据值得留意。单个 down-projection 线性层(序列 2048、batch 1、1000 次平均):7B 的层规模下 INT4 比 FP16 快约 3.2 倍,70B 的层规模下快约 4.3 倍,在线 Hadamard 变换最多增加 7% 开销。但解码单 token(缓存 2047 长度)的对比揭示了一个反直觉的边界:batch 小于等于 8 时,4-bit KV 缓存反而比 FP16 慢;batch 16 起才反超,最大约 1.72 倍。原因很直接:4-bit 缓存的收益全部来自少读 4 倍字节,但反量化、缩放、对齐这些固定开销摊在每个读出的块上;序列不够长、batch 不够大时,省下的 I/O 时间覆盖不了量化开销。这个现象在 KV 量化领域是普遍规律(KIVI 论文里也有类似表述):KV 量化是“大 batch、长上下文”场景的武器,小 batch 短上下文时别指望它。
从 QuaRot 出发:后续与局限
QuaRot 最大的贡献是把“旋转”从权重量化的角落提升为端到端低比特推理的通用范式,它留下的开放问题也成了后续工作的靶子。
最直接的继任者是 SpinQuant(Meta,ICLR 2025)。它的出发点是一个实验现象:随机抽一组 Hadamard 旋转,有些旋转量化后的效果显著好于另一些(零样本任务分差可达 13 个点)——那干脆把旋转矩阵本身当成可学习参数,在 Stiefel 流形上用 Cayley 变换做约束优化,让旋转适配具体模型的分布。在 QuaRot 的框架上,SpinQuant 用同样的四类旋转位置(残差流、value/输出投影、KV、FFN),但对能融合进权重的部分(残差流旋转 与头维旋转 )做端到端学习,代价是约 1.25 小时(8 卡、7B)的校准优化。结果:LLaMA2-7B 的 W4A4KV4 与全精度的零样本差距从 QuaRot 的水平进一步收窄到 2.9 分;对难量化的 LLaMA3-8B,相对 QuaRot 的剩余差距最多再缩小 45.1%。SpinQuant 还指出 QuaRot 在张量并行下的一个工程短板—— 的 Kronecker 结构在头数被 TP 切分后不再总是 2 的幂,它自己的 只旋转头维、可以全部融进权重,绕开了这个问题。
QuaRot 的局限可以归纳为四点,理解它们比记住加速数字更有价值:
- 依赖 GPTQ 校准:默认管线需要 128 条 WikiText-2 样本跑 GPTQ 权重量化(论文实测 LLaMA2-70B 约 2 小时,7B 级会短得多)。RTN 免校准方案在 8/6-bit 无损,但 4-bit 下与 GPTQ 仍有差距(小模型尤甚),“免校准 4-bit”直到 SpinQuant 时代仍要靠少量数据优化旋转;
- 在线 Hadamard 需要专门 kernel:每层 1.5 次在线变换虽然只占前向 7% 开销,但那是论文自己 kernel 的水平,要吃到 W4A4 的红利,INT4 MMA、快速 Hadamard、KV 反量化这些 kernel 缺一不可——这也是 QuaRot 论文代码里工程量最重的部分;
- 注意力内部仍是 FP16:KV 只解决了缓存存储的 4-bit,注意力分数与 PV 乘法还在 FP16 做(论文明确保留 FlashAttention 式在线 softmax)。想进一步压榨,需要的是把注意力本身也低比特化(FlashAttention-3 论文里 FP8 注意力的路线),这是另一条技术线;
- 解码端收益有条件:前面说的 batch 16 分水岭意味着单用户、短上下文场景下 INT4 KV 可能不赚反亏;旋转本身对 KV 位宽的提升也救不了 2-bit key 的悬崖。
小结
QuaRot 的故事可以浓缩成一句:W4A4KV4 之所以难,不是量化器不够好,而是坐标系没选对。LLM 的离群值本质上是一组“轴对齐”的结构——它们集中在标准基底的少数坐标上。SmoothQuant 选择把量化难度在权重和激活之间搬运,LLM.int8()、QUIK、Atom 选择识别出离群通道单独高精度处理,QuaRot 则用 Hadamard 旋转把整个坐标系转到一个离群值“摊平”的视角里,再利用 RMSNorm 与 softmax 点积的旋转不变性,把旋转融进权重、让数学输出分毫不差。最终,权重、激活、KV 缓存三个 4-bit 同时成立,零高精度通道,70B 模型困惑度损失 0.47、零样本精度保留 99%、prefill 最高 3.33 倍加速、解码峰值内存省 3.89 倍。它和 SmoothQuant 那种“平滑派”的区别,中文社区有个很形象的概括:一个是把刺磨钝,一个是换一个没有刺的坐标系。
这条思路的后续演化(SpinQuant 的旋转学习、FlashAttention-3 的 FP8 注意力、Blackwell 的 FP4 硬件)说明低比特推理的战场已经转移到“如何让数据分布适配低比特硬件”上——旋转、缩放、裁剪这些数据变换,正在取代复杂的混合精度调度,成为量化系统设计的首选杠杆。
参考资料
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs(arXiv 2404.00456)
- QuaRot — NeurIPS 2024 论文页面(papers.nips.cc)
- spcl/QuaRot 官方代码仓库(GitHub)
- QuaRot — NeurIPS 2024(mlanthology 条目)
- 大模型量化(五):QuIP 与 QuaRot 的旋转突破(知乎专栏)
- Rotate vs Smooth:量化算法中的旋转派和平滑派(知乎专栏)
- SpinQuant: LLM Quantization with Learned Rotations(ICLR 2025)
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(arXiv 2211.10438)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(arXiv 2210.17323)
- KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization(arXiv 2401.18079)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


