


LongCat Sparse Attention(LSA)完全拆解:驯服闪电索引器的三件套——相比 NSA/DSA 真的改进了吗
从一块 2026 年 8 月的论文谈起
2026 年 8 月 3 日,美团 LongCat 团队在 arXiv 上发布了一篇题为 LongCat Sparse Attention: Taming the Lightning via Streaming-aware Hierarchical Cross-Layer Indexing 的论文(arXiv:2608.01662)。几乎同一时间,美团开源了 LongCat-2.0(1.6T 总参数、48B 激活参数的 MoE 模型)以及基于 LSA 构建的开源模型 LongCat-Flash-Lite-Sparse(69B-A3B)。论文的标题直白地宣告了它的立场:「驯服闪电」——闪电指的就是 DeepSeek Sparse Attention(DSA)里的那个闪电索引器(Lightning Indexer)。
这篇论文在稀疏注意力社区里引起的第一个问题,就是本文标题里的那个:LSA 跟 NSA、DSA 比起来,真的改进了吗? 这确实是一个值得较真的问题——稀疏注意力在 2025-2026 年已经是一个高度拥挤的赛道,NSA(原生稀疏注意力,ACL 2025 最佳论文)、DSA(DeepSeek-V3.2 的稀疏注意力)都是这条线上的标杆,任何新工作如果不做实质增量,很容易沦为「换皮」。本文的答案是:LSA 的改进是真实存在的,但它的性质需要精确描述——它改进的不是「稀疏算法范式」,而是 DSA 在真实硬件上的两个系统瓶颈。换句话说,LSA 没有发明一种新的稀疏范式,而是把稀疏注意力的「最后一公里」——访存组织与索引开销——系统地补上了,并且在 560B 参数、100 万 token 上下文的规模上做了验证。
先把 LSA 放在稀疏注意力的谱系里看清楚它的位置。论文自己的 2.1 节把检索式稀疏注意力的演进分成四代:
| 代际 | 代表工作 | 稀疏模式来源 | 特点 |
|---|---|---|---|
| 固定模式 | Longformer、BigBird、Sparse Transformer | 预定义的滑窗/跨步/全局 token | 硬件友好但内容无关 |
| 查询感知、不可学习 | Reformer(LSH)、RetrievalAttention(ANN) | 哈希/近邻检索 | 内容相关但无法训练优化 |
| 粗粒度可学习检索 | MoBA、NSA | 块级打分(均值池化 key / 压缩分支分数) | 可训练,但块内 token 重要性被抹平 |
| 细粒度可学习检索 | DSA(闪电索引器) | 逐 token 打分 + top-k | token 级精度,但带来系统瓶颈 |
DSA 是第四代的代表,它把稀疏粒度推进到了 token 级,却也因此引入了两个此前被低估的系统问题——索引器输出不连续导致的访存浪费,以及索引器自身 的隐藏开销。LSA 的三件套:流式感知索引(Streaming-Aware Indexing,SI)、跨层索引(Cross-Layer Indexing,CLI)、层级索引(Hierarchical Indexing,HI),分别针对这两类瓶颈。下面先回顾 DSA 的机制,再逐个拆解。
DSA 基线:闪电索引器是怎么工作的
LSA 是 DSA 的直接后继者,论文中所有对比都以 DSA 为基线,因此先要精确地复述 DSA(其完整机制此前在站内NSA 系列第二篇讲过,这里只提取与本文相关的骨架)。
DSA 的闪电索引器为每个 query token 给前缀里的每个 token 打一个相关性分。给定 query 的隐藏状态 ,索引器对每个位置 计算:
其中 是索引器头数, 与标量权重 由 经可学习投影得到, 由 得到。三个细节决定了它的「闪电」属性:一是采用 MQA 模式,所有索引器头共享同一个 key ;二是用 ReLU 而非 softmax——softmax 需要跨序列维的归约与指数运算,ReLU 是逐元素操作,吞吐高得多;三是头数约为核心注意力的二分之一、头维度约为三分之一,且支持 FP8 计算。逐 token 的索引成本因此被压到很低。
随后对每个 query 选出分数最高的 个 token:
核心注意力只对这 个条目计算:
其中 是 MLA(多头潜在注意力)的潜在 KV 表示——DSA 实例化在 MLA 的 absorbed MQA 模式下,每个潜在向量被所有 query 头共享。以 、128K 上下文计算,稀疏率约 98.4%,而质量与全注意力几乎持平。训练上,DSA 采用两阶段:先在冻结主模型的情况下用 KL 散度把索引器蒸馏到全注意力的头聚合分布(稠密热身),再放开全部参数联合训练(稀疏训练阶段索引器输入从计算图 detach,只由 KL 损失驱动,主模型只由语言建模损失驱动)。
瓶颈一:索引器输出不连续,HBM 带宽利用率只有 4.5%
LSA 论文对 DSA 的系统性剖析(2.3 节)是全文最有价值的部分之一,因为它把「DSA 部署起来为什么没有理论上那么快」这件事第一次量化清楚了。
第一个瓶颈叫索引器输出不连续(Indexer Output Discontiguity)。动态选出的 token 在序列上是随机散布的,核心稀疏注意力算子必须用 gather 的方式、跨过大片无关数据,去抓取每一个被选中的 KV 向量。论文在他们自研的 AI 加速器上做了精算:理想合并访问下,单个计算核能同时维持约 50 个在途缓存行(cacheline,每条 512B),对应约 25.6 KB 的内存窗口;而 DSA 每选中一个 token,抓取的是一个 1152 B 的潜在 KV 向量(BF16),只占 3 条缓存行。这意味着:
- 这 3 条缓存行只占 50 个在途访存槽位的约 6%——内存级并行度(memory-level parallelism)塌了;
- 即便在这 3 条缓存行内部,数据填充效率也只有约 75%。
两项相乘,净有效带宽只有峰值的约 4.5%(约 1/22)。稀疏注意力在计算复杂度上是 、完全算力友好,实际执行时却变成了严重的内存受限——「计算稀疏」没有兑现成「时间变快」。
反向传播时这个瓶颈更致命。稀疏注意力的反向需要对被选中的非连续 token 索引做 scatter_add 梯度累加:多个计算核可能同时向 HBM 里同一块 KV 梯度区域写数据,写入冲突迫使事务串行化,硬件并发度被大幅压榨。索引器自身的反向同样要沿全部 个被打分位置散射梯度,遭受同样的跨核串行化。
瓶颈二:索引器开销,在 1024K 上下文占整层延迟的 90%
第二个瓶颈是索引器高开销(Indexer High Overhead)。回顾复杂度:每层 DSA 的执行分成两个算子——闪电索引器(Lightning Indexer,LI)给每个 query 对全部 个前缀 key 打分,稀疏 Flash 注意力(Sparse Flash Attention,SFA)只处理固定 个被选 token。解码阶段每个 query 到来时,SFA 的延迟与 无关(恒定约 0.10 ms),而 LI 随 线性增长;更关键的是,LI 内部不止打分是 ,top-k 选择本身也是 ——打分是矩阵运算、可以喂给高吞吐的张量单元,top-k 排序却必须在慢得多的向量处理单元上完成,后者常常才是真正的瓶颈(这个观察直接催生了后面的 HI 机制)。
论文 Table 1 给出了解码场景(batch=4、qlen=1、BF16、K=2048)的逐层延迟分解:
| KV 长度 | 索引器 (ms) | SFA (ms) | 整层 (ms) | 索引器占比 |
|---|---|---|---|---|
| 4K | 0.034 | 0.097 | 0.131 | 26% |
| 32K | 0.053 | 0.098 | 0.151 | 35% |
| 64K | 0.078 | 0.097 | 0.175 | 45% |
| 128K | 0.154 | 0.100 | 0.254 | 61% |
| 256K | 0.302 | 0.102 | 0.404 | 75% |
| 512K | 0.523 | 0.102 | 0.625 | 84% |
| 1024K | 0.930 | 0.102 | 1.032 | 90% |
两个算子的延迟曲线在约 100K 处交叉:短上下文时 SFA 主导,长上下文时索引器接管。索引器延迟从 4K 到 1024K 涨了 27 倍(0.034→0.930 ms),到 1024K 时占整层延迟的 90%——索引器这个「为服务核心注意力而生的组件」,最终比核心注意力本身还要贵一个数量级。而如果每个 query 都要这样全量打分,预填充和训练阶段的索引开销就是 ,这是 DSA 无法支撑百万级上下文原生训练的根源。
LSA 总览:三个正交的机制,两张补丁
LSA 的总体设计可以概括为「针对两个瓶颈各出对策,再加上一个训练无关的加速器」:
- SI(流式感知索引)针对访存不连续:把注意力的预算分成「固定流式区域 + 动态稀疏区域」两半,让一半的 KV 访问变成硬件友好的连续读,从而把稀疏注意力的 gather 问题从「全部随机」降为「一半随机」;
- CLI(跨层索引)针对索引开销:利用相邻层注意力显著性高度稳定的事实,让一层算好的索引被连续若干层共享,把索引遍数除以组大小 ;
- HI(层级索引)同样针对索引开销:把逐 token 的全量打分改成「先粗后精」的两阶段选择,把每次查询的选择复杂度从 降到 。
三者的关系是「互补且可组合」:SI 解决访存、CLI 摊销层间冗余、HI 压缩单次索引的候选空间,互不干扰,可以叠加使用。整体架构如图 1 所示。
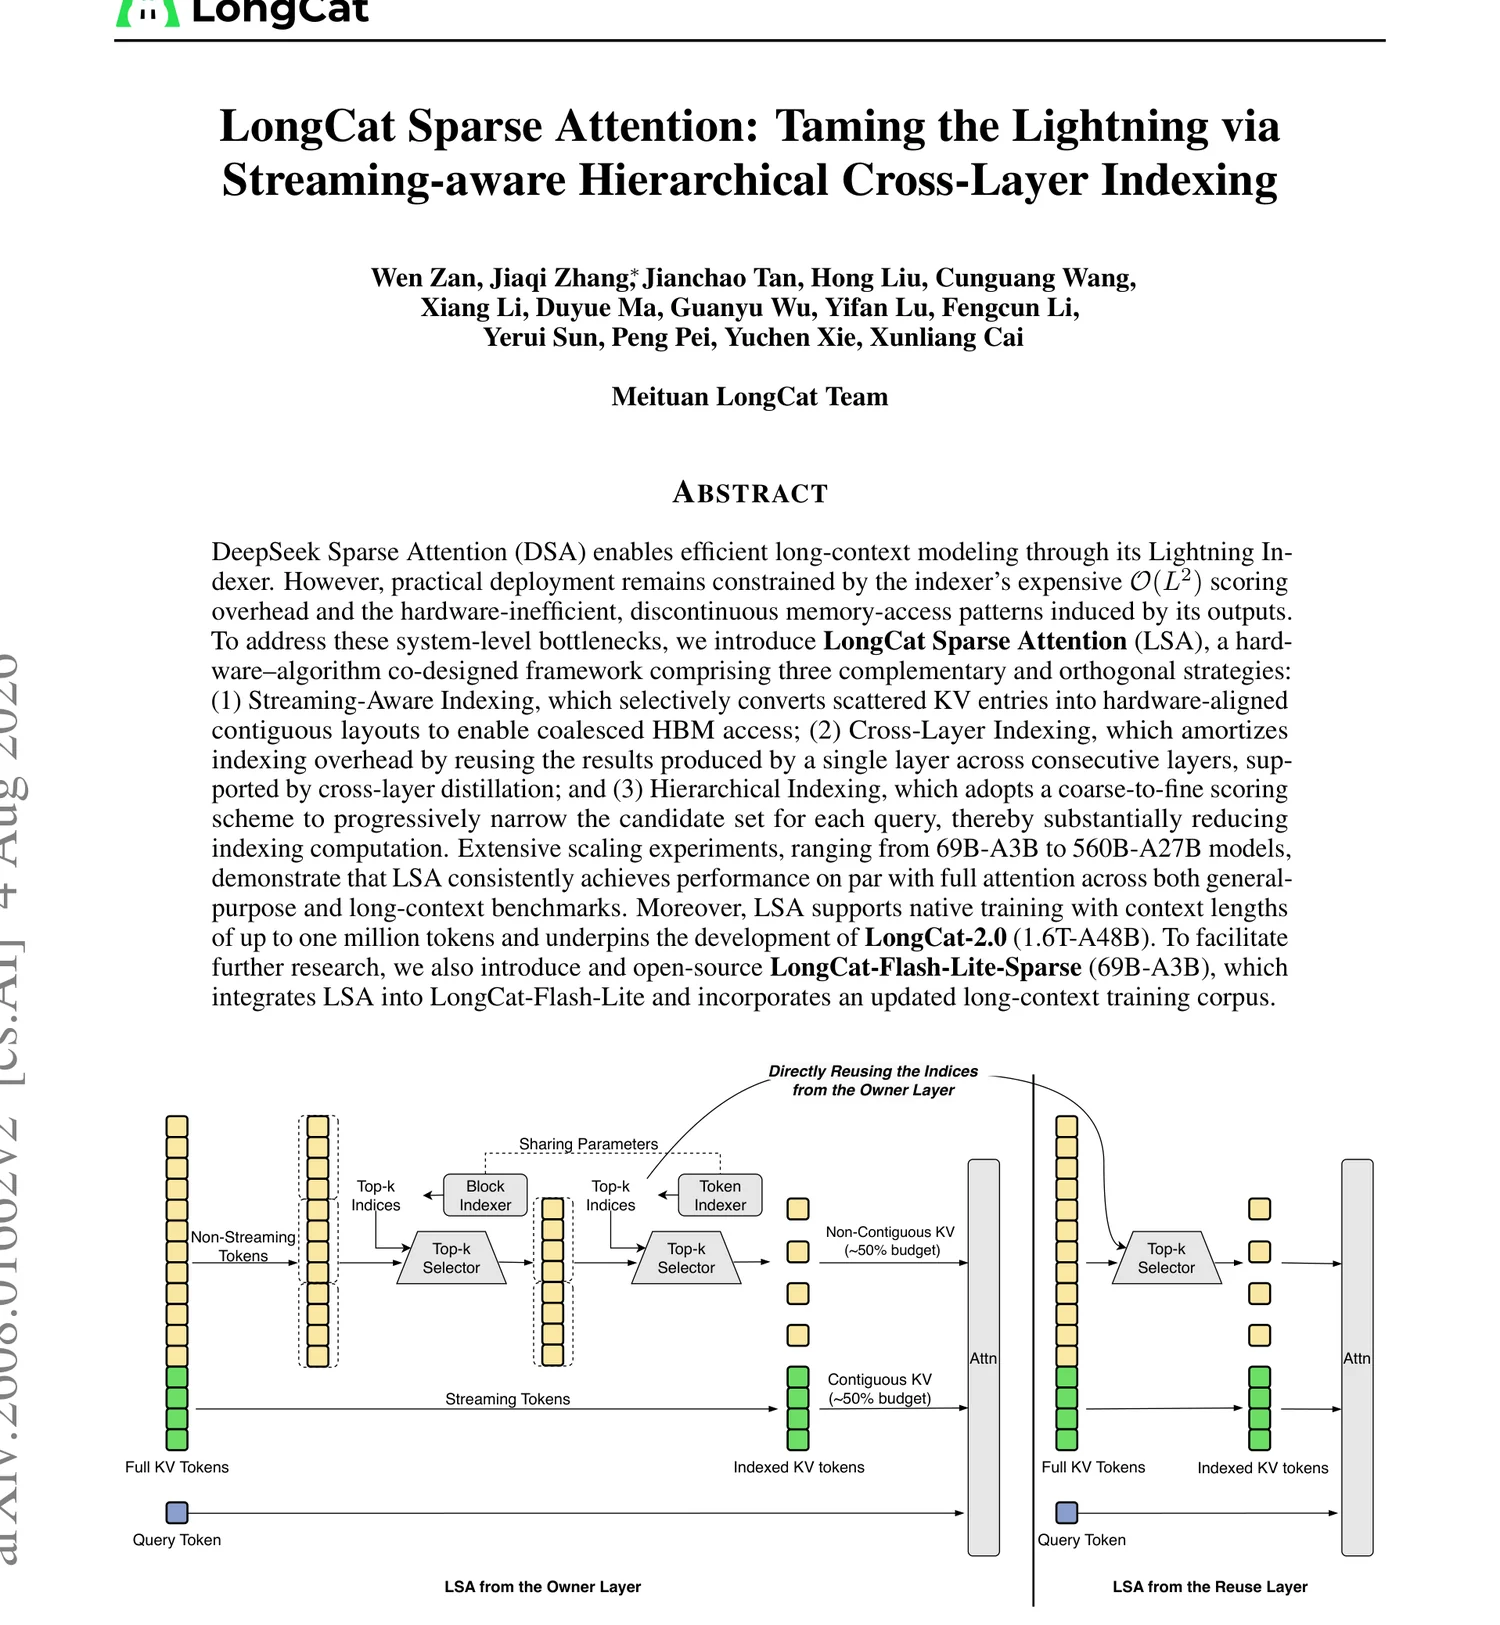
图片来源:LSA 论文 Figure 1。中间是跨层共享的索引器(每 N 层运行一次,图中 N=2);左侧显示注意力预算被划分为固定的 sink + 滑窗区域与动态稀疏区域;右侧是混合稀疏注意力算子 HFA(稀疏分支与滑窗分支并行执行)。
机制一:流式感知索引(SI)——把一半预算变成顺序读
证据:注意力质量的 83% 集中在流式区域
SI 的出发点是一组关于注意力分布的经验事实。StreamingLLM 早已揭示,序列开头的少量 token 是「注意力汇」(attention sink),因 softmax 归一化约束而吸收不成比例的注意力权重;DuoAttention 进一步发现注意力头存在功能分化——流式头(streaming heads)主要关注 sink 和最近 token,检索头(retrieval heads)负责长距离检索。
LSA 论文没有沿袭 DuoAttention 的「按头分类」路线,而是对全头聚合的注意力质量分布做了直接测量。他们在全注意力的 LongCat-Flash-Lite(69B-A3B,14 个 shortcut MoE 块、每个块内两次串行注意力,共 28 个注意力层)上、用 20 条 InfBench-QA 样本(序列长度 8192)统计:sink(16 token)与滑窗(1024 token)区域合计捕获了约 83% 的注意力质量,且这个比例在超过 5K token 后趋于稳定,在所有层上一致(论文 Figure 2)。
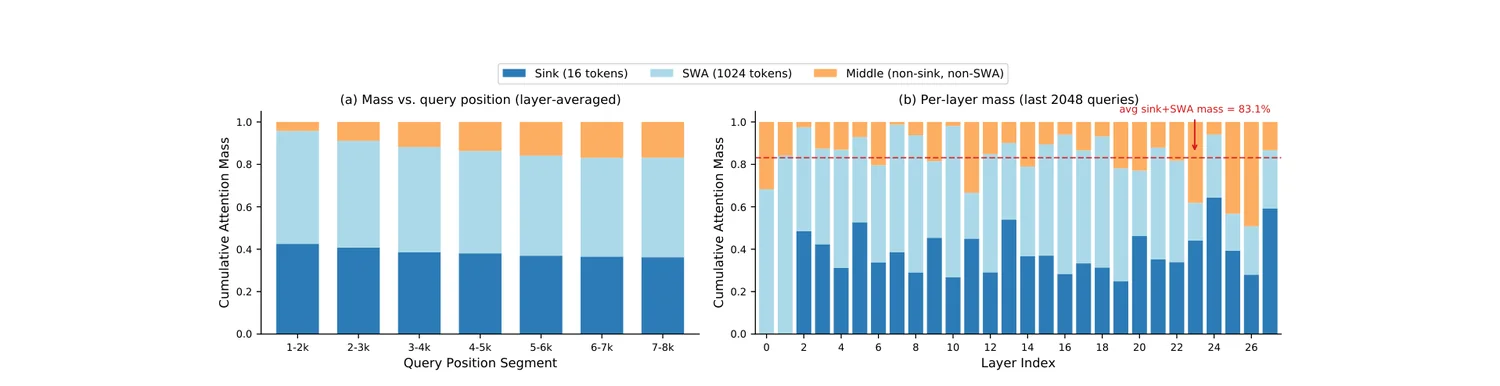
图片来源:LSA 论文 Figure 2。左图:按 query 位置分段的注意力质量占比,流式比例(sink + 滑窗)在 5K token 后收敛到约 83%;右图:按层分解,sink + 滑窗在全部 28 层平均捕获约 83% 的注意力质量(图注中的 avg sink+SWA mass = 83.1%)。
「83% 的质量集中在固定区域」是一个结构性的稳定事实,而不是某个特定 query 的偶然现象。这给了 LSA 一个大胆的设计空间:这些注意力质量是「白送的」,不需要索引器来决策——索引器只需要对剩下的中间区域负责。把固定区域做成确定性的预算,等于把 token 选择预算的一部分从「昂贵的动态决策」改写成「免费的硬件对齐访问」。
预算分解:2048 分三份
LSA 把每个 query 的被关注 token 集合分解为三个互不相交的子集:
其中 是序列开头的 sink 区域, 是 query 附近的滑窗区域, 是索引器从中部动态选出的剩余部分,三者大小满足 。索引器的打分范围相应收缩:
论文的配置是 、、——固定与动态预算约 1:1,即总预算 2048 中约一半的 token 位于连续内存区域。这个比例不是拍脑袋定的,而是消融实验的结果(见下文 5.3.1 节):固定比例 0%、25%、50% 都不伤质量,75% 时大海捞针准确率开始掉,100%(纯滑窗注意力)则训练损失显著恶化。50% 是「能塞进的最大固定窗口而不损质量」的边界。
这个分解带来三层收益,对应着三个不同的系统问题:
- 访存:sink 与滑窗是连续块,可以合并访问;核心注意力被拆成「稀疏 gather 分支」与「连续块分支」,后者彻底摆脱了 4.5% 带宽利用率问题;
- 索引开销:索引器打分范围从 收缩到 ,虽然幅度有限(约减 1040 个 token),但在超长上下文下聊胜于无;
- 接口:固定的流式区域为 KV 缓存卸载与投机解码提供了确定性接口——连续的解码步骤共享可预测的缓存区域,时序局部性(temporal locality)大幅改善。
第三点值得展开:KV 缓存卸载(把缓存放主机内存、只传输稀疏注意力访问的块)的效率取决于跨解码步骤的块重叠率。SI 把平均块重叠率从 65.05% 提升到 82.04%,单层重载延迟从 53.88 μs 降到 30.46 μs;CLI 进一步让索引复用层可以异步预取,可见延迟降到 15.23 μs——只有 DSA 基线的 28%。这是「确定性预算」在系统层带来的实打实的可预测性收益。
训练与 kernel:混合稀疏注意力算子(HFA)
训练侧,SI 不需要改两阶段训练框架:稠密热身阶段照旧对全序列注意力分布做蒸馏;稀疏训练阶段,蒸馏目标变成对选中集合 (含 sink 与滑窗部分)重归一化后的注意力分布。论文强调了一个细节:虽然推理时索引器只给中间区域打分,训练时却刻意把 sink 和滑窗部分也纳入蒸馏目标——因为这两个区域承载了 83% 的注意力质量,把它们纳入监督信号能让索引器学到完整的注意力结构,从而更好地选出中间区域真正重要的 token。
kernel 侧,SI 的实现是一个叫混合稀疏注意力算子(Hybrid Sparse Attention,HFA)的融合算子。前向时,核心注意力不再由一个 SFA 算子吃下全部预算,而是拆成两个并行算子:SFA 处理动态稀疏集合 ,SWA(滑窗注意力)算子处理 。两个算子派发到不同的非阻塞硬件流上重叠执行,部分输出用在线 softmax 重缩放(online-softmax rescaling)合并——也就是把两部分的 求和统计量按比例合成,数学上与一次完整注意力等价。反向时,HFA 的收益来自写冲突的减少:SFA 反向的核心瓶颈是对全序列长度分配梯度缓冲、再对选中索引集合做 scatter_add,不同核选中重叠索引时写同一缓存行导致串行化;把约一半预算划给连续的滑窗后,活跃的稀疏索引集合变小,离散 gather/scatter 次数与写冲突概率同时下降。
机制二:跨层索引(CLI)——一次索引,两层共享
证据:相邻层的 Top-K 有 57% 重叠、93% 覆盖率
CLI 的出发点同样是一组经验观察:大量工作(TidalDecode、Kascade、HySparse 等)已发现,跨相邻 Transformer 层,「显著 token 集合」高度稳定——这一现象支撑了一族「少数全注意力层当 oracle、其余稀疏层复用其选择」的稀疏方法。
LSA 要回答的更进一步的问题是:DSA 的闪电索引器单独在一层运行时,能不能选出「这一层和相邻层共同显著」的 token? 论文的做法是在全注意力的 LongCat-Flash-Lite 上让每一层独立运行自己的索引器,再统计层间一致性(论文 Figure 3):
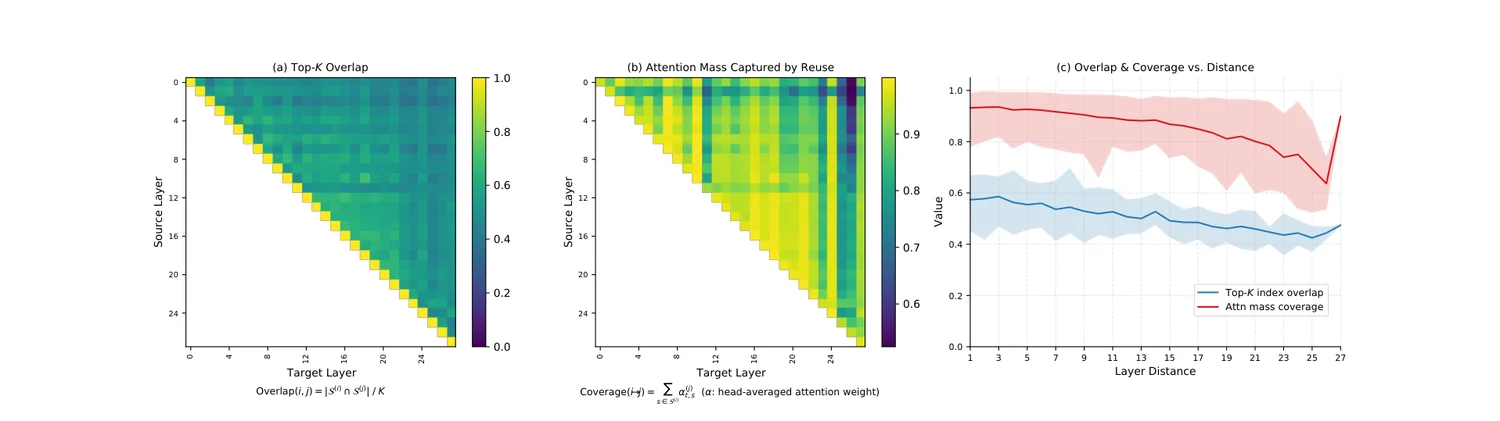
图片来源:LSA 论文 Figure 3。(a) 相邻层 Top-K 集合的成对重叠率矩阵;(b) 用一层 Top-K 覆盖另一层时捕获的注意力质量;(c) 随层距变化的平均重叠与覆盖率,相邻层约共享 57% 的 Top-K 预算、保留约 93% 的注意力质量。
两个数字值得细读:相邻层平均共享 57.4% 的 Top-K 预算,而把相邻层的索引集合拿来直接复用,仍能捕获目标层 93.2% 的注意力质量。注意这两个数字并不矛盾——Top-K 集合只有一半重合,但「没重合的那一半」在注意力质量上贡献很小,所以复用一层的结果覆盖了绝大部分真实注意力。
机制:owner 层算索引,复用层白拿
CLI 把连续层划分为大小为 的组,组内第一层(owner 层)执行索引器,其余 层直接复用它的索引集合。索引遍数从 降到 。
但「直接复用」有一个陷阱:每个索引器原本只被训练来预测自己这一层的显著性。如果推理时把它拿给相邻层用,选择质量会大打折扣。论文的消融给出了量化结果:不做跨层蒸馏的朴素复用,128K 大海捞针准确率跌到 70%,远低于蒸馏后的 CLI N=2(96%)甚至 N=4(82%)。这正是 CLI 的核心贡献所在——跨层蒸馏(cross-layer distillation):训练时,owner 层的索引器不再只对自己的注意力分布负责,而是对组内全部 层的注意力分布负责:
其中 是组内第一层, 是组大小, 是第 层的索引器蒸馏损失(即共享索引器输出与该层注意力分布的 KL 散度)。这个改动同时作用于稠密热身与稀疏训练两个阶段,推理时共享索引器只跑一次、把索引集合广播给组内所有层。
参数选择:为什么是 N=2 而不是 N=4
组大小 是 CLI 的核心旋钮,取值受三个因素约束:
- 长上下文质量:Figure 3(c) 显示,层距超过 4 后,所有层对的覆盖率最小值开始明显下降;消融(5.3.2 节)进一步确认 在长上下文验证集上持续落后——有趣的是,把 top-k 预算从 2K 加到 4K 也救不回来,说明「一层索引服务四层」的困难不在预算而在显著性模式的多样性;
- 架构约束:LongCat 系列采用 shortcut 连接架构,每个 shortcut 层内含两次串行注意力;同时要求 为偶数,才能与流水线并行(pipeline parallelism)的 stage 划分对齐;
- 与并行的兼容性:偶数 保证组边界在流水线 stage 内均匀分布。
于是 成为默认配置:索引计算减半,质量无可测损失。有趣的是,论文 3.2 节与一项并发工作 IndexCache(arXiv:2603.12201)做了对照——后者独立提出了几乎相同的训练感知跨层蒸馏复用机制,但报告 时性能仍能保持在基线 0.4% 以内。LSA 认为差异来自模型架构与上下文长度的不同:IndexCache 针对标准 Transformer 布局,而 shortcut 结构中每层含两次注意力、显著性模式更复杂。这个分歧本身是个提醒:跨层复用能走到多深,是模型相关的,不存在普适的免费午餐。
扩展到 MTP:投机解码路径上的复用
CLI 的第三个应用场景是 MTP(多 token 预测,DeepSeek-V3 引入的投机解码草稿模块,站内已有专文拆解)。MTP 在主干之后串行堆叠 个预测步(每步一个带独立注意力的 Transformer 层)。LSA 让全部 3 个 MTP 步共享一个索引(N=3),用跨层蒸馏把共享索引器训练成对三步联合最优:
表面上看,MTP 步与主干层不同——它们处理的是掺入未来 token 嵌入的表示,层间显著性相关性似乎更弱。但蒸馏损失保证了共享索引器是「为三步联合优化」的,而非简单复用某一步的结果。实测的验收指标是草稿接受长度(acceptance length):3 步 MTP 的理论上限是 4,LSA 平均 3.11,稠密 MLA 平均 3.15——差距可忽略(HumanEval 2.96 vs 2.97、GSM8K 3.17 vs 3.20、AIME 2.88 vs 2.83、MRCR 3.46 vs 3.59)。由于草稿 token 最终由主模型验证,草稿质量的微小波动只影响接受长度、不影响最终生成质量,这个代价完全可接受。
机制三:层级索引(HI)——先粗后精,把 top-k 的候选空间打薄
SI 和 CLI 在训练与推理时都生效;HI 则是纯推理期、免训练的即插即用模块,目标是把单次索引的成本打下来。
先回到一个关键观察:索引器的成本大头不是打分,而是 top-k 选择。打分是 的矩阵乘,可以喂给高吞吐的矩阵处理单元;top-k 却要在慢得多的向量处理单元上对全部候选排序。所以「减少候选集合」比「减少打分计算」更优先。HI 的两阶段设计正是为此:
阶段一:块级粗召回。 把序列切成大小为 的页(page),每页再切成 token 的子块。对每个子块,预计算其键的逐维均值 (每序列只算一次、缓存复用)。粗粒度页分数用与索引器相同的 query 与权重计算:
即每页的分数 = 页内各子块「均值 key 与 query 内积」之和。选出分数最高的 页作为候选:
阶段二:token 级精选。 只在召回页覆盖的 个 token 上做标准的逐 token 索引打分(公式与 Eq.1 相同),选出最终的 个:
按「top-k 选择才是瓶颈」的口径统计,两阶段各含一次 top-k:在页级别上是 ,在召回 token 上是 ,总复杂度从 降到:
论文配置 、、,即粗召回 1024 页 = 128K token 的候选预算。数值账(论文 Table 4,prefill、qlen=2048、BF16)如下:
| KV 长度 | 32K | 64K | 128K | 256K | 512K | 1024K |
|---|---|---|---|---|---|---|
| HI 总延迟 (ms) | 7.480 | 14.617 | 30.226 | 32.681 | 37.527 | 46.931 |
| 扁平索引器 (ms) | 5.934 | 11.950 | 23.977 | 48.025 | 96.139 | 192.698 |
| 加速比 | 0.79× | 0.82× | 0.79× | 1.47× | 2.56× | 4.11× |
注意 128K 以下的加速比是 0.79×——反而变慢了:候选预算(128K token)在短序列时接近全序列,阶段二几乎要处理全部 token,两阶段的额外开销(块均值维护、粗打分、候选 gather)净效果是负的。超过候选预算后,阶段二延迟饱和在约 27.8 ms 恒定值(与 无关),而扁平索引器继续线性增长,加速比随之拉大,1024K 时达到 4.11×。因此 HI 只在序列长度超过交叉点(本设置约 200K,论文统一按 ≥256K 启用)时开启,短上下文回退到扁平索引器。
免训练模块也有质量风险:粗召回的漏检是精阶段无法补救的,所以论文对三个旋钮逐一做了消融:
- 池化方法:对比了均值池化与 min-max 池化(后者用块内每维极值构造一个能上界块内最大 token 分数的粗分数,是 AsyncTLS/HISA 等并发工作采用的方案)。128K 大海捞针下,均值池化在池化尺寸 1/4/8/16/32 上得 82/76/80/78/74,min-max 得 82/64/60/68/68——均值明显更稳, 是效率-质量平衡点;
- 层选择:浅层对 HI 的召回误差更敏感,关闭前 4 个索引器的 HI 后 128K 大海捞针从 84 升到 92;
- 召回预算:MRCR(多针检索)任务上, 页(32K token)时 256K/512K 得 30.96/24.32, 页(128K token)时升到 32.34/30.28,而 LSA 无 HI 基线为 31.49/27.07—— 是保住质量的下限。
最终配置:均值池化、、关闭前 4 层 HI、 页,序列 ≥256K 时启用。
效率账:训练加速 1.6×、端到端 prefill 最高 3.6×
单层训练延迟:vs DSA 与 vs 稠密 MLA
先把三件套在效率上的贡献分清楚。论文 4.2 节对比了 LSA 与 DSA 的单注意力层训练延迟(含 kernel 执行与上下文并行通信,论文 Figure 4):
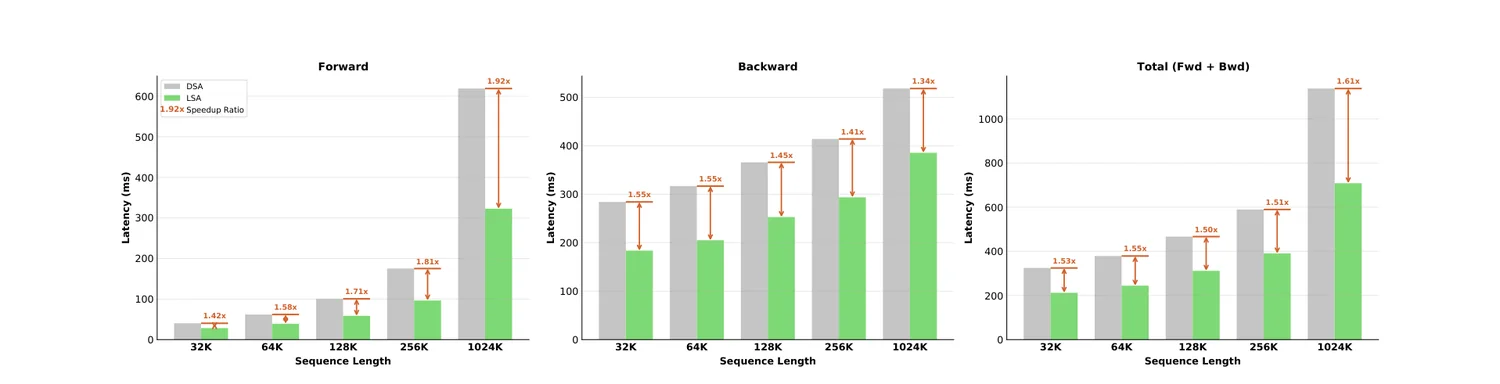
图片来源:LSA 论文 Figure 4。前向、反向与总延迟三组柱状图,箭头标注 LSA 相对 DSA 的加速比:32K 时总延迟 1.53×,1024K 时 1.61×。
LSA 相对 DSA 的总延迟加速 1.53×(32K)到 1.61×(1024K),拆开看:前向 1.42–1.92×,反向 1.34–1.55×。两个机制各贡献一半:CLI 把索引器前向摊销到两层(只省前向,因为共享不减少反向计算),在长上下文索引器成本占优时增益更大;SI 则前后向都省——尤其反向,因为消除了 SFA 反向的写冲突瓶颈,而反向本就比前向贵,绝对节省更大。
与稠密 MLA 的对比(论文附录 A,Figure 10)则画出了一条关键的交叉曲线:32K 时 LSA 反而慢(0.83×,索引开销净负),64K 时 1.39×,128K 时 2.21×,256K 时 3.39×,1024K 时总延迟 7.73×(前向 2.91×、反向 11.76×)。计入实际数据混合中的变长序列打包后,实际效率交叉点在 128K。这正是「百万上下文原生训练」能成立的原因:稠密 MLA 的反向在 1024K 下是二次增长,稀疏化后反向反而是最赚的(11.76×)。
端到端推理:prefill 1.42–3.60×,decode 1.25–1.40×
端到端对比在 LongCat-Flash-Lite(69B-A3B)规模上进行(论文 Figure 5)。服务配置上,≥256K 的请求启用 KV 缓存分区(KVP,见附录 B:缓存页按页粒度分片到多个 rank,每个 rank 先选本地 top-k、all-gather 后全局重排,SFA 在本地分片上并行计算再用 log-sum-exp 合并);HI 只在 prefill 且 ≥256K 时启用(解码场景其两阶段开销不划算,且 KVP 已降低单 rank 的 KV 长度)。
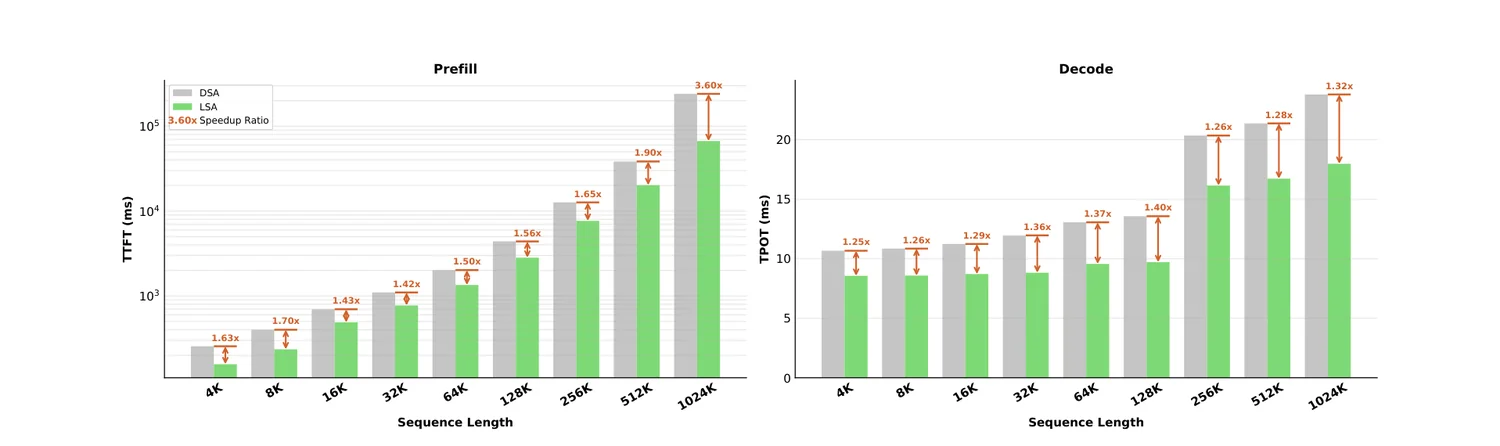
图片来源:LSA 论文 Figure 5。左图 prefill 的 TTFT(对数坐标),加速比随上下文增长,1024K 时 3.60×;右图解码的 TPOT,加速比在 128K 达到峰值 1.40×,之后因切换到 KVP 配置而略有回落。
prefill 的 TTFT 加速 1.42–3.60×,且随上下文单调增长——索引器在长上下文占的份额越大,CLI 与 HI 的收益越大(1024K 处 3.60×)。解码的 TPOT 加速 1.25–1.40×,峰值出现在 128K;256K 以上启用 KVP 后,KV 分片降低了索引器每 rank 的工作量,LSA 相对 DSA 的优势被部分抹平——1.26×、1.28×、1.32×。短上下文解码的 1.25× 主要来自 SI(核心注意力拆成并行双流 + 更少写冲突)。
把效率账收拢一下:LSA 的加速不是单一机制的功劳,而是「短上下文靠 SI、长上下文靠 CLI 与 HI」的分工——SI 缓解核心注意力的访存瓶颈(短上下文主导),CLI 摊销索引前向(随上下文越长越重要),HI 压制 prefill 的超线性索引增长(≥256K 才启用)。
质量账:与全注意力持平,但有两处要细看
HELMET 与标准基准
论文在两个规模上做了质量验证。长上下文用 HELMET(覆盖 Recall/RAG/Re-rank/LongQA/Citation/Summarization 六类):
| 模型 | 注意力 | Recall | RAG | Re-rank | LongQA | Cite | Summ | 平均 |
|---|---|---|---|---|---|---|---|---|
| Flash-Lite 69B | MLA | 98.83 | 64.61 | 71.34 | 44.03 | 35.83 | 36.38 | 58.50 |
| Flash-Lite 69B | DSA | 99.13 | 65.10 | 70.73 | 42.98 | 36.91 | 36.78 | 58.60 |
| Flash-Lite 69B | LSA | 98.63 | 64.38 | 72.64 | 44.46 | 37.53 | 36.48 | 59.02 |
| Flash 560B | MLA | 97.30 | 85.40 | 62.09 | 38.89 | 43.98 | 48.53 | 62.70 |
| Flash 560B | LSA | 97.38 | 84.60 | 71.36 | 38.97 | 45.20 | 49.10 | 64.43 |
Flash-Lite 上 LSA 平均 59.02,略高于 MLA 的 58.50 与 DSA 的 58.60,六类互有胜负。Flash(560B-A27B 思考模型)上 LSA 领先 MLA 达 1.73 分,主要来自 Re-rank 类 +9.3——论文对此的解释很诚实:这是评测伪影而非稀疏性的功劳。Flash 是长思考模型,生成容易被最大长度截断;LSA 生成略短、被截断的比例更小,而 MLA 在 Re-rank 子集上生成长度明显更长,截断拖低了分数。其余类别两架构相当。
标准基准(MMLU/GPQA/AIME/HumanEval+ 等)上,论文的结论是「无一致胜者」:Flash-Lite 上 LSA 的 AIME 2025(64.27 vs MLA 59.90、DSA 63.65)与 GPQA-Diamond(69.51 vs 68.72/68.66)略高,MATH500 略低(97.20 vs 98.20/96.60),MMLU 持平(85.50 vs 85.54/85.27)。稀疏化没有系统性代价。
两处需要细看的数字
第一处:SI 消融里 Recall 子项的下降。5.3.1 节把固定预算比例从 0% 扫到 100%:0/25/50% 在训练损失、长上下文验证损失与大海捞针上与 MLA 相当,75% 时大海捞针明显掉点,100% 直接弃用。但看 HELMET 细项(Table 9):SI(50% fixed)的 Recall 是 94.20,低于 LI(0% fixed)的 96.28 与 MLA 的 95.68——平均分 56.59 掩盖了 2 分的检索能力回退。50% 固定预算意味着动态选择只有 1024 个名额,「检索头」能自由挑选的范围缩水了。这不是错误,而是权衡:2 分的召回换取一半访存的连续性。阅读这篇论文时不应该跳过这个数字。
第二处:HI 在 agentic 任务上稳定掉 1-3 分。LongCat-Flash-Lite-Sparse 的评测(Table 15/16)显示,启用 HI 后绝大多数长上下文任务变化在 1 分以内(LongBench-v2 甚至微升 53.64 vs 52.50),但代码理解(LongCodeQA 62.30→59.37)与若干 agentic 任务(SWE-Bench Verified 68.20→65.20、SWE-Bench Multilingual 59.33→56.00、RWSearch 68.50→66.00)出现 1.5-3.3 分的下降。粗召回漏掉的长尾代码上下文是精阶段补不回来的。所以论文把 HI 定义为「质量小幅退化换取 4.11× 索引加速」的选项,而非无损组件——这正是免训练模块的典型属性:它不参与训练,模型从未学会适应它的召回误差。
开箱即用:LongCat-Flash-Lite-Sparse 与 LongCat-2.0
LSA 不是一篇纯论文工作,它带出了两个真实模型。
LongCat-Flash-Lite-Sparse(69B-A3B)是把完整 LSA 配方装进 LongCat-Flash-Lite 的开源模型:K=2048(sink 16 + 滑窗 1024 + 动态 1024)、CLI N=2、MTP 3 步共享索引(N=3)、HI 作为 ≥256K 的推理期选项。训练流水线分五阶段把原生上下文从 32K 一路推到 1M(32K→64K→128K→256K→1M),并在 128K 阶段起点从稠密 MLA 转换为 LSA(论文 5.3.6 节专门验证了转换时机的鲁棒性:128K 早转与 512K 晚转最终 HELMET 分别 58.96 与 59.02,均持平 MLA 的 58.50,因此推荐早转以最大化训练吞吐)。与稠密版对比,长上下文推理效率大幅提升的同时,agentic 能力反而更强:SWE-Bench Verified 68.20 vs 54.40、SWE-Bench Multilingual 59.33 vs 38.10、τ²-Telecom 95.18 vs 72.80、VitaBench 21.67 vs 7.00——论文将此归因于 1M 原生上下文让模型能吞吐整个代码仓库与长对话历史。通用能力(MMLU 85.31 vs 85.52、GPQA-Diamond 69.49 vs 66.78)基本持平。
LongCat-2.0(1.6T-A48B)则是 LSA 的「训练效率红利」的终点:论文明确说,正是 LSA 相对稠密 MLA 的训练加速(1024K 下 7.73×),让这个万亿参数模型在有限算力预算下完成了 100 万 token 上下文的原生训练(据公开报道,训练集群基于国产 AI 芯片,这也解释了论文性能剖析为什么是在自研加速器上完成的)。模型权重与代码已在 Hugging Face 与 GitHub 开源——仓库里除了模型卡,还包含 LSA 的配置说明(sink/滑窗/动态预算、CLI 组大小、MTP 共享索引等超参的完整取值),想复现训练或做推理实验的读者可以直接照着搭。
案例回放:稀疏注意力在 1M 上下文里长什么样
前面都是抽象机制与汇总数字,最后用论文附录 C 的一个案例分析把 LSA 的实际行为可视化出来。样本取自 RULER 的多针大海捞针任务(8 根针埋在 1M 上下文的代码仓库类文本里),论文在层 12/13/26/27 上并排展示了三列信息:LSA 索引器分数(softmax 归一化)、选择掩码(K=2048,白色为选中,红色虚线标出滑窗边界)、以及稠密 MLA 的全注意力权重(头平均):
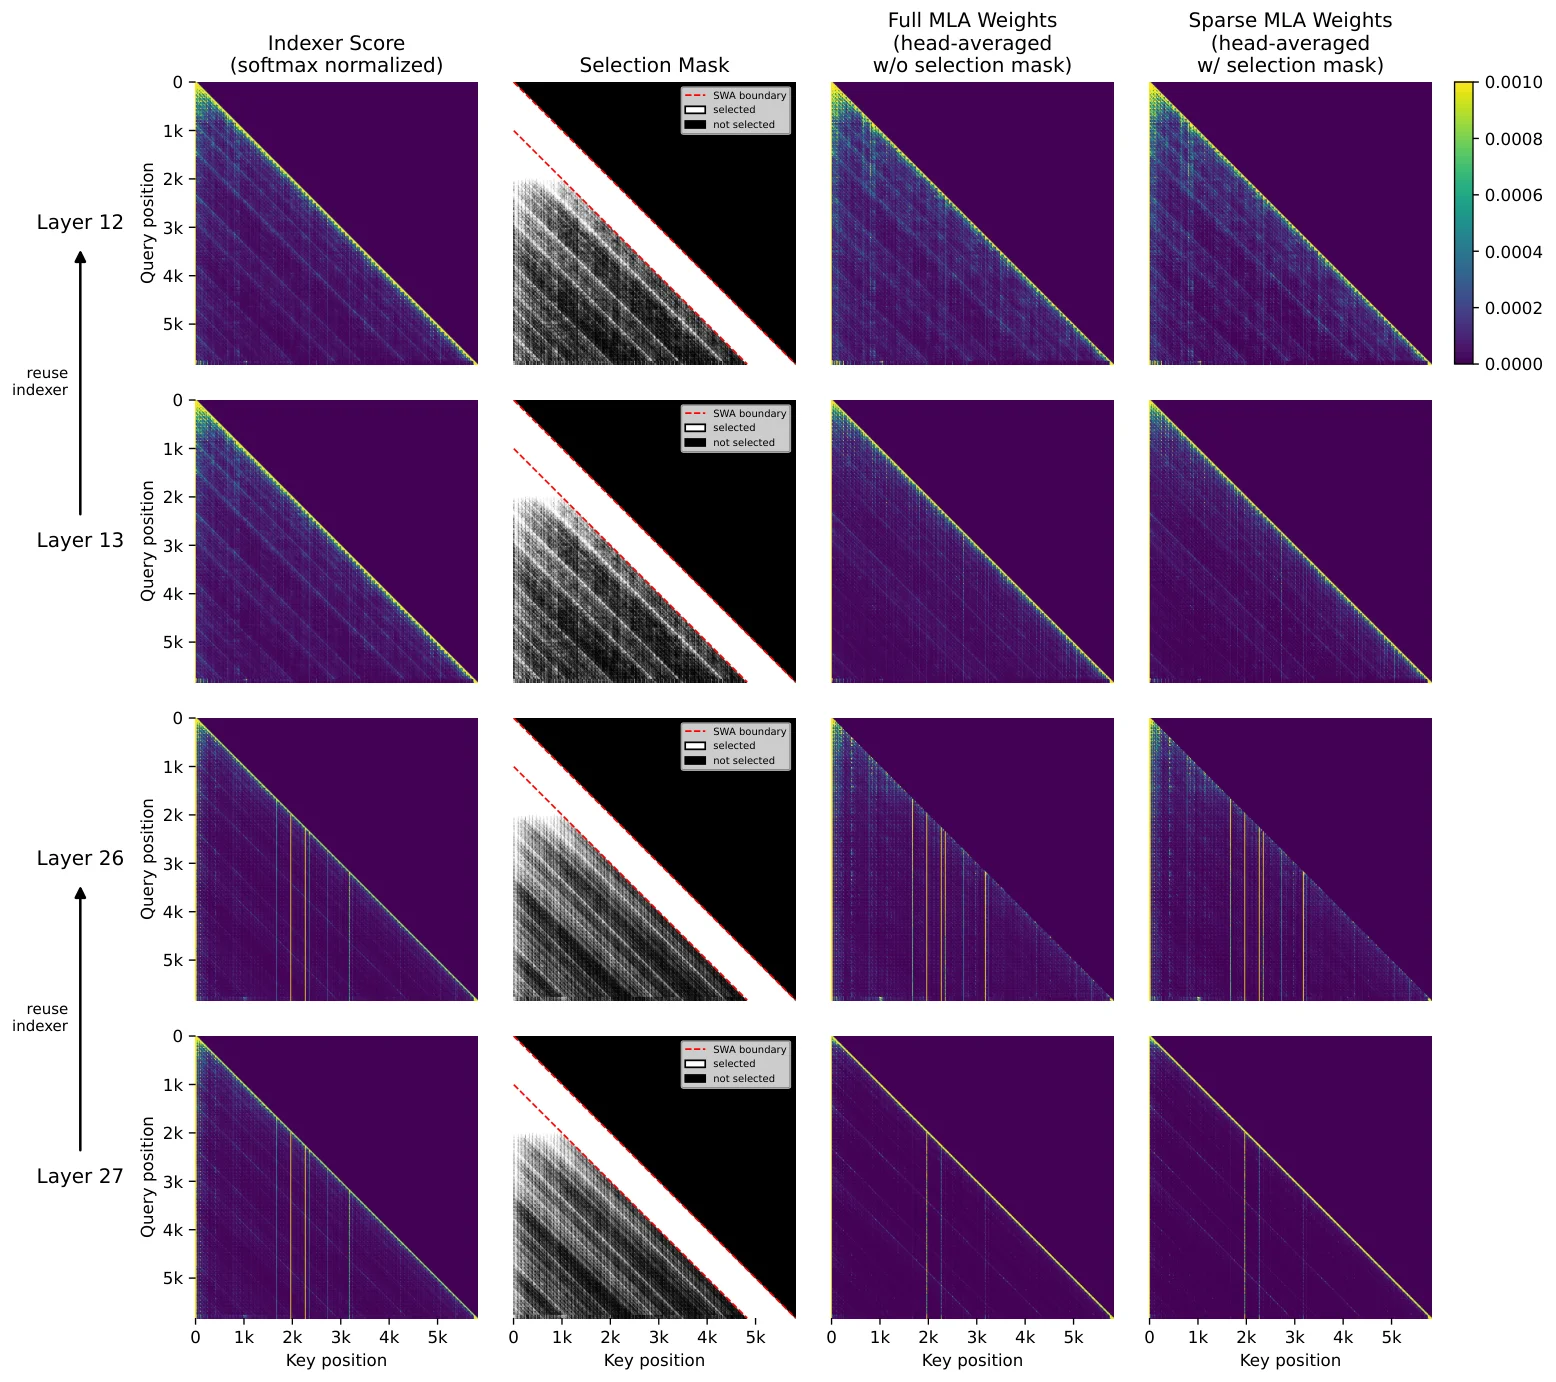
图片来源:LSA 论文附录 Figure 12。列 (1) 是 LSA 索引器分数(softmax 归一化),列 (2) 是 top-K 选择掩码(白色选中,红色虚线为滑窗边界),列 (3) 是稠密 MLA 的全注意力权重(头平均)。可见稀疏选择与全注意力高亮区域高度吻合,滑窗边界内的连续区域是固定预算的主场。
这张图值得读出的信息有三层。第一层,索引器分数与全注意力高亮区域高度吻合——稀疏选择不是拍脑袋,它选中的位置(白色区域)几乎都落在全注意力权重最高的地方,这是「token 级选择无损」最直观的证据。第二层,滑窗边界清晰可见:红色虚线之内是一整条连续的高分带,对应注意力质量分析里那 83% 的流式份额——这些区域根本不需要索引器介入,固定预算直接覆盖。第三层,层间共享的真实效果:层 26 与层 27 通过 CLI(N=2)共享同一份选择结果,两行的选择掩码完全一致,而对应的全注意力图依然高度相似——这从微观上印证了「相邻层显著性稳定」的统计结论。
论文的附录还给出了另一个耐人寻味的观察:把稀疏注意力权重线性截断到 显示时,能清楚地看到弱长程依赖(真正的最大值约 0.26)——即 LSA 在 2048 个被选 token 里,依然保留了从问题 token 指向远处文档段落的微弱长距离连接。稀疏化砍掉的是「不重要的 token」,不是「弱的依赖」:模型需要的那根长距离细线,被索引器完整地捞了回来。
诚实回答:跟 NSA、DSA 比,真的改进了吗
现在把三者的对比收拢成一张表,逐项过一遍:
| 维度 | NSA(2025.02,论文) | DSA(2025.09,V3.2-Exp) | LSA(2026.08,LongCat) |
|---|---|---|---|
| 稀疏粒度 | 块级(64-token 块 × 16 块) | token 级(top-2048) | token 级(动态 1024 + 固定 1040) |
| 选择信号 | 压缩分支 softmax 分数(零额外开销) | 独立闪电索引器(ReLU、FP8) | 闪电索引器 + 预算分解 + 粗到精 |
| 打分器训练 | 与主模型端到端(LM 损失) | 两阶段 KL 蒸馏(detach) | 两阶段 KL 蒸馏 + 跨层蒸馏 |
| 索引遍数/层 | 每层一次(块级) | 每层一次 | 每 2 层一次(MTP 每 3 步一次) |
| 单 query 选择复杂度 | 块打分 O(L/d) | O(L) 打分 + O(L) top-k | O(L/P + MP)(HI,≥256K) |
| 访存形态 | 块级连续(组中心加载) | 全随机 gather(带宽利用率 ~4.5%) | 半连续半 gather(HFA 双流) |
| 验证规模 | 27B(64K 上下文) | 671B(128K,续训改造) | 69B/560B(512K/256K),1M 原生训练,1.6T 模型 |
| 加速口径 | vs 全注意力:前向 9×、解码 11.6×(A100) | vs 稠密:长上下文成本显著下降(H800) | vs DSA:prefill 1.42–3.60×、decode 1.25–1.40×(自研加速器) |
逐条解读。
相对 DSA:是的,实质改进。 这是最没有争议的部分。LSA 论文对 DSA 的两个瓶颈做了此前无人量化的分析(4.5% 带宽利用率、90% 索引器延迟占比),并给出了对症的解法:SI 让一半访存连续化并顺带解决了反向写冲突,CLI 把索引前向减半且经蒸馏后无损,HI 把 prefill 的索引 top-k 从线性压到亚线性。端到端 1.42–3.60× 的 prefill 加速在 1024K 上下文下是实打实的系统收益。「改进」在这里的含义是:让 DSA 从「实验室里与全注意力持平」变成「能在 100 万上下文下原生训练与部署」。DSA 路线本身(token 级 + 独立索引器)被 LSA 证明是可以在系统层面被驯服的。
相对 NSA:不是同一赛道的改进。 NSA 与 LSA 的分歧是根本性的:NSA 是「块级稀疏 + 端到端原生可训练」,其选择信号是压缩分支的注意力分数的副产品——打分零额外开销、稀疏模式由语言建模损失端到端驱动;LSA 继承 DSA 的「token 级 + 独立索引器」,索引器需要 KL 蒸馏训练、输入从计算图 detach。LSA 论文引用了一条对 NSA 的合理批评:块级选择会模糊块内 token 的重要性差异,在长上下文与推理任务上可能次优。但反过来,token 级选择的代价正是 LSA 自己修的那两个瓶颈——这是 DSA 路线为了粒度付的税,LSA 只是把税单降低了,没有取消。NSA 的「压缩分支信号复用」思想(打分零成本)也没有进入 LSA。所以更准确的说法是:LSA 是「DSA 的系统化补丁」,不是「NSA 的替代品」;两条路线在「打分器与模型如何协同」这个根本问题上依然分道扬镳。NSA 的 9×/11.6× 是对全注意力、在 A100 上的测量;LSA 的 3.6× 是对 DSA、在自研加速器上的测量——口径不同,不能直接比较,但都能说明各自路线内部的自洽。
概念新颖性:三件套都有先例,增量在组合与工程。 SI 的「sink + 滑窗固定预算」本质上是 StreamingLLM/DuoAttention 的观察与 NSA 的固定激活块在 token 级上的重演,但论文用完整的预算比例消融(0-100%)和训练目标的设计(蒸馏包含流式区域)把它做扎实了;CLI 与 TidalDecode、Kascade、IndexCache(并发工作)同向,论文的独特贡献是跨层蒸馏损失与 MTP 扩展,以及「N=2 保守 vs IndexCache 的 N=4」的诚实分歧;HI 与 NSA 压缩分支、MoBA 的块级路由、HISA/AsyncTLS 同属粗到细思想,但「top-k 选择才是瓶颈」的定位和免训练即插即用的工程形态是它的特色。因此「改进」主要发生在系统层(访存组织、索引摊销、规模验证),而非算法范式层。
必须同时说清的三条局限。 其一,论文自己在结论里承认:LSA 大幅削减注意力计算,但 KV 缓存的存储占用一点没省——每个 token 的 KV 仍要落盘,KVP 与主机内存卸载只是缓解单卡压力,不降低总存储开销(论文建议未来与 CLA 的层间 KV 共享、DeepSeek-V4 CSA 的序列维压缩融合);其二,所有性能数字都在美团自研加速器上测得,4.5% 带宽利用率、3.60× 等数字的迁移性取决于目标硬件的 gather 能力(H100 级硬件有 TMA 等更优的 gather 原语,差距可能被压缩);其三,SI 的 Recall 子项 -2 分与 HI 的 agentic -1.5~-3.3 分是真实的权衡,不是免费的。
一句话结论:LSA 相对 DSA 是实质性的系统改进,相对 NSA 是另一条路线的补完;它最大的贡献是把「token 级稀疏注意力在 100 万上下文下可用」从口号变成了可复现的开源事实。 对想跟进这个方向的人来说,论文的 2.3 节剖析与 5.3 节消融(尤其「跨层蒸馏是复用前提」「top-k 才是索引瓶颈」「50% 固定预算是质量边界」三个结论)比任何单一机制都更有参考价值。
小结
最后把本文的要点压缩成五句话:
- LSA 由美团 LongCat 团队于 2026 年 8 月提出(arXiv:2608.01662),定位是 DSA 的系统级补丁,目标是让 token 级稀疏注意力支撑百万级上下文;
- 它先量化了两个此前无人算清的瓶颈:DSA 的 gather 访存把 HBM 有效带宽压到 4.5%,索引器在 1024K 上下文占整层延迟的 90%;
- 三件套各管一段:SI 用 50% 固定预算(sink 16 + 滑窗 1024)换一半连续访存与反向写冲突减半,CLI 用跨层蒸馏让两层共享一次索引且无损,HI 用页级粗召回 + token 级精选把 prefill 索引 top-k 从 压到 (1024K 时 4.11×);
- 成绩单:相对 DSA,训练 1.53–1.61×、prefill 1.42–3.60×、decode 1.25–1.40×,质量与全注意力持平;相对稠密 MLA,1024K 下训练总延迟 7.73×——这是 LongCat-2.0(1.6T-A48B)能原生训练 1M 上下文的前提;
- 诚实账:SI 的检索子项掉约 2 分、HI 在 agentic 任务掉 1.5-3.3 分、HI 只在 ≥256K 有用(短上下文反而 0.79× 变慢)、KV 缓存存储一点没省——但相对 DSA 的改进是真实且可复现的,开源模型 LongCat-Flash-Lite-Sparse 让任何人都能验证。
参考资料
- LongCat Sparse Attention: Taming the Lightning via Streaming-aware Hierarchical Cross-Layer Indexing(arXiv 论文页)
- LSA 论文 arXiv HTML 版(本文配图 Figure 1/2/3/4/5 与附录案例图来源)
- meituan-longcat/LongCat-2.0 开源仓库(GitHub)
- LongCat-2.0 模型主页(Hugging Face)
- DeepSeek-V3.2-Exp 技术报告(DSA 架构与两阶段训练细节)
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention(NSA 论文)
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse(并发工作)
- DeepWiki:LongCat-2.0 仓库的 LSA 技术文档
- TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention(跨层显著性稳定性相关工作)
- Efficient Streaming Language Models with Attention Sinks(StreamingLLM,SI 机制的上游工作)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


