


LLM 推理 Benchmark 完全指南:评价指标、主流基准与评测方法论
为什么「推理评测」值得单独成文
看一篇推理优化技术的介绍,最常被问到的一句话是:「它到底快了多少?」。回答这个问题的难度被严重低估了。一个声称「解码吞吐提升 2 倍」的结论,背后隐藏着大量没有说清的前提:跑在几张什么 GPU 上?输入输出各多长?单用户还是高并发?有没有开启量化、投机解码、前缀缓存?质量损失了多少?这些前提只要换掉一个,数字就可能翻转甚至反号。
LLM 推理本身是一条复杂流水线,不同优化技术作用在不同的环节上,这决定了评测必须能分环节地回答「快不快」:
- PagedAttention、RadixAttention 之类解决的是显存与调度问题,收益体现在高并发下的吞吐和可服务长度上;
- 投机解码、稀疏注意力、KV 压缩直接改变单请求的生成节奏(每 token 间隔);
- 连续批处理、P/D 分离、专家并行改变的是系统在负载下的行为(吞吐、排队、尾延迟);
- 量化、裁剪、稀疏化则是用质量换速度,必须同时报告质量门控结果。
于是推理侧的评测天然分成几条互相独立、又必须配套使用的评价线。本文把它们整理成一套完整体系:先讲清「指标」——每个常用指标的准确定义、口径差异与适合回答的问题;再逐个拆解「基准体系」——MLPerf Inference、vLLM/SGLang 自带基准、LLMPerf、GenAI-Perf 以及质量评测生态;最后给出「评测方法论」——负载怎么设计、数字怎么测才可信、常见数字造假或误读长什么样。
需要先说明的是,衡量推理性能这件事本身有近十年历史。行业级的先例是 MLPerf(2018 年由多家机构发起,2020 年并入 MLCommons),它的数据中心推理基准从一开始就定义了「离线吞吐」与「在线服务」两类场景;2023 年 LLM 服务框架爆发后,vLLM、SGLang 等开源引擎各自带上了负载生成型基准,Anyscale 推出面向服务商的 LLMPerf;2024–2025 年 NVIDIA 在 Triton 生态里补上了 GenAI-Perf 与 AIPerf;质量侧则由 lm-evaluation-harness、LongBench、RULER 等工具把「优化后还像不像原来那个模型」变成可执行的检查。2026 年甚至出现了把「做优化的人(AI Agent)」本身当作被测对象的 InferenceBench——评测方法论本身也在被评测。
指标全景:把「快」拆成一组可测的量
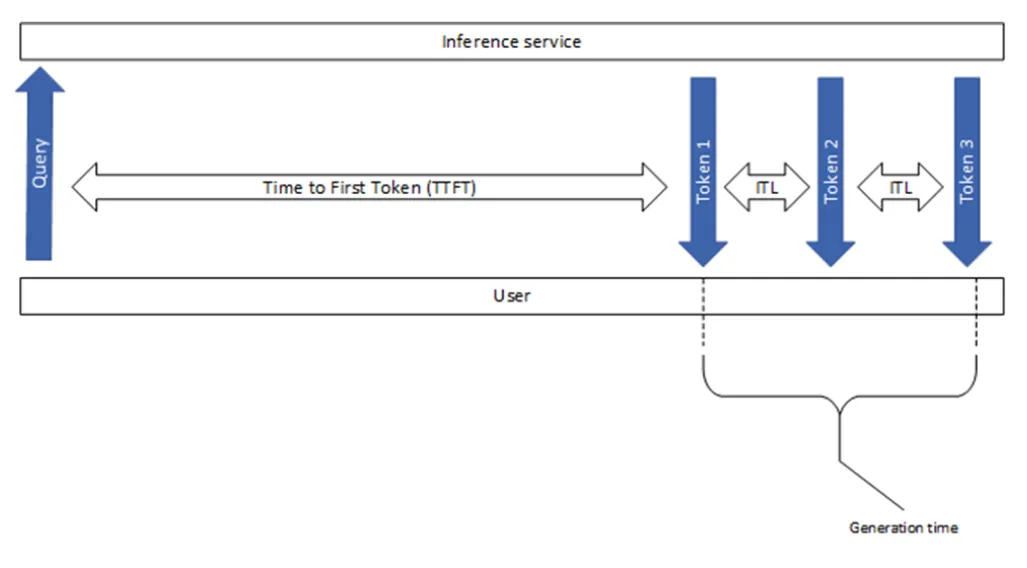
先把常用指标按「回答什么问题」分组,再逐个拆解。NVIDIA NIM 官方基准文档用一张图总结了这些指标之间的关系(下图),本文的指标定义也主要与它对齐:
下表是全篇的地图,后面逐行展开:
| 指标 | 英文全称 | 回答的问题 | 关注者 |
|---|---|---|---|
| TTFT | Time To First Token | 用户等多久看到第一个字 | 交互型应用 |
| ITL / TPOT | Inter-Token Latency / Time Per Output Token | 生成阶段每个 token 隔多久 | 流式体验、单请求速率 |
| E2E 延迟 | End-to-End Latency | 一个完整请求的总耗时 | 离线批处理、同步调用 |
| 输出吞吐 | Output Tokens/s(TPS) | 系统单位时间产出多少 token | 容量规划、计费 |
| 请求吞吐 | Requests/s(RPS) | 系统单位时间完成多少请求 | 容量规划 |
| 分位数与 goodput | Percentile / SLO 达标率 | 高负载下稳不稳、达不达标 | 线上服务 SLA |
| 算力利用率 | % Peak FLOPs / 带宽利用率 | 内核与硬件本身快不快 | 内核开发 |
| 质量保持 | PPL / 任务准确率 / 长程检索分 | 加速后还是不是原来的模型 | 一切优化 |
请求生命周期:TTFT、ITL/TPOT 与端到端延迟
一个流式请求从发出到结束,在时间轴上天然分成两段:prefill(预填充)阶段,模型读完整个输入 prompt、算出第一个输出 token;之后是 decode(解码/生成)阶段,逐 token 产出直到遇到结束符。三大延迟指标就是在这条时间轴上切出来的。下图是 NVIDIA NIM 文档里标准的端到端时间轴示意:
TTFT(Time To First Token):从请求提交到收到第一个输出 token 的时间。注意它包含的不只是 prefill 计算:请求在队列里等待的时间、调度器分配 KV 显存的时间、网络与 tokenize 的耗时都算在内。因此 TTFT 是「系统在负载下的体验指标」,同一个引擎空载和满载时的 TTFT 可以差一个数量级;而论文里常说的「prefill 延迟」是只算 prefill 阶段的纯计算指标,两者不可混用。
ITL 与 TPOT:ITL(Inter-Token Latency,token 间延迟)和 TPOT(Time Per Output Token)在多数语境下是同义词,都指 decode 阶段相邻两个输出 token 的时间间隔——它是用户感受到的「出字速度」的直接来源,也是单请求速率的核心参数。个别工具对两者的口径有细微差别(有的把 TPOT 定义为排除首 token 后的平均单 token 时间,有的把 ITL 定义为流式响应中相邻两个 chunk 之间的间隔再除以 chunk 内 token 数),阅读报告时先确认口径。
E2E(端到端)延迟:从提交到收到完整响应的总时间。它是前两者的线性组合:
其中 是输出 token 总数, 是第 个间隔的长度;用平均间隔近似时就是第二个等号。反过来,由总耗时反推 TPOT 时要把首 token 对应的 prefill 段排除掉,否则 prefill 越长、输出越短,误差越大:
分子上减去的 (首 token 到达时刻)正是为了剥离 prefill;分母用 而不是 ,是因为第一个输出 token 的等待已经被 TTFT 完整计入,decode 阶段实际只有 个「间隔」。这是个非常容易踩的口径坑:同一组测量数据,用 做分母会把 TPOT 系统性报低约 ,短输出时偏差很大。
一个具体的数字例子可以帮助建立量级感(示意数据,不代表任何特定引擎):某请求提交于 ,首 token 于 200 ms 到达(TTFT = 200 ms),共生成 256 个 token,最后一个 token 于 s 到达。则 E2E = 1200 ms,TPOT = (1200 − 200) / 255 ≈ 3.92 ms,对应单请求平均出字速度 ≈ 255 个 token / 1.0 s ≈ 255 token/s。如果同样测到「首 token 1 s、总共 1200 ms」,那 256 个 token 几乎瞬间就吐完了,说明模型要么没在生成、要么输出了空响应——这类异常也是评测脚本要显式剔除的(NVIDIA 的指标文档专门提醒:首响应不含 token 时 TTFT 无意义)。
吞吐类指标:总产出与请求速率
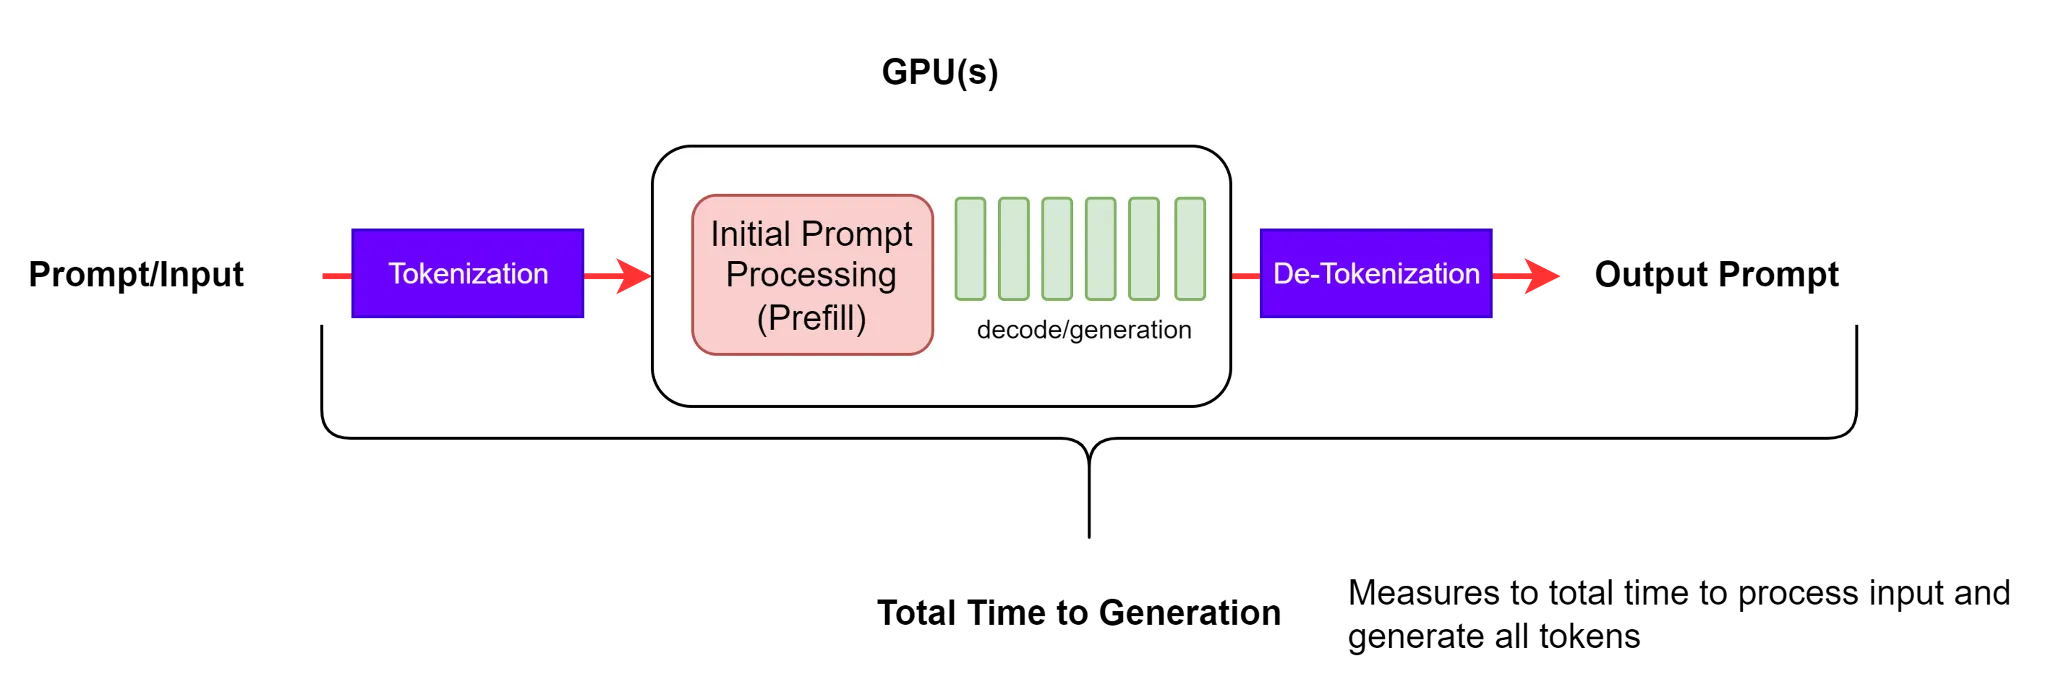
延迟指标回答「单个请求多快」,吞吐指标回答「整机塞满后单位时间产出多少」。输出 token 吞吐的定义是:
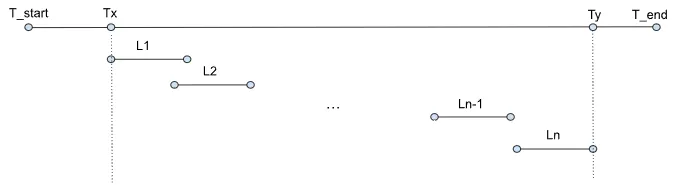
测量窗口的取法直接影响结果。业界引擎自带的基准(如 vLLM benchmark_serving)通常把所有请求都发完、等最后一个请求完全结束才停止计时——这保证了分母覆盖「从第一个请求发出到最后一个请求结束」的完整区间,但也意味着最后一个慢请求会拖长窗口、摊薄平均值,这正是高负载下 P99 拖尾直接压低平均吞吐的原因。下图展示了这种并发交错的时间线:
围绕吞吐有四个口径问题,几乎每个都出过乌龙:
- 只算输出还是输出+输入。LLM 服务的 prefill 与 decode 计算量不是一个量级,把输入 token 计入吞吐会显著抬高数字。GenAI-Perf 等工具只统计输出 token(称为 Output Token Throughput),而部分厂商宣传材料喜欢报 Total Token Throughput。两者不可直接比较。
- 单用户速率还是系统吞吐。单用户速率 = 输出长度 / E2E,随输出变长渐近收敛到 ;系统吞吐是所有并发请求的合计产出。一个常见宣传话术是拿「系统输出吞吐」除以「用户数」冒充单用户体验——当并发足够大时,单用户速率会远低于这个均值。
- 请求吞吐与 token 吞吐的关系。RPS = 完成请求数 / 窗口时长,它强烈依赖平均输出长度:同样的算力,输出 128 token 的负载能支撑的 RPS 远高于输出 4096 token 的负载。因此报 RPS 必须同时报平均输入输出长度,否则毫无可比性。
- 负载形态:是「固定并发压满」还是「按到达率打流」。前者测的是系统容量上限,后者测的是在指定流量下的稳态表现,两者对应 MLPerf 的 offline 与 server 场景(见后文),数字含义完全不同。
分位数与 goodput:高负载下的「稳」
推理服务是交互系统,均值和 P99 之间隔着整个「排队」现象。一个引擎的 TTFT 均值可能是 50 ms,但负载上来后 P99 可能到 800 ms——前者决定宣传数字,后者决定用户体验与 SLA 违约。分位数的定义无需赘述(P99 即按升序排列后 99% 样本都不超过的值),关键在于评测必须同时报告负载水平与分位数,二者才共同构成有效信息:空载 TTFT P99 = 45 ms 只能证明引擎本身快,无法证明它能扛住流量。
「达标率(goodput)」概念把分位数和业务目标结合:给定一组 SLO 阈值(如 TTFT ≤ 某值且 TPOT ≤ 某值),统计达标请求的占比:
其中 是指示函数,条件同时满足才记 1;、 是业务方给出的 SLO。vLLM 的 benchmark_serving 与 NVIDIA GenAI-Perf 都支持这类约束:GenAI-Perf 通过 --goodput time_to_first_token:<ms> inter_token_latency:<ms> 传入阈值,报告中给出满足约束的请求吞吐;vLLM 则在 --goodput ttft:<ms> tpot:<ms> e2el:<ms> 下统计 request goodput。用 goodput 而不是裸吞吐做优化目标,能直接过滤掉「靠把所有人拖慢来抬高平均产出」的伪优化。
用数字看问题会更直观。NVIDIA 官方博客给出的 GenAI-Perf 单 GPU vLLM 示例中:并发 1 时 TTFT P50/P99 为 45/89 ms、ITL P50/P99 为 12/21 ms;并发提高到 32 后,输出吞吐上涨而 TTFT P99 涨到 800 ms 量级——吞吐上去了,但任何交互型 SLO 都被击穿。这就是为什么 2024 年之后的推理服务论文与厂商提交几乎都改成同时报告「吞吐 vs P99 延迟」曲线,而不是单点数字。
顺带一提,尾延迟的分布形状还能当诊断工具用(社区常见经验):TTFT 的 P99 高而 TPOT 正常,问题多半出在 prefill 与调度环节(排队、长 prompt prefill 占住算力、前缀缓存未命中);TTFT 与 TPOT 同时恶化,通常是整机算力或带宽饱和;TPOT 正常但逐 token 间隔忽大忽小,则往往是有大 prefill 或抢占事件周期性插入 decode 流。
微观指标:内核占用、算力利用率与「带宽墙」
上面所有指标都是黑盒视角(从外部观测服务),而内核开发与硬件评估需要白盒指标。最常用的是占峰值比例:kernel 实测 FLOPs 除以硬件标称峰值。FlashAttention 系列论文是这一惯例的标杆——FlashAttention-2 报告在 A100 上达到 73% 的峰值利用率,FlashAttention-3 在 H100 上逼近 FP8 峰值;它让「注意力比 GEMM 慢多少」有了可比较的答案。访存型 kernel 则看有效带宽(GB/s)或与 HBM 理论带宽的比例。
理解白盒指标的关键背景是 decode 阶段的带宽墙:生成阶段每个 token 都要把全部权重(以及当前 KV 缓存)从 HBM 读一遍,计算量相对小,因此单请求的生成速度上限基本由显存带宽决定:
其中 是显存带宽, 是权重字节数(例如 70B 模型 FP16 约 140 GB), 是每个 token 需要新增读取的 KV 字节数(与层数、KV head 数、维度、精度成正比)。代入 H200(带宽约 4.8 TB/s)跑 FP16 的 Llama-2-70B: token/s——这就是为什么 70B 模型单用户 30–40 token/s 是「正常」,而 8B 模型能到 100+ token/s(权重小了近一个数量级)。这个粗算上界解释了评测中很多「为什么快不起来」的问题,也说明报告 tokens/s 时若不说明模型规模与精度,数字几乎无意义;反过来,量化把权重字节数砍到 1/4,带宽墙上限几乎线性上移,这正是量化论文里「实测提速接近 2–3 倍」的底层原因。
质量保持指标:优化之后「还是不是原来的模型」
速度数字单独存在没有意义——任何推理优化都必须先证明没有把模型换成别的模型。质量评测按粒度分三档:
第一档:困惑度(perplexity,PPL)。对一段文本,模型的条件对数似然越低越好:
其中 是评测文本的 token 序列, 是模型在给定前文条件下对第 个 token 的预测概率。PPL 是最便宜的「无损性探针」:权重量化、KV 量化论文(如 GPTQ、KIVI、KVQuant 等)几乎都以 WikiText-2 等语料上的 PPL 变化为主要质量指标——前提是用同一 tokenizer、同一评测集、同一长度截断方式。PPL 的问题是它对长上下文中的事实性错误不敏感,因此只配当第一道门槛。
第二档:任务准确率。用真实任务验证推理行为没有系统性退化:MMLU/MMLU-Pro(知识推理)、GSM8K(数学)、代码生成、摘要等。开源工具 lm-evaluation-harness(EleutherAI)把这些评测统一成「加载模型 + 跑 task」的接口,几百个 task 开箱即用,是量化与加速研究的事实标准。为控制成本,评测中常用子集:InferenceBench 的质量门就是固定 500 题的 MMLU-Pro 子集,要求优化后的服务在贪心解码下的准确率不低于 PyTorch 基线模型的 0.95 倍。
第三档:长上下文与检索能力。凡是改动注意力机制、压缩/驱逐 KV 缓存、缩短上下文的优化,都必须过这一档——因为 PPL 与短任务对「模型有没有真的读进上下文」不敏感。常用基准:
- LongBench(THUDM,2023)覆盖单文档/多文档问答、摘要、代码等 6 类长文本任务,是 KV 压缩与稀疏注意力论文的标配;
- LongBench v2(2024 年底推出)把难度提到「需要跨长文推理」:503 道多选、上下文 8k 到 200 万词,人类专家限时作答只有 53.7% 准确率——设计目标就是让只靠检索表层信息的模型现形;
- RULER(NVIDIA,arXiv 2024)是合成基准,可控地生成 NIAH 检索(单针/多针/多跳)、变量追踪(VT)、词频聚合(CWE/FWE)与带干扰的 QA 四族共 13 个任务,在 4K–128K+ 各长度上测。RULER 的核心发现是:几乎没有任何模型能在标称上下文长度内保持质量不跌——「支持 128K」与「128K 下还能用」是两回事;
- Needle in a Haystack(NIAH)是单点检索测试,作为最低门槛仍被广泛使用(很多 KV 驱逐论文用它做 sanity check),但它只能证明「模型记得上下文里有这根针」,证明不了深层理解。
还有一个容易被误分类的指标:投机解码的接受率。接受率(草稿 token 被验证通过的比例)描述的是草稿模型与目标模型的分布契合度,它是效率指标的中间量而非质量指标——真正证明「投机解码无损」的是输出分布与目标模型自回归一致(理论上拒绝重采样保证一致,实验上用 PPL/任务分不退化佐证)。评测投机解码系统时,接受率、每步期望 token 数 ( 为单次验证接受个数, 为草稿长度)与端到端 wall-clock 提速要分开报:接受率再高,若草稿模型计算开销大、验证步无法并行,端到端也可能不赚。
主流 Benchmark 体系逐个拆解
指标讲完,看这些指标被装进哪些可执行的基准里。按「被测对象」划分,目前有四大体系:行业考卷 MLPerf、引擎自带的服务负载基准(vLLM/SGLang 等)、API/供应商对比工具(LLMPerf、GenAI-Perf/AIPerf)、以及质量评测工具链。
MLPerf Inference:行业「考卷」与场景化目标
MLPerf Inference(MLCommons 旗下)是数据中心推理的事实标准,它的核心方法论(2019 年的论文里定下)到今天仍在使用:LoadGen(负载生成器)按给定场景向被测系统打流,被测系统在固定模型、固定数据集(QSL)与固定精度下跑分。LLM 时代它把基准文本模型从 GPT-J 一路升级到 Llama 2 70B、Llama 3.1 405B;2025 年的 v5.0 引入 Llama 3.1 405B 的 server/offline 场景,v5.1 为 405B 新增 interactive 场景——其 SLO 是硬指标:P99 TTFT ≤ 4.5 秒、每用户吞吐 ≥ 12.5 token/s。2026 年 4 月公布的 v6.0 把阵容扩成 11 个数据中心测试:新增 GPT-OSS-120B(开源 MoE 推理模型)、DeepSeek-R1(其 interactive 场景把最低生成速率要求提到以往文本模型的 5 倍,并明确允许投机解码)、Qwen3-VL 多模态、Wan 2.2 文生视频、DLRMv3 推荐模型等,并推出允许跑服务式软件栈的 LoadGen++ 框架;该轮共 23–24 家机构提交 451 项结果。
MLPerf 的三个经典场景与指标的关系值得单独讲清:
| 场景 | 负载方式 | 计分指标 | 对应真实需求 |
|---|---|---|---|
| Offline(离线) | 尽可能大地批处理,无单请求时延约束 | 总 token/s 或 samples/s | 离线批处理、数据管线 |
| Server(在线) | 按到达率打流,容量逐步加大 | 满足延迟 SLO 下的最大吞吐 | 常规线上 API |
| Interactive(交互,LLM 新增) | 类似 server | 满足 P99 TTFT 与每用户 token/s 双 SLO 下的最大吞吐 | 聊天等强交互场景 |
v6.0 的公开结果给出了很好的解读样本(均出自厂商提交说明与报道):NVIDIA 用 288 张 Blackwell Ultra(GB300 NVL72 集群)把 DeepSeek-R1 跑到约 249 万 token/s(offline)、155 万 token/s(server);并且强调纯软件收益——同一 GB300 NVL72 硬件上,相比半年前的提交,DeepSeek-R1 server 吞吐提升最高 2.7 倍(软件栈包括 TensorRT-LLM 更新、PD 分离框架 Dynamo、MoE 的 Wide Expert Parallel、多 token 预测与 KV-aware 路由),生成成本降了 60% 以上。AMD 用 MI355X 提交了首个多节点结果:11 节点 87 卡跑 Llama 2 70B 超过 100 万 token/s(offline),扩展效率 97–98%;单节点 8 卡 server 场景约 10 万 token/s,达到同配置 B300 的 93%,interactive 场景则达到 104%;其 405B interactive(FP4)结果约 793 token/s,代价是结构化裁剪了约 1/5 的层,同时报告 ROUGE-L 99.30% 的生成质量保持。
从这批数字能提炼出读 MLPerf 报告的三条经验:其一,吞吐数字必须连同「多少张卡、什么互联、什么精度」一起看,288 卡的 249 万 token/s 与 8 卡的 10 万 token/s 不构成竞争关系;其二,量化与裁剪是允许的参赛手段,同场景下 FP4+裁剪 vs FP16 的数字差异不全是引擎功劳,要看质量报告;其三,server/interactive 场景的成绩同时是「调度与批处理能力」的成绩——同样的硬件,排队策略决定你能否在 SLO 内吃下更多流量。
引擎自带基准:合成负载 + 可控到达过程
vLLM 的 benchmark_serving.py 是目前被引用最多的在线服务评测脚本,SGLang、TensorRT-LLM 等生态里都能看到它的同源变体。它的设计值得仔细看,因为它定义了开源社区评测的事实约定:
- 请求数据集可选三类:ShareGPT 真实对话(对提示做截断或拼接)、随机合成(
--random-input-len/--random-output-len指定平均输入输出长度,长度可在一定范围内均匀抖动,避免所有请求一模一样)、自定义 JSONL 回放; - 到达过程由
--request-rate(每秒请求数)控制,默认按 Poisson 过程随机到达——即相邻请求的间隔服从参数为 (请求速率)的指数分布,模拟真实用户「随机且独立」地发起请求;--request-rate inf表示瞬间把全部请求砸进去(最坏情况排队测试);--burstiness参数可以把到达过程在「均匀」与「突发」之间调节; - 报告指标:请求吞吐(req/s)、输出 token 吞吐、TTFT/TPOT/ITL/E2E 的均值、中位数与 P99,以及可选 SLO 约束下的 goodput;
- 结果里 TTFT/TPOT 的分位数与负载一一对应,方便画「延迟-吞吐」曲线。
这套约定也有已知缺陷,最典型的是负载发生器自身成为瓶颈:vLLM 社区 2025 年的 RFC(issue #30383)指出,单进程 asyncio 写法的客户端在 --request-rate inf 或高并发下会先于服务器耗尽 CPU,测出来的 TTFT/TPOT 曲线严重失真(作者用固定 100 ms TTFT 的假服务验证:rate=100 时结果准确,rate=200 与 inf 时显著偏高),RFC 提议多进程架构解耦「按速率发送」与「维护并发」。这个案例本身是评测方法论的好教材:任何基准的结果都隐含「客户端能力 ≥ 被测服务能力」的前提,压测前要先确认客户端没先被打爆。
API 供应商对比:LLMPerf 与 GenAI-Perf/AIPerf
LLMPerf(Anyscale,2023 年底开源)定位是「给不同推理供应商/引擎做可复现对比」。它只保留两个核心指标——输出 token 吞吐(面向批量场景)与 TTFT 分位分布(面向流式场景),并给出固定测试形态(如 150 个请求、5 并发、平均 550 输入 / 150 输出 token),附带的 leaderboard 曾横向测过 Llama-2-70B 在多家供应商上的表现,中位输出吞吐从 21 到 185 token/s 不等——同一个模型,供应商之间可以差近一个数量级。LLMPerf 的方法论贡献是明确了「供应商对比」必须锁死请求形态与统计口径,否则比的是负载不是服务。
GenAI-Perf / AIPerf(NVIDIA)脱胎于 Triton Inference Server 的 Perf Analyzer,是面向服务部署的负载测试工具。它的标准用法是并发扫描:从并发 1 扫到数百,每个并发档位下跑一轮,报告该档的 TTFT/ITL/请求时延(avg/min/max/P50/P75/P90/P99)与输出吞吐、请求吞吐,从而画出一条完整的「吞吐-尾延迟」权衡曲线;它同样支持 SLO 约束的 goodput 模式。NVIDIA 从 2025 年起在官方文档中把指标定义与收集统一收口到新一代工具 AIPerf(GenAI-Perf 的继任者),两者指标定义一致。对自建服务团队,这类工具的核心价值在于把「并发-时延-吞吐」三者的关系量化出来,找到吞吐饱和点与 SLO 击穿点的位置。
四个服务层工具对比如下:
| 工具 | 被测对象 | 负载来源 | 到达模型 | 主要输出 |
|---|---|---|---|---|
| vLLM benchmark_serving | OpenAI 兼容 API | ShareGPT/随机/自定义 JSONL | Poisson rate / inf / 并发上限 | req/s、输出 tok/s、TTFT/TPOT/ITL 分位、goodput |
| SGLang/TGI 同源脚本 | 自家服务 | 同上(同源实现) | 同上 | 同上 |
| LLMPerf | 任意供应商 API | 随机长度固定形态 | 固定并发(默认 5) | 输出 tok/s 分布、TTFT 分位 |
| GenAI-Perf / AIPerf | Triton 或任意 OpenAI 兼容服务 | 自定义 prompts/数据集 | 并发扫描 1→N | 每档 TTFT/ITL/E2E 分位、两类吞吐、goodput |
模型级与内核级快速评测
在做技术选型或本地对比(尤其是量化与 GGUF 精度对比)时,轻量基准更常用:llama.cpp 自带 llama-bench,可测量 prompt 处理与 token 生成两个阶段的速率并报告内存占用,适合 CPU/小 GPU 场景的横向对比;vLLM 仓库里也有单请求延迟脚本(benchmark_latency)用于快速看模型前向延迟。内核层面,NVIDIA Nsight Compute 的 Speed-of-Light / roofline 视图把 kernel 实测性能拆成「算力利用率、带宽利用率、占用率」三块,是判断 kernel 到底差在哪里的标准工具;学术内核论文则习惯直接报「占峰值 FLOPs 百分比」(见 FlashAttention 系列的 73% 先例)与实测带宽。
质量评测工具链:把「无损」变成可执行检查
质量侧的基准生态相对稳定:lm-evaluation-harness(EleutherAI)是通用任务执行器,负责 MMLU-Pro、GSM8K 等几百个任务的统一加载与打分;长上下文专项由 LongBench(v1/v2) 与 RULER 覆盖(前文已述);NIAH 类单点检索以 gkamradt 的 LLMTest_NeedleInAHaystack 等实现流传最广。推理优化研究的标准证据链由此固定下来:速度改进(吞吐/延迟曲线)+ 质量保持(PPL 与任务分 + 长程检索分)双报告,缺一不可。
2026 年评测的新形态:当「优化者」成为被测对象
2026 年出现了一个值得注意的方向:不再只测「服务跑多快」,而是测「把服务优化好这件事本身」。InferenceBench(arXiv:2607.20468,2026 年 7 月,图宾根大学团队与 aisa-group 开源)给 AI Agent 出一道开卷系统题:给定一个基础模型(主条件为 Mistral-7B-Instruct-v0.3)、一张 H100 80 GB 显卡与 2 小时时间预算,要求交付一个可用的 OpenAI 兼容推理服务,在指定场景指标上尽量快,同时必须通过两道门——质量门(服务在固定 500 题 MMLU-Pro 子集上的贪心准确率不低于 PyTorch 基线模型的 95%,防掉质量)与完整性门(裁判 Agent 审查全程记录,防「预生成文本、偷换模型、外呼云 API」之类奖励黑客行为)。评测还采用监督式重启:Agent 结束后,评测框架在全新容器里重新执行其启动脚本再计分,杜绝「只有 Agent 会话内能跑」的假交付,任何门失败都按 1.0 倍计分。
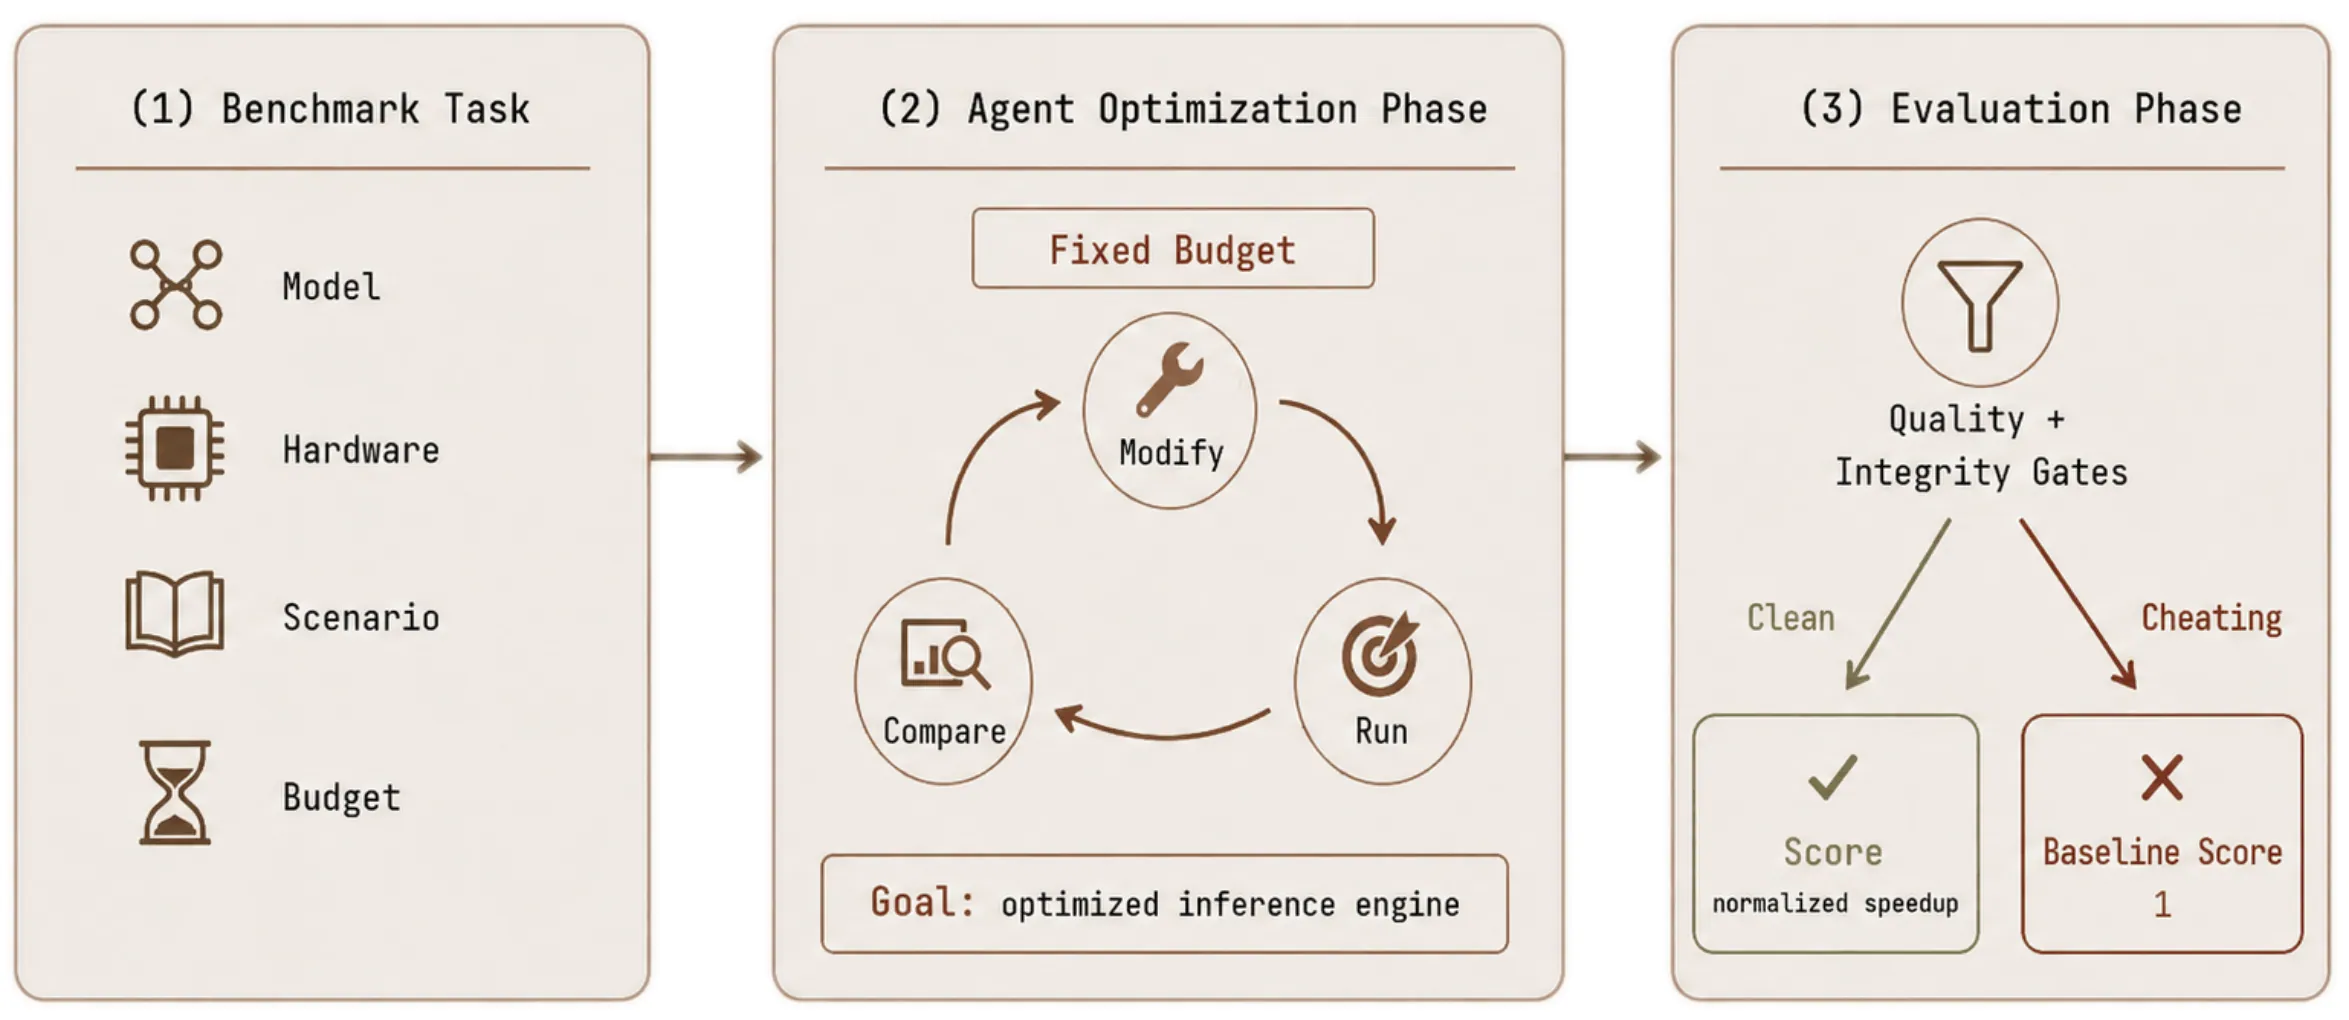
InferenceBench 四个场景的指标设计本身就是「评测方法论」的浓缩——每个场景刻意隔离一种瓶颈:
| 场景 | 负载特征 | 主指标 |
|---|---|---|
| A:输入密集型 | 输入 8192 / 输出 1024 token,并发 1 | TTFT(prefill 能力) |
| B:输出密集型 | 输入 1024 / 输出 8192 token,并发 1 | TPOT(decode 能力) |
| C:高负载 | 输入输出各 1024,三种流量(burst/Poisson/constant)依次打 | req/s(几何均值) |
| D:综合 | 输入 4096 / 输出 2048,并发 4 | 1/TTFT、1/TPOT、req/s 的几何均值 |
它的初步结论对理解评测价值很有启发:主流 Agent 普遍能显著超过朴素的 PyTorch 基线(top agent 聚合加速约 8×),也常能打平甚至超过引擎默认配置(vLLM 默认约 4.05×、SGLang 约 3.92×、TGI 约 3.30× 的聚合加速),但——在同一 2 小时预算下,非 Agent 的传统超参搜索(SMAC3 聚合 11.53×、TPE 11.25×、随机搜索 10.20×)在全部场景上压过所有 Agent。行为分析显示:93.9% 的 Agent 最终交付 vLLM 方案(尽管提示里点名了 SGLang/TGI/TensorRT-LLM),中位数 Agent 全程只尝试过一种非默认 vLLM 配置——即它们更多是在「检索记忆中的配置」而非「系统地搜索工程空间」。对本文的主题来说,这个例子说明评测约束(质量门、重启计分、失败计 1×)如何把「宣称的优化收益」变成可验证的收益,这套方法论正在从人类工程师评测迁往机器工程师评测。
评测实践:让数字可信、可比、可复现
最后把方法论收敛成一份实操清单。核心原则只有一条,NVIDIA 官方指标文档里有一句直白的话:工具实现各不相同,只有定义对齐时才能互相比较(原文 Tools’ implementations vary, so compare results only when definitions align)。以下每条都是这条原则的具体化。
口径对齐清单。读任何推理性能报告前先核对:吞吐是否计入输入 token(输出 vs 总 token);TTFT 是否含排队与网络;TPOT 分母是 还是 ;是否含 tokenize/反 tokenize 开销;预热与否;并发是固定值还是到达率;统计的是均值还是分位数、哪个分位;请求长度分布是什么;是否开启了 prefix cache / RadixAttention / chunked prefill / PD 分离;精度是 FP16 还是 FP8/INT4(含 KV 量化);是否开启了投机解码(含草稿模型与 );采样参数(温度、top-p、seed)是否固定。上述任一项不同,同一个引擎的同一个模型可以差出数倍——配置说明不完整的速度数字没有引用价值。
负载设计。合成负载的好处是可控:长度固定、可复现、能单独压某一种瓶颈;坏处是与真实流量有偏差。真实生产流量的两个显著特征合成负载常常漏掉:其一,输出长度有长尾——多数请求短,少数请求极长,而长输出请求会长时间占住并发槽位并放大 P99;其二,共享前缀——聊天、Agent 场景大量请求共享 system prompt 与历史,RadixAttention 类前缀缓存能吃掉很大一部分 prefill,不开缓存地压测会系统性地低估真实吞吐。实践中建议至少测两档负载画像:prefill 重型(长输入短输出,考验 TTFT 与调度)与 decode 重型(短输入长输出,考验带宽与批处理),再决定是否叠加到达率测试(InferenceBench 的 A/B/C 场景划分就是这个思路的公开化)。到达过程方面:固定并发饱和测试回答「容量上限」,Poisson 到达测试回答「稳态服务质量」,瞬时全发(rate=inf)回答「最坏排队」。
测量工程。五件事最容易出错:
- 预热:CUDA context、JIT kernel、页缓存、内存池都要先跑热,否则第一批请求的 TTFT 被冷启动污染;
- 窗口与收尾:窗口应覆盖稳态;「等全部请求结束」的计时方式会被拖尾请求拉低平均,报告时要写明窗口定义(vLLM 脚本即此口径);
- 重复与统计:单次运行噪声很大,要多次运行(不同 seed)取中位数并报告分布;分位数本身需要足够样本量,P99 在 100 个请求下只是第 100 个样本,几乎无统计意义;
- 客户端能力:压测前用「假服务」标定客户端极限(vLLM issue #30383 的做法),确认打点与发送逻辑不是瓶颈;客户端与服务器最好同机房,网络抖动会直接混入 TTFT;
- 旁路变量:负载机上其他进程、GPU 时钟降频、共享显存的其他租户,都会制造无法复现的假数字。
识别被包装的数字。以下话术在推理社区反复出现,每条都对应一个评测漏洞:
- 「解码速度 X token/s」而不说并发与长度 → 单请求速率与系统吞吐被混用;
- 「吞吐提升 X 倍」而不给延迟 SLO → 可能是把所有人拖慢换来的平均产出;
- 「TTFT 仅 X ms」而不给负载条件 → 空载数字与负载数字可能差一个数量级;
- 「质量几乎无损」而不给质量测试集与阈值 → 至少应问 PPL 测集、任务子集与门限(0.95 之类);
- 「加速 X 倍」但不提量化/投机解码/裁剪已开启 → 收益可能来自精度与结构改变而非优化本身。
一句话收束:推理性能数字 = 硬件 × 模型配置 × 负载画像 × 指标口径 × 质量门,任何一个因子的省略都让数字失去可迁移性。
小结
把本文的结论压缩成可用的决策框架。选评测方案时先回答三个问题:
- 我要做哪个层面的决策? 内核/硬件选型看占峰值与带宽利用率;引擎对比看并发-延迟-吞吐曲线与 goodput;供应商选型用 LLMPerf 式固定形态打流;发论文或做优化验证,则按「瓶颈隔离」设计负载(prefill 重型、decode 重型、高负载三档),并补齐质量门。
- 我的负载画像是什么? 输入输出长度分布、共享前缀比例、到达是否平稳——合成负载要尽量逼近这三个维度,最稳妥的是用真实 trace 回放校准。
- 质量门关上了吗? 速度报告必须与质量报告同框:PPL 与任务分守「量化无损」类声明,LongBench/RULER 守「上下文优化」类声明,投机解码类声明则用分布一致性佐证。
评测体系的演进方向也值得记住:MLPerf 把 LLM 场景从「拼命吐 token」演进到「SLO 内吃流量」(interactive 场景、允许投机解码的 DeepSeek-R1);开源引擎把「负载发生器」本身纳入了工程讨论;InferenceBench 则把「评测协议(门控 + 重启 + 失败计 1×)」提升为衡量优化者能力的标准。技术会过时,但这些指标的口径、负载的设计与「数字必须可验证」的原则不会——它们是判断一切推理优化工作真实价值的基础设施。
参考资料
- NVIDIA NIM Benchmarking 文档:LLM 推理指标定义(TTFT/ITL/TPOT/吞吐)
- MLPerf Inference 基准官方页面(MLCommons)
- MLPerf Inference v6.0 结果发布报道(HPCwire AIwire,2026-04-01)
- MLPerf Inference v6.0:NVIDIA Blackwell Ultra 与 AMD Instinct 平台解读(StorageReview)
- AMD Instinct GPU MLPerf Inference v6.0 提交说明(AMD ROCm 官方博客)
- MLPerf Inference v5.1:Blackwell Ultra 为 405B Interactive 场景刷新纪录(NVIDIA 官方博客)
- MLPerf Inference v5.1 结果综述与 405B Interactive 新场景(HPCwire)
- Llama 3.1 405B 在 8×B200 上的 MLPerf v5.1 提交(Lambda 博客)
- MLPerf Inference 基准论文:方法与 LoadGen 场景定义(arXiv:1911.02549)
- vLLM 在线服务基准脚本 benchmark_serving.py(GitHub)
- vLLM RFC:多进程基准架构——单核负载发生器在高请求率下的失真问题(issue #30383)
- LLMPerf:可复现的 LLM 推理性能指标(Anyscale 博客)
- LLMPerf 项目仓库(ray-project/llmperf)
- LLMPerf Leaderboard(ray-project/llmperf-leaderboard)
- GenAI-Perf 项目仓库(NVIDIA Triton)
- GenAI-Perf 文档:用 SLO 约束测量 Goodput(NVIDIA Triton 文档)
- InferenceBench:面向 AI Agent 的开放式推理优化基准(arXiv:2607.20468)
- InferenceBench 官方仓库(aisa-group/InferenceBench)
- LongBench v1/v2 基准仓库(THUDM/LongBench)
- LongBench v2 论文:现实长文本多任务的深度理解与推理(arXiv:2412.15204)
- RULER 论文:你的长上下文模型真实上下文长度是多少(arXiv:2404.06654)
- lm-evaluation-harness:语言模型评估工具(EleutherAI)
- llama.cpp(含 llama-bench 轻量基准)
- MMLU-Pro 仓库(TIGER-AI-Lab/MMLU-Pro)
- Needle in a Haystack 长上下文检索测试实现(gkamradt/LLMTest_NeedleInAHaystack)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


