


H2O 完全拆解:抓住 KV Cache 里的「重击者」,20% 预算无损生成(NeurIPS 2023)
背景:解码阶段的 KV Cache 内存墙
自回归 LLM 的推理分为两个阶段:prefill 阶段一次性读入用户输入(prompt),算出每个 token 的 Key/Value 向量并存入 KV Cache;decoding 阶段每步只生成一个新 token,新的 query 需要和全部历史 token 的 Key 做内积、对全部历史 Value 做加权求和,然后把自己新算出的 Key/Value 追加进缓存。因此 KV Cache 的规模随序列长度和 batch 大小线性增长,与模型参数本身无关——参数是固定的,缓存却每生成一个 token 就变大一点。
在 MHA(多头注意力,multi-head attention)架构下,每层每个头的 K、V 各占一份,KV Cache 的总字节数是:
其中 是层数, 是注意力头数, 是每个头的维度( 恰好等于隐藏维 ), 是序列长度, 是 batch 大小,FP16 下每个元素 2 字节。把系数乘进去就能感受到问题的量级:H2O 论文给出的例子是,一个 30B 参数的模型(OPT-30B 有 48 层、隐藏维 7168),输入 batch 128、序列长度 1024 时,KV Cache 高达 180GB——超过了当时一整张 A100 80GB 的显存两倍还多,而且这还没算模型权重本身。对话越长、并行处理的请求越多,这个数字就越失控。
为什么 KV Cache 内存这么要命?因为解码阶段是带宽瓶颈:每生成一个 token,都要把所有历史 KV 从头读一遍做注意力计算。缓存越大,每步要搬进 GPU 计算单元的字节越多,生成越慢。所以 KV Cache 问题同时是容量问题和带宽问题——省内存的方案若能减少每步实际读取的 KV 量,通常也会直接变成生成加速。
针对这个问题,站内此前拆解过的技术大致分两类。一类管内存怎么分配:PagedAttention 用操作系统式的分页与块表消灭内部碎片(详见 PagedAttention 完全拆解),RadixAttention 让共享前缀只算一次(详见 RadixAttention 完全拆解)。另一类管KV 用什么精度存:KIVI 对 K 按通道、V 按 token 做 2-bit 量化(详见 KIVI 完全拆解)。而本文要讲的 H2O 属于第三条路线:根本不存那么多 token——既然 KV Cache 随序列长度线性膨胀,能不能在缓存满了之后把不重要的历史 token 直接驱逐掉,让缓存规模封顶?
这条「驱逐」路线在今天已经是 KV Cache 研究的公共地基,而它的起点就是 2023 年发表的这篇经典论文。H2O(Heavy-Hitter Oracle,重击者预言),2023 年 6 月由来自 UT Austin、Stanford、CMU、Meta AI 等多机构的团队发布在 arXiv,发表于 NeurIPS 2023。它的核心发现一句话就能概括:注意力分数被少数「重击者」token 主导,驱逐时保住这些 token 和最近的 token,KV Cache 压到 20% 也能保持几乎无损的生成质量。
已有方案为什么不行
在 H2O 之前,想给 KV Cache「减肥」的尝试不少,但各有各的死穴。论文把它们归成三类。
第一类是训练期的稀疏注意力:Reformer 用局部敏感哈希(LSH)把注意力限制在近似最近邻的块里,Performer 用随机特征近似注意力核,Sparse Transformer 用固定的 strided/局部窗口模式。问题在于,这些方案的设计目标是消除注意力矩阵 的计算开销,注意力稀疏了,但 KV Cache 本身并没有变少多少;更重要的是它们的稀疏模式是训练时就定死的,直接套在预训练好的稠密模型上做生成,miss rate(该读到的 token 没被保留)非常高,质量立刻崩掉——H2O 论文图 1 的上半部分用示意注意力图展示了这一点:静态模式(strided、局部窗口)和实际注意力分布完全不匹配。
第二类是学习式的 KV 压缩:比如 gisting tokens 训练模型把一段文档的 KV 压缩成少数几个特殊的「摘要 token」。这类方法要微调模型,驱逐机制本身也很重,部署时成本高。
第三类是把 KV Cache 当成传统 CPU cache 来管理:缓存满了就按 LRU(最近最少使用)或 LFU(最不常使用)驱逐。这类直觉很自然,但 LLM 生成的场景和普通程序访存有一个本质区别——普通 cache 逐错了顶多多一次主存访问,KV Cache 逐错了 token 就永远回不来了,而且自回归是串行依赖的:第 步的输出取决于前 步的输出,一步驱逐错了关键信息,后面每一步都在错误的基础上继续错,误差沿序列方向自我放大。这正是论文强调的:经典缓存理论里 Belady 算法(提前知道未来访问序列时逐出最远才会用到的页)对普通 cache 是最优的,但对 KV Cache 不适用——KV Cache 里一个 token 未来的「被访问序列」取决于模型自己接下来生成什么,生成的内容又取决于缓存里剩什么,这是个闭环。
一个理想的 KV Cache 需要同时满足三个条件:缓存容量小(省显存)、miss rate 低(保质量)、驱逐策略开销低(不拖慢每步解码)。而难点也有三个:首先不确定缓存能否真的限制规模——原则上每一步都可能需要任意旧 token 的 Key/Value;其次最优驱逐策略是个组合搜索问题(该保留哪 个 token?);最后即使能暴力搜出最优解,也没法在线实时执行。论文图 1 把这道难题画成了示意图:
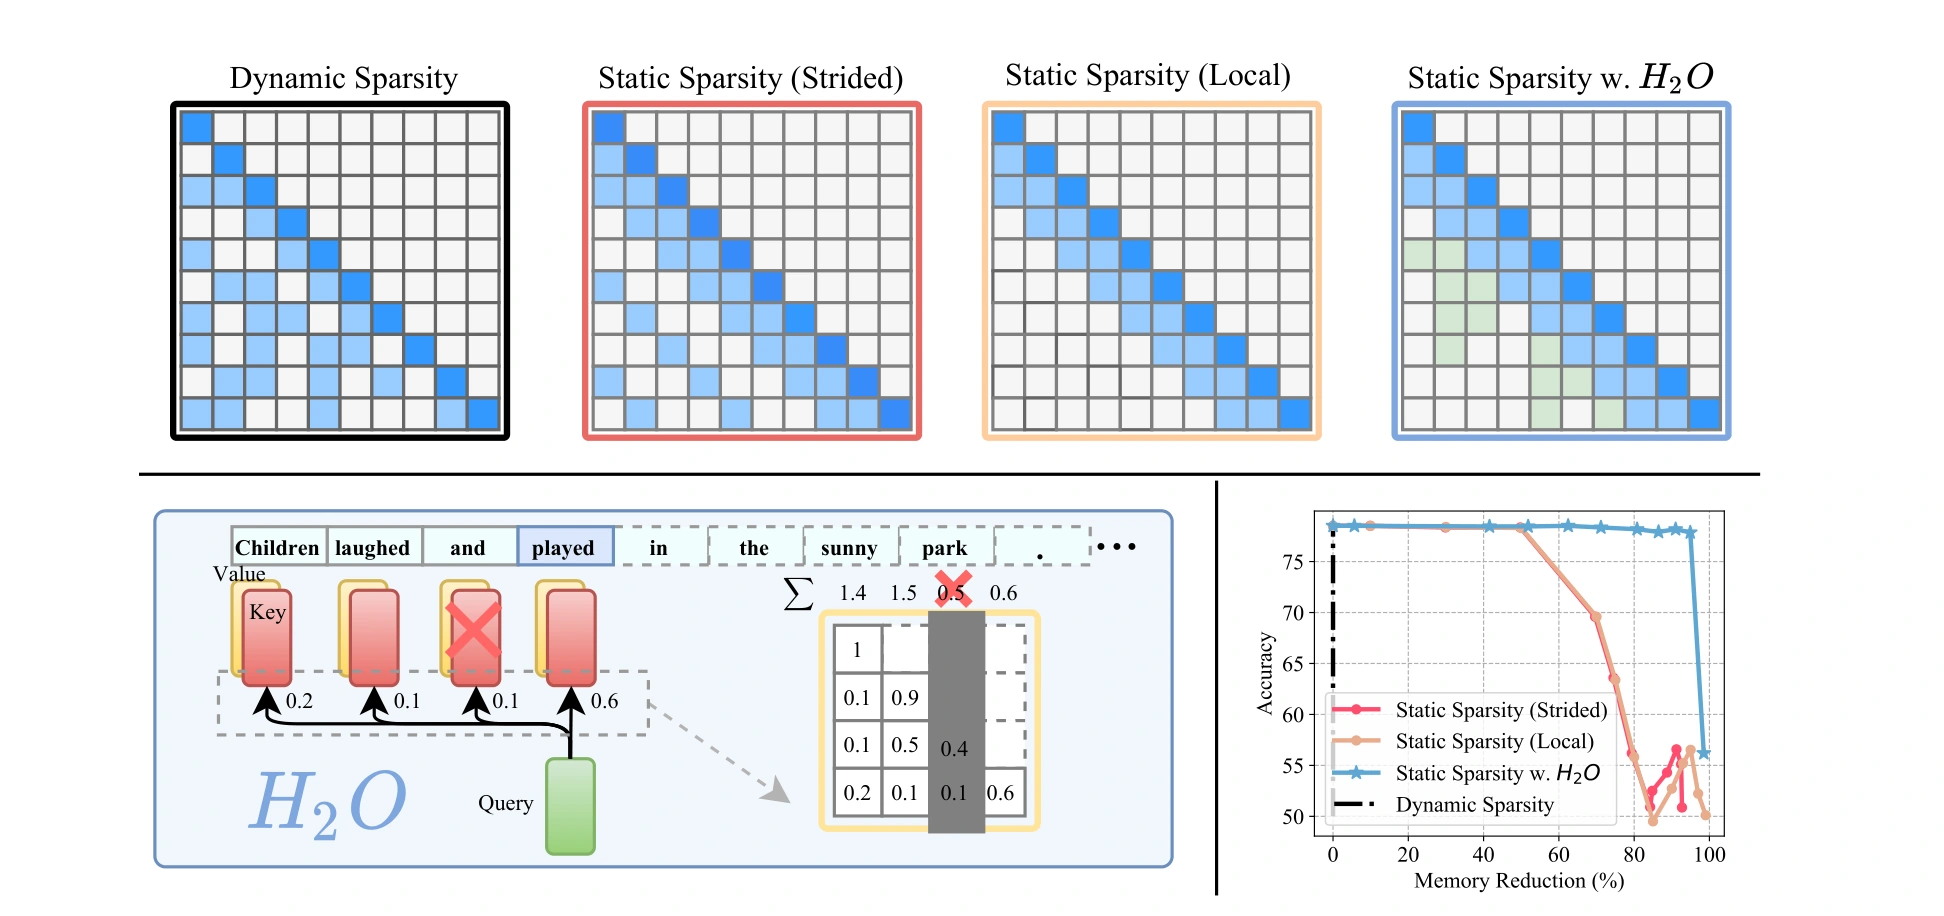
H2O 的破局思路分为两步:先通过经验观察确认「注意力到底需要哪些 token」(下一节),再据此设计一个低开销的在线驱逐策略(下下节)。
两个核心观察:稀疏性 + 幂律
H2O 的整个方法建立在两个经验观察上,这是论文最值得读的部分——它没有先设计算法,而是先问「注意力到底长什么样」。
观察一:注意力矩阵 95% 以上是稀疏的
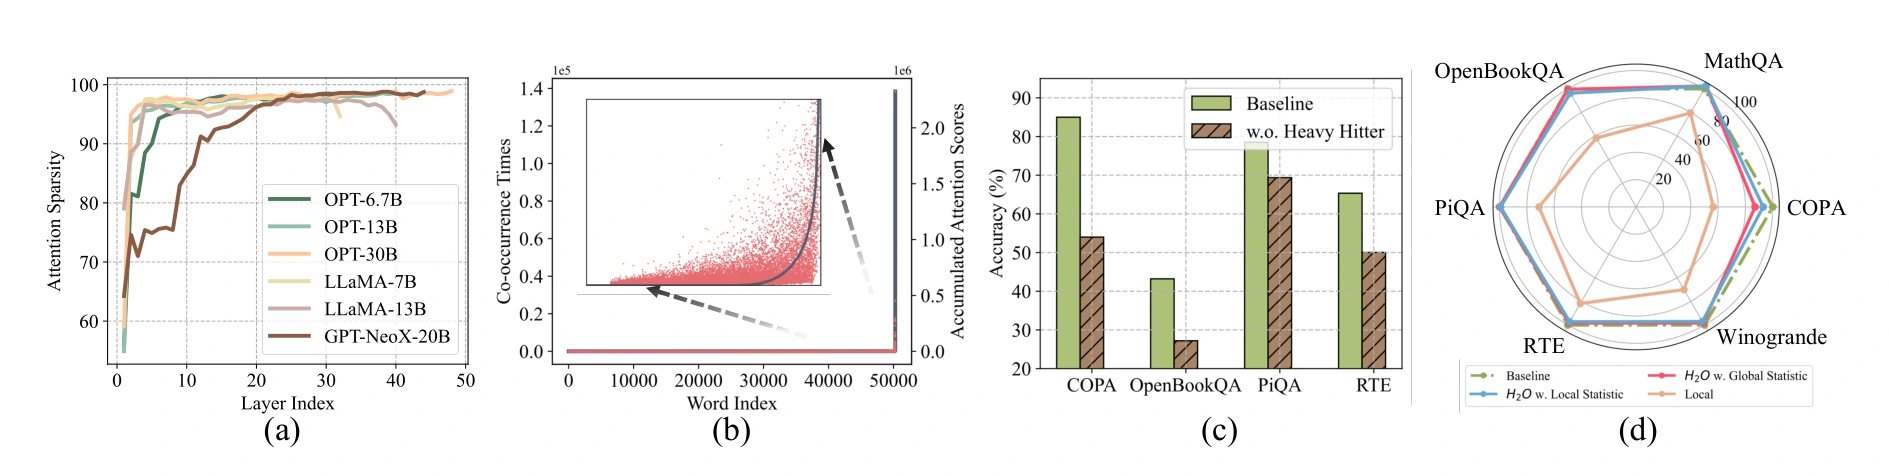
研究者拿预训练的 OPT 系列模型,在 WikiText-103 验证集上做零样本推理,统计每一层的注意力矩阵稀疏度。判定方法:对注意力概率矩阵(softmax 归一化后的 )的每一行,取该行最大值的 1% 作为阈值,低于阈值的元素视为「不重要」。
结果出乎意料:模型虽然是稠密训练的,推理时几乎所有层的注意力矩阵稀疏度都超过 95%。这意味着生成下一个 token 时,真正贡献注意力的历史位置只有不到 5%,每一步实际需要用到的 KV 理论上可以砍到 1/20——这是 H2O 能成立的空间前提。
但稀疏性只是必要条件。注意力稀疏说明「每步只需少数 token」,却没说「该留哪少数 token」——而驱逐一旦选错,代价不是一次 cache miss,而是生成质量的连锁崩溃。95% 的稀疏率对应「任意选 5%」几乎必然灾难。
观察二:累计注意力服从幂律,少数重击者拿走大部分注意力
第二个观察把「该留谁」的问题也回答了。把序列里每个 token 在注意力计算中累计收到的注意力概率(对所有 query 位置求和)画出来,分布是典型的幂律:一小部分 token 吸收了绝大部分注意力质量,其余 token 的得分长尾拖地。论文把这些极少数的关键 token 命名为重击者(Heavy Hitter,简写 ,这也是方法名 H2O 里「H2」的来源——注意不是水分子)。
图 2 的四个面板把这个观察钉死了:
- 面板 (a):各层注意力稀疏度,几乎全部超过 95%,稀疏性在几乎每一层都成立;
- 面板 (b):把累计注意力得分按词表里的词汇总(红色散点),和该词在语料中的共现次数(灰色曲线)叠在一起,两条曲线高度吻合。这说明重击者不是偶然涌现的——文本里频繁共现的词(主题词、高频功能词、反复出现的实体)天然是注意力的汇聚点,谁在语篇里「社交活跃」,谁就拿走最多的注意力。用论文里的话说,重击者的涌现是自然的,且与 token 在文本中的频繁共现强相关;
- 面板 (c):把重击者对应的 token 从注意力中屏蔽掉(保留其余全部 KV),模型在多个下游任务上的准确率断崖式下跌——证明重击者不是「注意力集中的装饰品」,而是模型真正依赖的信息载体;
- 面板 (d):预告了整个方法的可行性——在 20% 的 KV 预算下,用局部统计(只累加已发生步骤的注意力分数)决定驱逐的 H2O,和用全局统计(一个能看到未来所有注意力的 oracle)决定驱逐的 H2O,表现几乎一样好;而只保留最近 token 的 Local 策略大幅落后于全量基线。
面板 (d) 是全文最关键的图之一:它说明「过去被关注得多的 token,未来也大概率继续被关注」——过去的注意力分数是对未来重要性足够好的预测器。为什么?因为重击者的本质是语篇的主题与高频结构,主题在长文本中是缓慢变化的。自回归解码时我们无法预知未来每个 query 会注意谁,但用历史累计注意力做贪心近似,代价小到可以忽略。
H2O 驱逐策略:重击者区 + 最近区
问题形式化
先把「带容量限制的生成过程」说清楚。设注意力 query 矩阵为 ,key 矩阵为 ,第 个 token 生成时,KV Cache 里实际保留的 token 集合记为 ( 表示全部 个位置),预算为 。驱逐策略 满足两条约束:
- :缓存大小不随时间变化;
- ,等价于 :每步至多驱逐一个 token,保证驱逐本身的开销有上限。
生成过程中,第 步的注意力输出是:
其中 是 的第 行(当前 query), 是只取 中那些行的 key 子矩阵, 是归一化常数。被驱逐的 token 相当于 key 置零并从归一化项里剔除——这就是驱逐后注意力自动重新归一化(softmax 分母只对剩余 token 求和)的数学表达。目标:找一个驱逐策略,让受限生成过程的输出尽量接近无限制的原始过程。
贪心驱逐算法
直接找最优的 是组合问题,但有了「重击者」这把尺子就有了贪心方向。定义 token 集合的分数函数为集合内所有 token 的累计注意力得分之和:
其中 是 token 从进入缓存以来累计收到的注意力概率。那么每一步,在「现有缓存 ∪ 新 token」里逐出累计分数最低的那一个,就能让剩余集合的累计分数最大:
伪代码如下(对应论文 Algorithm 1,把注意力概率累加进一个 per-token 分数向量,满员后每步贪心驱逐分数最低者):
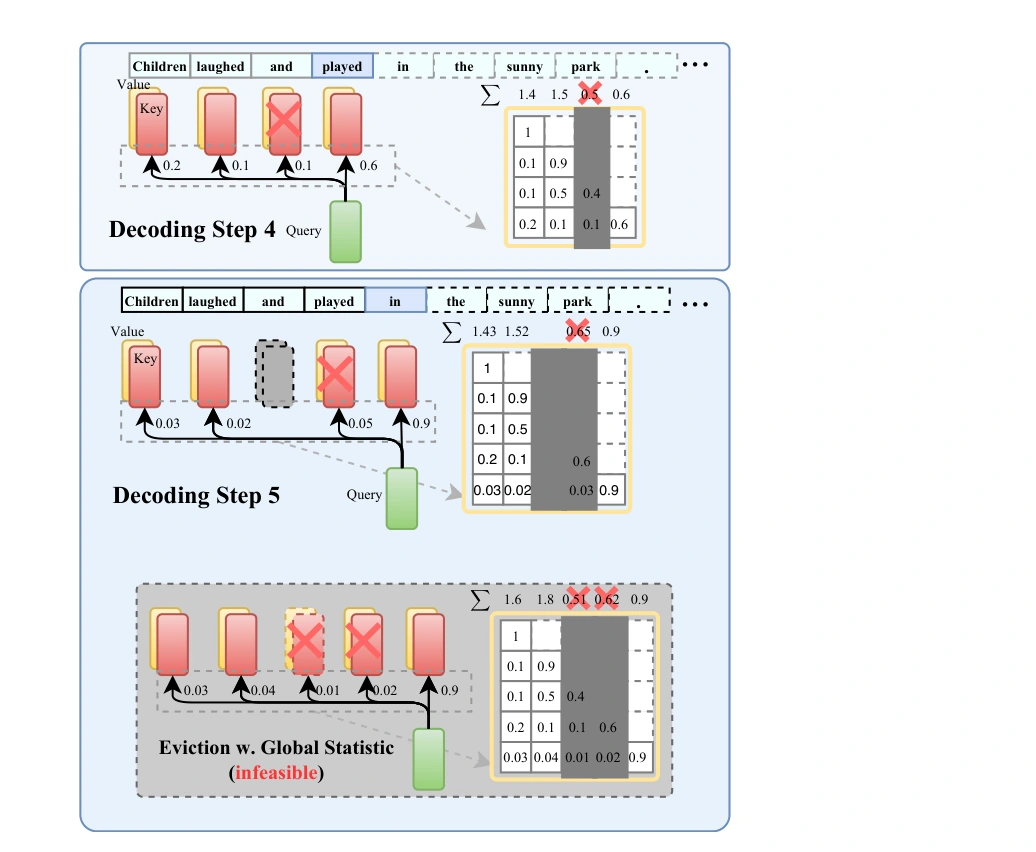
def h2o_generate(Q, K, budget_k): S = [] # 缓存中的 token 集合 acc = {} # token -> 累计注意力分数 for i in range(len(Q)): scores = softmax(Q[i] @ K[S].T) # 当前 query 对缓存内 token 的注意力 for s, a in zip(S, scores): acc[s] += a # 累加进历史总分 S.append(i); acc[i] = 0.0 # 新 token 入缓存 if len(S) > budget_k: u = min(S, key=lambda s: acc[s]) # 驱逐累计注意力最低的 token S.remove(u); del acc[u] return S论文图 3 用一个小例子把驱逐过程画了出来(预算为 3):
为什么是「重击者 + 最近」双缓冲,而不是纯重击者?
论文的驱逐策略实际保留的是两部分各占一半预算:K 个重击者 + K 个最近 token(总预算 2K,通常按 prompt 长度的百分比折算)。论文与多个基线的对比中反复出现一个现象:只保留重击者、或只保留最近 token,都无法维持全量 KV 的质量(掉 2.85% 到 22.75% 不等),两者合体才和全量基线打平。为什么最近区不可或缺?
第一个理由是局部性:语言建模里,紧挨着当前位置的若干 token 与当前生成的关联最强——语法衔接、指代、正在展开的短语都发生在最近窗口内。重击者管「这篇文档在讲什么」(长期主题),最近区管「现在正说到哪」(短期工作记忆),两个尺度缺一不可。
第二个理由更微妙:资历歧视。累计分数是按时间攒出来的,一个刚生成的 token 还没来得及被任何后续 query 注意过,累计分数天然是零;如果驱逐只看累计分,新 token 会在进入缓存的下一秒就被当垃圾逐出,永远活不过「考察期」。给最近 K 个 token 一个固定席位(先进先出滑动窗口),相当于保护期——它们不参与驱逐竞争,等它们滑出最近区、有了足够的被关注历史之后,才有资格作为「重击者候选人」与历史 token 竞争。
这个设计与站内拆解过的 QEvict 如出一辙——QEvict 保留了 5 个 attention sink token 和 32 个 recent token 作为两个「保护区」,只是把窗口换成了层级结构(详见 QEvict 完全拆解)。H2O 是这套「保护区」设计的源头。
为什么要按头独立驱逐?
还有一个常被忽略的实现细节:驱逐是按注意力头独立进行的——每一层里,每个 head 各自维护自己的重击者列表,各自逐出自己的最低分 token。论文在对比 SpAtten(一个用累计注意力选 token 的早期工作)时专门强调了这一点:SpAtten 把注意力分数跨头跨层累加在一起做统一决策,而 H2O 允许每个 token 在每个 head 上独立地被保留或驱逐。
直觉上这很重要:不同注意力头在预训练模型里分化出了不同职能——有的头追踪句法依赖,有的头做指代消解,有的头只对位置敏感。一个 token 对句法头是重击者、对位置头可能毫无意义;如果跨头汇总打分,小众但关键的功能就会被多数头稀释掉。按头驱逐等于给每个「专家」独立的预算,保住的是各个功能维度上的重要 token。官方实现(见下文)里「one heavy hitter will be evicted for each head」说的就是这个机制。
理论的角色:子模函数与贪心近似
H2O 把「限制容量下选最优 token 集」建模成一个动态子模最大化(dynamic submodular maximization)问题,并给出了理论保证。这里把直觉讲清楚,不抄证明。
子模函数(submodular function)刻画的是收益递减:集合越大,新增一个元素的边际收益越小。形式化地说,对任意 和不在 里的新元素 :
直观理解:给一个只有 3 个 token 的集合补充一个新 token,新增的信息量通常大于给一个已有 30 个 token 的集合补同样的 token——新概念可能已经被大集合覆盖过了。文档摘要(coverage)类函数是典型例子。论文论证注意力的「信息覆盖」天然具有这种递减回报性质,因此是一个(近似)子模函数。
子模函数最大化的经典结论是:在基数约束(最多选 个)下,贪心算法——每步选边际收益最大的元素——能达到最优值的 ,这是理论上能保证的最好常数。H2O 的驱逐正是「反向贪心」:保留能使剩余集合分数最大化的 个 token。论文把「每步序列都在变长、都要新加一个 token 再驱逐一个」的版本形式化为 dynamic submodular 框架,给出(非正式的)定理:
即:在温和假设下,贪心得到的缓存集合 能达到最优集合函数值的 倍,再减去一个可容忍的误差项 。这套理论的实际影响力不如两个经验观察大(假设的抽象程度较高,后续工作引用它更多是为了说明「驱逐是子模问题」这一视角),但它给了贪心驱逐一个自洽的解释框架:如果注意力函数确实是子模的,那么每步驱逐「当前最没用」的 token 在理论上就是接近最优的贪心。
实现细节:驱逐在系统里如何落地
FlexGen 改造:预分配 + 原地覆写
论文的高吞吐实现基于 FlexGen(一个可插拔权重/缓存 offloading 的白盒 OPT 推理引擎)。要做的事情其实很小:FlexGen 是 OPT 的显式逐层实现,KV Cache 的读写都经过显式的缓存管理函数,H2O 只在这些函数里做「手术」。
关键工程决策有三个:
- 预分配内存,驱逐不搬数据。 缓存张量一次性分配好,容量固定为「K 个重击者槽位 + K 个最近槽位」。被驱逐的 token 不是从内存里挪走,而是把它占的槽位直接覆写成新 token 的 KV——一个
cache_replace就完成驱逐+插入,避免任何数据搬移,保证驱逐不引入 I/O 开销。 - 最近区用环形队列。 最后 K 个槽位循环使用,新 token 每步写入,最老的最近 token 被顶掉,头尾指针 推进。
- 累计分数向量随注意力计算顺带更新。 注意力概率在每步的 kernel 里本来就要求出来,把它们累加进一个 per-head 的分数向量是几乎免费的额外操作;驱逐决策(找最低分)在分数向量上做线性扫描或维护小顶堆即可。
生成循环本身(权重/激活的预取与计算重叠、offloading 调度)完全不用动。论文给出了实现骨架:attention_forward 在 decode 分支调用 compute_attention(),它会返回新算出的 KV 以及本次要驱逐的槽位索引(evict_ids),store_cache() 拿到 evict_ids 后执行覆写。驱逐策略被封装在 compute_attention 这一个函数里,想换任何别的驱逐策略都只需要改这里——这也是为什么 H2O 的代码可以作为后续各种驱逐研究的实验平台。
两套代码:模拟版与真实丢弃版
官方仓库 FMInference/H2O 提供两套实现:h2o_flexgen(基于 FlexGen,追求端到端吞吐,报告吞吐数字用它)和 h2o_hf(基于 Hugging Face Transformers,跑各种质量基准)。h2o_hf 里又分两种模式:
- 模拟版:不真正丢 KV,而是通过修改 attention mask 把被驱逐 token 的位置屏蔽掉,模拟驱逐的效果。优点是与标准 Transformers 前向完全兼容、实现简单、跑 benchmark 快;
- 真实丢弃版(
utils_real_drop):真正改写 attention 前向,把被驱逐 token 的 KV 从缓存里物理删除。它验证了一个重要事实:模拟版的结果是可信的——驱逐带来的质量变化纯粹来自「注意力看不到这些 token」,而不是什么 mask 伪影。
每步开销分析
驱逐策略本身几乎不增加解码延迟:累计分数的累加复用注意力计算的结果,驱逐选择只在缓存满员后每步淘汰一个最低分 token。内存上,额外只需维护每个(层, 头)一个长度不超过预算的分数向量,和 KV 本身的体量相比可以忽略。算上这点开销,H2O 端到端(含 prefill 与解码、含驱逐决策本身的耗时)依然拿到了论文报告的全部加速比。
效果:20% 预算为什么够用
精度:预算压到 20%,性能追平全量
论文在 OPT(6.7B–66B,并覆盖至更大尺寸)、LLaMA(7B/13B/30B)、GPT-NeoX-20B 三类模型上,用 HELM 与 lm-eval-harness 的八个任务(COPA、MathQA、OpenBookQA、PiQA、RTE、Winogrande、XSUM、CNN/Daily Mail)做评测,缓存预算从 4% 扫到 100%。图 4 汇总了各任务、各模型上的「KV 预算-准确率」曲线:
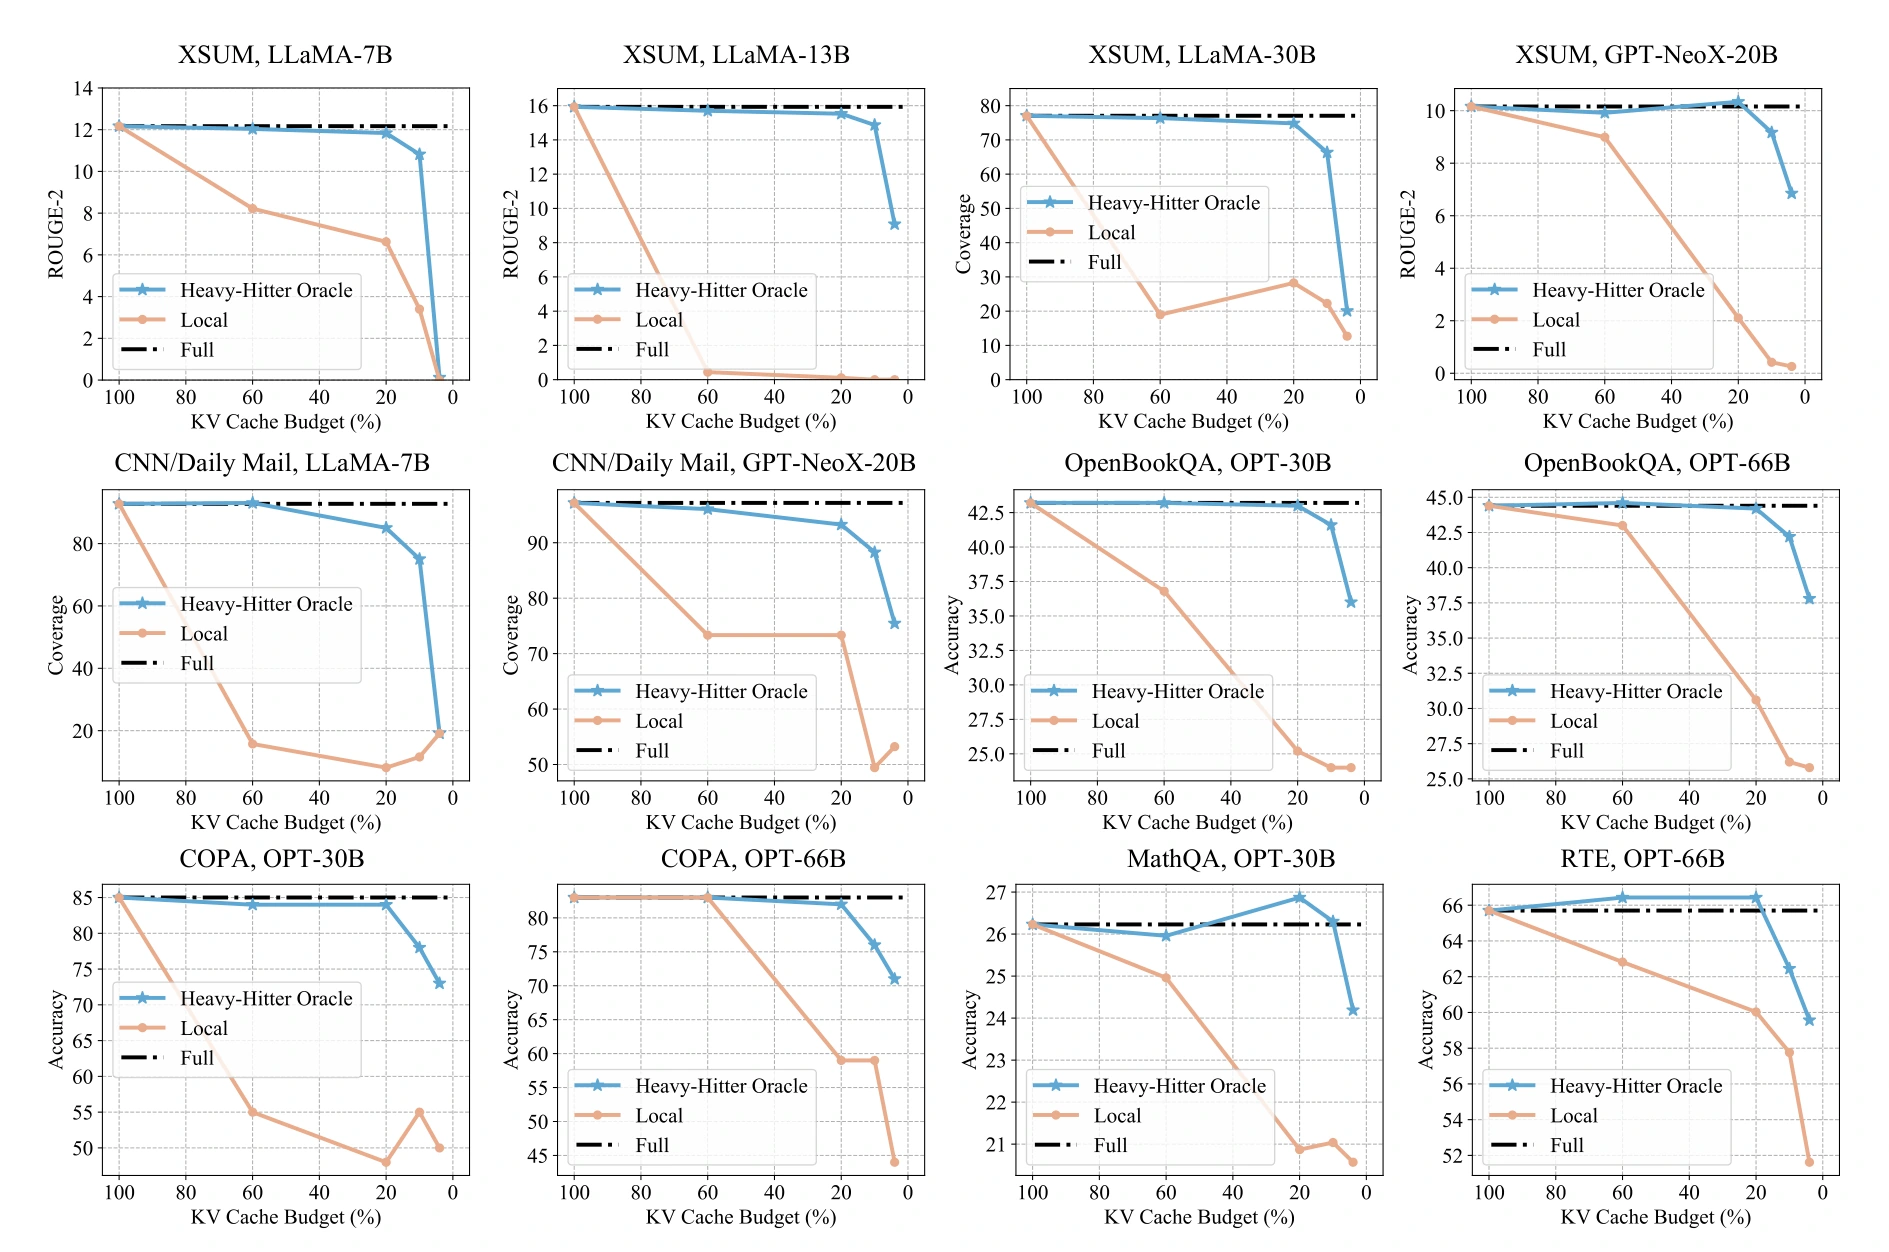
论文特别指出两个「失效点」:在 {LLaMA-13B, XSUM} 和 {LLaMA-7B, CNN/Daily Mail} 两组上,Local 策略在 60% 预算时就崩了,而 H2O 在 20% 预算下依然匹配全量性能——长文本摘要这类强依赖远距离信息的任务最能区分两者。总体看,多数任务上 H2O 与全量基线的差距在 1 个百分点以内,部分任务反超,论文称之为「20% 预算实现 5 倍内存压缩而几乎无损」。
一个反直觉的现象是:有些任务上 H2O 甚至超过全量基线。比如 OPT-66B 的 RTE 高 0.73%、OPT-30B 的 MathQA 高 0.64%、GPT-NeoX-20B 的 XSUM 高 0.18。论文把这种现象解释为驱逐带来的正则化效应——丢掉的冗余 KV 反而滤掉了一些干扰信息。表 1 给出了一组代表性数字(5-shot,20% 预算):
| 方法 | PiQA | COPA | OpenBookQA | Winogrande |
|---|---|---|---|---|
| Full(5-shot) | 80.09 | 81.00 | 44.80 | 71.51 |
| Full(0-shot) | 78.89 | 76.00 | 41.40 | 70.00 |
| Full(1-shot) | 79.11 | 76.00 | 43.60 | 70.24 |
| H2O(20% 预算) | 79.22 | 85.00 | 43.80 | 71.67 |
| Local(20% 预算) | 57.94 | 56.00 | 28.40 | 51.30 |
注意最后一行的 Local 策略:同样是 20% 预算、同样的总 token 数,只因为保留的是「最近的 20%」而不是「重击者+最近」,性能直接崩到接近随机。表里还有一层值得玩味的对照:5-shot 的完整 prompt 很长,而 H2O 用 20% 预算大约只相当于保留 1.2 个样本的上下文——它却稳定胜过用全量 KV 的 0-shot 和 1-shot 模型。这说明被驱逐的主要是 prompt 里的冗余,而重击者机制保住了真正承载任务信息的示范样本。
论文还做了「单独效果」消融(表 9),把预算分别只给重击者、只给最近区、两者各半,用 OPT-13B/30B 在四个任务上对比。以 OPT-30B 的 PiQA 为例:全量 78.51,只留最近区 55.82,只留重击者 67.25,两者合体 78.45——重击者单独贡献远大于最近区,但两者缺一不可(详见上文「双缓冲」一节)。另一组重要实验说明 H2O 的重击者区可以当外挂增强件:把 strided 或 fixed 的 Sparse Transformer 稀疏模式叠加重击者区之后,strided 模式几乎追平全量(表 2 中 COPA 从 50.00 回到 83.00,全量为 85.00),fixed 模式也大幅回升(COPA 从 61.00 回到 76.00);对 Top-K 策略则有最多 2 个百分点的提升(表 8)。注意论文正文说两种模式叠加重击者后「达到与全量相似的表现」,严格看 fixed 模式在部分任务上仍差数个点——表里的数字比正文的表述更诚实。但这不影响核心结论:「保留累计注意力最高的历史 token」是一个与具体稀疏模式正交的通用增强,任何按位置/模式剪枝的方案,只要把省下来的预算部分让给重击者,都能显著止血。
吞吐与延迟:省下的显存换成更大的 batch
精度之外,论文在系统层面报告了吞吐和延迟收益。方法是在 FlexGen 里实现驱逐,与 FlexGen 已有的 offloading、量化正交组合。收益逻辑很直接:KV Cache 从 100% 缩到 20%,省出的显存能换来两样东西——(1) 同一个 GPU 上塞下大得多的 batch;(2) 原本要依赖 CPU offloading 的配置可以完全不用 offload。两样都直接作用于解码吞吐。
T4(16GB)上的合成数据吞吐对比(token/s,括号里是有效 batch 大小与所需的最深 offloading 层级,C 表示 CPU):
| 序列长度 512+512 | OPT-6.7B | OPT-30B |
|---|---|---|
| Hugging Face Accelerate | 15.5 (1, GPU) | 0.6 (8, CPU) |
| DeepSpeed ZeRO-Inference | 9.6 (16, CPU) | 0.6 (4, CPU) |
| FlexGen | 16.8 (1, GPU) | 8.5 (80, CPU) |
| H2O(20% 预算) | 51.7 (4, GPU) | 18.8 (416, CPU) |
OPT-30B 的场景最能说明问题:模型权重加全量 KV 在 16GB 显存上根本放不下,三个基线都被迫深度 offload 到 CPU 内存,吞吐被 PCIe 带宽卡死在 1 token/s 上下;H2O 把 KV 砍到 20% 后,有效 batch 从 DeepSpeed/Accelerate 的 4–8(FlexGen 为 80)提升到 416,吞吐 18.8 token/s——比 DeepSpeed 与 Accelerate 高约 30 倍、比 FlexGen 高约 2.2 倍。论文标题级的结论用的是「最高」口径:相对 DeepSpeed ZeRO-Inference 与 HF Accelerate 最高 29×(出现在 XSUM/OPT-30B 的 offload 场景,6.70 vs 0.23 token/s),相对 FlexGen 最高 3×(出现在 OPT-6.7B 纯 GPU 场景,51.7 vs 16.8 token/s)。OPT-6.7B 纯 GPU 场景同样翻了三倍多:51.7 vs FlexGen 的 16.8,且 H2O 还顶着 4 倍于基线的 batch。XSUM 真实数据上结论一致。
A100(80GB)上的结果更直接,同一张卡、无 offloading,比的是同 batch 下的延迟与大 batch 下的吞吐上限:
| 配置 | 指标 | FlexGen | H2O(20%) |
|---|---|---|---|
| OPT-6.7B,2048+2048,batch 24 | 延迟(秒) | 99.5 | 53.5 |
| OPT-6.7B,2048+2048,batch 24 | 吞吐(token/s) | 494.1 | 918.9 |
| OPT-6.7B,2048+2048,batch 64 | 吞吐(token/s) | OOM | 1161.0 |
| OPT-13B,5000+5000,batch 4 | 延迟(秒) | 214.2 | 155.4 |
| OPT-30B,7000+1024,batch 1 | 延迟(秒) | 57.0 | 50.4 |
同 batch 下延迟降低 1.1–1.9 倍(主要来自每步读取的 KV 变少、访存带宽压力下降),而 FlexGen 在 batch 64 直接 OOM 的配置,H2O 跑到 1161 token/s——相对 FlexGen 最好成绩 494.1 又提高了 2.35 倍。注意这里的模型(OPT)训练序列只有 2K,跑 10K 序列本来就超出设计范围,论文用它演示的是「KV 驱逐让更大 batch 成为可能」的系统学收益,真正面向长上下文的模型收益只会更大。
与量化的组合也有报告:H2O 与 4-bit 权重量化叠加后精度几乎不变(COPA/OpenBookQA/PiQA 上 84.00/43.20/78.80,vs 全量 85.00/43.20/78.51),而量化省下的显存让 OPT-6.7B 的 batch 从 4 提升到 44–70,同配置的吞吐从 35.1–52.1 token/s 涨到 50.5–72.5 token/s。驱逐和量化一个砍 token 数量、一个砍每个字节的位数,天然正交。
流式扩展:四百万 token 与困惑度对比
H2O 论文还做了一个「流式」扩展实验,直接对标后来爆火的 StreamingLLM。StreamingLLM 的核心发现是 attention sink 现象:序列开头的几个 token 会吸收异常高的注意力(软最大值归一化的「溢出阀」),因此保留开头几个 token 加一个滚动窗口,配合位置滚动(position rolling:KV Cache 满了就把位置编码整体平移,而不是把序列截短,避免位置编码失配),就能让模型在任意长的流上持续生成(详见站内 QEvict 完全拆解 对 attention sink 的讨论)。
H2O 的流式版本把「只留开头几个 token + 局部窗口」的保留集换成「重击者区 + 局部窗口」(论文图 9 的标注口径,如 H2O-256-256 表示保留 256 个重击者与 256 个局部 token):开头那些 token 因注意力分数最高而自动占据重击者席位(论文观察到句首 token 不成比例地成为重击者,见下文「句首 token 观察」),除此之外,流里反复出现的重要主题词也会被保留下来。图 5 展示了结果:
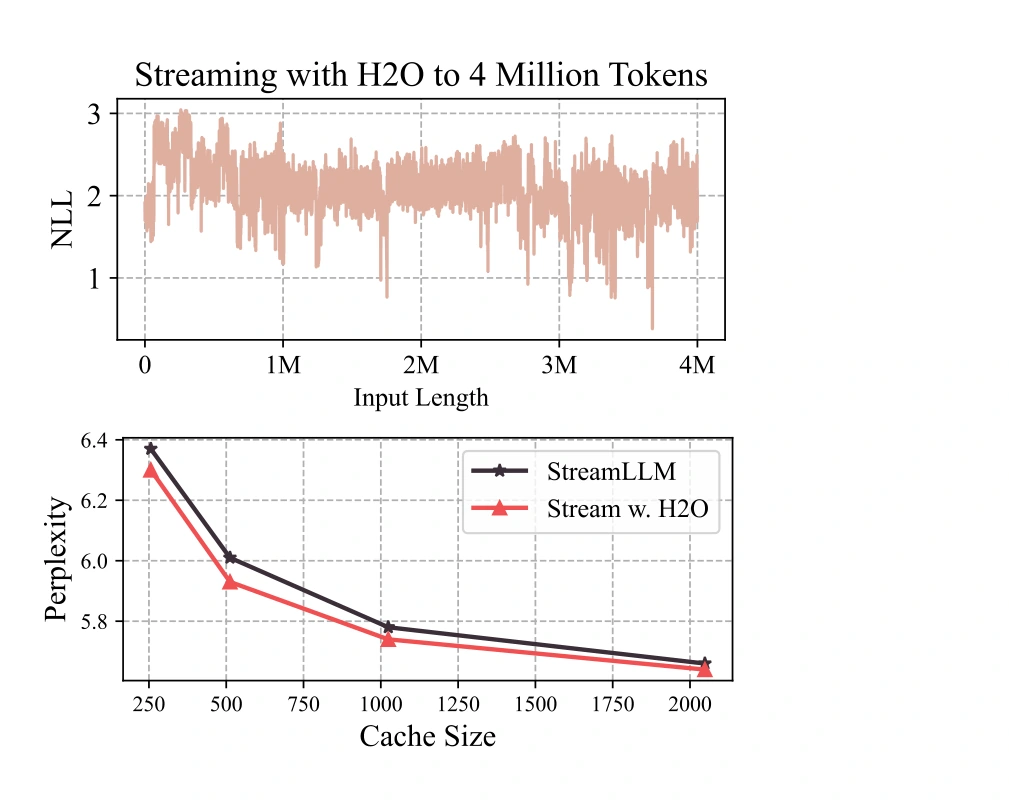
在 PG-19 语料(古登堡计划图书文本)上,H2O 处理到了 400 万 token 的序列长度,且各种缓存预算下的困惑度都低于原版 StreamLLM。原因不难理解:StreamLLM 的保留集是「开头固定几个 + 最近窗口」,中间段无论多重要都留不住;H2O 的保留集是「注意力选出来的重击者 + 最近窗口」,图书这种长文本里反复出现的人物、地点、主题会持续占据重击者席位。论文在附录里用一个多文档问答实验把差距放大:十个文档里只有一个藏着答案,把关键文档的位置在不同测试样本间挪动,StreamLLM/LM-Infinite 这种固定保留策略在关键文档被窗口冲走时直接失效,而 H2O 的表现显著更优(论文附录 C.4 的图 9)——重击者区相当于给流式场景补上了「基于内容的长期记忆」。
这里能看出 H2O 与 StreamingLLM 的哲学分岔:StreamingLLM 断言「开头 token 是注意力汇聚点,保住它们就够了」,H2O 则主张「谁重要由注意力自己说了算,我动态选」。前者简单到不需要任何打分,后者需要一个分数向量。后来的流式与 KV 压缩工作基本都在 H2O 的骨架上做文章:StreamingLLM 把重击者区简化成固定数量的 sink token,站内拆解过的 QEvict 则把 H2O 的单层保护区细化为「sink + recent」的层级结构(详见 QEvict 完全拆解)。
附赠效果:生成文本更多样
一个意外收获:驱逐居然让生成文本变得更多样。论文用 Self-BLEU 度量(越低越多样,即文本内部自我重复越少)量化:LLaMA-7B 在 XSUM 上生成,全量 KV 的模型 Self-BLEU 为 0.0057,H2O 为 0.0051,只留最近区的 Local 策略则高达 0.0436(大量重复)。可视化的例子更直观:同一段提示词下,全量模型会写出「a few years after the events of the first game」这类回环冗余的句子,H2O 则写出「the game is a first-person exploration game」这样的推进性内容;而 Local 策略直接退化成只会重复句号逗号。
这个现象的一种合理解释:驱逐移除了部分「自我复读锚点」——重复文本之所以发生,常是因为模型每一步都能在历史里找到自己刚写的句子并继续模仿;KV 缓存被压缩后,这种自我强化的路径变少,反而逼着模型依赖更本质的内容特征去生成。
局限与反思
H2O 的局限在论文里被如实讨论,也在后续工作中被反复验证,值得单独梳理。
驱逐是不可逆的。 与量化不同(量化只是降精度,信息还在),驱逐是硬删除:被逐 token 的 KV 彻底消失,后续任何一步都不可能再读到它。一旦驱逐判断失误——比如一个重要但还没被注意过的信息(「大海捞针」里的那根针)恰好被冲走——错误无法挽回。QEvict 文章里对比过这一点:在大海捞针类检索任务上,所有驱逐策略的得分都远低于量化策略,因为针的位置对提前打分几乎是不可见的(详见 QEvict 完全拆解)。这也是后来可恢复驱逐(多档缓存、量化+驱逐混合)出现的原因。
打分是「向后看」的。 H2O 用历史累计注意力预测未来重要性,这在主题稳定的文本上成立,但信息检索型任务天然刁难它:答案所在的那一段在提问之前从未被注意过,累计分数接近零,驱逐最先拿它开刀。论文附录的多文档问答实验正是这个病:关键文档处于「无人问津」状态时会被当作最没用的 token 逐出。站内拆解过的 Prefix Sliding 明确把这个差异说成「向后看 vs 向前看」——前缀被无条件保留,即使长时间没被注意(详见 Prefix Sliding 完全拆解)。
累计分数的老 token 偏差。 论文在附录里坦白了一个微妙偏差:累计分数天然偏向「资历老」的 token——它们被 query 注意过的次数更多,累计分更容易高,因此更不容易被逐。研究者试过用平均注意力分数替代累计分来消除这个偏差,结果反而掉点。这个现象与「句首 token 频繁成为重击者」的观察放在一起看很有意思:早期 token 拿到不成比例的注意力并非纯属噪声,句子开头的 token 往往承担着确立主题、设定语境的功能,模型确实在依赖它们——这个观察后来被 StreamingLLM 理论化为 attention sink。也就是说,H2O 在 2023 年 6 月已经站在了 sink 现象的门口,只是没有把它单独提炼成一个机制。
固定预算与任务敏感。 预算比例是超参数:论文主实验用 20%(论文报告在 5-shot 主任务上「小于 20% 预算、即超过 5 倍压缩,仍与全量相当」),但零样本/一样本这类上下文更短、每 token 信息密度更高的任务上,需要 30–40% 的预算才能追平全量。如何自适应地确定预算,论文没有回答。
后续影响
站在 2026 年回看,H2O 的重要性主要不在它自己的数字,而在它确立的范式几乎成了 KV Cache 驱逐研究的公共起点:
- 「用累计注意力分数评估 token 重要性」——QEvict 的窗口级累计打分与 H2O 一脉相承(QEvict),MAC-Attention 对历史注意力的复用、各类 Top-K 选择策略(SnapKV 等)都沿用这把尺子;
- 「重击者区 + 最近区」的双缓冲结构——后来的 StreamingLLM 把重击者区简化成固定 sink,QEvict 把它扩展成 sink+recent 两个保护区,Prefix Sliding 把它替换成任务前缀;
- 「驱逐与量化/offloading 正交组合」的系统观——Q-Hitter 等工作直接继承并发扬了 H2O 与 FlexGen 的组合框架;
- 作为基线的地位——几乎每一篇新的 KV 压缩/驱逐论文(包括站内拆解过的 QEvict、MAC-Attention、KIVI 的对比实验)都会把 H2O 列为必比的基线,其 20% 预算下的质量表现至今仍是衡量「内容自适应驱逐」的标尺。
小结
H2O 的故事可以压缩成一条完整的推理链:观察到注意力矩阵 95% 稀疏(有压缩空间)→ 观察到累计注意力呈幂律分布(知道该留谁)→ 验证过去注意力可以预测未来(在线驱逐可行)→ 设计重击者+最近的双缓冲贪心驱逐(把理论变成算法)→ 用子模最大化框架给出近似保证(给算法一个说法)→ 在 FlexGen 里用预分配内存和原地覆写把它做成系统(把算法变成吞吐)→ 用 OPT/LLaMA/GPT-NeoX 上横跨精度、吞吐、流式、量化的实验验证(把系统变成结论)。
它留下的心智模型至今有用:LLM 的 KV Cache 里,长期记忆(重击者)与短期记忆(最近窗口)是两种不同尺度的信息,前者要用内容自适应的方法动态维护,后者只要一个环形队列。后来的一切驱逐策略,几乎都是在回答同一个问题的不同变体:如何用最低的开销,猜中未来最会被注意的那几个 token。
参考资料
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models(arXiv:2306.14048)
- H2O NeurIPS 2023 会议版 PDF(Advances in Neural Information Processing Systems 36, pp. 34661–34710)
- GitHub: FMInference/H2O(h2o_flexgen 与 h2o_hf 两套官方实现)
- GitHub: FMInference/FlexGen(H2O 高吞吐实现所基于的推理引擎)
- Efficient Streaming Language Models with Attention Sinks(StreamingLLM,arXiv:2309.17453)
- LM-Infinite: Simple On-the-Fly Length Generalization for Large Language Models(arXiv:2308.16137)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


