


面试疑难(三):Docker/Git 实操、MXFP4 与 FP4 精度之谜、KV260 带宽算题与 Tensor Core/脉动阵列之辨
这组问题在问什么
这是「面试疑难」系列的第三篇。前两篇的题面分别落在语言底层、源码阅读(第一篇)和量化方法、手算题、跨硬件编程(第二篇)上,这一篇的四道题又把考察面拉宽了一档,从工程工具链一路跨到数据格式、板级带宽和芯片微架构:
- Docker、Git 的使用方法。
- 你知道 MXFP 等等精度吗?另外现在什么支持 FP4?为什么可以压缩到那么低、精度下降还不明显?
- 对于 KV260 这款板子,板载 DDR 带宽多少、多少位?对 Qwen2.5-0.5B-Instruct,0.5B 参数量按 8 bit 权重量化后,按上述带宽,理论最高 throughput 是多少?
- Tensor Core 和 systolic array(脉动阵列)的区别是什么?如何选择哪一种架构?
这四道题的内在逻辑其实是一条线:先证明你会用工具、能复现工作,再证明你看得懂数据格式的位布局,然后证明你能把硬件参数换算成性能上界,最后证明你能看穿微架构层面的设计取舍。前两问偏”工程基本功”,后两问偏”硬件与系统的定量直觉”。
下面按出场顺序逐题展开。
第一问:Docker、Git 的使用方法
这道题看着最”送分”,实际最容易答砸。原因在于大多数人会把它答成命令列表——docker run 有哪几个参数、git rebase 怎么写。面试官问”使用方法”,真正想确认的是三件事:
- 你知不知道这两个工具各自解决什么问题(而不是背了多少命令);
- 你有没有踩过坑(容器里改了代码没挂载、
git reset --hard手滑); - 你能不能把它们和推理工程的具体场景挂上钩(这是区分”会用”和”用得好”的地方)。
所以答题顺序应该是:先说清定位,再说核心机制,最后落到工程实践。
Git:分布式版本控制,本质是「快照 + 指针」
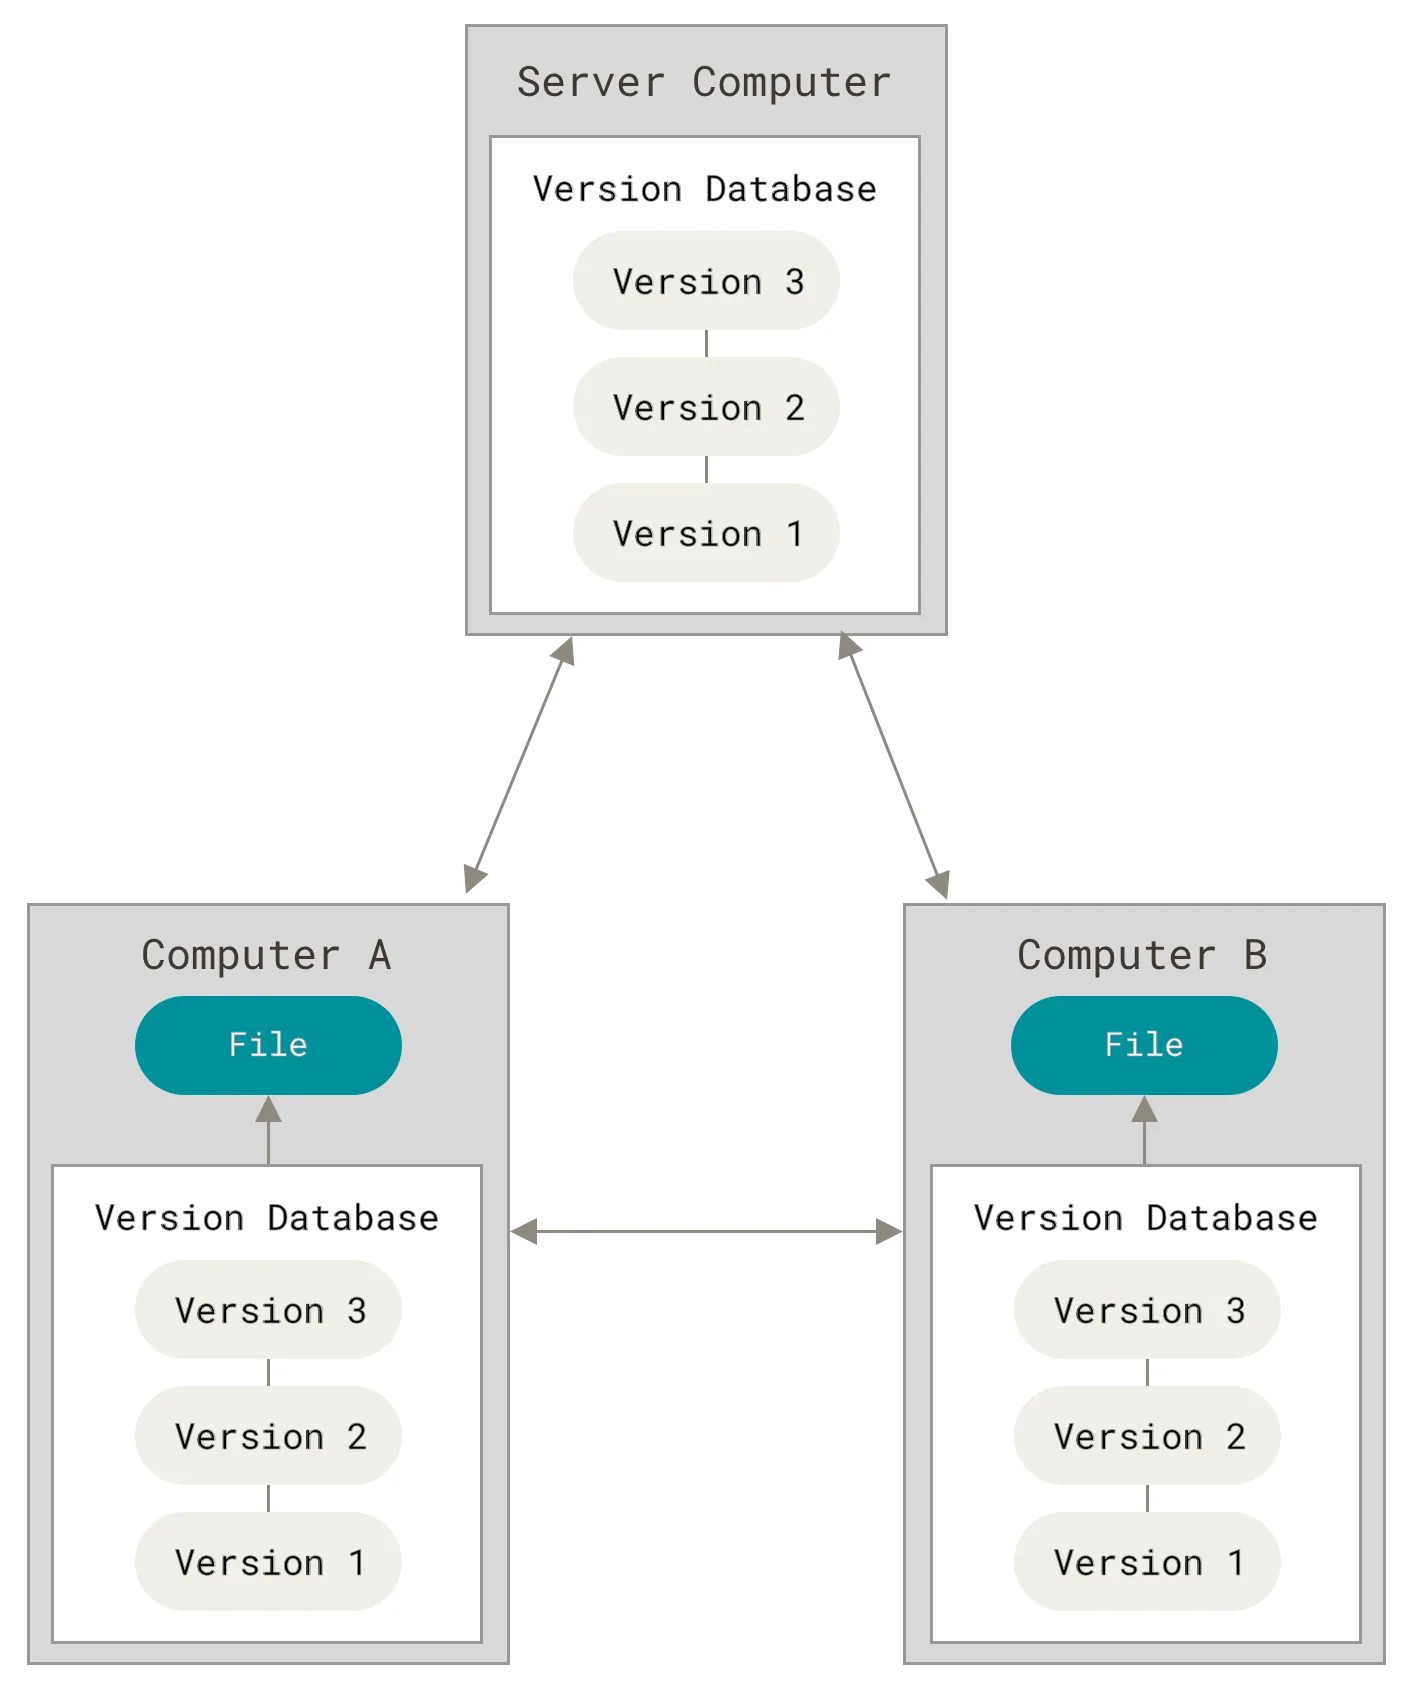
先说定位。Git 是分布式版本控制系统(Distributed Version Control System)。这句话的信息量比看起来大:早期集中式系统(CVS、SVN)只有一份权威历史存在中央服务器上,本地拿到的只是一份工作副本;Git 则是每个克隆都持有完整的仓库历史,服务器只是”另一个对等节点”。离线可以提交、可以看 log、可以切分支,网络只在同步时才需要。下图是《Pro Git》里那张经典的三者对比,直观说明了这一点。
理解 Git 的第一道坎是快照模型。很多人以为 Git 存的是”每次提交的差异(diff)“,其实不是。Git 每次 commit 存的是一棵完整的目录树快照(tree object),指向一批 blob 对象(文件内容)。如果某个文件这次没改,快照里对应的条目就直接复用上一个 commit 指向的同一个 blob,不产生新对象。所以”存差异”是错觉,实际是”内容寻址的对象数据库 + 每版一棵树”,只是底层用 zlib 压缩 + 增量打包(packfile)把空间省回来了。
这个模型直接解释了若干现象:为什么切分支那么快(只是换一个指针)、为什么合并能自动推断(比较两棵树)、为什么 Git 不怕文件重命名(内容相同就是同一个 blob)。
第二道坎是三个区域:
| 区域 | 名字 | 里面是什么 |
|---|---|---|
| 工作区 | working tree | 你正在编辑的文件 |
| 暂存区 | staging area / index | 下一次 commit 打算提交的内容 |
| 本地仓库 | repository(.git/) | 已经提交的对象数据库 |
git add 是”工作区 → 暂存区”,git commit 是”暂存区 → 本地仓库”,git push 是”本地仓库 → 远端”。暂存区的存在是 Git 和”直接存盘式”版本工具最大的体验差异:它允许你把一次改动拆成若干个语义清晰的提交,而不是把所有改动糊成一坨。
第三道坎是分支只是一个指针。main 不是什么特殊目录,只是一个 41 字节的文件,里面存着一个 commit 的 SHA-1 哈希。HEAD 则是指向”当前所在分支”的指针(或直接指向某个 commit,即 detached HEAD)。所以 git branch new-feature 只是新建了一个指针,代价接近零;git checkout new-feature 只是把 HEAD 挪过去并同步工作区。
日常操作按用途分成几组就够了:
# 起步git init # 本地新建仓库git clone <url> # 克隆(默认拿到全量历史)
# 日常提交循环git status # 看三区状态git diff # 工作区 vs 暂存区git diff --staged # 暂存区 vs 最后一次提交git add -p # 交互式挑拣,按 hunk 决定要不要暂存git commit -m "feat: ..." # 提交
# 分支与合并git switch -c feat/x # 新建并切到分支(旧写法 checkout -b)git merge feat/x # 合并进来(会产生 merge commit,除非可快进)git rebase main # 把当前分支的提交"搬"到 main 之上
# 远端git fetch origin # 只拉对象,不动本地分支git pull --rebase origin main # fetch + rebase(比默认 merge 历史干净)git push -u origin feat/x
# 临时存一下git stash / git stash pop三个高频追问:reset / revert / checkout 的区别
这是 Git 部分最容易被追问的点,值得单独讲。
git reset <commit>:移动分支指针,让当前分支指向另一个 commit。它改写历史。--soft:只移动指针,暂存区和工作区都不动。相当于”把后面几个提交的改动重新放回暂存区”,最常用在”提交粒度没分好,想重新组织”。--mixed(默认):移动指针,同时重置暂存区。改动回到工作区。--hard:移动指针,暂存区和工作区全部丢弃。这是唯一会真正吃数据的那个,未提交的改动无法找回。
git revert <commit>:不移动指针,而是新建一个”反向补丁”的提交,把那次改动抵消掉。历史只增不减,所以对已经推送到公共分支的提交,只能用 revert,不能用 reset。git checkout/git restore:只动工作区(和--staged时的暂存区),不移动分支指针。checkout在新版本被拆成了switch(切分支)和restore(恢复文件)两个命令,语义更清晰。
一句话总结:改历史用 reset(本地),改内容用 revert(公共),改文件用 restore。
merge 和 rebase 怎么选
merge 保留两条分支的真实拓扑,产生一个 merge commit;rebase 则是把当前分支上”独有的提交”逐个摘下来,重新应用到目标分支顶端,生成全新的 commit(新的哈希)。
两者结果内容相同,历史形状不同。判断标准只有一条:这条分支有没有别人基于它工作。纯本地分支、推之前整理历史,用 rebase;已经推送、别人可能已经拉取过,用 merge,否则会造成别人本地历史分叉。
对应的还有 cherry-pick(把某个 commit 单独摘到当前分支,常用于把 hotfix 回合到发布分支)和交互式 rebase(git rebase -i,用来 squash 压缩提交、reword 改信息、reorder 调顺序)。注意这个环境里交互式 rebase 不可用,实际工作中它是最常用的”整理提交”工具。
冲突的处理思路是:Git 在冲突文件里写入 <<<<<<< / ======= / >>>>>>> 三段标记,手动编辑成最终想要的内容,git add 标记为已解决,然后 git merge --continue 或 git rebase --continue。如果搞乱了,git merge --abort 或 git rebase --abort 回到起点。
在推理工程里,Git 到底怎么用
这是把答案从”通用知识”抬到”岗位相关”的部分:
- kernel 的版本管理。Triton kernel、CUDA 扩展、TileLang 脚本这类代码对性能极度敏感,一次微小的改动就可能让吞吐掉 10%。把每个性能有意义的版本打上 tag(
v0.3-triton-2sm-43tok),做 benchmark 时把 tag 写进实验记录,才能事后复现”当时 43 tok/s 的那版长什么样”。 - submodule 挂上游依赖。把 CUTLASS、FlashAttention、vLLM 作为 submodule 挂在
third_party/下,锁死 commit,避免上游一个 breaking change 让整条流水线挂掉。 - 二分定位性能回归。
git bisect配上自动化 benchmark 脚本,可以在几十个提交里快速定位”是哪次改动让 TTFT 变差了”。 - 多阶段复现。论文复现、模型结构改动、量化配置改动分别开分支,避免互相污染。
Docker:不是虚拟机,是三样内核机制的组合
第二个工具是 Docker。最需要纠正的误解是:容器不是轻量虚拟机。
虚拟机靠 Hypervisor 虚拟出一整套硬件,客人操作系统(Guest OS)从内核开始就是独立的,所以启动要几十秒、内存要几个 GB。容器则直接跑在宿主内核上,靠三样 Linux 内核机制拼出”隔离感”:
- 命名空间(namespace):负责”看不见”。
PID让容器里的进程以为自己是 1 号进程、看不到宿主进程;NET给容器独立网卡与端口空间;MNT给独立挂载点;UTS给独立主机名;IPC隔离 System V IPC 与 POSIX 消息队列;USER做用户 ID 映射(rootless 容器的基础)。 - 控制组(cgroup):负责”用不超”。限制 CPU 核数/权重(
--cpus)、内存上限(-m)、块设备 IO 带宽。v1 与 v2 的层级结构不同,现代发行版基本都切到 cgroup v2 了。 - 联合文件系统(UnionFS / OverlayFS):负责”镜像分层”。镜像由只读层叠加而成,容器启动时在最上面盖一层可写层,所有修改走写时复制(Copy-on-Write)——改一个文件时先把它从下面的只读层拷上来,再改副本。所以容器删掉时,可写层一扔,磁盘立刻回收,而基础镜像一层都不受影响。
由此引出镜像 / 容器 / 仓库三个概念的关系:镜像是模板(只读分层),容器是镜像的一个运行实例(多一层可写层),仓库是镜像的托管服务。容器停止再启动,可写层还在;docker rm 之后,可写层连同里面的改动一起消失。
Dockerfile:几条真正需要讲清的区别
# 语法:每条指令生成一层,能合并的合并FROM nvidia/cuda:12.4.1-devel-ubuntu22.04 AS builder
# 装依赖:apt 缓存必须和 install 在同一条 RUN 里清掉,否则缓存会被留在镜像里RUN apt-get update && apt-get install -y --no-install-recommends \ python3 python3-pip git ninja-build \ && rm -rf /var/lib/apt/lists/*
WORKDIR /workspaceCOPY requirements.txt .RUN pip install --no-cache-dir -r requirements.txt
# ---------------- 运行阶段:只带运行期需要的东西 ----------------FROM nvidia/cuda:12.4.1-runtime-ubuntu22.04COPY --from=builder /usr/local/lib/python3.10/dist-packages \ /usr/local/lib/python3.10/dist-packagesCOPY --from=builder /workspace /workspace
ENV PYTHONUNBUFFERED=1ENTRYPOINT ["python3", "-m", "vllm.entrypoints.openai.api_server"]CMD ["--model", "/models/Qwen3-8B", "--port", "8000"]几条高频追问:
CMD和ENTRYPOINT的区别。两者都是”容器启动时执行什么”,但角色不同:ENTRYPOINT是固定的可执行体,CMD是默认参数。docker run image --port 9000这个额外参数会追加到 ENTRYPOINT 后面,同时覆盖掉 CMD。所以上例中不加参数跑就用--model /models/Qwen3-8B --port 8000,加了参数就替换掉整个 CMD。另一个细节:exec形式(JSON 数组)让进程直接成为 PID 1,能正确收到SIGTERM;shell形式会包一层/bin/sh -c,信号可能传不到,导致docker stop要等超时才被SIGKILL。COPY和ADD的区别。ADD多了两个能力:自动解压本地 tar、支持 URL 下载。正因为这两个”隐式行为”容易出意外,官方建议默认用 COPY,只有确实要解压时才用 ADD。- 为什么要多阶段构建。编译 CUDA 扩展、装编译器等只在构建期需要,运行期不需要。多阶段构建让最终镜像只保留
runtime基础镜像 + 产物,镜像体积常常能从几个 GB 压到几百 MB。 - 为什么要
--no-install-recommends和rm -rf /var/lib/apt/lists/*。前者少装无关包,后者清掉 apt 的包索引——它们在RUN那一层里,如果不在同一条RUN里清,会被永久留在镜像层里,白占几十到上百 MB。
跑推理服务时必须知道的几个参数
docker run -d --rm \ --gpus all \ # 需要 nvidia-container-toolkit --ipc=host \ # 放开 IPC 命名空间,NCCL 共享内存需要 --shm-size=16g \ # 不用 --ipc=host 时,至少给足 /dev/shm --ulimit memlock=-1 \ # NCCL 锁页内存不设限 --ulimit stack=67108864 \ # 栈大小 64 MB,NCCL/深递归用 -p 8000:8000 \ -v /data/models:/models:ro \ # 模型目录只读挂载 -v ~/.cache/huggingface:/root/.cache/huggingface \ # 复用编译/下载缓存 -v $(pwd)/src:/workspace/src \ # 代码挂进来,改了立即生效 --name vllm-qwen3 \ my-vllm:latest这里每一个参数背后都有具体的故障现场:
--gpus all之所以能穿透容器看到 GPU,是因为nvidia-container-toolkit在容器启动时把驱动库(libcuda.so等)和设备节点(/dev/nvidia*)注入进去。容器里不需要装驱动,但宿主驱动版本必须够。--ipc=host/--shm-size是最常见的”玄学卡死”来源。默认/dev/shm只有 64 MB,NCCL 在建立通信拓扑和多卡同步时会申请远超这个量的共享内存,申请失败就表现为进程静默挂起或直接崩。用多卡张量并行/专家并行时,这一条几乎是必配。--ulimit memlock=-1:NCCL 需要把通信缓冲区锁在物理内存里避免被换出,默认上限往往不够。-v挂载:容器里的改动默认是易失的。调试时直接在容器里改代码、跑通了,一删容器全没了——这是新手最常踩的坑。正确做法是把代码和模型目录挂进来,容器只当运行环境。- 镜像体积控制:
.dockerignore排除.git、__pycache__、数据集;把不常变的层(CUDA、Python 依赖)放前面,常变的层(业务代码)放后面,才能吃到构建缓存。
最后几个容易混淆的命令:docker commit 把容器当前状态固化成新镜像(调试时临时用,不要进生产流程);docker save / docker load 走 tar 包搬运镜像(保留分层与元数据);docker export / docker import 搬运的是容器文件系统扁平快照(丢掉分层和历史),两者不能混用。
这题怎么答才稳
先用一句话把两者的定位钉住——Git 管”代码的历史与协作”,Docker 管”运行环境的一致性”,它们的共同目标都是可复现。然后各挑两个最能体现理解的机制讲透(Git 讲快照与三区、Docker 讲命名空间+cgroup+OverlayFS 和分层缓存),再补一两个真实踩过的坑,最后落到推理场景里怎么用。不要从 git add 开始背命令。
第二问:MXFP 是什么、什么硬件支持 FP4、为什么 4 bit 还不掉精度
这道题是三连问,但真正的考点是第三问——前两问是铺垫,第三问才是”你到底理解不理解低精度量化的机理”。
从一个 scale 到一组 scale:块缩放的由来
先回到最朴素的问题。把一组浮点数压成低比特,本质上要解决的是动态范围和分辨率的取舍。
以 4 bit 浮点为例,最自然的元素格式是 E2M1:1 位符号、2 位指数、1 位尾数。它能表示的正数是:
加上符号位共 15 个非零值(外加 0)。也就是说,这个格式能表达的绝对值范围是 ,只有大约 12 倍()。
现在考虑一个真实权重张量:里面大多数值在 量级,少数离群值可能到 ,二者差了 100 倍——一个张量里的动态范围远超 12 倍。如果整个张量共用一个 scale ,那么无论 取多大,总有一部分数值落进”小于最小可表示值”而被压成 0,或者落进稀疏的尾数台阶之间而被舍成大误差。
这就是块缩放(block scaling)要解决的问题。做法是把张量切成小段,每一段(block)共享一个自己的 scale:
其中 是原始浮点值, 是落在该 block 里的 4 bit 定点/浮点编码, 是这个 block 专有的缩放因子,通常由 block 内的绝对值最大值 推出:
是该格式能表示的最大绝对值(E2M1 是 6),这样归一化后所有值都落在 内,能最大限度用满量化台阶。
关键收益是”离群值被关进了自己的房间”:一个 block 里出现一个 100 倍大的离群值,代价只是这个 block 的 scale 变大、该 block 内其他元素的有效分辨率下降;其余几百个 block 完全不受影响。这比”整个张量共用一个 scale,被一个离群值牺牲掉全部精度”要好得多。
OCP MX 规范:统一骨架
MXFP(Microscaling Formats,微缩放格式)就是把这套思路标准化的一份规范。它由 Open Compute Project(OCP)在 2023 年 9 月发布 v1.0,参与方包括 AMD、Arm、Intel、Meta、Microsoft、NVIDIA、Qualcomm 等。规范定义了一族格式,共享同一套骨架:
- 块大小固定为 32 个元素;
- 每个块共享一个 E8M0 类型的缩放因子;
- 元素类型决定具体名字。
E8M0 是个很特殊的格式:只有 8 位指数,没有符号位、没有尾数位。它表示的值是
其中 是那 8 位无符号整数( 被保留为 NaN)。所以 E8M0 能表达的只有 2 的整数次幂,范围从 到 ——动态范围极大,但分辨率极粗,相邻两个可表示值之间差 2 倍。
按元素类型分,这族格式有:
| 格式 | 元素类型 | 元素位宽 | 块大小 | scale 类型 | 每元素有效位宽 |
|---|---|---|---|---|---|
| MXFP8 (E4M3) | E4M3 | 8 | 32 | E8M0 | 8.25 |
| MXFP8 (E5M2) | E5M2 | 8 | 32 | E8M0 | 8.25 |
| MXFP6 | E2M3 / E3M2 | 6 | 32 | E8M0 | 6.25 |
| MXFP4 | E2M1 | 4 | 32 | E8M0 | 4.25 |
| MXINT8 | INT8 | 8 | 32 | E8M0 | 8.25 |
“每元素有效位宽”这一列值得单独算一遍:32 个 4 bit 元素占 bit,外加一个 8 bit 的 E8M0 scale,共 136 bit,分摊到 32 个元素就是 bit/元素。这就是为什么”4 bit 量化”实际占用的存储是 4.25 bit,做显存估算时不能只按 4 算。
NVFP4:块缩到 16,scale 换成 FP8,再加一层 FP32
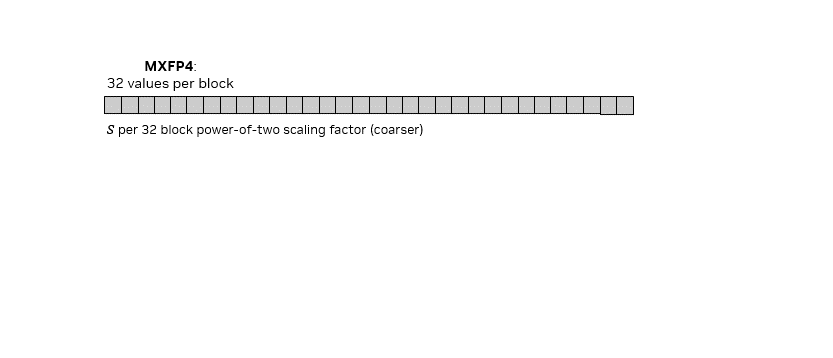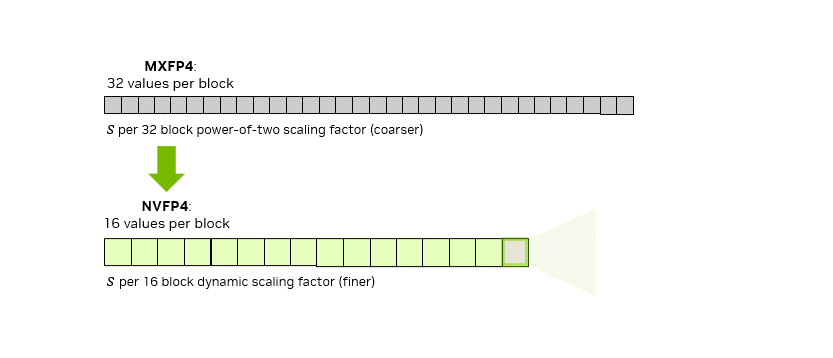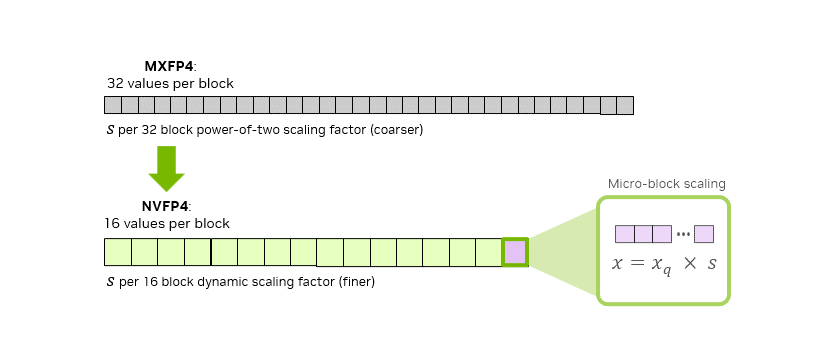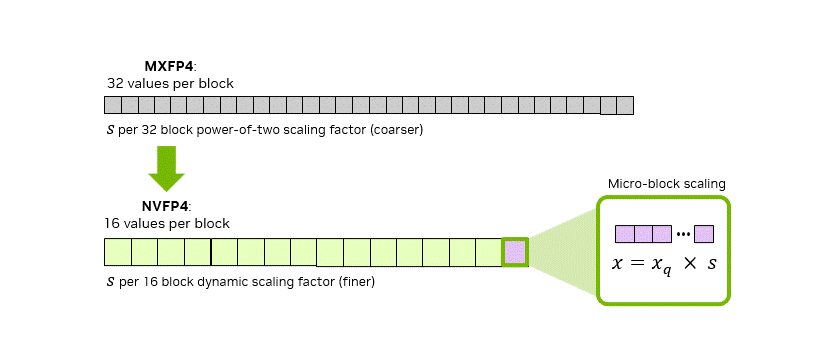
NVIDIA 在 Blackwell 一代提出了自己的 4 bit 格式 NVFP4,它和 MXFP4 共享元素格式(都是 E2M1),但在缩放结构上做了两处关键改动,并加了一层。
改动一:块大小从 32 缩到 16。 块越小,块内数值分布越集中,一个 代表的动态范围越窄,量化误差自然越小。代价是 scale 开销翻倍——每元素有效位宽从 4.25 升到 4.5。
改动二:scale 从 E8M0(2 的幂)换成 E4M3(FP8 浮点,且是无符号版本 UE4M3)。 这是 NVFP4 精度优势的主要来源。用 E8M0 时,算出来的理想 scale 必须向上取整到最近的 2 的幂(向上取是为了防止溢出),这一步可能让 scale 偏大最多 2 倍,等价于把整个 block 的有效分辨率砍半。换成 E4M3 后,scale 有 3 位尾数,能表达非 2 的幂的值,逼近精度大幅提升。
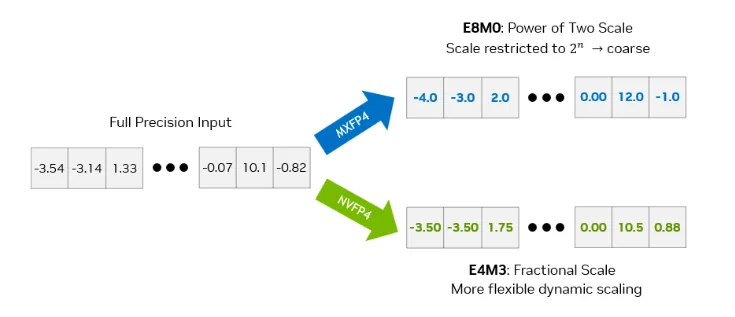
NVIDIA 官方给的数据是:同一批缩放因子上,E8M0 的平均平方误差(MSE)是 0.72,E4M3 是 0.08——差了约 9 倍。注意这张图讲的是”编码 scale 本身”的误差,和”用 scale 去量化元素”是两回事,但这个误差会原封不动地传递到最终的解量化结果上。
新增的一层:张量级 FP32 scale。 NVFP4 是两级缩放:内层是每 16 个元素一个 E4M3 scale ,外层是整个张量一个 FP32 scale 。解量化公式是
第二级的作用是防止 block scale 本身溢出或下溢。E4M3 虽然比 E8M0 分辨率高,但动态范围小得多(最小规格化值约 ,加上次正规数到 ;最大可表示值 448,约 ),如果某个张量的整体数值量级恰好落在 E4M3 的边缘,block scale 就会失真。先用一个 FP32 的张量级 scale 把整块数据”归一化”到 E4M3 的舒适区间,block scale 才能在范围内正常工作。
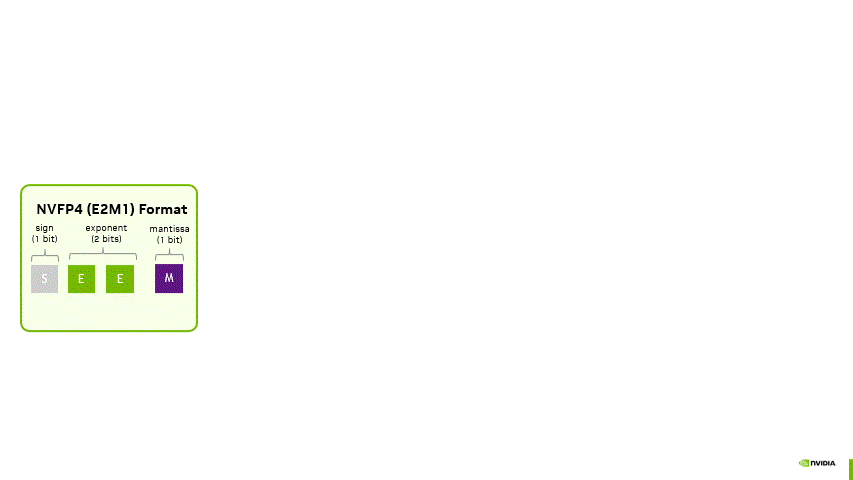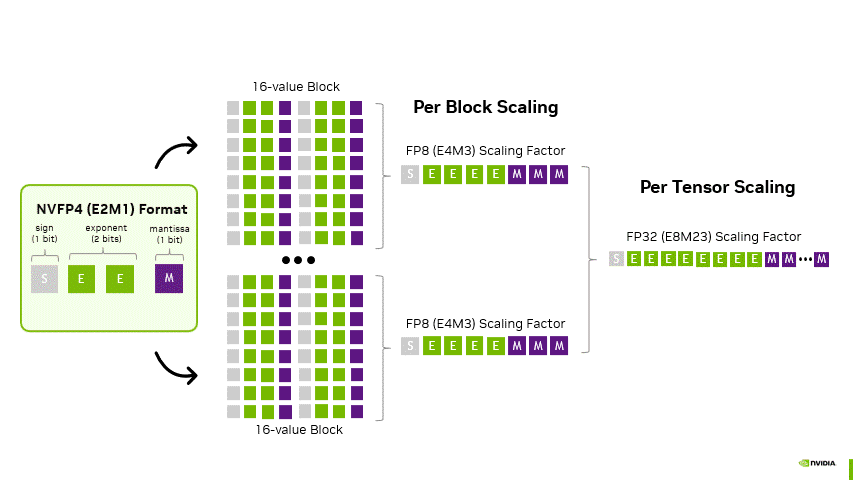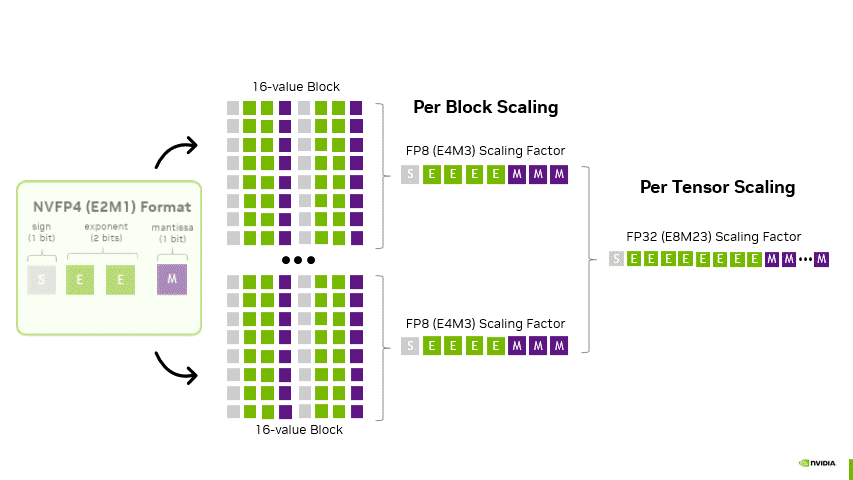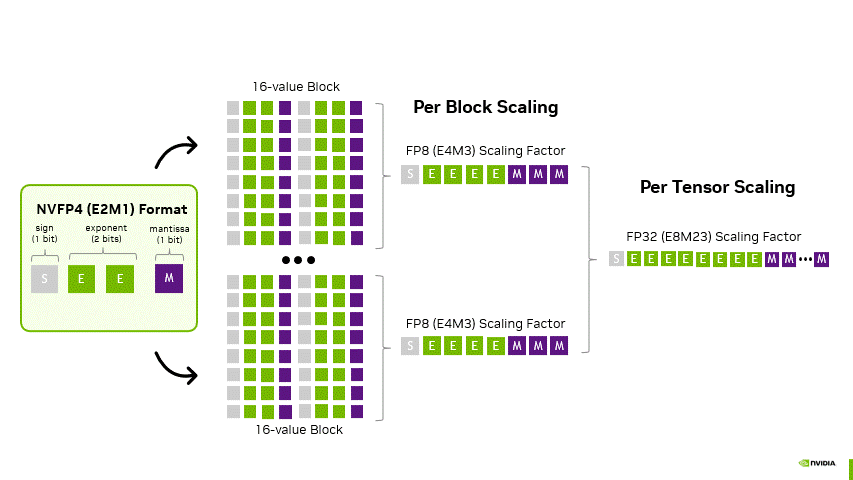
把有效位宽重算一遍:16 个 4 bit 元素 = 64 bit,加一个 8 bit 的 E4M3 scale,共 72 bit,分摊到 16 个元素是 bit/元素。张量级那个 FP32 scale 是每张量一个,可以忽略不计。
现在什么支持 FP4
按硬件、软件两层说。
硬件(能原生做 FP4 矩阵乘的):
- NVIDIA Blackwell 数据中心 GPU(B100 / B200 / GB200 / B300 / GB300)。第五代 Tensor Core 原生支持 FP4 与 FP6,PTX 层面就是
mma的kind::mxf4变体——指令直接吃 E2M1 数据加 E8M0 scale,不需要先解量化成高精度再做乘法。算力上,如果看”每一代支持的最小浮点类型的稠密算力”:A100 的 FP16 是 0.3 PFLOPS(稠密),H100 的 FP8 是 1.9 PFLOPS,B200 的 FP4 是 9 PFLOPS,GB300 的 FP4 到 15 PFLOPS。NVIDIA 自己的口径是 GB300 的 FP4 GEMM 吞吐约为 Hopper 原生 FP8 的 7 倍。 - NVIDIA Blackwell 消费级 GPU(RTX 50 系列,SM120)。有 FP4 的硬件通路,但软件生态明显滞后,后面细说。
- AMD Instinct MI355X(CDNA4)。支持 FP4 与 FP6,速率是 FP8 的 2 倍。AMD 走的路线值得注意:它原生支持的是 OCP 的 MX 系列(MXFP4 / MXFP6 / MXFP8,块大小 32、E8M0 scale),而不是 NVIDIA 私有的 NVFP4。
- 国内也有对应的自研格式,例如昇腾提出的 HiFloat4,思路同样是”块缩放 + 更精细的 scale 编码”。
软件(能吃 FP4 权重的推理栈):
- vLLM:通过 ModelOpt 导出的 checkpoint 支持 NVFP4(
quantization="modelopt_fp4"),加载时会在 CUTLASS / FlashInfer / Marlin 几个后端里自动挑 GEMM kernel。 - TensorRT-LLM / TensorRT Model Optimizer(现已改名 Model-Optimizer):NVIDIA 官方的一等公民路径,也已发布一批现成的
nvidia/*-NVFP4模型 checkpoint。 - TransformerEngine:提供 FP4 的量化与 GEMM 封装。
- SGLang、llama.cpp、AMD Quark:各自有对应的 MXFP4/NVFP4 支持。
必须提醒的工程现实:格式支持 ≠ 你的卡能跑到。 几个真实的坑:
- vLLM 在没有原生 FP4 GEMM kernel 的设备上会自动回退到 Marlin 的 W4A16——权重是 4 bit,但激活仍是 16 bit,走的是”权重反量化后做 FP16 乘法”的路径,吞吐提升远不如 W4A4 的原生路径,日志里会有一条 warning。
- RTX 50 系列(SM120)上,CUTLASS 的块缩放 FP4 kernel 长期只对
sm_100a开放,社区实测 NVFP4 在消费级 Blackwell 上”是在反量化而不是在跑原生 FP4”,端到端提升有限。 - 有一个很隐蔽的 bug 值得记住教训:vLLM 某些版本移除了 NVFP4 缩放缓冲区的零初始化,导致输出吞吐直接掉 87%~93%,而且不报错、不崩溃——只是变慢。这类”静默性能回归”说明低精度路径的验证不能只看”结果对不对”,必须同时看”速度对不对”。
核心问题:为什么压到 4 bit,精度还能不掉
前面都是铺垫,这里才是真正的答案。给一个完整的分层解释。
机制一:块缩放把离群值局部化。 已在前面讲过。量化误差的量级大致正比于 ,其中 是有效位宽。块缩放的贡献是把式中的 从”整个张量”缩小到”块内 32/16 个元素”,让这个上界大幅下降。这是低比特量化能成立的第一性前提。
机制二:scale 的精度和元素的精度一样重要。 这是 MXFP4 与 NVFP4 之间差距的主要来源。E8M0 的 2 倍量化台阶意味着”即使元素编码完美,光 scale 的舍入就带进了接近一倍的相对误差”;E4M3 把这个损失压下去约 9 倍。NVIDIA 用 8B 参数、1T token 的训练实验做过对照:达到相同的最终 loss,MXFP4 比 NVFP4 多需要约 36% 的训练 token。这个数字很直观地说明了”scale 格式不是免费的细节”。
机制三:两级缩放保证 scale 自己不失效。 张量级 FP32 scale 让 block scale 始终工作在 E4M3 的有效区间内,避免因为整张量数值量级偏大或偏小导致 block scale 溢出/下溢成 0。如果没有这一层,遇到量级极端的张量(某些层的激活、某些专家的权重)就会整块失真。
机制四:不是所有张量都进 FP4。 这一条经常被忽略,但工程上极其重要。NVIDIA 的 FP4 训练配方里,只有 MLP 的三个 GEMM(前向 FPROP、激活梯度 DGRAD、权重梯度 WGRAD)走 NVFP4,注意力模块内的 GEMM 全部保持更高精度。原因是明确的:QK^T 的分数要经过 softmax,而 softmax 是指数放大——分数上的微小量化噪声会被指数放大,进而扭曲整个注意力分布;而且注意力的激活里存在高度集中的离群值,4 bit 表达不了。
同理,推理侧做 W4A4 时,KV Cache 是否一起进 FP4 是另一个需要单独决策的问题(KV 的分布比权重更不友好,通常单独用 per-channel / per-token 的非对称量化处理)。
机制五:量化算法本身在补偿。 格式只是容器,怎么往里面装才是算法。这里堆了一整套武器:
- AWQ:不保护所有权重,只按激活的显著度放大那 1% 的关键通道,把量化难度从权重侧转移出去。
- GPTQ:用 Hessian 的二阶信息,每量化一个权重就用闭式解更新同一行剩余权重来补偿误差。
- 随机 Hadamard 变换(Random Hadamard Transform):对输入做一次正交旋转,把能量在维度上”打散”,让原本尖峰的离群值变成近似高斯分布——离群值一旦被摊平,块缩放就用不着为它牺牲整块的分辨率。注意 NVIDIA 只在 WGRAD 这一步做这个变换,FPROP/DGRAD 不做,因为要保持二维 scale 的一致性。
- 二维权重缩放:权重用 的二维块,让前向的 FPROP 和反向的 DGRAD(用的是同一份权重的转置)共用同一套 scale;激活和梯度用低开销的一维 缩放。
- 随机舍入(stochastic rounding):让舍入误差在期望上为零,避免大量细小更新被系统性地”舍成 0”。
机制六:模型对微小扰动本来就是鲁棒的。 这是最容易被忽视但最本质的一点。一个训好的大模型,其参数本身就带有大量冗余,损失曲面在收敛点附近相当平坦——这也正是”参数可以剪枝、可以量化、可以低秩分解”这一整类压缩方法能成立的共同前提。所以量化误差只要控制在某个阈值内,任务指标就不会显著变化。
代价与边界:不是白拿的
既然讲了机制,就必须讲清边界,否则答案会显得过于乐观。
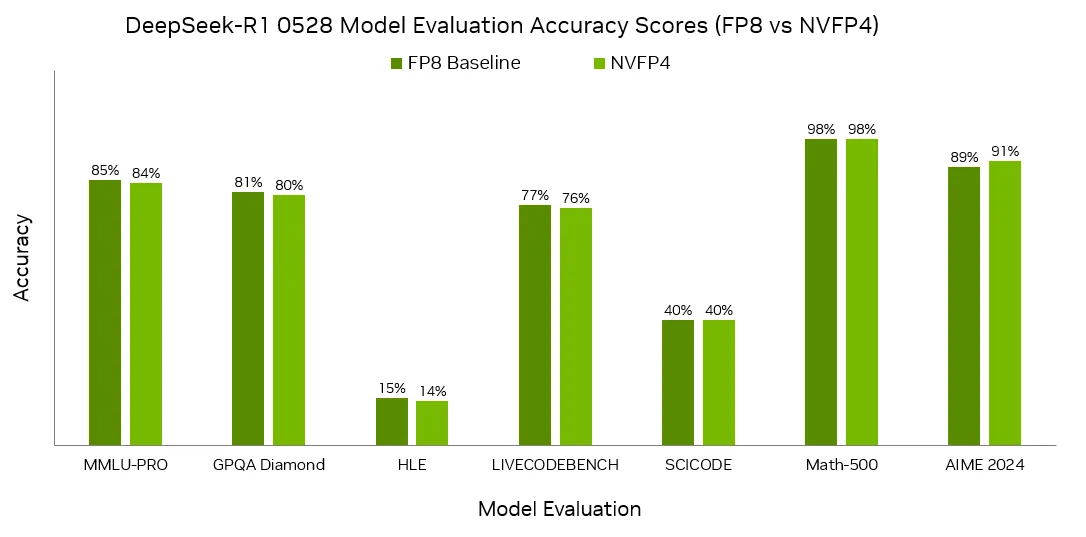
精度不是无损,只是差距小。 NVIDIA 公布的 DeepSeek-R1 0528 在 FP8 与 NVFP4 下的对比:MMLU-PRO 85% vs 84%、GPQA Diamond 81% vs 80%、HLE 15% vs 14%、LiveCodeBench 77% vs 76%、SciCode 40% vs 40%、Math-500 98% vs 98%、AIME 2024 89% vs 91%。七个基准里有六个小幅下降 0~1 个点、一个反而上升——整体是”接近无损”,不是”无损”。
块大小不是越小越好。 ICLR 2026 有一篇《Is Finer Better? The Limits of Microscaling Formats in Large Language Models》给了一个反直觉的结论:当 scale 本身被量化存储时,块大小缩小到某个阈值以下,模型质量反而会下降,作者称之为”困惑度反转”(perplexity inversion)。原因在于更小的块会逼出更多、数值更小的 scale,而这些 scale 在有限动态范围的格式里更容易下溢。这提醒我们:块大小、scale 格式、scale 精度这三个参数是耦合的,不能只盯着一个调。
FP4 推理比 FP4 训练容易得多。 推理可以做训练后量化——用一小批校准数据离线把 scale 算好,模型不动;输出质量可以逐层、逐个任务地验证。训练要在前向和反向同时低精度,还有一维块布局在转置后 scale 不一致导致梯度有偏之类的问题,至今没有被完全解决。
别忘了 scale 的访存开销。 4.25 或 4.5 bit/元素只是算术上的账。实际 kernel 里 scale 是另一块内存,访存模式和元素数据不同,需要专门设计(这就是为什么 NVIDIA 的块缩放 scale 要用 的 tiled 布局存储、指针要 16 字节对齐)。在小 batch 的解码场景里,这部分开销未必可以忽略。
这题怎么答才稳
答题节奏建议是:先给 MXFP 一个定位(OCP 2023 年发布的块缩放格式族,32 元素共享一个 E8M0 缩放因子,含 MXFP8/MXFP6/MXFP4/MXINT8),再点出 NVFP4 的两处改动和一层新增(块 32→16、scale E8M0→E4M3、加一层张量级 FP32),然后列硬件支持(Blackwell 数据中心与消费级、AMD MI355X、昇腾 HiFloat4),最后重点回答第三问——把”块缩放局部化离群值 + scale 格式精度 + 两级防溢出 + 选择性量化 + 量化算法补偿 + 模型本身鲁棒”这六条讲出来。能顺带说出”scale 编码误差 MSE 0.72 vs 0.08”、“MXFP4 需要多 36% token”这类具体数字,以及”vLLM 会静默回退到 W4A16”这种工程细节,区分度就出来了。
第三问:KV260 的 DDR 带宽,和 Qwen2.5-0.5B 的理论吞吐
这是一道纯定量题,但它比看上去难:题目给了四个已知量(板子、位宽、模型、量化位宽),要求一个结论(throughput),中间要自己补上”带宽怎么算”和”为什么 throughput 由带宽而不是算力决定”这两步推理。只报一个数字是不合格的,必须把假设摆出来。
先看清这块板子
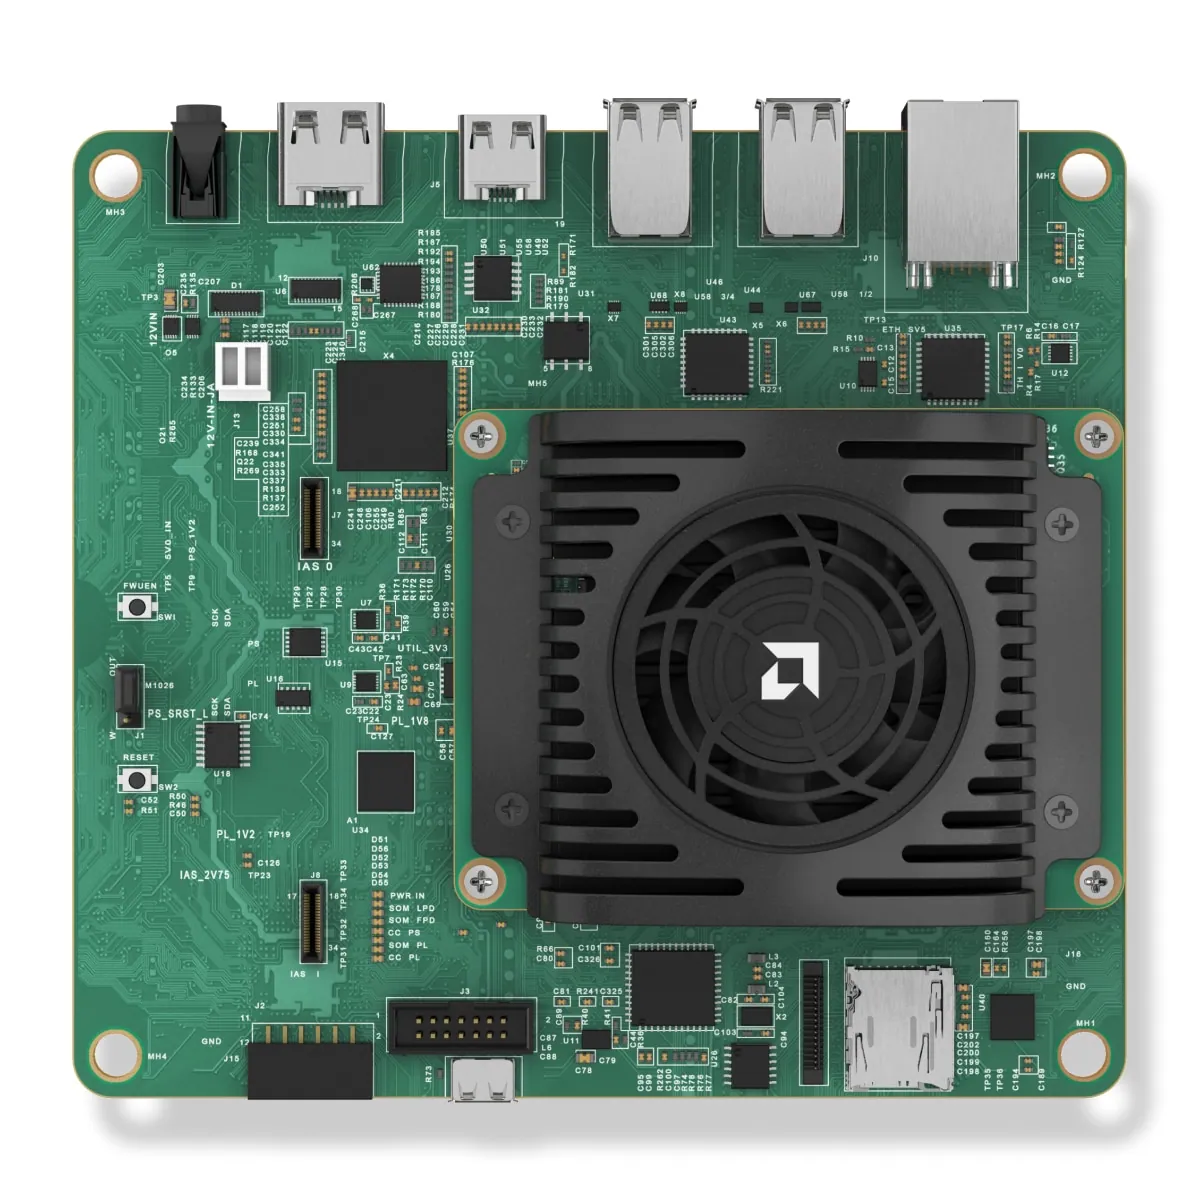
KV260 是 AMD(收购 Xilinx 后)在 2021 年推出的边缘 AI 开发套件。它本身不是一块芯片,而是载板加核心模块的组合:载板提供各种接口(MIPI 摄像头、以太网、DisplayPort、USB),核心算力在 K26 系统级模块(SOM,System-on-Module)上。
K26 SOM 的关键规格如下。
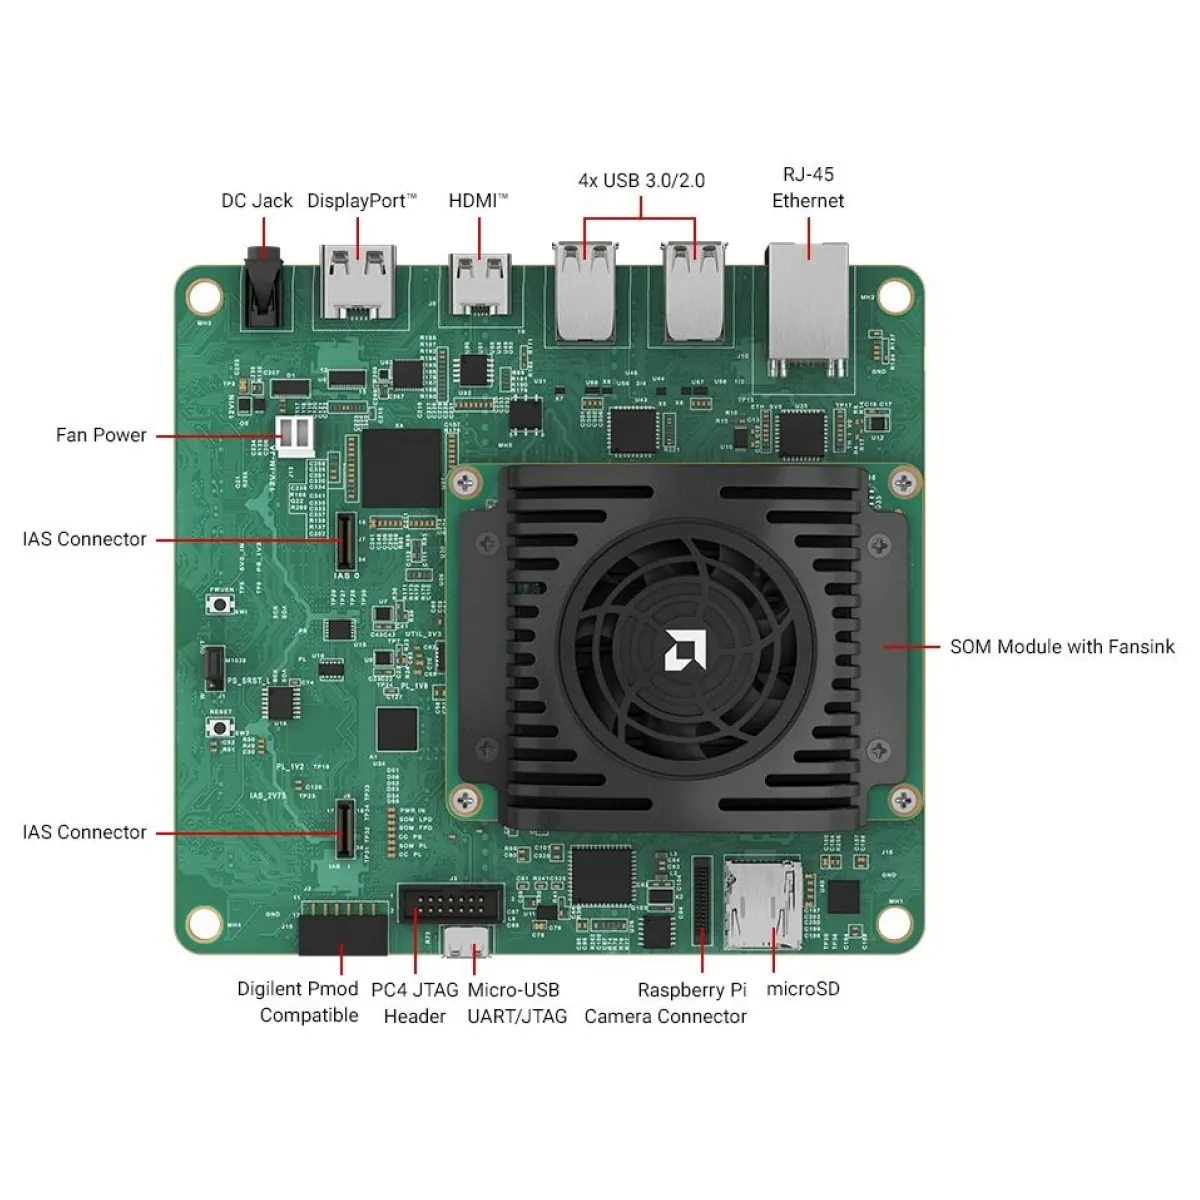
| 项目 | 规格 |
|---|---|
| MPSoC | Zynq UltraScale+ XCK26 |
| 处理器系统(PS) | 四核 Cortex-A53 @ 1.5 GHz + 双核 Cortex-R5F @ 600 MHz + Mali-400 MP2 GPU |
| 可编程逻辑(PL) | 256K 系统逻辑单元,1248 个 DSP48E2 切片,144 块 BRAM,64 块 UltraRAM(约 26.6 Mb 片上 SRAM) |
| 内存 | 4 GB DDR4,64 位位宽,2400 MT/s,非 ECC |
| 存储 | 16 GB eMMC + 512 Mb QSPI Flash |
| AI 算力(厂商标称) | 约 1.4 TOPS(INT8 DPU 口径) |
| 功耗 | 典型 7.5 W,最大 15 W |
注意一件事:K26 SOM 上的 4 GB DDR4 是 PS 和 PL 共用的系统内存。FPGA 逻辑部分没有自己独立的 DRAM,要访问内存必须走 PS 的内存控制器(通过 AXI 高性能端口)。这一点在后面的讨论里很关键。
带宽怎么算:64 位 × 2400 MT/s = 19.2 GB/s
板载 DDR 的理论峰值带宽由两个量决定:
代入数字:总线位宽 64 bit,等于 8 Byte;数据传输率 2400 MT/s,即每秒 2400M 次传输。于是
所以答案是 64 位、约 19.2 GB/s。
这里有一个几乎所有人第一次都会犯的错,值得专门说清楚。DDR 的名字(Double Data Rate)会诱导人”再乘 2”,但2400 MT/s 这个数字里已经包含了双边沿:DDR4-2400 的实际时钟是 1200 MHz,每个时钟周期在上升沿和下降沿各传一次,所以传输率是 MT/s。规范书上写 MT/s(Mega Transfers per second)而不是 MHz,就是为了避免歧义。
判断要不要乘 2 的规则很简单:看单位。写的是 MHz 就乘 2,写的是 MT/s 就不乘。19.2 GB/s 这个数字也可以反过来验证——DDR4-2400 单通道的理论带宽就是 19.2 GB/s,这是 DIMM 的常见规格,数字对得上。
顺带一个必须说的限定:19.2 GB/s 是理论峰值。真实可达带宽受刷新开销、行激活冲突(row-buffer miss)、读写切换、PS 侧其他主控争抢等因素影响,实测通常在峰值的 70%~85%。而且正如前面提到的,这 19.2 GB/s 是 PS(四核 A53、GPU、VCU)和 PL(FPGA 逻辑)共享的,如果 PS 上还跑着 Linux、摄像头采集、网络协议栈,PL 能拿到的份额还要再打折扣。
为什么解码阶段的吞吐由带宽决定
现在到了关键的一步推理:为什么用带宽除以权重体积就能得到吞吐?
先看模型规模。Qwen2.5-0.5B-Instruct 的配置是:隐藏维度 896、24 层、14 个查询头、2 个 KV 头(GQA,分组比 7:1)、头维度 64、词表 151936、总参数量约 0.49B。
把这些参数按 8 bit 量化,权重体积是:
题目里按 0.5B 估算,那就是 0.5 GB。
接下来是核心论证。LLM 的推理分成两个阶段:
- Prefill(预填充):一次性处理整个 prompt。此时有几百上千个 token 同时参与,矩阵乘的算术强度高,是算力瓶颈。
- Decode(解码):每次只生成一个 token。此时参与矩阵乘的”行数”只有 1(batch = 1 时),权重矩阵的每一个元素都必须从内存里读出来参与一次乘法,读完就用完,不复用,是带宽瓶颈。
这就是自回归解码的本质:每生成一个 token,都要把全部权重从 DRAM 完整过一遍。
于是单请求的解码吞吐上界是
其中 是权重体积(GB), 是这次前向需要读取的 KV Cache 体积(GB)。先假设上下文很短、把 KV 项暂时忽略,代入数值:
所以理论最高吞吐大约是 38 token/s(用 0.49B 精确值算是 39 token/s,用题目给的 0.5B 名义值是 38.4 token/s,取整说 38~39 都可以)。
验证一下:确实是带宽瓶颈,不是算力瓶颈
只给出 38 这个数字,面试官未必满意,因为他还想确认你怎么知道瓶颈在带宽而不是算力。用 Roofline 的思路验一遍。
先算这块板子的算力。1248 个 DSP48E2 切片,每个每周期做一个 25×18 的乘法累加(算 2 次浮点操作),PL 侧时钟按 500 MHz 估:
这与厂商标称的 1.4 TOPS 同量级(厂商口径还包含其他硬化单元),可以认为估得合理。
再算解码阶段的算术强度。每 token 需要的乘加次数约等于参数量 (每个权重参与一次乘加,即 2 FLOP):
而这块板子的 Roofline 拐点是
实际算术强度 2 FLOP/Byte,比拐点低 30 多倍,牢牢落在 Roofline 的内存受限区。结论确认:瓶颈是内存带宽,不是 DSP 算力。
反过来看也很清楚:如果用算力去估吞吐, token/s,和 38 差了一个数量级。哪个对?——取小的那个,也就是 38。这就是性能分析的基本功:把两个上界都算出来,取较小者。
这个数字会被什么打折
38 token/s 是”理论最高”,实际会低不少。逐项列出:
- 真实带宽利用率。按 75% 算,19.2 → 14.4 GB/s,吞吐降到约 29 token/s。
- KV Cache 的读取。Qwen2.5-0.5B 每 token 的 KV 是 Byte = 12 KB(2 表示 K 和 V,24 层,2 个 KV 头,64 维,2 字节 FP16)。上下文 1K 时 KV 只有 12 MB,相对 494 MB 权重可以忽略;但上下文到 8K 时是 96 MB(约 19%),到 32K(模型的最大上下文)时是 384 MB——几乎和权重一样大。也就是说,长上下文下这个吞吐还要再腰斩,而这恰恰是「用带宽除以权重体积」这个简化估算忽略掉的部分。
- 激活、中间张量、采样开销。每层的激活、RMSNorm 的读写、logits 的计算(词表 151936,最后一次投影本身就不小)都要占用带宽和算力。
- 端到端还有非解码部分。题目问的是 throughput(生成速度),但端到端还有一个 prefill 阶段(算力受限)、Python/调度开销、tokenizer 编解码。如果是首 token 延迟(TTFT)而不是吞吐,答案就完全不同。
- 实际部署的额外开销。FPGA 侧还需要把权重从 DDR 搬进 BRAM/UltraRAM 的分块流水,反量化的 LUT 逻辑也要吃资源;如果权重放不进片上 SRAM,就要反复走 DDR。
所以一个更诚实的答法是:理论上限约 38 token/s(batch=1、忽略 KV、满载带宽);实际落在 20~30 token/s 是正常预期;长上下文下会明显更低。
追问变体:如果 batch 变大呢
这是这道题最可能被追问的方向,答上来会很加分。
前面说过,batch = 1 时权重读完只用一次。但如果同时处理 个请求,同一份权重读一次可以服务 个 token,等效的”每 token 字节数”变成
代入 、上下文 1K: GB/token,吞吐上界
比 batch=1 时高了近 7 倍。但注意这时候离算力上界 token/s 还很远,继续加 batch 才会慢慢逼近。把两个上界画在一起,交点出现在
也就是说,要一直加到 batch 约 150,这道题才真正从带宽受限翻到算力受限;在此之前每加一点 batch 都几乎是线性收益。注意在交点上 KV Cache 的每 token 字节数(0.012 GB)已经占了总字节数(0.01536 GB)的近八成——权重那部分已经被复用压到几乎不占带宽了,剩下卡住你的全是 KV。这也是大批量场景里”权重不再是瓶颈、KV 才是”这句话的定量含义。
这正是”连续批处理(continuous batching)“这类服务系统技术能拿到数量级收益的根本原因——它把解码从”带宽受限”推回到”算力受限”,让 DMA 搬进来的权重被更多 token 复用。
当然,KV Cache 也会随 batch 线性增长,这是它的天花板。这也解释了为什么 KV 压缩(量化、驱逐、稀疏注意力)对高并发服务的价值这么高。
这题怎么答才稳
按这个顺序讲:板载 DDR 是 4 GB、64 位、2400 MT/s(顺带说一句”这是 PS 和 PL 共用的”),带宽 = 8 Byte × 2400 MT/s = 19.2 GB/s(并主动点破”DDR 不用再乘 2,MT/s 已经含双边沿”这个坑),权重 = 0.5B × 1 Byte = 0.5 GB,解码是带宽瓶颈,所以吞吐 ≈ 19.2 / 0.5 ≈ 38 token/s。然后用 Roofline 验证一遍(算术强度 2 vs 拐点 65,确认内存受限),最后主动补上三条打折项(带宽利用率、KV Cache、batch 效应)。主动提”batch 变大后权重被复用、吞吐能提升”这一层,是把这道题从”会算除法”打到”懂服务系统”的关键。
第四问:Tensor Core 和脉动阵列的区别,以及怎么选
这道题是四题里最考架构 sense 的。它容易被答成”一个是英伟达的、一个是谷歌的”这种表面区分,但那样就白白丢掉了展示深度的机会。
先承认共同点:它们在做同一件事
两者的目标完全一致:用硬件高效地完成矩阵乘累加(MAC),并且靠数据复用把算术强度推高,脱离内存墙。
再往深一层看,Tensor Core 内部的本质也是一个小规模的 MAC 阵列。学术界对 Volta Tensor Core 的逆向分析(如 Fasi 等人 2021 年关于 Tensor Core 数值行为的研究)显示,一个 HMMA 单元内部就是”若干个乘法器 + 一个宽加法树”,一次完成一个 (Volta 的粒度)的小矩阵乘,且累加过程带有硬件特定的截断行为。
所以”Tensor Core 还是脉动阵列”不是一个二选一,而是一条谱系。真正的差别在三个变量上:
- 阵列的物理规模——是几百个各自独立的小单元,还是一整块大网格;
- 数据从哪里来——是从寄存器/共享内存显式喂进去,还是靠相邻单元逐拍传递;
- 谁来调度——运行时硬件调度,还是编译期静态排布。
把这三个变量讲清楚,这道题就基本满分了。
Tensor Core:长在 SIMT 里的小尺寸 MMA 单元
Tensor Core 首次出现在 2017 年的 Volta(V100),每个 SM 里塞 4 个,总共 320 个。它的基本工作方式是:
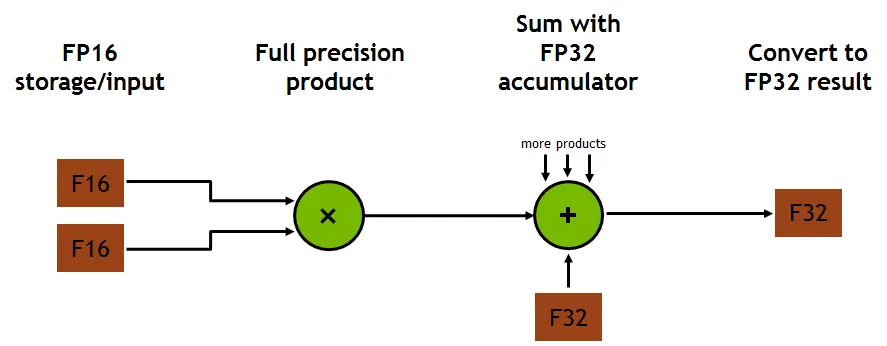
- 粒度小。Volta 单指令是 ,warp 级 WMMA 是 ;Ampere 的
mma.m16n8k16(FP16)和m16n8k8(TF32);Hopper 的wgmma.mma_async变成 warpgroup(128 线程)级的 ,并且是异步的——发出指令后可以不等结果就继续做别的,这是 FA-3 那类生产者-消费者流水线的硬件基础;Blackwell 的tcgen05.mma更进一步引入了 Tensor Memory(TMEM)作为独立的累加器存储。 - 数据从寄存器/共享内存来。操作数是按固定的 fragment 布局分散在各线程的寄存器里的(哪个线程持有哪些元素是被硬性规定的),程序员或 CUTLASS 这类模板库负责把数据摆到正确的位置。
- 控制是 SIMT 的。没有”整块阵列同步”这种概念,每个 SM 上的 warps 独立调度,硬件用延迟隐藏(warp 切换)来掩盖访存延迟。
- 每一代加一种精度:Volta FP16 → Turing INT8/INT4 → Ampere BF16、TF32、2:4 结构化稀疏 → Hopper FP8 → Blackwell FP4/FP6。
- 数量多、颗粒小,所以形状容忍度高。矩阵维度是 7 的倍数还是 13 的倍数都无所谓,拆成小 tile 拼一拼就行,浪费有限。
脉动阵列:一整块网格,数据在里面「流动」
脉动阵列(systolic array)的概念要早得多,由 H. T. Kung 和 Charles Leiserson 于 1978—1979 年在 CMU 提出。“systolic”(收缩的)这个词借用自生理学——像心脏收缩推动血液一样,数据被有节奏地”泵”过阵列,每个节拍前进一格。
它的典型代表是 Google TPU 的 MXU(Matrix Multiply Unit):TPU v1 是一块 的 INT8 阵列,共 65536 个 MAC,单周期完成 65536 次乘累加;v2/v3 改为每核两个 ;到 v6e 及之后的 Ironwood 一代又回到 。
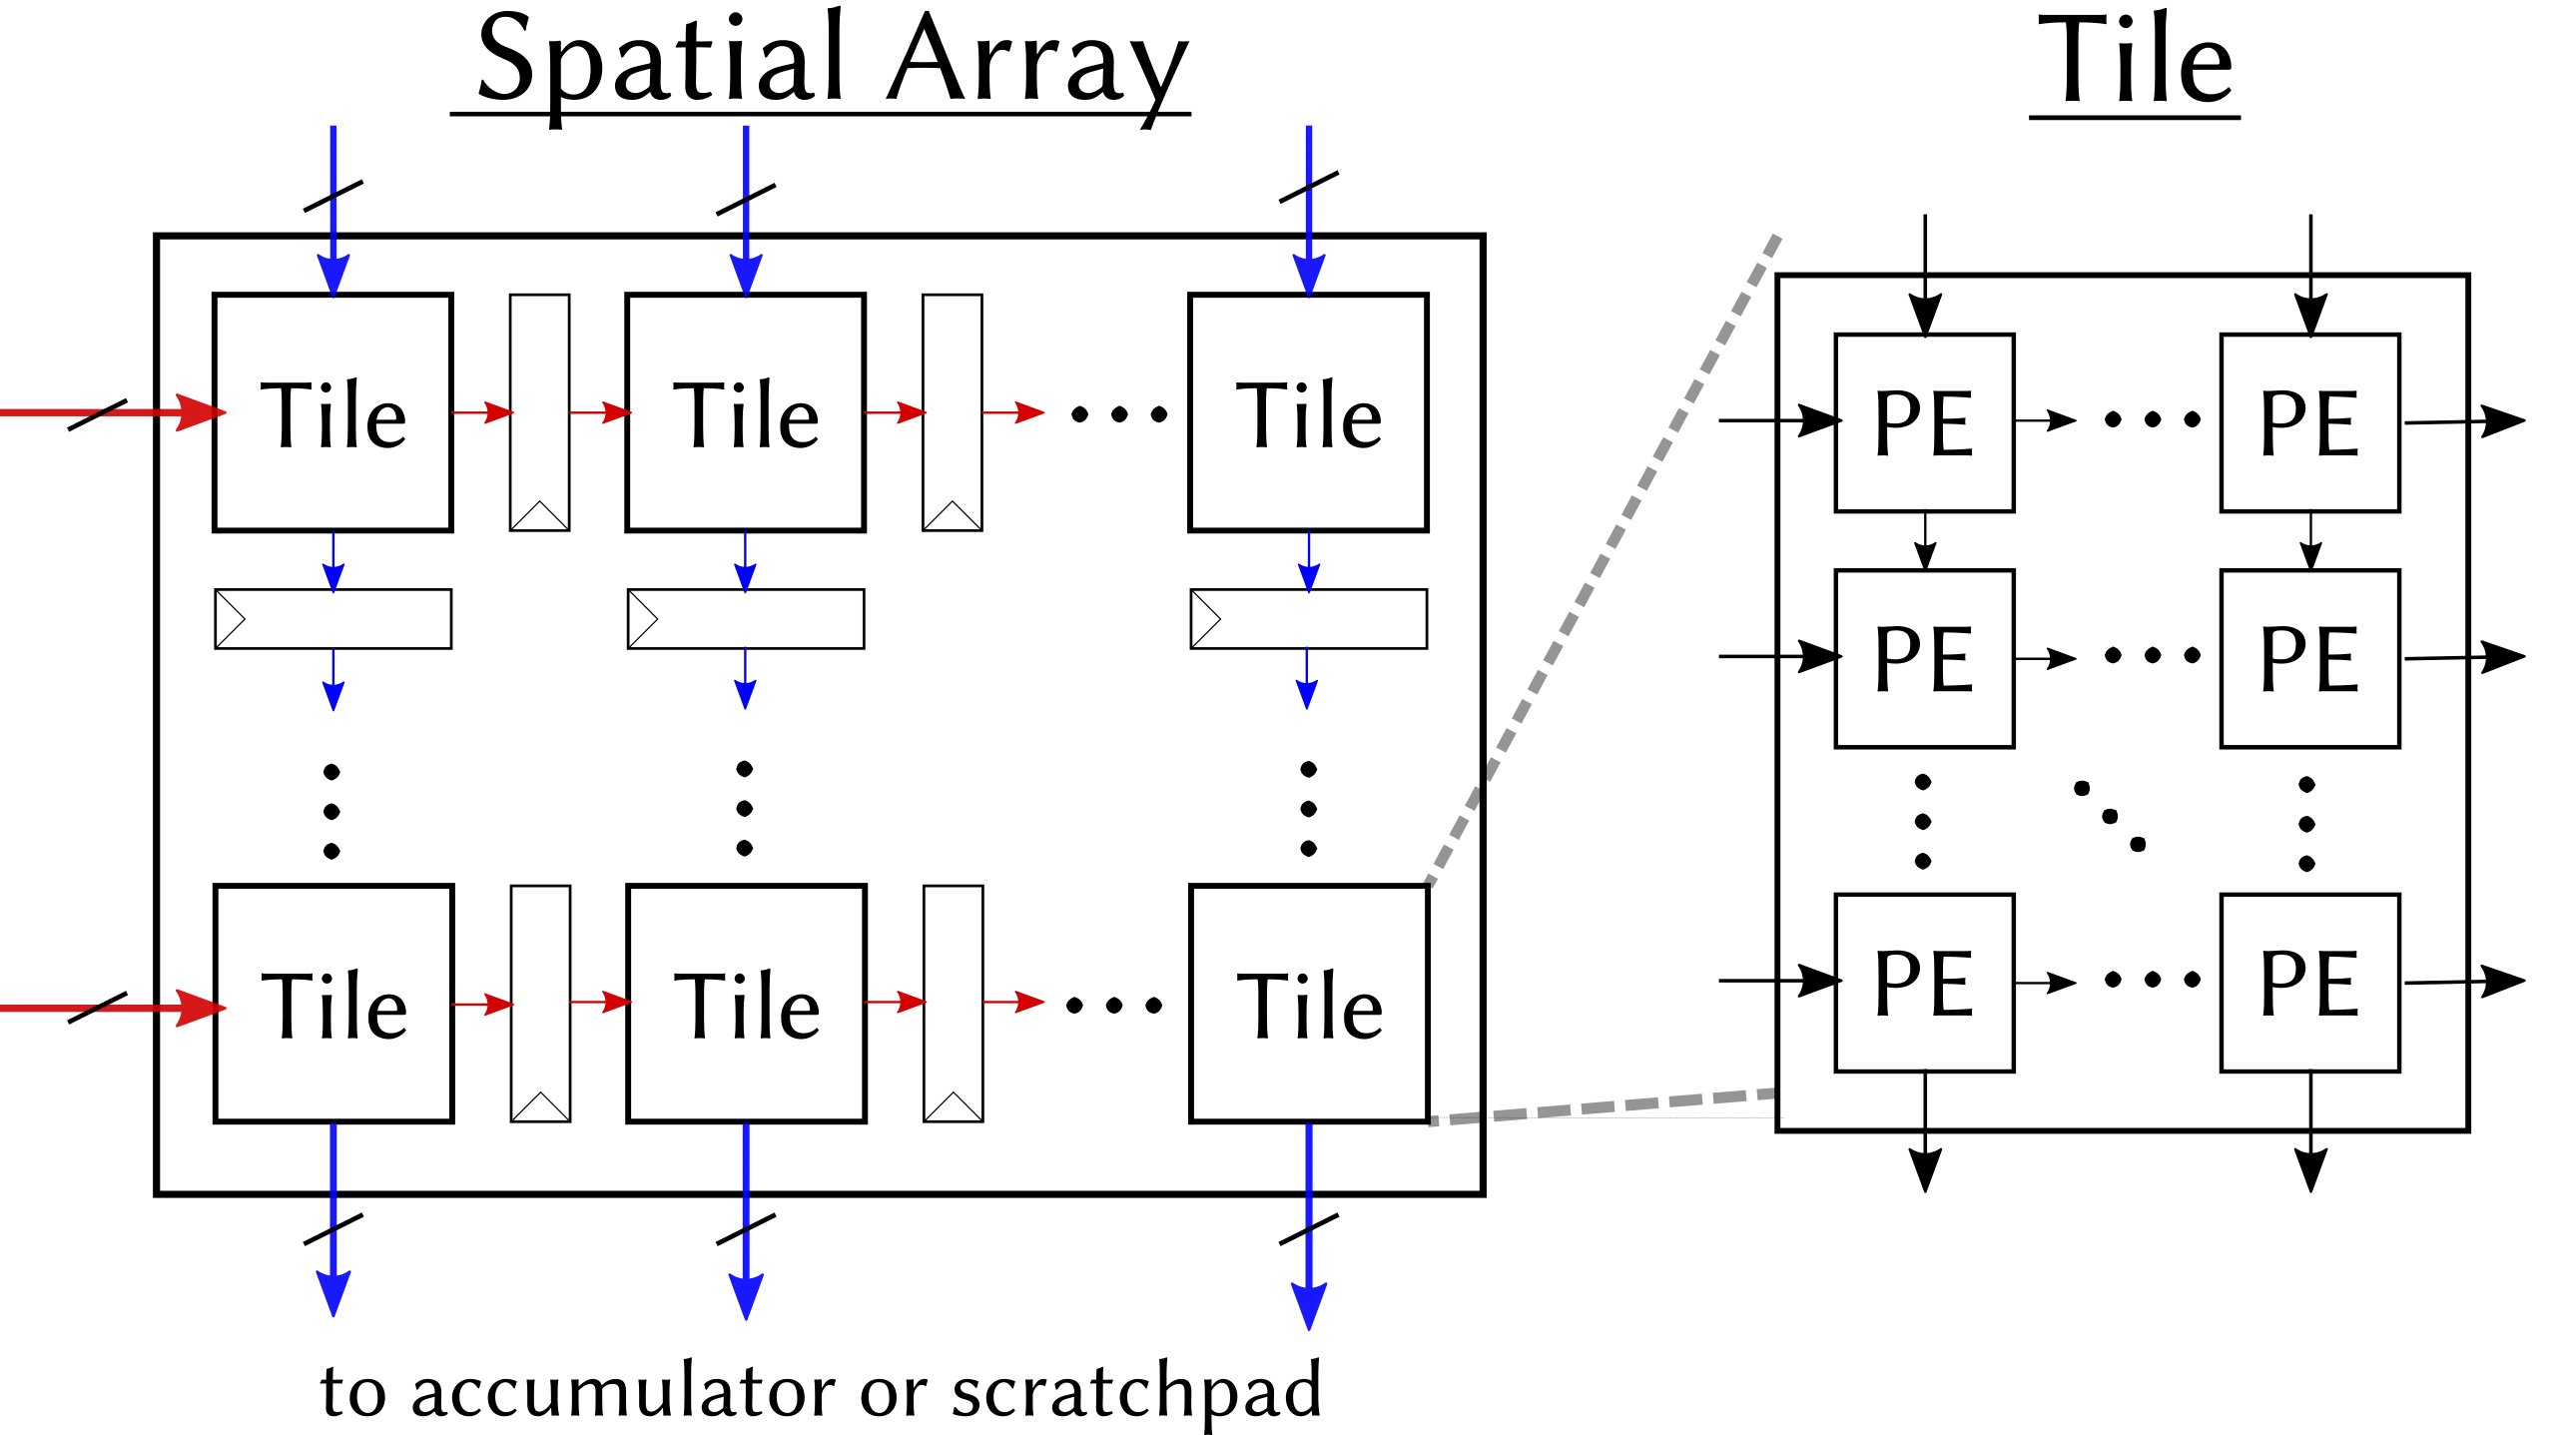
(上图来自 Gemmini——一个开源的全栈 DNN 加速器生成器——的论文,画的就是这类结构的标准骨架:PE 阵列、显式管理的 banked SRAM scratchpad、位宽更宽的累加器存储,以及外围的池化/激活等辅助电路。)
它的工作方式是:
- 阵列是重量级、整块的。一个核就一块大网格,没有”每个 SM 四个”这种分布。
- 数据走邻居转发,不落内存。以最经典的 weight-stationary(权重驻留)数据流为例:权重预先加载进每个 PE 并停在原地;激活从阵列左侧边界逐列进入,部分和从上方逐行流入,每个 PE 做一次乘法、加上从邻居传来的部分和、再传给下一个邻居。整个过程中间结果从不写回内存。
- 控制逻辑极少。没有取指、没有译码、没有乱序调度,PE 之间不需要地址,每个 PE 就只有乘法器、加法器和几个寄存器。这让芯片的绝大部分面积可以直接落在计算单元上,而不是取指译码、寄存器重命名这类控制通路上。
- 复用来得是几何性的。一个 的阵列,每个周期做 次 MAC,而每个操作数从内存里只读一次——因为每个进入阵列的值会被一整行或一整列复用。算术强度直接变成 量级,这是它能跑到 Roofline 计算受限区的根本原因。相比之下,小尺寸 MMA 单元的复用要靠软件显式管理存储层次(寄存器分块 → 共享内存 → L2)来”人造”出来。
五个真正的差别
把前面的描述收拢成一张对照表。
| 维度 | Tensor Core(GPU) | 脉动阵列(TPU MXU 类) |
|---|---|---|
| 规模与分布 | 每个 SM 4 个小 MMA 单元,全芯片数百个 | 每核一整块大网格,全芯片数十个 |
| 典型尺寸 | / / | / |
| 操作数来源 | 寄存器 fragment + 共享内存 | 片上 scratchpad(Unified Buffer)直供 |
| 阵列内通信 | 无,各单元独立从寄存器取数 | 相邻 PE 逐拍转发,中间结果不落内存 |
| 控制模型 | SIMT,运行时 warp 调度与延迟隐藏 | 编译期静态调度,几乎无控制逻辑 |
| 形状容忍度 | 高,维度不必对齐 | 低,边长需整除阵列维度 |
| 退化曲线 | 缓坡(batch 小只是效率降低) | 悬崖(不满足前提就整体停顿) |
| 编程门槛 | CUDA / PTX / CUTLASS,生态成熟 | XLA / Pallas / 自研编译器,门槛高 |
| 精度演进 | 每代新增一两种格式 | 通常固定,靠换代更新 |
| 不规则计算 | 由 SIMT 通用通路兜底 | 需专门的向量/标量协处理器分担 |
有三条值得展开。
关于形状容忍度。 一块 的阵列,只有在两个矩阵维度都是 256 的倍数时才能跑满 MAC/周期。更常见的麻烦是注意力头维度:如果 head dim 是 128,那么在 256 宽的阵列上,QK^T 这类矩阵乘的利用率直接顶死在 50%;head dim 是 64 的话只剩 25%。XLA 编译器会把不足的维度补齐到 256,但补出来的那些 PE 那一拍照样在耗电、照样在占周期。反过来,GPU 上的小 tile 拼装对这种形状几乎无感。在 GPU 上只是”超参选择”的东西,在 TPU 上是”直接的吞吐税”。
关于退化曲线。 这个差别经常被总结成一句话:“GPU 是缓坡,TPU 是悬崖”。GPU 靠运行时调度,batch 从 8 掉到 1 只是效率线性下降;TPU 靠编译期确定的静态流水,一旦前提(比如 batch 足够大、能喂饱阵列)不成立,整条流水线会集体停顿。TPU v5e 在 BF16 下大约需要每个 replica 有 240 个 token 才能越过 Roofline 拐点,token 数不够时 MXU 就在等 HBM。
关于不规则计算。 脉动阵列是同步的、规则的网格,天生不适合分支、稀疏、动态索引。所以 TPU 系的设计里一直有配套的协处理器:早期是 VPU(向量处理单元)和标量单元,新一代还加了 SparseCore——一个专门跑嵌入查表、稀疏聚合的数据流处理器,官方口径是同样这些稀疏算子比放在 MXU/VPU 上跑快 5~7 倍,而只占约 5% 的面积和功耗。GPU 这边因为本来就有一整套通用 SIMT 通路,不需要额外设计。
「Tensor Core 内部也是脉动阵列吗」
这是一个很好的追问,答案是:结构上有相似性,但设计约束不同。
相似之处在于,两者都是由大量 MAC 单元 + 加法树构成的规则计算结构,都在用空间换时间。
不同之处在于数据的喂法:脉动阵列的核心特征是邻居之间的逐拍转发(这是它名字的来源,也是它几乎不需要寄存器文件的代价换来的),而 Tensor Core 的操作数是从寄存器文件里取的,单元之间不做数据转发。正因为不需要”逐拍同步”这个约束,Tensor Core 才能以几百个独立小单元的形式散布在各个 SM 里,被 SIMT 调度器灵活驱动。
所以更准确的说法是:Tensor Core 是”小规模、寄存器喂数、由运行时调度”的 MAC 阵列;脉动阵列是”大规模、邻居转发、由编译器调度”的 MAC 阵列。 两者在谱系的两端,中间还有很多混合形态——比如昇腾 Da Vinci AI Core 里的 Cube 单元就是 的三维阵列,规模介于两者之间。
怎么选:把决策变量列出来
面试官问”如何选择”,其实是在看你会不会从约束出发做设计决策,而不是背结论。可用的判断维度有这么几条:
1. 工作负载的形状是否稳定且可对齐? 模型结构固定、维度都是阵列边长的整数倍(或者团队愿意为了对齐去调模型超参),脉动阵列的收益最大。模型结构三个月一变、每来一个新算子就要写新 kernel,GPU 更稳。
2. 规模与部署形态? 单机小批量、边缘设备,看重的是单卡的灵活性和开发效率;万卡集群,看重的是每瓦性能、每美元性能和集群级的确定性——后者正是脉动阵列系(TPU、Trainium/Inferentia)的立足点。
3. 有没有编译器团队? 这是一个很现实的约束。脉动阵列的收益有一半来自编译器——它负责把算子映射成静态数据流、安排 scratchpad 的搬运、做 double buffering。没有这个能力,阵列就是一块跑不动的硅。GPU 侧虽然同样有 tuning 成本,但 CUTLASS、Triton、cuBLAS 这些库把大部分坑填掉了,起步门槛低得多。
4. 稀疏性、不规则性和控制流有多重? MoE 的动态路由、稀疏注意力的动态索引、带分支的采样逻辑,这些都是脉动阵列的天然弱项。GPU 的通用通路能兜底,代价是效率不如专用电路。
5. 精度与格式的演进速度? 模型侧每半年换一种新精度(FP16 → BF16 → FP8 → FP4),GPU 每代 Tensor Core 都会跟进,软件栈也跟得快。脉动阵列的精度通常一次流片就定死了,换代周期以年计。
6. 团队的人力和生态。 这个因素经常被低估,但在真实决策中的权重极高。CUDA 人才池、调试工具、profiling 工具链的成熟度,直接决定项目能不能按期交付。
把这几条收成一句可操作的结论:
通用、多变、需要快速迭代 → GPU / Tensor Core;固定、大规模、愿意为每瓦性能做软硬协同 → 脉动阵列。
而且真实世界的答案通常是混合:绝大多数系统会用 GPU 承担通用计算和快速迭代的部分,把形状已经稳定下来的大块矩阵运算交给专用阵列。
一个典型的混合证据是:即使在 TPU 内部,非矩阵计算(激活、归一化、稀疏查表)也从来不是交给 MXU 做的,而是分给 VPU、标量单元和 SparseCore。脉动阵列从来不是”一块阵列包打天下”,而是一个以阵列为核心、配套多种协处理器的异构系统。 这一点和 GPU 用 SM + Tensor Core + 通用 ALU 组成异构单元,本质上是同一个设计哲学。
这题怎么答才稳
开篇就先消解二元对立——它们在做同一件事,本质都是 MAC 阵列,差别在规模、喂数方式和调度权归属。然后分头讲清两边的结构(Tensor Core 讲小粒度 + 寄存器 fragment + SIMT 调度 + 逐代加精度;脉动阵列讲大网格 + 邻居转发 + weight-stationary + 编译期调度),再用一张表把五个维度对上。选型部分必须从约束出发(形状稳定性、规模、编译器能力、稀疏性、精度演进、团队生态),最后用”TPU 内部也要配 VPU 和 SparseCore”收尾,点明这是一个谱系,不是二选一。
复盘:这组问题在考什么
四道题看起来跨度极大,但如果把它们并排放在一起看,考的是同一种能力:把一件”会用就行”的事,讲到机制层。
- Docker 和 Git 谁都会用,但能讲清命名空间与 cgroup 的边界、快照模型与三区的分工的人不多;
- MXFP4 和 NVFP4 的名字大家都见过,但能说清块缩放为什么有效、E8M0 和 E4M3 差在哪里、哪些张量不能进 FP4 的人不多;
- “算一下吞吐”这个要求不复杂,但能讲清为什么是带宽瓶颈、怎么用 Roofline 验证、batch 变化后会怎样的人不多;
- Tensor Core 和脉动阵列的区别很多人会答”一个英伟达一个谷歌”,能落到复用从哪来、谁负责调度、退化曲线是什么形状的人不多。
把这些补上,靠的不是多看几篇解读,而是遇到每个结论都追问一句”它为什么成立、边界在哪”——这件事对工具链、对数据格式、对硬件参数同样适用。
参考资料
- Pro Git:关于版本控制(集中式 / 分布式 / 本地)
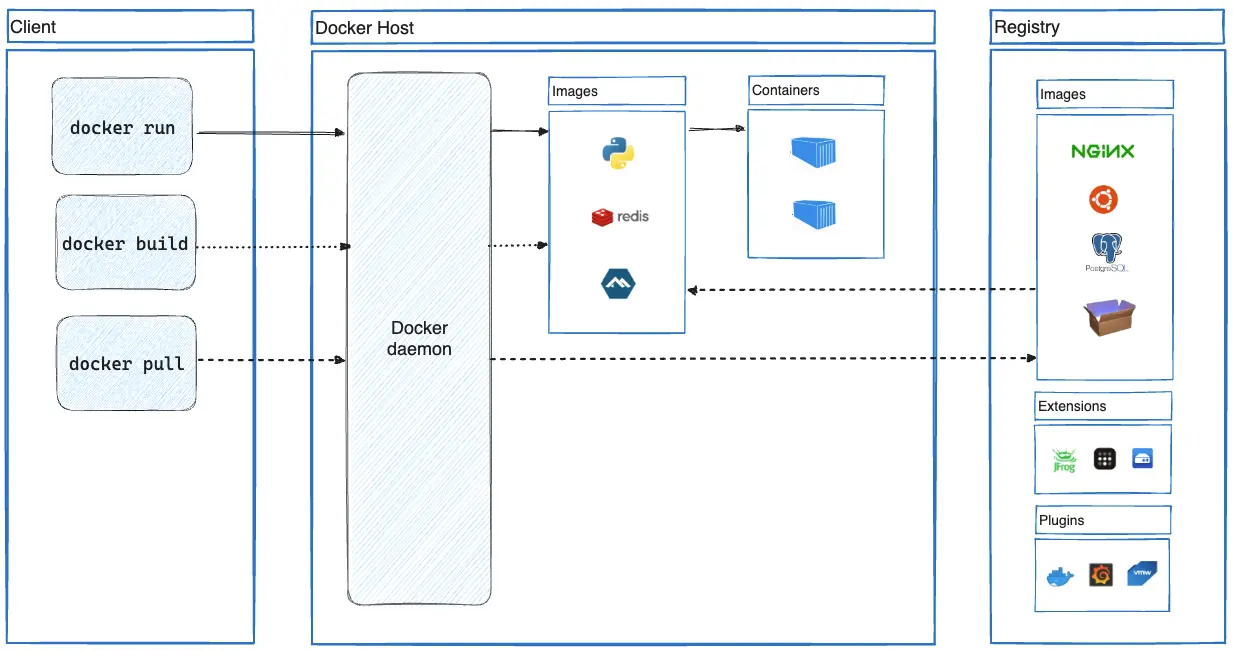
- Docker 官方文档:Docker 概览与架构
- Open Compute Project:Microscaling (MX) Formats Specification
- NVIDIA Technical Blog:Introducing NVFP4 for Efficient and Accurate Low-Precision Inference
- NVIDIA Technical Blog:Train Models Faster with JAX and MaxText Using NVFP4 on NVIDIA Blackwell
- NVIDIA cuDNN Frontend:The 128×4 Tiled Layout for Block Scaling Factors
- vLLM 文档:NVIDIA Model Optimizer 量化(NVFP4 / MXFP8 checkpoint 支持)
- Is Finer Better? The Limits of Microscaling Formats in Large Language Models(ICLR 2026)
- AMD Kria KV260 Vision AI Starter Kit 产品页
- AMD Kria K26 SOM 数据手册(DS987)
- Hugging Face:Qwen2.5-0.5B-Instruct 模型卡与 config.json
- NVIDIA Technical Blog:Programming Tensor Cores in CUDA 9
- Gemmini: Enabling Systematic Deep-Learning Architecture Evaluation via Full-Stack Integration(DAC 2021)
- SCALE-Sim: Systolic CNN Accelerator Simulator
- In-Datacenter Performance Analysis of a Tensor Processing Unit(TPU v1 论文,ISCA 2017)
- Numerical behavior of NVIDIA tensor cores(Fasi 等,PeerJ Computer Science 2021)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


