


KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token
背景:解码是带宽游戏,KV 缓存成了新的瓶颈
大语言模型的在线服务要控制成本,核心手段是把大量请求合并成 batch 一起跑,让一次前向同时服务很多人。但这个策略会撞上一堵墙:KV 缓存(KV cache)。自回归生成把每一层注意力算过的 Key 和 Value 存下来供后续 token 复用,这些缓存的总内存随 batch 大小和上下文长度线性增长:
其中 是层数, 是 KV 头数, 是每头维度, 是序列长度, 是每元素字节数,系数 2 代表 Key 与 Value 各一份。以 Llama-2-7B(32 层、MHA 32 个 KV 头、头维 128、FP16)为例,每新增一个 token 的 KV 状态是 字节,即 512 KB。单条 4K 上下文占 2 GB,batch 16 就是 32 GB——7B 模型 FP16 权重本身不过约 14 GB。KIVI 论文引言里引用了两个更夸张的例子:540B PaLM 在 batch 512、上下文 2048 时 KV 缓存达到 3 TB,是模型参数的三倍;OPT-175B 在 batch 512、prompt 512、输出 32 的负载下 KV 缓存要 1.2 TB,是权重的 3.8 倍。KV 缓存取代权重成为显存主体,是大 batch 长上下文服务绕不开的事实。
KV 缓存庞大带来的第二个问题在带宽。解码阶段每生成一个 token,都要把所有注意力头的全部历史 Key/Value 从 HBM 读回 SRAM 做点积,计算本身是矩阵乘、数值量很小,芯片绝大部分时间在等内存搬运——论文里说得很直白:加载 KV 缓存的过程中计算核心是闲置的(computational core is idle)。因此压缩 KV 缓存有两份收益:显存省下来可以塞更大的 batch,字节少了每步解码要搬的数据也少。量化是这两份收益通吃的手段:KV 缓存每个元素从 2 字节降到 0.25 字节(2 bit),内存和带宽一起降。
但在 2024 年初,KV 缓存的量化远没有权重量化成熟。论文梳理了当时的三条既有路线:
- 少头化:MQA/GQA 通过共享 KV 头把缓存按头数压缩(GQA 的机制可以参考本站 GQA 完全拆解),但需要从零训练或微调,动不了现成模型;
- 淘汰:H2O、StreamingLLM 这类方法按重要度丢掉一部分 token 的 KV(详见 QEvict 完全拆解 中对两条路线的梳理),会永久丢失信息,长上下文检索类任务容易受伤;
- 系统层:PagedAttention 的分页与虚拟内存(PagedAttention 完全拆解)、KV 缓存 offload 到 CPU/磁盘,解决的是”怎么管理”而非”怎么变小”。
至于量化,当时只有 FlexGen 等工作对 KV 缓存做过朴素的 4-bit 均匀量化(per-token),没有人系统研究过一个基本问题:KV 缓存里的元素到底长什么样、按哪个方向分组量化误差最小? GPTQ 那类基于二阶信息、需要反复扫描数据的优化式量化也无法用在 KV 上——KV 缓存是流式结构,每步只新增一行,不可能等全局最优后再推理。
KIVI 就是来补这个空白的。它由莱斯大学、德州农工、史蒂文斯理工与 CMU 的研究者合作完成(一作刘子瑞与袁佳一),2024 年 2 月 5 日发布在 arXiv(编号 2402.02750),同年被 ICML 2024 接收,代码开源在 github.com/jy-yuan/KIVI。论文先做了详尽的 KV 缓存元素分布诊断,再给出一个免微调、即插即用的 2-bit 量化方案:Key 按通道(per-channel)量化,Value 按 token(per-token)量化,中间用一个 FP16 精度的残差滑动窗口解决流式量化的工程难题。结果是在 Llama-2、Falcon、Mistral 上几乎无损地把 KV 缓存压到 2 bit,峰值显存(含权重)最多降低 2.6 倍,同样的显存下能塞最多 4 倍大的 batch,真实推理负载吞吐提升 2.35–3.47 倍。
量化方向的定义:per-token 与 per-channel
先把概念说清楚。KV 缓存是一个形状为 的矩阵( 个 token、 个通道,论文记为 )。做整数量化时,我们维护一个缩放因子 (scale)和一个零点 (zero-point),把连续值映射到 个整数电平:
时只有 4 个电平,量程 被 等分, 越大、每个电平覆盖的数值范围越宽,舍入误差越大。所以 scale 的取值方式直接决定误差:一个 的矩阵可以整体共用一个 scale(per-tensor),也可以拆成小组各自统计。KIVI 关心的分组方式有两种,差别在于切矩阵的方向:
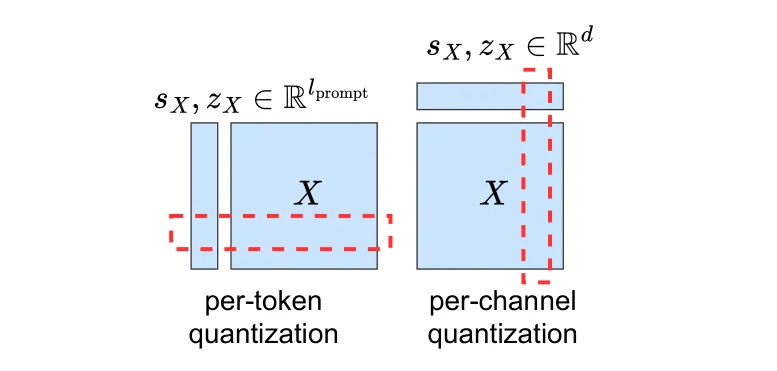
上图是论文 Figure 1 的示意图。per-token 量化沿着 token 方向给每一行(token)独立的 scale 与 zero-point,也就是”一个 token 的所有通道共用一组量化参数”;per-channel 量化沿着通道方向给每一列(通道)独立的 scale 与 zero-point,也就是”一个通道跨所有 token 共用一组量化参数”。图中的 、 分别就是按行或按列排布的零点与缩放向量。直觉上:同一组内的元素共享参数,组内幅值越接近,量化越精细;如果一组里混进了几个大数,scale 被撑大,其他成员的电平分辨率全部被稀释。
注意”按行共参数”与”按列共参数”的选择对 KV 缓存是流式不友好的,这一点后面设计部分会展开。先看论文做的最关键一步:用四种组合方式做”假量化”实验(fake quantization,即先把 KV 量化到低精度再反量化回 FP16 参与注意力计算,模拟真实效果),在 Llama-2-13B 上扫了一遍 CoQA 与 TruthfulQA:
| 配置(Llama-2-13B,组大小 32) | CoQA | TruthfulQA |
|---|---|---|
| 16 bit(FP16 基线) | 66.37 | 29.53 |
| 2 bit(K per-token,V per-token) | 52.93 | 24.98 |
| 2 bit(K per-channel,V per-channel) | 2.88 | 0.74 |
| 2 bit(K per-token,V per-channel) | 2.80 | 0.26 |
| 2 bit(K per-channel,V per-token) | 63.53 | 28.60 |
(上表为论文 Table 1,组大小统一 32。CoQA 是抽取式问答、按精确匹配计分,TruthfulQA 按 BLEU 计分,分数越高越好。)
这张表信息量很大,论文把它归纳成三个观察:
- 观察一(OB1):K、V 都按 per-token 量化时,4 bit 还能保持精度,降到 2 bit 明显掉点(CoQA 66.37 → 52.93)。per-token 是当时的主流做法(新 token 到了直接追加一行量化结果,流式友好),但它经不起 2 bit 的考验;
- 观察二(OB2):只要 Value 用了 per-channel,无论 Key 怎么量化,分数直接崩盘(2.88 和 2.80,接近随机水平)——Value 的 per-channel 量化是灾难性的;
- 观察三(OB3):2 bit 下唯一接近无损的组合是 Key per-channel、Value per-token(63.53 vs 基线 66.37)。
换句话说,Key 和 Value 对量化方向的偏好是对称反转的。为什么?论文紧接着给出了分布层面的证据和误差分析。
分布证据:Key 有”固定离群通道”,Value 没有
先看 KV 缓存本身的数值分布。论文在 Llama-2-13B 和 Falcon-7B 的多个层与头上逐 token、逐通道统计了幅值:
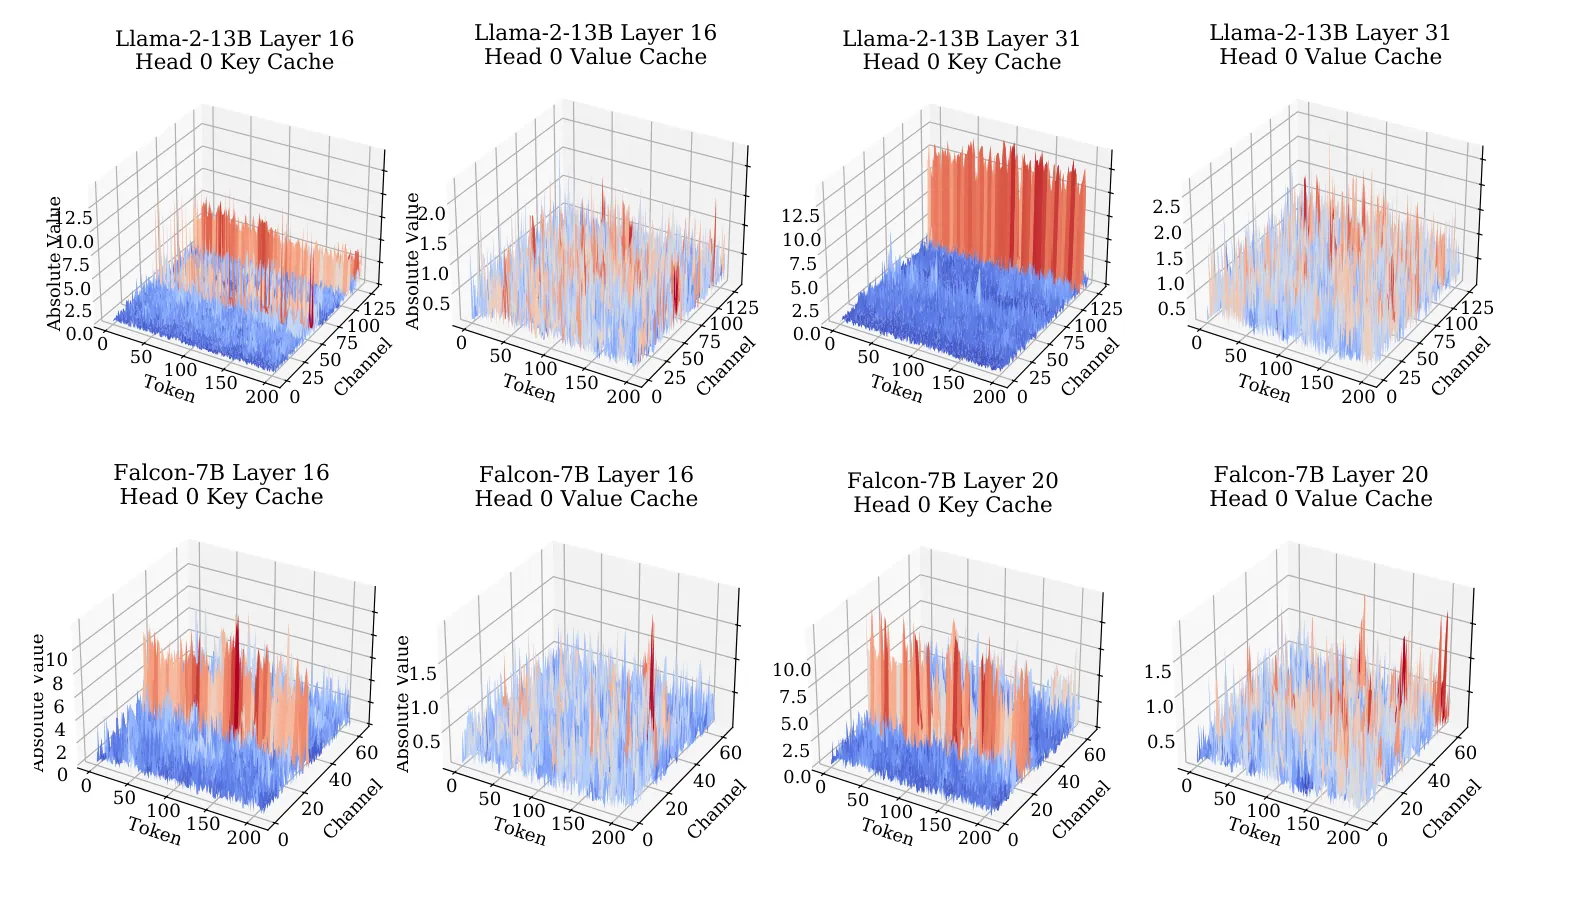
横轴是 token 序号,纵轴是通道序号,颜色代表绝对值大小。两个结论一目了然:
- Key 缓存存在少数幅值极大的固定通道:某些通道在所有 token 上都是”离群值”,普通通道始终普通。这个现象并不陌生——它和 LLM 激活里的系统性离群值一脉相承(LLM.int8() 的发现,SmoothQuant 里也专门分析过:离群只出现在少数通道、且跨 token 稳定)。Key 由激活乘投影矩阵 得到,论文指出这种”固定离群列”的模式与此前在激活中观察到的现象一致;
- Value 缓存没有明显的离群模式:分布相对均匀,看不出固定的热点通道或热点 token。
这两个分布事实直接解释了量化方向的胜负。假设某个通道 的幅值是其他通道的几十倍:按 per-token 量化时, 会把这个 token 的 scale 撑大几十倍,其余正常通道被迫用极粗的量化步长,相当于电平被”挤”没了——这和 SmoothQuant 论文里 per-tensor 量化被激活离群值毁掉是同一个机制(离群通道把整个量化范围拉大后,普通通道的有效电平只剩两三个)。而按 per-channel 量化时,离群通道自己用自己的大 scale,误差只留在它自己身上,不会溢出污染其他通道。
那 Value 为什么反而要 per-token?单看分布解释不了:Value 没有离群结构,按分布推 per-token 与 per-channel 的重建误差应该差不多。答案藏在 Value 参与计算的路径里,下面用误差分析说清楚。
为什么必须非对称:误差端到端放大的两条路径
注意力输出有两步计算:先算 logits(,再 softmax),再用 logits 对 Value 做加权求和。Key 和 Value 的量化误差正是从这两步分别进入最终结果的,论文对每一步都量了”相对误差”(重建误差与端到端误差,Llama-2-13B 上平均所有层与所有头,2 bit):
| 指标 | Key per-token | Key per-channel | Value per-token | Value per-channel |
|---|---|---|---|---|
| KV 矩阵重建误差(%) | 13.67 | 4.55 | 4.57 | 3.73 |
| 端到端误差(%) | 47.00 | 9.60 | 3.55 | 49.89 |
(论文 Table 2。端到端误差对 Key 指注意力 logits 的相对误差 ,对 Value 指注意力输出的相对误差。)
先看 Key 这一列。per-channel 相比 per-token,重建误差从 13.67 降到 4.55,而端到端 logits 误差从 47.00 降到 9.60,约 5 倍差距。原因就是上节说的离群通道:Key 的误差会先被 query 点积、再被 softmax 指数放大,per-token 方案把通道间的尺度差异转成了同尺度下的量化噪声,误差没有地方消化;per-channel 把每个通道的误差封在自己通道内部,其他通道的 logits 保持精确。需要留意的是,即便 per-channel,logits 的相对误差也有 9.6%,2-bit 量化能在端到端上几乎无损,说明注意力对 logits 的噪声相当鲁棒(softmax 之后相对大小比绝对大小重要),这也是 KV 量化敢压到 2 bit 的信心来源。
Value 这边的情况完全反过来。per-token 与 per-channel 的重建误差几乎一样(4.57 vs 3.73,per-channel 甚至略好),但端到端的注意力输出误差差了约 14 倍:per-token 只有 3.55%,per-channel 高达 49.89%。论文给出的解释紧扣注意力输出的定义。设注意力分数矩阵为 ,注意力输出是 Value 各行的加权和:
即输出 = 以注意力分数为权重、对所有 token 的 Value 行做加权平均。关键事实是注意力分数高度稀疏——论文在同一组统计里测到 Llama-2-13B 的平均注意力稀疏度高达 84.3%,意味着每个输出位置真正依赖的只有少数几个 token。于是:
- per-token 量化把误差限制在单个 token 内部:量化某个不重要的 token,只会轻微污染它的那一份 Value,而它本来在加权和里的权重就小;重要 token 自己的 Value 是全精度的,主导输出的那几项不受影响;
- per-channel 量化把误差摊在每一个 token 上:每个通道的 scale 跨所有 token 共享,单个 token 的误差会沿通道方向”传染”给所有 token 的该项,重要 token 也无法幸免——加权和把误差按各自权重叠加,最终误差被放大到 49.89%。
一句话总结不对称性的本质:Key 的误差被通道维的尺度差异放大,要按通道隔离;Value 的误差被注意力稀疏性”加权”,要按 token 隔离。 方向选错,2 bit 直接不可用;方向选对,两个 2 bit 都能接近无损。
(一个有趣的旁证是 Falcon-7B:它是 MQA 架构,KV 只有 1 个头,通道数少,Value 的 per-channel 分组粒度很粗,表里(论文 Table 3)V per-channel 的崩溃没有那么彻底——但最佳组合仍然是 K per-channel、V per-token。后面实验部分还会看到 Falcon 的其他特殊性。)
核心设计:分组量化 + FP16 残差滑动窗口
分布和误差分析给出了目标配置:Key 按通道、Value 按 token,都压到 2 bit。但把方案落到流式推理上,立刻撞上一个工程矛盾:
per-token 量化是流式友好的——新 token 的 Key/Value 算好后,整行量化,直接按 token 维追加到已量化的缓存尾部;per-channel 量化却要求统计跨 token 的幅值范围——而自回归解码每一步只产生一行新数据,永远凑不齐”一个通道的完整统计”。
KIVI 的解法是把 Key 缓存拆成两段:分组量化部分(grouped)+ 残差部分(residual)。设当前序列长度为 ,残差长度为 :
其中 是前面的 行(恰好能被组大小 整除),按 G 个连续 token 一组做 per-channel 量化后存储为低比特; 是最近 个 token,保持 FP16 全精度。解码时,每个新到的 key 先以全精度追加进残差:
一旦残差长度达到预设阈值 (残差长度,residual length,论文实验里取 128),就把整个残差块量化、拼到 grouped 缓存的尾部,然后清空残差重新累积。Value 侧完全对称:grouped 部分按 per-token 量化,尾部同样维护一个最多 行的 FP16 窗口,超了就整体量化合并。计算注意力时,grouped 与 residual 两段分开算 logits 再拼接(论文公式 (3), 表示量化后的矩阵):
伪代码如下(论文 Algorithm 1 的简化版):
参数:组大小 G,残差长度 R(R 能被 G 整除)
Prefill(输入 X ∈ R^{l×d}): X_K = X·W_K, X_V = X·W_V # 本层算出完整 K/V X_Kg = X_K[: l−R], X_Kr = X_K[l−R:] # 尾部 R 行留全精度 X_Vg = X_V[: l−R], X_Vr = X_V[l−R:] Q(X_Kg) ← KeyQuant(X_Kg) # 按通道量化,G 个 token 一组 Q(X_Vg) ← ValueQuant(X_Vg) # 按 token 量化 缓存 ← Q(X_Kg), X_Kr, Q(X_Vg), X_Vr return X_K, X_V # 本层前向仍用精确值传给下一层
Decoding(新 token t ∈ R^{1×d}): t_K = t·W_K, t_V = t·W_V X_Kr ← X_Kr ∥ t_K # 全精度入残差 X_Vr ← X_Vr ∥ t_V if len(X_Kr) == R: # 残差攒满一组 Q(X_Kr) ← KeyQuant(X_Kr) # 整体量化 Q(X_Kg) ← Q(X_Kg) ∥ Q(X_Kr) # 拼到 grouped 尾部 X_Kr ← 空 if len(X_Vr) > R: # Value 窗口队尾溢出 Q(X_Vr') ← ValueQuant(X_Vr[:-R]) Q(X_Vg) ← Q(X_Vg) ∥ Q(X_Vr') X_Vr ← X_Vr[-R:] A ← Concat([t_Q·Q(X_Kg)ᵀ, t_Q·X_Krᵀ]) # 量化段 + 全精度段 A_g ← Softmax(A)[: −R], A_r ← Softmax(A)[−R:] # 分段 softmax t_O ← A_g·Q(X_Vg) + A_r·X_Vr # 输出 = 量化段 + 残差段 返回 t_O注意一个细节:Prefill 阶段虽然存进缓存的是量化结果,但算到下一层时仍然使用精确的 FP16 K/V。也就是说量化只发生在”写入缓存”这一个动作里,模型前向本身全程精确,只有后续解码读缓存时才读到量化值——这正是它免微调、即插即用的原因。
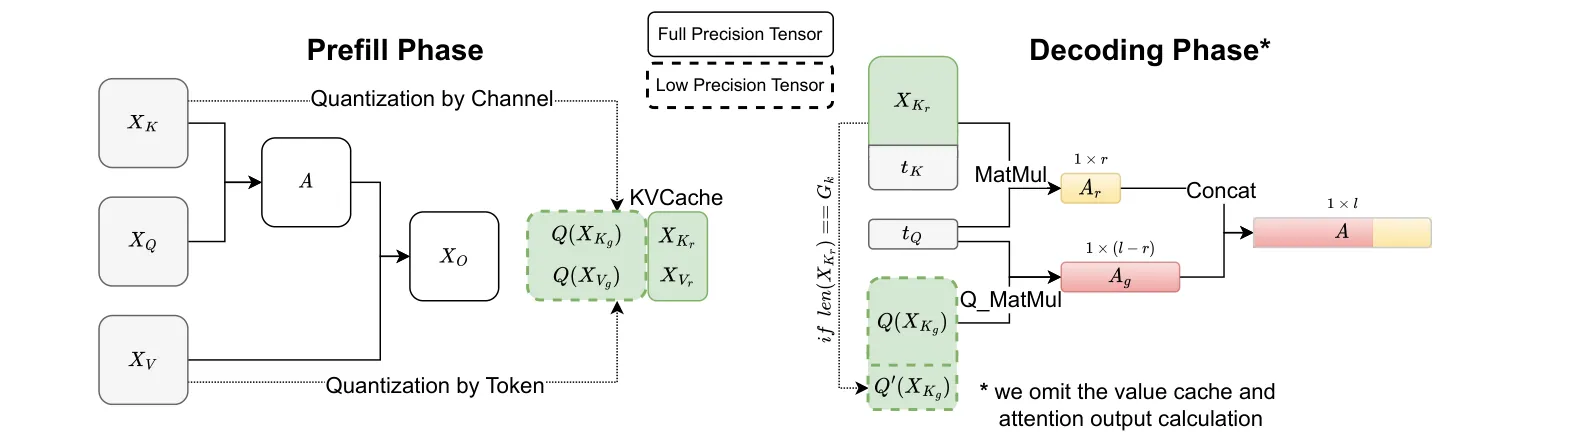
上图画的就是这个流程:蓝色块是低精度张量,绿色块是全精度张量;“Quantization by Channel” 管 Key,“Quantization by Token” 管 Value;attention 计算用融合反量化的 Q_MatMul 分别处理两段。图中省略了 Value 缓存与注意力输出,机制和 Key 完全镜像。
两个设计决策值得展开解释”为什么”:
为什么保留 FP16 残差窗口,而不是全部量化? 三方面理由。第一,per-channel 量化需要攒够 个 token 才能算一次 scale,新到的行天然要在全精度缓冲里等一等——残差是流式约束的必然产物。第二,解码生成对最近的上下文最敏感(本地上下文是生成质量的主要依赖),这段恰好就是残差窗口覆盖的范围,让它们保持全精度等于给”最重要的缓存”开了特权通道。第三是实验证据:对比论文 Table 3 里”假量化”(所有 token 一律量化,无残差)与真实 KIVI 在 GSM8K 上的表现——Llama-2-13B 上假量化 2 bit(K per-channel、V per-token)只有 12.21,KIVI-2 拿到 20.77(FP16 基线 22.67);Mistral-7B 上更夸张,26.46 → 36.01(基线 38.36)。GSM8K 这类多步数学推理对中间步骤的 KV 精度极其敏感,是全精度滑动窗口救回来的。论文明确说,这个窗口对 GSM8K 这类硬任务不可或缺。
为什么残差长度取 128、组大小取 32? 论文实验统一用 、( 必须能被 整除)。128 个全精度 token 在 4096 长度上下文里只占约 3% 的开销,却在长上下文下几乎不损失压缩收益;消融实验(Table 5)显示 与 64 效果相当, 精度明显下降——因为每个量化组的 token 越多,组内幅值差异越大,per-channel scale 越难照顾全局; 从 32 到 128 之间没有单调规律(32→20.62、64→19.86、96→20.55、128→20.77),说明只要窗口”够用”,具体大小不敏感,论文的建议是留一个合理偏大的值。
最后算一笔内存账:2 bit 原始数据是每元素 0.25 字节,但每组的 scale 与 zero-point(各 2 字节 FP16)还要摊进去。组大小 32 时每 32 个元素摊 4 字节,等效每元素约 0.375 字节(3 bit),相对 FP16 仍是约 5.3 倍压缩;残差窗口在长序列下占比很小。论文实测(Llama-2-7B,Figure 5 的负载)峰值显存含权重在内最多降 2.6 倍——注意这是含权重的口径,KV 占比越高压缩收益越接近理论值。
工程实现:把反量化融进矩阵乘
算法之外,KIVI 还提供了一套 CUDA/Triton 实现,让 2 bit KV 缓存真正跑起来而不是停留在仿真里:
- Q_MatMul(混合精度矩阵乘):朴素做法是每次把量化缓存反量化回 FP16 再做矩阵乘,凭空多一次全量读-写。KIVI 在 tile 粒度把反量化融合进矩阵乘:加载 INT2 块后就地解码成 FP16 片段直接参与计算,避免中间张量落回 HBM。前面 Figure 3 里的 “Q_MatMul” 就是这个 kernel;
- 分组量化 kernel 用 Triton 实现,负责流式地把新残差块量化并入缓存;
- 与权重量化正交:KIVI 只动 KV 缓存,模型权重可以是 FP16,也可以叠加 GPTQ/AWQ 等任意 weight-only 量化(论文把 GPTQ、AWQ、SqueezeLLM 列为可组合对象)。站内对这两类方法的机制都有完整拆解:GPTQ 与 AWQ;
- 可配置位宽:代码里 Key 与 Value 的位宽独立可配(2/4 bit),配合 group_size 与 residual_length 两个超参,一行 config 即可开启;
- 论文初版基于 Llama/Falcon/Mistral(MHA/MQA),仓库 在 2025 年初补充了 GQA 支持(兼容 Llama-3 家族),论文 v2 也补上了 Llama-3-8B、Mistral-7B-Instruct-v0.2 的实验;仓库记录还显示 2024 年 6 月 Hugging Face Transformers 官方的 KV cache 量化功能即受 KIVI 启发。
顺带一提实现上的一个坑:注意力要按”量化段 + 残差段”分两段计算 logits,softmax 必须在拼接后的完整 logits 上做、再按段切开,否则两段的归一化分母不一致(伪代码里 A_g ← Softmax(A)[:−R] 这一步),段内数值会整体失真。这是”分段计算但整体归一化”的经典细节。
实验:几乎无损的 2 bit 与翻倍的吞吐
精度:生成任务与长上下文基准
论文在 Llama-2-7B/13B、Falcon-7B、Mistral-7B 上用 LM-Eval 的三个生成任务(CoQA、TruthfulQA、GSM8K)和 LongBench 做评估。生成类任务一次解码几十上百步,KV 误差有累积机会,比单步分类任务更能暴露问题(论文特意指出 MMLU 这类闭卷题只解码一步,不适合评估 KV 压缩)。主要结果如下(论文 Table 3 摘录):
| 模型 | 配置 | CoQA | TruthfulQA | GSM8K |
|---|---|---|---|---|
| Llama-2-7B | FP16 基线 | 63.88 | 30.76 | 13.50 |
| Llama-2-7B | 假量化 2bit(K per-channel, V per-token) | 59.08 | 33.10 | 5.76 |
| Llama-2-7B | KIVI-2 | 63.05 | 33.95 | 12.74 |
| Llama-2-13B | FP16 基线 | 66.37 | 29.53 | 22.67 |
| Llama-2-13B | 假量化 2bit(K per-channel, V per-token) | 63.53 | 28.60 | 12.21 |
| Llama-2-13B | KIVI-2 | 66.23 | 29.84 | 20.77 |
| Mistral-7B | FP16 基线 | 67.40 | 30.45 | 38.36 |
| Mistral-7B | KIVI-2 | 66.35 | 32.17 | 36.01 |
| Falcon-7B | FP16 基线 | 59.83 | 23.20 | 4.55 |
| Falcon-7B | KIVI-2 | 57.48 | 24.98 | 3.41 |
两个看点。第一,KIVI-2 相对 FP16 掉点普遍在 1–2 分以内(Llama-2-7B GSM8K 12.74 vs 13.50,Mistral 36.01 vs 38.36),部分任务甚至反超基线(7B/13B 的 TruthfulQA)——噪声水平之内;KIVI-4 则几乎完全重合基线。第二,注意”假量化”行与 KIVI-2 行的差距:同样的量化配置,假量化在 GSM8K 上掉了 7 分以上,KIVI-2 只掉不到 2 分——全部差在 FP16 残差窗口上,这正是上一节强调的窗口价值,也是”免调优 2-bit”能成立的工程关键。
LongBench 长上下文评测(Table 4,8 个任务的平均分)同样平稳:Llama-2-7B 44.52 → 44.27(KIVI-2),Llama-2-13B 44.85 → 44.69,Llama-2-7B-Chat 45.95 → 45.67,Mistral-7B 46.58 → 45.85,KIVI-4 则几乎零损失(如 Llama-2-13B-Chat 45.96 → 46.44,还略高)。论文 v2 扩充的 Llama-3-8B-Instruct(GQA、8K 上下文)、Mistral-7B-Instruct-v0.2(32K)与 LongChat-7B-v1.5-32K 在 LongBench 全 16 任务上的平均掉点也最多只有 1 分出头(KIVI-4 则几乎零损失)。Falcon-7B 是唯一的例外:它是 MQA(只有 1 个 KV 头),KV 缓存本来就比其他模型小一个量级,压缩空间小、且单头缓存承载的信息密度高,2 bit 掉点明显(LongBench 8.71 → 7.95),论文建议这类模型用 KIVI-4。
长上下文还有一个更直观的检验:大海捞针(Needle-in-a-Haystack)——把一句指定的话藏在长文本的不同深度,问模型能否原样取回。论文 v2 在 Llama-3-8B-Instruct 与 Mistral-7B-Instruct-v0.2 上把序列一直拉到 20K 词:
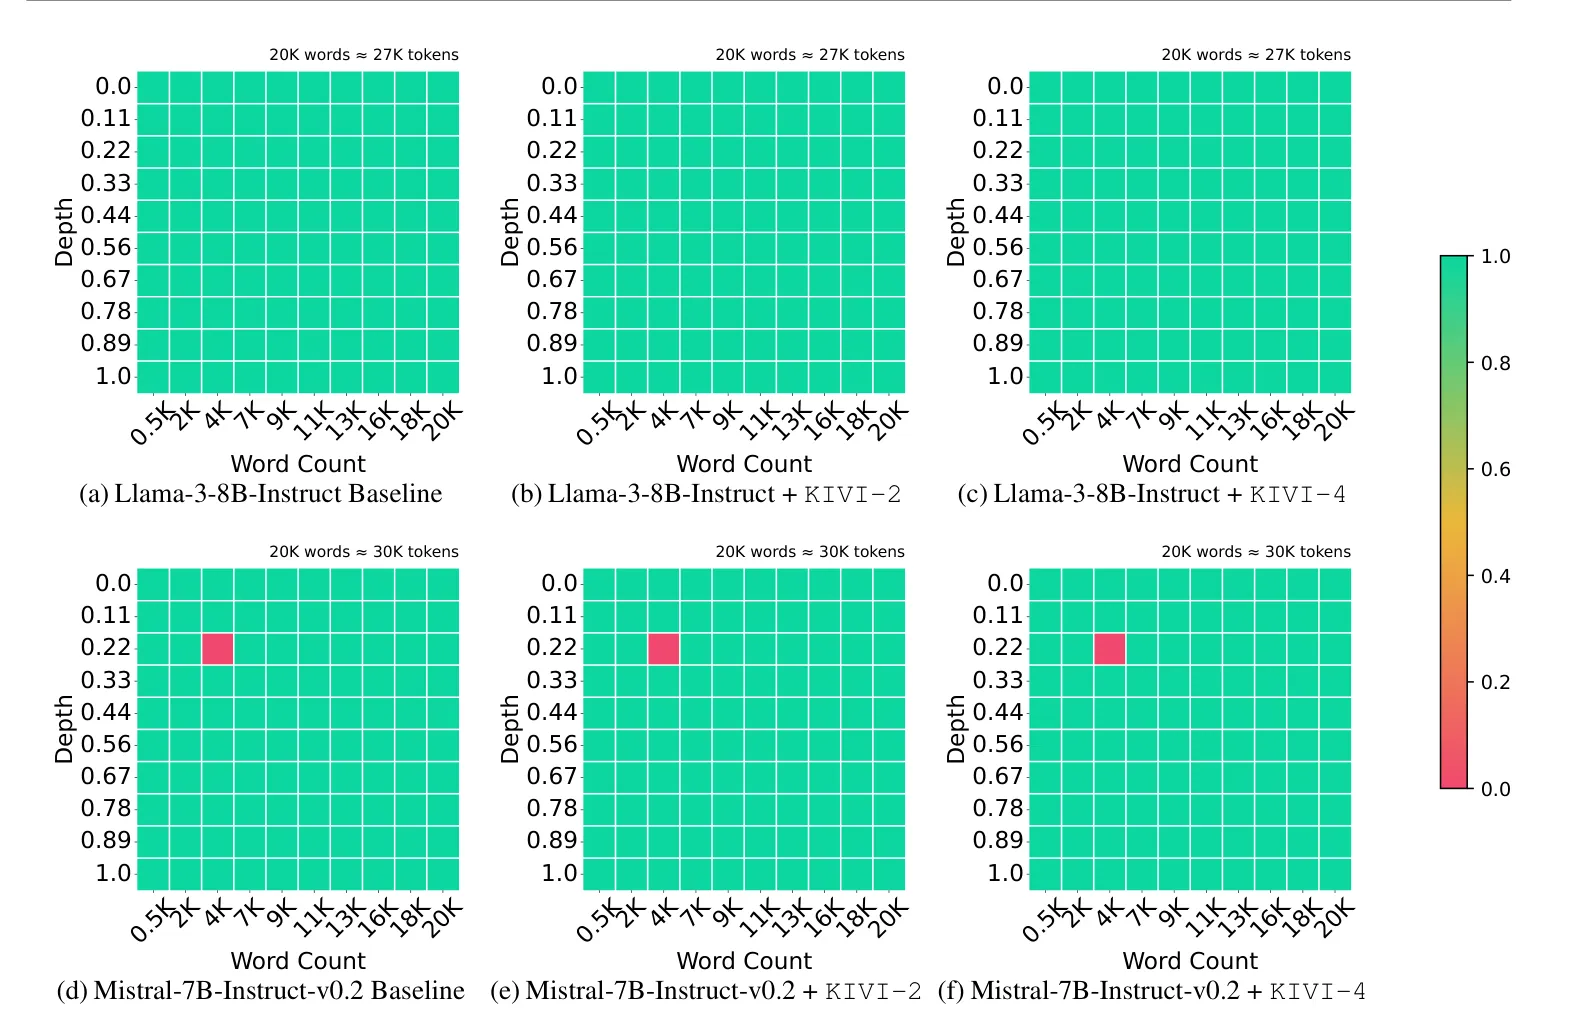
上图 6 个小图中,基线、KIVI-2、KIVI-4 三行几乎看不出区别,说明 2 bit KV 没有破坏模型把信息”钉在”长序列某处再取回的能力。两套模型都测到 20K 词的最长序列(约 2.7 万至 3 万 token,右上角标注略有差异)。仓库里还提供了一个 5 位数字 passkey 的 12K 上下文示例作为最小复现。
吞吐与显存:batch 上限翻倍
效率实验在单张 A100-80GB 上进行,负载参照 vLLM 用 ShareGPT 真实对话合成(平均输入 161 token、输出 338 token),不断加大 batch 直到显存溢出,对比 FP16 基线:
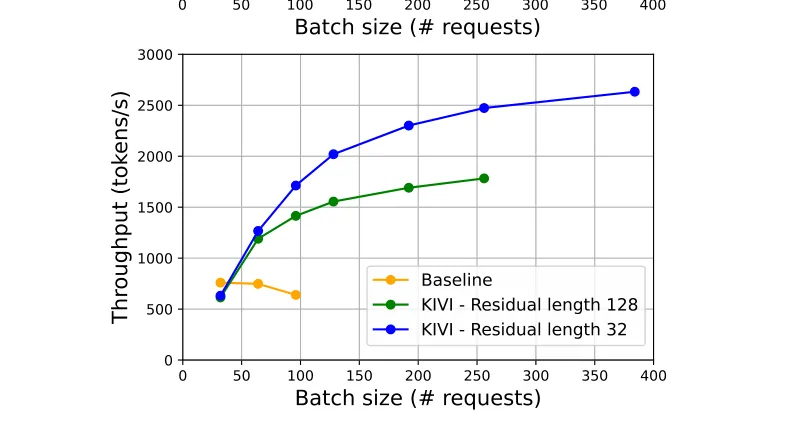
具体数字(论文正文与摘要口径):峰值显存(含权重)最多降 2.6 倍;同等显存预算下 batch 上限最多放大 4 倍;端到端吞吐提升 2.35–3.47 倍。吞吐收益的来源要拆成两层看:一是 KV 每元素从 2 字节降到约 0.375 字节后,每步解码从 HBM 读回的字节数按比例减少,带宽瓶颈环节直接受益;二是省下的显存换成更大的 batch,把 GPU 利用率与算术强度一起拉高——长上下文、长输出的负载下这两层收益都会继续放大。图里同时画了残差长度 32 与 128 两个版本,说明窗口大小对效率的影响很小。
局限与后续演进
KIVI 奠定了”KV 缓存量化”这条技术路线的基本盘,但它的局限同样清楚:
- 2 bit 是”近无损”而非严格无损:常规生成任务掉点 1–2 分,硬任务(GSM8K 多步推理)必须依赖 FP16 残差窗口兜底;窗口一旦缩小,精度立刻向假量化水平滑落;
- 对 KV 本就很小的模型收益打折:MQA/小 KV 模型上 2 bit 精度吃紧,论文的建议是退到 4 bit(KIVI-4);
- 量化的统计只在缓存写入时做一次,与层间其他算子的融合不彻底:论文在 Future Work 里明确写,若把量化过程进一步融合进前面的算子(如 RMSNorm、RoPE),提速还会更大——这也意味着 KV 量化要和注意力 kernel 深度耦合,框架落地成本不低;
- 没有考虑 RoPE 对 Key 分布的影响:Key 的离群通道结构在旋转位置编码之后会被削弱(RoPE 每两个通道一组旋转,把幅值打散到更多通道上)。KIVI 直接量化 RoPE 之后的缓存还能工作,但这是它”运气好”的部分——后续工作正是在这点上找到了改进空间。
与 KIVI 几乎同时独立出现的 KVQuant(2024 年 1 月底上 arXiv,发表于 NeurIPS 2024)把这条路推得更远。它在 KIVI 的框架上做了四点升级:量化施加在 RoPE 之前的 Key 上(避开旋转对离群结构的破坏);用校准集为每层学一个非均匀量化电平(NUQ,按层敏感度而非幅值布点);把约 1% 的极端离群值分离成稀疏表示与低比特稠密矩阵并存(dense-and-sparse);再叠一个 Q-Norm 把反量化后的分布拉回 FP16 的均值方差。结果把无损线推到了 3 bit(困惑度下降 < 0.1),KV 内存缩减 4.8 倍,并演示了单张 A100-80GB 跑 1M 上下文、8 卡系统逼近 10M 上下文。对比着看:KIVI 证明”方向选对、2 bit 可行”,KVQuant 则说明”方向之外,RoPE、离群值与量化电平分布都是可以再榨的维度”。
放到更大的图景里,KV 缓存的压缩有淘汰、量化、低秩三大家族(MLA 的低秩压缩是另一条路线),量化是最”信息无损”的一支——它不丢任何 token,只是降低每个 token 的表示精度。它与 PagedAttention 这类内存管理(怎么分配)、H2O/QEvict 这类淘汰(丢哪些 token)在原理上正交,实际系统(vLLM 等)也确实在把”分页 + 量化 + 淘汰”逐层叠加。KIVI 作为量化路线的源头工作,其价值不止于 2.6 倍显存:它示范了”先诊断数据分布、再决定压缩策略”的研究范式——KV 缓存不是一坨均匀的 FP16 张量,Key 和 Value 的统计特性不同,最优压缩方案就该不同。
小结
KIVI 用一次系统的分布诊断回答了一个此前没人认真回答的问题:KV 缓存压缩到 2 bit,误差从哪里来、怎么分组才能压住它?答案是 Key 有跨 token 稳定的离群通道,必须按通道量化把误差封死在单通道内;Value 没有离群结构,但它的误差经过稀疏注意力加权会被放大或隔离,必须按 token 量化。这个”非对称”配置在 Llama、Mistral、Falcon 上都经得起 2 bit 的考验。工程上,KIVI 用”G token 一组 + R 行 FP16 残差滑动窗口”化解了 per-channel 量化与流式解码的矛盾,并用融合反量化的矩阵乘 kernel 把方案落到了可用的速度上,最终换来含权重 2.6 倍峰值显存下降、最多 4 倍 batch 上限和 2.35–3.47 倍真实负载吞吐——而这一切不需要任何微调。理解了 KIVI,也就理解了此后 KV 量化文献(KVQuant、WKVQuant 及其后继)的坐标系:方向怎么选、窗口留多长、RoPE 前后在哪里下手、离群值怎么单独处理,都是在 KIVI 这张画布上继续画。
参考资料
- KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache(arXiv 论文,v1 2024-02-05,ICML 2024)
- KIVI(ICML 2024 Proceedings PMLR v235)
- KIVI 官方代码仓库(GitHub)
- KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization(arXiv)
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(arXiv)
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale(arXiv)
- LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding(arXiv)
- Efficient Memory Management for Large Language Model Serving with PagedAttention(arXiv)
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models(arXiv)
- StreamingLLM: Efficient Streaming Language Models with Attention Sinks(arXiv)
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints(arXiv)
- LLM 系列:KVCache 量化(掘金技术社区解读)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


