


KVQuant 完全拆解:预旋转逐通道量化、敏感度加权非均匀码本与稀疏离群值,3-bit KV Cache 如何近无损(NeurIPS 2024)
KVQuant(论文全名 “Towards 10 Million Context Length LLM Inference with KV Cache Quantization”)由 UC Berkeley SkyLab 团队的 Coleman Hooper、Sehoon Kim、Amir Gholami 等人完成,2024 年 1 月投至 arXiv(编号 2401.18079),2024 年 12 月发表于 NeurIPS 2024。它与我们之前拆解过的 KIVI(ICML 2024)几乎同期出现,同属「KV Cache 量化」这条经典技术线:KIVI 回答了沿着哪个轴量化(Key 按通道、Value 按 token),KVQuant 则进一步回答了用什么量化器(非均匀码本)、在什么状态下量化(RoPE 之前)以及怎么处理离群值(逐向量隔离),把 KV Cache 量化从「4-bit 勉强可用」推进到「3-bit 全模型家族困惑度退化小于 0.1」,并宣称让 LLaMA-7B 的上下文长度在单张 A100-80GB 上跑到 1M、在 8 卡系统上跑到 10M。这篇经典此后成了 KV Cache 量化方向几乎所有后续工作的对照基线,值得彻底拆解。
内存墙背景:长上下文的 KV Cache 为什么必须压缩
解码器(decoder-only)结构的 Transformer 在推理时分成两个阶段。Prefill(预填充)阶段一次性并行处理整个输入 prompt,把每个 token 的注意力中间结果 Key 和 Value 算出来;之后进入逐 token 自回归生成阶段,每个新 token 都要与历史上所有 token 做注意力。如果不把历史 Key/Value 存下来,每个新 token 都得重算全部历史,代价不可接受,所以推理引擎会为每个序列维护一份逐层缓存的 Key/Value 张量,这就是 KV Cache(键值缓存)。
KV Cache 的大小有个非常直白的公式:设模型有 层、每层 个注意力头、头维度 、每个元素占 字节(fp16 时 ),批量大小为 、序列长度为 ,则
系数 2 来自 Key 和 Value 各一份。对 LLaMA-7B(,,,fp16),单个 token 的 KV Cache 就是 字节,约 512 KB——序列长度 128K 时仅 KV Cache 就高达 64 GB,超过 fp16 权重(12.6 GB)五倍;LLaMA-65B 在 128K 上下文下 KV Cache 更是达到 320 GB。下表是论文附录 A 对不同 LLaMA 模型在不同序列长度下 KV Cache 内存的估算(批量 1):
| 模型 | fp16 权重 | KV@32K | KV@128K | KV@1M | KV@10M(fp16→2-bit) |
|---|---|---|---|---|---|
| LLaMA-7B | 12.6 GB | 16 GB | 64 GB | 512 GB | 4883 → 610 GB |
| LLaMA-13B | 24.1 GB | 25 GB | 100 GB | 800 GB | 7629 → 954 GB |
| LLaMA-65B | 121.1 GB | 80 GB | 320 GB | 2560 GB | 24414 → 3052 GB |
论文图 1 的左半部分(下图)把这个对比画了出来:序列长度 512 时模型权重还是内存大头,而 128K 时 KV Cache 已经一骑绝尘。
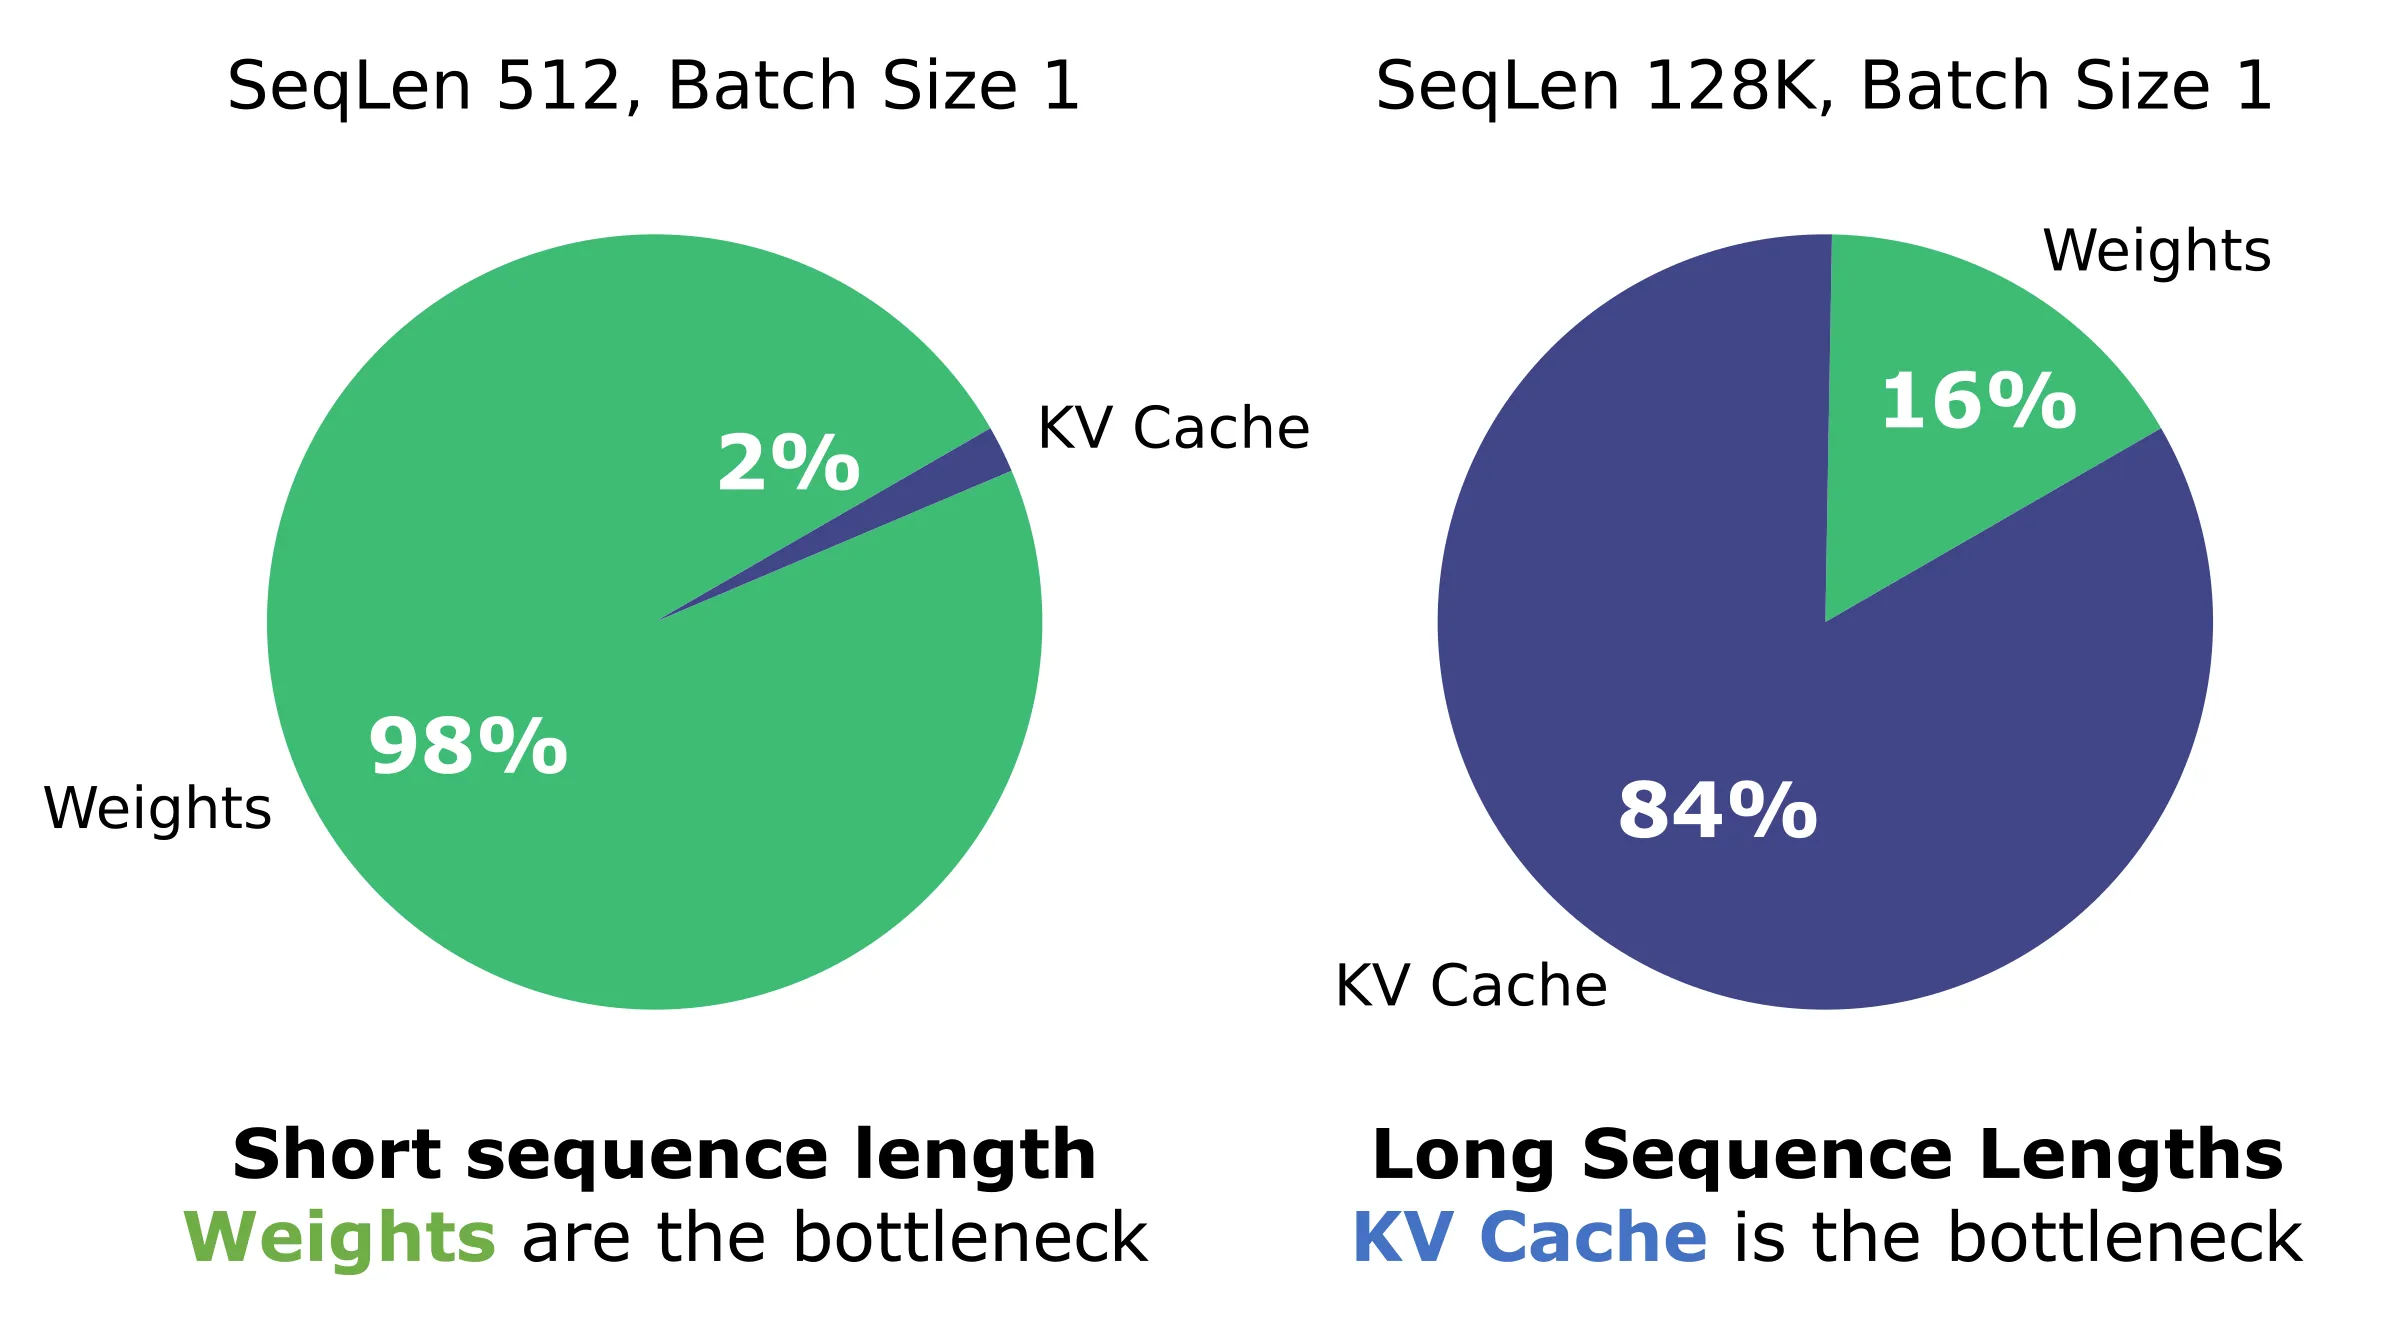
KV Cache 不但占内存,而且是解码阶段的时间瓶颈。生成阶段每个新 token 都要把自己这条序列的全部历史 KV 读一遍做注意力,不同序列的 KV 各不相同、无法在 batch 维度共享加载,所以 KV Cache 的读取永远受内存带宽(memory bandwidth)约束,与批量大小无关。这意味着任何能减小 KV Cache 体积的手段都直接转化为解码速度,即使为此付出更多的计算(比如反量化)也是划算的——带宽是瓶颈时,算力是空闲资源。这一条是整篇 KVQuant 设计的基石,后面「为什么敢用查表反量化这么重的方案」全靠它支撑。
压缩 KV Cache 有三条经典路线:驱逐/剪枝(只保留重要 token,如站内已拆解过的 H2O、StreamingLLM、SnapKV)、稀疏检索(每次只读部分 token,如 SparQ)、以及量化(把每个元素从 16 bit 压到 4 bit 以下)。量化与前两者正交:驱逐会永久丢掉信息,量化是保真的近似,两者可以组合。KVQuant 走的是量化这条路。
问题定义:为什么 4-bit 以下的 KV 量化会崩
如果只是把 Key/Value 用最简单的均匀量化(uniform quantization)压到 3-bit 或 2-bit,结果几乎是灾难性的。论文在 LLaMA 系列上(Wikitext-2,per-token 量化、RoPE 之后量化)报告的主表数字如下:
| 方法(3-bit 组) | LLaMA-7B | LLaMA-13B | LLaMA-30B | LLaMA-65B |
|---|---|---|---|---|
| fp16 基线 | 5.68 | 5.09 | 4.10 | 3.53 |
| int3(均匀、无分组) | 10.87 | 8.69 | 6.82 | 6.37 |
| nf3(NormalFloat 码本) | 7.33 | 6.21 | 5.46 | 4.44 |
| KVQuant-3bit | 5.87 | 5.25 | 4.25 | 3.63 |
| KVQuant-3bit-1%(隔离 1% 离群值) | 5.75 | 5.14 | 4.15 | 3.57 |
上表是困惑度(perplexity,PPL,越低越好)。均匀 3-bit 直接把 7B 模型的 PPL 从 5.68 干到 10.87,完全不可用;把量化进一步压到 2-bit 时(int2),LLaMA-7B 的 PPL 干脆爆炸到 11779——模型退化成了胡言乱语。即使 4-bit 也必须依赖细粒度分组(group size 64/128 的均匀量化,如 ATOM、FlexGen 的做法)才能勉强维持,而一旦想再省 25% 内存走到 3-bit,分组也救不回来。
为什么权重量化里表现良好的招数(均匀量化、细粒度分组)搬到 KV Cache 上就失灵?论文做了大量分布分析,归结为几个原因,每个原因都对应 KVQuant 的一个设计机制。先把结论摆出来,后文逐个拆:
- 量化轴选错了。Key 的离群值是「通道型」的——某些固定通道在所有 token 上幅度都很大。按 token 共享一个缩放因子(scale)时,一个通道的大幅度会逼着整个 token 的量化步长变大,把其他通道的小值全压进同一个量化桶里。
- 量化时机不对。主流模型(LLaMA 系)在注意力之前对 Query/Key 施加旋转位置编码(RoPE)。旋转把成对通道按位置相关角度混合,旋转之后 Key 的通道结构被搅乱,按通道量化失去了意义。
- 量化器形状不匹配。KV 激活分布严重非均匀(集中在零点附近、带重尾),等间距的均匀量化符号点(signpost)放错了地方;而固定形状的非均匀码本(如 QLoRA 的 NormalFloat)也不够好。
- 数值离群值没被隔离。哪怕通道结构处理好了,每个向量内部仍有极端离群元素把量化动态范围撑开,让其余 99% 的元素失去精度。
再加上 KV Cache 是流式生成的激活值(activation),不是静态权重,这带来两个权重量化没有的困难:缩放因子到底是在线统计还是离线校准(新 token 源源不断到来,改一个 scale 可能要回溯重写历史缓存);以及离群值的识别与提取必须在推理现场完成,不能像权重那样离线慢慢挑。KVQuant 的五个机制,就是在回答这六条。
三张分布图:KVQuant 的全部出发点
论文图 2 画了 LLaMA-7B 上 Key(RoPE 之前)、Key(RoPE 之后)、Value 三类激活的实际分布(单条 2K 长度样本,Wikitext-2),这是整篇论文的事实基础:
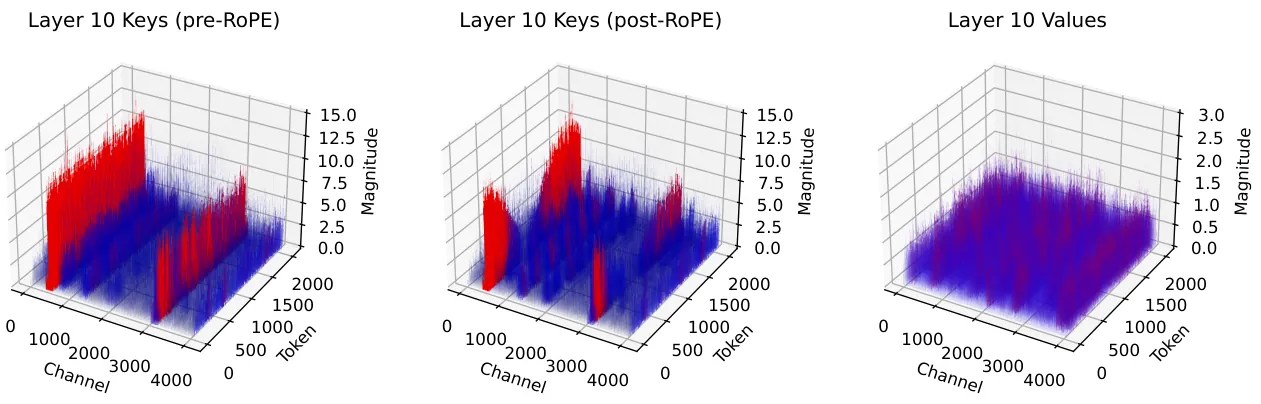
对照图注读这张图,能提炼出三条规律:
- 规律一(Key 旋转前有通道离群):pre-RoPE 的 Key 呈现清晰的「通道离群」结构——特定通道在所有 token 上都有稳定的大幅值,这正是 SmoothQuant、LLM.int8() 等论文反复观察到的 outlier channel 现象在 Key 激活上的体现。通道之间存在数量级差异的平均幅度,意味着沿 token 方向共享量化参数是错的,沿通道方向共享才是对的。
- 规律二(旋转打散结构):施加 RoPE 之后,同样的 Key 张量看起来「糊」了——离群通道的幅度不再连续、不再一致,随 token 位置振荡。原因后面详细讲:RoPE 是对通道对的旋转,旋转角随 token 位置变化,把离群通道的能量不断搬进与之配对的通道。
- 规律三(Value 没有固定离群模式):Value 的离群值散落在通道和 token 两个维度上,没有稳定结构,因此对它做逐通道量化收益有限甚至有害,需要另一套处理(逐 token + 在线隔离离群值)。
论文附录 F 的图 4 还揭示了第四条规律——动态范围被少数离群值撑开:无论 Key 还是 Value,各层中约 99% 的元素都集中在动态范围的一个小区间里,极少数数值离群值把「需要表示的区间」拉得极大。
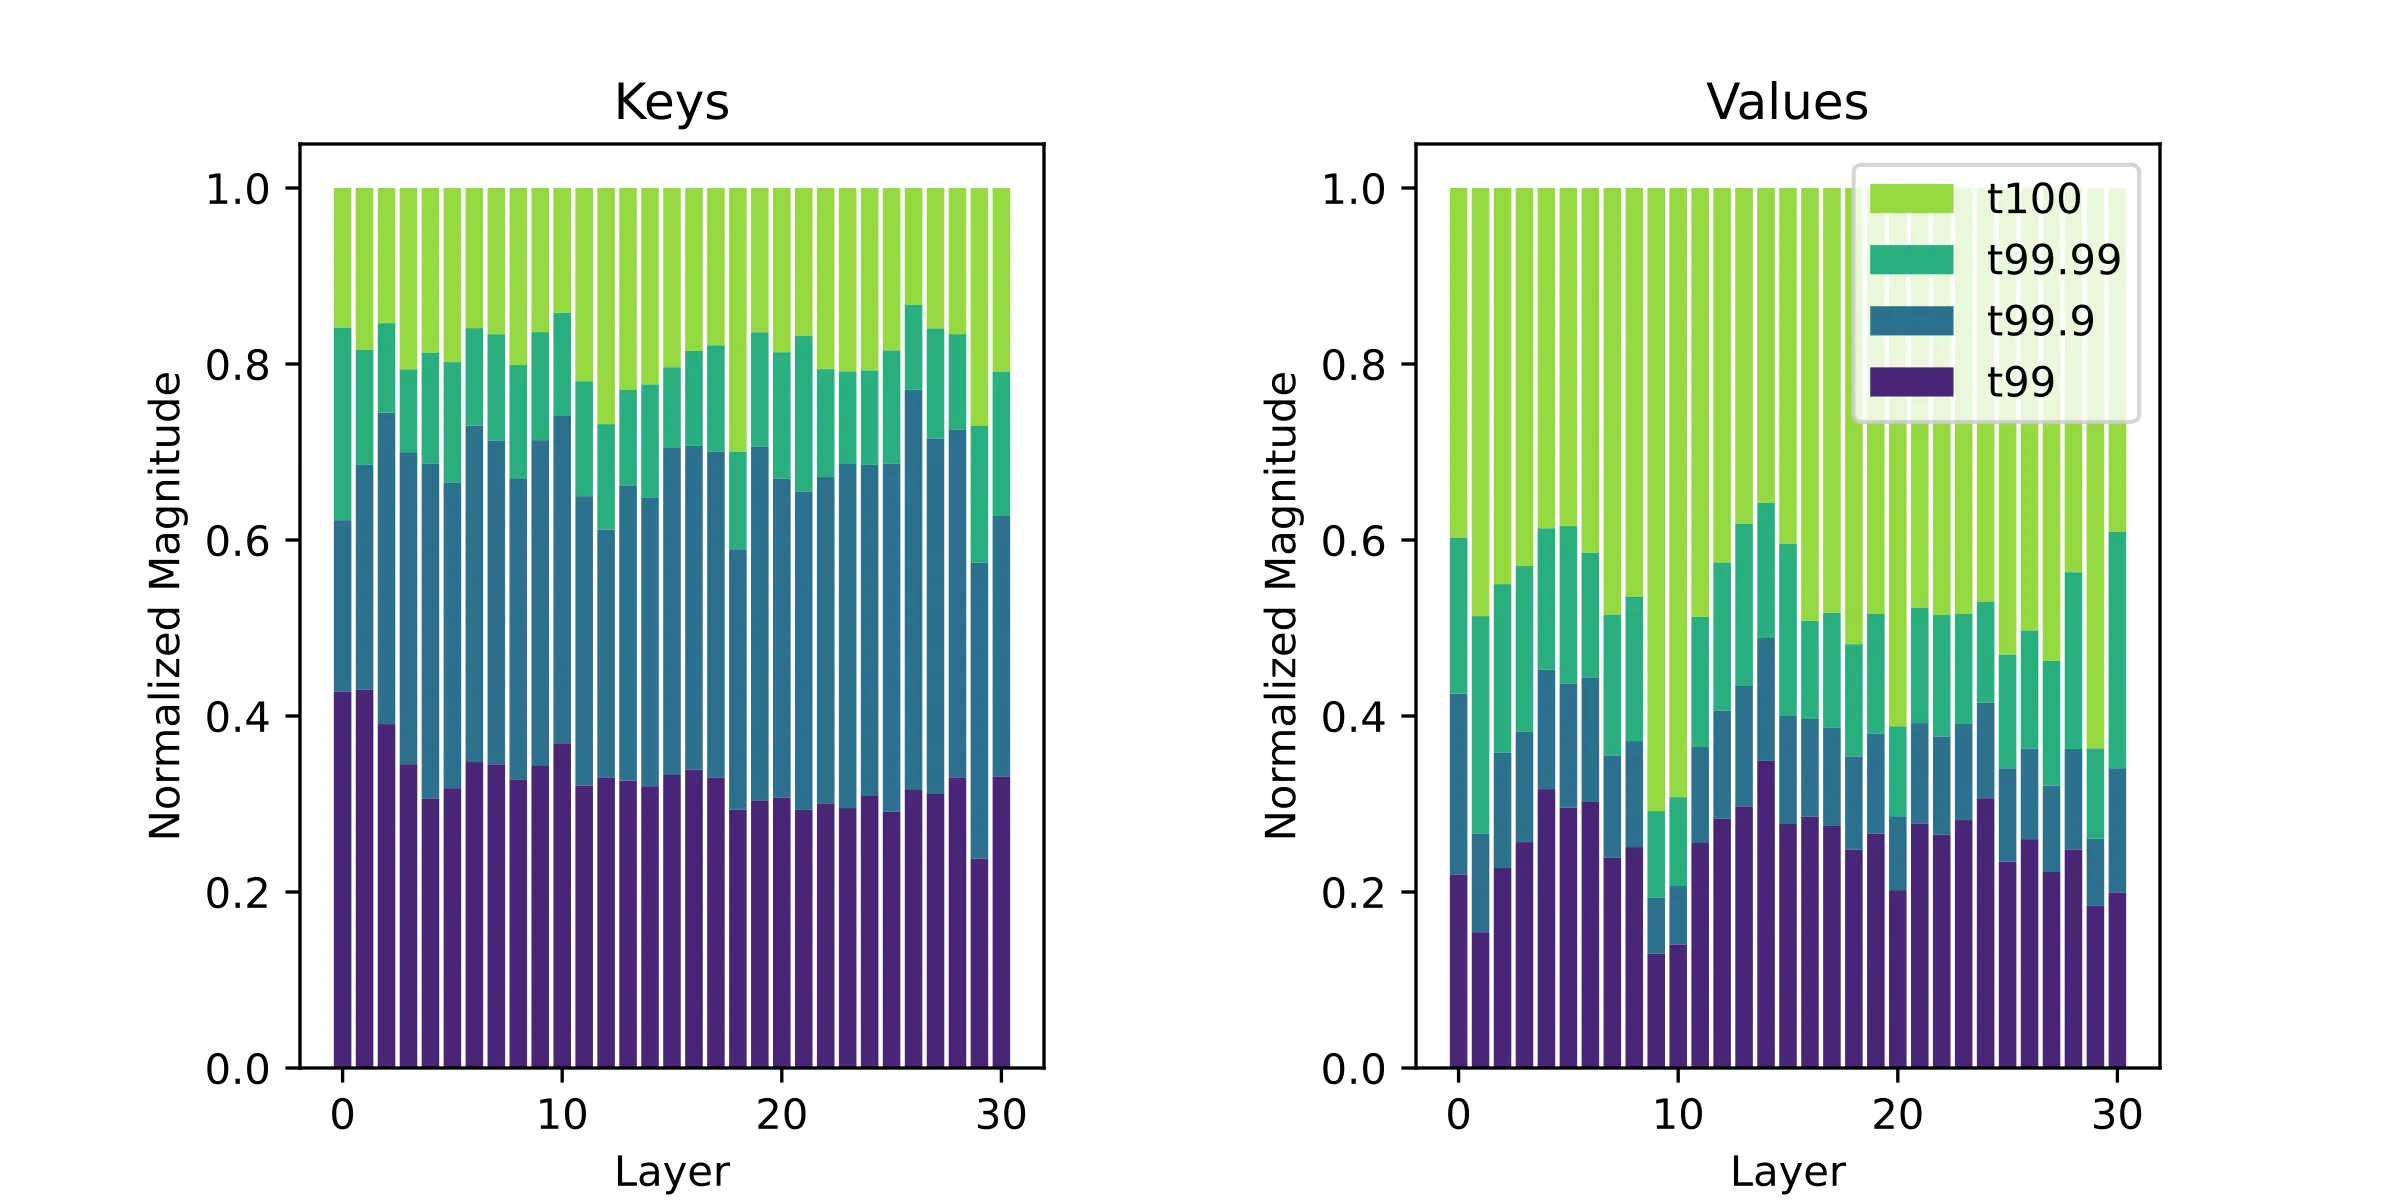
如果量化范围必须覆盖离群值,均匀量化下步长被离群值决定,密集区域分到的量化桶寥寥无几;把离群值挑出来单独存(dense-and-sparse),就能把量化范围收窄回密集区域。这就是机制四的动机。
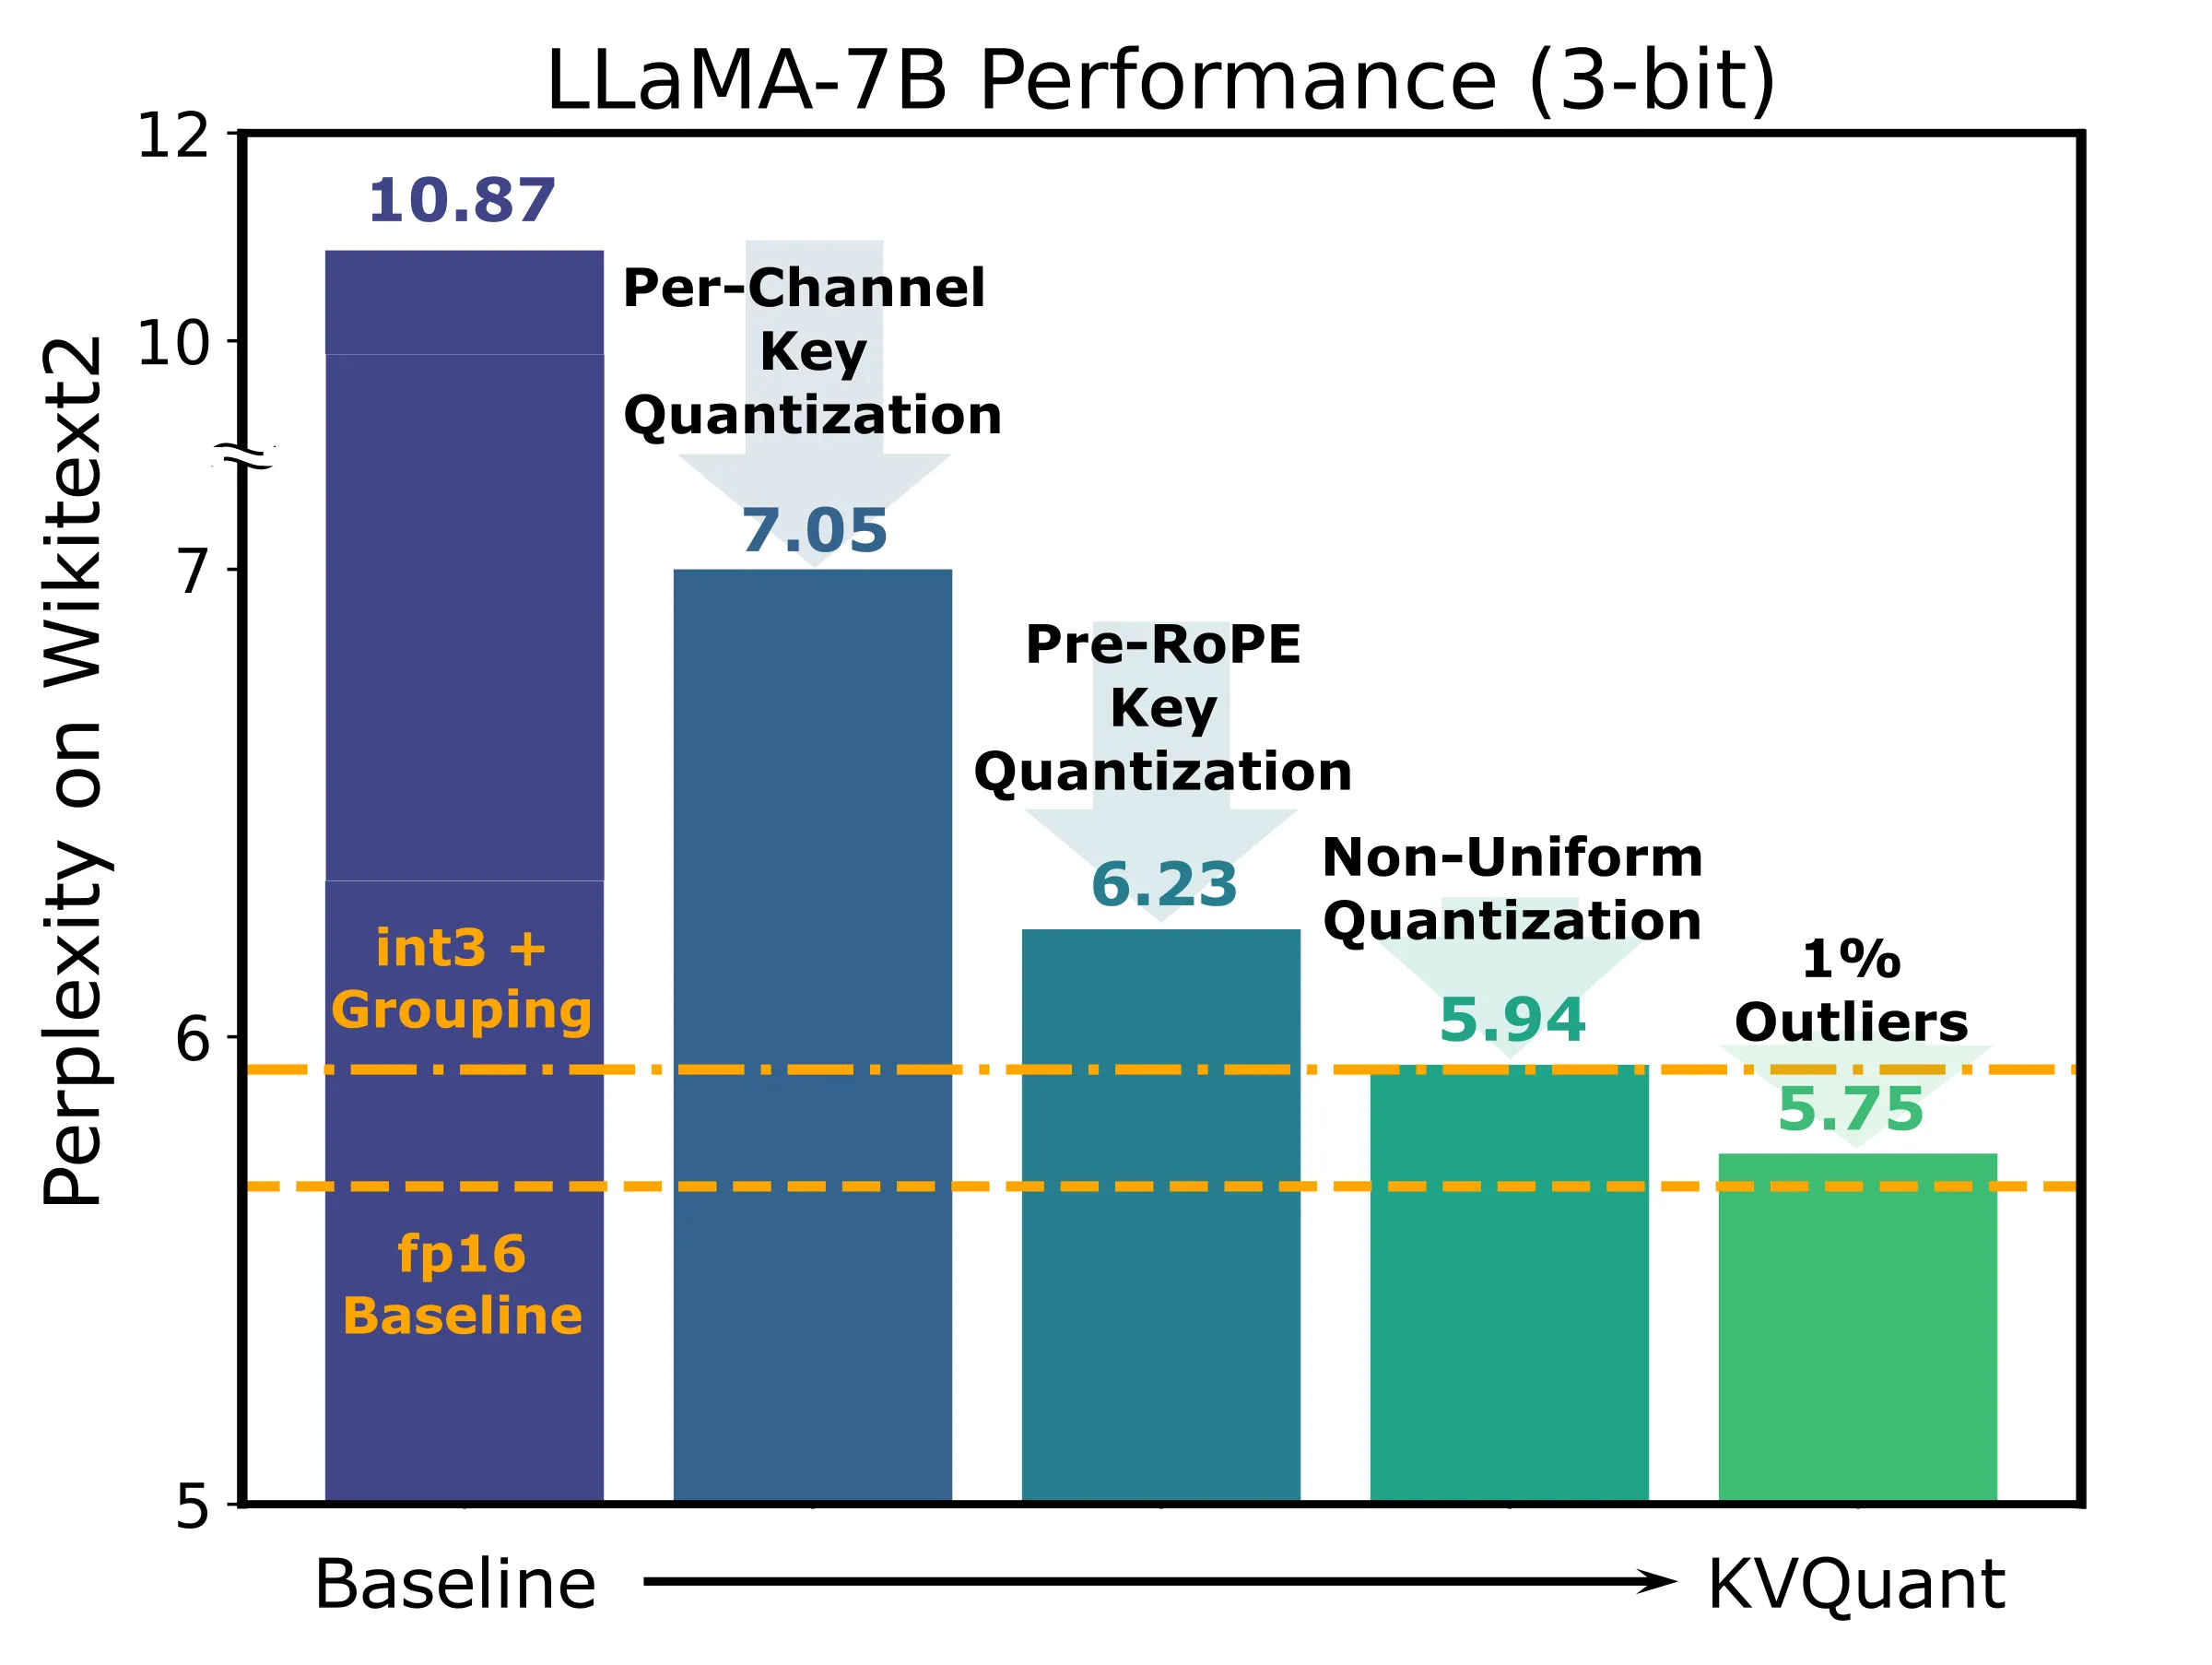
下图是论文图 1 右侧的 KVQuant 组件总览:把各机制按顺序叠加后,LLaMA-7B 的 KV Cache 压到 3-bit 时困惑度退化被压回 0.1 以内(配合 1% 稀疏离群值),对应 4.8 倍的缓存压缩:
机制一:量化轴的选择——Key 逐通道、Value 逐 token
先看最简单的量化形式。把向量 量化到 bit,需要两个参数:缩放因子(scale) 与零点(zero-point),量化值为 (四舍五入后取整),反量化时 。这里关键的工程自由度是 scale/zero-point 在哪个维度上共享:per-tensor 整层一个、per-token 每个 token 一个、per-channel 每个通道一个。
之前的 KV 量化工作(包括 KIVI 之前的方案、以及 KVQuant 的基线设定)都做 per-token:每个 token 的向量(长度即头维度 ,比如 128)共享一组参数。原因很自然:KV Cache 是流式生成的,每来一个 token 就可以独立计算它自己的统计量,per-token 对「在线」最友好。但看分布规律一,问题来了:Key 的离群是通道型的,per-token 量化时,一个 token 向量里如果有某几个通道幅度是其他通道的十几倍,那么该 token 的量化步长被离群通道决定,其余通道的小幅值全部塌缩到邻近的量化桶里,细节全丢;更糟的是,这种损失对每个 token 都会发生(因为离群通道在每个 token 里都存在),误差沿序列维度系统性累积。
改按通道(per-channel)量化:同一通道跨 token 共享一组 scale/zero-point。离群通道获得自己的大 scale,普通通道获得小 scale,各自在各自的动态范围内均匀量化——量化范围与分布结构对齐了。
论文(附录 G)在 LLaMA-7B、3-bit 下做了系统的轴组合消融:
| Key 量化维度 | Value 量化维度 | PPL(int3) |
|---|---|---|
| per-token | per-token | 10.87 |
| per-channel | per-channel | 223(崩坏) |
| per-channel | per-token | 7.05 |
两个结论都很反直觉,值得展开。
Key 必须 per-channel,Value 不能 per-channel。 Value 的分布(规律三)本来就没有通道结构,更关键的是误差传播路径不同:注意力输出是「注意力分数矩阵 × Value」的加权和,Value 某一通道的误差只会流进输出向量的某一个对应元素,per-channel 的 Value 量化会把误差长期、稳定地集中在少数输出元素上,再经多层网络逐层放大;而 per-token 量化把误差限制在 token 维度上,由于注意力权重通常只集中在少数几个重要 token 上,多数 token 的量化误差根本不会被放大。KIVI 论文在同期的独立实验里也观察到完全一样的现象,两篇论文在这个结论上互相印证。至于 per-channel + per-channel 为什么崩到 223,可以理解为 Value 的通道误差累积到极致的结果。
注意一个细节:为什么表里 per-channel 的 Key 用 fp16 零点? 论文的解释是,某些 Key 通道的所有元素全为正或全为负,此时零点会落在低精度整数表示范围之外,把零点四舍五入成低精度整数会显著伤精度,所以 Key 的零点保持 fp16(内存开销:每通道一个 fp16 零点 + 一个 fp16 scale,相对 3-bit 主体是可忽略的摊销)。这跟 KIVI 用「无零点量化 + 偏移量」的工程处理异曲同工——都是为了让零点不挤占低精度整数的表示空间。
per-token 改 per-channel 这一步带来了 3.82 的 PPL 改善(10.87 → 7.05),是整个方法里贡献最大的单项。但它也埋下两个工程难题,后面机制五会解决:其一,通道方向与矩阵乘法的归约方向不一致,反量化时需要按通道广播 scale;其二,per-channel 的 scale 无法在线更新(新 token 的加入理论上会改变每个通道的最优 scale,需要回溯改写全部历史缓存),只能离线校准。
机制二:预旋转量化——在 RoPE 施加之前保存 Key
第二个关键决策与旋转位置编码(RoPE,Rotary Position Embedding)有关。RoPE 的原理这里只做必要回顾(站内已有 RoPE 完全拆解):它把 Query/Key 向量按位置 旋转一个与位置成比例的角度,使得注意力分数天然只依赖 Query 与 Key 的相对位置。具体做法是把向量按两两一组(第 与第 维)施加旋转:
其中 , 是 token 在序列中的位置。实际实现大多用等价的元素式写法(把向量分成前后两半交叉运算),推理时一次向量乘加即可完成,但数学上就是「成对通道旋转」。
问题在于:旋转会破坏 Key 的通道离群结构。设某通道对里两个通道的典型幅度差异悬殊,比如 、(直观示例,非论文数据),旋转后两个输出分量变成
大通道的能量被按 的比例不断灌进小通道,而角度 随位置 变化——于是旋转后每个通道的幅度都随 token 位置振荡,通道统计变得位置相关、不可校准,「通道离群」这个可被利用的结构消失了。这正是图 2 中间列看起来比左列「糊」的原因。
所以论文提出在 RoPE 之前量化 Key(pre-RoPE quantization):KV Cache 里存的是未旋转、已量化的 Key;推理做注意力时,先把 Key 反量化回 fp16,再当场施加 RoPE,然后与 Query 相乘。这样量化面对的是分布规律一那副干净、可校准的通道离群图景。
这一步换来的代价是:解码时每个 Key 都要多一次「反量化 + 旋转」。但别忘了基线前提——KV Cache 读取是带宽瓶颈,量化后加载的数据量只有 fp16 的 3/16(3-bit 时),省下的带宽时间远多于反量化与旋转的计算时间;论文为此专门写了融合 kernel(机制六详述),把反量化、RoPE 与 QK 矩阵向量乘合成一个 pass。
消融结果(附录 H):同样是 per-channel Key + per-token Value 的 int3 配置,post-RoPE 量化 PPL 为 7.05,pre-RoPE 量化降到 6.23,又省下 0.82。这个数字还藏着一个微妙的细节:pre-RoPE 的好处只在 per-channel 量化下成立。附录 P 报告,如果 Key 走 per-token 量化,反而是 post-RoPE 更好(如 int3:pre-RoPE 14.68 vs post-RoPE 10.87)——原因与机制一对称:per-token 量化下,离群通道是「毒害」其所在 token 的量化范围的,而旋转恰好把离群通道的能量摊薄到同一 token 的其他通道上,相当于在 token 内部做了一次稀释,反而减小了对该 token 量化范围的冲击。这也是为什么论文给所有基线方法统一用「post-RoPE + per-token」的最强配置来对比——不是偷懒,而是实验发现这个配置确实是 per-token 路线下的最优。
到这里有个值得体会的方法论:量化轴与旋转状态的选择必须联合考虑。per-channel 量化想要「通道结构保持原样」,因此要在旋转前量化;per-token 量化想要「token 内部均衡」,旋转反而帮忙。KVQuant 选了前者,因为前者在 3-bit 低精度下收益大得多(7.05 vs 10.87 的差距起点已经决定了胜负)。
机制三:敏感度加权的非均匀码本 nuqX
为什么非均匀量化在这里是免费的
均匀量化把 等分成 个区间。KV 激活分布严重非均匀——大量元素挤在零点附近、尾部拉得很长(图 4 已显示 99% 的元素只占动态范围的一小段),3-bit 时只有 8 个量化桶,等间距摆放浪费严重:零点附近的桶太稀、尾部区域又没值可量。
非均匀量化(non-uniform quantization)允许量化符号点自由摆放,理论上能贴合任意分布,但代价是反量化不再是「乘 scale 加零点」这种廉价线性运算,而要做查表(lookup table,LUT)或比较。对权重量化来说这笔账要仔细算(计算强度高时反量化开销会吃掉收益);但 KV Cache 场景下论文给出一个漂亮的论断:KV Cache 加载永远带宽受限,非均匀量化的反量化开销是免费的——反正算力闲着,省下来的带宽才是硬通货。这是机制三能成立的根本原因。
为什么不能照搬 SqueezeLLM 的敏感度加权 k-means
非均匀码本怎么造?同组之前的权重量化工作 SqueezeLLM 用「敏感度加权的 k-means」离线为每层权重造码本:用海森/敏感度信息加权,让聚类中心偏向「对损失更重要的值」。但 KV 激活是推理时才产生的,Value 还要在运行时流式量化——总不能在解码中途跑 k-means。KVQuant 的折中方案是:
- 每层只造一个共享的码本(per-layer datatype),离线在少量校准样本上完成;
- 码本的形状(8/16/32 个符号点)由离线敏感度加权 k-means 决定;
- 运行时每个 channel/token 只需一个 fp16 scale 把码本整体缩放,再叠加(可选的)零点,即可贴合当前向量——量化主体仍是「查码本表」,只是每向量多乘一个标量。
这样把「每向量在线拟合分布」的高成本,降级成「每向量一个标量」,而把需要聚类的部分全部离线做掉。论文给这个 X-bit 码本起名 nuqX(non-uniform quantization datatype),如 nuq3、nuq4。
敏感度加权目标函数的来龙去脉
码本符号点 的选择标准不是「让重建误差最小」这么简单——不同元素的量化误差对最终损失的伤害不同,得按敏感度加权。论文沿用神经网络敏感度分析的标准推导(源自 Novak 等人的工作,SqueezeLLM 也用过同一框架),把激活 量化前后损失的变化做一阶泰勒展开,并假设各元素量化扰动 独立、零均值:
其中 是损失对激活的梯度。直觉是:损失面在某个激活元素方向越陡(梯度越大),该元素被量化扰动 后损失被推得越远。于是最优码本要最小化梯度平方加权的重建误差:
这里 是 Fisher 信息矩阵(Fisher information matrix)的对角元,即梯度平方在样本分布上的期望,实践中用 16 条校准样本(每条 2K token,来自 Wikitext-2 训练集)在教师强制(teacher forcing)下对每层 Key/Value 激活回传得到的经验梯度平方均值来估计; 是所有校准样本的元素总数。把 展开成一维后,这就是一个加权 k-means 问题:给定要聚成 类,每个样本带权重 ,聚类中心即为符号点。
还差一步归一化。per-channel/per-token 的 scale 与零点记为 、,先把元素归一化到 再做聚类:
因为反量化时归一化域的误差会被 放大(),代入目标函数后,归一化域的 k-means 权重应修正为 。也就是说:大 scale 的通道(多半是离群通道)在归一化域里值得被更精确地表示。附录 I 的消融显示,漏掉这个 因子(只做 Fisher 加权)会让 nuq3 从 5.94 退化到 6.01。
顺带一提,为什么要「敏感度加权」而不是「幅度加权」?直觉如下:k-means 若按幅度平方加权,聚类中心会被数值最大的离群值牢牢吸住——它们绝对值大、绝对误差大,但相对误差小,且数量极少,把宝贵的符号点让给它们是浪费;真正决定输出质量的是那些幅度中等、却落在 softmax 边界附近的元素。Fisher 加权按「对损失的边际影响」分配符号点,规避了这个陷阱。论文消融(LLaMA-7B,nuq3)给出非常有说服力的对比:普通幅度加权 k-means(unweighted)做出来的码本反而比均匀 int3 更差(6.84 vs 6.23),Fisher 加权后才大幅反超(5.94)——码本形状这件事,加权方式比等不等距重要得多。
机制三在「int3 均匀 → nuq3」这一步上带来 0.29 的 PPL 改善(6.23 → 5.94,同为 per-channel + pre-RoPE 配置),且在全部测试模型上一致优于 NormalFloat 固定码本(nf3,论文报告最大提升 0.33)。码本每层独立、各层可并行校准:论文报告在 Xeon Gold 6442Y 上单层 k-means 校准只需 1.9–4.5 分钟(2/3/4-bit),全部层串行做完也不超过 6 小时;Fisher 信息计算在 8 张 A100 上 2.8 分钟搞定——这是一次性的离线成本,且对校准数据不敏感(换用 C4 校准,结果几乎不变)。
机制四:逐向量稠密-稀疏量化——把 1% 的离群值请出量化范围
为什么离群值必须物理隔离
图 4 已经说明问题:量化动态范围由最大绝对值决定,一小撮离群值把范围撑大,均匀分摊后密集区的量化步长被迫变大。解决思路来自权重量化里的 dense-and-sparse(稠密-稀疏)分解(SqueezeLLM、SpQR 都这么干):把张量拆成「稠密低比特主体 + 稀疏高精度离群值」,离群值单独存、单独算,主体就能用更窄的范围量化。SpQR/SqueezeLLM 面对的是静态权重,离群值可以慢慢挑;KV 是动态激活,离群检测必须在线完成——这是 KVQuant 在这个机制上真正的新贡献。
阈值粒度必须与量化粒度一致
把离群检测做到哪个粒度,是本节的关键设计决策。朴素做法是 per-matrix:对整个 Key/Value 张量设一个全局离群阈值。论文指出这不对——离群的定义必须相对量化时共享参数的那个向量而言:per-channel 量化的 Key,离群阈值应该逐通道设;per-token 量化的 Value,阈值逐 token 设。原因很微妙:矩阵全局阈值下被标记为「离群」的元素,在它所属的通道内部可能只是普通大小(因为该通道整体幅度就大),删掉它是浪费稀疏预算;反过来,真正会撑开该通道量化范围的通道内极端值,在全局看来又未必够格当离群。用论文的话说,要「直接瞄准会扭曲量化范围的离群值,且瞄准的粒度与量化粒度一致」。这就是 per-vector dense-and-sparse:Key 按通道、Value 按 token,各自独立算上下阈值,超出阈值的元素抽出来单独存 fp16。
消融(附录 J,LLaMA-7B,nuq3)量化了这个差别:
| 配置 | PPL |
|---|---|
| nuq3(无离群隔离) | 5.94 |
| + 0.1% 离群(per-matrix 阈值) | 5.89 |
| + 0.1% 离群(per-vector 阈值) | 5.82 |
| + 1% 离群(per-matrix 阈值) | 5.85 |
| + 1% 离群(per-vector 阈值) | 5.75 |
注意两个现象:per-vector 阈值在同稀疏率下始终优于 per-matrix;且 1% per-matrix 的效果(5.85)甚至不如 0.1% per-vector(5.82)——稀疏预算用错了地方等于白用。抽出 1% per-vector 离群值后 PPL 从 5.94 降到 5.75,距 fp16 基线 5.68 只差 0.07,把 3-bit 拉进了「近无损」区间。
稀疏部分的存储成本与格式选择
离群值不是免费的:每个离群元素要存一个 fp16 数值(16 bit)+ 一个定位索引(16 或 32 bit),再加上稀疏矩阵的行/列指针摊销。论文按 1% 稀疏率估算,平均每个元素要多花约 33 bit(约 0.33 bit/元素),于是 nuq3-1% 的实际平均位宽是 3.33 bit,128K 上下文下 LLaMA-7B 的 KV Cache 从 12.0 GB 涨到 13.3 GB——相比 fp16 的 64 GB 仍是约 4.8 倍压缩。用公式表达:, 为稀疏率。
存储格式的选择跟着「KV Cache 只能追加」的特性走:Key 的离群矩阵用 CSC(Compressed Sparse Column)——新 token 对应新列,追加一列只需在列指针数组尾部加一个元素;Value 用 CSR(Compressed Sparse Row)——新 token 对应新行,同样只需行指针尾部追加。反过来的格式每次都要在数组中间插入数据并重排,代价高昂。附录 R 对索引位宽还有细致的记账:Key 的离群索引指向 token 位置,序列超过 65536 时需要 32 bit 索引;Value 的离群索引在头维度(4096)内,16 bit 足够。
运行时离群阈值怎么高效地算?Value 是逐 token 在线量化的,每来一个新 token 要做一次 top-k 选出 1% 离群。论文实测(LLaMA-7B,头维度 4096):GPU 上 top-k 需 0.088 ms,约为单次 QKV 投影矩阵向量乘(0.172 ms)的一半——直接加在关键路径上不可接受。妙招是把 top-k 扔给 CPU(Xeon Gold 6126 上仅 0.026 ms),并调整算子顺序:先算 Value 投影、把 top-k 的输入准备好,CPU 在 GPU 算 Query/Key 投影的同时完成离群检测,两路汇合后 GPU 直接打包写入缓存。融合后整个「投影 + 量化打包」的总耗时 0.173 ms,与不做量化的原始投影(0.172 ms)几乎相同——在线量化是零成本的。仓库后续还补充了 GPU 并行 top-k 以支持并行 prefill 打包。
机制五:attention sink 感知与「Key 离线、Value 在线」的校准分工
第一个 token 值得特殊对待
StreamingLLM(站内已有完全拆解)发现了一个反直觉现象:模型会在序列开头的少数 token 上堆积不成比例的大注意力分数,把它们当作「注意力汇聚点」(attention sink)——即便这些 token 语义上无关紧要。KVQuant 指出这个现象在量化语境下的推论:既然首 token 承载了大比例注意力权重,它的量化误差就会被注意力机制直接放大,模型对首 token 的量化误差异常敏感。
对策是 attention sink 感知量化(attention sink-aware quantization):校准阶段就跳过首 token 的统计;推理阶段把每层序列开头的少量 token(GitHub 实现中默认约 5 个)保留 fp16,其余照常量化。成本可以忽略(5 个 token 的 KV 相对 128K 序列是零头),收益却集中在最脆弱的地方。消融(附录 K)显示该机制在 2-bit 下效果巨大:LLaMA-7B 的 nuq2 从 8.47 降到 7.23,Llama-3-8B 从 16.63 降到 7.04——新模型在超低位宽下对 sink 的依赖更极端;在 3-bit + 1% 稀疏的配置下收益已很小(5.75 → 5.75),因为离群值机制已经把误差大头处理掉了。并发工作 IntactKV 独立提出了几乎相同的想法(保留「pivot token」不量化),两篇互相印证。
Key 离线校准、Value 在线计算:为什么必须分工
激活量化统计量的两大来源——在线计算(online)与离线校准(offline)——各有致命伤,而这伤还随量化轴不同而不同。下图(论文图 5)总结了这组矛盾:
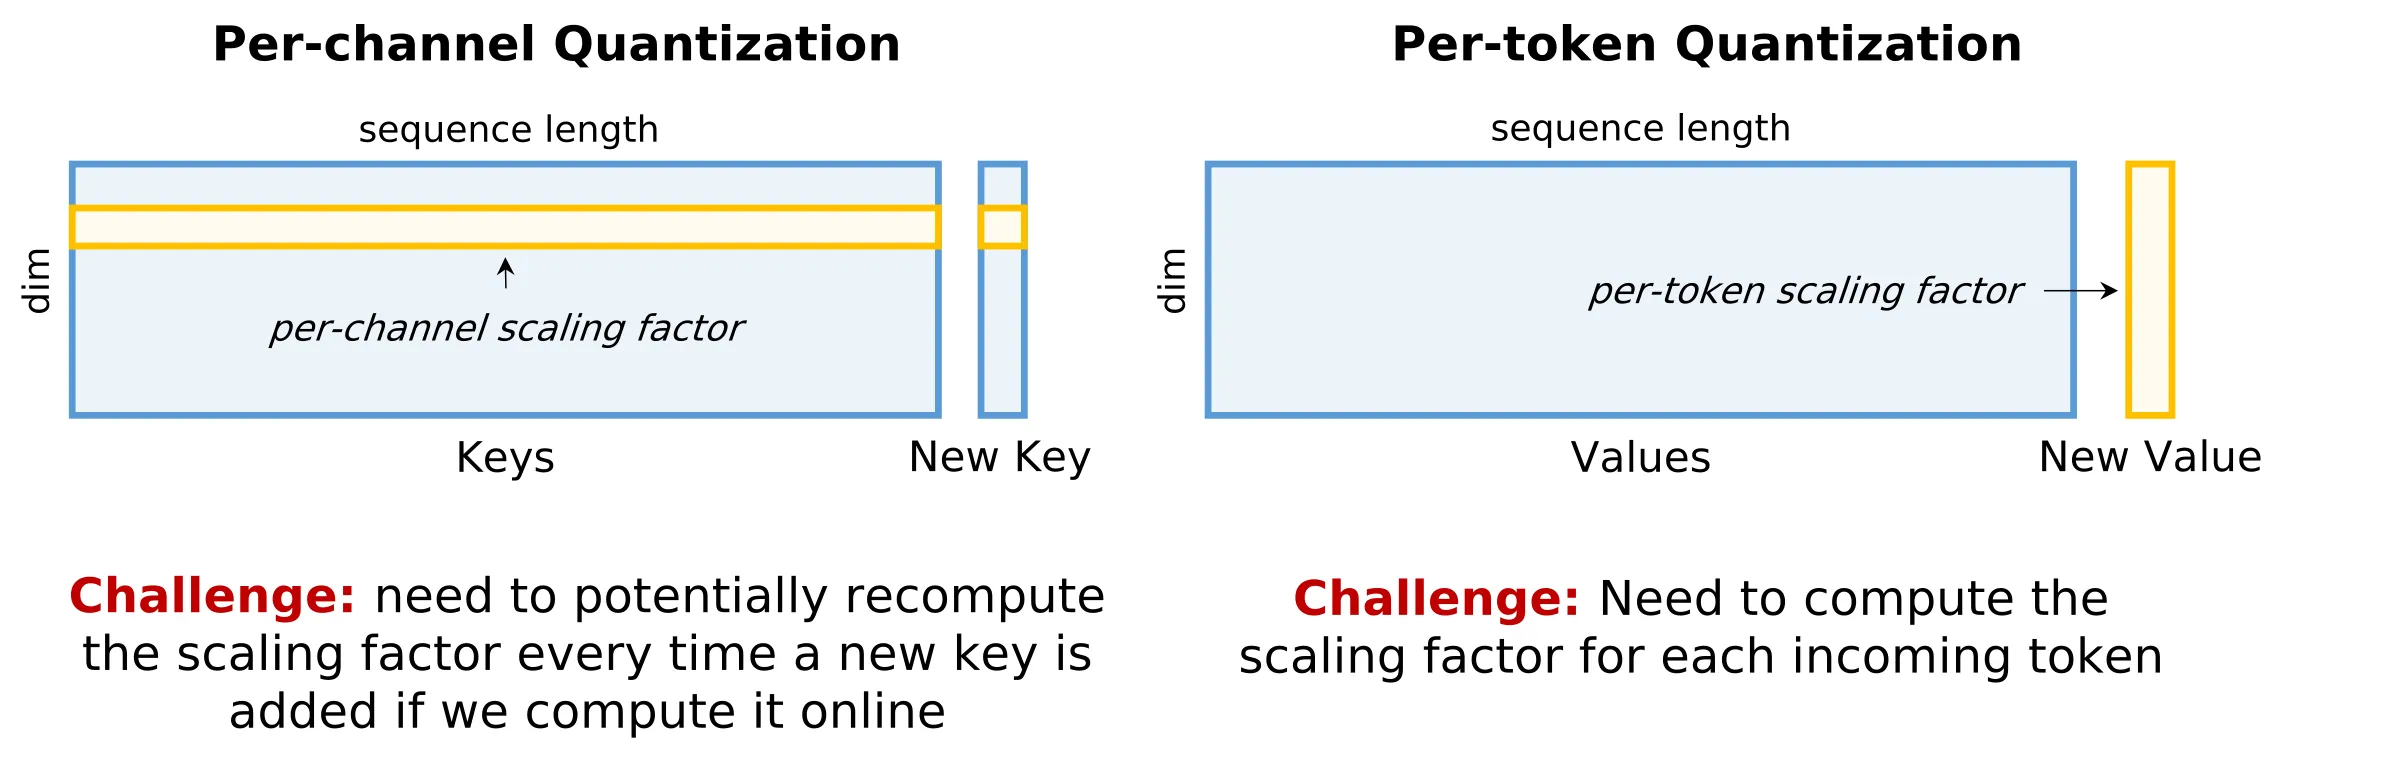
- Key(per-channel)必须离线。每追加一个新 token,通道的最优统计量都可能变化,而通道是跨所有历史 token 共享的——在线更新意味着把所有历史 Key 重新量化一遍,绝无可能。因此 Key 的 scale/零点/码本全部用 16 条校准样本离线确定,推理时只读不写统计量。
- Value(per-token)可以且应当在线。统计量只属于新来的这个 token,不影响历史;离线校准反而有风险——校准集里没见过的离群 token 会在线上把量化范围撑爆。所以 Value 的 scale、零点与离群阈值都在线算(配合机制四的 CPU top-k 并行方案,零额外开销)。
离线校准的隐患是分布偏移:线上遇到的激活范围超出校准所见时,量化会失真。论文的应对是机制四的离群隔离恰好也修复了校准偏移:附录 L 的消融显示,无离群隔离时 nuq3 离线校准比在线差 0.03(5.94 vs 5.91),一旦启用 1% 离群隔离,离线与在线完全打平(5.75 vs 5.75)——因为离群值(无论校准期还是线上期遇到的)都被单独拎出来高精度保存,量化范围不再被极端值左右,校准分布的敏感性大幅下降。这是个非常漂亮的机制耦合:校准难题不是靠更好的校准,而是靠让量化对校准分布不再敏感。
Kernel 实现:查表反量化、片上 RoPE 与平衡稀疏矩阵乘
机制讲完了,来看 KVQuant 的 CUDA kernel 怎么把这些设计落到解码关键路径上(论文对 LLaMA-2-7B-32K 实现并实测,代码开源在 SqueezeAILab/KVQuant)。
存储与反量化。KV Cache 主体存 4-bit 索引,每个索引指向该层 nuq4 码本(16 个 fp16 符号点)的一项;反量化值 = 每向量 scale × 码本[索引] + 零点。因为码本是逐层共享的,整个 kernel 只需载入一份每层码本(在线程内复制以便并行访问),再加每 channel/token 一个 fp16 scale 的广播——这正是机制三「per-layer datatype + per-vector rescale」设计的工程红利:如果每向量各用一套码本,反量化时每个元素都要查不同的表,GPU 上根本无法高效实现。所有算术保持在 fp16。
预旋转 Key 的片上 RoPE。为了支持 pre-RoPE 量化,Key 的矩阵向量乘 kernel 把「反量化 → 施加 RoPE → 与 Query 点乘」融合成一步:加载 4-bit 索引 → 查表反量化 → 用元素式旋转公式当场旋转(不需要构造旋转矩阵)→ 与 Query 对应元素相乘累加。RoPE 在这里是免费的,因为反正要走一遍数据。
稀疏部分的 SpMV。1% 离群值用 CSR/CSC 存,与主体矩阵的矩阵乘分开做:稠密部分走查表 matvec,稀疏部分走平衡稀疏矩阵-稠密向量乘(balanced SpMV)。朴素 CSR/CSC SpMV 让每个线程处理整行/整列,离群分布不均时线程负载严重倾斜;KVQuant 沿用 SqueezeLLM 与 Euro-Par 2017 平衡 SpMV 工作的方案,按非零元数量平均分配任务(每个线程 10 个非零元),负载均衡优先于同步开销。稠密与稀疏两个 kernel 在一次 launch 内完成并直接累加输出,避免两次写回。
实测延迟(A6000,批量 1,序列长度 2K/4K/16K,单位微秒):
| 操作 | l=2K | l=4K | l=16K |
|---|---|---|---|
| Key:fp16 matvec(含 RoPE) | 33.3 | 59.1 | 219.4 |
| Key:nuq4-1%(打包+稠密+稀疏) | 25.6 | 39.9 | 126.3 |
| Value:fp16 matvec | 26.0 | 50.2 | 203.7 |
| Value:nuq4-1% | 22.1 | 37.9 | 124.5 |
读表要点:其一,序列越长加速越明显(Key 从 1.30× 到 1.74×)——因为序列越长越带宽受限,压缩数据量省下的带宽时间越能压过固定开销,符合机制三的「带宽换计算」前提;其二,在线打包开销是固定的(4.5 微秒左右,与序列长度无关),只在极短序列下才显得贵;其三,以 16K 的 Key 乘法为例,126.3 = 4.5(打包)+ 87.6(稠密)+ 34.2(稀疏),反量化与稀疏双通道合计仍比直接读 fp16 快 1.7 倍。论文把这些 kernel 接进了端到端解码流水线:每生成一个 token,先在线压缩再入缓存,之后所有注意力都读压缩数据。
效果全景:3-bit 近无损、长上下文与 1M/10M 场景
主表结论
把全部机制合起来(Key pre-RoPE per-channel + Value per-token + nuqX 码本 + per-vector 1% 离群 + attention sink 感知),在 LLaMA、Llama-2、Llama-3、Mistral 全家族上,Wikitext-2 与 C4 两个数据集的结果(论文表 1/附录 O):4-bit-1% 困惑度退化小于 0.02、3-bit-1% 小于 0.1、2-bit-1% 小于 0.5,对应 3.7 倍、4.8 倍、6.9 倍 KV Cache 压缩。前文的对比表已经展示了 LLaMA 系列 Wikitext-2 上 3-bit 的完整局面:int3 崩到 10.87,带分组的 FlexGen/ATOM 式均匀量化 3-bit 在 5.9 左右,KVQuant-3bit 追到 5.87,加 1% 离群隔离后 5.75。2-bit 一档差距更悬殊:int2 是 11779 这种灾难数字,FlexGen-2bit 也要 11.09,而 KVQuant-2bit-1% 只有 6.01。需要提醒的是,公平对比时要看「平均位宽」而非名义位宽——带 128 元素 fp16 残差窗口的 KIVI-2bit 实际平均 3.05 bit,KVQuant 的 3-bit-1% 平均 3.33 bit,两个方案几乎同价位(约 3.1–3.3 bit),这个前提下比较才有意义。
长上下文质量:passkey、LongBench 与 RULER
量化省下的内存最终要兑换成长上下文能力,而长上下文任务恰是量化误差最容易累积的场景。论文在 LLaMA-2-7B-32K 与 Llama-2-70B-32K(LongLoRA)两个长上下文模型上做了三类验证。
下图是论文图 3:在两个 32K 模型上,Wikitext-2 困惑度随评估序列长度(2K 到 32K)的变化。量化模型(尤其 nuq3-1%)的曲线在全部长度上都贴着 fp16 基线,误差没有随上下文变长而发散——这是长上下文量化最关键的性质:误差不累积。
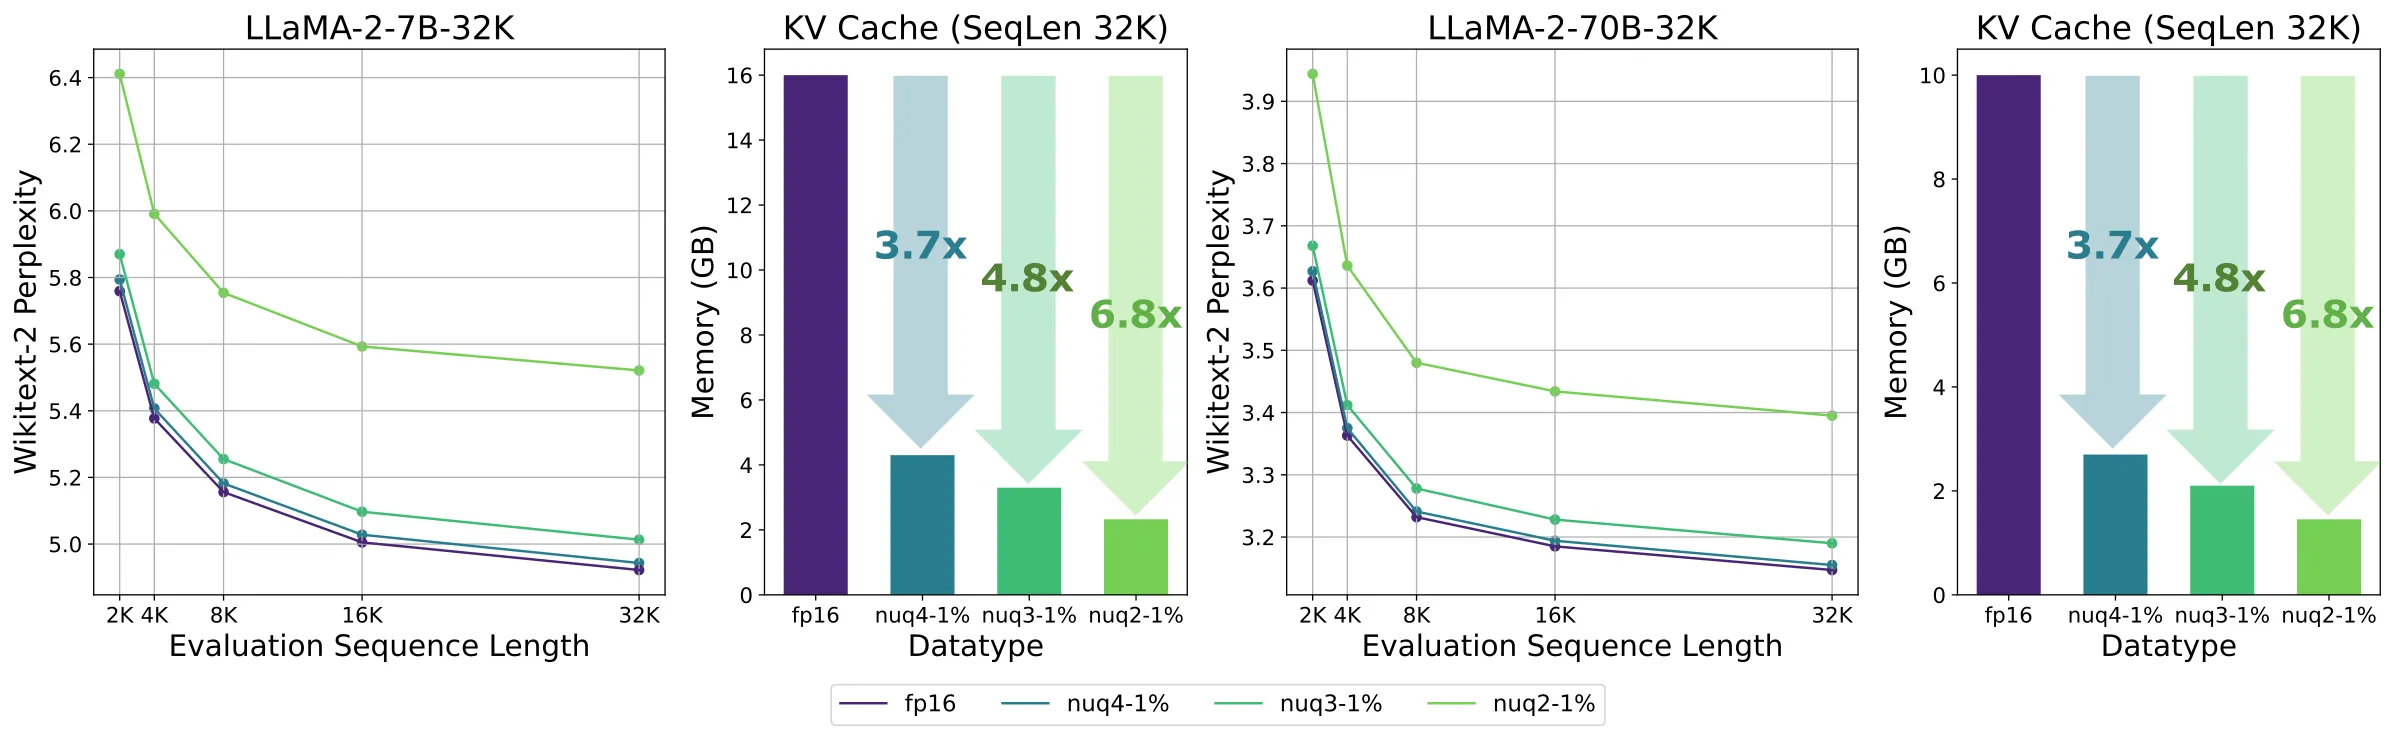
Passkey 检索(在长文本里找埋入的随机口令)衡量模型跨长距离调用信息的能力。LLaMA-2-7B-32K 上,KIVI(2-bit + 组大小 32 + 128 元素 fp16 残差,平均 3.05 bit)在 2K 到 32K 长度下成功率只有 0.68–0.76;KVQuant-nuq3-1%(3.33 bit)是 0.98–1.0,nuq2-1%(2.33 bit)也有 0.98–1.0。论文把差距归因于表示哲学的差异:KIVI 只在序列尾部保留一段 fp16 残差窗口,长距离任务需要调用上下文任意位置的信息,尾部残差帮不上忙;KVQuant 对所有 token 一视同仁地量化(配 1% 离群隔离),不预设哪个区间更重要,因而完整上下文都可检索。这个归因在 RULER(13 项任务、最长 32K)与 LongBench(平均 12.2K)上得到印证:RULER 平均分 fp16 基线 56.40、KIVI 39.78、KVQuant-nuq3-1% 53.65(位宽相近下大幅领先);LongBench 平均 fp16 31.96、KIVI 30.04、KVQuant-nuq3-1% 31.21。2-bit 档(36.54 @ 2.33 bit)也与 3.05 bit 的 KIVI 相当,而位宽小约四分之一。
与权重量化叠加
KV Cache 量化不必单打独斗。论文把 KVQuant 与自家 SqueezeLLM 的权重量化(4-bit/3-bit dense-and-sparse)叠加:LLaMA-7B/13B 上,4-bit 权重 + nuq4-1% KV 相对纯权重量化只多 0.02 PPL,3-bit 权重 + nuq3-1% 只多 0.1 PPL——权重与 KV 的误差几乎不互相放大,全栈量化的道路是通的。
1M 与 10M:账是怎么算平的
回到标题里的「10 Million Context」。论文附录 A 的估算表(前文已列部分)给出关键数字:LLaMA-7B 在 1M 上下文下 fp16 KV Cache 需要 512 GB,nuq2(2-bit,无稀疏)压到 64.1 GB,加上 4-bit 量化后的权重(1.6 GB),总计约 66 GB——刚好装进一张 A100-80GB;10M 上下文下 nuq2 需要 611.5 GB,分摊到 8 张 A100(总 640 GB)同样成立(nuq3 则需 8 卡装 65B 的 1M 上下文:480.3 GB 分到 8 卡约 60 GB/卡)。这是「纸上容量」估算,实际端到端还要考虑激活、临时缓冲与 PagedAttention 式的碎片管理,但方向是实的——这正是论文与其配套的 LWM(Large World Model)仓库所做的事情:用 KVQuant kernel 在单张 A100 上推理 1M 上下文的世界模型。
小结:四件套的逻辑与启示
把 KVQuant 的机制串起来,会发现它是一套严密的「先诊断、后对症」流程:先用量化友好性(quantization friendliness)的眼光审视 KV 分布(图 2、图 4),找到四个可剥削的结构——通道离群、旋转搅拌、非均匀重尾、数值离群值;再为每个结构安排一个机制——按通道量化匹配通道离群、预旋转量化躲开旋转搅拌、敏感度加权非均匀码本贴合重尾分布、逐向量稠密-稀疏隔离数值离群值;最后用 attention sink 感知与「Key 离线、Value 在线」的校准分工,解决激活量化特有的在线统计难题。每一步的消融都有明确的 PPL 账本(10.87 → 7.05 → 6.23 → 5.94 → 5.75,fp16 为 5.68),读者可以清楚看到每个机制各自值多少钱。
它也示范了几条可迁移的系统级洞察:
- 量化轴、旋转状态、离群粒度必须联合设计,单独优化任何一环都会错过另一环的红利(附录 P 里 per-token 时 pre-RoPE 反而变差,就是反例);
- 码本分配要按敏感度而不是幅度,普通 k-means 造出的码本可能比均匀量化更差;
- 带宽受限场景下可以放心用「重反量化」换压缩,这是 KV 与权重场景的账本差异;
- 让量化对校准分布不敏感(离群隔离),比寻找更好的校准分布更有效,直接消解了离线校准的分布偏移问题。
局限方面,论文自己也承认几点:这套方法只解决「给定长上下文模型后如何高效推理」,训练/扩展出 10 万+ 上下文模型本身是正交的前置工作;实测 kernel 针对的是带宽受限的解码阶段,prefill 阶段的并行批量压缩当时未覆盖(仓库后续已补充 GPU 并行 top-k 与并行打包 kernel);端到端实现里稀疏矩阵的追加仍有内存重排开销,论文计划用分块分配解决。另外,2-bit 仍依赖 attention sink 保留与 1% 离群隔离才压得住,并非所有模型都能无损吃下。
KVQuant 之后,KV Cache 量化迅速成为长上下文推理的标准组件:IntactKV 等并发/后续工作把「保留关键 token 不量化」进一步系统化;llama.cpp 社区围绕极端 KV 量化的讨论(如 TurboQuant 把每分量压向 3-bit、以及 K/V 非对称位宽分配:3-bit Key + 2-bit Value 在某些架构上质量远好于对称 2-bit 的观察)也把 KVQuant 当作基准与起点。理解了本文的四件套,再去看这些工作会轻松很多——它们大多是在 KVQuant 的框架上调整一两个旋钮。
参考资料
- KVQuant 论文(arXiv:2401.18079,v6 含全部附录)
- NeurIPS 2024 论文全文 PDF(Proceedings 版)
- KVQuant 官方代码仓库(SqueezeAILab/KVQuant,含 LWM 1M 推理)
- KIVI 论文(arXiv:2402.02750)
- SqueezeLLM 论文(arXiv:2306.07629,dense-and-sparse 权重量化)
- StreamingLLM 论文(arXiv:2309.17453,attention sink)
- IntactKV 论文(arXiv:2403.01241,并发提出保留 pivot token)
- KVQuant 中文阅读笔记(Zhongzhu Zhou 技术博客)
- KVQuant 英文技术综述(Zhongzhu Zhou Technical Review)
- 地平线开发者社区:LLM 量化技术介绍之 KV Cache 量化
- llama.cpp 社区讨论:TurboQuant——极端 KV Cache 量化
- llama.cpp issue #21591:非对称 K/V 量化(3-bit K + 2-bit V)的质量观察
- LWM:World Model on Million-Length Video and Language(1M 上下文模型仓库)
- LongBench:长上下文理解基准(arXiv:2308.14508)
- RULER:长上下文模型真实上下文长度评估(arXiv:2404.06654)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


