


SWA 滑窗注意力完全拆解:只加 4 个 attention sink,零训练反超后训练线性注意力
2026 年 8 月,微软 Applied Sciences Group 的 Alexia Jolicoeur-Martineau 等人在 arXiv 发布论文《Sliding-window beats linear attention》(arXiv:2608.28444),给出一个非常”便宜”的结论:预训练模型推理时把注意力掩码换成带 attention sink 的滑窗注意力(SWA),不需要任何后训练,就能在绝大多数知识与推理任务上追平乃至超过花了几千万到上百亿 token 后训练出来的线性注意力模型;在需要长上下文推理的任务上,两者的差距是 2 到 10 倍。
这篇论文值得拆解的地方不止于结论本身,更在于它揭示了一个长期存在的比较方法问题:线性注意力研究一直在跟一个”注定会输”的滑窗基线对比。理解这件事,等于把滑窗注意力、attention sink、线性注意力与后训练线性化这几块拼图重新摆正了位置。
背景:每一步解码都越来越贵
Transformer 的自注意力可以写成:对序列位置 ,输出是历史 KV 的加权和
其中 是查询、键、值向量(按注意力头划分,每个头维度 ),分子是对所有历史位置做 softmax 加权求和,分母是归一化常数。写全序列的复杂度是 ( 为序列长度),这是”训练/预填充”视角的账。
推理(解码)侧的账是另一本:生成第 个 token 时,注意力需要把前 个位置的键和值全部读出来做点积。为了不重复计算,框架把历史 KV 存进 KV Cache,每个新 token 只追加自己的一份。于是每解码一个 token:
- 计算量随历史长度线性增长(要与 个 key 点积);
- 内存持续增长且永不释放——每个 token 约占用 字节(FP16)。以 32 层、8 个 KV 头、 的 8B 级模型为例,单个 token 的 KV 约 131 KB(128 KiB),128K 上下文累计约 17 GB,基本把一张卡的显存吃光;
- 解码速度被从 HBM 搬运 KV 的带宽锁死,历史越长,每步越慢。这在吞吐曲线上表现为:上下文超过一定长度后,每秒产出 token 数持续下滑。
“上下文越用越贵”是这条二次注意力路线的结构性缺陷,也是所有改进工作的出发点。
两条省内存的路线:稀疏化与线性化
解决方向大致分两类:一类是稀疏化注意力掩码,让每个 query 只 attend 一部分 key;另一类是线性注意力,把 softmax 注意力改写成可以递推的形式,彻底摆脱”历史越长越贵”。
路线 A:滑窗注意力(SWA)
滑窗注意力(Sliding Window Attention,SWA)由 Longformer(Beltagy et al., 2020)提出:每个 token 只 attend 自己之前最近 个 token,
解码时 KV Cache 只保留窗内的 token,窗口写满后逐 token 滚动替换,内存与每步计算量封顶为 ,与总上下文长度无关。 的配置下,上例模型的 KV 内存恒定在约 8 MB 量级——注意这不是量化或压缩,只是”不看那么远”。
直觉上,只看最近 个 token 会不会太”近视”?不会完全近视,因为注意力层是堆叠的:第 层的输出已经把前 层各自 宽的局部信息逐层传递上来,有效感受野约为 ,这和卷积网络里感受野随层数扩张是同一套逻辑。Longformer 之后,Mistral 7B(arXiv:2310.06825)直接以 4096 的窗口做预训练,在 32K 上下文上滚动缓存推理,是 SWA 大规模落地的代表。
路线 B:线性注意力与”后训练线性化”
线性注意力(Katharopoulos et al., 2020)走的是另一条路:把注意力核函数做分解
其中 是把向量映到某个(通常更高维或等维)特征空间的变换,要求 能近似模拟 softmax 的”指数尖峰”形状。代入注意力公式后,求和项可以交换顺序:
关键在于中间量可以递推:
(历史 KV 的”线性状态”)和 (归一化状态)大小固定,不随序列增长。于是每解码一个 token 只做一次状态更新(),时间与内存对上下文长度都是 ——这就是线性注意力的承诺:用一个固定大小的递归状态替代不断增长的 KV Cache。Mamba、RWKV、GLA、Gated DeltaNet 等模型都可以归入这一家族。
线性注意力的代价同样明确,论文概括为三点:一是表达力弱于 softmax 注意力(softmax 可以表达尖锐的”检索”模式,线性核难以模拟);二是”记什么、忘什么”不可控,固定状态必然互相覆盖;三是训练与部署生态不成熟。为了绕开”从头训练太贵”,出现了后训练线性化这条研究线:拿现成预训练模型,把注意力层替换成线性注意力,再蒸馏/微调补回性能。早期工作如 Mamba in the Llama(20B token)、MOHAWK(3-5B token)、SUPRA(Linearizing Large Language Models,100B token)、Llamba(8-12B token)用几十亿 token 量级恢复大部分性能;LoLCATs 则用 LoRA 把成本压到 4000 万 token,并能恢复 97.5% 的平均基准分。后训练线性化因此一度被看作”低成本的二次问题解药”。
值得先记住一个细节:LoLCATs 名字里的 S 就是 SWA——为了不崩,这些线性化方法普遍在架构里混合保留了一条滑窗分支(论文图 1 中的 LoLCATs/Liger-GLA 掩码正是”线性注意力 + 滑窗”的叠加)。也就是说,即便在”去二次化”的阵营内部,SWA 也被当作不可省的安全网。
缺失的基线:sink-free 的 SWA 是个注定输的比较对象
SWA 有一个广为人知的坑:纯滑窗(不保留开头 token)在长文本上会灾难性失效。原因是 LLM 里存在 attention sink(注意力汇聚点)现象——StreamingLLM(Xiao et al., ICLR 2024)发现,语言模型的注意力分布会异常集中在序列最前面的几个 token(常常是 BOS、空格这些语义空洞的位置)上,即使它们与当前内容毫无关系。这些位置是模型给”多余注意力”找的倾倒处:softmax 要求权重归一化,当模型没有真正想 attend 的东西时,把权重倾泻给 sink 对输出的扰动最小。一旦滑窗越过这些 token,注意力失去合法的”汇点”,分布被摊到每个真实 token 上,输出表征被扭曲,长文本生成随之崩溃(流式场景下模型”失忆”甚至输出乱码,详见本站 StreamingLLM 完全拆解)。
修复办法简单到出奇:在滑窗外固定保留序列开头的前 个 token(StreamingLLM 的结论)。微软这篇论文把这个方案形式化为记号 : 是窗口总宽度, 是保留的 sink 数(全文固定为 4),即第 个 token 的注意力集合为
也就是”最近 个 token + 开头 个 token”。位置 超过窗口后,这个集合大小恒为 ,KV Cache 不再增长。
于是微软团队指出了一个尴尬的错位:几乎所有线性注意力论文对比的 SWA 基线都是不带 sink 的版本。既然 sink-free SWA 在长序列上必然灾难性崩溃,这种对比等于先打折对手再宣布胜利。没有人做过”带 sink 的 SWA vs 后训练线性注意力”的直接对照——这正是该论文补上的一块拼图。下图是论文给出的三种掩码对比:
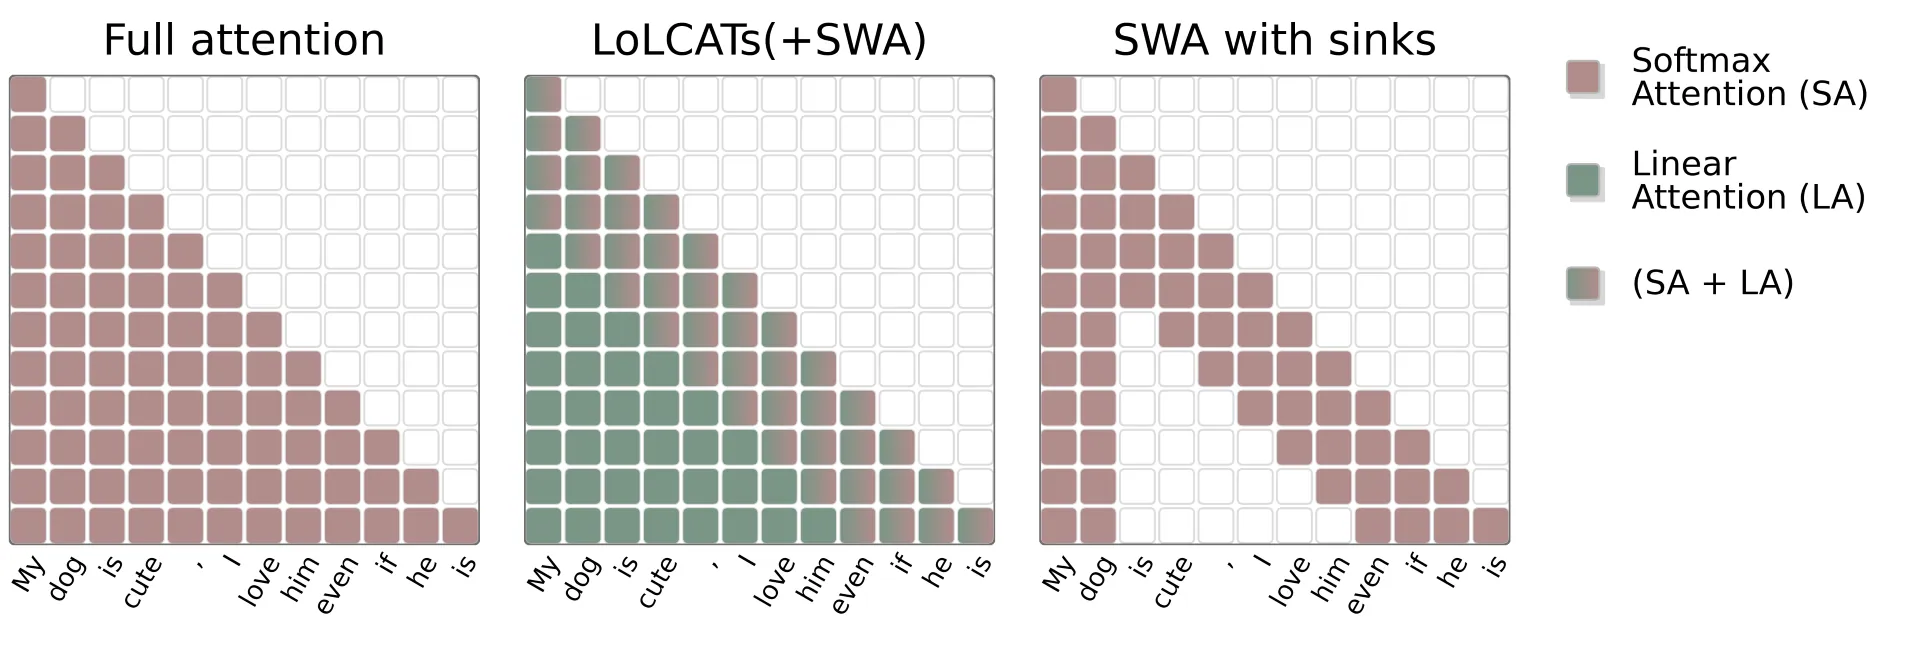
读图只需要把握一点:方格阵中的色块表示该(key, query)位置可被注意力访问,三块图分别对应三种模式的掩码结构。全注意力对全部历史开放;LoLCATs/Liger-GLA 把注意力拆成”线性状态 + 一段滑窗”的叠加;而带 sink 的 SWA 把可见位置限制在最近 个 token 与开头的 sink token 上。整个改动量,只是把推理时的注意力掩码与 KV Cache 保留策略换掉。
短上下文常识与推理:11 组对照,零训练拿下 9 组
实验的公平性设计是这篇文章最扎实的部分。评估框架分三层:Teacher(原始预训练模型,全注意力,作为分数天花板)、SWA(w, s)(Teacher 的权重原封不动,推理时直接换成滑窗掩码,0 训练 token)、以及各线性化方法(在自己的 Teacher 上做后训练蒸馏得到的模型)。指标选 MMLU(5-shot)、ARC-C、ARC-E、HellaSwag、PIQA、Winogrande 六个通用知识/推理基准,这些正是线性化论文自己惯用的指标。恢复率(Recovery)定义为学生分数除以对应 Teacher 分数。
论文先把 12 种线性化方法与 的恢复率汇总成一张总表(表 1)。表中”后训练 token 数”是各方法在各自论文中声称的成本,“阶段数”是蒸馏阶段数,括号内为跨多个基础模型的标准差:
| 方法 | 后训练 token | 阶段 | MMLU 恢复率 | 平均恢复率 |
|---|---|---|---|---|
| SUPRA | 100B | 1 | 53.0 | 88.1 |
| Hedgehog | 40M | 2 | 36.9 | 73.9 |
| LoLCATs | 40M | 2 | 83.2 (2.2) | 97.5 (1.3) |
| Liger-GLA | 20M | 1 | 62.2 (5.8) | 92.0 (2.8) |
| MOHAWK | 3-5B | 3 | 56.9 | 92.4 |
| Mamba in the Llama | 20B | 2 | 67.7 | 86.7 |
| DiJiang | 40B | 1 | 88.7 | — |
| ARWKV | 60M/830M | 2/3 | 84.1 | 94.7 |
| Llamba | 8-12B | 3 | 91.5 | 98.6 |
| QLinAtt | 350-700M | 3 | 74.0 | 92.9 |
| QRWKV6 | 350-700M | 3 | 92.4 (2.7) | 99.1 (0.8) |
| QRWKV7 | 350-700M | 3 | 86.4 (6.8) | 96.1 (4.1) |
| SWA(64, 4) | 0 | 0 | 93.2 (3.5) | 99.0 (0.5) |
这张表读出三个梯队。第一梯队是 :0 个训练 token,MMLU 恢复率 93.2%,六个基准平均恢复率 99.0%。第二梯队是花了大钱的线性化方法:Llamba 烧了 8-12B token 蒸馏,平均恢复率 98.6% 略逊于 SWA,MMLU 恢复率 91.5%;QRWKV6 用了 3.5-7 亿 token 三阶段训练,平均恢复率 99.1%(比 SWA 的 99.0% 略高 0.1 个百分点),MMLU 恢复率 92.4%。第三梯队是 LoLCATs/Liger-GLA 等”省 token”方法:LoLCATs 只花 40M token 就达到 97.5% 平均恢复率,但 MMLU 只恢复 83.2%——恰是这类方法在论文宣传里常被强调的”惊人性价比”,放在 SWA 的零成本对照下立刻失色。
诚实地说,在短上下文平均分上 与顶配线性化方法(QRWKV6)是打平关系,真正的压倒性优势在 MMLU 恢复率与训练成本上;而论文作者也明确承认了这一点,并没有把”平均恢复率 99.0 vs 99.1”包装成完胜。这组数字的杀伤力在于成本不对称:一边是 0 token + 改一行掩码,另一边是数亿 token 的多阶段蒸馏,结果只是打平。
模型层面(论文表 2)覆盖 1.3B 到 70B 的 11 个基础模型:Phi-1.5-1.3B、Mistral-7B-v0.1、Llama 2-7B、Llama 3-8B、Llama 3-8B-Instruct、Llama 3.1-8B、Llama 3.1-70B、Qwen 2.5-7B/32B/72B-Instruct、QwQ-32B。下表把每个模型压缩成一行(教师 vs SWA vs 该模型下最强的线性化方法,按六基准平均分):
| 基础模型 | Teacher | SWA(64,4) | 最佳线性化方法(训练 token) |
|---|---|---|---|
| Phi-1.5-1.3B | 63.1 | 62.4 | LoLCATs 62.5(40M) |
| Mistral-7B-v0.1 | 72.3 | 71.2 | LoLCATs 70.7(40M) |
| Llama 2-7B | 65.0 | 63.8 | DiJiang MMLU 40.7 vs SWA 39.8 |
| Llama 3-8B | 71.9 | 71.0 | LoLCATs 70.7(40M) |
| Llama 3-8B-Instruct | 71.6 | 70.7 | Mamba2 62.1(0) |
| Llama 3.1-8B | 72.5 | 71.8 | Llamba 71.5(12B) |
| Llama 3.1-70B | 79.1 | 78.2 | LoLCATs 75.6(40M) |
| Qwen 2.5-7B-Instruct | 73.7 | 73.0 | QRWKV7-RoPE 72.8(600M) |
| Qwen 2.5-32B-Instruct | 77.2 | 76.6 | QRWKV6 77.3(600M) |
| QwQ-32B | 75.2 | 75.2 | QRWKV6 74.7(600M) |
| Qwen 2.5-72B-Instruct | 80.1 | 79.8 | QRWKV6 79.3(600M) |
注:Llama 2-7B 一行的 DiJiang 未报告完整基准,只能单比 MMLU;其余行中加粗的 SWA 分数代表该模型下非教师方法的最优平均分。
11 组可比对照里 SWA 拿下 9 组,例外恰好两个,且都值得分析。第一个例外是 Phi-1.5-1.3B:LoLCATs 平均分 62.5,仅比 SWA 的 62.4 高 0.1 分——1.3B 小模型上线性化损失的绝对值本来就小,两者几乎并列。第二个例外是 Qwen 2.5-32B-Instruct:QRWKV6 拿到 77.3,与 Teacher 的 77.2 持平(线性化在这个模型上罕见地无损),SWA 则掉到 76.6。这两个反例恰好证明作者没有挑选对自己有利的模型:线性注意力不是永远差,而是要用数亿 token 的后训练才能换到与零成本 SWA 相当乃至略优的结果。
几个额外观察。其一,模型越大 SWA 越稳:Llama 3.1-70B 上 SWA 平均 78.2(教师 79.1),MMLU 从 78.9 降到 73.2(恢复约 92.8%);Qwen 2.5-72B 上平均分 79.8 vs 80.1,几乎无损。其二,对话/指令微调甚至 RL 后模型同样适用:Llama 3-8B-Instruct、Qwen 2.5 系列 Instruct、推理模型 QwQ-32B(SWA 平均分与教师完全持平)都进过实验池。其三,论文附录里他们还在更现代的架构(Qwen3-8B、Phi-4-mini-reasoning、Phi-4-reasoning-plus)上用 GLA、Gated DeltaNet、QRWKV6 按 LoLCATs 风格自蒸馏(0.1B cleaned-Alpaca token),线性化模型平均分集体跌到 45-56 分(教师 61.7-75.4),而 SWA(64,4) 稳定在 60.9-74.9——用少量通用蒸馏数据线性化 8B 级新模型,恢复效果远不如旧模型上那些精心调过的配方,线性化方法对”蒸馏数据的质与量”高度敏感。
长上下文推理:从”打平”到”2-10 倍碾压”
短上下文任务(MMLU 等)大多只依赖句子内部与相邻句子的局部线索,线性注意力的固定状态够用;真正的分水岭在需要跨长距离回溯事实的任务上。论文用两个经典基准验证:Single Needle-in-a-Haystack(S-NIAH,从长文本里找回埋入的事实)与 BABILong(多跳推理,需要把散布在长文本里的事实串起来)。基础模型统一是 Llama 3.1-8B。
S-NIAH:检索任务
S-NIAH 有 1/2/3 三个难度(要找回 1/2/3 个”针”),上下文从 0.5K 测到 4K。对比 (w=512$ 的一组代表性数据(S-NIAH-3,最难):
| 上下文长度 | 0.5K | 1K | 2K | 4K |
|---|---|---|---|---|
| SWA(512, 4) | 100 | 90.4 | 64.8 | 23.0 |
| LoLCATs(+SWA) | 100 | 51.0 | 10.6 | 5.8 |
| Liger-GLA(+SWA) | 97.6 | 1.2 | 1.2 | 0.0 |
| Full Attention | 100 | 100 | 100 | 99.8 |
在 0.5K 时三者普遍接近满分(针还落在窗口内,直接命中即可);一旦上下文长度超过窗口,分化立刻出现——Liger-GLA 在 1K 就基本归零(512 窗的 S-NIAH-1 只剩 1.0 分),SWA 与 LoLCATs 在 1K 尚能维持,差距在 2K/4K 彻底拉开。以最难的 S-NIAH-3(三个针)在 4K 上下文为例,SWA 在 128/256/512 三档窗口拿到 17.2/19.6/23.0,LoLCATs 只有 1.6/2.2/5.8,Liger-GLA 是 0.8/0.6/0.0——论文摘要中”SWA 恢复全注意力性能的 17.2%-23%,LoLCATs 与 Liger-GLA 至多 5.8% 与 0.8%“指的就是这组任务(全注意力在该长度接近满分,准确率与恢复率几乎相等)。逐格核对这些任务在 4K 的全部 9 个格子(3 窗口 × 3 难度),LoLCATs 每个格子都低于 SWA 同窗配置的分数:差距最小处在 S-NIAH-2 的 512 窗(SWA 23.0 对 16.6),最大处 LoLCATs 直接归零(128 窗的 S-NIAH-1,SWA 12.6 对 0)。窗口收益同样只属于 SWA:4K 的 S-NIAH-1 上,SWA 从 的 12.6 涨到 的 19.0,而 LoLCATs 只从 0 涨到 8.8——同样加宽窗口,SWA 把预算全部变成检索能力,混合线性化方法则被状态干扰稀释。
BABILong:多跳推理任务
BABILong 把 bAbI 的问答任务加长到 1K-4K 上下文,需要模型综合多句事实推理(QA1-QA5 平均),窗口固定 256:
| 上下文长度 | 0K | 1K | 2K | 4K |
|---|---|---|---|---|
| SWA(256, 4) | 55 | 20 | 19 | 15 |
| LoLCATs(+SWA) | 56 | 22 | 10 | 3 |
| Full Attention | 74 | 70 | 67 | 60 |
0K 时两者几乎并列(甚至 LoLCATs 略高),1K 时 LoLCATs 还领先 2 分——与短上下文实验一致,状态在小范围内够用。但从 2K 开始剧情反转:SWA 在 2K/4K 拿到 19/15,LoLCATs 只剩 10/3。按恢复率算,4K 下 SWA 恢复全注意力约 25%(15/60),LoLCATs 只恢复 5%(3/60)。逐任务看 4K 的数据更有意思:SWA 在 QA1-QA5 上分别拿 12/6/11/18/30,LoLCATs 是 3/1/4/1/6——LoLCATs 分数在 1-6 之间徘徊,基本是”每问必错”的随机水平,而 SWA 的 QA4(时间推理)与 QA5(归纳)还能保持两位数。
论文摘要里”2 到 10 倍”的说法就是对这批长上下文数据的总结:比值随任务、窗口与对照方法浮动——BABILong 4K 上约为 5 倍(15 对 3),S-NIAH 上小则约 1.4 倍(512 窗的 S-NIAH-2,23.0 对 16.6),大则超过 10 倍(128 窗的 S-NIAH-3,17.2 对 1.6)。严格讲这不是”加速倍数”而是精度倍数(同一任务上的准确率之比),读论文时别把两个量纲混在一起。
为什么线性注意力的状态在长上下文里系统性变差
机制上的原因论文没有长篇推导,但结合两类注意力的性质可以拆成三层。
第一层是检索的精确性。softmax 注意力的 query 和 key 在做近似最近邻匹配:query 可以”指向”历史上任意一个具体位置, 能对单个 key 形成尖锐的峰值,且 个历史位置彼此不共享容量。线性注意力把全部历史压进一个固定大小的状态 (每个头一个 矩阵),写入与覆盖同时发生:新信息必然挤占旧信息。检索一个很久以前的精确事实,对全注意力只是”一个点积峰值”的事,对线性状态则是”在压缩了 个 token 的容量里大海捞针”。
第二层是任务的时序结构。S-NIAH/BABILong 这类任务的解题线索往往集中在文本后段(针通常埋在长文本的后半部分,多跳推理的最后几条事实也在近期窗口内)。SWA 对近期 token 是全保真存储,query 与窗内 key 的点积匹配完全无损;线性状态则把近期事实与更早的历史混在同一个状态里互相干扰。论文附录的逐任务数据支持这个解释:LoLCATs 在需要”回溯最早事实”的 QA1 上 4K 只剩 3 分,而 SWA 靠窗口内保留的近期推理链维持两位数。
第三层是表达力天花板。 的核函数理论上可以模拟任意尖锐的相似度函数,而线性核 的表达范围窄得多。Hedgehog(arXiv:2402.04347)这类工作专门研究”什么样的 能更接近 softmax 的尖峰形态”(其设计是 的双边指数变换),本身就是线性注意力表达力不足的注脚——需要专门造核函数去”模仿”softmax,恰恰说明原版函数有不可替代的性质。
值得补充一个反直觉的结论:长上下文并不是线性注意力的主场。宣传里线性注意力的卖点是”上下文任意长内存恒定”,但这份报告显示,真到了需要从长上下文里精确取用信息的任务上,固定状态是失忆的根源。它的 状态只适合”历史无所谓,近期流更重要”的场景——而那恰好也是 SWA 的最强场景,并且 SWA 还保真得多。
速度与内存实测:免训练的同时还更快
性能之外,论文补了一组速度/内存/FLOPs 的微基准。设置:4 层 Transformer(嵌入维度 1024,16 个头、头维 64),batch size 1,FP16,NVIDIA RTX PRO 6000 Blackwell Max-Q 工作站;全注意力与 SWA 走 FlashAttention 后端,线性注意力走 ThunderKittens(arXiv:2410.20399)后端,LoLCATs 用 ThunderKittens 的”滑窗+线性”融合 kernel(窗 256)。上下文长度扫 128 到 256K:
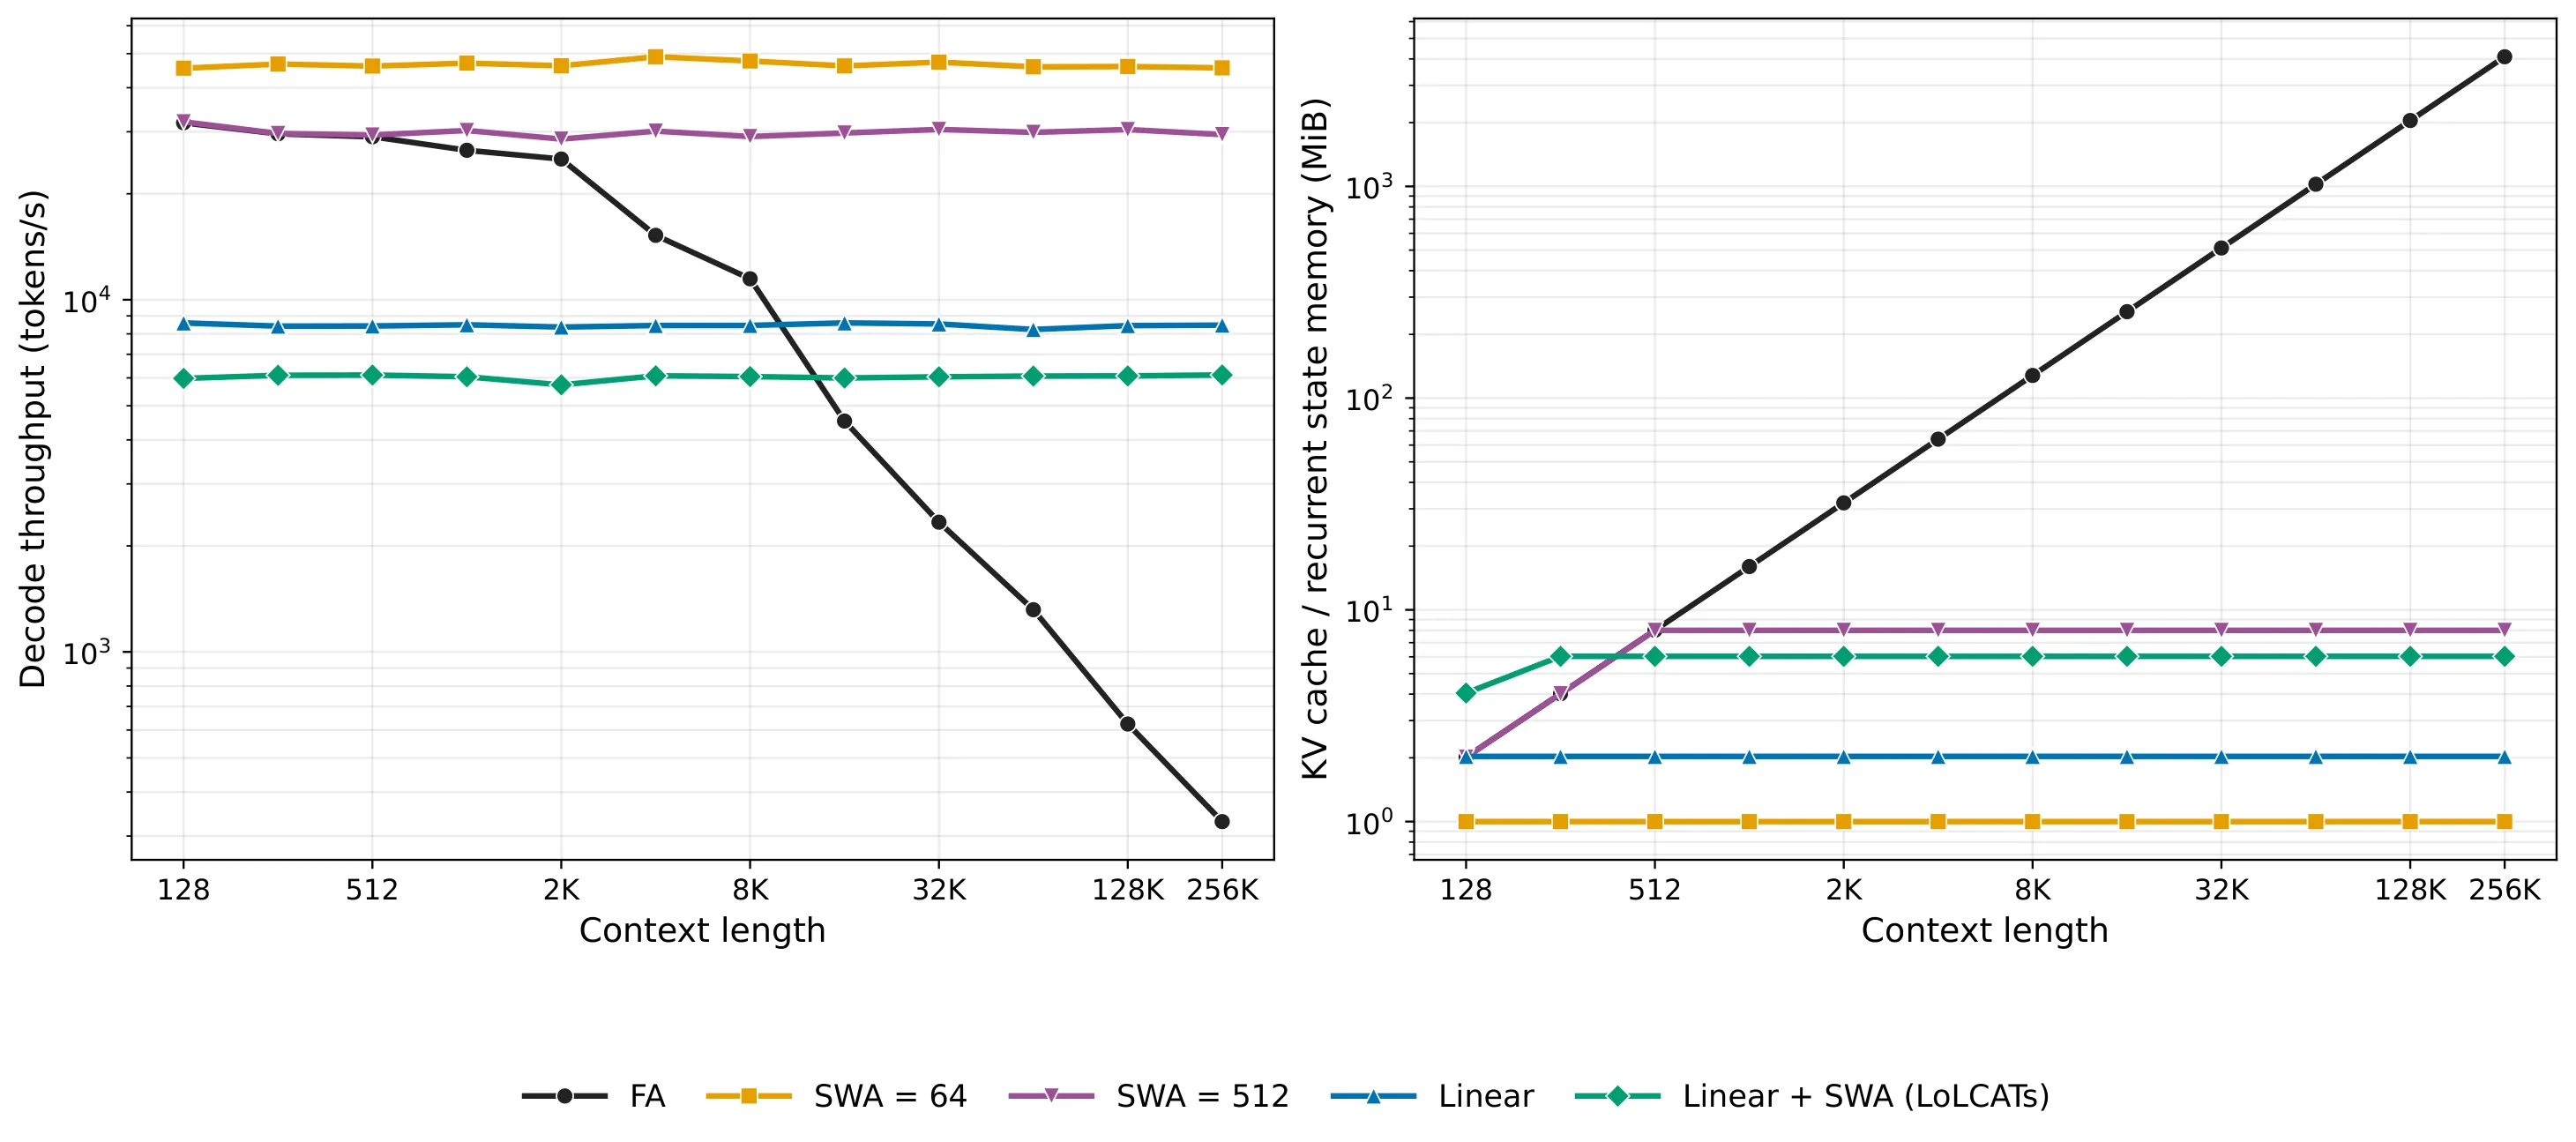
左面板是解码吞吐:全注意力在上下文超过约 1K 后开始持续下滑(每步要把全部历史 KV 从显存搬进计算单元,带宽锁死);其余方法全程基本是一条水平线。SWA 是全场最快——64 窗快于 512 窗,两者都快于线性注意力和 LoLCATs。右面板是内存:全注意力随上下文线性上涨(256K 时已达 GiB 量级);SWA 的内存先涨到窗口大小、随后封顶, 的 SWA 拥有全场最低内存,其次才是线性注意力,LoLCATs(状态+256 窗)再高一些, 的 SWA 最高。
这份微基准的配置值得解读两句:4 层小模型测的是注意力机制本身的相对成本,放大的是”KV 规模随上下文增长”这一因素,与模型层数无关的结论(曲线形状、方法排序)对生产级模型依然成立;它没有覆盖预填充(prefill)阶段的并行效率——那是另一本账,对单请求解码吞吐影响不大。另外注意全注意力直到上下文超过 1K 才明显变慢,说明短上下文下”看得全”并没有付出多大解码代价,滑窗的价值正是在上下文变长之后才兑现。
这里有一个反常识的点值得解释:常被宣传为”内存 “的线性注意力,实测内存并不是最低。它的递归状态(每个头一个 的 加一个 维的 )虽然与上下文无关,却是按层、按头存储的稠密矩阵,常数并不小,最终数值还取决于状态精度与 kernel 实现等细节;而 的 SWA 只是滚动保留 64 个 token 的 KV,窗口越小常数越小。也就是说,” vs “的渐进比较在常数层面并没有那么悬殊,窗口取小一点的 SWA 在论文的实测配置里反而最省——只有当窗口开到 512 时,KV 内存才明显超过线性状态。另外线性注意力的解码还要串行读写状态并施加核变换,FLOPs 并不低——论文附录的 FLOPs 图(下)显示每解码一个 token 的注意力计算量:全注意力随上下文近似线性增长,SWA 涨到窗口大小后封顶,线性注意力与 LoLCATs 则是与上下文长度无关的常数线—— 的承诺正是来自这里,只是这条常数线并不比中小窗口的 SWA 更低:
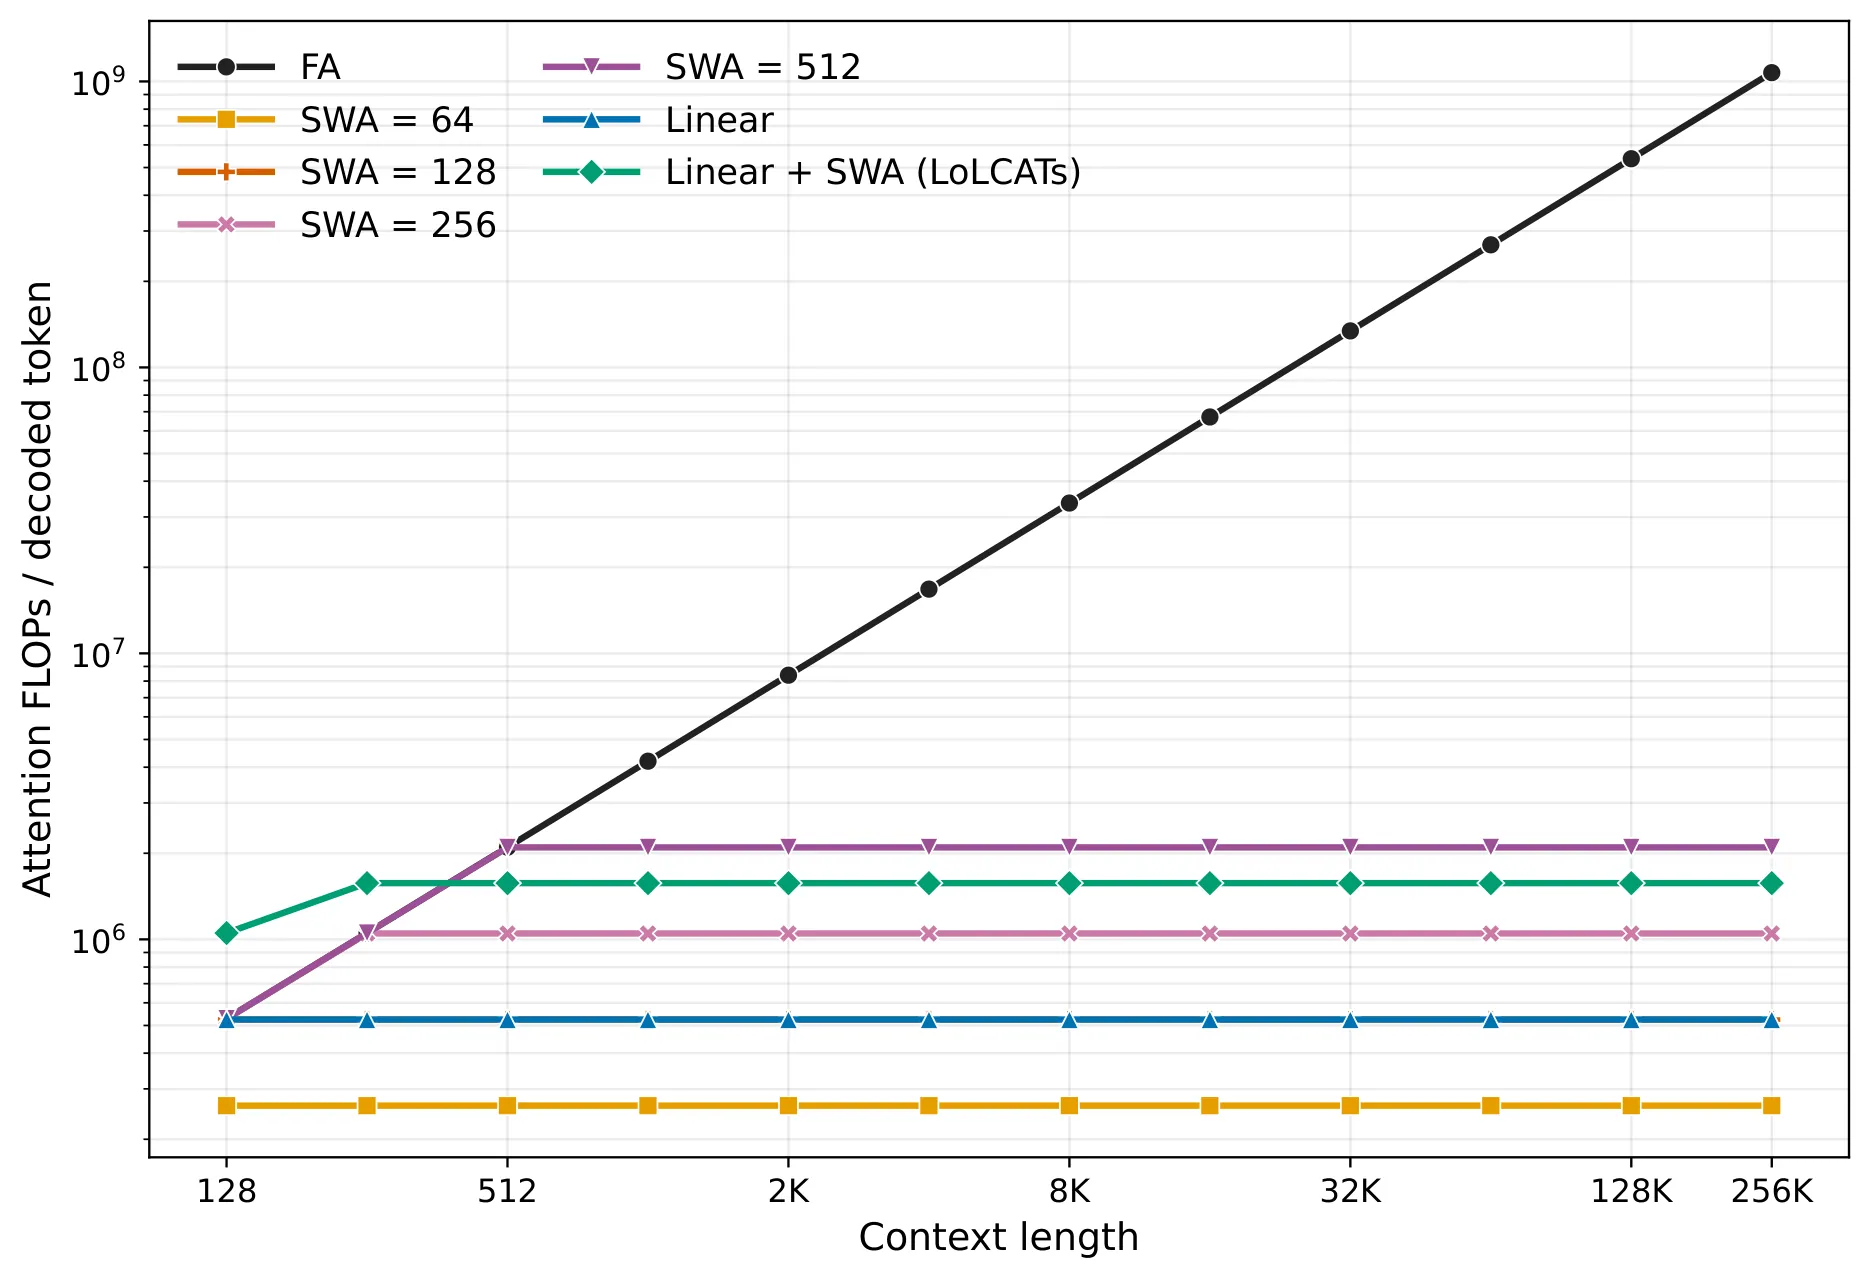
把吞吐与 FLOPs 图合起来看,结论很干脆:在论文测试的配置下, 的 SWA 同时在速度、内存、计算量三个维度上不输给任何线性化方案,而它不需要训练,质量还更高。
局限与开放问题
论文的边界划得很清楚,引用结论时这些前提不能丢。
一是规模与长度的覆盖范围。质量评测最大到 70B(Llama 3.1-70B、Qwen 2.5-72B),长上下文评测的上限是 4K(相对 2026 年动辄 128K+ 的商用上下文仍是短距离),更长的上下文、agentic 任务、多模态模型都未涉及。SWA 在 4K 以上是否会继续衰减、线性状态在更长距离上是否反而更稳,仍无定论。
二是没碰混合注意力。论文刻意排除了”部分 token/部分层保留全注意力”的混合模型,而混合注意力恰是 2025-2026 年最活跃的设计方向——本站拆解过的 NSA 原生稀疏注意力(滑窗是三分支之一)、DeepSeek-V4 混合注意力(HCA 家族里始终保留滑窗组件)都在”全局压缩 + 滑窗兜底”的谱系里;而 Prefix Sliding 从推理侧把”sink”推广成了”保留任意长系统前缀 + 最近窗口”,与本文的 SWA(w, s) 是同一思想的两种尺度。SWA 与全注意力、线性注意力各自占多少比例最优,论文留给后续工作。从已有证据看,“滑窗兜底”几乎是所有混合架构的共识组件,这反过来再次支持了 SWA 的基础价值。
三是免训练是下界。论文只论证”零成本配置”,但业界已有针对 SWA 的后训练适配工作(如 SWAA),可以把滑窗模型的分数再往上推。反过来讲,这意味着论文测出的 SWA 性能是保守的”地板”而非”天花板”——线性化方法拿自己精心后训练的成果,对比的只是 SWA 的免训练默认档。
四是视频/多模态是开放战场。作者指出视频扩散模型已有免训练 SWA 很强的先例:Sliding Tile Attention(arXiv:2502.04507)在 HunyuanVideo 上以 3.53 倍速度恢复 97% 的 VBench 分数。多模态与视频的注意力是二维(空间)甚至三维(时空)滑窗,比文本一维滑窗的收益空间更大。
落地建议
把论文结论翻译成工程动作,其实只有几步:
- 改掩码:推理时把 causal mask 换成”开头 4 token + 最近 token”, 建议先在 128-512 之间扫描(论文数据里 64 已能保住大部分常识分,长上下文任务则明显吃窗口)。
- 改 KV Cache 策略:缓存只保留窗内 token,用环形/滚动分配复用已释放的物理块。生产框架大多已内置这一能力——vLLM 对 Mistral 这类原生 SWA 模型就是滚动缓存实现,SGLang 亦同;FlashAttention 的窗口掩码路径可直接复用,无需写新 kernel。
- 不必动权重:直接拿现成预训练模型上线即可,这是该方案与一切”改造型”方案的本质区别——回滚也只是把掩码换回去。
- 留出升级空间:若质量仍差一口气,再考虑 SWA 后训练微调;想要”远距离事实检索”能力,则要评估混合注意力路线(滑窗 + 全局压缩),那是另一个设计空间。
对自部署与推理服务而言,这等于在”KV Cache 压缩/驱逐”(如本站的 H2O、StreamingLLM 路线)之外多了一个零训练、零内核改写的固定内存选项:它没有驱逐策略的预测误差,代价是显式放弃远距离注意力——而论文的证据表明,大多数真实文本任务需要的”远距离”,只是开头那 4 个 token 而已。
那么滑窗到底把什么换掉了?对照 S-NIAH/BABILong 的衰减曲线可以看得很清楚:当需要回溯的内容落在窗口之外时,SWA 与线性方法同样无能为力(4K 上下文、512 窗下 SWA 是 23.0 分,而全注意力是 99.8)——滑窗不是”压缩”远距离信息,而是直接放弃它;线性状态试图”记住”远距离信息,却记不准。两种取舍在任务谱系上各有一席之地:代码补全里跨几百行的符号引用、长文档埋在开头的关键约束、多轮对话早期的用户偏好,这类”远距离精确信息”密集的场景仍然需要全注意力或混合注意力;而写作续写、翻译、单文档问答、agent 的近期工具调用链这类”近期信息主导”的场景,SWA 的损失几乎测不出来。工程选型前,用论文的恢复率口径(学生/教师)在自有任务数据上扫一遍窗口大小,比盲信任何一方的宣传都可靠。
小结
这篇论文没有提出新机制,它的贡献是把一个被忽略的基线摆回台面:带 4 个 attention sink 的 SWA 是一个免训练、免新内核、内存恒定、解码更快的方案,在短上下文上与烧掉数亿 token 后训练的线性注意力打平,在长上下文检索与多跳推理上以 2-10 倍的精度优势胜出。它同时给后训练线性化研究提了个醒:对比基线必须是与 sink 共存的 SWA,而不是注定崩溃的 sink-free 版本。
滑窗注意力的故事至此形成了一个完整闭环:Longformer 提出它,Mistral 用预训练证明它,StreamingLLM 用 4 个 sink 修复它,而现在这份来自微软的报告,把它定位成衡量一切”上下文效率改造”的基准线。2026 年的混合注意力架构里,滑窗仍是所有方案的兜底组件——最朴素的技术往往活得最久。
参考资料
- Sliding-window beats linear attention(arXiv:2608.28444)
- 论文 HTML 全文(arXiv:2608.28444v1)
- Longformer: The Long-Document Transformer(arXiv:2004.05150)
- Efficient Streaming Language Models with Attention Sinks / StreamingLLM(arXiv:2309.17453)
- Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention(arXiv:2006.16236)
- LoLCATs: On Low-Rank Linearizing of Large Language Models(arXiv:2410.10254)
- The Hedgehog & the Porcupine: Expressive Linear Attentions with Softmax Mimicry(arXiv:2402.04347)
- Linearizing Large Language Models / SUPRA(arXiv:2405.06640)
- Transformers to SSMs: Distilling Quadratic Knowledge to Subquadratic Models(arXiv:2408.10189)
- Llamba: Scaling Distilled Recurrent Models for Efficient Language Processing(arXiv:2502.14458)
- ThunderKittens: Simple, Fast, and Adorable AI Kernels(arXiv:2410.20399)
- Mistral 7B(arXiv:2310.06825)
- Fast Video Generation with Sliding Tile Attention(arXiv:2502.04507)
- 微软新研究:无需后训练,只加 4 个 Token,滑动窗口注意力反超线性注意力(智源社区解读)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


