


DeepSeek 3FS 完全拆解:链式复制、用户态零拷贝与 KVCache 磁盘缓存
先说清楚:为什么补这一篇
DeepSeek 在推理与系统方向的技术,本站已经覆盖得相当密:架构侧有 MLA、DeepSeekMoE、MTP 与 DSA 稀疏注意力;kernel 侧有 DeepGEMM;通信侧有 DeepEP;服务系统侧有 V3/R1 推理系统;KVCache 复用的方法论还有 RadixAttention 与 DualPath 等专文。
但如果把 open-infra-index 里那份开源清单逐条对照,会看到一个明显的缺口:存储层。
2025 年 2 月 24 日到 28 日,DeepSeek 办了一场”开源周”,每天放出一个组件:FlashMLA、DeepEP、DeepGEMM、DualPipe 与 EPLB,最后一天放出的是 3FS(Fire-Flyer File System) 与轻量数据处理框架 smallpond。前四个本站都写过,唯独 3FS 没有。而 3FS 恰恰是这套技术栈里唯一直接服务于 LLM 推理成本的服务——官方 README 的功能列表里明明白白写着 “KVCache for Inference: Provides a cost-effective alternative to DRAM-based caching”,SC24 论文里更直接点名它支撑了 DeepSeek 的 KV Context Caching on Disk,把推理服务的成本”降低了一个数量级”。
也就是说,本站讲了很多”怎么把 KV Cache 放进显存和内存”,但没讲”KV Cache 放不下的时候往哪放、怎么放得便宜”。这篇补上。
需要说明的是,3FS 不是又一个”论文里的漂亮设计”。它是 DeepSeek 生产集群里跑出来的系统,SC24 论文(arXiv:2408.14158)披露的硬件规模和实测数据都能对上号。文章里所有数字都来自官方 Design Notes、官方 README 与这篇论文。
背景:为什么通用文件系统做不了这件事
一台机器的 PCIe 账本
理解 3FS 的设计动机,要先理解它服务的集群长什么样。DeepSeek 的 Fire-Flyer 2 集群用的是 10,000 张 PCIe A100,不是 DGX 那种 SXM + NVLink 的昂贵形态。单机内部结构(论文 Figure 4)是这样的:
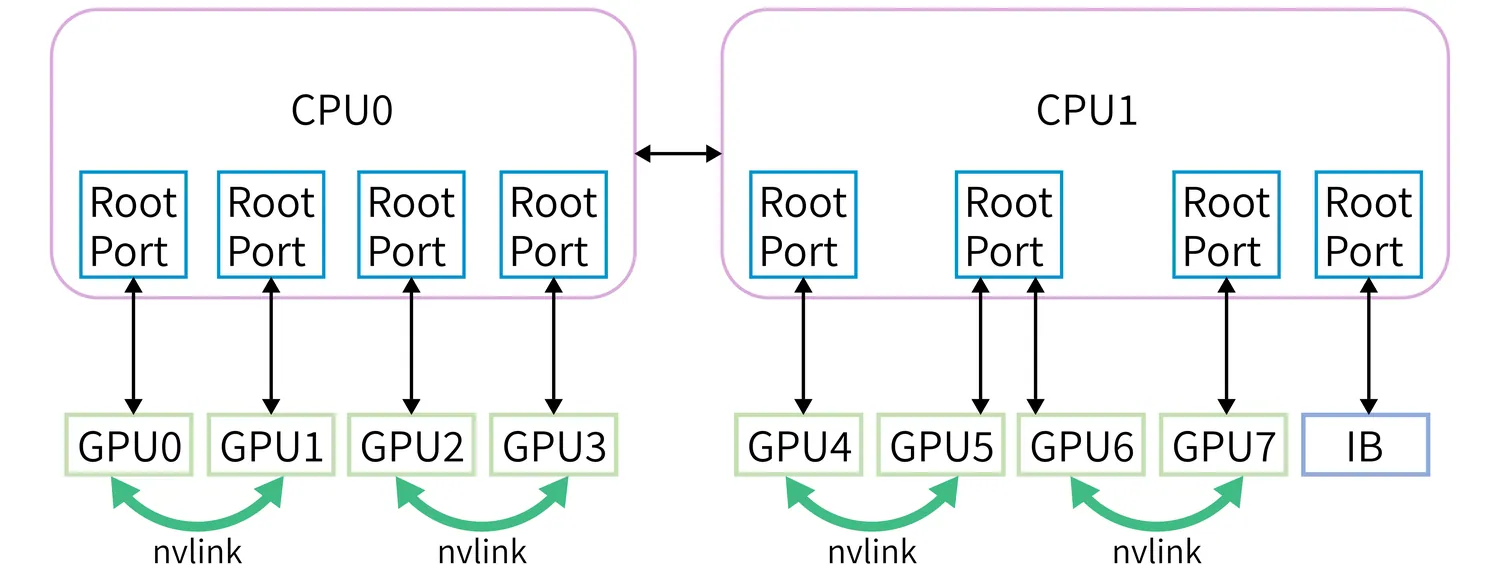
图中可以看到关键约束:两颗 CPU(CPU0、CPU1)各带 4 个 PCIe Root Port,8 张 GPU 分别挂在两个 CPU 下面,整个节点只有一张 200Gbps 的 InfiniBand 网卡,挂在 CPU1 上。GPU 两两之间用 NVLink 桥接(图中 GPU0-GPU1、GPU2-GPU3 等),但这是为了后续扩展补上的,最初的设计里连 NVLink 都没有。
这张图解释了 DeepSeek 的一个核心成本哲学:用 PCIe 替代 SXM,把硬件成本砍掉一半、能耗降 40%,代价是单机的卡间带宽和网卡出口带宽都远不如 DGX。既然硬件上省了钱,软件就必须把”便宜硬件的带宽”榨干——包括存储。
存储要同时满足四种矛盾的需求
AI 集群的存储面对着几类行为差异极大的负载,论文和官方文档里列得很清楚:
- 数据预处理:大量中间产物,需要层级目录管理,写多读少,文件数量巨大。
- Dataloader:训练时从几千个节点随机读样本,样本大小从几 KB 到几 MB 不等,且不对齐 4K。这是典型的随机小读。
- Checkpoint:几 TB 的参数和优化器状态要定期落盘,需要极高的顺序写带宽,而且不能阻塞训练。
- KVCache:推理时的 KV 缓存读写,需要极高的读吞吐 + 海量容量 + 能承受被反复淘汰重写。
用一套系统同时满足这四件事,是 3FS 全部设计张力的来源。华为/火山引擎的解读文章里有一个很到位的说法:3FS 要的是”把几千块 SSD 的 IOPS 和几百个存储节点的网络带宽聚合成一个池子,让应用以完全位置无关(locality-oblivious)的方式访问”。
传统方案在这里各有各的问题:
- NFS / 通用分布式文件系统:元数据是瓶颈,几万节点的随机小读打不住。
- 对象存储:论文专门讨论了为什么不选它。对象存储用 key 里的
/模拟目录层级,但不支持原子地移动目录、不支持递归删除整个目录。而 DeepSeek 内部一个非常常见的模式是”建临时目录 → 写文件 → 整体 move 到最终位置”,在处理海量小文件时,递归删除更是刚需。另外对象存储没有软链接和硬链接,而 DeepSeek 用它们给动态更新的数据集做轻量快照。 - 本地盘:数据无法在节点间共享,checkpoint 和 KVCache 复用都无从谈起。
所以 3FS 的选择是:做一个真正的文件系统(保留 POSIX 目录树语义、符号链接、硬链接),但把元数据和数据拆开,元数据交给事务型 KV,数据交给链式复制,两者都跑在 RDMA 网络上。
整体架构:四个角色与一张融合网络
3FS 的组成并不复杂,四个角色,全部接在 RDMA 网络(InfiniBand 或 RoCE)上:
| 角色 | 职责 | 状态 |
|---|---|---|
| Cluster Manager(mgmtd) | 集群成员管理、故障检测、链表的唯一修改者 | 多节点热备,一主多备 |
| Meta Service | 实现文件系统语义(open/create/rename…) | 无状态,可水平扩展 |
| Storage Service | 管理本地 SSD,提供 chunk 存储接口,实现 CRAQ | 管理若干 storage target |
| Client | FUSE 客户端 / 原生客户端 | 无状态 |
元数据和存储服务向 cluster manager 发心跳;cluster manager 负责成员变更并把集群配置广播给所有服务和客户端。多个 cluster manager 中选一个主,主挂了自动提升另一个。集群配置通常存在 ZooKeeper 或 etcd 里——但 DeepSeek 生产环境用的是和文件元数据同一个 KV(也就是 FoundationDB),理由很实在:少依赖一个组件,就少一份运维负担。
计算与存储共用一张网
这里有一个容易被忽略但极其重要的设计:3FS 的存储流量不和计算流量隔离在两张物理网络上。
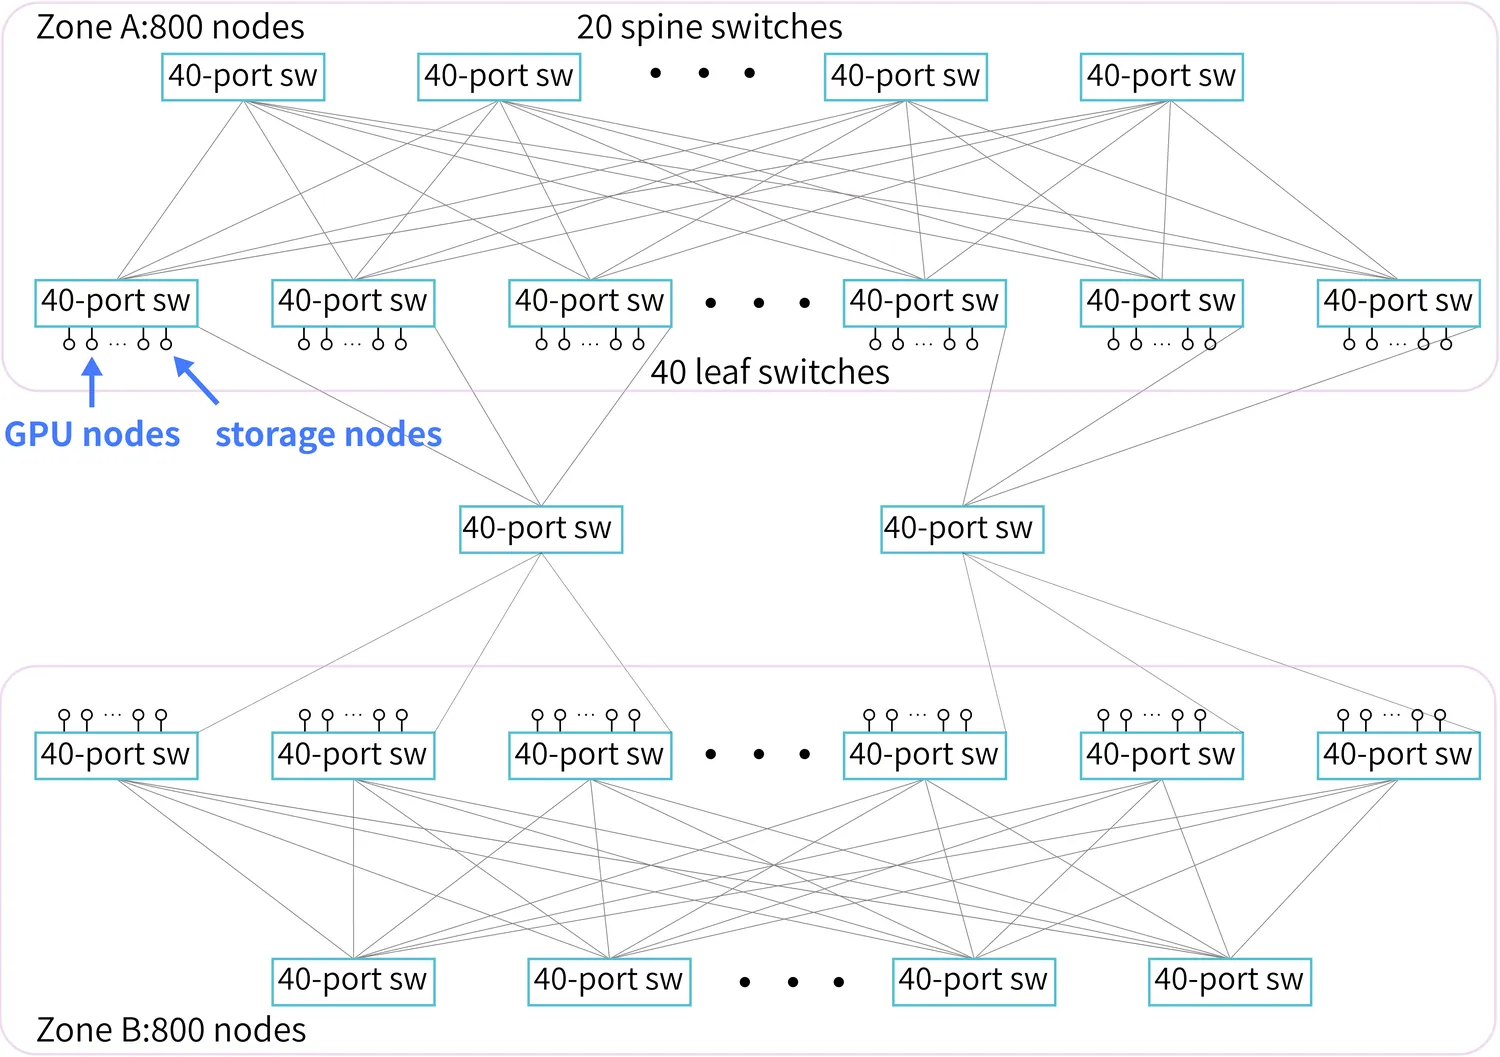
从图中能看到,Zone A 的 800 个节点挂在 40 台 leaf 交换机下,上面是 20 台 spine,组成一个完整的二层 Fat-Tree;Zone B 同样 800 节点,两个 Fat-Tree 之间通过 switch 再连起来。GPU 节点和存储节点共享同一组 leaf 交换机——论文里这叫 Computation-Storage Integrated Network(计算存储融合网络)。
融合网络省了钱(不用为存储单独建一张网),但带来一个直接后果:四种流量——HFReduce 通信、NCCL 通信、3FS 存储流量、其他流量——要在同一张网上抢带宽,还会互相干扰。DeepSeek 的应对手段有三层:
- 用 InfiniBand 的 Service Level(SL)做流量隔离。建立连接时给不同流量打不同的 SL,SL 再映射到 IB 的物理队列 Virtual Lane(VL),不同 lane 的流互不干扰。论文里说他们”最终配置了各自的比例”,从而避免了队头阻塞(HOL blocking)导致的拥塞。
- 调整路由,把存储流量均匀打散到 leaf → spine 链路上。
- 在 3FS 内部实现 request-to-send 流控,专门对付 incast 拥塞。
第 3 点值得单独说,因为它是 3FS 最反直觉的设计决策之一。
request-to-send:先申请,再发送
因为每个 3FS 客户端理论上都可以访问任意一个存储服务,客户端侧会出现严重的 incast 拥塞——几百个存储服务同时把数据往一个客户端塞,把它那唯一一张 200Gbps 网卡的接收队列打爆。
DeepSeek 的解法是在客户端和存储服务之间加一次握手:
1. Client 向 Storage Service 发起读请求2. Storage Service 从 SSD 读出数据,缓存在本地内存3. Storage Service 向 Client 申请"我可以发了吗?"4. Client 根据当前并发发送者数量决定是否授权5. 被授权后,Storage Service 用 RDMA WRITE 把数据写入客户端内存, 再补一个 RDMA SEND 通知客户端"传完了"为什么用 RDMA WRITE 而不是 READ? 这是 RDMA 的经典权衡。RDMA READ 由接收方发起,数据直接从远端内存读进本地,看起来更简单;但 READ 会在远端产生额外的 PCIe 和内存访问开销。WRITE 是单边的、单向的,数据从发起方直接落进对端内存,效率更高。代价是需要提前告知对方”我要往你的哪个地址写”,也就是需要这个 request-to-send 握手来协调。
论文对这个设计的评价很坦诚:“request-to-send 控制增加了端到端的 IO 延迟,但它是实现可持续高吞吐的必要条件。” 这是一个典型的”用一点延迟换吞吐稳定性”的取舍——对 KVCache 和 checkpoint 这种吞吐敏感、延迟相对不敏感的场景,这笔交易划算。
数据面:CRAQ 链式复制为什么适合只读为主
3FS 把文件切成等大的 chunk,每个 chunk 通过链式复制(Chain Replication)复制到多个 storage target 上。它采用的协议是 CRAQ(Chain Replication with Apportioned Queries),核心卖点是 write-all-read-any:写必须沿着链全部走完,读可以向链上任意一个副本发起。
这个特性对 3FS 至关重要。官方 Design Notes 里有一句话点明了动机:
Utilizing read bandwidth of all replicas is critical to achieve highest read throughput in an all-flash storage system. (在全闪存存储系统中,利用所有副本的读带宽是达成最高读吞吐的关键。)
3 副本在这套系统里不是”为了可靠性多存两份”,而是读带宽乘以 3。
写路径的六个步骤
Design Notes 把存储服务处理一次写的流程写得很细:
- 校验请求里的 chain version 与本地已知的最新版本是否一致,不一致直接拒绝。
- 发起 RDMA Read 把要写的数据拉过来。注意这里是”拉”不是”推”——后继节点主动从前序节点读数据(如果请求来自客户端,就从客户端读)。这个方向的选择减少了数据切包,性能更好。
- 数据进本地内存缓冲区后,从锁管理器获取该 chunk 的锁,同一 chunk 的并发写被串行化。所有写都在链首串行化。
- 读取该 chunk 的 committed version 到内存,应用更新,把结果存成一个 pending version。所以一个 target 上同一个 chunk 可能同时存在两个版本:已提交版本号 和待提交版本号 ,满足 。
- 如果自己是链尾,原子地把 committed 替换为 pending,然后向前驱发确认消息;否则把写请求转发给后继。
- 收到确认消息时,把自己的 committed 替换为 pending,继续向前驱传递确认,然后释放 chunk 锁。
第 4 步那个 的不变式很关键,它是读路径判断”数据是否可读”的依据。
读路径:不用问链尾
标准 CRAQ 的读有个麻烦:客户端可能拿到过一个陈旧副本(因为写还没传到链尾)。标准做法是读链尾,或者向链尾问一下最新版本号。
3FS 换了一种更省事的做法:
- 如果本地只有 committed version,直接返回。
- 如果同时有 committed 和 pending,返回一个特殊状态码,告诉客户端”这里正在写”。
- 客户端可以等一小会儿重试,或者发一个 relaxed read 请求直接拿走 pending 版本。
这等于把”要不要等一致性”的决定权交给了客户端。对于 KVCache 这种”读到的数据可能刚刚写入”的场景,客户端大概率选重试;对于可以容忍最终一致性的场景,relaxed read 省掉一次往返。没有向链尾发版本查询这一个改动,就把每次读的往返次数降下来了——在一个每秒要处理数百万次小读的系统里,这个差别是巨大的。
链表怎么排:避免恢复期的读热点
链表(chain table)决定了哪些 target 组成一条链。论文举了个具体例子:6 个节点 A-F,每个 SSD 上建 5 个 target(A1…A5、B1…B5…),共 30 个 target,每 chunk 3 副本,就能排出 10 条链。
这里有一个非常精彩的工程细节。假设读流量均匀分布在所有 target 上,现在 A 挂了,它承担的读请求会被重定向到同链的 B 和 C。结果就是 B、C 的读带宽瞬间饱和,成为整个系统的瓶颈——而换盘 + 数据同步要花好几个小时,这段时间整个集群的读吞吐都被拖累。
3FS 的解法是重新设计链表的排列方式,让 A 和尽可能多的其他 SSD 配对:
| Chain | Target 1 (head) | Target 2 | Target 3 (tail) |
|---|---|---|---|
| 1 | B1 | E1 | F1 |
| 2 | A1 | B2 | D1 |
| 3 | A2 | D2 | F2 |
| 4 | C1 | D3 | E2 |
| 5 | A3 | C2 | F3 |
| … | … | … | … |
对比之下,A 出现在第 2、3、5、6、9 条链里,与 A 同链的节点变成了 B、C、D、E、F 五家。A 挂掉后,读压力被五家分担,每家只多接 1/5 的流量,而不是让两家翻倍。
更妙的是论文接下来的一句话:“To achieve maximum read throughput during recovery, the load balance problem can be formulated as a balanced incomplete block design. The optimal solution is obtained by using integer programming solver.”——把”故障期间的读负载均衡”规约成了一个平衡不完全区组设计(BIBD)问题,用整数规划求解器求最优解。
这是整篇 Design Notes 里最能体现”设计深度”的地方:一个看起来只是”把链排一排”的工程问题,被形式化成了一个组合设计问题,并且用求解器拿到了最优解。对熟悉组合数学的读者来说,链表就是一个 v 个处理、b 个区组、每个区组 k 个元素的设计问题。
故障检测与状态机
cluster manager 靠心跳做 fail-stop 故障检测。规则有两条要注意:
- 超过 秒(默认 60s)收不到心跳,判定服务故障。
- 服务自己如果 秒联系不上 cluster manager,就主动停止处理请求并退出。
第二条很关键:这是防止网络分区导致脑裂的手段。一个存储服务如果被分区隔离,它无法判断自己是”活着但网络断了”还是”真的挂了”,主动退出是唯一安全的做法。心跳在这里的本质是向 manager 续租。
每个 storage target 有两个状态:public state(存在链表里,分发给所有服务和客户端)和 local state(只有存储服务和 manager 知道,存在 manager 内存里)。
public state 的五个取值和它们对读写的允许情况是理解恢复流程的钥匙:
| Public State | 可读 | 可写 | 含义 |
|---|---|---|---|
| serving | Y | Y | 正常服务 |
| syncing | N | Y | 存活,正在恢复数据 |
| waiting | N | N | 存活,但恢复尚未开始 |
| lastsrv | N | N | 已宕机,且曾是最后一个 serving 的 target |
| offline | N | N | 宕机或介质故障 |
注意 syncing 状态可写不可读——因为它的数据还不完整,读会读到错的东西,但写可以继续(写会以 full-chunk-replace 的形式把它逐步填满)。这个”可写不可读”的组合是整个在线恢复机制的基础。
local state 只有三种(up-to-date / online / offline),它扮演的是触发事件的角色:cluster manager 周期性地扫描每条链,根据一张状态转移表更新各 target 的 public state。Design Notes 里给出了完整的转移表,其中有一条特别值得注意:
If a storage target is marked offline, it’s moved to the end of chain. (一旦 target 被标记 offline,它会被移到链尾。)
移到链尾意味着它不再承担写的中继,读也会绕开它(因为 offline 不可读)。等它恢复、重新上线并同步完成后,再回到正常位置。
在线恢复:用”整块替换写”完成同步
恢复流程是 3FS 设计里最有意思的一段,因为它做到了”恢复过程和正常读写完全重叠”。
当一个之前离线的存储服务重新启动时:
- 它先周期性地从 cluster manager 拉最新链表,但在自己的所有 target 都被标记为 offline 之前不发心跳——这样保证所有 target 都会走一遍恢复流程。
- 恢复期间收到写请求时,请求一律是 full-chunk-replace 写(整块替换,而不是增量写)。本地 committed version 被更新,已有的 pending version 被丢弃。因为它此时是链尾,直接向前驱发确认。
- 恢复开始前,前驱向它发一个 dump-chunkmeta 请求,它遍历本地 chunk 元数据存储,把所有 chunk 的 id、chain version、committed/pending 版本号回给前驱。
- 前驱拿到元数据后,和本地的那份对比,决定哪些 chunk 需要传。
- 传输时对每个 chunk 加锁 → 读出版本号和内容 → 发 full-chunk-replace 写 → 解锁。
- 全部传完,向前驱发 sync-done;服务收到后把 local state 置为 up-to-date,在后续心跳里上报。
前驱判定”哪些 chunk 要传”的规则也写得很清楚:
- 本地有、远端没有 → 传。
- 远端有、本地没有 → 删。
- 本地 chain version 更大 → 传。
- chain version 相同但 本地 committed 版本号 ≠ 远端 pending 版本号 → 传。
- 其余情况说明两份副本要么一致,要么正在被进行中的写请求更新,不用管。
为什么用整块替换写而不是增量传输? 因为这个流程同时承担了两个职责:既恢复数据,又保证恢复期间新写入的数据不会丢失。用整块替换这种”幂等”的写语义,前驱不需要知道远端缺哪一段,只要把整块推过去,恢复和数据同步就自然合流了。
元数据面:把目录树塞进 FoundationDB
3FS 的元数据服务是无状态的。所有文件元数据以键值对形式存在 FoundationDB 里,元数据服务只负责把 POSIX 的目录操作翻译成 FoundationDB 的事务。
为什么选一个事务型 KV
Design Notes 给的选型理由很直接:FoundationDB 提供 Serializable Snapshot Isolation(SSI),也就是可串行化的强 ACID 语义。把可靠性、扩展性下沉到 KV 层之后,元数据服务本身可以做得非常简单:
- 无状态 → 管理员可以随时升级或重启,客户端请求失败自动切到别的 meta service。
- 目录树操作里那些经典难题(重命名导致成环、孤儿节点)不需要自己实现——交给 FoundationDB 的事务模型去解决。
对比一下:如果用对象存储的思路(key 里带 / 模拟目录),“把 dir_a/dir_b 移到 dir_c/ 下”这件事需要先确认 dir_c 不是 dir_b 的后代,这要求向上遍历所有祖先,而且整个操作不是原子的。用事务型 KV 表达,这只是一次读写事务。
inode 与 dentry 的键设计
元数据只有两类核心结构:inode 和 目录项(directory entry)。
inode 存属性,每个有全局唯一、单调递增的 64 位 ID。键的构造是 "INOD" 前缀 + inode id,且 id 用小端序编码。这个”小端序”细节是刻意为之:小端序能让连续分配的 inode 分散到不同的 FoundationDB 节点上,避免新建文件时全部打到同一个分片形成热点。
inode 的 value 按类型不同:
- 共有属性:属主、权限、访问/修改/变更时间。
- 文件 inode 额外有:文件长度、chunk 大小、在链表中选中的范围、shuffle seed。
- 目录 inode 额外有:父目录的 inode id、给子目录/文件用的默认布局配置(链表、chunk 大小、stripe 大小)。父 inode id 是用来检测目录移动成环的——把
dir_a/dir_b移到dir_c/时,要确认dir_c不是dir_b的后代,做法就是从dir_c向上遍历所有祖先。 - 符号链接 inode 额外有:目标路径字符串。
目录项的键是 "DENT" 前缀 + 父 inode id + 条目名。这个设计有个漂亮的性质:同一个目录下的所有条目天然构成一段连续的 key range,列目录就是一次 range query,不需要额外索引。
减少事务冲突的两个技巧
元数据服务的性能瓶颈不在计算,而在事务冲突。两个优化值得单独讲:
第一,用 inode id 哈希把请求攒批。 同一目录下的创建操作、同一文件的更新操作,会通过 inode id 的哈希被转发到固定的元数据节点上,这样这些请求可以攒成 batch 提交,大幅减少 FoundationDB 的冲突概率。
第二,用 rendezvous hash 分散文件长度更新任务。 文件长度更新是一个高频冲突点(下面细说),把任务按 inode id 做 rendezvous hash 分散到多个 meta service,可以避免多个服务同时重算同一个文件的长度导致反复冲突。
文件长度为什么只能是最终一致
这是 Design Notes 里讲得最细的一个工程妥协。
文件长度存在 inode 里。但对于正在被写入的文件,inode 里的长度和实际长度会不一致。3FS 的做法是:
- 客户端每 5 秒向上报一次自己写到的最大位置;如果这个位置超过了 inode 里的长度,且没有并发的 truncate,就把它采纳为新长度。
- 因为可能有多个客户端并发写,上面的机制只能保证最终一致。
- 处理
close/fsync时,元数据服务要拿到精确长度——办法是向存储服务查询最后一个 chunk 的 id 和长度。
而这个”查询最后一个 chunk”的操作,在文件数据条带化(striped)到多条链上时开销不小。所以有了两个进一步的优化:
优化一:生产环境用大 stripe size(200)。 但小文件实际只会用到远少于 200 条链,于是 inode 里额外存一个”可能用到的链数量”提示值,初值 16,每次写到更多链上就翻倍。这样更新长度时就不必查询全部 200 条链。
优化二: 同样的思路还可以推广到小文件的删除。
这里的取舍很清楚:精确长度是昂贵的,所以把它推迟到真正需要的时候(close/fsync)再算,平时用一个每 5 秒上报的近似值顶着。
文件创建与数据布局
文件创建时,元数据服务会:
- 按 stripe size 轮询(round-robin) 从指定链表里选出连续若干条链。
- 生成一个随机种子,把选中的链打乱顺序。
第二步的随机种子是防热点的关键:如果不打乱,所有文件的第 0 个 chunk 都会落在同一条链上。
然后,当应用打开文件时,客户端向元数据服务要一次布局信息(哪些链、chunk 大小、seed),之后就可以自己算出每个 chunk 的 id 和所在的链:
这就是”元数据服务不在关键路径上”的实现方式:读一个 chunk 的数据不需要经过任何元数据查询,客户端本地算一遍就知道该找哪个存储服务要数据。对 KVCache 这种动辄几十万次小读的场景,这一条直接决定了系统能不能跑起来。
存储引擎:chunk engine 的三层结构
存储服务底下真正的存储引擎叫 chunk engine,每个 SSD 上跑一个。它的架构简单但每一层都有讲究:
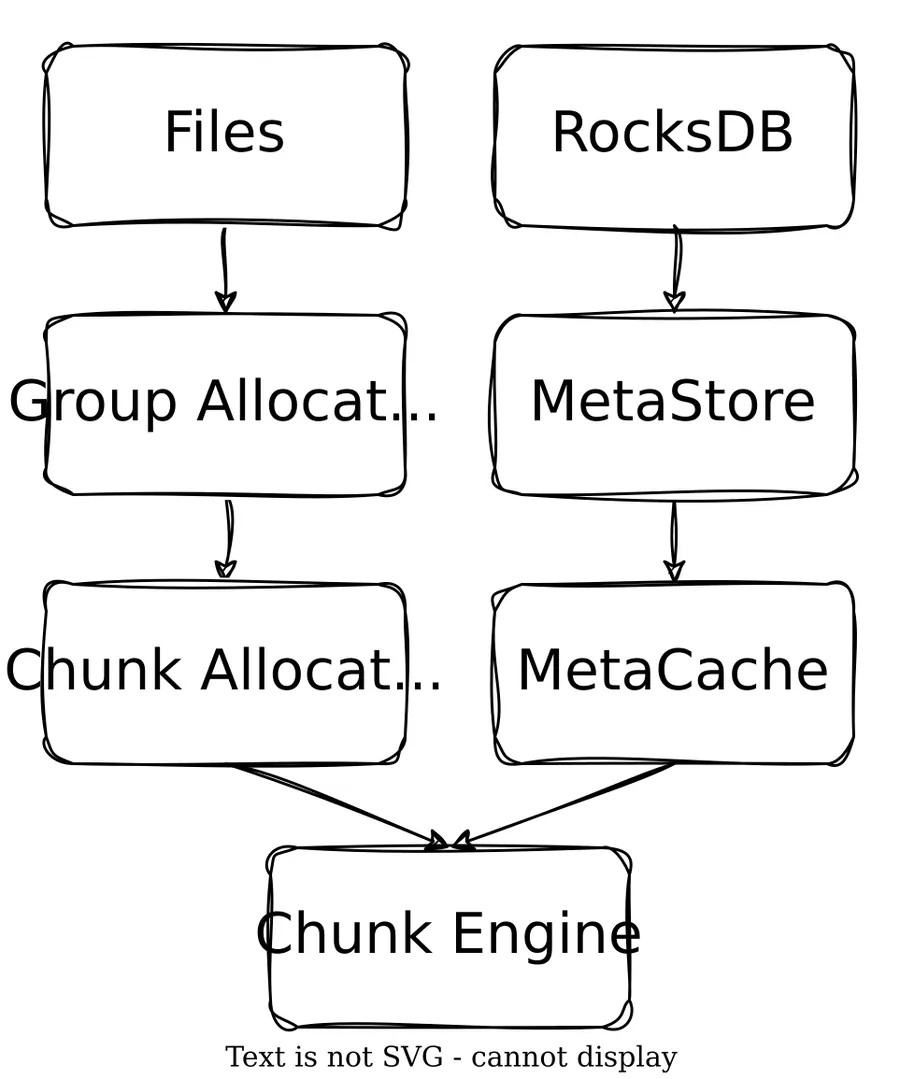
(图源:3FS 仓库 src/storage/chunk_engine/docs/architecture.drawio.svg)
左边一列是空间管理:Files 是若干个固定数量的数据文件,Group Allocator 和 Chunk Allocator 负责从中分配空间。右边一列是元数据管理:RocksDB 持久化 chunk 元数据,MetaStore 是持久层封装,MetaCache 是内存缓存。
物理块的 11 种大小与 256 文件池
chunk 数据最终落在物理块上。物理块大小从 64 KiB 到 64 MiB,按 2 的幂共 11 种。分配器会挑一个大小最贴近实际 chunk 的物理块——这样既不浪费空间,也不会因为块太小而频繁分裂。
每种物理块大小对应一个资源池,池里有 256 个物理文件。物理块的占用状态用位图(bitmap)在内存里维护。当一个物理块被回收时:
- 只是把位图标志位置 0,实际的存储空间保留下来,优先给后续分配用。
- 只有当池里没有可用物理块时,才用
fallocate()在物理文件里分配一大段连续空间,一次性创建 256 个新物理块。
为什么要”保留空间 + 批量 fallocate”? 两个目的:一是避免频繁的系统调用;二是 fallocate() 一次性分配连续大空间能减少磁盘碎片——这对全闪存阵列上的顺序读性能影响很大。
四个接口与 COW 语义
chunk engine 对外只暴露四个线程安全的操作:
| 操作 | 语义 |
|---|---|
open / close | 从 RocksDB 加载元数据,重建分配器状态 |
get | 通过 hashmap 缓存拿到带引用计数的 chunk 句柄,平均 O(1) |
update | COW 语义:先分配新物理块,再改数据;旧 chunk 在所有句柄释放前保持可读 |
commit | 用 write batch 把新元数据原子写入 RocksDB,并同步刷新元数据缓存 |
update 的 COW 实现是这样的:分配新块 → 把已有 chunk 数据读进缓冲区 → 应用更新 → 把新缓冲区写入新块 → 用新块位置和旧元数据构造一份新元数据 → 原子地更新 RocksDB 里的新 chunk 元数据和两个物理块的状态。
这里有个针对追加写的优化:如果是追加(append),直接在原块尾部原地写入,不走 COW。为什么这个优化重要?因为 KVCache 和日志类负载本质都是追加写,如果每次都”读出来-改-写回去”,写放大和 SSD 磨损都会很严重。Design Notes 的说法是”An optimized process is implemented for appends, where data is directly added in-place at the end of the existing block.”——单独为追加开了一条快路径。
客户端:从 FUSE 的 40 万 IOPS 到用户态零拷贝
前面说了那么多服务端设计,但如果客户端送不上请求,一切都是白搭。3FS 在客户端上花的功夫,可能是整个系统里最有普适价值的部分。
FUSE 的三个硬伤
大多数应用用 FUSE 客户端(hf3fs_fuse),因为它兼容 POSIX,接入成本低——把 open() 换成挂载点路径就行。但 FUSE 有三个绕不开的性能问题,Design Notes 把每个都量化了:
第一,内存拷贝开销。 用户态的文件系统守护进程无法访问应用的内存,数据必须在内核态和用户态之间来回拷贝,消耗内存带宽、增加端到端延迟。一次请求要经过内核 VFS → FUSE 转发 → 用户态守护进程,中间有 4 次”内核-用户态”上下文切换。
第二,多线程支持太原始。 应用发起 I/O 请求时,FUSE 把请求放进一个受自旋锁保护的多线程共享队列,用户态守护进程再从队列里取。锁竞争导致 FUSE 的 I/O 处理能力无法随线程数扩展。3FS 的实测数字很刺眼:FUSE 每秒只能处理约 40 万次 4 KiB 读,继续加并发不仅没用,反而因为锁竞争加剧而更慢。perf 分析显示内核态的自旋锁吃掉了大量 CPU 时间。
第三,Linux 5.x 的 FUSE 不支持对同一文件并发写。 应用只能通过并发写多个文件来绕开,以拉满总吞吐。
为什么不写内核模块
一个自然的想法是:既然 FUSE 慢,那就写个 VFS 内核模块,像 NFS 客户端那样。这样彻底绕开 FUSE 所有的问题。
3FS 明确否决了这条路,理由非常工程化,值得完整引用其逻辑:
- 内核模块开发远比用户态系统编程困难。
- Bug 难以诊断,且可能在生产环境造成灾难性后果——比如机器直接崩溃,连一条用于调试的日志都不留。
- 升级内核模块时,所有使用该文件系统的进程必须干净地停止,否则就得重启机器。
在几千个节点的训练集群里,“升级一次文件系统客户端可能要重启机器”是完全不可接受的运维成本。所以 3FS 选择了一条中间路线。
USRBIO:把 io_uring 的思路搬进用户态
3FS 的原生客户端实现在 FUSE 守护进程内部,提供的是一套异步、零拷贝的用户态 API,灵感直接来自 Linux 的 io_uring。核心是两个数据结构:
- Iov:一大块共享内存区域,用于零拷贝读写,用户进程和原生客户端共享。InfiniBand 的内存注册由客户端管理。所有读到的数据都进 Iov,所有要写的数据都先放进 Iov。
- Ior:一个小型的共享环形缓冲区,用法和
io_uring类似——用户进程把读写请求入队,原生客户端出队并完成它们。请求按 batch 执行,batch 大小由io_depth参数控制。
元数据操作(open/close/stat)仍然走 FUSE,应用先 open() 拿到文件描述符,再通过原生 API 注册这个 fd,然后就能在它上面做原生 I/O。这个设计让元数据操作和 POSIX API 保持一致,迁移已有代码更容易。
通信机制上,USRBIO 用的是共享内存 RingBuffer + 信号量通知,思路借鉴了 DPDK 和 io_uring。具体做法是:每个实例使用一个 Iov 文件(注册为 RDMA memory buffer,实现全链路零拷贝)和一个 Ior 文件(实现 IoRing,含提交队列和完成队列);一个挂载点下所有 USRBIO 实例共享 3 个 submit semaphore 文件来表示优先级。
收益有多大?官方数字是相比 FUSE 快 3 到 5 倍。 因为请求直接从用户进程发给 FUSE 守护进程,那 4 次上下文切换和 1-2 次数据拷贝全部消失。
这个设计的边界很克制:USRBIO 只加速读写操作,其他操作全部复用 FUSE 逻辑。这跟 GPU Direct Storage 的思路如出一辙——只在真正吃性能的那条路径上做特化。
FFRecord:给小文件补一块短板
Design Notes 里有一句很坦诚的自评:“3FS 未对小文件做调优,直接存取大量小文件性能较差。”
这不是疏忽,而是设计取舍的结果——大文件条带化、大块读写是 3FS 的主线,小文件不是。但训练时确实存在海量小文件(样本、图片、中间产物)的场景,于是 3FS 提供了 FFRecord 文件格式来弥补:
- 把多个小文件合并进一个文件,减少训练时打开文件的开销。
- 支持随机批量读取(一次读一批样本,而不是一个个读)。
- 包含 CRC32 数据校验。
这相当于在 3FS 这层”大文件友好”的文件系统之上,用一层应用侧的文件格式来模拟”小文件友好”。用格式解决问题,而不是改文件系统——这是很典型的系统设计取舍。
推理侧:KVCache 为什么需要一块磁盘
好,现在回到推理。
3FS-KV:建在 3FS 之上的分布式数据处理系统
论文 Section VI-B4 介绍了一个叫 3FS-KV 的东西:它是建在 3FS 之上的共享存储分布式数据处理系统,目前支持三种模型——key-value、消息队列、对象存储。它支持读写分离和按需启动,从而充分利用 3FS 提供的高 I/O 吞吐。
关键的是最后一句:3FS-KV 支撑了 DeepSeek 的 “KV Context Caching on Disk” 技术,把 LLM 服务的成本降低了一个数量级(reduces the cost of LLM serving by an order of magnitude)。
为什么这件事在成本上如此重要
要先理解一个事实:LLM 推理的输入 token 里有极大概率是重复的。多轮对话里每一轮都要把之前的全部历史重新发一遍;代码补全里文件的绝大部分内容不变;RAG 场景里同一份文档会被反复检索。这些重复的前缀,如果每次都重新算一遍 prefill,算力就被白白烧掉了。
业界对此的通用解法是前缀缓存(prefix caching):把算过的 KV 缓存按前缀存起来,下次遇到相同前缀直接复用。本站已经详细写过 RadixAttention 如何用前缀树自动复用 KV Cache,也写过 DualPath 如何让解码引擎直读 KV-Cache。
但这些方案都止步于内存。而内存有两个硬约束:
- 容量。一块 8 卡 H800 节点的显存是 640 GB 级别,扣掉模型权重后能留给 KV 的空间有限。前缀缓存的命中率对容量极其敏感——缓存池越大,能装下的不同前缀越多,命中率越高。
- 成本。DRAM 便宜不到哪去,而且它和显存一样是每节点私有的。你在这个节点缓存的 KV,换个节点就用不上了。
3FS 的思路是:把 KV 缓存卸载到共享的 NVMe 存储池上。
官方 README 对这条功能的描述只有一句话,但信息量很大:
KVCache for Inference — Provides a cost-effective alternative to DRAM-based caching, offering high throughput and significantly larger capacity. (为推理提供 DRAM 缓存的低成本替代方案,具备高吞吐与显著更大的容量。)
三个词的对比很清楚:成本比 DRAM 低、吞吐够高、容量大得多。而且因为 3FS 是所有节点共享的,缓存不再绑定在某一台机器的显存里——今天这个副本算过的前缀,明天另一个副本可以直接命中。
这就是为什么 3FS 的 KVCache 不是”把文件系统顺便拿来存 KV”,而是一个架构级的成本优化。
实测:40 GiB/s 的读吞吐是怎么来的
先看整个集群的读带宽上限在哪。官方 README 披露的压测集群是 180 个存储节点,每节点 2×200Gbps InfiniBand 网卡、16 块 14TiB NVMe SSD,用 500+ 个客户端节点(每节点 1×200Gbps)做读压测:
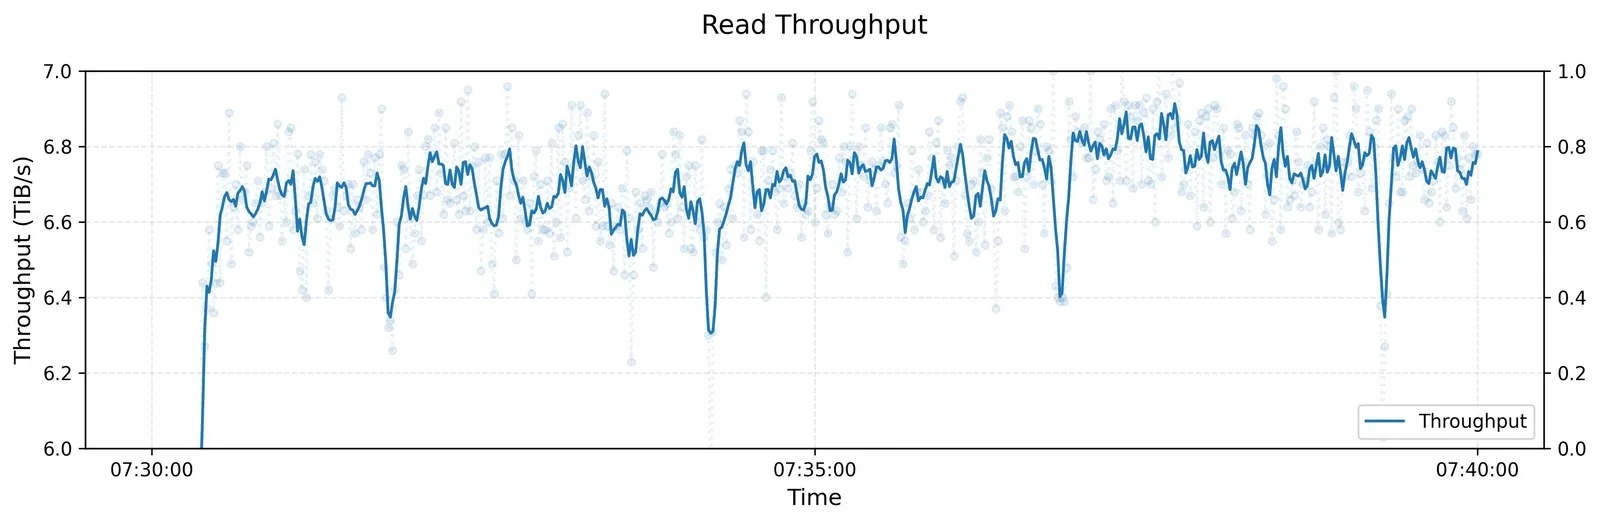
(图源:3FS 官方 README)
最终的聚合读吞吐约 6.6 TiB/s,而且这个数字是在有训练任务背景流量并存的情况下达成的——考虑到前面说的存储与计算共用一张融合网络,这一点比数字本身更有说服力。
在这个基础上,单客户端的 KVCache 表现为:全部 KVCache 客户端(单节点 1×400Gbps NIC)的读吞吐峰值达到 40 GiB/s。
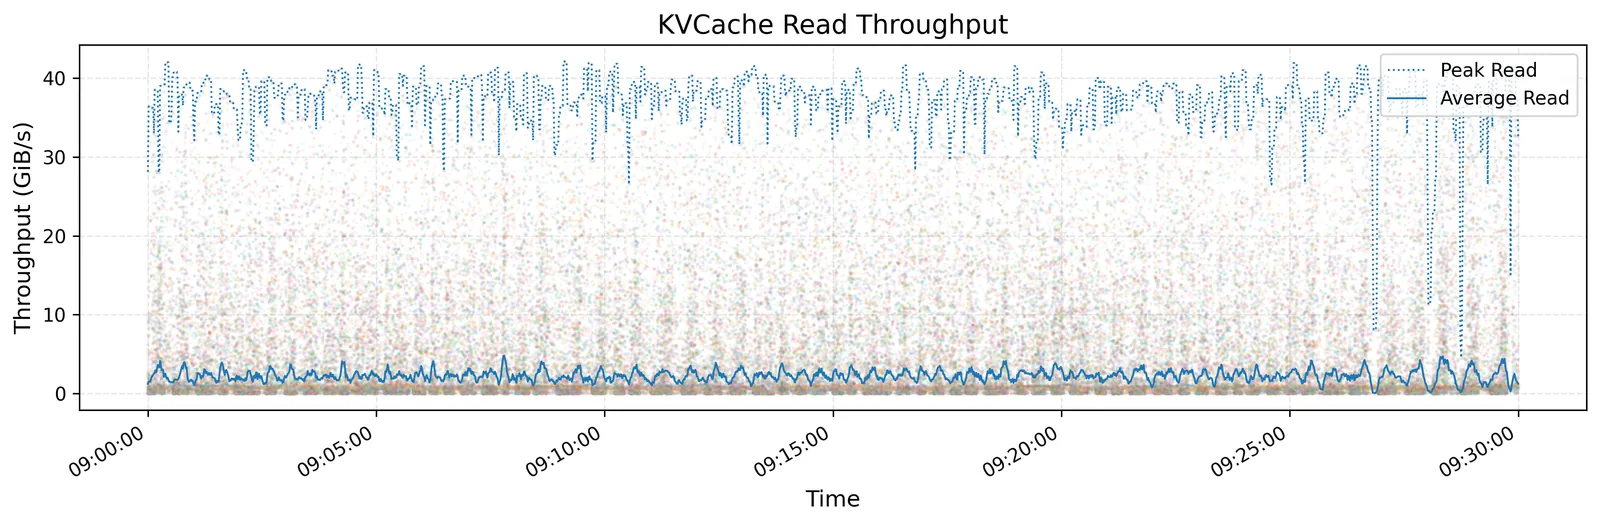
(图源:3FS 官方 README)
这张图有两个信息层,都要读:
- 峰值(蓝色虚线)稳在 40 GiB/s 附近,中间有几次掉到 30 GiB/s 以下——那是故障切换或负载波动。
- 平均值(蓝色实线)在几 GiB/s 到十几 GiB/s 之间起伏,远低于峰值。
平均值远低于峰值这件事不是缺陷,而是负载特征的真实画像:推理请求的到来是突发性的,缓存命中也是。系统需要为突发峰值准备带宽,但大部分时间用不满。这也解释了为什么 3FS 要用 request-to-send 做流控——必须保证峰值来临时不被打爆。
官方还配了一张垃圾回收(GC)的 IOPS 图,这是理解”为什么 KVCache 需要一块磁盘”的另一个侧面:
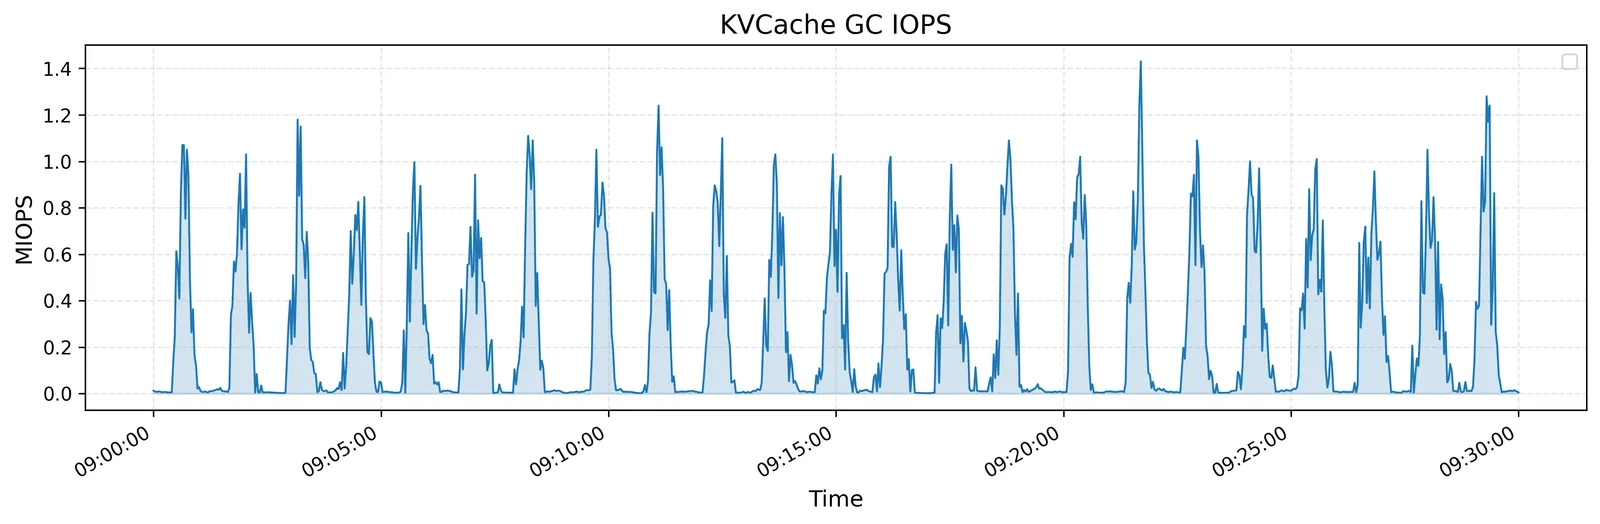
(图源:3FS 官方 README)
这张图的形状非常有特点:周期性的、陡峭的尖峰,峰值冲到 1.4 MIOPS,峰谷之间几乎没有过渡。这说明 KVCache 的淘汰/回收是按批触发的:缓存池满了,触发一轮回收,把大量失效的 KV 块一次性清掉。
为什么这个模式对存储系统是挑战? 因为它意味着系统要在极短时间内承受百万级的元数据操作(哪些块失效了、空间怎么回收、位图怎么更新),而峰值过后又迅速回落到近乎为零。这正是前面 chunk engine 那套设计要应付的场景:位图在内存里维护保证 O(1) 判断、RocksDB 用 write batch 批量提交、物理块保留空间优先复用。没有这些设计,一轮 GC 尖峰就能把存储服务打瘫。
顺手提一句 checkpoint
虽然本文不展开训练侧,但有一个数字值得放在这里做对照:3FS 的 checkpoint manager 用批量写 API 把参数和优化器状态分块写入,单节点超过 10 GiB/s,整个保存过程几秒钟完成,且与训练异步进行。
这个数字和 KVCache 的 40 GiB/s 读吞吐放在一起看,能看出 3FS 的能力边界:它是一个为”大块、高并发、可容忍适度延迟”设计的系统。几秒钟保存完几百 GB 的 checkpoint,和瞬间扛住百万 IOPS 的 GC 尖峰,本质是同一套能力在两个场景下的体现。
smallpond:3FS 之上的一层数据处理
开源周最后一天和 3FS 一起放出的还有 smallpond——一个基于 DuckDB 和 3FS 的轻量级数据处理框架,用来做大规模数据预处理。
它的定位可以从官方给出的 GraySort 测试看出来。GraySort 衡量的是超大规模数据集的排序性能,3FS 的实现采用两阶段方案:
- 用 key 的前缀位做 shuffle 分区;
- 在分区内排序。
两个阶段的数据都从 3FS 读写。测试集群是 25 个存储节点(每节点 2 个 NUMA 域、每域 1 个存储服务、2×400Gbps 网卡)加 50 个计算节点(每节点 192 物理核、2.2 TiB 内存、1×200Gbps 网卡)。
结果是:对 110.5 TiB 数据、8192 个分区排序,用时 30 分 14 秒,平均吞吐 3.66 TiB/min。
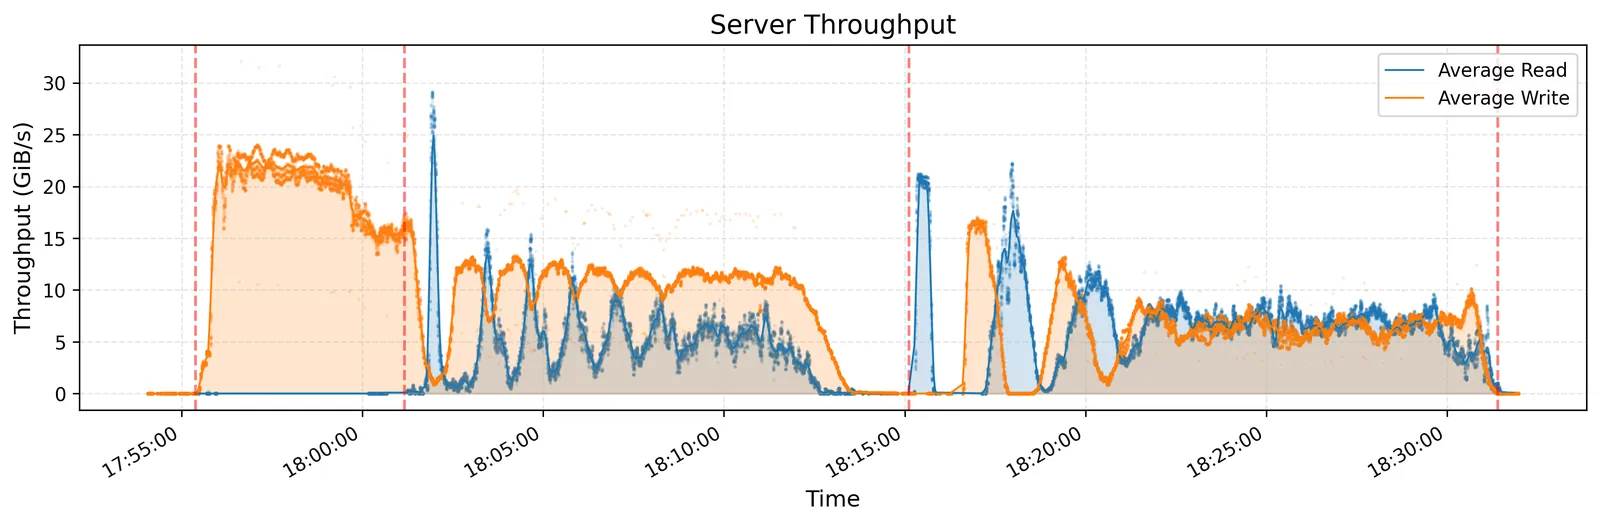
(图源:3FS 官方 README)
这张图里的细节比总数字更有意思:橙色(写)在一开始就冲到 22-24 GiB/s 并稳定维持了相当一段时间——那是 shuffle 阶段在把分区数据写出去;随后蓝色(读)出现几次陡峭的尖峰,最高接近 29 GiB/s——那是后续阶段在读取分区做排序。读写呈现出明显的阶段性交替,而不是均摊。
这恰好说明了 3FS 那套”计算存储融合网络 + 流量隔离 + request-to-send 流控”的价值:在这样一个读写交替、突发性极强的负载下,系统仍然能维持稳定吞吐而不发生拥塞。
需要强调的是,smallpond 的定位是轻量:它不是 Spark 那样的通用大数据引擎,而是”用 DuckDB 做单机计算、用 3FS 做共享存储”的组合,把分布式的部分压到最小。对 DeepSeek 来说,它服务的是数据预处理这条链路,而不是推理。
小结
把这篇的内容收一下:
3FS 要解决的问题是:在一个由 PCIe A100 组成的、每节点只有一张 200Gbps 网卡的便宜集群里,用一套共享存储同时支撑数据预处理、随机小读的 dataloader、TB 级 checkpoint 和 KVCache——而且存储流量还要和计算流量共用一张融合网络。
它的技术选择可以归纳成几条:
| 问题 | 方案 | 代价 |
|---|---|---|
| 元数据一致性 | FoundationDB + 无状态 meta service,SSI 事务 | 依赖一个外部 KV 组件 |
| 读吞吐 | CRAQ 链式复制,write-all-read-any | 写路径变长(必须走完整条链) |
| 恢复期读热点 | 链表按 BIBD 设计,用整数规划求最优 | 设计复杂度 |
| incast 拥塞 | request-to-send 握手 + RDMA WRITE | 端到端延迟增加 |
| FUSE 性能瓶颈 | 用户态 USRBIO,共享内存 Ring + 零拷贝 | 应用需改造代码 |
| 小文件 | FFRecord 格式(合并 + 批量读 + CRC32) | 需要应用配合 |
| 写放大 | chunk 追加写走原地快路径 | 需要区分写模式 |
| KV 缓存成本 | 3FS-KV 卸载到共享 NVMe 池 | 引入存储层延迟 |
最值得记住的一点:3FS 不是”顺便支持了 KVCache”,而是在架构层面把 KV 缓存的成本问题当成一等公民。当全行业都在想办法把 KV 塞进更贵的显存里、塞进更大一点的内存里时,DeepSeek 的选择是把它放进一个共享的、便宜的、容量大得多的闪存池里,再用一套精心设计的系统(CRAQ 的 read-any、USRBIO 的零拷贝、chunk engine 的追加快路径、request-to-send 的流控)去补偿闪存和网络相对 DRAM 的延迟劣势。
这条路径和 PagedAttention 解决”显存里怎么摆”、RadixAttention 解决”内存里怎么复用”、DualPath 解决”跨节点怎么搬”是同一个问题的不同层次——KV Cache 的存储层次,从显存、内存、节点间网络,一路延伸到了共享闪存。3FS 补上的正是这一层。
参考资料
- 3FS 官方仓库(deepseek-ai/3FS)
- 3FS Design Notes(官方设计文档)
- Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning(arXiv:2408.14158,SC24)
- 3FS USRBIO API Reference
- 3FS chunk engine 架构图(architecture.drawio.svg)
- deepseek-ai/open-infra-index(开源周与推理系统技术总览)
- smallpond 官方仓库
- DeepSeek API 文档:上下文硬盘缓存(Context Caching on Disk)
- DeepSeek 3FS 架构分析和思考(腾讯云开发者社区)
- Linux 内核 FUSE 源码:同一文件并发写的限制(v5.4.284 fs/fuse/file.c)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


